Pipelines agenticas de produção frequentemente falham devido a violações inesperadas de schema. Até mesmo LLMs autorregressivos de primeira linha falham no parsing de JSON durante chamadas de ferramentas de alto volume, forçando desenvolvedores a construir loops de retry complexos e manipuladores de erro personalizados.
TypeSafe Jev resolve essa falha estrutural abandonando completamente a geração sequencial, token por token. Operando como um modelo de decisão não autorregressivo, o Jev ingere o estado da aplicação e avalia perguntas de schema pré-declaradas em uma única passagem paralela para frente (forward pass). Como as escolhas de saída possíveis são estritamente limitadas antes da execução, o Jev elimina matematicamente JSON malformado, nomes de ferramentas inválidos e texto fora do schema.
Principais Conclusões: O que é o TypeSafe Jev AI? Benchmarks de Performance e Velocidade
TypeSafe Jev AI é um modelo de decisão não autorregressivo construído especificamente para classificação em sub-segundos, scoring de intenção e roteamento estruturado de microserviços. Diferente de LLMs autorregressivos, o Jev avalia escolhas de schema pré-declaradas em um único forward pass.
- Zero Alucinação em Nível de Tipo: Substitui loops de decodificação de strings por primitivas de schema de estado limitado, resultando em 0% de taxa de erro de tipo.
- Execução em Sub-500ms: Amostragem paralela não autorregressiva atinge latência P95 de 70ms–500ms, até 200 vezes mais rápido que LLMs padrão.
- Tokens de Saída Gratuitos: Zero tokens sequenciais gerados significa que os tokens de saída são completamente gratuitos a $0.042/1M de tokens de entrada.
- Ideal Para: Roteamento de microserviços, despacho de ferramentas de agente, triagem de tickets e gate de intenção.
Repensando a Stack de IA: Intuição do Sistema 1 vs. Raciocínio do Sistema 2
Ao projetar software backend escalável, forçar verificações condicionais simples por meio de um endpoint de chat completion pesado cria latência severa no sistema. A maioria dos sistemas de microserviços não exige prosa criativa ou geração de cadeia de pensamento multi-etapas; eles exigem seleção imediata e determinística sobre escolhas conhecidas.
Aplicando o Framework Cognitivo de Kahneman à Arquitetura de Software
O cofundador da TypeSafe, Diogo Almeida, que anteriormente foi co-criador de Reinforcement Learning from Human Feedback na OpenAI, introduziu uma mudança estrutural com TypeSafe Jev para resolver essa ineficiência. Baseando-se diretamente no framework cognitivo de Kahneman, a plataforma divide o processamento em duas camadas operacionais distintas na arquitetura moderna de AI stack:
- Sistema 2 - Raciocínio Lento e Deliberado: LLMs autorregressivos padrão que operam via geração sequencial, token por token. Esses modelos se destacam em redigir documentos longos, lidar com raciocínio ambíguo e escrever código complexo.
- Sistema 1 - Decisões Rápidas e Intuitivas: Um modelo System One AI dedicado treinado via Reinforcement Learning for Calibrated Decisions (RLCD) em vez do tradicional RLHF. Ele é projetado especificamente para classificação em sub-segundos, scoring de intenção e roteamento de execução sem overhead conversacional.
Jev vs. Custo e Arquitetura de LLM: Modelos de Decisão vs. Modelos de Chat
Substituir modelos de chat de propósito geral por modelos de decisão tipados especializados melhor definidamente o fluxo de trabalho de microserviços: isolando a avaliação rápida da geração profunda.
| Dimensão Arquitetural | LLMs autorregressivos (Sistema 2) | TypeSafe Jev (Sistema 1) |
| Tarefa Principal | Ressoa de síntese de texto aberto | Escolha e avaliação de schema |
| Latência de Execução | 3.000ms a 30.000ms+ | 70ms a 500ms |
| Formato de Saída | Fluxo de texto não estruturado | Primitivas de schema estritamente tipadas |
| Loop de Computação | Decodificação sequencial de tokens | Avaliação em forward pass único |
| Objetivo de Treinamento | Preferência humana (RLHF) | Confiança de decisão calibrada (RLCD) |
Transferir roteamento, guardrails de segurança e despacho de funções para fora dos modelos de chat padrão resolve os gargalos de performance inerentes aos LLMs autorregressivos. Ao incorporar um modelo de IA System One, garante-se que os motores de raciocínio pesados sejam apenas acionados quando a geração aberta for genuinamente necessária.
Como o Modelo TypeSafe Jev Entrega Zero Alucinação em Nível de Tipo
Mesmo com o modo JSON estrito ativado, LLMs fronteia não retonam frequente chaves fora do schema ou valores enum alucionados durante execuções de produção de alta concorrência, causando falhas em 0,5% a 5% das solicitações de pipeline. Microserviços de produção exigem determinismo de tipo absoluto, mas modelos autorregressivos permanecem inerentemente vulneráveis a erros de geração de strings.
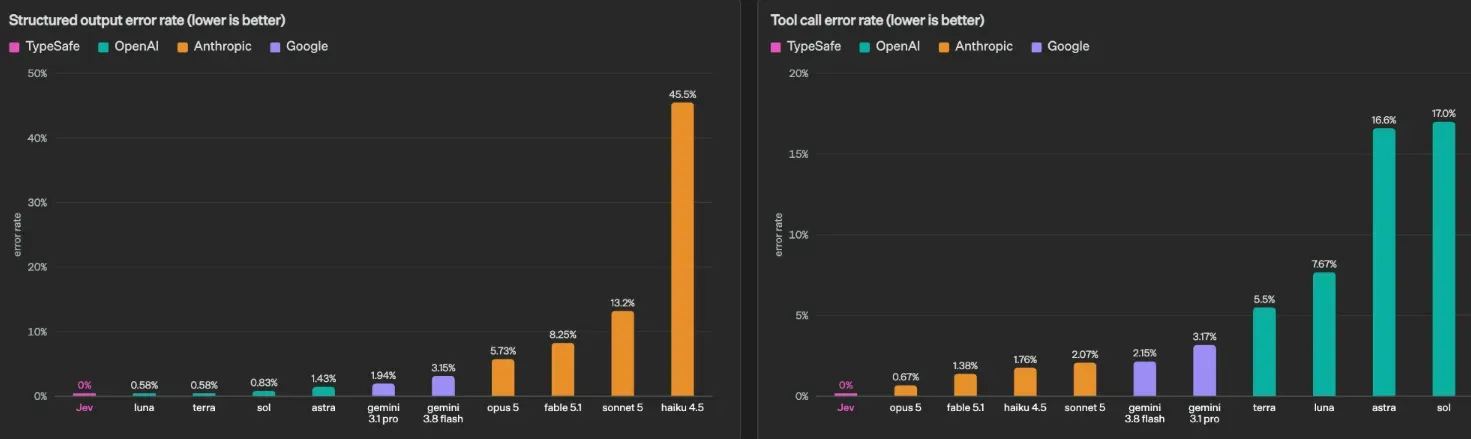
O TypeSafe Jev resolve isso substituindo loops de decodificação de string por uma arquitetura de estado limitado. Em vez de gerar texto arbitrário e tentar forçá-lo em sintaxe JSON, o Jev avalia dados de entrada contra restrições de schema predefinidas em uma única passagem. Essa mudança estrutural entrega verdadeira IA de zero alucinação no nível de tipo, resultando em 0% de erros de tipo em fluxos de trabalho automatizados.
As Três Primitivas de Schema Principais
O Jev processa todas as perguntas de entrada por meio de três tipos explícitos:
- Primitiva de Escolha (Choice): Seleciona exatamente uma opção de uma lista predefinida de até 255 escolhas categóricas, retornando o rótulo vencedor junto com as distribuições completas de probabilidade.
- Primitiva de Score: Avalia a entrada contra uma escala numérica ordenada ou rubrica descritiva, fornecendo classificações junto com os spreads de probabilidade em cada nível.
- Primitiva Noul: Calcula a probabilidade exata de uma condição sim ou não como um float entre 0,0 e 1,0, eliminando justificativas de texto intermediárias.
Como cada consulta é mapeada estritamente para essas três primitivas, o mecanismo de execução não pode emitir chaves válidas, nomes de ferramentas fora da lista ou payloads inválidos de saída.
Segurança de Tipo na Avaliação de Saída Estruturada
Modelos de chat tradicionais geram sintaxe caractere por caractere, criando riscos constantes de parsing em pipelines de backend.
| Métrica de Avaliação | Modo JSON autorregressivo | TypeSafe Jev System One |
| Imposição do Tipo de Saída | Validação de string pós-geração | Primitivas nativas limitadas matematicamente |
| Frequência de Erro de Tipo | Variável (0.5% a 5%+ de taxa de falha) | 0% de erros de tipo (schema limitado) |
| Risco de Enum Inválida | Alto sem loops de retry personalizados | Zero (impossível por design) |
Restringir a execução do modelo estritamente a um estado limitado garante uma avaliação confiável de saída estruturada. aplicativos consomem as saídas do Jev diretamente sem escrever manipuladores de exceção para schemas JSON quebrados.
Nota sobre Determinismo de Tipo vs. Probabilidade: O TypeSafe Jev garante 0% de erros de tipo e correspondência de schema por design, eliminando matematicamente sintaxe malformada, chaves ausentes e valores enum fora da lista. No entanto, como todos os modelos de decisão, suas escolhas de saída permanecem probabilísticas. Em entradas intrinsecamente ambíguas, os scores de confiança devem ser usados para controlar a execução, em vez de assumir certeza semântica absoluta.
Como o Parallel Sampling Não-Autorregressivo Gera Latência Sub-seq de 500ms e Saídas Grátis
Usar endpoints de chat padrão para tags de classificação simples como {"category": "billing"} introduz latência desnecessária em microserviços de produção. Porque ambos modelos autorregressivos dependem de decodificação sequencial de tokens, threads de backend permanecem bloqueados enquanto aguardam loops de geração de caracteres únicos.
A Mecânica de Avaliação de Passagem Única
Os transformers tradicionais executam loops de geração autorregressiva onde cada novo token requer uma passagem separada pela pilha de rede. Essa dependência sequencial cria baixa latência e infla os custos de infraestrutura com base no volume de tokens gerados.
O TypeSafe Jev elimina a geração sequencial usando amostragem paralela não autorregressiva. Como descrito no lançamento da TypeSafe, o processo:
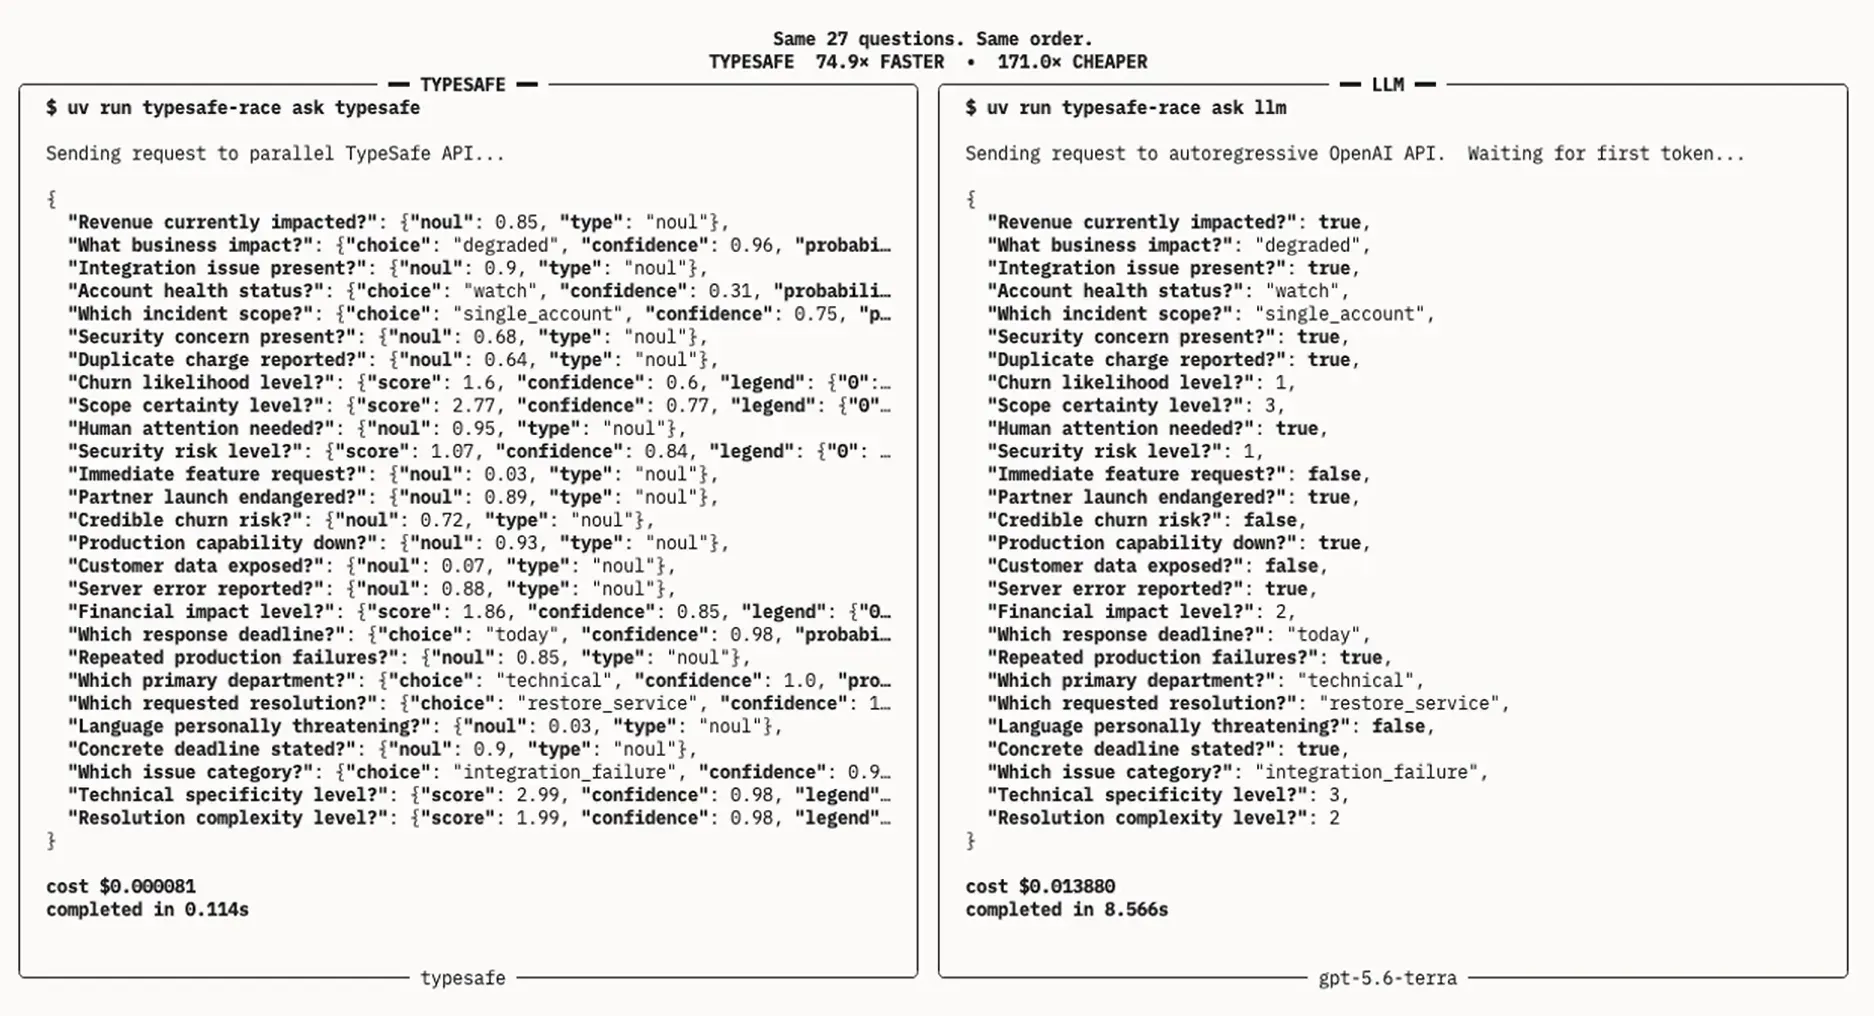
Comparação de benchmark terminal executando 2 perguntas de tablaais simultâneas: TypeSafe Jev vs. endpoint GPT 5.6 Terma
Como o modelo calcula distribuições de probabilidade sobre predefínidos, em vez de gerar texto livre, loops de decodificação de saída desaparecem. Essa mudança estrutural gera três ganhos principais de performance:
- Tokens de Saída Grátis (muito baratos para serem medidos): Como o Jev avalia as escolhas em um único forward pass sem gerar tokens sequenciais que precisam ser passados, a avaliação de saída tem custo de compute quase zero, tornando os tokens de saída efetivamente grátis.
- Preço previsível: o processamento de contexto da cobrança cobra um valor fixo de $0,042 por milhão de tokens de entrada. Avaliar schemas estáticos designados com Jev evita inflação de faturas de API exponenciais em comparação com overhead tradicional de execução de contexto longo FEM. (--keman)
- Execução em menos de um segundo: benchmarks de latência publicados do TypeSafe Jev mostram P95 consistentemente entre 70ms e 500ms, executando até 200 vezes mais rápido que modelos de chat de fronteira.
Detalhamento de Performance Arquitetural
| Métrica / Dimensão | LLMs autorregressivos tradicionais (Sistema 2) | Mecanismo TypeSafe Jev System One |
| Loop de Execução | Decodificação token por token sequencial | Passagem única paralela sobre pré-declarado schema |
| Tipo de Saída | Strings de texto não estruturados / JSON strings | Primitivas de decisão tipadas (Choice, Score, Noul) |
| Taxa de Erro de Schema | 0.58% a 45%+ dependendo do modelo/prompt | 0% erro de tipo (matematicamente limitado) |
| Perfil de Latência P95 | 3,000ms a 30,000ms+ | 70ms a 500ms |
| Economia de Saída | Variável por token ($15 a $60 / MTok) | GRÁTIS (barato demais para medir) Nenhuma geração sequencial de tokens de saída |
| Domínio Principal | Raciocínio, rascunho de escrita, síntese aberta | Classificação, escolha de ferramenta, gate de confiança |
Contenção do Gargalo de Largura de Banda de Memória
Na inferência padrão de LLM, a largura de banda de memória satura quando os pesos do modelo são recarregados na lógica de memória para cada token individual. Ao concluir avaliações-decisão em um único forward pass, o Jev contorna completamente esse gargalo de memória, sustentando velocidades de resposta estáveis sob forte tráfego concorrente.
Reinforcement Learning para Decisões Calibradas e Gates de Confiança
Modelos de chat padrão frequentemente geram declarações incorretas com auto-reportada confiança de 99%, porque o ajuste fino convencional recompensa de frases persuasivas em vez de verdade estatística. Em microwebserviços de produção, uma decisão errada excessivamente confiante leva diretamente a registros corrompidos no banco, argumentos quebrados de ferramentas e tempo de inatividade.
Alinhando a Confiança do Modelo com a Precisão Empírica
Para resolver isso, a TypeSafe introduziu Reinforcement Learning for Calibrated Decisions. Diferente da metodologia RLHF tradicional que otimiza preferência humana subjetiva, o RLCD treina modelos de decisão especificamente para produzir probabilidades calibradas e datas.
Na prática, se a saída do Jev de Jev houve 0.90 de probabilidade para uma escolha, isso significa que a escolha do candidato está precisamente correta 90% das vezes, conforme validado em conjuntos de teste. Isso garante uma decisão segura e probabilística e permite a implementação de ritmo de decisão com gate de confiança (confidence-gated routing) sem a necessidade de escrever heurísticas complexas de prompts para estimar a certeza da saída.
Implementando Roteamento com Gate de Confiança em Produção
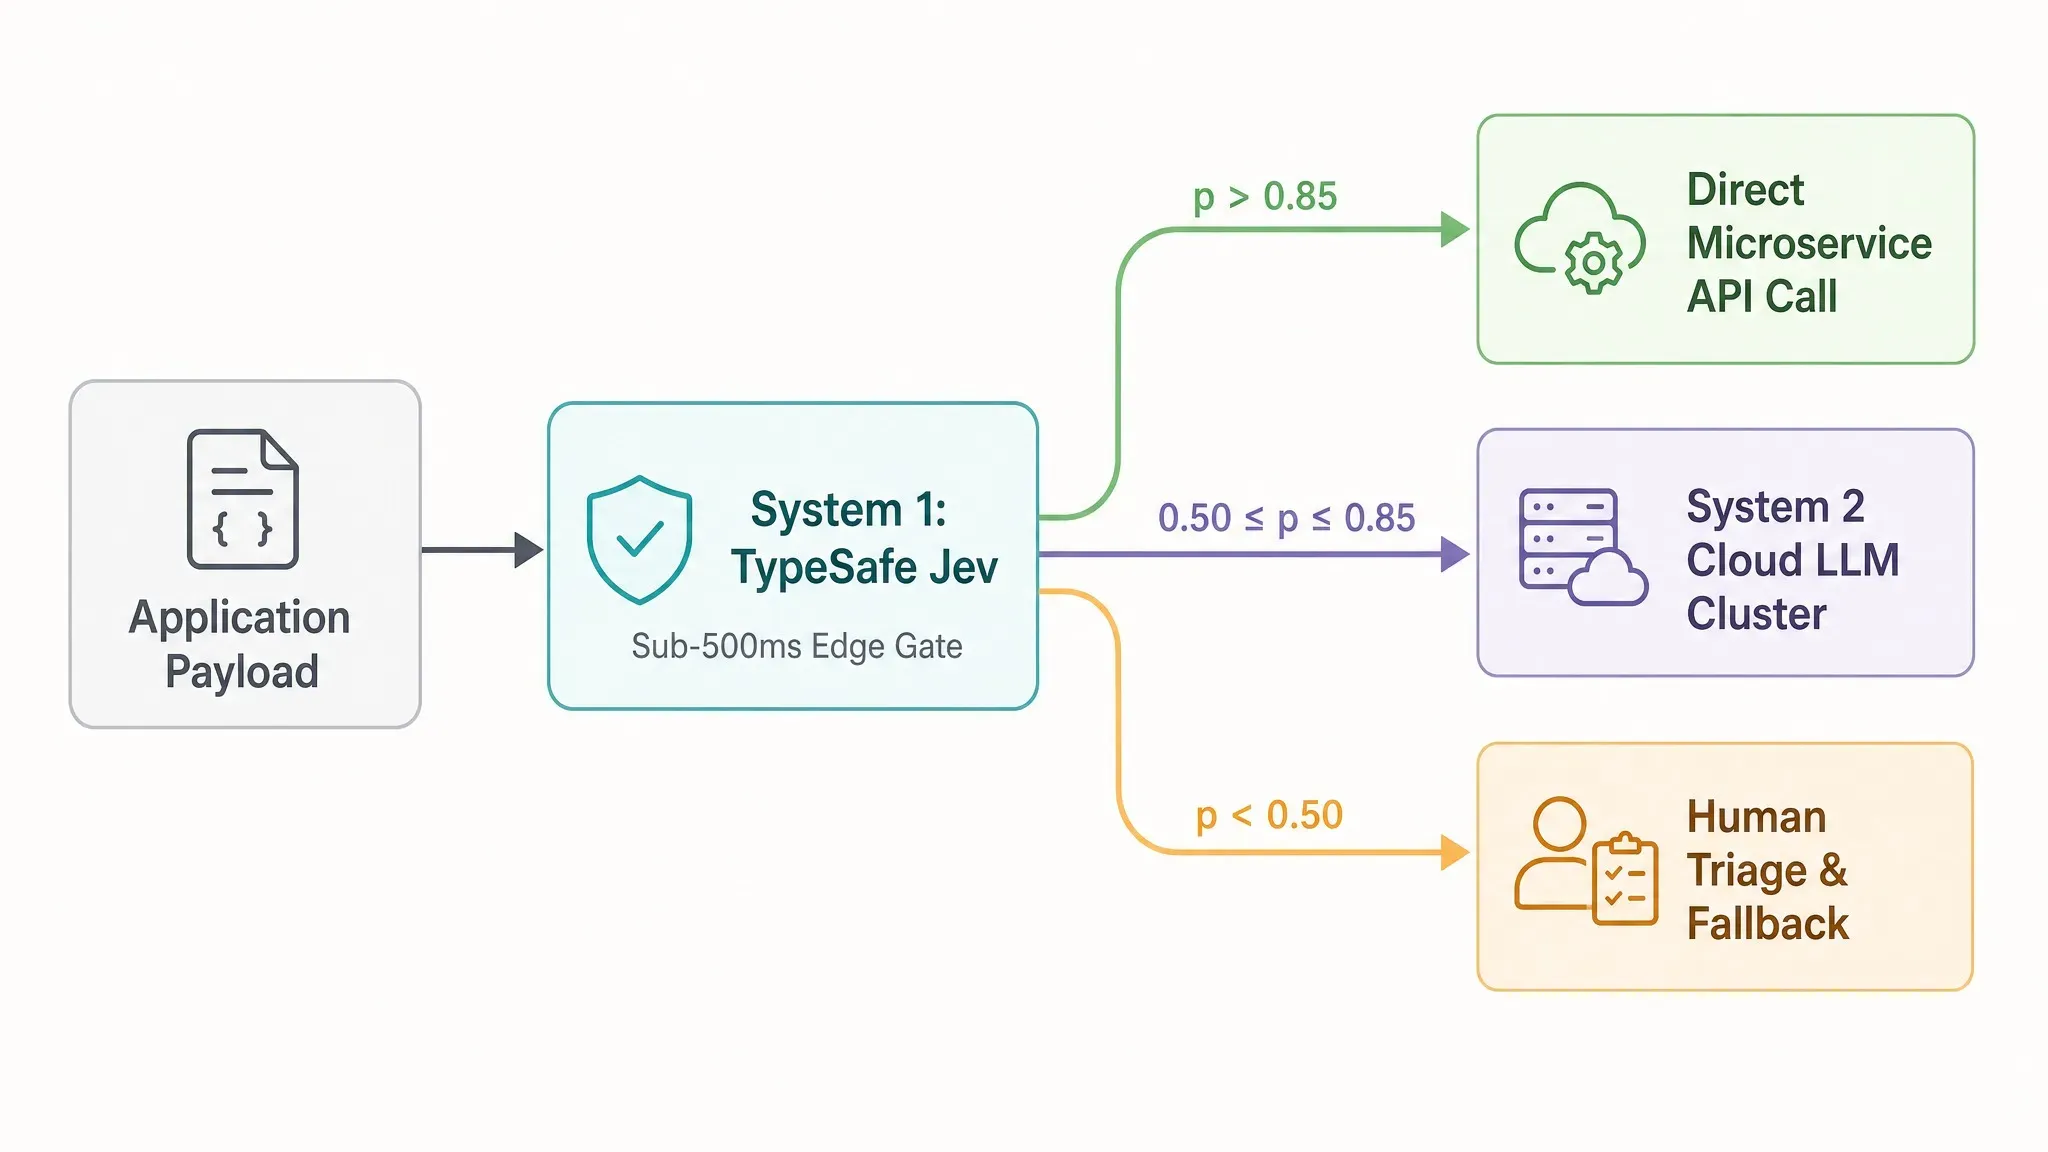
Os engenheiros podem usar essas distribuições de probabilidade calibradas para configurar gates de decisão baseados em limites (thresholds). Em um cenário típico de produção:
p > 0.85** (Execução de Caminho Rápido):** Executar imediatamente no caminho de alta velocidade, ignorando completamente os endpoints de LLM lentos.0.540 ≤ p ≤ 0.85** (Escalação do Sistema 2):** Enviar saídas limítrofes para um LLM de raciocínio longo escalado para lidar com casos de borda ambíguos.p < 0.50** (Triagem de Fallback):** Acionar padrões de segurança ou enviar a solicitação para uma fila de revisão humana.
Para casos de borda limítrofes, o roteamento com gate de confiança direciona o payload para uma camada de raciocínio empresarial. Utilizar o GPT 5 Tarra no Atlas Cloud ofere um alvo de fallback ideal para essas tarefas escaladas, aproveitando sua janela de contexto pesada de 1.050K e pricing de tokens econômico (grandes $2/$12), para executar análise profunda sem inflar os custos de infraestrutura de microservices.
Os logprobs raw de LLMs autorregressivos são notoriamente não calibrados e mudam sempre que os system prompts mudam. Ao integrar o RLCD diretamente no processo central de treinamento, o Jev torna o roteamento com gate de confiança pronto para produção, permitindo que equipes de software automatizem pipelines de alto volume enquanto isolam os casos de borda.
Padrões de Design para Produção: Pipelines de IA de Alta Velocidade na Prática
Agentes de produção frequentemente quebram quando um LLM inventa uma assinatura de função que não existe, como get_user_billing_v2() ou passa parâmetros de tipo inválidos para um endpoint de API interna. Encadear múltiplas verificações condicionais em endpoints padrão de chat aumenta a latência total, causando timeout em microservices voltados ao cliente.
Padrões Arquiteturais Principais para Microserviços de Alto Volume
Integrar motores de decisão em sub-segundos em pipelines de IA de produção permite que pilhas de software substituam loops de prompt imprevisíveis por padrões de design de backend determinísticos:
- Seleção de Ferramentas no Agente: Âncoras ativas escolhem ferramentas dentro de fluxos de agentes automatizados com base no estado da ação atual do agente. O Jev traduz as escolhas em opções explícitas de schema para poder retornar o nome da função selecionada em vez apenas de um de texto, garantindo payloads de saída válidos o tempo todo, eliminando falhas silenciosas em tempo de execução e o atrito consistente do parsing de JSON. Este pré-filtro rápido garante payloads de schema válidos antes de passar instruções para pipelines de alta autonomia pipelines de Agente de Codificação LLM.
- Avaliação Paralela de Multi-Pergunta: Endpoints de chat padrão forçam aplicativos aplicativos a avaliar pergquantos condicçõesaz sequentialmente, multiplicando a latência total pelo número de verificações realizadas. Jev permite uma avaliação de segurança particularmente paralela: ele pode realizar uma variedade de eventos de schema em um único estado público de contexto de uma única passagem. Isso significa que executar 15 verificações de classificação leva a mesma Janela de 100ms que executar apenas uma.
- Automação de Triagem de Tickets: Para microserviços de alto volume processando tickets de clientes, Jev analisa o contexto do cliente, roteia prioridade técnica e verifica elegibilidade de reembolso de forma simultânea. Com tempos de resposta sub-segundos, isso é triagem automática sem gargalos preventivos mesmo durante picos de tráfego.
Implementando Nós de Decisão System One via SDK
Os desenvolvedores desenvolvem nós de decisão de baixa latência para integrá-lo oficial ao typesafe-sdk aos microserviços existentes. O payload de execução envia o estado do aplicativo junto com as primitivas de schema pré-decladas diretamente para o endpoint https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Entrada do cliente: 'Fui cobrado duas vezes $49 na fatura #1092 e preciso de reembolso imediatamente.'", 7 questions: [ 8 { id: "routing_category", type: "choice", options: ["billing_dispute", "account_access", "feature_request"] }, 9 { id: "is_urgent", type: "noul" } 10 ] 11});
Configurações tradicionais de chamada de ferramenta re-tokenizam todo o contexto completo do prompt para cada avaliação de função (function call). Ao desacoplar a representação de estado das perguntas de decisão, Jev pode executar pipelines de classificação multi-ramificação sem multiplicação-o uso de tokens de contexto, inflar fatusseiras de API ou sacrificando garantias de latência P95.
Limitações e Trade-offs Arquiteturais do TypeSafe Jev (O que o Jev Não Pode Fazer)
A ideia arquitetural de que modelos de decisão não autorregressivos substituem completamente LLMs de propósito geral não é válida para toda produção: colocar um modelo de decisão unilateral em produção para escrever um e-mail educado, resumir itens de fatura ou gerar conteúdo textual vai inevitavelmente quebrar. A saída do modelo é um rótulo, um score ou um noul. Implementações que tentam substituir completamente LLMs de propósito geral por System One rapidamente encontram limites práticos dentro da arquitetura.
Análise de Limites Estruturais
Entender os modos de falha específicos do Jev é essencial antes de conectar o Jev aos fluxos de microserviços. O design de passagem única do Jev impõe limites rígidos em algumas tarefas centrais:
- Geração de texto: O Jev produz zero texto generativo. Ele não pode escrever ensaios, resumir documentos ou explicar em linguagem natural as razões de suas escolhas.
- Limites de raciocínio multi-hop: A arquitetura é construída para rapidez de avaliação, não para raciocínio abstrato complexo ou lógica de suposições em várias etapas. Cadeias de raciocínio válido devem ser delegação para LLMs tradicionais.
- Limitações matemáticas: não faz aritmética e não pode contar itens de forma confiável dentro de uma string de contexto. Operações financeiras e manipulação de dados devem permanecer no código backend para garantir confiabilidade.
- Interpretação literal de critérios: o modelo segue regras de prompt literalmente, sem inferir lógica de negócio implícita. Opções de schema ambíguas geram spread de probabilidade não previstos- use descrições precisas e específicas, conforme já prioridade.
- Contexto Rota (Degradação) sob payloads pesados: Ao passar registros complexos e não estruturados de contexto grande, o "rot" (deterioração) pode degradar a precisãão da avaliação. Filtrar ruído de estado de input antes de enviar a requisição continua essencial.
Mapa Arquitetural: Capacidades do Sistema 1 vs. Sistema 2
| Tarefa Operacional | TypeSafe Jev System One | Autoregressive LLM System Two |
| Classificação Categórica | Nativo (sub-500ms) | Lento (Texto sequencial) |
| Síntese e Redação de Texto | Impossível (sem loop de decodificação) | Nativo (geração aberta) |
| Cálculo Matemático | Não suportado (limitações de aritmética) | Variável (Requer execução de código) |
| Resistência a Ruído | Propensa a contexto de contexto em grandes estados | Janela de contexto resiliente maior |
Tratar Jev como um nó de decisão sub-segundo, não como um motor o raciocínio universal, é crítico para um design de sistema sólido na produção.
Future Cloud Infrastructure: Orchestrating Fast Decision Nodes
Roteamento de cada requisição de usuário diretamente em um modelo de raciocínio de raciocínio 70 bilhões de paramento queima milhares de dólares em ciclos de GPU inúteis enquanto força usuários para esperar vários segundos por simples verificações de segurança e roteamento de payload. Stacks de microserviços modernos não podem se dar ao luxo de tratar de payload de HTTP como um problema de razão aberta, o tempo todo.
A Mudança para Arquitetura Híbrida de IA
Os ambientes de nuvem estão se afastandosse dos endpoints de LLM monolíticos em direção a uma arquitetura de IA híbrida desacoplada. Neste novo paradigma, os orquestadores de nuvem posicionam no de decisão de borda rápida para avaliar instantanamente os primeiros payloads de entrada.
- Edge, guardrails e roteamento: mais nós de decisão avaliam intenção do usuário, saneía-se entradas e verificam a conformidade com o schema em uma única passada.
- Análise de Estado e Orquestração: Os orquestadores de nuvem analisam o escore de confiança, executando imediatamente pedidos de alta certeza e encaminhando tarefas complexas de razão.
- Raciocínio System 2 centralizado: os clusters LLM pesados recebam payloads pré-filtrados e estruturados somente quando síntese multi-voltas ou geração em aberto é estritamente necessária.
Implementando Modelos System One em Escala
Desde que as plataformas de nuvem expandem suas capacidades de hospedagem, integrar um deployment TypeSafe Jev à infraestrutura de IA fornece um padrão eficiente para microserviços de borda. Executar modelos de decisão não autorregressivos próximos aos usuários finais reduz tempos de ida e volta dramatically e corta custos de computação para aplicações de alto consumo.
Pipelines monocromados de camadas de decisão dedicadas garantem que as redes de backend permaneçam responsivas sob cargas pesadas, enquanto mantêm os modelos de raciocínio da fronteira focados exclusivamente em tarefas que exigem profunda computação.


