Última atualização: Wan 3.0 está no ar desde 24 de agosto de 2026.
Você montou uma pasta para um anúncio de 15 segundos. Duas imagens de personagens parados. Um vídeo de tom de marca que o cliente enviou. Um guia de marca que existe apenas como PDF. Uma amostra de voz do ator que você realmente quer.
Então você abriu seu modelo de vídeo e ele pediu uma imagem.
Então você fez o que todo mundo faz. Traduziu a pasta em um prompt de 800 palavras e rezou. O rosto se desviou no terceiro plano. A jaqueta mudou de cor. A voz era de outra pessoa completamente.
A omni-referência do Wan 3.0 é a primeira vez que um modelo de vídeo diz: ok, me entregue a pasta. Até 20 ativos em uma única chamada, em cinco tipos de entrada, mantidos juntos em uma única tomada contínua de 30 segundos.
Este artigo faz três coisas e pula o resto. Ele detalha o que esses 20 ativos realmente são, usa os próprios clipes gerados da Alibaba como evidência e oferece um fluxo de trabalho equivalente que você pode executar hoje, porque o Wan 3.0 ainda está em beta público na nuvem da própria Alibaba e ainda não pode ser chamado por plataformas de terceiros.
Principais conclusões
- A referência multimodal do Wan 3.0 aceita até 20 ativos em uma única chamada, abrangendo imagens, vídeos, áudio, documentos e páginas da web ao vivo, e os mantém consistentes em uma única tomada de 30 segundos.
- É o primeiro modelo de vídeo mainstream a tratar um PDF, uma apresentação de slides ou uma URL como uma entrada criativa, em vez de algo que você parafraseia em um prompt.
- Wan 3.0 entrou em beta público em 6 de agosto de 2026 no Alibaba Cloud Model Studio e Qwen Cloud como
wan3.0-video. É de pesos fechados. Quem disser que já está sob Apache 2.0 está chutando. - O título de 20 ativos não é onde ele realmente se destaca. Modelos de referência-para-vídeo que você pode chamar agora já aceitam mais de 20 ativos. A diferença são documentos e páginas da web, não a quantidade.
- Você pode testar o formato de dois personagens, referência fixa e totalmente narrado de graça com o gerador gratuito de esquetes de anúncios de IA da Atlas Cloud: quatro fotos de produto entram, um esquete falado de 15 segundos sai, sem cartão.
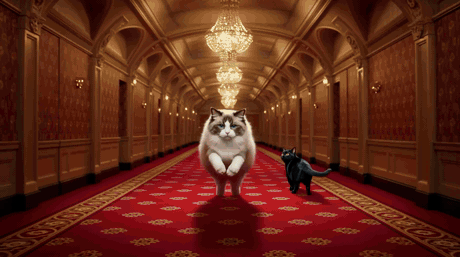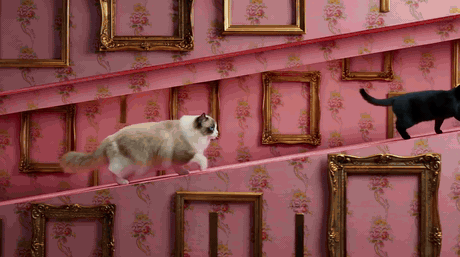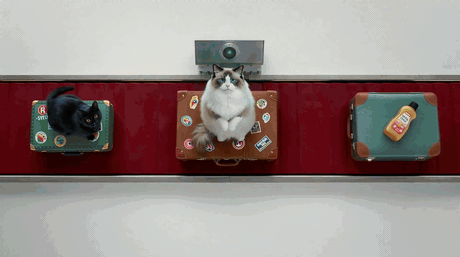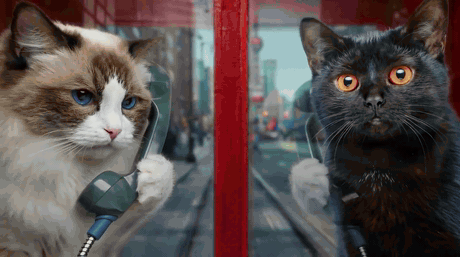
Dois gatos perseguidos por cinco cenários diferentes pelo Wan 3.0 sem deriva de personagem_Duas imagens de referência. Cinco cenários completamente diferentes, de um corredor de hotel a um tambor de máquina de lavar e uma cabine telefônica vermelha. Nem um quadro de deriva. Fonte: Manual oficial do criador Wan 3.0 da Alibaba_ Wan 3.0 creator handbook , agosto de 2026, que também é de onde vêm todos os outros clipes do Wan 3.0 neste artigo.
Por que o Vídeo de Múltiplas Referências Falha, e o que a Referência Multimodal do Wan 3.0 Muda
Modelos de vídeo não têm memória entre clipes. Cada geração começa do zero. Esse é o problema inteiro em uma frase.
Então, no momento em que sua história precisa de mais de um plano, você está costurando. O primeiro plano te dá um rosto que você ama. O segundo plano te dá um primo desse rosto. O terceiro plano silenciosamente muda a jaqueta de ameixa para bordô, e quando você percebe já pagou por onze renderizações.
A referência de imagem única ajudou, mas só fixava uma coisa. Um rosto. Não conseguia segurar simultaneamente um rosto, uma roupa, um adereço, um local e uma voz, porque havia um slot e cinco trabalhos.
Existem duas saídas. Dar ao modelo mais slots, ou parar de fazê-lo começar de novo. O Wan 3.0 faz ambos ao mesmo tempo, e é por isso que os dois recursos principais são na verdade um único recurso. Uma tomada nativa de 30 segundos significa que não há corte para o personagem se desviar. Vinte ativos de referência significa que cada elemento que precisa permanecer fixo ganha seu próprio slot dedicado, em vez de lutar por um.
Aqui está como isso se parece quando nada é costurado. Trinta segundos, uma câmera contínua, uma criança em um carrinho de compras que acaba incorporada dentro de um outdoor e depois sai de debaixo dele.
30 segundos completos em uma passagem, sem cortes, com a trilha sonora gerada na mesma passagem. Fonte: Manual oficial do criador Wan 3.0 da Alibaba.
O que "20 Ativos" Realmente Significa Dentro da Referência Multimodal do Wan 3.0
Vinte é um número de manchete. O que importa é que os vinte não são todos do mesmo tipo. A omni-referência do Wan 3.0 cobre cinco tipos de entrada, e cada um controla um eixo diferente da saída.
Imagens controlam identidade. Um cartão de personagem, uma foto de produto, uma placa de localização. O Wan 3.0 chama isso de consistência em nível de pixel, e nos exemplos da própria Alibaba a trava se estende além do rosto para o guarda-roupa: o manto cinza em camadas, o gibão de couro com tiras, a faixa escura na cintura, tudo sobrevive a uma luta corpo a corpo de dezesseis segundos em três locais.
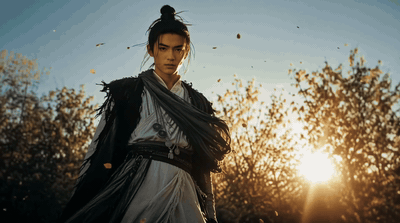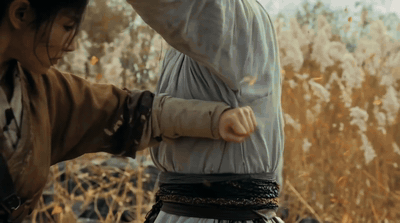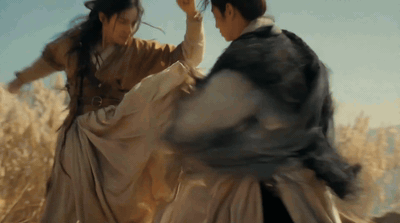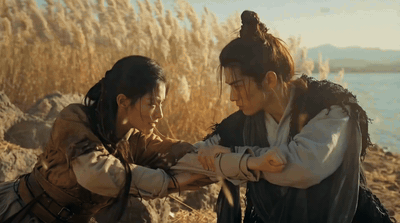
Dois cartões de personagem dirigindo uma cena de luta wuxia com detalhes de figurino mantidos quadro a quadro
Dois cartões de personagem mais uma placa de localização do banco de juncos. O guarda-roupa e o cenário se mantêm em cada arremesso. Mostrado aqui como um GIF silencioso; o arquivo entregue carrega uma mixagem estéreo de 44,1kHz. Fonte: Manual oficial do criador Wan 3.0 da Alibaba.
Áudio controla voz. Esta é a parte que torna "multimodal" mais que marketing. Você anexa uma amostra de voz por personagem, escreve as falas no prompt, e o diálogo volta naquele timbre, com sincronia labial, na mesma passagem que a imagem. Duas pessoas, duas referências de voz, uma academia.
Duas imagens de sujeito mais dois clipes de referência de voz separados, e o diálogo volta nessas duas vozes. Vale a pena ligar o som para este. Fonte: Manual oficial do criador Wan 3.0 da Alibaba.
Vídeo controla ritmo. Um vídeo de referência não está lá para ser copiado. Está lá para doar seu ritmo: quanto tempo uma batida se sustenta, como uma transição se move. Neste, cinco quadros-chave fornecem os sujeitos e um vídeo de referência fornece a cadência de virada de cartão horizontal entre eles.
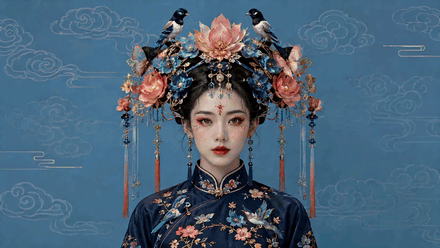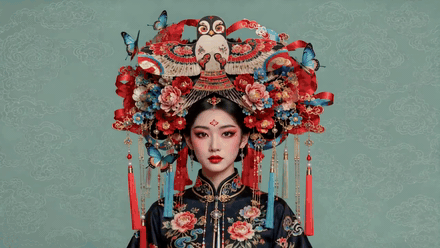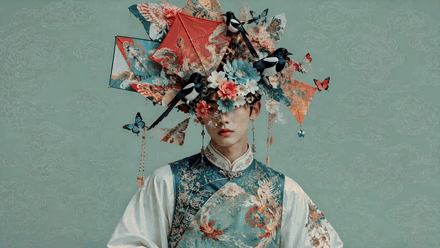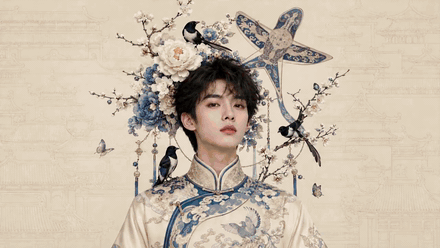
Cinco quadros-chave virados com o ritmo extraído de um vídeo de referência_Cinco_ imagens de quadro-chave para os sujeitos, um vídeo de referência para o ritmo de virada. Fonte: Manual oficial do criador Wan 3.0 da Alibaba.
Documentos e páginas da web controlam estrutura. Esta é a parte verdadeiramente nova. O Wan 3.0 aceita arquivos de documento e URLs ao vivo como entrada criativa, e relatórios sobre o beta listam .doc, .xls, .ppt, .pdf e .txt entre os formatos aceitos (AlphaSignal, agosto de 2026). A mesma lógica já funciona com uma imagem de storyboard: um storyboard entra, seis planos saem, na ordem do próprio storyboard.
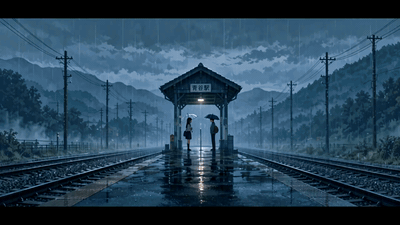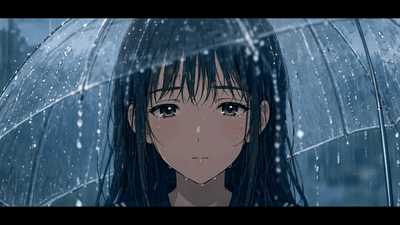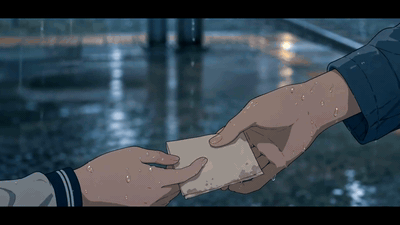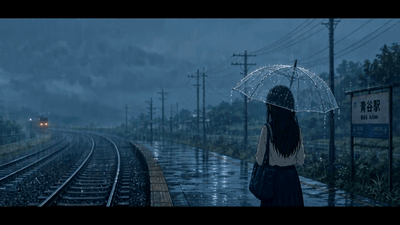
Uma única folha de storyboard expandida em seis planos sequenciais em uma plataforma de trem chuvosa
Uma folha de storyboard como referência, seis planos gerados em sua ordem, até o bilhete passando de mãos no quinto plano. Fonte: Manual oficial do criador Wan 3.0 da Alibaba.
Primeiro e último quadros controlam pontos finais. O truque mais antigo do livro, ainda suportado, ainda a maneira mais rápida de delimitar um plano.
Aqui está como isso se compara com a versão que a maioria das pessoas está realmente usando hoje.
| Wan 2.7 Referência-para-Vídeo | Wan 3.0 omni-referência | |
|---|---|---|
| Ativos de referência | uma imagem por sujeito, até 3 vídeos, 1 clipe de voz | até 20 ativos no total |
| Modalidades | imagem, vídeo, áudio | imagem, vídeo, áudio, documento, página web |
| Duração máxima, uma passagem | 10 s | 30 s nativos, mais duração inteligente |
| Áudio na mesma passagem | sim | sim |
| Edição e extensão de vídeo | não exposto | edição baseada em instrução e referência, mais extensão |
| Disponibilidade | ativo em APIs de terceiros | Alibaba Cloud Model Studio e Qwen Cloud beta |
Há uma regra que ninguém coloca na documentação e todo mundo aprende da maneira difícil: uma referência, um trabalho. Imagem1 fixa o rosto e a roupa. Vídeo1 doa apenas movimento. Áudio1 doa apenas timbre. No momento em que você atribui a um único ativo dois trabalhos conflitantes, ou carrega uma imagem de referência com duas pessoas, o modelo tem que adivinhar, e adivinhar é exatamente o que você estava tentando evitar. O manual da Alibaba é direto sobre isso também: um sujeito por imagem de referência.
O Fluxo de Trabalho de Referência Multimodal do Wan 3.0 que Você Pode Executar Hoje
Resposta direta primeiro. O Wan 3.0 está em beta público na nuvem da própria Alibaba, sob o ID do modelo wan3.0-video (Alibaba Wan, agosto de 2026). Ainda não chegou em plataformas de API de terceiros, incluindo a Atlas Cloud. Qualquer um vendendo acesso à API do Wan 3.0 agora está revendendo outra coisa.
O que chegou é a forma do fluxo de trabalho. Pacote de referência entra, uma chamada, clipe finalizado com som sai. Isso funciona hoje em modelos de referência-para-vídeo que você pode chamar em uma aba do navegador, e quando você os alinha, o título de 20 ativos parece diferente.
| Modelo | Ativos de referência | Modalidades | Duração máxima | Áudio nativo | Preço por segundo |
|---|---|---|---|---|---|
| Wan 3.0 (beta da Alibaba, não na Atlas) | 20 total | imagem, vídeo, áudio, documento, página web | 30 s | Sim | reportado $0,05 a $0,20 por resolução |
| Wan 2.7 Referência-para-Vídeo | 1 imagem por sujeito, 3 vídeos, 1 clipe de voz | imagem, vídeo, áudio | 10 s | Sim | $0,10 |
| Seedance 2.5 Referência-para-Vídeo | 50 (30 imagem / 10 vídeo / 10 áudio) | imagem, vídeo, áudio | 30 s | Sim | $0,13 |
| MiniMax H3 Referência-para-Vídeo | misto, sem limite declarado | imagem, vídeo, áudio | 15 s | Sim | $0,10 |
| Kling Video O3 Pro Referência-para-Vídeo | 7 imagens, ou 4 imagens + 1 vídeo | imagem, vídeo | 15 s | Sim | $0,10 |
| Vidu Q3-Mix Referência-para-Vídeo | 4 imagens | imagem | 16 s | Sim | $0,11 |
| Veo 3.1 Referência-para-Vídeo | 3 imagens | imagem | 8 s | Opcional | $0,20 |
Os preços são as taxas da Atlas Cloud em agosto de 2026. Os valores do Wan 3.0 são os reportados para o beta da Alibaba Cloud, não uma taxa da Atlas, e a Alibaba não publicou uma página de preços públicos para o modelo ainda, então trate essa linha como provisória.
Leia essa tabela duas vezes e a história real aparece. O título de 20 ativos não é onde o Wan 3.0 se destaca, porque o Seedance 2.5 já aceita 50 e iguala os 30 segundos. O que mais nada naquela lista aceita é um PDF.
Para o passo a passo abaixo, a demonstração roda no Wan 2.7 Referência-para-Vídeo, porque sua forma de entrada é a parente mais próxima da omni-referência: múltiplas imagens de sujeito, um vídeo de referência opcional e um clipe de voz, todos mapeados para os rótulos character1 e character2 dentro do prompt. Três modelos, uma aba do navegador, sem instalação local.
Para uma execução hospedada atual, abra Wan 3.0 na Atlas Cloud e teste um prompt como o abaixo antes de publicar o fluxo de trabalho.
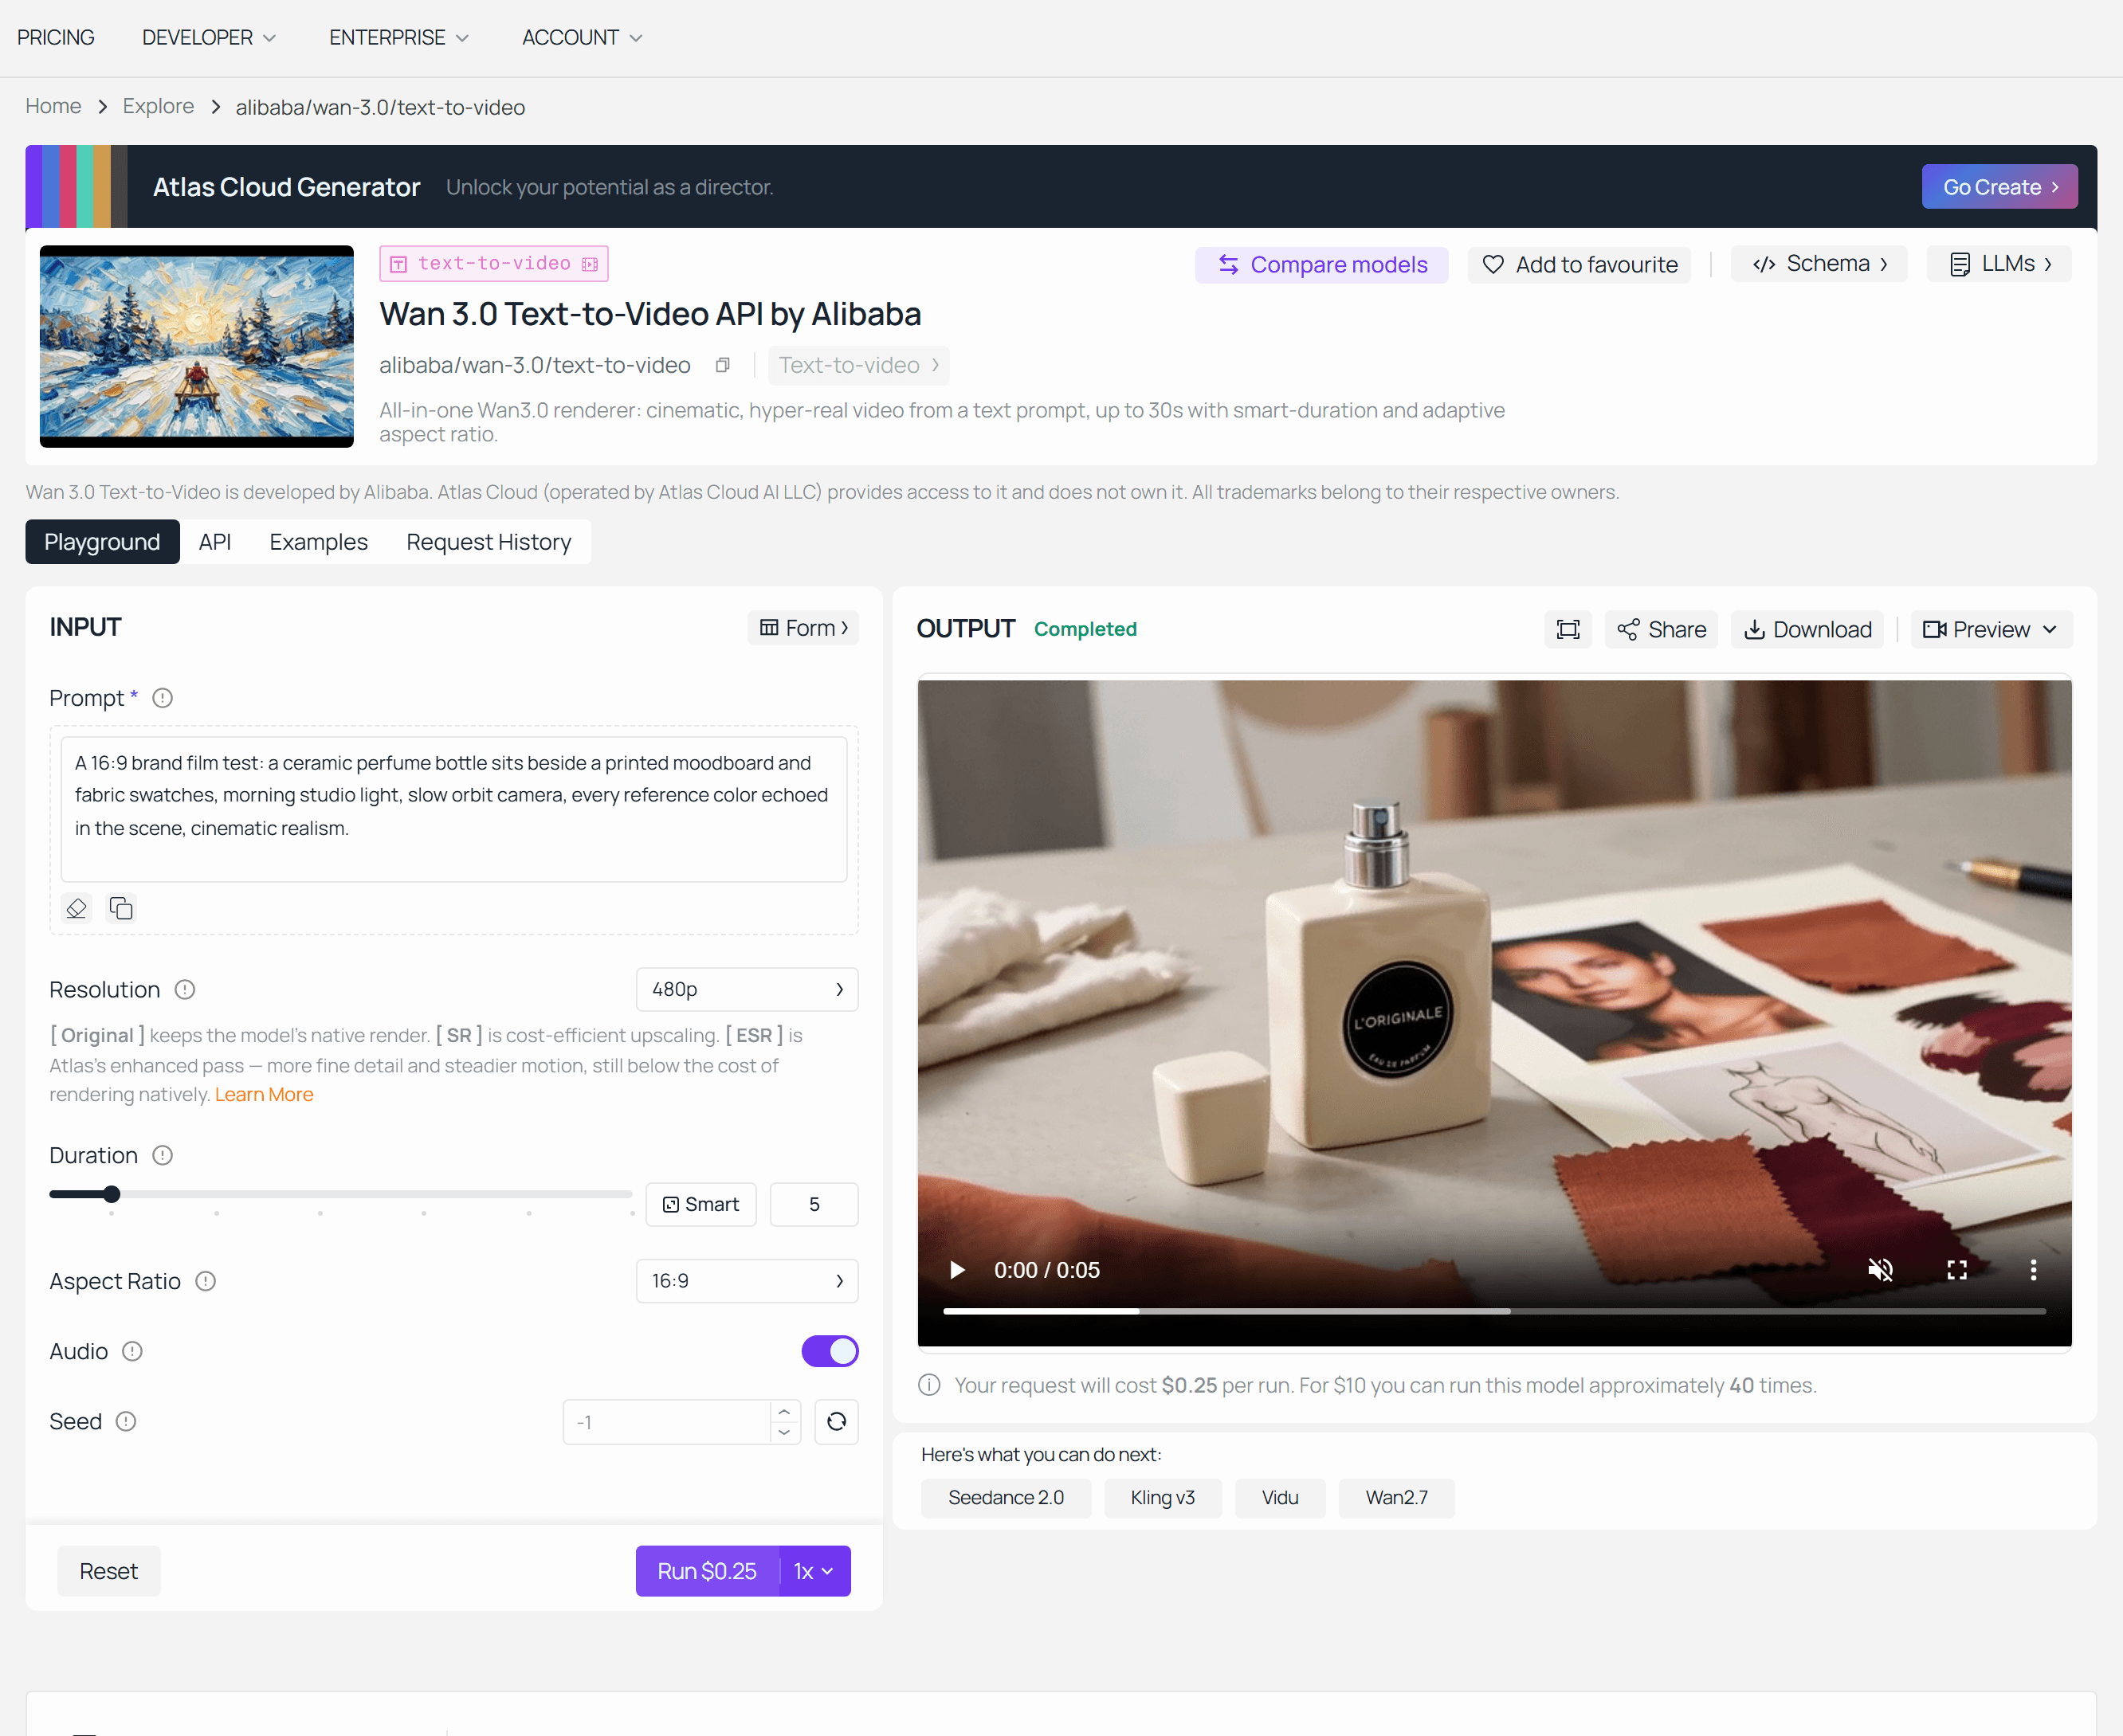
Captura de tela do prompt-para-resultado do Wan 3.0: entrega de marca com 20 referências.
Construa Você Mesmo: Uma Cena de Referência Multimodal em Quatro Passos
A cena: uma recepção de hotel em tons pastel. Um concierge inexpressivo. Um viajante segurando um gato ragdoll. O concierge olha diretamente para a lente e diz "O gato tem reserva. Você não."
Duas imagens mais um clipe de voz, o que são três ativos de referência em duas modalidades. Essa é a menor construção que é honestamente multimodal, em vez de apenas multi-imagem.
Passo 1. Gerar imagem de referência 1, o sujeito que você deve fixar
Imagens de referência têm três trabalhos e apenas três: um sujeito, de frente para a câmera, fundo limpo. Todo o resto é decoração. Use GPT Image 2 com qualidade high, tamanho 16:9, n=1.
Plain1Full-body studio portrait of a middle-aged hotel concierge with a deadpan expression, standing dead-centre against a flat dusty-pink wall. He wears a plum-purple double-breasted bellhop uniform with gold piping and brass buttons, a small round pillbox hat, and a thin moustache. Perfectly symmetrical framing, even soft frontal light, no cast shadow on the wall, 35mm film grain, muted pastel palette. One subject only, no other people, no text, no logo, no props in frame. 2
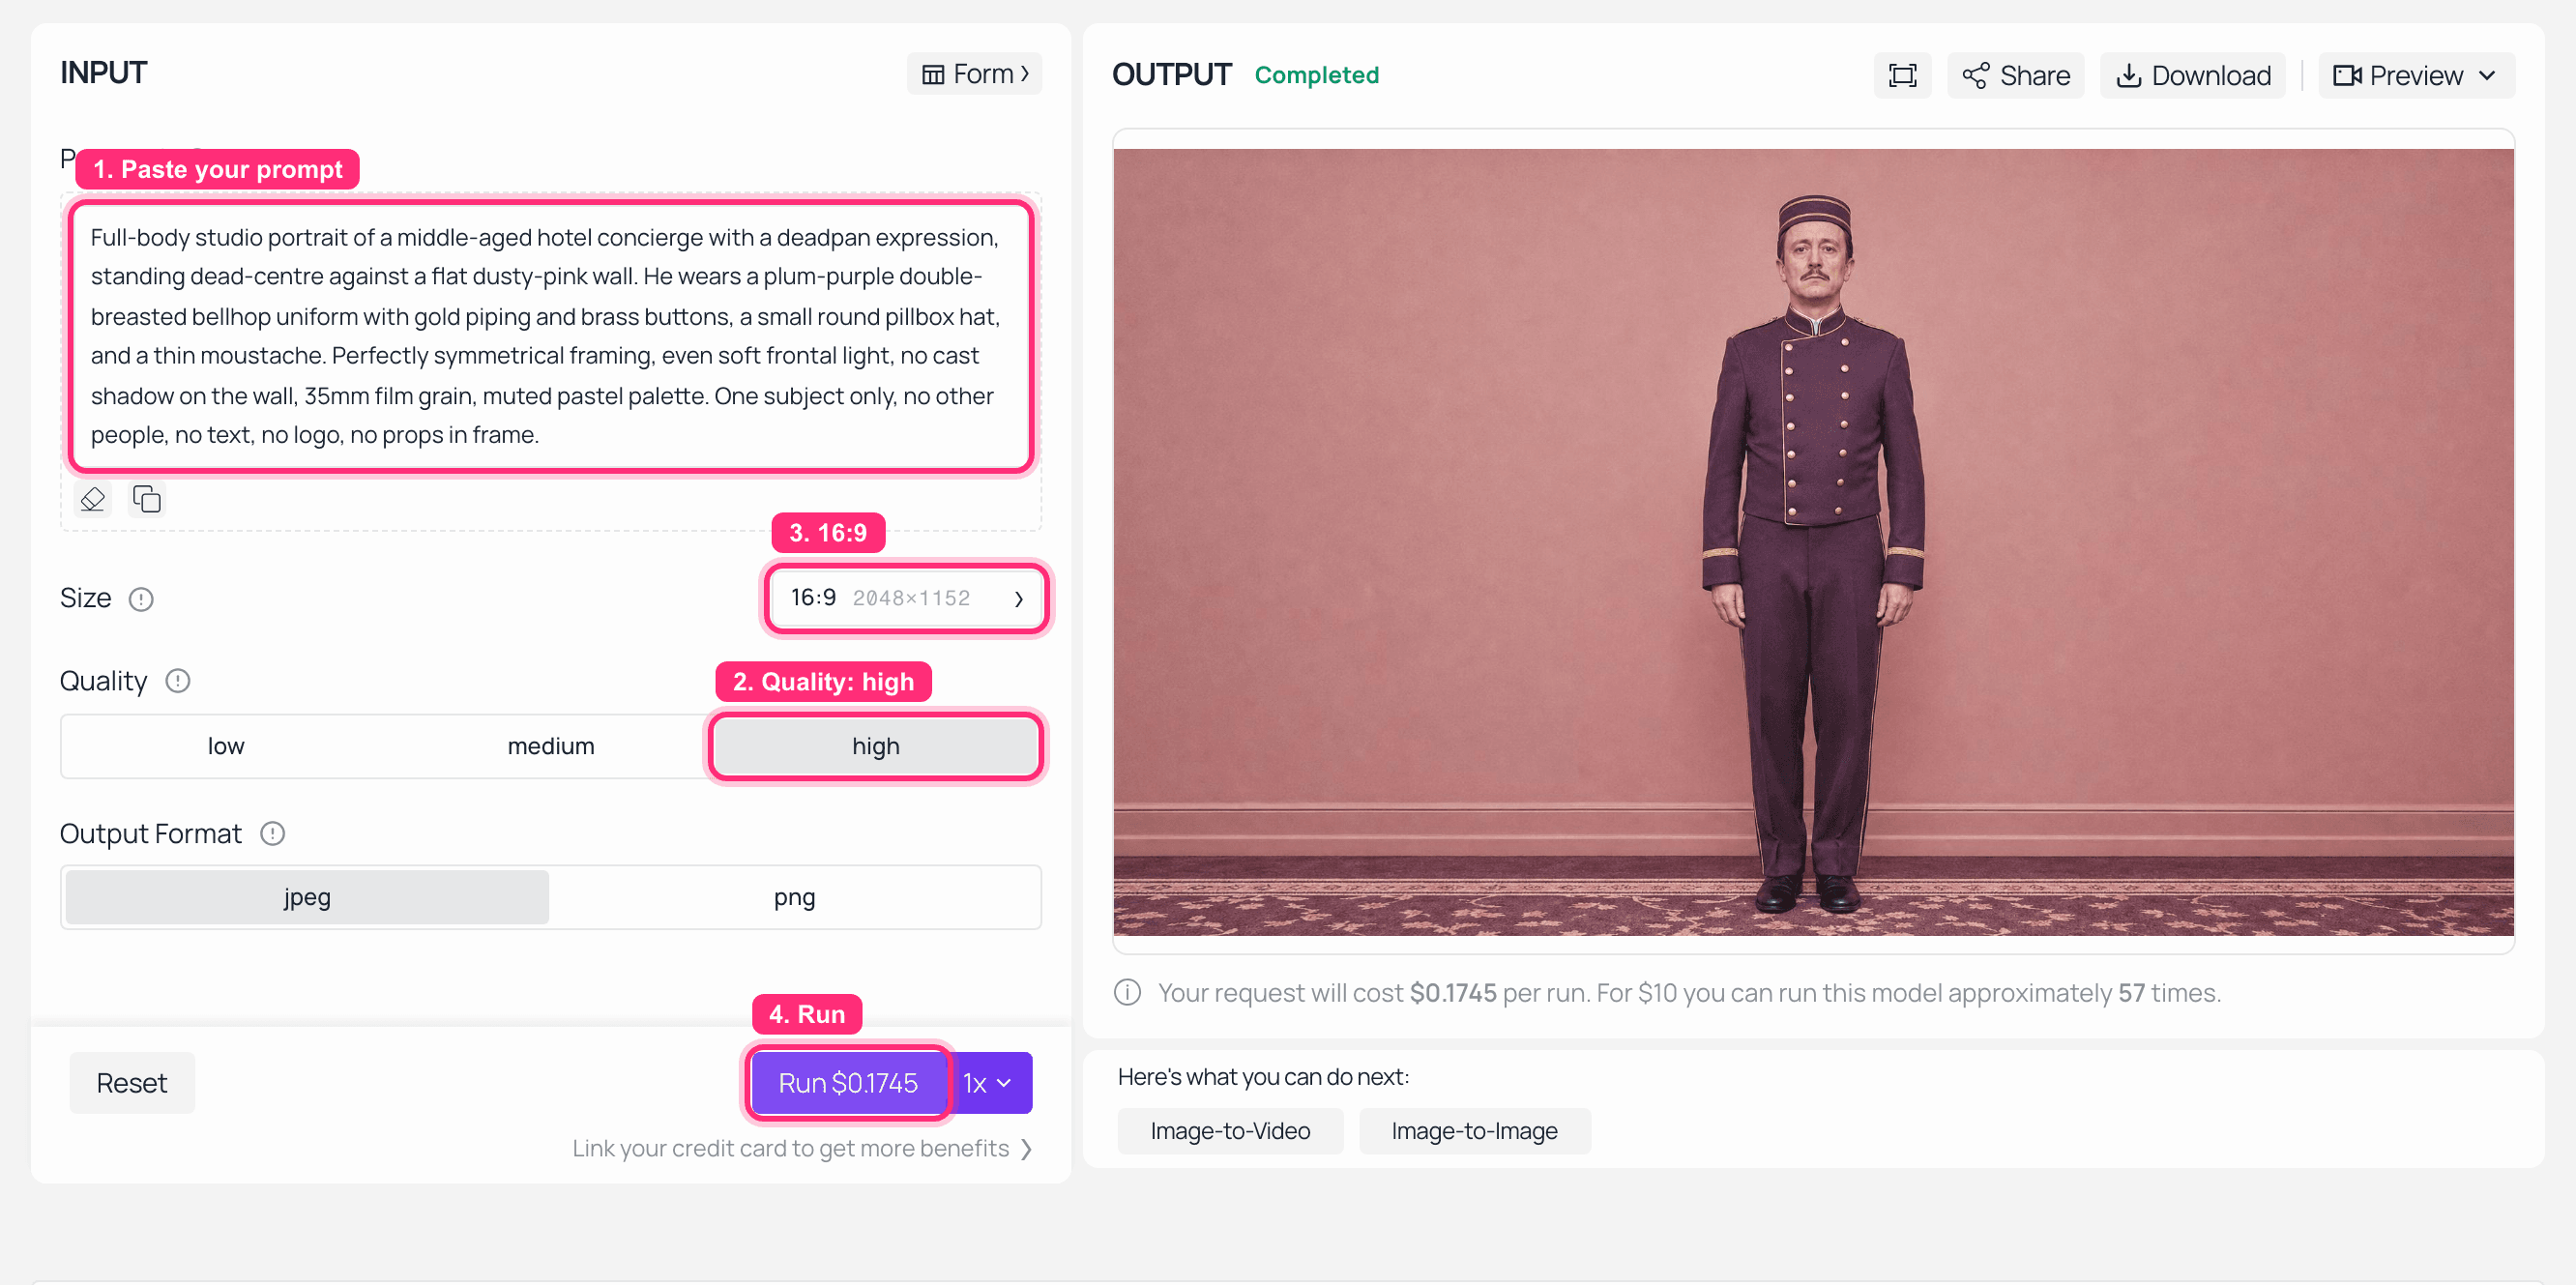
Playground do GPT Image 2 na Atlas Cloud com o retrato de referência do concierge renderizado no painel de saída
GPT Image 2 na Atlas Cloud: qualidade alta, 16:9, um sujeito, fundo plano. Este é o arquivo que se torna character1.
Passo 2. Gerar imagem de referência 2, o segundo sujeito fixado
Mesmo modelo, mesmas configurações. O contraste de cor entre os dois personagens é intencional, já que dá ao modelo uma maneira fácil de mantê-los separados quando compartilham um quadro.
Plain1Full-body studio portrait of a young woman traveller holding a fluffy ragdoll cat against her chest, standing dead-centre against a flat mustard-yellow wall. She wears a mustard wool coat, a red beret and round tortoiseshell glasses, and holds a small vintage leather suitcase in her free hand. Perfectly symmetrical framing, even soft frontal light, no cast shadow on the wall, 35mm film grain, muted pastel palette. One subject only, no other people, no text, no logo. 2
Passo 3. Gerar a referência de voz, que é a parte verdadeiramente multimodal
O clipe de voz é o que transforma isso de um trabalho multi-imagem em um multimodal. O slot de áudio do Wan 2.7 quer uma amostra curta, aproximadamente 1 a 10 segundos, então mantenha a linha curta. Use MiniMax Speech 2.6 HD e escolha uma voz masculina baixa, plana e imperturbável.
Plain1Good evening. Checking in? Of course. Everyone is. 2
Passo 4. Uma chamada, três referências, um clipe finalizado
Agora o pacote inteiro entra junto no Wan 2.7 Referência-para-Vídeo. Configurações: resolution: 1080P, ratio: 16:9, duration: 10, que é o teto deste modelo, prompt_extend: false, seed: -1. Carregue images em ordem, passo 1 primeiro, para que mapeie para character1, depois passo 2 como character2, e anexe o arquivo do passo 3 em audio.
Plain1Symmetrical, dead-centre wide shot of a pastel hotel lobby front desk, dusty-pink walls and a mustard-yellow key rack behind it. character1 is the concierge standing behind the desk; character2 is the traveller standing in front of it, still holding her ragdoll cat. The camera pushes in slowly along a perfect centre axis and never tilts. character1 looks straight down the lens and says flatly: "The cat has a reservation. You do not." character2 blinks once, turns her head slowly towards the cat, then back to the desk. The cat stares directly into the camera without moving. 35mm film grain, even soft lighting, muted pastel palette, no camera shake, no cuts. 2
Prompt negativo:
Plain1handheld shake, jump cuts, subtitles, on-screen text, watermark, extra people, deformed hands, face morphing, colour shift, motion blur 2
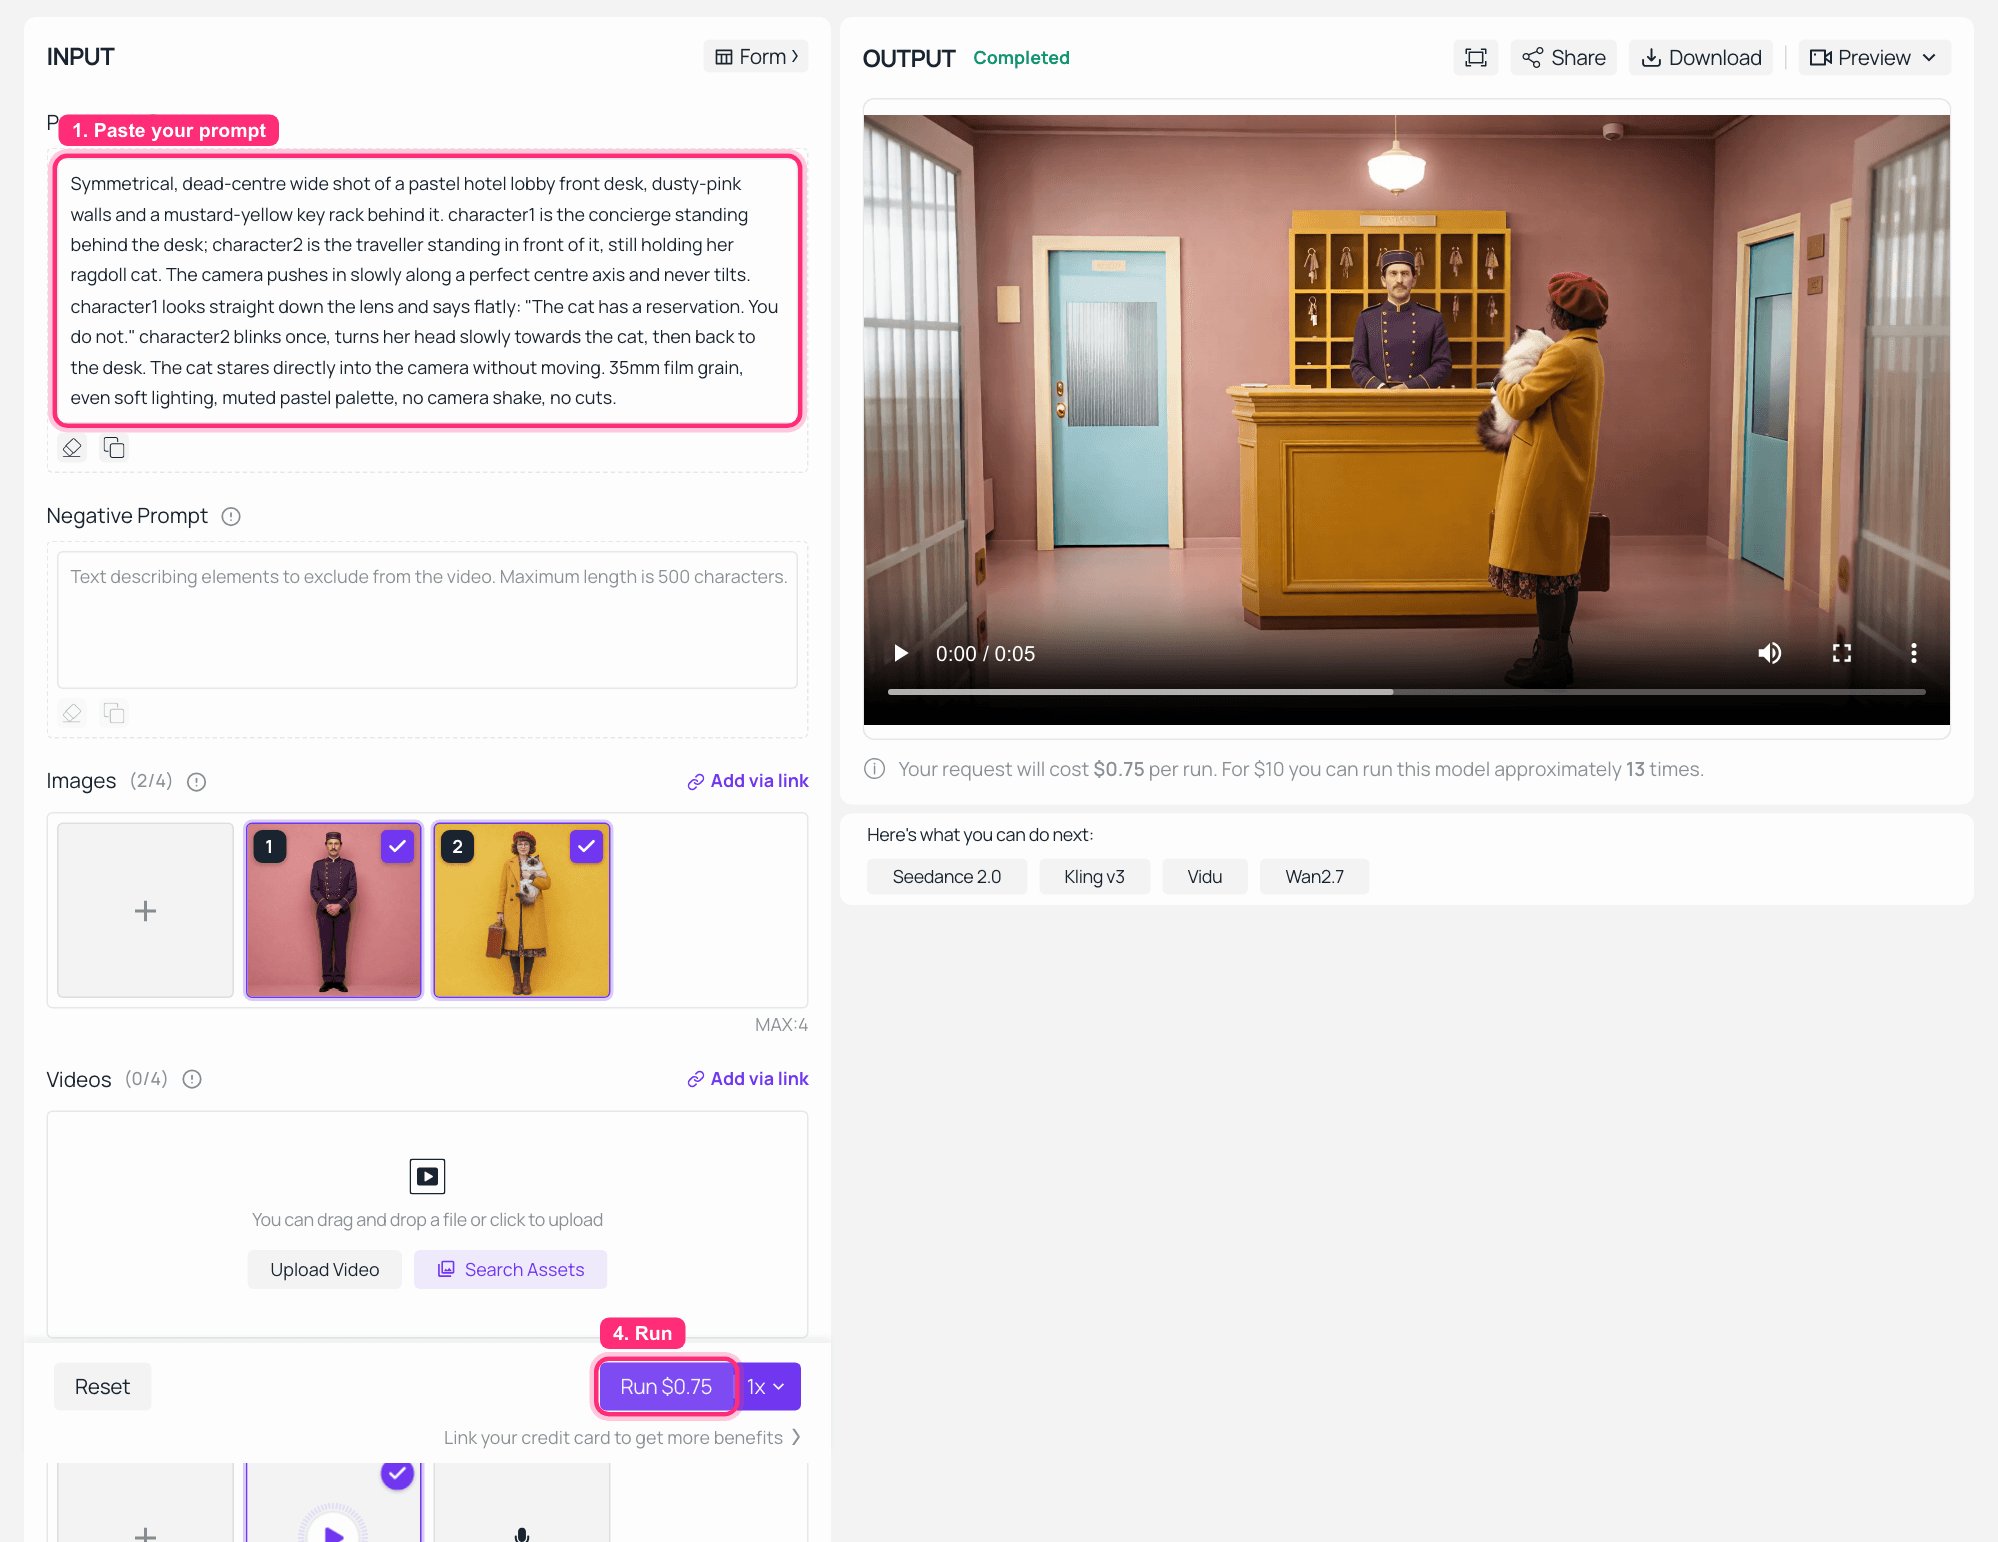
Playground do Wan 2.7 Referência-para-Vídeo na Atlas Cloud com duas imagens de referência e um arquivo de áudio carregados e o clipe finalizado no painel de saída
Wan 2.7 Referência-para-Vídeo na Atlas Cloud: duas imagens de referência e um clipe de voz anexados à esquerda, a tomada finalizada sendo reproduzida à direita em 1080P e 16:9. Esta captura rodou na duração padrão do modelo; defina para 10 para a versão completa abaixo.
O clipe finalizado. Ambos os rostos se mantiveram, ambas as roupas se mantiveram, e a fala foi entregue na voz clonada do passo 3, então este vale a pena reproduzir com som.
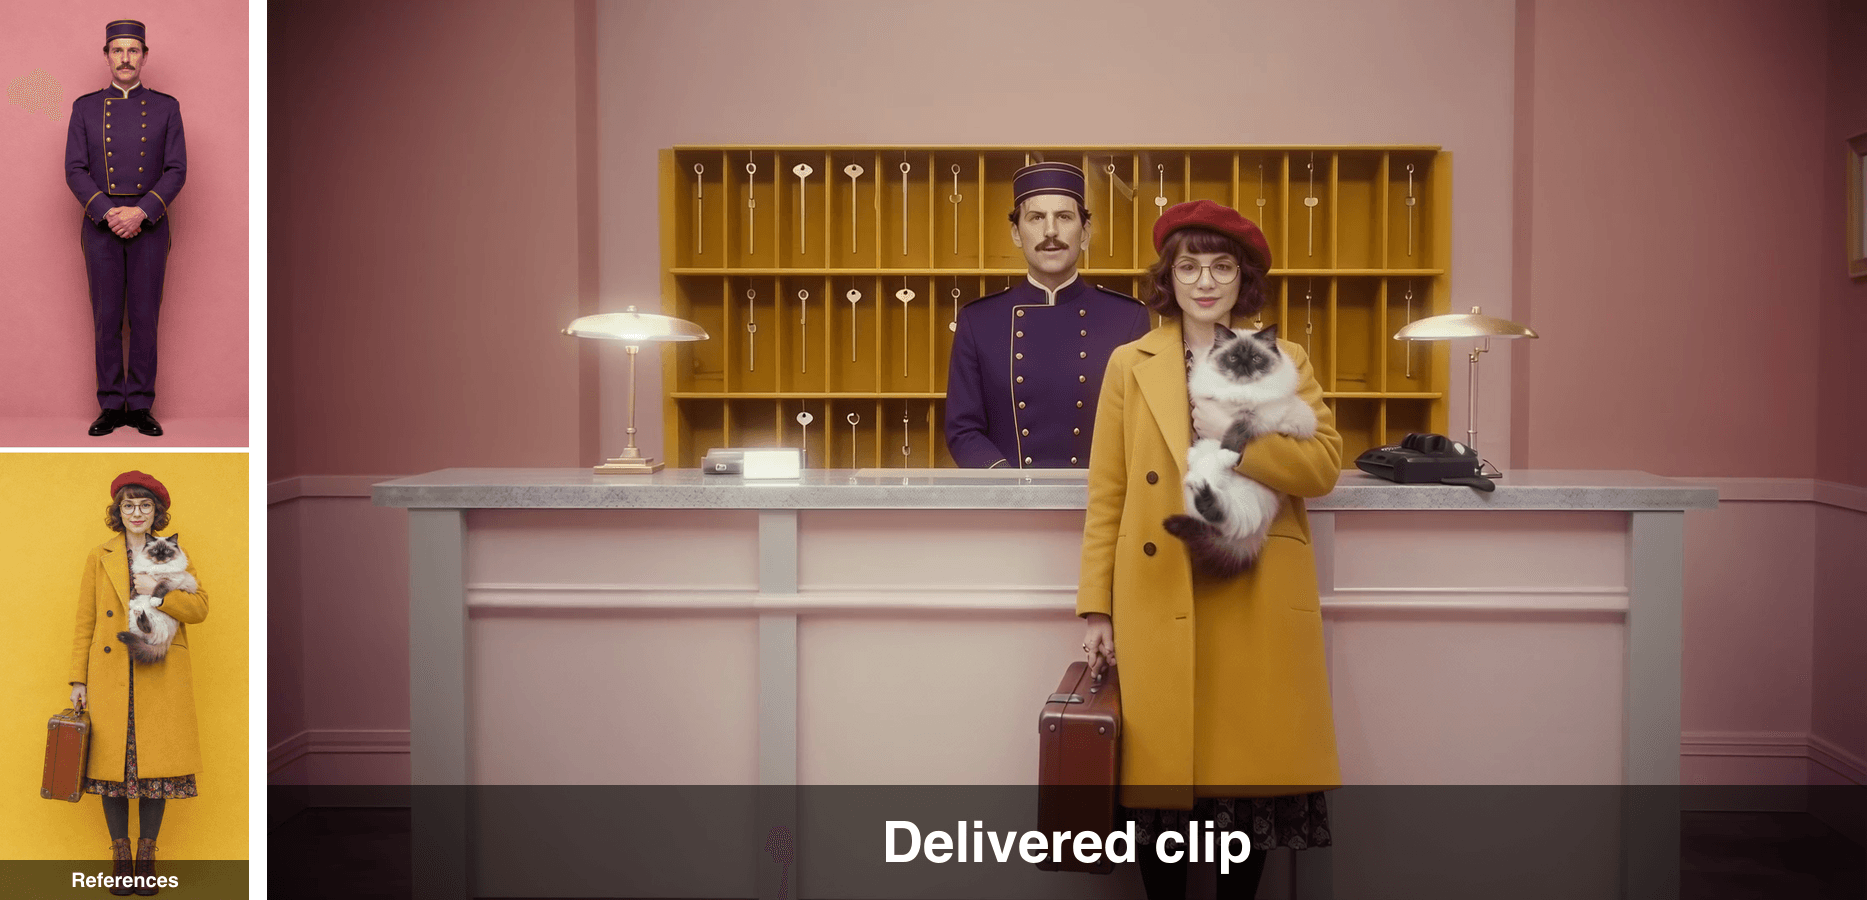
Os dois retratos de referência ao lado de um quadro do clipe finalizado, mostrando os mesmos rostos e roupas
Referências à esquerda, um quadro do clipe entregue à direita. Os detalhes do uniforme, a boina, os óculos e o gato sobrevivem à viagem.
Variações no Fluxo de Trabalho de Referência Multimodal do Wan 3.0
Leve para 30 segundos. O mesmo pacote de referência roda no Seedance 2.5 Referência-para-Vídeo com duration: 30, o que te dá a duração que o Wan 3.0 promete sem esperar pelo beta. Ele aceita até 30 imagens de referência, 10 vídeos e 10 clipes de áudio, então o pacote tem espaço para crescer. Escreva os 20 segundos extras como batidas no prompt, não como vibrações, ou o modelo vai preencher.
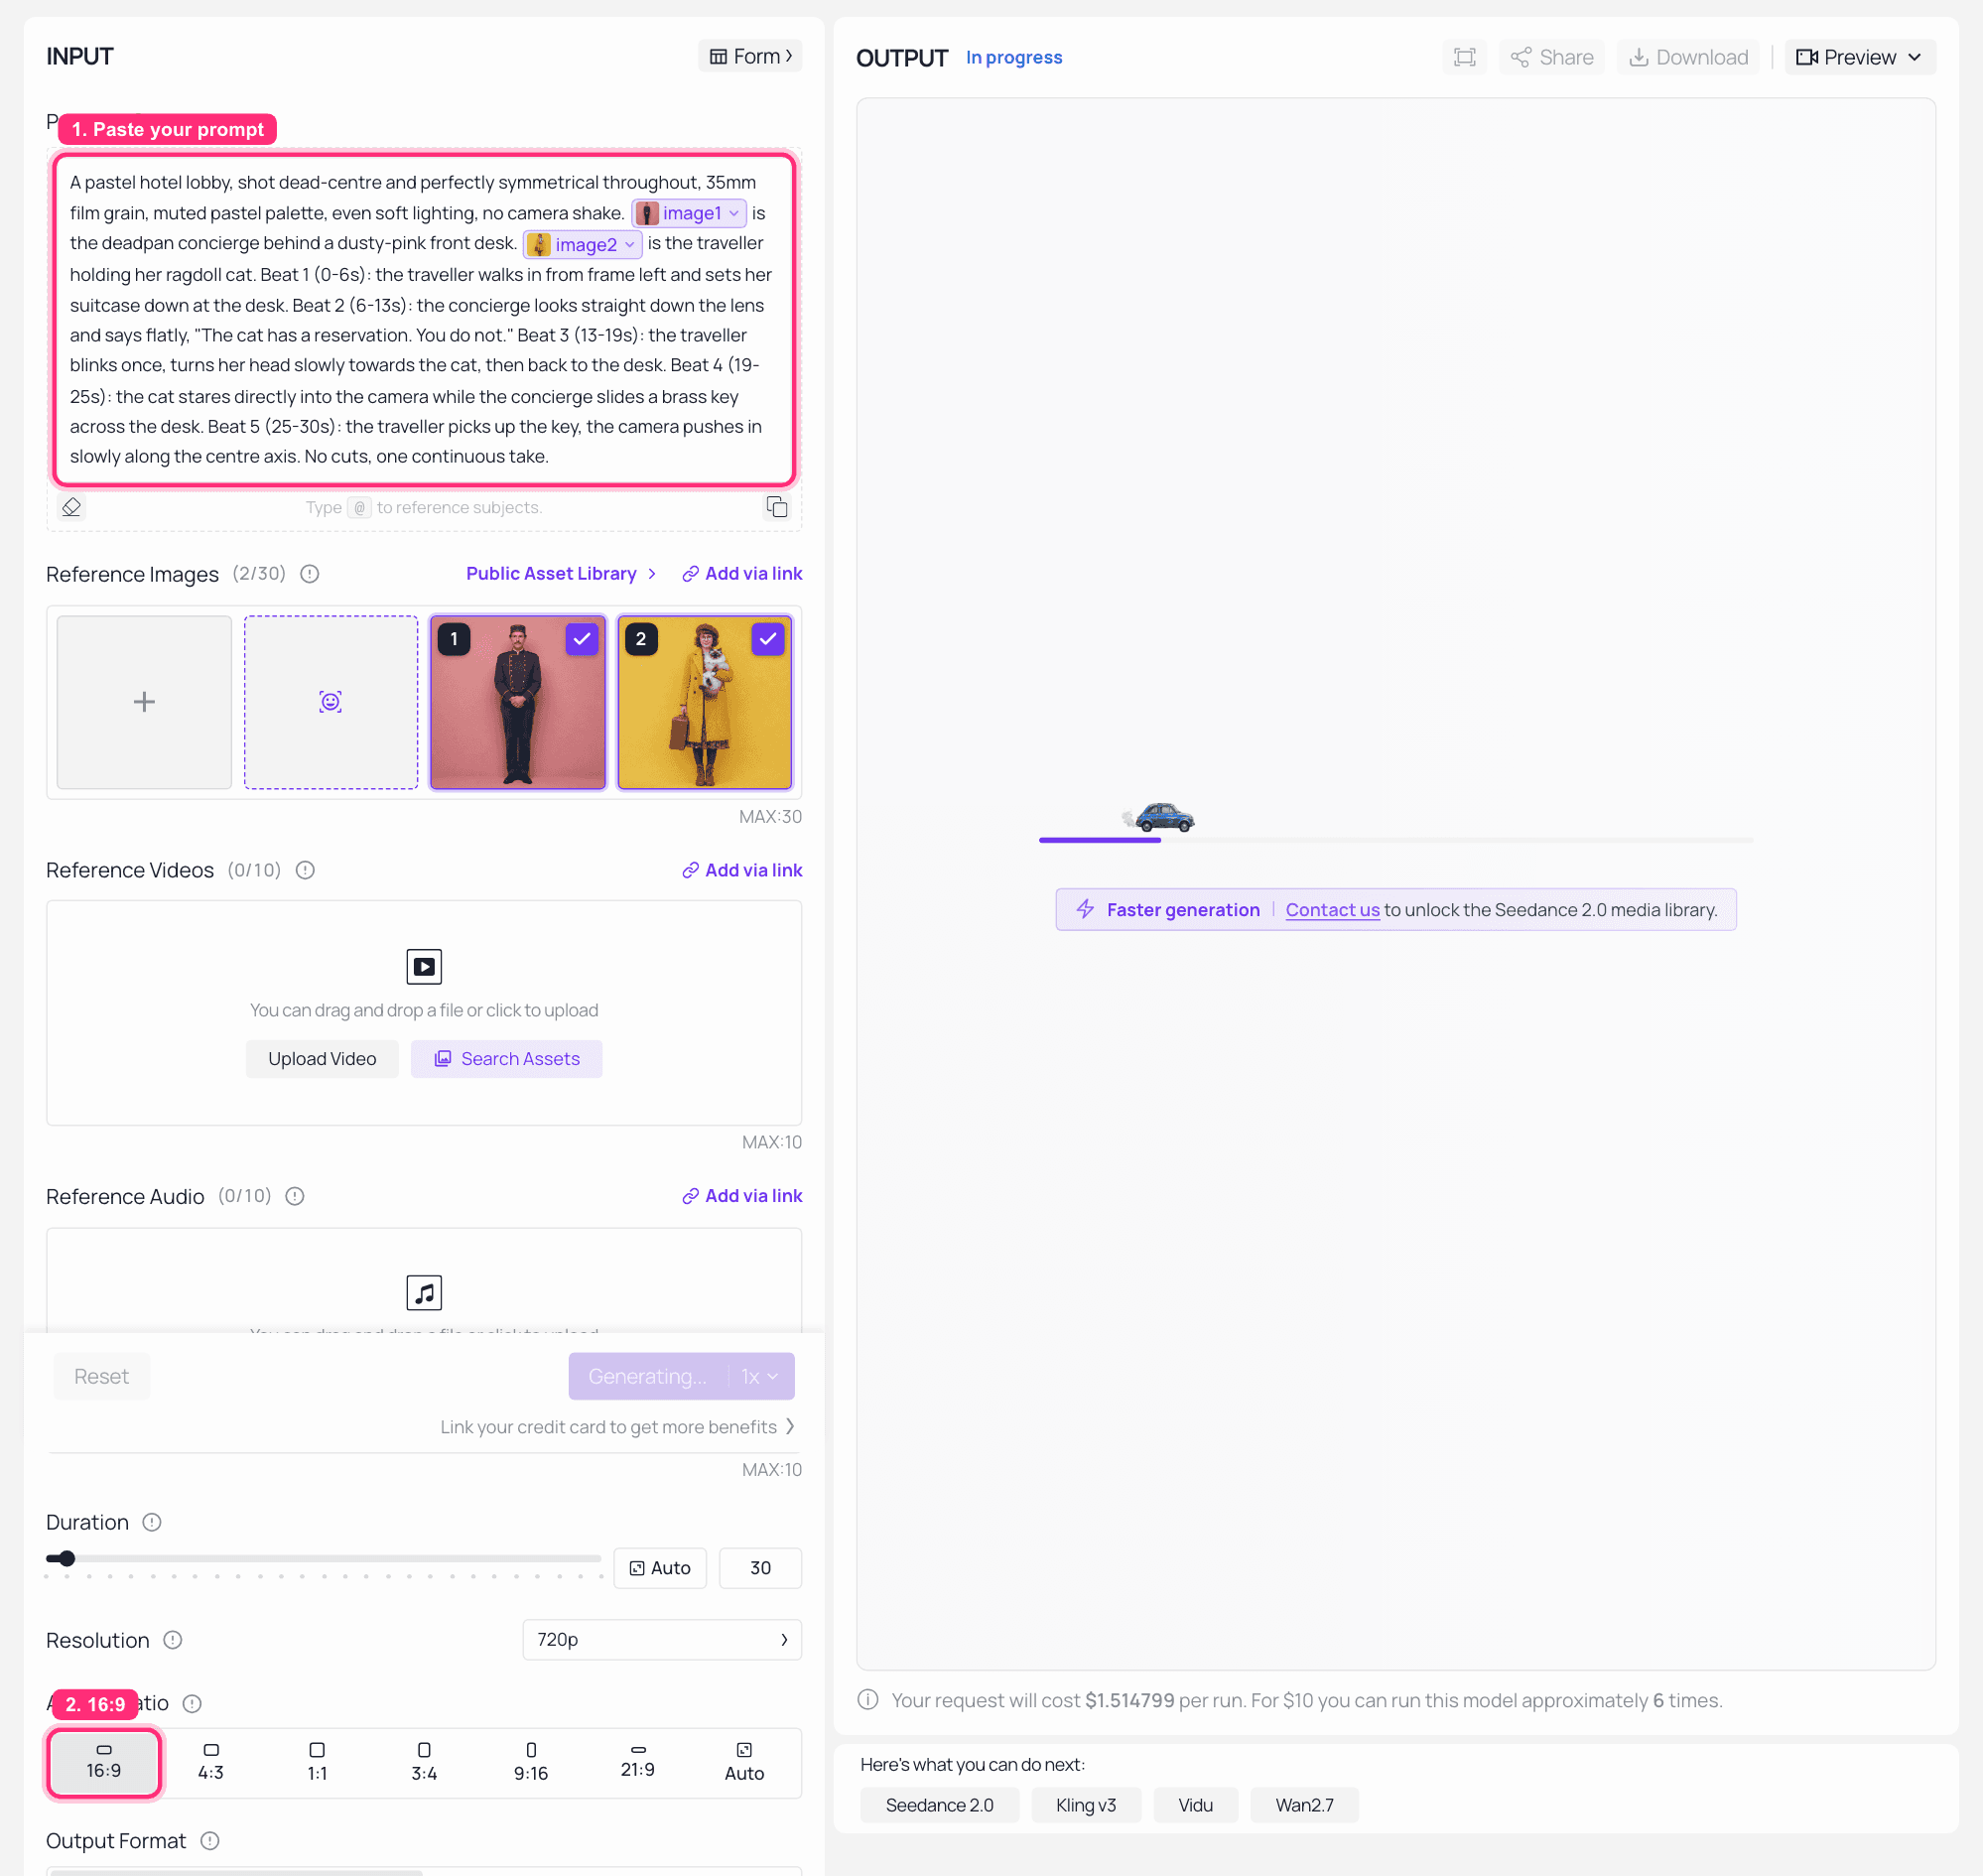
Playground do Seedance 2.5 Referência-para-Vídeo na Atlas Cloud com duração definida para 30 e a longa tomada renderizada
Seedance 2.5 Referência-para-Vídeo na Atlas Cloud com duração definida para 30 e os mesmos dois retratos de referência anexados, capturados no meio da geração. Observe as tags @image1 e @image2 no prompt: é assim que você diz ao Seedance qual referência desempenha qual papel. Verifique o preço cotado no botão Executar antes de confirmar, pois ele reflete a duração que o trabalho realmente enviará.
A versão de 30 segundos da mesma cena, mesmo pacote de referência, batidas escritas plano por plano.
Adicione um vídeo de referência apenas para movimento. Anexe um clipe cujo ritmo você gosta e diga isso explicitamente no prompt, algo como "siga o vídeo de referência apenas para o ritmo de corte, ignore seus sujeitos e cenário". Esse é o truque por trás do exemplo de virada de cartão mais acima.
Corrija a deriva com o prompt negativo antes de tocar no positivo. Morfismo facial, mudança de cor e tremida de câmera são os três que estragam planos com referência fixa, e geralmente é mais barato suprimi-los do que descrevê-los.
Experimente o Formato de Referência Multimodal de Graça
Se você quer a forma disso antes de querer os parâmetros, a Atlas Cloud lançou um gerador gratuito de esquetes de anúncios de IA na semana passada que executa a mesma cadeia sem nenhum dos botões.
Você escreve uma linha sobre seu produto e seus pontos de venda. Ele escreve um roteiro de comédia de dois personagens para você, gancho, conflito, reviravolta, então renderiza um vídeo de 15 segundos com diálogo falado e efeitos sonoros embutidos. Você pode anexar até quatro fotos reais de produto como referências, e o anúncio mantém sua forma, cor, rótulo e logotipo do roteiro ao quadro final. Seis estilos vêm com ele, de meme engraçado a reviravolta na trama e sitcom, passando por luxo e venda direta, e o diálogo volta no idioma em que você escreveu a descrição.
Essa é a mesma cadeia de dois-personagens-mais-imagens-de-referência-mais-voz do tutorial, menos a escrita do prompt e menos a conta. O que a torna uma maneira decente de descobrir se este formato se adequa ao seu produto antes de gastar qualquer coisa ajustando-o.
Para ter uma ideia do que uma pilha de imagens de referência faz em uma peça de produto, esta é a versão do próprio Wan 3.0 do trabalho: cinco imagens entram, um reel de lançamento sai, cada imagem ancora uma batida da edição.
Cinco imagens de referência expandidas em um reel de lançamento de produto estilo Material Design_Cinco imagens de referência dirigindo um filme de produto de nove segundos, cada uma ancorando uma batida e passando o bastão para a próxima. Fonte: Manual oficial do criador Wan 3.0 da Alibaba._
Quanto Custa um Clipe de Referência Multimodal do Wan 3.0
| Etapa | Modelo | Preço unitário | Quantidade | Custo |
|---|---|---|---|---|
| 1 e 2, duas imagens de referência | GPT Image 2 | $0,009 por imagem | 2 | $0,02 |
| 3, referência de voz | MiniMax Speech 2.6 HD | $0,08 por 1K caracteres | 49 caracteres | $0,00 |
| 4, a tomada de 10 segundos em 1080P | Wan 2.7 Referência-para-Vídeo | $0,15 por segundo em 1080P | 10 s | $1,50 |
| Total do tutorial | cerca de $1,52 | |||
| Variação, 30 segundos | Seedance 2.5 Referência-para-Vídeo | $0,134 por segundo em 480P | 30 s | cerca de $4,02 |
| Rota gratuita | Gerador Gratuito de Esquete de Anúncio de IA | gratuito | 1 clipe, 15 s | $0 |
Essas são as taxas da própria plataforma, verificadas em agosto de 2026 e cobradas conforme o uso. Duas coisas movem o total mais do que as pessoas esperam. A resolução é a primeira: os $0,10 por segundo na tabela de comparação é a taxa base do Wan 2.7, e 1080P cobra $0,15, que é de onde vêm os $1,50 acima. A segunda é que o Seedance precifica por contagem de pixels, então seus $0,134 por segundo listados são o valor para 480P e uma tomada em 720P custa mais do que uma multiplicação direta sugere. Para referência, a taxa reportada do beta do Wan 3.0 de $0,20 por segundo em 1080P colocaria uma tomada completa de 30 segundos em cerca de $6, o que é mais do que a rota do Seedance em 480P hoje.
Uma nota sobre o uso disso. O Wan 3.0 é um beta e seus termos podem mudar, então releia-os antes de construir um pipeline nele. Se suas imagens de referência são pessoas reais, obtenha sua permissão primeiro, já que referência-para-vídeo é precisamente a capacidade que torna isso importante. Os clipes de exemplo neste artigo são resultados gerados pela própria Alibaba a partir de seu manual público do criador, reproduzidos aqui para comentários.
Perguntas Frequentes
Quantas referências a referência multimodal do Wan 3.0 pode realmente aceitar?
Até 20 ativos em uma única chamada, extraídos de imagens, vídeos, áudio, documentos e páginas da web. O limite prático é menor que o técnico. Atribua a cada ativo exatamente um trabalho, um sujeito por imagem, e você usará muito menos de 20 para a maioria das cenas.
O Wan 3.0 pode realmente transformar um PDF ou uma página da web em um vídeo?
Sim, essa é a parte verdadeiramente única. Junto com texto, imagem, áudio e vídeo, ele aceita arquivos de documento e URLs ao vivo, com relatórios sobre o beta listando .doc, .xls, .ppt, .pdf e .txt. Nenhum outro modelo de referência-para-vídeo na tabela de comparação acima aceita um documento.
O Wan 3.0 é open source? Posso executá-lo no ComfyUI?
Não, e não agora. O Wan 3.0 é um beta fechado rodando na nuvem da própria Alibaba. Gerações anteriores do Wan foram lançadas abertamente, e é por isso que a expectativa existe, mas a Alibaba não confirmou pesos para o 3.0. Páginas que afirmam um lançamento Apache 2.0 de 1,3B ou 14B do Wan 3.0 não são apoiadas por nada oficial.
O Wan 3.0 está disponível através de APIs de terceiros ainda?
Ainda não, incluindo a Atlas Cloud. A coisa mais próxima que você pode chamar hoje é o Wan 2.7 Referência-para-Vídeo, cuja forma de entrada corresponde quase exatamente à omni-referência, exceto pelas modalidades de documento e página web, ou o Seedance 2.5 Referência-para-Vídeo se você precisar dos 30 segundos completos.
Qual é a maneira mais barata de testar um vídeo de dois personagens com referência fixa?
O gerador gratuito de esquetes de anúncios de IA linkado acima. Quatro fotos de referência entram, um clipe falado de 15 segundos com dois personagens sai, sem parâmetros e sem gastos. Se ele segurar seu produto e seu formato, então vá ajustar a cadeia paga.
Por que meus personagens ainda se desviam mesmo com imagens de referência?
Três causas, em ordem de frequência. Uma referência está carregando dois trabalhos, então está sendo solicitada a fixar tanto o rosto quanto o local. A imagem de referência tem mais de uma pessoa ou um fundo ocupado, então o modelo não sabe qual parte fixar. Ou o desvio é um artefato de renderização em vez de uma falha de referência, nesse caso coloque face morphing, colour shift no prompt negativo antes de reescrever qualquer coisa.


