Qwen Image 3.0 pro Identity Preserving Edits
Qwen Image 3.0 pro är Qwens familj för bildgenerering och bildredigering för utvecklare som bygger visuella produktionsflöden. Den skapar bilder upp till 2048×2048, skriver automatiskt om prompts, väljer upplösning utifrån promptens avsikt och följer redigeringsinstruktioner på naturligt språk samtidigt som ansiktsdrag och identitet bevaras. Få åtkomst till båda modellerna via Atlas Cloud med en enda OpenAI-kompatibel nyckel och standardprissättning enligt användning på $0.04 per anrop. Börja bygga redan idag.
Qwen Image 3.0 Pro är utvecklad av Alibaba. Atlas Cloud (som drivs av Atlas Cloud AI LLC) tillhandahåller åtkomst till modellen men äger den inte. Alla varumärken tillhör sina respektive ägare.
Utforska de Ledande Modellerna
Atlas Cloud förser dig med de senaste branschledande kreativa modellerna.


Qwen Image 3.0 pro – genererings- och redigeringslägen
Jämför de text-till-bild- och referensbaserade redigeringsendpoints som är tillgängliga för Qwen Image 3.0 pro.
| Modalitet | Beskrivning |
|---|---|
| Qwen Image 3.0 Pro API (Text to Image) | Omvandla textprompter till bilder med upplösningar på upp till 2048×2048, med automatisk omskrivning av prompter och promptstyrt val av upplösning. Avancerad återgivning av komplex text och exakt följsamhet till prompter passar för affischer, produktbilder, illustrationer och andra kompositionskänsliga tillgångar. |
| Qwen Image 3.0 Pro API (Image Editing) | Ange en till tre referensbilder och en instruktion på naturligt språk för att skapa en redigerad bild. Viktiga detaljer, såsom ansiktsdrag och identitet, bevaras samtidigt som de begärda ändringarna tillämpas, vilket gör endpointen lämplig för porträttförfining, visuella variationer och kontrollerade uppdateringar av tillgångar. |
Qwen Image 3.0 pro: typografi, detaljrikedom och kontroll
Qwen Image 3.0 pro kombinerar avancerad textrendering, exakt följsamhet till promptar, generering upp till 2048 × 2048, automatisk omskrivning av promptar och identitetsbevarande redigeringar från en till tre referenser via Atlas Clouds enhetliga pay as you go API.
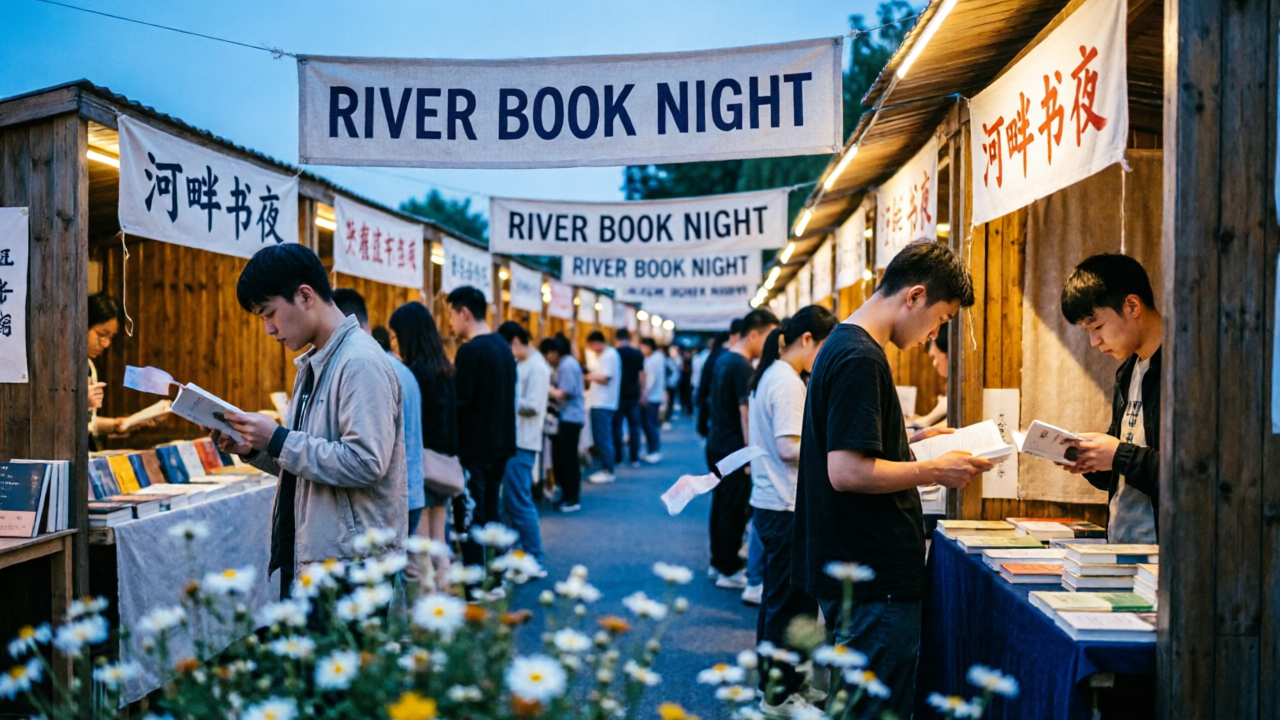
Typografi med Qwen Image 3.0 pro
Qwen Image 3.0 pro följer detaljerade promptar och hanterar samtidigt komplex textrendering på engelska och kinesiska. Modellen kan strukturera täta kreativa layouter utan att separera typografin från scenen. Ange text, hierarki, komposition och visuell stil i samma begäran och korrekturläs sedan namn och siffror före publicering. Det gör modellen praktisk för banderoller, redaktionell grafik, förpackningskoncept och informationsrik design.
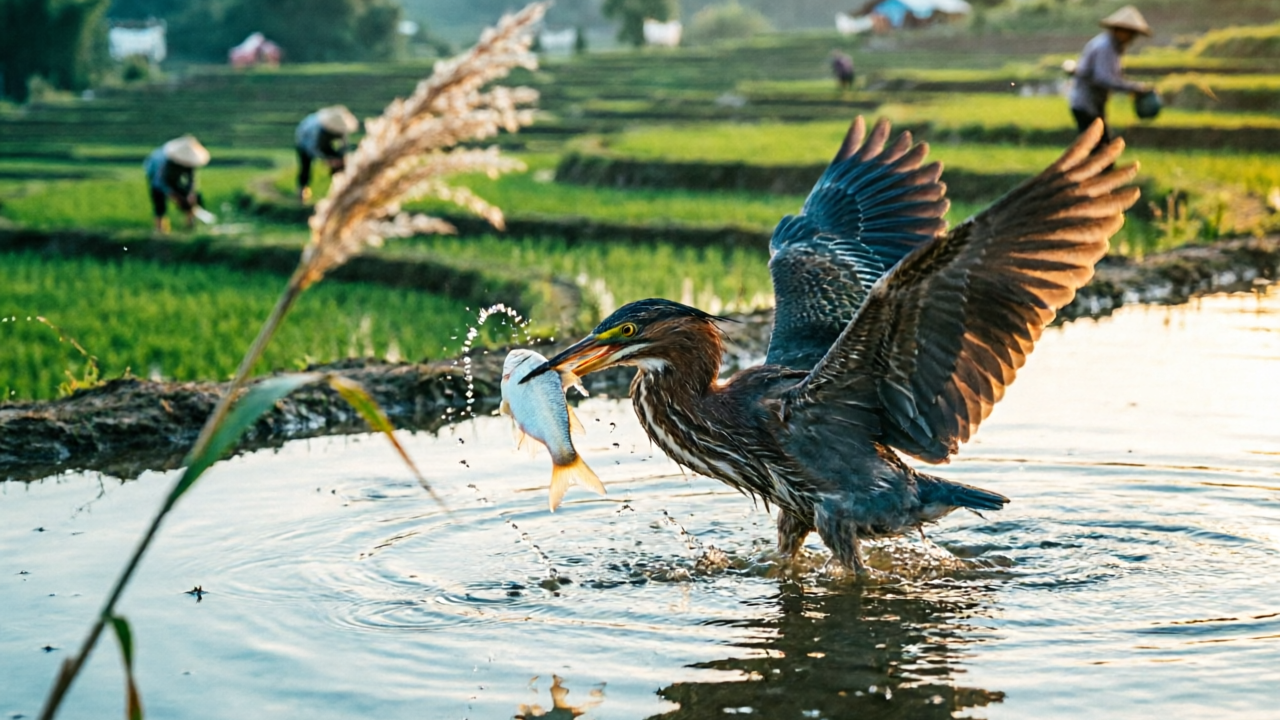
Detaljrikedom i 2048 × 2048
Generera bilder med upplösningar upp till 2048 × 2048 när fin struktur och läsbara detaljer är viktiga. Promptstyrt val av storlek kan automatiskt välja en utdataupplösning, medan en uttryckligen angiven storlek låter dig rikta in dig på en känd canvas. Från produktfotografi till redaktionella porträtt ger den extra pixelbudgeten möjlighet till närmare granskning, flexibla beskärningar i efterföljande led och välpolerade produktionsresurser.
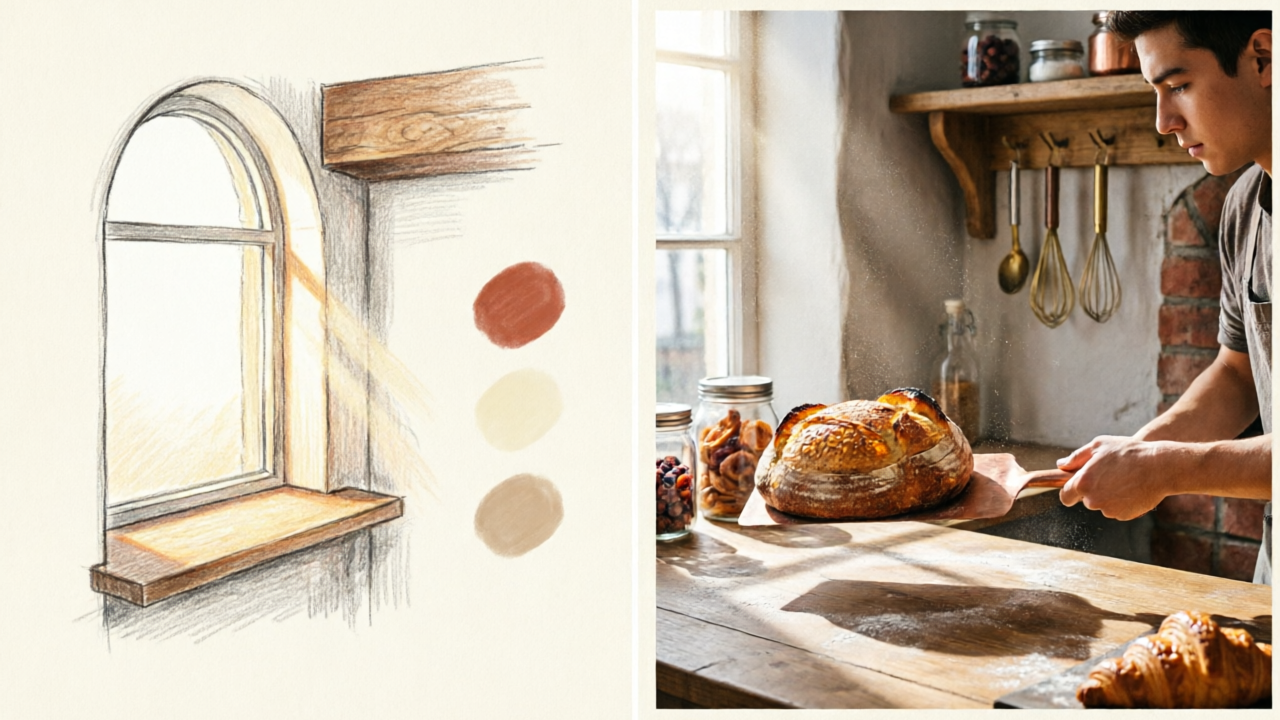
Två lägen för omskrivning av promptar
Korta promptar kan automatiskt byggas ut före genereringen, och omskrivning är aktiverad som standard. På text generation endpoint utför Direct-läget en omskrivning i ett enda steg, medan Agent-läget använder en agentbaserad pipeline för att berika underlaget. Låt omskrivningen vara aktiverad för utforskande koncept eller inaktivera den när exakt ordalydelse och strikt kontrollerade instruktioner är viktigare i produktion.
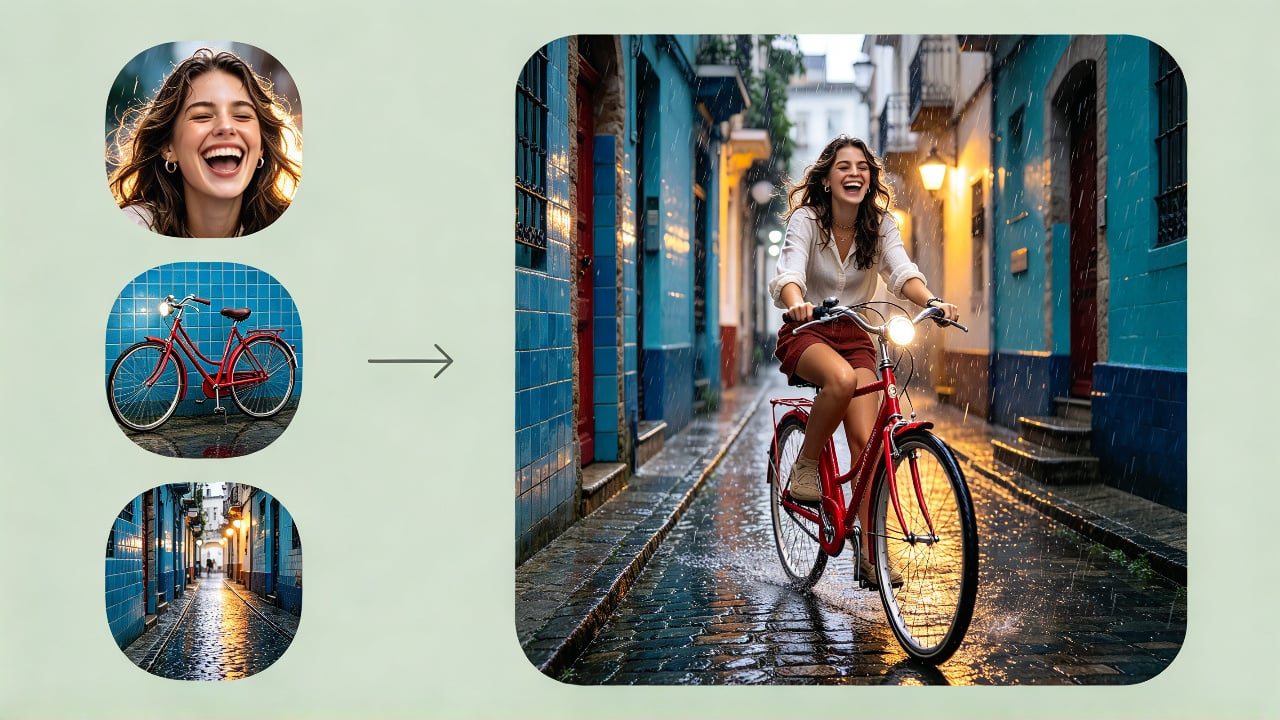
Redigering med en till tre referenser
Lägg till en till tre referensbilder i en redigering och beskriv ändringen på naturligt språk. Modellen kan använda källorna för motiv, sammanhang eller visuell vägledning, samtidigt som viktiga ansiktsdrag och identiteten bevaras. Be om en ny miljö, styling eller komposition utan att bygga om det godkända motivet från grunden. Detta passar för kampanjvarianter, kontinuitet mellan karaktärer och produktbilder baserade på referenser.
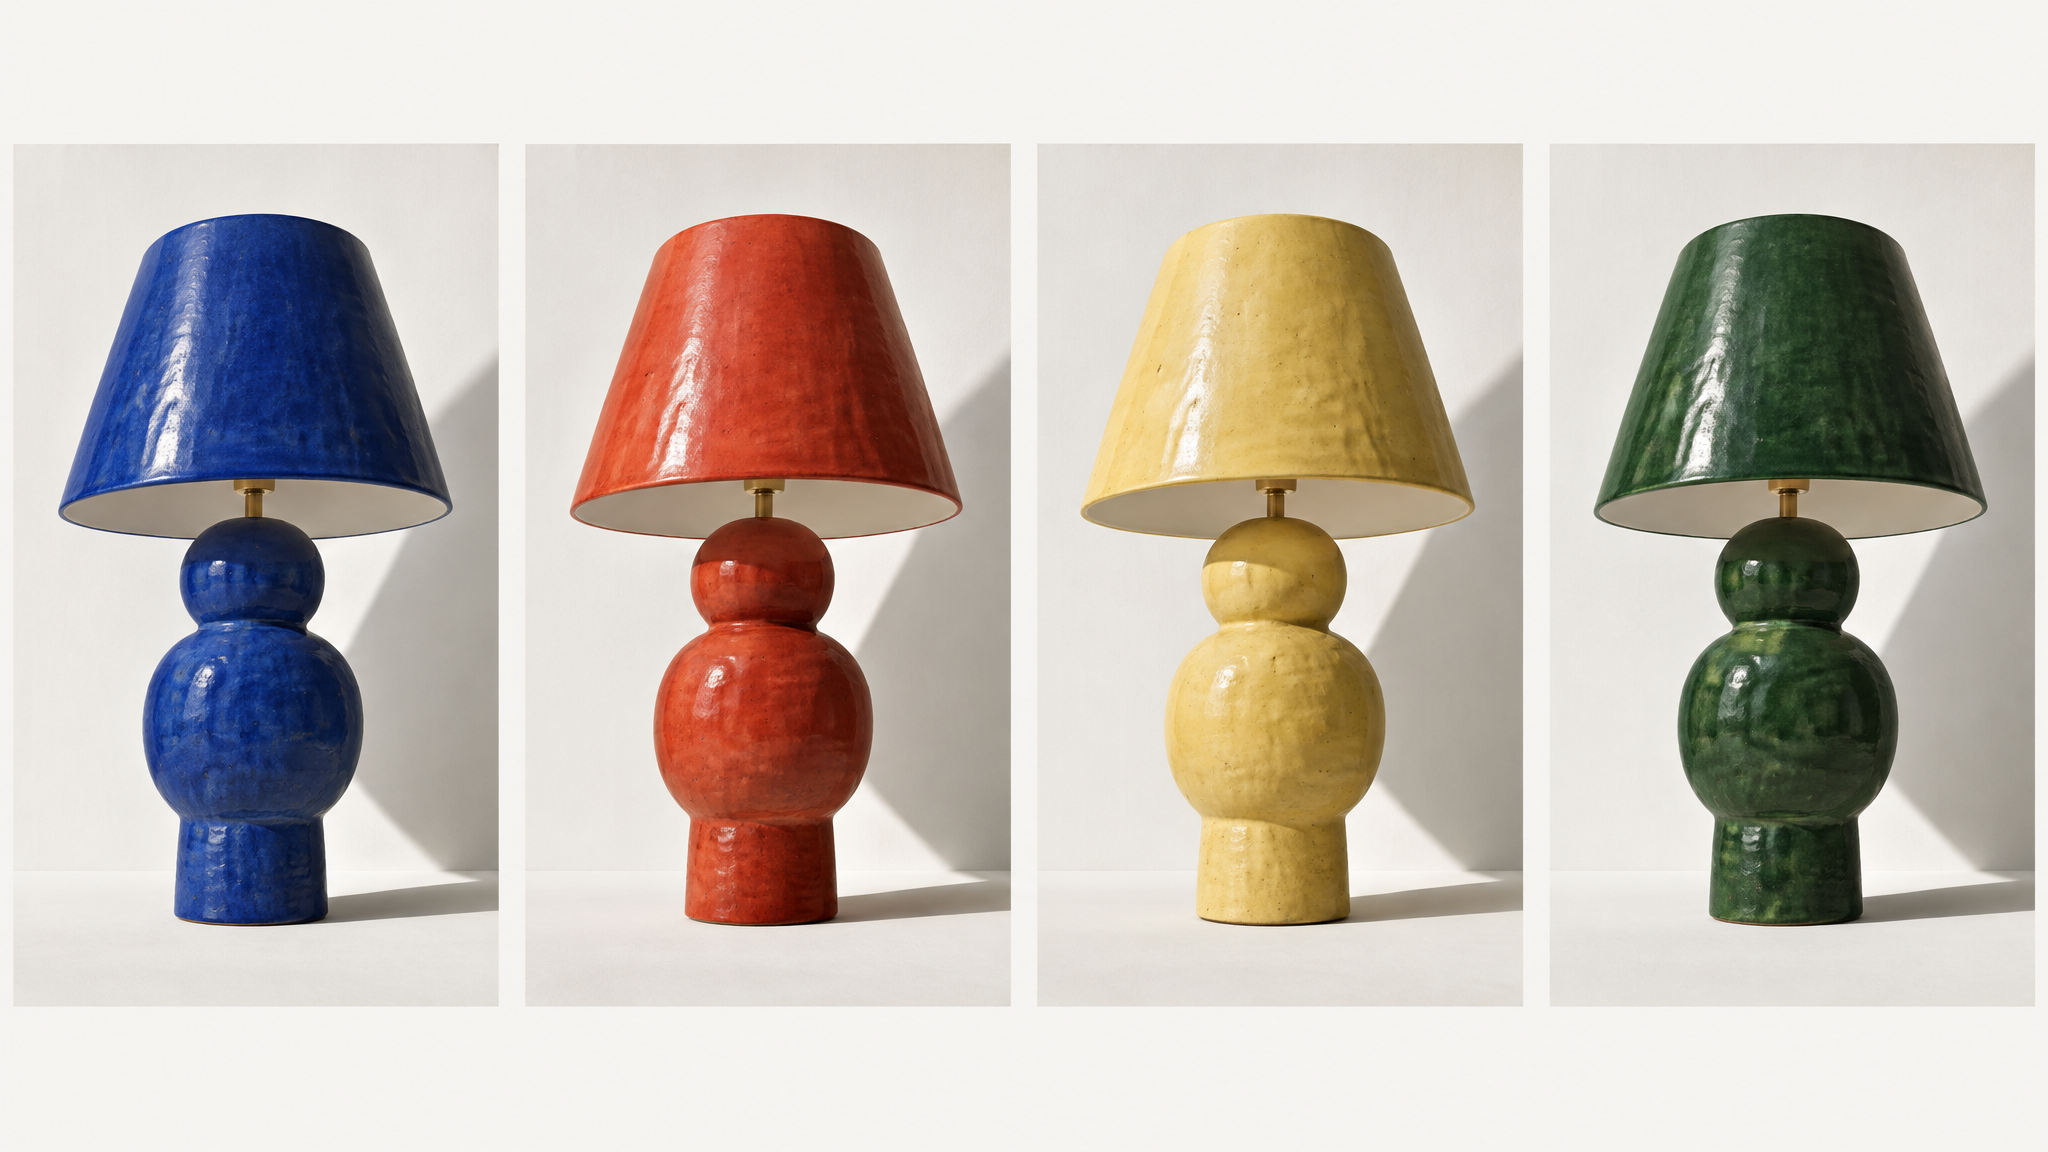
Reproducerbara batchkontroller
Behöver du upprepningsbara experiment? Ange ett fast seed-värde från 0 till 2147483647, lägg till en negativ prompt och begär upp till fyra utdata i samma genereringsanrop. Dessa kontroller gör det enklare att jämföra promptrevisioner, utesluta oönskat innehåll och granska ett mindre urval av alternativ under konsekventa förhållanden. Använd dem för strukturerade kreativa tester i stället för tillfälliga gissningar.
En prompt, tre visioner: Qwen Image 3.0 pro i jämförelse
Se hur Qwen Image 3.0 pro, en ledande extern konkurrent och föregångaren i samma serie tolkar identiska prompter inom design med typografiskt fokus och dokumentärfotografi.
På en livlig kryddbasar mitt på dagen: fånga det avgörande, humoristiska ögonblicket när en ung manlig försäljare svingar en grov jutesäck med saffran upp i luften, precis när en rörelseoskärpad duva stöter till en hög med gurkmeja och skickar ett strålande moln av gyllene pulver genom scenen; förskräckta kunder reagerar naturligt och komiskt, där en tydligt skyddar flera glänsande röda granatäpplen med båda händerna medan en annan samtidigt håller vikta papperspåsar med kryddor mot bröstet, med varje arm, hand, finger, föremål och interaktion anatomiskt korrekt, tydlig och lätt att avläsa. Rama in marknaden genom lager av stenarkader för en stark bild-i-bilden-komposition, med ett något upphöjt holländskt vinkelperspektiv; upprepade block av karmosinröda chilifrukter, djupt indigoblå keramiska skålar och intensivt gula gurkmejahögar skapar en disciplinerad palett med endast primärfärgerna rött, gult och blått. Hårt riktat zenitljus mitt på dagen kastar skarpa geometriska skuggor över stånden, ansiktena och de slitna stenplattorna. Bevara taktil realism i luftburna pulvergranulat, vävda jutfibrer, papperslika saffranstrådar, dammiga kryddhögar, hamrade kopparvågar, glaserad keramik, väderbitna träfibrer, skrynkliga papperspåsar, naturlig ungdomlig hud och subtilt analogt filmkorn. Inkludera en bred horisontell handmålad butiksskylt med exakt texten “KRYDDOR, SOL & ÖVERRASKNING” i stora, perfekt läsbara bokstäver, samt flera separata handskrivna prislappar med exakt texten “SAFFRAN 12”, “GURKMEJA 4”, “CHILIFRUKTER 6” och “GRANATÄPPLEN 3”, alla korrekt stavade, rent utformade och naturligt integrerade i ståndet. Dokumentärfotografi i stil med ett vintage-resemagasin från 1970-talet, mänsklig värme i ögonblicket, återhållsam realism, 28mm miljöobjektiv, djupt skiktat fokus med en mjukt delvis skymmande förgrundskant, lätt rörelseoskärpa på duvan, skarpa ansikten och händer, autentisk exponering, inga poser, ingen oljig överrendering, inget HDR-utseende, ingen plastlik hud, inga grumliga färger, inget överdrivet sken, ingen episk fantasibelysning, ingen rörig regnbågspalett, inga missbildade händer, inga extra fingrar, inga duplicerade personer, ingen förvrängd text, inga ramar, ingen mockup, brett liggande 16:9-bildformat, helt utfallande.
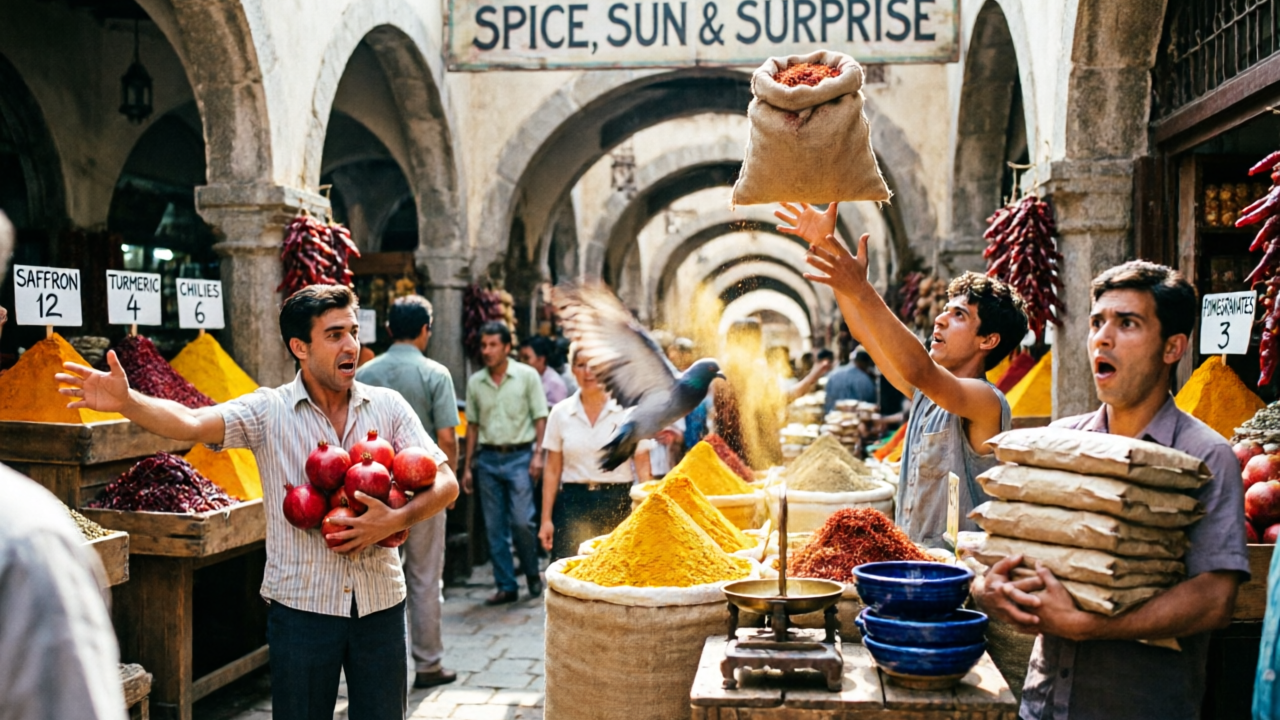
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
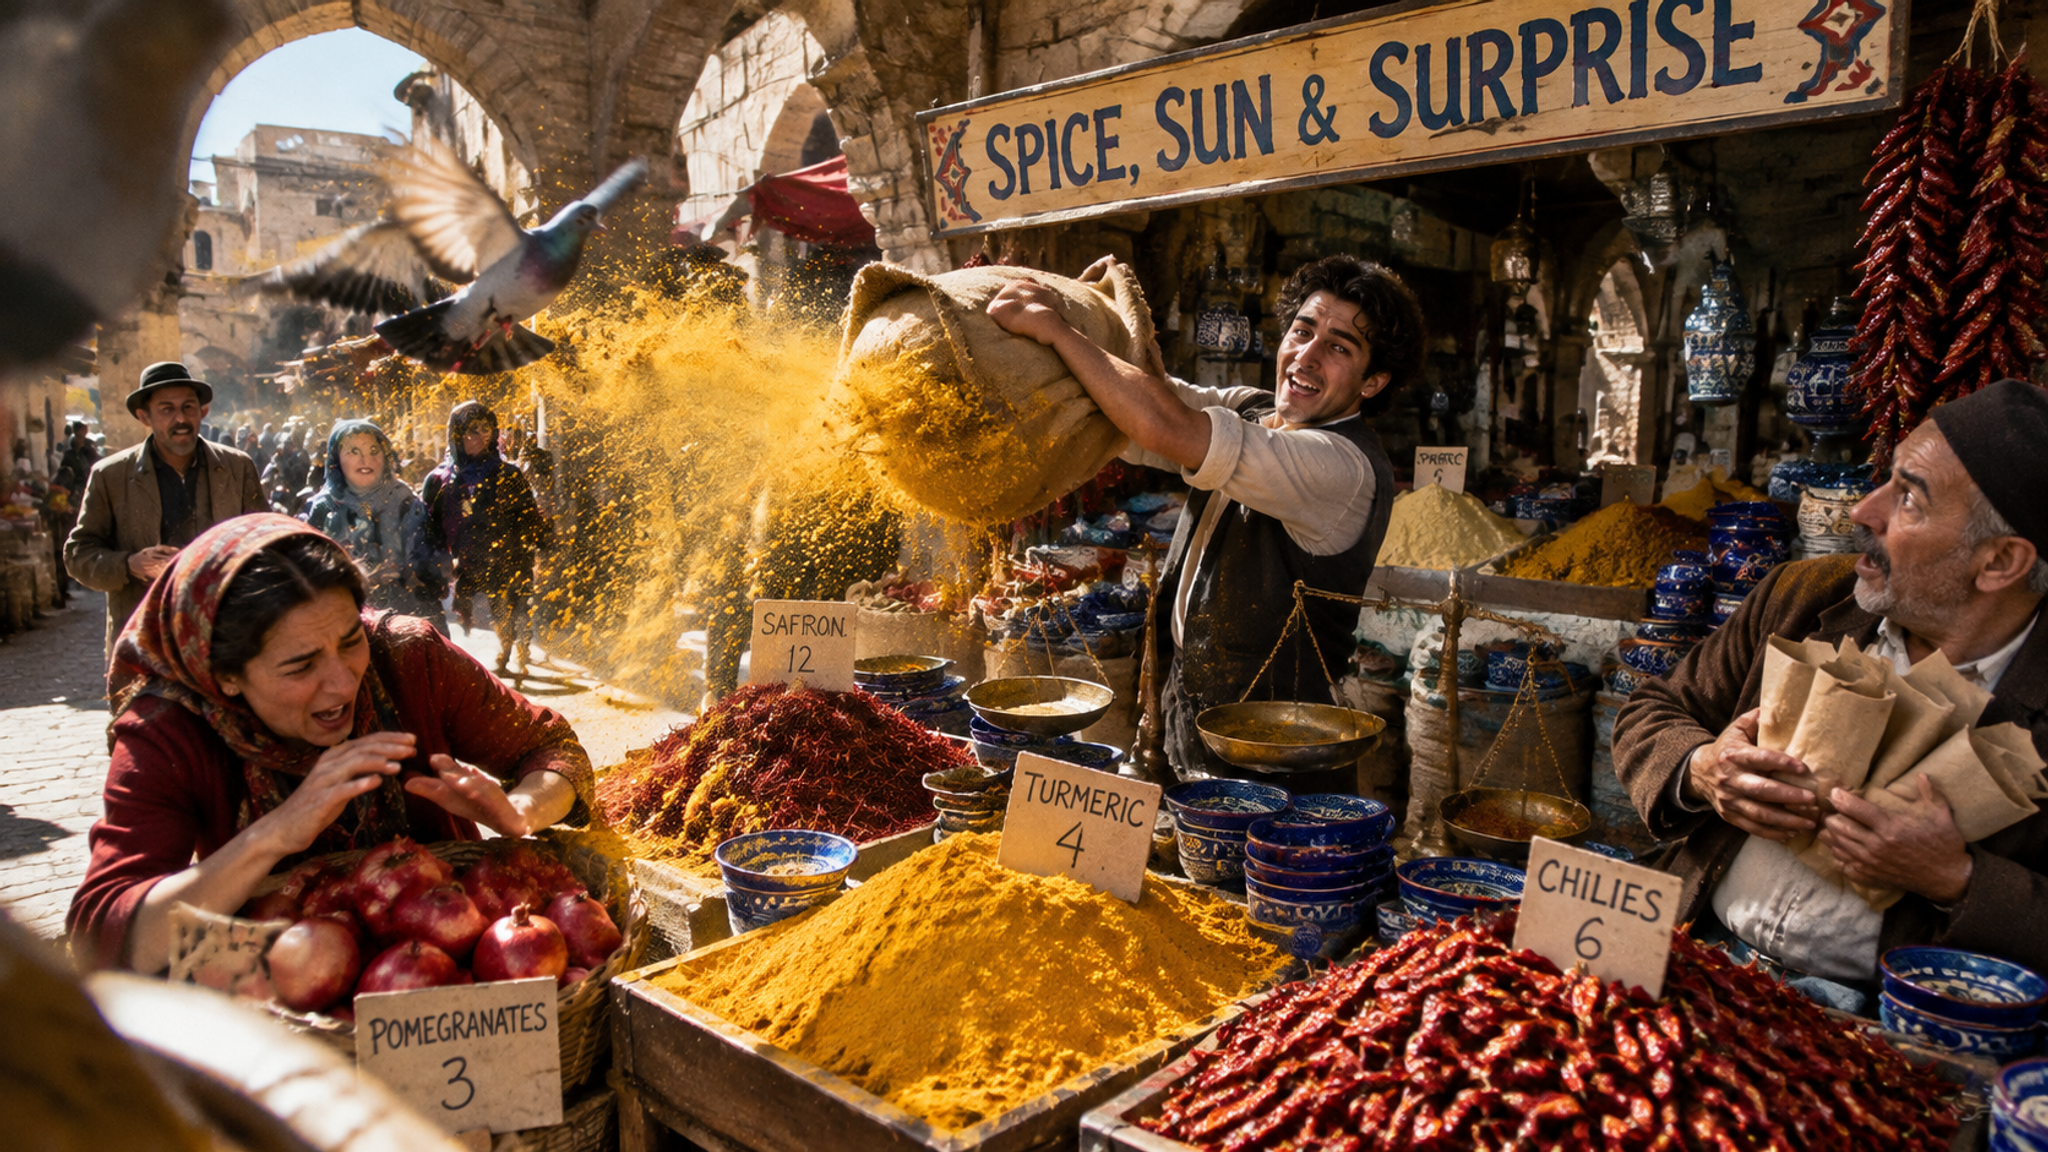
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
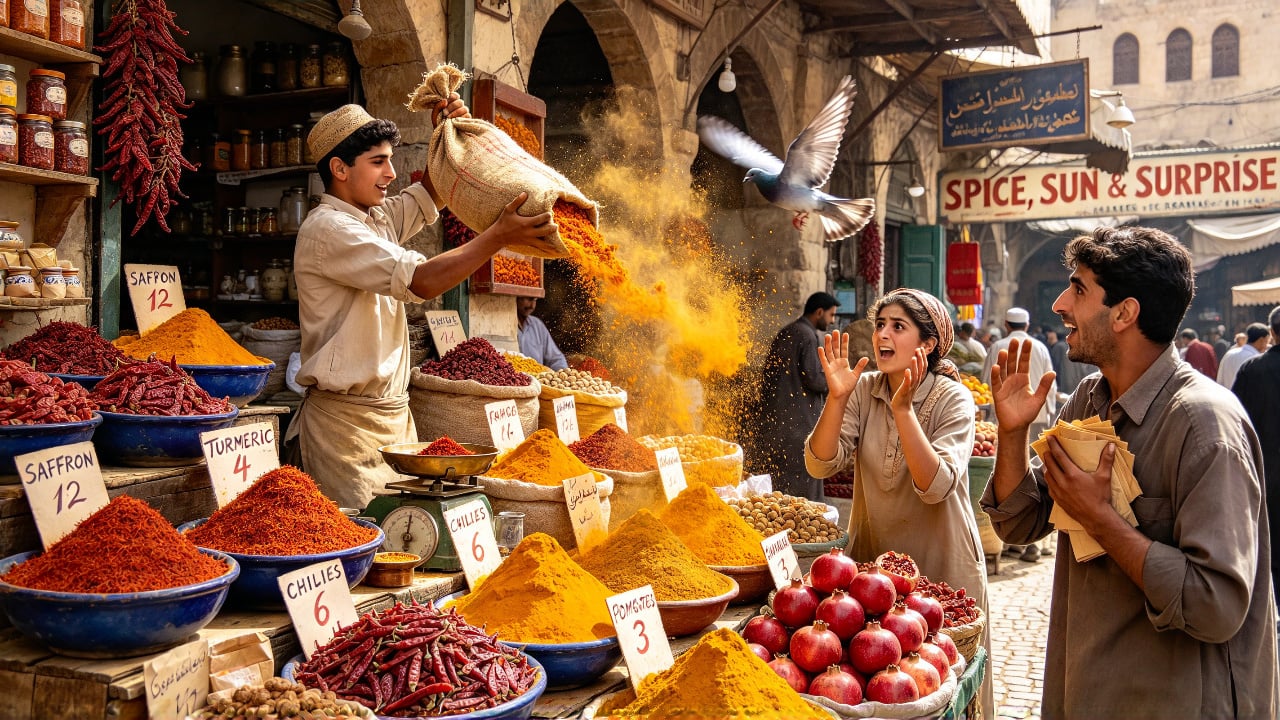
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
En filmisk dokumentärbild inifrån en självbetjäntvättomat en regnig natt, som fångar det avgörande ögonblicket när en frontmatad tvättmaskin plötsligt vräker ut en enorm kaskad av vitt skum; en ung kvinna i en klar gul regnrock skrattar spontant när hon fångar spillet med ett rött tvättfat av plast, hennes händer greppar naturligt kanten med anatomiskt korrekta fingrar, medan hennes vän står på andra sidan den immiga glasrutan och tydligt skriver den exakta spegelvända texten “SISTA TVÄTT 11:30” med fingret, läsbar inifrån tvättomaten; i samma ögonblick slår en våt strumpa mot glaset och fastnar där. Rader av runda tvättmaskinsluckor skapar djärv upprepad geometri och starka linjer som leder blicken in i ett djupt bilddjup, medan skiktade reflektioner i fönstret visar både den lekfulla handlingen inomhus och den regnvåta neongatan utanför, vilket bildar ett sammanhängande dubbelt narrativ. Riktat kallvitt lysrörsljus från taket mejslar fram skarpa silhuetter och rena konturer över ansikten, regnrock, händer, skum och krom; återhållet magentafärgat neonljus tränger genom fönstret och speglas i vattenpölarna på trottoaren, med en disciplinerad trefärgspalett i cyanblått, intensivt gult och magenta. Fotorealistiska vattendroppar på glaset, genomskinliga bubblor, fuktigt vävt tyg, borstad metall, gummitätningar runt luckorna, kondens, reflektioner i vattenpölar, subtil rörelseoskärpa i det flygande skummet, mjukt filmkorn vid hög ISO, naturlig ungdomlig hudstruktur, spontana uttryck, komplexa men rumsligt konsekventa reflektioner och transparenta ytor. Miljöreportage i ögonhöjd, 35mm-objektiv, måttligt skärpedjup, filmisk realism, subtila imperfektioner, inga arrangerade poser, ingen fet överrendering, inget HDR-utseende, ingen plastlik hud, inga grumliga färger, inget överdrivet sken, ingen billig episk belysning, brett horisontellt 16:9-bildformat, helt utfallande.
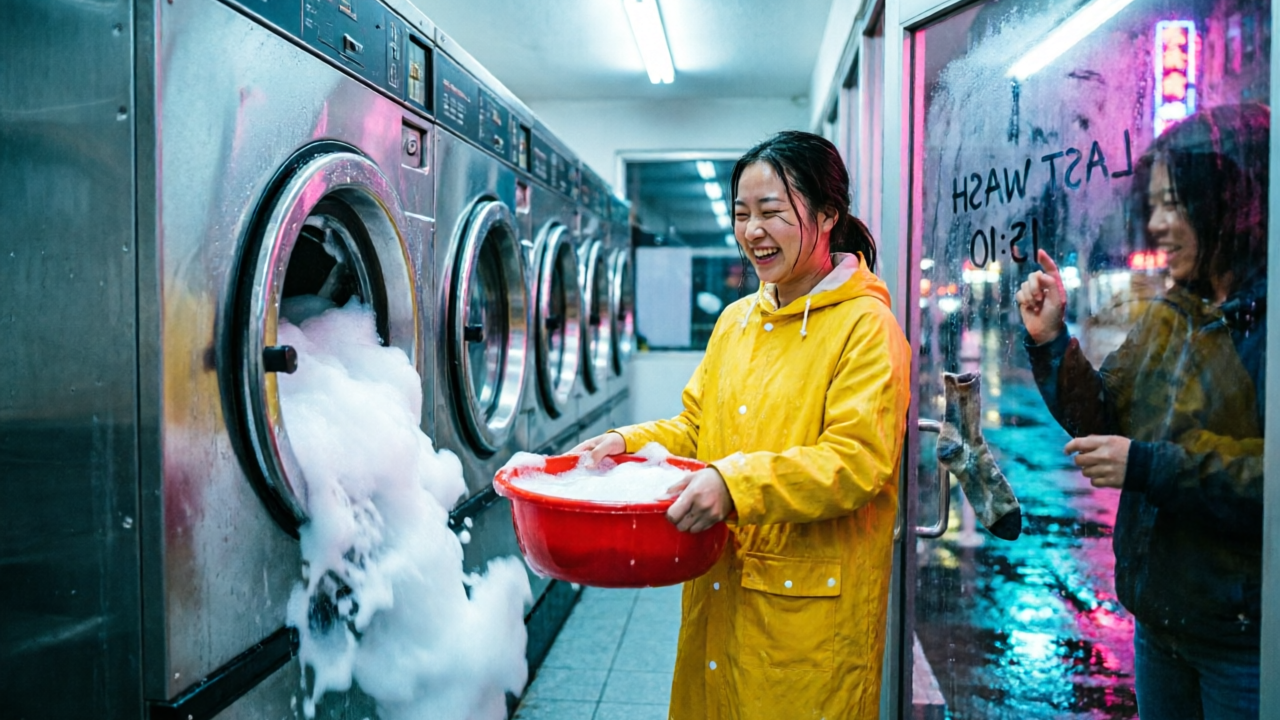
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
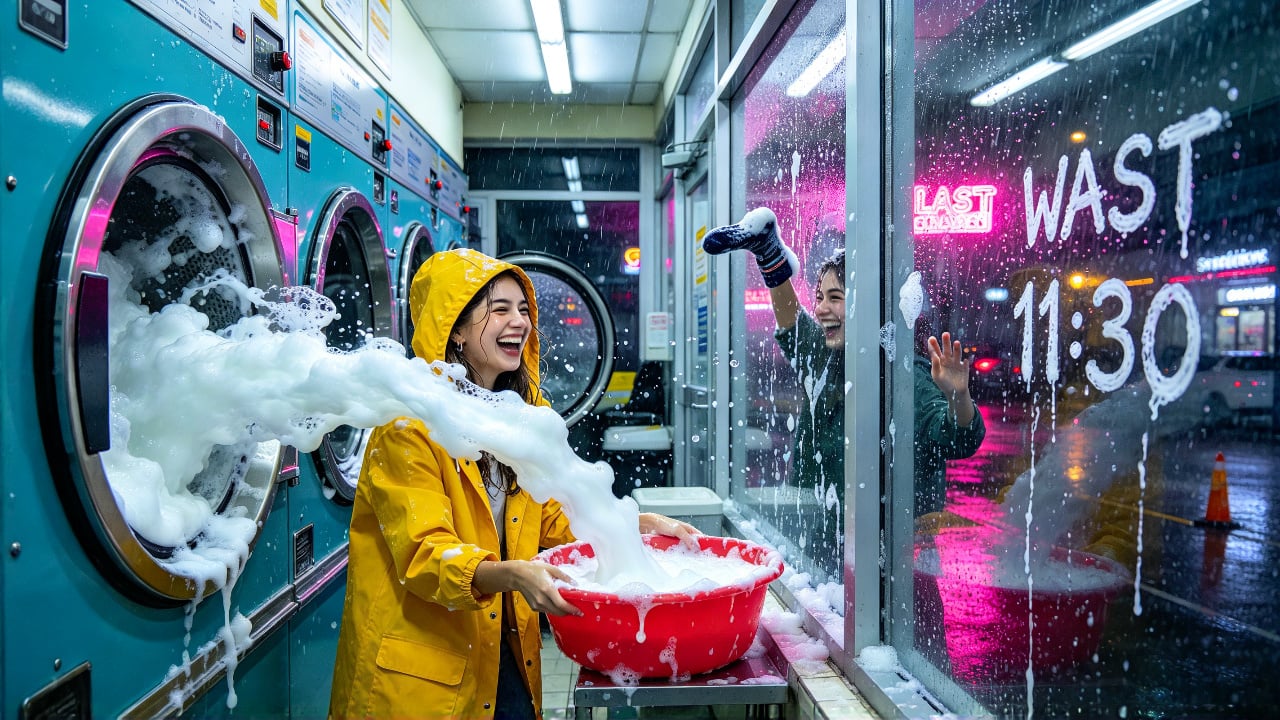
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
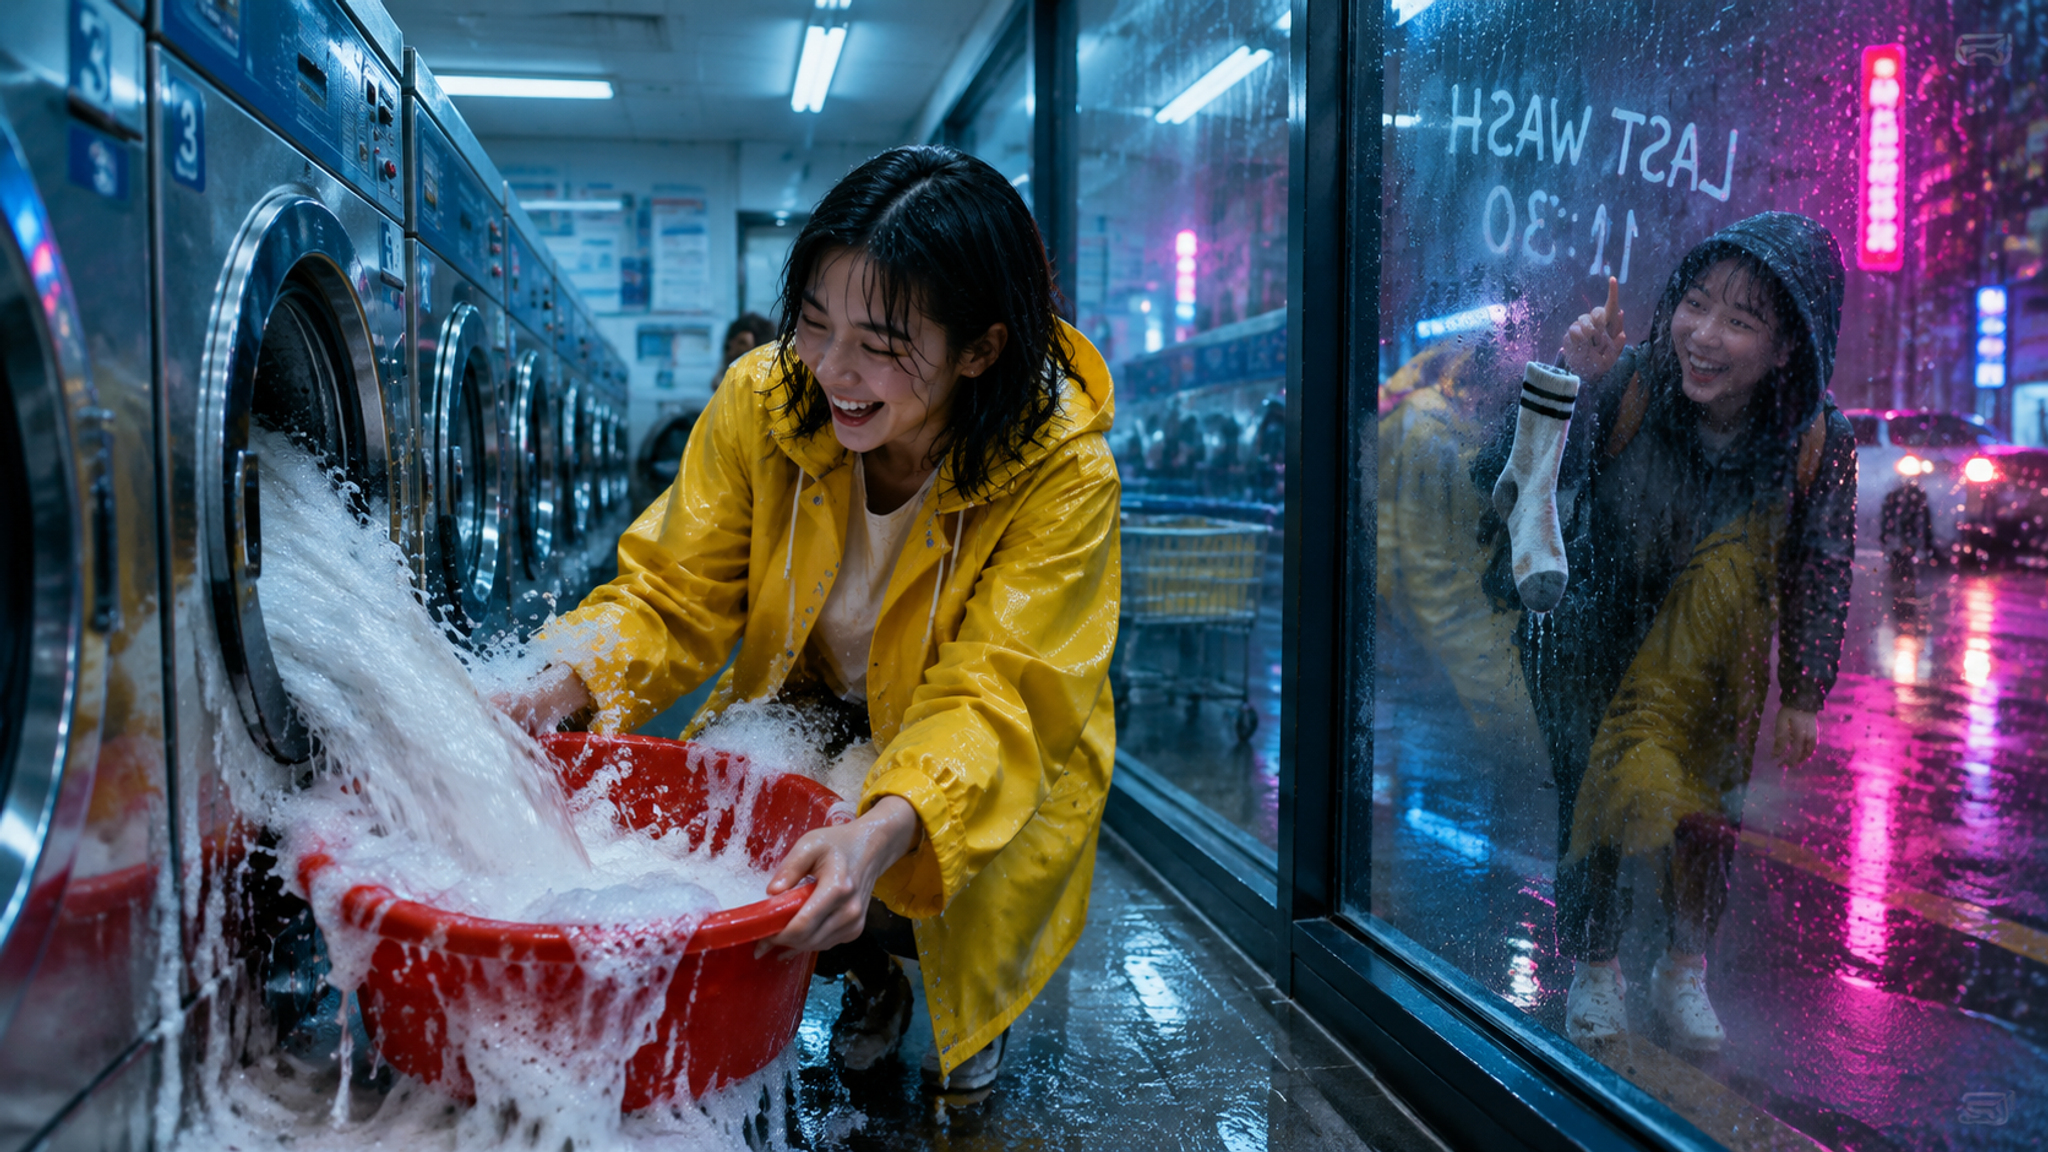
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
Bygg visuella system med Qwen Image 3.0 Pro
Qwen Image 3.0 Pro stöder kampanjgrafik, produktvisualiseringar, gränssnittskoncept, storyboards och identitetsbevarande redigeringar genom exakt följsamhet till prompten, avancerad textrendering, upp till 2048×2048 i upplösning samt one to three referensbilder.

Kampanjaffischer med Qwen Image 3.0 Pro
Förvandla krävande promptar till kampanjaffischer, banderoller och grafik för sociala medier med hjälp av Qwens styrka inom avancerad textrendering och exakt följsamhet till prompten. Skapa varumärkestillgångar i upp till 2048×2048 för lanseringar, evenemang och kampanjer.

Produktvisualiseringar med Qwen Image 3.0 Pro
Generera produktbilder från text medan automatisk omskrivning av prompten utvecklar kortfattade idéer och promptstyrd storleksanpassning väljer en lämplig arbetsyta. Resultatet passar för katalogbilder, e-handelskampanjer och snabba koncepttester för små team.

Identitetsbevarande porträttredigering
Bevara ansiktsdrag och identitet samtidigt som kläder, miljö, ljussättning eller visuell stil ändras genom redigeringar på naturligt språk. Porträttstudior och appar för kreatörer kan skapa igenkännbara kampanjvarianter från one to three referensbilder.

Gränssnitts- och infografikkoncept
Behöver du informationsrika bilder utifrån detaljerade instruktioner? Använd exakt följsamhet till prompten och avancerad textrendering för att ta fram prototyper av gränssnittskoncept, pedagogiska diagram, kommenterade förklaringar och presentationsgrafik för produkt- eller utbildningsteam.

Kompositioner med flera referenser
Ta med upp till three referensbilder i en och samma redigeringsbegäran och styr sedan ändringarna på naturligt språk medan viktiga detaljer förblir intakta. Detta passar för bildkompositioner, produktvarianter och kreativa arbetsflöden med fokus på karaktärer.

Storyboards med Qwen Image 3.0 Pro
Skissa sekventiella scener utifrån noggrant formulerade promptar, där promptföljsamheten hjälper varje bildruta att följa de efterfrågade motiven, miljöerna och den visuella riktningen. Filmskapare, byråer och spelteam kan omvandla tidiga idéer till storyboardrutor.
Qwen Image 3.0 pro jämfört med ledande bild-API:er
Jämför Qwen Image 3.0 pro med Seedream- och Nano Banana-endpoints utifrån arbetsflöde, maximal utmatningsstorlek, antal referensbilder, promptverktyg och Atlas Clouds standardpris.
| Modell | Arbetsflöde | Maximal utmatningsstorlek | Max antal referensbilder | Promptverktyg | Standardpris |
|---|---|---|---|---|---|
| Qwen Image 3.0 Pro Text-to-Image | Text till bild | 2048×2048 | - | Automatisk omskrivning av promptar | $0.04/bild |
| Qwen Image 3.0 Pro Edit | Bildredigering | 1440×1440 | 3 | Automatisk omskrivning av promptar | $0.04/bild |
| Seedream v5.0 Pro Text-to-Image | Text till bild | Upp till 4.19 MP | - | Resonemang och promptoptimering | $0.045/bild |
| Seedream v5.0 Pro Edit | Bildredigering | Upp till 4.19 MP | 10 | Resonemang och promptoptimering | $0.045/bild |
| Nano Banana 2 Text-to-Image | Text till bild | 4K | - | Resonemang och sökförankring | $0.08/bild |
| Nano Banana 2 Edit | Bildredigering | 4K | 14 | Resonemang och sökförankring | $0.08/bild |
Hur man använder Qwen Image 3.0 Pro på Atlas Cloud
Get started in minutes — follow these simple steps to integrate and deploy models through Atlas Cloud’s platform.
Skapa ett Atlas Cloud-konto
Registrera dig på atlascloud.ai och slutför verifieringen. Nya användare får gratis krediter för att utforska plattformen och testa modeller.
Varför Använda Qwen Image 3.0 Pro på Atlas Cloud
Att kombinera de avancerade Qwen Image 3.0 Pro-modellerna med Atlas Clouds GPU-accelererade plattform ger oöverträffad prestanda, skalbarhet och utvecklarupplevelse.
Prestanda & flexibilitet
Låg Latens:
GPU-optimerad inferens för realtidsresonemang.
Enhetligt API:
Kör Qwen Image 3.0 Pro, GPT, Gemini och DeepSeek med en integration.
Transparent Prissättning:
Förutsägbar fakturering per token med serverlösa alternativ.
Företag & Skala
Utvecklarupplevelse:
SDK:er, analys, finjusteringsverktyg och mallar.
Tillförlitlighet:
99.99% drifttid, RBAC och efterlevnadsredo loggning.
Säkerhet & Efterlevnad:
SOC 2 Type II, HIPAA-anpassning, datasuveränitet i USA.
Svar på frågor om Qwen Image 3.0 Pro API
Qwen Image 3.0 Pro är Alibabas modell för bildgenerering och bildredigering, som skapar bilder från text eller ändrar befintliga bilder med instruktioner på naturligt språk. På Atlas Cloud stöder den utdata på upp till 2048×2048 samt redigering med en till tre referensbilder.
Använd den för att generera bilder som kräver detaljerad följsamhet till prompten, komplex textrendering eller hög upplösning. I redigeringsflöden kan instruktioner på naturligt språk ändra en bild samtidigt som viktiga detaljer, till exempel ansiktsdrag och identitet, bevaras.
Välj text-till-bild- eller redigeringsrutten och anropa sedan modellen via Atlas Clouds OpenAI-kompatibla API med motsvarande modell-ID. Använd det länkade parameterschemat i Playground som auktoritativ källa när du bygger och validerar din begäran.
Välj qwen-image-3.0-pro/text-to-image när du genererar en bild från en prompt, eller qwen-image-3.0-pro/edit när du ändrar referensbilder. Båda rutterna har separata scheman i Playground, så använd schemat som hör till det valda arbetsflödet.
Text-till-bild-generering stöder upplösningar på upp till 2048×2048. Om upplösningen inte väljs manuellt kan modellen använda prompten för att styra valet av upplösning.
Ange mellan en och tre referensbilder tillsammans med en redigeringsinstruktion på naturligt språk. Redigeringsmodellen använder dessa indata för att genomföra de begärda ändringarna samtidigt som viktiga visuella detaljer, inklusive ansiktsdrag och identitet, bevaras.
Ja. Text-till-bild-modellen inkluderar automatisk omskrivning av prompter tillsammans med promptstyrt val av upplösning. Kontrollera resultaten mot dina ursprungliga instruktioner när exakt formulering, layout eller inbäddad text är viktig.
Atlas Cloud anger ett standardpris på $0.04 per bild för både text-till-bild- och redigeringsmodellerna. Debiteringen följer en betala-per-användning-modell, vilket gör att utvecklare kan använda båda arbetsflödena utan att binda sig till en prenumeration.
Båda versionerna stöder text-till-bild-generering och bildredigering. Alibabas officiella översikt beskriver standardmodellen som en avvägning mellan kvalitet och hastighet, men de verifierade källor som granskats här innehåller ingen kvantitativ jämförelse med Pro. Kör representativa prompter genom båda versionerna innan du väljer standard för produktion.
Börja med en tydlig referensbild och ange uttryckligen vilka ansikts- eller identitetsdetaljer som måste förbli oförändrade. Redigeringsendpointen tar emot upp till tre referenser och är utformad för att bevara dessa detaljer. Om avvikelserna kvarstår kan du förenkla den begärda omvandlingen och utvärdera en annan generering.
Utforska Fler Familjer
Seedance 2.5
Seedance 2.5 API är nu tillgängligt på Atlas Cloud! Det ger utvecklare ByteDances nyaste videomodell. Den genererar upp till 30 sekunder inbyggd video i en enda körning från text, en enskild bild eller upp till 50 multimodala referenser, med synkroniserat ljud och flerspråkig text i bildrutan. På Atlas Cloud når du den genom en enda nyckel, med motivkonsekvens och förbättrad fysik som håller långa tagningar sammanhängande.

Wan 3.0
Wan 3.0 API är nästa generation av Alibabas Wan-videofamilj, byggd för att ta långformatsgenerering, multireferenskontroll och audiovisuell kvalitet till nya höjder. Atlas Cloud är redan värd för Wan 2.7, 2.6 och 2.5, och Wan 3.0 körs på samma enhetliga nyckel utan separat konfiguration. Börja bygga idag. Rulla ner till uppvisningen för att se vad Wan 3.0 kan skapa.
MiniMax H3
MiniMax H3 är MiniMax multimodala videofamilj för att skapa med text, bilder och referenser. Via de rutter som stöds bevarar den motiv från referensmedia, erbjuder flexibla bildformat och kombinerar genererat ljud med bild genom H3 Developer, med utdataprofiler som väljs per endpoint. Atlas Cloud samlar hela familjen bakom en enda OpenAI-kompatibel nyckel, med transparent användningsbaserad prissättning från standardpriset $0.038 per sekund. Börja bygga redan idag.
Seedream 5.0 Pro
Seedream 5.0 Pro API ger utvecklare ByteDances kontrollerbara bildredigeringsmodell på Atlas Cloud. Den placerar redigeringar exakt med ankare och koordinater, separerar bilder i redigerbara lager, slår samman flera referenser och matchar exakta färger och material, med flerspråkig text i 2K och 3K. På Atlas Cloud når du den via en enda nyckel!
Seedance 2.0
Seedance 2.0 är ByteDance:s produktionsmodell för video och möjliggör exakt skapande av videoklipp. Omvandla prompts till video, animera en bild för första bildrutan med valfri vägledning från sista bildrutan eller forma resultaten med referensmedia och valfri webbsökning. Atlas Cloud samlar dessa arbetsflöden i ett enhetligt API med transparent prissättning enligt användning och en OpenAI-kompatibel nyckel. Börja bygga idag.
GPT Image 2.5
gpt-image-2.5-familjen från OpenAI ger utvecklare möjlighet att välja mellan Flare och Sunburst för produktionsarbetsflöden för bilder. Rendera med valfria upplösningar upp till 3840x2160 och välj mellan fem kvalitetsnivåer, däribland xhigh och max, för att uppfylla specifika krav på utdata. Atlas Cloud erbjuder färdig REST-inferens utan cold starts och med standardpriser från $0.004 per generering. Börja bygga idag.
GPT Image 2
GPT Image 2 API ger utvecklare tillgång till OpenAI:s senaste bildmodell, uppföljaren till GPT Image 1.5. Den genererar och redigerar bilder med exakt textåtergivning i latinska och CJK-tecken, plus en stark komposition för affischer, mockups och infografik. På Atlas Cloud når du den via ett enhetligt API tillsammans med över 300 modeller, med gratis krediter, 99,99 % upptid och utan krav på OpenAI-organisationsverifiering.
Gemini Omni Flash
gemini omni API ger utvecklare tillgång till Google DeepMinds nativt multimodala Gemini Omni Flash-familj, inklusive Gemini Omni 1.1 Flash. Skapa filmiska videor med synkroniserat inbyggt ljud, animera stillbilder med exakt kontroll över start- och slutbild eller redigera befintligt videomaterial med textstyrda ändringar som bevarar innehåll som inte berörs. Atlas Cloud erbjuder en OpenAI-kompatibel nyckel, samlad åtkomst och transparent prissättning med betalning efter användning. Börja bygga redan i dag.
Grok Imagine
Grok Imagine API täcker xAI:s bild-, video- och talmodeller – från Image 2.0 till Video 1.5 och xAI TTS v1. Rendera 1K eller 2K stillbilder över 14 bildformat, skapa upp till 15 sekunders 1080p-video, styr resultatet med upp till 7 referensbilder, eller lägg till röst på 20 språk. Atlas Cloud kör alla lägen på en enda slutpunkt, prissatt per användning från $0.02 per bild och $0.05 per sekund. Börja bygga idag.
Googles mest kraftfulla kreativa modeller är alla tillgängliga på Atlas Cloud. Veo 3.1 levererar filmisk videogenerering, Nano Banana 2 driver skapandet av högupplösta bilder, och Gemini tillför multimodal intelligens till varje arbetsflöde. Få tillgång till hela Googles modellsvit via en enda API key med Day-0-tillgänglighet och pay-as-you-go-prissättning.
Seedance 2.0 Mini
Seedance 2.0 Mini tar ByteDances multimodala videogenerering till arbetsflöden där hastighet och kostnad är avgörande. Det levererar kärnfunktionerna i Seedance 2.0 med ett lättare fotavtryck – snabbare generering, lägre kostnad per video och samma API-integration som du redan använder. För team som kör pipelines med hög volym eller gör prototyper i stor skala är Mini den praktiska standarden.
ByteDance
Från filmisk videogenerering till skapande av högupplösta bilder, ByteDances kraftfullaste modeller är live på Atlas Cloud. Kör Seedance och Seedream i stor skala med de lägsta inferenspriserna och noll infrastrukturkostnader.
Rekommenderade artiklar
Guider, handledningar och produktnyheter som hjälper dig att få ut mesta möjliga av Atlas Cloud.


