
MiniMax API
ในฐานะชุด Large Language Models (LLMs) ระดับแนวหน้าที่พัฒนาโดย MiniMax AI, MiniMax ได้รับการออกแบบมาเพื่อยกระดับประสิทธิภาพการทำงานในโลกจริงผ่านปัญญาประดิษฐ์ล้ำสมัย ระบบนิเวศนี้ประกอบด้วย MiniMax M2.5 ซึ่งสร้างขึ้นโดยเฉพาะสำหรับสภาพแวดล้อมการทำงานระดับมืออาชีพที่ต้องการประสิทธิภาพสูง และ MiniMax M2.1 โมเดลที่มอบความสามารถด้านการเขียนโปรแกรมหลายภาษาที่ได้รับการยกระดับอย่างมาก เพื่อจัดการงานทางเทคนิคที่ซับซ้อนและมีขนาดใหญ่ ด้วยประสิทธิภาพระดับ SOTA ในการเขียนโค้ด การใช้เครื่องมือแบบ agentic การค้นหาอัจฉริยะ และระบบอัตโนมัติสำหรับเวิร์กโฟลว์ในสำนักงาน MiniMax ช่วยให้ผู้ใช้ปรับกระบวนการดำเนินงานที่มีคุณค่าทางเศรษฐกิจได้หลากหลายให้คล่องตัวขึ้น ด้วยความแม่นยำและความน่าเชื่อถือที่เหนือชั้น
MiniMax พัฒนาโดย MiniMax โดย Atlas Cloud (ดำเนินการโดย Atlas Cloud AI LLC) เป็นผู้ให้บริการเข้าถึงโมเดลนี้ แต่ไม่ได้เป็นเจ้าของโมเดล เครื่องหมายการค้าทั้งหมดเป็นของเจ้าของที่เกี่ยวข้อง
สำรวจโมเดลชั้นนำ
Atlas Cloud มอบโมเดลสร้างสรรค์ล่าสุดที่นำหน้าในอุตสาหกรรมให้กับคุณ



เปรียบเทียบชุดโมเดล MiniMax API
ภาพรวมที่ชัดเจนว่าแต่ละ endpoint ของ MiniMax รับอะไร สร้างอะไร และมีค่าใช้จ่ายเท่าไร ครอบคลุมทั้งข้อความ การเขียนโค้ด เวิร์กโฟลว์แบบ agentic และการสร้างเพลง
| รูปแบบสื่อ | คำอธิบาย |
|---|---|
| MiniMax M3 API (ข้อความ) | ต้องการโมเดล agentic ที่รวดเร็วใช่ไหม? MiniMax M3 แปลง prompt แบบข้อความให้เป็นโค้ด การเรียกใช้เครื่องมือ และการให้เหตุผล ด้วยแกนประมวลผลขนาดเบาที่มี 10 billion activated parameter ซึ่งออกแบบมาเพื่อ latency ต่ำและขยายระบบได้ดี ราคามาตรฐานคือ $0.6 ต่อ 1 million input tokens และ $2.4 ต่อ 1 million output tokens โดยมีเรตราคาแยกต่างหากเมื่อ prompt มีขนาดเกิน 512K tokens เหมาะกับเซสชัน agent ที่ยาว ใช้เครื่องมือจำนวนมาก และการพัฒนาแอปพลิเคชันสมัยใหม่ |
| MiniMax M2.7 (ข้อความ) | MiniMax M2.7 แปลงคำสั่งภาษาธรรมชาติให้เป็นโค้ดระดับ production และการทำงานของ agent แบบหลายขั้นตอน โดยใช้สถาปัตยกรรม 10 billion activated parameter เดียวกันเพื่อ throughput สูง ราคามาตรฐานอยู่ที่ $0.3 ต่อ 1 million input tokens และ $1.2 ต่อ 1 million output tokens ช่วยให้การรันงาน agentic ขนาดใหญ่คุ้มค่า เลือกใช้เมื่อคุณต้องการความสามารถด้านการเขียนโค้ดและการสร้างแอปที่เชื่อถือได้มากกว่าขนาดโมเดลดิบ |
| MiniMax M2.5 (ข้อความ) | หาก workload ของคุณต้องการการให้เหตุผลที่ประหยัดและขยายได้ MiniMax M2.5 รองรับการเขียนโค้ด การประสานงานแบบ agentic และการพัฒนาแอปพลิเคชันทั่วไปจากเอนจินขนาดกะทัดรัด 10 billion activated parameter ราคาที่ระบุคือ $0.3 ต่อ 1 million input tokens และ $1.2 ต่อ 1 million output tokens โดย cached input คิดที่ $0.03 ต่อ 1 million เพื่อช่วยลดต้นทุนของ context ที่ใช้ซ้ำ จึงเป็นค่าเริ่มต้นที่ใช้งานได้จริงสำหรับ pipeline ปริมาณสูงที่นำ context กลับมาใช้ซ้ำ |
| MiniMax Music 2.6 API (Text to Music) | อธิบายสไตล์และใส่เนื้อเพลงแบบมีโครงสร้างพร้อมแท็ก เช่น [Verse] และ [Chorus] แล้ว MiniMax Music 2.6 จะส่งคืนแทร็กเสียงร้องหรือบรรเลงที่สมบูรณ์จากคำขอสร้างเพียงครั้งเดียว รูปแบบเอาต์พุตรองรับ MP3, WAV และ PCM ที่ sample rates สูงสุด 44.1 kHz และ bitrates สูงสุด 256 kbps โดยรับ prompts ได้สูงสุด 2,000 ตัวอักษร และ lyrics ได้สูงสุด 3,500 ตัวอักษร ราคา $0.15 ต่อ generation เหมาะสำหรับการทำต้นแบบซาวด์แทร็ก จิงเกิล และเพลงพื้นหลังสำหรับแอปและวิดีโอ |
ฟีเจอร์ใหม่ของ MiniMax + โชว์เคส
การผสมผสานโมเดลขั้นสูงกับแพลตฟอร์มเร่งความเร็ว GPU ของ Atlas Cloud มอบความเร็ว ความสามารถในการปรับขนาด และการควบคุมเชิงสร้างสรรค์ที่ไม่มีใครเทียบได้สำหรับการสร้างภาพและวิดีโอ
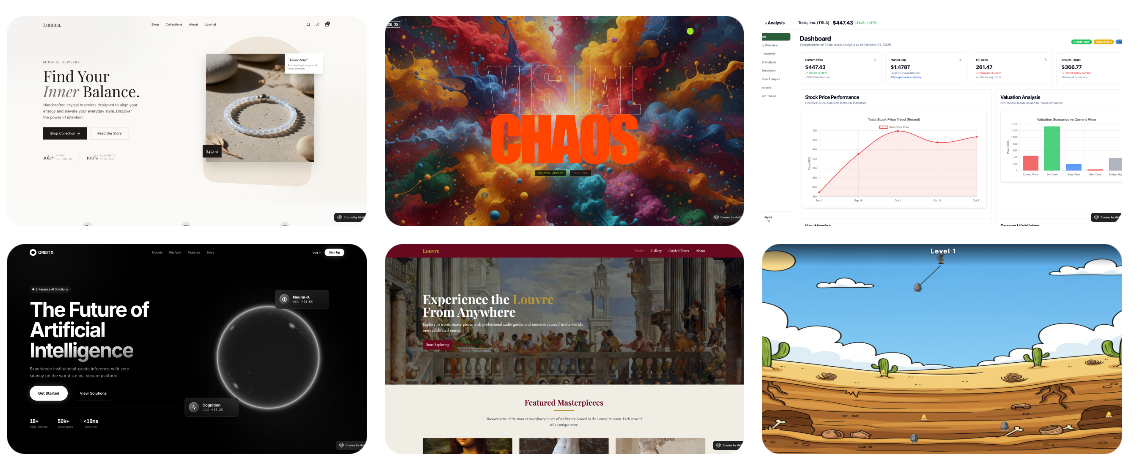
การเขียนโค้ดขั้นสูงและการวางแผนแบบ Agent ด้วย MiniMax M2.5
MiniMax M2.5 รองรับภาษาโปรแกรมมากกว่า 10 ภาษา รวมถึง Rust, Go และ Python เพื่อช่วยให้พัฒนา full-stack ได้อย่างครอบคลุมบนแพลตฟอร์ม Web, mobile และ desktop ด้วยการผสานความรู้เชิงลึกของอุตสาหกรรมสำหรับการจัดรูปแบบเอกสารระดับมืออาชีพและการสร้างแบบจำลองทางการเงิน จึงช่วยให้เปลี่ยนผ่านจากการออกแบบสถาปัตยกรรมระบบไปสู่การทดสอบชิ้นงานส่งมอบขั้นสุดท้ายได้อย่างราบรื่น นี่คือโซลูชันที่ชัดเจนสำหรับงานวิศวกรรมซอฟต์แวร์ที่ซับซ้อนและเวิร์กโฟลว์งานสำนักงานที่มีความสำคัญสูง
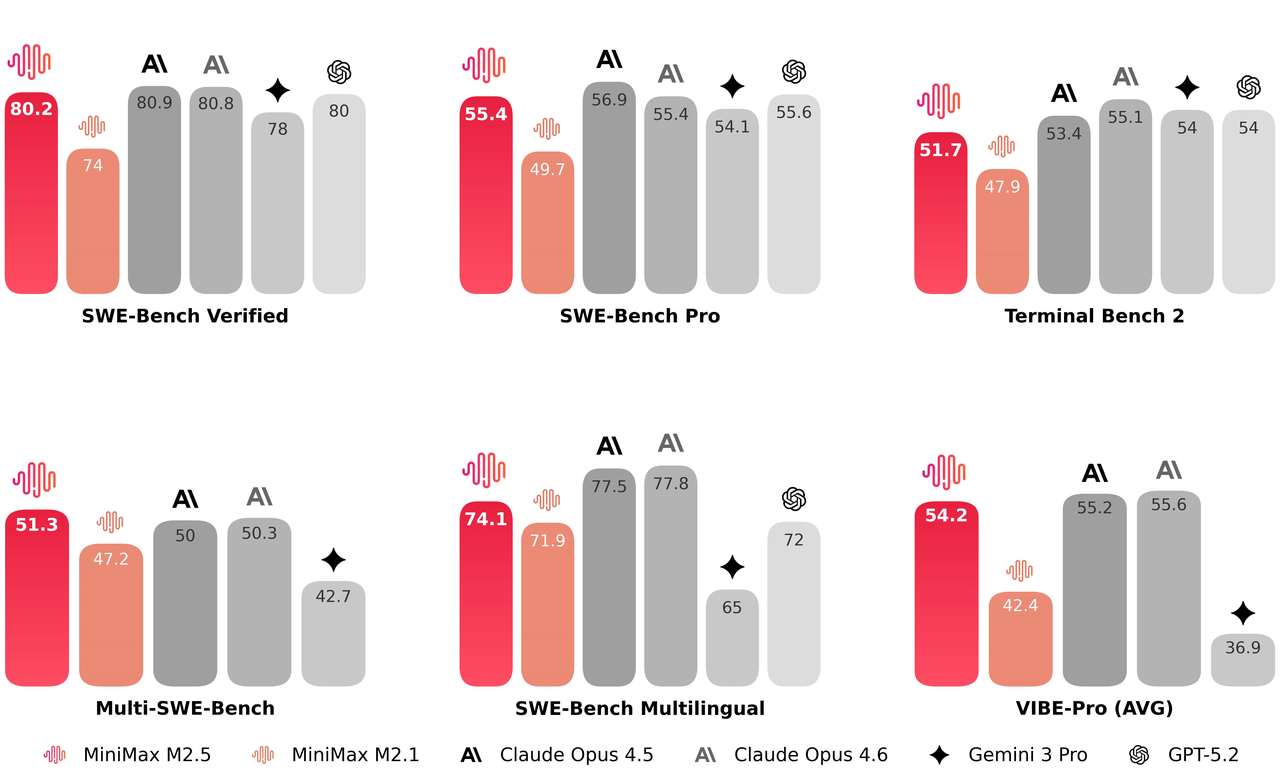
การตอบสนองรวดเร็วและการตัดสินใจงานอย่างมีประสิทธิภาพด้วย MiniMax M2.5
สถาปัตยกรรม M2.5 เพิ่มความเร็วในการดำเนินงานแบบ end-to-end ได้ 37% ช่วยลดเวลาของงานซับซ้อนบน SWE-bench จาก 31.3 นาทีเหลือ 22.8 นาทีอย่างมีนัยสำคัญ ด้วยการปรับตรรกะการแยกงานให้เหมาะสม โมเดลใช้ tokens และรอบการค้นหาน้อยลง 20% เพื่อไปถึงเป้าหมายใน benchmark อย่าง BrowseComp จึงเป็นโซลูชันที่คล่องตัวสำหรับการตัดสินใจความเร็วสูง พร้อมลด overhead การประมวลผลที่ซ้ำซ้อน
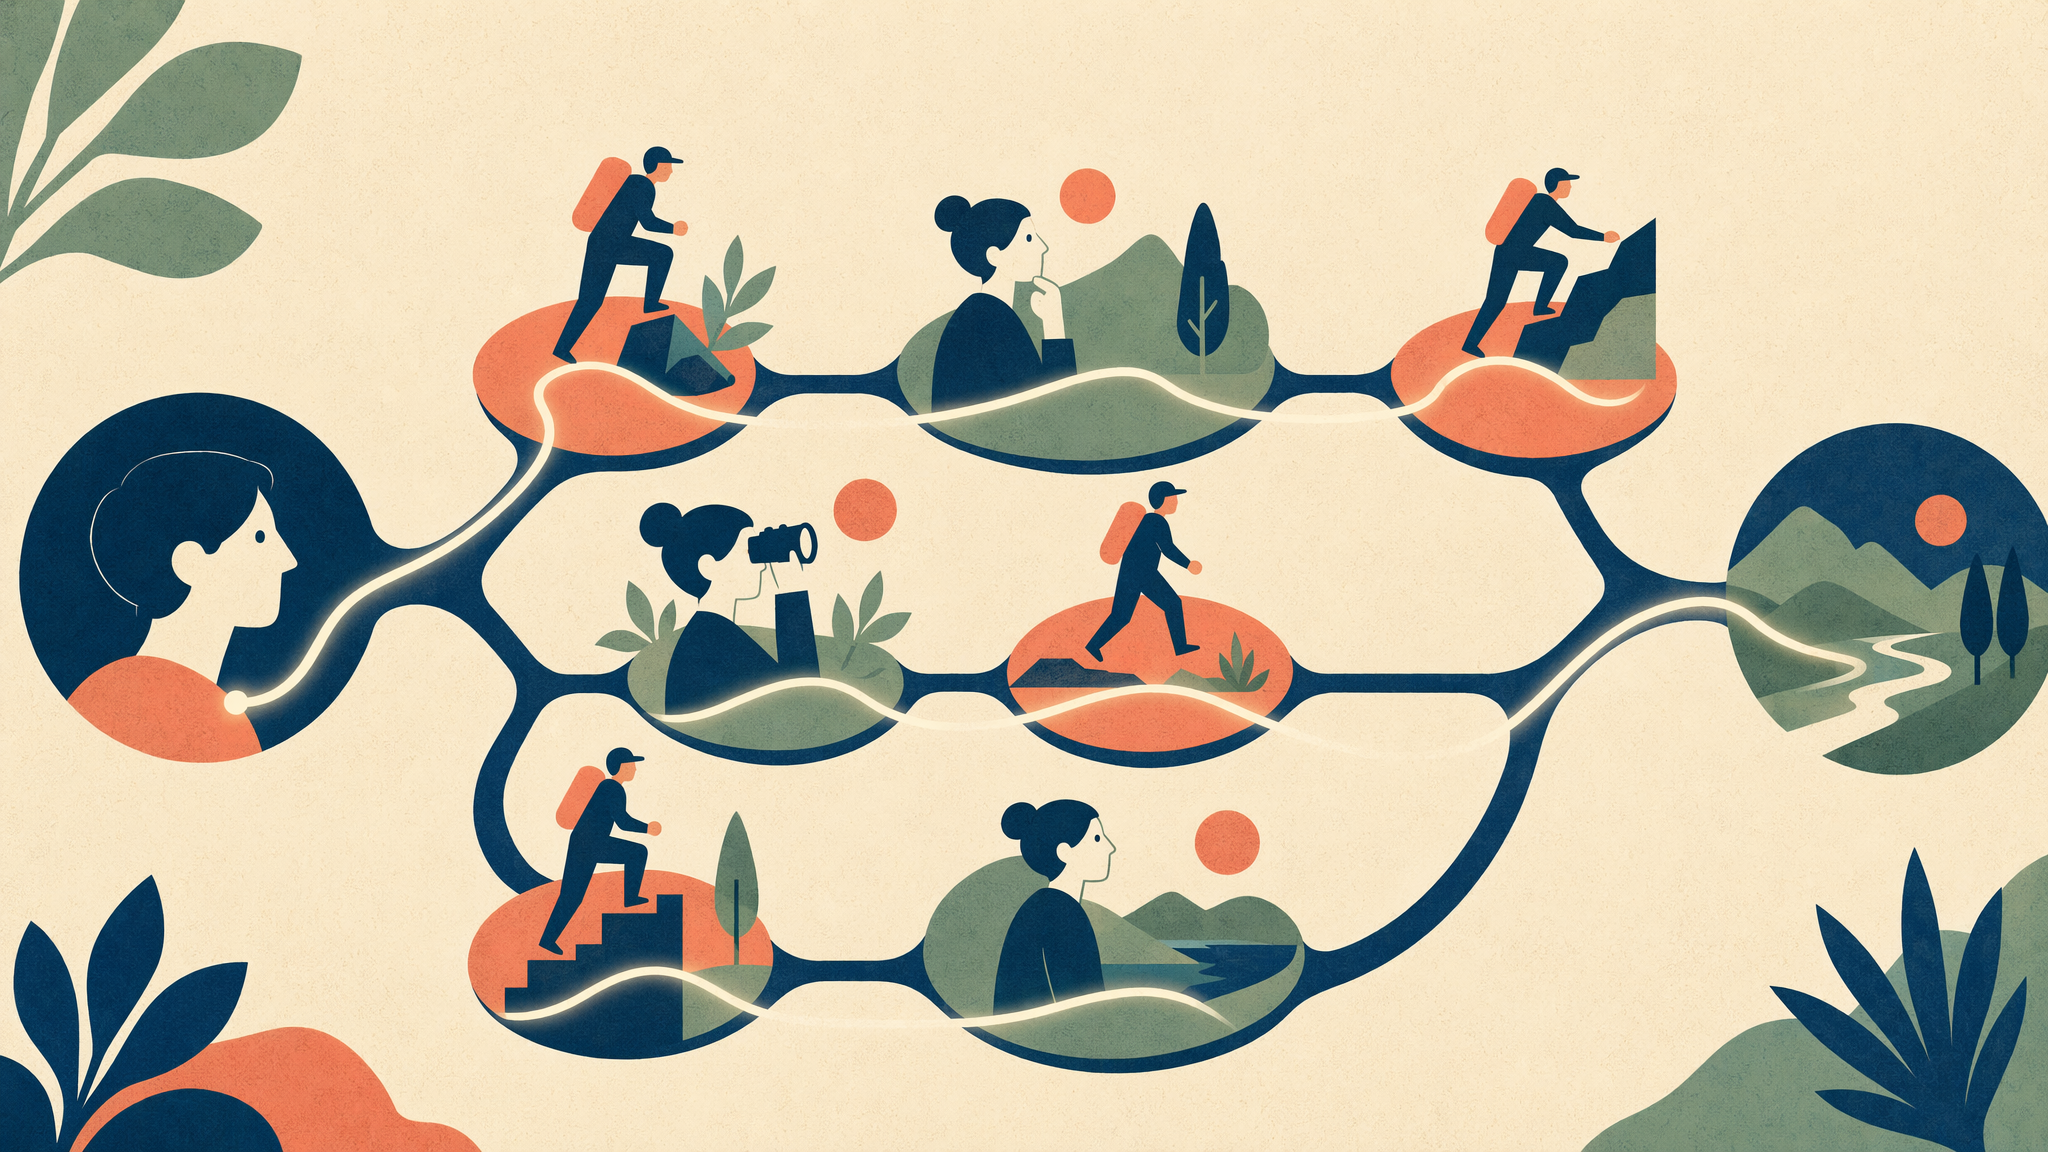
การคิดแบบสลับขั้นที่คงเหตุผลเดิมไว้
Reasoning tokens จะถูกเก็บรักษาไว้ระหว่างแต่ละ turn ทำให้โมเดลกลับมาทำงานต่อในแต่ละขั้นของบทสนทนา agent แบบหลาย turn ได้โดยยังคงกระบวนการคิดก่อนหน้าไว้อย่างครบถ้วน การคิดแบบสลับขั้นนี้ช่วยให้โมเดลวางแผน ลงมือทำ สังเกตผล และปรับปรุงต่อได้โดยไม่ทิ้งตรรกะที่พาไปถึงจุดนั้น ผลลัพธ์คือการตัดสินใจระยะยาวที่เสถียรกว่า ซึ่งเป็นข้อได้เปรียบสำคัญเมื่อหนึ่งงานต้องเรียกใช้เครื่องมือต่อเนื่องหลายครั้ง
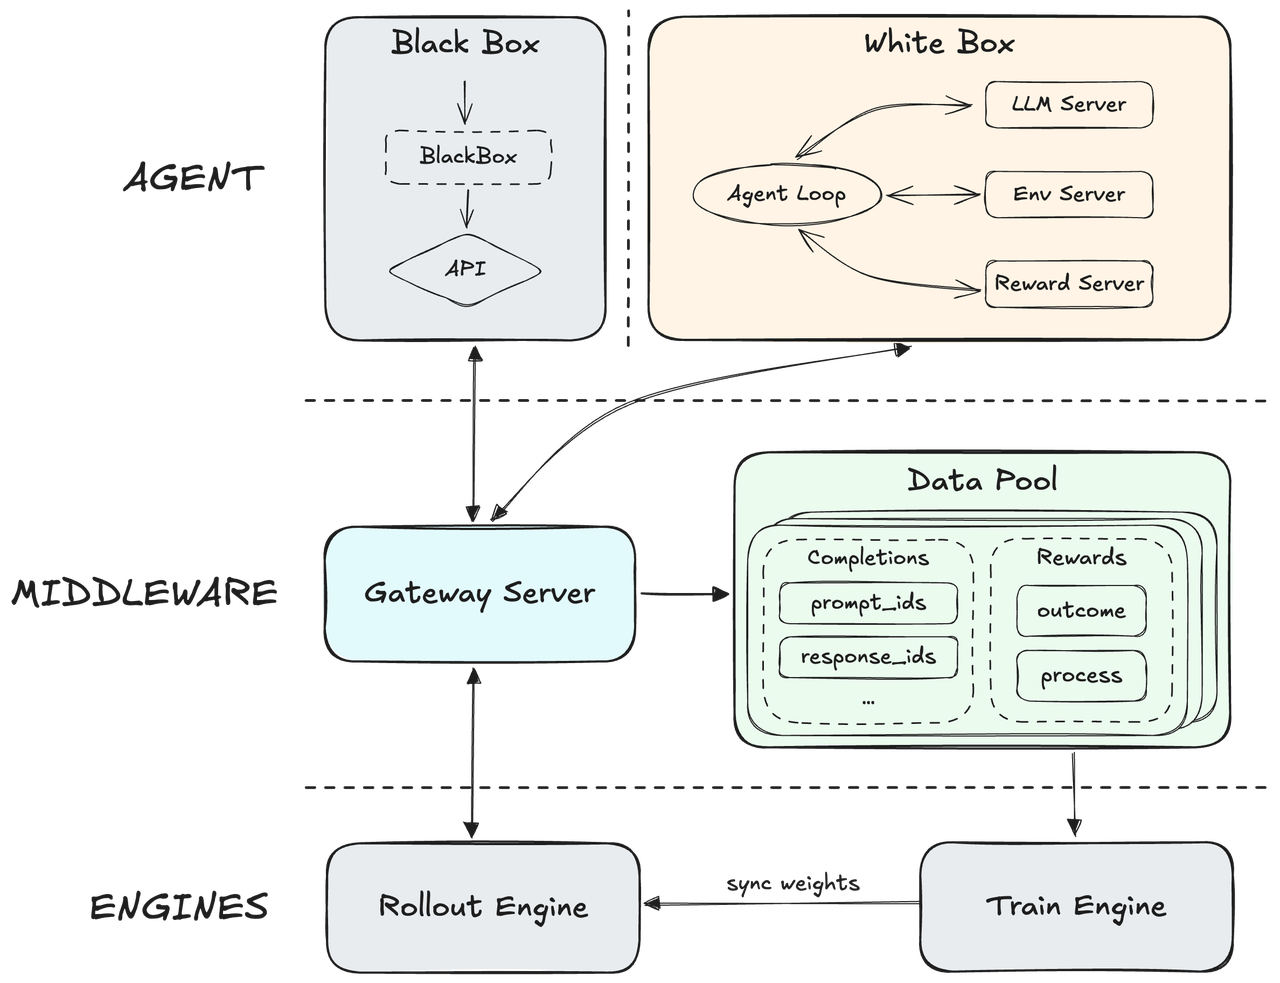
สถาปัตยกรรมเชิงวิวัฒนาการผ่าน RL ขนาดใหญ่ด้วย MiniMax M2.5
MiniMax สร้างบนเฟรมเวิร์ก Agent RL แบบ native โดยแยก engine หลักออกจาก agent scaffolding เพื่อให้ทำงานได้ทั่วไปในสภาพแวดล้อมจริงที่หลากหลายนับแสนแบบ ระบบผสานกลไก process reward ขั้นสูงที่ใช้ feedback จากการดำเนินงานแบบเรียลไทม์เพื่อปรับเส้นทางการให้เหตุผลและรับประกันคุณภาพผลลัพธ์ระดับสูงสุด สิ่งนี้สร้างระบบที่ปรับตัวได้สูง สามารถรักษาความแม่นยำเหนือชั้นพร้อมเพิ่มความเร็วการตอบสนองเชิงปฏิบัติการโดยรวมให้สูงสุด
Context Window ขนาด 196K-Token ใน MiniMax API
ทุก request ไปยัง MiniMax M2.1 มาพร้อม context window ขนาด 196,608-token ซึ่งกว้างพอสำหรับ monorepo ขนาดใหญ่ เอกสารสเปกหลายร้อยหน้า หรือ transcript ของ agent ที่ยาวมากได้ในครั้งเดียว เมื่อภาพรวมทั้งหมดยังคงอยู่ในบริบท โมเดลจึงติดตาม dependency ข้ามไฟล์ได้แทนที่จะหลุดประเด็นกลางงาน ทีมที่ทำงานกับ codebase ขนาดใหญ่และคลังงานวิจัยที่หนาแน่นจะได้ความสอดคล้องต่อเนื่องที่โมเดล context สั้นไม่อาจเทียบได้
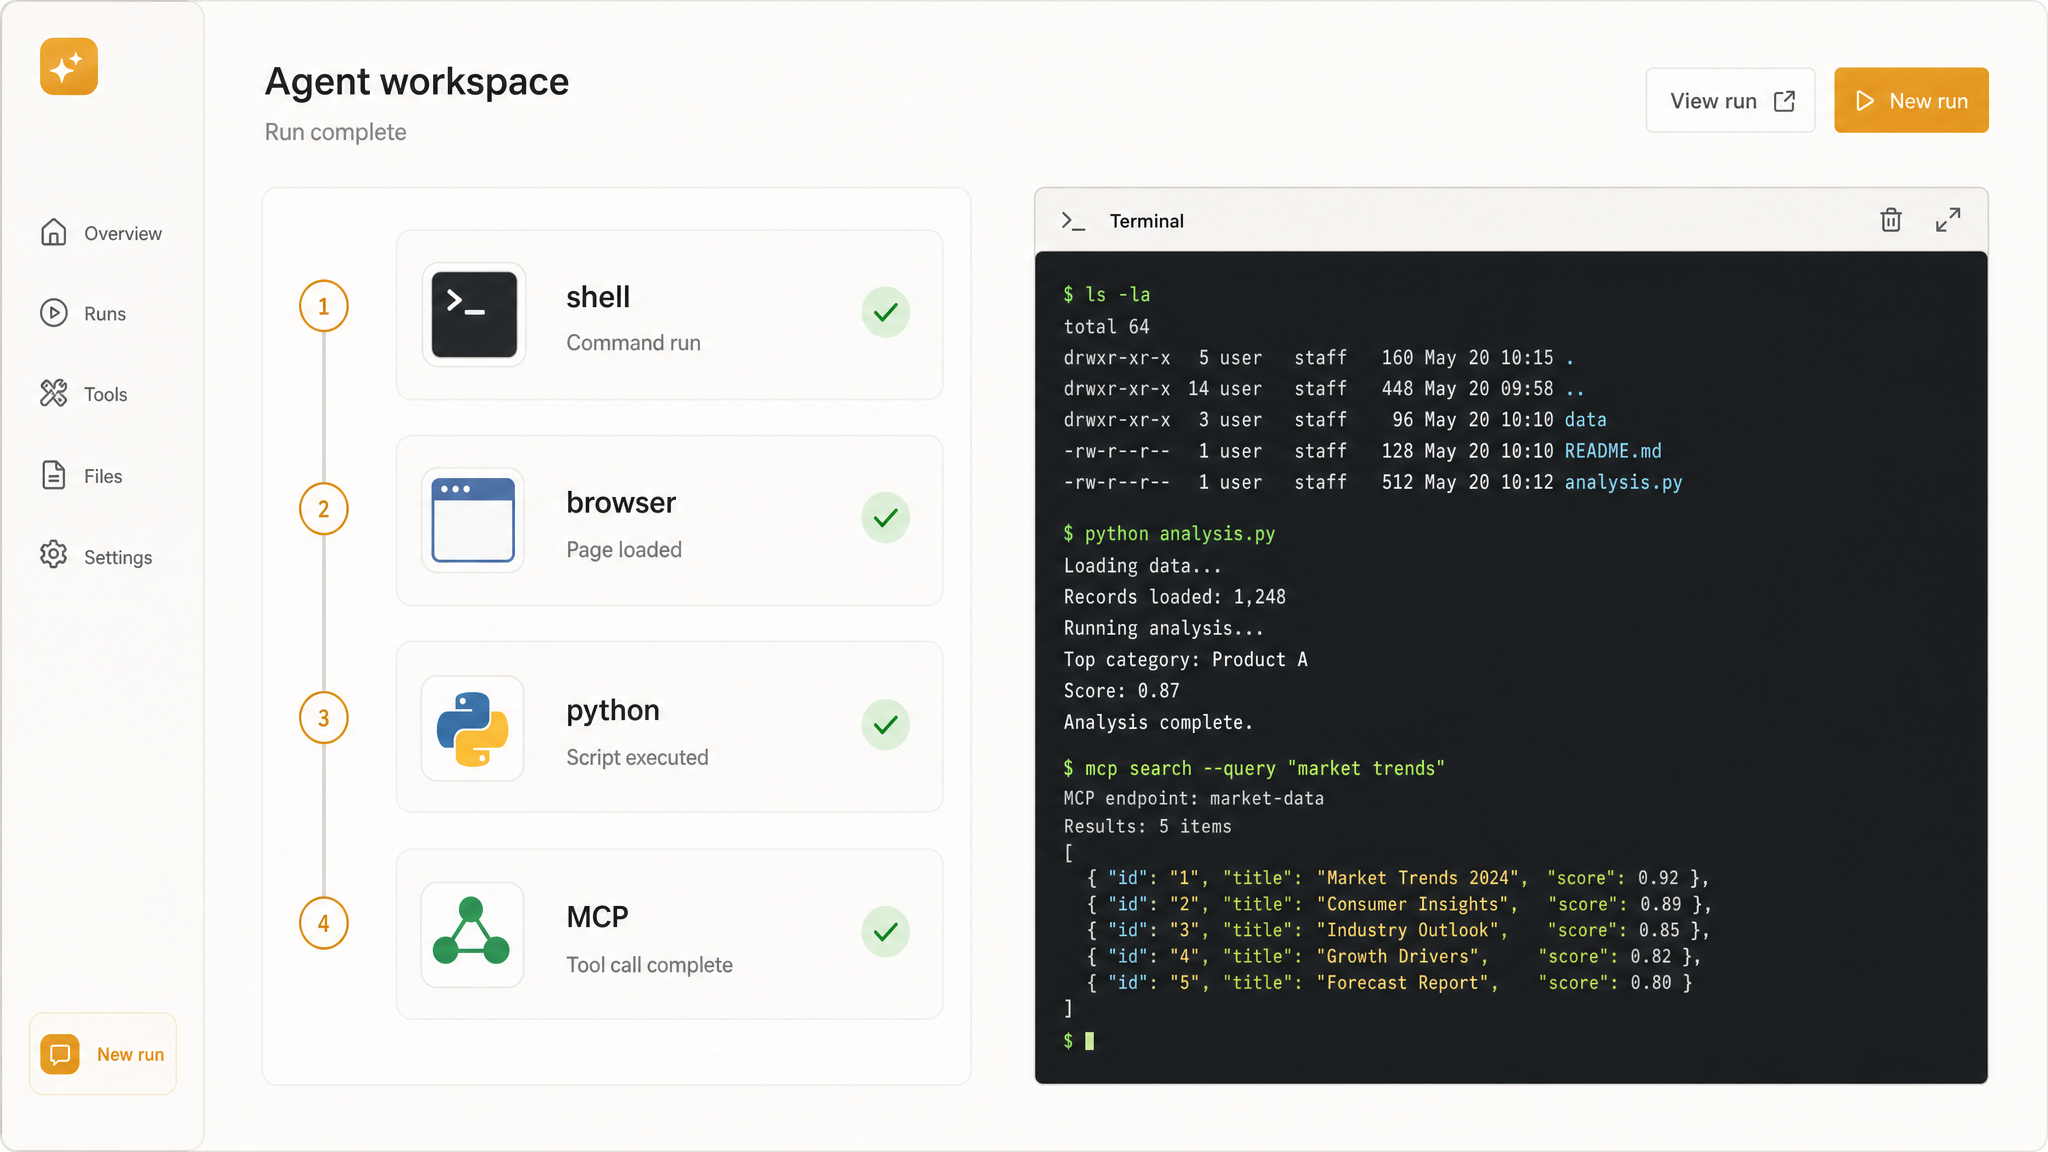
ควบคุม Shell, Browser และ Code ด้วย MiniMax API
Function calling เปลี่ยน MiniMax M2.1 ให้เป็น agent เชิงรุกที่ประสาน shell commands, browser sessions, การรัน Python และ MCP tools ในแผนงานระยะยาว โมเดลสามารถเชื่อมต่อขั้นตอนหลายสิบขั้น อ่าน feedback จากการรัน และแก้ไขตัวเองแทนที่จะหยุดที่ผลลัพธ์แรก ด้วยคะแนน 47.9 percent บน Terminal-bench 2.0 จึงเป็นรากฐานที่เชื่อถือได้สำหรับ loop การ build, test และ deployment แบบอัตโนมัติ
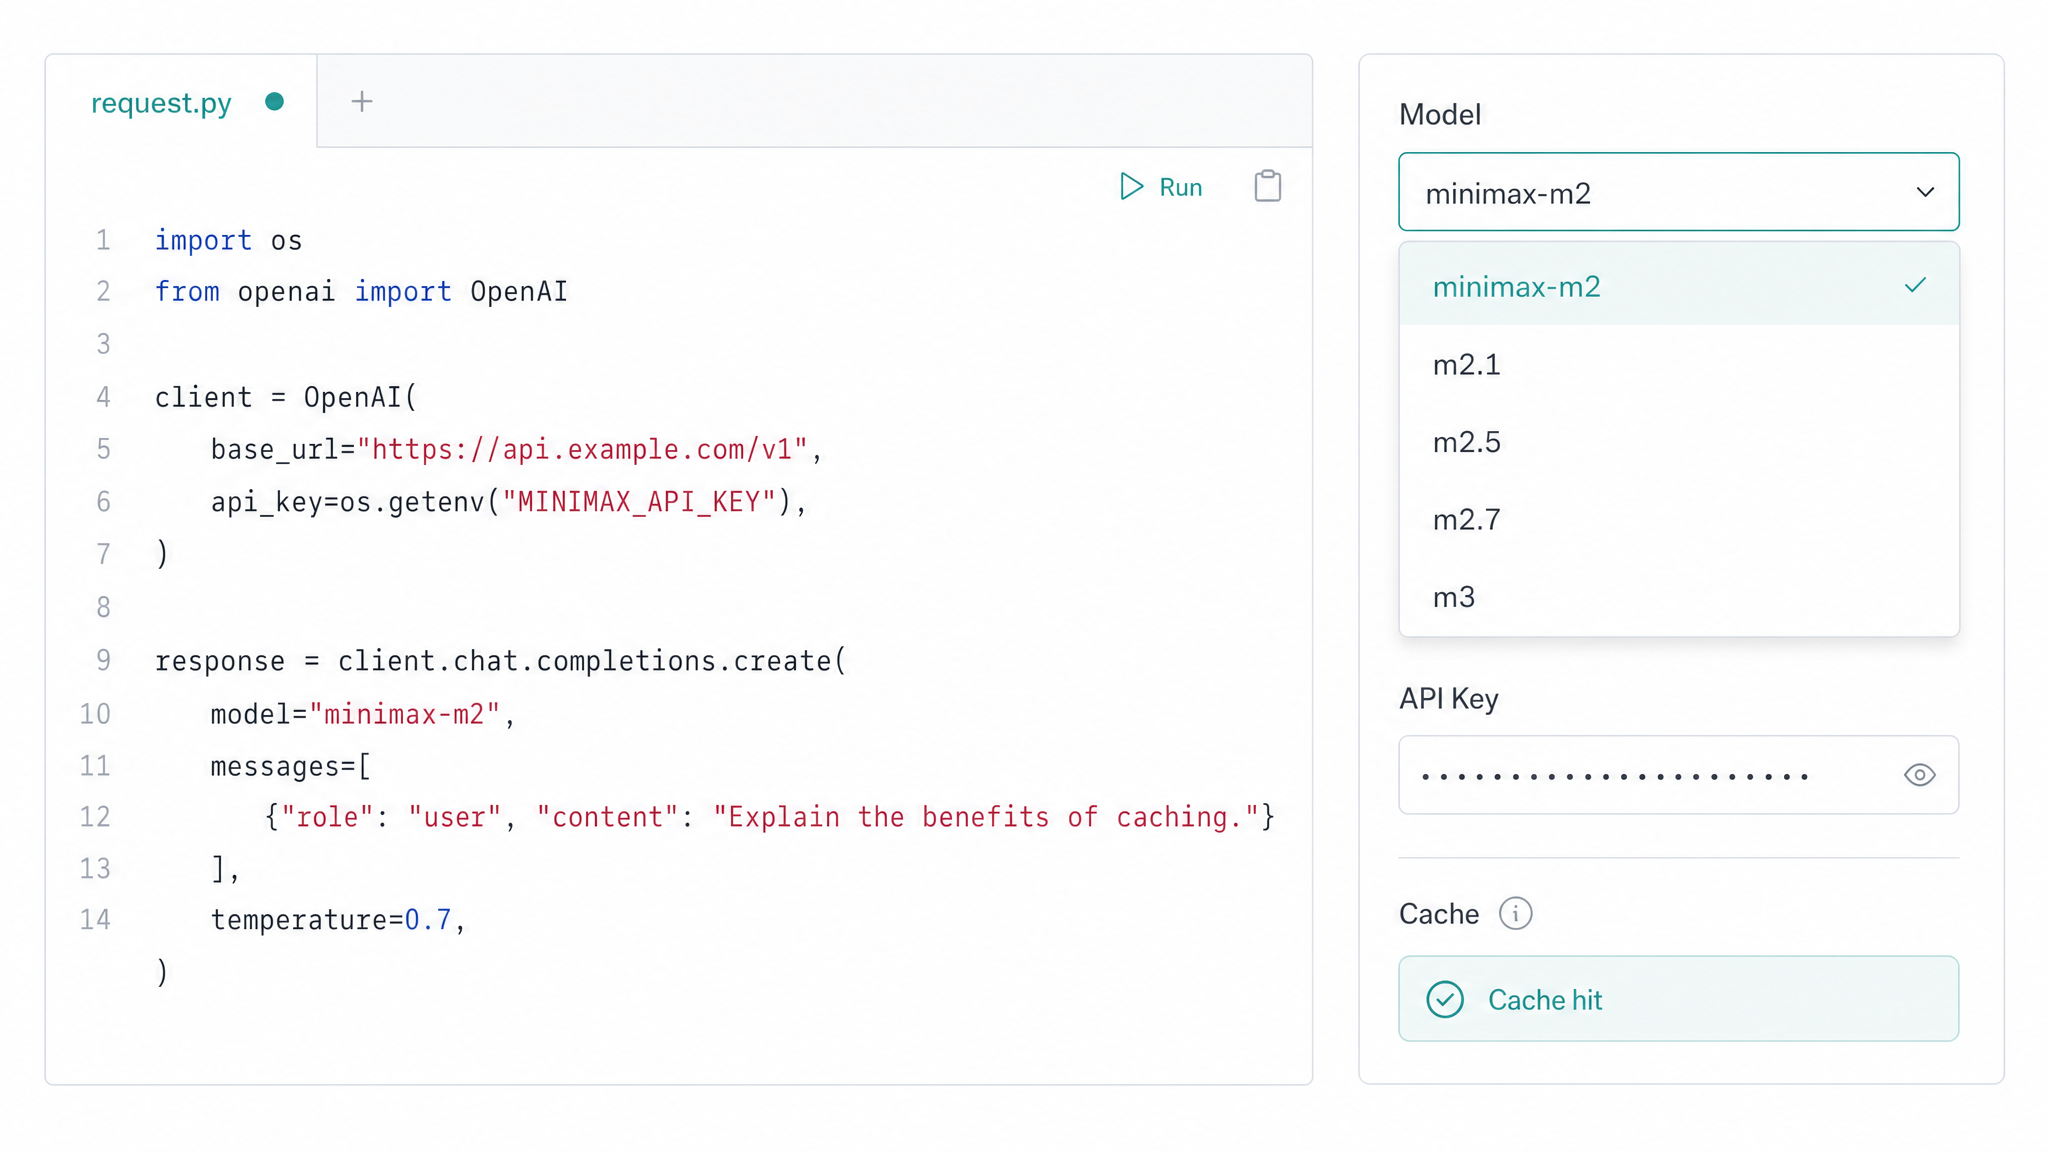
MiniMax API Key เดียวสำหรับทุกระดับโมเดล
คีย์เดียวที่เข้ากันได้กับ OpenAI ปลดล็อกไลน์อัป MiniMax ทั้งหมด ตั้งแต่ M2 และ M2.1 ไปจนถึง M2.5, M2.7 และ M3 พร้อมการเข้าถึงผ่าน Anthropic SDK และ raw HTTP เปลี่ยน tier ได้ด้วยการแก้ model string เพียงรายการเดียว โดยไม่ต้องปรับโครงสร้าง stack ของคุณใหม่ Prompt caching คิดค่าบริบทที่ซ้ำกันที่ $0.03 ต่อหนึ่งล้าน tokens ทำให้ loop ของ agent แบบวนซ้ำและ system prompts ที่ยาวยังคงคุ้มค่าเมื่อใช้งานในสเกลใหญ่
หนึ่งพรอมป์ สามโมเดล: ศึกประชันเขียนโค้ดด้วย MiniMax API
ป้อนพรอมป์สำหรับสร้างงานเดียวกันให้ MiniMax API และโมเดลคู่แข่งอีกสองตัว แล้วดูว่าแต่ละตัวเปลี่ยนคำสั่งเดียวให้กลายเป็นเว็บเพจไฟล์เดียวที่ใช้งานได้อย่างไร
หน้า HTML ไฟล์เดียวที่สะอาด ประณีต และทำงานได้ครบในตัวเอง (ใช้เฉพาะ inline CSS และ JavaScript เท่านั้น — ห้ามใช้ไลบรารีภายนอก, CDNs, ฟอนต์ หรือ URL รูปภาพโดยเด็ดขาด; ทุกพื้นผิวต้องสร้างจาก CSS gradients, box-shadows และ inset shadows ล้วน ๆ) ที่เรนเดอร์เวิร์กเบนช์จัดเรียงตัวพิมพ์ LETTERPRESS แบบ skeuomorphic และโต้ตอบได้: เติมเต็ม viewport ด้วยพื้นโต๊ะทำงานไม้ walnut โทนอุ่น (ไล่ระดับสีน้ำตาลซ้อนชั้น + ลายไม้ละเอียดจาก repeating linear-gradients และจุดเงาคล้าย noise) ส่องสว่างด้วยโคม tungsten อุ่นดวงเดียวจากมุมซ้ายบน เพื่อให้ชิ้นส่วนโลหะปัดเงารับไฮไลต์สะท้อนนุ่ม ๆ และวัตถุที่นูนขึ้นทุกชิ้นทอดเงายาวนุ่มไปทางขวาล่าง ด้านซ้าย: ถาดเก็บตัวพิมพ์แบบแบ่งช่อง (California job case) พร้อมช่องตารางที่บรรจุชิ้นตัวพิมพ์ตะกั่วนูนจิ๋ว (ตัวอักษร ตัวเลข เครื่องหมายวรรคตอน) โดยแต่ละชิ้นเป็นแท่งโลหะขอบ bevel พร้อม glyph แบบนูนและกลับด้านเหมือนกระจกบนผิวหน้า ตรงกลาง: composing stick / galley tray แบบเปิดที่ตัวพิมพ์ที่จัดแล้วจะค่อย ๆ สะสมอยู่ภายใน จัดเตรียมโฟลว์การเรียงพิมพ์ที่ใช้งานได้จริงครบถ้วน: (1) ผู้ใช้พิมพ์บนแป้นพิมพ์จริง หรือคลิก glyph ในถาดตัวพิมพ์ และสำหรับอักขระแต่ละตัว ชิ้นตัวพิมพ์ตะกั่วจะเคลื่อนไหวบินออกจากช่องของมันแล้วตกลงใน composing stick พร้อมแอนิเมชันเด้งจบแบบ "แกร๊ก" สั้น คม และลงตัว; (2) บล็อกเว้นระยะตะกั่วบาง ๆ ระหว่างตัวพิมพ์สามารถลากได้ เพื่อให้ผู้ใช้ปรับ letter-spacing/kerning โดยลาก พร้อม reflow เลย์เอาต์แบบสด; (3) ลูกกลิ้งหมึกที่หมุนได้ (brayer) ให้ผู้ใช้ลากผ่าน forme ที่ล็อกไว้ ทิ้งความเงาของหมึก deep-indigo มันวาว (มีแอนิเมชันแสงสะท้อน specular เคลื่อนที่) บนหน้าตัวพิมพ์ที่นูน; (4) คันโยกกดพิมพ์แบบดึงลงที่ผู้ใช้กดได้ (click-and-hold หรือปุ่ม) ซึ่งลดแผ่นกระดาษ laid paper สีครีมลงเหนือ forme ที่ลงหมึกแล้วและประทับพิมพ์ — ช่วงไคลแมกซ์คือคันโยกดีดกลับ ขณะที่บรรทัดที่พิมพ์ใหม่ปรากฏบนกระดาษด้วย typography แบบ letterpress ที่ยุบลึกอย่างสมจริง: ตัวอักษรแต่ละตัวถูกกดลงในเนื้อกระดาษด้วย inset shadow ที่ให้ความรู้สึกเป็นรอยบุ๋มจริง หมึกซึม/ฟุ้งเล็กน้อยเข้าไปในลายเส้นใยกระดาษที่มองเห็นได้ และมี halo รอยกด plate จาง ๆ รอบบล็อก โทนสี: burnt umber, brushed brass gold และ warm cream/rice-paper off-white เป็นหลัก โดยมี deep indigo ink เป็นสำเนียงโทนเย็นเพียงสีเดียว ใส่รายละเอียดเชิงสัมผัส: brass thumbscrews, quoin lock, ปุ่มโทนไม้พร้อมสถานะ pressed/active ที่สมจริง และ easing ที่น่าพอใจในทุก transition (spring-like cubic-bezier) ทำให้ responsive (ย่อขนาดลงถึงความกว้างระดับ tablet ได้อย่างงดงาม), เก็บ state ทั้งหมดใน vanilla JS และให้ผู้ใช้แต่งบรรทัดบทกวีสั้น ๆ ได้เต็มบรรทัด ลงหมึก และดึงงานพิมพ์ที่ชื่นชมด้วยสายตาได้ — ทุกอย่างต้องให้ความรู้สึกทำมือ หนักแน่น และมีพิธีรีตอง โดยถ่ายทอดฟิสิกส์ของการตก การลาก และการกดประทับผ่านการเคลื่อนไหวและเงา แทนการใช้ asset ภายนอกใด ๆ
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
สร้างไฟล์ HTML เดี่ยวที่สมบูรณ์และทำงานได้ครบในตัวเอง เปิดได้โดยตรงในเบราว์เซอร์สมัยใหม่ทุกตัวโดยไม่มี dependency ภายนอกเลย — CSS และ JavaScript ทั้งหมดต้องเป็น inline และห้ามใช้ไลบรารีภายนอก, CDNs, ฟอนต์ หรือ URL รูปภาพ (วาดทุกอย่างด้วย Canvas 2D หรือ SVG ที่สร้างจากโค้ด) สร้าง "Brass Gear Train Workbench" แบบโต้ตอบได้: เครื่องจำลองเฟืองกลไกแบบประกอบติดกันบนพื้นโต๊ะพิมพ์เขียววิศวกรรมที่มีฝุ่นบาง ๆ ซึ่งผู้ใช้ประกอบ geartrain ที่ทำงานได้จริงและดูการหมุนที่แม่นยำตามฟิสิกส์ส่งต่อไปตลอดโซ่กลไก ข้อกำหนดหลักด้านการโต้ตอบและการจำลอง: - เรนเดอร์เวทีหลักเป็นพื้นผิวโต๊ะเขียนแบบพิมพ์เขียว: กริดสี cyan ละเอียดบนกระดาษสีน้ำเงินวิศวกรรมเข้ม พร้อมฝุ่นบาง ๆ และ vignette จาง ๆ รวมถึงขีดบอกระยะและ annotation งานเขียนแบบตามขอบ - จัดให้มีถังอะไหล่/แถบด้านซ้ายที่เก็บเฟืองหลายขนาดแตกต่างกัน (จำนวนฟัน / module ต่างกัน เช่น 12, 18, 24, 36, 48 teeth) ผู้ใช้ลากเฟืองจากถังลงบนเวที และเมื่อปล่อยจะ snap เข้ากับกริด - เฟืองแต่ละตัวต้องวาดเป็นล้อฟันเฟืองสไตล์ involute จริงในโทน brass — ตัวเรือนสีทองอุ่น ขอบ aged copper-patina ไฮไลต์สี ivory มี hub, spokes และ center bore ที่มองเห็นได้ — พร้อมเงา bevel ละเอียดเพื่อให้โลหะดูเป็นโลหะจริง - ใช้การตรวจจับ mesh ของจริง: เมื่อเฟืองสองตัวที่วางแล้วมีระยะห่างศูนย์กลางเท่ากับผลรวมของ pitch radii (module × teeth / 2) ภายใน tolerance เฟืองจะเข้าขบกันอัตโนมัติและล็อกเป็น driven chain; วาดตัวบ่งชี้ meshing ในตำแหน่งที่ฟันเฟืองสอดประสานกัน โซ่สามารถแตกแขนงผ่านเฟืองหลายตัวได้ - วาง crank handwheel ที่มุมซ้ายล่างให้เป็นต้นกำเนิดทั้งด้านภาพและกลไก ผู้ใช้หมุน crank ได้ (ลากเพื่อหมุน หรือกดปุ่มค้างไว้); จากนั้นโซ่ที่ mesh ทั้งหมดจะหมุนต่อเนื่องกันเป็นลำดับ คำนวณ angular velocity และทิศทางของเฟือง downstream แต่ละตัวอย่างเคร่งครัดจาก gear ratio (ω_out = ω_in × N_in / N_out, ทิศทางสลับกันทุก mesh) และทำแอนิเมชันให้ฟันเฟืองคง phase-locked ที่จุดสัมผัสอย่างสมบูรณ์ เพื่อไม่ให้เห็นฟันซ้อนทับหรือทะลุผ่านกัน - เฟืองตัวสุดท้ายในโซ่ขับเข็ม pointer needle บน dial gauge ที่มีตัวเลข เข็มต้องแสดงค่าจริงที่ได้จาก cumulative gear ratio (แสดง output RPM ที่คำนวณแล้วและ total ratio เป็นข้อความแบบสด) - หากผู้ใช้พยายามวางเฟืองที่รูปทรงฟันไม่สามารถ mesh ได้ (spacing/module ไม่เข้ากัน) จุดต่อนั้นต้อง jam: กะพริบสีแดง หยุดการส่งแรงผ่านจุดต่อเสีย และแสดงคำเตือนเล็ก ๆ ว่า "tooth mismatch" - เพิ่มลำแสง: ลำแสงแดดยามเช้าโทนอุ่นเฉียงจากหน้าต่างด้านบนพาดผ่านเวที พร้อมฝุ่น motes ลอยเคลื่อนในลำแสง และ glints แบบ specular โทนอุ่นเลื่อนไปตามฟันเฟืองขณะหมุน เพื่อให้เครื่องจักรดูเหมือนกำลังตื่นขึ้น งานภาพและ UX polish: - แนวทางศิลป์: เส้นวาดมือแบบวิศวกรรมย้อนยุคผสานโลหะ photoreal — กริดละเอียดแบบ blueprint ซ้อนใต้ brass, aged bronze, patina green-blue และ ivory white; แสงด้านข้างโทนอุ่นพร้อมเงาทอดนุ่มยาวเพื่อปั้นปริมาตรและความลึก - องค์ประกอบภาพควรทำให้ crank อ่านได้ชัดว่าเป็นจุดเริ่มต้น โดยมี drive chain ตัดเฉียงข้ามเฟรม - ใส่ HUD ที่ไม่รก แสดง crank speed, total gear ratio, output RPM และ gear count พร้อม controls เล็ก ๆ สำหรับ reverse crank, clear stage และปรับ crank speed ด้วย slider - ทุกอย่างต้องลื่นไหล (requestAnimationFrame), responsive ต่อขนาดหน้าต่าง และทำงานโต้ตอบต่อเนื่อง — การลาก, snapping, meshing และการอัปเดตค่าที่อ่านได้ต้องตอบสนองแบบ real time ทั้งหมด ทำให้รู้สึกจับต้องได้ แม่นยำ และมีชีวิต
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
พัฒนาซอฟต์แวร์ระดับโปรดักชันด้วย MiniMax API
จากการบิลด์ฟูลสแตกหลายภาษาไปจนถึงเอเจนต์สำนักงานอัตโนมัติ MiniMax API จะเปลี่ยนความลึกในการเขียนโค้ดและการใช้เครื่องมือระยะยาวของ M2.1 ให้เป็นเวิร์กโฟลว์ที่ทีมของคุณส่งมอบได้ทุกวัน

การพัฒนาฟูลสแตกข้ามหลายภาษา
MiniMax M2.1 เขียนและรีวิวโค้ดระดับโปรดักชันใน Rust, Go, TypeScript, C++ และภาษาอื่น ๆ ครอบคลุมตั้งแต่ระบบระดับล่างไปจนถึงเลเยอร์แอปพลิเคชัน ทีมที่สร้างบริการแบบ polyglot ใช้มันเพื่อรักษาความสอดคล้องในทุกชั้นของระบบ

แอปมือถือแบบเนทีฟผ่าน MiniMax API
เมื่อฟีเจอร์ Android และ iOS ต้องปล่อยพร้อมกัน MiniMax API จะสร้าง Kotlin, Swift และ Objective-C ที่สอดคล้องกับแนวทางของแต่ละแพลตฟอร์ม ช่วยให้ทีมขนาดเล็กดูแลทั้งสองสโตร์ได้โดยไม่ต้องแยกกำลังวิศวกรรม

เอเจนต์เขียนโค้ดอัตโนมัติบน MiniMax API
เชื่อม M2.1 เข้ากับลูปเอเจนต์ของคุณผ่าน function calling เพื่อวางแผนงานหลายขั้นตอน เรียกใช้เครื่องมือ และแก้ไขตัวเองได้ตลอดงานระยะยาว นักพัฒนาใช้สิ่งนี้เพื่อสร้างผู้ช่วยที่ปิดทิกเก็ตจริงได้ ไม่ใช่แค่สร้างโค้ดสั้น ๆ

พนักงานดิจิทัลสำหรับเวิร์กโฟลว์สำนักงาน
ในบทบาทพนักงานดิจิทัล M2.1 ดำเนินงานตั้งแต่ต้นจนจบในด้านงานธุรการ การเงิน วิทยาศาสตร์ข้อมูล และ HR จากคำสั่งภาษาธรรมดา ทีมปฏิบัติการนำไปใช้เพื่อลดงาน back-office ที่ซ้ำซากในระดับใหญ่

การให้เหตุผลทั้งโค้ดเบสด้วยคอนเท็กซ์ 196K
ต้องรีแฟกเตอร์ในรีโพซิทอรีที่ไม่คุ้นเคยหรือไม่? ด้วยหน้าต่างคอนเท็กซ์ 196.61K token, M2.1 อ่านไฟล์ได้หลายร้อยไฟล์พร้อมกัน ติดตาม dependency และชี้ให้เห็นการเปลี่ยนแปลงที่การย้ายระบบต้องการจริง ๆ

อินเทอร์เฟซเว็บแบบอินเทอร์แอคทีฟด้วย MiniMax API
ความเข้าใจด้านดีไซน์ที่แข็งแกร่งช่วยให้ MiniMax API สร้างเว็บฟรอนต์เอนด์ที่ประณีต อินเทอร์แอคชันซับซ้อน และแม้แต่การจำลองฉากวิทยาศาสตร์แบบ 3D ได้ ทีมผลิตภัณฑ์ส่งมอบแดชบอร์ดและ visualization ที่มีข้อมูลหนาแน่นได้โดยตรงจาก prompt
MiniMax API เปรียบเทียบกับ LLMs สำหรับการเขียนโค้ดและเอเจนต์อื่นๆ อย่างไร
เปรียบเทียบ MiniMax API กับโมเดลเอเจนต์และการเขียนโค้ดของคู่แข่งบน Atlas Cloud พร้อมวิเคราะห์เจาะลึกเกี่ยวกับหน้าต่างบริบท ขีดจำกัดผลลัพธ์ และราคาโทเค็นแบบจ่ายตามการใช้งานจริง (pay-as-you-go)
| Model | Context Window | Max Output | Input Price ($/1M) | Output Price ($/1M) |
|---|---|---|---|---|
| MiniMax M3 | 524K tokens | 512K tokens | $0.60 / $1.20 (>512K) | $2.40 / $4.80 (>512K) |
| MiniMax M2.7 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| MiniMax M2.5 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| Kimi K2.7 Code | 262K tokens | 262K tokens | $0.95 | $4.00 |
| GLM 4.7 | 203K tokens | 203K tokens | $0.60 | $2.20 |
| DeepSeek V4 Flash | 1M tokens | 393K tokens | $0.14 | $0.28 |
วิธีใช้ MiniMax บน Atlas Cloud
เริ่มต้นได้ในไม่กี่นาที — ทำตามขั้นตอนง่าย ๆ เหล่านี้เพื่อเชื่อมต่อและใช้งานโมเดลผ่านแพลตฟอร์ม Atlas Cloud
สร้างบัญชี Atlas Cloud
สมัครสมาชิกที่ atlascloud.ai และยืนยันตัวตน ผู้ใช้ใหม่จะได้รับเครดิตฟรีเพื่อสำรวจแพลตฟอร์มและทดสอบโมเดล
ทำไมต้องใช้ MiniMax บน Atlas Cloud
การรวมโมเดล MiniMax ขั้นสูงเข้ากับแพลตฟอร์มที่เร่งด้วย GPU ของ Atlas Cloud ให้ประสิทธิภาพ ความสามารถในการขยาย และประสบการณ์นักพัฒนาที่ไม่มีใครเทียบได้
ประสิทธิภาพและความยืดหยุ่น
เวลาแฝงต่ำ:
inference ที่ปรับแต่ง GPU เพื่อการตอบสนองแบบเรียลไทม์
API แบบรวมศูนย์:
รัน MiniMax, GPT, Gemini และ DeepSeek ด้วยการเชื่อมต่อเดียว
ราคาโปร่งใส:
ชำระเงินต่อโทเค็นที่คาดเดาได้พร้อมตัวเลือก serverless
องค์กรและขนาด
ประสบการณ์นักพัฒนา:
SDK, การวิเคราะห์, เครื่องมือปรับแต่ง และเทมเพลต
ความน่าเชื่อถือ:
ความพร้อมใช้งาน 99.99%, RBAC และการบันทึกที่พร้อมสำหรับการปฏิบัติตาม
ความปลอดภัยและการปฏิบัติตาม:
SOC 2 Type II, สอดคล้อง HIPAA, อธิปไตยข้อมูลในสหรัฐอเมริกา
ตอบคำถามเกี่ยวกับ MiniMax API
MiniMax API ช่วยให้นักพัฒนาเข้าถึงตระกูลโมเดลภาษาขนาดใหญ่ของ MiniMax ที่สร้างโดย MiniMax AI ผ่านโปรแกรมได้ โดยเป็นชุดโมเดลที่ออกแบบมาสำหรับการเขียนโค้ด การใช้เครื่องมือเชิงเอเจนต์ และการให้เหตุผลระยะยาว บน Atlas Cloud คุณเข้าถึงโมเดลเหล่านี้ได้ผ่านเอนด์พอยต์เดียวที่เข้ากันได้กับ OpenAI พร้อมราคาจ่ายตามการใช้งานที่โปร่งใส และเข้าถึงรุ่นใหม่ได้ตั้งแต่ Day-0
Atlas Cloud ให้บริการโมเดลข้อความในตระกูล M-series รวมถึง MiniMax M2.5, MiniMax M2.7 และรุ่นเรือธง MiniMax M3 พร้อมด้วย MiniMax Music 2.6 สำหรับการสร้างเพลงจากข้อความ ทุกโมเดลใช้การยืนยันตัวตนและเอนด์พอยต์เดียวกัน ดังนั้นการสลับโมเดลจึงทำได้ด้วยการเปลี่ยนตัวระบุโมเดลเพียงค่าเดียวในคำขอของคุณ
โมเดลเหล่านี้ได้รับการปรับให้เหมาะกับงานวิศวกรรมซอฟต์แวร์แบบครบวงจร ทั้งการแก้ไขหลายไฟล์ ลูปคอมไพล์-รัน-แก้ไข และการซ่อมแซมโค้ดที่ตรวจสอบด้วยชุดทดสอบในหลายภาษาโปรแกรม นอกจากนี้ยังทำงานได้ดีในบริบทเชิงเอเจนต์ที่ต้องใช้ function calling การวางแผนหลายขั้นตอน และการกู้คืนจากข้อผิดพลาดระหว่างการรัน จึงเหมาะอย่างยิ่งสำหรับเอเจนต์เขียนโค้ดอัตโนมัติและเวิร์กโฟลว์ที่ขับเคลื่อนด้วยเครื่องมือ
เนื่องจาก MiniMax API เข้ากันได้กับ OpenAI คุณจึงสามารถชี้ SDK มาตรฐานของ OpenAI ไปยัง base URL ของ Atlas Cloud ส่ง key ของคุณ และตั้งค่าฟิลด์ model เป็นเวอร์ชันที่ต้องการได้ Streaming, function calling และเอาต์พุตแบบ JSON-structured ล้วนทำงานผ่านอินเทอร์เฟซเดียวกัน ดังนั้นอินทิเกรชันที่มีอยู่ส่วนใหญ่จึงต้องเปลี่ยนเพียง base URL และ key เพื่อเริ่มใช้งาน
ขนาด context window แตกต่างกันตามเวอร์ชัน MiniMax M2 รองรับประมาณ 200K tokens ซึ่งเพียงพอสำหรับโหลด codebase ขนาดใหญ่หรือเอกสารยาว ๆ ในคำขอเดียว ขณะที่ M3 รุ่นใหม่ขยายได้ถึงประมาณ 1 million tokens เลือกใช้โมเดลที่มีบริบทสูงกว่าเมื่อภารกิจของคุณครอบคลุมหลายไฟล์หรือเอกสารอ้างอิงขนาดยาว
การคิดค่าบริการเป็นแบบจ่ายตามการใช้งานและวัดตามจำนวน token โดยไม่ต้องสมัครสมาชิก โมเดลข้อความตระกูล M2-series เริ่มต้นที่ $0.30 ต่อ 1 million input tokens และ $1.20 ต่อ 1 million output tokens ส่วน M3 ที่มีขีดความสามารถสูงกว่ามีราคา $0.60 ต่อ 1 million input tokens และ $2.40 ต่อ 1 million output tokens และ cached input จะคิดค่าบริการในอัตราที่ต่ำกว่า
ใช่ MiniMax ได้เปิดซอร์ส weights ของ M-series ภายใต้ modified MIT license ซึ่งเพิ่มข้อกำหนดเรื่องการแสดงที่มาสำหรับการนำไปใช้งานเชิงพาณิชย์ขนาดใหญ่มาก คุณสามารถ self-host weights เพื่อประเมินผล แล้วค่อยย้ายไปใช้ Atlas Cloud API เมื่อคุณต้องการโครงสร้างพื้นฐานแบบ managed, uptime ที่สม่ำเสมอ และไม่ต้องดูแล GPU เอง
MiniMax มุ่งให้คุณภาพด้านการเขียนโค้ดและงานเชิงเอเจนต์ในระดับ frontier ด้วยต้นทุนเพียงเศษเสี้ยวของโมเดล proprietary ขนาดใหญ่กว่า โดยใช้สถาปัตยกรรม mixture-of-experts ที่เปิดใช้งานพารามิเตอร์เพียงประมาณ 10 billion จากทั้งหมด 230 billion ต่อ token หาก workload ของคุณคือการสร้างโค้ด การ refactor หรือเอเจนต์ที่ใช้เครื่องมือภายใต้งบประมาณจำกัด โมเดลนี้ให้สมดุลที่แข็งแกร่งระหว่างความสามารถ ความเร็ว และราคา อันดับบน benchmark อาจเปลี่ยนไปในแต่ละรุ่น ดังนั้นควรตรวจสอบเวอร์ชันปัจจุบันกับงานของคุณเองก่อนตัดสินใจใช้งานจริง
สำรวจกลุ่มเพิ่มเติม
Seedance 2.5
Seedance 2.5 API พร้อมใช้งานแล้วบน Atlas Cloud! มอบโมเดลวิดีโอใหม่ล่าสุดของ ByteDance ให้กับนักพัฒนา สร้างวิดีโอเนทีฟได้นานถึง 30 วินาทีในการประมวลผลเพียงครั้งเดียวจากข้อความ รูปภาพเดียว หรือการอ้างอิงหลายรูปแบบสูงสุด 50 รายการ พร้อมเสียงที่ซิงโครไนซ์และข้อความหลายภาษาในเฟรม บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่านคีย์เดียว โดยมีความสอดคล้องของวัตถุและระบบฟิสิกส์ที่ได้รับการปรับปรุงซึ่งช่วยให้ภาพระยะยาวมีความต่อเนื่อง

Wan 3.0
Wan 3.0 API คือเจเนอเรชันถัดไปของตระกูลวิดีโอ Wan จาก Alibaba ซึ่งสร้างขึ้นเพื่อยกระดับการสร้างวิดีโอแบบยาว การควบคุมแบบหลายข้อมูลอ้างอิง และคุณภาพของภาพและเสียงให้ก้าวไปอีกขั้น Atlas Cloud ได้โฮสต์ Wan 2.7, 2.6 และ 2.5 ไว้แล้ว และ Wan 3.0 สามารถทำงานบนคีย์แบบรวมเดียวกันโดยไม่ต้องตั้งค่าแยกต่างหาก เริ่มต้นสร้างสรรค์ได้ตั้งแต่วันนี้ เลื่อนลงไปที่ส่วนจัดแสดงเพื่อดูว่า Wan 3.0 สามารถสร้างอะไรได้บ้าง
MiniMax H3
MiniMax H3 คือกลุ่มโมเดลวิดีโอของ MiniMax สำหรับการสร้างวิดีโอจากข้อความ รูปภาพ และข้อมูลอ้างอิง สร้างคลิปความยาว 5 ถึง 15 วินาที กำหนดการเคลื่อนไหวด้วยเฟรมสุดท้ายที่เลือกใช้ได้ รักษาองค์ประกอบของวัตถุจากรูปภาพอ้างอิง หรือเลือก H3 Developer เมื่อเสียงที่สร้างขึ้นเหมาะกับเวิร์กโฟลว์ของคุณ Atlas Cloud รวม H3, H3 Fast, H3 Max และ H3 Developer ไว้ในเวิร์กโฟลว์ API เดียว พร้อมราคาแบบมาตรฐานเริ่มต้นที่ $0.038 ต่อวินาที เริ่มพัฒนาได้แล้ววันนี้
Seedream 5.0 Pro
Seedream 5.0 Pro API มอบโมเดลการแก้ไขภาพที่ควบคุมได้ของ ByteDance บน Atlas Cloud ให้กับนักพัฒนา โดยจะวางการแก้ไขอย่างแม่นยำด้วยจุดยึดและพิกัด แยกภาพออกเป็นเลเยอร์ที่แก้ไขได้ ผสานข้อมูลอ้างอิงหลายรายการ และจับคู่สีและวัสดุที่แน่นอน พร้อมข้อความหลายภาษาที่ความละเอียด 2K และ 3K บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่านคีย์เดียว!
Seedance 2.0
Seedance 2.0 API ให้คุณเข้าถึงระดับโปรดักชันของโมเดลวิดีโอแบบมัลติโมดัลจาก ByteDance — รองรับอินพุต 4 รูปแบบ (ข้อความ, รูปภาพ, วิดีโอ, เสียง) และระบบ "Universal Reference" ชั้นนำของอุตสาหกรรมที่ล็อกองค์ประกอบภาพ การเคลื่อนไหวของกล้อง และการกระทำของตัวละครในทุกช็อต ผสานรวมการควบคุมระดับผู้กำกับด้วยการเรียกใช้ API เพียงครั้งเดียว ในราคาคงที่ $0.09/วินาที รับคีย์ได้ทันที และไม่มีคิวรอ — พร้อมการรับประกันเวลาพร้อมใช้งานและการปฏิบัติตามข้อกำหนดระดับองค์กร Seedance 2.0 Native 4K เปิดใช้งานแล้ววันนี้!
GPT Image 2.5
ตระกูล GPT Image 2.5 จาก OpenAI ให้ทางเลือกแก่นักพัฒนาในการใช้ Flare และ Sunburst สำหรับเวิร์กโฟลว์รูปภาพในระดับโปรดักชัน เรนเดอร์ที่ความละเอียดใดก็ได้สูงสุด 3840x2160 และเลือกจากระดับคุณภาพห้าระดับ รวมถึง xhigh และ max เพื่อให้ตรงตามความต้องการผลลัพธ์ที่เฉพาะเจาะจง Atlas Cloud ให้บริการการอนุมาน REST ที่พร้อมใช้งานโดยไม่มีการเริ่มต้นแบบเย็นและราคามาตรฐานเริ่มต้นที่ 0.004 ดอลลาร์ต่อการสร้าง เริ่มต้นสร้างได้แล้ววันนี้
GPT Image 2
GPT Image 2 API ช่วยให้นักพัฒนาสามารถเข้าถึงโมเดลรูปภาพล่าสุดของ OpenAI ซึ่งเป็นรุ่นสืบทอดจาก GPT Image 1.5 โดยสามารถสร้างและแก้ไขรูปภาพพร้อมกับการเรนเดอร์ข้อความที่แม่นยำทั้งในอักษรละตินและ CJK รวมถึงการจัดวางองค์ประกอบที่ยอดเยี่ยมสำหรับโปสเตอร์ ม็อกอัป และอินโฟกราฟิก บน Atlas Cloud คุณสามารถเข้าถึงโมเดลนี้ผ่าน API ที่เป็นหนึ่งเดียวร่วมกับโมเดลอื่นๆ อีกกว่า 300 รุ่น พร้อมเครดิตฟรี เวลาทำงาน 99.99% และไม่จำเป็นต้องมีการตรวจสอบยืนยันองค์กรจาก OpenAI
Gemini Omni Flash
API ของ gemini omni นำตระกูล Gemini Omni Flash แบบมัลติโมดัลโดยกำเนิดจาก Google DeepMind ซึ่งรวมถึง Gemini Omni 1.1 Flash มาสู่นักพัฒนา สร้างวิดีโอสไตล์ภาพยนตร์พร้อมเสียงเนทีฟที่ซิงโครไนซ์กัน ทำให้ภาพนิ่งเคลื่อนไหวได้ด้วยการควบคุมเฟรมเริ่มต้นและเฟรมสิ้นสุดอย่างแม่นยำ หรือปรับแก้ฟุตเทจที่มีอยู่ผ่านการแก้ไขด้วยคำสั่งข้อความ โดยยังคงรักษาเนื้อหาที่ไม่ได้แก้ไขไว้ Atlas Cloud มอบคีย์เดียวที่เข้ากันได้กับ OpenAI การเข้าถึงแบบรวมศูนย์ และราคาที่โปร่งใสโดยคิดค่าบริการตามการใช้งาน เริ่มพัฒนาได้วันนี้
Grok Imagine
Grok Imagine API ครอบคลุมโมเดลรูปภาพ วิดีโอ และพูดของ xAI ตั้งแต่ Image 2.0 ถึง Video 1.5 และ xAI TTS v1 สร้างรูปภาพนิ่ง 1K หรือ 2K ในอัตราส่วน 14 แบบ ขยายฉากไปยัง 15 วินาทีของวิดีโอ 1080p ควบคุมภาพด้วยรูปภาพอ้างอิงได้ถึง 7 รูป หรือเพิ่มบรรยายเสียงในภาษา 20 ภาษา Atlas Cloud รันทุกโหมดบนเอนด์พอยต์เดียว มีราคาแบบจ่ายตามการใช้งาน ตั้งแต่ $0.02 ต่อรูปภาพและ $0.05 ต่อวินาที เริ่มสร้างวันนี้
โมเดลเชิงสร้างสรรค์ที่ทรงพลังที่สุดของ Google พร้อมใช้งานแล้วบน Atlas Cloud โดย Veo 3.1 นำเสนอการสร้างวิดีโอระดับภาพยนตร์ Nano Banana 2 ขับเคลื่อนการสร้างภาพที่มีความเที่ยงตรงสูง และ Gemini นำความชาญฉลาดแบบมัลติโมดัลมาสู่ทุกเวิร์กโฟลว์ เข้าถึงชุดโมเดลของ Google เต็มรูปแบบผ่าน API key เดียวพร้อมความพร้อมใช้งานระดับ Day-0 และการกำหนดราคาแบบจ่ายตามการใช้งาน (pay-as-you-go)
Seedance 2.0 Mini
Seedance 2.0 Mini นำเสนอการสร้างวิดีโอแบบมัลติโมดัลของ ByteDance สู่เวิร์กโฟลว์ที่ความเร็วและต้นทุนมีความสำคัญสูงสุด โดยมอบความสามารถหลักของ Seedance 2.0 ในรูปแบบที่ใช้ทรัพยากรน้อยลง — สร้างได้เร็วกว่า ต้นทุนต่อวิดีโอต่ำกว่า และใช้การผสานรวม API เดิมที่คุณใช้อยู่แล้ว สำหรับทีมที่จัดการไปป์ไลน์ปริมาณมากหรือสร้างต้นแบบในสเกลขนาดใหญ่ Mini คือตัวเลือกเริ่มต้นที่ใช้งานได้จริง
ByteDance
ตั้งแต่การสร้างวิดีโอระดับภาพยนตร์ไปจนถึงการสร้างภาพที่มีความละเอียดสูง โมเดลที่ทรงพลังที่สุดของ ByteDance พร้อมใช้งานแล้วบน Atlas Cloud รัน Seedance และ Seedream ในสเกลขนาดใหญ่ด้วยราคาการอนุมานที่ต่ำที่สุด และไม่มีค่าใช้จ่ายแฝงด้านโครงสร้างพื้นฐาน
บทความแนะนำ
คู่มือ บทแนะนำ และอัปเดตผลิตภัณฑ์ ที่ช่วยให้คุณใช้ Atlas Cloud ได้อย่างเต็มประสิทธิภาพ


