İki ekip DeepSeek V4.1 Flash için saniyede yüzlerce token bildirebilir ve yine de farklı şeyleri ölçüyor olabilir. Biri tek bir istek için decode hızını kastediyor olabilir; bir diğeri düzinelerce eşzamanlı istek genelinde toplam çıktıyı kastediyor olabilir. DeepSeek V4.1 Flash çıkarım iş hacmi optimizasyonunu iyileştirmek için önce hizmetinizin ihtiyaç duyduğu metriği seçin, ardından kendi istek karışımınızı kıyaslayın, servis değişkenlerini birer birer değiştirin ve gecikme, kalite ve maliyeti birlikte doğrulayın. Model ailesi artık 17 Ekim Flash-1017 güncellemesini içeriyor, bu nedenle sonuçları karşılaştırmadan önce tam checkpoint'i kaydedin. Kamuya açık raporlar faydalı optimizasyon yolları gösterir, ancak hiçbiri kendi donanımınızdaki eşleştirilmiş bir testin yerini tutmaz.
Önemli çıkarımlar
- Toplam çıktı token/sn, istekler genelinde kapasiteyi ölçer; istek başına decode hızı, tek bir kullanıcının deneyimini ölçer.
- Ayarlama yapmadan önce prompt uzunluklarınızı, çıktı sınırlarınızı, eşzamanlılığı, sıcak durumu ve gecikme hedefinizi yeniden oluşturun.
- V4.1 Flash'ın sıkıştırılmış KV önbelleği ve sınırlı yeniden oynatma (bounded replay), bellek baskısını azaltır ancak sabit bir uçtan uca hızlanma garanti etmez.
- vLLM ve SGLang'ı yalnızca eşleşen model, donanım, iş yükü ve ölçüm koşulları altında karşılaştırın.
DeepSeek V4.1 Flash için İş Hacmi Ne Anlama Gelir?
İş hacmi bir orandır, ancak pay ve test sınırı önemlidir. Bir çıkarım hizmeti için en az beş ölçüm kaydedin:
| Metrik | Size ne söyler | Tipik kullanım |
|---|---|---|
| Toplam çıktı token/sn | Tüm etkin isteklerin saniyede ürettiği çıktı token'ları | Kapasite planlama ve filo verimliliği |
| İstek başına decode token/sn | Tek bir isteğin deneyimlediği üretim hızı | Üretim sırasında etkileşimli yanıt verebilirlik |
| Prefill token/sn | Saniyede işlenen giriş token'ları | Uzun prompt'lar ve retrieval ağırlıklı iş yükleri |
| İlk token'a kadar süre (TTFT) | İsteğin gelişinden ilk çıktı token'ına kadar geçen süre | Algılanan başlangıç gecikmesi |
| Uçtan uca gecikme, p50/p95 | Trafik dağılımı genelinde toplam istek süresi | Hizmet düzeyi hedefleri ve kuyruk davranışı |
Bir sunucu, daha fazla diziyi toplu işleyerek toplam iş hacmini artırabilir, ancak bu her kullanıcının token'lar arasında daha uzun beklemesine neden olur. Tersine, düşük eşzamanlılık için ayarlanmış bir kurulum, hızlı bireysel yanıtlar sunarken hızlandırıcıları yetersiz kullanabilir. İki sonuç da evrensel olarak daha iyi değildir. Doğru hedef, ürününüzün hizmet hedefini karşılayan iş hacmi-gecikme eğrisi üzerindeki bir noktadır.
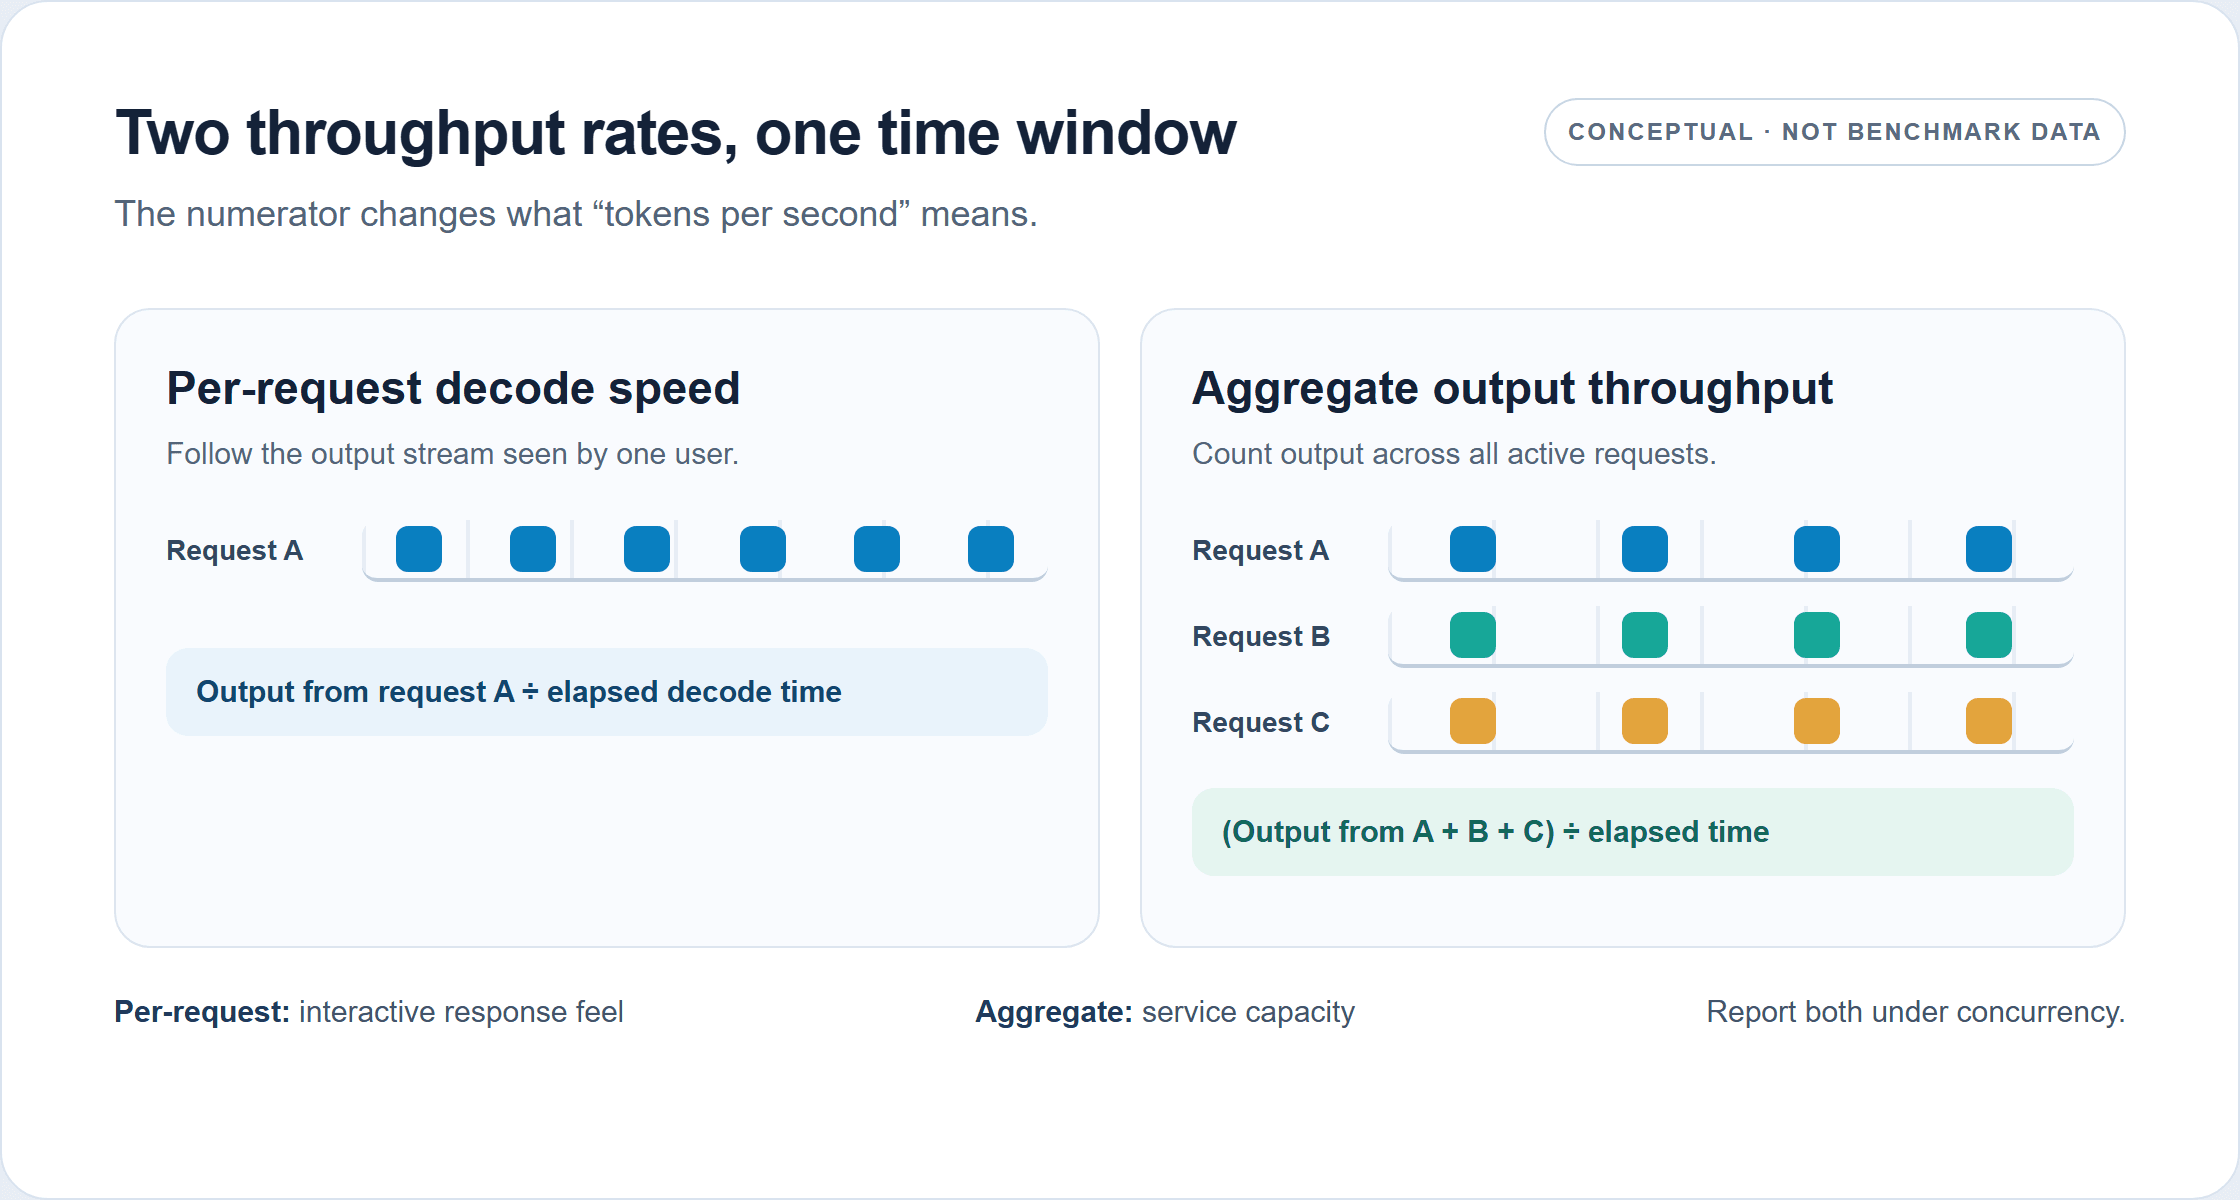
İki oran farklı çıktı akışlarını sayar. Bu kavramsal bir diyagramdır, ölçülmüş DeepSeek V4.1 Flash performansı değildir.
İş hacminin prefill, decode veya her ikisini içerip içermediğini belirtin. GPU sayısına bölüp bölmediğinizi belirtin. İstenen maksimum token yerine başarılı çıktı token'larını bildirin ve iptalleri veya hataları açıklayın. Bu ayrıntılar olmadan bir token/sn rakamı, bir operatöre uygulamasını tahmin edip edemeyeceğini söyleyemez.
Yeniden Üretilebilir Bir DeepSeek V4.1 Flash Temel Referansı Oluşturun
Kullanışlı bir temel referans, darboğazını ortaya çıkaracak kadar üretim trafiğine benzer. Tek bir kısa prompt, büyük bir konuşma geçmişini tekrar tekrar gönderen bir ajan için zayıf bir vekildir ve sabit 1.024 token çıktı, erken duran veya geniş ölçüde değişen iş yüklerini kaçırır.
İş yükünü ve ölçüm penceresini sabitleyin
Gözlemlenen trafikten istek grupları oluşturun. Her grup için yaklaşık giriş uzunluğunu, beklenen çıktı uzunluğunu, varış desenini ve varsa paylaşılan önekleri koruyun. Gerçek istek yolunun parçasıysa araç veya akıl yürütme turlarını dahil edin. Çalıştırmalar arasında prompt'ları, örnekleme ayarlarını, durdurma koşullarını ve çıktı üst sınırlarını sabit tutun.
Hem düşük eşzamanlılık senaryosunu hem de hizmetinizin zirvede beklediği eşzamanlılığı çalıştırın. Ardından iş hacminin nerede artmayı bıraktığını veya gecikmenin sınırını nerede aştığını ortaya çıkarmak için ara eşzamanlılık düzeyleri ekleyin. Isınma sonrasında sabit bir ölçüm penceresi kullanın, her noktayı yineleyin ve medyan ile aralığı bildirin. Kısa bir patlama, istikrarlı hizmet kapasitesi yerine başlangıç davranışını ölçebilir.
Soğuk başlangıç ölçümlerini sıcak servisten ayırın. Soğuk çalıştırmalar, yığına bağlı olarak model yükleme, grafik yakalama veya önbellek doldurmayı içerir; sıcak çalıştırmalar servise hazır bir sistemi tanımlar. Önek önbelleği kullanan bir iş yükü için önbellek isabeti ve önbellek ıskası trafiğini ayrı ayrı ölçün. Karışım üretimle eşleşmiyorsa bunları tek bir ortalamada birleştirmeyin.
Bir kıyaslama kaydı tutun
Her çalıştırma için şu alanları içeren bir satır kaydedin: checkpoint veya model revizyonu; çalışma zamanı ve commit; GPU modeli ve sayısı; ara bağlantı; hassasiyet ve nicemleme; tensor, expert veya pipeline paralel düzeni; giriş ve çıktı token dağılımı; eşzamanlılık ve istek varış deseni; sıcak veya soğuk durum; çalıştırma süresi; başarı oranı; toplam iş hacmi; istek başına decode hızı; TTFT; ve p50/p95 uçtan uca gecikme.
Bu kayıt, bir liderlik tablosu rakamından daha faydalıdır çünkü bir sonraki deneyi yeniden üretilebilir kılar. Ayarlama yapmadan önce bunu dondurun. İş yükü veya checkpoint değişirse, farkı bir servis bayrağına atfetmek yerine yeni bir temel referans başlatın.
Prefill, Decode, KV Önbelleği veya Zamanlamayı Teşhis Edin
Bir sonraki ölçümü seçmek için belirtileri kullanın, bir düzeltmeyi tahmin etmek için değil. Kabul edilebilir decode hızıyla birlikte yüksek TTFT, giriş işleme, kuyruklama, önbellek ıskaları veya başlangıç ek yüküne işaret eder. Düşük eşzamanlılıkta yavaş decode, çekirdekleri, bellek bant genişliğini, paralel iletişimi ve modelin yürütme yolunu incelemeyi gerektirir. Eşzamanlılık arttıkça düzleşen toplam iş hacmi, bellek baskısı, zamanlayıcı sınırları, iletişim ek yükü veya doygun bir hesaplama yolu gösterebilir. Uzun bağlam bozulması, önbellekte kalma, prefill işi ve host'tan aygıta veri hareketinin ölçülmesini gerektirir.
| Gözlem | İlk kontroller |
|---|---|
| TTFT prompt uzunluğuyla büyüyor | Prefill hızı, kuyruk süresi, önek önbelleği isabet oranı, grafik veya derleme ısınması |
| Eşzamanlılık 1'de bile decode hızı düşük | Çalışma zamanı model yolu, çekirdek desteği, hassasiyet, GPU kullanımı, iletişim ek yükü |
| Eşzamanlılık arttıkça toplam token/sn düzleşiyor | KV önbelleği kapasitesi, zamanlayıcı toplu işlemesi, bellek bant genişliği, paralel topoloji |
| Toplam çıktı iyileşirken p95 gecikmesi keskin şekilde artıyor | Toplu iş boyutu, kuyruklama politikası, istek uzunluğu karışımı, hizmet hedefi |
| Uzun prompt'lar faydalı etkin istekleri tahliye ediyor | KV önbelleğinde kalma, önbellek ayırma, bağlam dağılımı, host belleği trafiği |
V4.1 Flash, bu baskılardan bazılarını hafifletmeyi amaçlayan mimari özelliklere sahiptir. Model raporu, katmanlar arası önbellek yeniden kullanımı ve FP4 küresel KV önbellekleme ile CSA2'yi tanımlar; bu, token başına 890 baytlık bildirilen küresel KV ayak izi verir, V4-Flash'in karşılık gelen ayak izinin kabaca dörtte biri. SWA Bounded Replay farklı bir depolama ödünleşimini ele alır: tüm kayan pencere dikkat durumunu kalıcı tutmak yerine, bir dağıtım son pencereyi yeniden oynatarak eksik durumu yeniden oluşturabilir. DeepSeek, bu tasarım için kalıcı KV önbelleğinin V4-Flash'in ayak izinin yaklaşık sekizde biri olduğunu ve küçük miktarda ek prefill yeniden hesaplaması gerektiğini bildirir. Bunlar mimari ve dağıtım sonuçlarıdır, sekiz kat iş hacmi vaadi değildir. (DeepSeek teknik raporu, Eylül 2026)
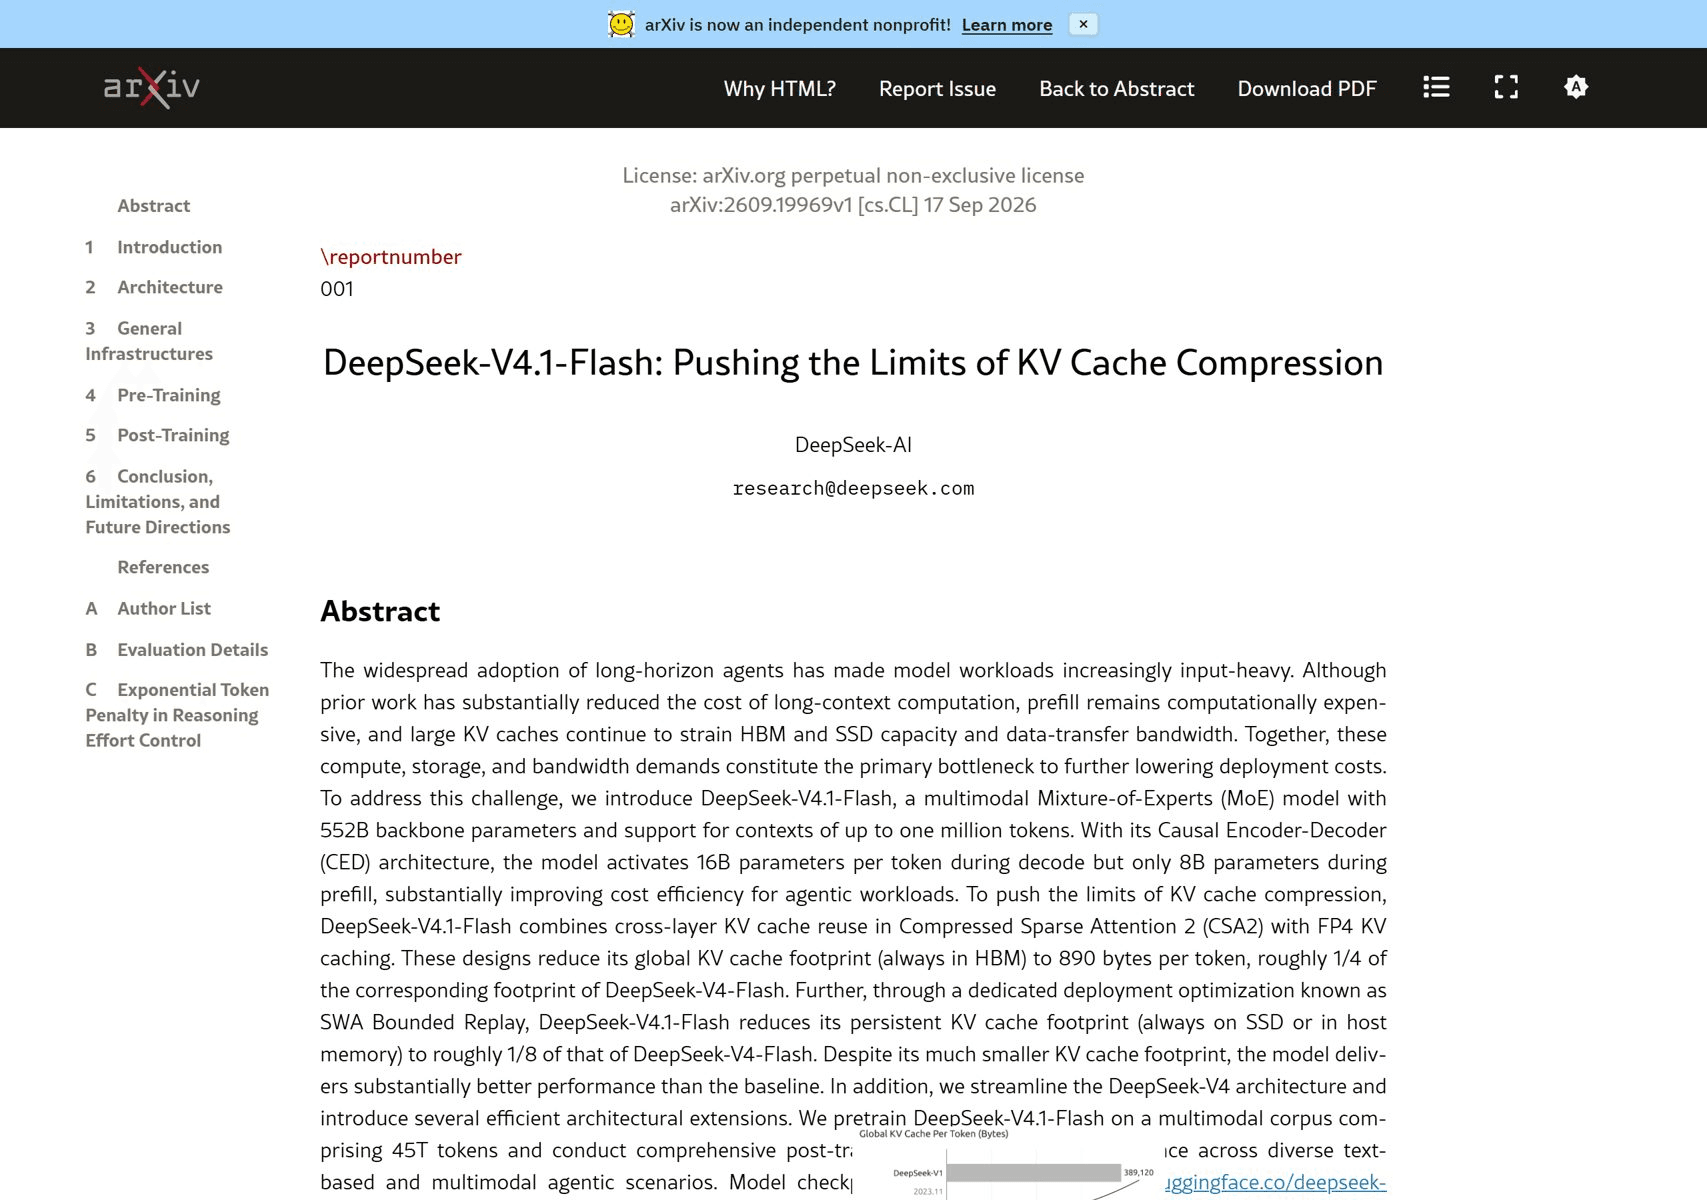
Kaynak şekil, her dağıtım için uçtan uca iş hacmi çarpanı değil, önbellek kapasitesini açıklar.
Teşhis belirsiz olduğunda, temsili bir çalıştırmayı profilleyin ve kuyruk süresini, GPU kullanımını, bellek kullanımını ve aşama başına zamanlamayı inceleyin. Tek bir değişkeni değiştirin, aynı iş yükünü yeniden çalıştırın ve çıktı doğruluğunu veya görev kalitesini kontrol edin. Bu, görünürdeki bir hızlanmanın hizmet veya yanıtlardaki bir gerilemeyi maskelemesini önler.
vLLM veya SGLang'ı Aynı Hedefe Göre Ayarlayın
Geçerli model yolu dağıtmayı planladığınız checkpoint'i ve donanımı destekleyen bir çalışma zamanı seçin. Tam sürümü, çekirdekleri, grafik davranışını ve paralel düzeni doğrulayın. Bir modelin destekleniyor olarak listelenmesi, her nicelemenin veya topolojinin eşit derecede optimize edildiği anlamına gelmez.
vLLM: sürüme özgü model yolunu doğrulayın
vLLM ekibinin Ekim raporu, AgentX kıyaslamasında bir ilerlemeyi tanımlar: düşük gecikme sonucunda yaklaşık 1,9× iyileşme ve 150 TPS kısıtı altında sıfırıncı gün temel referansına kıyasla yaklaşık 5,3× iş hacmi. Çalışma, CUDA grafikleriyle SWA sınırlı yeniden oynatmayı ve modele özgü çekirdek entegrasyonunu içeriyordu. Bu değerleri, yığının o kıyaslama altında zaman içinde önemli ölçüde değiştiğinin kanıtı olarak ele alın, başka bir kümeye uygulanacak çarpanlar olarak değil. ( vLLM mühendislik raporu, Ekim 2026)
Kendi çalıştırmanız için önce desteklenen bir sürüm ve bilinen iyi yapılandırma belirleyin. Ardından grafik yakalama veya yeniden oynatma davranışını, toplu işlemeyi ve paralelliği ayrı ayrı ölçün. Daha yüksek iş hacmi noktasını seçmek için kullanılan gecikme kısıtını koruyun. Grafik yakalama başlangıç veya bellek ihtiyaçlarını değiştiriyorsa, bu maliyetleri dağıtım kararına dahil edin.
SGLang: eşzamanlılık profilini eşleştirin
SGLang ekibinin raporu, test bağlamının neden önemli olduğuna dair alışılmadık derecede net bir örnek verir. 8 H200 GPU'da, spekülatif kod çözme olmadan optimize edilmiş çalıştırması, eşzamanlılık 1'de kullanıcı başına yaklaşık 76'dan 168 token/sn'ye ve eşzamanlılık 64'te GPU başına yaklaşık 96'dan 221 çıktı token/sn'ye yükseldi. Sabit 8.192 token girişler ve 1.024 token çıktılar kullandı. Ayrı 4×GB300 sonuçları farklı prompt uzunlukları, paralel ayarlar ve DSpark spekülatif kod çözme kullandı. Bu nedenle rapor, SGLang'ın optimizasyonlarının kendi trafiğinizde değerlendirilmesini destekler; doğrudan vLLM AgentX sayılarıyla kıyaslanmasını değil. ( LMSYS/SGLang optimizasyon raporu, Eylül 2026)
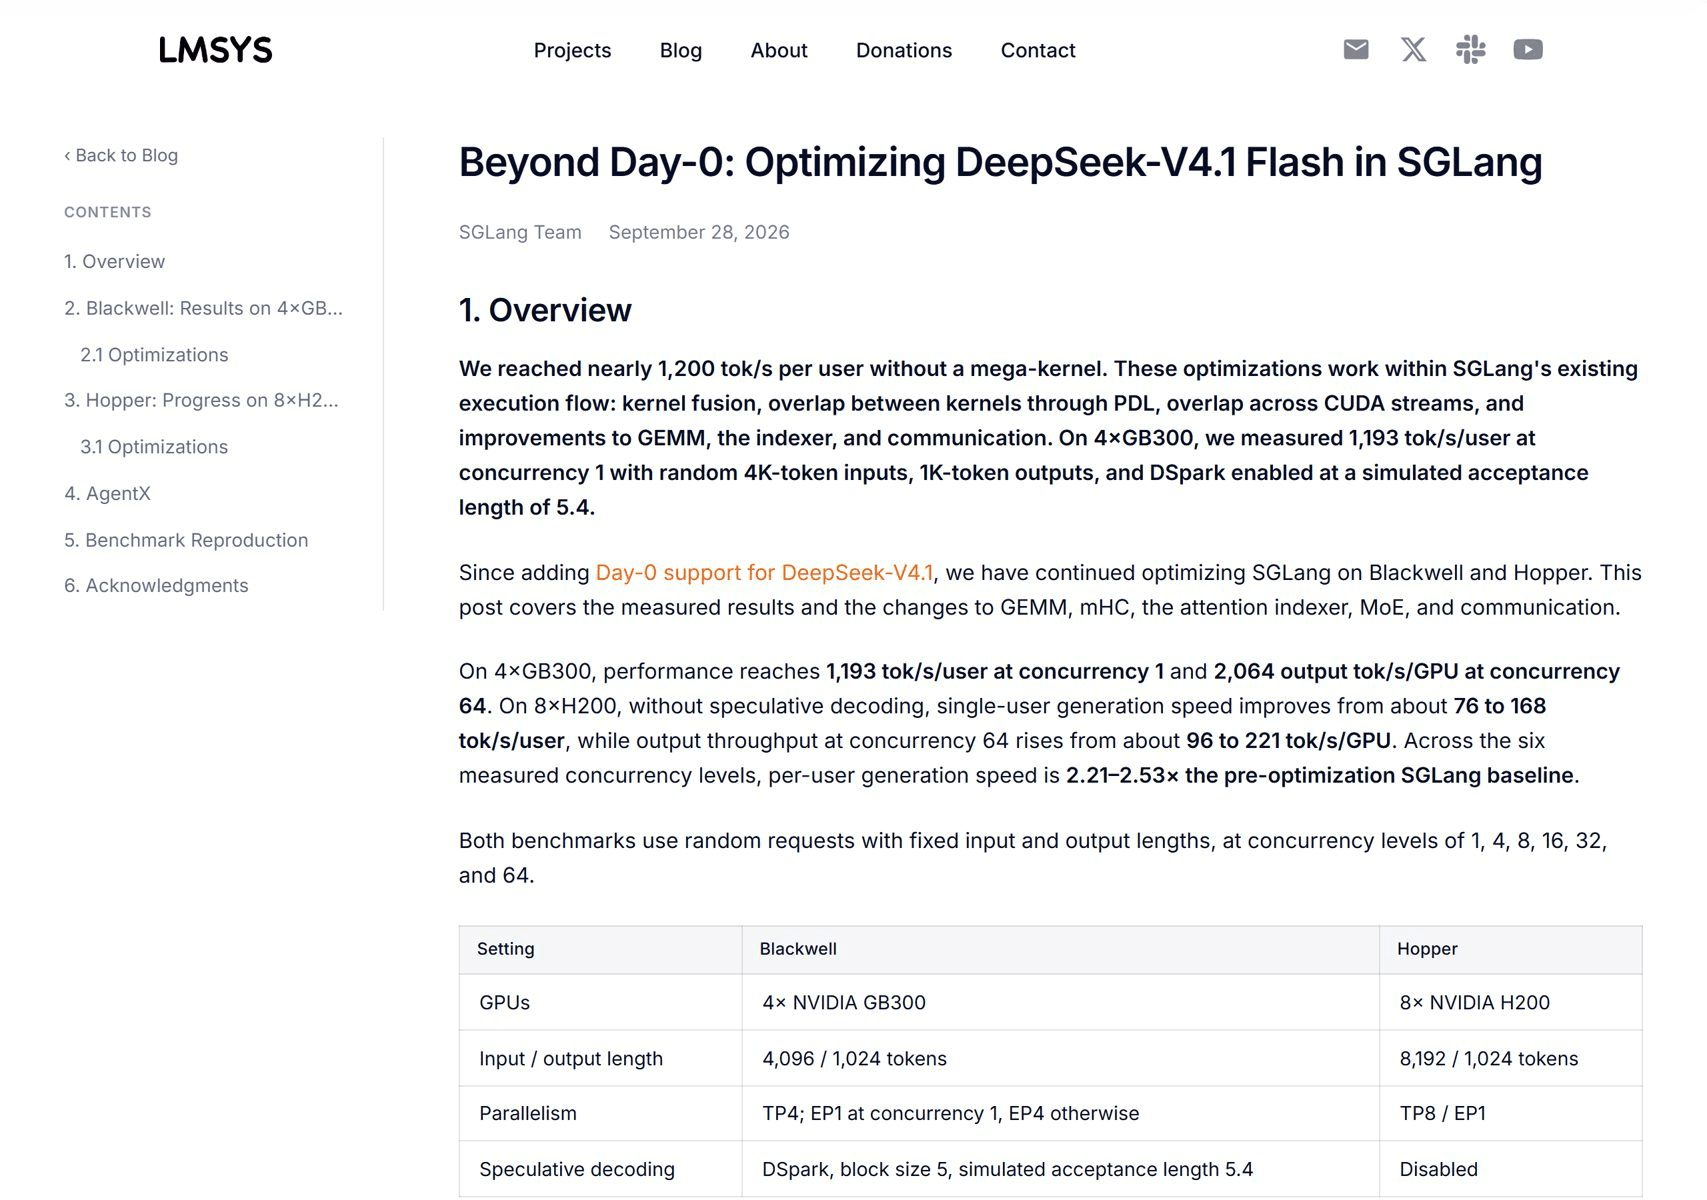
Kaynak raporlar farklı iş yükleri ve donanım kullanır; sayıları bire bir karşılaştırma grafiği olarak okunmamalıdır.
Bir çalışma zamanıyla başlayın ve desteklenen yolunu optimize edin. Ancak checkpoint, GPU tahsisi, prompt ve çıktı dağılımları, eşzamanlılık, ısınma ve hizmet hedefini sabit tutabiliyorsanız ikinci bir çalışma zamanı karşılaştırması kurun. Bu karşılaştırma mühendislik zamanına mal olur, bu nedenle önce mevcut yığının gerçekten sınırlayıcı faktör olduğunu doğrulayın.
SLO'yu Bozmadan Eşzamanlılığı ve Uzun Bağlamı Optimize Edin
Eşzamanlılığı adım adım artırın ve her adımda toplam çıktıyı, istek başına decode hızını, TTFT'yi, p95 gecikmesini, bellek kullanımını ve hataları kaydedin. En yüksek iş hacmi noktasını yalnızca gecikmesi ve hata oranları hizmet hedefinizi hâlâ karşılıyorsa koruyun. İstekler üretimden önce kuyruğa giriyorsa, daha büyük bir toplu iş aygıt kullanımını iyileştirebilir ancak ürünü daha yavaş hissettirebilir.
Uzun bağlamlı trafik için etkin bağlam dağılımını ve önbellek isabet oranını ölçün. Belirtilen maksimum bağlam penceresi, her isteğin bu uzunlukta eşzamanlı olarak sunulabileceği anlamına gelmez. KV önbelleği, bellek için ağırlıklar, aktivasyonlar, grafik havuzları ve çalışma zamanı arabellekleriyle rekabet eder. Değişken istek uzunlukları için pay bırakın ve gerçekçi trafik altında tahliye veya öncelik iptalini ölçün.
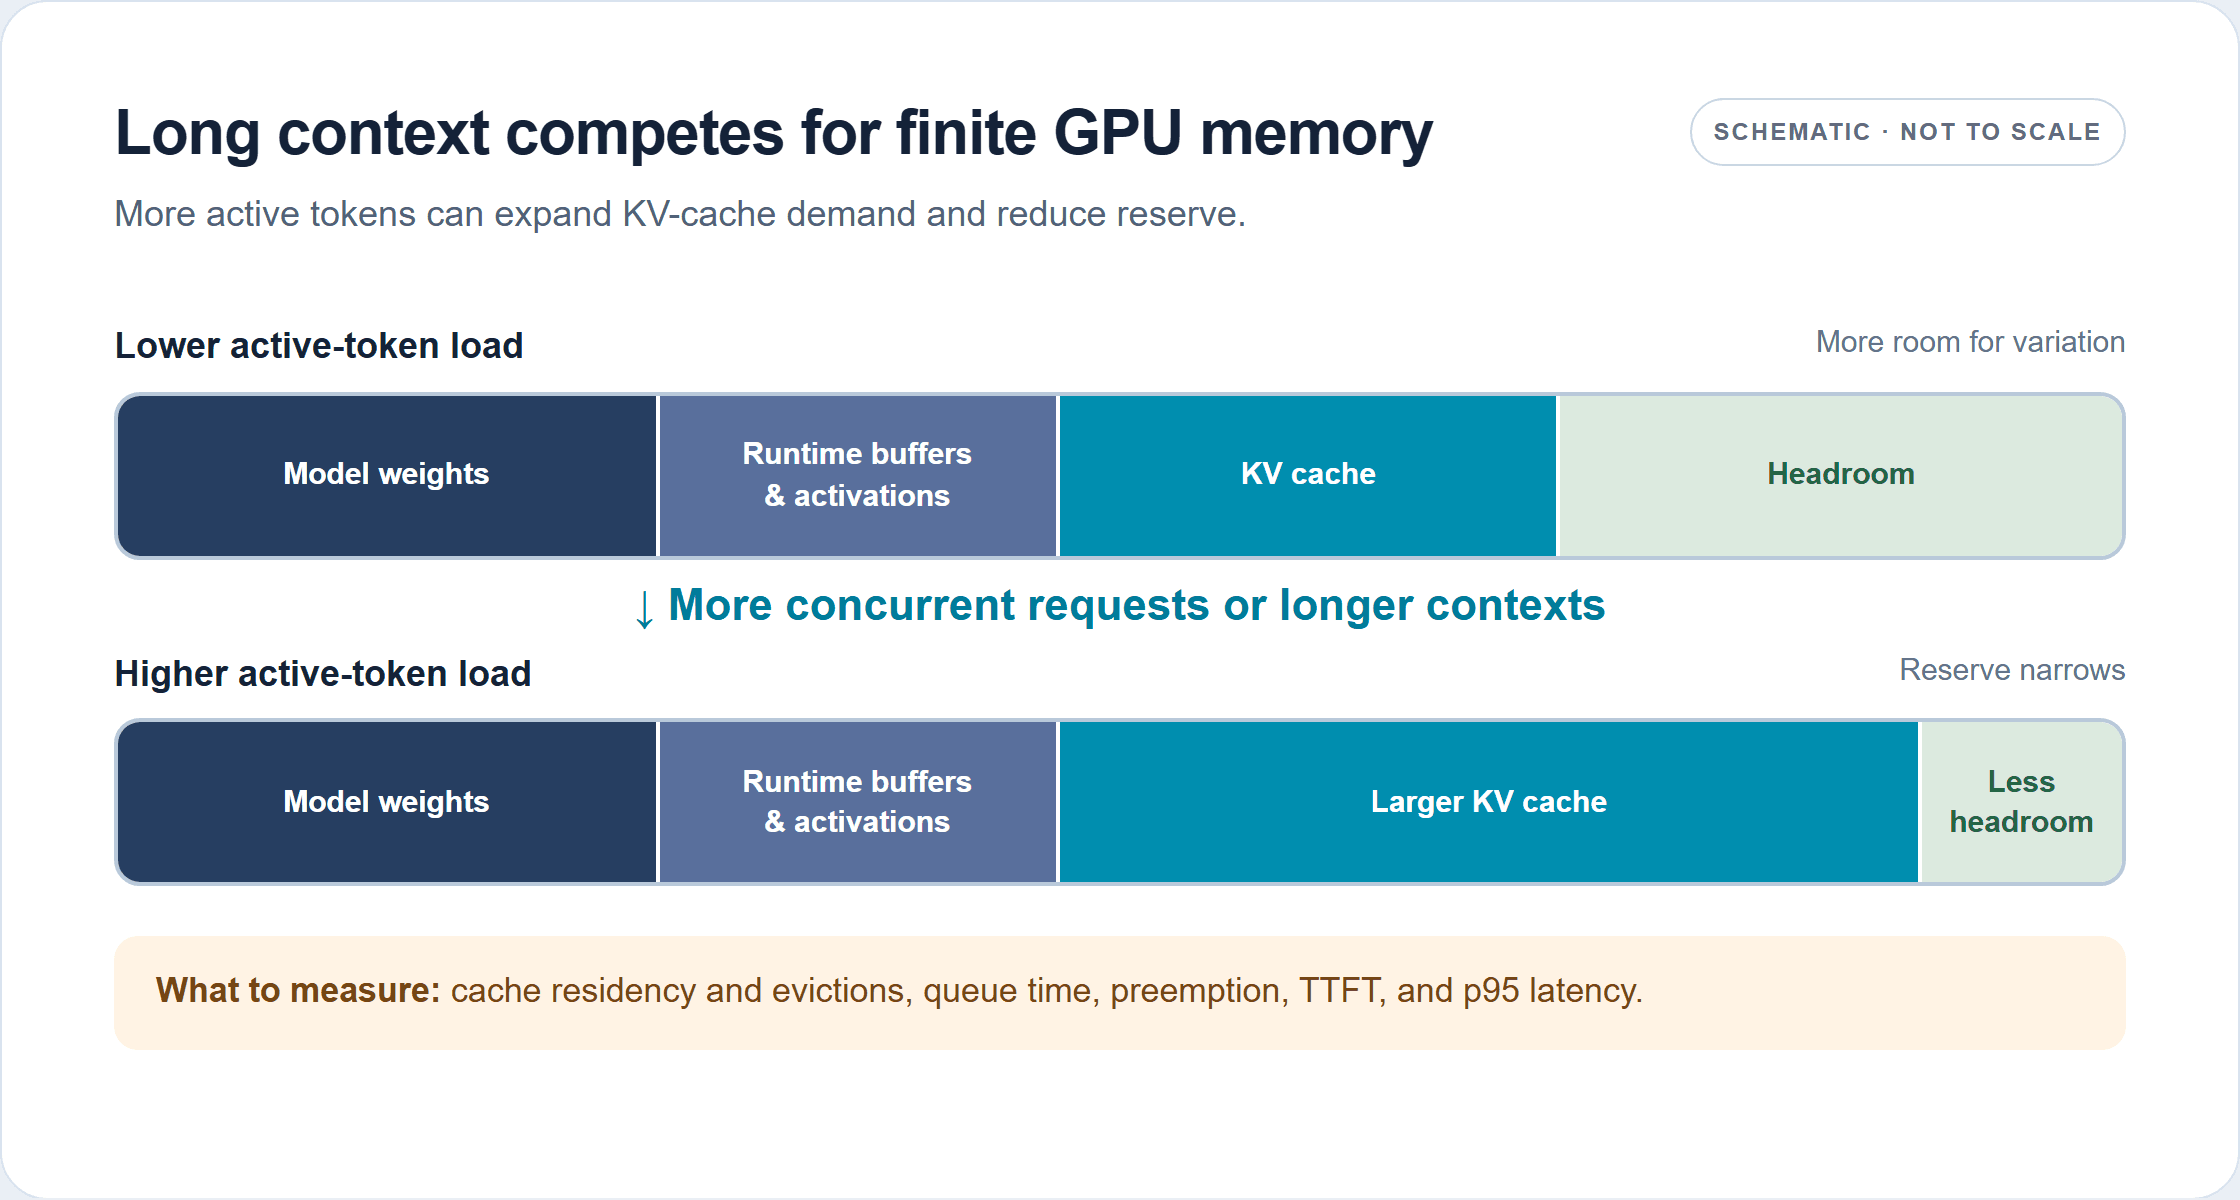
Daha uzun bağlamlar veya daha fazla eşzamanlı istek KV önbelleği talebini artırabilir. Bellek blokları şematiktir ve ölçekli değildir.
Nicelemeyi, KV önbelleği hassasiyetini, tensor paralelliğini, expert paralelliğini ve prefill/decode ayrıştırmasını ayrı deneyler olarak ele alın. Bunlar bellek kullanımını, iletişimi, çekirdek seçimini, çıktı kalitesini ve gecikmeyi değiştirebilir. En iyi düzen GPU türüne ve ara bağlantıya bağlıdır; daha fazla GPU eklemek iletişim maliyetlerini artırabilir veya bazı kaynakları boşta bırakabilir. Hassasiyeti veya model yürütmeyi değiştirdikten sonra tam çıktı kalitesini ve hata modlarını doğrulayın.
Pratik sıra basittir: temel referansı yeniden oluşturun, hedefini kaçıran metriği belirleyin, tek bir darboğaz hipotezi oluşturun, tek bir ayarı değiştirin ve yineleyin. Ayar bir metriği iyileştirirken başka bir metriğe zarar veriyorsa, bu ödünleşimin ürüne uyup uymadığına açıkça karar verin. Bu, optimizasyonu bir bayrak yığını yerine kontrollü bir karar haline getirir.
Spekülatif Kod Çözmeyi ve İddia Edilen Her Hızlanmayı Doğrulayın
Spekülatif kod çözme, taslak token'lar verimli şekilde kabul edildiğinde ve çalışma zamanı doğrulamayı iyi uyguladığında seri hedef model işini azaltabilir. Faydası taslak yoluna, kabul davranışına, toplu iş şekline, donanıma ve prompt/çıktı karışımına bağlıdır. Decode'a bağlı trafiğe yardımcı olabilir ve prefill, kuyruklama veya iletişim baskın olduğunda az değer taşıyabilir.
Spekülasyon etkinken ve devre dışıyken bir A/B testi çalıştırın. Model checkpoint'ini, prompt kümesini, token üst sınırını, varış desenini, eşzamanlılığı, ısınmayı ve ölçüm penceresini sabit tutun. Varsa doğrulama adımı başına kabul edilen token'ları; toplam iş hacmi, istek başına hız, TTFT, p95 gecikmesi, GPU kullanımı, hatalar ve görev kalitesiyle birlikte kaydedin. Yayımlanmış bir kıyaslamadaki simüle edilmiş kabul uzunluğu bir test koşuludur, prompt'larınız için varsayılacak bir değer değildir.
İddia edilen bir hızlanma yalnızca üç kontrolü geçerse faydalıdır: aynı hizmet hedefi, kabul edilebilir yanıt kalitesi ve adil bir maliyet karşılaştırması. Yayımladığınız her sayıyla birlikte tam bağlamı bildirin. Farklı GPU sayılarını, prompt uzunluklarını, çıktı uzunluklarını, hassasiyet modlarını, model revizyonlarını veya metrikleri kontrollü bir deneymiş gibi karşılaştırmaktan kaçının.
Kendi Sunucunuzda mı Barındırmalı yoksa Yönetilen DeepSeek V4.1 Flash API'sini mi Kullanmalı?
Kendi sunucunuzda barındırma, trafik GPU'ları faydalı tutacak kadar istikrarlıysa, ekip çıkarım altyapısını işletebiliyorsa ve donanım veya yürütme üzerindeki kontrol operasyonel işi haklı çıkarıyorsa mantıklıdır. Hızlandırıcıların, kapasite payının, gücün, ağın, depolamanın, bakımın ve mühendislik zamanının tam maliyetini dahil edin. Tek başına yüksek zirve token/sn sonucu, başarılı görev başına daha düşük maliyet ortaya koymaz.
Yönetilen bir API, bir ekibin ürün talebini hızlıca doğrulaması, bir servis filosu işletmekten kaçınması veya bir API temel referansını kendi dağıtımıyla karşılaştırması gerektiğinde faydalıdır. Atlas Cloud, DeepSeek V4.1 Flash'ı deepseek-ai/deepseek-v4.1-flash model kimliği altında OpenAI uyumlu bir API ile listeler. DeepSeek V4.1 Flash model sayfası şu anda milyon giriş token'ı başına $0.30, milyon çıktı token'ı başına $1.20 ve milyon önbellek okuma token'ı başına $0.03 gösteriyor; Ekim 2026 itibarıyla hiçbir indirim görüntülenmiyor. Harcamayı tahmin etmeden önce güncel fiyatlandırma listesini kontrol edin. Yönetilen bir uç nokta, kendi istek gecikmenizi veya trafik ekonomisini ölçme ihtiyacını ortadan kaldırmaz.
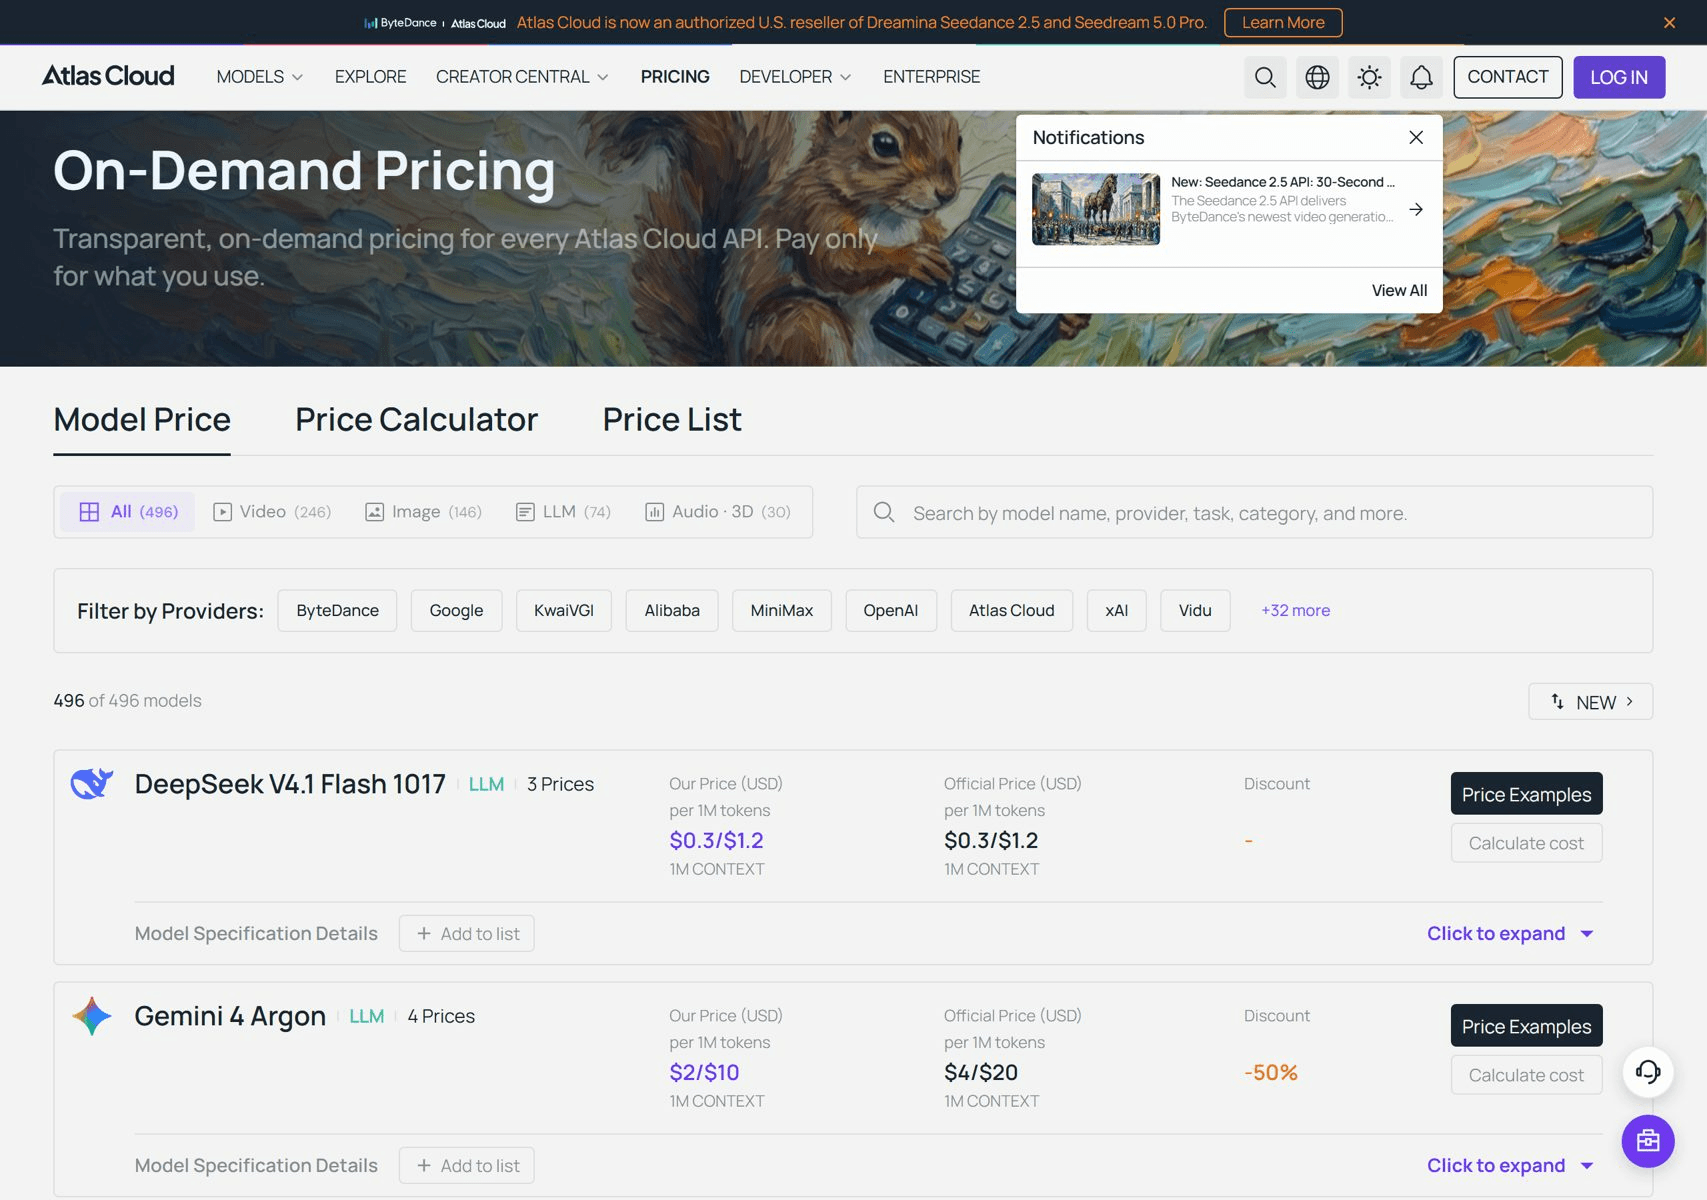
Liste, yönetilen bir API seçeneğini tanımlar; bu bir servis kıyaslaması değildir.
Adil bir dağıtım kararı için aynı iş isteklerini kendi sunucunuzda barındırılan hizmete ve yönetilen uç noktaya yeniden oynatın. Tamamlanan görev başına maliyeti, gecikme dağılımını, güvenilirliği ve her seçeneği sürdürmek için gereken personel süresini karşılaştırın. Birincil hedefiniz DeepSeek V4.1 Flash çıkarım iş hacmi optimizasyonuysa, her iki yol için de aynı iş yükünü ve başarı kriterlerini koruyun.
Sık Sorulan Sorular
İş hacmi ile kullanıcı başına saniyedeki token arasındaki fark nedir?
Toplam iş hacmi, etkin istekler genelindeki çıktıyı sayar. Kullanıcı başına token/sn, tek bir isteğin decode hızını ölçer. Toplu işleme birincisini artırırken ikincisini azaltabilir, bu nedenle etkileşimli hizmetler için her ikisini de bildirin.
Eşzamanlılığı artırmak iş hacmini her zaman iyileştirir mi?
Hayır. Toplam çıktı, hesaplama veya bellek doygunluğa ulaşana kadar artabilir, sonra düzleşir. Kuyruklama ve kuyruk ucu gecikmesi bu noktadan sonra kötüleşmeye devam edebilir. Hizmet hedefi başarısız olduğunda eşzamanlılığı artırmayı durdurun.
vLLM ve SGLang kıyaslama sayıları doğrudan karşılaştırılabilir mi?
Yalnızca model revizyonu, donanım, prompt ve çıktı uzunlukları, eşzamanlılık, sıcak durum, ölçüm sınırı ve gecikme kısıtı eşleşiyorsa. Yayımlanmış raporlar farklı kurulumlar kullanır, bu nedenle doğrudan bir çalışma zamanı kazananı yerine optimizasyon yollarını gösterirler.
Kendi sunucumda barındırmak yerine ne zaman yönetilen bir API kullanmalıyım?
Entegrasyon hızı ve azaltılmış altyapı işi, servis yığınına sahip olmaktan daha önemli olduğunda yönetilen bir API kullanın. Kullanım, operasyonel uzmanlık, kontrol ve ölçülmüş bir toplam maliyet durumu GPU'ları çalıştırmayı haklı çıkardığında kendi sunucunuzda barındırın.





