Bir milyon token'lık bağlam penceresi, bir modelin ne kadar metni kabul edebileceğini söyler; her cümleyi ne kadar güvenilir yorumlayacağını değil. DeepSeek V4.1 Flash uzun belge analizi doğruluğu için kamuya açık kanıtlar yararlı ama eksiktir: DeepSeek'in model kartı, 1-shot kurulumunda V4.1 Flash temel modeli için LongBench-V2'de 45,2 tam eşleşme bildirir; API ise o zamandan beri daha yeni bir 1017 derlemesine geçmiştir. Bu kıyaslama tek bir değerlendirme kurulumuna dair bir sinyaldir; sözleşmeniz, yıllık raporunuz veya araştırma arşiviniz için bir geçme oranı değildir.
Pratik yanıt, hızlı erişim ve ilk geçiş sentezi için Flash kullanmak, ancak önemli kararlar için sayfa düzeyinde kanıt ve insan incelemesi istemektir. Burada atıfta bulunulan hiçbir kamu kaynağı, aşağıdaki beş belge görevi genelinde yeniden üretilebilir, güncel derlemeye ait bir değerlendirme sunmaz. Test planı, bu çalıştırmaların zaten yapıldığına dair bir iddia değil, çalıştırılmaya hazır bir protokoldür.
Önemli çıkarımlar
- Model ailesi 1M token'a kadar destekler, ancak bağlam sınırı doğruluk garantisi değildir.
- Yayımlanan 45,2 LongBench-V2 puanı temel model ve 1-shot kıyaslama kurulumu içindir.
- DeepSeek'in API'si artık V4.1-Flash-1017 sunuyor; sürüm notları yeni bir uzun belge puanı yayımlamıyor.
- Kanıt konumlarını isteyin, bunları kaynakla karşılaştırın ve hataları kendi belgelerinizde ölçün.
1M token penceresi belge analizi için ne anlama gelir
DeepSeek'in model kartı V4.1 Flash'ı bir milyon token'a kadar bağlamları desteklediği şeklinde tanımlar. API belgeleri şu anda sunulan modeli DeepSeek-V4.1-Flash-1017 olarak tanımlıyor ve 1M bağlam uzunluğu listeliyor. Bunlar kapasite spesifikasyonlarıdır. Modelin bir dipnotu ne sıklıkla bulduğunu, iki belge sürümünü ayrı tuttuğunu veya istenen bir olgunun eksik olduğunu kabul ettiğini ortaya koymazlar. (DeepSeek model kartı)
Bir token bir sayfa değildir. Sayfa sayısı tablolara, dipnotlara, düzene, dile ve çıkarım kalitesine göre değişir. Taranmış bir PDF OCR gerektirebilir; bir tablo metne dönüştürüldüğünde satır etiketlerini kaybedebilir; üstbilgiler ve yinelenen sayfa öğeleri soruya yardımcı olmadan bağlam tüketebilir. İstem ve istenen yanıt da token kullanır. Dolayısıyla nominal bir milyon token üst sınırı, her milyon token'lık dosyanın her sohbet arayüzünden veya API istemcisinden bozulmadan ulaşacağı anlamına gelmez.
Bir testten önce tam model tanımlayıcısını, istemciyi ve giriş yöntemini kaydedin. Çıkarılan metnin tamamının gönderilip gönderilmediğini, sağlayıcının onu kesip kesmediğini ve isteğin beklenen model sürümüne ulaşıp ulaşmadığını kontrol edin. Güncel DeepSeek API'si en son Flash derlemesi için deepseek-flash kullanır. Ağ geçidiniz veya SDK'nız başka bir takma ad kullanıyorsa, o takma adı kaydedin ve yönlendirmesini doğrulayın. Yinelenebilir barındırılan çağrılar kuran ekipler Atlas Cloud'un model platformundan başlayabilir, ardından DeepSeek V4.1 Flash API listesini açabilir.
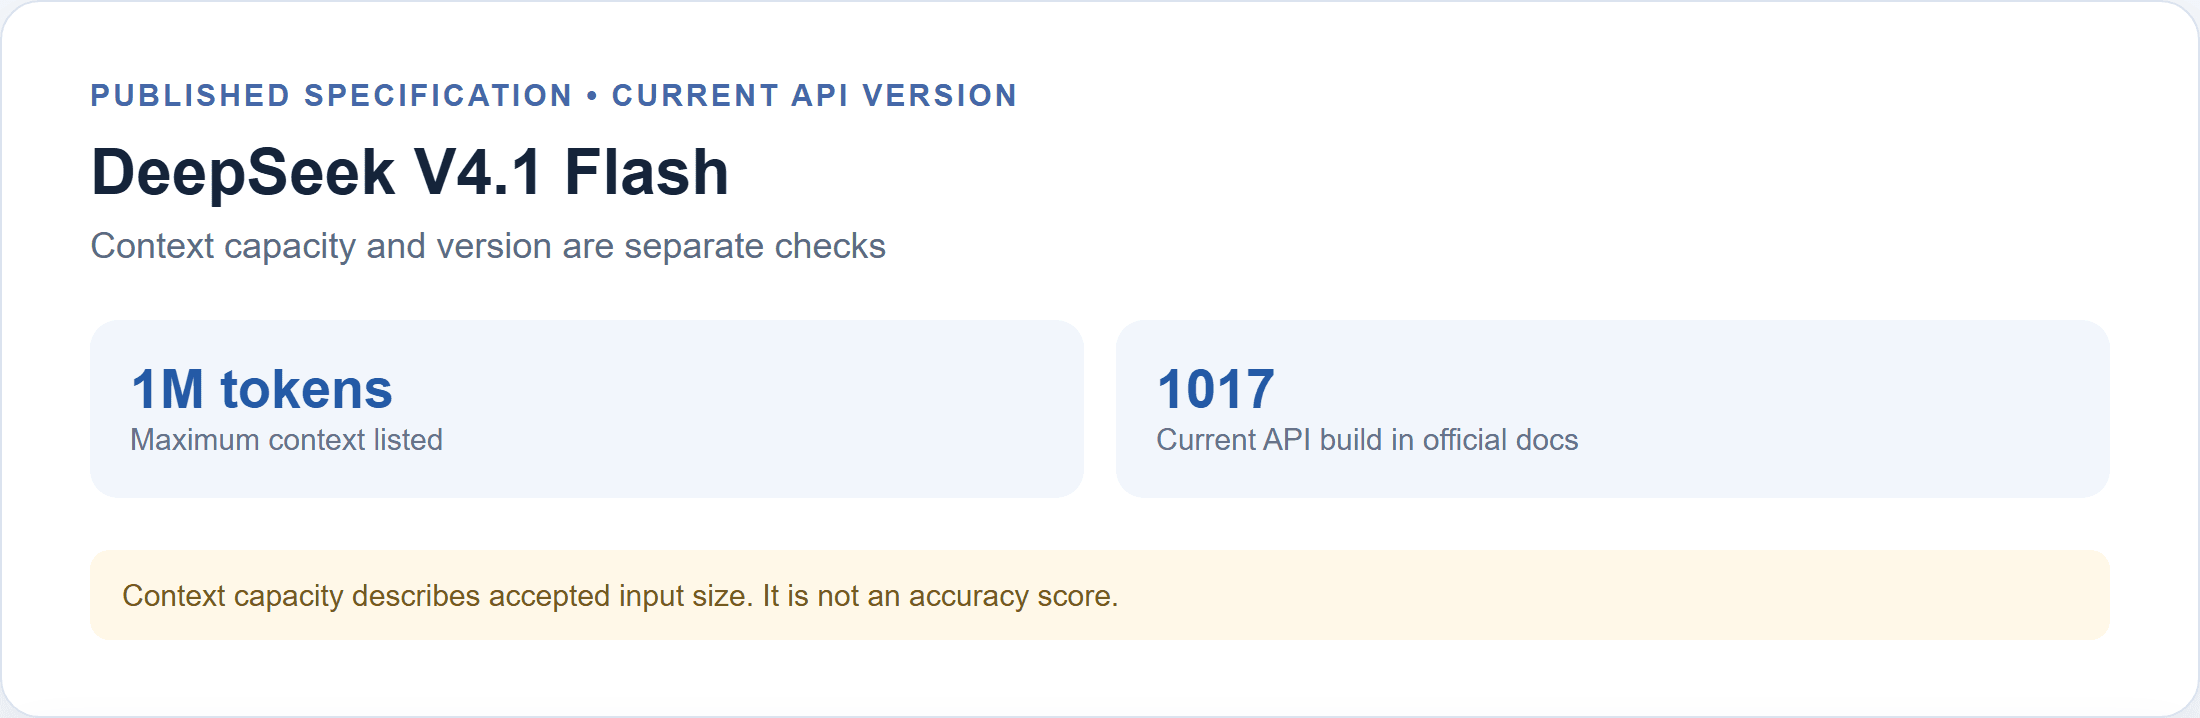
Yayımlanan spesifikasyon 1M bağlam üst sınırı verir; güncel API belgeleri 1017 derlemesini tanımlar.
Başarılı bir yükleme veya istek yalnızca sistemin bir girdiyi kabul ettiğini gösterir. İlgili bir ayrıntının yanıtı etkilediğini ortaya koymak için kesin bir konum isteyin, o pasajı alın ve çevresindeki metnin iddiayı desteklediğini doğrulayın.
LongBench-V2 puanının gösterdiği ve göstermediği şeyler
Model kartının LongBench-V2 satırı, 1-shot ayarında tam eşleşme puanlarını bildirir. Tablosu sonuçları temel model değerlendirmeleri olarak etiketler ve tüm temel modellerin aynı iç değerlendirme çerçevesini kullandığını söyler. Ayrıca 0,3 içindeki puanların eşdeğer kabul edildiğini belirtir. Değerler şunlardır:
| Model kartındaki temel model | LongBench-V2 (EM) | Shot sayısı |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
V4-Flash-Base ile V4.1-Flash-Base arasındaki 0,5 puanlık fark, kartın belirttiği 0,3 eşdeğerlik bandından büyüktür, ancak yine de dar bir kıyaslama karşılaştırmasıdır. 45,2 “uzun PDF'lerde %45,2 doğruluk” değildir. Belirli bir temel model, kıyaslama seti, istem kurulumu ve değerlendirici için tam eşleşme puanıdır. Farklı bir istemle sorularınızı yanıtlayan barındırılan bir instruct/API modelini doğrudan puanlamaz.
LongBench-V2, tek belge ve çok belge soru yanıtlama, uzun diyalog, kod depoları ve yapılandırılmış veri dahil altı kategoride 503 çoktan seçmeli soru içerir. Bağlamları 8.000 ila 2 milyon kelime arasında değişir. Kıyaslama yazarları, 15 dakikalık sınır altında uzmanlar için ortalama %53,7 doğruluk ve bildirdikleri değerlendirmede en iyi doğrudan yanıt veren model için %50,1 bildirir. Bu genişlik onu yararlı bir stres testi yapar, ancak toplu bir sayı hangi belge işleminin güçlü veya zayıf olduğunu teşhis edemez. (LongBench-V2 makalesi)
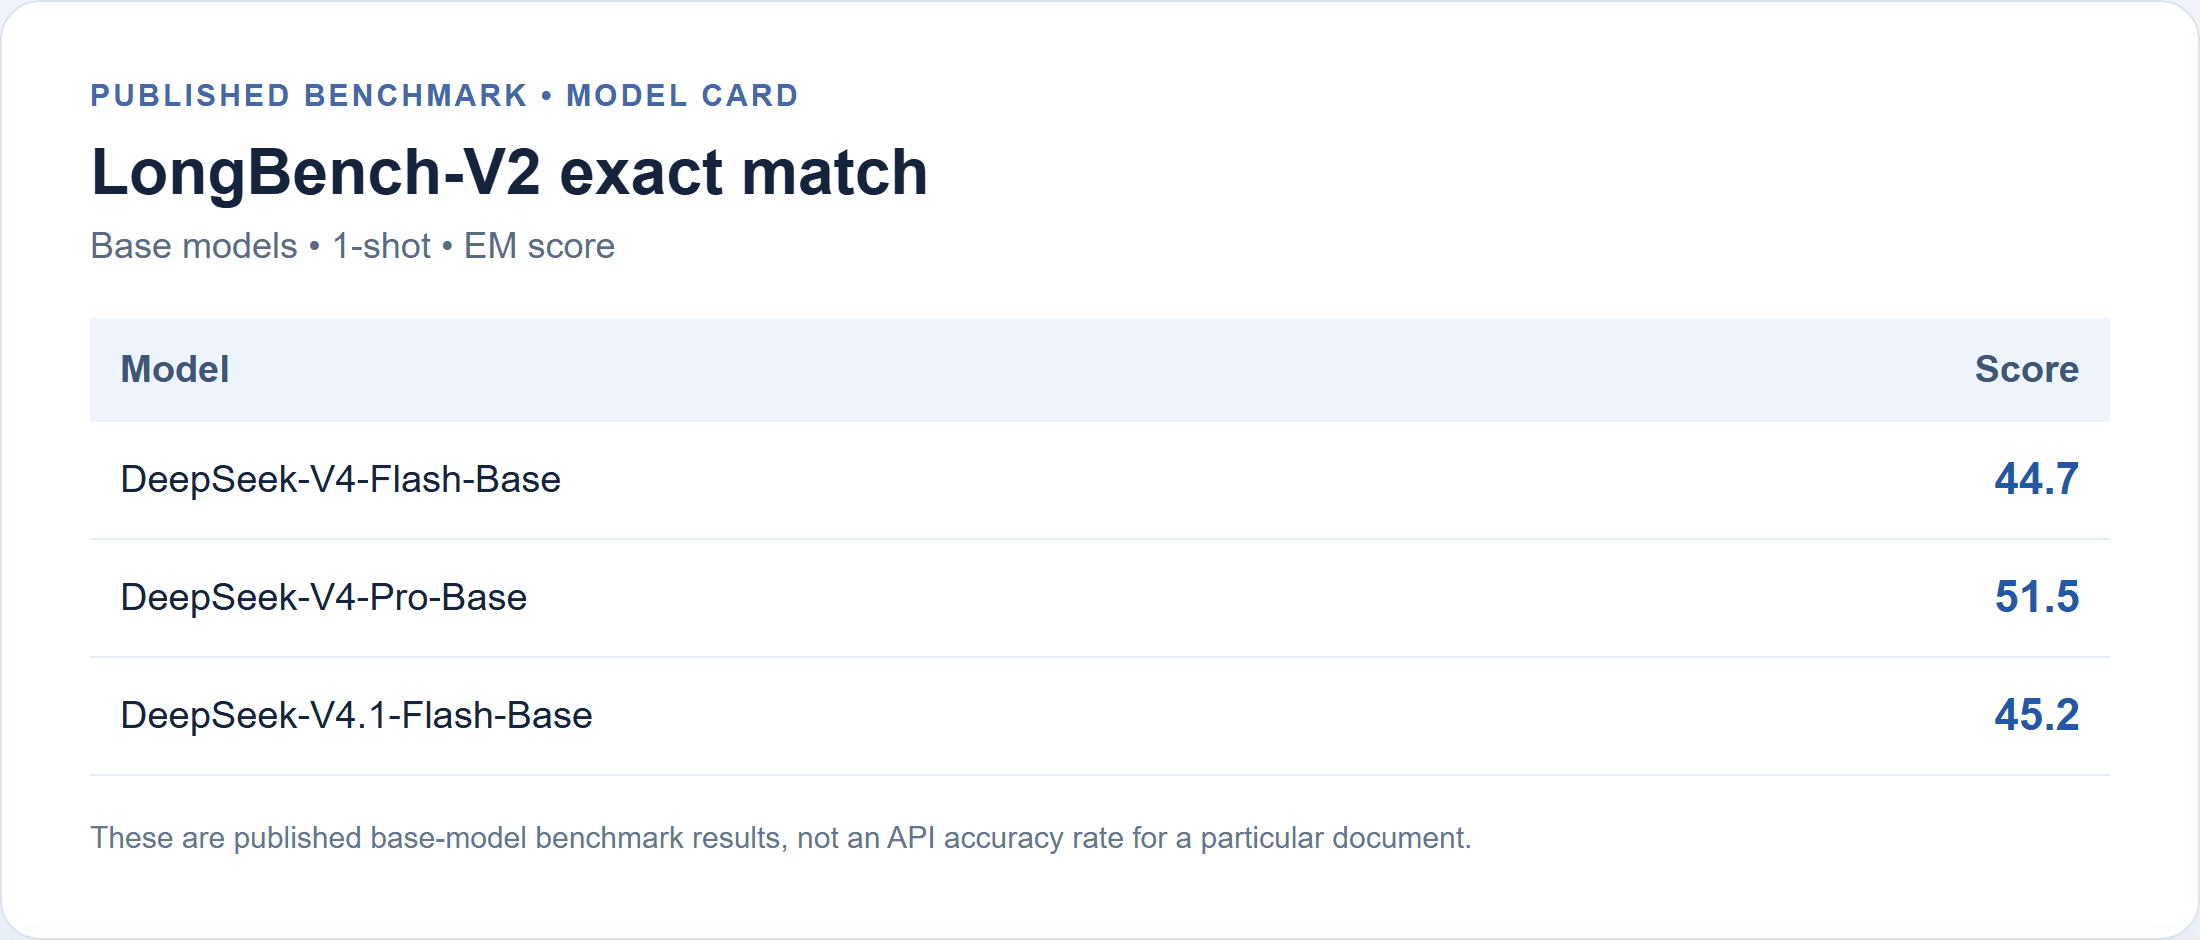
Yayımlanan satır bir temel model, 1-shot sonucudur. Ölçülmüş bir API geçme oranı değildir.
Bir sürüm uyarısı var. DeepSeek'in 17 Ekim sürüm notları, API ve web uygulamasının V4.1-Flash-1017'ye yükseltildiğini ve API model adının deepseek-flash olarak kaldığını söylüyor. Notlar güncellenmiş ajan ve akıl yürütme kıyaslamalarını listeliyor, ancak yeni bir LongBench-V2 sonucu bildirmiyor. Dolayısıyla 45,2, V4.1 Flash temel modeli için yararlı bir yayımlanmış referans olarak kalırken, güncel API derlemesinin uzun belge sorularındaki doğruluğu bu kaynaklarda nicelenmemiş durumda. İlgisiz kıyaslama kazanımlarını belge soru-cevabına aktarmayın. (DeepSeek V4.1-Flash-1017 güncellemesi)
Adil bir uzun belge doğruluk testi nasıl yürütülür
Yararlı bir değerlendirme sabit bir kaynak, bir yanıt anahtarı ve puanlama kuralları gerektirir. Sürümü ve sayfa yapısı paylaşılabilen bir kamuya açık yıllık rapor veya teknik raporla başlayın. PDF'yi ve çıkarılan metni kaydedin, kaynak URL'sini ve erişim tarihini kaydedin ve yerel metin çıkarımı mı yoksa OCR mı kullandığınızı not edin. Modelin iyi idare ettiğini zaten bildiğiniz için bir belgeyi seçmekten kaçının.
Modeli istemlemeden önce yanıt anahtarını kaynaktan kendiniz yazın. Her soru için beklenen yanıtı ve tam sayfa veya bölümü kaydedin. Bu, ikna edici bir yanıtın değerlendirme standardı haline gelmesini önler. Soruları puanlanacak kadar belirli tutarken, bir okuyucunun gerçekte karşılaşacağı belirsizliği koruyun.
Her çalıştırma için aynı belgeyi, soru setini, model tanımlayıcısını, istemi, akıl yürütme ayarını ve çıktı biçimini kullanın. API sıcaklık veya akıl yürütme kontrolleri sunuyorsa bunları kaydedin. Değişkenliği tahmin etmek istiyorsanız seti birden fazla kez çalıştırın; tek çalıştırma bir örnektir, kararlı bir oran değildir. Puanlamadan önce çıktıyı sessizce düzeltmeyin.
Kompakt bir set beş farklı başarısızlık fırsatını kapsayabilir:
| Görev | Örnek soru biçimi | Doğrulanacak şey |
|---|---|---|
| Tek noktalı arama | “Rapor revize edilen politika için hangi tarihi veriyor?” | Tam değer ve atıfta bulunulan sayfa |
| Bölümler arası bağlantı | “Bölüm 2'deki risk, Bölüm 7'deki kontrolle nasıl ilişkilidir?” | Her iki pasaj ve bağlantının belirtilip çıkarım mı olduğu |
| İstisna işleme | “Belirtilen kapsamdan kimler hariç tutulur?” | Dipnot, kapsam ve niteleyiciler |
| Sürüm çakışması | “Revizyon sonrası hangi değer geçerlidir ve neyin yerini almıştır?” | Tarihler, sürüm etiketleri ve her iki konum |
| Eksik bilgi | “Rapor satıcı kopyaları için hangi saklama süresini belirtir?” | Belge hiçbir şey söylemiyorsa bunun kabulü |
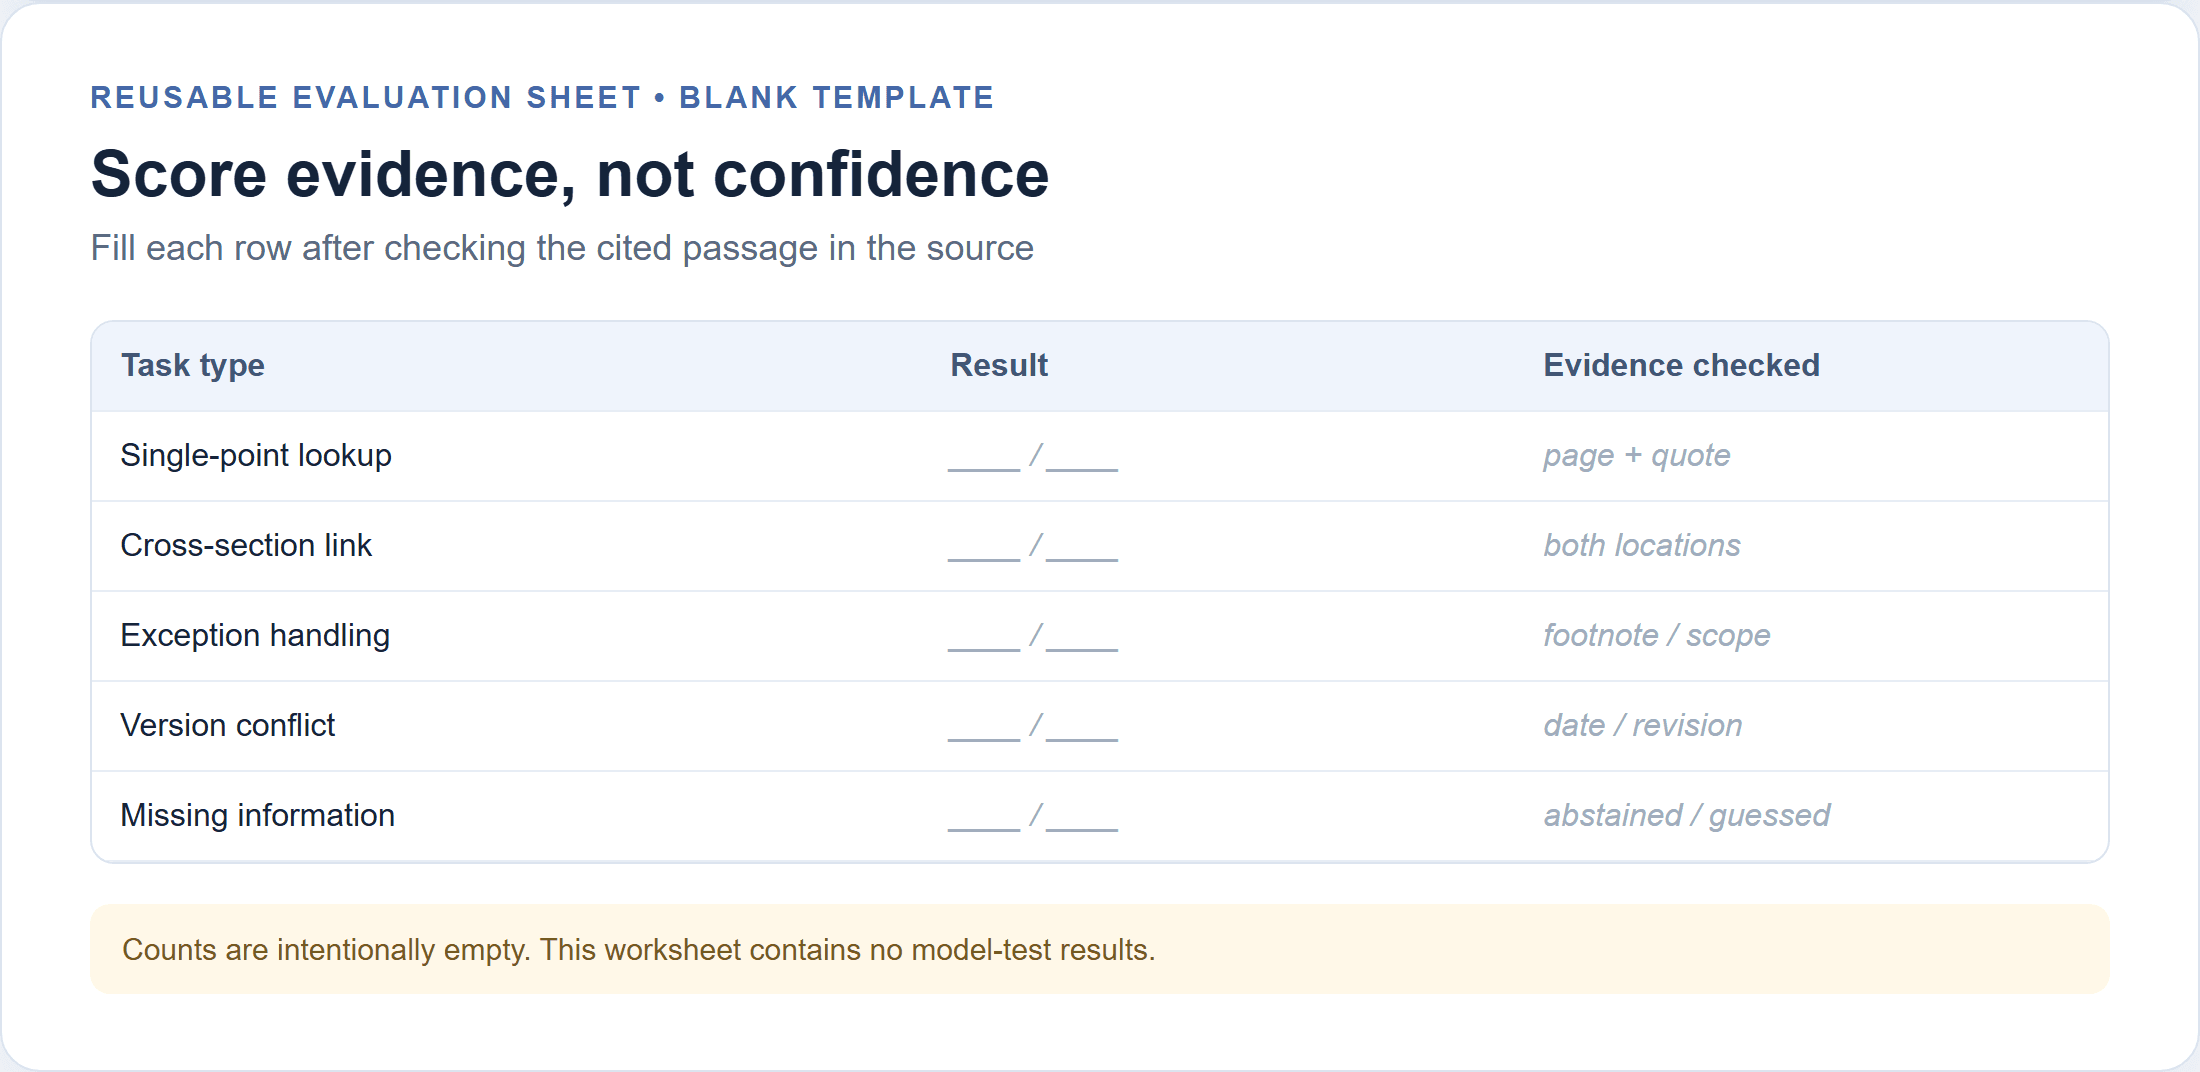
Bu boş bir puanlama çalışma sayfasıdır, sonuç tablosu değildir. Her yanıtı kaynak belgeye göre kontrol ettikten sonra doldurun.
Her yanıtı doğru, kısmi, yanlış, desteklenmemiş veya doğru şekilde çekimser olarak puanlayın. Desteklenmemiş iddiaları yanlış yanıtlardan ayrı sayın çünkü bir yanıt doğru ana başlık yanıtını verip bir ayrıntıyı uydurabilir. Her atfın iddiayı destekleyen pasaja işaret edip etmediğini kontrol edin. Soru sayısını ve kategori sayılarını birlikte bildirin. Genel bir yüzde, modelin dipnotları kaçırdığını mı yoksa yalnızca bilgi bölümlere yayıldığında mı zorlandığını gizler.
Tam kaynak dosyayı, çıkarımı, istemleri, ham yanıtları ve puanlama sayfasını saklayın. Yalnızca paylaşma izniniz olan materyali yayımlayın ve gizli adları veya hesap ayrıntılarını redakte edin. Bir gözden geçiren kişi, puanlanan her yanıtı model çıktısından kaydedilen kaynaktaki bir sayfaya kadar izleyebilmelidir.
Uzun belge yanıtları nerede başarısız olma eğilimindedir
Belirtilen bir belgeye karşı güncel derleme çalıştırması olmadan, V4.1 Flash'ın belirli bir hata oranı veya başarısızlık örüntüsü sergilediğini iddia etmek yanlış olur. Aşağıdaki kategoriler incelenecek şeylerdir, bu modelle ilgili ölçülmüş bulgular değildir.
Kapsam kaybıyla başlayın. Bir gövde paragrafı bir kural belirtirken bir dipnot bunu bir bölge, tarih aralığı veya müşteri sınıfıyla sınırlayabilir. İstisnayı açıkça isteyin ve atıfta bulunulan pasajın bunu içerip içermediğini inceleyin. Yalnızca ana paragraftan bir alıntı yetersiz olabilir.
Ardından sürüm karışıklığını kontrol edin. Raporlar bir taslakta ve revize edilmiş bir bölümde benzer değerleri yineleyebilir. Modelden yalnızca “güncel sayıyı” istemek yerine her değere eklenmiş tarihi veya sürümü adlandırmasını isteyin. Sessizce birini seçerse, doğru seçmiş olsa bile yanıtı eksik olarak puanlayın.
Bölümler arası sorular çıkarımı davet eder. Bir model iki doğru olguyu, belgenin hiç yapmadığı nedensel bir açıklamada birleştirebilir. Doğrudan ifadeleri çıkarımlardan ayrı etiketlemesini isteyin. Ardından çıkarımı kanıtla karşılaştırın ve görev için makul olup olmadığına karar verin.
Son olarak çekimserliği test edin. Yanıtı bulunmayan bir soru ekleyin. Kendinden emin bir tahmin, kulağa makul gelse bile başarısızlıktır. Sözleşmeler, uyumluluk, klinik materyal veya sonuç doğuracak finansal analiz için bir sonuç kullanmadan önce nitelikli bir kişiden özgün metni kontrol etmesini isteyin.
Daha güvenli yanıtlar için bir doğrulama iş akışı
Bu istem yanıtları denetlemeyi kolaylaştırır. Doğruluğu garanti edemez veya kaynak incelemesinin yerini alamaz. Sayfa etiketlerini koruyan bir çıkarımla kullanın, ardından büyük bir dosyanın genel özetini istemek yerine odaklı sorular sorun.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Uzun bir rapor için işi göreve göre bölün, otomatik olarak keyfi sayfa sayısına göre değil. Önce bir kaynak haritası isteyin: bölüm başlıkları, tarihler, tanımlanmış terimler ve ilgili tablolar. Ardından belirli bir konuyu sorgulayın ve destekleyici pasajlarını isteyin. Bölümler arası bir sonuç için, her iki pasajı aynı turda sağlayın veya alın ve modelden bağlantıyı açıklamasını, herhangi bir çıkarımı işaretlemesini isteyin.
Bir insan doğrulama döngüsü kullanın:
- Atıfta bulunulan sayfayı ve alıntıyı özgün dosyada kontrol edin.
- Alıntının komşu istisnaları ve tablo başlıklarını içerdiğini doğrulayın.
- Her iddiayı doğrudan, çıkarımsal, desteklenmemiş veya çürütülmüş olarak işaretleyin.
- Çıkarım önemli yapıyı atladıysa istemi düzeltin veya görevi bölün.
- Bir gözden geçirenin kararı yeniden üretebilmesi için ham isteği ve yanıtı kaydedin.
Barındırılan bir uç nokta kullandığınızda, çalıştırma günlüğüne token kullanımını ekleyin. Atlas Cloud'un model fiyatlandırma sayfası şu anda DeepSeek V4.1 Flash'ı 1M girdi token'ı başına $0.30, 1M çıktı token'ı başına $1.20 ve 1M önbellek okuma token'ı başına $0.03 olarak listeliyor; listelenen indirim yok. Bütçelemeden önce güncel listeyi kontrol edin. Bu fiyat referansı Atlas Cloud içindir, evrensel bir DeepSeek API fiyatı değildir.
Listelenen bu oranlarda, 100.000 önbelleksiz girdi token'ı ve 3.000 çıktı token'ı yaklaşık $0.033 tutar: girdi için $0.030 artı çıktı için $0.0036.
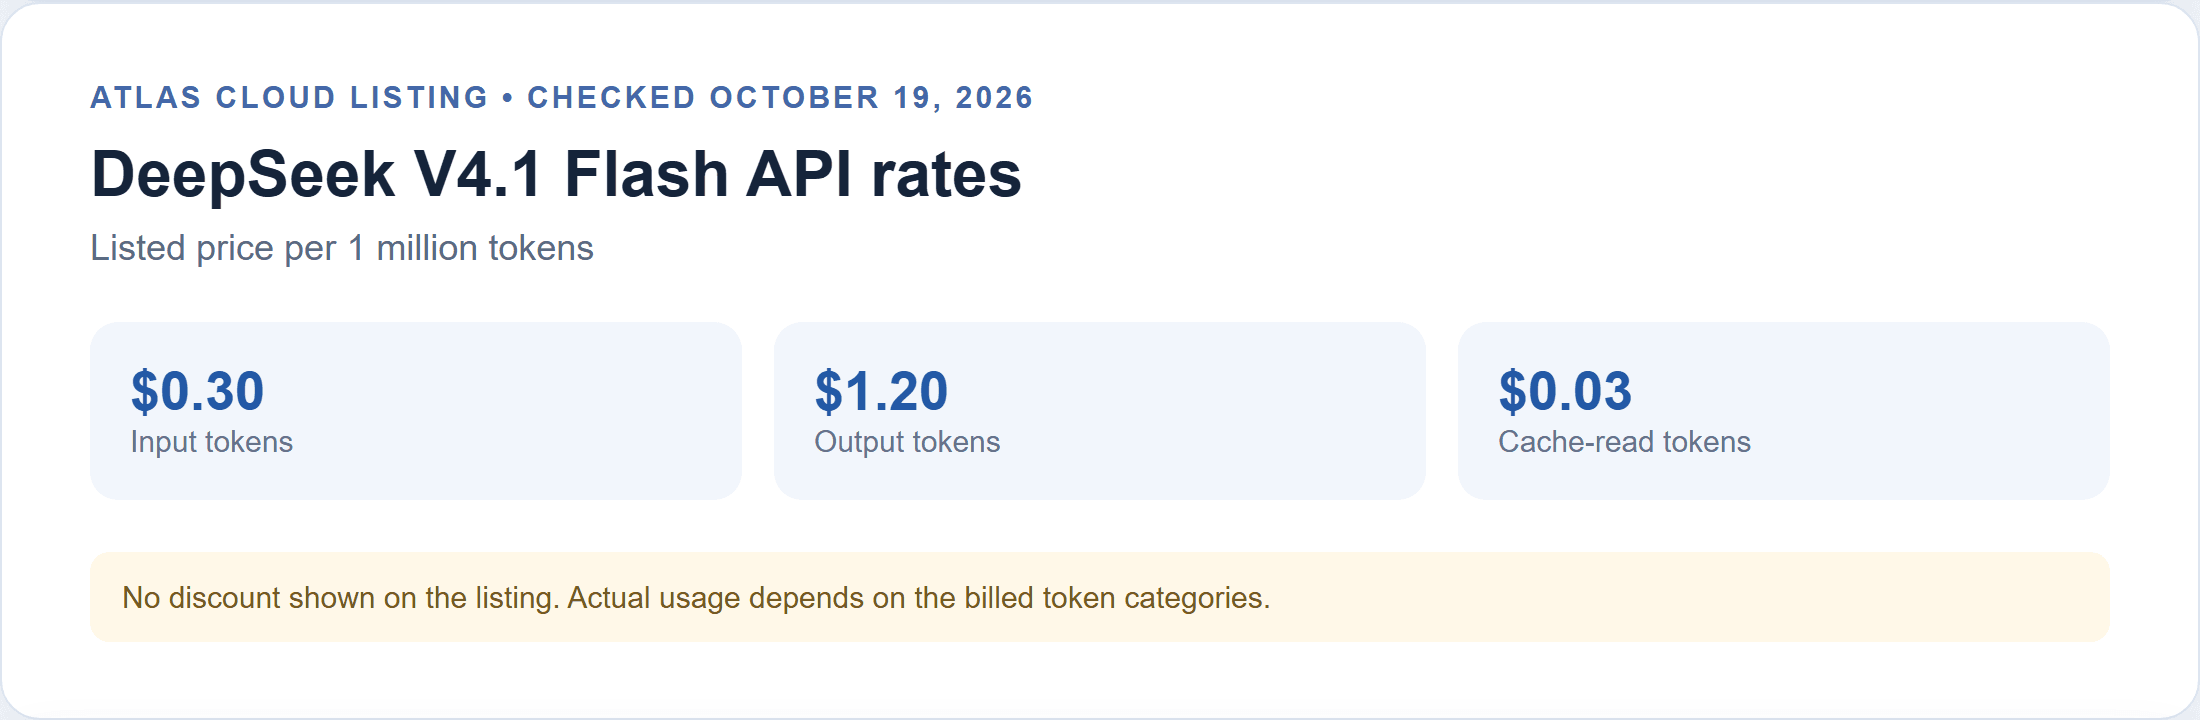
Atlas Cloud fiyatlandırması 19 Ekim 2026'da kontrol edildi; liste indirim göstermiyor. Aynı oranlarda 1M token'lık girdi ve 20.000 token'lık yanıt, önbellek işlemi veya diğer faturalandırılabilir kalemler öncesinde yaklaşık $0.324 tutar. Bunlar aritmetik örneklerdir, ölçülmüş belge testi faturaları değildir. Gerçek girdi istemi ve çıkarılan metni içerir; yinelenen çağrılar kullanımı artırır. Sayfa sayısından tahmin etmek yerine sağlayıcının döndürdüğü token sayılarını kullanın.
Uzun belgeler için DeepSeek V4.1 Flash ne zaman kullanılmalı
Tanımları bulmanız, tarihleri toplamanız, bir bölüm haritası oluşturmanız veya bir kişinin kontrol edeceği bir özet taslağı hazırlamanız gerektiğinde Flash makul bir ilk geçiştir. Bu görevler görünür kanıt izlerine sahiptir ve daha sıkı sorularla yeniden çalıştırılması kolaydır. Yinelenen işler için bilinen yanıtlı soruları saklayın ve model sürümü, çıkarım işlem hattı veya istem değiştiğinde bunları yeniden çalıştırın.
Bir soru uzak bölümleri birleştirdiğinde, bir dipnota bağlı olduğunda veya revizyonları karşılaştırdığında kontroller ekleyin. Atıfları kendi başlarına kanıt olarak değil, gezinme yardımcıları olarak kullanın. Bir yanıt sözleşme yükümlülüğünü, uyumluluk konumunu, finansal açıklamayı veya başka bir yüksek etkili kararı etkileyecekse, nitelikli bir gözden geçirene kaynaktaki her maddi iddiayı doğrulatın.
Yararlı soru, bu modelin belgenizin sizin sürümünüzde ve tam iş akışınızda, kontrol edilmeye dayanan kanıtlarla yanıtlar döndürüp döndürmediğidir. Kendi kullanım durumunuz için DeepSeek V4.1 Flash uzun belge analizi doğruluğunu ortaya koyabilecek test budur.
Sık Sorulan Sorular
1M token'lık bağlam penceresi, bir modelin 1M token'lık bir belgeyi doğru şekilde analiz edebileceği anlamına mı gelir?
Hayır. Desteklenen bağlam kapasitesini tanımlar. Gerçek istek ayrıca yönergeleri ve çıktı bütçesini içerir; çıkarım, arayüz sınırları ve soru zorluğu yararlı kanıtın mevcut olup doğru yorumlanıp yorumlanmayacağını etkiler.
LongBench-V2, belge soru yanıtlama doğruluğuyla aynı şey midir?
Hayır. Birkaç uzun bağlam görev kategorisi içerir ve belirli bir kurulum altında performans bildirir. Bir karşılaştırma sinyalidir; belirli bir PDF, API derlemesi, istem veya alan için garanti değildir.
Tek bir istem mi kullanmalıyım yoksa uzun bir belgeyi bölümlere mi ayırmalıyım?
Yapı önemli olduğunda bir kaynak haritası ve odaklı sorular kullanın. Karşılaştırılması gereken pasajları sentez adımı için birlikte kullanılabilir tutun ve yanıtı doğrulayabilmeniz için sayfa etiketlerini koruyun.
Yapay zekâ tarafından oluşturulan bir özetten gelen atıfları nasıl doğrulamalıyım?
Özgün dosyada atıfta bulunulan her sayfayı açın, alıntıyı ve çevresindeki metni kontrol edin ve pasajın belirli iddiayı desteklediğini doğrulayın. Atıfta bulunulan cümlenin yanı sıra tablo başlıklarını ve dipnotları da doğrulayın.
Girdi ve çıktı token'ları maliyeti nasıl etkiler?
Girdi token'ları belgeyi, yönergeleri ve soruyu kapsar. Çıktı token'ları yanıtı kapsar. Daha uzun istemler, birden fazla çağrı ve yinelenen pasajlar kullanımı artırır; tahminler için faturalandırılan token sayılarını ve sağlayıcının güncel fiyat tablosunu kullanın.


