Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: 2026'da Kodlama İçin Hangi Açık Kaynak Model Kazanıyor?
Kısa Cevap
Saatlerce müdahale gerektirmeden çalışan otonom bir kodlama ajanı oluşturuyorsanız: Kimi K2.6. Terminal-Bench 2.0'da %66,7 puan almış ve yayınlanan kıyaslamalarda 13 saatlik kesintisiz bir oturumda 4.000'den fazla araç çağrısını sürdürmüştür; bu karşılaştırmadaki diğer hiçbir açık modelin ulaşamadığı bir kararlılık tavanıdır.
En iyi ajanik ön yüz geliştiricisine ihtiyacınız varsa: GLM 5.1. Bağımsız olarak doğrulanmış Code Arena Elo puanı 1.530 (ajanik web geliştirmede küresel olarak üçüncü), yalnızca otomatik test paketlerini değil, birebir karşılaştırmalarda gerçek geliştirici tercihini yansıtır.
Token başına maliyet kısıtlayıcı faktörse: MiniMax M2.7 Atlas Cloud'da giriş başına 0,30$/M token ile SWE-Bench Pro'da %56,22 puan alır ve yalnızca 10B etkinleştirilmiş parametreye sahiptir – GLM-5.1'in performansının yaklaşık beşte biri maliyetle %94'ü.
Kod tabanınız 262K bağlam penceresi için çok büyükse: Qwen 3.6 Plus, burada 1M token bağlam desteğine sahip tek model ve bu grupta Terminal-Bench 2.0'da %61,6 ile lider.
Temel Kıyaslamalar Bir Bakışta
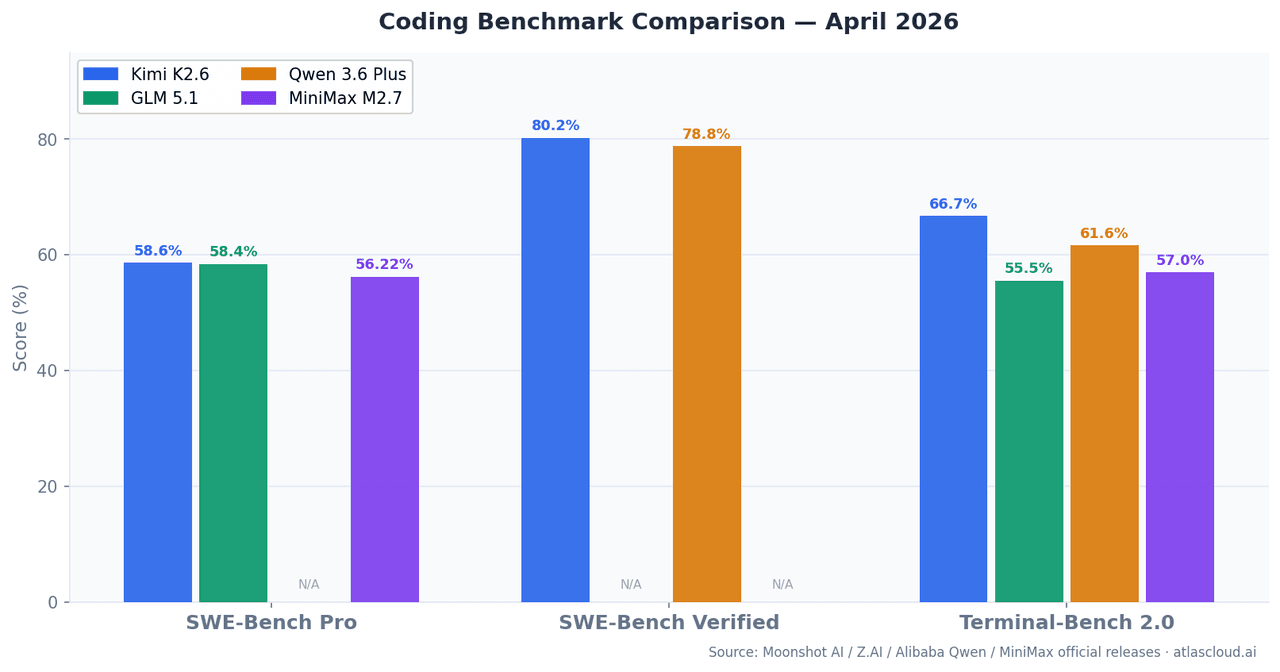
| Model | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Bağlam Penceresi | Etkinleştirilmiş Parametreler |
|---|---|---|---|---|---|
| Kimi K2.6 | %58,60 | %80,20 | %66,70 | 262K | — |
| GLM 5.1 | %58,40 | — | %55+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | %78,80 | %61,60 | 1M | Hibrit MoE |
| MiniMax M2.7 | %56,22 | — | %57,00 | 196K | 10B |
SWE-Bench Pro, eğitim kesme tarihinden sonra açılan gerçek GitHub sorunlarını çözme yeteneğini ölçer, bu da SWE-Bench Verified'a kıyasla veri kirliliği riskini azaltır. Terminal-Bench 2.0, canlı terminal ortamlarında çok adımlı CLI ve kabuk görevlerini test eder – üretim ajanlarının gerçekte yaptıklarına daha yakındır.
Bu yazı, Kimi K2.6, GLM 5.1, Qwen 3.6+ ve MiniMax M2.7'yi karşılaştırmaktadır; daha fazla modeli fiyat ve özellikler açısından yan yana görmek için Atlas Cloud model karşılaştırma sayfasını kullanın.
Kimi K2.6: Uzun Süreli Ajanlar İçin Üretildi
Moonshot AI, Kimi K2.6'yı Nisan 2026'da K2.5'in yükseltmesi olarak, temel olarak uzun oturumlarda ajanik kararlılığı iyileştirerek yayınladı. SWE-Bench Verified'da %80,2 ile Claude Opus 4.6'nın (%80,8) hemen altında yer alır ve SWE-Bench Pro'da %58,6 ile dörtlü arasında liderdir.
En önemli sayı Terminal-Bench 2.0'da %66,7'dir. Terminal-Bench 2.0, SWE-Bench'tan temel bir farkla ayrılır: görevleri gerçek terminal ortamlarında çalıştırır, modelin çıktıyı okumasını, hataları ele almasını, uyum sağlamasını ve yineleme yapmasını gerektirir – sadece yamalar oluşturmak değil. Kimi K2.6'nın tek bir 13 saatlik oturumda 4.000'den fazla araç çağrısı boyunca performansını sürdürmesi bir laboratuvar yapaylığı değildir. Moonshot'ın teknik yayınında belgelenmiş bir davranıştır.
Az rapor edilen bir avantaj: çapraz dil genellemesi. Kimi K2.6, Rust, Go, Python, ön yüz ve DevOps görevlerinde tutarlı performans gösterir. Çoğu kıyaslama değerlendirmesi Python ağırlıklıdır. Üretim yığınınız çok dilli ise bu önemlidir.
Cevabın olmadığı yer: Atlas Cloud'da giriş başına 0,95$/M token ile K2.6, bu gruptaki en pahalı giriş tarafı modelidir. 12 saatlik oturum kararlılığına ihtiyaç duymadığınız, büyük bağlamlarla çok sayıda istek gönderdiğiniz toplu işleme görevleri için maliyet, MiniMax M2.7 veya Qwen 3.6 Plus'tan daha hızlı birikir.
GLM 5.1: Ajanik Ön Yüzün Yıldızı
Z.AI, GLM-5.1'i 7 Nisan 2026'da piyasaya sürdü. MoE yönlendirmeli 754 milyar parametre ile burada ham parametre sayısı bakımından en büyük modeldir. SWE-Bench Pro'da %58,4 puan alır – Kimi K2.6'nın %58,6'sından istatistiksel olarak ayırt edilemez.
Fark yaratan unsur, Arena.ai tarafından 10 Nisan 2026'da bağımsız olarak doğrulanan Code Arena Elo puanı 1.530'dur ve onu ajanik web geliştirme liderlik tablosunda küresel olarak üçüncü sıraya yerleştirir. Bu, otomatik puanlama değil, gerçek geliştiricilerin çıktılara oy verdiği canlı bir birebir karşılaştırmadır. Avantaj, ön yüz UI oluşturma, tam yığın iskele kurma, React/Vue bileşen oluşturma ve NL2Repo'da (doğal dilden tam depo yapıları oluşturma) yoğunlaşmıştır.
Bilmeniz gereken sınır koşulu: GLM-5.1'in ön yüz avantajı gerçektir. Saf algoritmik problemlerde (HumanEval ve MBPP) Kimi K2.6'ya karşı ölçülebilir bir avantajı yoktur. Liderlik tablosu farkı, UI veya web odaklı olmayan problemlerde sıfıra yaklaşır. GLM-5.1'i sırf genel liderlik tablosu sıralamasına dayanarak seçmek, görev alanını kontrol etmeden yapılırsa hata olur.
Atlas Cloud'da fiyatlandırma: Giriş token başına 1,40$'dan başlar – dörtlü arasında en yüksek. Ön yüz oluşturma kalitesi çıktınızı doğrudan etkiliyorsa haklı çıkar.
Qwen 3.6 Plus: Bağlam Boyutu Gerçek Kısıtlama Olduğunda
Alibaba, Qwen 3.6 Plus'ı Mart 2026 sonlarında yayınladı. Terminal-Bench 2.0'da Claude Opus 4.6'ya karşı doğrudan karşılaştırmalarda liderdir (%61,6'ya karşı %59,3) ve SWE-Bench Verified'da %78,8 puan alır.
1M token bağlam penceresi onu ayıran özelliktir. Çoğu 100K token altındaki üretim kodlama görevi için bu karşılaştırmadaki dört modelin de yeterli bağlam kapasitesi vardır ve fark önemsizdir. Qwen 3.6 Plus'ın tek geçerli seçenek olduğu yer: yüzlerce dosya arasında monorepo analizi, büyük ölçekli eski kod tabanı yeniden düzenlemesi veya 262K token'a sığmayan uçtan uca belgeden koda iş akışları.
Hibrit mimari (doğrusal dikkat + seyrek MoE yönlendirme), çok büyük bağlamları işlerken yoğun dönüştürücülere kıyasla daha iyi çıkarım verimi sağlar – yani 1M token yeteneği, saf ölçeklemeye kıyasla nispeten düşük gecikme maliyetiyle gelir.
Atlas Cloud'da fiyatlandırma: Giriş token başına 0,325$'dan başlar. Büyük bağlam görevleri için bu gruptaki en iyi kullanışlı token başına maliyettir.
MiniMax M2.7: Verimlilik İçin Sezgilere Aykırı Durum
MiniMax, M2.7'yi Mart 2026'da yayınladı. Yalnızca 10B etkinleştirilmiş parametre ile SWE-Bench Pro'da %56,22 puan alır – GLM-5.1'in puanının %94'ü, token başına maliyetin yaklaşık beşte biri kadardır.
Bu karşılaştırmadaki sezgilere aykırı sonuç budur. Çıkarım sırasında 10B parametreyi etkinleştiren bir model, sınır ötesi kodlama performansına yaklaşır çünkü MoE mimarisi, tam model ağırlıklarını çalıştırmak yerine uzmanlaşmış alt ağlara yönlendirme yapar. Sonuç olarak daha düşük gecikme, daha düşük maliyet ve parametre sayısının tek başına tahmin edeceğinin ötesinde çıktı kalitesi elde edilir.
M2.7'nin fiyat noktasının ötesine geçtiği kategori: makine öğrenimi mühendisliği görevleri. MLE-Bench Lite'ta (22 makine öğrenimi yarışması) %66,6 madalya oranıyla sadece sınır ötesi kapalı kaynak modellerin ardından ikinci sıradadır. Doğru gradyan birikimi mantığı yazma, özel PyTorch katmanları uygulama, kayıp eğrilerinde hata ayıklama – M2.7 bunları maliyetiyle orantısız bir hassasiyetle ele alır.
Dikkatli olunması gereken yer: 196K bağlam ile M2.7 bu gruptaki en küçük pencereye sahiptir. Büyük depolarda derin çapraz dosya analizi gerektiren görevler, Qwen 3.6 Plus'ın sorunsuzca ele aldığı sınırlara takılabilir.
Atlas Cloud'da fiyatlandırma: Giriş token başına 0,30$, çıkış token başına 1,20$ – yüksek verimli kodlama iş yükleri için en uygun fiyatlı seçenek.
Gerçek Dünya Kodlama Test Vakaları
Vaka 1: Python Backend'de Otonom Hata Düzeltme
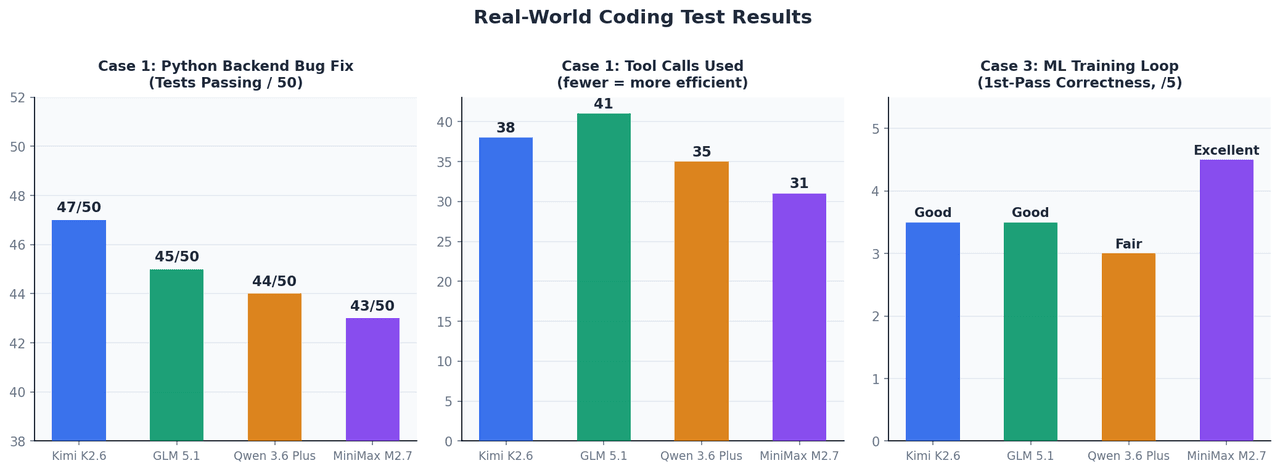
Kurulum: 12 dosyalı bir FastAPI uygulaması, 50 testten oluşan başarısız bir test paketi ve ~45K token bağlam penceresi. İlk prompttan sonra manuel müdahaleye izin verilmez.
| Model | Düzeltmeden Sonra Geçen Testler | Kullanılan Araç Çağrıları | Tamamlanma Süresi |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 dakika |
| GLM 5.1 | 45 / 50 | 41 | ~5 dakika |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 dakika |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 dakika |
Bu bağlam boyutunda dördü de dar bir aralıkta performans gösterir. Kimi K2.6, en zor uç durum hatalarında – özellikle birden çok hata ayıklama döngüsünde çıkarım durumunu korumayı gerektiren async bağlam yöneticisi yaşam döngüsü sorunları ve TypeVar sınır daraltması – öne geçti.
Vaka 2: Spesifikasyondan React Dashboard
Kurulum: Dört grafik türü (çizgi, çubuk, pasta, dağılım), koyu mod geçişi ve yazılı bir İngilizce spesifikasyondan TypeScript türleri içeren eksiksiz bir responsive dashboard oluşturun.
GLM-5.1 ilk geçişte doğru Tailwind yardımcı sınıflarıyla çalışan TypeScript tipli bileşenler üretti. Kimi K2.6 tür hatalarını çözmek için bir yineleme gerektirdi. Qwen 3.6 Plus işlevsel olarak doğru ancak daha az deyimsel JSX üretti. MiniMax M2.7 en hızlıydı ancak manuel temizlik gerektiren bazı eski React kalıpları oluşturdu.
GLM-5.1 ile diğerleri arasındaki fark en çok bileşen mimarisinde görüldü – GLM-5.1 kendiliğinden kompozisyon kalıpları uyguladı ve endişeleri diğerlerinin yapmadığı şekilde ayırdı.
Vaka 3: ML Eğitim Döngüsü Uygulaması
Kurulum: Bir görüntü transformer'ı için gradyan birikimi, AMP karma hassasiyet ve erken durdurma ile bir PyTorch eğitim döngüsü uygulayın. Hedef: hata ayıklama döngüleri olmadan ilk denemede doğru çalışsın.
MiniMax M2.7 öne çıktı – scaler.step() ve scaler.update()'i optimize edici adımına göre doğru şekilde yerleştirdi, çoğu modelin ilk oluşturmada yanlış yerleştirdiği bir ayrıntı. Gradyan birikimi loss / accumulation_steps ölçeklemesi de doğru şekilde ele alındı. Bu, doğrudan %66,6 MLE-Bench Lite madalya oranıyla uyumludur.
Atlas Cloud Fiyat Karşılaştırması (Nisan 2026)
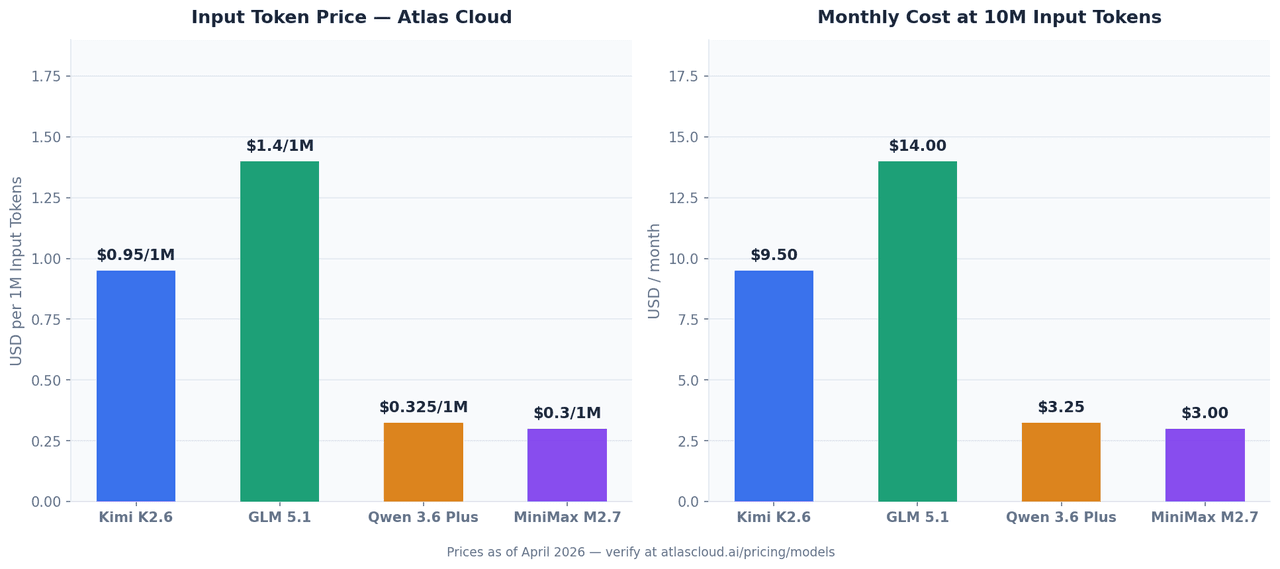
Dört model de Atlas Cloud'un birleşik API'si aracılığıyla kullanılabilir. Aşağıdaki fiyatlar Nisan 2026 itibarıyladır ve değişebilir – güncel ücretleri atlascloud.ai adresinden teyit edin.
| Model | Giriş (1M token başına) | Çıkış (1M token başına) | Atlas Cloud Model ID |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | $1,40'dan başlar | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | $0,325'den başlar | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
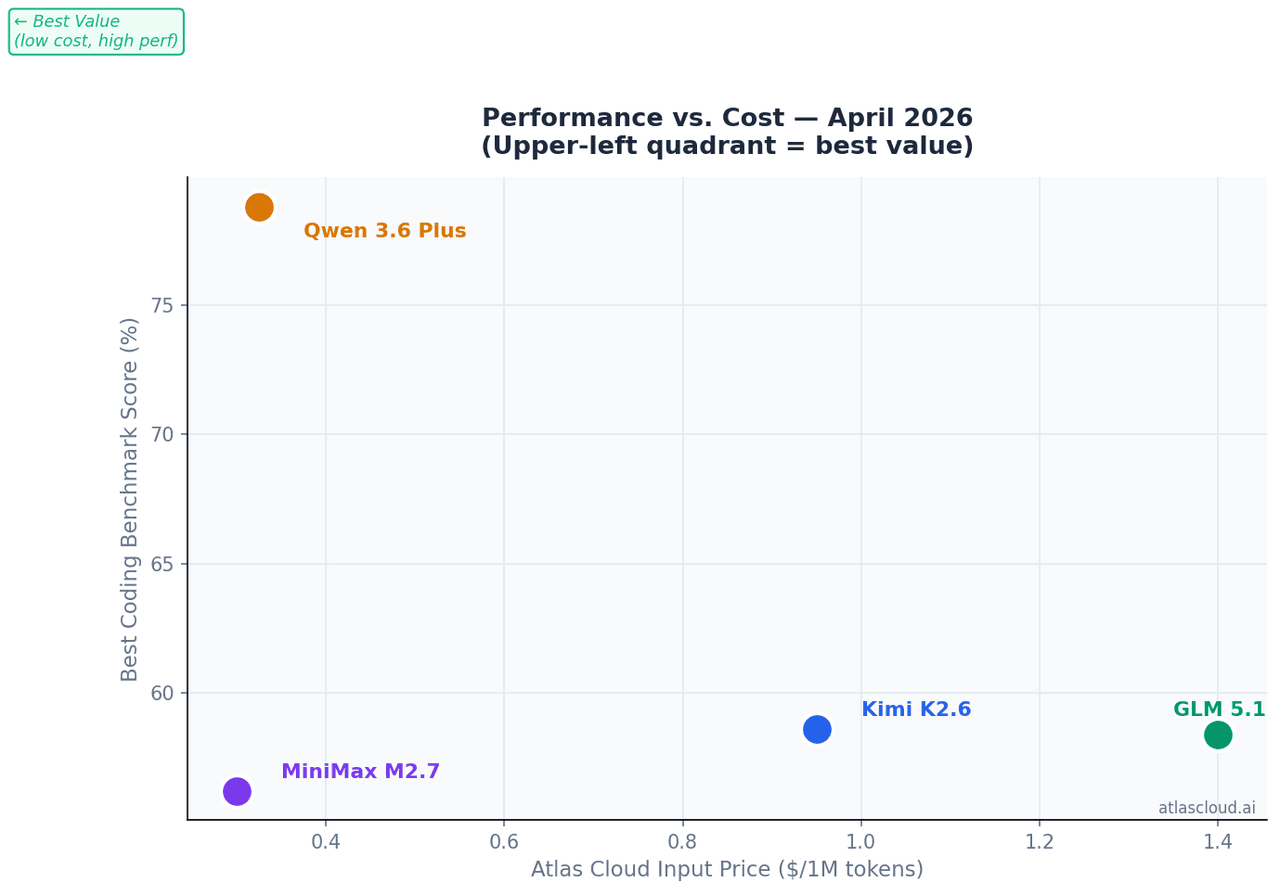
Ayda 10M token giriş – ekip düzeyinde bir kodlama asistanı için gerçekçi bir hacim:
| Model | Aylık Giriş Maliyeti (10M token) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Dört Modeli Tek Bir API Anahtarıyla Çağırma
Dört model de Atlas Cloud'da aynı OpenAI uyumlu uç noktayı paylaşır. Aralarında geçiş yapmak bir satırı değiştirmeyi gerektirir:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Modelleri değiştirmek için bu tek satırı değiştirin 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Sen kıdemli bir yazılım mühendisisin. Yanıt vermeden önce kodu dikkatlice analiz et." 21 }, 22 { 23 "role": "user", 24 "content": "Bu fonksiyonu incele ve tüm hataları tespit et:\n\n[kodunuzu buraya yapıştırın]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Bu OpenAI uyumlu yapı, OpenAI SDK üzerine inşa edilmiş mevcut entegrasyonların Atlas Cloud ile değişiklik yapılmadan çalışması anlamına gelir – yalnızca base_url ve api_key değişir.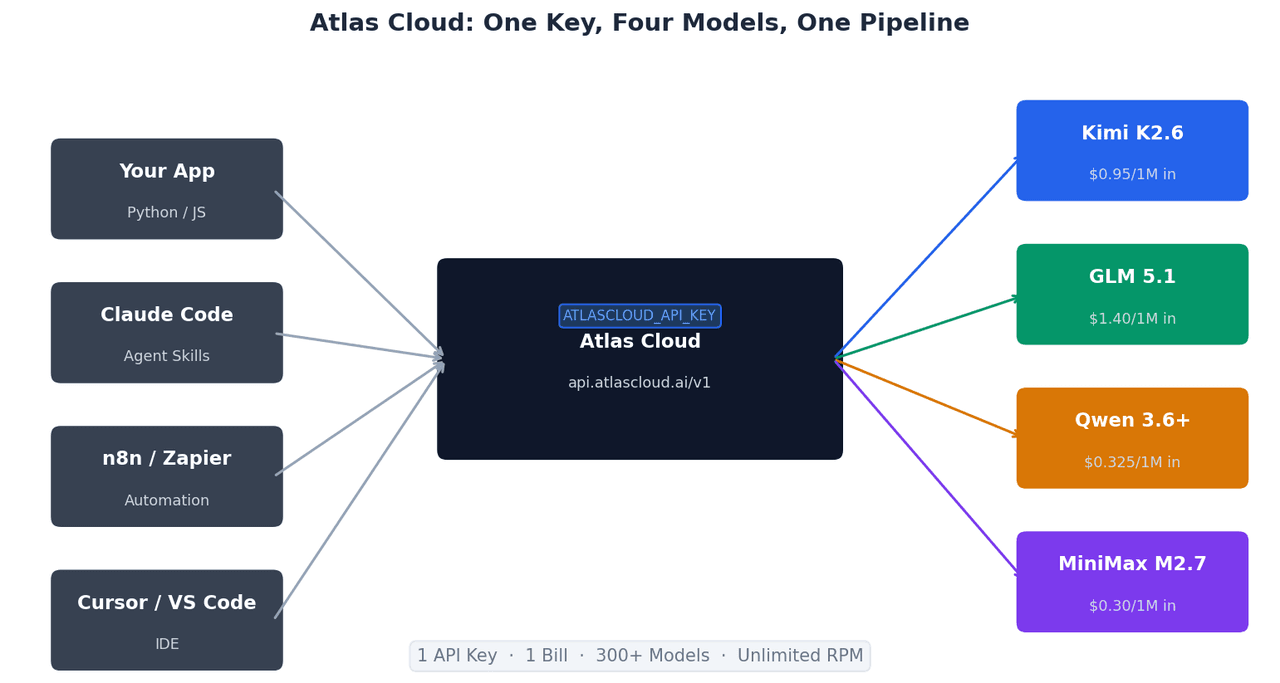
Bu Modeller İçin Neden Atlas Cloud Kullanmalısınız
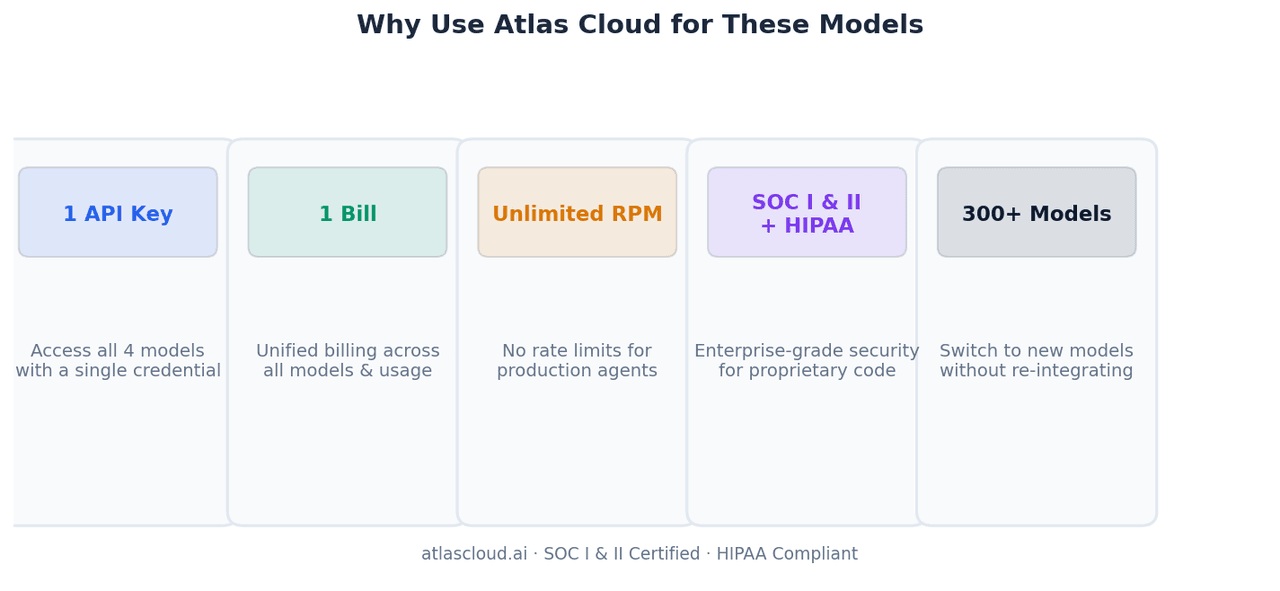
Tek API anahtarı, dört model, tek fatura. Model yönlendirme mantığı çalıştırmak – ön yüz görevlerini GLM-5.1'e, toplu analizi MiniMax M2.7'ye ve uzun vadeli ajanları Kimi K2.6'ya göndermek – dört kimlik bilgisi yerine birini yönetmeyi gerektirir. Aylık mutabakat tek bir faturadır.
Sınırsız RPM. Üretim kodlama ajanları paralel araç çağrıları yapar. Doğrudan sağlayıcı API'lerindeki hız sınırlamaları, çoklu ajan boru hatlarını darboğaz yapabilir. Atlas Cloud bu tavanı kaldırır.
SOC I ve II sertifikalı, HIPAA uyumlu. Bu modeller aracılığıyla özel kaynak kodu işleyen ekiplerin denetlenebilir altyapıya ihtiyacı vardır. Atlas Cloud'un uyumluluk sertifikaları, kodunuzun doğrulanmamış uç noktalardan geçmediği anlamına gelir.
300'den fazla model, aynı entegrasyon kalıbı. Bu modellerden herhangi birinin bir sonraki sürümü çıktığında veya yeni bir model belirli iş yükünüzde onları geride bıraktığında, bunu yönlendirme mantığınıza eklemek yeni bir SDK entegrasyonu değil, tek bir dize değişikliği gerektirir.
Hangi Görev İçin Hangi Model
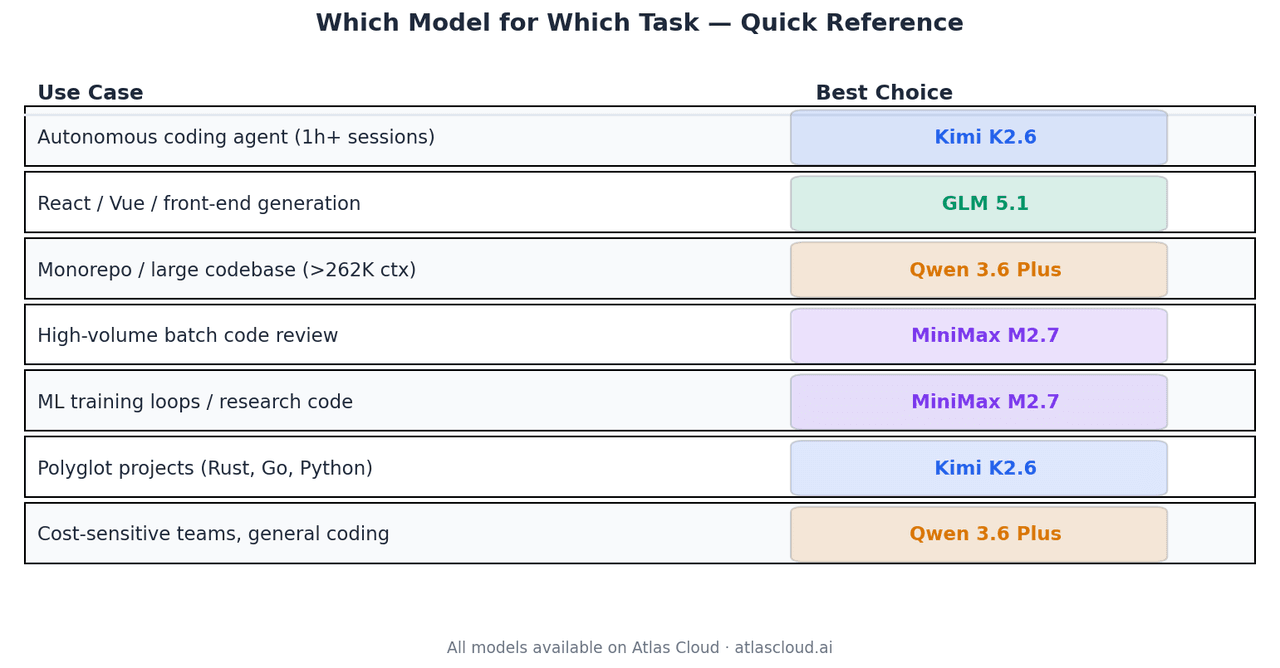
| Kullanım Durumu | En İyi Seçenek | Neden |
| Otonom kodlama ajanı, 1+ saatlik oturumlar | Kimi K2.6 | %66,7 Terminal-Bench 2.0, 4K+ araç çağrısı kararlılığı |
| React / Vue / ön yüz oluşturma | GLM 5.1 | Code Arena Elo 1.530, ajanik web geliştirmede küresel ilk 3 |
| Monorepo veya büyük kod tabanı analizi | Qwen 3.6 Plus | Burada 1M bağlam penceresine sahip tek model |
| Yüksek hacimli toplu kod incelemesi | MiniMax M2.7 | Giriş 0,30$/M token, GLM-5.1 kalitesinin %94'ü |
| ML eğitim döngüleri, araştırma kodu | MiniMax M2.7 | %66,6 MLE-Bench Lite madalya oranı |
| Çok dilli projeler (Rust, Go, Python) | Kimi K2.6 | Belgelenmiş çapraz dil genellemesi |
| Maliyet hassas ekipler, genel kodlama | Qwen 3.6 Plus | Giriş 0,325$/M token, tüm kategorilerde güçlü |
Özet
Bu dört model, standart kıyaslamalarda dar farklarla ayrılıyor. Anlamlı farklılıklar belirli koşullarda ortaya çıkıyor.
Kimi K2.6, otonom uzun süreli ajanlar için doğru cevaptır. GLM 5.1, ön yüz ajanik çalışmalarında liderdir. Qwen 3.6 Plus, bağlam 262K token'ı aştığında tek seçenektir. MiniMax M2.7, kodlama modellerini ölçekte çalıştıran ekipler için maliyet etkin varsayılandır.
Dört model de Atlas Cloud'da atlascloud.ai adresinde tek bir API anahtarı altında, token başına ödeme fiyatlandırması ve minimum taahhüt olmadan kullanılabilir.
Kıyaslama verileri Moonshot AI'nin teknik blogundan, Z.AI geliştirici belgelerinden, Alibaba Qwen ekibi yayın gönderisinden, MiniMax resmi model sayfasından ve Arena.ai bağımsız değerlendirmelerinden alınmıştır. Tüm kıyaslamalar Nisan 2026 verileridir. Atlas Cloud fiyatlandırması yayın tarihi itibarıyla belirtilmiştir – üretim dağıtımından önce güncel ücretleri teyit edin.


