

Bir benchmark liderliği, aynı model bir sonraki çalıştırmada bir gereksinimi kaçırana kadar kesin görünebilir. Faydalı bir Muse Wonder güvenilirlik testi daha dar bir soru sorar: model görevinizi, sizin standardınıza göre, aynı koşullar altında, tekrar tekrar tamamlıyor mu?
İlk kanıtlar karışıktır çünkü testler farklı şeyleri ölçer. Lansman günü yapılan bir görev seti, görev başına tek çalıştırmadan sonra standart Muse Wonder'a çok yüksek bir puan verdi. Başka bir değerlendirme, araştırma analizinde güçlü yönler bulurken anket tasarımı, satış iddiaları ve slayt düzeninde daha zayıf sonuçlar buldu. Hiçbir sonuç, kod tabanınızı veya ajan iş akışınızı ne kadar tutarlı ele alacağını kanıtlamaz.
Önemli çıkarımlar
- Lansman benchmark'larını üretim garantileri olarak değil, yetenek sinyalleri olarak değerlendirin.
- Muse Wonder ve Muse Wonder Full ayrı varyantlardır. Sonuçlarını ayrı tutun.
- Geçme oranını, tekrarlanabilirliği, tamamlanmayı ve kurtarmayı farklı sonuçlar olarak ölçün.
- 10 ila 20 gerçek görevle başlayın, kurulumu sabitleyin ve önemli görevleri en az üç kez tekrarlayın.
- Eşiği yanlış bir yanıtın maliyetine ve insan inceleme sürecinize göre seçin.
Muse Wonder güvenilir mi? Kısa yanıt
15 Ekim 2026 itibarıyla mevcut kanıtlar, genel bir güvenilirlik hükmünü değil, görev bazında bir değerlendirmeyi destekler. Muse Wonder bazı erken kontrollerde iyi performans gösterdi; diğer çalıştırmalar ise hataları veya hâlâ inceleme gerektiren sunum işlerini ortaya çıkardı. Çalışmalar istemler, akıl yürütme ayarları, değerlendiriciler, örneklem büyüklükleri ve deneme sayıları bakımından farklılık gösterir.
(Meta, 12 Ekim 2026), Muse Wonder ve Muse Wonder Full'in profesyonel ve kişisel ajan görevleri için oluşturulduğunu ve Active Memory ile Active Focus adını verdiği özelliklere sahip olduğunu söylüyor. Bunlar amaçlanan davranışa ilişkin ürün iddialarıdır. Bir modelin hatalardan kurtulabildiği iddiası, kendi iş akışınızda kurtarmayı test etmeniz için bir nedendir; güvenilir biçimde kurtulacağının kanıtı değildir.
Standart Wonder'ı Wonder Full'den ayrı tutun. Meta, standart Muse Wonder'ı Model API'si ve Muse Code için listeler; Full ise Muse Code abonelikleri üzerinden sunulur. Standart Wonder'ı daha yüksek bir akıl yürütme ayarında çalıştırmak onu Full yapmaz.
Savunabileceğiniz bir karar için, dağıtmayı planladığınız tam varyantı ve rotayı test edin. Bir görevi yalnızca yazılı bir kabul kuralını karşıladığında ve sonucu kontrol edilebildiğinde başarılı sayın.
Muse Wonder güvenilirlik testi neyi ölçmeli
Doğruluk ve tutarlılık farklıdır
Geçme oranı, kaç denemenin tanımlanmış bir rubriği karşıladığını ölçer. Tutarlılık, aynı görevin tekrarlanan çalıştırmalarının her seferinde kabul edilebilir sonuçlar üretip üretmediğini ölçer. Bir model yüksek geçme oranına sahip olup yine de iş akışınız için önemli olan şekillerde değişkenlik gösterebilir.
Dört boyutu ayrı ayrı izleyin:
| Ölçüt | Ne kaydedilmeli | Örnek kontrol |
|---|---|---|
| Doğruluk | Rubriği geçen denemeler | Çıkarılan toplam kaynak belgeyle eşleşiyor mu? |
| Tutarlılık | Tekrarlanan denemelerin geçip geçmediği ve uyuşup uyuşmadığı | Üç çalıştırma aynı zorunlu kısıtları koruyor mu? |
| Tamamlama kalitesi | İstenen her çıktının mevcut olup olmadığı | Tüm dosyalar, alıntılar ve istenen alanlar dahil mi? |
| Kurtarma | Çalıştırmanın bir arızadan sonra doğru şekilde devam edip etmediği | Bir araç hatasını bildirip güvenle yeniden deniyor ve ardından son durumu doğruluyor mu? |
Kulağa eksiksiz gelen bir yanıt mutlaka eksiksiz değildir. Bir kod değişikliği test gerektirir; bir araştırma özeti izlenebilir kaynaklar gerektirir; bir ajan çalıştırması son eyleminin gerçekleştiğine dair kanıt gerektirir.
Model hatalarını iş akışı hatalarından ayırın
Bir model hatasını sunma veya araç sorunundan ayırt edebilmek için yeterli bağlamı kaydedin. En azından model varyantını ve sürümünü, akıl yürütme ayarını, istemi, araç yapılandırmasını, tarihi, çalıştırma süresini, token veya görev maliyetini ve ham çıktıyı kaydedin.
Başarısızlıkları puanlamadan önce sınıflandırın:
- Model: yanlış olgu, kötü akıl yürütme veya kaçırılmış gereksinim.
- Araç: başarısız API çağrısı, geçersiz araç argümanları veya harici bir sistemden yanlış sonuç.
- Sunma: zaman aşımı, kesinti veya kullanılamayan uç nokta.
- Değerlendirme: belirsiz rubrik veya kabul edilebilir işi kabul edilemezden ayırt edemeyen bir kontrol.
Dört kategoriyi tek bir başarısızlık oranında birleştirirseniz neyi düzelteceğinizi bilemezsiniz.
Mevcut Muse Wonder testleri ne gösteriyor
Meta'nın yayımladığı benchmark karşılaştırmaları, benchmark performansına ilişkin satıcı kanıtlarıdır. Bağımsız olarak yürütülen bir iş akışı değerlendirmesiyle aynı şey değildir. Bağımsız testlerin de sınırları vardır: küçük bir kamu görev seti, tek bir deneme, belirli bir model rotası veya insan tercih puanı yalnızca dar bir soruyu yanıtlar.
Aşağıdaki tablo kanıtları kaynağa ve kapsama göre ayırır. Birleştirilmiş bir puan değil, her sonucun neyi destekleyebileceğine dair bir kılavuzdur.
| Kanıt kaynağı | Neyi test etti | Tarih ve kurulum | Size ne söyleyebilir | Ana sınırlama |
|---|---|---|---|---|
| Meta duyurusu ve model materyalleri | Yetenek benchmark'ları ve amaçlanan ajan özellikleri | 12 Ekim 2026'da duyuruldu; satıcı tarafından bildirilen karşılaştırmalar | Meta'nın hangi yetenekleri vurguladığı ve hangi varyantları yayımladığı | Satıcı testi, iş akışınızda tekrarlanabilirliği ortaya koymaz |
| (Spring Prompt, 13 Ekim 2026) | Anketler, ürün listeleri, slaytlar, reklam planlama, satranç ve görsel arama | 13 Ekim; standart API modeli, genellikle orta düzey akıl yürütme; kamuya açık görevler | Performans göreve göre değişti; bazı değerlendirmeler tekrarlanan ürün listeleme çalıştırmalarını içeriyordu | Çoğu görev küçük örneklemdi; birçok sonuç görev başına tek çalıştırmaydı; bir kodlama veya Muse Code testi değil |
| (Quantslant, 12 Ekim 2026) | Ajanlar, kodlama, yazma, akıl yürütme ve bir uzun belgeyi kapsayan 23 görev | 12 Ekim; OpenRouter üzerinden standart model, düşük akıl yürütme; görev başına tek çalıştırma | Model, bu kurulum altında tanımlanmış görev setini yüksek oranda geçti | Tek bir çalıştırma, çalıştırmadan çalıştırmaya tutarlılığı ölçemez; %100'e yakın sonuçlar görev düzeyinde inceleme gerektirir |
| Topluluk gönderileri | Bireysel kodlama, ajan ve benchmark tepkileri | Lansman dönemi gönderileri; kendi kendini seçmiş kullanıcılar ve görevler | Sırada neyin test edileceğine dair faydalı ipuçları | Anekdotlar ve oylar ölçülmüş geçme oranları değildir |
Kaynak karşıtlığı önemlidir. Quantslant, görev başına tek çalıştırma ve düşük akıl yürütme ayarıyla 23 görevlik setinde %99,7 bildirdi. Ayrıca bir sayıdan kelimeye dönüştürme kodlama görevinde bir başarısız birim testi olduğunu belirtti. Bu sonuç, o belirli sete ilişkin kanıttır; günlük görevlerin %99,7'sinin geçeceğine veya tekrarlanan çalıştırmaların uyuşacağına dair kanıt değildir.
Spring Prompt, 13 Ekim'de API varsayılanlarında standart Wonder için daha değişken bir tablo bildirdi. Araştırma analizi puanı dokuz kamuya açık görevde 93,6/100 iken dokuz anket planından yalnızca üçü tüm kontrolleri geçti. Ürün listeleri için üç tekrarda güvenilir şekilde yayına hazır sayılan oran, olgusal özetlerde %66,1 ve satış özetlerinde %51,8 oldu. Altı slayt destesinden beşi düzen düzeltmesi gerektirdi ve biri sunulabilir olarak değerlendirildi. Bunlar birleşik tek bir puanın parçaları değil, farklı paydalara sahip ayrı ölçümlerdir.
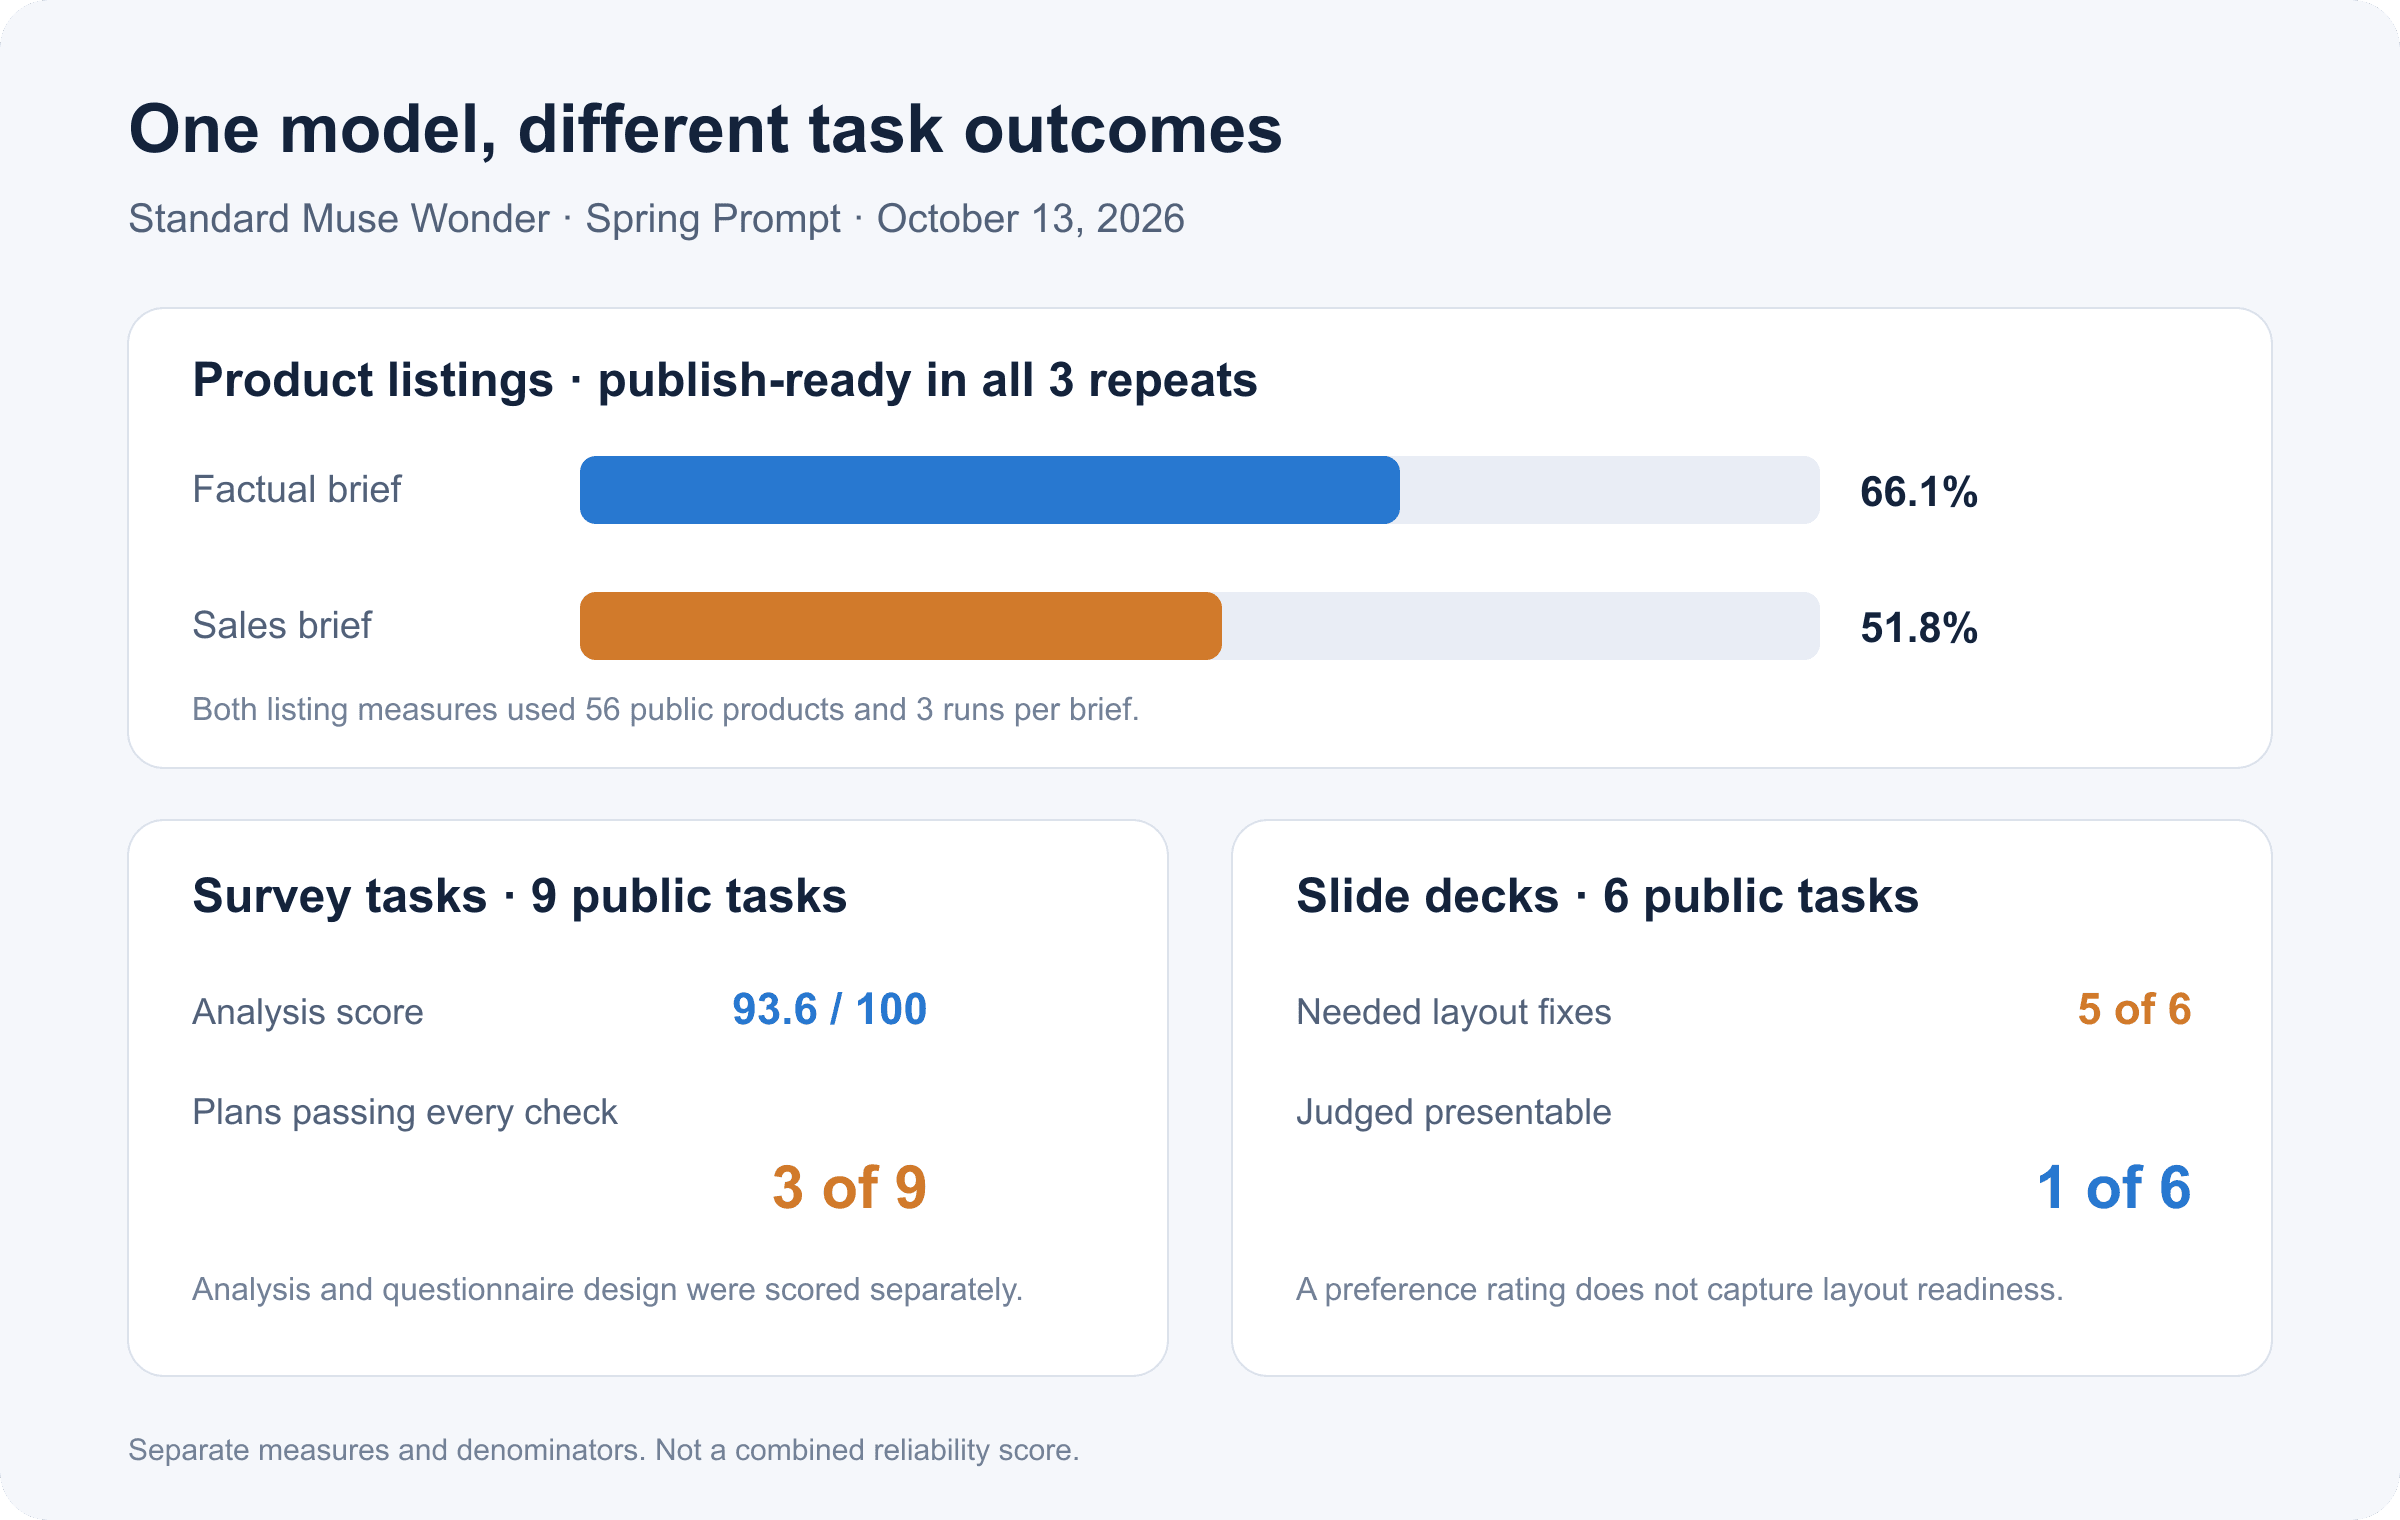
Spring Prompt'un 13 Ekim 2026 standart Muse Wonder sonuçları: tekrar test edilen listeleme geçme oranları, anket analizi ve deste inceleme sonuçları
Tek bir değerlendirmeden bağımsız görev sonuçları. Ölçümler farklı paydalar kullanır ve bir puan halinde birleştirilmeden ayrı ayrı gösterilir.
Spring Prompt'un testleri kodlama, kalıcı bellek veya Muse Code'u ölçmedi. Bu nedenle karşılaştırması, Wonder'ın kodlama için güvenilir olup olmadığını veya Full'ün daha iyi performans gösterip göstermediğini kesinleştiremez. Tek bir geniş etiketin önemli görev farklarını neden gizlediğini gösterir.
Meta'nın lansman makalesi, standart Muse Wonder'ın Meta Model API ve Muse Code üzerinden kullanılabildiğini, Wonder Full'ün ise Muse Code abonelerine sunulduğunu söylüyor. Active Memory ve Active Focus'u faydalı ayrıntıları koruma ve hatalar boyunca işe devam etme özellikleri olarak tanımlıyor. Bu tanımlar test senaryolarını belirlemeye yardımcı olur, ancak lansman makalesi bağımsız bir tekrarlı çalıştırma çalışması değildir.
Lansman haftası topluluk başlıklarında tartışılan kodlama ve 3D derleme iddiaları için gönderileri hipotez olarak değerlendirin. Belirli bir şikâyeti yeniden üretilebilir bir göreve dönüştürün ve çıktıyı doğrulayın. Yorumları veya beğenileri başarı oranına dönüştürmeyin.
Tekrarlanabilir bir Muse Wonder güvenilirlik testi nasıl yürütülür
1. Gerçek işlerden küçük bir görev seti oluşturun
Ekibinizin modelin gerçekten ele almasını beklediği 10 ila 20 görev seçin. Bunları kodlama, olgusal çıkarım, talimat takibi, uzun bağlam ve araç kullanımı gibi kategorilere ayırın. Nesnel testleri, referans yanıtları veya net bir rubriği olan görevleri tercih edin.
Gerçekçi uç durumları dahil edin: eksik girdi, çelişen gereksinimler, kullanılamayan bir araç ve netleştirme sorusunu tetiklemesi gereken bir görev. Onaylanmış süreciniz izin vermediği sürece hassas veya düzenlemeye tabi verileri dışarıda tutun.
2. İstemi, modeli ve ayarları sabitleyin
Tam istemi ve sistem talimatlarını yazın. Model adını ve sürümünü, akıl yürütme düzeyini, araçları, sağlanan bağlamı, tarihi ve varsa süre sınırını kaydedin. Standart Wonder'ı Full ile aynı modelmiş gibi karşılaştırmayın.
Faydalı bir test istemi, modelden kanıtlarını göstermesini ve test edilemez gereksinimleri belirlemesini isteyebilir:
Ekli spesifikasyonu ve uygulamayı okuyun. Yalnızca şunları döndürün: (1) GEÇTİ, BAŞARISIZ veya TEST EDİLEMEZ olarak işaretlenmiş her gereksinim; (2) her durum için tam kanıt; (3) eksik olan herhangi bir gereksinim; (4) her BAŞARISIZ için minimal yeniden üretilebilir bir test. Çıktısını gösteremediğiniz sürece bir testin geçtiğini iddia etmeyin.
Bu bir değerlendirme girdisidir; modelin buna uyacağının garantisi değildir. Ortaya çıkan yanıtı puanlayın ve iddia edilen her test çıktısını bağımsız olarak doğrulayın.
3. Görevleri tekrarlayın ve her denemeyi puanlayın
Yüksek etkili her görevi aynı kurulumla en az üç kez çalıştırın. Bütçe yalnızca tek denemeye izin veriyorsa, sonucu tutarlılık sonucu değil ilk örneklem olarak etiketleyin. Her ham yanıtı koruyun; yalnızca en iyisini bildirmeyin.
Her deneme için bir satır kullanın. Kabul kuralını çalıştırmalar boyunca sabit tutun.
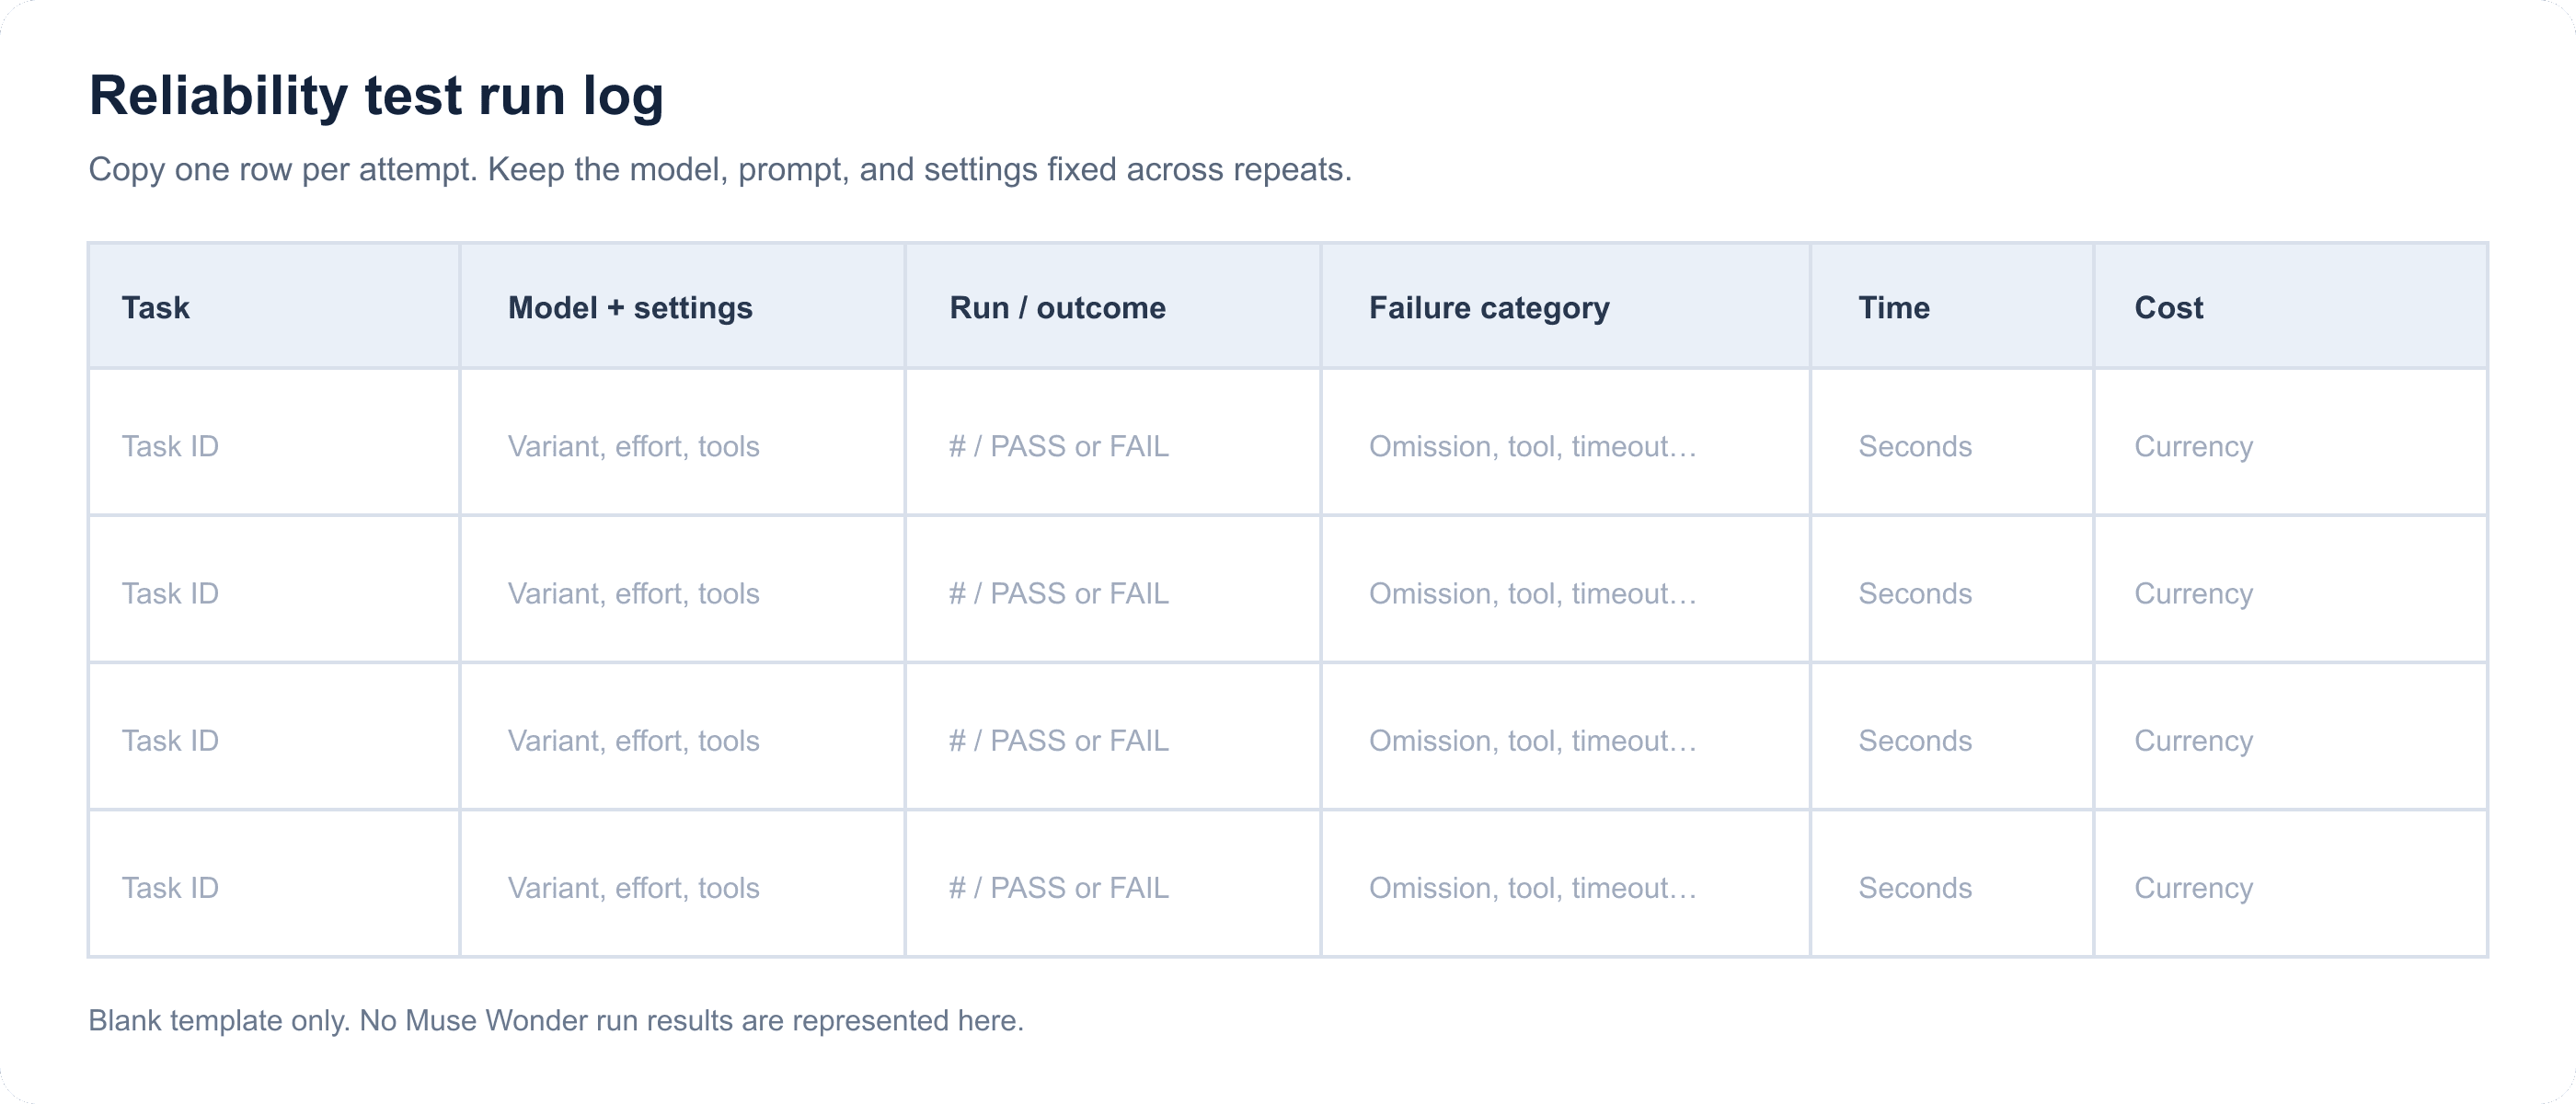
Görev, model, çalıştırma, sonuç, hata, süre ve maliyet alanlarını gösteren boş Muse Wonder güvenilirlik testi günlüğü
Yeniden kullanılabilir boş kayıt şablonu. Deneme başına bir satır doldurun; ölçülmüş Muse Wonder sonucu içermez.
4. Bir başarısızlık günlüğü tutun ve kurtarmayı doğrulayın
Belirli kategoriler kullanın: olgusal hata, eksiklik, başarısız kod testi, araç hatası, zaman aşımı, desteklenmeyen tamamlama iddiası veya biçim uyuşmazlığı. Çok adımlı işlerde çalıştırmanın nerede durduğunu ve bir yeniden denemenin tamamlanmış eylemleri tekrarlayıp tekrarlamadığını veya son durumu doğrulayıp doğrulamadığını not edin.
Kanıt olmadan “tamam” diyen bir ajan tamamlama kontrolünü geçmemiştir. Görevle eşleşen bir test sonucu, kaydedilmiş dosya, kaynak alıntısı veya doğrulanmış durum isteyin.
5. Başarısızlık maliyeti etrafında bir karar eşiği belirleyin
Faydalı bir evrensel geçme oranı eşiği yoktur. Bir kişinin satır satır kontrol ettiği bir taslak, bir veritabanı geçişinden veya otomatik bir ödemeden farklı bir risk profiline sahiptir.
Eşiği üç faktöre göre belirleyin:
- Yanlış bir sonuç ne kadar zararlı veya pahalıdır?
- Bir kişi hatayı herhangi birini etkilemeden önce yakalayabilir mi?
- İş akışı net bir durma ve denetim iziyle güvenli şekilde başarısız oluyor mu?
Düşük riskli taslaklar için inceleme yeterli olabilir. Kod değişiklikleri, finans, hukuk, sağlık veya kullanıcıları etkileyen eylemler için daha güçlü testler ve bağımsız doğrulama kullanın. Yüksek bir ortalamanın tek bir ciddi başarısızlık modunu gizlemesine izin vermeyin.
Görev türüne göre Muse Wonder güvenilirliği
Kodlama ve çok adımlı derlemeler
Deponun gerçek test paketini çalıştırın ve istenen davranışı kontrol edin. Gereksinim kapsamını, regresyon başarısızlıklarını ve modelin iddia ettiği değişikliklerin dosyalarla ve test çıktısıyla eşleşip eşleşmediğini puanlayın. İkna edici bir ekran kaydı veya açıklama, yürütülebilir bir kontrolün yerini tutmaz.
İlk Quantslant seti dört kodlama görevi içeriyordu ve bir sayıdan kelimeye dönüştürme görevi için 16 birim testinden 15'inin geçtiğini bildirdi. Bu küçük, tek çalıştırmalık bir sinyaldir. Spring Prompt açıkça kodlama test etmedi, bu nedenle bulguları kodlama ajanı güvenilirliği hakkında genelleme yapmak için kullanılmamalıdır.
Araştırma ve olgusal çıkarım
İnceleyicinizin denetleyebileceği bir kaynak paketi veya referans yanıtları kullanın. Her olgusal iddiayı birincil bir kaynağa karşı kontrol edin ve uydurma alıntıları ve yanlış atıfları genel yanıt kalitesinden ayrı olarak izleyin.
Spring Prompt'un anket analizi küçük değerlendirmesinde göreli bir güçlü yöndü, ancak anket sorusu tasarımı daha zayıftı. Yüksek bir analiz puanı, anket aracını veya yeni bir araştırma görevinin arkasındaki kaynakları sessizce onaylamamalıdır.
Uzun bağlam ve ajan iş akışları
Modelin her kısıtı koruyup korumadığını, her aracı doğru kullanıp kullanmadığını ve son durumu doğrulayıp doğrulamadığını kontrol edin. Kesinti kurtarmayı kasıtlı olarak test edin: bilinen bir adımdan sonra bir çalıştırmayı durdurun, ardından bir kontrol noktasından devam mı ediyor yoksa bir yan etkiyi tekrarlıyor mu görün.
Meta'nın duyurusu bellek ve kurtarma yeteneklerini tanımlar, ancak burada atıfta bulunulan kamuya açık erken değerlendirmeler kalıcı bellek veya ajan kurtarma için uzun vadeli tutarlılık ortaya koymaz. Bunlara güvenmeden önce bu davranışları doğrudan ölçün.
Muse Wonder ile Muse Wonder Full karşılaştırması: kanıtları ayrı tutun
Muse Wonder ve Muse Wonder Full farklı varyantlardır. Meta'nın lansman bilgileri ayrı erişim yolları tanımlar ve standart Wonder'ın bağımsız API testleri, yalnızca akıl yürütme ayarı değişti diye Full sonuçları haline gelmez.
| Karşılaştırma sorusu | Mevcut kanıt neyi destekliyor |
|---|---|
| Full, maksimum akıl yürütmede standart Wonder ile aynı mı? | Hayır. Onları farklı varyantlar olarak değerlendirin ve tam adı kaydedin. |
| Atıfta bulunulan Spring Prompt API değerlendirmesi Full'ü test etti mi? | Hayır. Standart Wonder'ı test etti; Full bu karşılaştırmanın dışındaydı. |
| Atıfta bulunulan standart API sayıları Full'ü sıralayabilir mi? | Hayır. Full'ü test etmiyorlar. |
| Adil bir karşılaştırma ne sağlar? | Aynı görev seti, puanlama rubriği, tarih aralığı, araç erişimi ve belgelenmiş ayarlar; her iki varyant için tekrarlarla. |
Adil bir karşılaştırma, eşleştirilmiş görevler ve eşleştirilmiş koşullarla başlar. Erişim yolları farklı istemler, araçlar veya faturalama dayatıyorsa bu farkları belgeleyin ve karşılaştırmayı keşifsel olarak adlandırın.
Maliyet, erişim ve Muse Wonder'ın nerede test edileceği
Kabul edilen görev başına maliyeti karşılaştırın, yalnızca token başına listelenen fiyatı değil. Uzun istemler, yeniden denemeler, akıl yürütme token'ları, araç çağrıları, zaman aşımları ve insan incelemesi kullanılabilir bir sonucun maliyetini değiştirir. Quantslant, 12 Ekim 2026'da standart Wonder'ın token ücretlerini milyon giriş token'ı başına $4 ve milyon çıkış token'ı başına $20 olarak bildirdi; kendi 23 görevlik çalıştırması $0.64 tuttu. Bu, bildirilen tek bir rota ve iş yüküdür; evrensel bir görev fiyatı değildir.
Meta'nın güncel lansman duyurusu standart Wonder'ı Meta Model API ve Muse Code üzerinden, Full'ü ise Muse Code abonelikleri üzerinden listeler. Bütçeleme yapmadan önce resmi arayüzde erişimi, bölgesel uygunluğu ve güncel faturalamayı doğrulayın.
Geliştirici platformuna daha geniş bir bakış için Atlas Cloud ile başlayın. 15 Ekim 2026 itibarıyla Muse Wonder'ı model kataloğunda doğrulayamadım, bu nedenle bu makale Atlas Cloud'u bu model için bir yürütme rotası olarak sunmuyor. Ekibiniz halihazırda orada listelenen diğer modelleri karşılaştırıyorsa, Atlas Cloud model kütüphanesi aynı görev setine karşı çalıştırmak için adayları belirlemenize yardımcı olabilir.
Bir Muse Wonder güvenilirlik testinin faydalı sonucu, kanıta bağlı bir dağıtım kararıdır: hangi görev geçti, ne sıklıkla geçti, maliyeti neydi ve hangi inceleme hâlâ gerekli.
Sıkça Sorulan Sorular
Muse Wonder kodlama için güvenilir mi?
İlk lansman testleri yalnızca küçük bir kodlama örneklemi sağlar. Quantslant, bir görevde bir birim testi kaçırmasıyla birlikte dört kodlama görevi bildirdi; Spring Prompt ise kodlama test etmedi. Kendi görevlerinizde depo testlerini çalıştırın ve bir kodlama iş akışı kararı vermeden önce önemli olanları tekrarlayın.
Muse Wonder güvenilirliğini kendim nasıl test ederim?
Sabit bir gerçek görev seti kullanın, tam model ve istem ayarlarını koruyun, geçme ölçütlerini önceden tanımlayın ve her çıktıyı saklayın. Önemli görevleri tekrarlayın ve sonuçları testlerle veya kaynak belgelerle doğrulayın.
Her Muse Wonder görevini kaç kez tekrarlamalıyım?
İlk tutarlılık kontrolü olarak yüksek etkili görevler için en az üç çalıştırma kullanın. Üç deneme hâlâ küçük bir örneklemdir, bu nedenle hatalar maliyetli olduğunda veya çıktılar değiştiğinde seti genişletin.
Muse Wonder ile Muse Wonder Full arasındaki fark nedir?
Farklı kullanılabilirlik yollarına sahip ayrı model varyantlarıdır. Maksimum akıl yürütmedeki standart Wonder'ı Full olarak değerlendirmeyin veya eşleştirilmiş bir test olmadan aralarında sonuç aktarmayın.
Meta'nın Muse Wonder benchmark puanlarına güvenebilir miyim?
Bunları satıcı tarafından bildirilen yetenek kanıtı olarak kullanın ve benchmark kurulumunu okuyun. İstemleriniz, araçlarınız ve tekrarlanan çalıştırmalarınız genelinde tutarlı performansı kanıtlamazlar.
Muse Wonder, Atlas Cloud'da mevcut mu?
15 Ekim 2026 itibarıyla Atlas Cloud'un model kataloğunda doğrulayamadım. Bir yürütme sağlayıcısı seçmeden önce canlı kataloğu kontrol edin.





