多數創作者會從靜態 Arena 排行榜挑選圖像模型,結果卻只能看著寫實人像在三次編輯輪次後崩壞。在這場 GPT Image 2.5 對比 Qwen Image 2.1 的真實世界基準測試中,OpenAI 在零樣本照片寫實度勝出,而 Qwen 2.1 則在反覆修訂中的背景結構穩定性領先。
實證基準測試摘要
| 實證指標 | GPT Image 2.5 | 評分 | Qwen Image 2.1 | 評分 |
| 零樣本寫實度 | 照片寫實肌膚與自然 RAW 光線 | ★★★★☆ (4.5) | 細節銳利;肌膚略顯平滑/油亮 | ★★★☆☆ (3.0) |
| 多輪穩定性 | 到第 5 輪出現全域雜訊與比例偏移 | ★★★☆☆ (3.5) | 背景鎖定;零結構衰減 | ★★★★☆ (4.0) |
| 材質保留 | 逼真深色羊毛與陰影質感 | ★★★★☆ (4.5) | 高對比;有光澤/塑膠化偏移風險 | ★★★☆☆ (3.0) |
| 編輯控制 | 視覺定位點;全畫布重新編碼 | ★★★★☆ (4.0) | 繪製遮罩與原生透明 RGBA | ★★★★☆ (4.5) |
| 最佳製作適用 | 高階單次生成商業素材 | 4.1 / 5 | 自架工作流程與鎖定背景編輯 | 3.6 / 5 |
關鍵要點
- GPT Image 2.5 精準掌握單次生成照片寫實,在單次渲染中呈現逼真肌膚透光感與類 RAW 動態範圍。然而,其全畫布重新編碼會導致全域雜訊累積,並在第 5 輪出現解剖式透視縮短。
- Qwen Image 2.1 運用具 KV 快取鎖定的 32 層 DiT,在多輪編輯中讓背景幾何完全無偽影。取捨在於局部處理:重複的目標遮罩編輯往往會過度飽和鏡面高光,讓自然肌膚變得油亮,讓霧面布料變得光亮。
當你優先追求純淨的單次生成寫實度時,選擇 GPT Image 2.5。如果你的流程需要自架控制、鎖定背景編輯或原生 RGBA 去背,則選擇 Qwen Image 2.1。
單提示照片寫實:光線物理、肌膚紋理與材質保真度
以提示工程創作的創作者常花數小時微調光線提示,卻發現視覺瑕疵源自基準渲染,而非反覆編輯。在下達修改指令前測試零樣本視覺保真度,能建立必要的對照基準,協助攝影師區分模型既有極限與真正的多輪編輯劣化。
測試 1:強烈直射光下的人類肌膚微細節
為評估壓力下的原始渲染機制,兩款模型都使用未修圖特寫人像提示進行測試,內容包含強烈正午陽光、肌膚紋理變化與解剖學微表情。
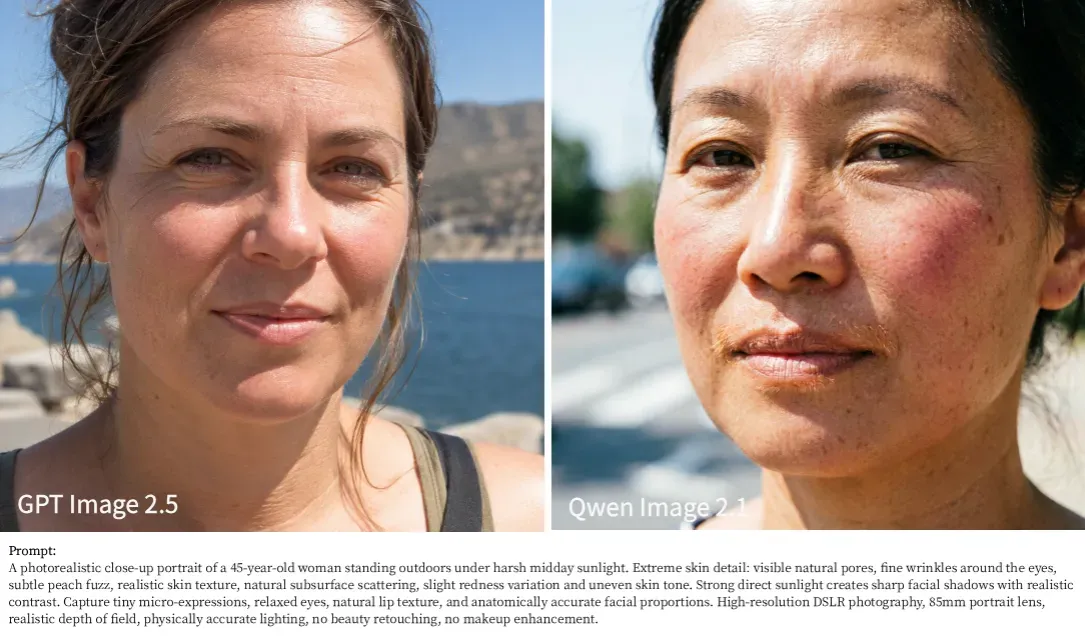
關鍵視覺觀察與細節解析:
- 次表面散射與陰影過渡(GPT Image 2.5 勝出):
GPT Image 2.5 以高度準確度模擬光學物理。在 85mm 人像設定中,光線自然擴散於雙頰與額頭,產生逼真次表面散射,並伴隨眼周與鼻樑周圍平順的陰影衰減。
- 字面提示遵循 vs. 塑膠感(Qwen Image 2.1 取捨):
Qwen Image 2.1 能緊密回應細節提示,準確呈現臉部細毛與不均勻的雙頰色素。然而其鏡面高光可能過於強烈,使鼻與額頭留下不自然的油亮光澤。
- 微表情與解剖準確度:
GPT Image 2.5 呈現極度放鬆的臉部肌肉,並具解剖精準的眼周皺紋與唇紋。雖然 Qwen 2.1 達到高表面銳利度,但放大後肌膚紋理顯示微圖案重複,在高對比光線下暴露其合成擴散根源。
測試 2:布料與材質保真度(羊毛粗糙度 vs. 輪廓光高光)
理解物理材質互動——例如霧面羊毛的光吸收與編織亞麻的不均勻竹節紋理——對電子商務與商業時尚工作流程至關重要。
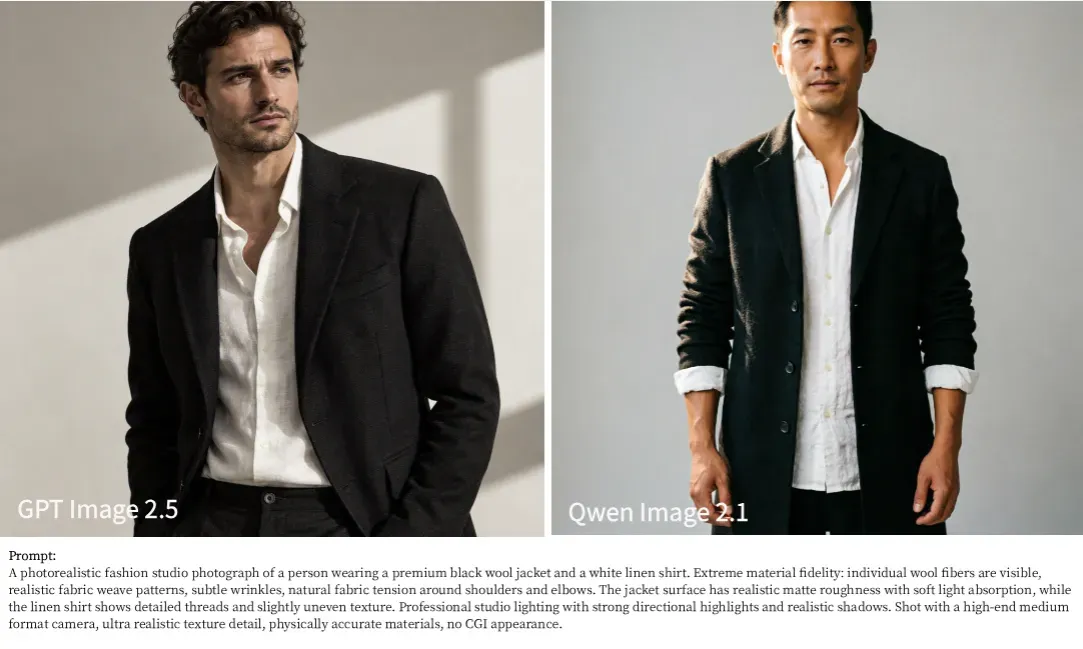
關鍵視覺觀察與材質反應:
- 深色布料分離與陰影深度(GPT Image 2.5 勝出):
GPT Image 2.5 處理低頻深色調而不犧牲細節。黑色羊毛外套上的褶皺、翻領縫線與細微微陰影仍清晰可見,並由白色亞麻襯衫上的逼真織紋與鈕扣張力痕跡取得平衡。
- 邊緣分離與輪廓光精準度(Qwen Image 2.1 優勢):
Qwen Image 2.1 展現對直接定向光線的出色控制。輪廓光捕捉深色外套邊緣,明確凸顯肩部與手臂的微觀羊毛纖維。
- 材質密度與陰影壓縮(Qwen Image 2.1 限制):
雖然 Qwen 2.1 產生格外銳利的外輪廓,其深色羊毛渲染在非照明區域傾向陰影壓縮與死黑。與 OpenAI 的 Sunburst 等級相比,外套內褶失去細微織紋,使陰影下的整體材質反應更為平坦。
測試 3:產品攝影、金屬拉絲紋理與鏡面反射
評估金屬鏡面高光、玻璃折射與環境反射,可揭示模型在商業產品攝影中多忠實地實現 PBR 渲染流程。
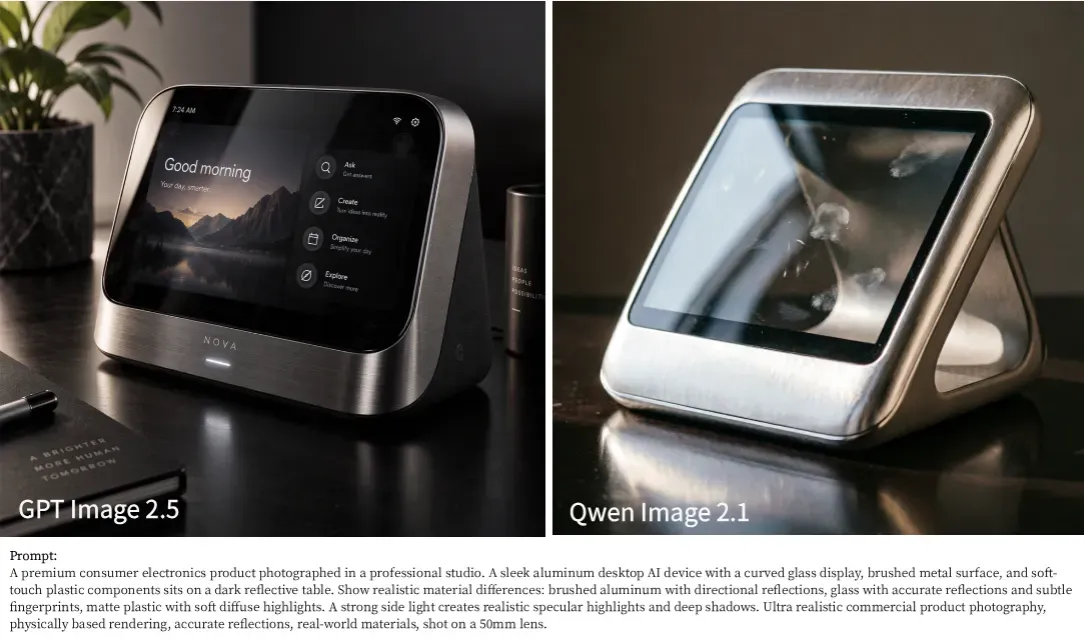
關鍵視覺觀察與光學物理:
- 金屬表面物理與各向異性反射(GPT Image 2.5 勝出):
GPT Image 2.5 以高精準度處理拉絲鋁。下方邊框的水平紋理沿材質自然反射鏡面高光,避免烤漆金屬的平板外觀。它也在逼真玻璃反射下清晰疊加銳利、易讀的 UI 元素。
- 銳利如刀的鏡面邊緣高光與玻璃污痕(Qwen Image 2.1 優勢):
正如對工業設計主體的假設,Qwen Image 2.1 擅長渲染高對比鏡面反射。橫跨玻璃表面的直接柔光箱反射,具有乾淨、俐落的邊界幾何。它也嚴格遵循指紋污痕要求,以高視覺衝擊力捕捉玻璃上的微小瑕疵。
- 反光桌面衰減與材質區分:
雖然 Qwen 2.1 渲染出搶眼的高光邊緣,其金屬框在陰影區域略偏向光滑銀色塑膠。相較之下,GPT Image 2.5 在拉絲金屬正面、深色霧面塑膠背面與光澤玻璃顯示器之間維持清晰材質區分,同時保留深色桌面上的自然鏡面衰減。
測試 4:複雜 HDR 環境、動態範圍與大氣霧霾
高對比環境,例如逆光雨後街道及其反光濕路面與濃重陰影,清楚暴露模型曝光準確度的極限。
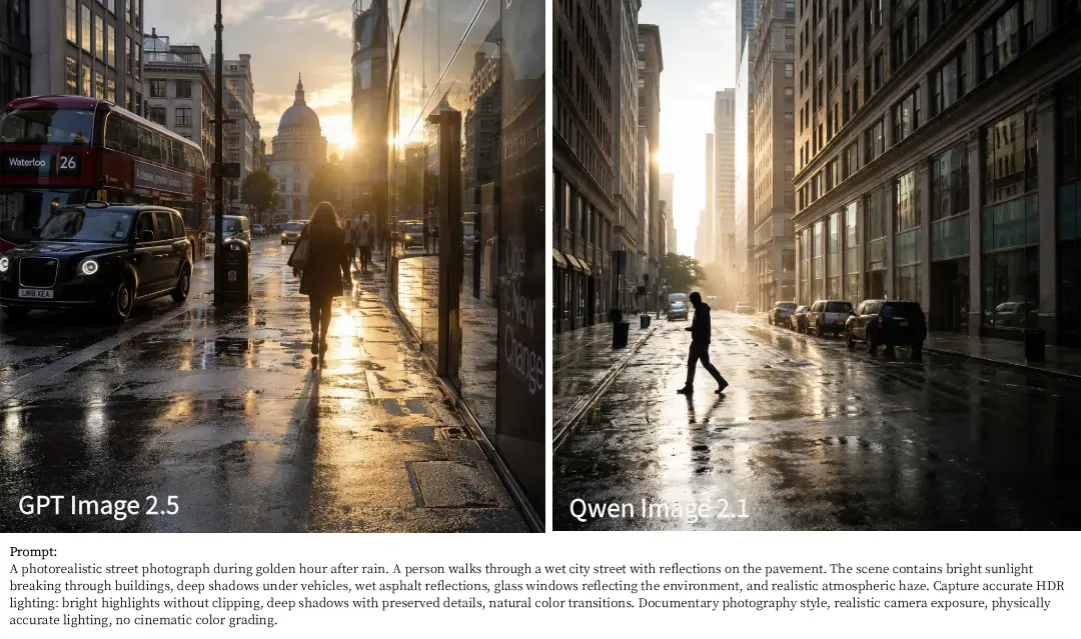
關鍵視覺觀察與曝光機制:
- 寬廣動態範圍與陰影細節保留(GPT Image 2.5 勝出):
GPT Image 2.5 展現優異的相機感光元件模擬,模仿全片幅 RAW 曝光。即使背景建築有直接黃金時刻陽光穿透,它仍在左側雙層巴士與黑色計程車下方保留出色陰影細節,呈現清晰車牌文字與輪胎輪廓,且不讓天空亮部過曝。
- 路面反射清晰度與邊緣銳利度(Qwen Image 2.1 優勢):
Qwen Image 2.1 擅長渲染俐落環境反射。前景濕瀝青捕捉行走行人與高聳石造立面的銳利鏡像反射。其在複雜建築窗戶間的整體幾何清晰度仍格外乾淨。
- 亮部裁切與大氣衰減:
雖然 Qwen 2.1 在濕地面渲染出搶眼鏡面光痕,其曝光引擎在強烈逆光區域出現輕微亮部裁切——在太陽與地平線交會處產生純白光暈。相較之下,GPT Image 2.5 以更高光學準確度處理體積霧與細微金光衰減,避免嚴重的裁切偽影。
總結評分表:照片寫實基準測試(測試 1–4)
為綜整四項嚴格照片寫實基準測試的發現,下表凸顯各模型在八項關鍵視覺保真度指標中的優勢。
| 類別 | GPT Image 2.5 | Qwen Image 2.1 | 核心光學差異 |
| 肌膚毛孔 | ✓ | GPT 2.5 呈現逼真肌膚微紋理與細微毛孔,沒有 AI 噴修感。 | |
| 微表情 | ✓ | GPT 2.5 捕捉自然臉部肌肉張力與溫度,避免僵硬表情。 | |
| 陰影深度 | ✓ | GPT 2.5 以完整類 RAW 動態範圍保留車輛與建築下方的深色陰影細節。 | |
| 布料紋理 | ✓ | GPT 2.5 呈現自然羊毛織紋與可觸帶有機纖維絨毛,且不過度銳化。 | |
| 鏡面高光 | ✓ | Qwen 2.1 在濕路面與金屬表面產生俐落、高對比鏡面反射。 | |
| 產品材質 | ✓ | GPT 2.5 在混合霧面與光澤材質間達成物理準確的漫射/鏡面平衡。 | |
| 乾淨邊緣 | ✓ | Qwen 2.1 擅長銳利幾何線條、硬表面建築與邊緣定義。 | |
| 自然寫實度 | ✓ | GPT 2.5 提供未修圖、紀錄片風格的相機質感,沒有合成「AI 光澤」。 |
單提示測試關鍵要點:
- GPT Image 2.5 為紀錄片式照片寫實的整體贏家:在有機人體物理肌膚/表情、複雜陰影深度與自然色彩科學方面占優勢。它避免高對比場景裁切,使其成為商業人像、寫實街拍與編輯設計的首選。
- Qwen Image 2.1 最適合銳利建築與硬表面:透過超乾淨邊緣、俐落鏡面高光與建築精準度展現出色視覺衝擊力,但偏向更高光學對比,偶爾出現亮部裁切。
多輪迭代編輯壓力測試:5 輪劣化基準測試
創意總監常眼睜睜看著純淨 AI 人像在僅僅三次連續提示修訂後劣化成像素糊塊。為在不依賴廠商行銷說法的情況下評估多步驟提示保真度,兩套系統都接受標準化 5 輪編輯壓力測試。
5 步基準測試方法
壓力測試在五個連續編輯指令中衡量主體保留、背景替換保留與逐輪品質流失:
- 第 1 輪(基準): 在攝影棚設定中渲染的高細節照片寫實人像。
- 第 2 輪(主體編輯): 改變服裝顏色與外套材質,同時保留臉部身分。
- 第 3 輪(背景替換): 將主體從攝影棚移至日落時分的戶外城市街頭。
- 第 4 輪(光線調整): 將環境光源轉為高對比霓虹夜景反射。
- 第 5 輪(微細節新增): 加入逼真雨滴與肌膚水光反射。
各迭代輪次的模型效能
逐輪評估兩套視覺引擎,凸顯多輪修圖期間潛空間雜訊累積方式的關鍵架構差異。
| 編輯輪次 | GPT Image 2.5 效能 | Qwen Image 2.1 效能 |
| 第 1–2 輪 | 主體保留與服裝紋理調整完美;第 2 輪背景替換期間有自然黃金時刻輪廓光包覆。 | 第 1 輪臉部保留清晰;第 2 輪有效替換背景,但環境光包覆與背景模糊感覺略不如 GPT 2.5 自然。 |
| 第 3 輪 | 平順的背景與霓虹重新打光處理,具逼真膚色與細微環境光暈。 | 過度飽和霓虹高光,造成不自然的油亮、塑膠感臉部肌膚紋理。 |
| 第 4 輪 | 乾淨地重新照亮臉部輪廓;保留霧面棉質外套紋理與細微表面濕氣。 | 嚴重材質崩壞:霧面風衣變成不自然的光澤乙烯基/塑膠雨衣。 |
| 第 5 輪 | 擴展為全身,但產生尷尬身體比例與不自然透視縮短。 | 比例良好的構圖:呈現解剖準確的全身行走姿勢,但持續油亮肌膚反射降低整體寫實度。 |
視覺迭代進展(5 輪基準測試)
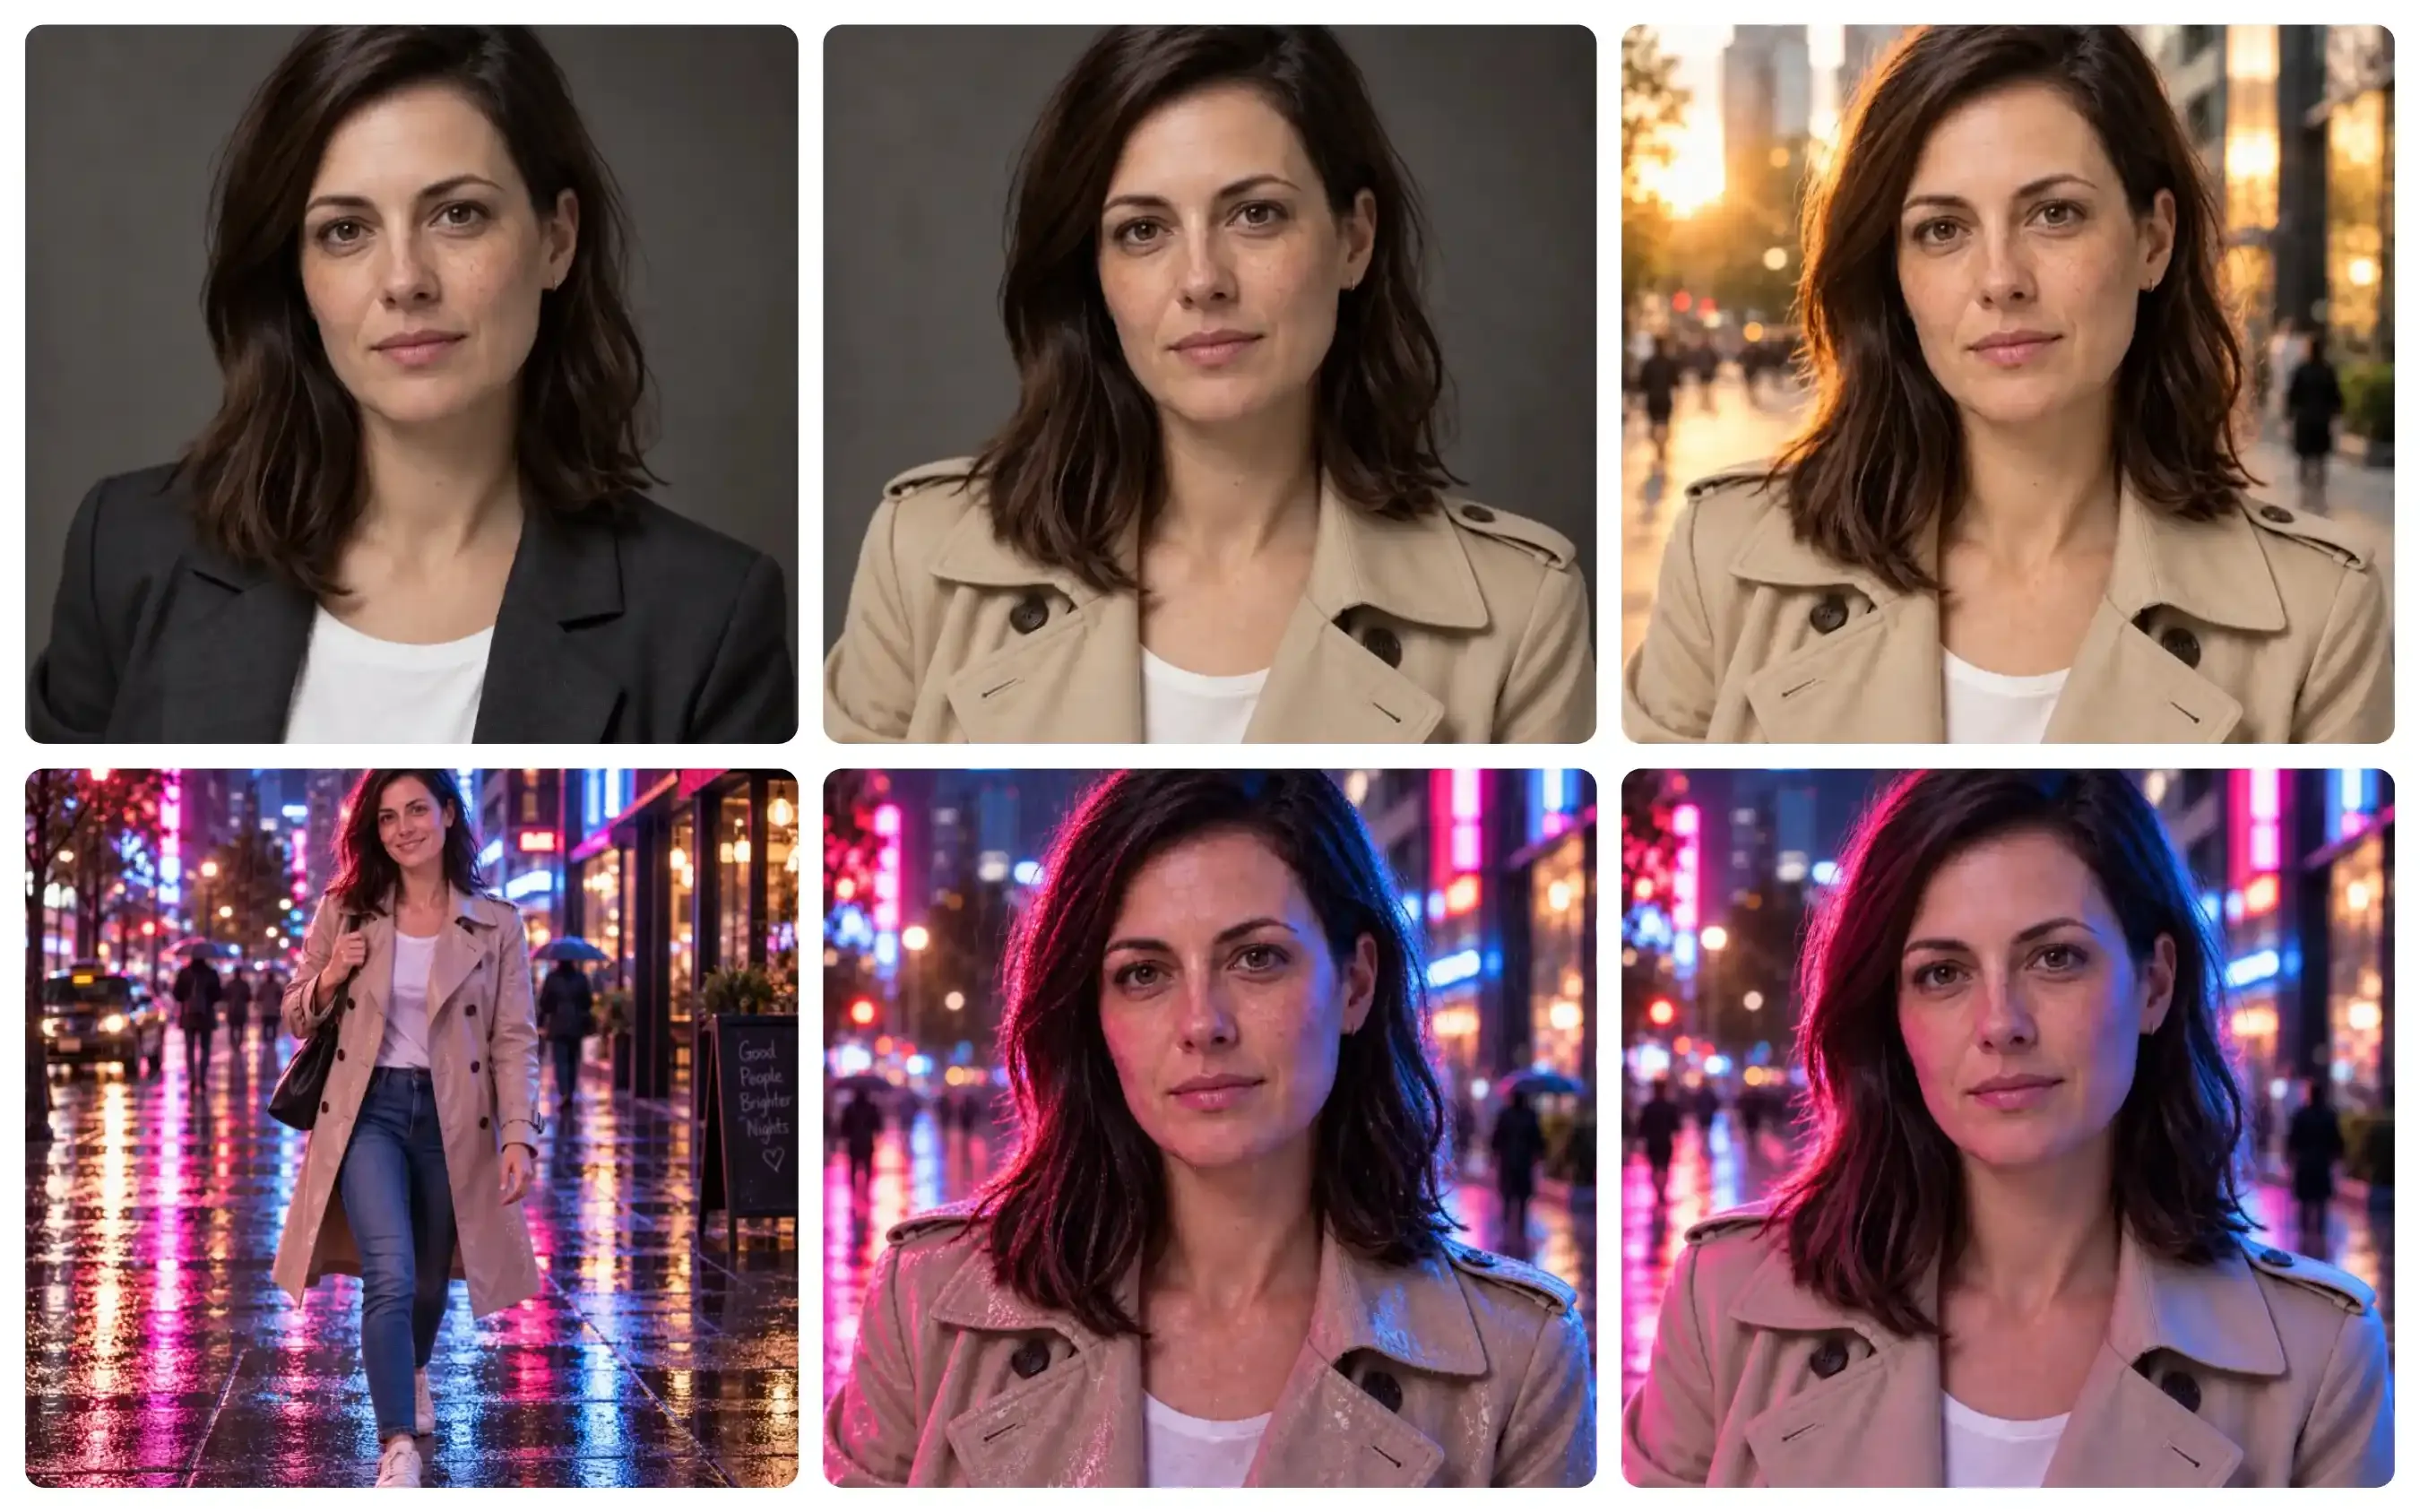
GPT Image 2.5 多輪迭代序列面板 1–6,第一張圖為基準影像。
在 GPT Image 2.5 迭代編輯期間,Sunburst 模型在所有輪次中維持強烈臉部身分與逼真光線包覆。它在背景與重新打光處理(第 2 和第 3 輪)期間自然整合複雜環境逆光,將主體無縫融入霓虹與黃金時刻環境,沒有合成偽影或布料紋理崩壞。然而在第 5 輪全身擴展時,它引入略微扭曲的身體比例與尷尬的透視縮短。
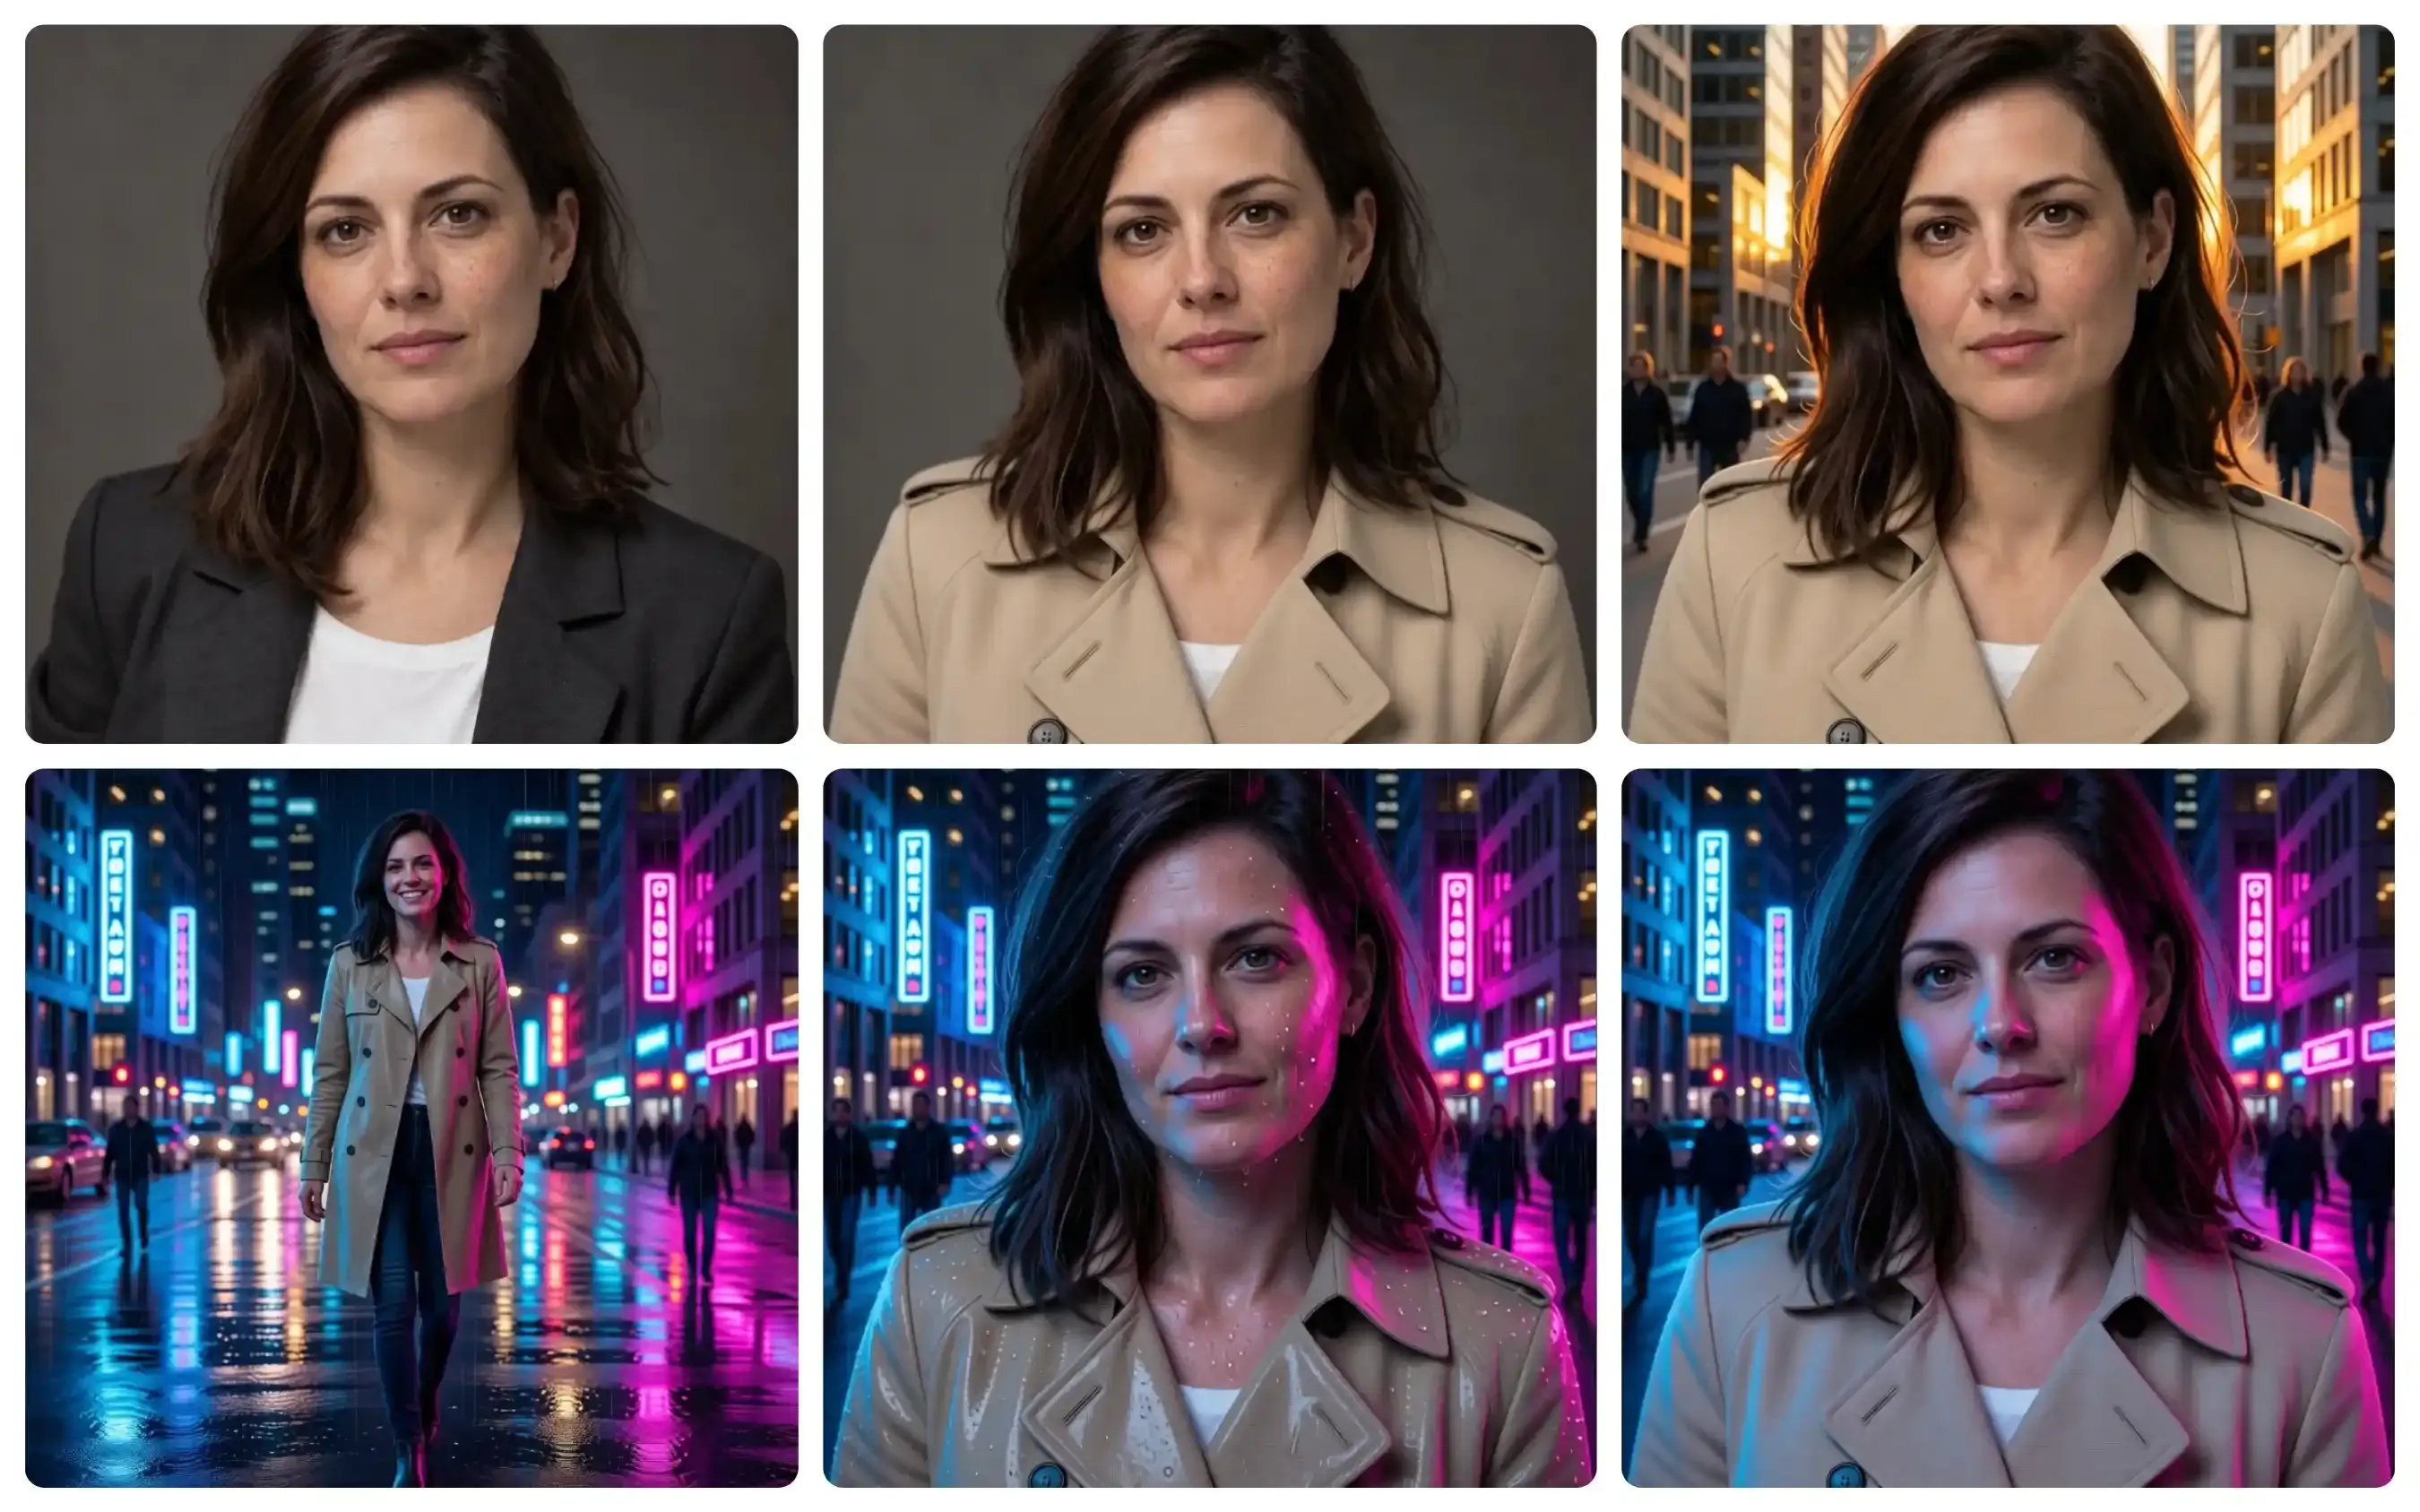
Qwen Image 2.1 多輪迭代序列面板 1–6,第一張圖為基準影像。
相較之下,Qwen Image 2.1 初期主體保留與背景放置處理良好,但隨著編輯累積顯示明顯潛空間漂移。雖然第 2 輪背景替換結構穩固,其光線整合不如 GPT 細膩。後續重新打光與雨水處理(第 3 和第 4 輪)觸發材質轉變,將服裝的棉質紋理變成高光澤塑膠雨衣,並伴隨過度飽和肌膚高光。
「塊狀」偽影現象:為何迭代圖像編輯會降低品質
重複提示修訂經常侵蝕微紋理,將細緻頭髮變成塊狀偽影,過度飽和肌膚反射,並把霧面布料異變成光澤塑膠。** **這種模式直接源自視覺引擎在連續編輯中管理潛空間轉換的根本架構差異。
架構機制 vs. 像素劣化
| 技術參數 | OpenAI GPT Image 2.5 流程 | Qwen Image 2.1 DiT 框架 |
| 重新編碼方法 | 全畫布 VAE 重新編碼 | 前綴 KV 快取重用與區塊遮罩 |
| 雜訊累積 | 全域潛空間漂移 | 限制於局部編輯遮罩 |
| 5 輪基準測試觀察到的效果 | 自然環境光融合;後期輪次出現細微全域雜訊累積與解剖/比例偏移。 | 高背景結構剛性;局部潛空間重新處理造成鏡面飽和(油亮肌膚)與材質崩壞(棉質變乙烯基)。 |
| 緩解策略 | 延長取樣(Sunburst 模式) | 混合粒度注意力與遮罩隔離 |
將架構連結至基準測試發現
理解架構選擇如何影響多輪像素衰減,能直接解釋我們的 5 輪壓力測試結果:
- 全潛空間重新編碼(GPT Image 2.5):
在全畫格工作流程中,GPT Image 2.5 在每個編輯輪次重新編碼整個潛空間畫布。如我們的 單提示照片寫實 測試所示,此全域方法擅長計算複雜光學互動——例如在第 2 輪計算跨頭髮與肌膚的自然黃金時刻輪廓光。然而,由於每次處理都遍歷整個畫布,擴散雜訊會在多輪中全域累積。到第 4 和第 5 輪,這會造成細微高頻細節流失、陰影中的巨像素量化,以及全身畫格擴展時的解剖透視縮短。
- 局部遮罩與快取重用(Qwen Image 2.1):
Qwen 2.1 的 32 層單流 DiT 架構運用區塊級遮罩與前綴 KV 快取重用。靜態情境計算在去雜訊步驟中鎖定未編輯區域,消除背景像素的重新編碼損失,並保留銳利建築線條。然而,由於生成更新被限制並在局部遮罩內重度處理,重複處理相同子區域往往過度飽和鏡面高光——解釋第 3 輪轉為油亮肌膚反射,以及第 4 輪外套材質從霧面棉質轉為高光澤乙烯基。
雖然 GPT Image 2.5 的 Sunburst 模式使用延長取樣,在早期輪次維持優異光線物理與自然肌膚紋理,其全域處理最終造成細微全畫布漂移。相反地,Qwen Image 2.1 透過 KV 快取鎖定未編輯 token,防止背景幾何劣化,但在延長修圖鏈中需要謹慎處理提示,以避免局部高光飽和。
編輯機制與工作流程控制:留言標記 vs 局部遮罩
提示 AI 模型替換模特兒的外套,常導致系統重新設計背景或改變臉部特徵。精確的輸入機制決定更新在迭代編輯期間是保持局部,還是破壞其餘構圖。
比較 GPT Image 2.5 與 Qwen Image 2.1,揭示兩種維持多步驟提示保真度的不同操作框架。
控制介面與輸入機制
| 功能能力 | GPT Image 2.5 畫布工具 | Qwen Image 2.1 編輯系統 |
| 局部目標選取 | 座標定位點與向量筆觸 | 繪製註解、圓圈或二值遮罩檔案 |
| 參考圖像錨定 | 支援最多 16 張參考圖像 | 支援最多 10 張參考圖像 |
| 像素隔離 | 全畫格潛空間重新編碼處理 | 具區塊級遮罩鎖定的前綴 KV 快取 |
| 圖層輸出選項 | 標準 RGB 輸出 | 原生透明 RGBA 生成 |
精確標記 vs 邊界遮罩
OpenAI 依賴 ChatGPT 介面內的座標定位點與手繪向量筆觸。透過 ChatGPT 留言編輯功能放置座標定位點,會向目標區域發出語意文字更新訊號,而草圖引導工作流程則使用繪製向量線來引導版面幾何。將參考圖像錨定與最多 16 張輸入圖像結合,可讓主體風格在變體間保持一致。然而,由於底層模型會重新編碼完整圖像畫布,精確座標之外仍可能出現輕微像素滲色。
相反地,Qwen Image 2.1 透過允許使用者繪製註解、在多個編輯目標周圍畫彩色圓圈,或提供獨立二值遮罩檔案,強制執行嚴格的局部遮罩編輯。其突出能力——原生透明 RGBA 生成——讓創作者直接以真實 alpha 通道生成或編輯透明去背,繞過後處理背景移除工具。雖然參考圖像錨定支援最多 10 張輸入圖像,將未編輯像素鎖在明確遮罩邊界後,可帶來更高的使用者意圖準確度,並防止不必要的全域偏移。
防止多輪 AI 編輯期間偽影累積的實用變通方法
看著精緻商業合成圖在第四次提示修訂時劣化成模糊像素,迫使製作團隊丟棄數小時的編輯進度。實施結構化多輪編輯變通方法,讓創作者在複雜修訂工作流程中維持影像清晰度並避免像素劣化。
乾淨 AI 圖像編輯的製作策略
應用四項針對性製作技術,協助團隊在多輪生成期間防止 AI 圖像劣化:
- 參考重新錨定: 將原始第 1 輪基準生成作為明確參考圖像,與最新編輯提示一併重新注入,迫使模型重新對齊臉部比例與背景光線向量。此參考圖像重新錨定技術有助於在連續生成處理中重置潛空間漂移。
- 策略性精準層級選擇: 在 GPT Image 2.5 Flare 上執行快速視覺草稿,相較早期模型降低 50% 延遲。最終編輯處理切換至 Sunburst 品質層級(
xhigh或max)會套用延長取樣時間,保留複雜細節並限制重新編碼雜訊。 - 隔離局部遮罩: 利用 Qwen Image 2.1 的遮罩邊界編輯,將生成更新嚴格限制在目標邊界內。提供明確二值遮罩或繪製註解,確保未編輯背景像素完全繞過去雜訊流程,維持原始影像銳利度。
- 單次複合提示: 將多個小型編輯請求合併為一次整合指令處理,避免多輪品質衰減。練習複合提示,以單一步驟改變外套顏色、背景環境與光線角度,可減少總重新編碼週期。
遵循這些實用 GPT Image 2.5 編輯技巧,讓設計師在多步驟商業專案中交付經得起近距離檢視的乾淨 AI 圖像編輯。
最終決策指南:你該為工作流程選擇哪個模型?
僅依據靜態排行榜分數選擇圖像生成平台,往往在客戶提出複雜修訂時導致製作瓶頸。選擇最佳 AI 圖像編輯模型,取決於你的創意團隊優先追求商業零樣本完美度,還是迭代編輯流程中的開放權重靈活性。
製作比較矩陣
| 工作流程需求 | GPT Image 2.5 (Sunburst / Flare) | Qwen Image 2.1 (7B DiT) |
| 主要部署 | 託管 API 與 ChatGPT UI | 開放權重自架 |
| 最高原生解析度 | 4K API 輸出(最高 3840px) | 2K 原生輸出(2048px+) |
| 遮罩與透明度 | 視覺精確留言 | 原生透明貼圖(RGBA) |
| 多輪成本控制 | 每次生成按量計價 API | 在消費級 GPU 上免費本機執行 |
依製作流程選擇
你的特定技術設定決定哪個模型能帶來更高效率:
- 選擇 GPT Image 2.5,如果: 你的團隊管理商業照片寫實工作流程,需要頂級零樣本細節、4K API 輸出與複雜文字渲染。專為高階品牌、廣告海報與無縫網頁使用打造,其 Sunburst 品質層級直接透過 ChatGPT 介面或託管端點,提供乾淨光線與精準解剖結構。
- 選擇 Qwen Image 2.1,如果: 你需要可在消費級硬體上本機執行、且沒有每次生成 API 成本的自架圖像模型。作為開放權重架構運作,它為開發者提供完整資料隱私、透過 64 通道 RGBA 生成的原生透明貼圖,以及使用明確遮罩邊界的成本效益多參考構圖。
依據你工作室的基礎架構評估 GPT Image 2.5 與 Qwen Image 2.1,確保你在初期視覺保真度與長期營運成本之間取得平衡。


