下載進度條達到 65 GB,風扇開始運轉,真正的問題來了:它真的能載入嗎?GPT-OSS-120B 記憶體需求的簡短答案是權重約需 61 GB,再加上一些工作空間,這就是為什麼 OpenAI 將其定位為單張 80GB GPU 模型。
下面,我們將這個數字拆解成各部分,展示已運行過它的硬體及實測速度,並涵蓋當你的設備不足時的託管途徑。
重點摘要
- GPT-OSS-120B 以 60.8 GiB MXFP4 檢查點形式發布,這就是為什麼 OpenAI 的目標是單張 80GB GPU。
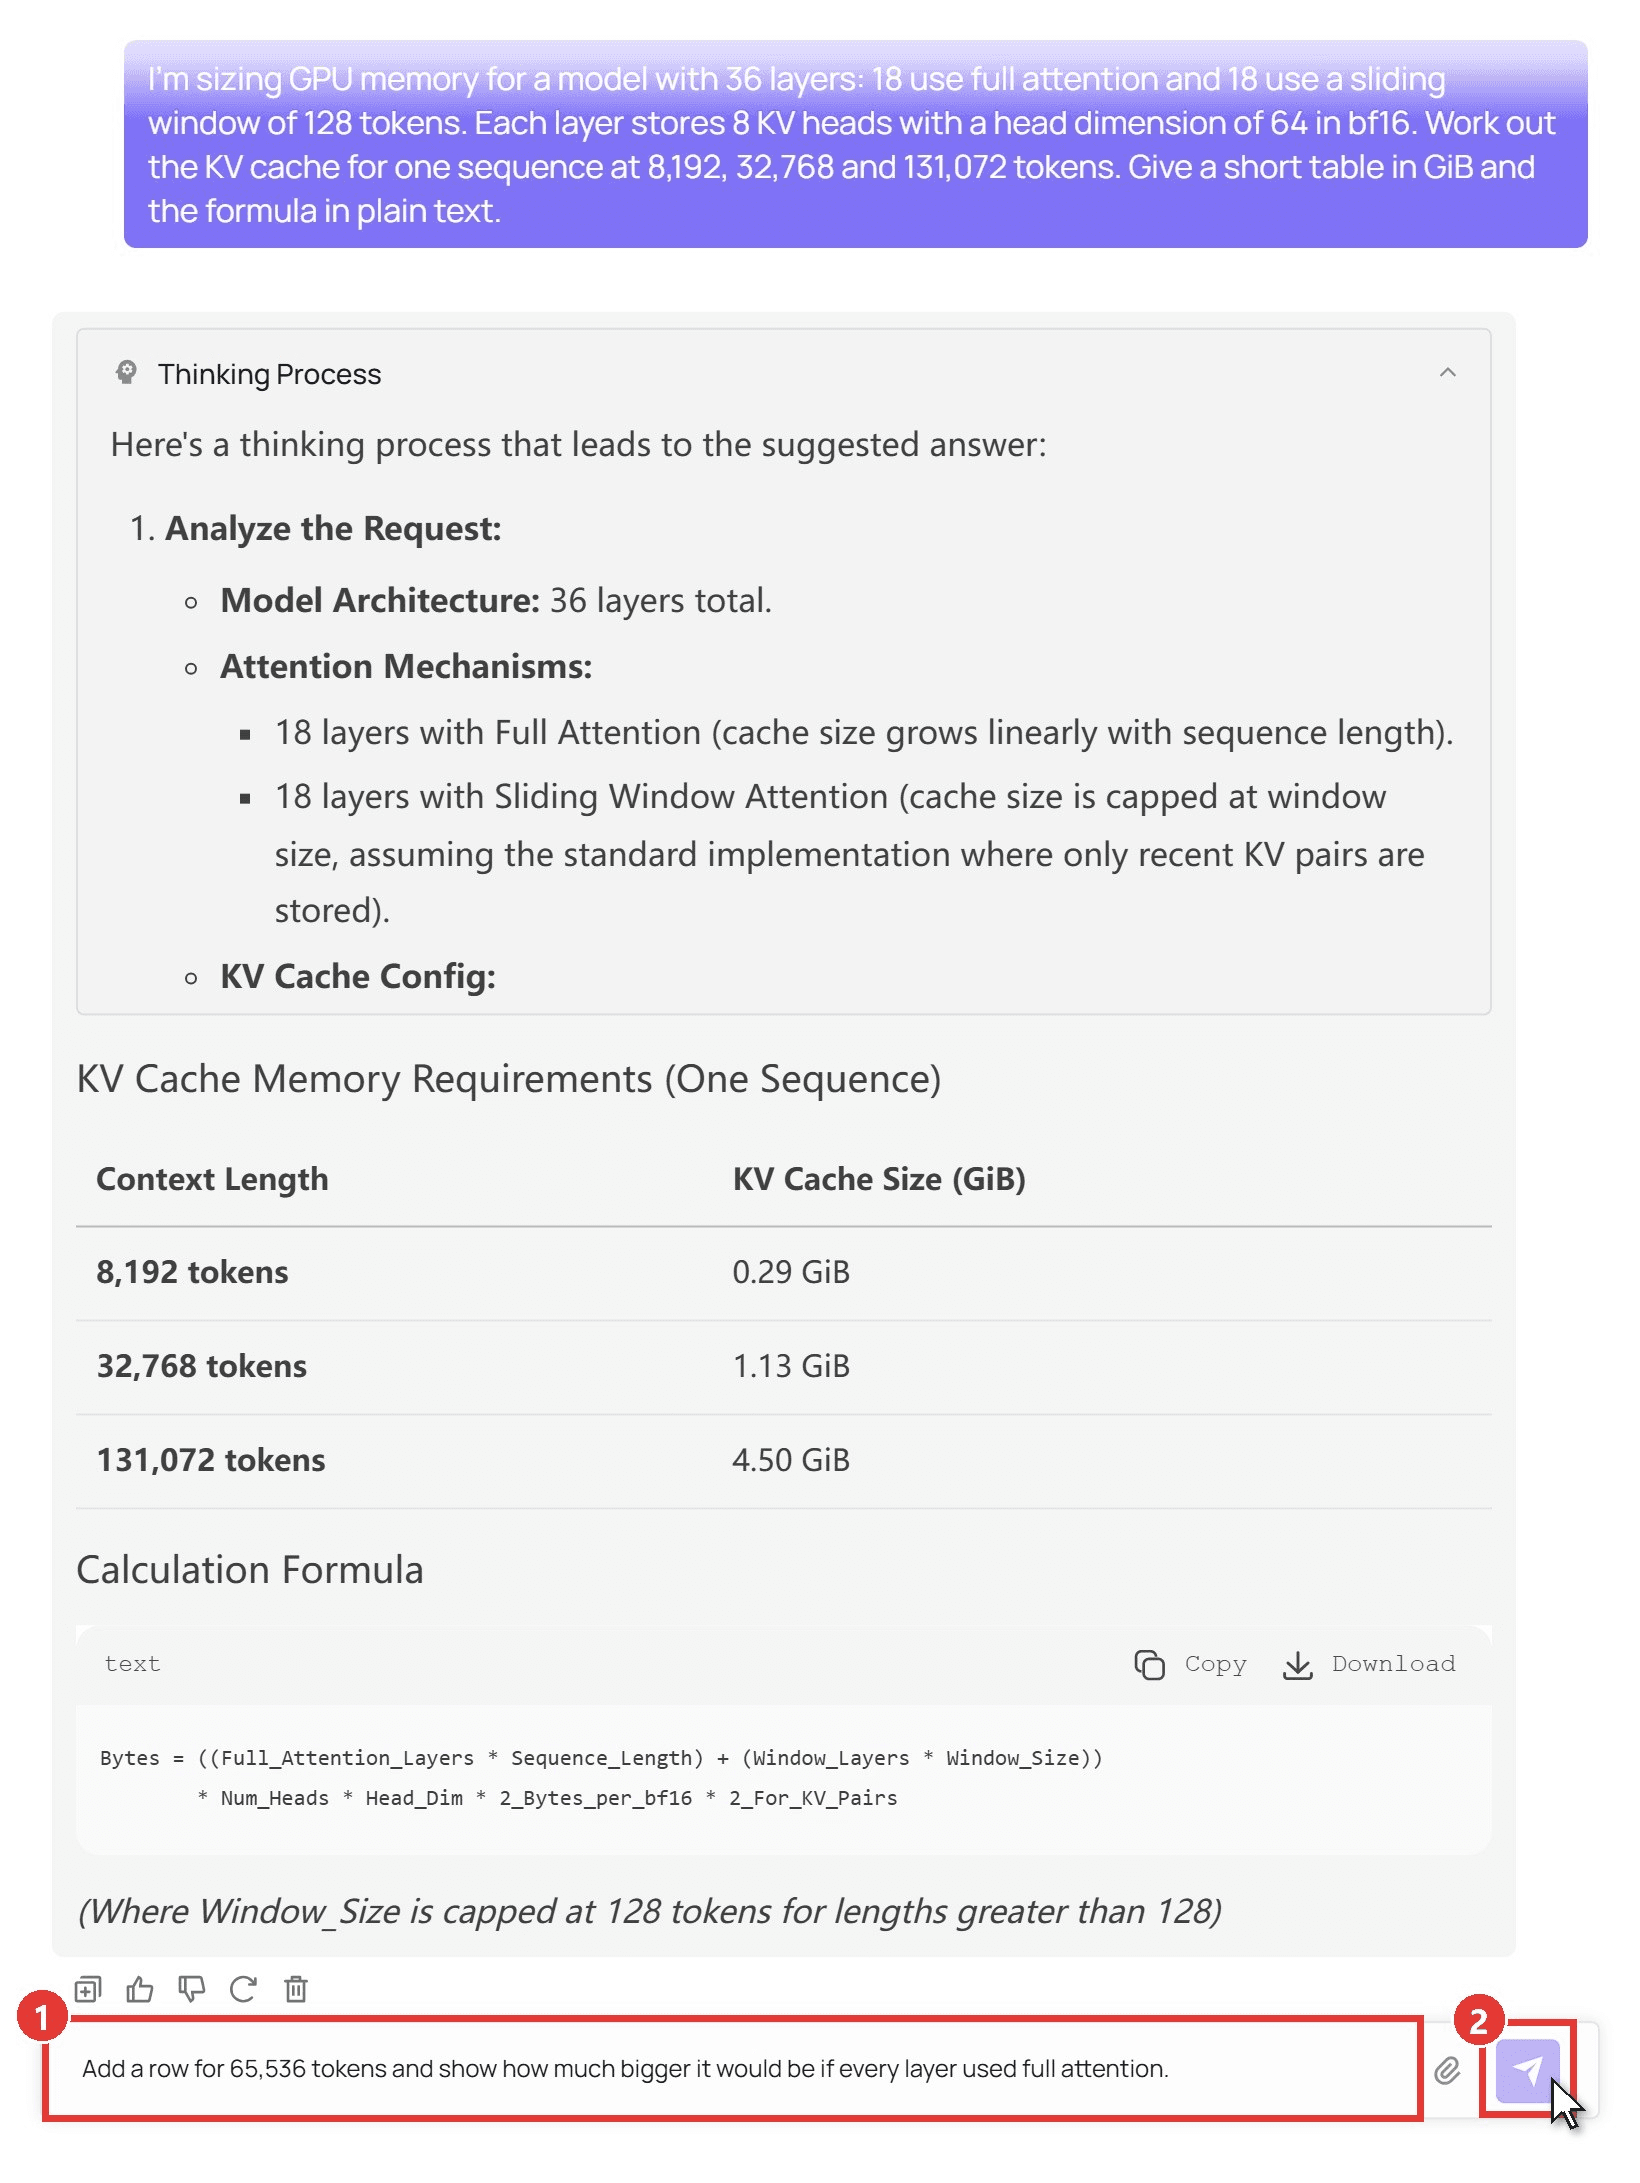
- 上下文長度幾乎不增加記憶體:在完整的 131K token 下,KV 快取僅達到約 4.5 GiB。
- 如果 VRAM 少於 80GB,llama.cpp 可以將專家層卸載到系統 RAM,仍能運行它。
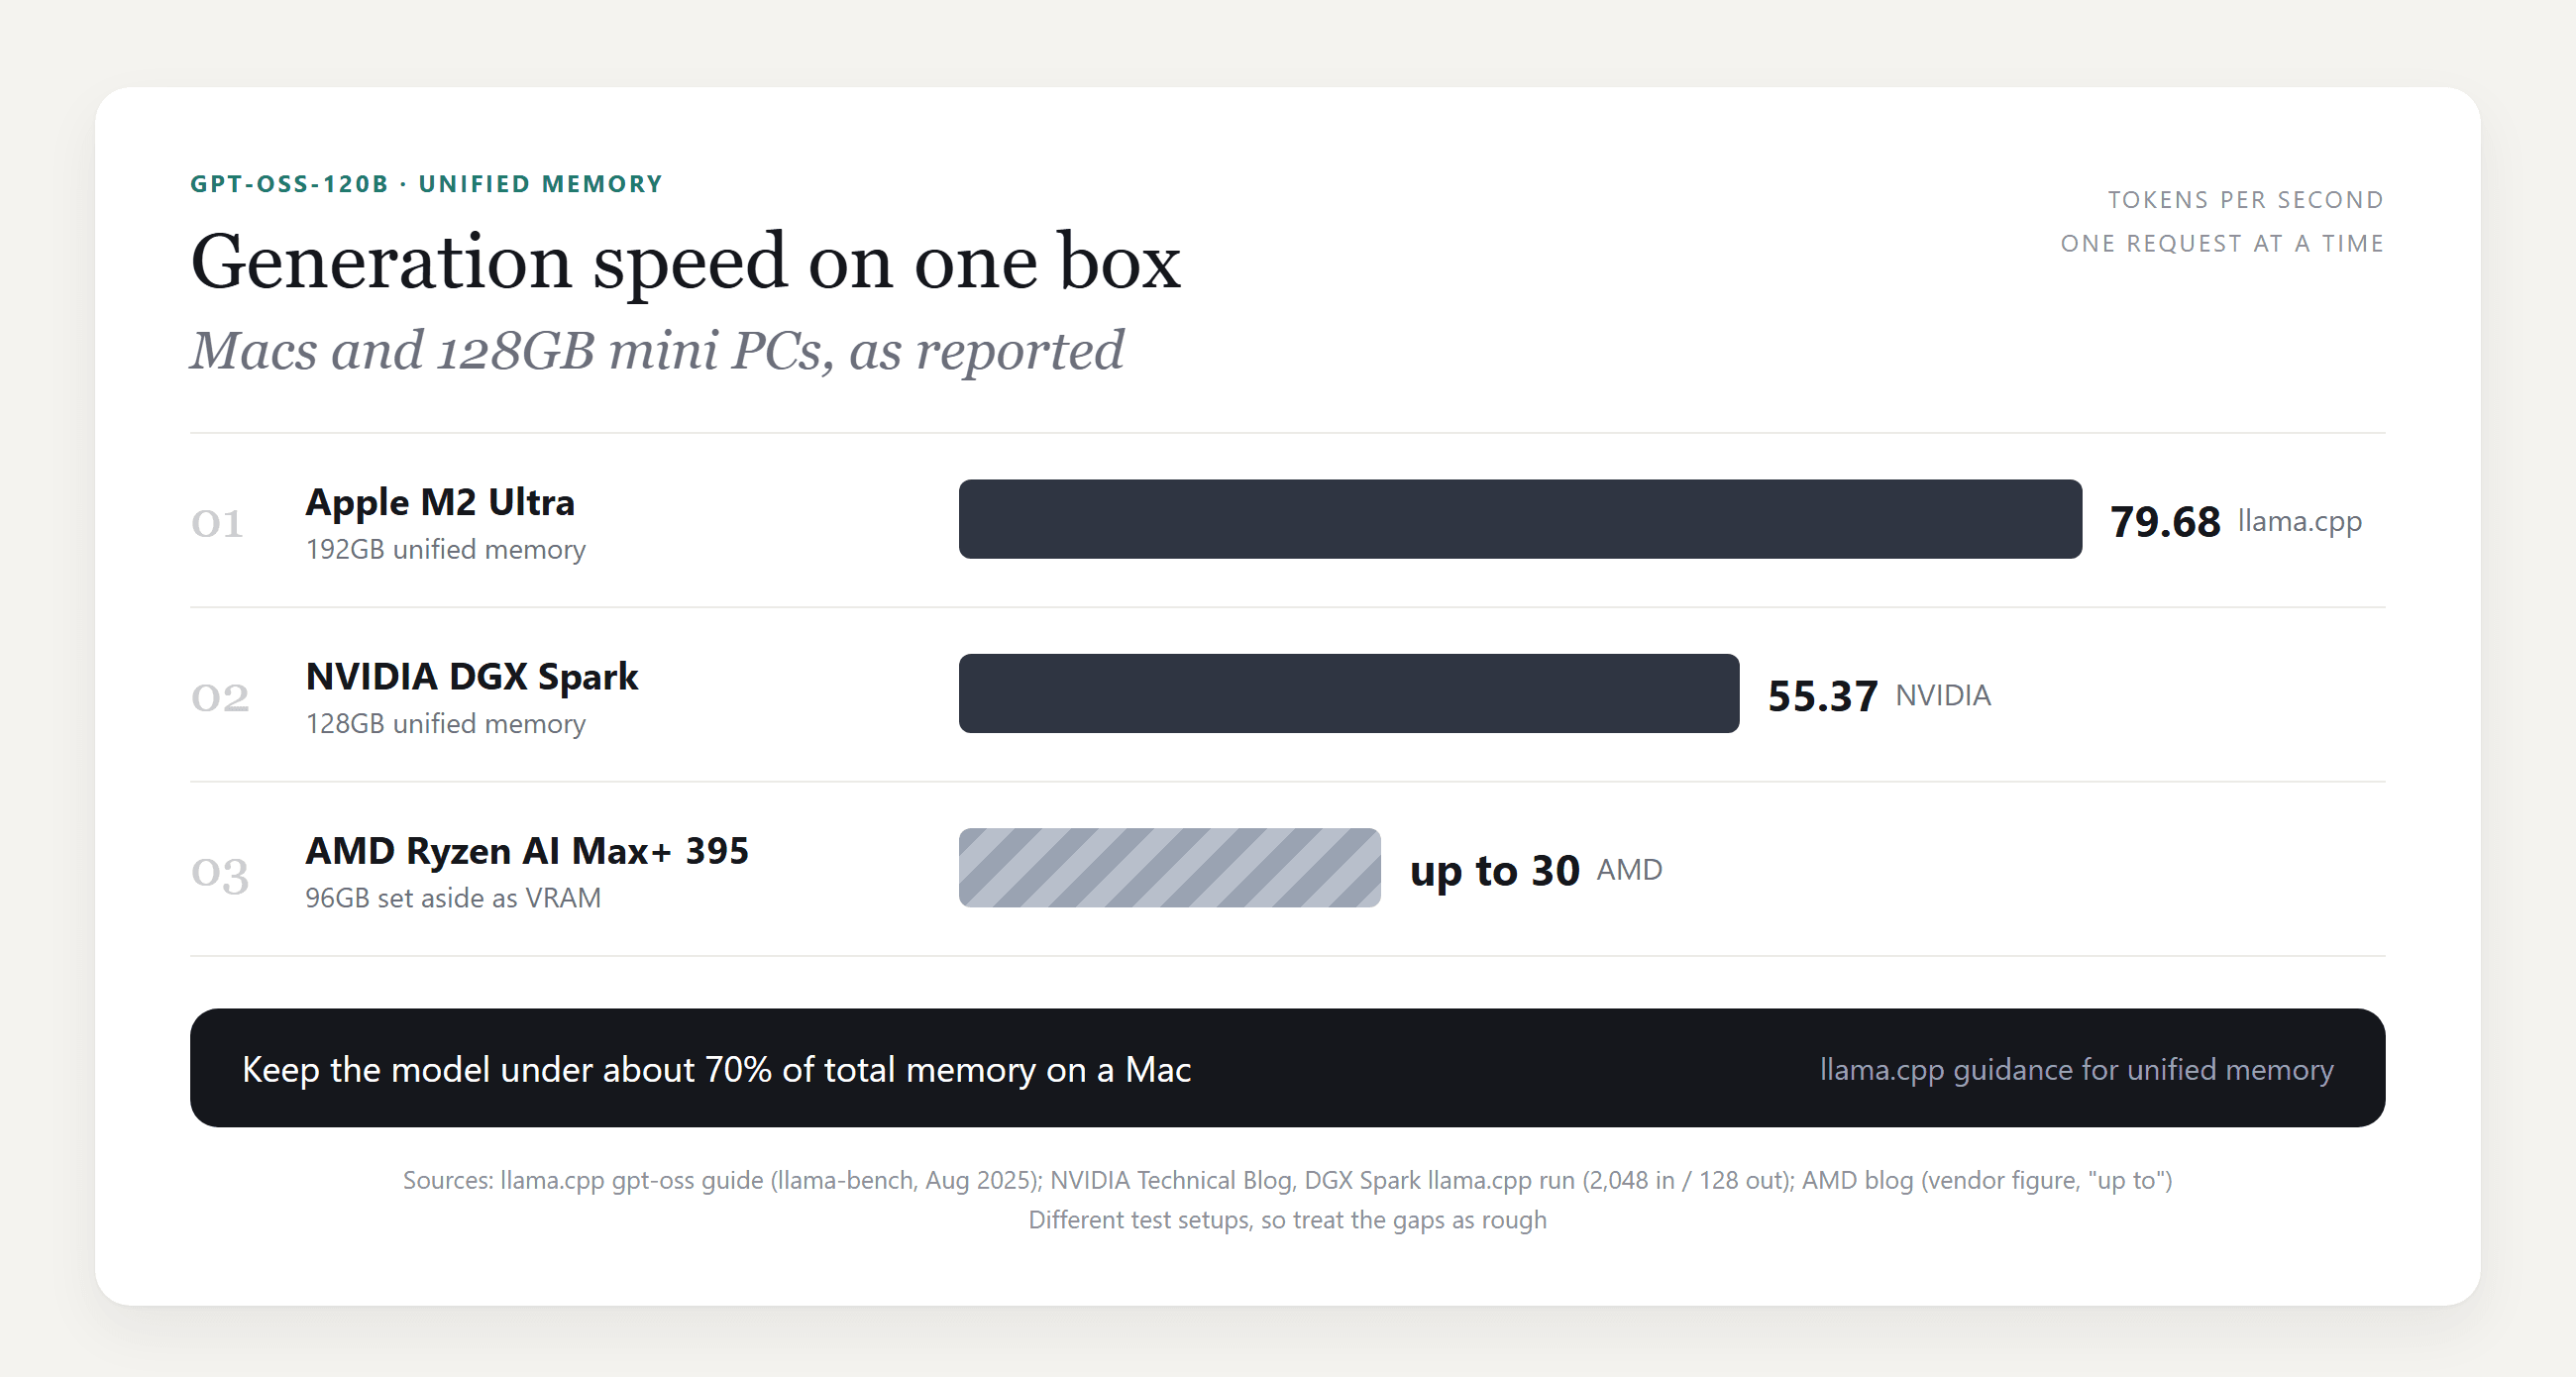
- 記憶體超過 96GB 的 Mac 和 128GB 迷你 PC 可以在一台機器上容納完整模型。
- 沒有適合的硬體?呼叫 Atlas Cloud 上的 Qwen3.5 122B A10B 透過一個 OpenAI 相容 API。
GPT-OSS-120B 記憶體需求:權重加上 KV 快取
OpenAI 於 2025 年 8 月 5 日在 Apache 2.0 授權下發布了 gpt-oss-120b。它是一個混合專家模型,因此其 116.8B 參數中每個 token 只有 5.1B 參與運算。這有助於速度,而非記憶體:每個專家仍然必須待在記憶體中,隨時準備被選中。
保持它小巧的訣竅是 MXFP4。根據 gpt-oss 模型卡,佔參數超過 90% 的專家權重以每個 4.25 位元儲存。相同模型的 16 位元副本將需要大約四倍空間。
| 規格 | GPT-OSS-120B |
|---|---|
| 總參數量 | 116.8B |
| 每個 token 的活躍參數量 | 5.1B |
| 層與專家 | 36 層,128 個專家,每個 token 啟用 4 個 |
| 權重格式 | 專家層使用 MXFP4,其餘使用 BF16 |
| 檢查點大小 | 60.8 GiB |
| 上下文視窗 | 131,072 個 token |
上下文視窗如何改變 GPT-OSS-120B 的記憶體
每個 token 在每個注意力層留下一個鍵和一個值。該儲存就是 KV 快取,當每個層都關注完整上下文時,它會隨上下文長度同步增長。
GPT-OSS-120B 避開了大部分。其 36 層中有一半使用滑動視窗,只回看 128 個 token,且每個層僅儲存 8 個 64 維的 KV 頭。只有 18 層保留整個上下文。我們從模型設定中計算出 KV 快取,它與 llama.cpp gpt-oss 指南中的實測總量相符。
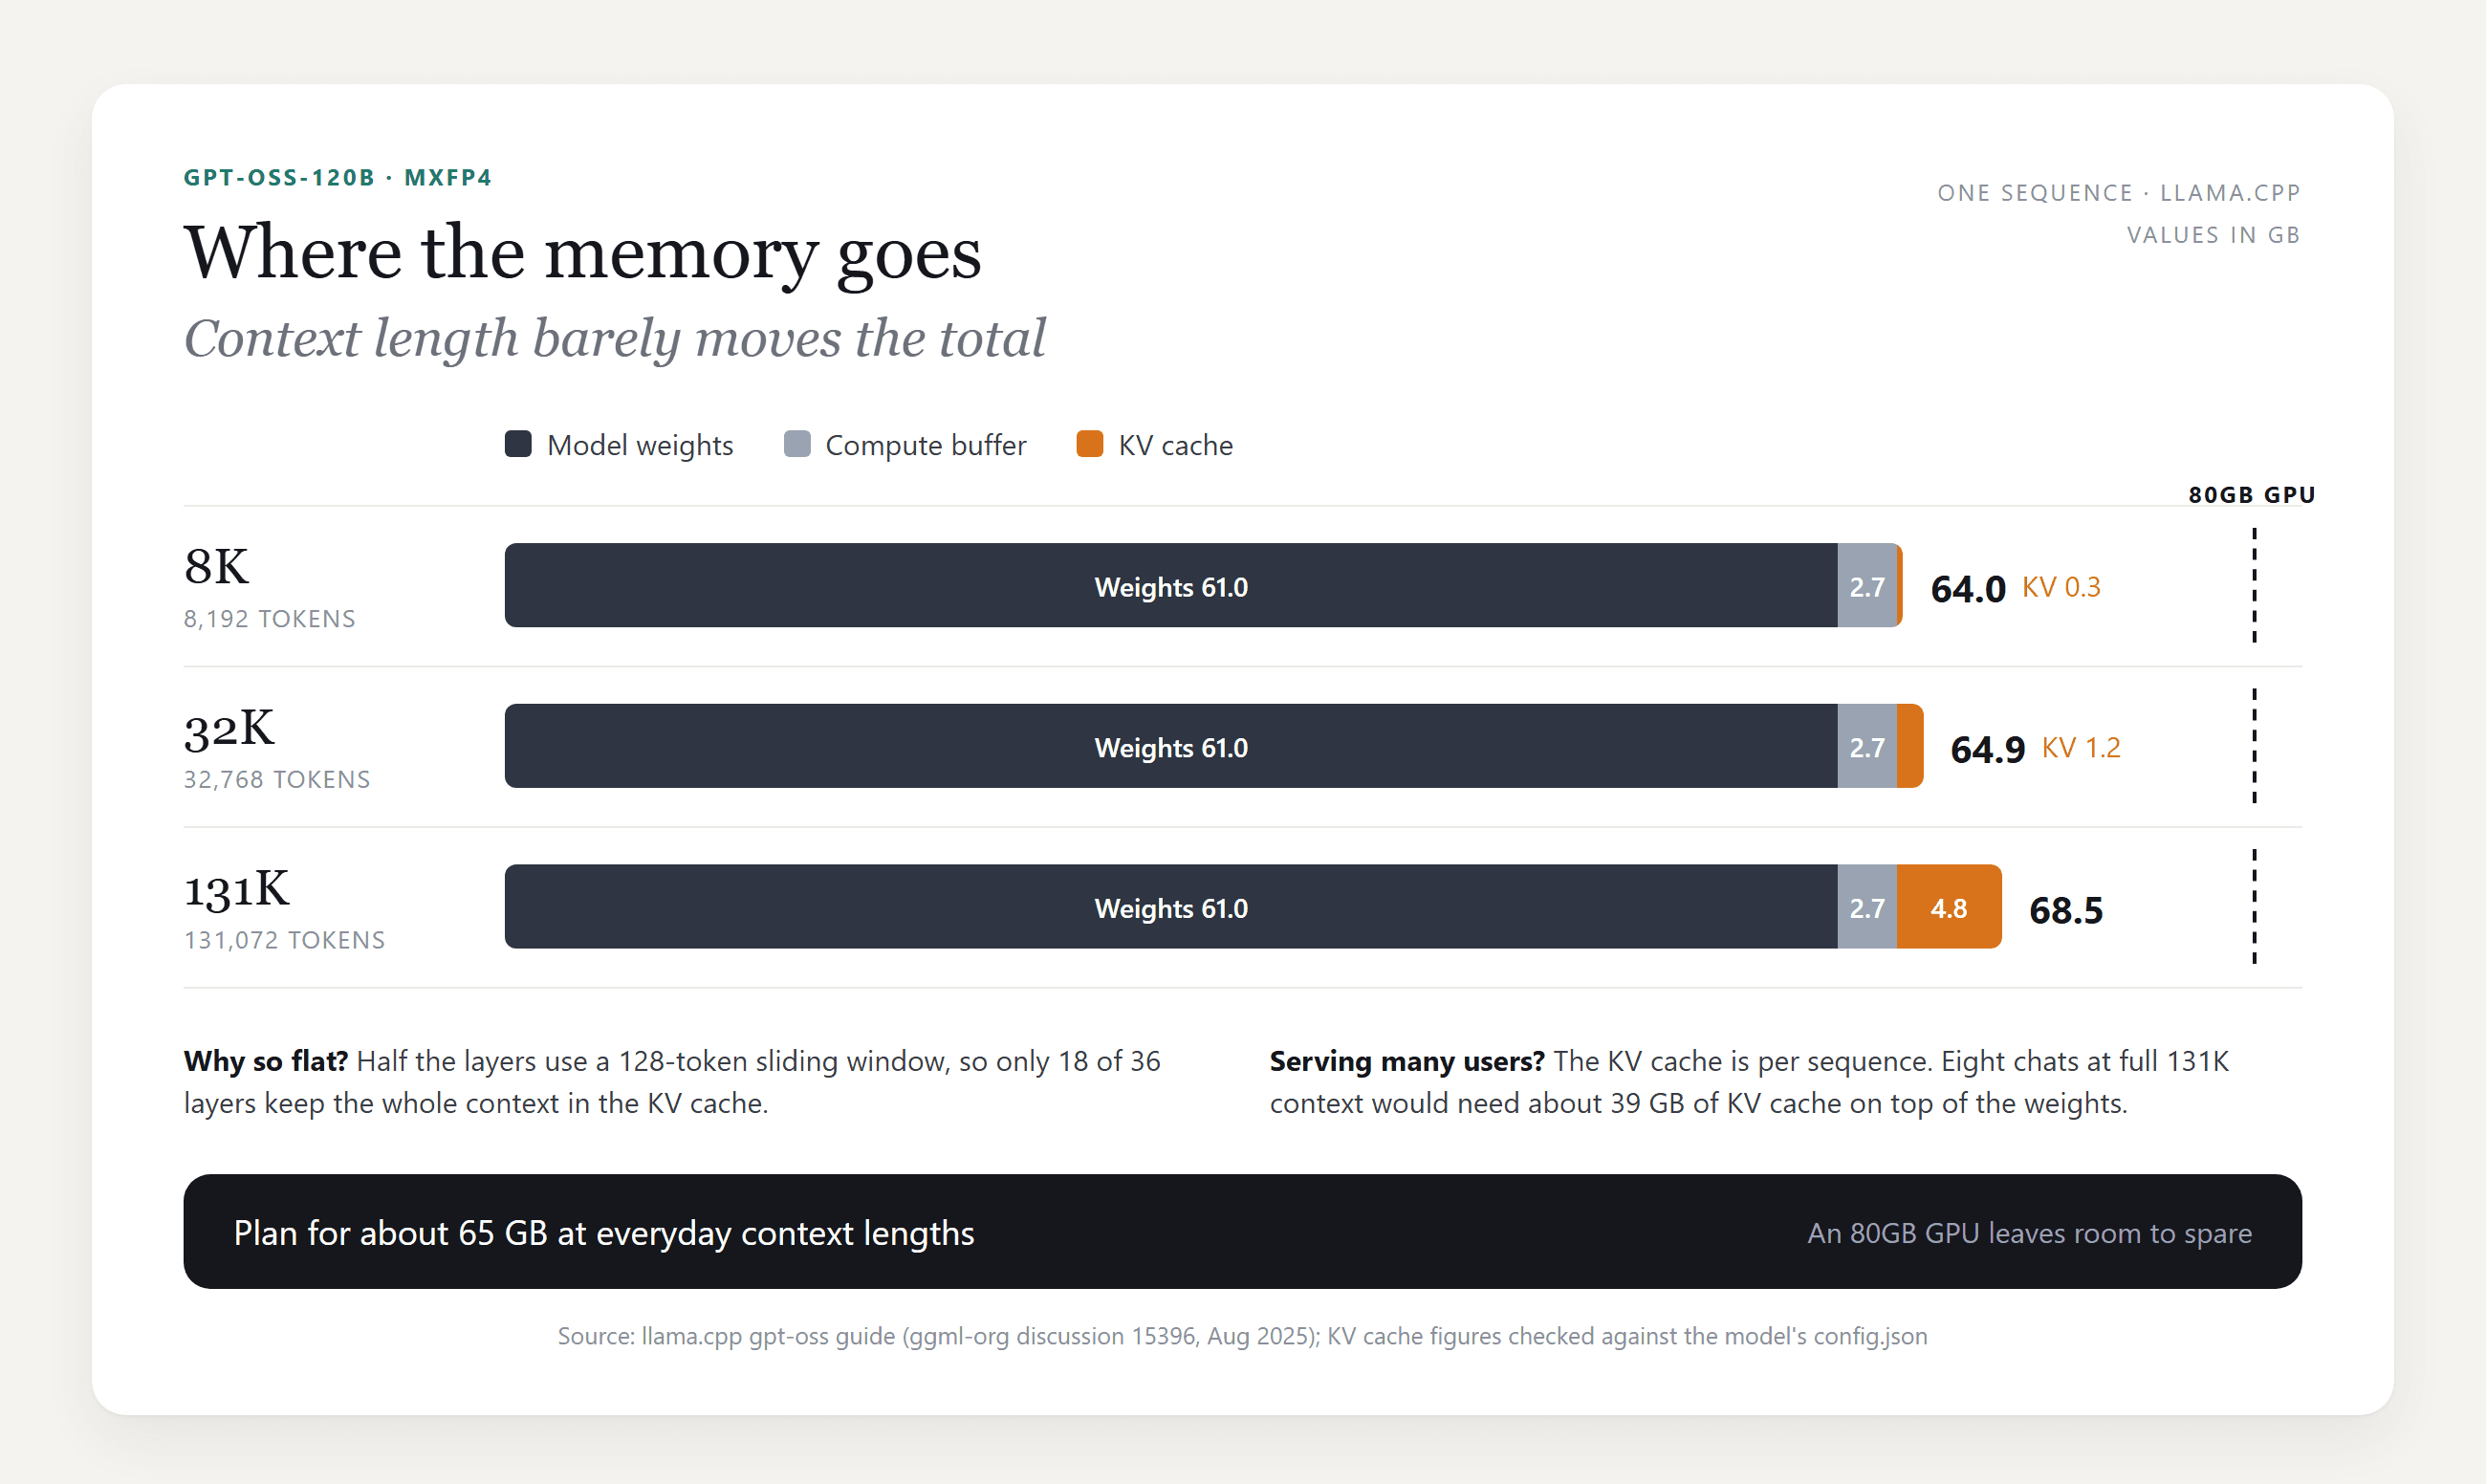
從 8K 到完整的 131K 花費不到 5 GB。它會累加的地方在於並行處理:KV 快取是每個對話獨立的,因此一個伺服器若持有八個完整長度的對話,就需要在權重之上額外大約 39 GB。
我可以在本機執行 GPT-OSS-120B 嗎?各設定的硬體需求
是的,如果你能將大約 65 GB 放在某個快速的地方:一張大 GPU、一張 GPU 加系統 RAM,或一台具有統一記憶體的機器。
GPT-OSS-120B 的 GPU 需求
最簡單的情況是一張 80GB 資料中心卡。gpt-oss 的 vLLM 指南指出,120b 模型「可裝在單張 A100 (80GB) 上」,且將其拆分到更多 GPU 上有助於提高吞吐量。
在 80GB 以下,llama.cpp 指南提供了一條出路。其 --n-cpu-moe 旗標將部分專家層保留在系統 RAM,其餘放在 GPU 上。該指南指出最低只需約 8GB 的 VRAM,只要 GPU 和系統記憶體合計仍能容納模型。
| 設定 | 權重所在位置 | 回報的生成速度 |
|---|---|---|
| RTX Pro 6000, 96GB | 全部在 GPU 上 | 196 tokens/s (llama.cpp 指南) |
| A100 或 H100, 80GB | 全部在 GPU 上 | 可裝在單張卡上 (vLLM 指南) |
| RTX 5090, 32GB, 加系統 RAM | 21 個專家層保留在系統 RAM | 零上下文時約 30 tokens/s (llama.cpp 指南) |
同一份指南提到的一個 Windows 陷阱:當 VRAM 耗盡時,驅動程式可能會悄悄溢出到系統 RAM,因此模型會載入然後變得極慢。請在工作管理員中查看 GPU 記憶體,並提高卸載數量,直到它保持在你顯示卡容量以下。
在 Mac 或 128GB 迷你 PC 上執行 GPT-OSS-120B
統一記憶體消除了 GPU 和 RAM 的區分。llama.cpp 指南指出,記憶體超過 96GB 的 Mac,例如 M2 Ultra 或 M3 Max 機器,可以在完整上下文下運行該模型,並建議保持在總記憶體約 70% 以下。
macOS 預設限制 GPU 可以接線的記憶體量。在 192GB 的機器上,該指南透過一條命令將該上限從 154GB 提高到 180GB:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
新的 128GB 迷你 PC 屬於同一類別。NVIDIA 回報,在執行 llama.cpp 的 DGX Spark 上,gpt-oss-120b 的速度為 55.37 tokens/s。AMD 表示,一台將 96GB 保留為 VRAM 的 Ryzen AI Max+ 395 機器可達到「最高每秒 30 個 token」,這是該公司自己的數據。
記憶體不足?透過 API 使用託管的開放權重模型
如果這些機器都不在你的桌上,託管的開放權重模型完全跳過硬體問題。
Atlas Cloud 提供 Qwen3.5 122B A10B,屬於其 Qwen 模型系列。理論上,它與 gpt-oss-120b 非常匹配:來自阿里巴巴 Qwen 團隊的 Apache 2.0 混合專家模型,總參數 122B,活躍參數 10B。它可讀取最多 262,144 個 token 的上下文。
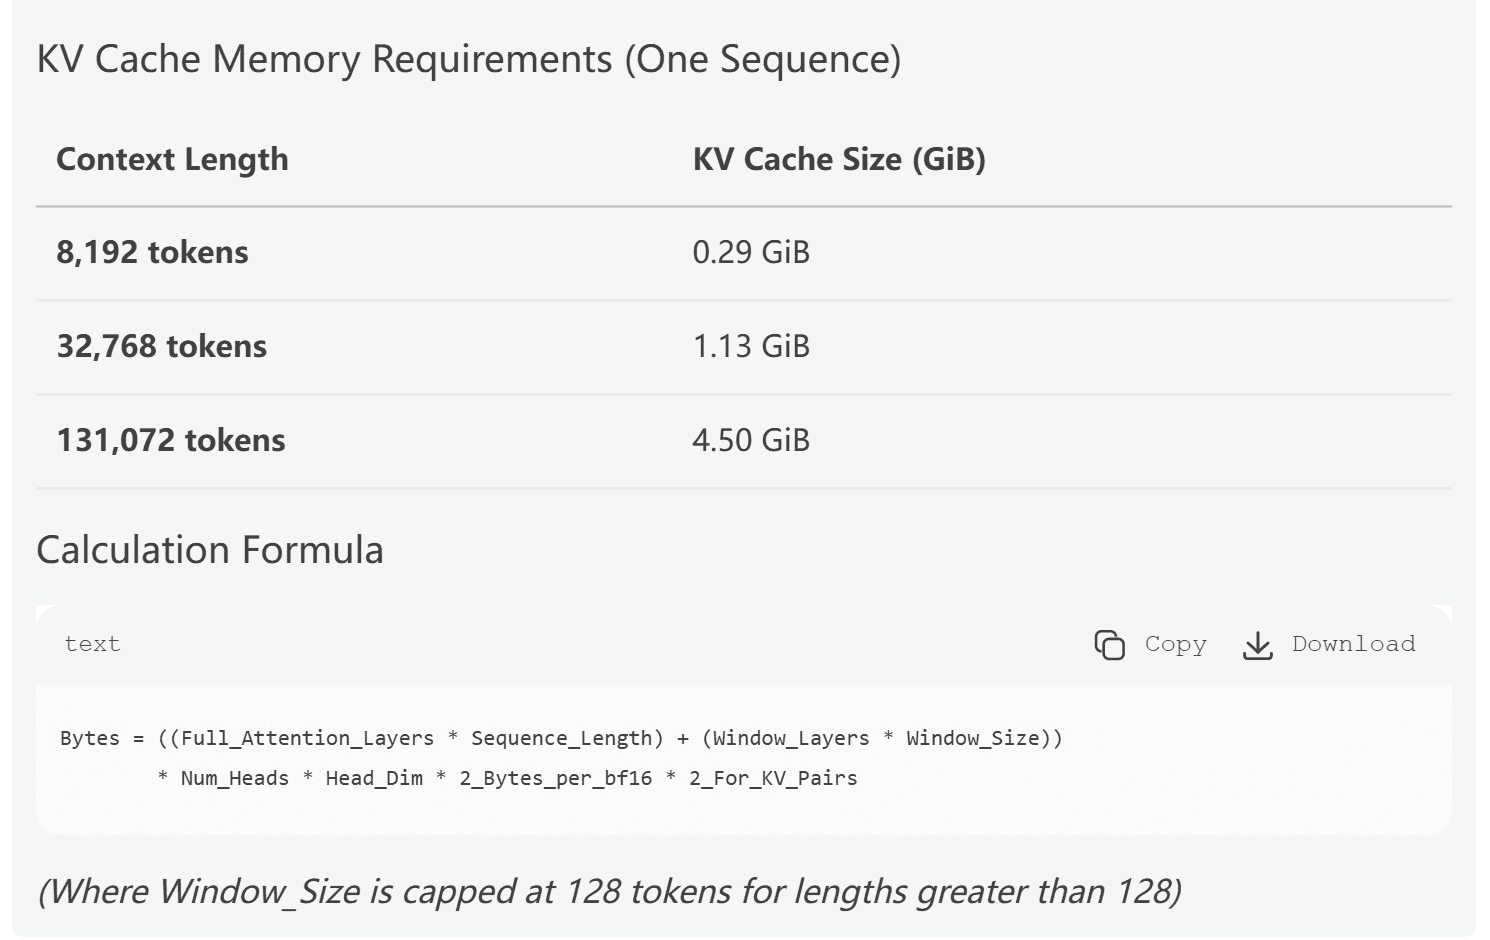
我們給它 gpt-oss 設定中的注意力佈局,並要求計算三個長度下的 KV 快取。它的表格與我們自己的計算結果精確到小數點後兩位。如果你之後想要一台自己的 Qwen 機器,我們關於最適合本機程式開發的 Qwen 模型的指南會按 RAM 為它們分級。
方法 1:在 Playground 中試用 Qwen3.5 122B A10B
登入並開啟 Qwen3.5 122B A10B Playground,然後:
- 在訊息框中輸入您的問題。
- 點擊傳送箭頭。推理內容會顯示在答案上方的「思考過程」面板中。
方法 2:使用 Atlas Cloud API 呼叫 Qwen3.5 122B A10B
適用於指令碼與應用程式:
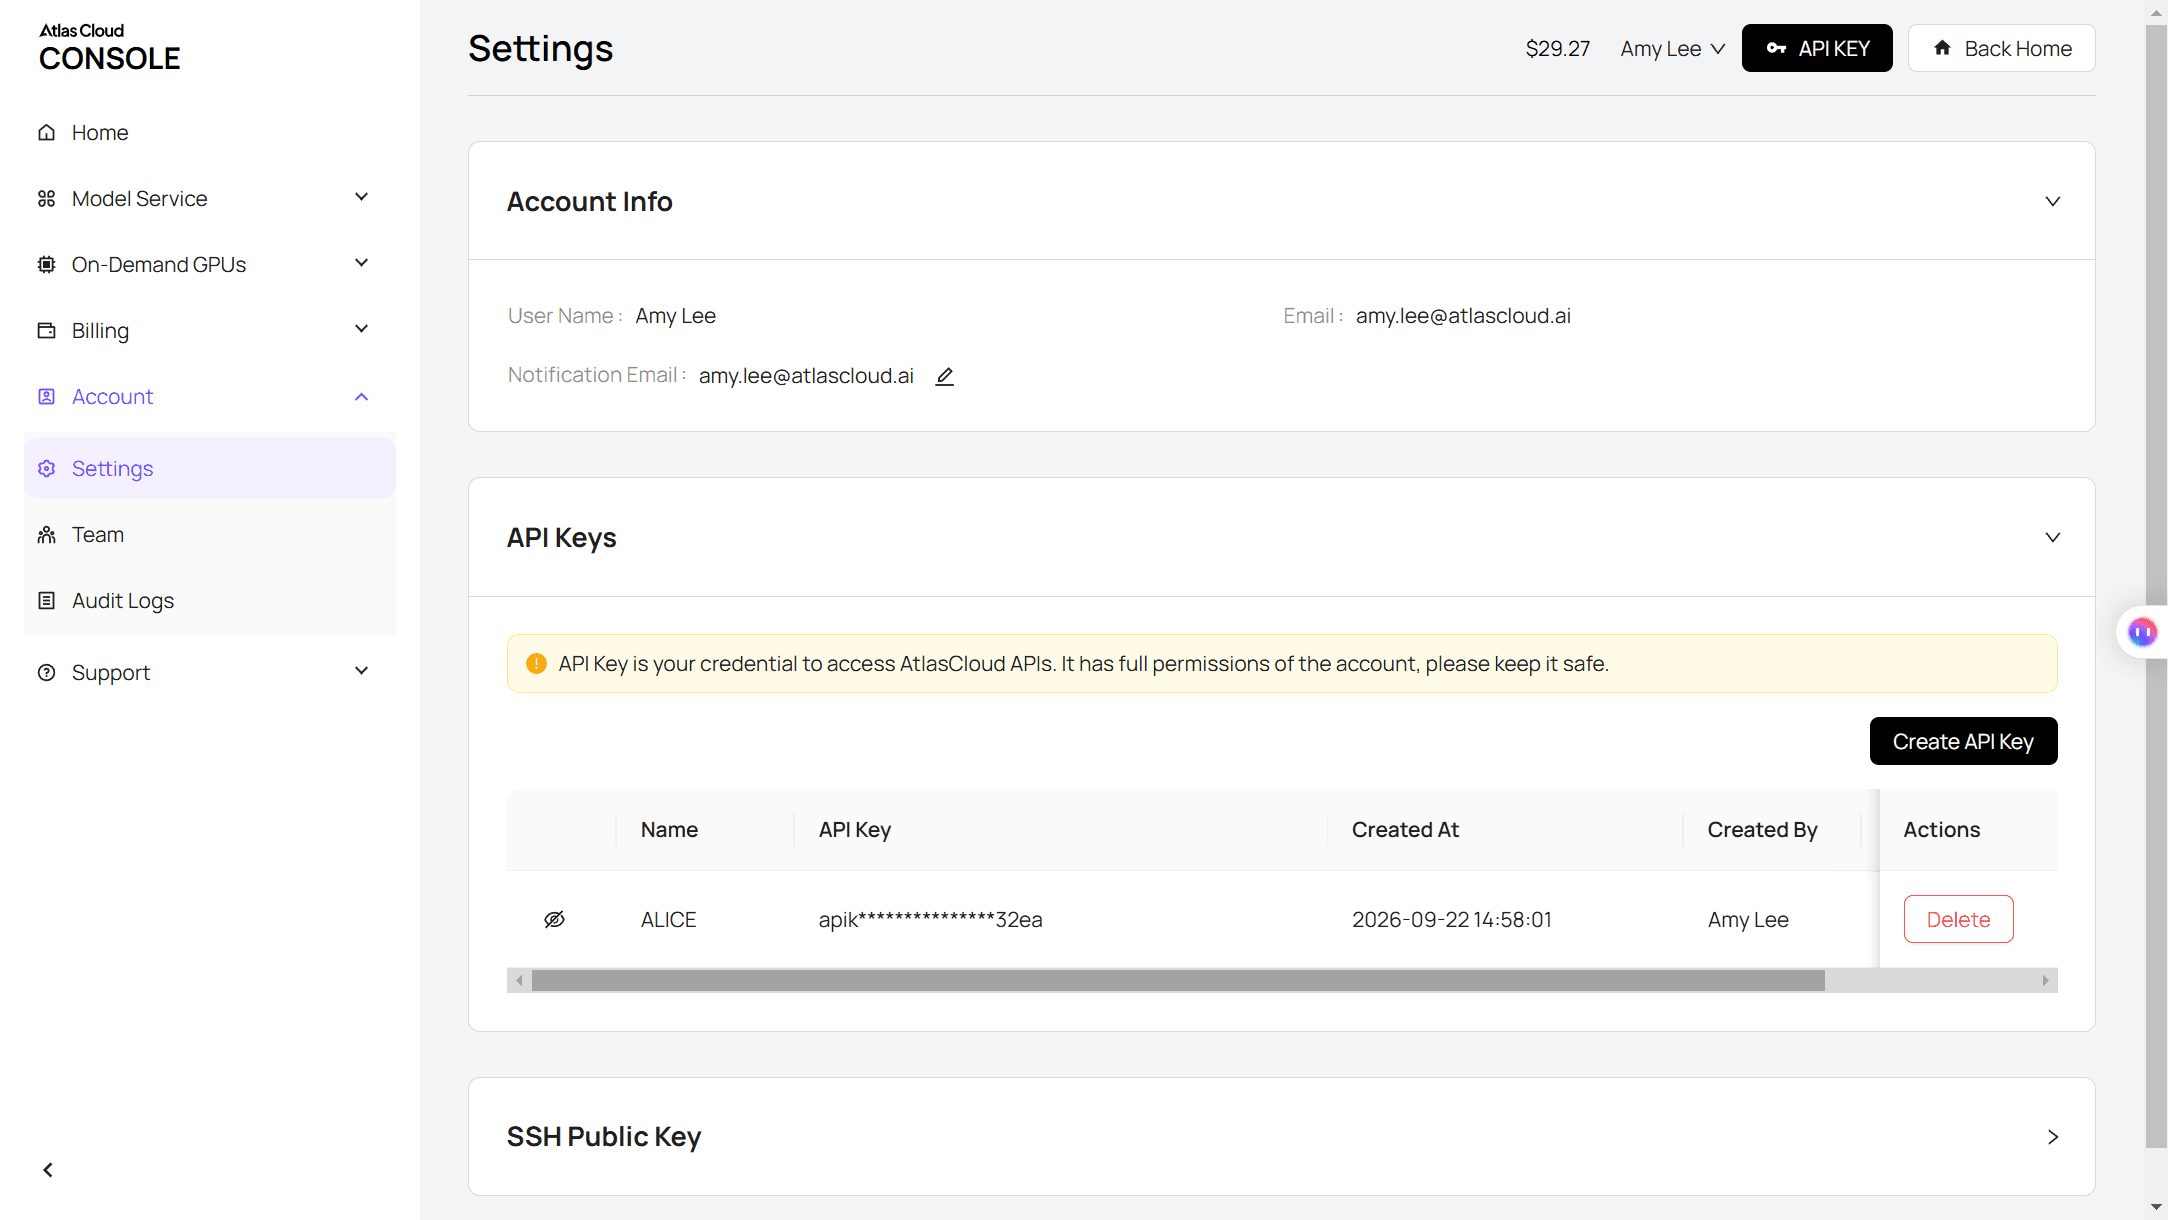
步驟 1:建立 API 金鑰。 在主控台開啟「設定」,前往「API 金鑰」,然後點擊「建立 API 金鑰」。請將其保留在伺服器端。
步驟 2:檢查請求格式。 API 文件涵蓋了聊天完成格式,模型頁面有一個 API 分頁,內含現成範例。
步驟 3:傳送您的第一個請求。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
答案會以 choices[0].message.content 回傳。由於端點遵循 OpenAI 格式,為本機 gpt-oss 伺服器編寫的程式碼通常只需要新的基礎 URL、金鑰和模型字串。同一把金鑰也適用於平台上的其他聊天模型,正如我們關於統一 LLM API 閘道的文章所述。
GPT-OSS-120B 與 GPT-OSS-20B:記憶體與基準測試的取捨
較小的兄弟需要五分之一的記憶體。gpt-oss-20b 有 20.9B 參數,其中 3.6B 活躍,OpenAI 表示它可在「最低 16GB 記憶體」上運行。問題是你放棄了什麼。
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | 8K 上下文時的記憶體 (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (無工具) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (無工具) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
分數來自模型卡的高推理努力設定。在 SWE-Bench Verified 上,程式設計差距不到兩分,而知識差距在研究所程度的科學上約為 9 分,在 HealthBench 上為 15 分。對於在 16GB 到 24GB 顯示卡上主要進行程式設計,20b 是明智的選擇。需要額外知識?這正是 120b 賺取其記憶體成本的地方。
GGUF、Ollama 或 vLLM:為您的記憶體預算選擇執行環境
每個都運行 OpenAI 發布的 MXFP4 權重;它們的區別在於這些權重可以放在哪裡。
| 執行環境 | 下載 | 最適合 |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | 在能容納整個模型的機器上供單一使用者使用 |
| LM Studio | 65 GB | Mac 或 Windows PC 上的桌面應用程式 |
| llama.cpp (ggml-org GGUF) | 約 63 GB | VRAM 少於 65 GB,並將專家層卸載至 RAM |
| vLLM | 約 65 GB 的 safetensors | 從一個或多個資料中心 GPU 服務多位使用者 |
若要在具備大記憶體的機器上快速開始:
plaintext1ollama run gpt-oss:120b
若使用較小的 GPU,請使用 llama.cpp 並調整卸載數量:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
這四者都處理 OpenAI 的和諧聊天格式,模型需要該格式才能正常運作。只有當你編寫自己的服務程式碼時,這才重要。
常見問題
GPT-OSS-120B 比 GPT-5 或 Gemini 3 Pro 更好嗎?
它們屬於不同類別:GPT-5 和 Gemini 是你可以透過應用程式或 API 存取的閉源模型,而 gpt-oss-120b 在你自己的硬體上運行。Gemini 3 Pro Preview 也已於 2026 年 3 月 9 日關閉,其名稱現在指向 Gemini 3.1 Pro Preview。如果本機控制很重要,Google 的開放權重系列是 Gemma 4 系列。
為什麼有些網站說 GPT-OSS-120B 需要 255 GB?
那些數字假設 16 位元權重:大約 117B 參數乘以 2 位元組,加上額外開銷。OpenAI 發布的檢查點已經是 MXFP4,因此實際下載量大約在 61 GB 範圍。
推理努力程度會改變記憶體使用量嗎?
不會改變權重。低、中、高設定會改變模型思考的時間長度。高努力會寫入更多推理 token,這些 token 會填滿上下文視窗並增大 KV 快取,因此長時間工作階段會逐漸趨向上方圖表中較大的總量。
為什麼人們說 GPT-OSS-120B 在文字遊戲方面表現不佳?
證據是軼事性的。在該模型的 Hugging Face 討論頁面上,有些使用者報告在撰寫暴力小說時遭到拒絕,而其他人則說角色扮演運作良好。對於互動式小說,在為其購買硬體之前,請先測試你自己的提示。
託管的 120B 等級模型要多少錢?
截至 2026 年 10 月,Qwen3.5 122B A10B 在 Atlas Cloud 上的價格為每百萬輸入 token 0.3 美元,每百萬輸出 token 2.4 美元。這是在其常規 0.4 美元和 3.2 美元費率上的 25% 折扣。我們的尺寸問題在計入推理後使用了約 5,000 個輸出 token,以折扣價計算約為一美分。
結論
GPT-OSS-120B 比其參數數量所暗示的更容易裝載。在日常上下文長度下,預計約 65 GB,在完整的 131K 下則低於 70 GB。一張 80GB GPU、一台記憶體超過 96GB 的 Mac,或一台 128GB 迷你 PC 都能容納它,而較小的顯示卡可以透過將專家層移入系統 RAM 來運行它。
如果這些數字排除了你的機器,對於主要進行程式設計的工作,可以降級到 gpt-oss-20b,或者當你需要更大的腦力而不想購買硬體時,呼叫託管的開放權重模型。無論哪種方式,一旦你知道權重佔用 61 GB 而其餘是餘裕空間,gpt oss 120b 的記憶體需求就不再是猜謎遊戲。


