我盯著三塊 Artificial Analysis 排行榜看了十分鐘,還是搞不清楚誰才是贏家。
文字轉影片:Gemini Omni Flash 領先 5 分。
圖片轉影片:Gemini 領先 2 分。
影片剪輯:MiniMax H3 領先 9 分。
接著我看了信賴區間那一欄。正負 7。正負 9。正負 10。
三塊排行榜,三個差距,每一個都落在自己的誤差棒之內。在盲測投票中,這兩個模型根本是一樣的。
於是我關掉排行榜,打開了下拉選單。那個差距不是 5 分。那個差距是整整一個解析度等級。
重點摘要
- 三項 Artificial Analysis 的差距(+5、+2、+9,資料擷取於 2026 年 8 月 6 日)全部落在 ±7 到 ±10 的信賴區間內。就原始品質而言,這是平手,不是勝出。
- H3 支援 2K、最長 15 秒以及六種畫面比例。Gemini Omni Flash 的 API 上限為 720p、10 秒與兩種畫面比例。這些是列舉值,不是主觀意見。
- H3 接受音訊作為輸入。Gemini 不行。Gemini 有
seed和thinking_level。H3 兩者都沒有。 - Gemini 有一個專用的
video-edit端點,可以直接修改你的原始片段。H3 的修改路徑是reference-to-video,它會以你的片段作為參考來重新生成。兩者不是同一種操作,第二輪測試就會顯示出來。 - 兩者之中只有一個有可下載的權重,而且不是 Google 的那個。
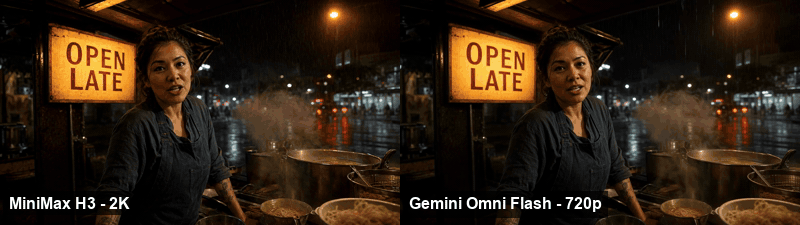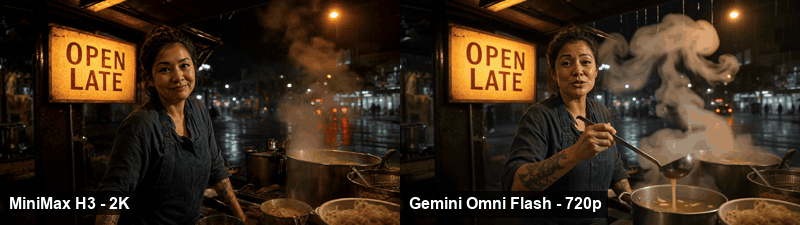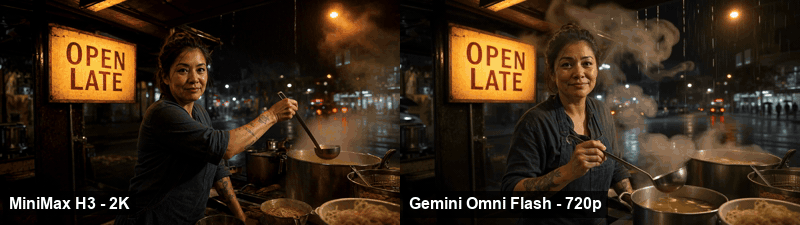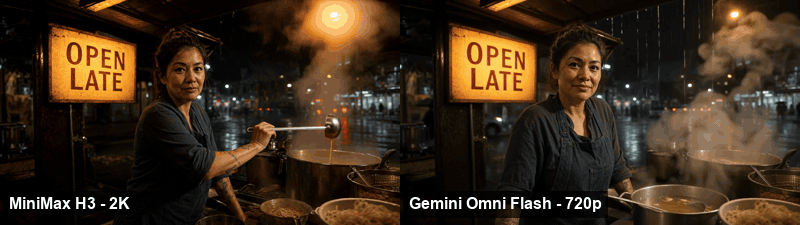
MiniMax H3 與 Gemini Omni Flash 測試第一輪,兩個模型動畫化相同的初始畫面,並排顯示
第一輪:相同的初始畫面、相同的提示、相同的長度。左邊是 MiniMax H3 的 2K,右邊是 Gemini Omni Flash 的 720p。此處以無聲 GIF 顯示;兩個生成的檔案都帶有原生音訊,並在下方嵌入為可播放影片。這就是問題所在。兩者都很好。
為什麼 MiniMax H3 與 Gemini Omni Flash 的排行榜差距會被誤讀
幾乎所有關於 MiniMax H3 與 Gemini Omni Flash 的貼文,都只引用一個排行榜和一個價格。這兩個習慣都會導致錯誤答案。
以下是三塊 Artificial Analysis 排行榜,以及大家都跳過的那一欄。
表 A:MiniMax H3 與 Gemini Omni Flash 在三項 Artificial Analysis 排行榜(含音訊)的比較,資料擷取於 2026 年 8 月 6 日
| 排行榜 | Gemini Omni Flash | MiniMax H3 | 差距 | 落在誤差範圍內? |
|---|---|---|---|---|
| 文字轉影片 | 1,243 (#1) ±7, 11,842 票 | 1,238 (#2) ±9, 6,830 票 | Gemini +5 | 是 |
| 圖片轉影片 | 1,191 (#2) ±9, 6,506 票 | 1,189 (#3) ±10, 5,545 票 | Gemini +2 | 是 |
| 影片剪輯 | 1,123 (#2) ±5, 11,706 票 | 1,132 (#1) ±6, 9,128 票 | H3 +9 | 是,勉強過關 |
你可以在 Atlas Cloud 模型比較 中,將 MiniMax H3 與 30 多個影片模型並排對比,並在生成前看到每秒成本。
Elo 分數來自 Artificial Analysis Video Arena(Artificial Analysis,2026 年 8 月)。圖片轉影片項目的領先者是 Dreamina Seedance 2.0 720p(1,197 分),所以這兩個模型都沒拿到那個王座。這些是滾動的群眾投票分數,而且會變動,這正是為什麼 5 分的差距不能當作定論。
一個 5 分的領先,搭配 ±9 的信賴區間,意味著排名可能只因為投票噪音就在下週翻轉。這不是「Gemini 在文字轉影片方面比較好」。這只是個有計分板的擲硬幣遊戲。
還有三件事人們常搞錯:
「每分鐘美元」欄位不是你要付的錢。 Artificial Analysis 列出 Gemini 每分鐘 6.00 美元,H3 每分鐘 7.80 美元。該欄位標準化為預設設定下 1080p 影片一分鐘的成本。但 Gemini Omni Flash 根本無法產生 1080p。所以這個數字是模型估算,不是實際帳單。要比就比最終成品,而不是比秒數。
一個排行榜不代表整個模型。 在三塊排行榜中,H3 分別是第二、第三和第一。Gemini 分別是第一、第二和第二。只引用其中一個,你就能證明你原本就相信的結論。
「Omni」不代表「什麼都能吃」。 這是個好名字,但會誤導人。這兩個模型之中,有一個可以接受音訊檔案作為輸入。不是名字裡有「omni」的那個。
沒人列的 MiniMax H3 與 Gemini Omni Flash 規格表
如果 Elo 分數無法區分它們,那規格限制表可以。我直接從兩個模型的即時輸入架構抓取資料,而不是相信任何發表文章,而差異很明顯。
表 B:MiniMax H3 與 Gemini Omni Flash 的硬性限制,取自 2026 年 8 月 6 日的即時 API 架構
| 限制 | MiniMax H3 | Gemini Omni Flash |
|---|---|---|
| 解析度 | 768P 或 2K | 720p,而且這是列舉中唯一的值 |
| 長度 | 4 到 15 秒 | 3 到 10 秒 |
| 畫面比例 | 21:9、16:9、4:3、1:1、3:4、9:16 | 僅 16:9 和 9:16 |
| 修改路徑 | reference-to-video(以參考為基礎重新生成) | 專用 video-edit 端點(直接修改原始檔案) |
| 最後影格控制 | 支援 end_image | 不支援 |
| 參考限制 | 最多 9 張圖片、最多 3 部影片、最多 3 個音訊、總共 12 個檔案 | 1 到 10 張圖片 |
| 音訊輸入 | 是 | 否 |
| seed 可重複性 | 否 | 是 |
| thinking_level | 否 | 是(預設 / 高 / 低) |
| 開放權重 | 是,在 Hugging Face | 否 |
誠實地看這張表,Gemini 在三個項目上明顯勝出。可重複的 seed 對於需要兩次渲染相同畫面的流程很重要。真正的 video-edit 端點是一個與參考條件再生完全不同的工具。而 thinking_level 提供了一個 H3 根本沒有的品質調整選項。
H3 在五個項目上勝出,而這些項目正是決定你是否能交付客戶要求的檔案的那些。
我在 Atlas Cloud 上執行所有測試,因為兩個模型都透過同一個 /api/v1/model/generateVideo 端點提供,這意味著整個測試只需要一個輪詢迴圈和一個驗證標頭。切換模型只需要更改 model 字串。這個細節就是為什麼「兩個都用」是實際可行的答案,而不是敷衍了事。
表 C:本次測試中每個端點的成本,根據 2026 年 8 月 6 日即時價格表驗證
| 端點 | 價格 | 本次測試的 10 秒片段 |
|---|---|---|
| openai/gpt-image-2/text-to-image | $0.009 / 張 | $0.01 |
| minimax/h3/image-to-video | $0.14 / 秒 | $1.40 |
| minimax/h3/reference-to-video | $0.14 / 秒 | $1.40 |
| google/gemini-omni-flash/image-to-video | $0.13 / 秒 | $1.30 |
| google/gemini-omni-flash/video-edit | $0.14 / 秒 | $1.40 |
| google/gemini-omni-flash/text-to-video | $0.125 / 秒 | 未使用 |
| minimax/h3/text-to-video | $0.14 / 秒 | 未使用 |
本月兩個模型都沒有折扣。Gemini 還提供一個更便宜的開發者層級(文字轉影片和圖片轉影片 $0.112/秒,參考轉影片 $0.12/秒);H3 沒有對應的層級。
Gemini Omni Flash 無法跨越的開放權重門檻。 H3 的權重已發佈在 Hugging Face(MiniMax,2026 年 8 月):一個 33B 密集單流 Omni Transformer,加上 Qwen3-VL-32B 文字編碼器、視覺 VAE 和音訊 VAE。有兩個注意事項比下載大小更重要。首先,你自行託管的版本執行在 768 像素短邊;Context-IR 預處理階段和 Regenerate-2K 模組並未包含在釋出中,2K 輸出來自這兩個部分。其次,社群授權目前不涵蓋歐盟、英國、南韓或美國,這些地區需要單獨申請。在基於此構建產品之前,請先閱讀。Gemini Omni Flash 沒有類似的對話,因為根本沒有檔案可下載。
這個開放權重的定位,加上積極的定價,是這次發佈的整個策略重點(南華早報,2026 年 8 月)。
親自執行 MiniMax H3 與 Gemini Omni Flash 修改測試
以下是沒人做過的部分。每個人都只測試第一次生成。沒有人測試第二次。
真正的工作不是一個提示就結束。真正的工作是你已經喜歡的片段,加上客戶回覆說「很喜歡,可以讓招牌顯示 24H,然後她的圍裙改成紅色嗎」。那句話正是這兩個模型不再能互換的關鍵,而這正好是影片剪輯排行榜衡量的任務。
這個場景刻意設計得很殘酷:一個雨夜的麵攤,老闆娘直視鏡頭說話,她身後有一塊手繪招牌,上面的字清晰可見,湯鍋冒著蒸氣,雨打在遮雨棚上。一個畫面同時考驗嘴型同步、畫面上文字穩定性、流暢動作和分層環境音效。
兩個模型都拿到相同的初始畫面、相同的提示和相同的修改指示。以下的每個生成都是 10 秒,這是 Gemini Omni Flash 的上限,但在 H3 的範圍內。
步驟 1:用 GPT Image 2 鎖定初始畫面
兩個模型必須從同一張圖片開始,否則第一輪測量的是構圖運氣而不是模型本身。打開 GPT Image 2 遊樂場,將品質設為 高,比例設為 16:9,貼上以下內容:
Plain1Photoreal night street-food stall in heavy rain, shot on a 35mm lens at f/2.0. A woman in her late thirties in an indigo canvas apron stands behind a steaming noodle counter, looking straight into the lens, mid-sentence. Behind her a hand-painted tin light-box sign glows warm amber with the words "OPEN LATE" in clean bold sans-serif capitals. Rain streaks through the sodium streetlight, steam rises off the broth pot, wet asphalt reflects red and green neon from across the street. Shallow depth of field, practical lighting only, slight lens haze, natural skin texture, no text anywhere else in the frame. 16:9.
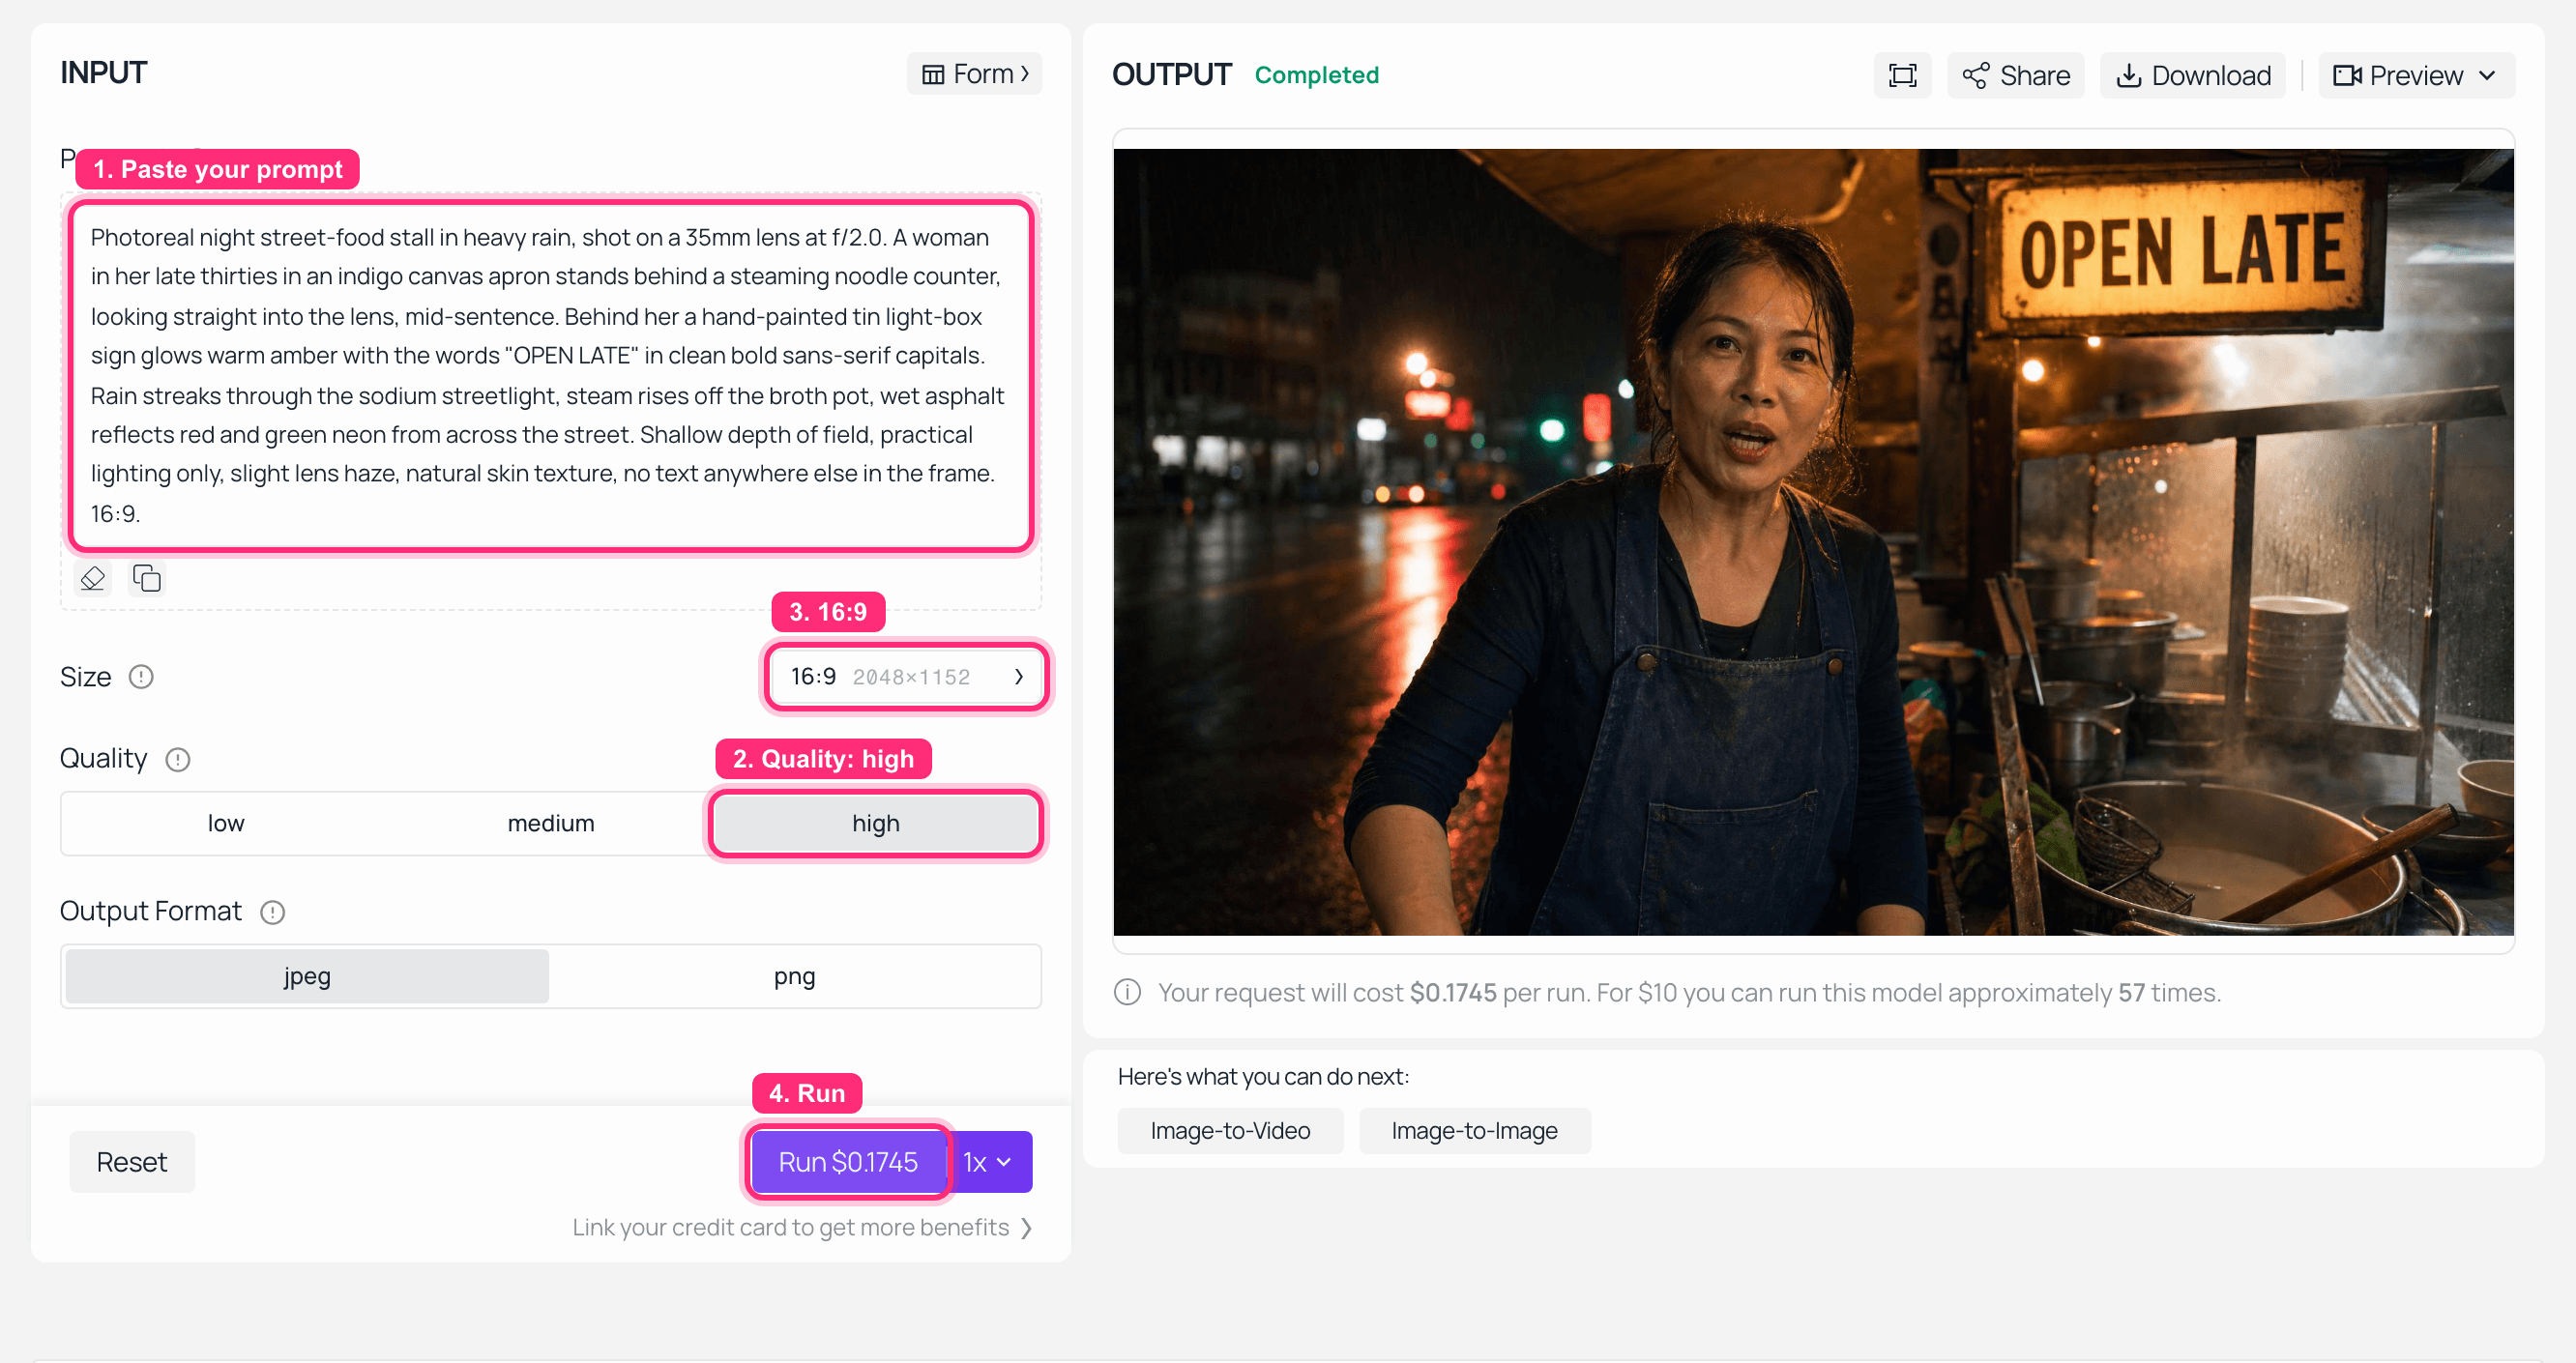
Atlas Cloud 上的 GPT Image 2 遊樂場,左邊是麵攤提示,右邊輸出面板是生成的初始畫面
Atlas Cloud 上的 GPT Image 2:左邊是提示,右邊 OUTPUT 是共用的初始畫面。這一步驟的成本是 $0.009。
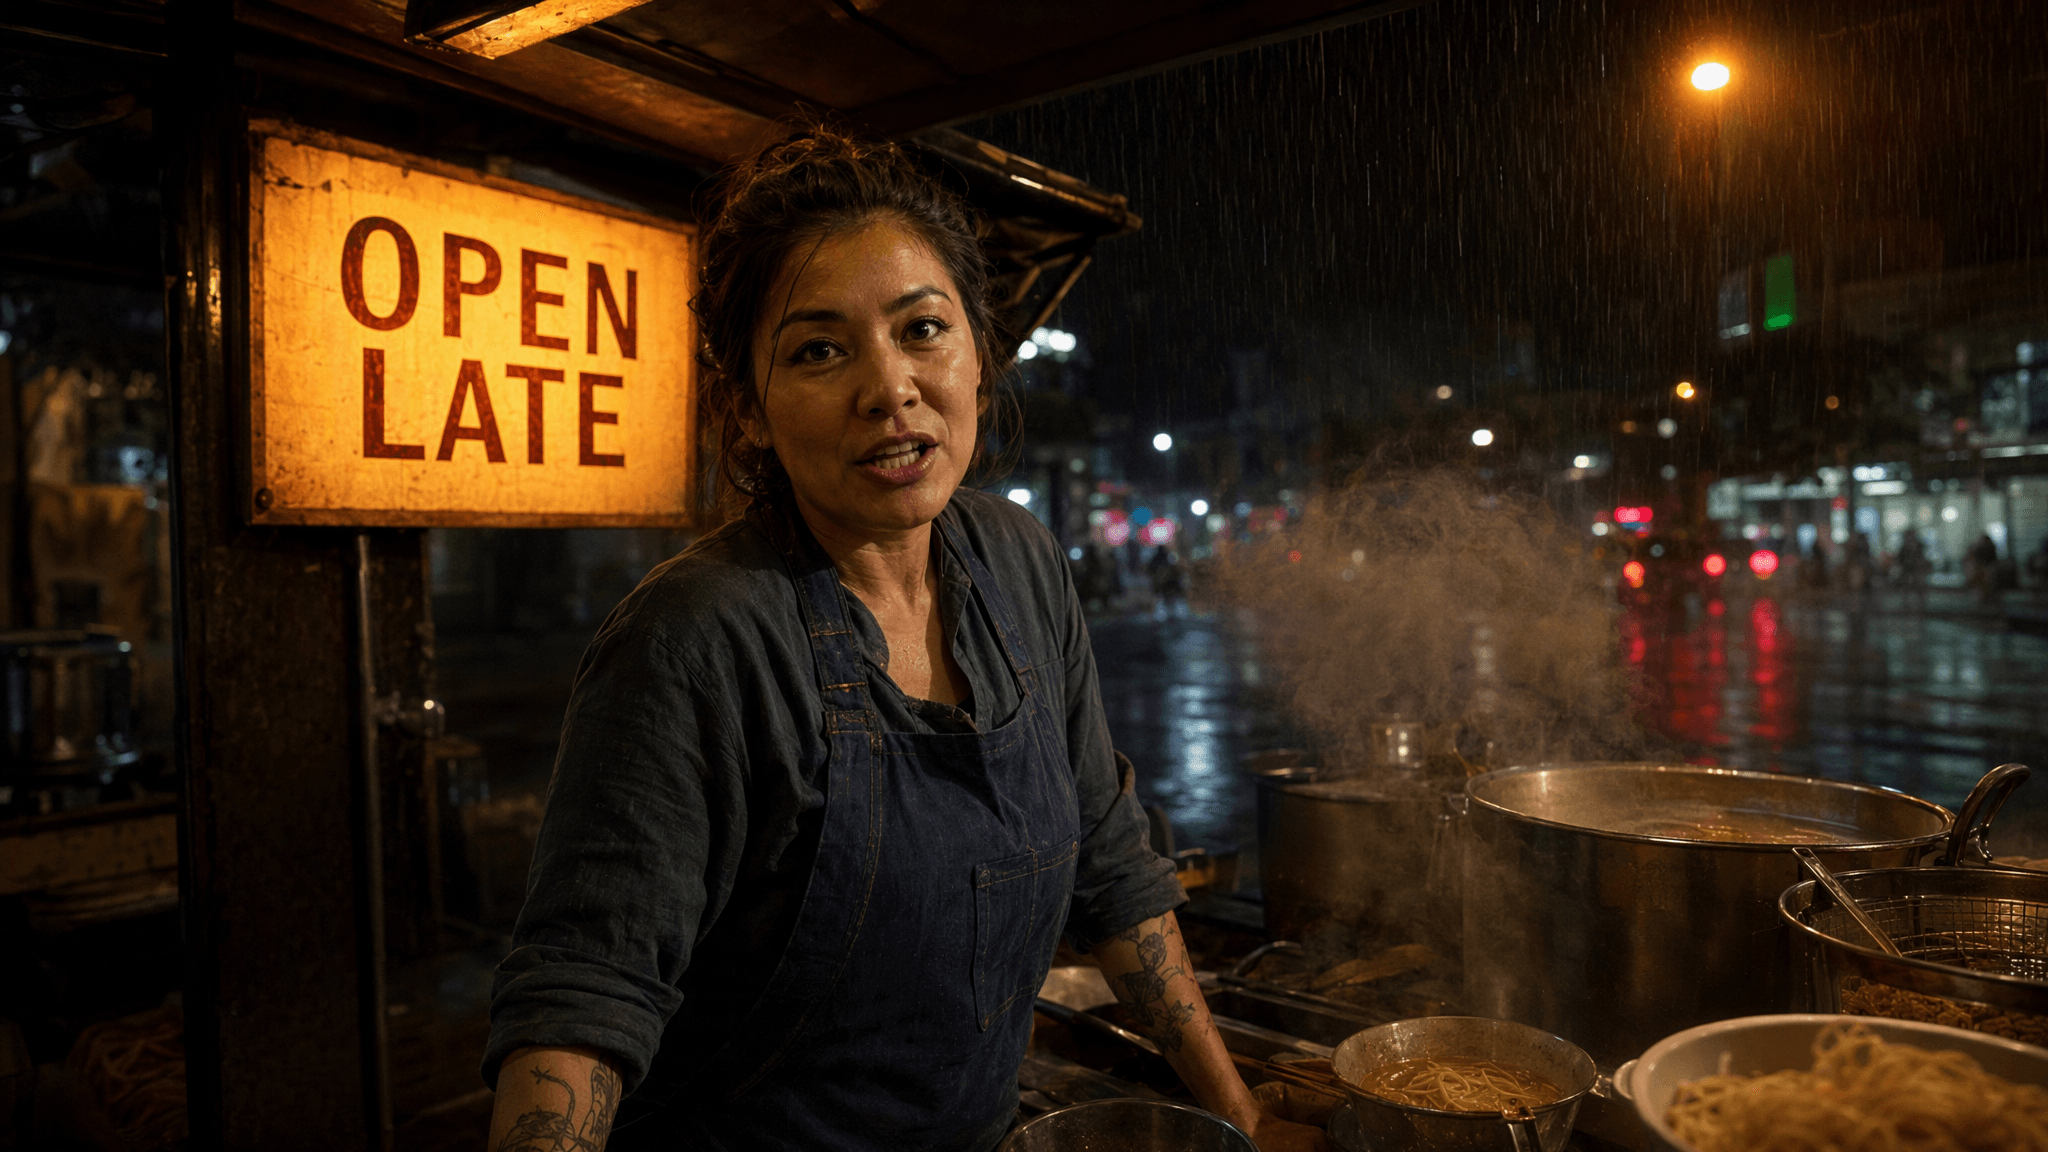
生成的初始畫面:一位身穿靛藍圍裙的女士在雨夜的麵攤後,身後有塊發光的「OPEN LATE」手繪招牌
兩個模型收到的唯一輸入畫面。注意修改指示要針對的兩件事:「OPEN LATE」招牌和靛藍圍裙。使用 openai/gpt-image-2/text-to-image 生成。
步驟 2:MiniMax H3 第一輪
前往 MiniMax H3 遊樂場,選擇 image-to-video 任務,上傳步驟 1 的圖片,將 resolution 設為 2K,duration 設為 10,ratio 設為 adaptive(圖片轉影片的列舉只有 adaptive)。提示:
Plain1The vendor looks into the lens and says, in a warm tired voice: "Broth's been on since four this morning. Sit down, it's still raining." She lifts the ladle as she speaks. Steam curls up across the frame. Rain keeps falling on the awning behind her. The camera holds still, no push, no pan. Ambient audio: rain on canvas, broth simmering, distant traffic, her voice close and dry.
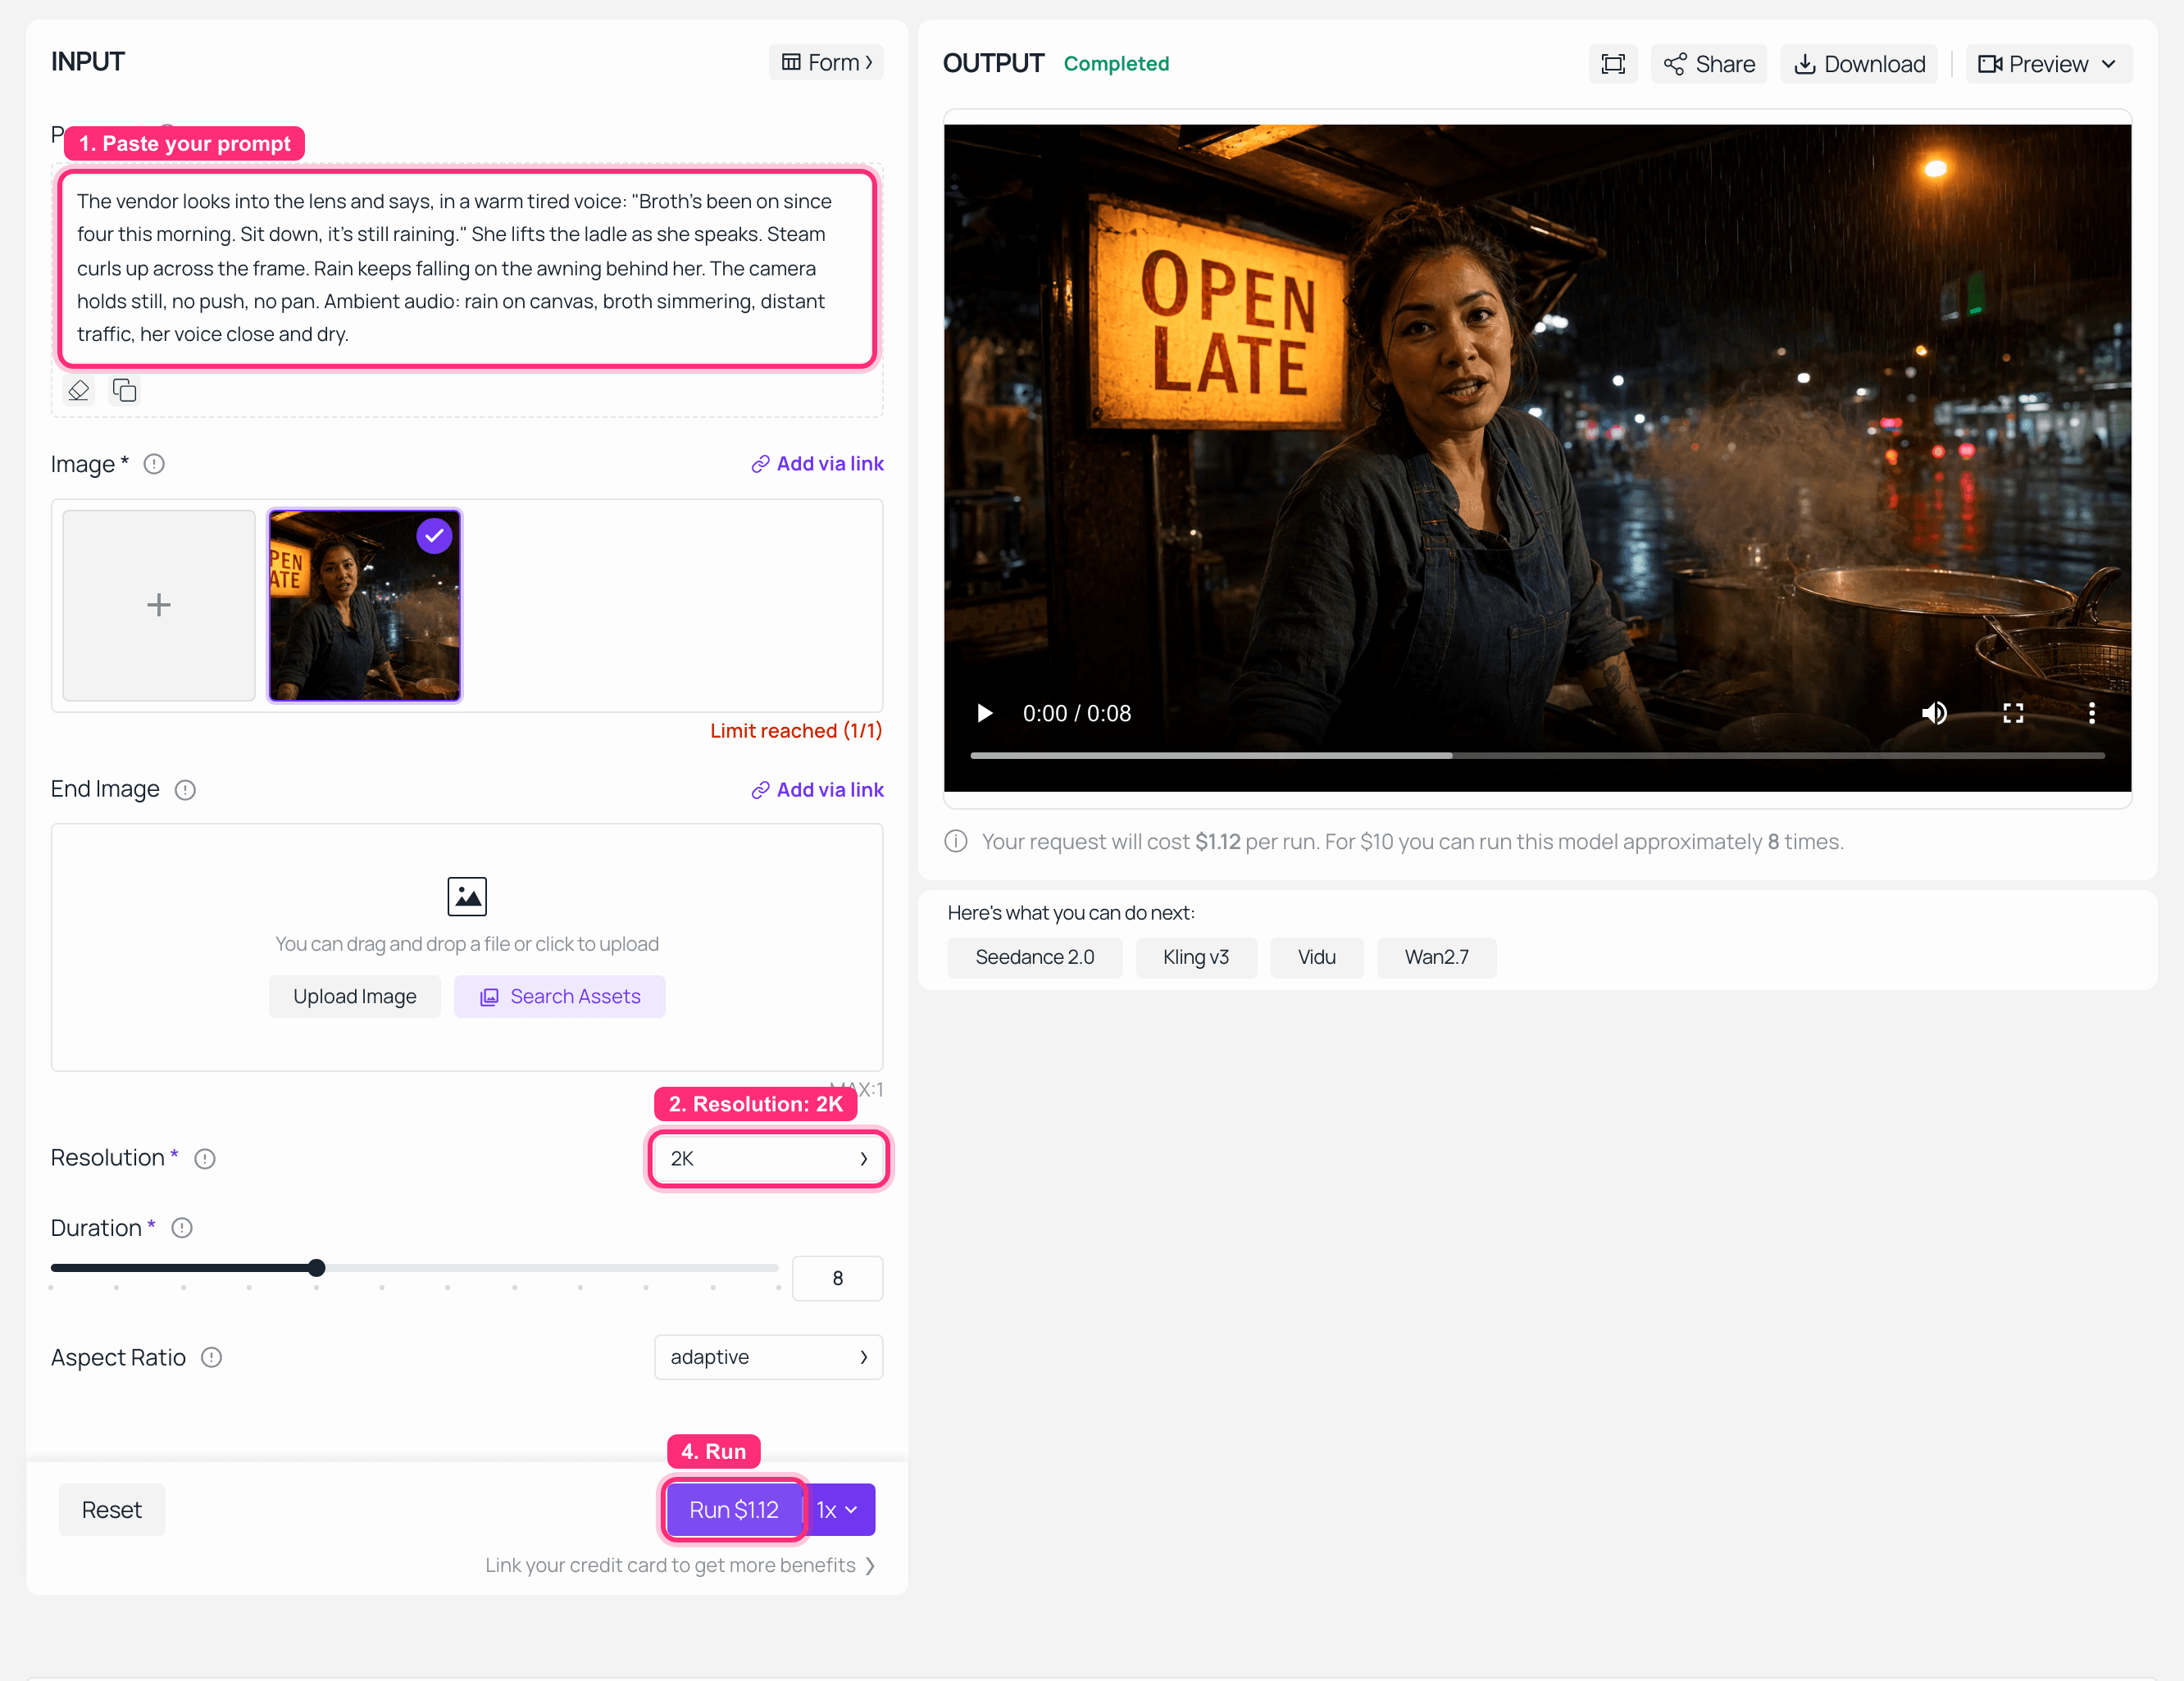
Atlas Cloud 上的 MiniMax H3 圖片轉影片遊樂場,選擇了 2K 解析度,輸出面板中顯示完成的片段
Atlas Cloud 上的 MiniMax H3 圖片轉影片:選擇 2K,完成的片段在 OUTPUT。這個擷取畫面以遊樂場的 8 秒預設值執行,成本為 $1.12;用於比較的 10 秒版本在下方嵌入,成本為 $1.40。
MiniMax H3,第一輪,2K,10 秒。請開啟聲音:對話、雨聲和湯鍋聲都是在同一輪生成中產生的,不是後製疊加的。
步驟 3:Gemini Omni Flash 第一輪,相同畫面,相同文字
打開 Gemini Omni Flash 遊樂場,選擇 image-to-video,上傳相同的步驟 1 圖片,並貼上步驟 2 的提示,不修改任何字元。設定:resolution 720p,duration 10,aspect_ratio 16:9,thinking_level default,seed -1。
當你在那個表單中時,有兩件事要注意,因為它們是這篇文章的縮影。resolution 下拉選單只有一個選項。duration 欄位最多到 10。我不是選擇 720p 而不是更好的東西;而是根本沒有其他東西可選。
關於這裡缺少什麼的說明:我無法為兩個 Gemini 步驟擷取到執行完成的遊樂場畫面。我用來擷取畫面的暫存環境從 Google 端回傳了 403 PERMISSION_DENIED,三次都是如此,所以我只有顯示失敗 OUTPUT 面板的 Gemini 擷取畫面,我不會把它偽裝成成功執行的畫面。下面的影片是真實的,是透過生產 API 使用上述設定生成的。H3 的兩個步驟確實成功擷取到畫面,那些擷取畫面是真實的。
Gemini Omni Flash,第一輪,720p,10 秒,相同的輸入。在上面的 H3 片段之後直接播放這個,然後自己判斷音訊。
步驟 4:第二輪,將修改指示發送給 Gemini Omni Flash
這是關鍵的一輪。在同一個 Gemini 模型頁面上切換到 video-edit 任務,上傳 Gemini 自己在步驟 3 中產生的片段 作為 video 輸入,設定 resolution 720p 和 thinking_level high(一個包含兩部分修改的指示正是這個調整選項要處理的複雜情況)。完全按照客戶會發送的方式貼上這個指示:
Plain1Keep this exact shot: same camera position, same woman, same face, same rain, same lighting, same audio. Change the hand-painted sign so it reads "OPEN 24H" instead of "OPEN LATE", in the same painted style and the same amber glow. Change her apron from indigo blue to deep crimson. Change nothing else in the frame.
Gemini Omni Flash 在修改指示後的結果。請看招牌,然後看圍裙,再檢查是否有其他東西移動了。
步驟 5:第二輪,將相同的修改指示發送給 MiniMax H3
這裡是誠實的結構性差異,你應該在閱讀結果之前就知道。H3 沒有 video-edit 端點。它的修改路徑是 reference-to-video:你將原始片段作為參考提供給它,它會根據該參考生成一個新的影片。它不是編輯你的檔案。它是製作一個新的、看起來像你的檔案的作品。
在 MiniMax H3 頁面上,選擇 reference-to-video 任務,將 H3 在步驟 2 中產生的片段 加入 refers 作為影片參考,然後設定 resolution 2K,duration 10,ratio adaptive。貼上步驟 4 的提示,完全不修改。
這個步驟也沒有遊樂場擷取畫面,原因不同且更無聊:我用來擷取畫面的無頭瀏覽器在載入影片參考時,在參考上傳器上當機了三次。這個執行本身是透過 API 順利完成的。
MiniMax H3 在相同的修改指示後,透過 reference-to-video 以 2K 執行。
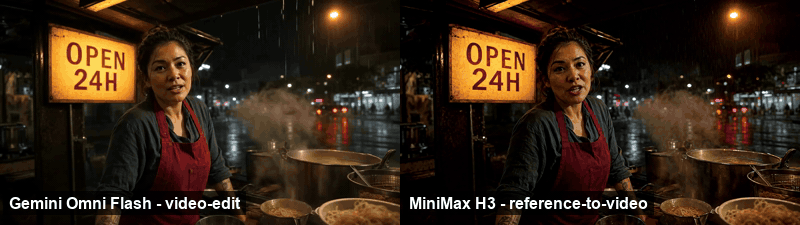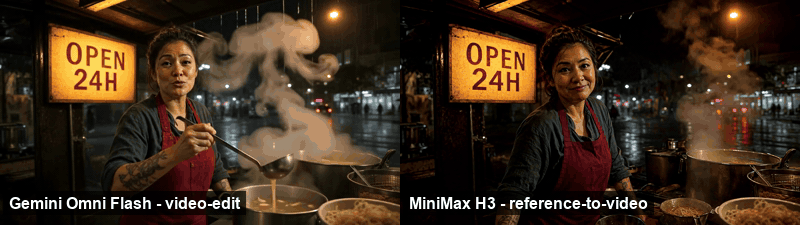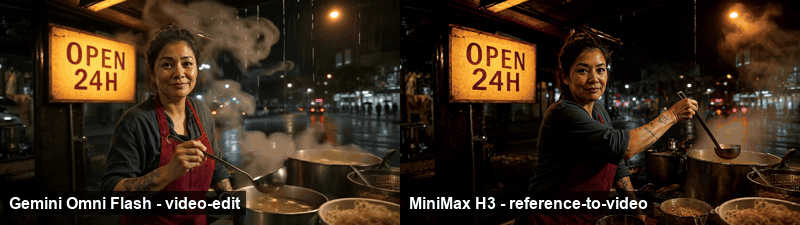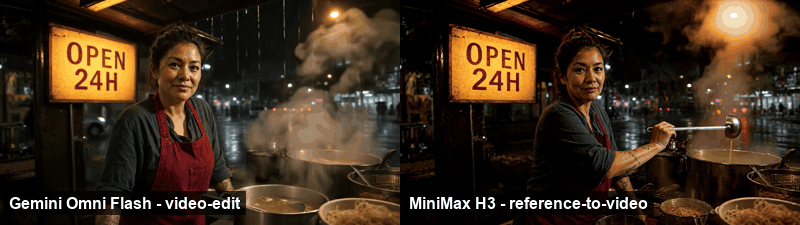
第二輪並排比較:左邊是 Gemini Omni Flash 的 video-edit 結果,右邊是 MiniMax H3 的 reference-to-video 結果,兩者都來自相同的修改指示
第二輪並排,無聲 GIF。左邊是 Gemini Omni Flash 的 video-edit,右邊是 MiniMax H3 的 reference-to-video。兩者都根據相同的句子進行修改。
第二輪實際發生了什麼。 我原本預期 H3 會輸掉這一輪。參考條件再生比真正的編輯端點更粗糙,而「重新生成整個片段,希望它落在同一個地方」正是你會得到不同臉孔、鏡頭偏移以及客戶問「畫面怎麼了」的方式。
但結果並非如此。兩個模型都完成了任務,而且都做得很乾淨。
Gemini 的 video-edit 表現完全符合預期。招牌現在顯示「OPEN 24H」,使用相同的手繪字體、相同的琥珀色光芒和相同的金屬招牌風化效果。圍裙變成了深紅色。其他一切都沒變:相同的臉、相同的表情、相同的湯勺角度、相同的蒸汽形狀、相同的雨、相同的背景尾燈。它看起來就像原始檔案做了兩個像素級的修正,因為本質上就是如此。
H3 的 reference-to-video 也產生了相同的兩個變化,而且畫面穩定性遠比其架構所暗示的好。招牌改了,圍裙改了,而且在這 10 秒內,與第一輪片段相比,構圖、湯勺倒湯的姿勢、蒸汽柱和她的臉都保持得很好。如果這裡有偏移,我逐幀檢查也找不到。
所以第二輪是第三個統計上的平手,我不會為了讓故事更乾淨而假裝不是。這兩個輸出的區別不在於編輯品質。而是 H3 回傳了 2560x1440 的解析度與 32 kHz 立體聲軌道,而 Gemini 回傳了 1280x720。相同的指示,相同的成功,不同的可交付成果。
一個誠實的方法論說明:這只是針對單一畫面的單次修改,不是受控研究。對招牌和衣物進行兩部分修改算是相當友善的編輯。更困難的情況(移除鏡頭移過去的物體、改變被主體遮擋的東西、疊加四輪修改指示)才是專用編輯端點應該佔優勢的地方,也是再生開始不穩定的地方。在做出決定之前,請先執行你自己的測試。
三個值得測試的 MiniMax H3 與 Gemini Omni Flash 差異
第二輪是改變交付結果的關鍵。還有三個差異值得花二十分鐘和你的帳戶餘額來測試。
餵它一個音訊檔案。 H3 的 reference-to-video 可以接受最多三個 2 到 15 秒的音訊片段,只要至少有一個圖片或影片參考一起提供。這意味著你可以給它一段真實的語音錄音,讓角色表演出來。Gemini Omni Flash 在其四個端點中沒有任何一個有音訊輸入欄位,所以這個比較根本無法進行。這對 Google 來說不是分數上的損失;這是一種根本不存在的功能。
要求 21:9。 H3 的 reference-to-video 比例列舉包含 21:9、16:9、4:3、1:1、3:4 和 9:16。Gemini 的 aspect_ratio 列舉包含 16:9 和 9:16。如果你的可交付成果是寬銀幕標題序列或 1:1 的社群媒體剪輯,那麼這兩個模型中有一個根本不在討論範圍內。
鎖定一個 seed 並重新執行。 這個方向相反。Gemini 提供了 seed;H3 在任何端點上都沒有提供。如果你正在建立一個流程,要求相同的請求在星期二必須回傳與星期一相同的影格,那麼 Gemini 給了你一個控制點,而 H3 什麼都沒給。對於迴歸測試、A/B 文案變體,或任何自動化算圖農場,這是一個真正的優勢,應該記在 Google 的帳上。
MiniMax H3 與 Gemini Omni Flash 測試的實際成本
以上整個實驗,四個影片生成和一個圖片,總共大約 $5.51。一張初始畫面 $0.009,兩個 10 秒的第一輪片段 $1.40 和 $1.30,兩個 10 秒的第二輪片段各 $1.40。
每秒來看,Gemini 比較便宜:$0.125 到 $0.14,而 H3 是固定的 $0.14,所以根據端點不同,大約便宜 7% 到 11%。這個數字是真的,但單獨來看幾乎沒用。
原因如下。假設可交付成果是一個 15 秒的 21:9 電影級開場,解析度為 2K。H3 可以一次生成。Gemini 根本無法生成:解析度、長度、畫面比例都不行。你必須拼接一個 10 秒和一個 5 秒的 16:9 片段,裁剪成偽寬銀幕,然後交付 720p。你無法交付的東西的每秒價格,不是省錢。
反過來說。假設可交付成果是一個 16:9 的社群媒體剪輯,需要經過四輪客戶修改,而且當法務部門在三週後要求重新渲染時,必須逐位元組相同。Gemini 的 video-edit 加上 seed 正是為這種循環而設計的,而且執行時每秒成本更低。
表 D:哪個 MiniMax H3 與 Gemini Omni Flash 的工作該交給誰
| 你面前的工作 | 交給 |
|---|---|
| 2K 交付 | MiniMax H3 |
| 超過 10 秒的單一鏡頭 | MiniMax H3 |
| 21:9、4:3、1:1 或 3:4 構圖 | MiniMax H3 |
| 餵入真實音訊軌道 | MiniMax H3 |
| 在自己的 GPU 上自行託管 | MiniMax H3 |
| 落在特定的最後影格 | MiniMax H3 |
| 對話式的多輪修改 | Gemini Omni Flash |
| 保留片段中未修改的部分 | Gemini Omni Flash |
| 透過 seed 實現可重複渲染 | Gemini Omni Flash |
| 標準 16:9 短片,最低每秒成本 | Gemini Omni Flash |
這篇文章的結論是那張表,而不是一個分數。如果一個基準測試無法以超過其自身誤差棒的差距區分兩個模型,那麼基準測試已經告訴了你它知道的一切,接下來規格表接手。
要更廣泛地了解 H3 在整個領域中的位置,MiniMax H3 替代方案分析 涵蓋了在其不領先的排行榜上擊敗它的模型。
常見問題
MiniMax H3 比 Gemini Omni Flash 好嗎?
盲測無法區分它們。在三項 Artificial Analysis 排行榜上,差距分別是 5、2 和 9 個 Elo 分數,而且每一個都落在 ±7 到 ±10 的信賴區間內。根據規格而不是排名來選擇。解析度上限、長度上限和畫面比例列表會改變你的可交付成果;5 個 Elo 分數則不會。
MiniMax H3 和 Gemini Omni Flash 哪個比較便宜?
每秒來看,Gemini 比較便宜。在 Atlas Cloud 上,它每秒 $0.125 到 $0.14,而 H3 是固定的 $0.14,而且 Gemini 還有一個開發者層級,每秒 $0.112,H3 沒有對應層級。但 Gemini 限制在 720p、10 秒和兩種畫面比例,所以對於許多可交付成果來說,你比較的不是同一種產品。比較的是最終剪輯的價格,而不是每秒價格。
Gemini Omni Flash 可以生成 1080p、2K 或 15 秒的影片嗎?
不行。它的 API resolution 參數只有一個合法值 720p,duration 接受 3 到 10 秒。MiniMax H3 提供 768P 或 2K,以及 4 到 15 秒。這些是從 2026 年 8 月 6 日即時架構讀取的列舉限制,不是編輯意見,Google 可能之後會放寬。
我可以像自行託管 MiniMax H3 那樣自行託管 Gemini Omni Flash 嗎?
不行。H3 的權重在 Hugging Face 上,可以在本地以 768 像素短邊執行。產生 2K 輸出的 Context-IR 階段和 Regenerate-2K 模組並未包含在釋出中,保留在 API 端。另外,請檢查授權:目前它不涵蓋歐盟、英國、南韓或美國,除非單獨申請。
我只能選擇一個嗎?
不,上面的「按工作分配」表格是更好的答案。兩個模型在 Atlas Cloud 上都透過同一個 generateVideo 端點提供,所以同時使用兩個模型只需要一個輪詢迴圈和不同的 model 字串,而不是兩個整合。根據可交付成果來路由,比賭在每週都會變動的排行榜上要好。


