


本月十天内发布了三款旗舰编程模型:11 月 9 日的 Claude Fable 5.2、11 月 17 日的 GPT-6.2 以及 11 月 18 日的 Gemini 4 Neon。每篇发布文章都把自己的模型放在图表首位。那么,当你自己为 token 付费时,哪个才是最佳编程 AI 模型?
我们用同一个 API key 在 Atlas Cloud 上,对下面十款模型中的七款运行了相同的三项编程任务,每项三次,并由模型从未见过的隐藏测试评分。Claude Fable 5.2、Claude Opus 5.5 和 Gemini 4 Neon 根据公开基准排名,每个部分会说明你看到的是谁的数据。以下是排名,以及一个正确答案在时间和 token 上花费了多少。
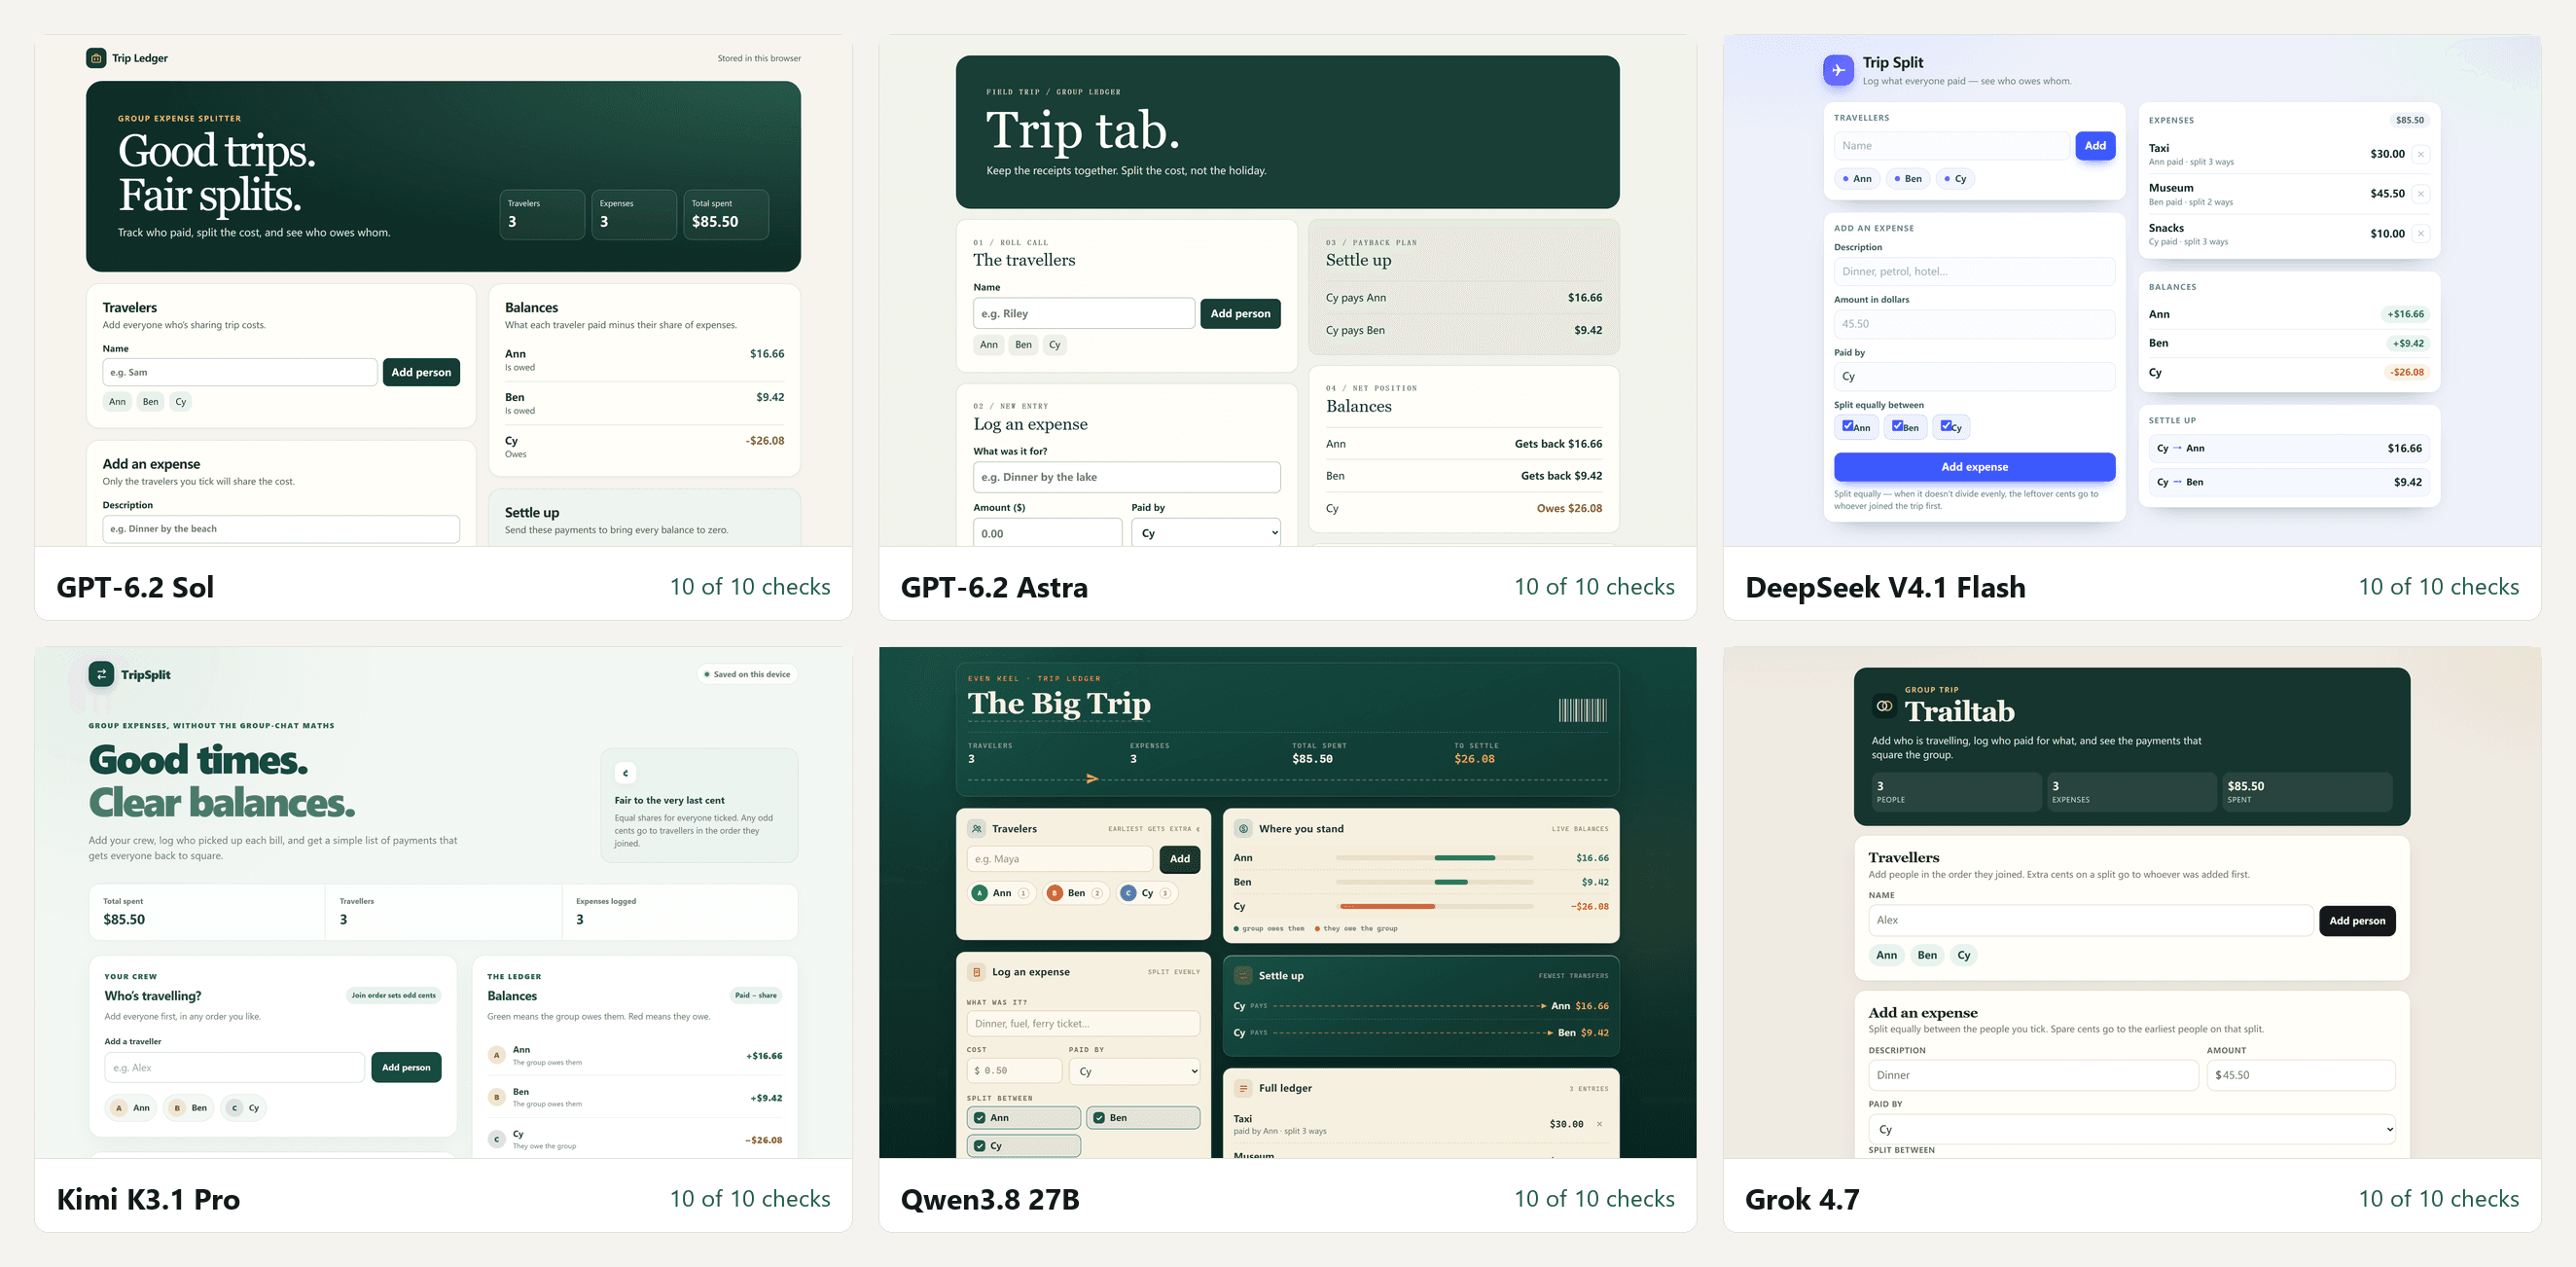
我们第三项测试的真实输出。每个应用都是对同一提示词的一次回复,于 2026 年 11 月 20 日在浏览器中打开,未做任何编辑。
关键要点
- OpenAI 的 GPT-6.2 Sol 是我们整体上最佳的编程 AI 模型:九次测试运行全部解决,每次约 24 秒。
- 我们运行的七款模型中有四款解决了全部九次运行。每次运行的平均时间从 23 秒到约八分钟不等。
- Gemini 4 Neon 和 Claude Fable 5.2 在 Artificial Analysis Coding Agent Index 上位居前列,差距不到一分。
- DeepSeek V4.1 Flash 是最佳的免费编程 AI:在 DeepSeek 自家应用中免费,权重以 MIT 许可发布。
- Qwen3.8 27B 是我们选出的最佳本地编程 AI 模型,权重以 Apache 2.0 开放。
最佳编程 AI 模型:2026 年对比表
哪个 AI 最适合编程取决于你看哪一列。十款模型中有四款公开权重,其中七款在此运行。标价从每百万输入 token $0.30 到 $8,相差约 27 倍。在我们的运行中,一次成功运行的成本相差约 13 倍,从 3 美分到 39 美分。
API 价格是七款我们运行的模型的 Atlas Cloud 标价,以及另外三款的厂商标价,均截至 2026 年 11 月 20 日。Coding Agent Index 来自 Artificial Analysis,同日读取,每款模型都位于该页面为其配对的代理中。
| 模型 | 最适合 | 权重 | API 价格,每 1M 输入 / 输出 | Coding Agent Index | 我们的运行:解决数,平均时间 | 每次成功运行成本 |
|---|---|---|---|---|---|---|
| GPT-6.2 Sol | 日常编程整体最佳 | 闭源 | $2 / $10 | 50 | 9/9,24 秒 | $0.04 |
| Claude Fable 5.2 | 长时、困难任务 | 闭源 | $8 / $40 | 58 | 未运行 | 未运行 |
| Gemini 4 Neon | 编程代理 | 闭源 | $3 / $15 | 59 | 未运行 | 未运行 |
| GPT-6.2 Astra | 代码审查 | 闭源 | $8 / $40 | 53 | 9/9,23 秒 | $0.11 |
| DeepSeek V4.1 Flash | 免费用途 | 开放,MIT | $0.30 / $1.20 | 37 | 9/9,139 秒 | $0.03 |
| Claude Opus 5.5 | 预算更低的 Claude | 闭源 | $4 / $20 | 58 | 未运行 | 未运行 |
| Kimi K3.1 Pro | 开放权重代理工作 | 开放,自定义许可 | $2 / $10 | 49 | 9/9,489 秒 | $0.18 |
| Qwen3.8 27B | 本地使用 | 开放,Apache 2.0 | $0.50 / $3 | 未列出 | 8/9,491 秒 | $0.12 |
| GLM 5.3 | 低成本 bug 修复 | 开放,自定义许可 | $1.40 / $4.40 | 40 | 6/9,301 秒 | $0.25 |
| Grok 4.7 | 免费代理试用 | 闭源 | $2 / $6 | 42 | 6/9,495 秒 | $0.39 |
我们如何测试本列表中的每款编程 AI 模型
我们于 2026 年 11 月 20 日运行测试,并在同一天读取了每一项价格和排行榜。每个受测模型都通过普通 API 接收相同提示词:没有系统提示词,默认推理强度,周围没有编程代理。
- 按规格构建。 一个 Python 营业时间截止时间计算器,由 20 项隐藏测试评分。
- 跨文件修复 bug。 一个 TypeScript 库存预留模块,植入四个 bug,由 12 项隐藏测试评分。
- 一次性 Web 应用。 一个单文件旅行费用分摊器,由 10 项自动化浏览器检查评分。
只有每项检查都通过,一次运行才算解决。每项任务三次运行,即每款模型九次,共 63 次。
四项标准决定排名:
- 解决的运行数。 九次运行中有多少次通过了每项隐藏检查。
- 每次成功运行的成本和时间。 总支出除以成功运行数,加上每次运行的平均秒数。
- 公开代理基准。 Artificial Analysis Coding Agent Index、Terminal-Bench 4.1 和 LiveBench 2.0,截至 2026 年 11 月 20 日发布。
- 可及性。 免费层、开放权重和 API 标价。
成功运行数优先,四款模型以九次全解并列。每次成功运行的成本和时间打破平局,因此它们在我们运行的七款模型中权重最大。公开代理基准排定我们未运行的三款。
关于上限的一点说明。我们起初将每次回复限制为 20,000 输出 token,五款模型至少在一项任务上触及该限制,其中大多数仍在推理。我们将上限提高到 64,000,并重新运行被截断的调用,这里每个数字都来自该设置。
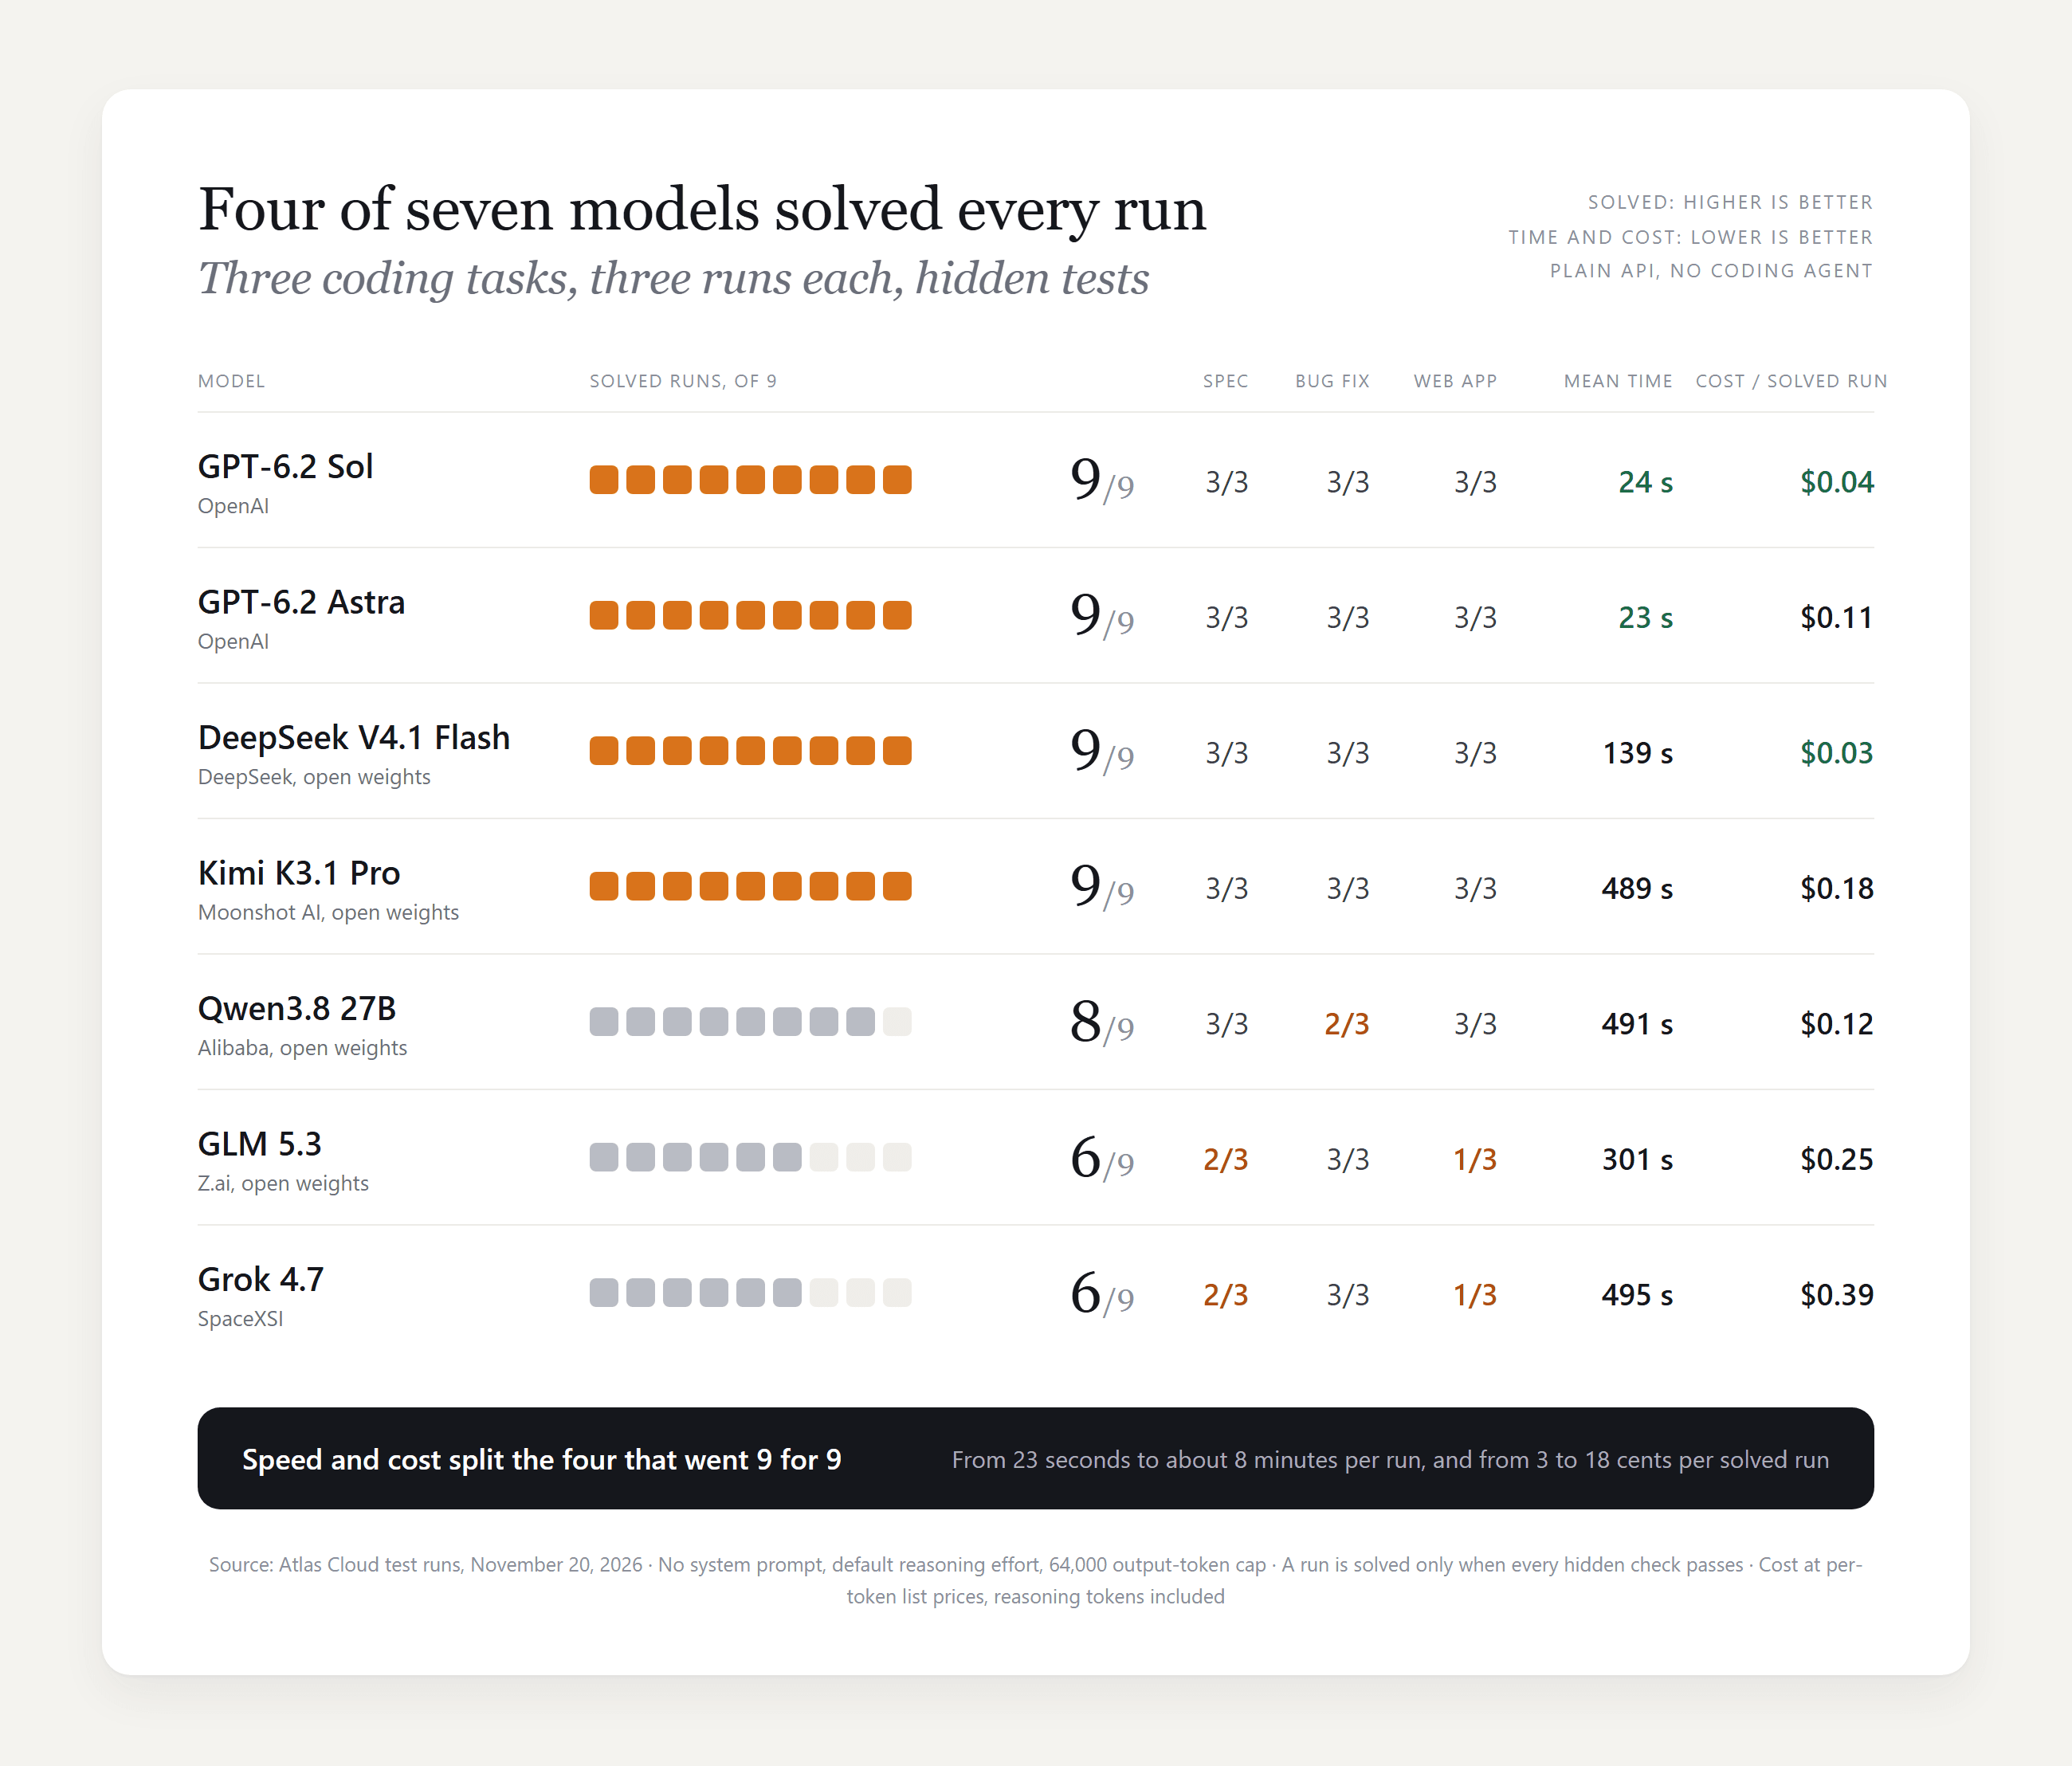
图表由 Atlas Cloud 根据我们 2026 年 11 月 20 日的自有运行制作。
披露:Atlas Cloud 发布本文,并托管我们运行的七款模型,包括排名第一的模型。没有任何模型厂商付费获得排名,每款模型都根据其公开数据和我们的自有运行进行描述。
1. GPT-6.2 Sol:整体最佳编程 AI 模型
GPT-6.2 Sol 解决了我们全部九次运行,每次运行约 24 秒。在 Web 应用任务中,它的三次回复每次打开都是可用的费用分摊器,并且无需编辑通过全部 10 项浏览器检查。
在 GPT-6.2 Sol playground 中亲自尝试编程任务。
它为何突出: 四款模型解决了全部九次运行。在这四款中,只有 Astra 一样快,但每次成功运行成本是它的 2.8 倍;只有 DeepSeek V4.1 Flash 每次成功运行成本更低,但等待时间约为六倍。
Sol 的 Coding Agent Index 为 50,低于领先者,细节很重要。它与指数领先者差距最大的是技术问答集,这是该指数的三个部分之一。在软件工程集上,Sol 在最大努力下得 41.5,Astra 为 41.7。
最适合: 第一次回答就必须正确的日常工作。在我们的运行中,它根据书面规格构建了一个截止时间计算器,并跨三个 TypeScript 文件修复了四个 bug,每次都在半分钟内完成。高容量 API 工作受益最大,因为每个正确答案的成本保持很低。
定价: 按 token 付费,无订阅。新账户在绑定支付方式后可获得少量试用额度。常见问题中列出了每 token 费率。
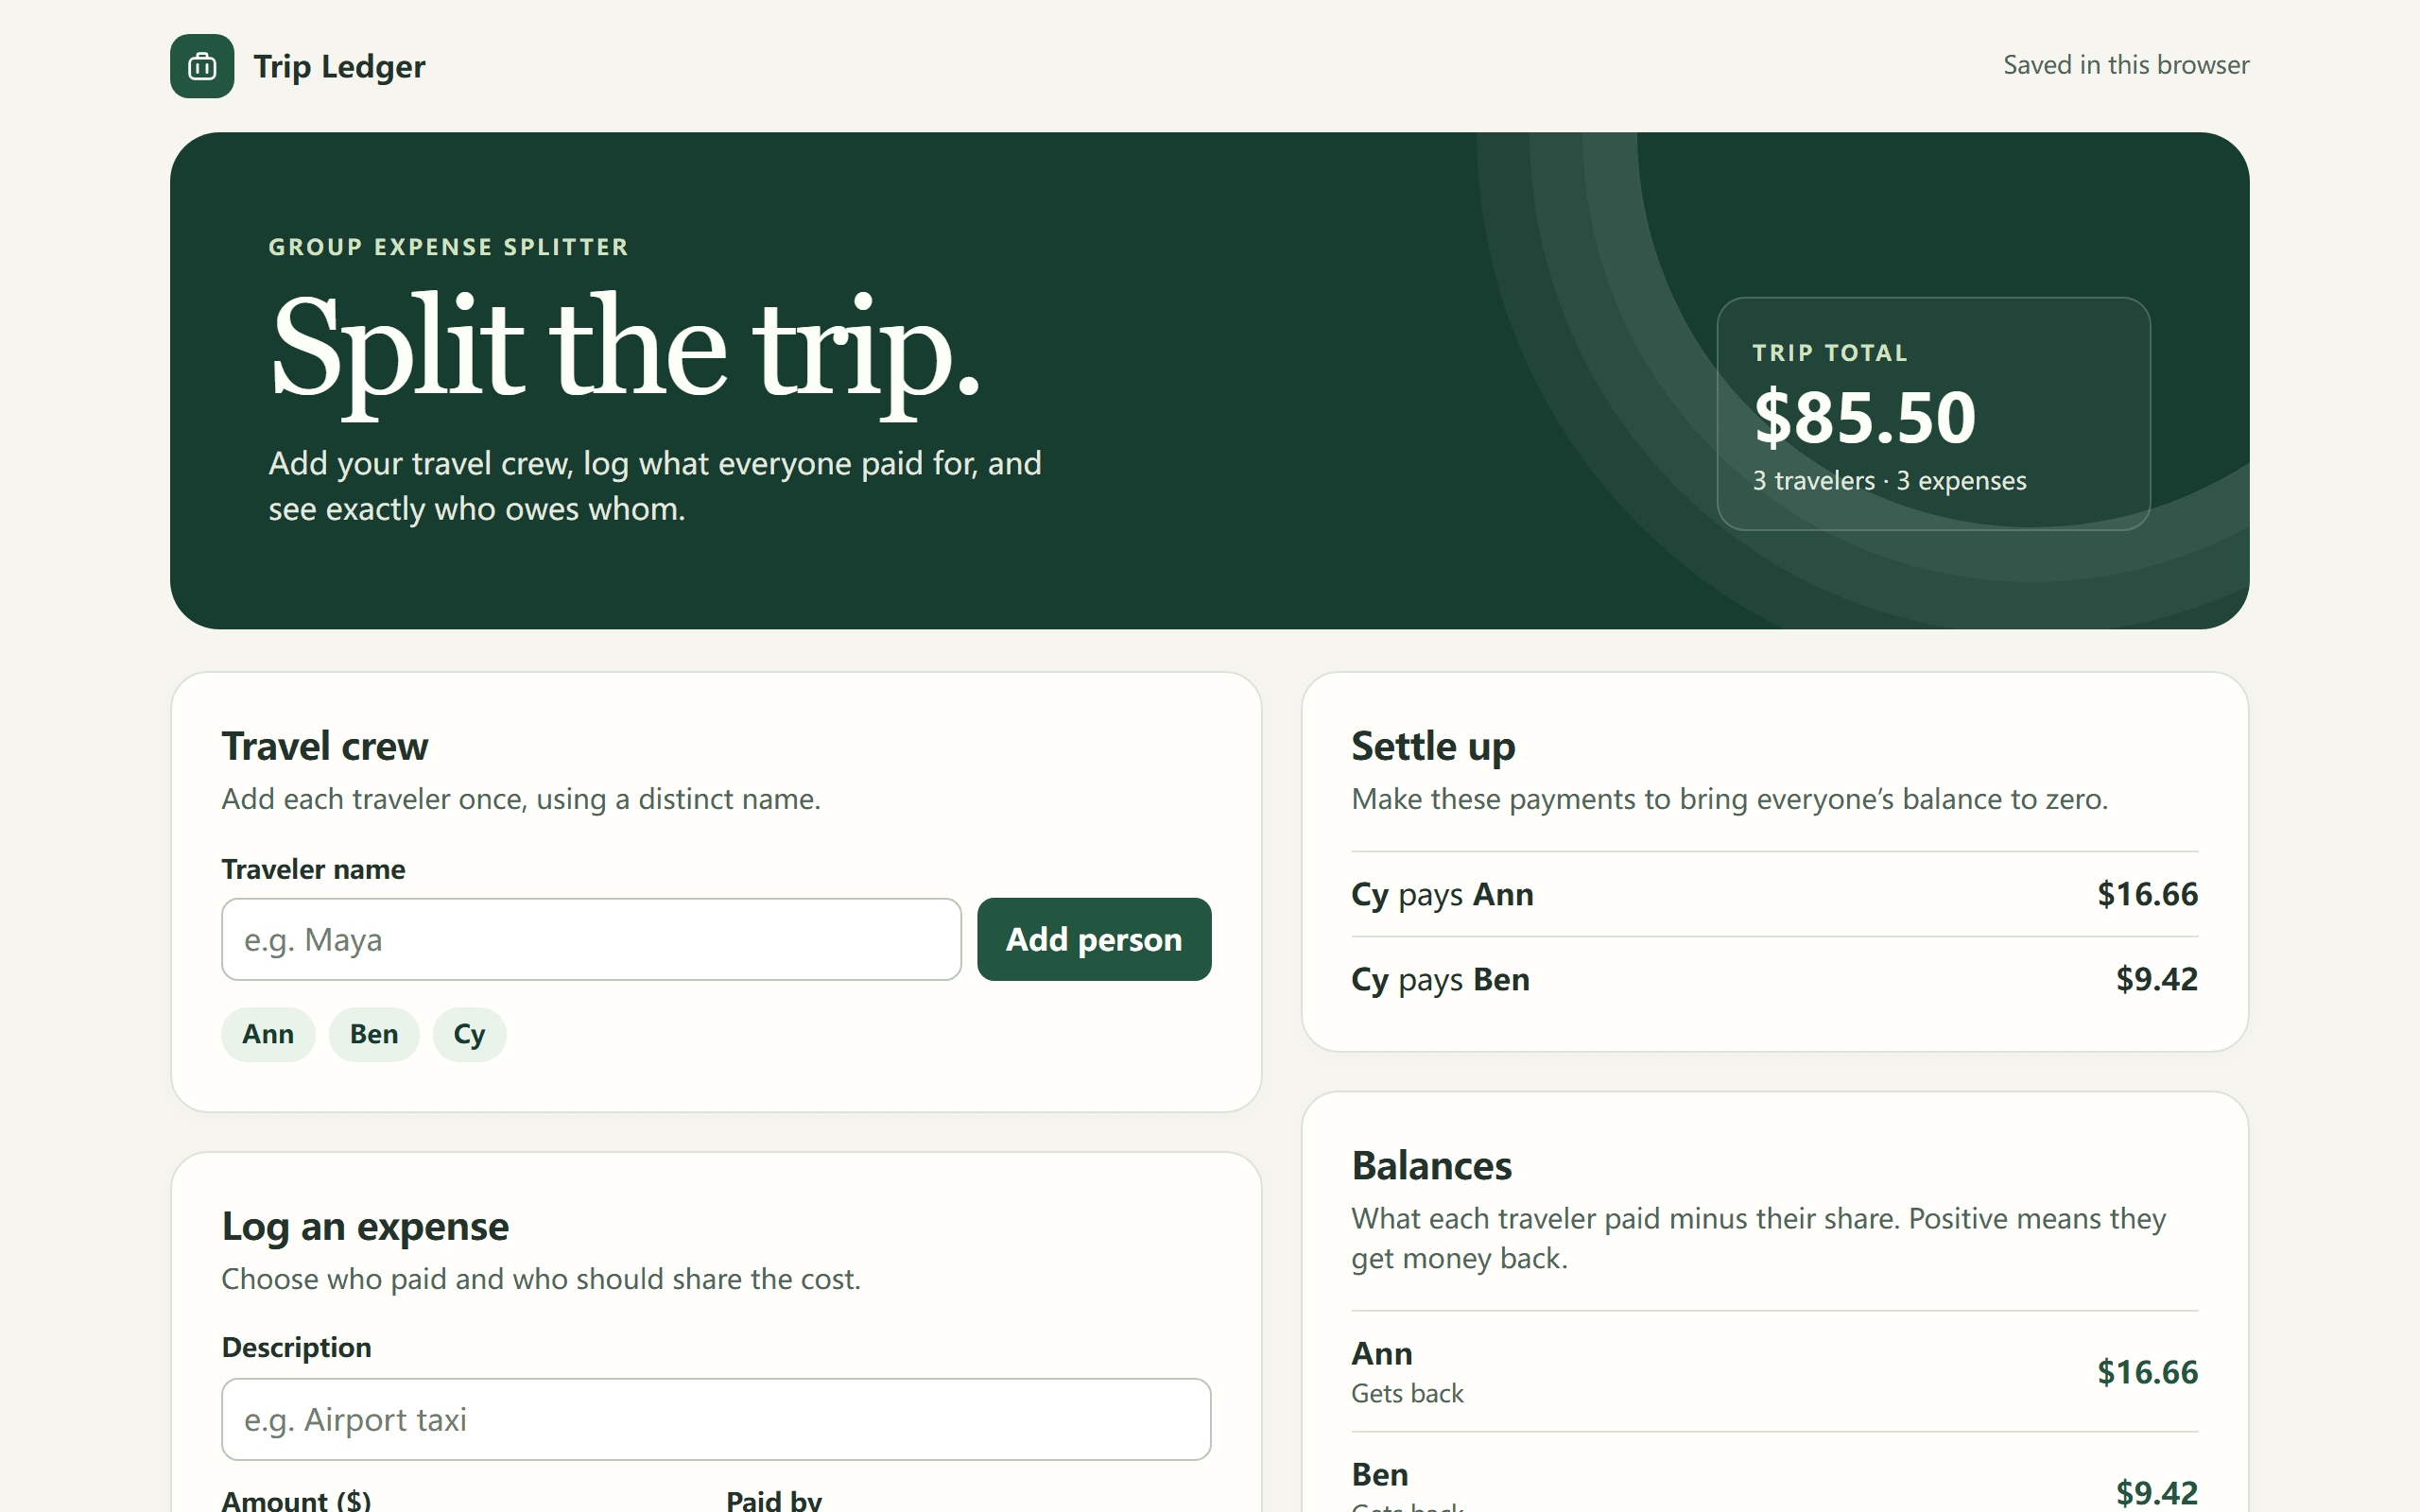
GPT-6.2 Sol 在我们 Web 应用任务中的输出,2026 年 11 月 20 日在 Atlas Cloud 上运行。该回复通过了全部 10 项自动化浏览器检查。
在 Atlas Cloud 上运行你自己的编程测试
两种方式都以默认设置调用模型,与我们的测试一样。
方法 1:playground。 登录,打开 GPT-6.2 Sol playground,然后按两步操作。
- 将你的任务提示词粘贴到消息框。
- 点击紫色发送箭头。回复会流式显示在消息框上方的面板中。
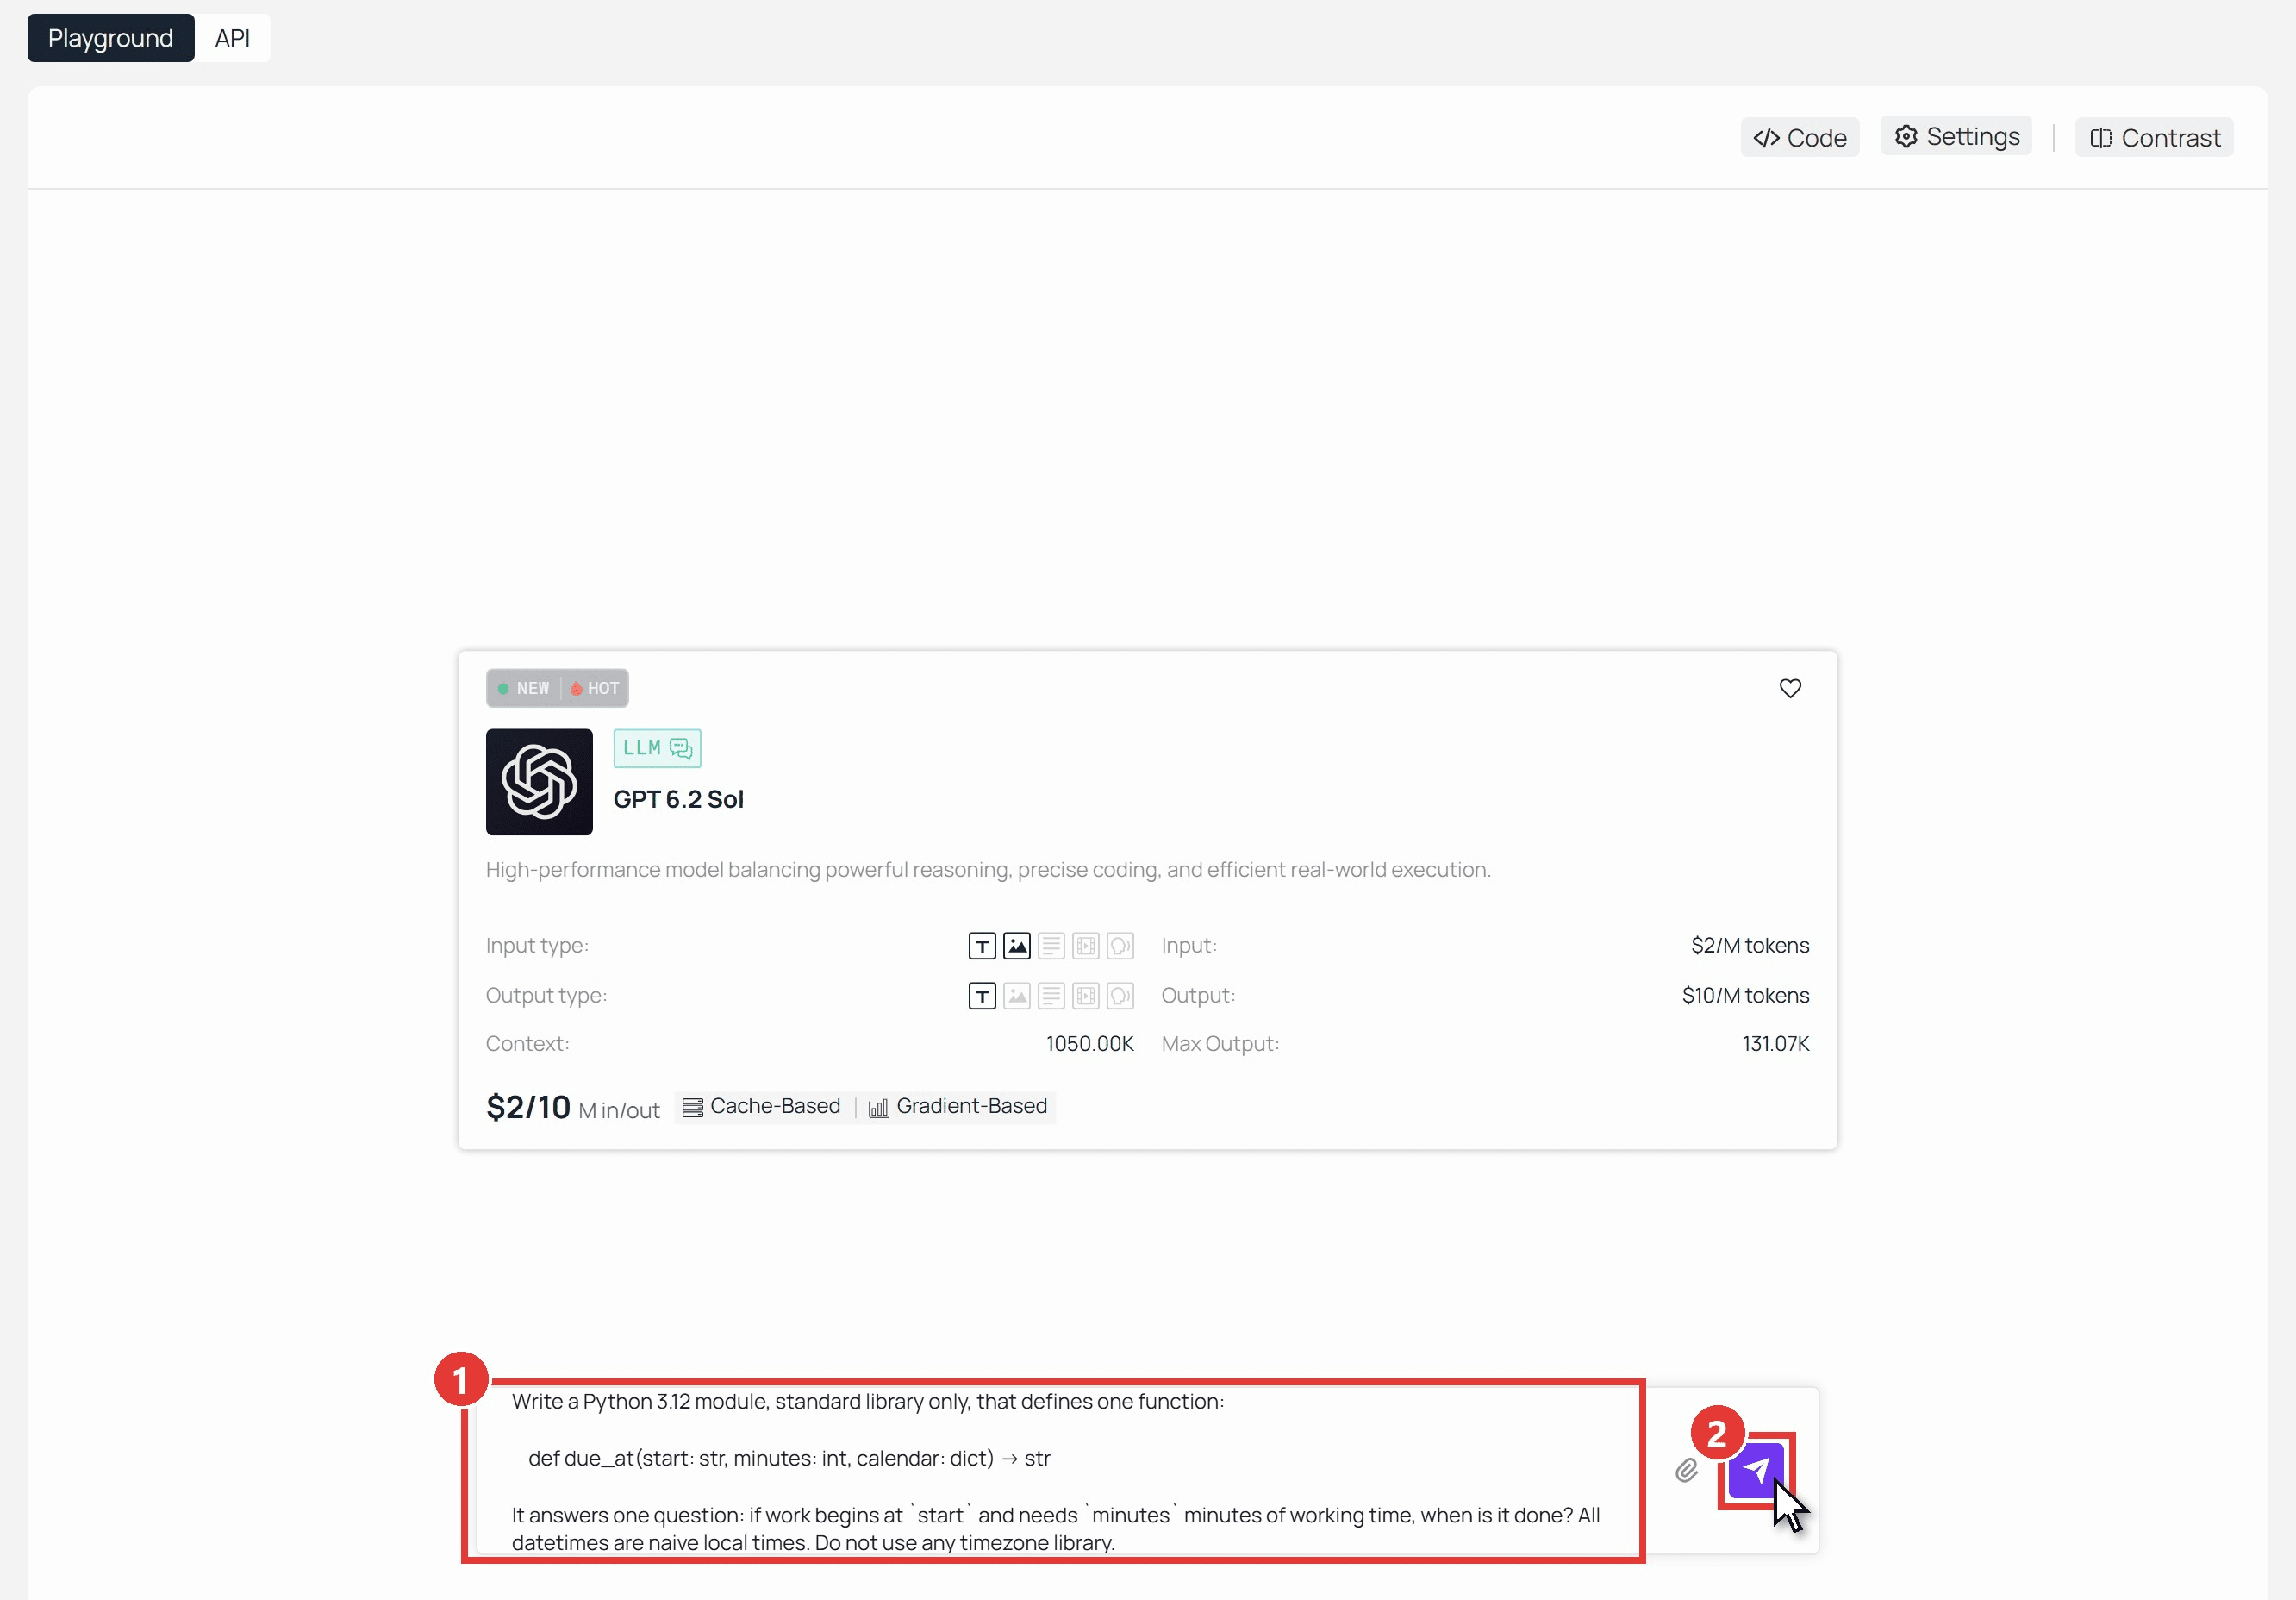
从回复中复制代码块,保存并对其运行你自己的测试。
方法 2:API。 使用此方式可多次重复测试或编写脚本。
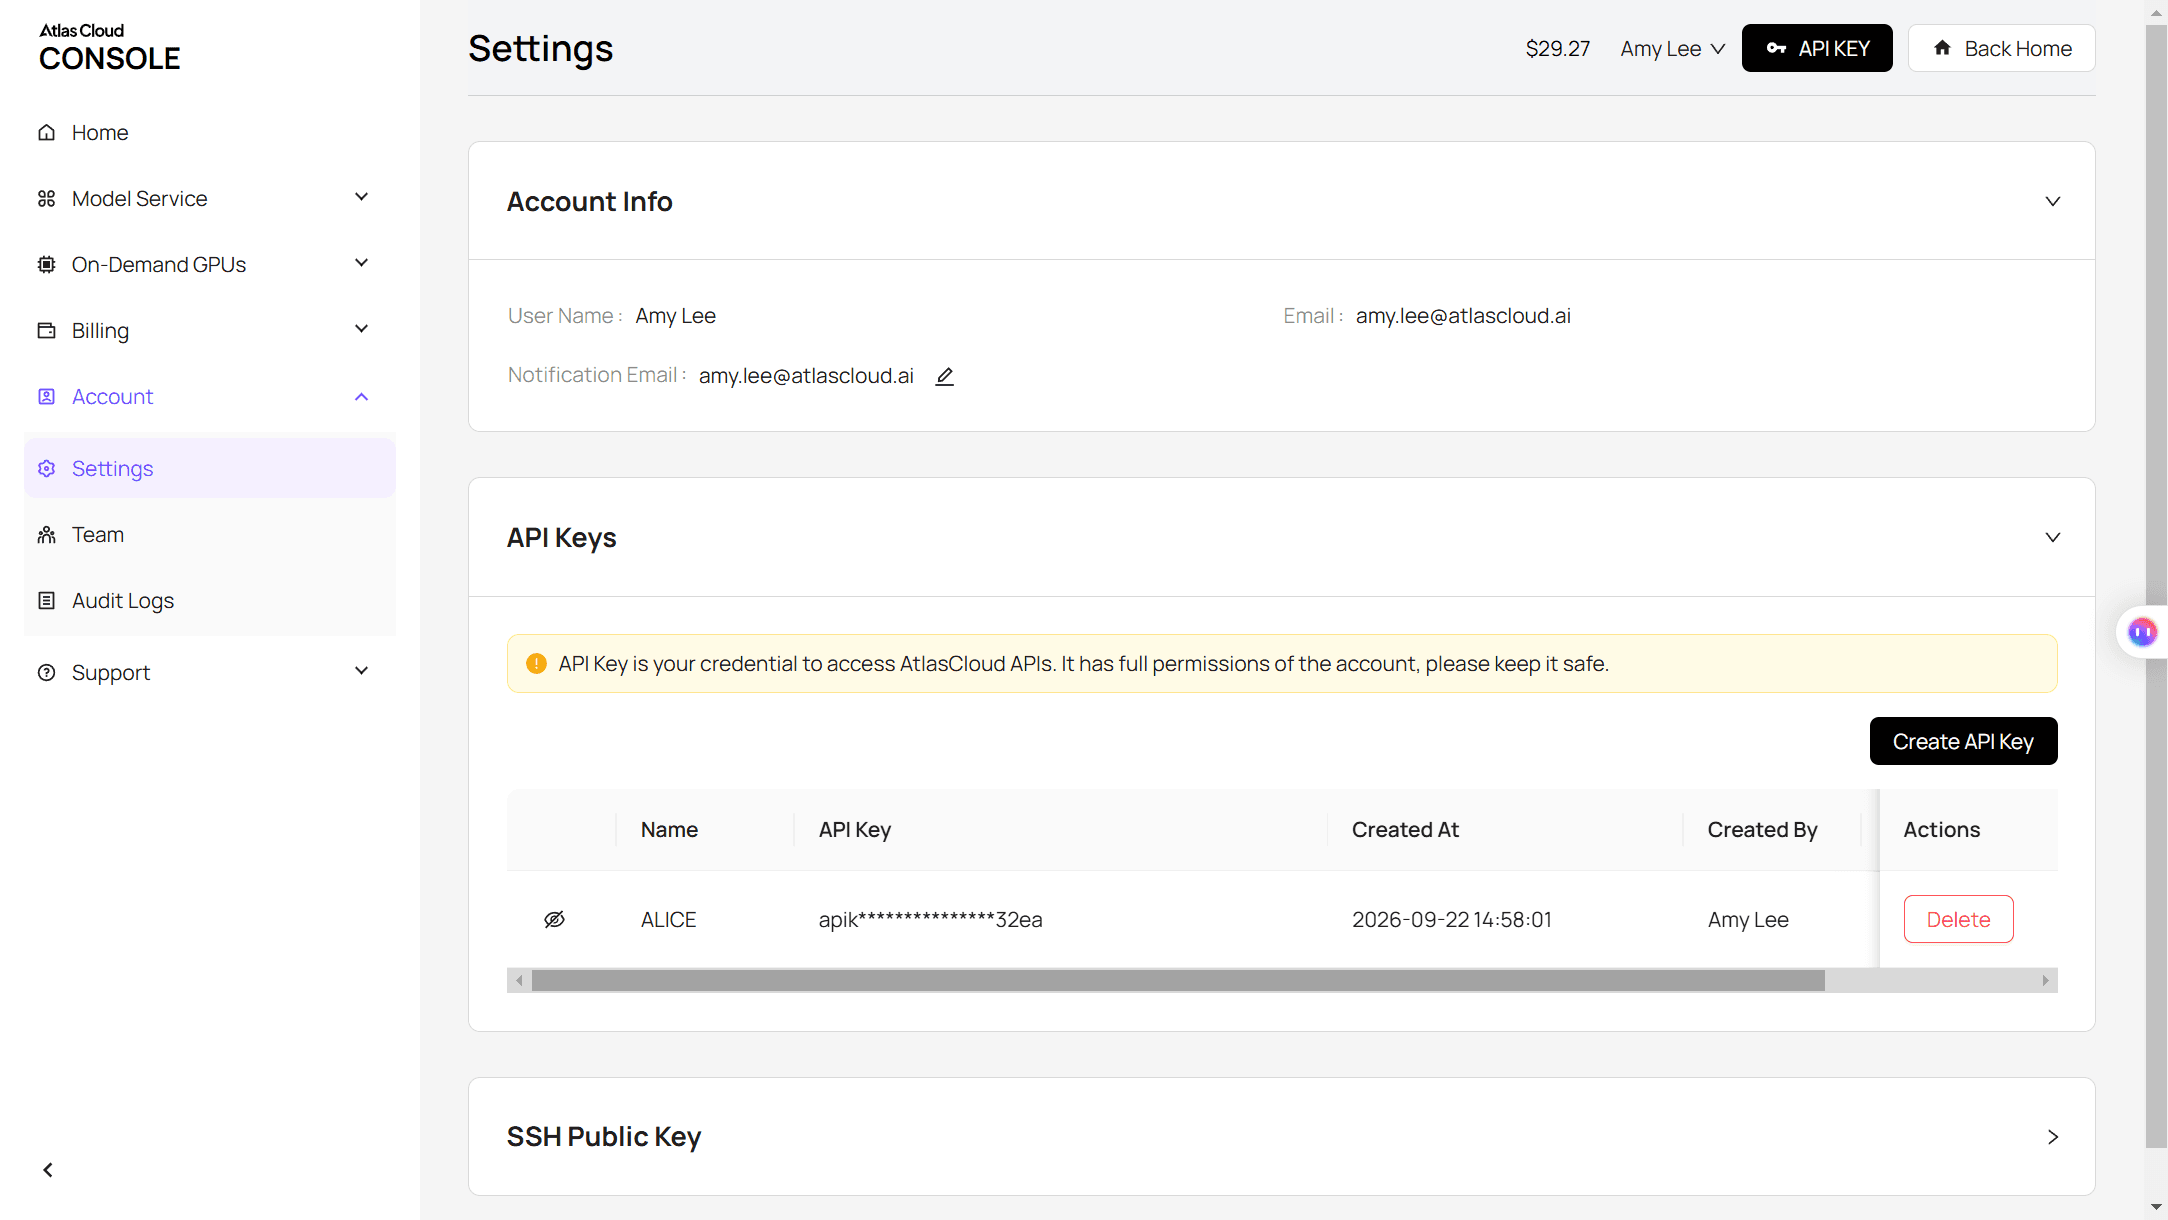
步骤 1:创建 API key。 在控制台中,打开 Settings,进入 API Keys,点击 Create API Key。一个 key 覆盖平台上的每款模型。
步骤 2:检查请求格式。 Atlas Cloud API 文档列出了支持的 LLM 请求格式。GPT-6.2 Sol 使用下面显示的 OpenAI Responses 格式。
步骤 3:发送请求。 将你自己的任务放入 input 字段。
plaintext1curl -s -X POST "https://api.atlascloud.ai/v1/responses" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "openai/gpt-6.2-sol", 6 "input": "Write a Python 3.12 module, standard library only, that defines due_at(start, minutes, calendar) and returns when the work is done. Reply with one fenced python code block.", 7 "max_output_tokens": 64000 8 }'
回复文本位于 output 数组中,usage 块统计 input、output 和 reasoning token。将模型字符串改为 openai/gpt-6.2-astra,同一请求就会在 Astra 上运行,使用相同端点和相同 key。
2. Claude Fable 5.2:长时困难任务的最佳编程 AI
Anthropic 于 2026 年 11 月 9 日发布 Claude Fable 5.2,并报告在 FrontierCode 2.0 的 Xhigh 设置下达到 49.1%,称这是其测试过的所有已发布模型中的最高分。我们没有亲自运行 Fable 5.2。本节每个数字都来自公开基准或 Anthropic 自己的页面。
免费访问止于何处: 在 Anthropic 的定价页面上,2026 年 11 月 20 日查看,Pro 计划将 Fable 5.2 计入使用额度,Max 则包含它,但上限为每周限额的一半。
一次成功任务成本: Artificial Analysis 测得 Fable 5.2 在 Claude Code 中每项任务 $15.47。Gemini 4 Neon 在同一指数上为 $6.86,GPT-6.2 Astra 为 $5.12。
公开基准怎么说: 四舍五入前 Coding Agent Index 为 58.5,Gemini 4 Neon 为 58.6,覆盖 322 项任务,每项尝试三次。在 Terminal-Bench 4.1 上,Claude Code 搭配 Fable 5.2 得分 65.8%。
在编程方面不足在哪: 时间。在该指数中,Fable 5.2 的一项任务平均耗时 53.3 分钟,Astra 为 25.1 分钟。
适合: 数小时的重构和大型代码库,其中一次失败尝试的成本高于 token。 不适合你,如果: 你按 token 为常规修复付费。
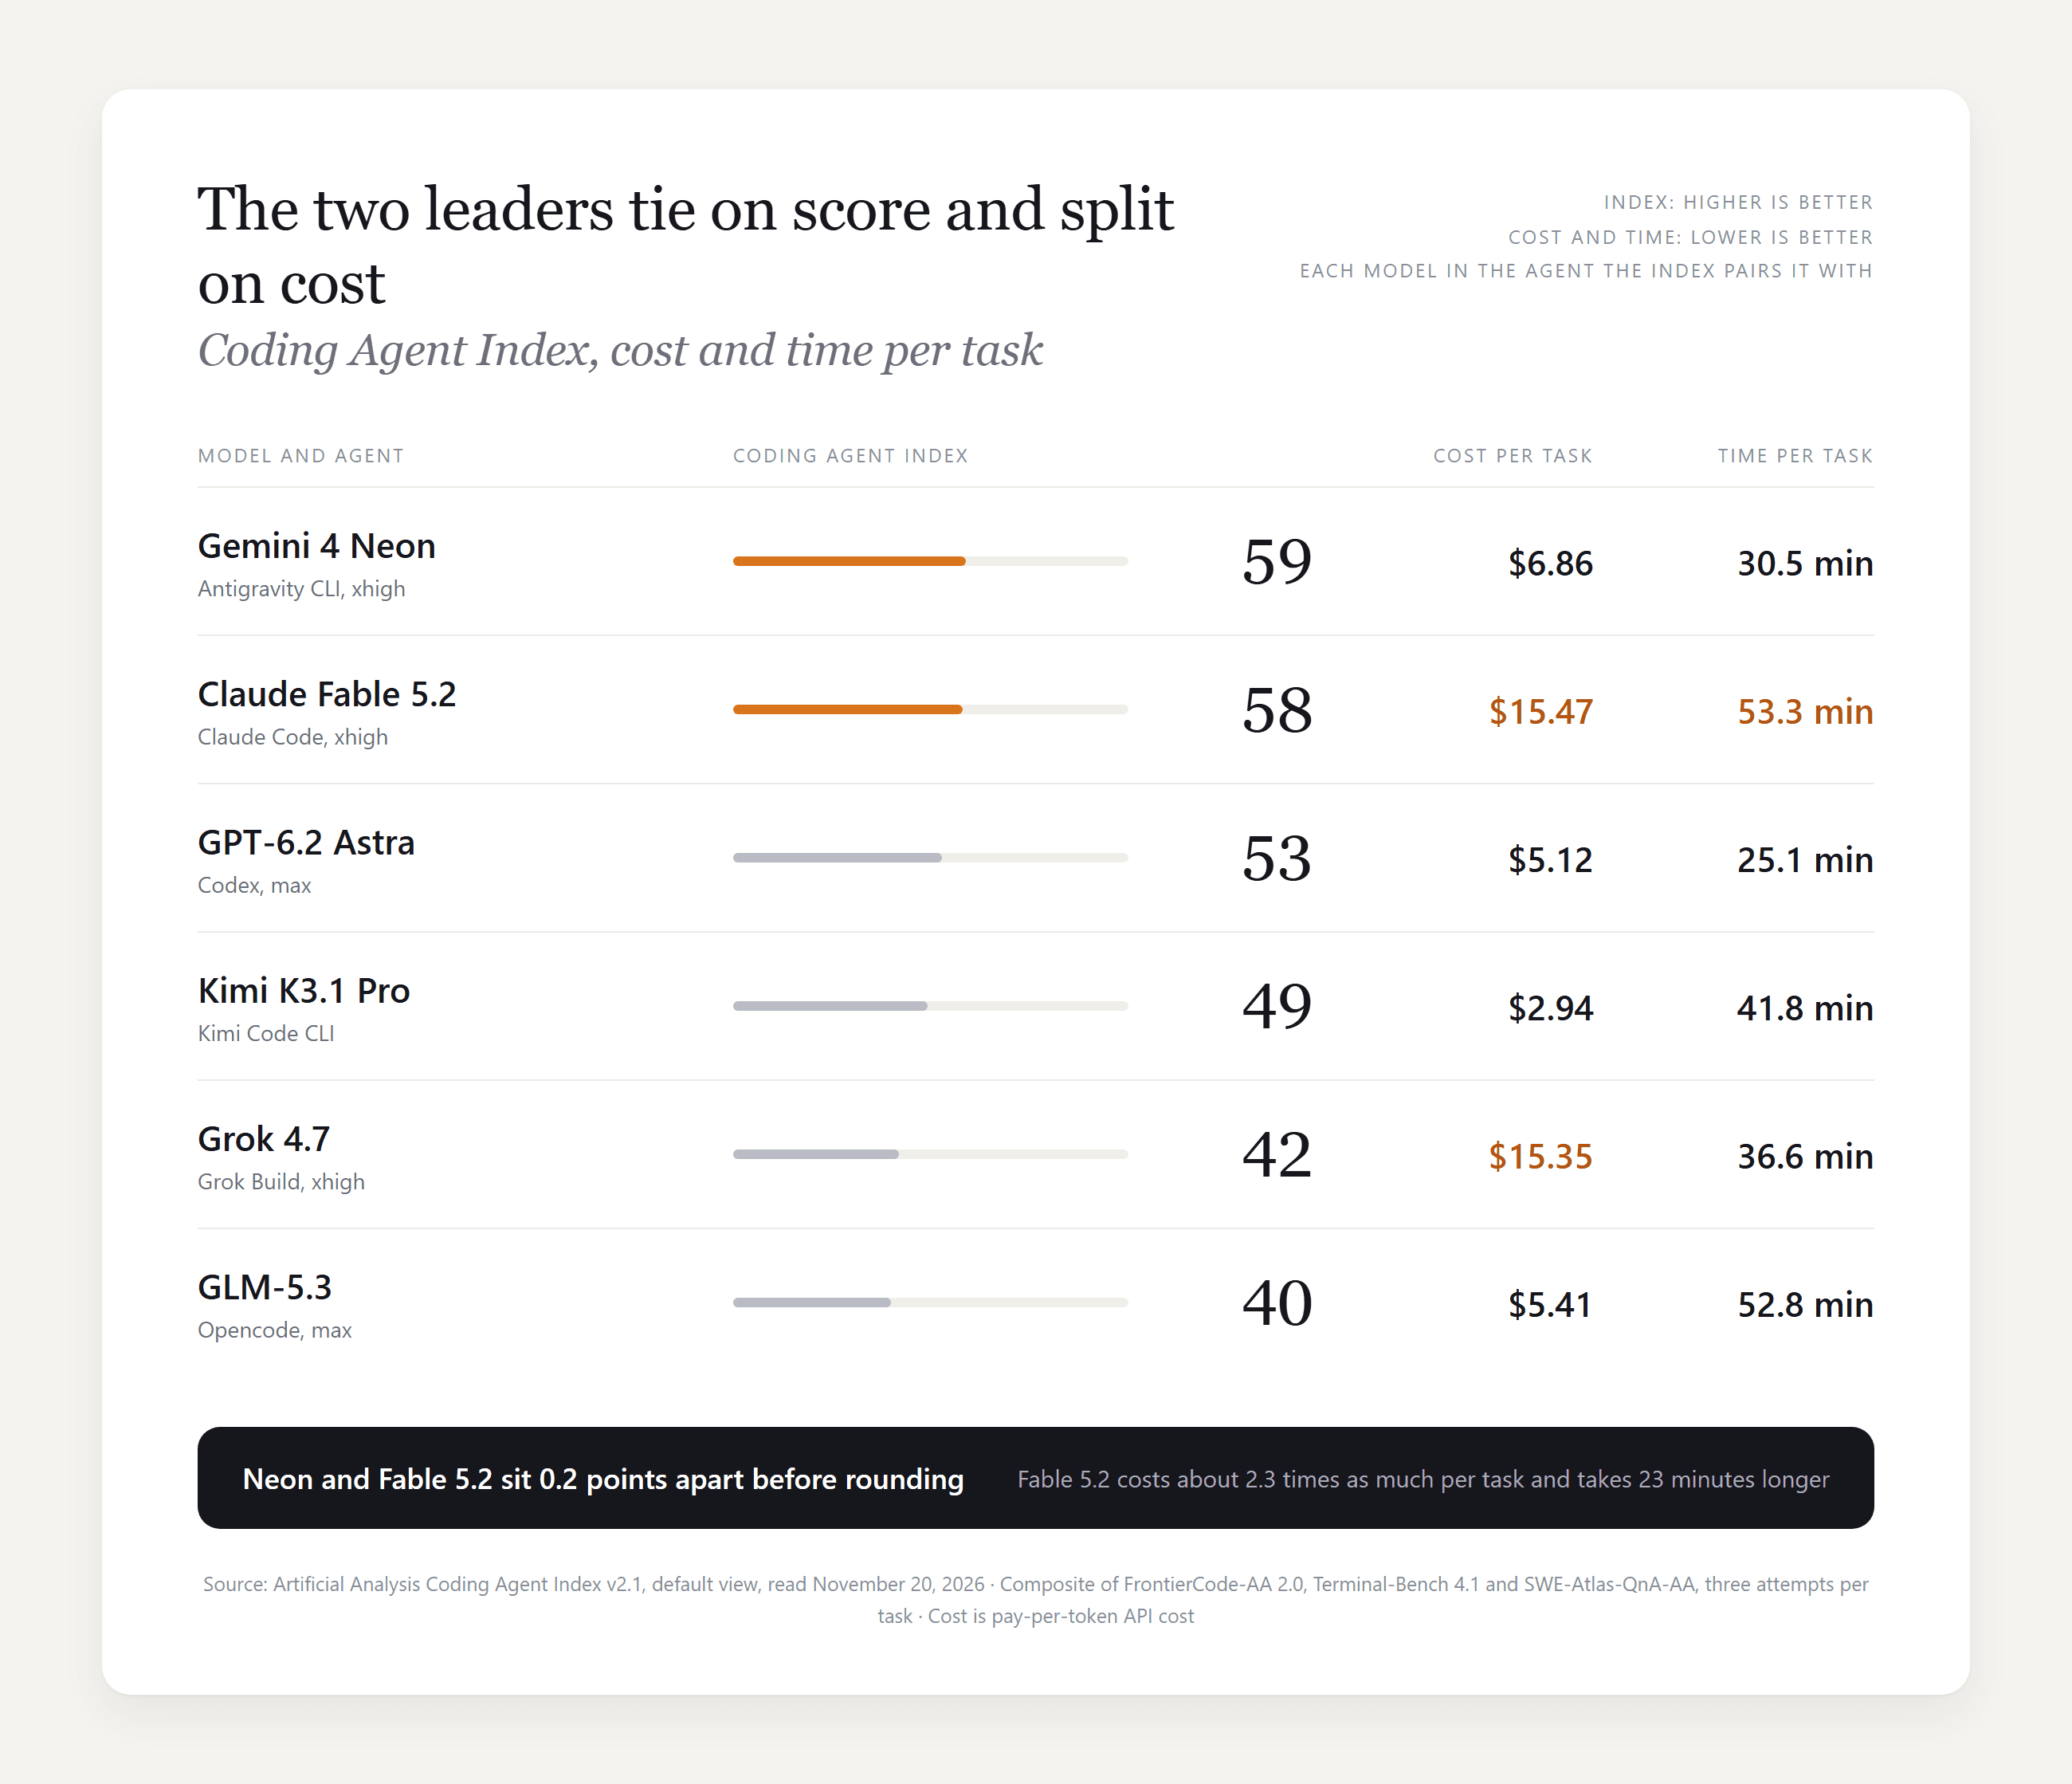
图表由 Atlas Cloud 根据 Artificial Analysis 数据制作,读取于 2026 年 11 月 20 日。
3. Gemini 4 Neon:最佳编程代理 AI 模型
Google 于 2026 年 11 月 18 日推出 Gemini 4 Neon,它在 Artificial Analysis Coding Agent Index 上以 59 位居榜首,运行在 Google 的 Antigravity CLI 中。我们没有亲自运行 Neon,因此本节依赖公开数据。
免费访问止于何处: Google 的定价页面称 Gemini 4 Neon 不在 Gemini API 的免费层中提供。在 Antigravity 和 Gemini 应用中,它随付费 Pro 和 Ultra 计划提供。
一次成功任务成本: LiveBench 2.0 显示 Neon 每项成功任务 $2.65,Fable 5.2 为 $9.85。API 标价为每百万输入 token $3、每百万输出 token $15。
公开基准怎么说: Neon 在 LiveBench 2.0 总体以 87.4 领先,并在其长时间运行代理套件上得分 82.6,落后 Fable 5.2 0.3。Google 报告在 Terminal-Bench 4.1 上为 65.2%。
在编程方面不足在哪: 该记录才发布两天,2026 年 11 月 20 日我们查看时 Terminal-Bench 排行榜尚未列出 Neon。它的头条分数也来自 Google 自家代理内部,下文 harness 部分会回到这一点。
适合: 由一个模型连续半小时规划、编辑和运行命令的代理工作流。 不适合你,如果 : 你需要免费层。
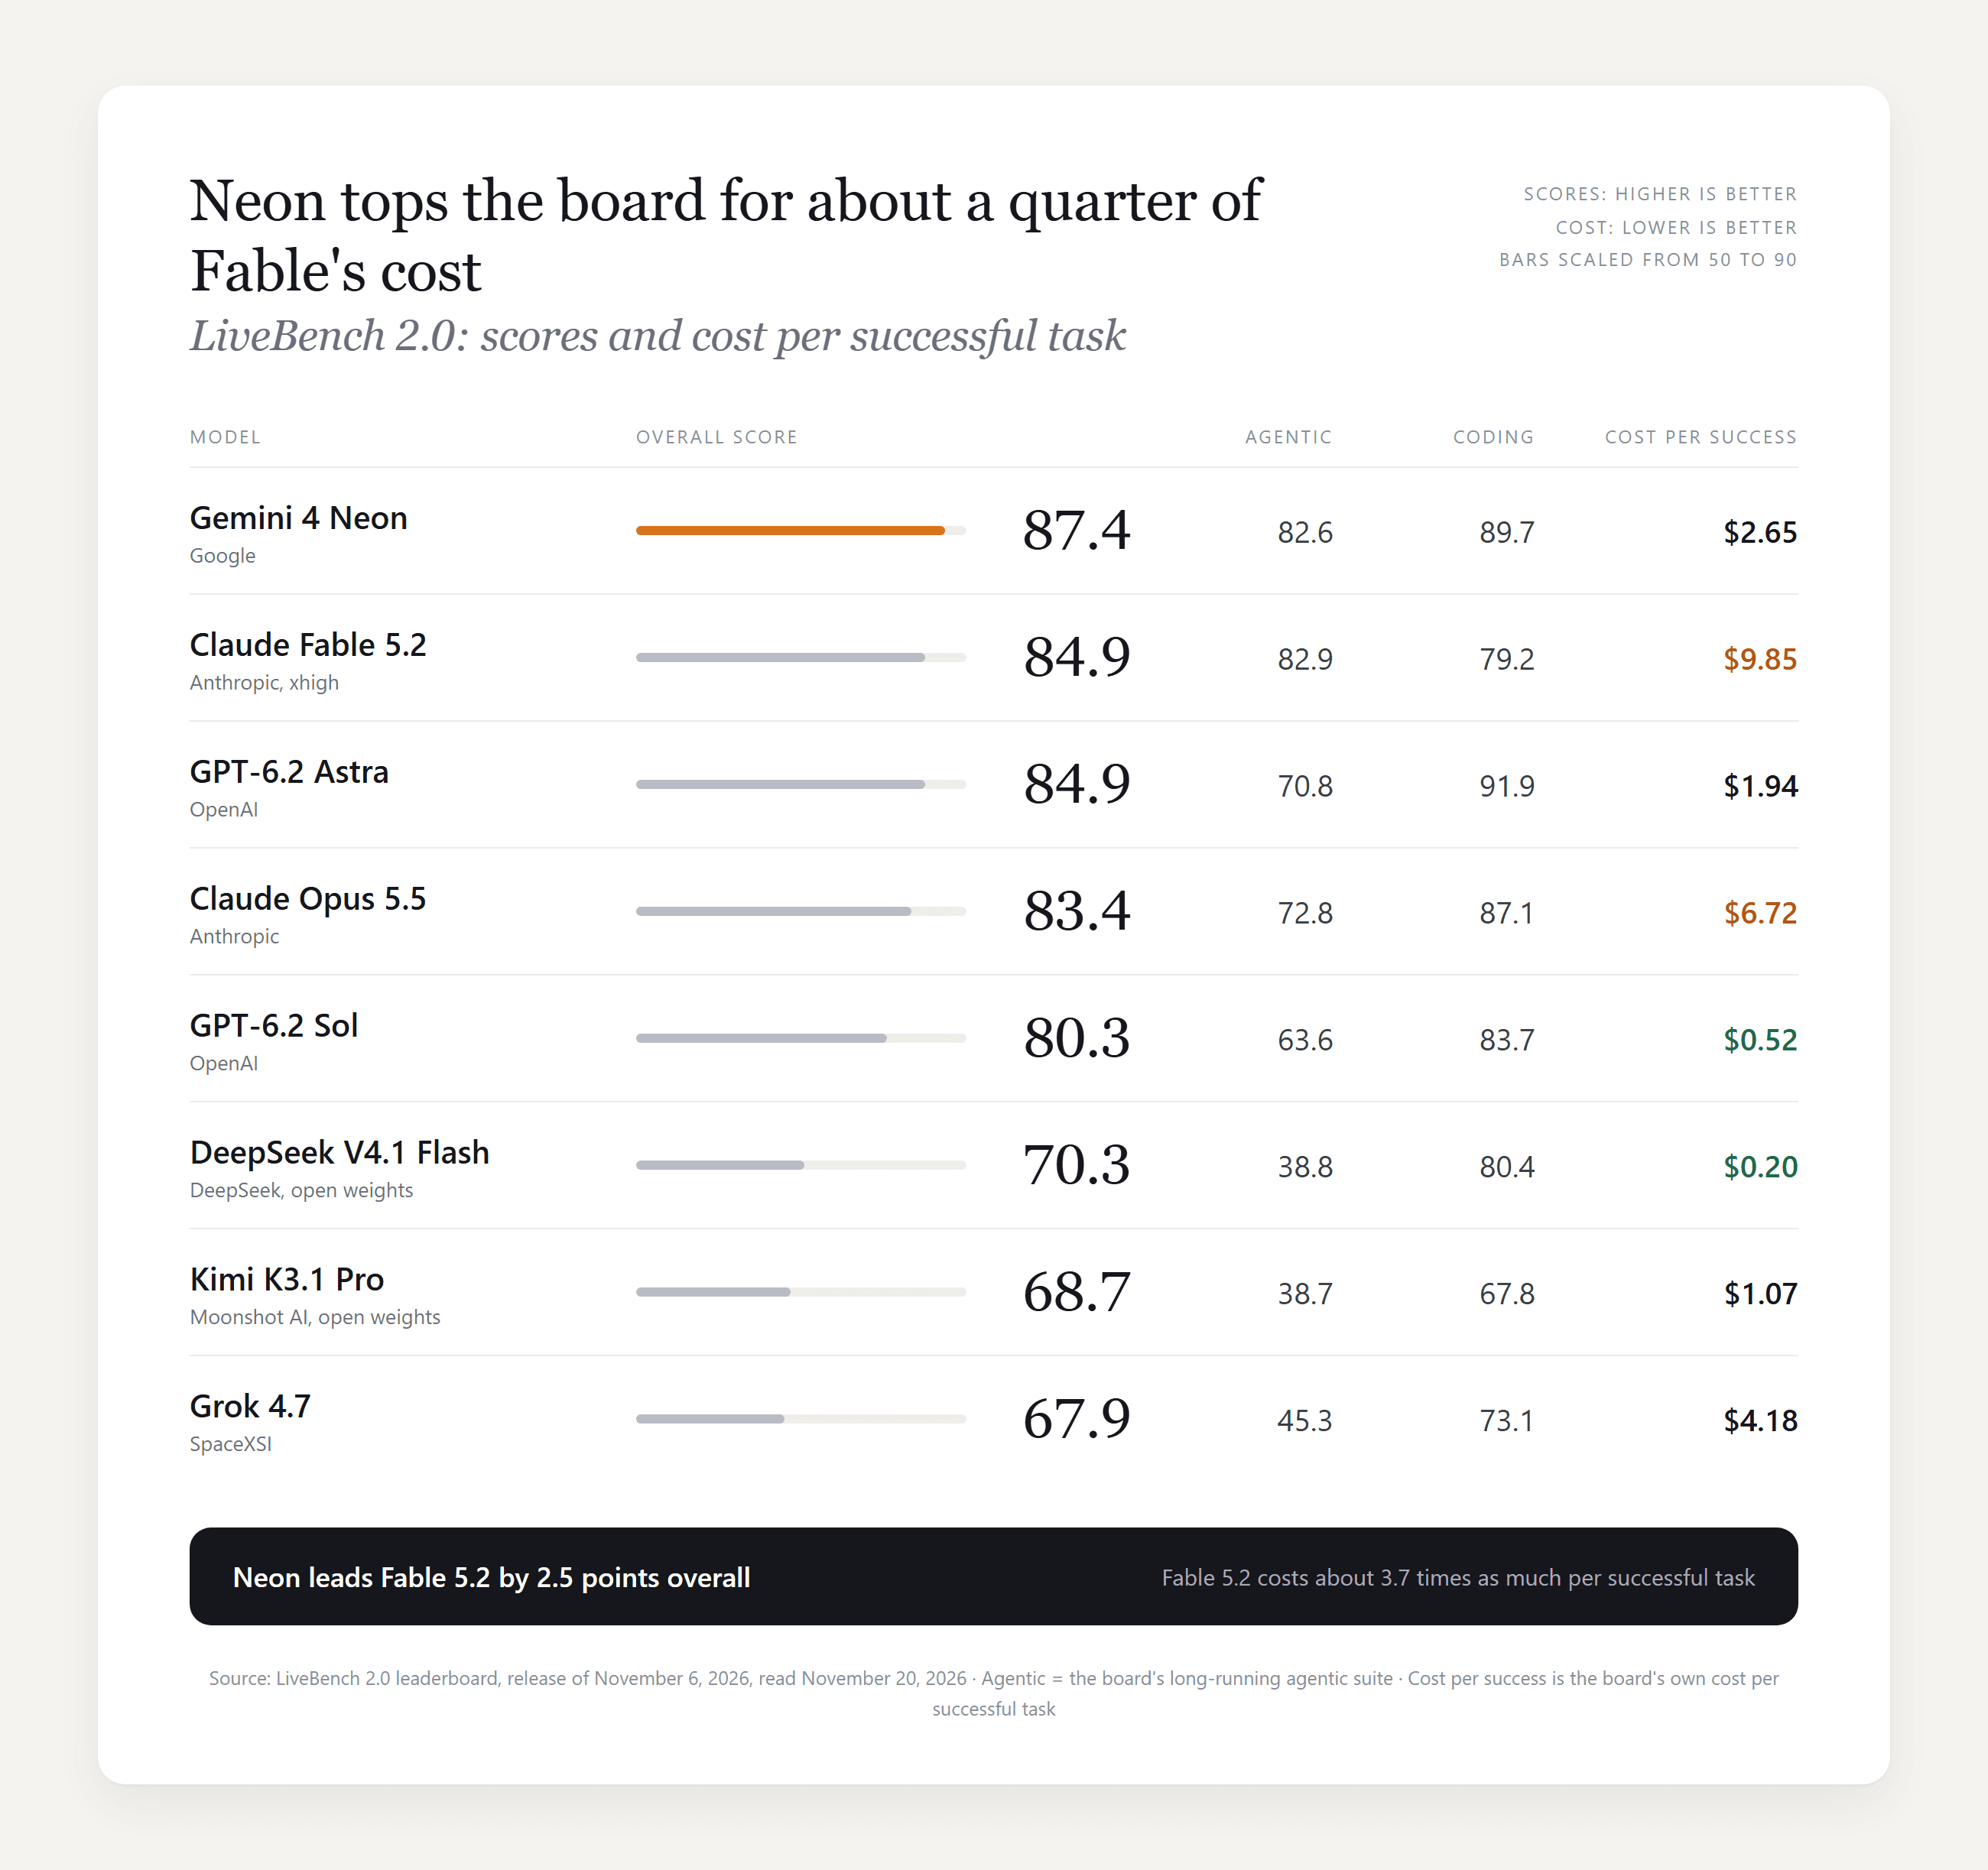
图表由 Atlas Cloud 根据 LiveBench 2.0 数据制作,读取于 2026 年 11 月 20 日。
4. GPT-6.2 Astra:最佳代码审查 AI 模型
GPT-6.2 Astra 是 OpenAI 于 11 月 17 日发布的旗舰模型。它解决了我们全部九次运行,每次 23 秒,与 Sol 结果相同,但每次成功运行成本是 Sol 的 2.8 倍。
免费访问止于何处: OpenAI 在 ChatGPT Work 和 Codex 中发布 GPT-6.2,而不是普通 Chat。在这两者之外,Astra 是 API 模型。
一次成功任务成本: 在我们的测试中每次成功运行约 11 美分,Sol 为 4 美分。
公开基准怎么说: Astra 的 91.9 是 LiveBench 2.0 编程分数中,本列表九款被该榜列出的模型里最高的。代码审查是它拉开与 Sol 差距的地方。在我们 GPT-6.2 评测 中提及的第三方测试里,Astra 在 xhigh 努力下捕获了 96% 的问题,Sol 为 84%。
在编程方面不足在哪: 在我们的三项任务中,更高价格没有换来额外成功运行。
适合: 对变更进行第二轮审查,其中漏掉 bug 代价高昂。 不适合你,如果: 你的工作是常规修复,Sol 以更低价格返回相同结果。
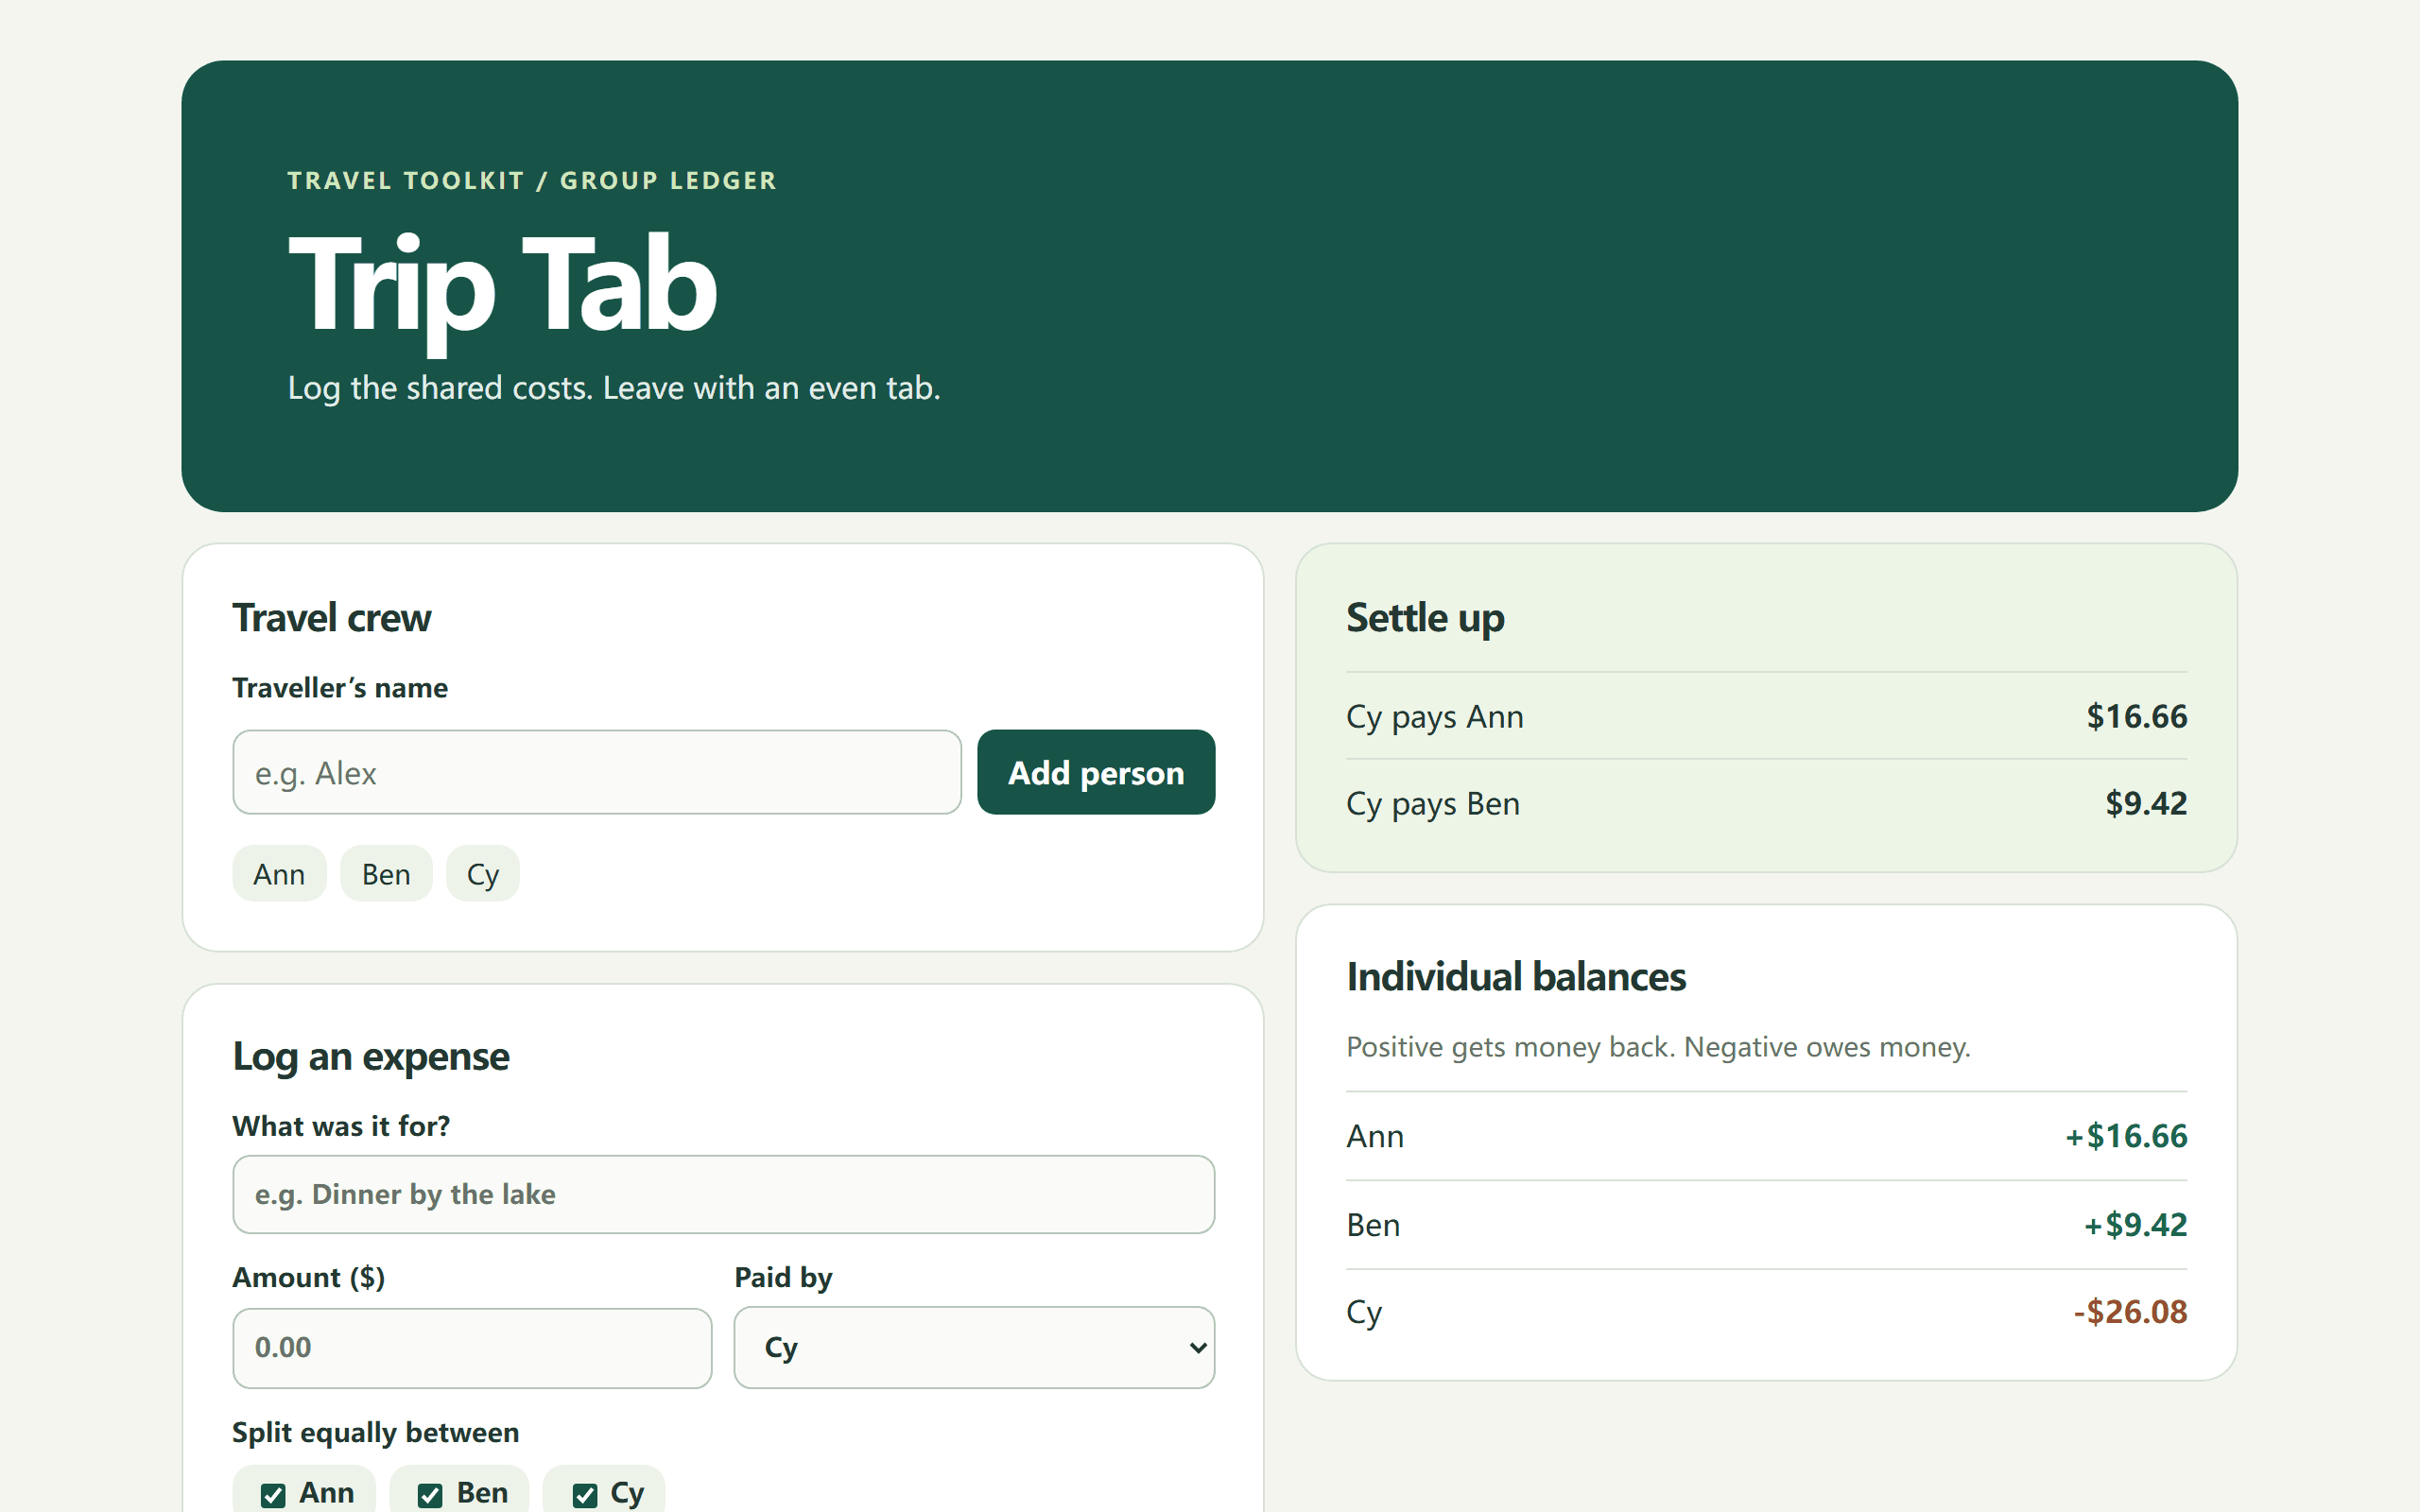
GPT-6.2 Astra 在我们 Web 应用任务中的输出,2026 年 11 月 20 日在 Atlas Cloud 上运行。该回复通过了全部 10 项自动化浏览器检查。
5. DeepSeek V4.1 Flash:最佳免费编程 AI
DeepSeek V4.1 Flash 在 DeepSeek 自家应用中运行,DeepSeek 称其免费使用,其权重以 MIT 许可发布。通过 API,它解决了我们全部九次运行,在我们运行的七款模型中每次成功运行成本最低。
免费访问止于何处: DeepSeek 的应用发布文章称该应用免费使用,无广告或应用内购买,其 2026 年 10 月 17 日更新日志称 Web 和应用模型已迁移到 V4.1 Flash 1017 更新。API 使用按 token 付费。
一次成功任务成本: 在我们的测试中每次成功运行约 3 美分。LiveBench 2.0 显示每次成功任务 20 美分。
公开基准怎么说: LiveBench 2.0 编程 80.4,落后 Sol 约三分。代理工作较弱:在 Claude Code 的 Terminal-Bench 4.1 上为 38.5%,Coding Agent Index 为 37。
在编程方面不足在哪: 等待时间。一次运行平均耗时 139 秒,Sol 为 24 秒,因为模型在写答案前花了约 21,000 token 推理。给它留出空间。在我们最初的 20,000 token 上限下,九次回复中有八次在答案完成前被截断。
适合: 学生、副项目,以及想要 MIT 许可权重的团队。 不适合你,如果: 你需要几秒内得到答案,或长时间代理会话。
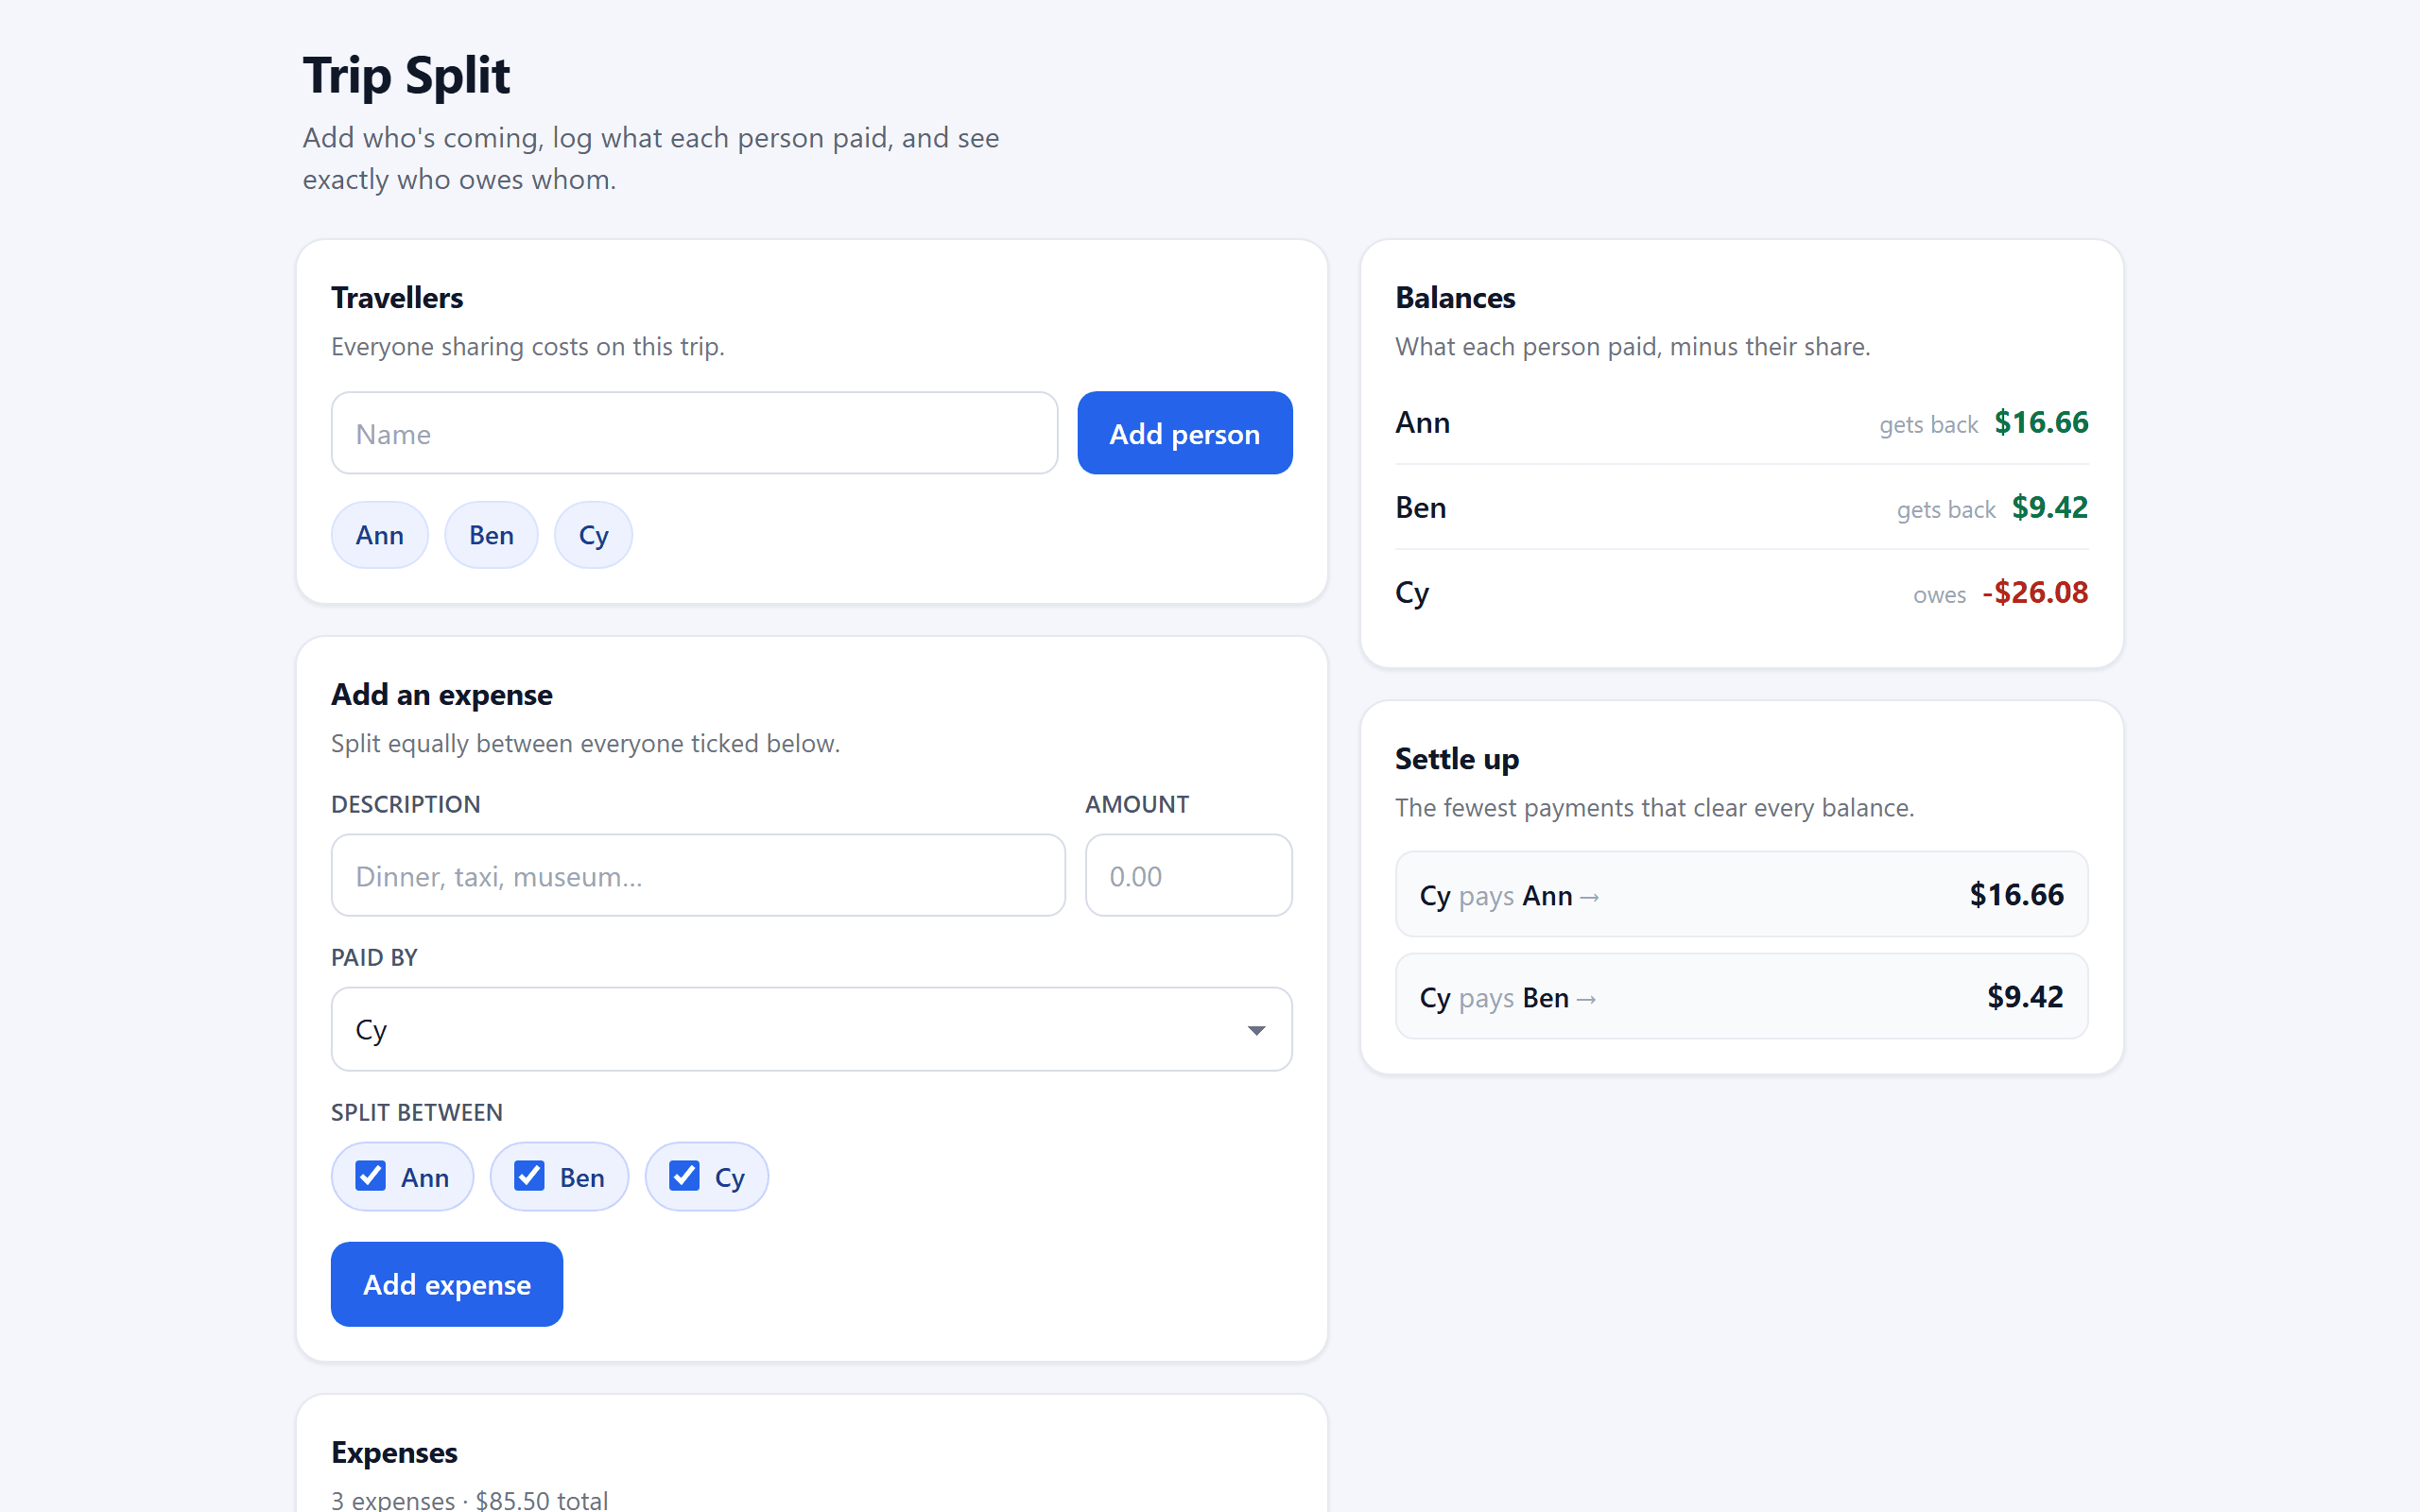
DeepSeek V4.1 Flash 在我们 Web 应用任务中的输出,2026 年 11 月 20 日在 Atlas Cloud 上运行。该回复通过了全部 10 项自动化浏览器检查。
另外五款值得了解的 AI 编程模型
这五款在我们的标准上排名较低:在我们的测试中成功运行更少或等待更长,或者对 Opus 5.5 而言,代理指数略低于 Fable 5.2。当你的限制很具体时,它们仍有一席之地:Claude 预算、开放许可、你自己的 GPU。
| 模型 | 何时选择 | Terminal-Bench 4.1 | LiveBench 2.0 编程 |
|---|---|---|---|
| Claude Opus 5.5 | Fable 5.2 太贵 | 65.8% | 87.1 |
| Kimi K3.1 Pro | 你想要用于代理工作的开放权重 | 59.7% | 67.8 |
| Qwen3.8 27B | 代码必须留在你的机器上 | 未列出 | 69.3 |
| GLM 5.3 | 你在小预算下修复 bug | 41.2% | 未列出 |
| Grok 4.7 | 你想在付费前试用代理 | 38.8% | 73.1 |
6. Claude Opus 5.5
Opus 5.5 是当 Fable 5.2 的价格成为问题时该选的 Claude。它于 2026 年 9 月 22 日发布,标价为 Fable 每 token 费率的一半,并在 Claude Code 的 Terminal-Bench 4.1 上与它持平。我们没有运行它。代价体现在最难的工作上:在 Coding Agent Index 的软件工程集上,Fable 5.2 以 49.2 比 44.0 领先。
7. Kimi K3.1 Pro
Kimi K3.1 Pro 是用于代理工作的开放权重选择。它在 Kimi Code CLI 中的 Coding Agent Index 为 49,是该指数覆盖的本列表中开放权重模型里最高的,并在 Claude Code 的 Terminal-Bench 4.1 上得分 59.7%。权重以 Moonshot AI 自有许可发布。它解决了我们全部九次运行,每次约八分钟。
8. Qwen3.8 27B:最佳本地编程 AI 模型
Qwen3.8 27B 是在你自己硬件上运行的模型。它以 Apache 2.0 发布,拥有 270 亿参数,原生上下文为 262,144 token,官方 FP8 构建为 30.9 GB,因此下载前检查你的内存。通过 API,它解决了我们九次运行中的八次。未成功的是修 bug 运行,在货币转换错误后有三项隐藏测试失败。
我们的 本地 Qwen 编程指南 使用更早的 Qwen 编程模型,介绍了 Ollama 和 Cline 设置。Qwen4-Max 于 2026 年 11 月 16 日发布,目前仅限 API,阿里巴巴表示后续会推出更小的开放权重 Qwen4 模型。
9. GLM 5.3
GLM 5.3 靠一项工作赢得位置。在我们的修 bug 任务中,它解决了全部三次运行,每次约 24 秒,速度与 Sol 相当,每次成功运行约 2.5 美分。其他任务更糟。一次规格回复花掉了全部 64,000 token 预算用于推理,其三个 Web 应用中有两个各漏掉一项浏览器检查。因此总共九次中解决六次。权重以自定义许可开放。
10. Grok 4.7
Grok 4.7 思考最久。它的三个 Web 应用全部通过每项浏览器检查,但有两个使用超过 64,000 输出 token,超出我们的上限,所以只算一个。一次规格回复描述了模块但没有包含代码。
这让九次运行中解决六次,每次约八分钟,并且是七款中每次成功运行成本最高的。Grok 4.7 发布页面邀请用户在 Grok Build 中免费试用该模型,这是一种低成本方式,看看它的长时间推理是否适合你的工作。
哪个 AI 代理最适合编程?Harness 会改变分数
代理排行榜对配对排名:模型加上包裹它的代理。Google 自己的发布数字显示了包裹层有多重要。在 Gemini 4 Neon 公告 中,该模型在极简 mini-SWE harness 中解决了 SWE-sweep 基准的 12.8%,在 Google Antigravity 内为 39.0%。同一模型,分数三倍。
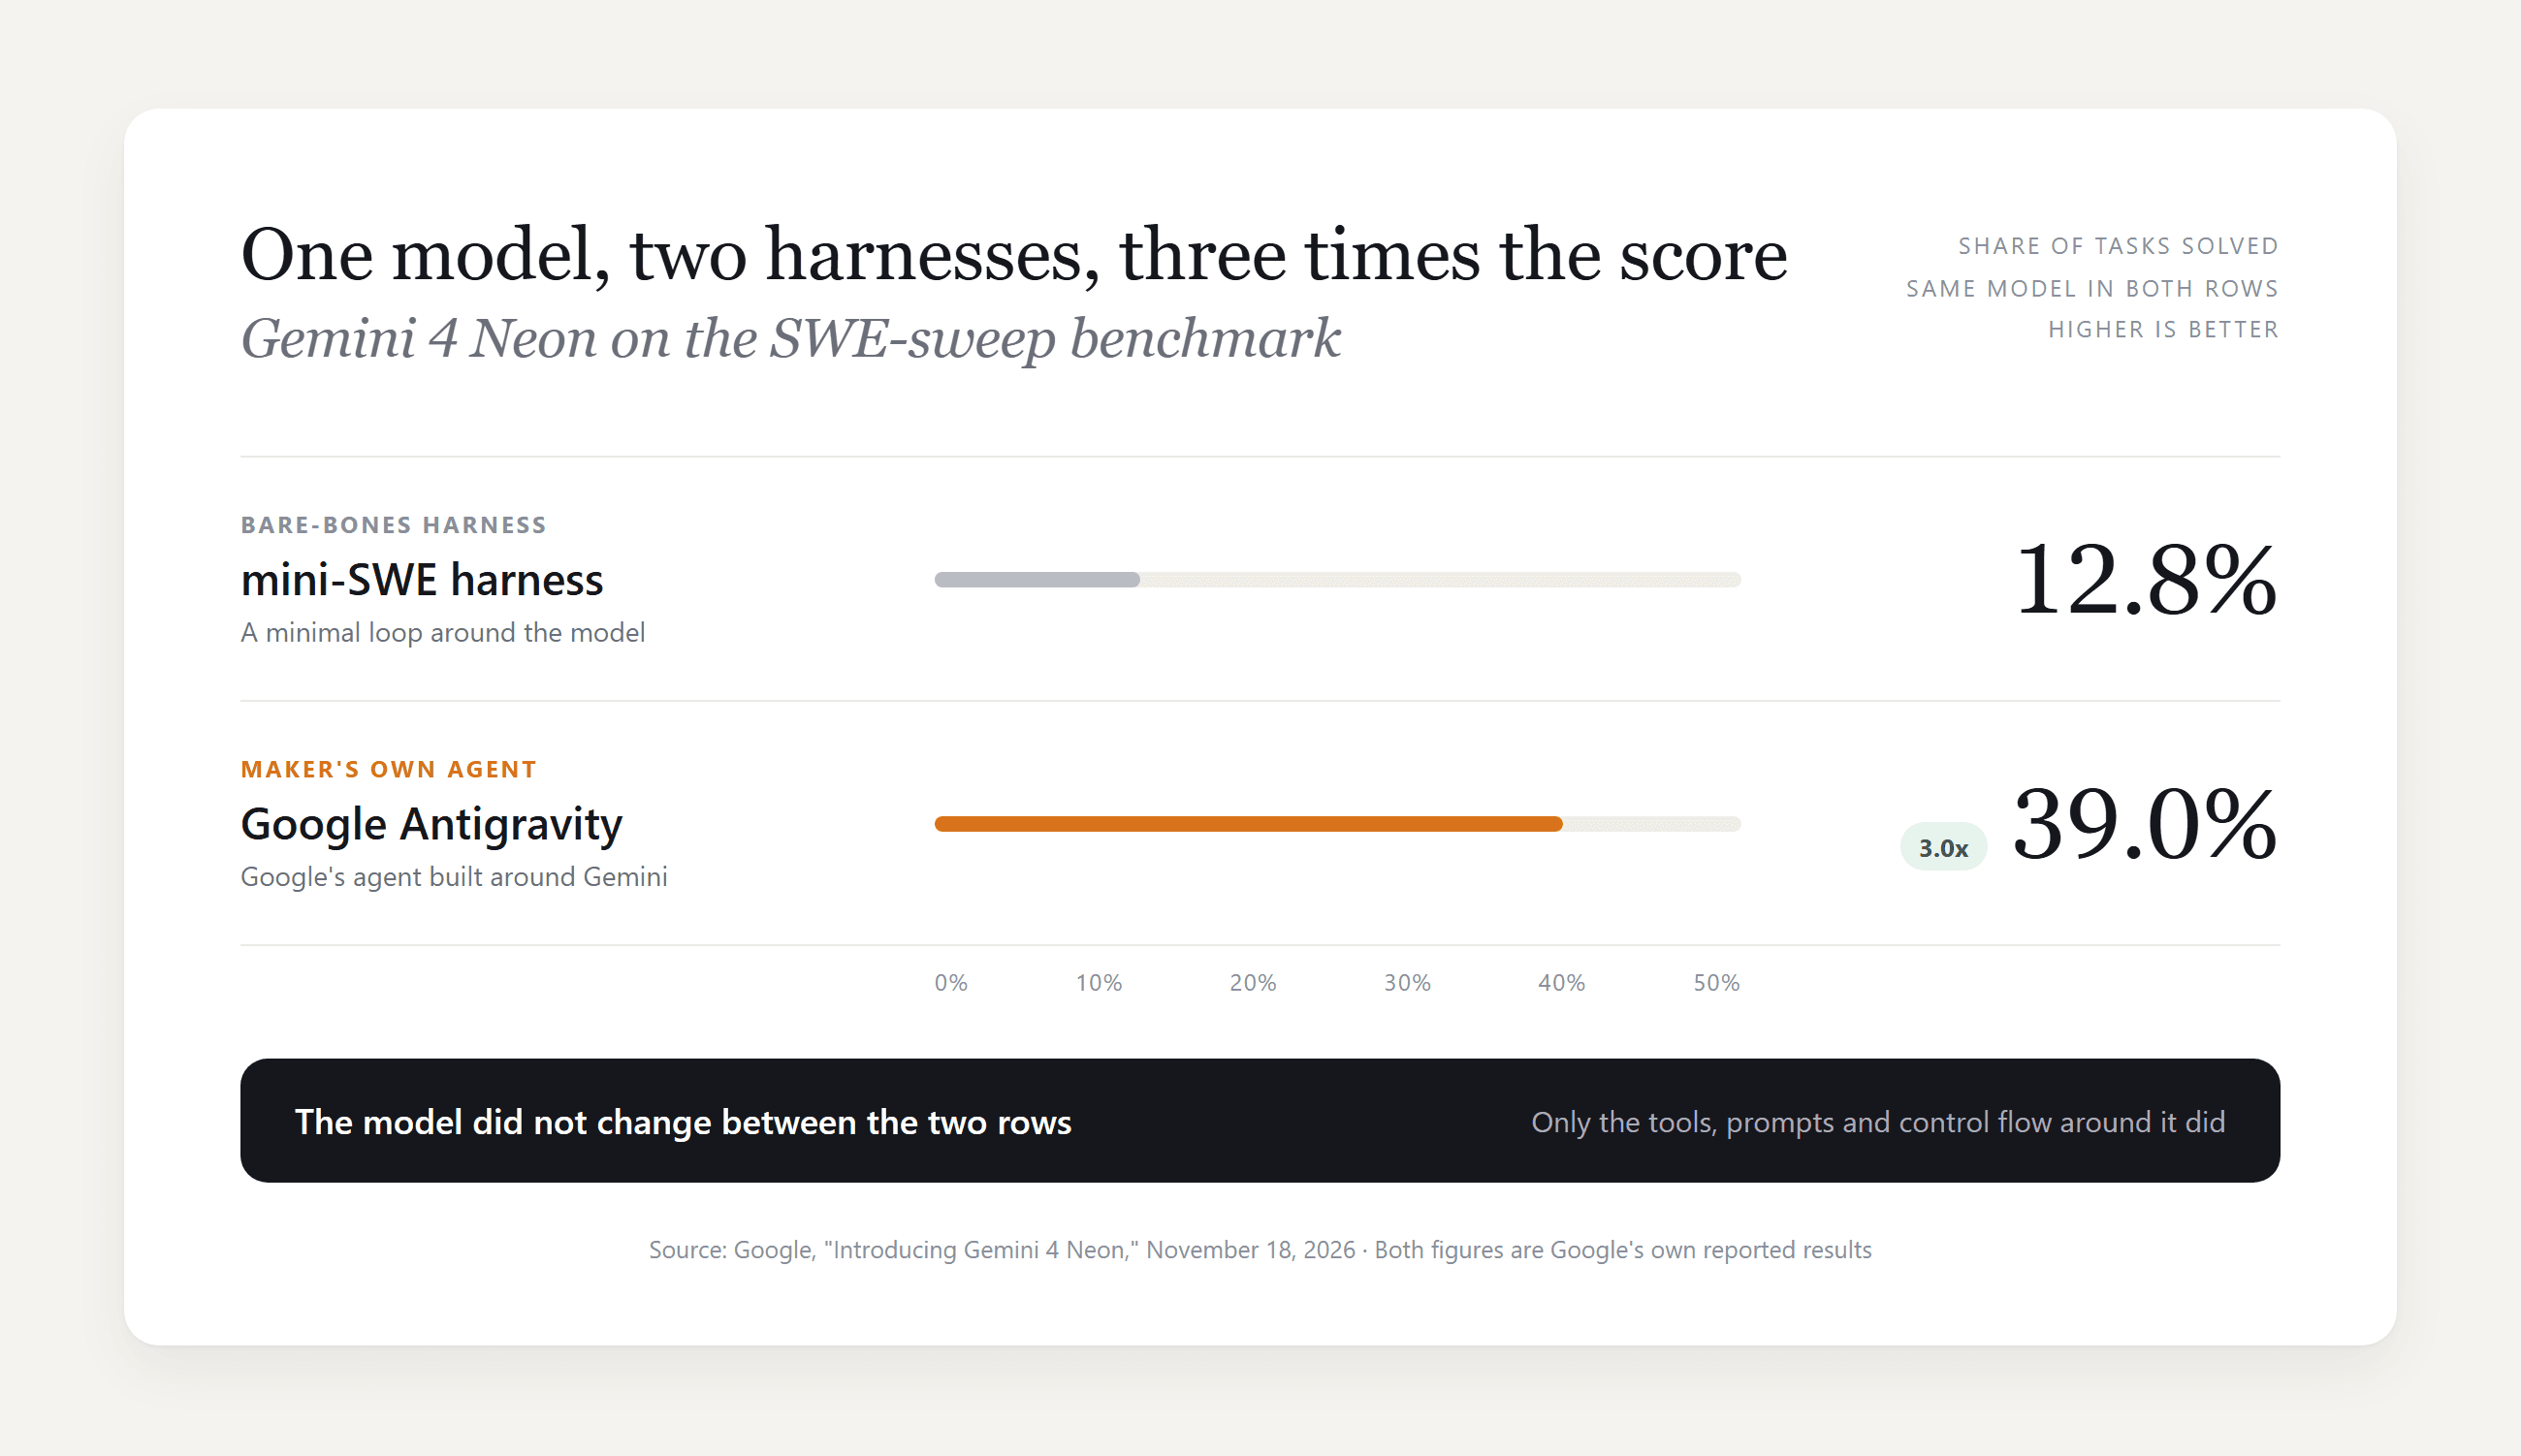
图表由 Atlas Cloud 根据 Google 2026 年 11 月 18 日 Gemini 4 Neon 公告中的数字制作。
研究人员在 ICML 2026 研讨会上也提出了同样观点。在一篇关于 harness 评估的海报 中,Jiwoo Han 和 Yuekai Sun 写道:“harness 的重要性不亚于 LLM。”
因此最佳编程 AI 代理是模型与 harness 的配对。本列表中有三款在 Coding Agent Index 上位居前列:Antigravity CLI 搭配 Gemini 4 Neon 为 59,Claude Code 搭配 Claude Fable 5.2 为 58,Codex 搭配 GPT-6.2 Astra 为 53。我们自己的测试故意反其道而行。它们调用裸 API,没有代理,因此模型是唯一变量。
反而该怎么做: 拿一个你们团队已经关闭的 bug,隐藏其测试,把工单交给两种配对,各运行三次。统计通过数、分钟数和美元。这一小时反映的是你的代码库,而公开指数看不到它。
Reddit 对最佳编程 AI 怎么说?
我们于 2026 年 11 月 20 日通过 Google 的索引阅读了这些帖子:标题、评论数,以及 Google 为每个帖子显示的预览文本。
| 子版块 | 帖子 | 评论 | 预览怎么说 |
|---|---|---|---|
| r/ollama | 当前最佳编程模型? | 50+ | Claude Opus 5.5 |
| r/GeminiAI | Neon 在编程代理中胜过 Fable 5.2,哇 | 30+ | Neon 便宜且编程强,Fable 5.2 更能处理项目上下文 |
| r/AI_Agents | 一名学生请求免费或更便宜的编程 AI | 10+ | DeepSeek 和 GLM |
| r/LocalLLaMA | Qwen 3.8 27b 有时聪明得让我害怕... | 250+ | 接近前沿模型,但更慢 |
| r/LocalLLM | 继续用 Qwen3.8 27B 还是换掉? | 60+ | 留下,并用 llama.cpp 提供服务 |
没有预算限制时,预览偏向 Claude。r/ollama 帖子中的最高答案是 Opus 5.5,Neon 帖子仍认为 Fable 5.2 对整体项目的把握更好。
预算相关帖子听起来不同。在 r/AI_Agents 关于免费和更便宜选项的帖子中,最高答案点名 DeepSeek 和 GLM。在本地论坛中,r/LocalLLM 的最高答案是继续用 Qwen3.8 27B,并改变它的服务方式。
GPT-6.2 意见分裂。r/codex 有关于 6.2 发布双方的长帖,这符合一款在某些榜单接近榜首、在另一些榜单中游的模型。
常见问题
现在编程排名第一的 AI 是哪个?
取决于榜单。截至 2026 年 11 月 20 日,Gemini 4 Neon 以 59 领先 Artificial Analysis Coding Agent Index。在 Terminal-Bench 4.1 上,Claude Fable 5.2 和 Opus 5.5 在 Claude Code 中以 65.8% 并列,落后 GitHub Copilot 的 Fusion 条目 71.2%。GPT-6.2 Astra 在本列表模型中的 LiveBench 2.0 编程分数最高,为 91.9。
Claude 和 ChatGPT 哪个更适合编程?
在我们同时运行两个代理的一个仓库上,它们在正确性上打平。Claude Code 搭配 Opus 5.5 和 Codex 搭配 GPT-6.2 Sol 都在一个薪资 bug 上通过了全部八项隐藏测试。Codex 用时 120 秒,Claude 为 208 秒,Claude 自己写了更多测试。完整运行见我们的 Claude vs ChatGPT 对比。
最适合 vibe coding 的 AI 是什么?
对于从一个提示词生成的小应用,GPT-6.2 Sol。在我们的 Web 应用任务中,它约 36 秒返回一个可用的费用分摊器,三次全部成功,GPT-6.2 Astra 以更高成本匹配它。DeepSeek V4.1 Flash、Kimi K3.1 Pro 和 Qwen3.8 27B 也三次全成,每个应用等待二到十三分钟。对于经过多步构建的更大应用,请改从 harness 部分选择代理配对。
通过 API 运行这些模型要多少钱?
截至 2026 年 11 月 20 日,Atlas Cloud 列出的我们运行的七款模型每百万输入和输出 token 费率如下:GPT-6.2 Sol $2 和 $10,GPT-6.2 Astra $8 和 $40,DeepSeek V4.1 Flash $0.30 和 $1.20,Kimi K3.1 Pro $2 和 $10,Qwen3.8 27B $0.50 和 $3,GLM 5.3 $1.40 和 $4.40,Grok 4.7 $2 和 $6。
按 token 计费,无订阅。在我们的测试中,一次成功运行的成本在 3 到 39 美分之间,具体取决于模型。推理 token 按输出计费,因此思考更久的模型每个正确答案成本更高。
结论
七款模型、三项任务、63 次运行。四款模型解决了每一次,而区分它们的是等待时间:每次运行从 23 秒到约八分钟。GPT-6.2 Sol 位于快的一端,并且每次成功运行成本是两项最低之一,这就是它领跑本列表的原因。
最佳编程 AI 模型仍然取决于任务。长时间困难工作,在其自家代理内使用 Claude Fable 5.2 或 Gemini 4 Neon;预算为零时使用 DeepSeek V4.1 Flash;代码必须留在你机器上时使用 Qwen3.8 27B。然后在做出承诺前,把你自己的一个已关闭 bug 交给其中两个运行。




