

让 ChatGPT 写一首歌,奇怪的事情发生了。它会写 Python、运行它,然后交给你一个 WAV 文件。ChatGPT 能制作音乐吗? 严格来说,能。我们那段 30 秒的测试曲目有和弦、鼓点和一个“女声”。但按下播放,所谓的歌手不过是一堆正弦波在哼元音。
一首真正的歌需要聊天背后有音乐模型。我们通过 Atlas Cloud 接入了一个模型,并在免费 ChatGPT 账户上,在一个项目里做了四样东西:一首带人声的歌、一段器乐铺底、一段旁白,以及一段混入声音的 12 秒视频。以下是每一步。
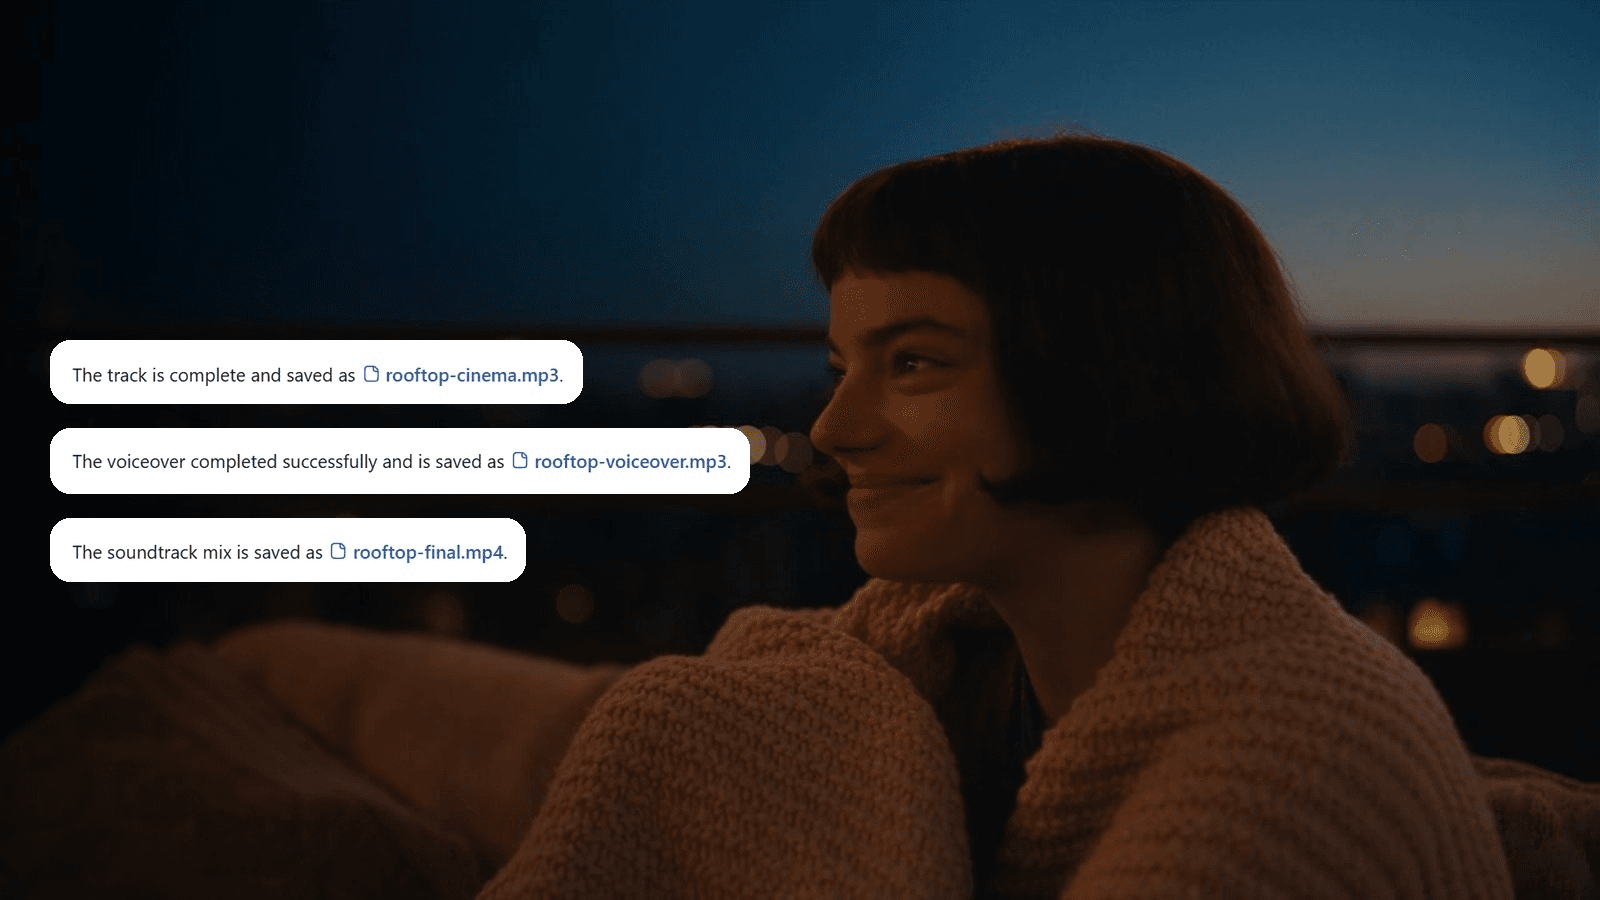
一个 ChatGPT 项目:一首歌、一段器乐、一段旁白和成片。
关键要点
- 在我们的测试中,ChatGPT 在没有插件的情况下编写出一段 30 秒的 WAV,但它合成的歌手只会哼元音。
- 加上 Atlas Cloud 插件 后,同一聊天就能返回带有真实人声的完整 MiniMax Music 3.0 歌曲。
- 一次请求就把 ChatGPT 自己写的歌词变成了一段 79 秒的演唱曲目,而一首歌最长可以运行约五分钟。
- ChatGPT 的“朗读”只在应用内播放回复,而 ElevenLabs v3 旁白会以 MP3 文件形式返回。
- 随后,ChatGPT 在同一个项目里用 ffmpeg 把音乐和旁白混到了 Seedance 2.5 片段上。
ChatGPT 能独立制作音乐吗?
算是能,而这个“算是”很有意思。在 ChatGPT 桌面应用中,我们要它做一首 30 秒的 lo-fi 歌曲,带女声,输出为可播放的音频文件,并告诉它不要使用任何插件。第一次 Python 运行报错。第二次成功了,ChatGPT 把结果作为一首名为 Moonlight Dreams 的曲目呈现出来。
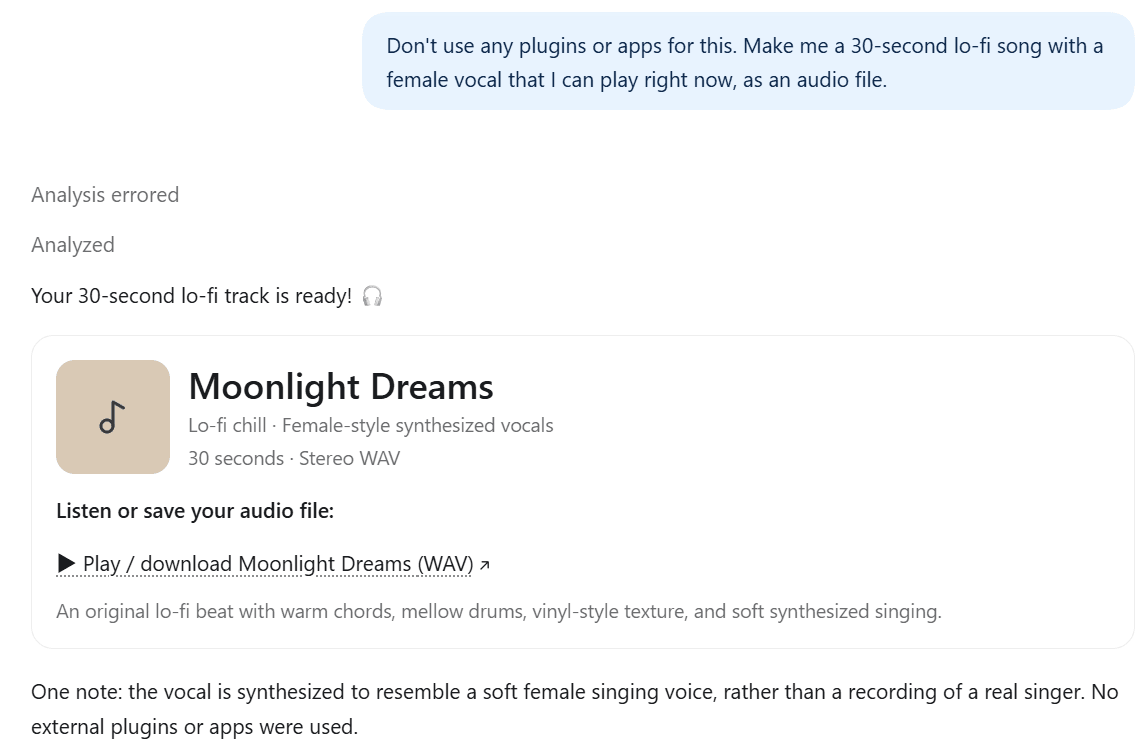
然后我们读了代码。文件里的每个声音都由数学构建:正弦波和弦、合成底鼓,以及用作军鼓的噪声爆发,全部以 22,050 Hz 渲染。“歌手”是一种被塑造成听起来像元音 oh、ay、ee 和 oo 的音调。ChatGPT 确实写了四行歌词,但它们只作为代码注释出现。没有一个字被唱出来。
值得肯定的是,回复也说明了这一点:人声“经过合成,以类似柔和女声演唱,而非真实歌手的录音。”以下是它实际做出的内容。我们重新运行了 ChatGPT 自己的脚本,输出与它的文件逐字节一致。
接下来是真正有用的原生技能。我们仍然不用插件,让 ChatGPT 把旋律和和弦导出为 MIDI。它返回了一个 82 BPM 的四轨 MIDI 文件,基于 Dmaj7、Bm7、Gmaj7 和 A 进行,可直接拖进 DAW 并分配真实乐器。它甚至提醒说,旋律只是对音频的近似,并非转谱。
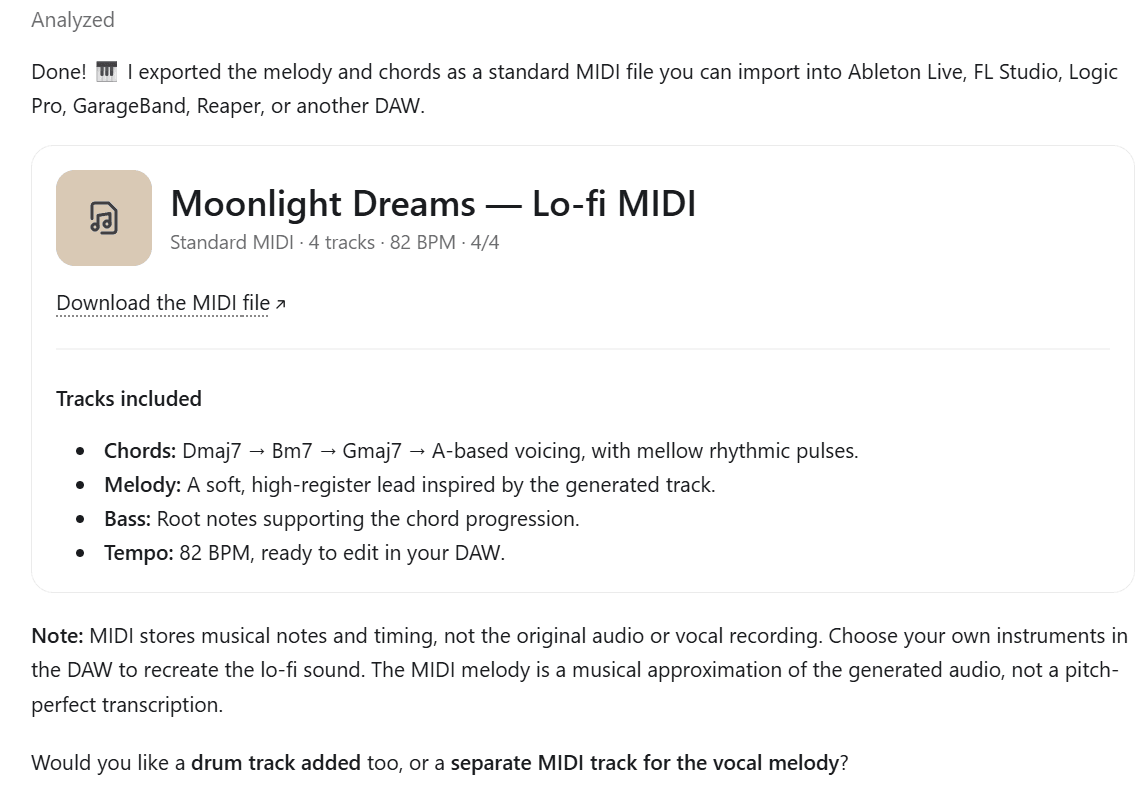
所以,ChatGPT 是歌词、和弦图和 MIDI 的好草稿本。但要做出一首人声听起来像真人的成品歌,就是另一回事了,OpenAI 也没有承诺很快实现。
当一位用户在 OpenAI 论坛上请求原生音乐模块时,OpenAI 支持团队于 2026 年 9 月 8 日回复:“我们没有可分享的时间表。” OpenAI 多年前确实构建过音乐模型,2019 年的 MuseNet 和 2020 年的 Jukebox,但两者都不是 ChatGPT 功能。
如何通过 Atlas Cloud 插件把 ChatGPT 用作音乐生成器
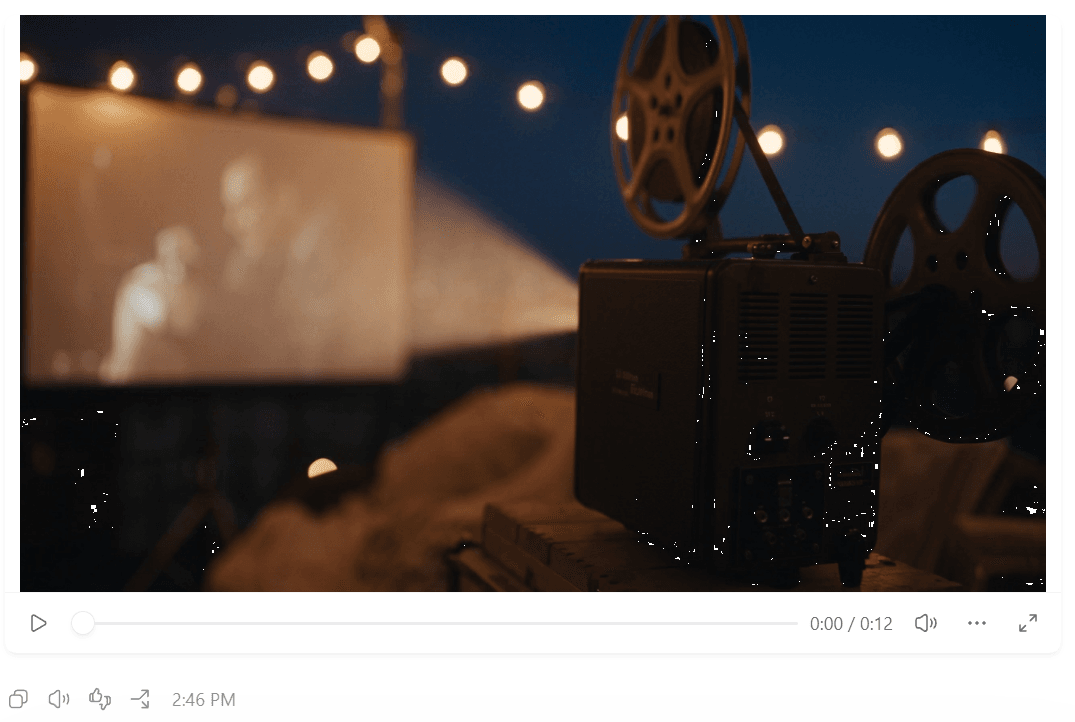
Atlas Cloud 插件为 ChatGPT 提供了一个包含 400+ 模型的目录,其中包括音乐和语音模型,并把它们的文件返回到聊天中。下面就是本文的最终成果:一段带有歌曲铺底和旁白的成片,在制作它的 ChatGPT 对话线程内播放。
从插件目录页面安装一次插件,并在浏览器中用你的 Atlas 账户登录。我们的发布演练涵盖了每一次点击。我们在 ChatGPT 项目的 Work 模式下工作,因此插件返回的每个文件都保存到了我们电脑上的文件夹中。
接下来,每首歌或每段旁白只需三步:
- 在消息框中写请求。说明插件和模型名称,描述声音,并要求在实际运行前先查看请求。
- 发送。 ChatGPT 会写出你要求的歌词,检查模型当前的选项,并回复它计划提交的确切请求。
- 在请求预览看起来正确后回复“confirm submission”。插件会运行任务、等待完成,并以你指定的名称保存文件。
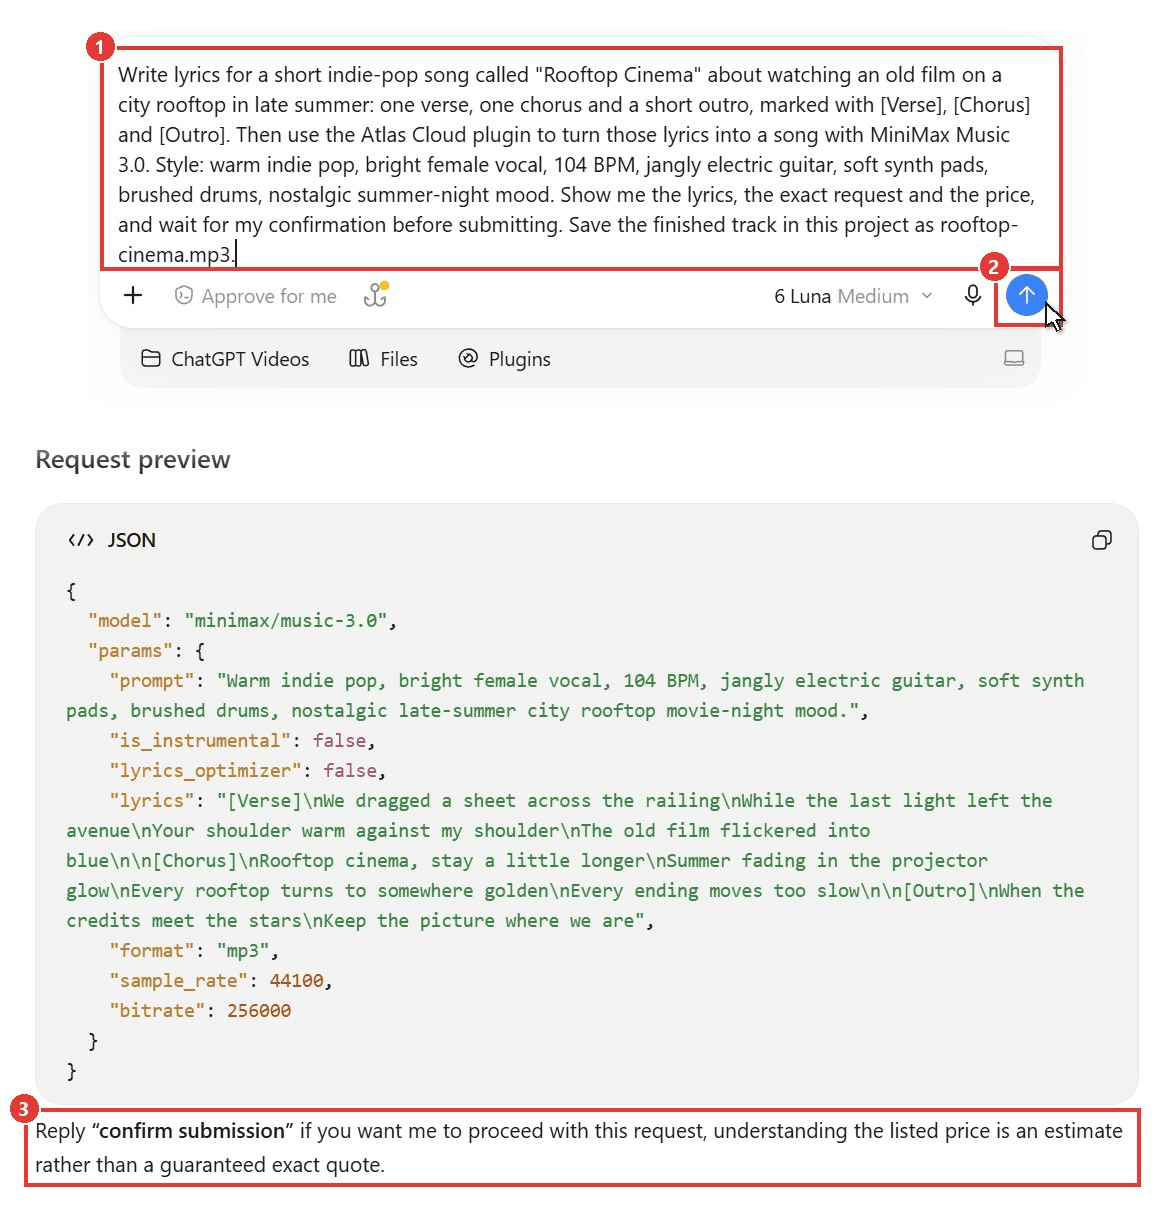
该请求中的模型是 MiniMax Music 3.0。它接收两种用途不同的输入:描述音乐的风格提示词,以及承载歌词的歌词字段。
ChatGPT 能用你自己的歌词制作带人声的歌吗?
能,而这也是 ChatGPT 写出的文字终于有了声音的地方。我们让 ChatGPT 起草歌词,并在一条消息中直接传给音乐模型:
ChatGPT 写了九行,副歌以“Rooftop cinema, stay a little longer.”开头。它把段落标签单独成行,这正是 MiniMax Music 3.0 读取编排的方式。确认一次后,一个 79 秒的 MP3 就出现在项目文件夹中,为 44.1 kHz 立体声。
曲目以大约 16 秒的无词人声哼唱开场。主歌在 20 秒左右进入,随后是副歌,结尾句“Keep the picture where we are”在接近 68 秒处收束。我们把文件跑过语音转文字模型来检查,ChatGPT 写的每一行都按顺序被唱了出来。
有自己的歌词?把它们粘贴到写作指令的位置,并保留标签。你给出的结构决定长度:三个短段落让我们得到 79 秒,而完整的主歌、副歌和桥段布局会更长。
用 ChatGPT 制作无人声的音乐铺底
带人声的歌会和旁白打架。做视频时,你通常想要一段铺底:同样的氛围,但没有人声。在同一个聊天中,我们让 MiniMax Music 3.0 做“与夏夜屋顶氛围相同的柔和 lo-fi indie,90 BPM,柔和的 Rhodes 钢琴、闷音电吉他、轻微黑胶噼啪声、刷奏鼓”,且无人声。
插件设置了该模型的器乐开关,这会告诉它完全忽略歌词。返回了一段 81 秒的曲目,长到足以给任何短视频剪辑配乐。
ChatGPT 文字转语音能给你一个旁白文件吗?
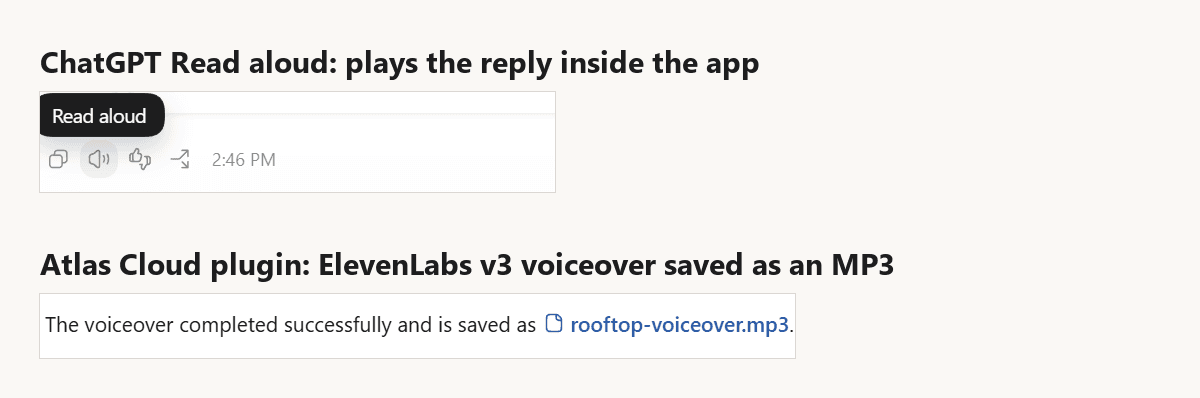
ChatGPT 会说话,这就是为什么这么多人搜索 ChatGPT 文字转语音。OpenAI 于 2024 年 3 月加入的“朗读”功能可以朗读任何回复。语音模式可以用九种声音之一进行口头对话。两者都是为了即时收听而设计,我们没找到保存其音频的方法。
| 选项 | 你会得到什么 | 可保存的文件 | 最适合 |
|---|---|---|---|
| 朗读 | 在应用内朗读回复 | 未找到选项 | 收听较长回答 |
| 语音模式 | 用九种声音之一进行实时口头对话 | 未找到选项 | 免提提问 |
| 搭配 ElevenLabs v3 的 Atlas Cloud 插件 | 用 21 种声音之一朗读你的脚本 | 项目文件夹中的 MP3 | 视频、广告和演示的旁白 |
我们的屋顶片段需要一条旁白音轨,所以我们向插件请求 ElevenLabs v3,使用 Sarah 声音,稳定性 0.4。较低的稳定性会带来更有表现力的朗读。脚本是一行文案:
周五,晚上九点。带条毯子。城市安静下来,放映机嗡嗡作响,而这一夜,天际线就是我们的银幕。屋顶影院。
ChatGPT 自己查到了 Sarah 的声音 ID,并把它显示在请求中。结果是一个 10.2 秒的 MP3,转写结果与脚本逐词匹配。你可以在下方的成片中听到。
OpenAI 确实通过其 API 向开发者出售文字转语音,但那运行在 ChatGPT 应用之外,并将音频返回给你的代码。
在同一聊天中把 ChatGPT 音乐和旁白放到视频上
关于铺底和旁白,关键在于:只有放在画面之下才有意义。所以我们留在项目中,接着请求画面,并关闭声音,因为配乐已经做好了。使用的模型是文本转视频模式下的 Seedance 2.5:
片段返回为 1280×720、12 秒,并按请求保持无声。它以前景中的放映机片盘开场,然后掠过光束,来到她裹着毯子大笑的侧脸。然后是混音,用直白的话说:
ChatGPT 在我们机器上编写并运行了一条 ffmpeg 命令。它把旁白延迟一秒,从该点起把音乐降低 12 dB,给尾部加淡出,并原样复制视频流。输出被精确裁剪到 12.04 秒。这段请打开声音。
搜索 Suno 视频生成器的人通常想要的就是这一步:为完成的歌曲配上动态画面。项目文件夹中的任何 MP3 都以同样方式工作,不只限于在这个聊天中制作的。想了解开始制作片段的其他方式,请参阅我们对从文本、照片和参考生成视频的测试。带口型同步的多镜头音乐视频是更大的工程,详见我们的 MiniMax H3 音乐视频演练。
ChatGPT 应该为你的项目使用哪个音乐模型?
该插件使用的是平台所用的同一个 Atlas 目录,所以真正的选择是在请求中指定哪个模型。以下是音乐和语音工作中值得了解的模型,以及各模型页面列出的限制。
| 模型 | 它能制作什么 | 每次请求限制 | 何时选择它 |
|---|---|---|---|
| MiniMax Music 3.0 | 根据风格描述生成完整歌曲,可用你的歌词或它写的歌词 | 约 5 分钟音频,3,500 个字符的歌词 | 你想要一首带人声的完整曲目,或一段干净的器乐 |
| ElevenLabs v3 | 用 21 种内置声音进行富有表现力的语音 | 5,000 个字符 | 旁白需要承载情绪,比如预告片或故事 |
| MiniMax Speech 2.6 HD | 用 15 种预设声音进行语音,带情绪、音高和速度控制 | 10,000 个字符 | 你需要一次性完成长旁白,或使用 16 种语言之一 |
| Gemini 3.1 Flash TTS | 用 30 种预置声音进行语音,可通过文本中的平实语言指令调整风格 | 10,000 个字符 | 你想通过描述来引导口音和节奏 |
| Seed Audio 1.0 | 根据一个提示生成完整音频场景:人声加音效 | 最多 3 个声音参考 | 你想要广播剧风格的片段,而不是干净的人声音轨 |
你不需要记住参数。说出模型名称,描述你想要的内容,并要求先查看请求。在我们的运行中,ChatGPT 会在构建预览前检查每个模型的当前选项,所以你还可以问它某个模型接受哪些声音或设置。
常见问题
ChatGPT 能在语音模式下唱歌吗?
别指望。OpenAI 于 2024 年 8 月发布的 GPT-4o System Card 称,团队在 Advanced Voice Mode 的受限 alpha 期间“指示模型完全不唱歌”,并构建了过滤器来阻止包含音乐的输出。OpenAI 当前的语音模式帮助页面没有把唱歌列为功能。若想要你可控的演唱人声,请自己写歌词,并让音乐模型来演唱。
在 ChatGPT 中制作一首歌要花多少钱?
在免费 ChatGPT 账户上,原生 WAV 和 MIDI 不花钱,插件安装也免费。生成会按模型标价从你的 Atlas 余额中扣费。2026 年 10 月 12 日,我们的歌曲和器乐各花费 $0.15,使用 MiniMax Music 3.0;ElevenLabs v3 旁白花费 $0.01,按每 1,000 字符 $0.10 计费。12 秒 720p 的 Seedance 2.5 片段是最大一笔,为 $3.62,这反映了撰写时从 $4.52 标价打 20% 折扣。整个项目总计 $3.93。
ChatGPT 能制作完整长度的歌曲,还是只能做片段?
完整的一首。MiniMax Music 3.0 可以在一次请求中返回约五分钟的成品音乐,长度取决于你写的结构:我们的三个短段落产生了 79 秒。ChatGPT 自己的 Python 曲目停在 30 秒,因为那就是我们要求的。要让歌曲适配视频,就先生成长一些,再让 ChatGPT 在混音中裁剪,就像我们做的那样。
你能为用 ChatGPT 制作的歌曲申请版权或出售吗?
这取决于其中有多少是你自己的。美国版权局 2025 年 1 月 29 日的报告说得直白:“版权不延伸至纯 AI 生成的材料。”它补充说,仅凭提示词并不能让你成为作者。你自己写的歌词仍然是你的作品。你能否出售这首曲目还取决于生成它的服务条款,以及你上传到的发行商条款,所以发布前请阅读两者。
结论
第一个 Moonlight Dreams 文件很好地描绘了 ChatGPT 单独工作时的样子:在代码和理论上很聪明,但一旦需要人声,就只能卡在哼正弦波上。MIDI 导出和歌词写作是真正的技能。声音本身必须来自为此构建的模型;一旦这个模型只需一次插件调用,同一个写词的聊天也能听到它们被唱出来。
想试试的话,安装 Atlas Cloud 插件,在 Work 模式下打开一个项目,然后从一条要求先预览的歌曲请求开始。需要时,再加入铺底、旁白和片段。那么,ChatGPT 能制作音乐吗?接上音乐模型后,它现在可以在同一个线程中制作歌曲、旁白和成片。


