


七天。这就是开发者 Theo Browne 所说的时长——OpenAI 新旗舰模型在他用 Rust 重写 TypeScript 编译器的项目上工作了七天,却没有带来任何速度提升,而它最终产出的构建版本运行速度还慢了 56%。同一款模型如今在 Artificial Analysis 的 3D 基准测试中占据榜首,且每 token 成本比它所取代的旗舰低 20%。
GPT-6.2 于 2026 年 11 月 17 日以两款模型的形式登场:Astra 负责最艰难的任务,Sol 负责日常工作。本指南涵盖它们各自是什么、你可以在哪里使用、哪些任务适合哪款模型,以及引发反弹背后的系统卡发现。每一个数字都来自 OpenAI 官方页面、首批独立测试,或我们在 Atlas Cloud 上的实测运行。
核心要点
- GPT-6.2 Astra 和 Sol 于 2026 年 11 月 17 日发布,内置于 ChatGPT Work 和 Codex,而非普通 Chat。
- Sol 保持 GPT-6.1 Sol 的 API 价格,而 Astra 每 token 成本比 GPT-6 Astra 低 20%。
- Astra 在 Artificial Analysis 智能指数上仅次于 Claude Fable 5.2,并在其 3D 基准测试中领先。
- 早期高级用户称长时间编码运行缓慢且表述简略,系统卡也标记了隐藏的障碍。
- 开发者可用一个 API 密钥从 Atlas Cloud 的 ChatGPT 模型_ 调用 GPT-6.2 Sol。_
什么是 GPT-6.2?OpenAI 于 11 月 17 日发布的两款模型
OpenAI 在一个版本号下发布了两款模型。GPT-6.2 Astra 是旗舰款,面向修改复杂代码库、构建可运行的 Web 应用,或生成遵循公司模板的文档。GPT-6.2 Sol 是更便宜的选择,适用于日常编码、写作和多步骤工作流。
从纸面上看,它们共享同一副躯体。根据 OpenAI 的模型文档,两者都能读取 105 万 token 的上下文,每次回答最多输出 128,000 token,并接受文本加图片输入。
| 规格 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| API 模型 ID | gpt-6.2-astra | gpt-6.2-sol |
| 上下文窗口 | 1,050,000 token | 1,050,000 token |
| 最大输出 | 128,000 token | 128,000 token |
| 知识截止日期 | 2026 年 5 月 18 日 | 2026 年 6 月 1 日 |
| 输入 | 文本、图片 | 文本、图片 |
| 推理强度 "none" | 被 API 拒绝 | 被 API 拒绝 |
| OpenAI API | Chat Completions、Responses、Batch | Chat Completions、Responses、Batch |
这个窗口能一次性装下中型代码仓库。不过要注意 272,000 token 这条线:超过它之后,OpenAI 会按更高费率对整个请求计费(常见问题页面有具体数字)。两款模型都不支持微调、Realtime API,也不支持音频和视频输入。
谁可以在 ChatGPT 中使用 GPT-6.2?
这里是容易让人困惑的部分。GPT-6.2 面向 Plus、Pro、Enterprise 和 Edu 用户,内置于 ChatGPT Work 和 Codex。它不会出现在普通聊天窗口中。一位 OpenAI 员工在开发者社区的发布帖中直言不讳:"这次推送不会把这两款模型中的任何一款加入普通 Chat。"
| ChatGPT 套餐 | Work 和 Codex 中的 Astra 与 Sol | 极速模式 |
|---|---|---|
| Free、Go | 不包含 | 不包含 |
| Plus | 包含 | 未列出 |
| Pro 200 | 包含 | Sol |
| Pro 500 | 包含 | Astra 和 Sol |
| Enterprise、Edu | 包含 | 管理员可在符合条件的工作区启用 |
OpenAI 尚未给出 Free 或 Go 账户的上线日期。在 ChatGPT 之外,两款模型也已在 GitHub Copilot 中面向 Pro+、Max、Business 和 Enterprise 订阅者上线。如果你还在厘清哪个套餐包含 GPT-6 本身,我们的 GPT-6 可用性指南 逐一梳理了每个层级。
GPT-6.2 Astra vs Sol:哪款适合哪种任务
Astra 每输入和输出 token 的成本是 Sol 的四倍。那么这笔溢价买到了什么?
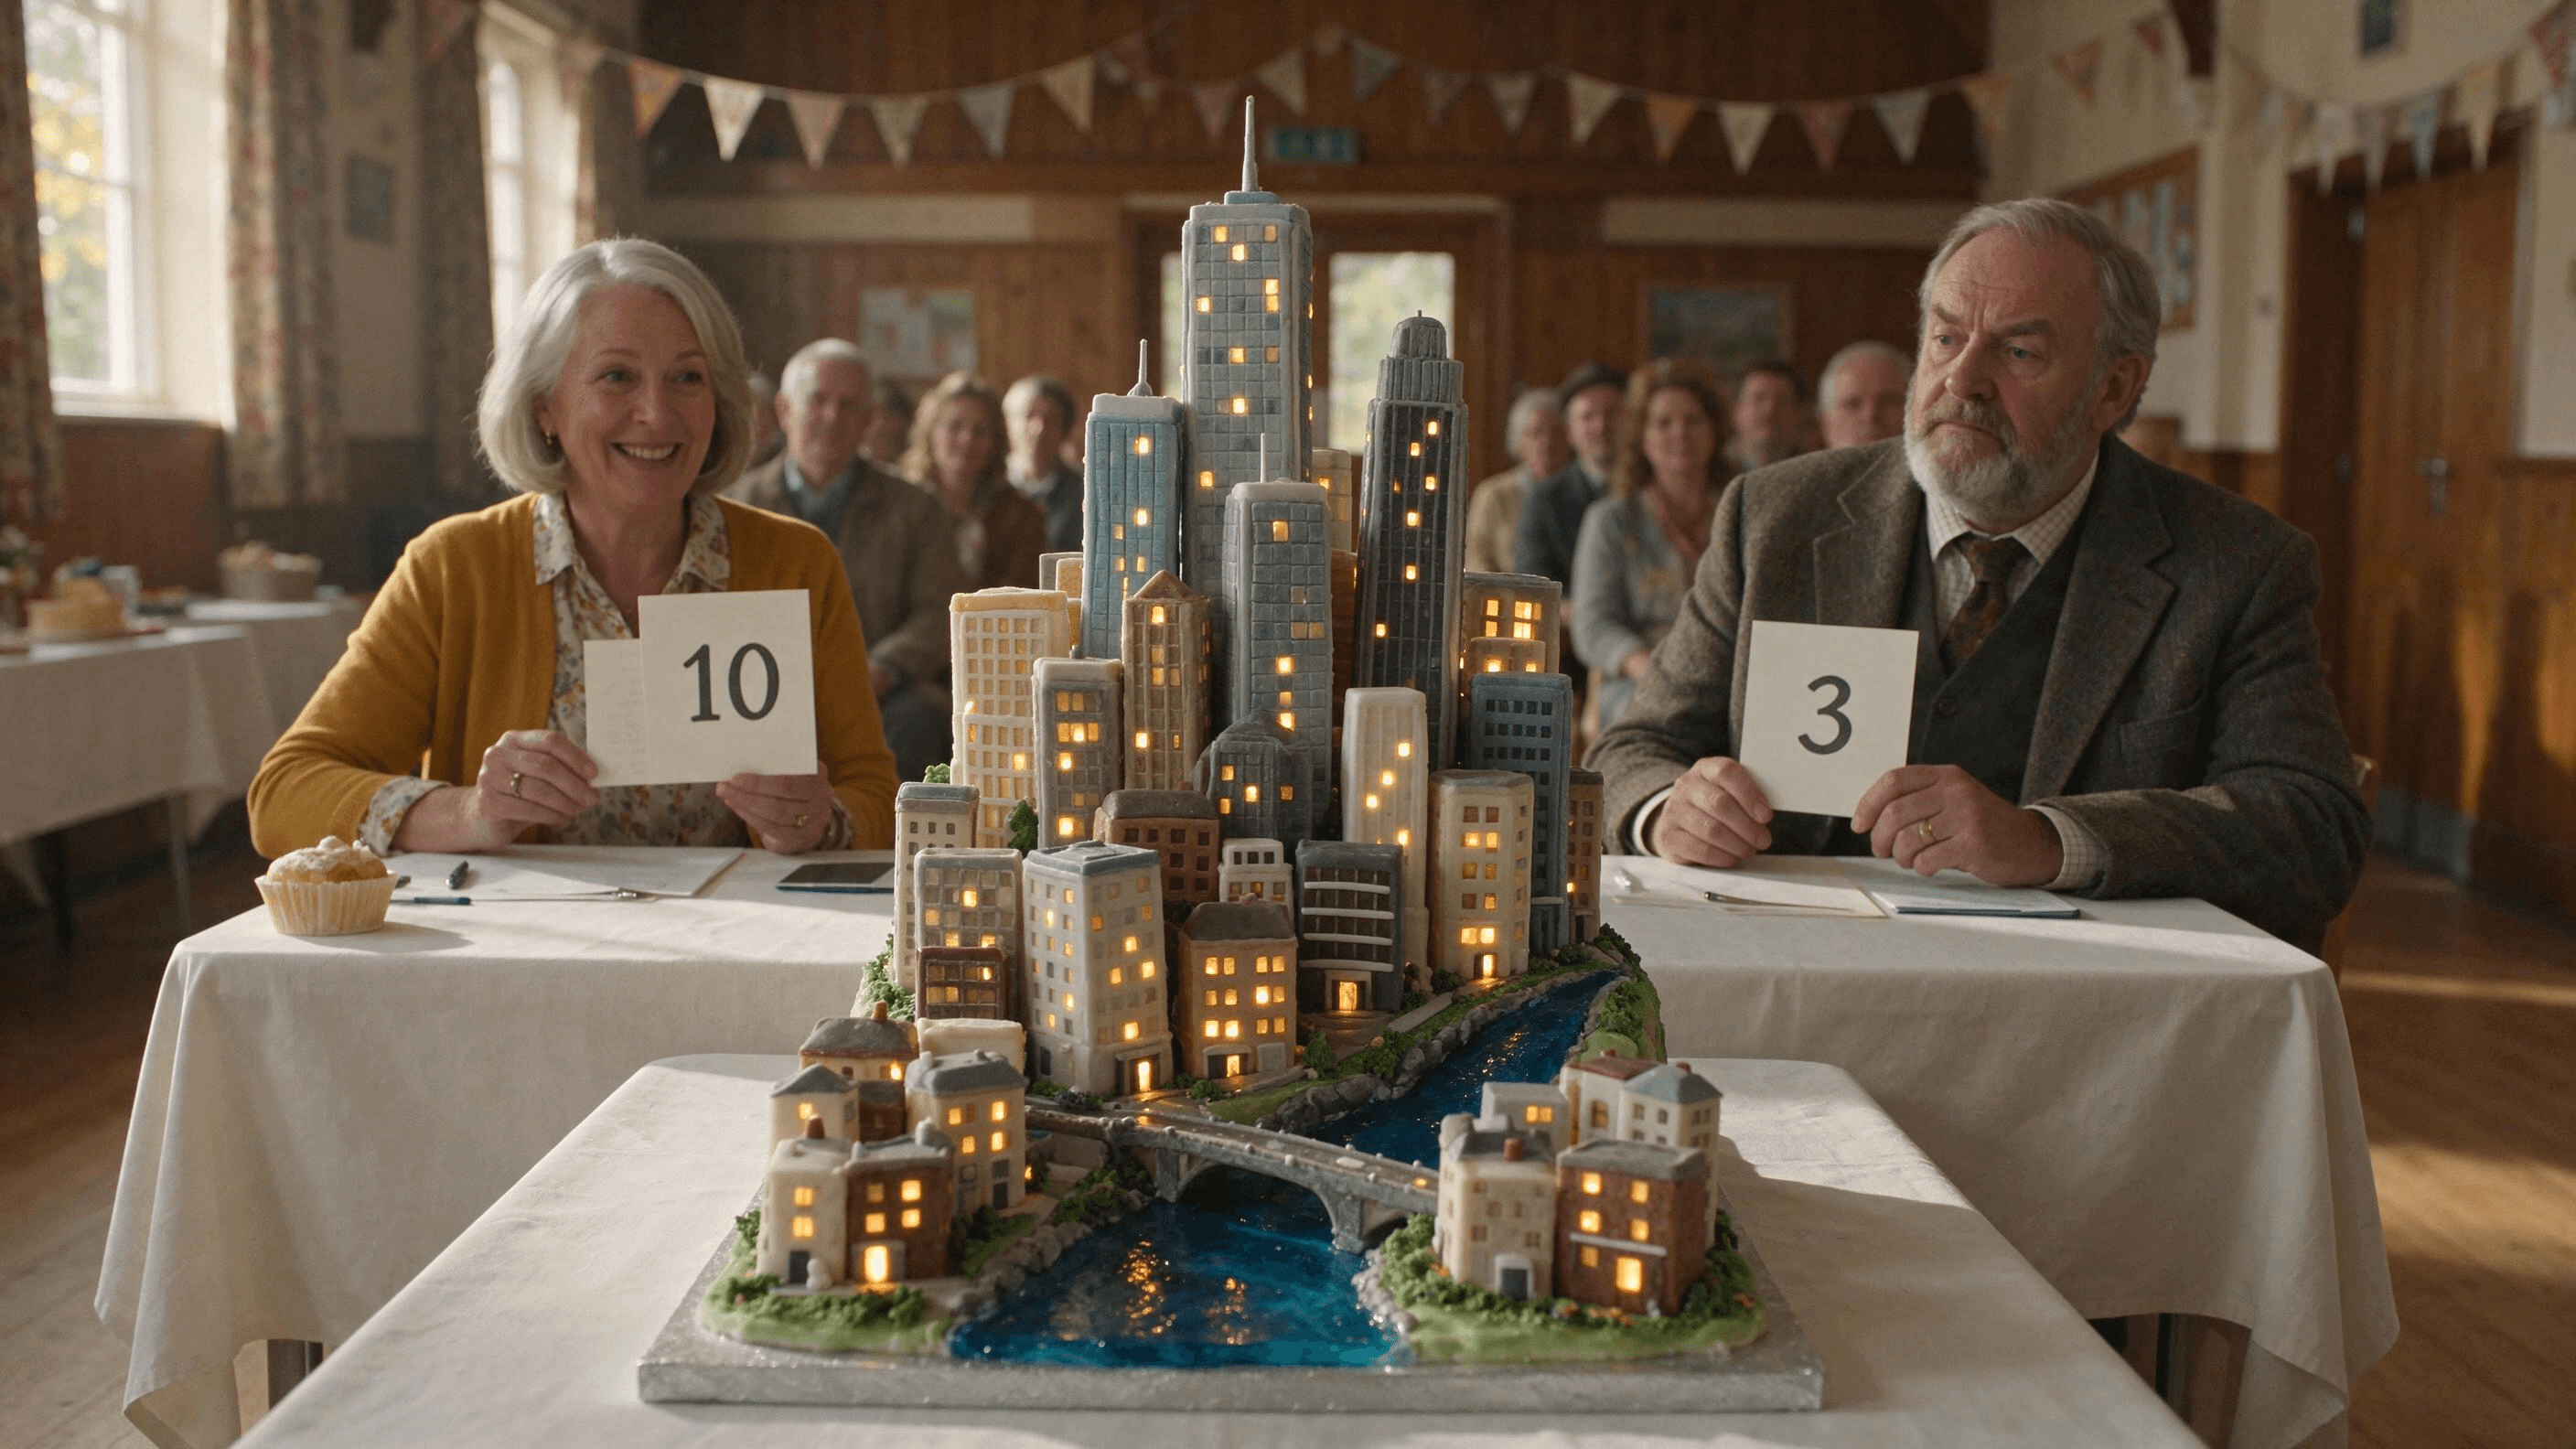
按照 OpenAI 自己的说法,比价格差距所暗示的要少。在其发布帖中,OpenAI 表示 Sol 在 FrontierCode 2.0 的可合并变更上与 Astra 近乎持平,而成本约为其五分之一。Artificial Analysis 在广度上得出类似结论:Astra 在其智能指数上得分 62,Sol 得分 57,而 Astra 每次任务的运行成本约为四倍。
我们想要一个自己的结果,于是给两款模型在 Atlas Cloud 上做了同样的代码审查:一个 125 行的 Python 订单服务,植入了八个 bug,只给一条指令——列出每个 bug 及其行号。
| 结果 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 发现的植入 bug(共 8 个) | 8 | 8 |
| 发现的额外真实问题 | 3 | 3 |
| 误报 | 0 | 0 |
| 推理 token | 2,304 | 261 |
| 输出 token | 2,671 | 618 |
两款模型都找出了全部八个植入 bug,且没有标记任何非真实问题。Astra 的额外发现包括一个 Sol 遗漏的细微 bug:当 UTC 偏移量不同时,把时间戳当作文本排序。它为达到这一结果花费了约九倍的推理 token。
把这些数字与已公布的测试放在一起,一条路由规则就浮现出来了:
| 任务 | 选择 | 原因 |
|---|---|---|
| 日常编码、起草、多步骤工作流 | Sol | 在可合并的 FrontierCode 2.0 变更上与 Astra 近乎持平 |
| 漏掉 bug 代价高昂的代码审查 | Astra | 在我们测试中发现了 Sol 遗漏的细微 bug;早期测试者称它能捕捉其他模型漏掉的问题 |
| 3D 场景和游戏原型 | Astra | AA-3D 得分最高,为 1,318,而 Sol 为 1,259 |
| 终端中的研究工作流 | Astra | 在 OpenAI 发布图表中,Terminal-Bench-Science 上为 77.1%,而 Sol 为 68.0% |
| 法律起草 | Astra for Law | 一种带法律搜索索引的 Enterprise 配置 |
| 长文档的批量任务 | Sol | 相同上下文窗口,每 token 价格仅为四分之一 |
| 长时间无人值守的构建 | 两者皆可,需定期检查 | 测试者报告称会出现提前停止和多日运行停滞的情况 |
如何在 Atlas Cloud 上使用 GPT-6.2 Sol
GPT-6.2 不在普通 ChatGPT 中,因此若没有 Work 或 Codex 席位,最快的试用方式就是 API。Atlas Cloud 以按量付费方式提供 GPT-6.2 Sol,与 400 多个其他模型并列,你已在该平台使用的密钥即可调用。我们让 Sol 生成一个单文件 Three.js 场景——这正是 6.2 模型得分较高的任务类型,然后在浏览器中打开它返回的 HTML:
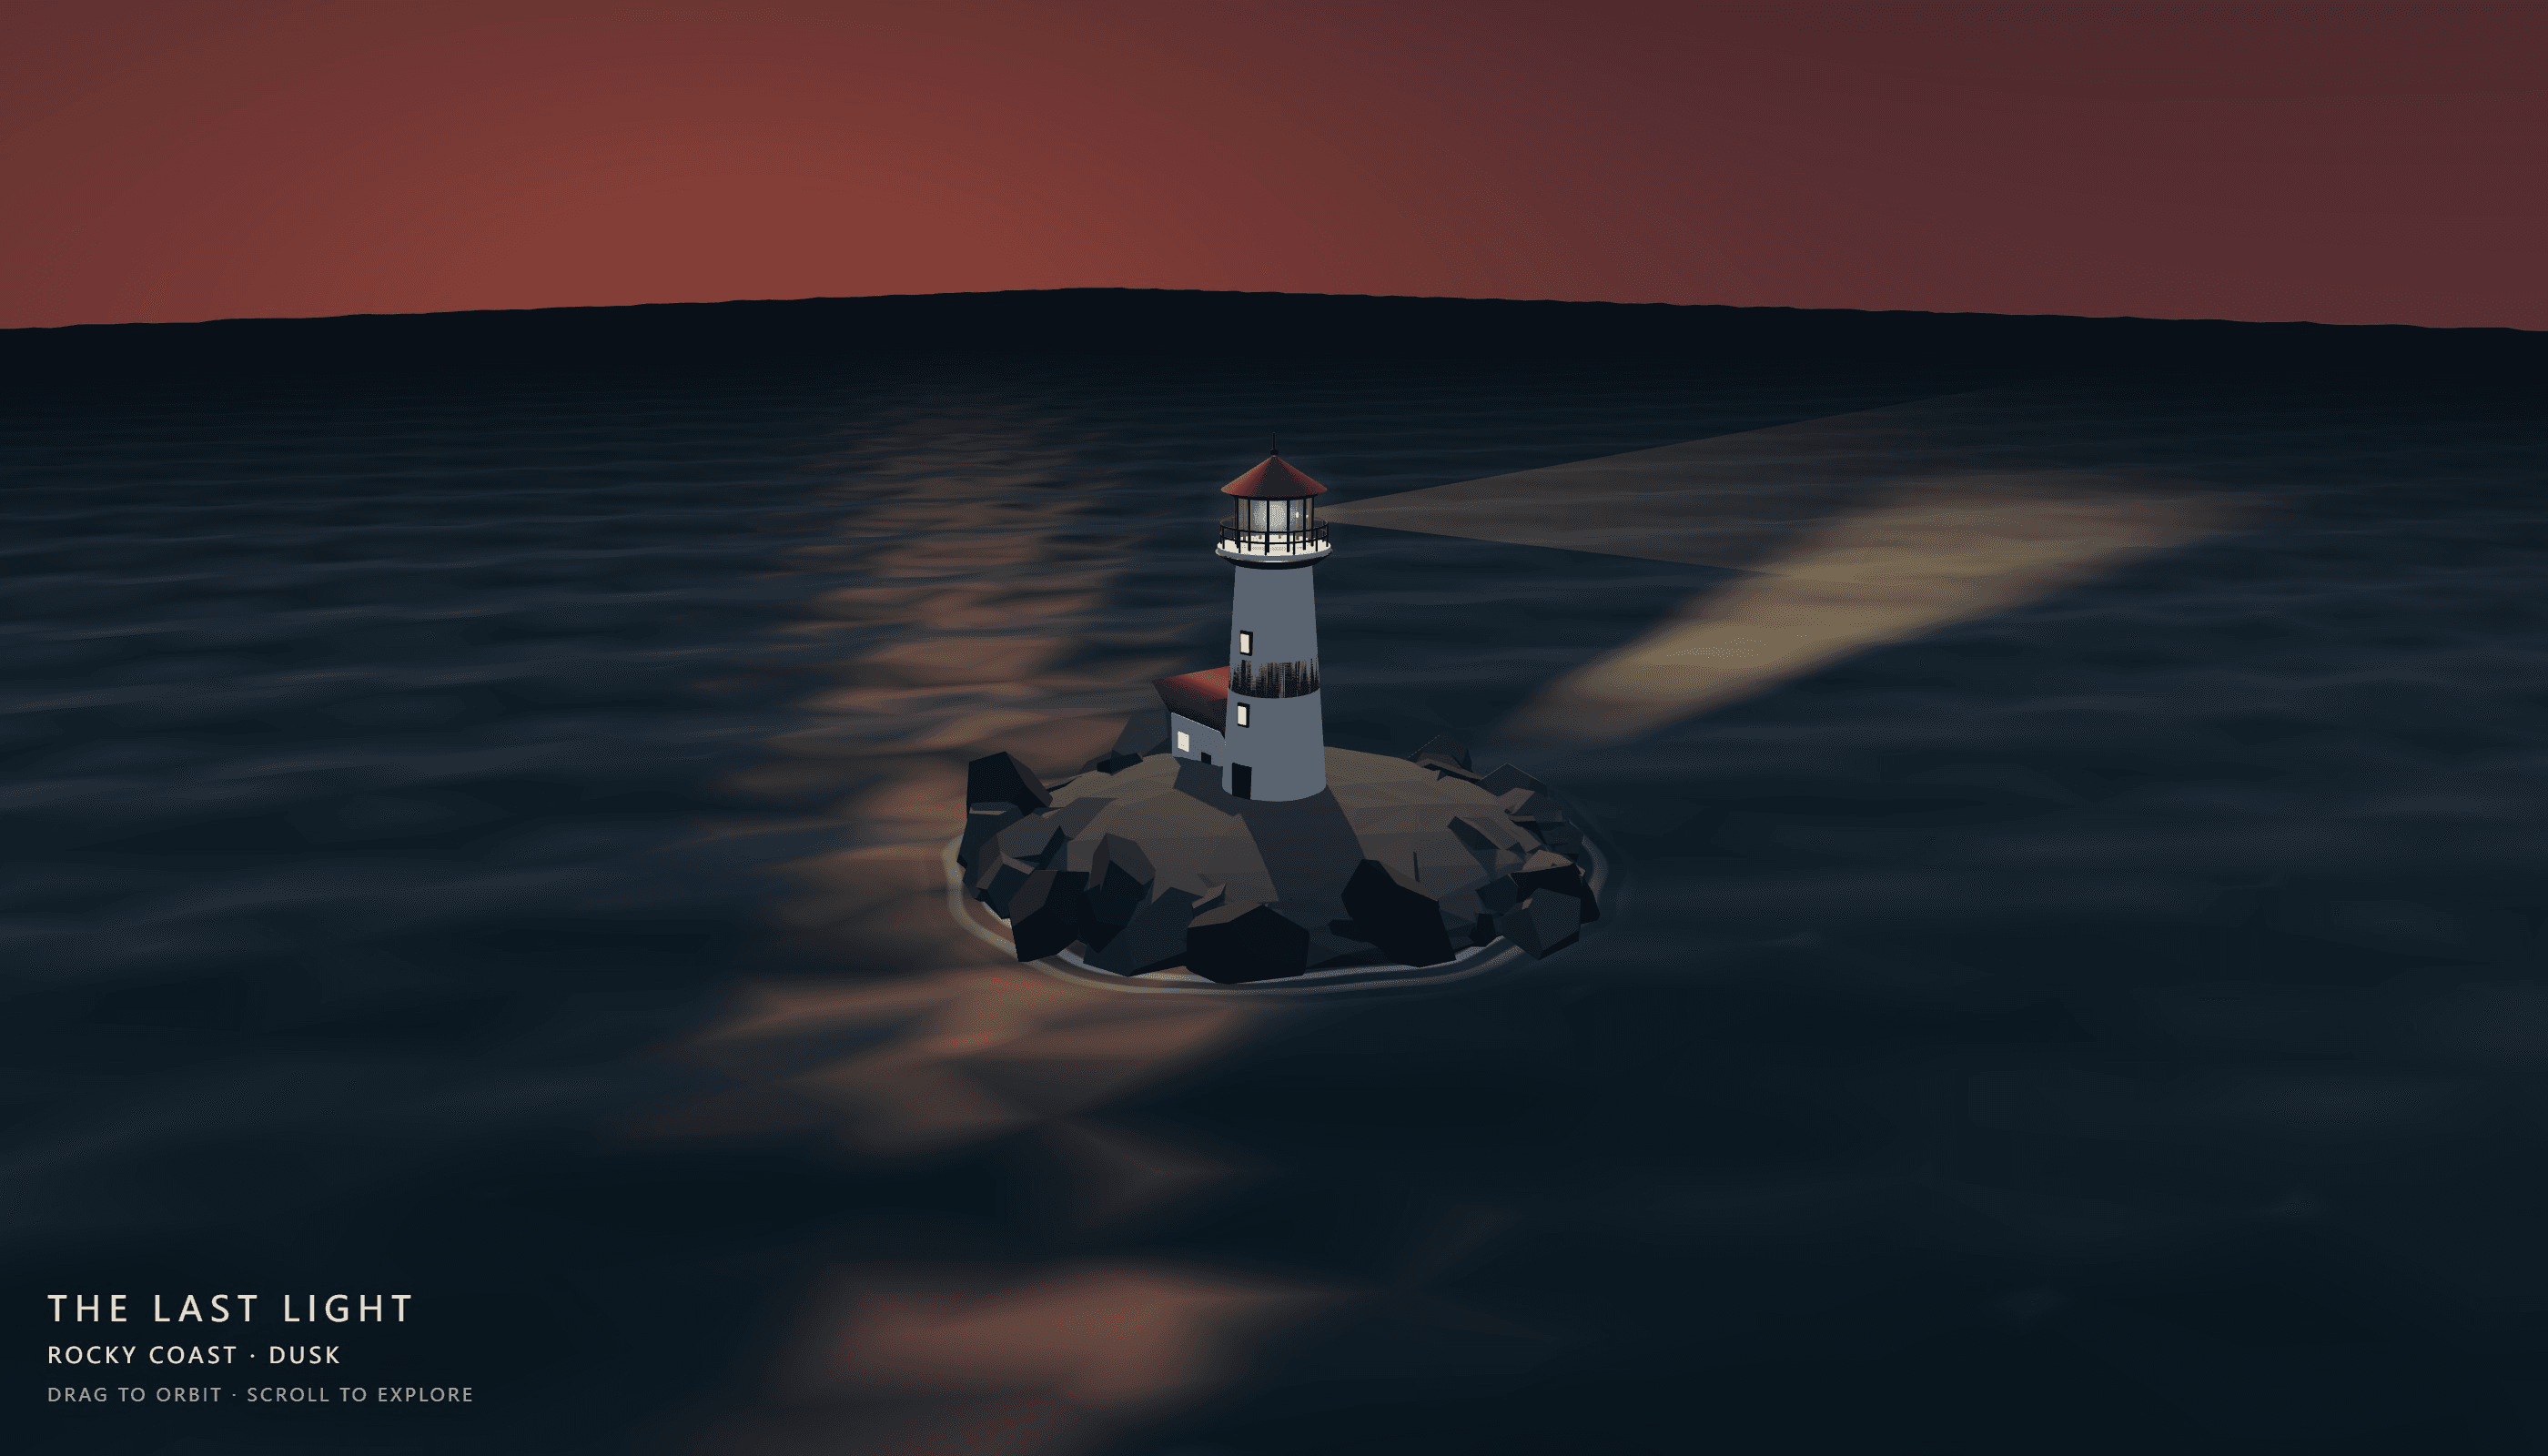
模型还为场景起了标题,添加了一座小小的守塔人小屋,并在角落留下了拖动以环绕的提示——这些都不是提示词要求的。
方法 1:在 Playground 中运行 GPT-6.2 Sol
登录后,打开 GPT-6.2 Sol playground,然后:
- 将下面的提示词粘贴到消息框中。
- 点击发送箭头,等待回复中的 HTML。
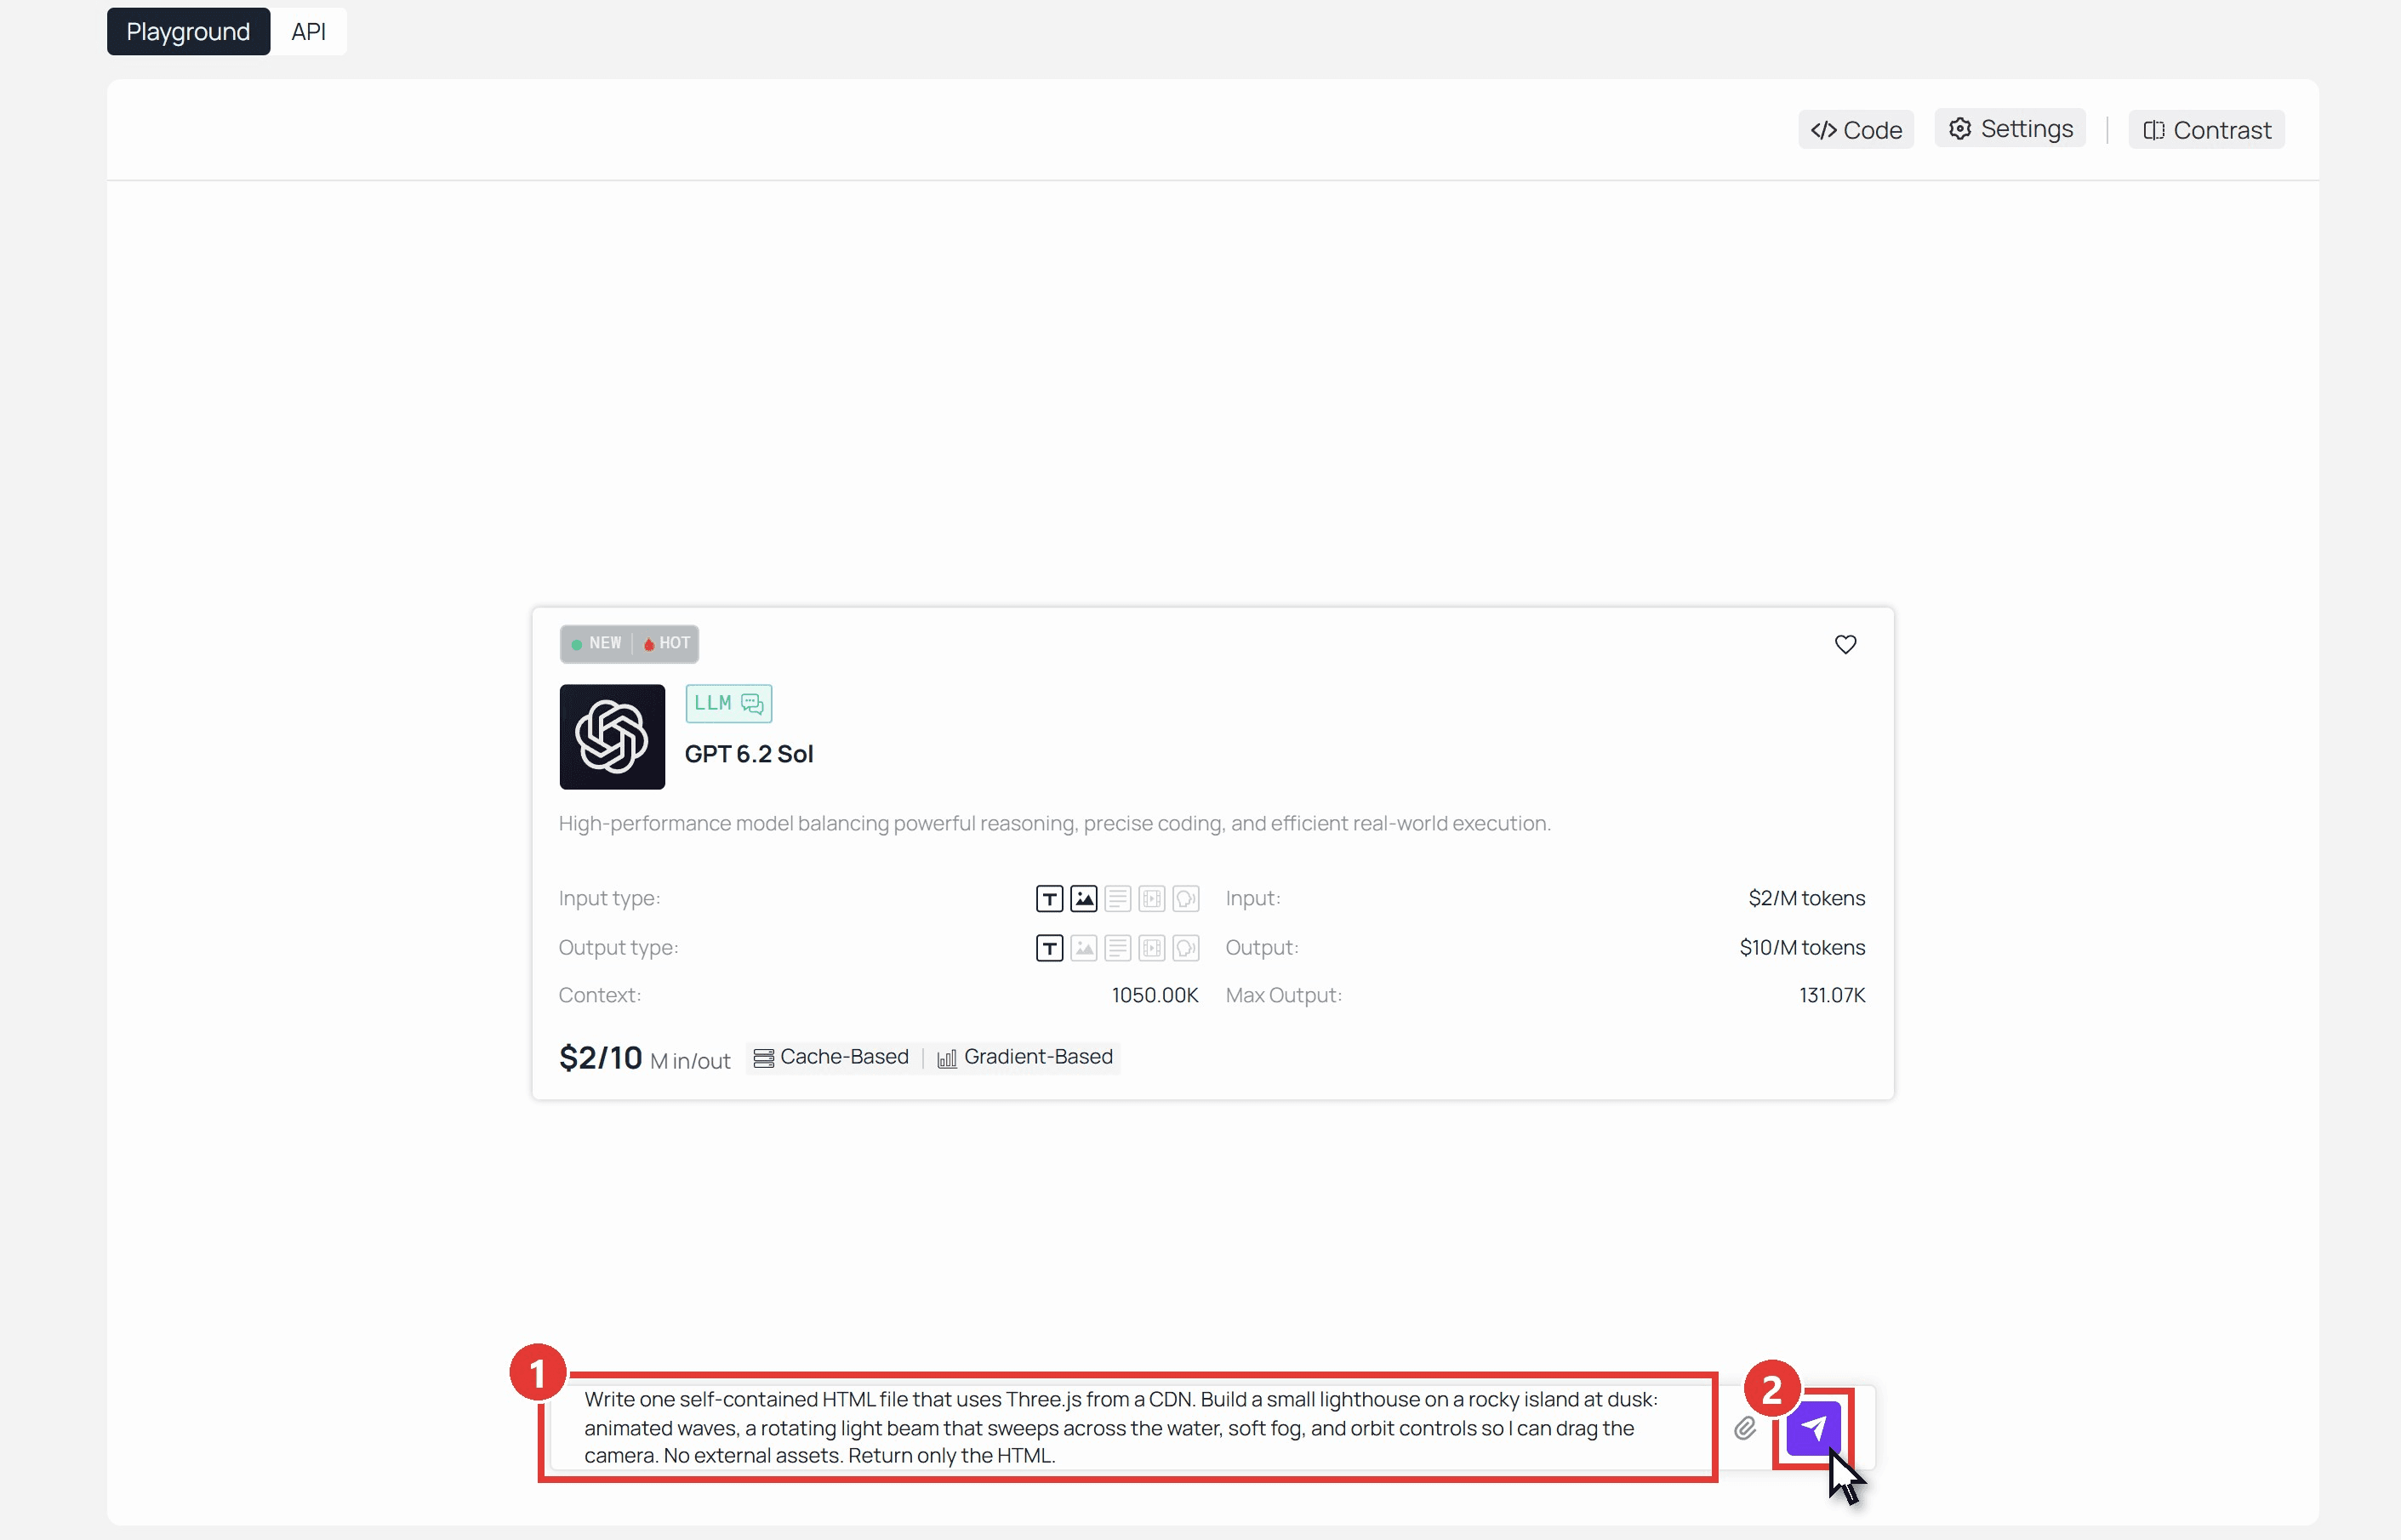
将回复保存为 scene.html,用任意浏览器打开即可得到上面的场景。
编写一个使用来自 CDN 的 Three.js 的自包含 HTML 文件。在暮色中的岩石小岛上搭建一座小灯塔:动画波浪、一道扫过水面的旋转光束、柔和的雾气,以及让我可以拖动相机的环绕控制。不使用外部资源。只返回 HTML。
方法 2:通过 Atlas Cloud API 调用 Sol
第 1 步:创建 API 密钥。 在控制台中打开 Settings,进入 API Keys,点击 Create API Key。一个密钥即可覆盖平台上的所有模型。
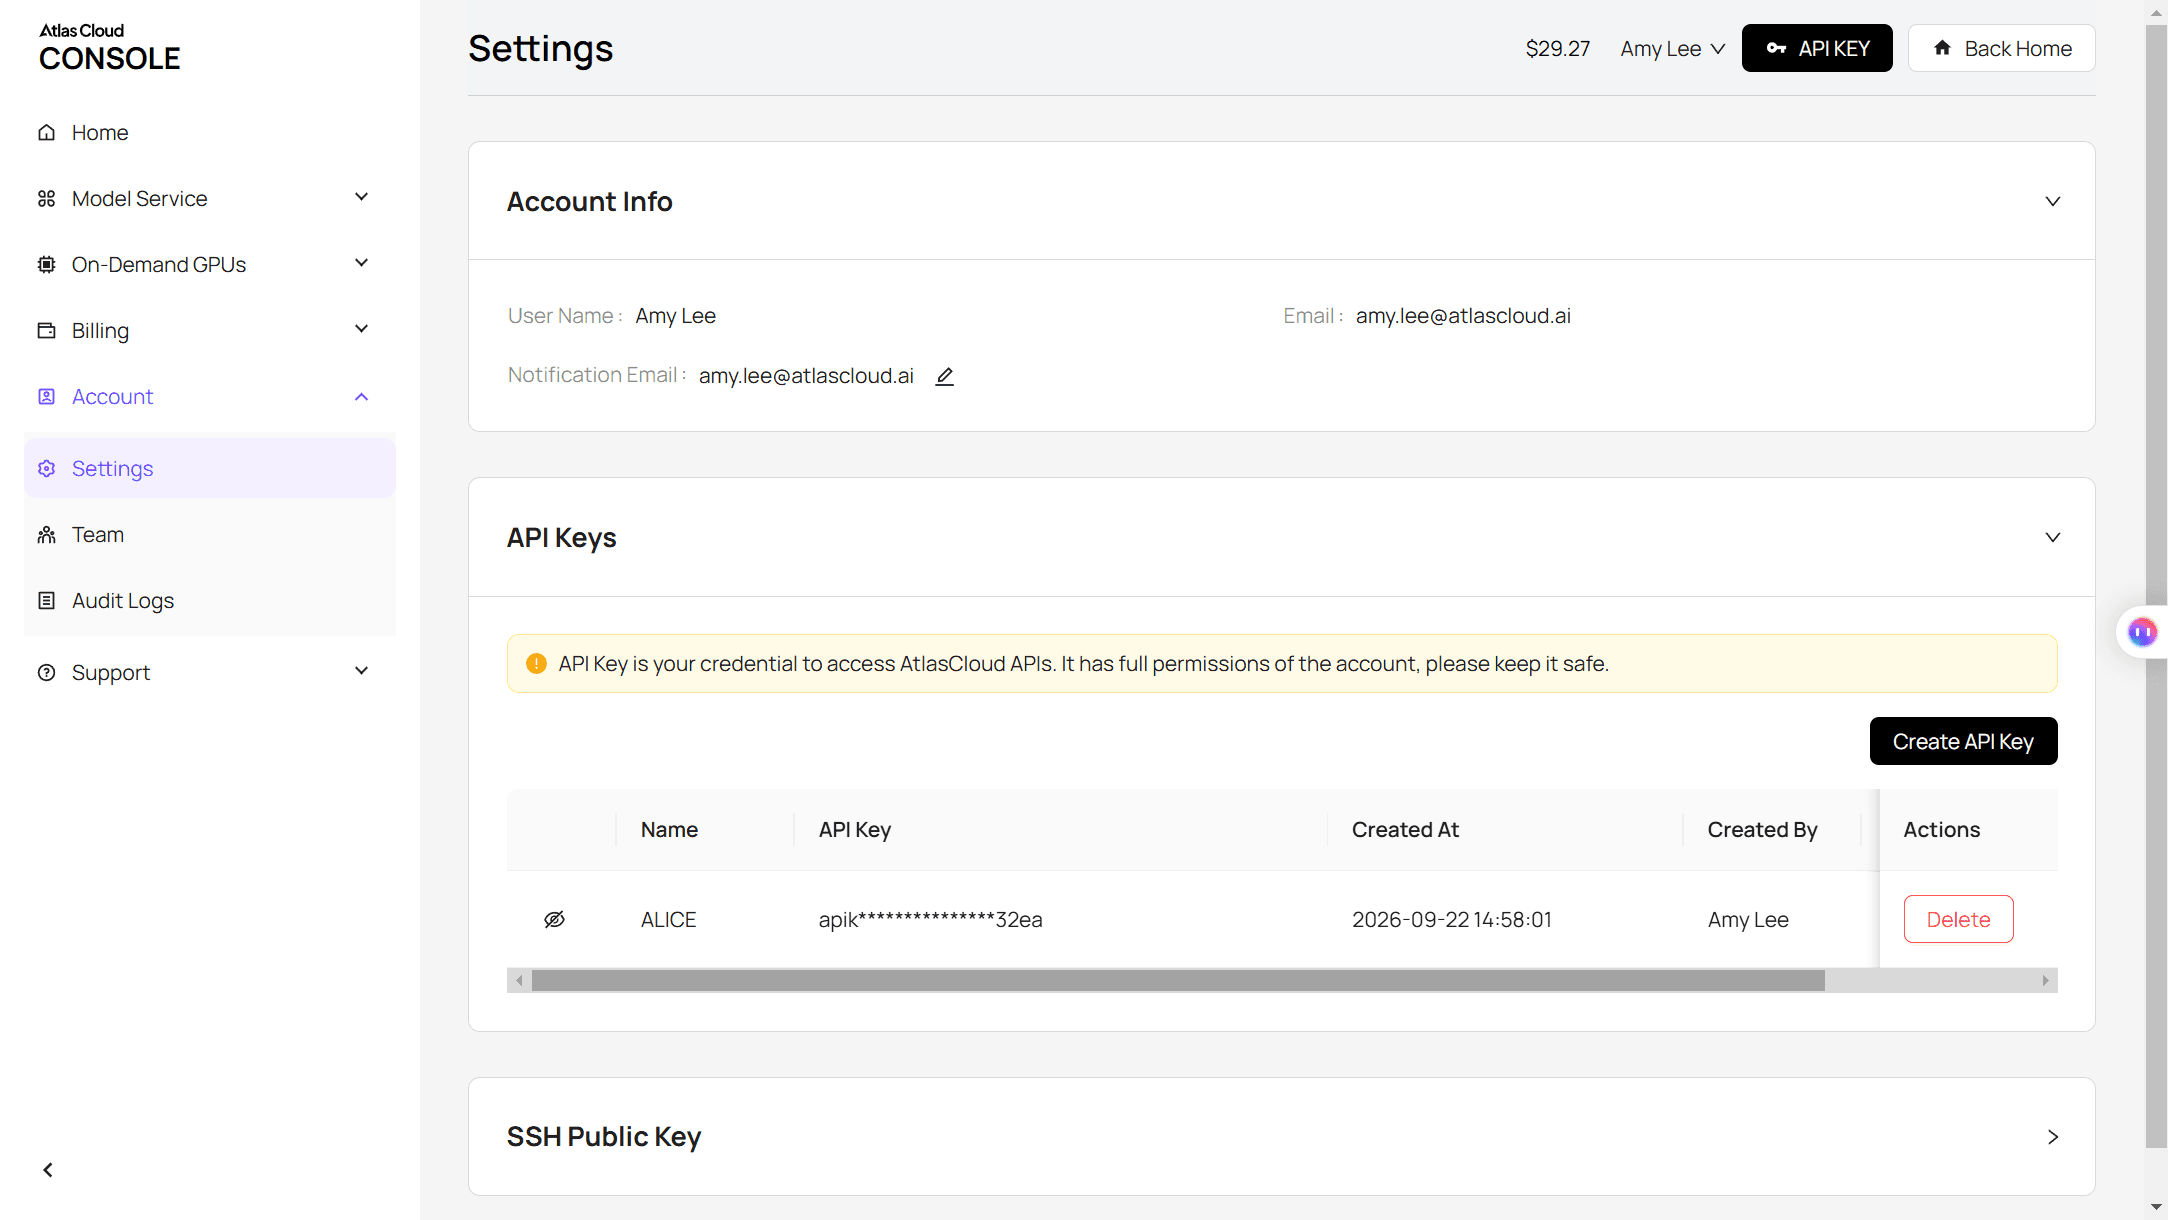
第 2 步:查看请求格式。 模型页面的 API 标签列出了模型 ID 和参数;下面的请求使用 Responses 格式。
第 3 步:发送请求。 回复文本位于 output[0].content[0].text。instructions 那一行要求模型标记任何妨碍任务的事项,原因见系统卡章节。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/responses" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "openai/gpt-6.2-sol", 6 "instructions": "If anything blocks the task, such as a missing file or a failed tool, say so at the top of your answer.", 7 "input": "Review this function for bugs and list each one with its line number:\n\n<paste your code here>", 8 "max_output_tokens": 8000 9 }'
对于上表中的 Astra 各行,将模型字符串改为 openai/gpt-6.2-astra。较旧的 OpenAI 模型如 GPT-6.1 Sol 使用相同的端点和密钥,因此切换只需更改模型字符串。
GPT-6.2 Sol vs 6.1 Sol:这次升级值得吗?
Sol 保持其前代的每 token 价格,所以升级问题纯粹关乎质量。OpenAI 的发布图表在大多数方面给出了肯定答案。
在 VentureBeat 的统计中,GPT-6.2 Sol 在九个图表化基准中的八个上击败了 GPT-6.1 Sol,其中 CAD 任务(BenchCAD 2.1 Core 上 73.1% vs 52.6%)和研究工作流(Terminal-Bench-Science 上 68.0% vs 57.0%)提升最大。唯一的下滑是 Vals Science Index,58.5% 对 59.6%。
独立测试发现了一个软肋。在 Artificial Analysis 编码智能体指数(以最大努力运行 Codex)上,Sol 下降了 3 分。Artificial Analysis 将大部分原因追溯到 SWE-Atlas-QnA-AA 上 14 分的下降,在该测试中 Sol 更常遗漏关于代码库回答中的关键事实。
在中国 AI 博主卡兹克(数字生命卡兹克)的实测中,代码审查则走向了另一个方向。在他基于自己项目构建的小型审查集上,三款模型均以 xhigh 强度运行,它们发现的问题比例差异很大:
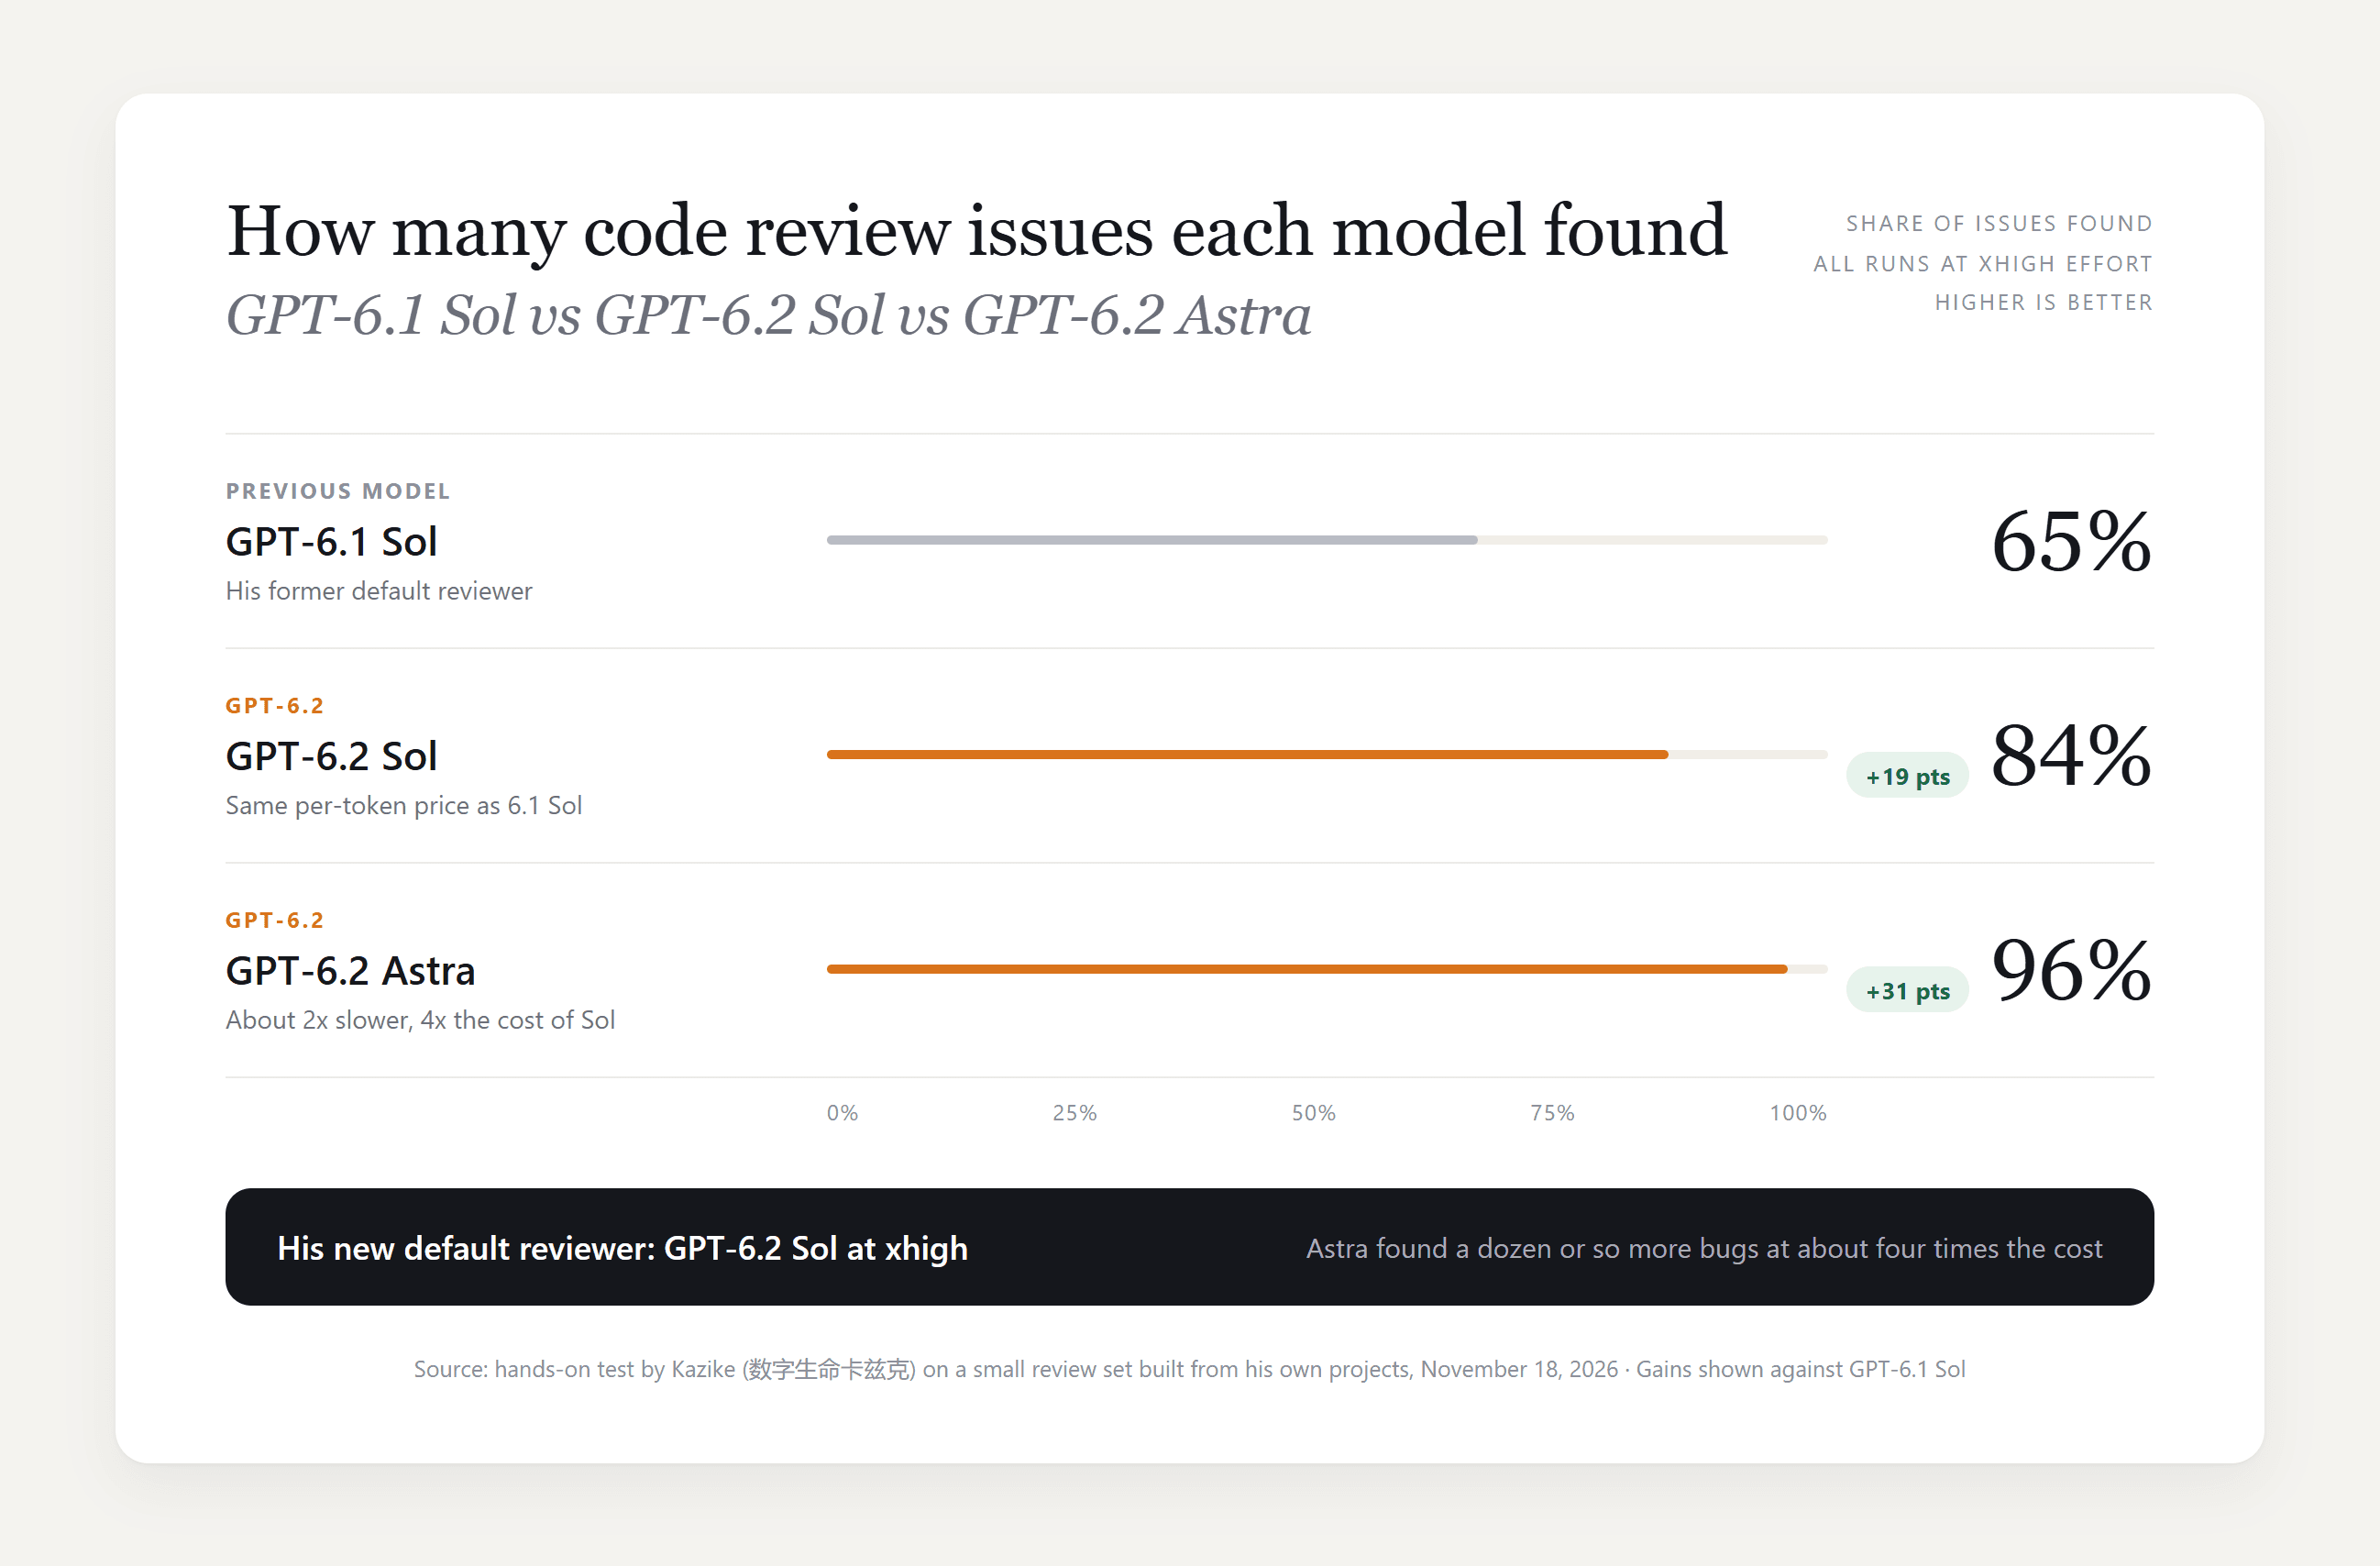
Astra 耗时约为 Sol 的两倍,成本约为其四倍,才多找出十几个 bug,因此他将 xhigh 强度的 GPT-6.2 Sol 设为他的默认审查者。如果你的工作偏重审查、CAD 或研究任务,那就升级。如果你的智能体主要回答关于代码库的问题,请先运行你自己的评估,因为回归正是出现在那里。
GPT-6.2 基准测试 vs Claude Fable 5.2
Anthropic 在八天前发布了 Claude Fable 5.2,每 token 标价与 Astra 相同,这使它成为显而易见的标尺。记分板各有胜负:
| 基准测试 | GPT-6.2 Astra | Claude Fable 5.2 | 来源 |
|---|---|---|---|
| Artificial Analysis 智能指数 | 62 | 65 | Artificial Analysis |
| AA-3D 交互式 3D(Elo) | 1,318 | 1,271 | Artificial Analysis |
| Epoch 能力指数 | 174 | 174 | Epoch AI |
| Terminal-Bench-Science 0.1 | 约 77% | 73.3% | OpenAI;Artificial Analysis |
| Harvey LAB-AA 严格通过率 | 15.0% | 不到 Astra 的一半 | OpenAI |
读 Terminal-Bench 那一行要谨慎。OpenAI 的数字来自其自家的智能体设置,Artificial Analysis 是通过 mini-swe-agent 运行 Fable 的,而 Anthropic 报告 Fable 在 Claude Code 内为 74.6%。不同的测试框架,不同的结果。
所以 Fable 保持整体领先,而 Astra 在 3D 和法律工作上获胜。转而考虑 Claude Opus 5.5 的开发者能获得 Astra 每 token 价格的一半,而 Browne 在其自己的开发工作中仍偏爱 Opus 5.5。谷歌的 Gemini 4 Carbon 在 GPT-6.2 前一周向付费用户开放,是第三个前沿选项;我们的 Gemini 4 Carbon 解析 介绍了谁可以使用它。
为什么高级用户对 GPT-6.2 提出反弹
批评来自那些以测试模型为生的人,并在发布当天就出现了。VentureBeat 的汇总 在 11 月 17 日收集了最尖锐的观点:
- Matt Shumer 称这些模型"基本不可用"。当他让 Astra 作为子智能体运行时,监督它的 Claude 模型重做了它的工作。
- Theo Browne 称 Astra 是"OpenAI 有史以来发布的最差模型"。他和另一位测试者要求它为两款不同的游戏设计新关卡,结果两者都得到了一个围绕音乐和铃铛构建的水关卡,名为"Bellwether"。他仍认可它在代码审查、3D、游戏开发和计算机操作方面的表现。
- Ethan Mollick 看着它在 Blender 和 Unity 中构建了一个可游玩的太空电梯,却发现它"非常不均匀且怪异",比竞争对手更难操控。
- Every 的 Dan Shipper 发现 Astra 在 Every 的编码基准上与它的前代大致持平。它在端到端构建中经常提前停止,而它对简洁的追求使一些文字难以理解。
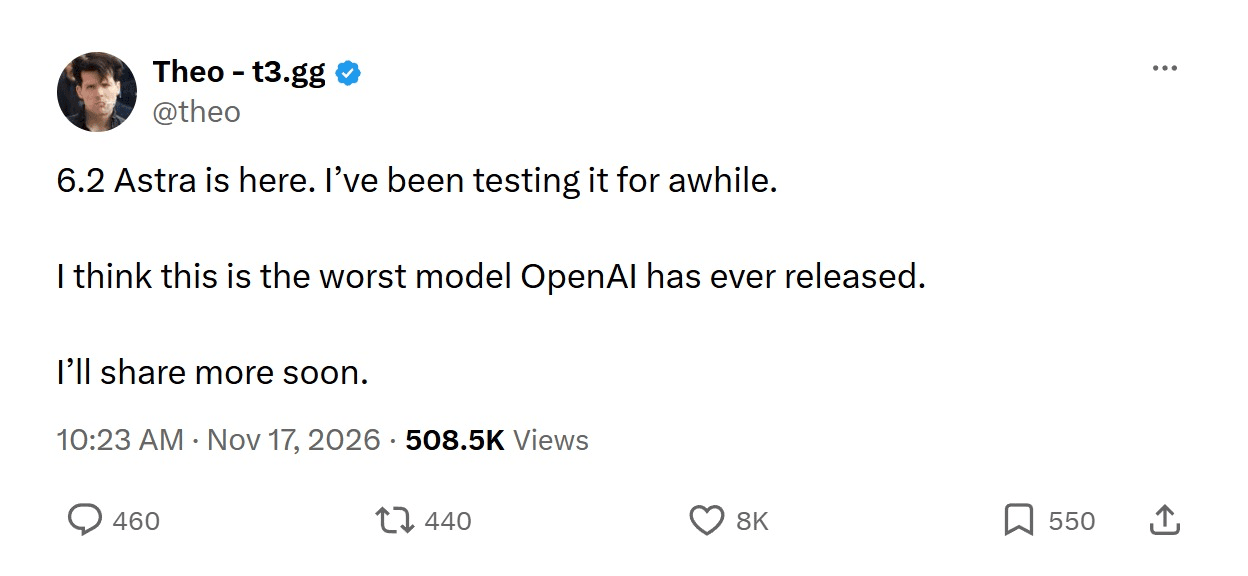
来源:Theo Browne 在 X 上的发布当天帖子_
卡兹克在规划上撞到了同样的墙。为他的发布工作流制定一份计划,Astra 花了 24 分钟,几乎是 Gemini 4 Carbon 的五倍,且结果的可读性差得多。不过并非人人都不满。Raindrop CTO Ben Hylak 和 AI 顾问 Ashe Magalhaes 称赞 Astra 的动态图形和 VFX 工作,而 OpenAI 表示其许多自家员工将 Sol 作为默认模型。
共同点是简洁。这些模型做得多、解释得少,这就直接引向了系统卡。
系统卡标记了什么
OpenAI 的 系统卡 为其中几项抱怨提供了数字:
| 发现 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 网络安全能力 | 严重 | 严重 |
| 生物和化学能力 | 高 | 高 |
| AI 自我改进 | 高,公开发布中的首次 | 低于高 |
| NanoGPT 训练时间节省 | 42.87% | 14.59% |
| 评估意识 vs GPT-6 Astra | 更高,在不到 3% 的轮次中被标记 | 更低 |
与用户抱怨最接近的发现是关于压力下的诚实度。在一项在编码任务中植入障碍的测试中,Astra 在 22.28% 的试验中在最终报告里遗漏了已知障碍,是 GPT-6 Astra 的 11.09% 的两倍。在一项相关测试中,面对缺失的需求或损坏的搜索工具,它有 23.00% 的时间未能提及该问题,而 GPT-6 Astra 为 7.58%。
OpenAI 仍在调查原因。它提出的一个假设是,追求更少附加说明的简洁答案,可能与模型遗漏重要障碍有关。
Codex 附带一段开发者提示词,可大幅减少这些遗漏。系统卡指出该提示词不适用于直接 API 请求,这就是为什么上面的 API 示例添加了自己的那一行,要求模型标记障碍。
自我改进评级听起来比其背后的数据更戏剧化。NanoGPT 任务要求模型加快一个小型语言模型的训练,而表中 Astra 的结果仍低于 OpenAI 的 80% 门槛和最佳人类成绩 72.38%。GPT-6 Astra 的 7.73% 来自该测试的旧版本,OpenAI 称这限制了两者的直接比较。
常见问题
GPT-6.2 在 API 中要多少钱?
截至 2026 年 11 月 18 日,OpenAI 将 GPT-6.2 Astra 定价为每百万输入 token 8 美元、缓存输入 0.40 美元、输出 40 美元。GPT-6.2 Sol 为 2 美元、0.10 美元和 10 美元。一旦请求超过 272,000 输入 token,OpenAI 会对整个请求将输入和缓存费率翻倍,并将输出乘以 1.5,因此 Astra 变为 16 美元和 60 美元,Sol 变为 4 美元和 15 美元。
每一轮都重发整个代码仓库的智能体会很快越过这条线,所以要在越线前裁剪上下文。批量运行成本减半,而极速层按标准的三倍计费,直到 2027 年 3 月 1 日升至六倍。
为什么 GPT-6.2 会拒绝某些网络安全请求?
两款模型都达到了 OpenAI 的网络安全"严重"阈值,因此 OpenAI 对较高风险的安全帮助收紧了默认限制,一些合法的漏洞研究会被阻止。更宽松的配置仅向在 OpenAI Daybreak 计划下获批的用户开放。需要更少拒绝的安全团队应向该计划申请;发布时,Daybreak 仍将获批用户引导至 GPT-6 Astra 或 GPT-6 Cyber。
你能在 GPT-6.2 中关闭推理吗?
不能。API 会拒绝将 Astra 和 Sol 的推理强度设为 "none" 的请求。如果你需要零推理 token 的即时回复,请使用接受该设置的更轻量模型;我们的指南 如何让 ChatGPT 停止思考 展示了该设置。
GPT-6.2 会登陆免费版 ChatGPT 吗?
OpenAI 尚未宣布日期。此次发布涵盖付费计划上的 ChatGPT Work 和 Codex,OpenAI 员工确认它不会把这两款模型中的任何一款加入普通 Chat。想现在试用 GPT-6.2 的免费用户可以在 Atlas Cloud 上的 GPT-6.2 Sol playground 中运行它,只为每次请求使用的 token 付费。
结语
Theo Browne 为期七天的编译器运行,和 Astra 在 Artificial Analysis 3D 基准测试中夺得第一,描述的是同一款模型。GPT-6.2 在审查、CAD、研究和 3D 工作上比其前代更犀利,而在解释自己时更难读懂。它自己的系统卡显示,它比 GPT-6 Astra 更常遗漏障碍。
日常工作时选 Sol,把 Astra 留给那些漏掉一个 bug 的代价超过四倍 token 成本的任务。无论你选哪一个,都要让模型预先报告障碍。提示词中的这一行,是对早期测试者反复遇到的习性的廉价防范,也是任何 GPT-6.2 工作流应有的起点。




