大多数创作者根据静态 Arena 排行榜选择图像模型,结果却发现逼真的人像在三次编辑轮次后就崩坏了。在这场针对 GPT Image 2.5 与 Qwen Image 2.1 的真实世界基准测试中,OpenAI 在零样本照片级真实感方面胜出,而 Qwen 2.1 在迭代修改过程中的背景结构稳定性方面领先。
实证基准测试摘要
| 实证指标 | GPT Image 2.5 | 评分 | Qwen Image 2.1 | 评分 |
| 零样本真实感 | 照片级真实皮肤与自然 RAW 光照 | ★★★★☆ (4.5) | 细节锐利;皮肤略显光滑/油腻 | ★★★☆☆ (3.0) |
| 多轮稳定性 | 第 5 轮时出现全局噪点与比例偏移 | ★★★☆☆ (3.5) | 背景锁定;零结构衰减 | ★★★★☆ (4.0) |
| 材质保留 | 真实的深色羊毛与阴影纹理 | ★★★★☆ (4.5) | 高对比度;存在光泽/塑料感漂移风险 | ★★★☆☆ (3.0) |
| 编辑控制 | 视觉定位点;全画布重新编码 | ★★★★☆ (4.0) | 绘制蒙版与原生透明 RGBA | ★★★★☆ (4.5) |
| 最佳生产适配 | 高端单次商业资产 | 4.1 / 5 | 自托管工作流与锁定背景编辑 | 3.6 / 5 |
核心要点
- GPT Image 2.5 在单次照片级真实感方面表现出色,能在单次渲染中呈现真实的皮肤半透明感和类 RAW 动态范围。然而,其全画布重新编码会导致全局噪点累积,并在第 5 轮时出现解剖学透视缩短。
- Qwen Image 2.1 利用 32 层 DiT 与 KV 缓存锁定,在多轮编辑中保持背景几何完全无伪影。代价在于局部处理:重复的目标蒙版编辑往往会过度饱和镜面高光,使自然皮肤变得油腻,哑光面料变得有光泽。
当你的首要目标是纯净的单次真实感时,选择 GPT Image 2.5。如果你的流程需要自托管控制、锁定背景编辑或原生 RGBA 抠图,则选择 Qwen Image 2.1。
单提示词照片级真实感:光照物理、皮肤纹理与材质保真度
擅长提示词工程的创作者常常花费数小时微调光照提示词,结果却发现视觉缺陷源自基线渲染,而非迭代编辑。在发出修改指令前测试零样本视觉保真度,可以建立必要的对照基线,帮助摄影师将模型固有的局限性与此前多轮编辑造成的真实退化区分开来。
测试 1:强烈直射光下的人体皮肤微观细节
为了评估压力条件下的原始渲染机制,两个模型均使用未经修饰的近距离人像提示词进行测试,该提示词包含强烈的正午阳光、皮肤纹理变化和解剖学微表情。
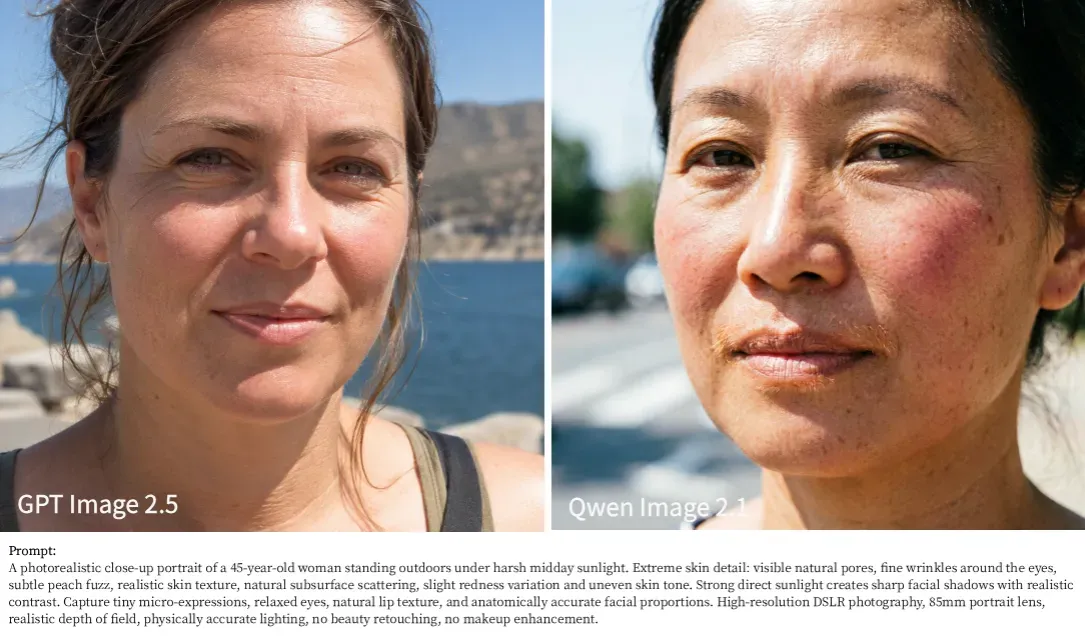
关键视觉观察与细节分析:
- 次表面散射与阴影过渡(GPT Image 2.5 胜出):
GPT Image 2.5 以极高的准确度模拟光学物理。在 85mm 人像设置中,光线自然地漫射过脸颊和额头,产生真实的次表面散射,同时眼周和鼻梁周围呈现平滑的阴影衰减。
- 字面提示词遵循与塑料感(Qwen Image 2.1 的权衡):
Qwen Image 2.1 对详细提示词的响应非常紧密,能准确渲染面部绒毛和不均匀的脸颊色素沉着。然而,其镜面高光可能显得过于刺眼,在鼻子和额头上留下不自然的油光。
- 微表情与解剖学准确性:
GPT Image 2.5 渲染出极其放松的面部肌肉,眼角皱纹和唇纹在解剖学上精确。虽然 Qwen 2.1 实现了高表面锐度,但在放大后皮肤纹理显示出微观图案重复,在高对比度光照下暴露出其合成扩散的根源。
测试 2:面料与材质保真度(羊毛粗糙度与轮廓光)
理解物理材质交互——例如哑光羊毛的光吸收与编织亚麻上不均匀竹节纹理的差异——对电商和商业时尚工作流至关重要。
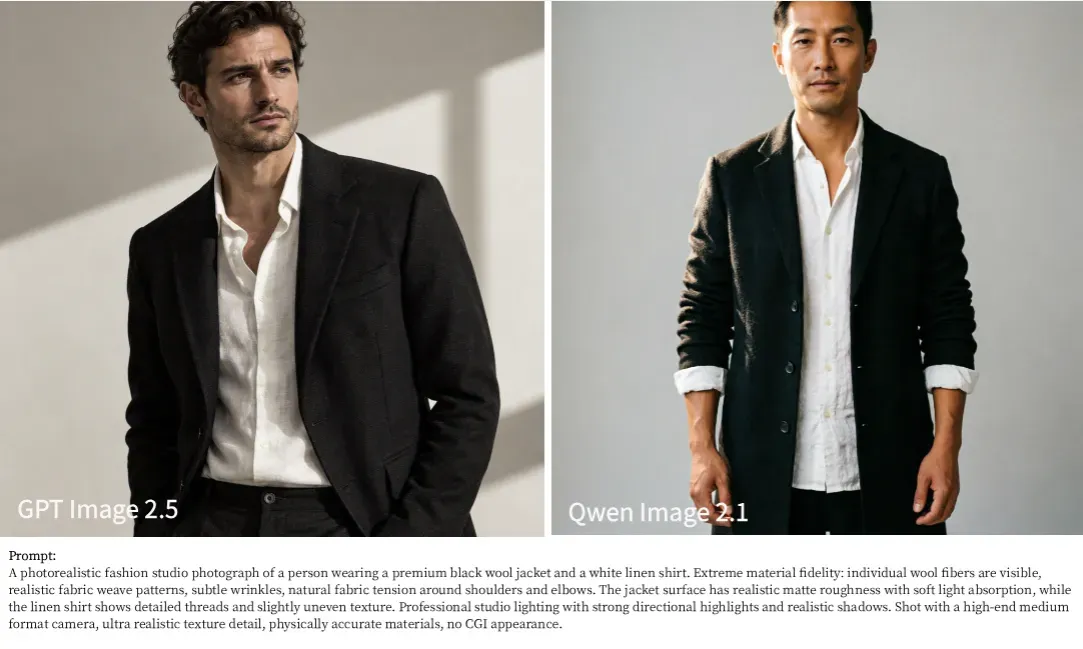
关键视觉观察与材质响应:
- 深色面料分离度与阴影深度(GPT Image 2.5 胜出):
GPT Image 2.5 在不牺牲细节的情况下处理低频暗色调。黑色羊毛夹克上的褶皱、翻领缝线和细微微观阴影仍然可见,同时白色亚麻衬衫上的真实编织纹理和纽扣张力痕迹也得到平衡呈现。
- 边缘分离与轮廓光精度(Qwen Image 2.1 的优势):
Qwen Image 2.1 在直接定向光照控制方面表现出色。捕捉深色外套边缘的轮廓光明确突出了肩部和手臂上的微观羊毛纤维。
- 材质密度与阴影压缩(Qwen Image 2.1 的局限):
虽然 Qwen 2.1 产生了异常锐利的外部轮廓,但其深色羊毛的渲染在非光照区域倾向于阴影压缩和死黑。与 OpenAI 的 Sunburst 层级相比,夹克内部褶皱失去了细微的编织图案,导致阴影下的整体材质响应更加平淡。
测试 3:产品摄影、金属拉丝纹理与镜面反射
评估金属镜面高光、玻璃折射和环境反射,可以揭示模型在商业产品摄影中实现 PBR 渲染管线的忠实程度。
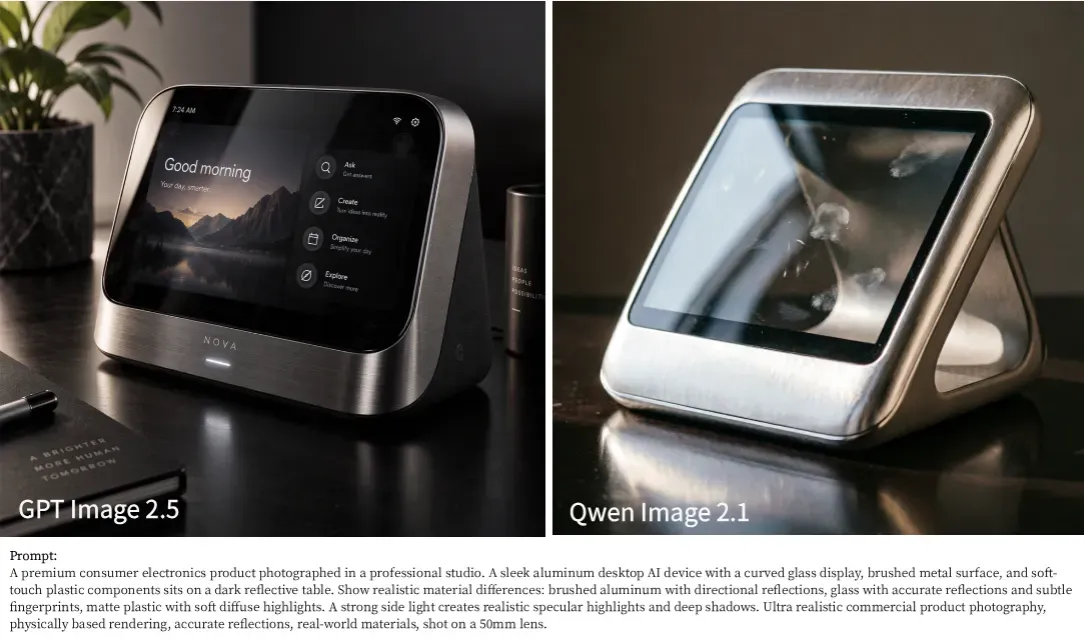
关键视觉观察与光学物理:
- 金属表面物理与各向异性反射(GPT Image 2.5 胜出):
GPT Image 2.5 以高精度处理拉丝铝材。下边框上的水平纹理自然地沿纹理反射镜面高光,避免了喷漆金属的扁平外观。它还能在逼真的玻璃反射下清晰分层呈现锐利、可读的 UI 元素。
- 锐利镜面边缘高光与玻璃污渍(Qwen Image 2.1 的优势):
正如对工业设计主体的预期,Qwen Image 2.1 在渲染高对比度镜面反射方面表现出色。玻璃表面上的直接柔光箱反射具有干净、清晰的边界几何形状。它还严格遵循了指纹污渍要求,以高视觉冲击力捕捉玻璃上的微观瑕疵。
- 反射桌面衰减与材质区分:
虽然 Qwen 2.1 渲染出引人注目的高光边缘,但其金属框架在阴影区域略偏向光滑的银色塑料。相比之下,GPT Image 2.5 在拉丝金属正面、深色哑光塑料背板和光泽玻璃显示屏之间保持了清晰的材质区分,同时在深色桌面上保留了自然的镜面衰减。
测试 4:复杂 HDR 环境、动态范围与大气雾霾
高对比度环境,如雨后逆光街道及其反光湿路面和浓重阴影,能清晰暴露模型曝光准确度的极限。
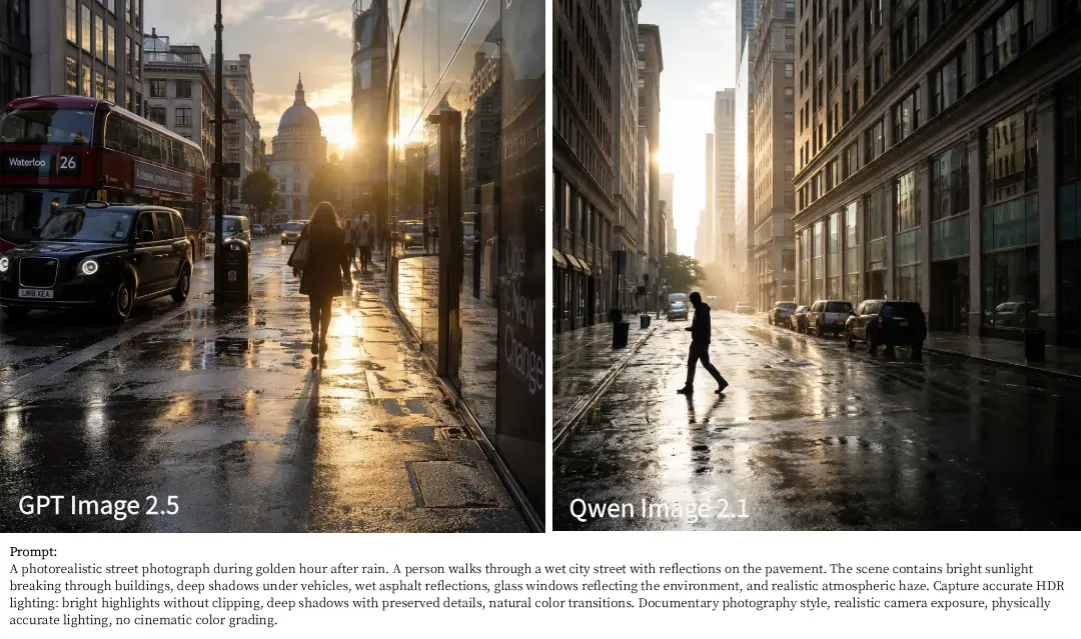
关键视觉观察与曝光机制:
- 宽广动态范围与阴影细节保留(GPT Image 2.5 胜出):
GPT Image 2.5 展现出卓越的相机传感器模拟能力,仿若全画幅 RAW 曝光。即使背景建筑中透出直接的金色时刻阳光,它仍保留了左侧双层巴士和黑色出租车下方的出色阴影细节,清晰渲染出车牌文字和轮胎轮廓,同时天空中的明亮高光没有过曝。
- 路面反射清晰度与边缘锐度(Qwen Image 2.1 的优势):
Qwen Image 2.1 擅长渲染清晰的环境反射。前景中的湿沥青捕捉到行人行走和 tall stone 立面的锐利镜面反射。其在复杂建筑窗户上的整体几何清晰度保持得异常干净。
- 高光裁切与大气衰减:
虽然 Qwen 2.1 在湿地面渲染出引人注目的镜面光痕,但其曝光引擎在强烈逆光区域遭受轻微高光裁切——在太阳与地平线交汇处产生纯白色光斑。相比之下,GPT Image 2.5 以更高的光学准确度处理体积雾霾和微妙的金色光线衰减,避免了刺眼的裁切伪影。
总结评分卡:照片级真实感基准测试(测试 1–4)
为综合我们在四项严格照片级真实感基准测试中的发现,下表突出了每个模型在八项关键视觉保真度指标上的优势领域。
| 类别 | GPT Image 2.5 | Qwen Image 2.1 | 核心光学差异 |
| 皮肤毛孔 | ✓ | GPT 2.5 渲染真实的皮肤微观纹理和细微毛孔,没有 AI 磨皮感。 | |
| 微表情 | ✓ | GPT 2.5 捕捉有机的面部肌肉张力和温度感,避免僵硬表情。 | |
| 阴影深度 | ✓ | GPT 2.5 在车辆和建筑下方保留深色阴影细节,具有完整的类 RAW 动态范围。 | |
| 面料纹理 | ✓ | GPT 2.5 渲染自然的羊毛编织和触感有机纤维绒毛,没有过度锐化。 | |
| 镜面高光 | ✓ | Qwen 2.1 在湿路面和金属表面产生锐利、高对比度的镜面反射。 | |
| 产品材质 | ✓ | GPT 2.5 在混合哑光和光泽纹理之间实现物理准确的漫射/镜面平衡。 | |
| 干净边缘 | ✓ | Qwen 2.1 在锐利几何线条、硬表面建筑和边缘清晰度方面表现出色。 | |
| 自然真实感 | ✓ | GPT 2.5 呈现未经编辑的纪实风格相机外观,没有合成的“AI 光泽”。 |
单提示词测试的核心要点:
- GPT Image 2.5 纪实照片级真实感综合胜出者:在有机人体物理皮肤/表情、复杂阴影深度和自然色彩科学方面占主导地位。它避免了高对比度场景的裁切,使其成为商业人像、写实街头摄影和编辑设计的首选。
- Qwen Image 2.1 最适合锐利建筑与硬表面:通过超干净的边缘、锐利的镜面高光和建筑精度展现出卓越的视觉冲击力,尽管它倾向于更高的光学对比度并偶尔出现高光裁切。
多轮迭代编辑压力测试:5 轮退化基准测试
创意总监常常目睹一张完美的 AI 人像在仅仅三次连续提示词修改后就退化成像素化的泥浆。为了在不依赖厂商营销声明的情况下评估多步骤提示词保真度,两个系统都接受了标准化的 5 轮编辑压力测试。
5 步基准测试方法论
压力测试通过五个连续编辑指令测量主体保留度、背景替换保持度和逐轮质量损失:
- 第 1 轮(基础): 在工作室环境中渲染的高细节照片级真实人像。
- 第 2 轮(主体编辑): 更改服装颜色和夹克材质,同时保留面部身份。
- 第 3 轮(背景替换): 将主体从工作室环境移至日落时的户外城市街道。
- 第 4 轮(光照调整): 将环境光源切换为高对比度霓虹夜景反射。
- 第 5 轮(微观细节添加): 添加逼真的雨滴和皮肤水反射。
模型在迭代轮次中的表现
逐轮评估两个视觉引擎,突出了潜空间噪点在多轮修饰过程中累积方式的关键架构差异。
| 编辑轮次 | GPT Image 2.5 表现 | Qwen Image 2.1 表现 |
| 第 1–2 轮 | 完美的主体保留和服装纹理调整;第 2 轮背景替换时自然的金色时刻轮廓光包裹。 | 第 1 轮清晰的面部保留;第 2 轮有效替换背景,尽管环境光包裹和背景虚化感觉不如 GPT 2.5 自然。 |
| 第 3 轮 | 平滑的背景与霓虹重新光照处理,具有逼真的肤色和微妙的氛围光晕。 | 过度饱和的霓虹高光创造出异常油腻、塑料感的面部皮肤纹理。 |
| 第 4 轮 | 干净地重新照亮面部轮廓;保留哑光棉质外套纹理和微妙的表面湿度。 | 严重的材质崩坏:哑光风衣变为不自然的光泽乙烯基/塑料雨衣。 |
| 第 5 轮 | 扩展为全身,但产生尴尬的身体比例和不自然的透视缩短。 | 比例良好的构图:渲染解剖学准确的全身行走姿态,尽管持续的油腻皮肤反射降低了整体真实感。 |
视觉迭代进程(5 轮基准测试
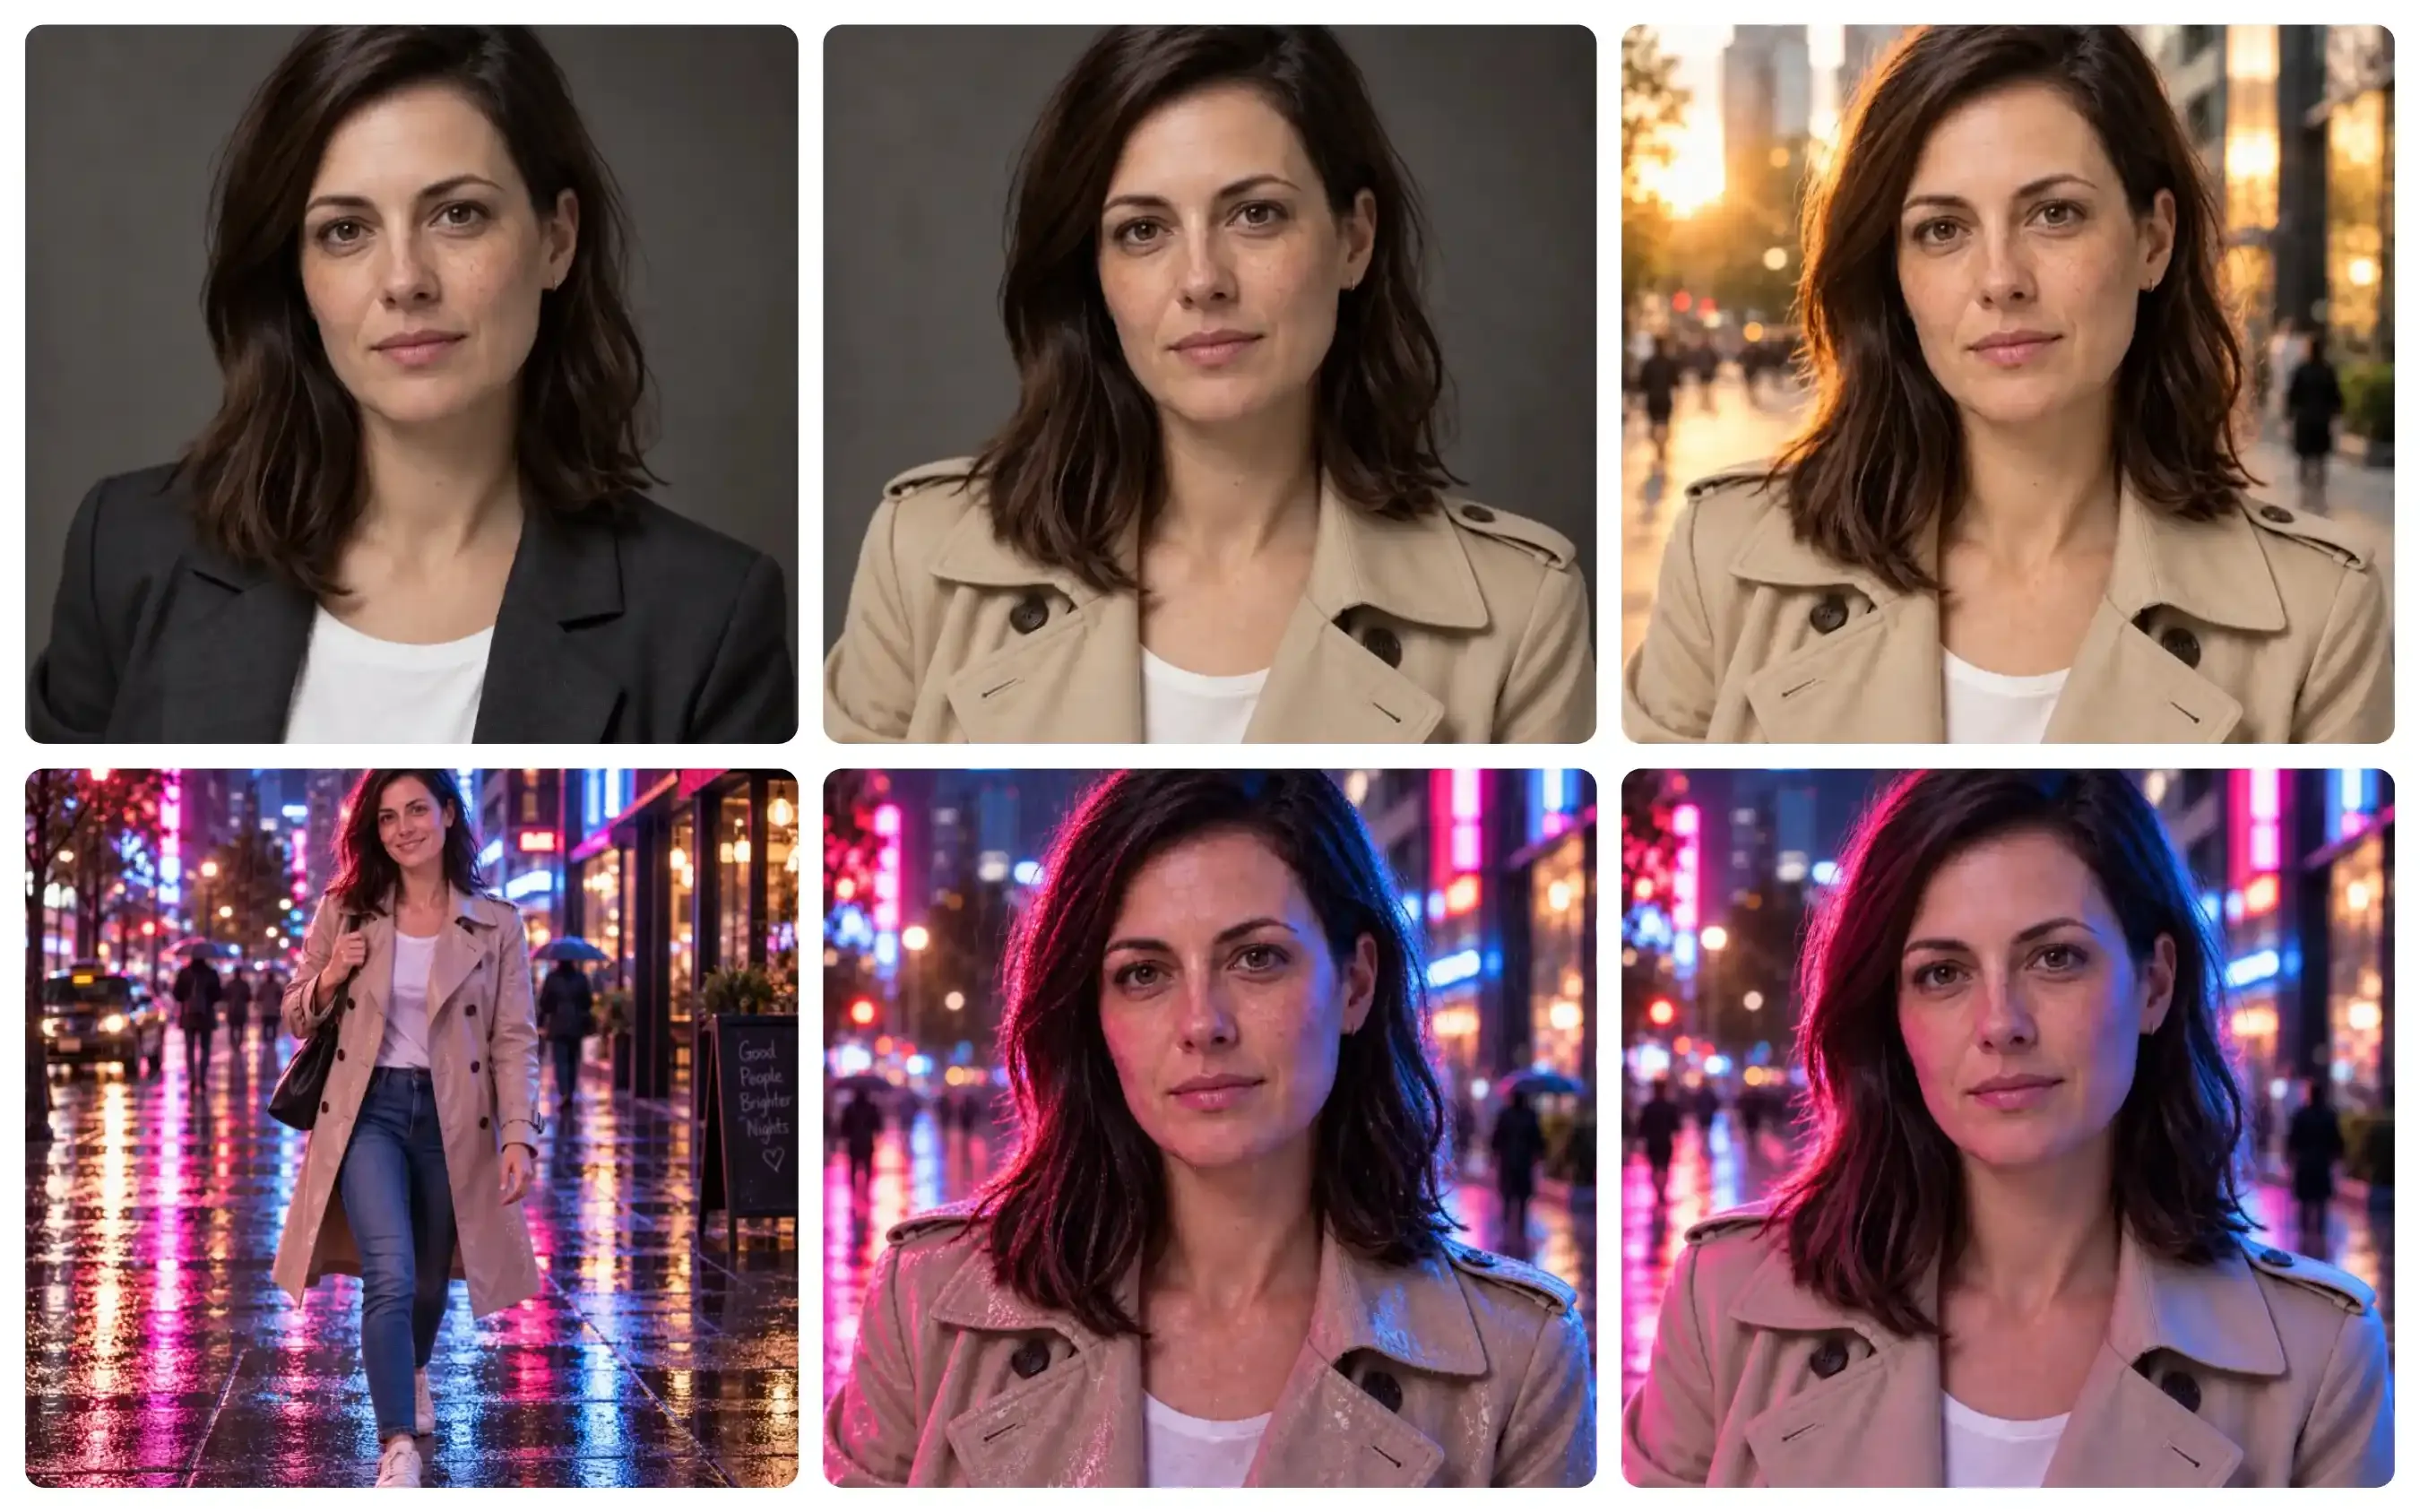
GPT Image 2.5 多轮迭代序列面板 1–6,第一张图为基础图像。
在 GPT Image 2.5 迭代编辑过程中,Sunburst 模型在所有轮次中保持了强烈的面部身份和逼真的光线包裹。它在背景和重新光照处理(第 2 和第 3 轮)中自然地整合了复杂的环境逆光,将主体无缝融入霓虹和金色时刻环境,没有合成伪影或面料纹理崩坏。然而,在第 5 轮的全身扩展中,它引入了轻微扭曲的身体比例和尴尬的透视缩短。
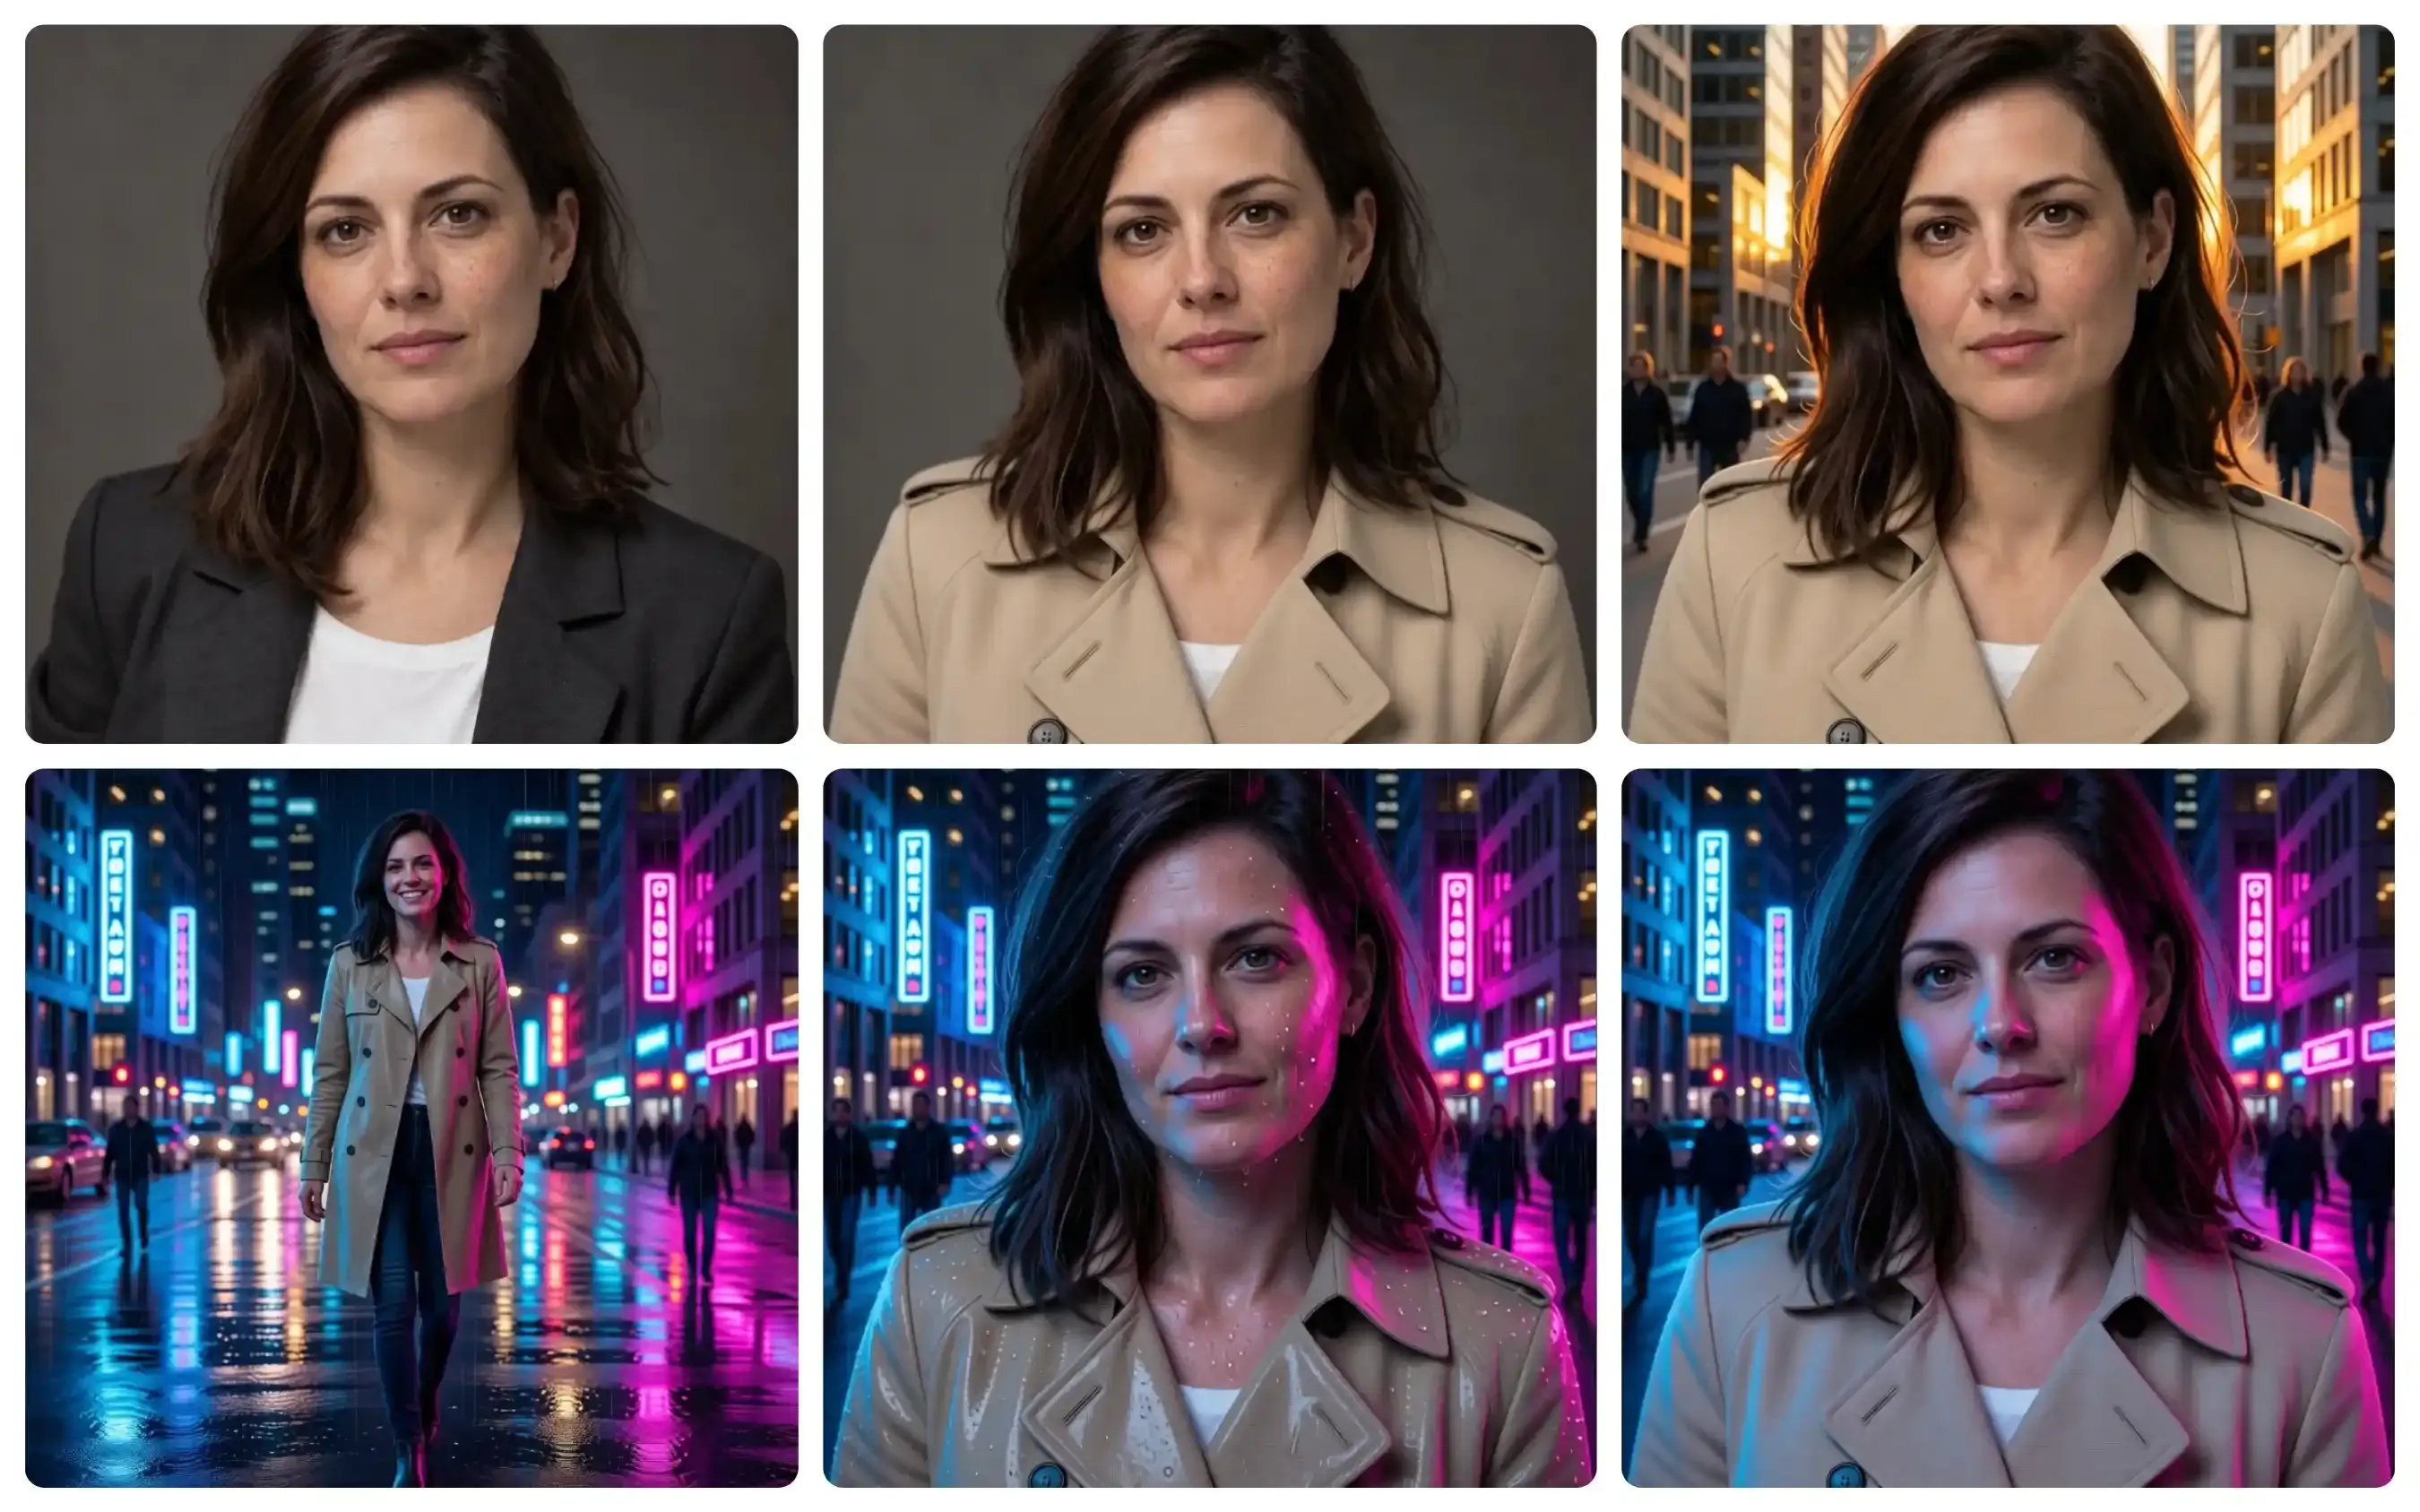
Qwen Image 2.1 多轮迭代序列面板 1–6,第一张图为基础图像。
相比之下,Qwen Image 2.1 在初始主体保留和背景放置方面表现良好,但随着编辑累积显示出明显的潜空间漂移。虽然第 2 轮背景替换在结构上合理,但其光线整合不如 GPT 细腻。随后的重新光照和雨水处理(第 3 和第 4 轮)触发了材质偏移,将服装的棉质纹理变为高光泽塑料雨衣,同时皮肤高光过度饱和。
“块状”伪影现象:为什么迭代图像编辑会降低质量
重复的提示词修改经常侵蚀微观纹理,将精致的头发变成块状伪影,过度饱和皮肤反射,并将哑光面料变异为光泽塑料。 T这一模式直接源于视觉引擎在连续编辑中管理潜空间变换的根本架构差异。
架构机制与像素退化
| 技术参数 | OpenAI GPT Image 2.5 管线 | Qwen Image 2.1 DiT 框架 |
| 重新编码方法 | 全画布 VAE 重新编码 | 前缀 KV 缓存复用与分块掩码 |
| 噪点累积 | 全局潜空间漂移 | 限制在局部编辑蒙版内 |
| 5 轮基准测试中的观察效果 | 自然的环境光混合;后期轮次中出现微妙的全局噪点累积和解剖学/比例偏移。 | 高背景结构刚性;局部潜空间重新处理导致镜面饱和(油腻皮肤)和材质崩坏(棉质变乙烯基)。 |
| 缓解策略 | 扩展采样(Sunburst 模式) | 混合粒度注意力与蒙版隔离 |
将架构与基准测试发现联系起来
理解架构选择如何影响多轮像素衰减,直接解释了我们的 5 轮压力测试结果:
- 全潜空间重新编码(GPT Image 2.5):
在全帧工作流中,GPT Image 2.5 在每个编辑轮次中重新编码整个潜空间画布。正如我们在_单提示词照片级真实感_测试中所展示的,这种全局方法擅长计算复杂的光学交互——例如在第 2 轮中计算头发和皮肤上的自然金色时刻轮廓光。然而,由于每次处理都处理整个画布,扩散噪点在多轮中全局累积。到第 4 和第 5 轮时,这会产生微妙的高频细节损失、阴影中的宏像素量化,以及全身帧扩展时的解剖学透视缩短。
- 局部蒙版与缓存复用(Qwen Image 2.1):
Qwen 2.1 的 32 层单流 DiT 架构利用分块级掩码和前缀 KV 缓存复用。静态上下文计算在去噪步骤中锁定未编辑区域,消除背景像素的重新编码损失,并保持锐利的建筑线条。然而,由于生成更新被限制并在局部蒙版内重度处理,对同一子区域的重复处理往往过度饱和镜面高光——这解释了第 3 轮中向油腻皮肤反射的转变,以及第 4 轮中外套材质从哑光棉到高光泽乙烯基的变化。
虽然 GPT Image 2.5 的 Sunburst 模式使用扩展采样在早期轮次中保持卓越的光照物理和有机皮肤纹理,但其全局处理最终导致微妙的画布级漂移。相反,Qwen Image 2.1 通过 KV 缓存锁定未编辑 token 来防止背景几何退化,但需要谨慎的提示词处理,以避免在延长修饰链中局部高光饱和。
编辑机制与工作流控制:评论高亮 vs 局部蒙版
提示 AI 模型替换模特的夹克,往往导致系统重新设计背景或改变面部特征。精确的输入机制决定了更新是保持局部化还是在迭代编辑中破坏其余构图。
比较 GPT Image 2.5 与 Qwen Image 2.1,揭示了两种截然不同的操作框架,用于维持多步骤提示词保真度。
控制界面与输入机制
| 功能能力 | GPT Image 2.5 画布工具 | Qwen Image 2.1 编辑系统 |
| 局部目标选择 | 坐标定位点与矢量笔触 | 绘制标注、圆圈或二进制蒙版文件 |
| 参考图像锚定 | 支持最多 16 张参考图像 | 支持最多 10 张参考图像 |
| 像素隔离 | 全帧潜空间重新编码处理 | 前缀 KV 缓存与分块级蒙版锁定 |
| 图层输出选项 | 标准 RGB 输出 | 原生透明 RGBA 生成 |
精确定位标注 vs 边界蒙版
OpenAI 依赖 ChatGPT 界面内的坐标定位点和手绘矢量笔触。通过 ChatGPT 评论编辑功能放置坐标定位点,向目标区域发出语义文本更新信号,而草图引导工作流使用绘制的矢量线来指导布局几何。将参考图像锚定与最多 16 张输入图像结合,可保持主体风格在各变体间的一致性。然而,由于底层模型重新编码整个图像画布,定位点坐标之外仍可能出现轻微的像素渗漏。
相反,Qwen Image 2.1 通过允许用户绘制标注、在多个编辑目标周围画彩色圆圈或提供单独的二进制蒙版文件,强制执行严格的局部蒙版编辑。其突出能力——原生透明 RGBA 生成——允许创作者直接使用真实 alpha 通道生成或编辑透明抠图,绕过后期处理背景移除工具。虽然参考图像锚定支持最多 10 张输入图像,但将未编辑像素锁定在明确的蒙版边界后面,能获得更高的用户意图准确度并防止不必要的全局偏移。
在多轮 AI 编辑中防止伪影累积的实用变通方法
目睹一张精修的商业合成图在第四次提示词修改时退化为模糊像素,迫使制作团队丢弃数小时的编辑进度。实施结构化的多轮编辑变通方法,可以让创作者在复杂修改工作流中保持图像清晰度并避免像素退化。
干净 AI 图像编辑的制作策略
应用四种针对性的制作技术,帮助团队在多轮生成中防止 AI 图像退化:
- 参考重新锚定: 将原始第 1 轮基础生成作为显式参考图像与最新编辑提示词一起重新注入,迫使模型重新对齐面部比例和背景光照向量。这种参考图像重新锚定技术有助于在连续生成过程中重置潜空间漂移。
- 策略性精度层级选择: 在 GPT Image 2.5 Flare 上执行快速视觉草稿,与早期模型相比可将延迟降低 50%。切换到 Sunburst 质量层级(
xhigh或max)进行最终编辑处理,应用扩展采样时间以保留复杂细节并限制重新编码噪点。 - 隔离局部蒙版: 利用 Qwen Image 2.1 的蒙版边界编辑,将生成更新严格限制在目标边界内。提供显式二进制蒙版或绘制标注,确保未编辑的背景像素完全绕过去噪管线,保持原始图像锐度。
- 单次复合提示词: 将多个小型编辑请求合并为一次整合指令处理,避免多轮质量衰减。实践复合提示词,在单一步骤中更改夹克颜色、背景环境和光照角度,减少总重新编码周期。
遵循这些实用的 GPT Image 2.5 编辑技巧,使设计师能够交付在多步骤商业项目中经得起仔细检查的干净 AI 图像编辑。
最终决策指南:你应该为工作流选择哪个模型?
仅基于静态排行榜分数选择图像生成平台,往往会在复杂客户修改到来时导致生产瓶颈。选择最佳 AI 图像编辑模型取决于你的创意团队是优先考虑商业零样本完美度,还是迭代编辑管线中的开源权重灵活性。
生产对比矩阵
| 工作流需求 | GPT Image 2.5 (Sunburst / Flare) | Qwen Image 2.1 (7B DiT) |
| 主要部署 | 托管 API 与 ChatGPT UI | 开源权重自托管 |
| 最大原生分辨率 | 4K API 输出(最高 3840px) | 2K 原生输出(2048px+) |
| 蒙版与透明度 | 视觉精确定位评论 | 原生透明贴纸(RGBA) |
| 多轮成本控制 | 按生成计量的 API 定价 | 消费级 GPU 上免费本地运行 |
基于生产管线进行选择
你的具体技术设置决定了哪个模型能带来更高效率:
- 选择 GPT Image 2.5 如果: 你的团队管理需要顶级零样本细节、4K API 输出和复杂文本渲染的商业照片级真实感工作流管线。专为高端品牌、广告海报和无缝网页使用而打造,其 Sunburst 质量层级通过 ChatGPT 界面或托管端点直接交付干净的光照和精确的解剖结构。
- 选择 Qwen Image 2.1 如果: 你需要一个在消费级硬件上本地运行、没有按生成 API 成本的自托管图像模型。作为开源权重架构运行,它为开发者提供完全的数据隐私、通过 64 通道 RGBA 生成的原生透明贴纸,以及使用显式蒙版边界的成本高效多参考合成。
根据你工作室的基础设施评估 GPT Image 2.5 与 Qwen Image 2.1,可确保你在初始视觉保真度与长期运营成本之间取得平衡。


