下载进度条达到 65 GB,风扇开始狂转,真正的问题随之而来:它到底能加载吗?GPT-OSS-120B 内存需求的简短答案是:权重约 61 GB,再加上一些工作空间,这就是为什么 OpenAI 将其宣传为单张 80GB GPU 即可运行的模型。
下面,我们将这个数字拆成几部分,展示已运行过它的硬件及实测速度,并介绍当你的硬件不够时可采用托管方案。
关键要点
- GPT-OSS-120B 以 60.8 GiB MXFP4 检查点形式发布,这就是 OpenAI 瞄准单张 80GB GPU 的原因。
- 上下文长度增加的显存很少:在完整的 131K token 下,KV 缓存也仅约 4.5 GiB。
- 如果显存低于 80GB,llama.cpp 可以将专家层卸载到系统内存,仍然能够运行它。
- 内存超过 96GB 的 Mac 和 128GB 迷你主机可以把完整模型放在一台机器上。
- 没有合适的硬件?通过一个 OpenAI 兼容 API 调用 Atlas Cloud 上的 Qwen3.5 122B A10B 。
GPT-OSS-120B 内存需求:权重加 KV 缓存
OpenAI 于 2025 年 8 月 5 日在 Apache 2.0 许可证下发布了 gpt-oss-120b。它是一个专家混合模型,因此其 116.8B 参数中只有 5.1B 会在每个 token 上工作。这有助于速度,但不影响内存:每个专家仍然必须驻留在内存中,随时等待被选中。
让它保持小巧的技巧是 MXFP4。根据 gpt-oss 模型卡,占参数总量 90% 以上的专家权重以每个 4.25 位存储。同一模型的 16 位副本需要大约四倍的空间。
| 规格 | GPT-OSS-120B |
|---|---|
| 总参数量 | 116.8B |
| 每个 token 的激活参数量 | 5.1B |
| 层数与专家 | 36 层,128 个专家,每个 token 激活 4 个 |
| 权重格式 | 专家层为 MXFP4,其余为 BF16 |
| 检查点大小 | 60.8 GiB |
| 上下文窗口 | 131,072 个 token |
上下文窗口如何改变 GPT-OSS-120B 内存
每个 token 都会在每个注意力层留下一个键和一个值。这个存储就是 KV 缓存,当每一层都关注完整上下文时,它会随上下文长度同步增长。
GPT-OSS-120B 避开了大部分。36 层中有一半使用滑动窗口,只回看 128 个 token,而且每层只存储 8 个 64 维的 KV 头。只有 18 层保留完整上下文。我们根据模型配置计算了 KV 缓存,它与 llama.cpp gpt-oss 指南 中的实测总量一致。
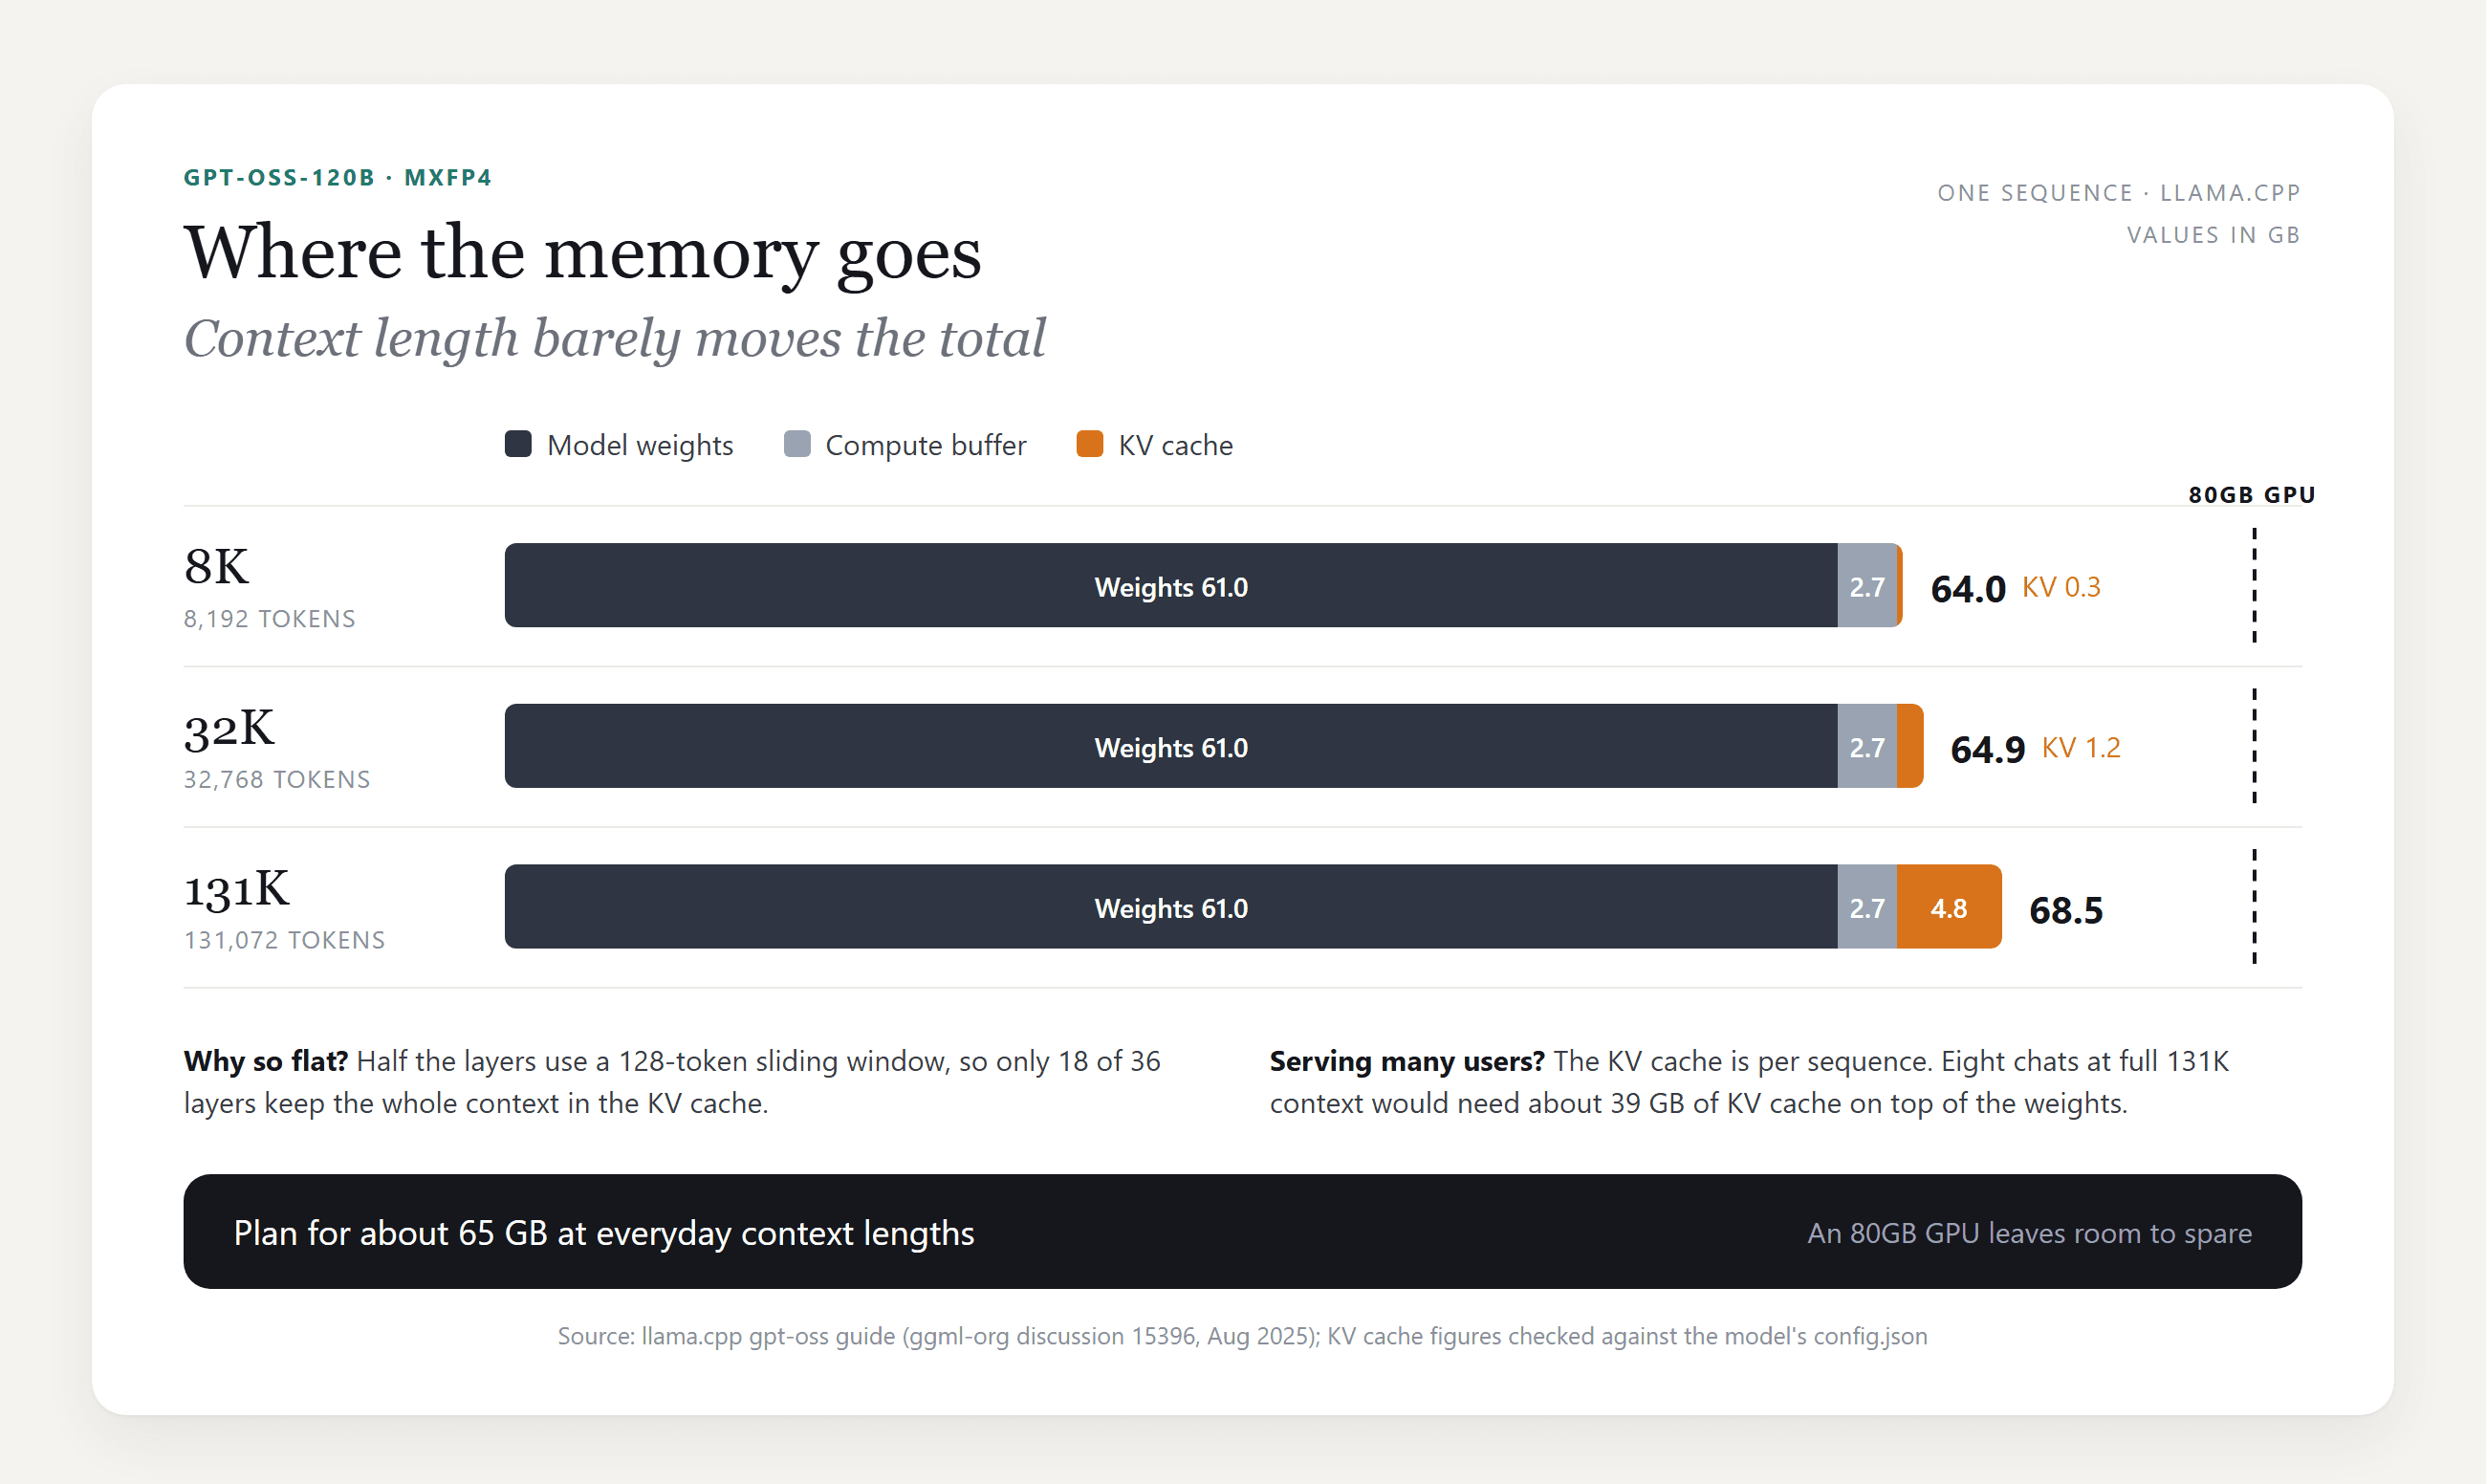
从 8K 到完整的 131K,代价不到 5 GB。真正叠加的是并发:KV 缓存按每个对话计算,因此一台服务器若容纳八个全长对话,需要在权重之外再加约 39 GB。
我能在本地运行 GPT-OSS-120B 吗?按配置划分的硬件要求
可以,只要你能把约 65 GB 放在足够快的地方:一块大显存 GPU、GPU 加系统内存,或一台带统一内存的机器。
GPT-OSS-120B GPU 要求
最简单的情况是一块 80GB 数据中心卡。gpt-oss 的 vLLM 配方 表示,120b 模型“可适配单块 A100 (80GB)”,并指出将其拆分到更多 GPU 上有助于提升吞吐量。
低于 80GB 时,llama.cpp 指南提供了一个出路。它的 --n-cpu-moe 标志将部分专家层保留在系统内存中,其余放在 GPU 上。指南给出的最低要求约为 8GB 显存,只要 GPU 和系统内存合起来仍能容纳模型即可。
| 配置 | 权重所在位置 | 报告的生成速度 |
|---|---|---|
| RTX Pro 6000,96GB | 全部在 GPU 上 | 196 tokens/s(llama.cpp 指南) |
| A100 或 H100,80GB | 全部在 GPU 上 | 可适配单卡(vLLM 配方) |
| RTX 5090,32GB,加系统内存 | 21 个专家层保留在系统内存 | 零上下文时约 30 tokens/s(llama.cpp 指南) |
同一份指南提到一个 Windows 陷阱:当显存耗尽时,驱动程序可能会悄悄溢出到系统内存,于是模型虽然加载了,但之后会慢得像爬。请在任务管理器中查看 GPU Memory,并不断提高卸载数量,直到它保持在你显卡容量以下。
在 Mac 或 128GB 迷你主机上运行 GPT-OSS-120B
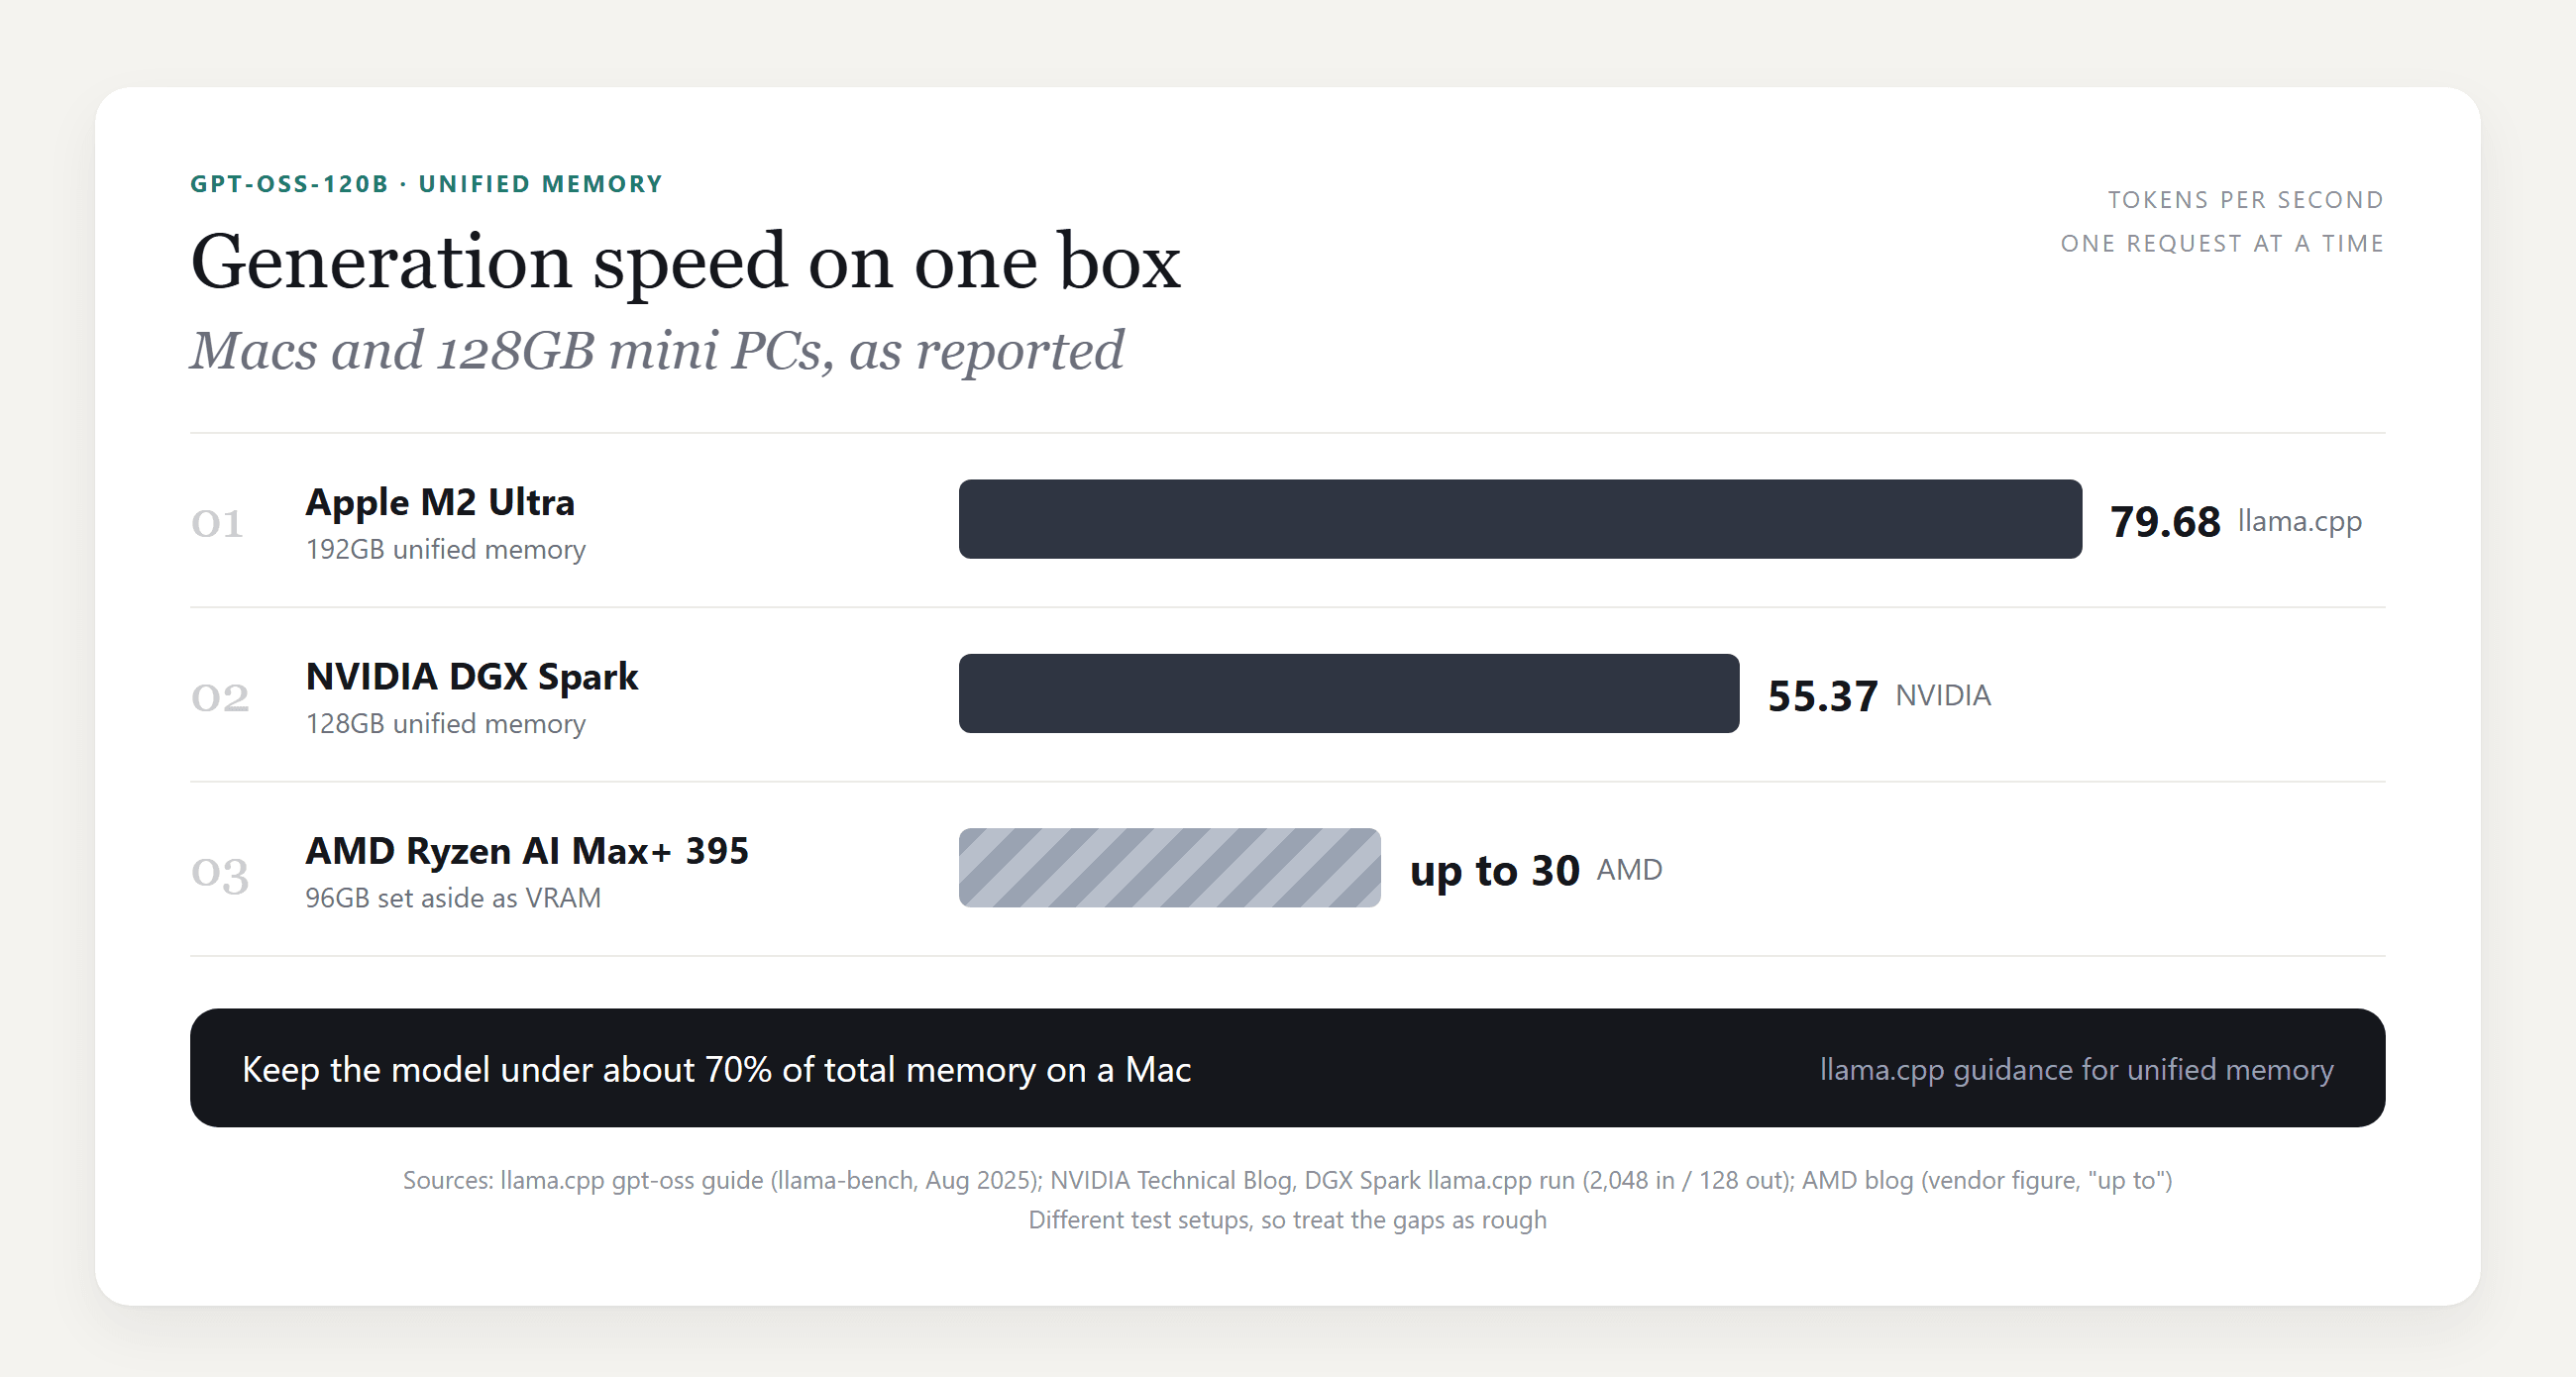
统一内存消除了 GPU 与内存的划分。llama.cpp 指南称,内存超过 96GB 的 Mac,例如 M2 Ultra 或 M3 Max 机型,可以在完整上下文下运行该模型,并建议保持在总内存的约 70% 以下。
macOS 默认会限制 GPU 可锁定的内存量。在 192GB 机器上,该指南通过一条命令将上限从 154GB 提高到 180GB:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
新的 128GB 迷你主机也属于同一档。NVIDIA 报告称,在运行 llama.cpp 的 DGX Spark 上,gpt-oss-120b 达到 55.37 tokens/s。AMD 表示,将 96GB 划作显存的 Ryzen AI Max+ 395 机器可达到“最高每秒 30 tokens”,这是该公司的自家数据。
内存不够?通过 API 使用托管的开放权重模型
如果这些机器都不在你的桌上,托管的开放权重模型可以完全跳过硬件问题。
Atlas Cloud 提供 Qwen3.5 122B A10B,它是其 Qwen 模型阵容 的一部分。从纸面上看,它与 gpt-oss-120b 非常接近:一个来自阿里巴巴 Qwen 团队的 Apache 2.0 专家混合模型,总参数 122B,激活参数 10B。它最多可读取 262,144 个 token 的上下文。
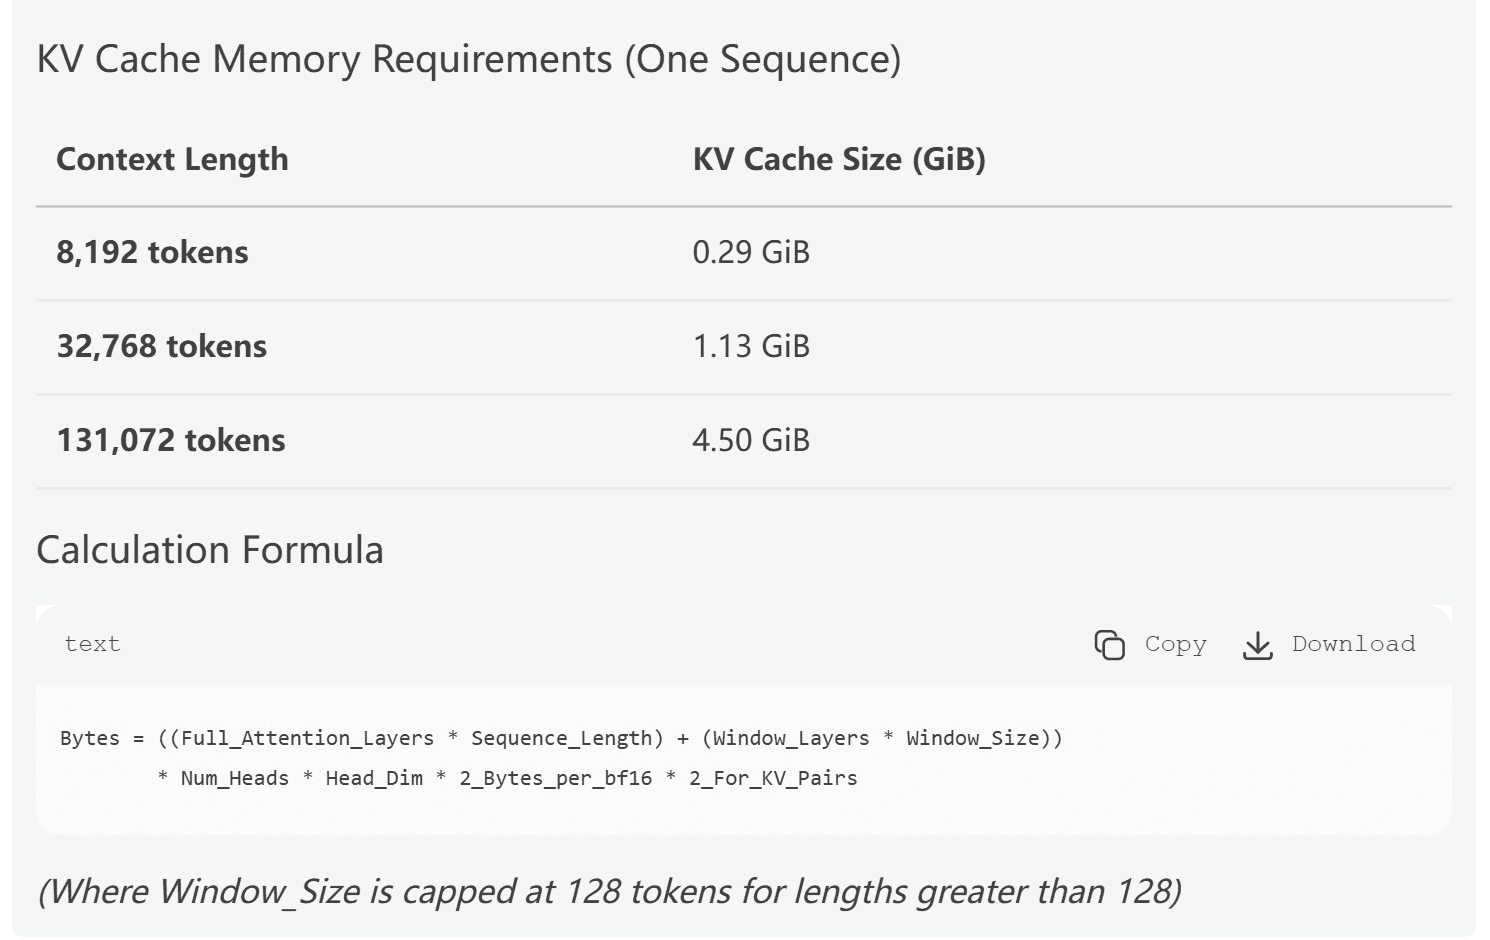
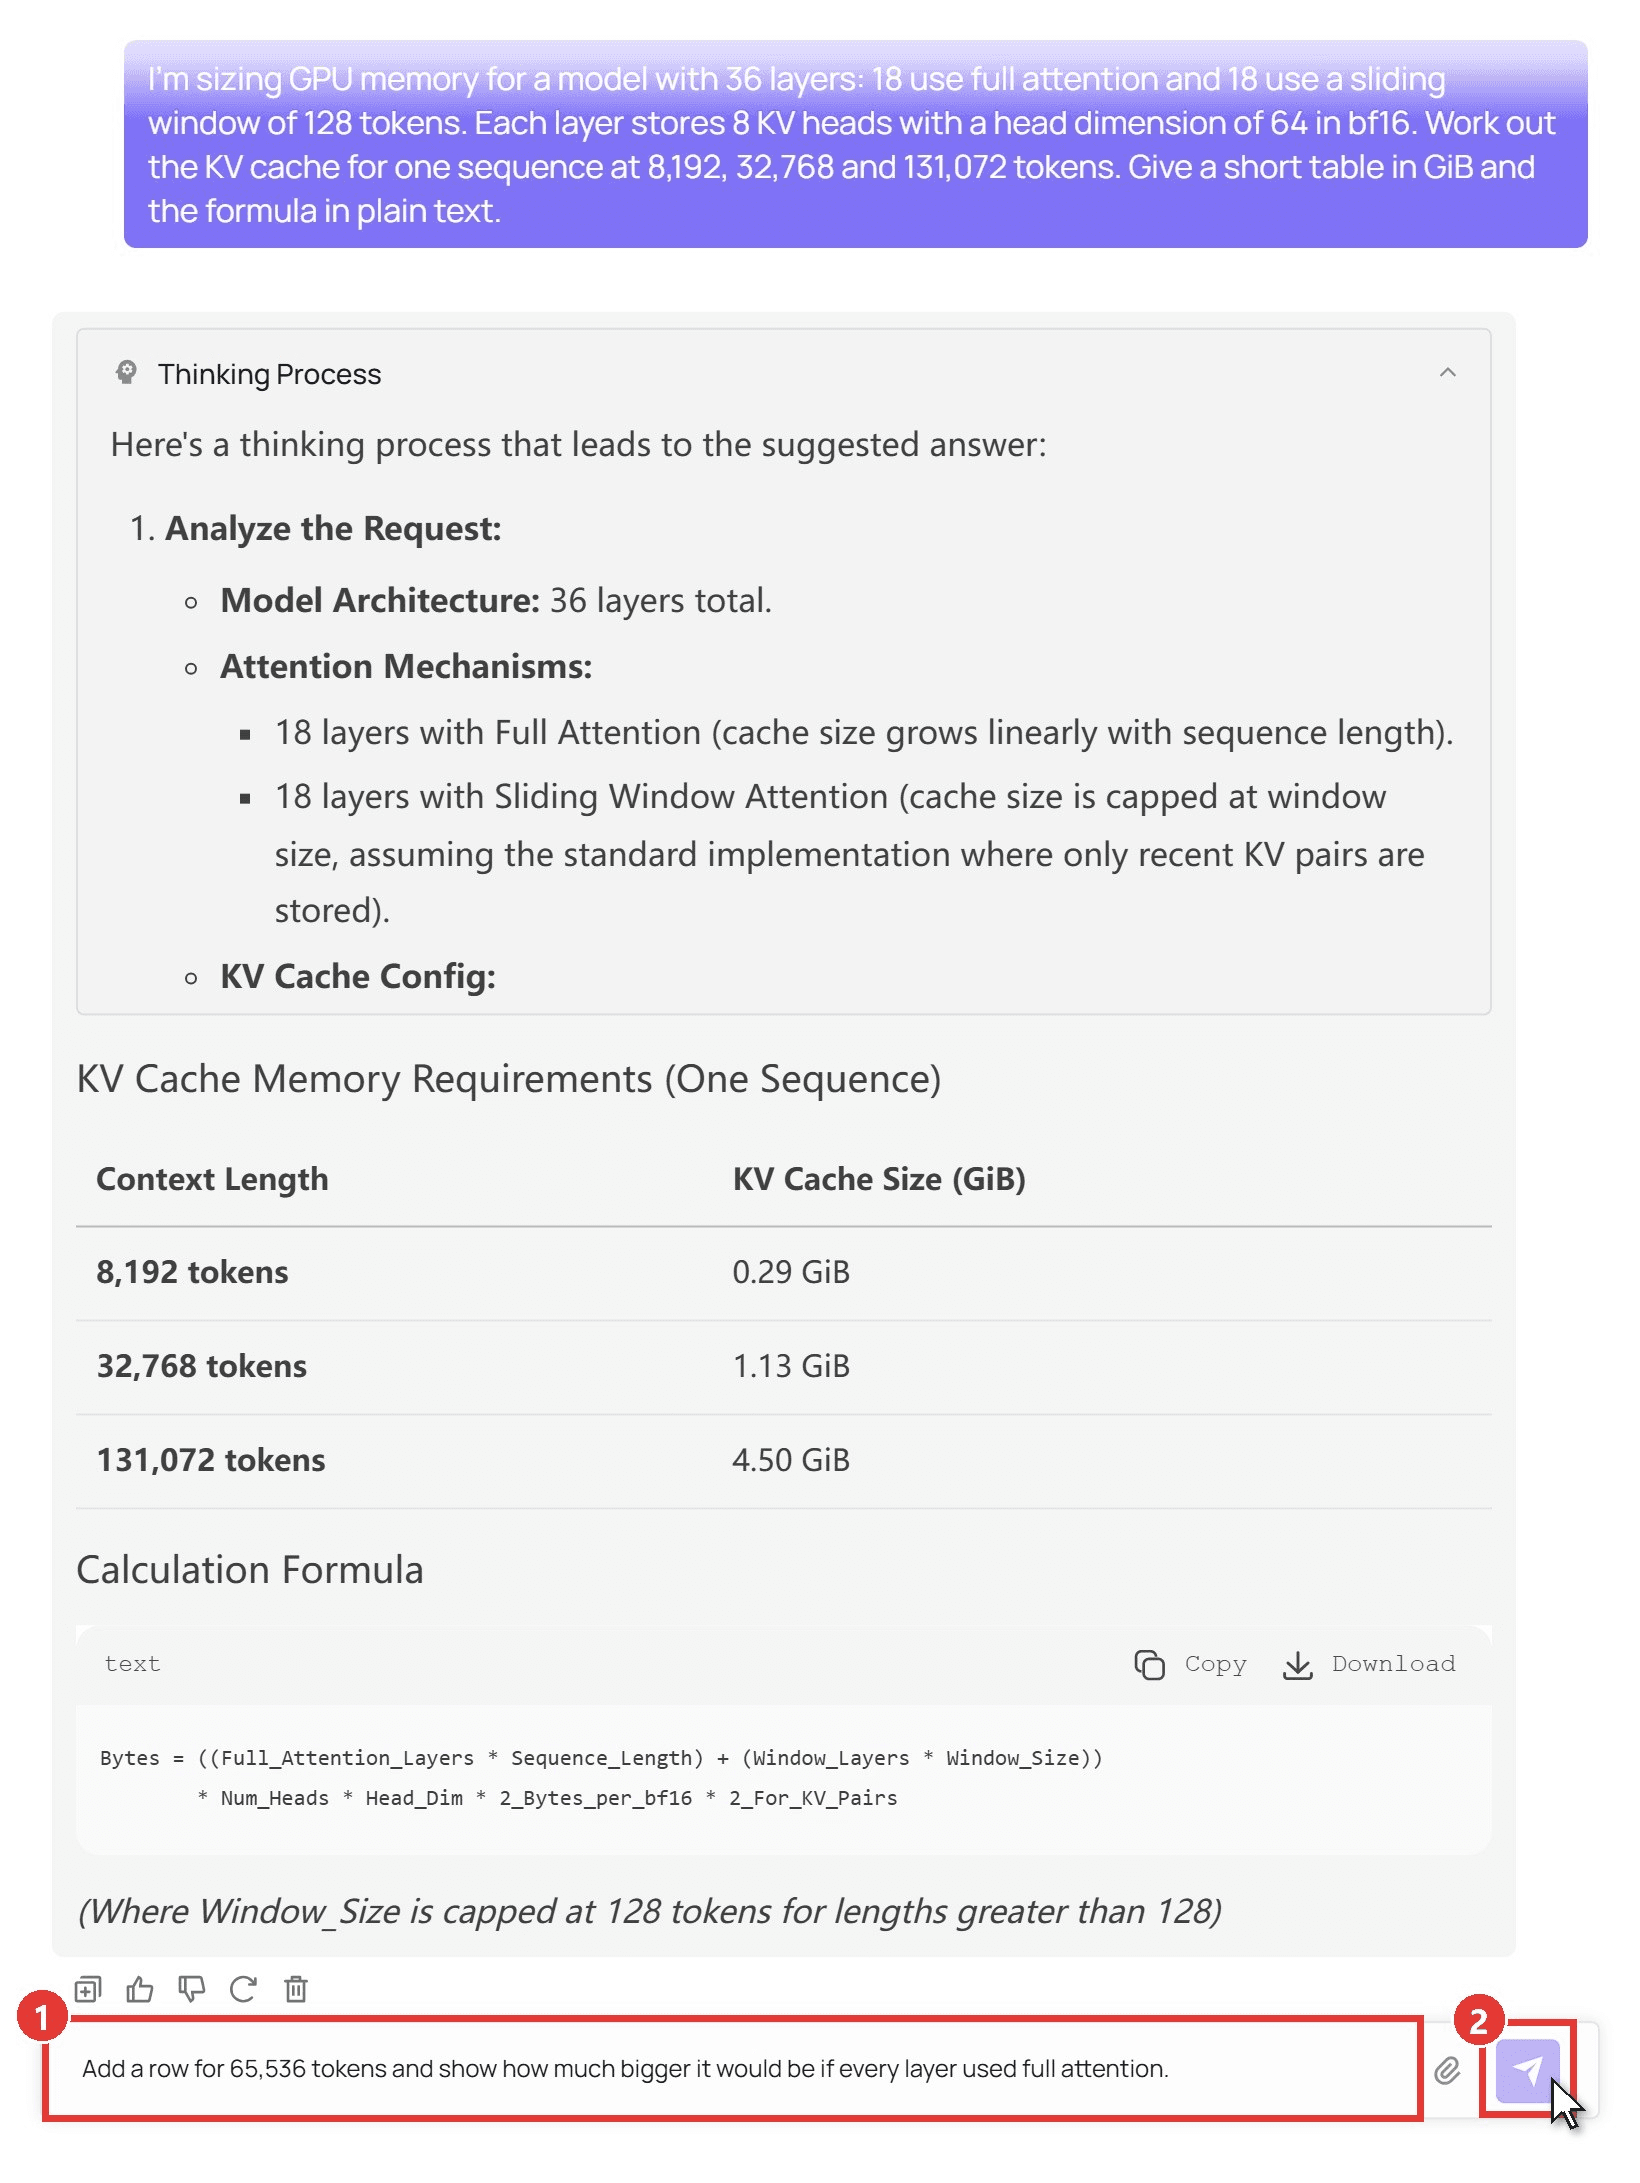
我们将 gpt-oss 配置中的注意力布局交给它,并要求它计算三种长度下的 KV 缓存。它的表格与我们自己的计算匹配到小数点后两位。如果你之后想为自己的机器选一个 Qwen,我们关于最适合本地编码的 Qwen 模型 的指南会按内存大小对它们进行划分。
方法 1:在 Playground 中试用 Qwen3.5 122B A10B
登录并打开 Qwen3.5 122B A10B playground,然后:
- 在消息框中输入你的问题。
- 点击发送箭头。推理过程会显示在答案上方的 Thinking Process 面板中。
方法 2:使用 Atlas Cloud API 调用 Qwen3.5 122B A10B
适用于脚本和应用:
步骤 1:创建 API 密钥。 在控制台中打开设置,进入 API 密钥,然后点击创建 API 密钥。请将其保存在服务器端。
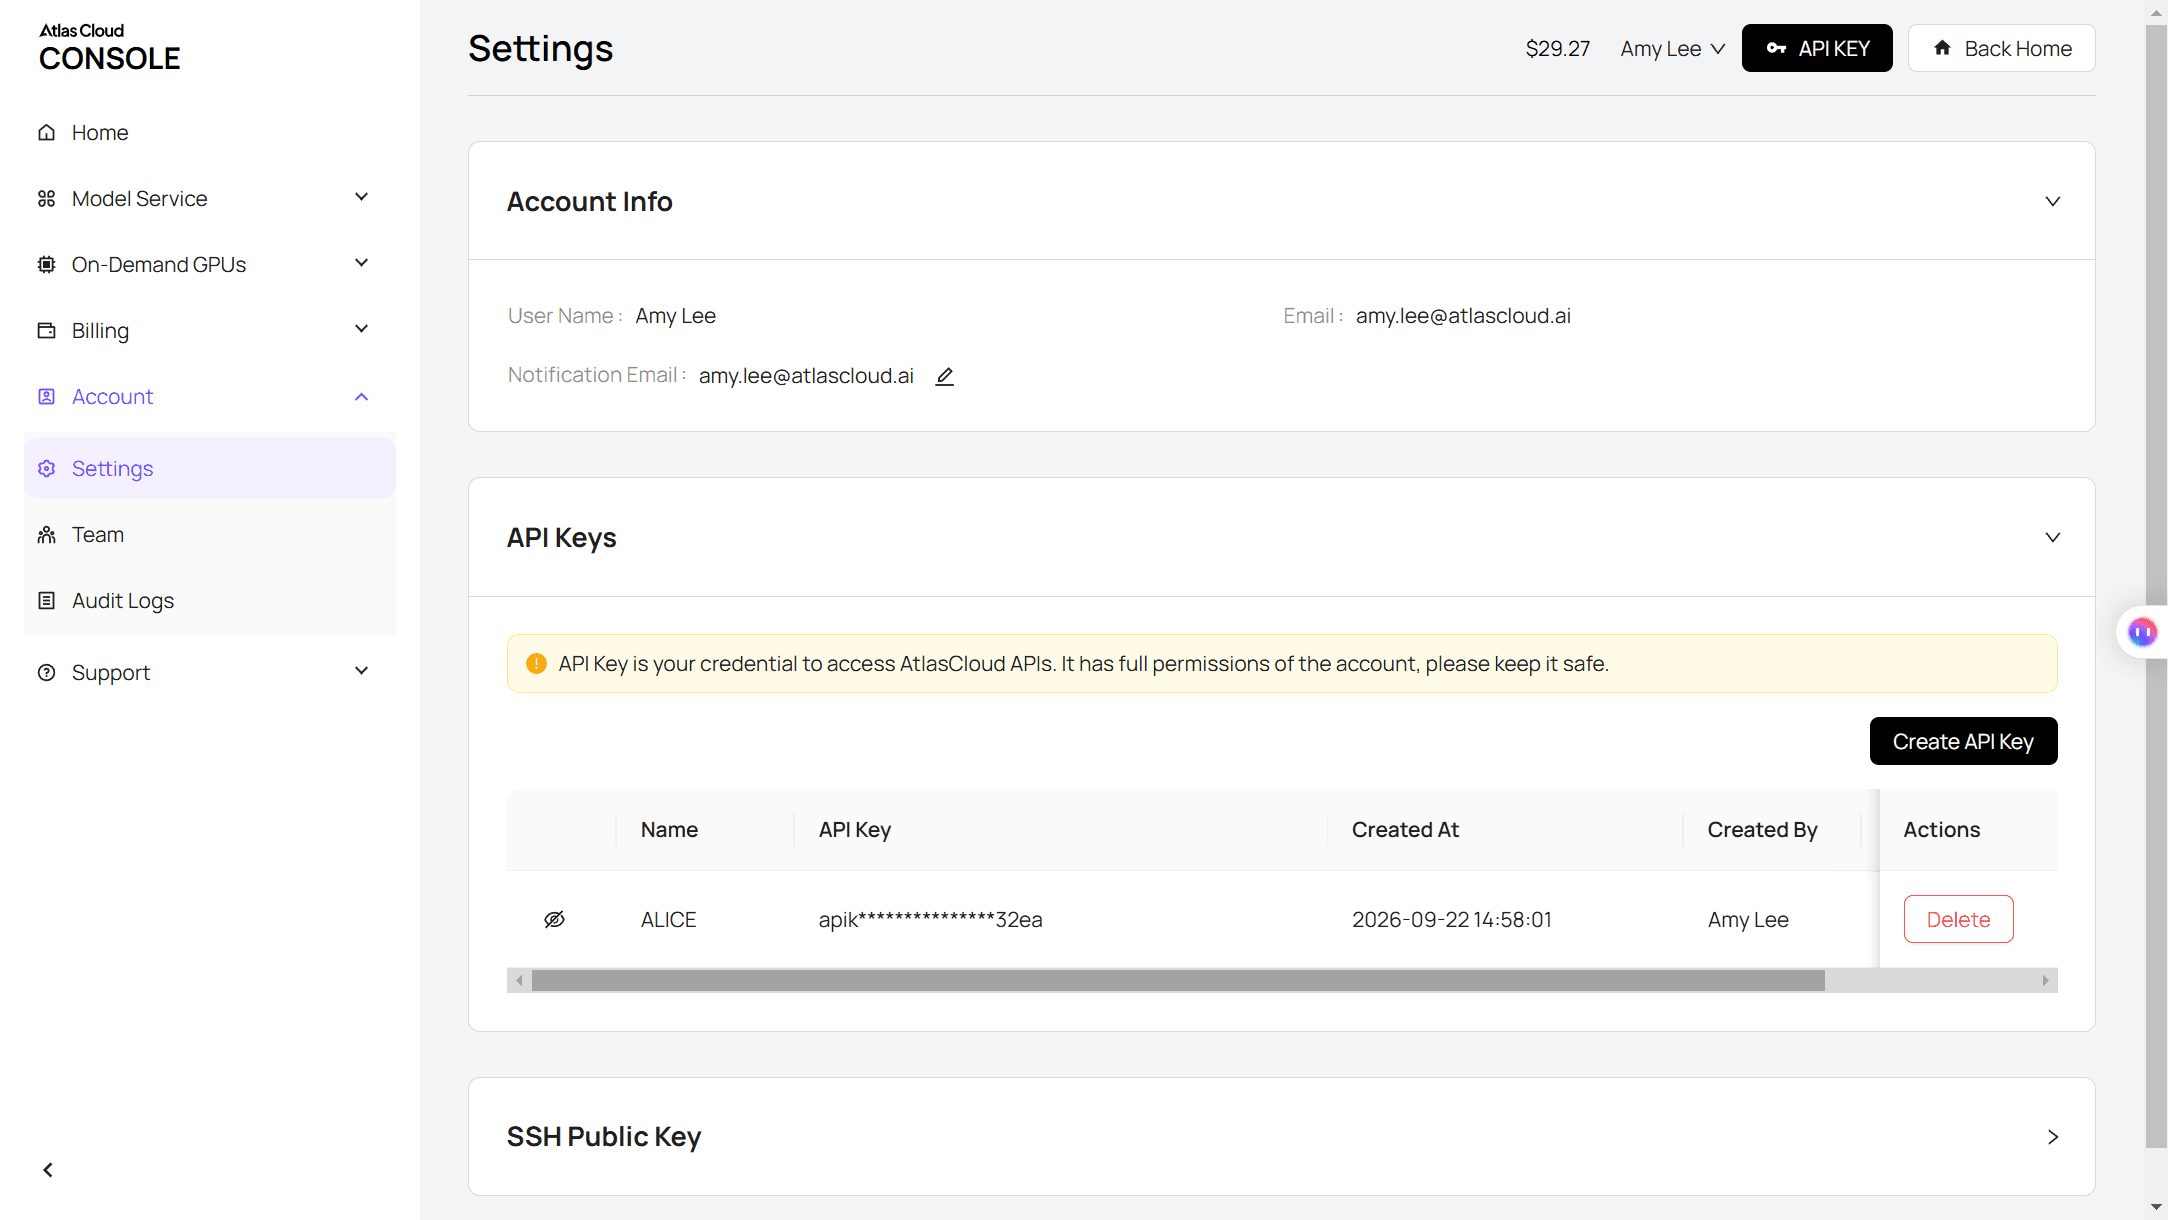
步骤 2:查看请求格式。 API 文档 涵盖聊天补全格式,模型页面还有一个 API 选项卡,其中包含现成示例。
步骤 3:发送你的第一个请求。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
答案会返回到 choices[0].message.content。由于该端点遵循 OpenAI 格式,为本地 gpt-oss 服务器编写的代码通常只需要新的 base URL、密钥和模型字符串。同一个密钥也可用于平台上的其他聊天模型,正如我们关于统一 LLM API 网关 的文章所介绍的那样。
GPT-OSS-120B 与 GPT-OSS-20B:内存与基准测试的权衡
较小版本只需要五分之一的内存。gpt-oss-20b 拥有 20.9B 参数,其中 3.6B 为激活参数,OpenAI 表示它可在“低至 16GB 内存”上运行。问题在于你放弃了什么。
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | 8K 上下文内存(llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond(无工具) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo(无工具) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
分数来自模型卡中高推理强度下的结果。编码差距在 SWE-Bench Verified 上不到两个点,而知识差距在研究生水平科学上约为 9 个点,在 HealthBench 上为 15 个点。如果在 16GB 到 24GB 的显卡上主要写代码,20b 是合理选择。需要额外的知识?这正是 120b 值得那份内存账单的地方。
GGUF、Ollama 还是 vLLM:根据内存预算选择运行时
它们都运行 OpenAI 发布的 MXFP4 权重;区别在于这些权重可以放在哪里。
| 运行时 | 下载大小 | 最适合 |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | 在能容纳整个模型的机器上供单个用户使用 |
| LM Studio | 65 GB | Mac 或 Windows PC 上的桌面应用 |
| llama.cpp (ggml-org GGUF) | 约 63 GB | 显存低于 65 GB,将专家层卸载到内存 |
| vLLM | 约 65 GB 的 safetensors | 用一块或多块数据中心 GPU 服务大量用户 |
在大内存机器上快速开始:
plaintext1ollama run gpt-oss:120b
对于较小的 GPU,使用 llama.cpp 并调整卸载数量:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
这四种运行时都支持 OpenAI 的 harmony 聊天格式,模型需要该格式才能正常工作。只有当你编写自己的服务代码时,这一点才重要。
常见问题
GPT-OSS-120B 比 GPT-5 或 Gemini 3 Pro 更好吗?
它们属于不同类别:GPT-5 和 Gemini 是闭源模型,通过应用或 API 访问,而 gpt-oss-120b 在你自己的硬件上运行。Gemini 3 Pro Preview 也于 2026 年 3 月 9 日停用,其名称现在指向 Gemini 3.1 Pro Preview。如果本地控制很重要,Google 的开放权重系列是 Gemma 4 家族。
为什么有些网站说 GPT-OSS-120B 需要 255 GB?
这些数字假设使用 16 位权重:大约 117B 参数乘以 2 字节,再加上开销。OpenAI 发布的检查点已经是 MXFP4,因此实际下载大小在 61 GB 左右。
推理强度会改变内存使用吗?
不会改变权重。低、中、高设置改变模型思考的时间。高推理强度会写入更多推理 token,这些 token 会填满上下文窗口并增大 KV 缓存,因此长会话会逐渐接近上图中的较大总量。
为什么人们说 GPT-OSS-120B 在文字游戏中表现不佳?
证据只是轶事性的。在该模型的 Hugging Face 讨论页上,一些用户报告在写暴力小说时遭到拒绝,而另一些人说角色扮演运行良好。对于互动小说,请先测试你自己的提示词,再为此购买硬件。
托管的 120B 级模型费用是多少?
截至 2026 年 10 月,Qwen3.5 122B A10B 在 Atlas Cloud 上的价格为每百万输入 token $0.3,每百万输出 token $2.4。这相当于其常规价格 $0.4 和 $3.2 的 25% 折扣。我们的容量测算问题在计入推理后使用了约 5,000 个输出 token,按折扣价约为一美分。
结论
GPT-OSS-120B 比其参数量所暗示的更容易容纳。日常上下文长度下预计约 65 GB,完整 131K 上下文下低于 70 GB。一块 80GB GPU、一台内存超过 96GB 的 Mac,或一台 128GB 迷你主机都能容纳它,而较小的显卡可以通过将专家层移入系统内存来运行它。
如果这些数字排除了你的机器,那么主要做编码工作可降级到 gpt-oss-20b;当你需要更强的大脑又不想购买硬件时,可以调用托管的开放权重模型。无论如何,一旦你知道权重占 61 GB,其余都是余量,gpt oss 120b 内存需求就不再是猜谜游戏。





