让AI生成摘要
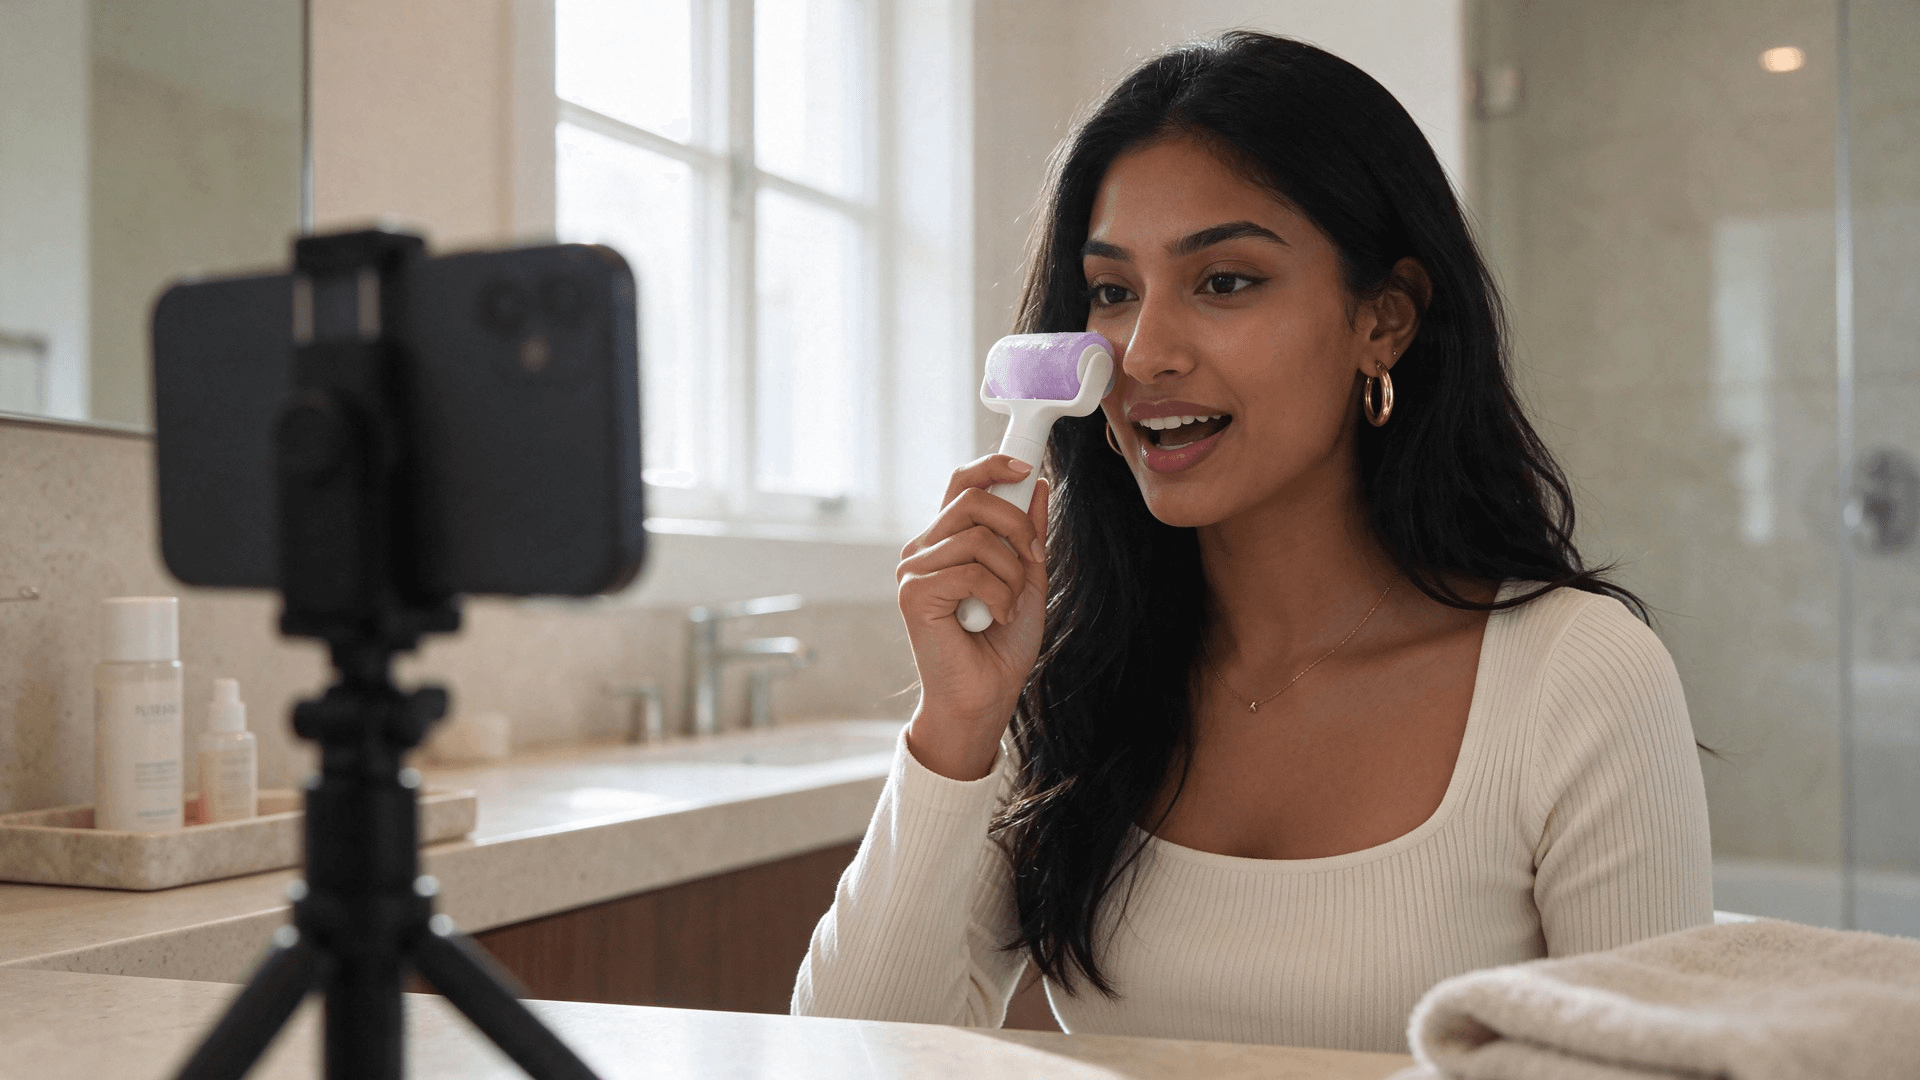
视频开头,一位女士坐在浴室梳妆台前。她将磨砂冰滚轮沿着颧骨向上滚动,抱怨自己只睡了四个小时就接了个早上七点的电话。没有人把镜头对准她。这段视频来自一张肖像照、一张产品照和一段八秒的配音。
本指南将逐步介绍如何创建像她这样的AI网红用于品牌视频:一张可以在任何场景中重复使用的面孔,从已经爆火的视频中借用的钩子,以及每当脚本改变时都可以重新生成的口播片段。我们在撰写本文时构建了这个示例,因此每一步都展示了真实的输入和输出。
关键要点
- AI网红是一张你在视频中重复使用的一致面孔,基于单张参考照片构建。
- 从已被验证的TikTok钩子开始:在写任何脚本台词之前,先拆解一个爆款视频。
- Seedance 2.5 将一张肖像照、一张产品照和一段配音台词转化为唇形同步的口播视频。
- 写三条钩子台词,每条都做成一个片段,然后保留前三秒效果最好的那条。
- 在TikTok上标注AI制作的出镜者,并且只使用你有权使用的真实面孔。
什么是AI网红以及谁在创建AI网红
AI网红是一个生成的人物,以相同的面孔、声音和风格反复出现在镜头前。“反复出现”才是关键。一个好看的画面很容易。一个在周一厨房里和周五汽车里看起来都像同一个女人的出镜者,才是人们真正会去搜索的。
有两类人在创建它们,他们想要的东西不同:
| 人设账号 | 品牌出镜者 | |
|---|---|---|
| 目标 | 作为虚拟人物增长粉丝 | 为产品视频和广告出镜 |
| 必须保持固定的 | 面孔、个性、生活故事 | 面孔、声音、表达风格 |
| 典型输出 | 每日帖子、快拍、直播 | 10到30秒的钩子和演示 |
| 成功指标 | 受众规模 | 观看时长和产品点击量 |
本指南涵盖第二列。如果你对这个形式本身还不熟悉,我们关于什么是AI UGC的讲解首先介绍了基础知识。
在Atlas Cloud上将一张照片变成会说话的AI网红
在讲任何理论之前,这是完成的片段:十秒钟,竖屏,有她的声音,滚轮工作的特写,以及最后将产品举起的画面。
它是在Atlas Cloud上使用Seedance 2.5 Reference-to-Video制作的。作为一个AI网红生成器,它从你的输入开始:你提供面孔、产品和声音,它围绕这些构建镜头。
它一次请求最多接受30张参考图片,包括真实人物的照片,并且单个音频片段可以独立驱动唇形同步。
这对品牌出镜者很重要。面孔在每个视频中都保持不变,当脚本改变时,你只需替换一个音频文件,而不需要预订重拍。
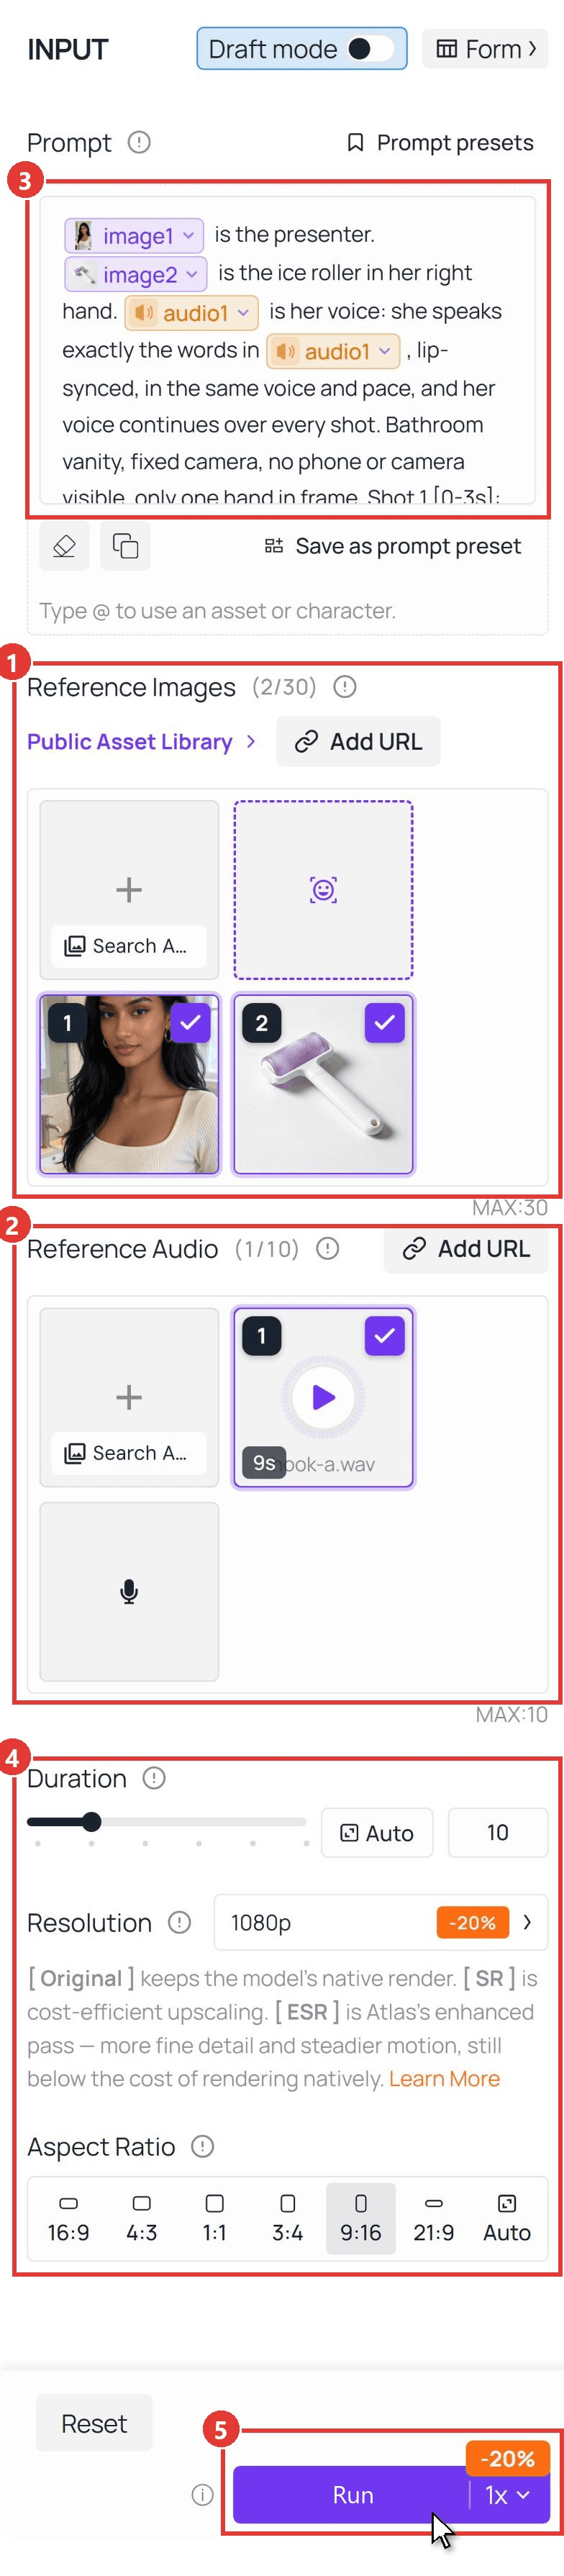
整个运行过程都在Seedance 2.5 Reference-to-Video playground的一个页面上完成:
- 首先在参考图片下上传肖像,然后上传产品照片。顺序很重要:第一个文件会成为Image1。
- 在参考音频下上传配音台词。
- 粘贴提示词,然后重新输入每个@提及,并从列表中选择匹配的文件,使其变成标签。
- 将时长设置为10,分辨率设置为1080p,宽高比设置为9:16。
- 点击运行。
如何用5个步骤创建AI网红
Playground是最后一步。决定视频能否阻止用户滑动的是你输入的所有内容,所以以下是从研究到完成钩子的AI网红创建方法。
步骤1:从真实爆款视频中拆解TikTok钩子
不要从空白脚本开始。选择一个在你所在领域已经获得观看量的短视频,并拆解它。
我们使用了频道All You Can Face的一个19秒日常视频,一个针对浮肿脸、浮肿眼睑和浮肿眼下的日常流程。我们没有看十遍,而是通过Atlas Cloud API将链接交给了Gemini 3.5 Flash。公开的YouTube链接可以直接作为视频输入:
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.5-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://www.youtube.com/shorts/V_rNa1iOuXA"}}, 9 {"text": "Return the 0-3s hook line verbatim, the hook type, each shot change with its timestamp, all on-screen text, and the hook as one reusable template sentence."} 10 ] 11 }] 12 }'
以下是返回结果的浓缩版:
| 我们询问的内容 | 视频的做法 |
|---|---|
| 开场白 | “如果你醒来脸部浮肿,做这个20次。” |
| 钩子类型 | 用直接指令表达的痛点 |
| 结构 | 四个镜头,每个对应一个问题,每个都以相同的句式开头 |
| 屏幕文字 | 一个清单,每个镜头增加一项 |
| 取景 | 胸部以上,全程眼睛看着镜头 |
| 可复用模式 | [动作] 用于 [数量] 如果你醒来时 [问题] |
一份TikTok钩子列表给你的是第一行台词。拆解中有用的部分是台词下面的结构:一个重复的句式,每个镜头一个可见的回报,没有开场白。这就是我们带入脚本的东西。
步骤2:锁定一张面孔并在场景中重复使用
只有每次看起来都像同一个人,你的网红对观众来说才是真实的。从一张你有权使用的肖像开始,然后改变除面孔之外的一切:服装、房间、光线。
任何基于参考图编辑的图像模型都可以做到这一点。我们在Atlas Cloud上使用了Seedream:用5.5 Edit模型将一张工作室肖像变成浴室梳妆台的主镜头,然后用5.0 Lite顺序编辑器在一次请求中从该主镜头衍生出另外三个场景。
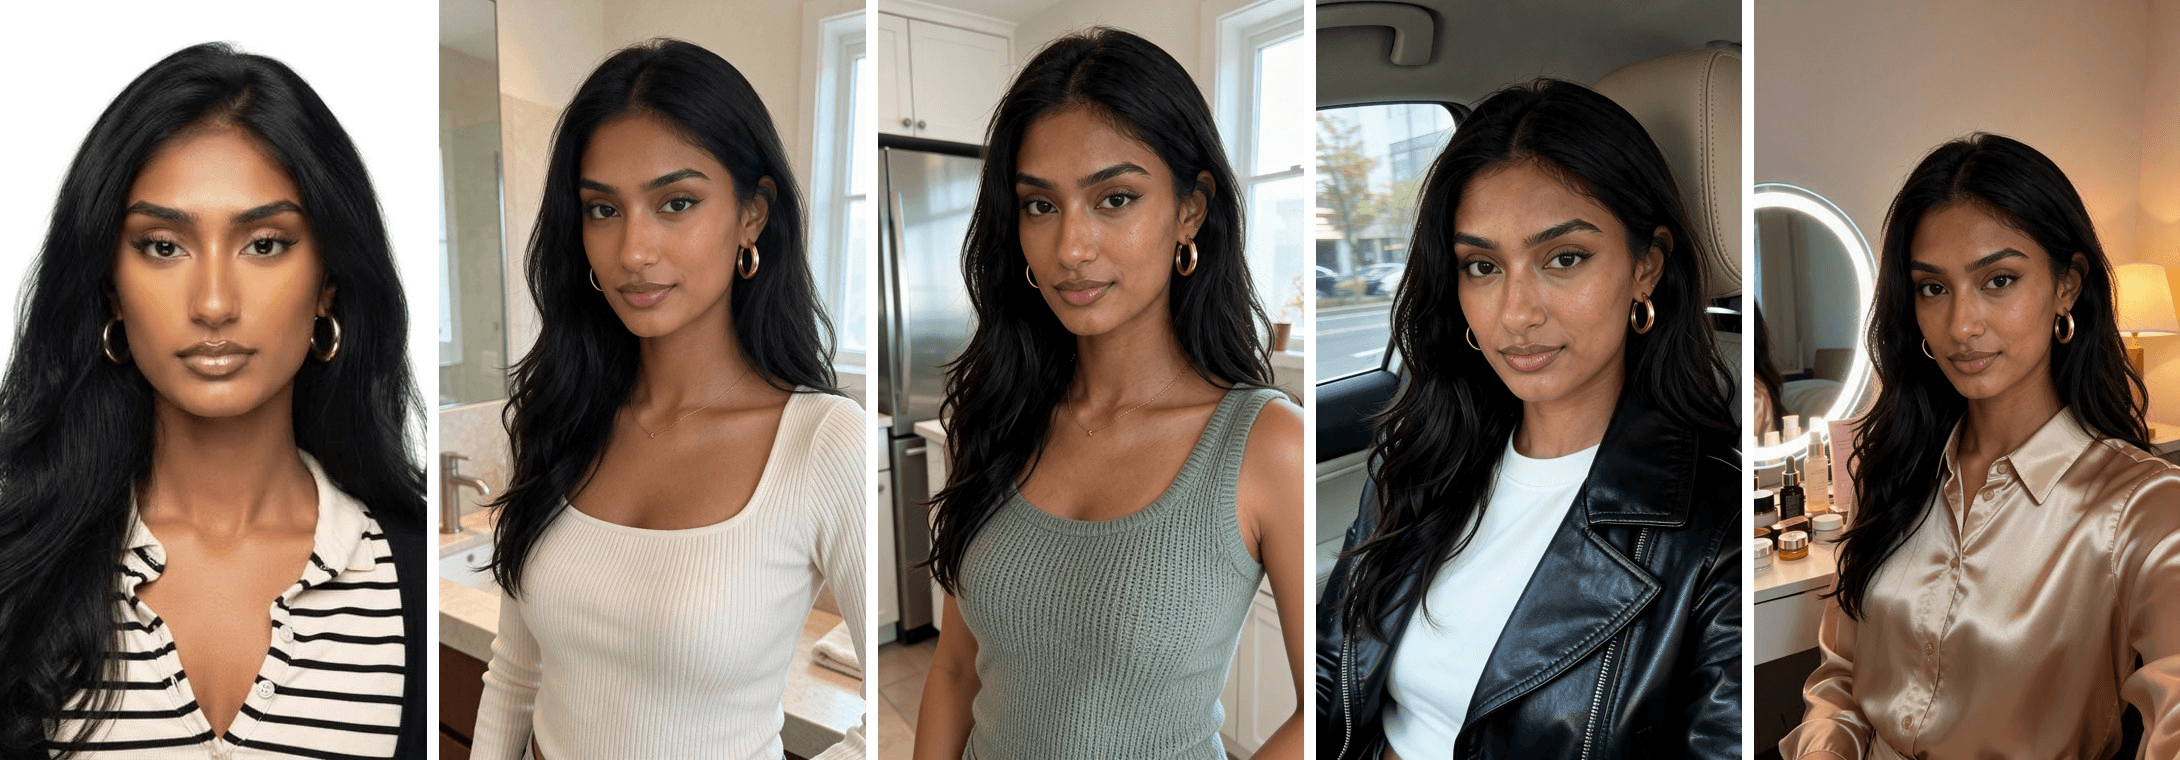
有三件事让我们保持了面部稳定:
- 固定身份,自由造型。 在第一句中说明不能改变的内容(面孔、肤色、头发、耳环),然后描述新的服装和房间。
- 描述相机,而不是设备。 “从胸部高度的固定相机拍摄”会得到干净的自拍风格画面。提到柜台上的手机,模型往往会画出手机。
- 把她打扮得像创作者。 基础款运动衫看起来像素材库。罗纹方领上衣或缎面衬衫看起来像是有意自拍的人。
步骤3:按照已验证的模式为TikTok撰写爆款钩子
有了步骤1中的模式,写作就变成了填空。我们为冰滚轮起草了三句台词,每句借用不同的开头:
| 钩子 | 台词 | 开头类型 |
|---|---|---|
| A | 我睡了四个小时,早上七点还有个电话。用这个东西两分钟,就没人问我是不是累了。以下是我的使用方法。 | 特技加数字 |
| B | 如果你醒来脸部浮肿,做这个两分钟。从下巴向上滚,每只眼睛下方,然后横过额头。就这样。 | 来自步骤1的模式 |
| C | 别再买去浮肿的眼霜了。我把它放在冰箱里过夜,滚两分钟,相机上就能看出区别。 | 反常识建议 |
然后给每句台词配上自己的音轨。Seedance 2.5 本身就会根据参考音频进行唇形同步,所以音频就是脚本:用相同的声音将每个钩子录制或生成为单独的文件。
我们在Atlas Cloud上使用Gemini 2.5 Pro TTS生成,使用Sulafat语音,并在文本前加了一行风格说明,要求随意、温暖、略带俏皮的朗读。
步骤4(方法1):在Playground中生成口播视频
按照上方截图中的五个点击步骤,每个钩子运行一次。每次运行之间只有音频文件改变。提示词保持不变:
plaintext1@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced, in the same voice and pace, and her voice continues over every shot. Bathroom vanity, fixed camera, no phone or camera visible, only one hand in frame. 2Shot 1 [0-3s]: chest-up, she talks straight to the lens, holding the roller near her chin. 3Shot 2 [3-6s]: extreme close-up on her cheek. The roller head is pressed flat against her skin and rolls slowly upward along her cheekbone. The lilac cylinder turns on its axle as it moves, the white frost streaks on its surface rotating up and out of view, while the white handle stays still. Her skin gently dips under the roller. 4Shot 3 [6-10s]: back to chest-up, she holds the roller up beside her face toward the lens and finishes the line.
那个提示词中的两个选择起了大部分作用。中间镜头是特写,因为像圆柱体转动这样的小机械细节在产品充满画面时最容易看清。而且配音台词明确地在剪辑点继续,所以特写感觉像一个镜头内的B-roll。
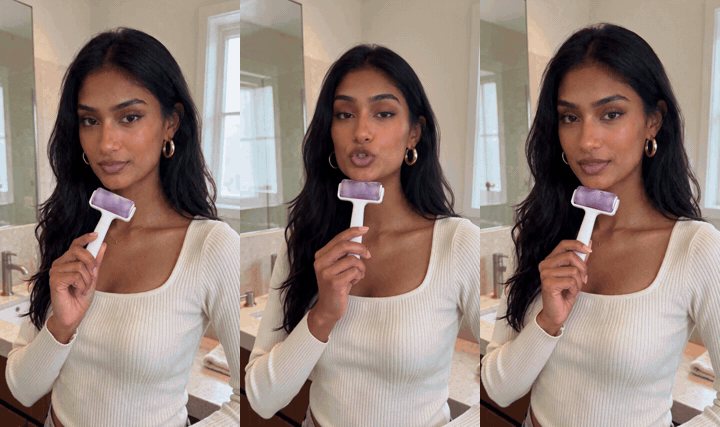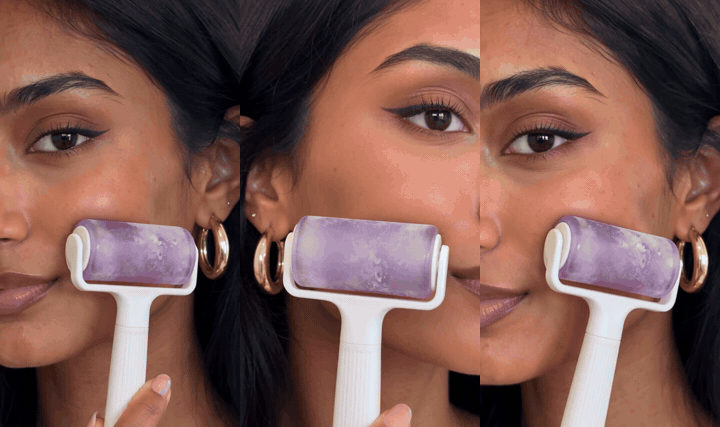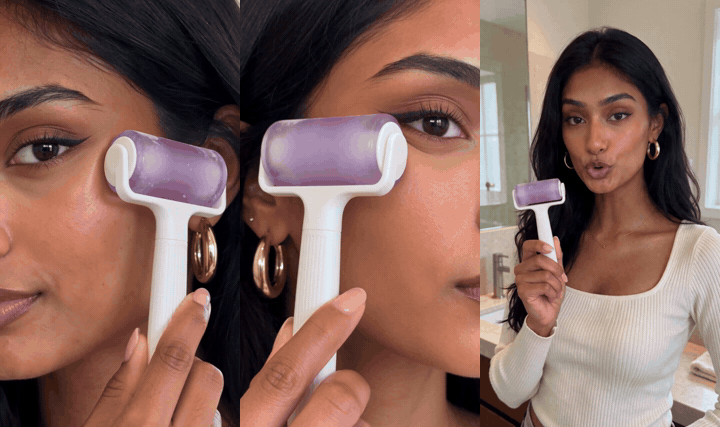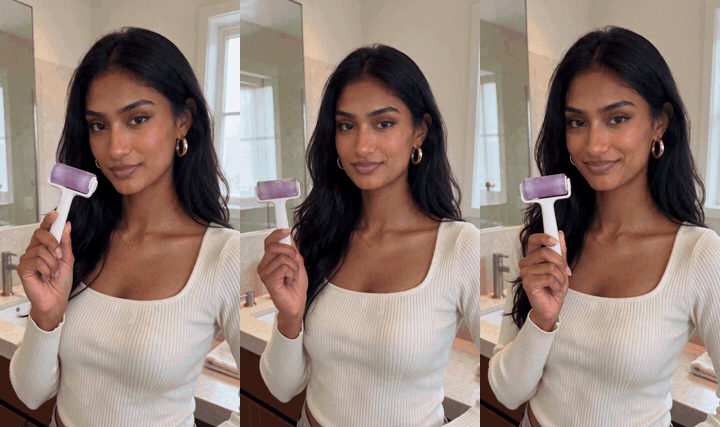
我们为1080p版本保留了钩子A。它的前两秒包含一个数字和一个利害关系(四小时睡眠,早上七点电话),所以观众在第一次剪辑之前就知道回报。如果你更愿意手写每一帧和镜头列表,我们的20分钟AI UGC广告工作流程走的是那条路。
步骤5(方法2):通过API批量处理钩子
一旦一个钩子奏效,API就会把其他十个变成对音频文件的循环。
步骤1:创建并复制你的API密钥。 打开Atlas Cloud控制台,进入设置,然后API密钥,点击创建API密钥。
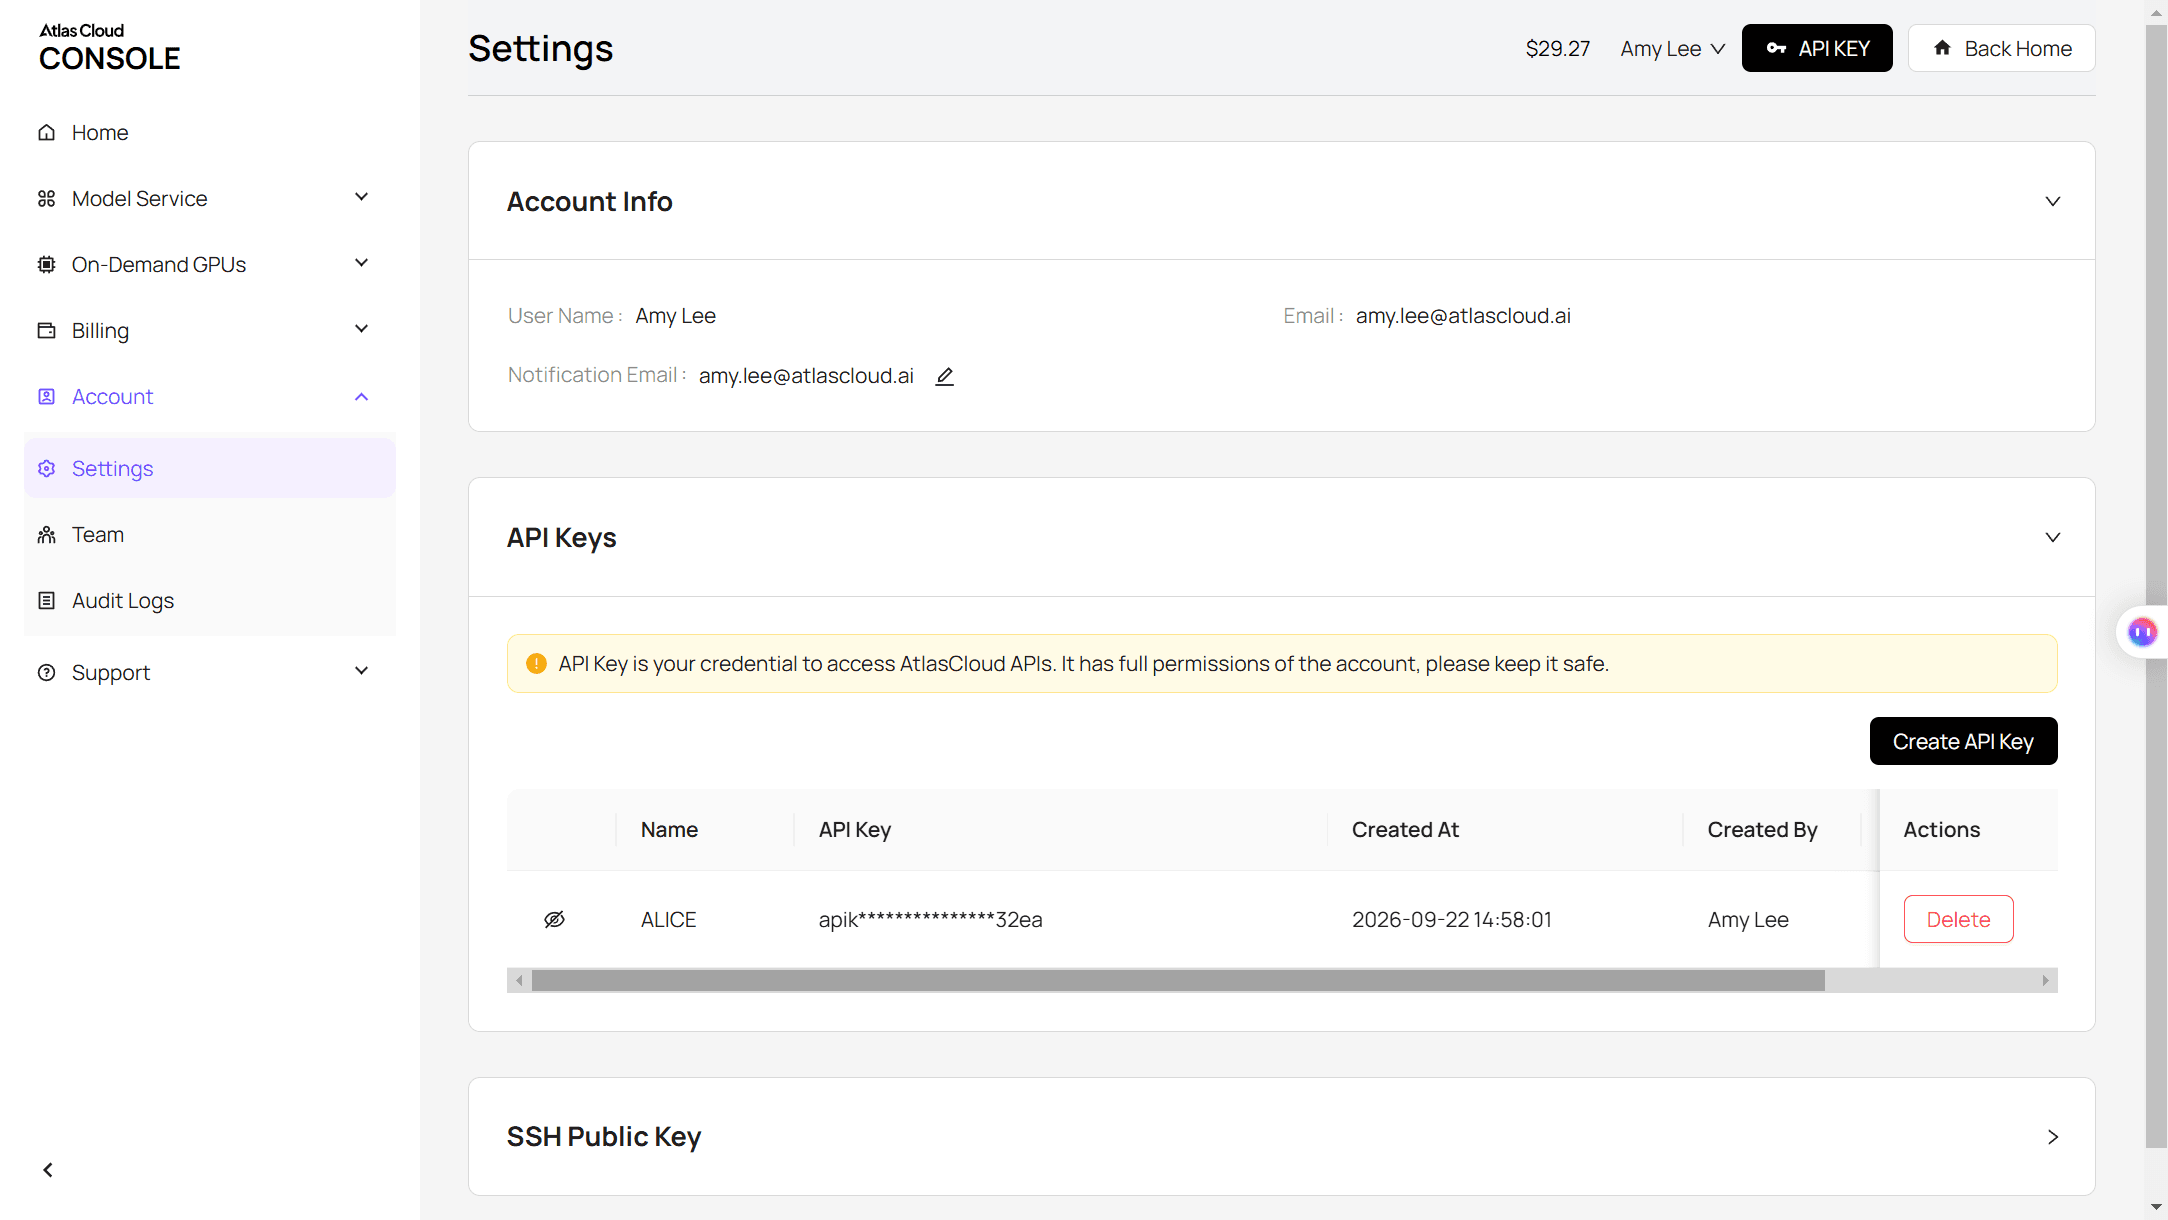
步骤2:查看API文档。 每个模型的参数,包括这里使用的参考字段,都在API文档中。
步骤3:发出你的第一个请求。 提交一个钩子:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced. Shot 1 [0-3s]: chest-up, talking to the lens. Shot 2 [3-6s]: extreme close-up, the roller pressed to her cheek, the cylinder turning on its axle as it rolls upward. Shot 3 [6-10s]: chest-up, she holds the roller beside her face and finishes the line.", 7 "reference_images": ["https://your-cdn.com/presenter.png", "https://your-cdn.com/ice-roller.png"], 8 "reference_audios": ["https://your-cdn.com/hook-a.wav"], 9 "duration": 10, 10 "resolution": "1080p", 11 "ratio": "9:16", 12 "generate_audio": true 13 }'
响应会返回一个预测ID。轮询它,直到状态显示为completed:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
要批量处理,保持请求体固定,为每个钩子替换reference_audios URL。Atlas Cloud在其模型上运行一个API:每个视频模型都共享这个端点、密钥和轮询循环,所以切换模型意味着更改模型字符串。上面的图像和语音步骤使用相同的密钥和相同的提交并轮询模式。
要了解完整的按格式测试钩子的网格,请参阅如何扩展UGC广告制作。
AI网红规则:标签和肖像权
在她销售任何东西之前,检查两类规则:平台标签和广告中合成人物的法律。
| 地区 | 要求 | 做法 |
|---|---|---|
| TikTok | 标注显示真实场景或人物的AI生成内容 | 发布时打开AI生成标签,或添加说明文字或贴纸 |
| 纽约州广告 | 当广告主知道使用了合成表演者时,在广告中披露 | 在广告中添加清晰可见的披露信息 |
| 使用真实面孔作为参考 | 获得你使用其肖像的人的许可 | 获得书面同意,或者从你拥有版权的肖像开始 |
TikTok在2023年9月推出了其AI生成内容标签,并要求创作者在逼真的AI内容上使用它。纽约的合成表演者法律,S.8420-A,于2025年12月11日签署,并于2026年6月9日生效,首次违规的民事罚款为1,000美元,之后每次违规罚款5,000美元。
在模型方面,Atlas Cloud上的Seedance 2.5接受真实人物的照片作为参考,并自动将其注册为资产。其文档要求你仅在获得授权的情况下使用真实人物的肖像,这与你对人类创作者遵循的规则相同。
常见问题
创建AI网红需要多少钱?
使用Seedream 5.5 Edit在9:16下每张肖像约0.03美元。Seedance 2.5视频按分辨率和长度定价:在Atlas Cloud上,一个10秒竖屏片段,带两张参考图片和一个语音文件,720p约为3.02美元,1080p约为5.94美元。
这些价格截至2026年11月13日,已应用20%折扣。由于每个钩子都是独立的片段,主要的AI UGC成本是你选出获胜者之前测试了多少个钩子。
有我可以使用的TikTok钩子生成器吗?
任何文本模型都可以生成钩子,但当你给它一个模式而不是一个主题时,输出会更好。先拆解一个爆款视频(步骤1),然后让模型为你的产品用那个确切的句式写十句台词。挑选三个来拍摄胜过生成五十个却一个都不拍。
我的AI网红可以说其他语言吗?
可以。根据其模型文档,Seedance 2.5原生支持超过10种语言的语音生成。为了获得最紧密的唇形同步,先用目标语言生成配音台词,并将其作为参考音频传入,就像你对英语所做的那样。
一个AI网红视频可以有多长?
一次Seedance 2.5生成时长从4到30秒。钩子最好短一些:我们的三个片段各10秒,这留出了空间给一句台词、一个特写和一次产品展示。对于更长的广告,分别生成场景,然后剪辑在一起。
结论
现在面孔是容易的部分。将能销售的出镜者与只是好看的出镜者区分开来的是她周围的工作:从已经爆火的东西中提取的钩子模式、在场景中重复使用的单张肖像,以及为每句台词配上的音轨,使嘴唇与词语匹配。
如果你正在为自己的产品弄清楚如何创建AI网红,从小处开始。拆解一个视频,写三句台词,运行三个片段,并保留那个赢得前三秒的。然后让API为之后的每个钩子重复这个循环。




