同一冷萃咖啡瓶拍摄的两张打印件,一张柔和一张锐利,放在咖啡馆柜台上,中间夹着一张收据
同一张照片的两张打印件,一张柔和一张锐利。在 MiniMax H3 上,这种差距并非质量滑动条。由 openai/gpt-image-2/text-to-image 生成。
我提交了两次相同的提示词。唯一改变的是一个下拉菜单:768P,然后是 2K。
第一次运行花费 0.40 美元,130 秒后返回。第二次花费 0.56 美元,耗时 181 秒。然后我把两帧并排放置,感觉不对劲。瓶子还在。标签还在,小字印刷也都在。但柜台从温暖的木头变成了浅色的石头,背景中咖啡师身后出现了一个架子,玻璃上的冷凝水突然到处都是,光线的颜色也变了。
我并没有为草稿省钱。我拍了两卷不同的胶片。
这不是一个 bug。这正是 H3 上“2K”的实际含义,一旦你理解了这一点,每个人给出的标准建议——先便宜地草稿,再贵地完成——就悄然失效了。下面是那次测试的所有数字,以及让便宜草稿奏效的一个改变。
关键要点(所有数据均在 Atlas Cloud 上测量,2026-08-05)
- 768P 输出 1344x768,2K 输出 2560x1440(16:9 请求)。像素数和视频比特率均为 3.6 倍。
- 4 秒片段的计费为 $0.40 vs $0.56,即 $0.10/s vs $0.14/s。768P 每秒便宜 29%,而非半价。
- 768P 在文生视频对中返回速度 快 28%(130s vs 181s),在图生视频对中快 17%(194s vs 234s)。
- 相同提示词下,768P 和 2K 的文生视频产生了 两个不同的版本,而非一个版本的两个质量级别。裸 768P 草稿并不能预览你的 2K 最终版。
- 使用图生视频锁定第一帧后,漂移停止。相同的场景、构图、标签位置,2K 将其额外像素精确用在了 MiniMax 所说的地方:小字印刷。
- 768P 并非受限功能。 截至 2026-08-05,两个分辨率层级均在分辨率枚举中并可在下拉菜单中直接选择,无论旧版汇总文章如何说。
MiniMax H3 2K vs 768P:768P 仍处于内测阶段吗?
不,这一点值得尽早澄清,因为它仍在许多发布后不久撰写的定价汇总中被重复提及。
我今天提取了所有三个 H3 端点的实时输入模式。resolution 字段为 enum: ["768P", "2K"],默认值为 "2K",适用于文生视频、图生视频和参考生视频;duration 在所有端点上均为 4 到 15 秒的整数秒。没有标志、没有门槛、没有销售表格。然后我在两个不同端点上提交了 768P 任务,两者均完成并按照较低费率计费。如果某个页面告诉你需要联系销售才能使用 768P,那么该页面描述的是发布第一周的情况,而非本周。
MiniMax H3 2K vs 768P,相同提示词,并排对比
左侧是 768P。右侧是 2K。相同的提示词、相同的 duration=4、相同的 ratio=16:9,连续提交给 minimax/h3/text-to-video。
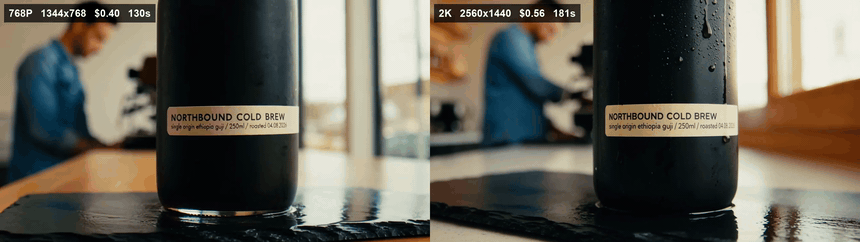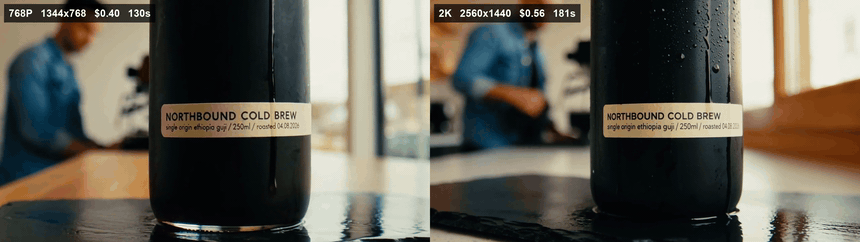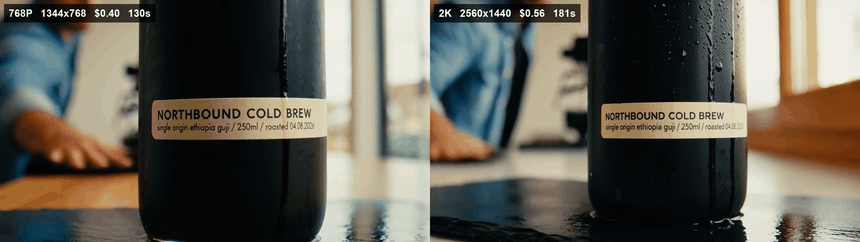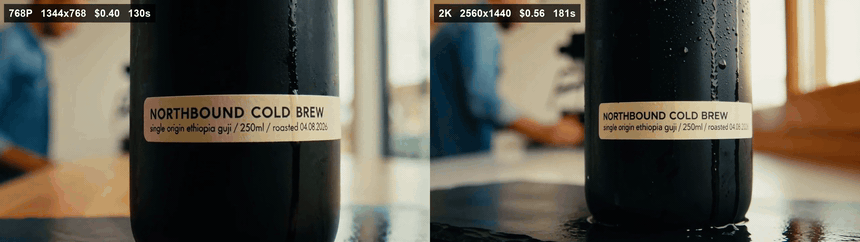
MiniMax H3 2K vs 768P 分屏,来自相同文生视频提示词,叠加了分辨率、价格和实际耗时
相同提示词,两次运行。左:768P,1344x768,$0.40,130s。右:2K,2560x1440,$0.56,181s。显示为静音 GIF;两个输出文件均携带 32 kHz 立体声音频。在 Atlas Cloud 上测量,2026-08-05。
看看实际差异在哪里。不是清晰度。而是胶片本身。不同的柜台材料、不同的背景装饰、不同的冷凝水量、不同的相机高度、不同的色温,标签在瓶子上的位置也不同。提示词中并未要求任何这些变化。
现在来看大家通常认为会相反的部分。以下是两个版本中标签区域的裁剪图,从原始文件截取并放大到相同宽度,因此 768P 裁剪图的放大倍数高于 2K。
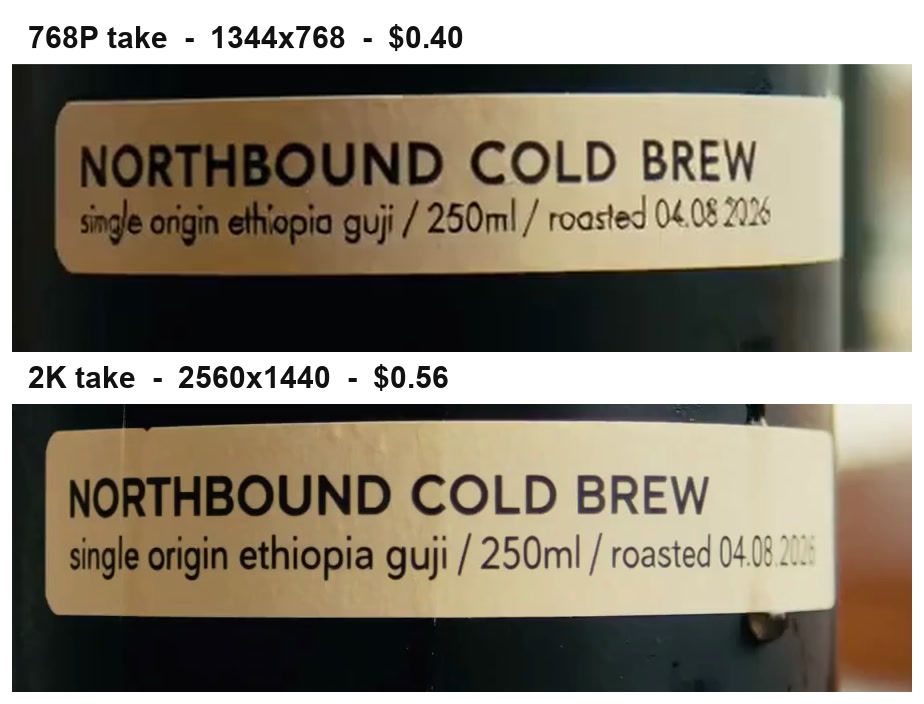
MiniMax H3 768P 和 2K 版本标签裁剪对比,两者的小字成分行均清晰可读
小字行 "single origin ethiopia guji / 250ml / roasted 04.08.2026" 在 768P 下依然清晰。虽然更柔和且字间距有波动,但没有任何内容难以辨认。这里 768P 的真正代价并非模糊文字,而是不同的构图。
因此,MiniMax H3 2K vs 768P 的诚实框架并非“清晰 vs 模糊”。而是“这个版本 vs 另一个版本,再加上细节增强”。
MiniMax H3 2K vs 768P 规格表(实测)
下表所有数据均来自输出文件的 ffmpeg -i 和完成预测的 price 字段,而非文档页面。
| 实测数据(基于输出文件) | 768P | 2K | 比例 |
|---|---|---|---|
| 输出分辨率(16:9 请求) | 1344x768 | 2560x1440 | 3.6倍像素 |
| 视频比特率 | 998 kb/s | 3,624 kb/s | 3.6倍 |
| 文件大小,4.46秒片段 | 620 KB | 2.00 MB | 3.3倍 |
| 帧率 | 24 fps | 24 fps | 相同 |
| 音轨 | AAC 立体声,32,000 Hz,131 kb/s | AAC 立体声,32,000 Hz,127 kb/s | 相同 |
| 容器时长 (duration=4) | 4.46s | 4.46s | 相同 |
| 提交到完成,实际耗时 | 130s | 181s | 1.39倍 |
| 实际计费 | $0.40 | $0.56 | 1.4倍 |
| 有效费率 | $0.10/s | $0.14/s | 便宜29% |
想用相同提示词将 MiniMax H3 与其他视频模型进行比较?Atlas Cloud 模型对比 在生成前就会显示分辨率和每秒成本。
两个脚注,让我花钱买来的教训。第一,两个分辨率层级对于 duration=4 的请求都输出了 4.46 秒,并均按 4 秒计费,所以你免费获得了额外的 0.46 秒,但不能围绕它规划剪辑。第二,音频在不同分辨率层级间完全相同。如果片段由对话或音乐同步主导,那么 2K 在关键方面毫无增益。
为什么 MiniMax H3 2K vs 768P 会让所有人困惑
因为 H3 上的 2K 并非放大步骤。而是第二次生成。
MiniMax 直接描述了该机制:“对于 H3 的 2K 输出,我们没有使用传统的专用超分辨率模块,而是让 H3 基础模型在上下文中重新生成自己的低分辨率输出。”他们还解释了为什么这样构建:上下文方法“让它再次利用原始的多模态上下文来生成高分辨率输出,恢复传统超分辨率只能‘猜测’且通常无法恢复的细节,如小文本和精细细节”(MiniMax,2026 年 7 月)。
用生产思维再读一遍。2K 过程回到你的原始上下文并再次生成。当你的上下文只是一个文本提示词时,“再次生成”意味着“再次掷骰子”。这正好是我两次运行所展示的。模型从未被告知要复制 768P 版本,因为它从未见过 768P 版本。
三种在实践中会出问题的方式:
- 你在文生视频上以 768P 滚动便宜草稿,挑选一个获胜者,然后以 2K 重新运行。 你得到一个陌生的结果。提示词被尊重,但胶片是新的。这就是本页顶部的测试。
- 你按每秒便宜 29% 的预算计划,认为总成本也便宜 29%。 事实并非如此,因为在任何实际批次中,最终版本才是昂贵的部分,而一次浪费的 2K 重新生成就会抵消多个草稿节省的费用。
- 你假设某个便宜的升级路径就在那里。 我检查了今天 Atlas Cloud 上的完整目录:452 个模型,三个 H3 端点,其中没有 H3 重新生成端点。在只有三个生成端点暴露的情况下,“将此片段升级到 2K”意味着要么重新生成,要么运行一个单独的放大程序。两者都需要花钱,而且它们提供的东西并不相同。
值得说明为什么值得围绕这个模型进行工程优化,而不是切换。发布时的头条卖点是“高达 2K 分辨率的视频,最长 15 秒的片段,原生立体声音频”(DataNorth AI,2026 年 8 月),而评分也支持这一点:H3 目前以 1,130 分位居 Artificial Analysis 视频编辑 Elo 排行榜榜首,领先于 Gemini Omni Flash 的 1,122 分,并领先 Dreamina Seedance 2.0 720p 的 1,037 分 93 分(Artificial Analysis,2026 年 8 月)。质量值得一个工作流。工作流只需要尊重 2K 是如何生成的。
本 MiniMax H3 2K vs 768P 测试背后的四个模型,一个标签页搞定
整个测试涉及四个模型、一个 API 密钥、一张账单。我在 Atlas Cloud 上运行,因为否则在图像模型、两个 H3 端点和放大程序之间切换意味着三个账户和三张发票需要在月底对账。
| 本测试中的任务 | 模型 | 截至2026年8月的价格 | 我实际支付的费用 |
|---|---|---|---|
| 锁定第一帧 | openai/gpt-image-2/text-to-image | 列表价从 $0.009/图像起(更高token层级) | $0.1745,一张 2048x1152,质量高 |
| 草稿和最终版,锁定帧 | minimax/h3/image-to-video | $0.14/s (2K),$0.10/s (768P) | 各 $0.40 和 $0.56,4秒 |
| 裸控制对 | minimax/h3/text-to-video | 相同两个层级 | 各 $0.40 和 $0.56,4秒 |
| 保留版本,提升像素 | atlascloud/video-upscaler | $0.018/s 到 1080p,$0.024/s 到 2K,最低5秒 | $0.12,4.46秒片段 |
在复制数字之前有两个注意事项。H3 端点都发布了一个统一的标头费率 $0.14/s,即 2K 层级;768P 费率出现在账单中,而非列表中,所以请自己测量一次。而且这四个模型目前都没有折扣。如果你想精简锁定帧的步骤,openai/gpt-image-2-developer/text-to-image 在2026年8月享有50%折扣(从 $0.009 降至 $0.004),且是同一家族做相同的工作。
如何自己运行 MiniMax H3 2K vs 768P 测试
五个步骤,$2.21 的信用额度,大约 15 分钟的实际总时间。下面的每个提示词都是我发送的精确字符串。
首先三个参数说明,因为每个都可能悄悄导致一次运行失败:
- 在文生视频中,字段是
ratio,而非aspect_ratio,默认值为1:1,其枚举没有adaptive选项。请自行传递16:9,否则你会得到一个方形片段。在图生视频中,枚举只有adaptive,因为你的第一帧决定了形状。 - 始终显式发送
duration,而不是相信文档中默认的 8。你的计费基于实际输出,而非你的假设。 - 每个 H3 任务都会超过正常的行内超时,因此请异步提交并轮询。
price字段也填充得较晚:当status变为completed时,它通常仍为空,你需要再次轮询预测 ID 才能获得真实数字。没有第二次轮询,你就无法构建一个诚实的成本表。
步骤 1:用 GPT Image 2 锁定帧
这一步将草稿从彩票变成预览。将最终构图生成为静态图像,它就成为两次视频运行中不可移动的部分。
text1Macro product photograph of a matte black cold-brew coffee bottle standing on a wet slate slab, morning window light raking across it from the right. A cream paper label wraps the bottle, sharply legible: bold uppercase title "NORTHBOUND COLD BREW" on one line, and directly beneath it in small type "single origin ethiopia guji / 250ml / roasted 04.08.2026". Condensation beads on the glass, an espresso machine and a barista in a denim shirt softly out of focus in the background. Cinematic, shallow depth of field, warm neutral grade, photoreal, 16:9. 2
设置:质量 高,尺寸 2048x1152。不要在这里省钱。你希望 2K 过程保护的每一个细节都必须首先存在于这个帧中。
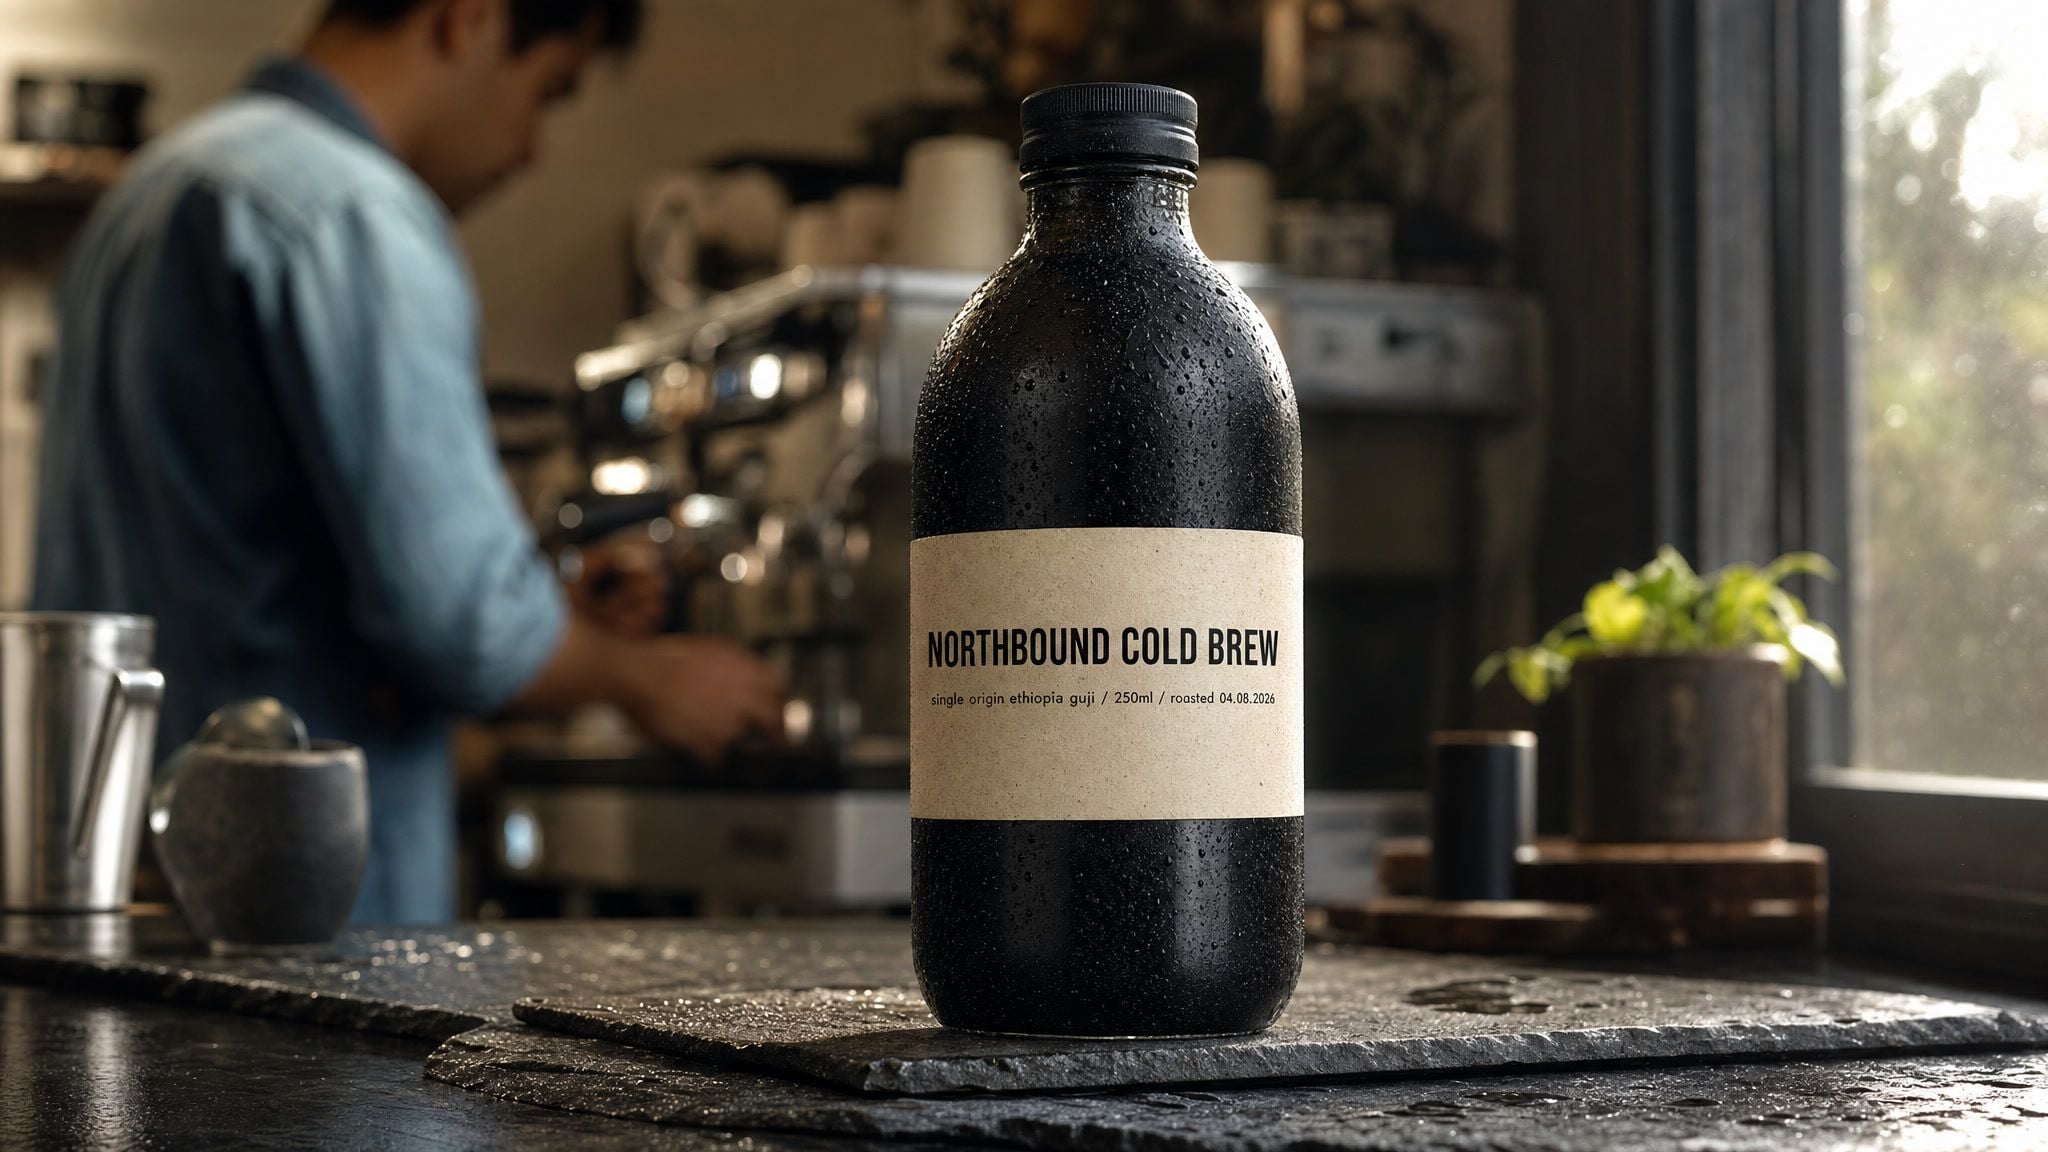
使用 GPT Image 2 生成的锁定第一帧,2048x1152,显示冷萃咖啡瓶及其清晰的小字
由 openai/gpt-image-2/text-to-image 生成,质量高,2048x1152。计费 $0.1745,耗时 146 秒。
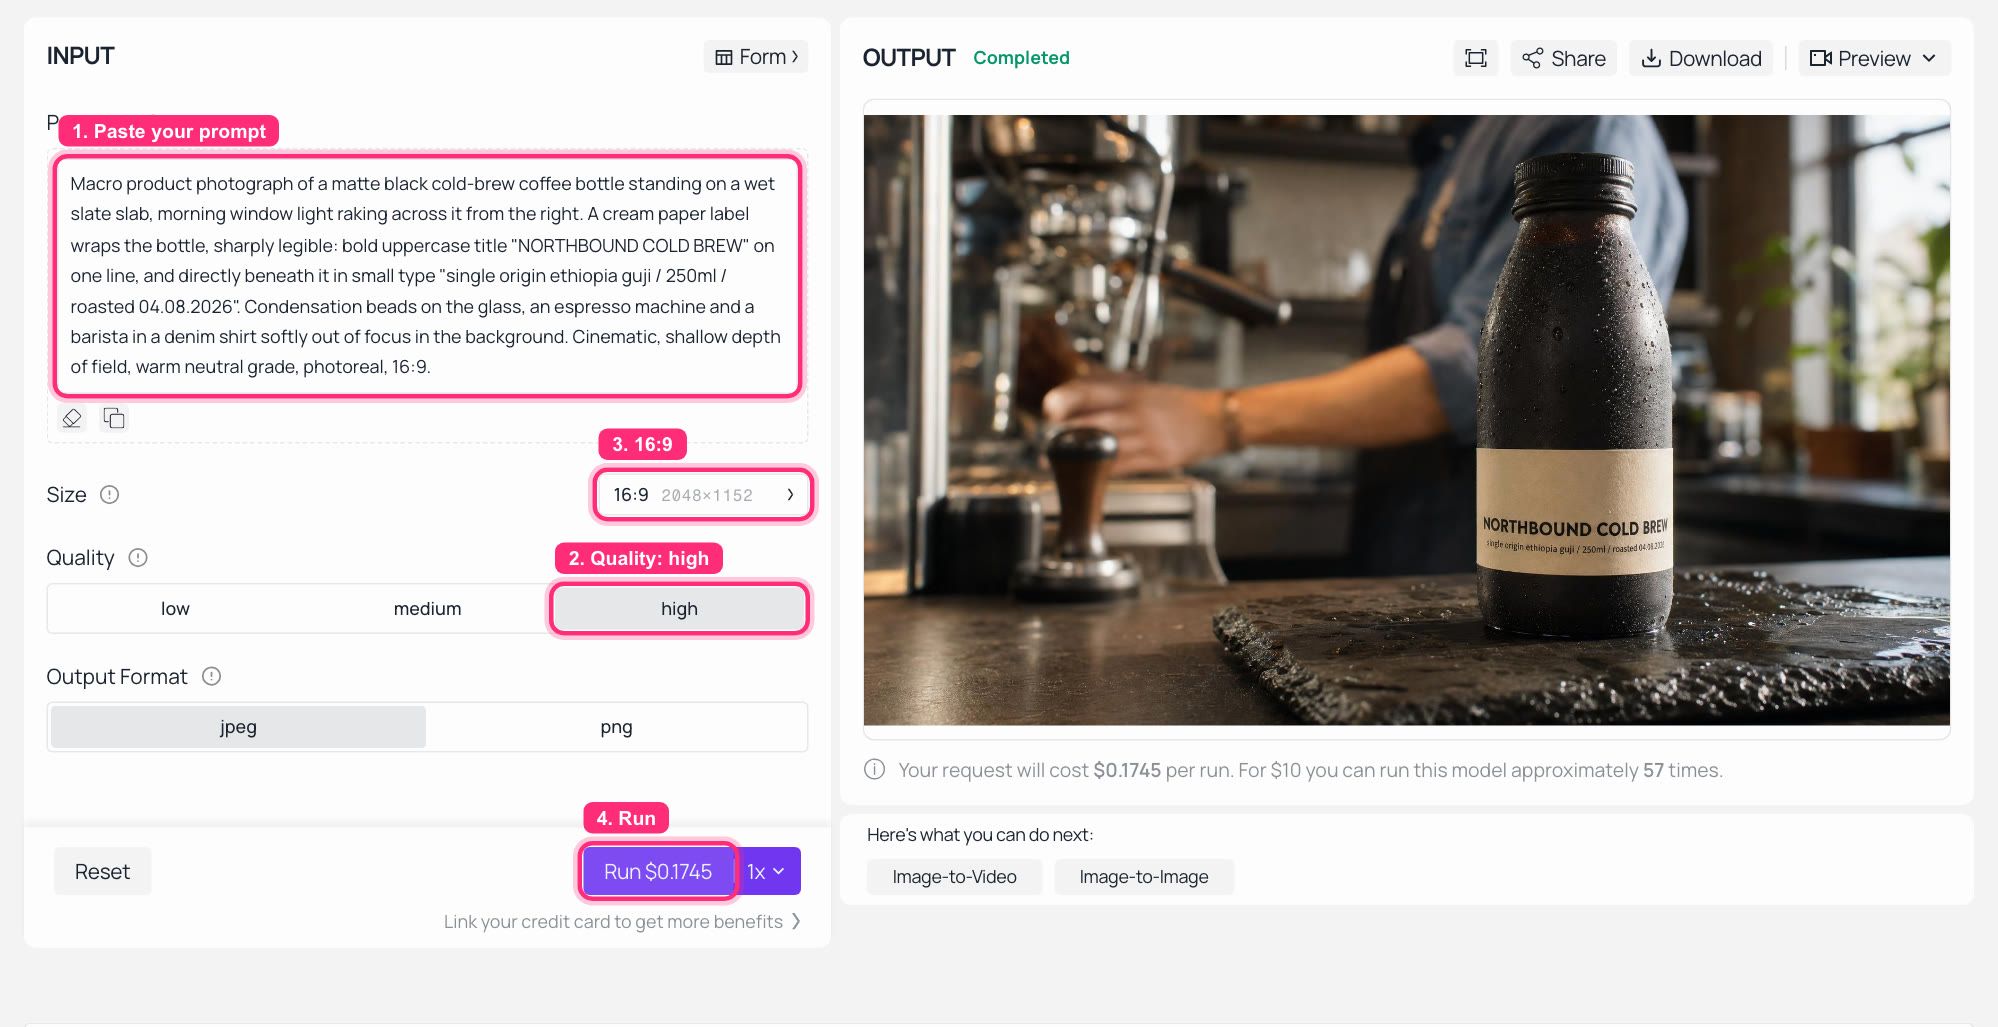
Atlas Cloud 上的 GPT Image 2 工作台,帧提示词已填写,生成的瓶子显示在输出面板中
Atlas Cloud 上的 GPT Image 2:质量设置为高,16:9,锁定帧渲染在右侧。
步骤 2:以 768P 起草
与最终版使用相同的端点。此步骤和步骤 4 之间仅分辨率不同。
text1Slow macro dolly-in on the bottle. Condensation beads slide down the glass. The label stays perfectly still and legible. In the soft background the barista wipes the counter once. Natural cafe room tone, a faint espresso machine hiss. No camera shake. 2
minimax/h3/image-to-video 的设置:第一帧 = 步骤 1 的输出,resolution=768P,duration=4,ratio=adaptive。
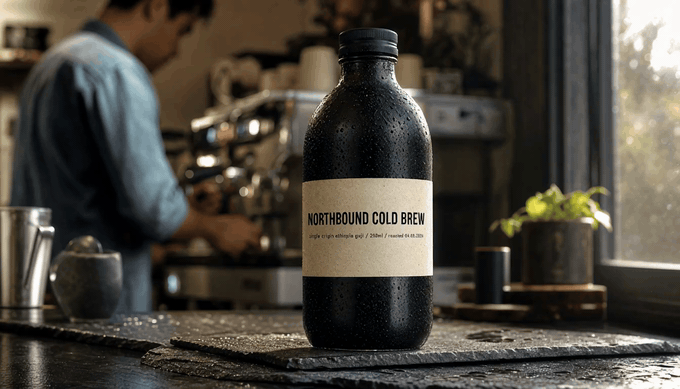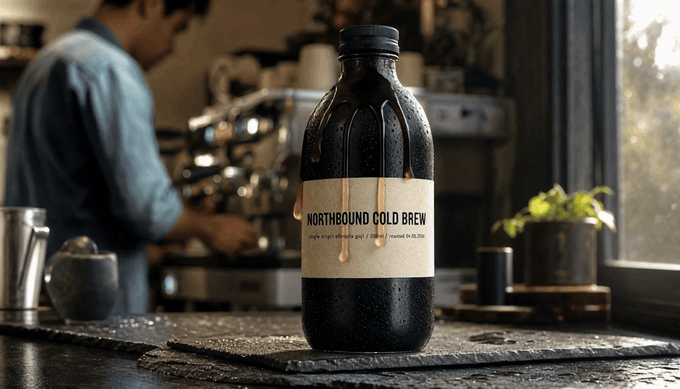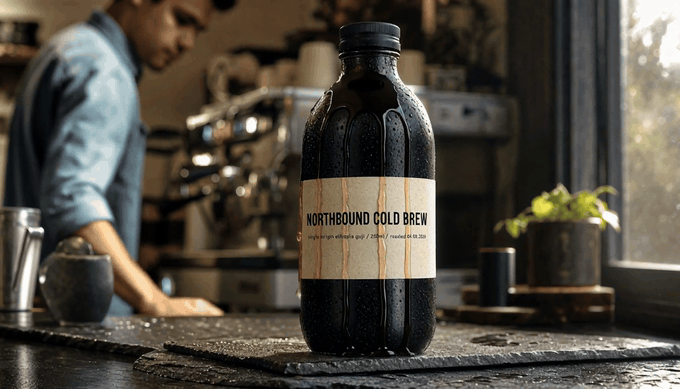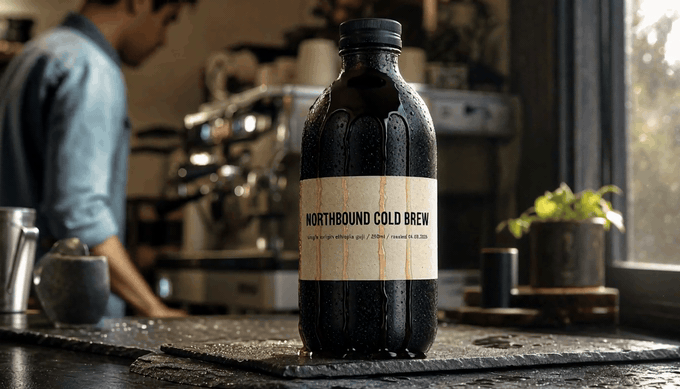
MiniMax H3 768P 草稿片段,向冷萃咖啡瓶缓慢微距推近
768P 草稿:1344x768,计费 $0.40,耗时 194 秒。显示为静音 GIF;文件本身携带 32 kHz 立体声。注意标签上向下涂抹的四条厚重水滴条纹。
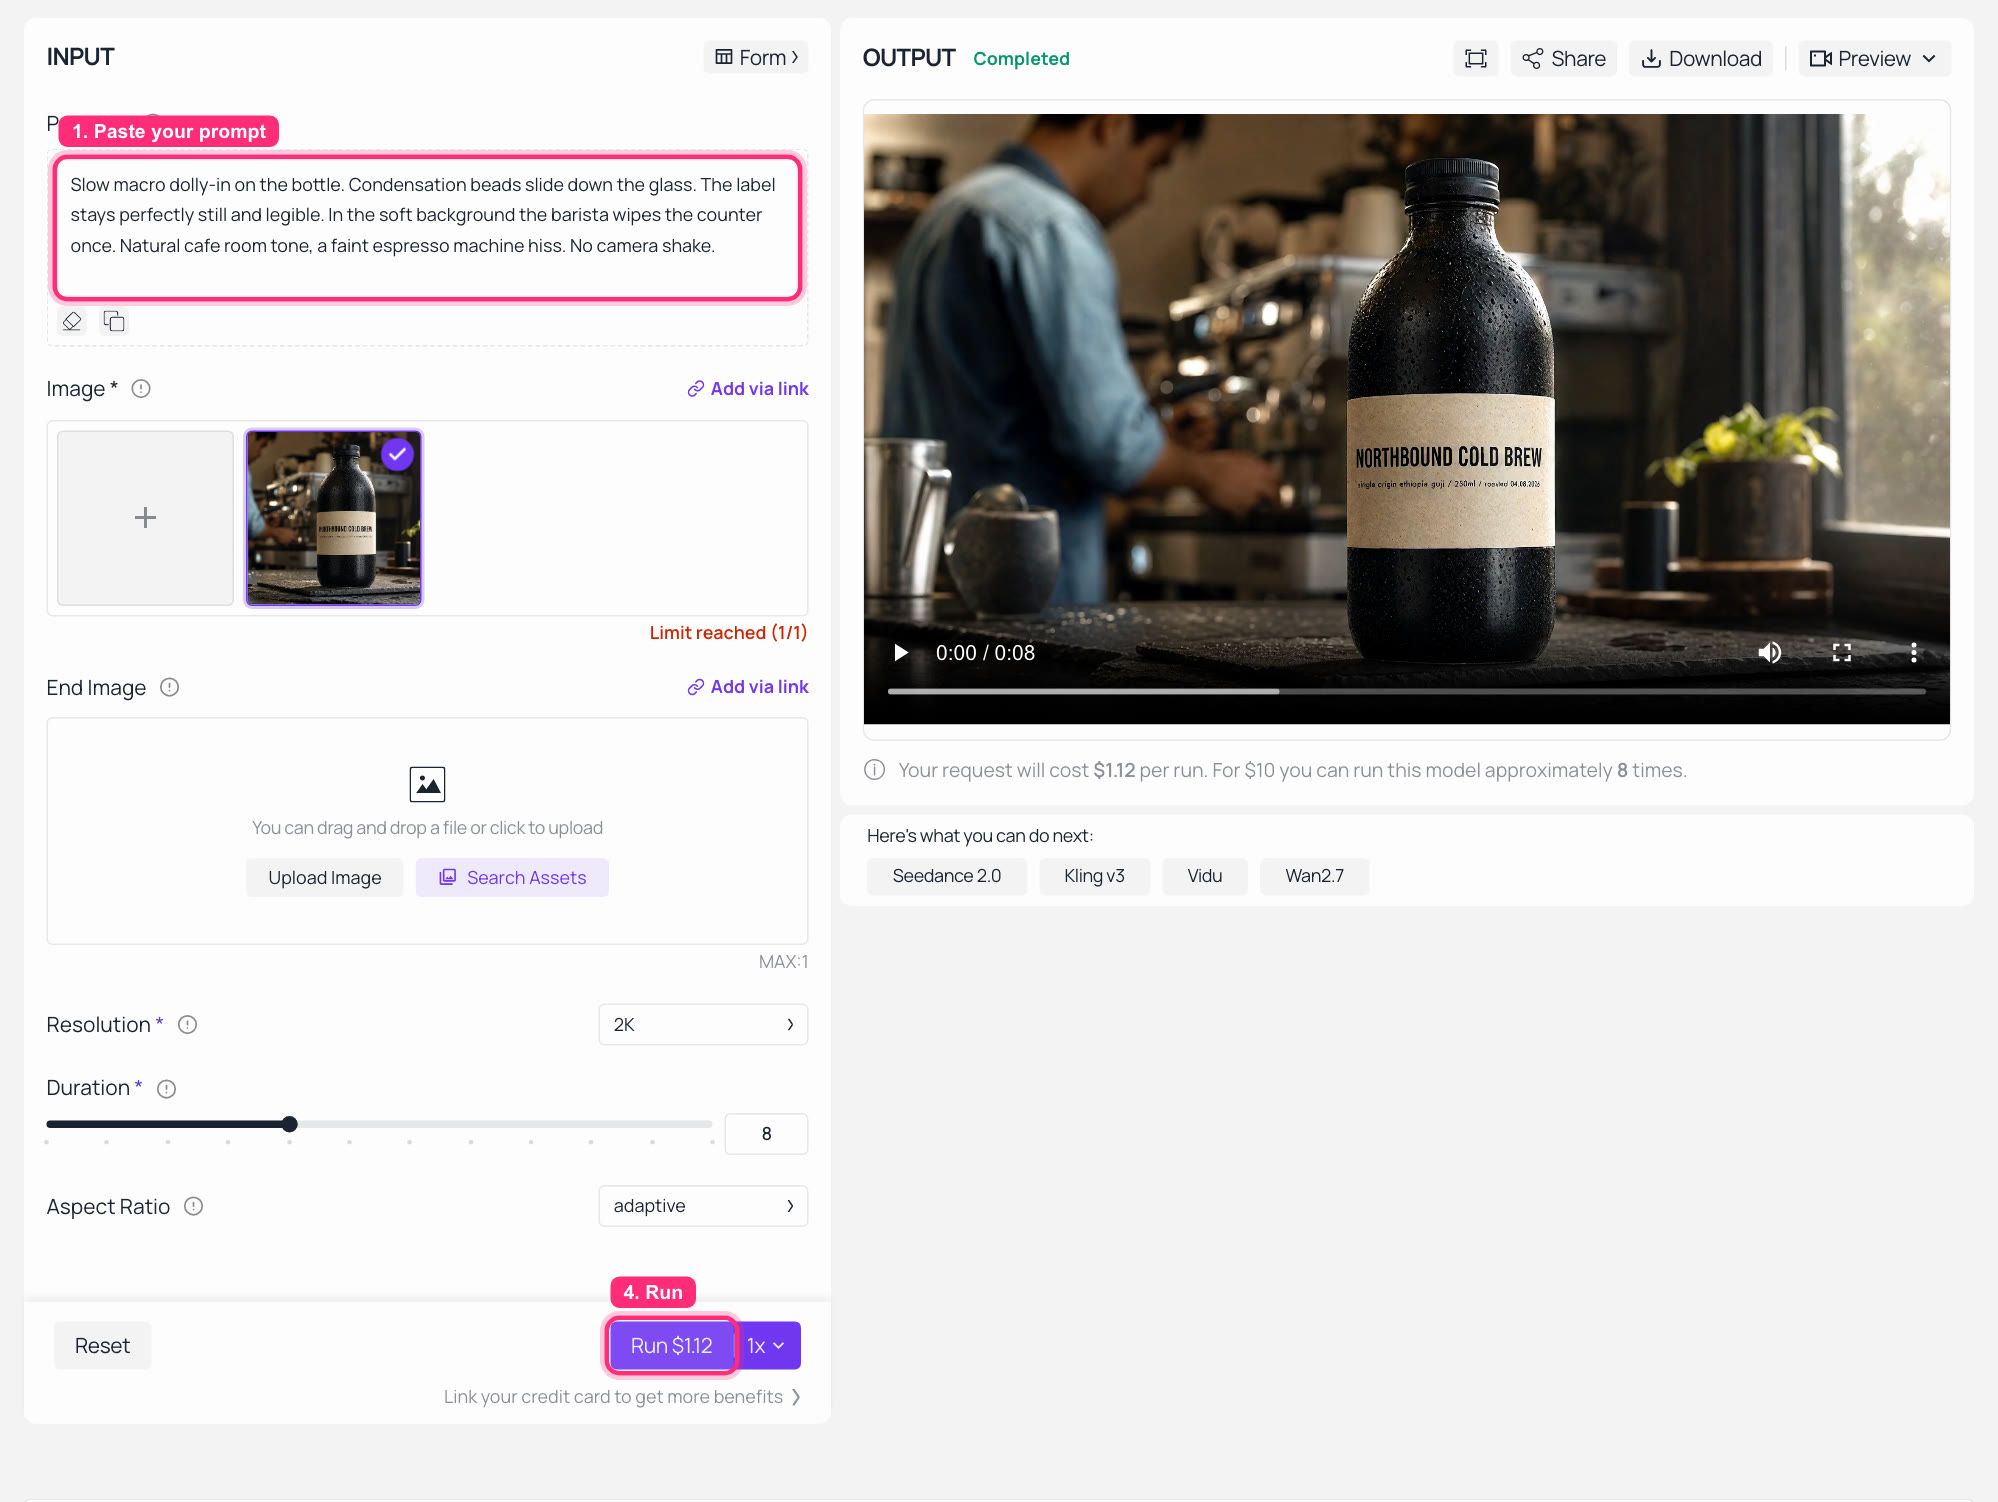
Atlas Cloud 上的 MiniMax H3 图生视频工作台,已上传锁定帧,输入提示词,输出面板中显示完成的片段
图生视频表单,已加载锁定帧。分辨率和时长是区分此步骤与步骤 4 的唯一两个字段,两个层级都位于同一个列表中,没有任何限制。此截图保留了 2K 和 8 秒的默认值,因此运行按钮显示 $1.12;将分辨率切换到 768P,时长切换到 4,该报价将降至 $0.40。
步骤 3:正确评估 MiniMax H3 2K vs 768P 草稿
草稿是排练,而非最终证明。根据我的两对测试,以下是它可靠告诉你和不可靠告诉你的内容。
可信赖的方面:提示词措辞、运动是否合理、摄像机移动量、四秒内的节奏、以及音频背景。所有这些都干净地转移了。
不可信赖的方面:精细表面纹理、产品上最小的字体、或其产生的任何伪影。在我的 768P 草稿中,标签上出现了四滴厚棕色滴痕,而 2K 运行没有产生,小字成分行也变成了模糊一团。如果因为我因为看起来脏而拒绝该草稿,我本会拒绝一个有效的提示词。
这就是真正的分工。768P 回答“这是否是正确的镜头”,2K 回答“这是否可交付”。
步骤 4:切换一个字段,以 2K 完成
相同的端点、相同的帧、相同的提示词字符串。将 resolution 改为 2K,其他不变。
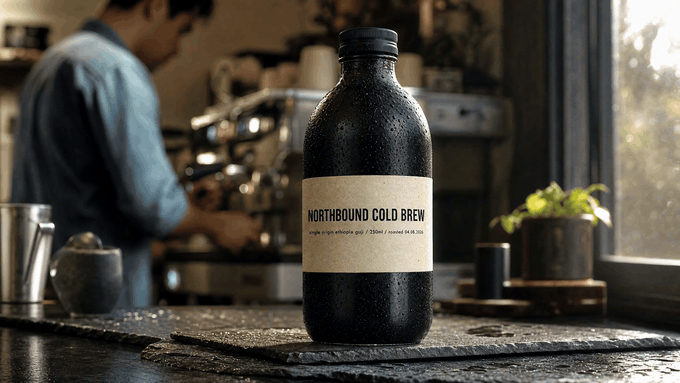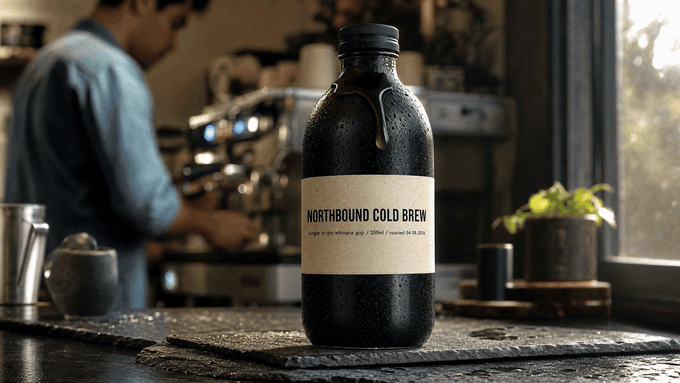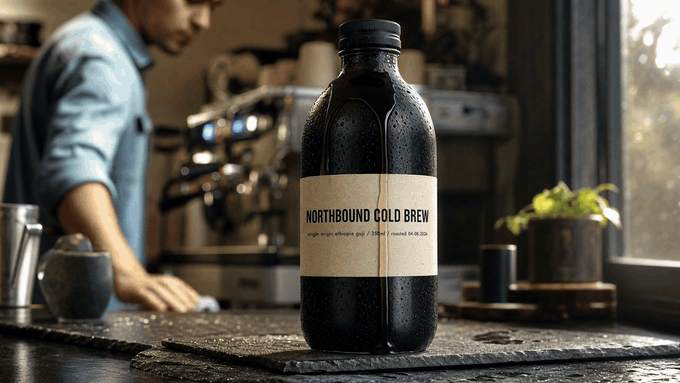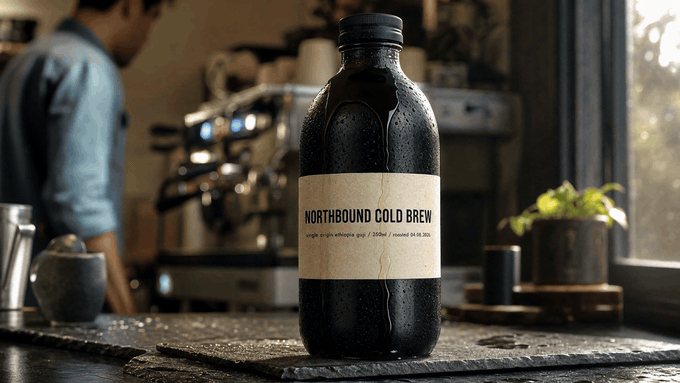
来自相同锁定第一帧的 MiniMax H3 2K 最终片段,标签干净,小字清晰
2K 最终版:2560x1440,计费 $0.56,耗时 234 秒。与草稿相同的石板、相同的咖啡机、相同的植物、相同的咖啡师、相同的标签位置。
以下是整篇文章旨在测试的问题的答案,结果令人满意。通过锁定第一帧,漂移停止了。布景、构图、相机高度和排版位置在 768P 草稿和 2K 最终版之间保持不变。差异仅限于细节:2K 过程清理了涂抹的滴痕,使其变成一条细流,解析了纸张纹理,并将小字成分行从噪声变回文字。这正是 MiniMax 声称的上下文重新生成行为,也是本测试中 2K 首次看起来像是一个质量层级,而非一次重新生成。
作为对比,这是对照组。裸文生视频在 2K 下的运行,正是产生了本页顶部那个陌生结果的运行。相同的提示词内容,没有第一帧,因此没有任何东西固定构图。
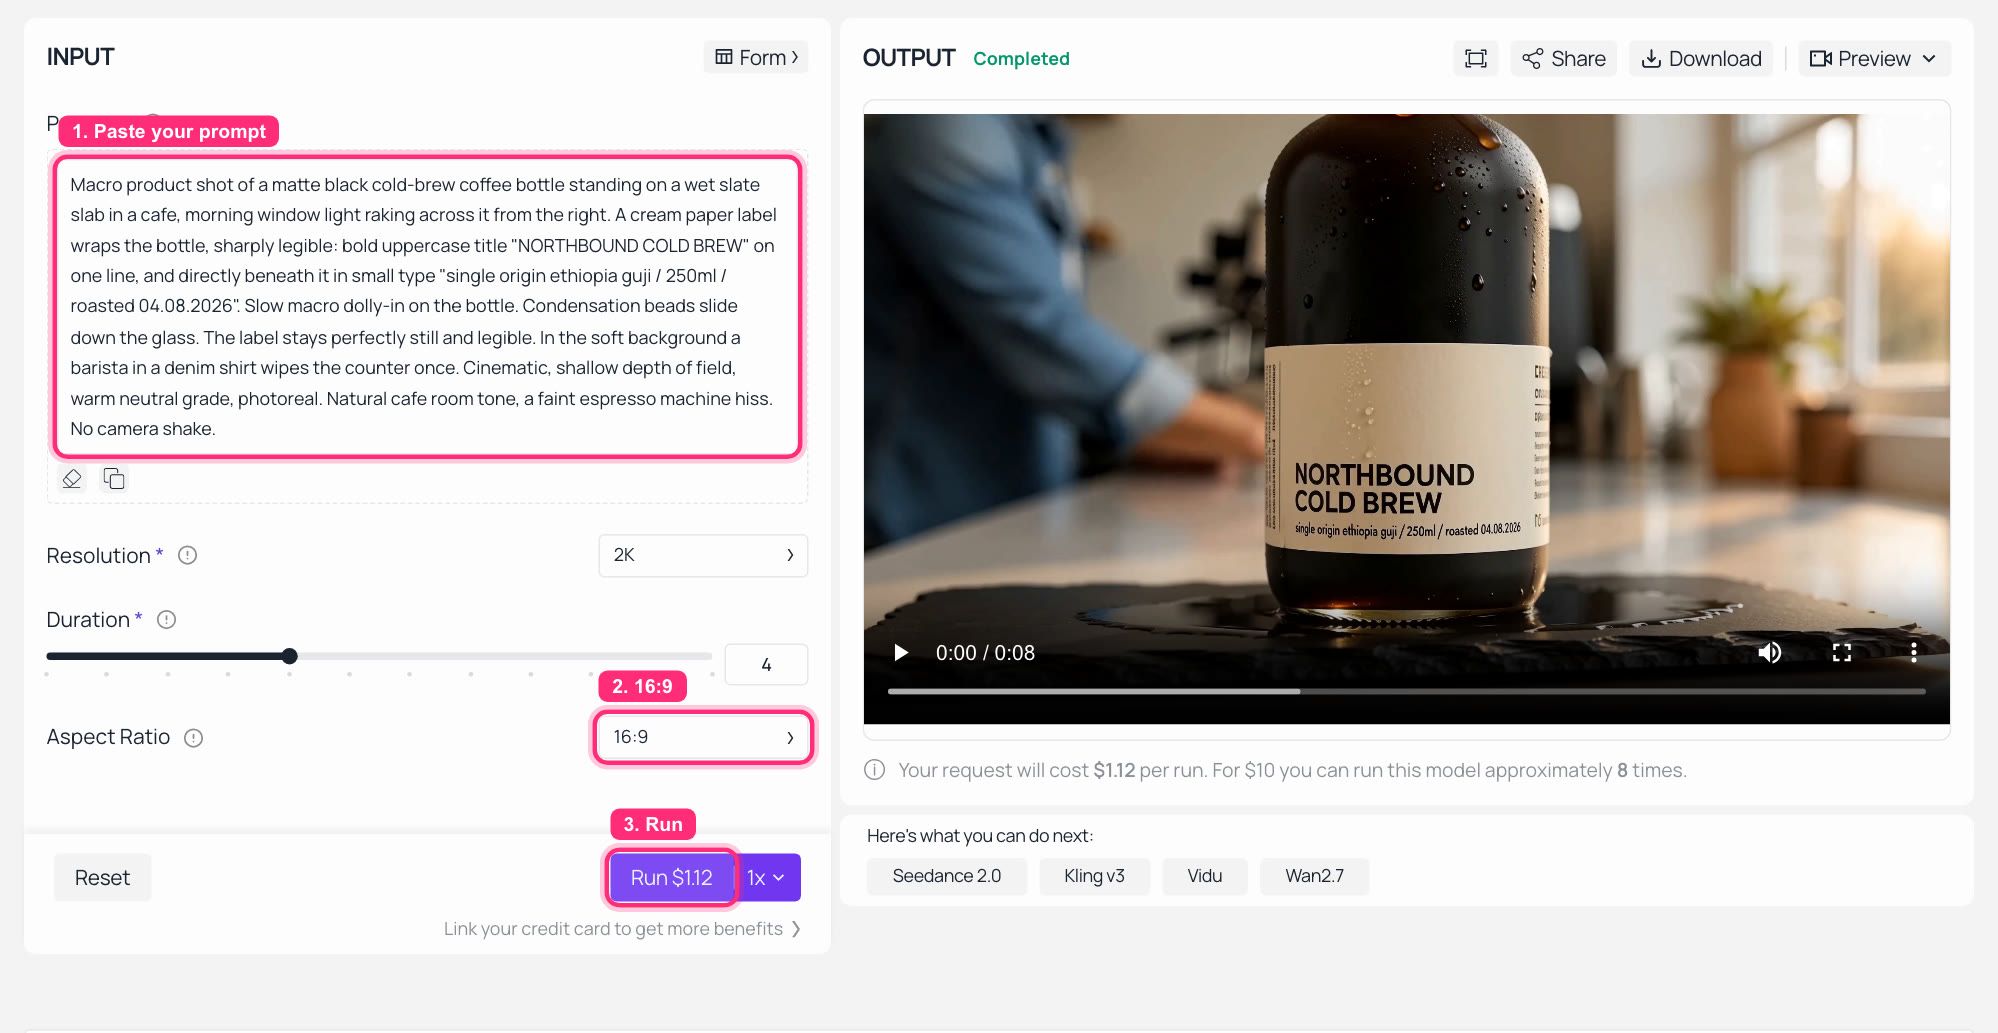
Atlas Cloud 上的 MiniMax H3 文生视频工作台,2K 分辨率,输出面板中显示完成的控制片段
Atlas Cloud 上的 MiniMax H3 文生视频:无第一帧,分辨率 2K,宽高比 16:9,输出面板中显示完成的片段。这个生成本身没有错。只是它并非 768P 运行产生的同一部电影。
步骤 5:或者跳过 MiniMax H3 2K vs 768P 重新生成,直接放大
有时 768P 版本已经是最好的了。表演到位,时机正确,你不希望重新生成可能导致不同结果。那么就不要重新生成。直接将精确文件通过放大程序处理。
atlascloud/video-upscaler 的设置:video = 你的 768P 输出 URL,target_resolution=2k。2K 输入上限为 23 秒和 690 帧,输入 fps 必须为 30 或更低,因此 H3 的 24 fps 片段可以轻松通过。
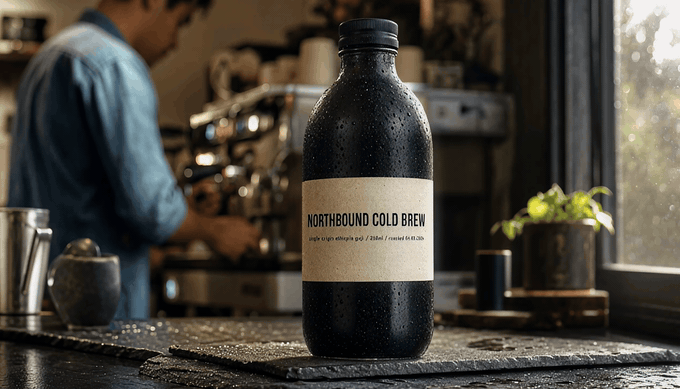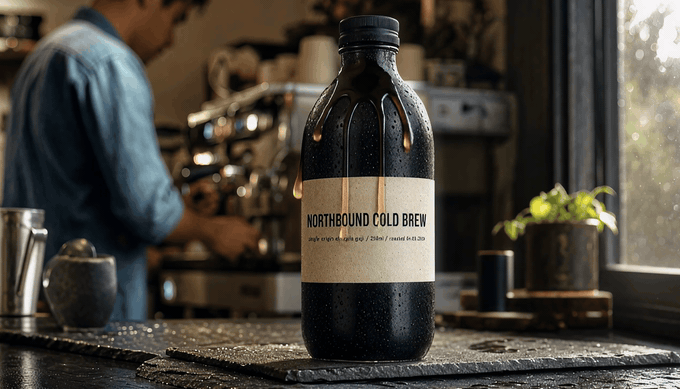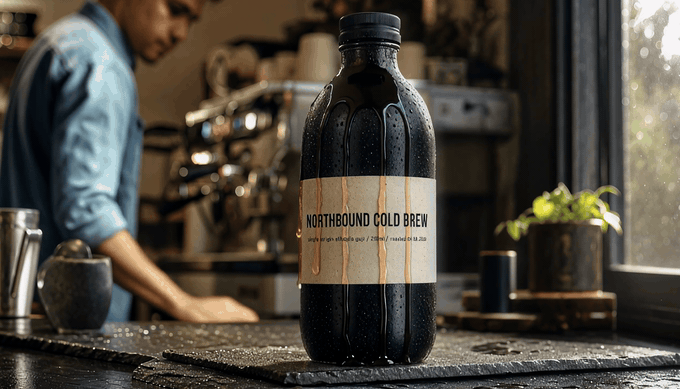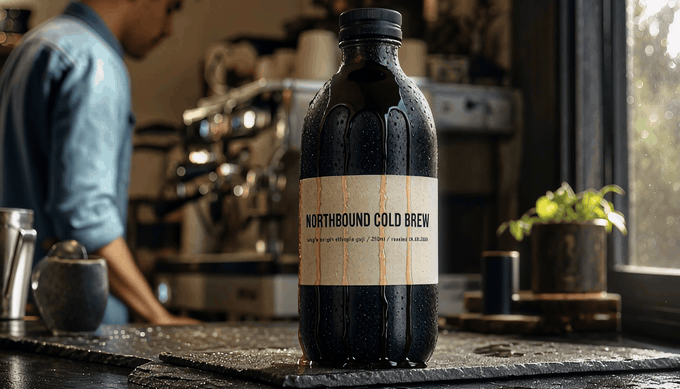
通过 Atlas Cloud 视频放大程序将 768P 版本放大到 2K,相同画面,更高分辨率
放大后的版本:2540x1452,计费 $0.12,耗时 40 秒。相同的四滴泪痕,一切都相同。这是同一部电影,而非新电影。
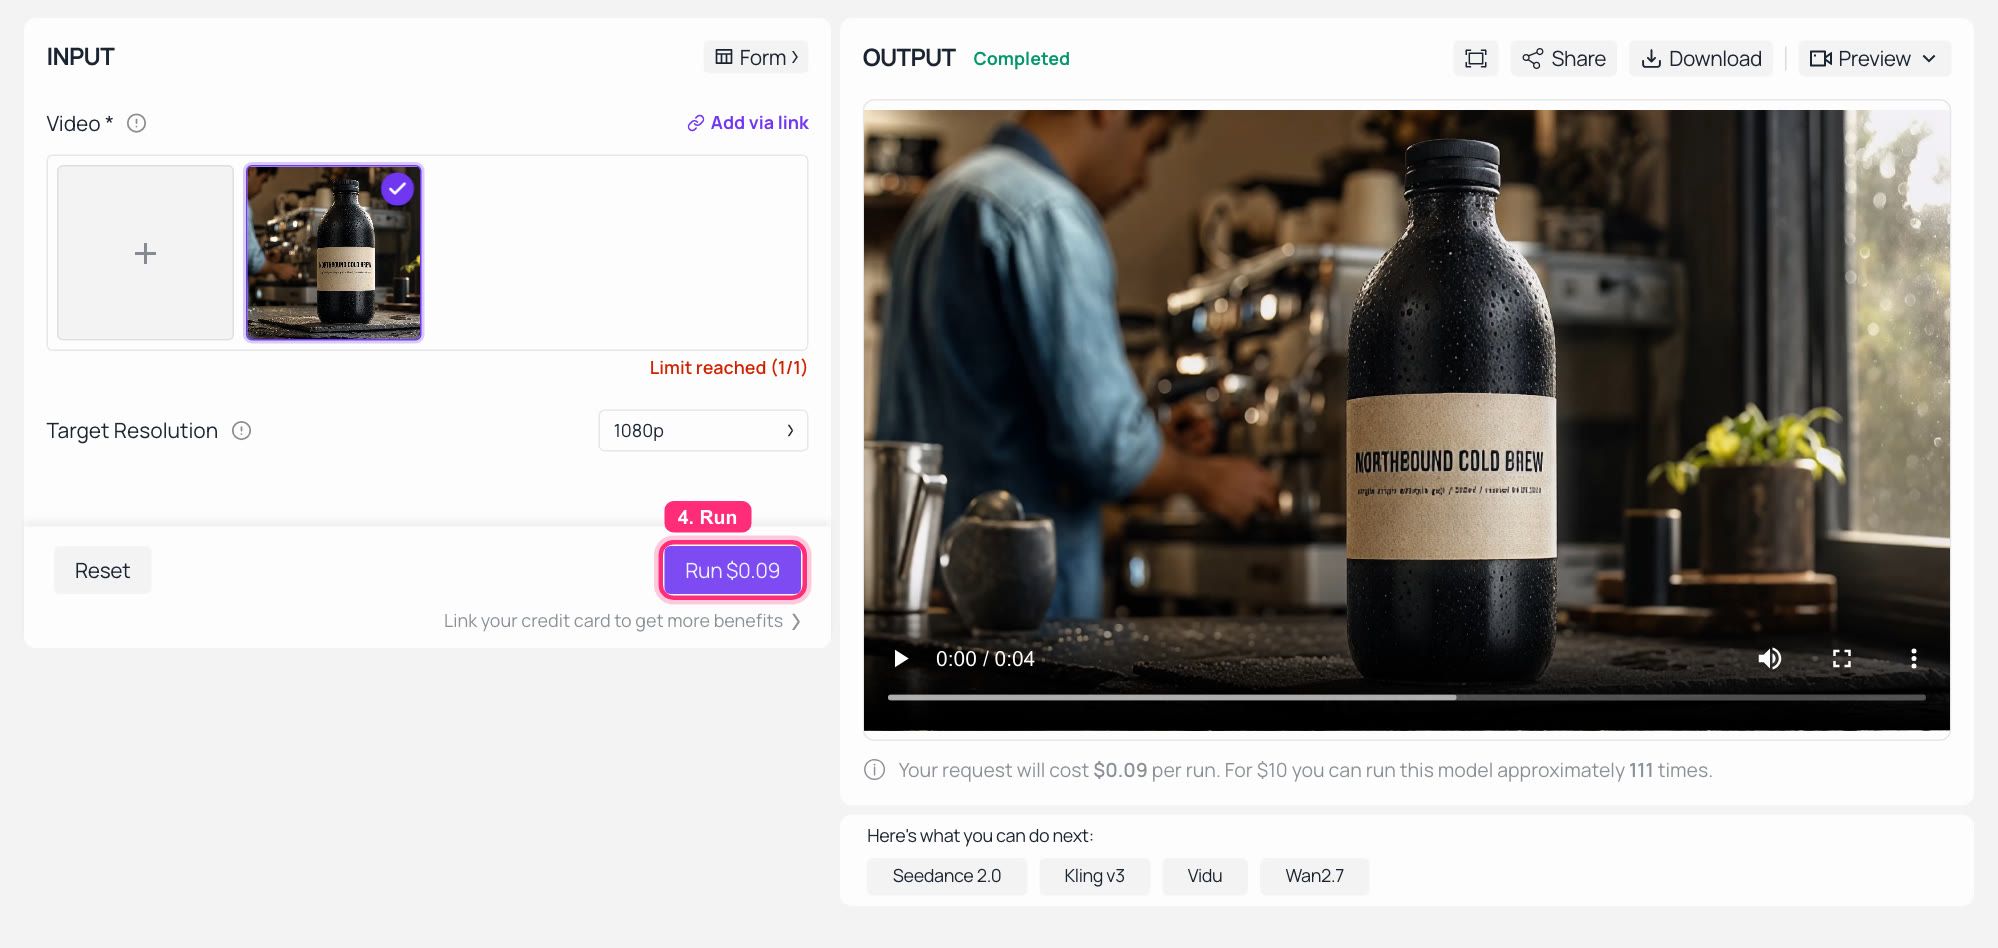
Atlas Cloud 视频放大程序工作台,已加载 768P 片段,输出面板中显示 2K 结果
Atlas Cloud 上的视频放大程序,已加载 768P H3 片段,右侧播放放大后的结果。此截图运行在 1080p 默认值上,运行按钮将其定价为 $0.09(任何低于 5 秒最小值的片段)。将目标分辨率切换为 2k,你就进入了 $0.024/s 层级,即我自己的运行中计费的 $0.12。
以下是任何人都不能错过的结论,所有三个标签裁剪图来自同一锁定帧,放大倍数相同。
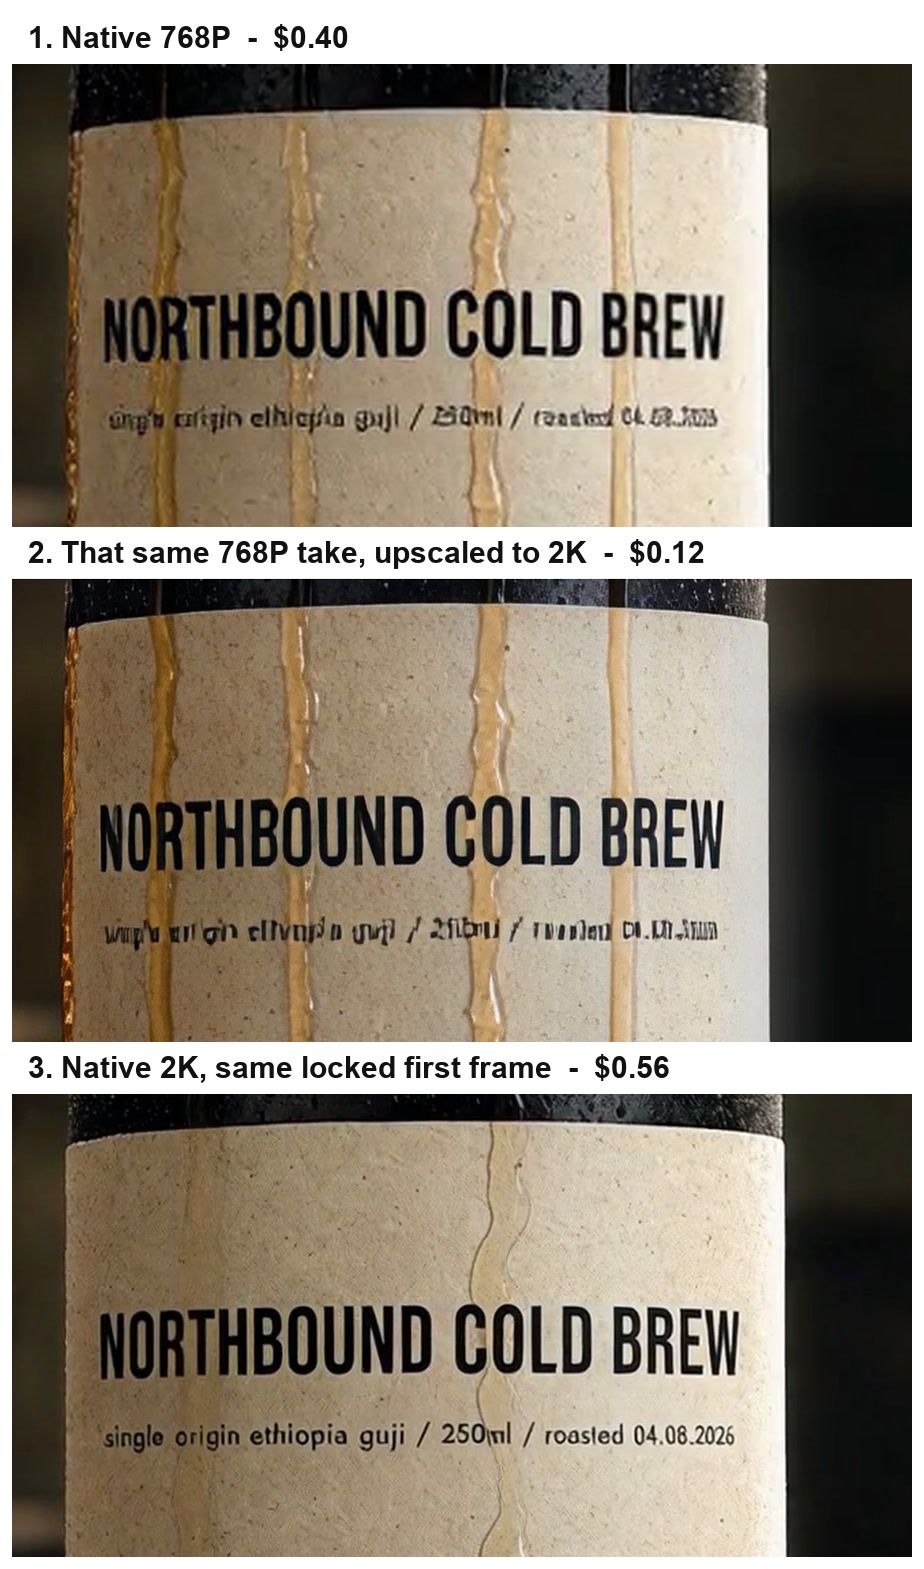
三向标签裁剪对比:原生 768P、该片段放大到 2K、原生 2K,显示只有原生 2K 恢复了小字
原生 768P、同一片段放大后、以及原生 2K。放大程序使纸张纹理和大标题变得锐利漂亮,并保留了确切的版本。它无法恢复小字行,因为该信息从未存在于 768P 文件中。而重新生成过程可以做到,因为它回到上下文而非像素。
因此,这两条路线并非竞争对手。它们回答不同的问题。放大保留表演。重新生成恢复细节。根据你的片段不能失去哪一个来选择。
值得在 MiniMax H3 2K vs 768P 上测试的变体
- 竖屏。 我的 16:9 测试返回了 1344x768,因此短边是层级固定的。9:16 请求在相同逻辑下应返回 768x1344,但在基于此假设构建竖屏批次之前,请先测量一次。在图生视频中,你可以通过第一帧设置形状,而不是与
adaptive枚举抗争。 - 讲话头像。 这是我会跳过草稿直接使用 2K 的地方。面部、牙齿和眼线正是重新生成过程存在的精细细节类别,而 768P 草稿会对三者都产生误导。
- 长片段。 在 15 秒时,差距扩大到 $1.50 vs $2.10,实际时间也随之延长。规划队列,而不仅仅是预算。
- 产品文字和多语言工作。 H3 稳定的帧内文字和原生多语言音频正是人们最初选择它用于商业包装的原因。两者在 768P 下都保持良好,这使得 768P 成为社交媒体裁剪的实用交付层级,而不仅仅是排练室。
MiniMax H3 2K vs 768P 每个可用片段的实际成本
首先,达到 2K 可交付成果的三条路线,每个 8 秒片段,基于我实际被收取的费率。
| 达到 2K 片段的路线 | 使用的费率 | 一个 8 秒片段的成本 | 保留相同版本 | 恢复小文字 |
|---|---|---|---|---|
| 直接到 2K | $0.14/s | $1.12 | 不适用 | 是 |
| 768P 草稿,然后在锁定帧上 2K 重新生成 | $0.10/s 然后 $0.14/s | $0.80 + $1.12 = $1.92 | 是,如果第一帧被锁定 | 是 |
| 768P 最终版,然后放大到 2K | $0.10/s 然后 $0.024/s | $0.80 + $0.192 = $0.99 | 是,完全 | 否 |
现在来看决定你月份的数字。取一个现实组合:10 个 4 秒草稿滚动以找到镜头,然后两个完成的 8 秒片段。
| 10 个草稿 + 2 个最终版的批次 | 草稿 | 最终版 | 帧锁定 | 总计 |
|---|---|---|---|---|
| 全部使用 2K | 10 x 4s x $0.14 = $5.60 | 2 x 8s x $0.14 = $2.24 | 无 | $7.84 |
| 768P 草稿,2K 最终版,锁定帧 | 10 x 4s x $0.10 = $4.00 | $2.24 | $0.17 | $6.41(少 18%) |
| 768P 草稿,768P 最终版,放大后 | $4.00 | 2 x ($0.80 + $0.192) = $1.98 | $0.17 | $6.15(少 22%) |
诚实地阅读中间行。每秒节省 29%,但每批次节省 18%,因为你的最终版仍然是最终版。只有当草稿占主导地位时,节省才会接近 29%:在 20 个 8 秒草稿滚动而非 10 个短草稿的情况下,第二条路线大约比全部 2K 便宜 25%。而每一分钱都依赖于锁定帧,因为没有它,那十个便宜滚动就是十部你不会发布的电影。
第二个红利是时间,这可能更重要。在文生视频对中,768P 返回速度快 28%,并且在两个对中,它从未花费更长时间。在那些实际时间下的 4 秒片段上,这意味着大约每小时 27 个草稿滚动,而不是 20 个。当你还在寻找正确的提示词时,额外的七次机会比节省的 1.60 美元更重要。
一个法律说明,如果你打算通过自托管来避免所有这些问题。Hugging Face 上的开放权重是 H3-Base,它在 768 短边上生成。2K 过程存在于 API 端,因此开放权重只能得到草稿层级,而非最终层级。社区许可证还包含覆盖欧盟、英国、韩国和美国的排除领土,并提供了一个单独的授权渠道,因此在本地签出上构建商业管道之前,请阅读许可证。要更全面地了解已发布权重包含和不包含的内容,请参阅我们的 MiniMax H3 评测,以及完整模型目录,如果你想将 H3 与当前视频领域的其他模型进行定价比较。
常见问题
在 MiniMax H3 2K vs 768P 中,768P 实际上每个片段更便宜吗?
是的。我为一个 4 秒的 768P 片段支付了 $0.40,为相同请求的 2K 支付了 $0.56,因此 $0.10/s vs $0.14/s,每秒节省 29%。关键在于,只有当便宜运行能教会你关于昂贵运行的一些信息时,节省才有效,这需要锁定第一帧。裸文生视频的 768P 草稿是一个独立的电影,花在上面的钱不是节省的钱。
在 MiniMax H3 2K vs 768P 中,2K 只是 768P 输出的放大版吗?
不。MiniMax 让基础模型在上下文中重新生成自己的低分辨率输出,而不是运行专用的超分辨率模块,这就是为什么 2K 可以恢复小文字和精细表面细节,而放大程序只能近似。我的三向标签裁剪图精确展示了这一点:放大的 768P 片段锐化了纸张纹理,但让小字成分行保持为不可读的噪声,而原生 2K 运行将其变回文字。
我的 MiniMax H3 768P 草稿看起来会像我的 2K 最终版吗?
只有在锁定第一帧的情况下。在裸文生视频上,两个层级从相同的提示词给了我不同的布景、不同的相机高度、不同的冷凝水和不同的标签位置。在具有固定第一帧的图生视频上,构图、取景和排版在层级之间保持不变,唯一的变化是细节和纹理。
我仍然需要联系销售才能使用 MiniMax H3 768P 吗?
不需要,截至 2026-08-05 为止。所有三个 H3 端点上的实时模式将 resolution 列出为 enum: ["768P", "2K"],工作台在一个下拉菜单中显示两者,我的 768P 任务在两个不同端点上均完成并按照较低费率计费。内测的说法来自发布后最初几天撰写的报道。
在 MiniMax H3 2K vs 768P 中,2K 慢多少?
在我的 4 秒对上,慢 1.2 到 1.4 倍:文生视频 181s vs 130s,图生视频 234s vs 194s,从提交到完成测量。从架构上讲,2K 是同一上下文上的第二次生成过程,因此绝对差距在更长片段上会扩大,而非保持不变。
我可以在不重新生成的情况下将 768P 片段升级到 2K 吗?
你可以通过将其通过视频放大程序来提高分辨率,而无需更改版本,这花费了我 $0.12(一个 4.46 秒片段,2K 层级,$0.024/s,最低 5 秒),并在 40 秒内返回。这逐帧保留了表演。但它不会恢复从未捕获的细节,因此如果去 2K 的目的是让小的文字清晰可读,那么你需要的是重新生成过程,而不是放大程序。


