我盯着三块Artificial Analysis排行榜看了十分钟,想弄清楚到底谁赢了。
文本生成视频:Gemini Omni Flash 领先5分。图片生成视频:Gemini 领先2分。视频编辑:MiniMax H3 领先9分。
然后我看了置信区间那一列。正负7。正负9。正负10。
三块排行榜,三个差距,每一个都在自己的误差线之内。在盲评中,这两个模型实际上是同一个模型。
于是我关掉排行榜,改打开下拉菜单。那个差距根本不是5分。那是整整一个分辨率等级。
关键要点
- 所有三个Artificial Analysis差距(+5、+2、+9,数据截至2026年8月6日)都落在±7到±10的置信区间内。从原始质量看,这是平局,不是胜利。
- H3 提供2K分辨率,最长15秒,六种画面比例。Gemini Omni Flash 的API上限为720p、10秒和两种画面比例。这些是枚举值,不是主观意见。
- H3 接受音频作为输入。Gemini 不支持。Gemini 有
seed和thinking_level。H3 两者都没有。 - Gemini 有一个专门的
video-edit端点,用于修改你的原始片段。H3 的修改路径是reference-to-video,它会以你的片段作为参考重新生成。它们不是同一个操作,第二轮测试证明了这一点。 - 两者中只有一个可下载权重,而且不是Google那个。
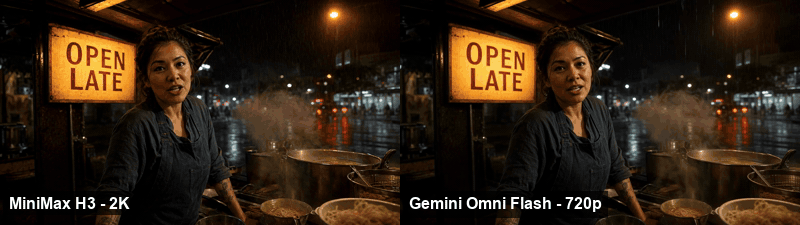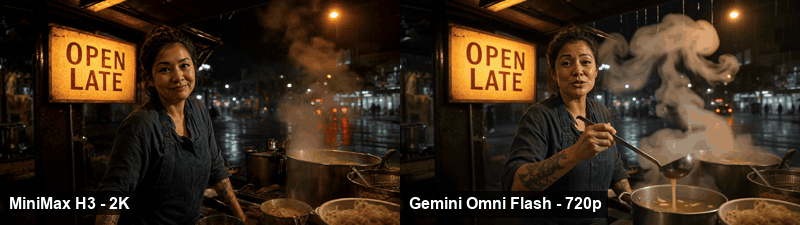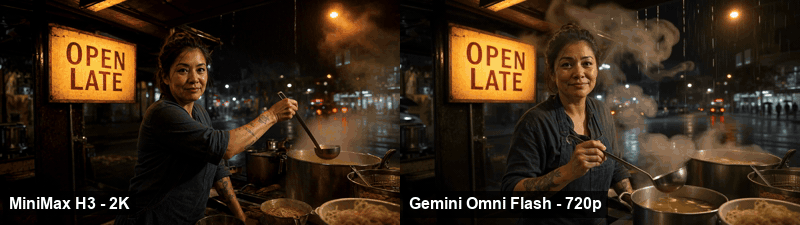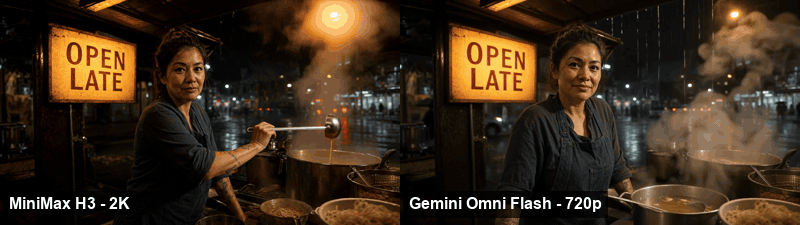
MiniMax H3 对比 Gemini Omni Flash 测试第一轮,两个模型用相同的首帧生成动画,并排展示
第一轮:相同的首帧、相同的提示词、相同的时长。左侧 MiniMax H3 以2K生成,右侧 Gemini Omni Flash 以720p生成。此处显示为静音GIF;两者交付的文件均带有原生音频,下文也嵌入了可播放的视频。这就是问题所在:它们都很好。
为什么 MiniMax H3 对比 Gemini Omni Flash 的排行榜差距被误读
你几乎能找到的所有关于 MiniMax H3 对比 Gemini Omni Flash 的文章都只引用一个排行榜和一个价格。这两种习惯都会得出错误答案。
以下是所有三个Artificial Analysis排行榜,以及每个人都跳过的那一列。
表A:MiniMax H3 对比 Gemini Omni Flash 在三个Artificial Analysis排行榜上的表现(含音频),数据截至2026年8月6日
| 排行榜 | Gemini Omni Flash | MiniMax H3 | 差距 | 是否在误差范围内? |
|---|---|---|---|---|
| 文本生成视频 | 1,243 (#1) ±7, 11,842 票 | 1,238 (#2) ±9, 6,830 票 | Gemini +5 | 是 |
| 图片生成视频 | 1,191 (#2) ±9, 6,506 票 | 1,189 (#3) ±10, 5,545 票 | Gemini +2 | 是 |
| 视频编辑 | 1,123 (#2) ±5, 11,706 票 | 1,132 (#1) ±6, 9,128 票 | H3 +9 | 是,勉强 |
你可以在 Atlas Cloud 模型对比 中,用相同的提示词并排运行 MiniMax H3 和 30 多个视频模型——生成前会显示每秒成本。
Elo 分数来自 Artificial Analysis Video Arena(Artificial Analysis,2026年8月)。图片生成视频排行榜由 Dreamina Seedance 2.0 720p 以 1,197 分领跑,所以这两个模型都不占榜首。这些是滚动众投票分数,会有变动,这正是为什么5分的差距不能作为定论。
5分的领先优势搭配±9的区间,意味着排名可能仅凭投票噪音就在下周翻转。这并非“Gemini 在文本生成视频上更好”。这是抛硬币,只不过加了个计分板。
还有三件事人们常搞错:
美元/分钟这一列不是你实际支付的费用。 Artificial Analysis 列出 Gemini 为 $6.00/分钟,H3 为 $7.80/分钟。该列标准化为默认设置下生成一分钟 1080p 视频的成本。而 Gemini Omni Flash 根本无法生成 1080p。所以这个数字是建模估算,不是账单。比较的是最终交付物,而不是秒数。
一块排行榜不代表整个模型。 H3 在三块排行榜上分别位列第二、第三和第一。Gemini 分别位列第一、第二和第三。单独引用任何一块,你都能证明你原本就相信的结论。
“Omni”并不意味着“什么都能吃”。 这是一个好名字,同时也具有误导性。这两个模型中有一个能接收音频文件作为输入。它不是名字里带“omni”的那个。
没人印出来的 MiniMax H3 对比 Gemini Omni Flash 规格表
如果 Elo 分数无法区分它们,那么约束表可以。我从两个模型的实时 API 模式中提取了数据,而不是相信任何发布文章,差异并不细微。
表B:MiniMax H3 对比 Gemini Omni Flash 硬性约束,来自 2026年8月6日 的实时 API 模式
| 约束条件 | MiniMax H3 | Gemini Omni Flash |
|---|---|---|
| 分辨率 | 768P 或 2K | 720p,且这是枚举中唯一的值 |
| 时长 | 4 到 15 秒 | 3 到 10 秒 |
| 画面比例 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 | 仅 16:9 和 9:16 |
| 修改路径 | reference-to-video(使用参考重新生成) | 专用 video-edit 端点(修改你的原始素材) |
| 最后一帧控制 | 支持 end_image | 不支持 |
| 参考限制 | ≤9 张图片,≤3 个视频,≤3 个音频,总计 12 个文件 | 1 到 10 张图片 |
| 音频输入 | 是 | 否 |
| seed 可复现性 | 否 | 是 |
| thinking_level | 否 | 是(default / high / low) |
| 开放权重 | 是,在 Hugging Face 上 | 否 |
实事求是地看这张表,Gemini 明确胜出三行。可复现的种子对于需要两次渲染相同帧的管线很重要。真正的 video-edit 端点与基于参考条件重新生成是截然不同的工具。而 thinking_level 提供了一个 H3 完全没暴露的质量调节旋钮。
H3 胜出五行,而且这些行决定了你是否能交付客户要求的文件。
我下面所有的测试都在 Atlas Cloud 上运行,因为两个模型都在那里通过同一个 /api/v1/model/generateVideo 端点提供服务,这意味着整个测试只需要一个轮询循环和一个认证头。切换模型只需要修改 model 字符串。正是这个细节使得“两者都用”成为一个现实可行的答案,而不是一个敷衍了事的说法。
表C:本次测试中每个端点的成本,已验证于 2026年8月6日 的实时价格表
| 端点 | 价格 | 本次测试的10秒片段 |
|---|---|---|
| openai/gpt-image-2/text-to-image | $0.009 / 图片 | $0.01 |
| minimax/h3/image-to-video | $0.14 / 秒 | $1.40 |
| minimax/h3/reference-to-video | $0.14 / 秒 | $1.40 |
| google/gemini-omni-flash/image-to-video | $0.13 / 秒 | $1.30 |
| google/gemini-omni-flash/video-edit | $0.14 / 秒 | $1.40 |
| google/gemini-omni-flash/text-to-video | $0.125 / 秒 | 未使用 |
| minimax/h3/text-to-video | $0.14 / 秒 | 未使用 |
本月两个模型都没有折扣。Gemini 还提供了一个更便宜的开发者层级(文本生成视频和图片生成视频 $0.112/秒,参考生成视频 $0.12/秒);H3 没有等效层级。
Gemini Omni Flash 无法跨越的开放权重线。 H3 的权重发布在 Hugging Face 上(MiniMax,2026年8月):一个 33B 密集单流 Omni Transformer,加上 Qwen3-VL-32B 文本编码器、一个视觉 VAE 和一个音频 VAE。有两个注意事项比下载大小更重要。首先,你自托管的内容运行在 768 像素短边上;Context-IR 预处理阶段和 Regenerate-2K 模块不在发布版本中,2K 输出来自这两个模块。其次,社区许可证目前不涵盖欧盟、英国、韩国或美国,这些地区需要单独申请表格。在基于它构建产品之前,请仔细阅读。Gemini Omni Flash 没有等效的讨论,因为没有文件可下载。
这种开放权重定位,加上激进的价格策略,是这次发布整个战略故事的核心(南华早报,2026年8月)。
自己运行 MiniMax H3 对比 Gemini Omni Flash 修改测试
这是没人做过的那部分。所有人都对初次生成进行基准测试。没人对第二次生成进行基准测试。
真正的工作不是一次提示词。真正的工作是一个你喜欢的片段,加上一个客户回复说“喜欢,能把招牌改成 24H,她的围裙改成红色吗?”这一句话就是这两个模型不再可以互换的地方,而这恰好是视频编辑排行榜衡量的任务。
这个场景被刻意设计得很苛刻:一个雨夜的面摊,摊主直视镜头,她身后有一块手绘招牌,上面的字清晰可见,汤热气腾腾,雨打在雨棚上。一个画面同时考验唇形同步、屏幕上文字稳定性、流畅运动和分层环境音频。
两个模型都得到相同的首帧、相同的提示词和相同的修改意见。下面的每次运行都是10秒,这是 Gemini Omni Flash 的上限,也在 H3 的能力范围内。
步骤 1:用 GPT Image 2 锁定首帧
两个模型必须从同一张图片开始,否则第一轮衡量的是构图运气而不是模型本身。打开 GPT Image 2 工作区,将质量设为 high,比例设为 16:9,然后粘贴以下内容:
Plain1Realistic night street food stall in heavy rain, shot on a 35mm lens at f/2.0. A woman in her late thirties in an indigo canvas apron stands behind a steaming noodle counter, looking straight into the lens, mid-sentence. Behind her a hand-painted tin light box sign glows warm amber with the words "OPEN LATE" in clean bold sans-serif capitals. Rain streaks through the sodium streetlight, steam rises off the broth pot, wet asphalt reflects red and green neon from across the street. Shallow depth of field, practical lighting only, slight lens haze, natural skin texture, no text anywhere else in the frame. 16:9.
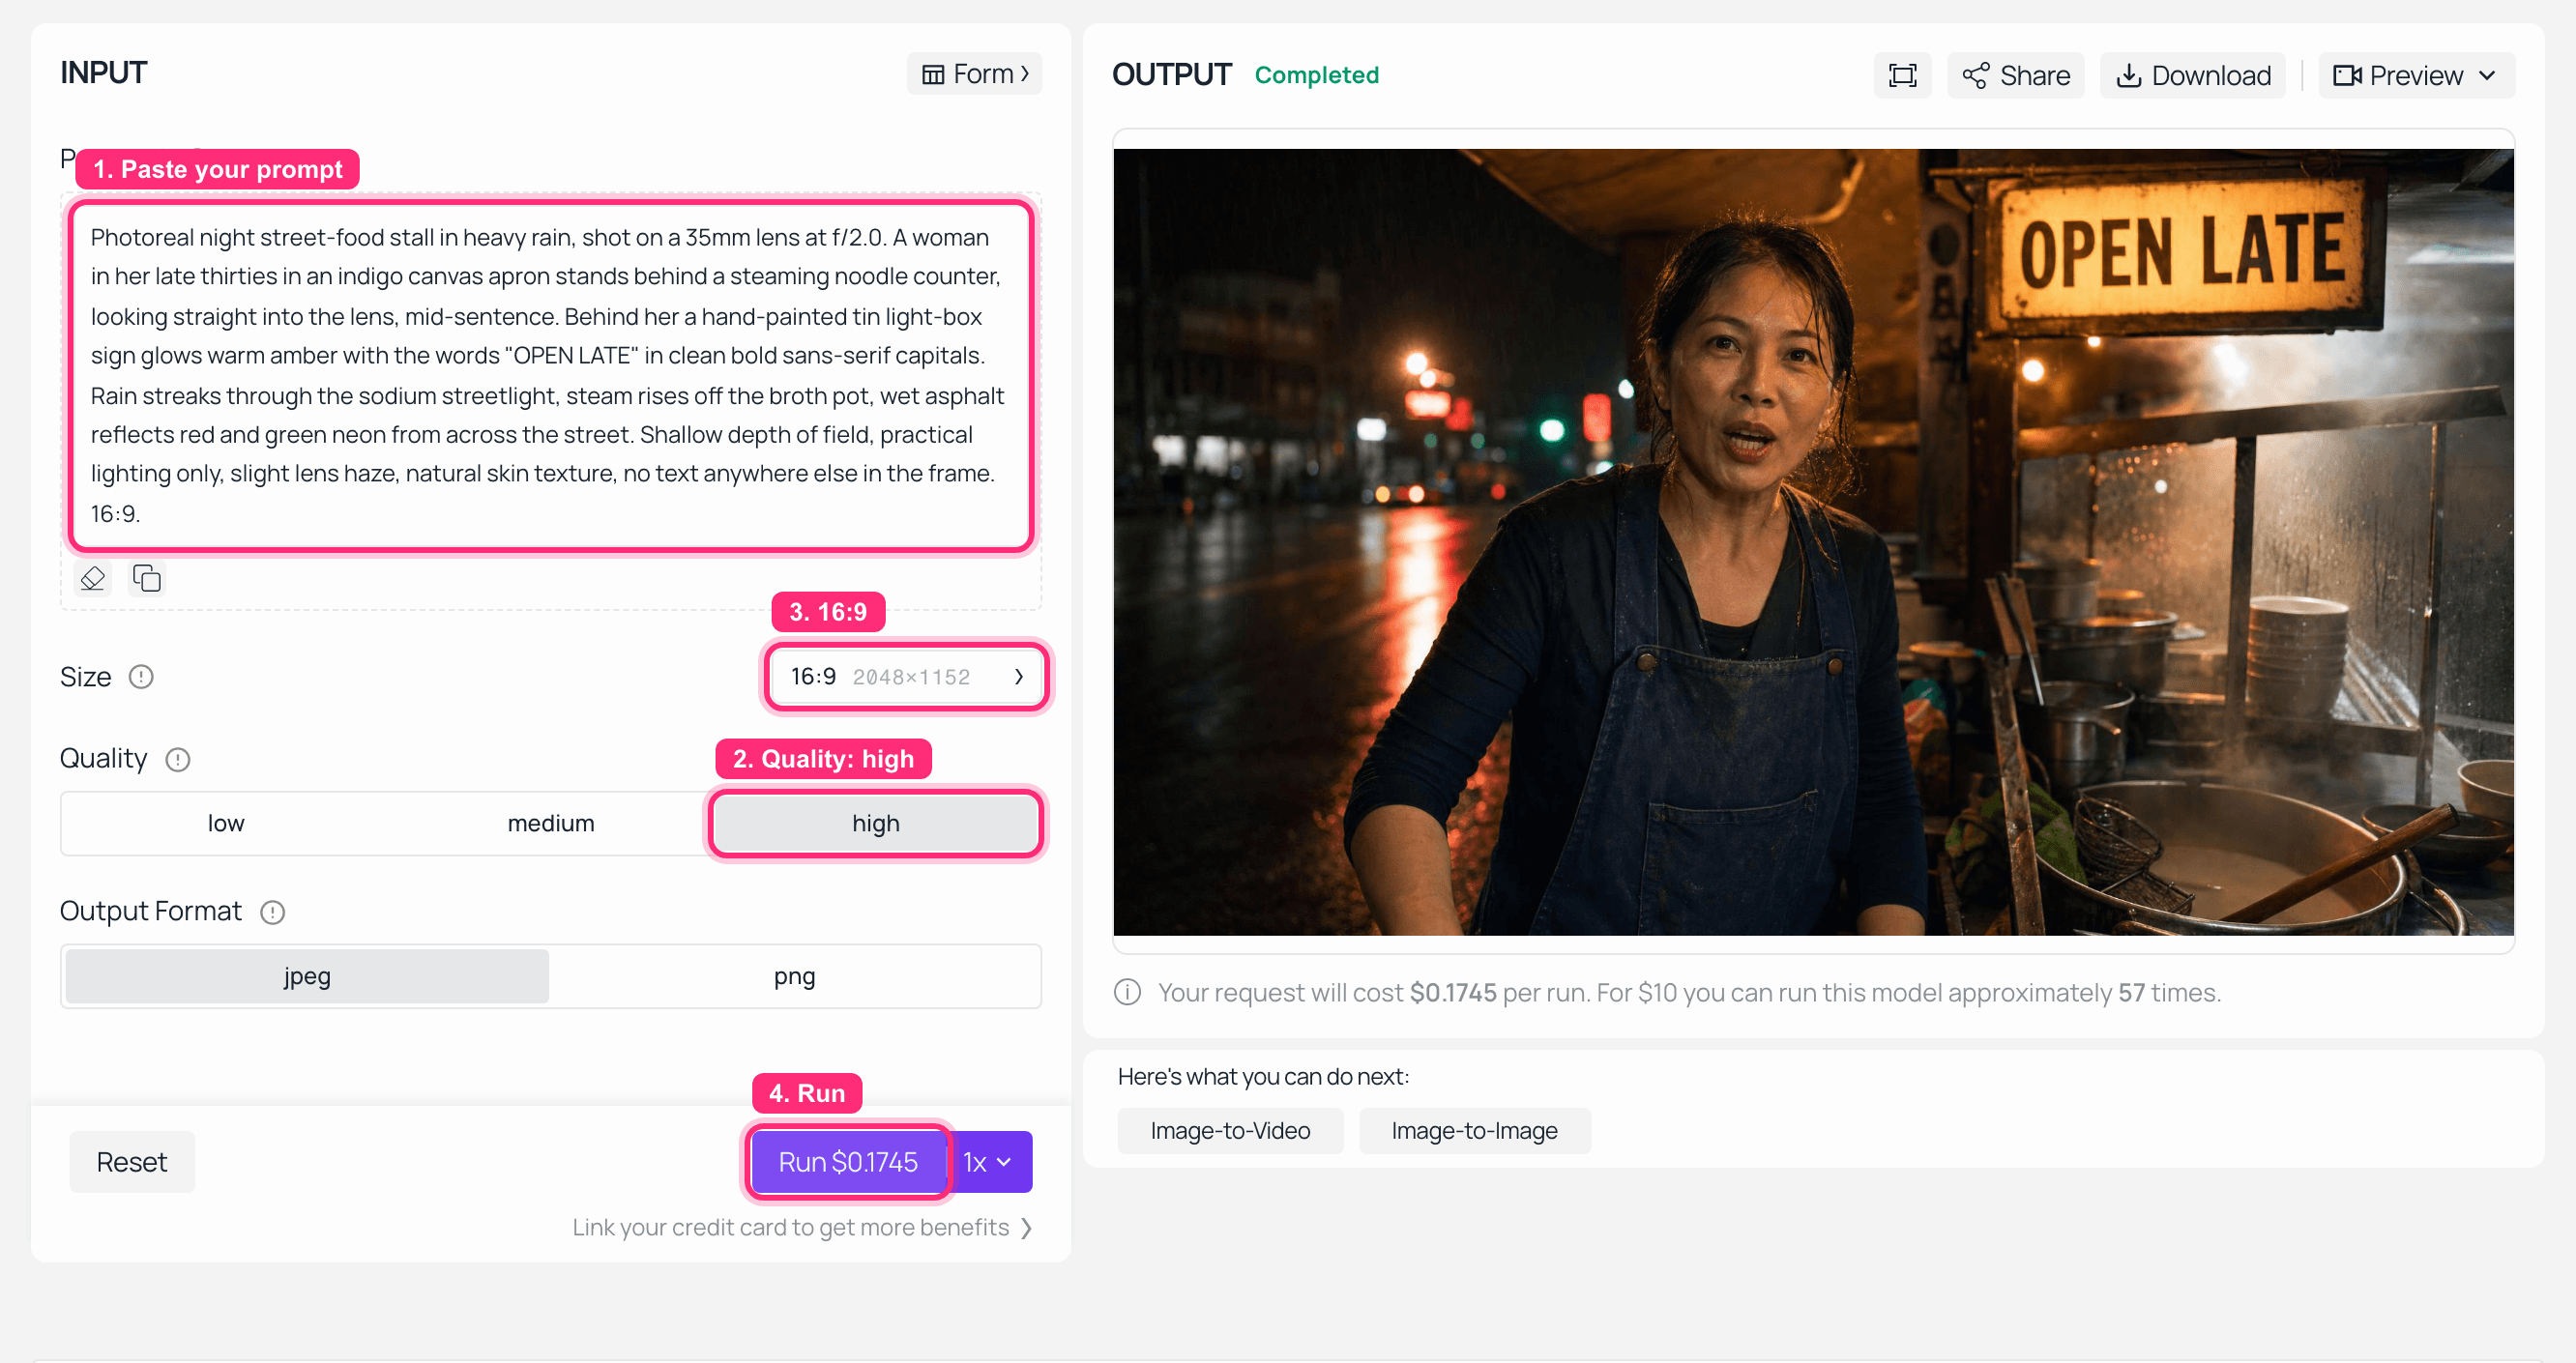
Atlas Cloud 上的 GPT Image 2 工作区,左侧是面摊提示词,输出面板中是生成的首帧
_Atlas Cloud 上的 GPT Image 2:左侧为提示词,OUTPUT 中为共享的首帧。_此步骤成本 $0.009。
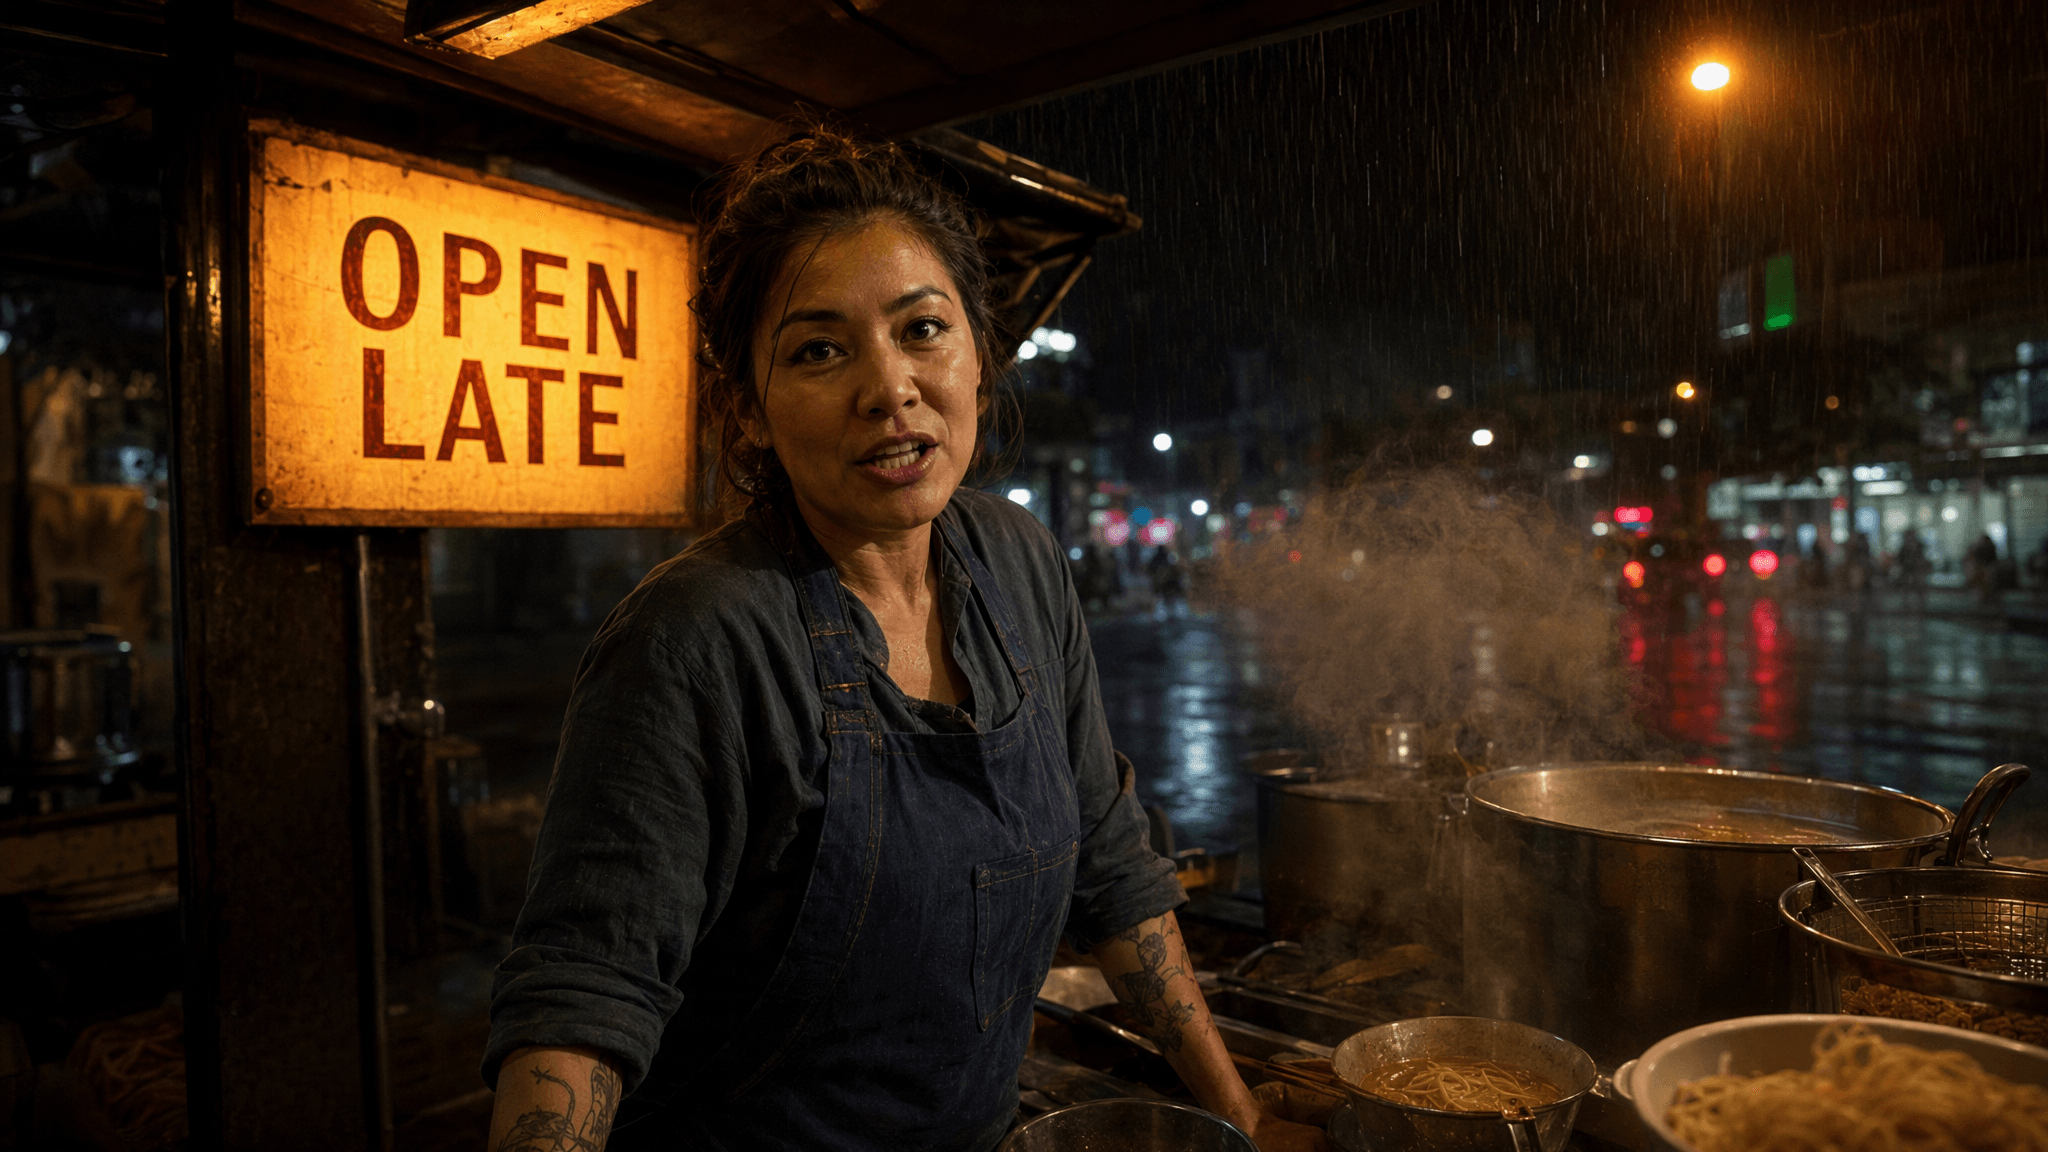
生成的首帧:一位身着靛蓝围裙的女性,在雨夜中站在蒸汽腾腾的面摊后,身后一块手绘的“OPEN LATE”招牌发出暖光
两个模型接收到的单一输入。注意修改将针对的两件事:“OPEN LATE”招牌和靛蓝围裙。使用 openai/gpt-image-2/text-to-image 生成。
步骤 2:在 MiniMax H3 上进行第一轮
进入 MiniMax H3 工作区,选择 image-to-video 任务,上传步骤 1 的图片,设置 resolution 为 2K,duration 为 10,ratio 为 adaptive(图片生成视频的枚举仅提供 adaptive)。提示词:
Plain1The vendor looks into the lens and says, in a warm tired voice: "Broth's been on since four this morning. Sit down, it's still raining." She lifts the ladle as she speaks. Steam curls up across the frame. Rain keeps falling on the awning behind her. The camera holds still, no push, no pan. Ambient audio: rain on canvas, broth simmering, distant traffic, her voice close and dry.
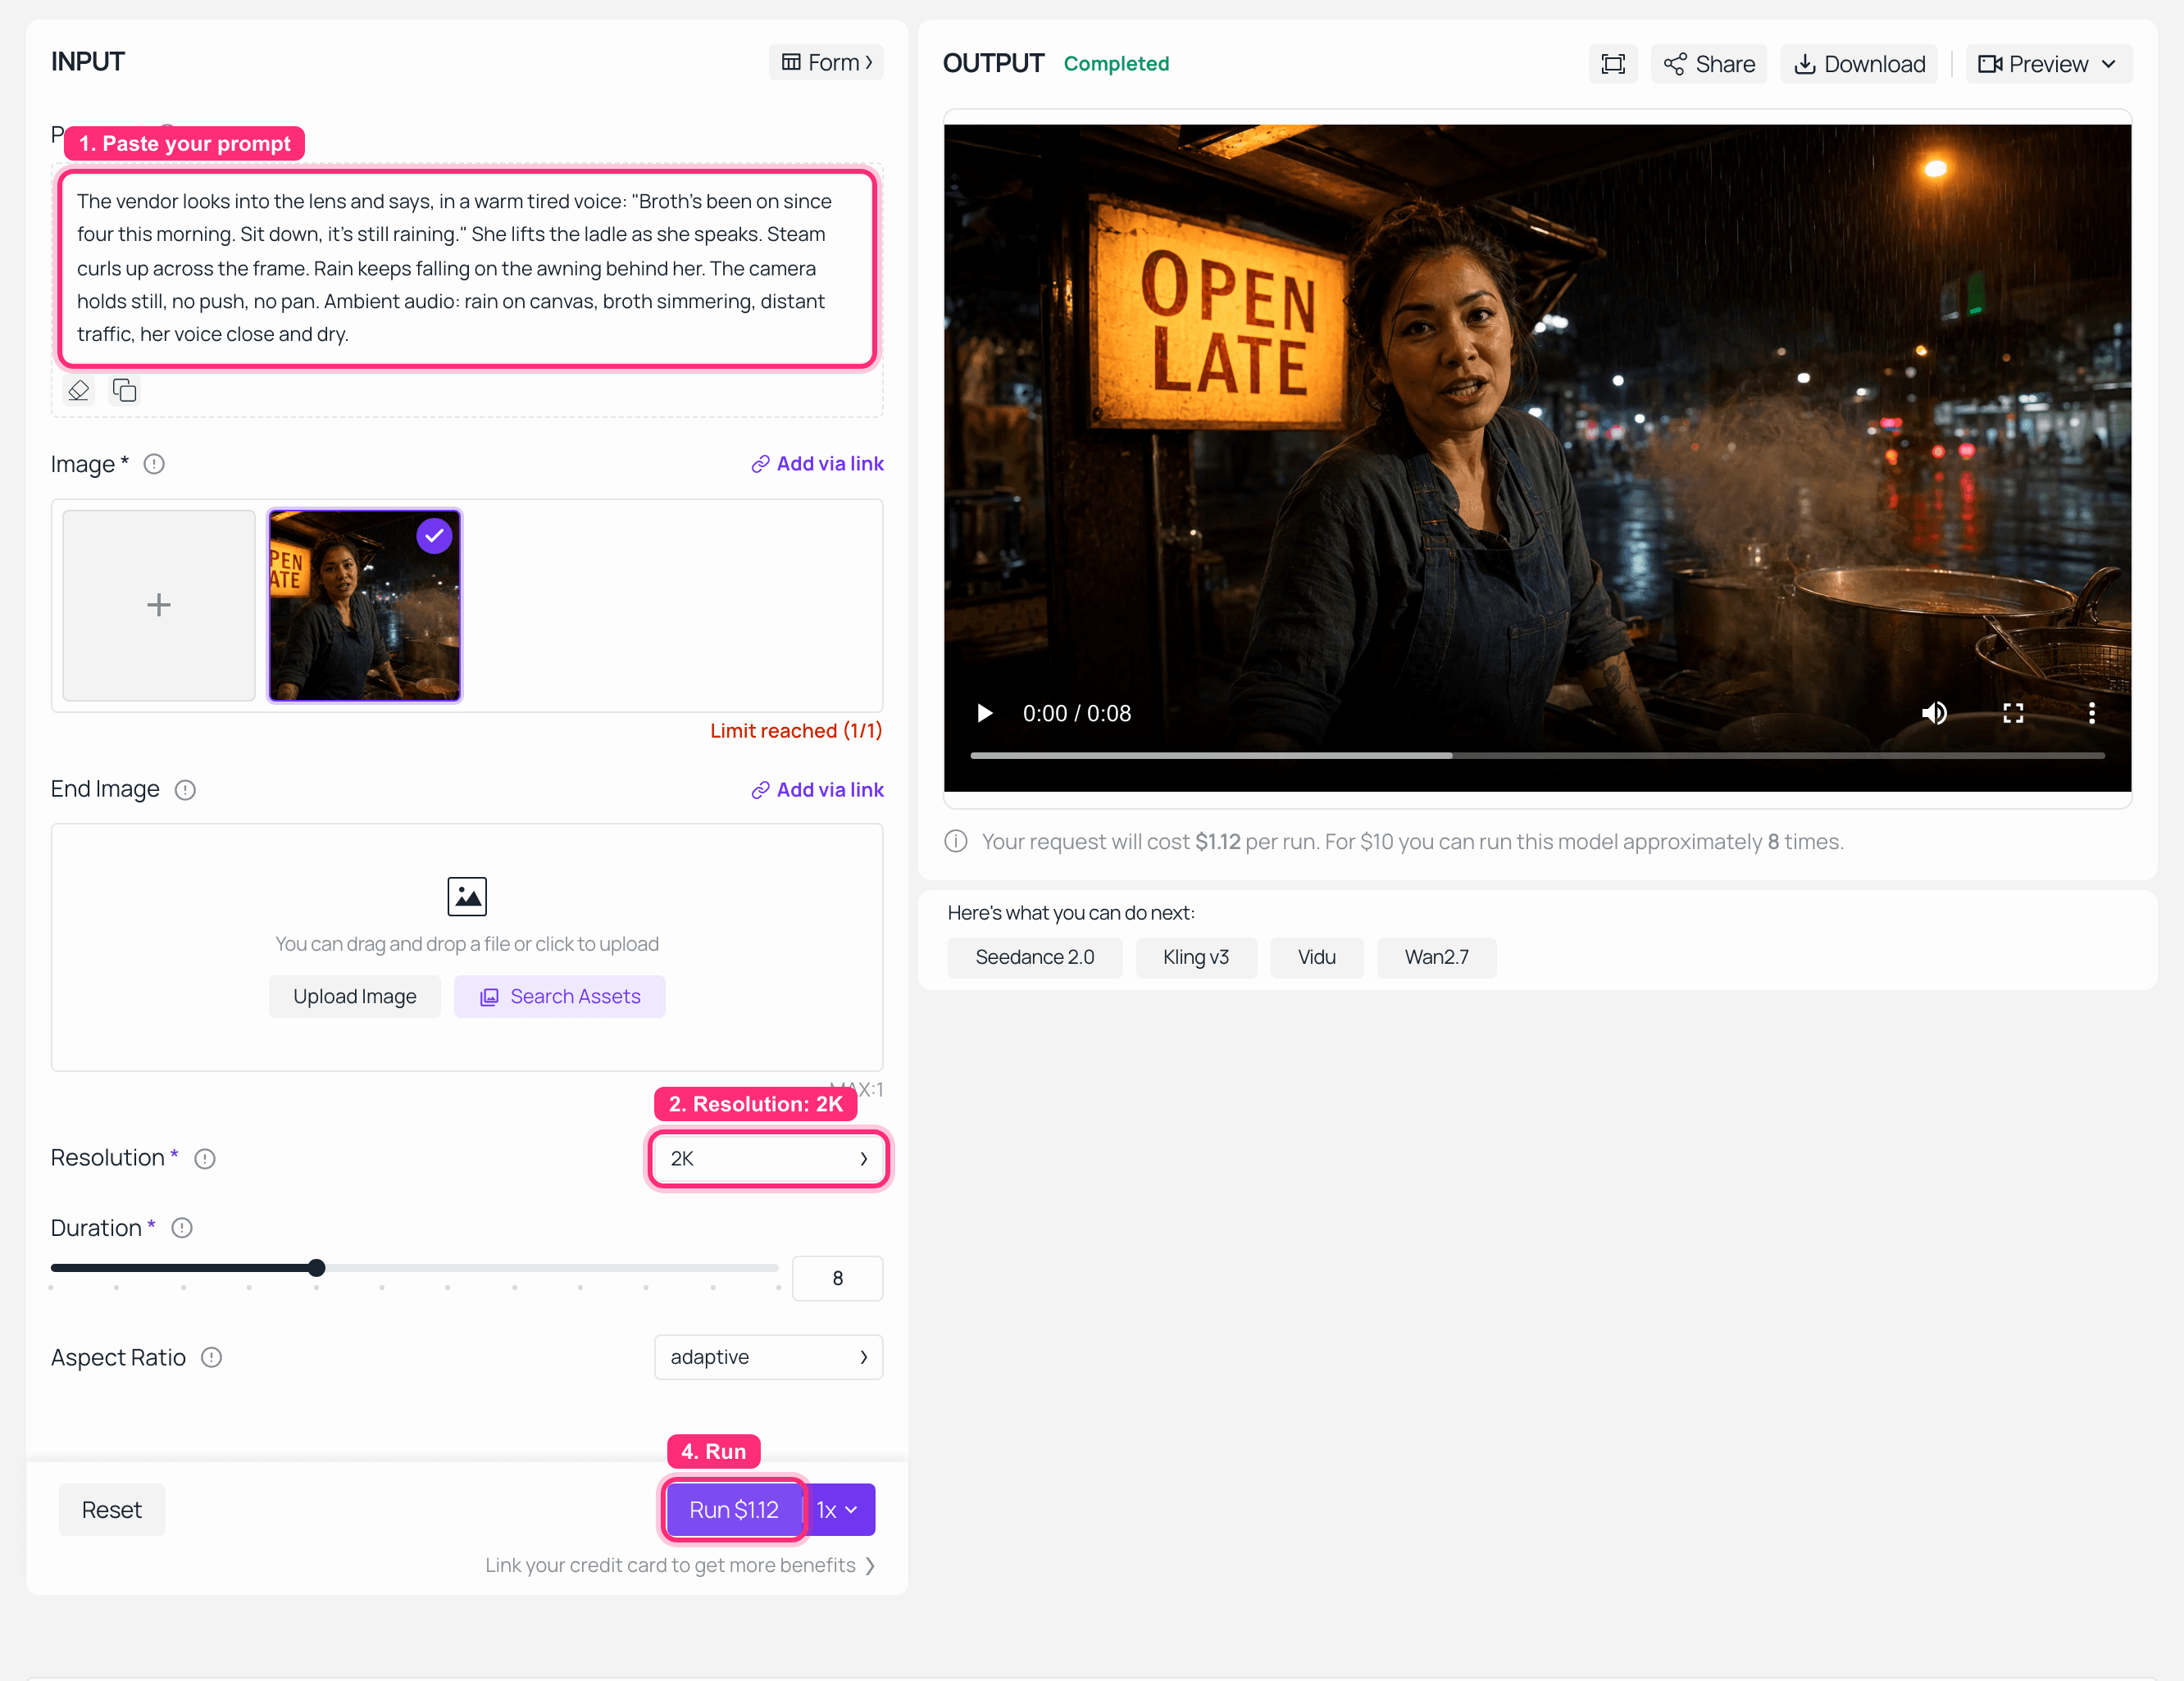
Atlas Cloud 上的 MiniMax H3 图片生成视频工作区,选择了 2K 分辨率,输出面板中正在播放完成的片段
Atlas Cloud 上的 MiniMax H3 图片生成视频:选择了 2K,OUTPUT 中为完成的片段。本次捕获以工作区默认的 8 秒运行,成本 $1.12;用于对比的 10 秒版本内嵌在下方,成本 $1.40。
MiniMax H3,第一轮,2K,10 秒。打开声音:对话、雨声和汤的沸腾声都在同一轮生成中,并非后期叠加。
步骤 3:在 Gemini Omni Flash 上进行第一轮,同一帧,同一句话
打开 Gemini Omni Flash 工作区,选择 image-to-video,上传步骤 1 的同一张图片,粘贴步骤 2 的提示词,不改变任何字符。设置:resolution 720p,duration 10,aspect_ratio 16:9,thinking_level default,seed -1。
在填写表单时,有两件事值得注意,因为它们正是这篇文章的缩影。resolution 下拉菜单里只有一个选项。duration 字段最大值是 10。我不是选择了 720p 而不是更好的选项;而是根本没有其他选项可选。
关于此处缺少什么:我无法为 Gemini 的任何一个步骤截取运行完成的工作区截图。我用来截图的暂存环境在三次尝试中都从 Google 端返回了 403 PERMISSION_DENIED,所以我唯一的 Gemini 截图显示的是失败的 OUTPUT 面板,我不会假装它是成功运行。下面的片段是真实的,通过生产 API 使用上述设置生成。H3 的两个步骤则成功捕获了截图,那些截图是真实的。
Gemini Omni Flash,第一轮,720p,10 秒,输入完全相同。紧接着上面的 H3 片段播放,自行判断音频质量。
步骤 4:第二轮,向 Gemini Omni Flash 发送修改意见
这是关键的一轮。在同一个 Gemini 模型页面上切换到 video-edit 任务,上传 Gemini 在步骤 3 中生成的片段 作为 video 输入,设置 resolution 720p 和 thinking_level high(两步修改指令正是该旋钮要处理的复杂情况)。完全按照客户会发送的方式粘贴以下备注:
Plain1Keep this exact shot: same camera position, same woman, same face, same rain, same lighting, same audio. Change the hand-painted sign so it reads "OPEN 24H" instead of "OPEN LATE", in the same painted style and the same amber glow. Change her apron from indigo blue to deep crimson. Change nothing else in the frame.
Gemini Omni Flash 在修改意见之后。先看招牌,再看围裙,然后检查其他任何东西是否移动。
步骤 5:第二轮,向 MiniMax H3 发送相同的修改意见
这是诚实的结构差异,你应该在阅读结果之前了解它。H3 没有 video-edit 端点。它的修改路径是 reference-to-video:你将原始片段作为参考提供给它,它会生成一个基于该参考条件的新视频。它不是编辑你的文件。它是制作一个应该看起来像你的文件的新文件。
在 MiniMax H3 页面上,选择 reference-to-video 任务,将 H3 在步骤 2 中生成的片段 作为视频参考添加到 refers,然后设置 resolution 2K,duration 10,ratio adaptive。粘贴步骤 4 的提示词,不做任何编辑。
这一步也没有工作区截图,原因不同且更无聊:我用来截图的无头浏览器在加载视频参考时,在参考上传器上崩溃了三次。运行本身通过 API 顺利完成,没有报错。
MiniMax H3 在相同的修改意见之后,通过 reference-to-video 以 2K 生成。
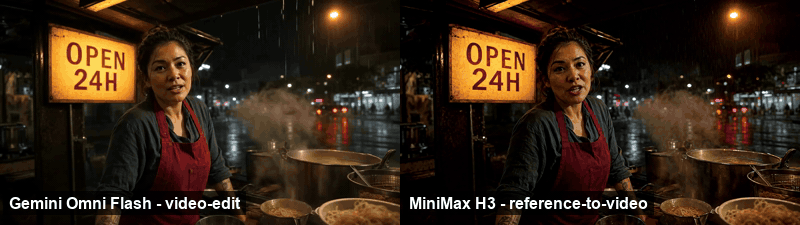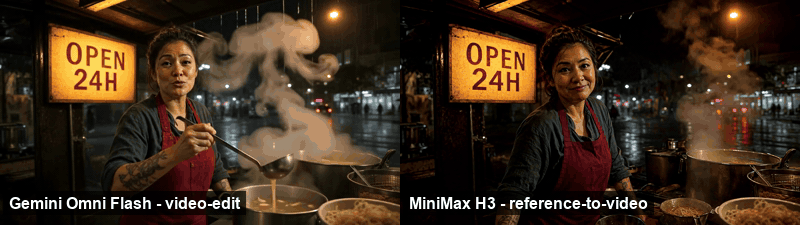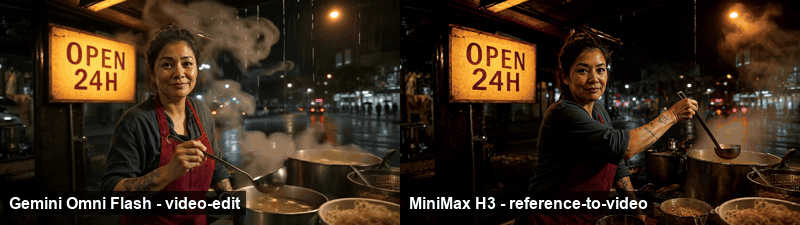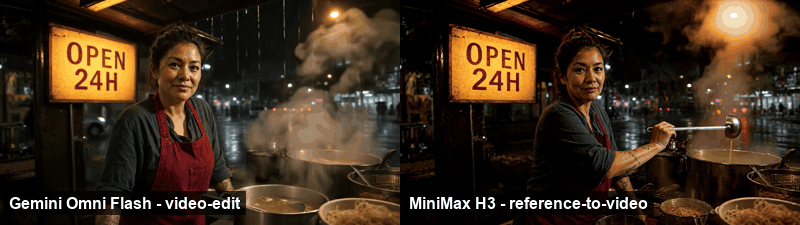
第二轮并排对比:Gemini Omni Flash 的 video-edit 结果与 MiniMax H3 的 reference-to-video 结果,均基于相同的修改意见
第二轮并排,静音 GIF。左侧为 Gemini Omni Flash 通过 video-edit 生成,右侧为 MiniMax H3 通过 reference-to-video 生成。两者都基于同一句话进行修改。
第二轮实际发生了什么。 我原本预期 H3 会输掉这一轮。基于参考条件重新生成是比真正的编辑端点更粗糙的工具,“重新生成整个片段并希望它落在相同位置”正是导致不同面孔、相机漂移和客户追问“镜头怎么了”的原因。
但结果并非如此。两个模型都完成了任务,而且都完成得很干净。
Gemini 的 video-edit 表现完全符合预期。招牌显示为“OPEN 24H”,采用相同的手绘字体、相同的暖色光芒和相同的招牌老化效果。围裙变成了深红色。其他一切都没有改变:相同的面孔、相同的表情、相同的勺子角度、相同的蒸汽形状、相同的雨水、相同的背景尾灯。它看起来像是原始文件进行了两次像素级修正,因为本质上就是这样。
H3 的 reference-to-video 产生了相同的两个变化,并且镜头的保持程度远好于其架构所暗示的水平。招牌变了,围裙变了,而且在全部 10 秒内,画面构图、勺子舀汤的轨迹、蒸汽柱以及她的面部表情都与第一轮的片段保持一致。如果存在偏移,我逐帧对比后也没有发现。
所以第二轮是第三个统计平局,我不会为了编一个更简洁的故事而假装不是这样。区分两个输出的不是编辑质量。而是 H3 交回了 2560x1440 分辨率和 32 kHz 立体声音轨,而 Gemini 交回了 1280x720。同样的指令,同样成功,不同的交付物。
一个诚实的说明:这是一个单一镜头上的单次修改,不是控制性研究。对招牌和衣物的两项修改是比较友好的编辑。更困难的情况(移除相机移动经过的物体、改变被主体遮挡的东西、叠加四轮修改意见)才是专用编辑端点应该领先的地方,也是重新生成开始出现抖动的地方。在做出决定之前,请运行你自己的测试。
值得测试的另外三个 MiniMax H3 对比 Gemini Omni Flash 差异点
第二轮是改变交付结果的差异点。还有三个差异点值得你花二十分钟的信用额度。
给它一个音频文件。 H3 的 reference-to-video 接受最多三个 2 到 15 秒的音频片段,前提是至少附带一个图片或视频参考。这意味着你可以给它一个真实的人声录音,让角色来表演它。Gemini Omni Flash 在其四个端点中的任何一个上都没有音频输入字段,所以这个比较根本无法进行。对 Google 来说这不是评分损失;这只是某种能力缺失。
要求 21:9。 H3 的 reference-to-video 比例枚举包含 21:9、16:9、4:3、1:1、3:4 和 9:16。Gemini 的 aspect_ratio 枚举包含 16:9 和 9:16。如果你的交付物是宽屏片头序列或 1:1 社交视频,那么这两个模型中有一个根本不参与讨论。
锁定种子并重新运行。 这一条反过来。Gemini 暴露了 seed;H3 在任何端点上都没有暴露。如果你正在构建一个管线,要求同一个请求在周二返回的帧必须与周一返回的相同,Gemini 给你一个把手,而 H3 什么都不给。对于回归测试、A/B 文案变体,或任何自动化渲染农场,这是一个真正的优势,应该记在 Google 的账上。
MiniMax H3 对比 Gemini Omni Flash 测试的实际成本
以上整个实验,四个视频生成和一个图片,大约花费 $5.51。一张首帧 $0.009,两个 10 秒第一轮片段 $1.40 和 $1.30,两个 10 秒第二轮片段各 $1.40。
按每秒计算,Gemini 更便宜:$0.125 到 $0.14 对比 H3 的固定 $0.14,根据端点不同大约便宜 7% 到 11%。这个数字是真的,但单独看几乎没用。
原因如下。假设交付物是一个 15 秒的 21:9 宽屏电影片头,2K 分辨率。H3 可以一次性渲染。Gemini 根本无法渲染:分辨率不行,时长不行,画面比例也不行。你需要拼接一个 10 秒和一个 5 秒的 16:9 片段,裁剪来伪装宽屏,然后交付 720p。一个你无法交付的东西的每秒价格不是节省。
反过来。假设交付物是一个 16:9 社交视频,将经历四轮客户修改意见,并且当法务团队在三周后要求重新渲染时,必须以字节完全相同的方式返回。Gemini 的 video-edit 加上 seed 正是为这种循环而构建的,而且在执行过程中每秒成本更低。
表D:MiniMax H3 对比 Gemini Omni Flash 的哪种任务应该交给谁
| 你面前的任务 | 交给它 |
|---|---|
| 2K 交付 | MiniMax H3 |
| 超过 10 秒的单次镜头 | MiniMax H3 |
| 21:9、4:3、1:1 或 3:4 画面比例 | MiniMax H3 |
| 输入真实音频轨道 | MiniMax H3 |
| 在你自己的GPU上自托管 | MiniMax H3 |
| 指定特定最后一帧 | MiniMax H3 |
| 对话式多轮修改 | Gemini Omni Flash |
| 保留片段中未修改的部分 | Gemini Omni Flash |
| 通过种子实现可复现渲染 | Gemini Omni Flash |
| 普通的 16:9 短格式,最低每秒成本 | Gemini Omni Flash |
这篇文章的结论就是那张表,而不是一个分数。如果一个基准测试无法以超过其自身误差线的程度区分两个模型,那么基准测试已经告诉了你它知道的一切,接下来轮到规格表说话。
要更广泛地了解 H3 与其他模型的对比位置,可以查看 MiniMax H3 替代方案分析,其中涵盖了在它不领先的排行榜上击败它的模型。
常见问题解答
MiniMax H3 比 Gemini Omni Flash 更好吗?
盲评无法区分它们。在三个 Artificial Analysis 排行榜上,差距分别是 5、2 和 9 个 Elo 分,每一个都落在 ±7 到 ±10 的置信区间内。根据规格而不是排名来选择。分辨率上限、时长限制和画面比例列表会改变你的交付物;5 个 Elo 分不会。
MiniMax H3 和 Gemini Omni Flash 哪个更便宜?
按每秒计算,Gemini。在 Atlas Cloud 上,它运行价格为 $0.125 到 $0.14 每秒,而 H3 是固定的 $0.14,并且 Gemini 有一个开发者层级 $0.112 每秒,H3 没有等效层级。但 Gemini 上限为 720p、10 秒和两种画面比例,所以对于许多交付物来说,你比较的不是同一个产品。为最终成品定价,而不是为秒数定价。
Gemini Omni Flash 能生成 1080p、2K 或 15 秒视频吗?
不能。它的 API resolution 参数只有一个合法值 720p,duration 接受 3 到 10 秒。MiniMax H3 提供 768P 或 2K 以及 4 到 15 秒。这些是从 2026年8月6日 的实时模式中读取的枚举约束,不是主观意见,Google 未来可能会解除限制。
我能像自托管 MiniMax H3 一样自托管 Gemini Omni Flash 吗?
不能。H3 的权重在 Hugging Face 上,可以在本地以 768 像素短边运行。产生 2K 输出的 Context-IR 阶段和 Regenerate-2K 模块不在发布版本中,保留在 API 端。另外检查许可证:它目前不涵盖欧盟、英国、韩国或美国,除非有单独申请。
我必须只选择一个吗?
不,上面的按任务分配表是更好的答案。两个模型在 Atlas Cloud 上都通过同一个 generateVideo 端点提供服务,所以同时使用两者意味着一个轮询循环和一个不同的 model 字符串,而不是两个集成。根据交付物路由优于押注一个每周变动的排行榜。


