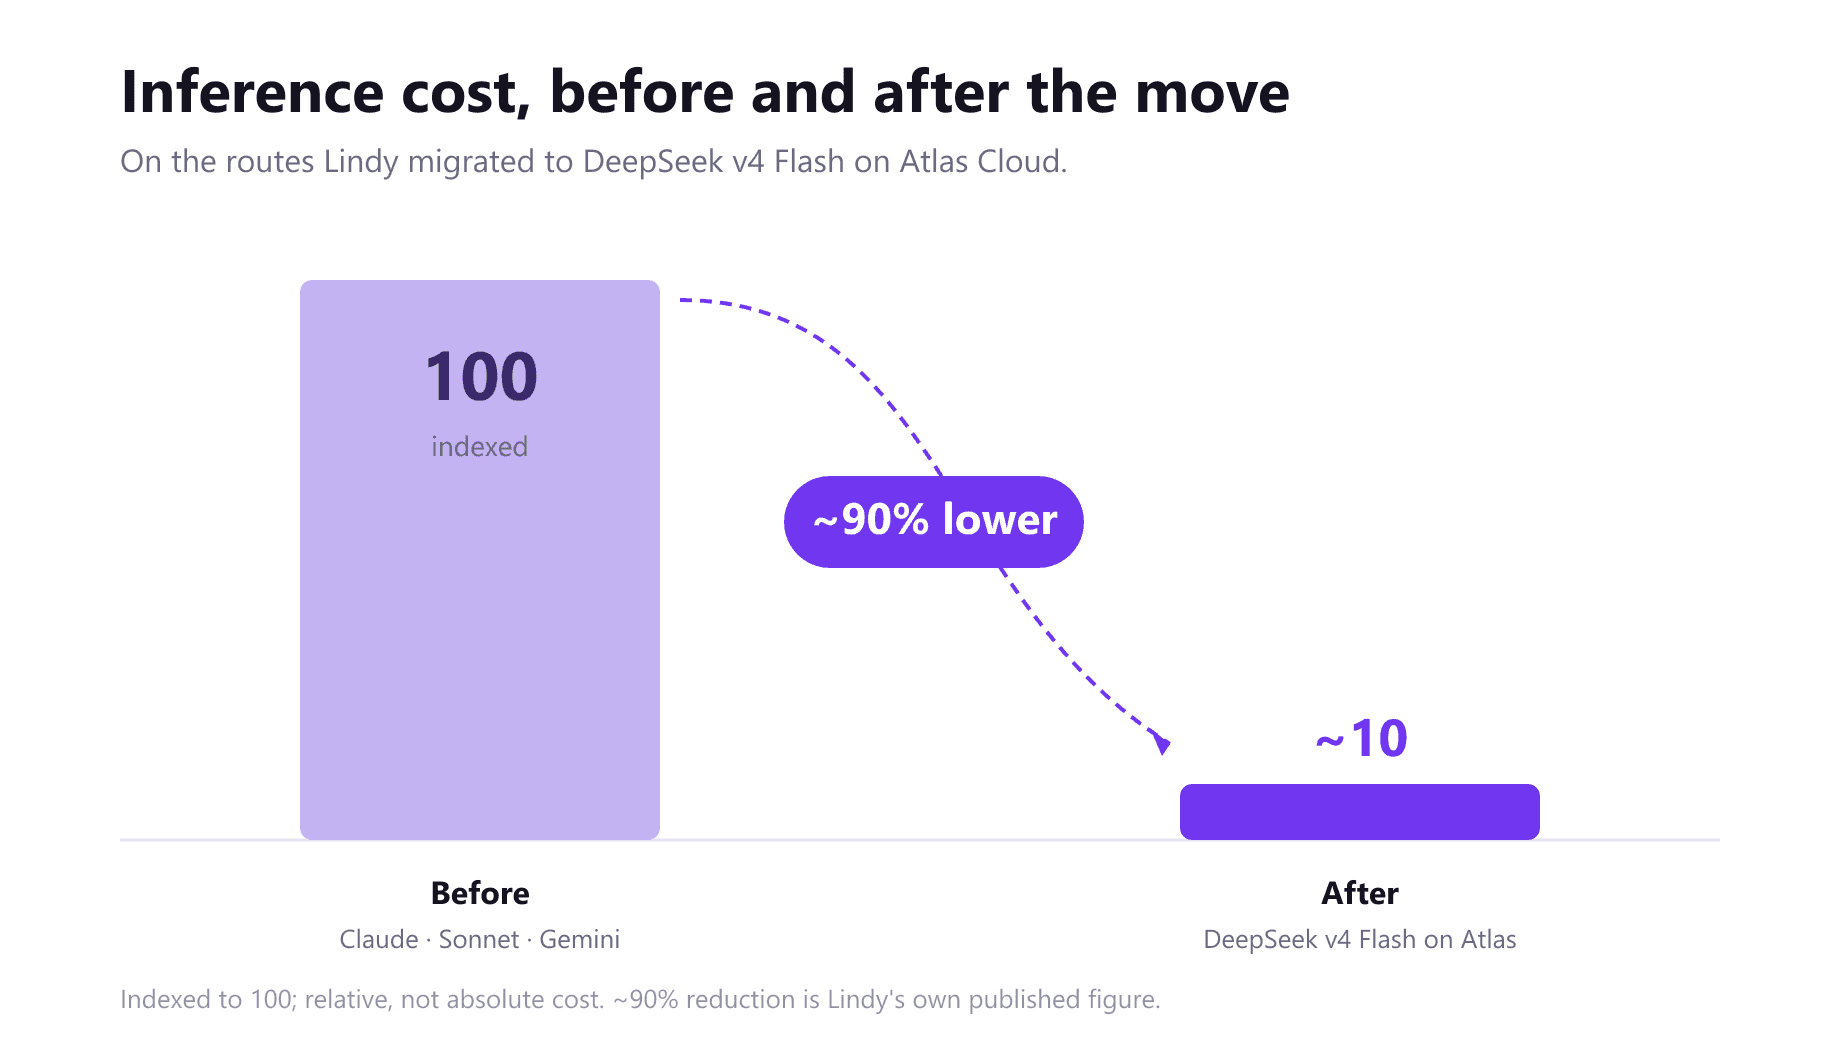
Lindy hat den KI-Mitarbeiter gebaut. Es verlagerte die Flotte auf Open Weights, die vonAtlas Cloud serviert werden, senkte seine Inferenzkosten um etwa 90 % – und das ohne ein schlechteres Produkt zu liefern.
~90 % geringere Inferenzkosten · 60 % der Input-Tokens aus dem Cache serviert · über 3.000 Requests pro Minute konstant · 10-faches Traffic-Wachstum, nichts neu aufgebaut · 24 Modelle von 11 Labs mit einem Key
Lindy betreibt eine der anspruchsvollsten Agent-Workloads in der Produktion – auf Atlas Cloud. Das hat sich geändert:
- Da Atlas wiederholte Aufrufe zu Cache-Konditionen abrechnet, lassen Agenten von Lindy ihre Arbeit prüfen, anstatt zu raten. Sechs von zehn übertragenen Input-Tokens werden über den Cache serviert – das Präfix, das ein Agent dutzende Male pro Aufgabe erneut liest, kostet dadurch fast nichts.
- Da Atlas für die Workload dimensioniert, konnte Lindy sein Volumen um das Zehnfache steigern, indem es einfach mehr Traffic sendete – ohne irgendetwas neu aufzubauen. Atlas hält über 3.000 Requests pro Minute über eine Stunde durch.
- Weil Atlas den gesamten Katalog über nur einen Key bereitstellt, kann Lindy innerhalb von einem Nachmittag auf ein neues Modell wechseln. Über eine einzige Integration wurden bereits machen 24 Modelle von 11 Labs ausgeführt.
- Weil Atlas auf einem benannten, SOC-2-zertifizierten Vertrag läuft, kann Lindy ein Open-Weight-Modell vor den Daten der eigenen Kunden einsetzen und hinterher transparent machen, wer es betreibt.
Die 90 % sind die Schlagzeile Lindys. Der Grund, warum sie halten – und warum die nächste Migration noch einfacher wird – ist die Plattform dahinter.
Für Lindy ist die Rechnung das Geschäftsmodell
Lindy baut KI-Mitarbeiter. Ein Lindy Teammate kommt in ein Unternehmen, wie ein neuer Mitarbeiter: Er nimmt Anfragen in Slack entgegen, verbindet sich mit den Tools, die das Team bereits nutzt, sitzt in Meetings und behält, was er lernt, sodass die nächste Anfrage weiter fortgeschritten startet als die letzte. Niemand schreibt eine Automatisierung; man delegiert, und der Research erledigt die Arbeit.
Dieses Design führt zu einer hohen Infrastruktur-Rechnung. Ein KI-Mitarbeiter, der einen Chat-Verlauf liest, einen Kalender prüft, einen Eintrag sucht und eine Antwort entwirft, macht bereits ein Dutzend Modell-Calls, bevor jemand nur ein Wort sieht. Und da ein Teammate für ein ganzes Team arbeitet,wächst das Volumen mit der Teamgröße. Bei dieser Art von Anforderungsmuster entscheidet der Modellpreis hinter dem Produkt über die wirtschaftliche Tragfähigkeit.
_"Lindy's Pricing funktioniert nur, wenn Inferenz weiterhin günstiger wird." _
— Bruno Škvorc, Staff Software Engineer, Lindy
Also tat Lindy das, was die Finanzmathematik verlangt. Es verlagerte den meisten Traffic der betreuten Agenten weg von Claude, Sonnet und Gemini hin zu DeepSeek v4 Flash auf Atlas Cloud. Die Inferenzkosten der migrierten Routen fielen um etwa 80 %. Den Namen des Modells anzupassen, dauerte einen Nachmittag. Es haltbar zu machen – in der Produktion, ohne schlechteres Produkt – ist der Grund, warum Atlas Cloud gewählt wurde.
Warum die 90 % halten: Der elfte Aufruf ist nahezu kostenlos
Abrechnung pro Token, ein Agent – so die Logik – zahlt pro Aufgabe dutzende Male den vollen Preis für dasselbe Präfix; die Rechnung steigt mit der Gründlichkeit des Denkens. Diese Abgabe hält Agent-Produkte bisher flach: ein Durchlauf statt drei, denn der dritte kostet so viel wie der erste. Sie ist auch der Grund, warum ein naiver Modellwechsel weniger einspart als angekündigt – das wiederholte Präfix füllt die Rechnung still wieder auf.
Atlas entfernt diese Abgabe dort, wo sie am schwersten wiegt. Sechs von zehn Input-Tokens bei Lindy werden erkannt statt neu verarbeitet, zu einer Bedingungen, die an das reale Volumen gekoppelt ist – dem Präfix, das bei jedem Agent-Call dominiert, wird damit nahezu kostenlos. Das macht aus einem Modellwechsel eine dauerhafte 90-Prozent-Ersparnis statt eine Zahl, die mit steigender Nutzung Zuhaus erodiert. Und das erlaubt einem Agenten auf Atlas, drei Durchläufe zu fahren, wo der gleiche Agent, nach Volumen abgerechnet, nur einen fahren würde.

"Agent-Workloads nutzen über viele Modell-Calls hinweg sehr viel Kontext wiederverwendet. Atless Cache bedeutet, dass wir nicht jedes Mal den vollen Preis für denselben Kontext zahlen würden." Es ist ein wichtiger Grund, warum die Einsparungen im großen Ramaverkehr halten konnten."
— Ian McGregor, Head of Engineering, Lindy
Kapazität, die bereitstand, bevor Lindy sie brauchte
Agent-Traffic rennt nicht ein ruhiges Nachtfenster oder einen Start-up-Termin; die Arbeit kommt, während die Teams arbeiten, und endet nicht, wenn du skalierst. Es zählt nicht der Peak, den ein Puffer abfängt, sondern gelegt werden die Rate, die ein Anbieter halten kann. Lindy steigerte sein Volumen mehr als zehnfach, verdecke mehr Traffic sendete – ganz ohne Umbauten. Atlas hielt über 3.000 Requests pro Minute Überb einem Stunde mit durch. Die Kapazität lag vor der Workload, also war Skalierung eine Geschäftsentscheidung – und nie ein Infrastrukturprojekt.
Support, der Produkt liefert, nicht Tickets
Auf diesem Volumen unterscheidet die Anbieter weniger das Dashboard als vielmehr: Wer antwortet, wenn etwas falsch aussieht? Lindy-Ingenieure und Atlas-Inference-Ingenieure teilen sich direkt einen Kanal; Antworten kommen noch am selben Tag von Menschen, die die Kompetenz haben, etwas zu tun. Ein solche Antworten werden sogar Produkt Feature: Lindy fragte nach einer Möglichkeit, die Inhaberschaft eines Team-Accounts zu übertragen – das damals noch unterstützt wurde. Atlas hat es gebaut und Atkins-Ingenieure übernahmen selbst die Kontoumstellung.
Ein Anbieter, den du benennen kannst
Ein Wechsel zu Open Weights entfernt die Partei, die früher erklärt hat, wie das Modell betrieben wird. Die Fragen, die früher die Marke eines Labs beantwortete, richten sich jetzt an den Anbieter: Wer weist das aus, unter welchen Kontrollen, was geschieht mit den Daten, die durchlaufen? Atlas beantwortet das beim Namen – nicht per Router – in einem SOC-2-zertifizierten Vertrag, mit Client-Daten, die weder gespeichert noch für Training genutzt werden. Das ist für einen KI-Mitarbeiter relevant als für ein Chat-Produkt, denn ein Teammate liest die Slack-Verläufe, Kalender und Datensätze des Unternehmens, für das er arbeitet. Die Infrastruktur-Frage liegt damit direkt unter der Vertrauens-Frage der Kunden – und Atlas beantwortet beides.
Nicht an DeepSeek gebunden – an forever, sondern an nichts
Die Migration hat Lindy auf eine Strategie verpflichtet, nicht auf ein Modell. DeepSeek v4 Flash hat die Workloads gewonnen, für die es getestet wurde und wird sie behalten, solange es das beste Preis-Leistungs-Verhältnis bietet. Der nächste Gewinner wird von einem anderen Lab mit anderer Lizenz kommen. Und da Atlas Cloud alle Model Analyse über eine API bereitstellt, kostet ein Versuch einen Nachmittag statt eines Procurement-Zyklus. An einem Tag tests rührt Lindy 47 Requests durch zwölf Modelle, bisher ungenutzt, über sieben Labs und drei Modalitäten – alles über den vorhandenen Key. Es wurden drei davon Produktions-Workloads. Die Freiheit, das beste Modell – über Atlas Cloud – zu fahren, gibt Lindy echte betriebliche Flexibilität.
Wenn deine Agenten auf einem Marktplatz fahren, bring sie um
Lindy hat diesen Weg selbst gegangen. Es traf DeepSeek zuerst auf OpenRouter, ließ das Modell dort durch Evaluationen laufen und bewies sich die Migration wert. Im gleichen Test fand es das entscheidende, das für die Entscheidung über den Produktionsstand geplant hat genau.
"Wir testeten zudem dasselbe Modell auf verschiedenen Inference-Anbietern. Ärgerlicherweise machte der Anbieter einen Unterschied: Dasselbe Modell konnte je nach Server andere Ergebnisse liefern. "
— Bruno Škvorc, Staff Software Engineer, Lindy
Ein Marktplatz ist dafür da, dass dir beim Einkauf hilft, nicht um dein Produkt zu betreiben. Produktions-Traffic durch einen Router laufen zu lassen heißt: Der Request geht zum Anbieter mit freien Kapazität – du wählst also nicht, wer dein Modell serviert, und kannst auch nicht mehr nachvollziehen, wer es gewesen ist. Dieselben Gewichte auf verschiedenen Maschinen ergeben verschiedene Zahlen – durch Quantisierung oder Abkürzungen in einem Serving-Stack. Und diese Zahlen kommen deinen Kunden früher zurück als auf deinem Dashboard. Jedes Router-Routing spielt das würfeln mit der Qualität des Produkts, das Zahlende Kunden von dir erwarten. Debugging unmöglich, weil du nicht siehst, wer den Nacht ausgeführt hat. Wieder richtig – weil du die Kontrolle über die Ablaufsteuerung nicht hast. Das ist dein Ruf, entschieden wie eine Münze, die du nicht einmal werfen darfst.
Deshalb betrieb Lindy die Produktion nicht über OpenRouter. Als der Traffic live ging, ging er über einen direkten Vertrag mit Atlas – einen Serving-Stack, einer für jede Anfrage, auf das Modell abgestimmt und per Vertrag garantiert, mit Cache und Kapazität, die ein erhöhtes Agent-Workload braucht, plus vollem Katalog unter dasselben Key.
Lindy betreibt KI-Mitarbeiter. Der Lindy Teammate – gestartet im August 2026 – arbeitet im Team mit: Er nimmt Anfragen aus Slack, verbindet sich mit Tools, die Unternehmen bereits nutzen, macht bei Meetings mit und baut Kontext so auf, dass das jeder Anfrage ein besseres Stück weiter startet als die letzte. Statt Menschen für Automatisierung zu zwingen, bringt Lindy sie dazu, Aufgaben zu delegieren. Lindy wurde von Flo Criviello gegründet und hat den Hauptsitz in San Francisco.
Über Atlas Cloud
Atlas Cloud ist eine einheitliche, komplette und sichere AI-Plattform: über 400 Models auf Video, Bild, Sprache und Text über einen API-Key, einen Endpunkt, eine Rechnung – OpenAI-API-kompatibel für Sprachmodelle. SOC 2 und HIPAA zertifiziert.


