
Kimi API for Vision-to-Code Generation
Die Kimi API ist die Open-Weight-K2-Reihe von Moonshot AI – vom nativ multimodalen K2.5 bis zum auf Coding spezialisierten K2.7 Code. Da Vision direkt in das Modell integriert ist, können Sie Screenshots, UI-Mockups und kurze Videos in funktionsfähigen Frontend-Code umwandeln, bis zu 100 parallele Sub-Agents koordinieren und über einen Kontext von 256K Tokens hinweg schlussfolgern. Atlas Cloud stellt die gesamte Familie über einen einheitlichen Endpoint mit transparenter Pay-as-you-go-Preisgestaltung bereit. Beginnen Sie noch heute mit der Entwicklung.
Kimi wurde von Moonshot AI entwickelt. Atlas Cloud (betrieben von Atlas Cloud AI LLC) stellt lediglich den Zugang bereit und ist nicht Eigentümerin des Modells. Alle Marken sind Eigentum ihrer jeweiligen Inhaber.
Erkunden Sie die Führenden Modelle
Atlas Cloud bietet Ihnen die neuesten branchenführenden kreativen Modelle.

Stimmen Sie Ihren Workload auf das passende Kimi API-Modell ab
Vergleichen Sie den Schwerpunkt jedes Kimi-Endpunkts und die standardmäßigen Preise pro Million Token auf einen Blick.
| Modalität | Beschreibung |
|---|---|
| Kimi K2.7 Code API (Text zu Text) | Dieser speziell für Engineering-Arbeiten entwickelte Endpunkt verwandelt Prompts in natürlicher Sprache und vorhandene Quelldateien in funktionierenden Code, Korrekturen und Entwicklerautomatisierung. Er ist auf Programmierung, Debugging und KI-gestützte Entwickler-Workflows ausgelegt, bei denen zuverlässige Codegenerierung im Vordergrund steht, und wird standardmäßig mit $0.95 pro Million Eingabe-Token und $4 pro Million Ausgabe-Token abgerechnet. |
| Kimi K2.6 API (Text zu Text) | Geben Sie Text-Prompts ein, und Kimi K2.6 liefert begründete Antworten, Code und strukturierte Ausgaben für alltägliche Produktivitätsaufgaben. Da es gleichermaßen für Reasoning und Coding optimiert ist, eignet es sich für Teams, die ein einziges Allzweckmodell für Analyse, Entwurf und Softwareentwicklung wünschen; zwischengespeicherte Eingaben für wiederholten Kontext kosten $0.16 pro Million Token. |
| Kimi K2.5 API (Text zu Text) | Wenn eine Aufgabe lange Dokumente oder mehrstufige Pipelines umfasst, verarbeitet Kimi K2.5 umfangreiche Texteingaben und liefert kohärente, kontextbewusste Antworten. Es wurde für Long-Context-Verständnis und intelligente Workflows entwickelt und läuft mit transparenter Pay-as-you-go-Preisgestaltung von $0.60 pro Million Eingabe-Token und $3 pro Million Ausgabe-Token, sodass groß angelegte Analysen kosteneffizient bleiben. |
Die Kimi API: von 256K Kontext bis zu 300-Agenten-Schwärmen
Die Kimi API bringt Moonshot AIs K2-Modelle mit Billionen Parametern an einen einzigen Endpoint und kombiniert ein Kontextfenster mit 262.144 Tokens mit nativer Bild- und Videoeingabe, selbstgesteuerten Agenten-Schwärmen sowie spezialisierten Modellen für Coding, Debugging und langfristiges Reasoning.
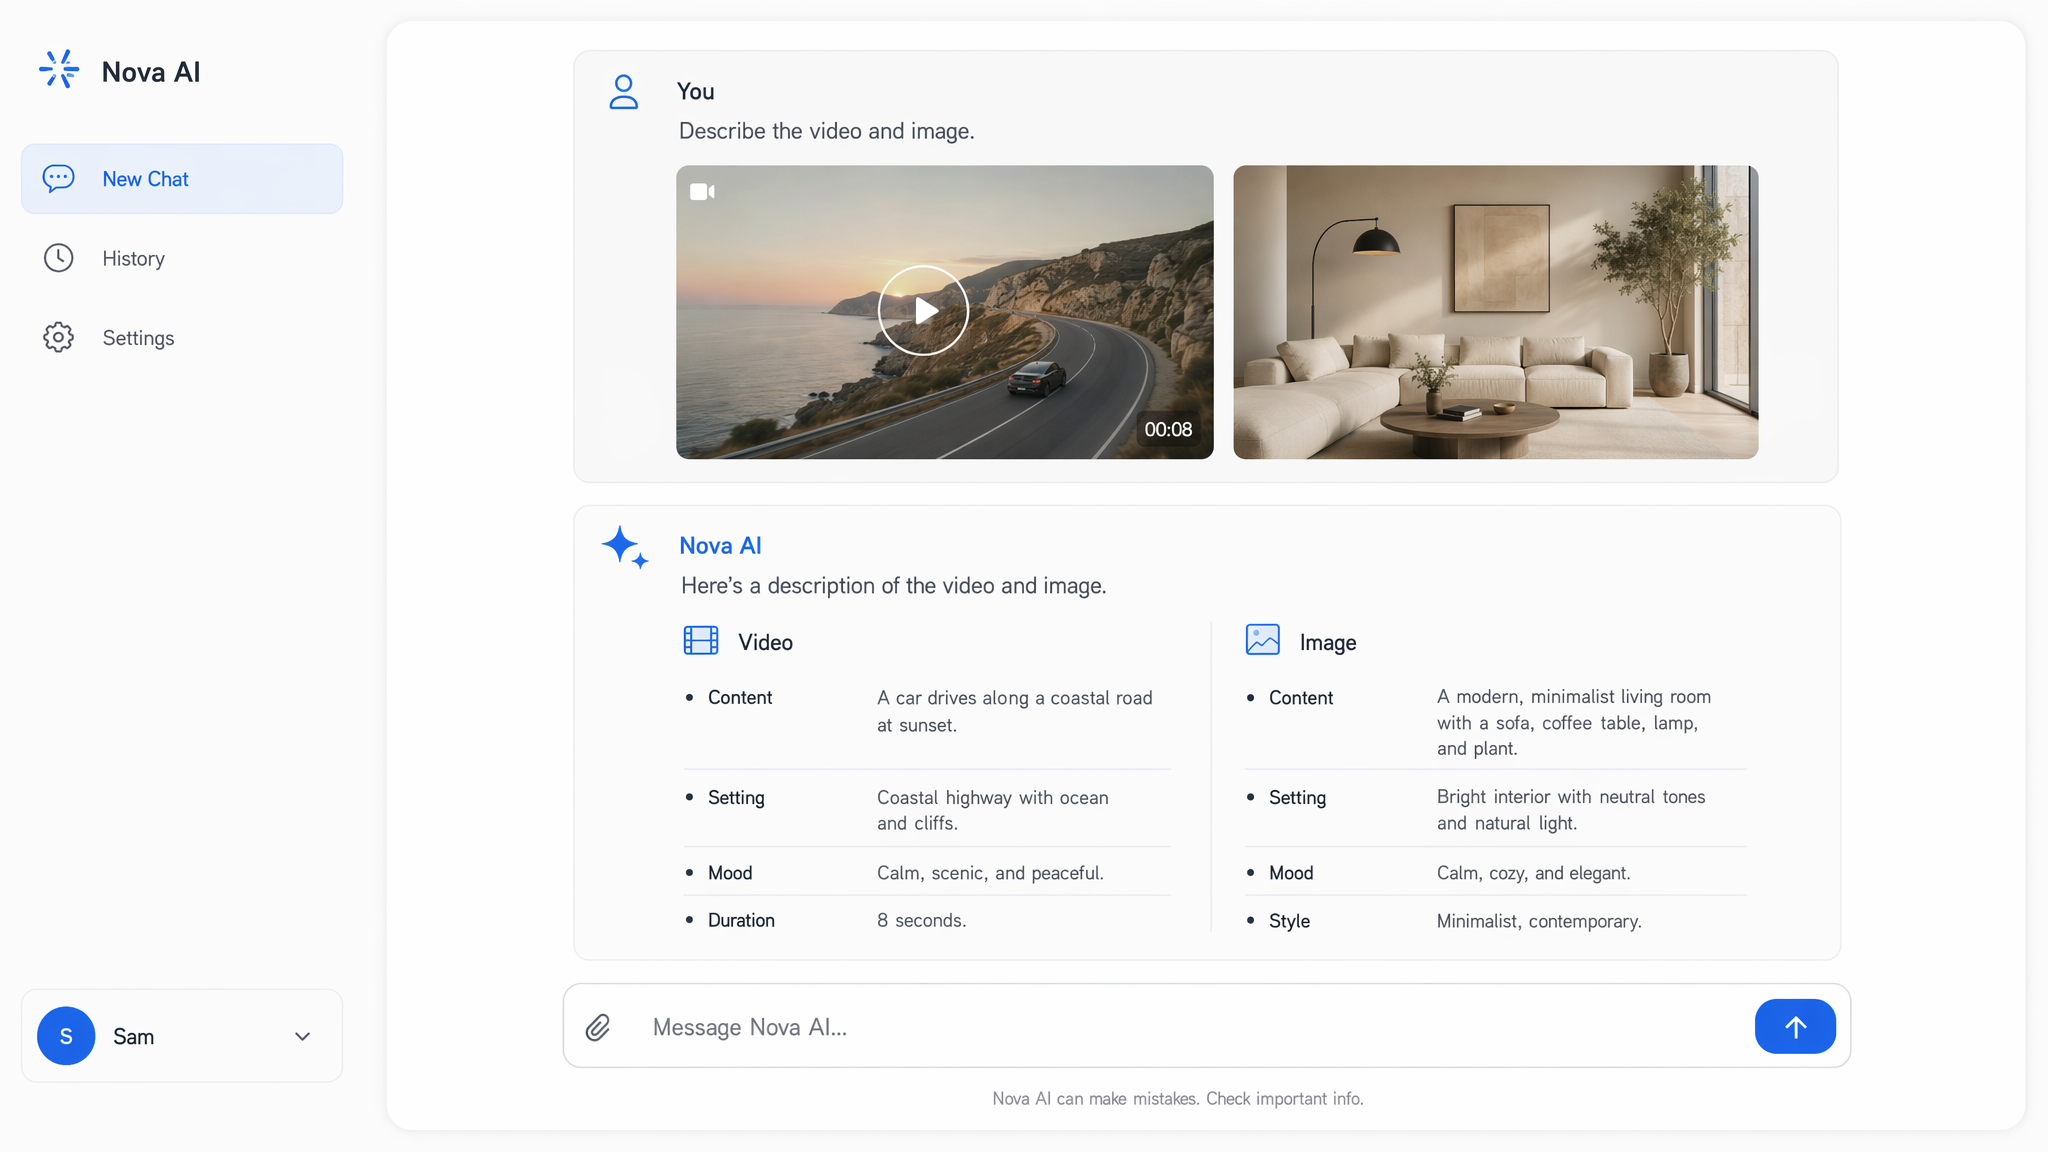
Natives Verständnis von Bildern und Videos
K2.6 verarbeitet Text, Bilder und Video in einer einzigen nativen multimodalen Architektur und akzeptiert Formate von PNG und WebP bis MP4, MOV und WebM ohne externe Plugins. Sein MoonViT Vision Encoder liest Bildschirmaufzeichnungen, Designdateien und Diagramme direkt. Während frühere K2.5-Versionen Text und Bilder verarbeiteten, erweitert K2.6 denselben Stack auf vollständiges Videoverständnis, sodass visueller Kontext einfach zu einem weiteren Input wird.
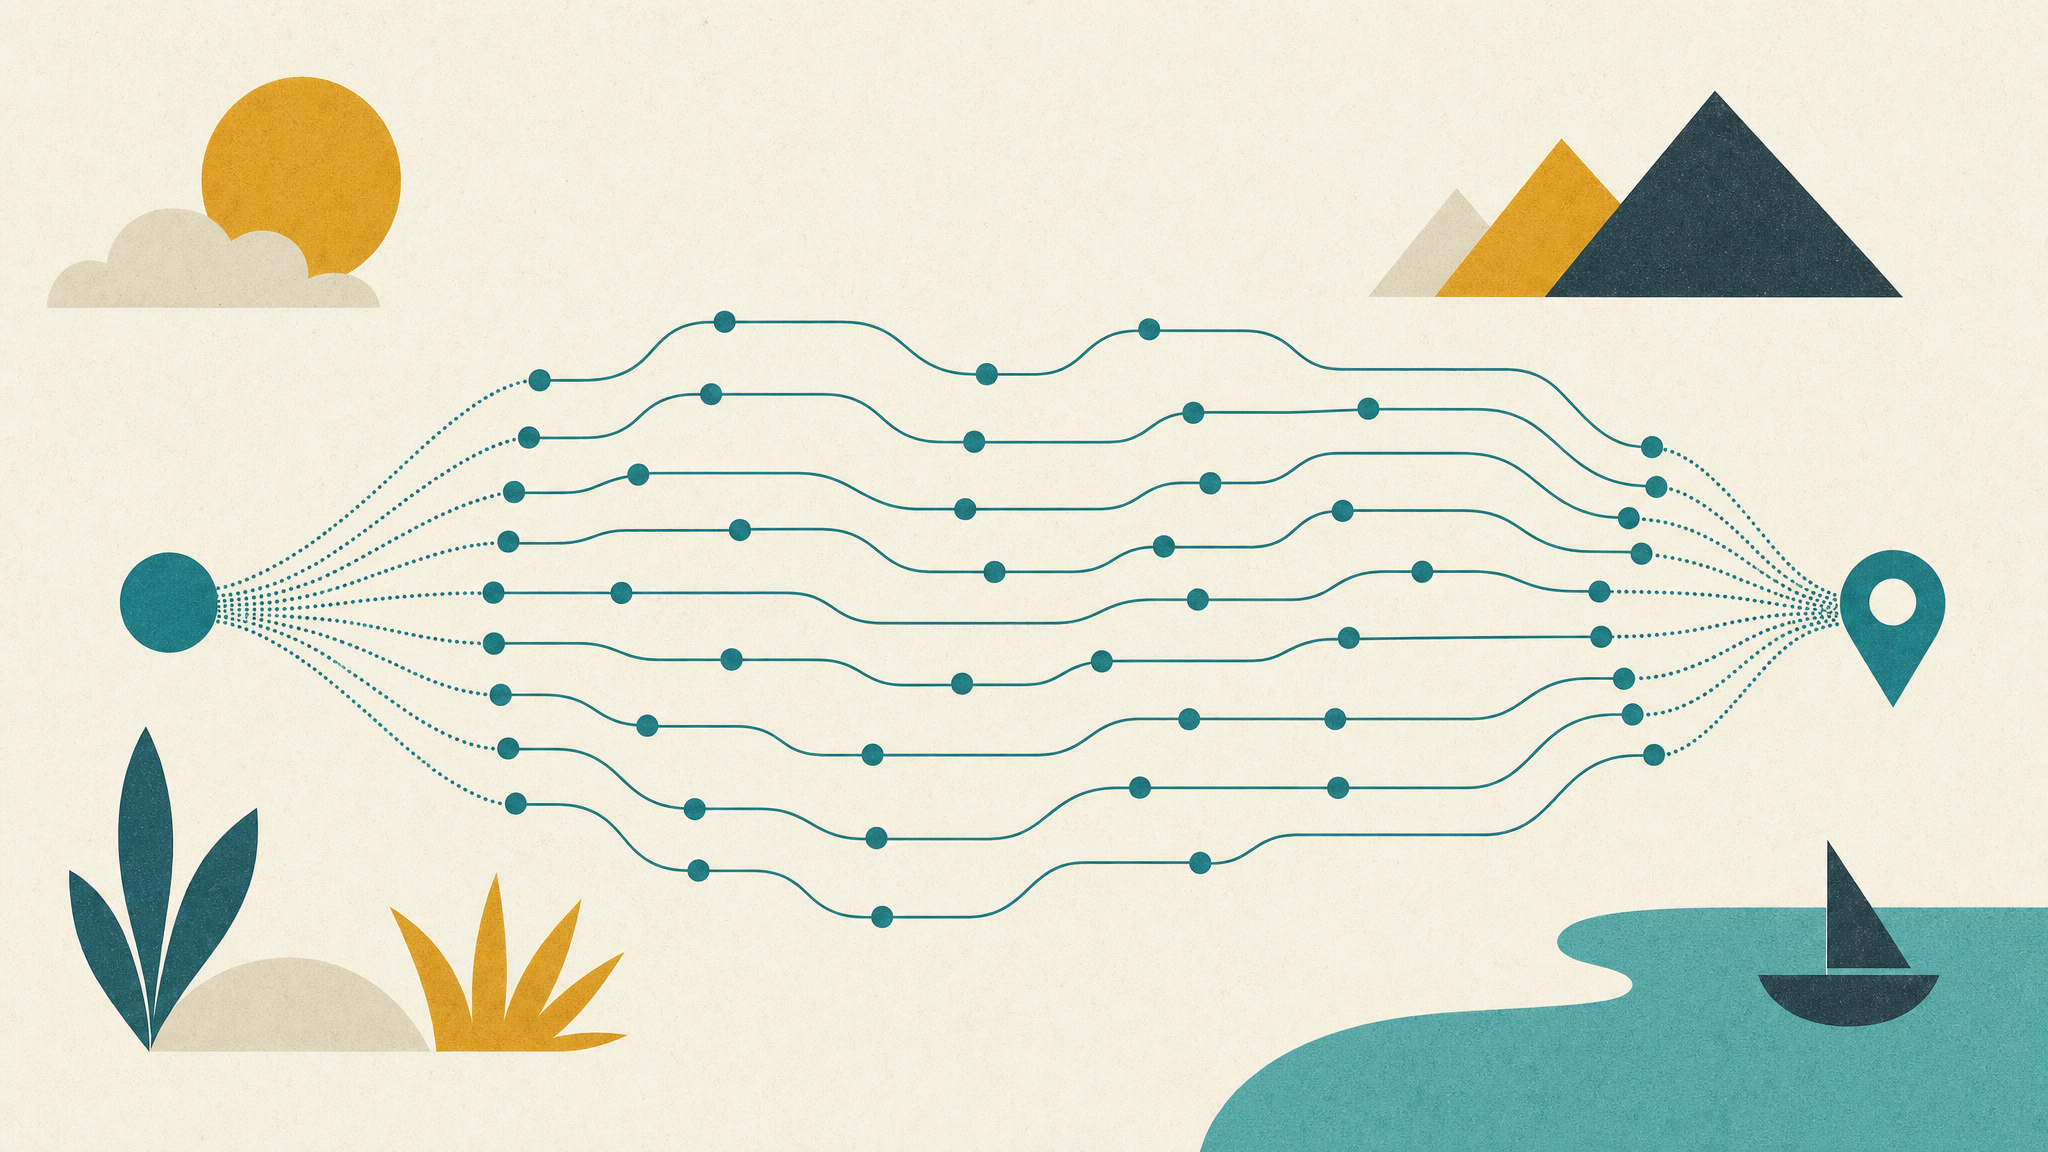
Selbstgesteuerte Agenten-Schwärme über die Kimi API
Die Kimi API stellt einen selbstgesteuerten Agenten-Schwarm bereit, der auf 300 Sub-Agenten skaliert, die über etwa 4.000 koordinierte Schritte hinweg arbeiten. Statt auf einem einzelnen Thread zu schlussfolgern, zerlegt K2.6 ein großes Ziel in parallele Zweige und orchestriert sie bis zum Abschluss. Jeder Sub-Agent übernimmt seinen eigenen Teil der Aufgabe und meldet die Ergebnisse anschließend an den gemeinsamen Plan zurück. Dieses Design eignet sich für langfristige Automatisierung, bei der sich ein Projekt über viele voneinander abhängige Phasen erstreckt.
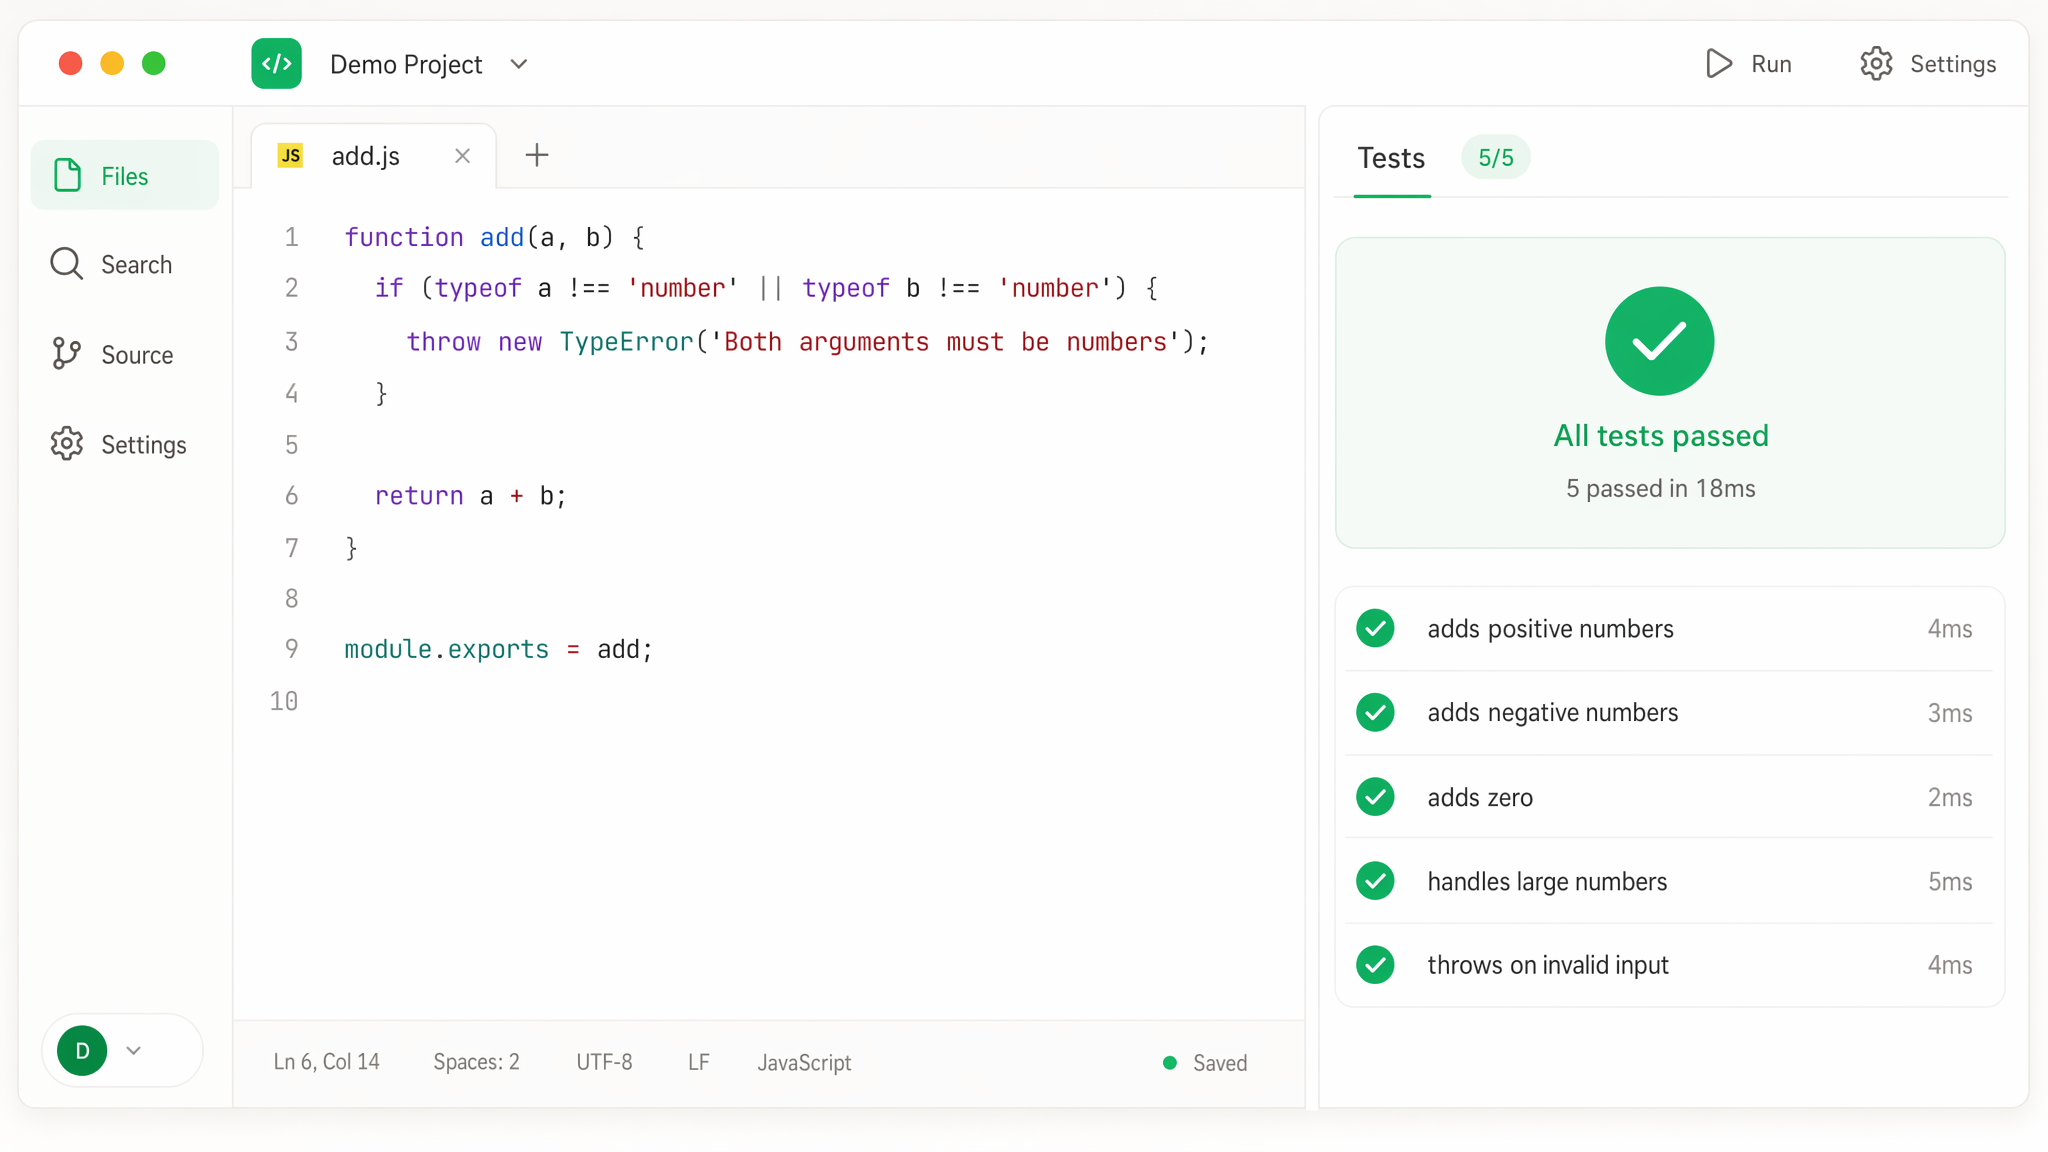
Coding und Debugging integriert
Coding steht im Zentrum der Familie, mit Kimi K2.7 Code, das gezielt für Programmierung, Debugging und Entwickler-Agent-Workflows entwickelt wurde. Im Coding-Benchmark SWE-Bench Pro erreicht K2.6 einen Wert von 58.6 und übertrifft damit mehrere Frontier-Modelle bei realen Repository-Fixes. Richte eines der beiden Modelle auf eine fehlschlagende Testsuite, und es verfolgt den Fehler, schlägt einen Patch vor und iteriert, bis der Build grün wird.
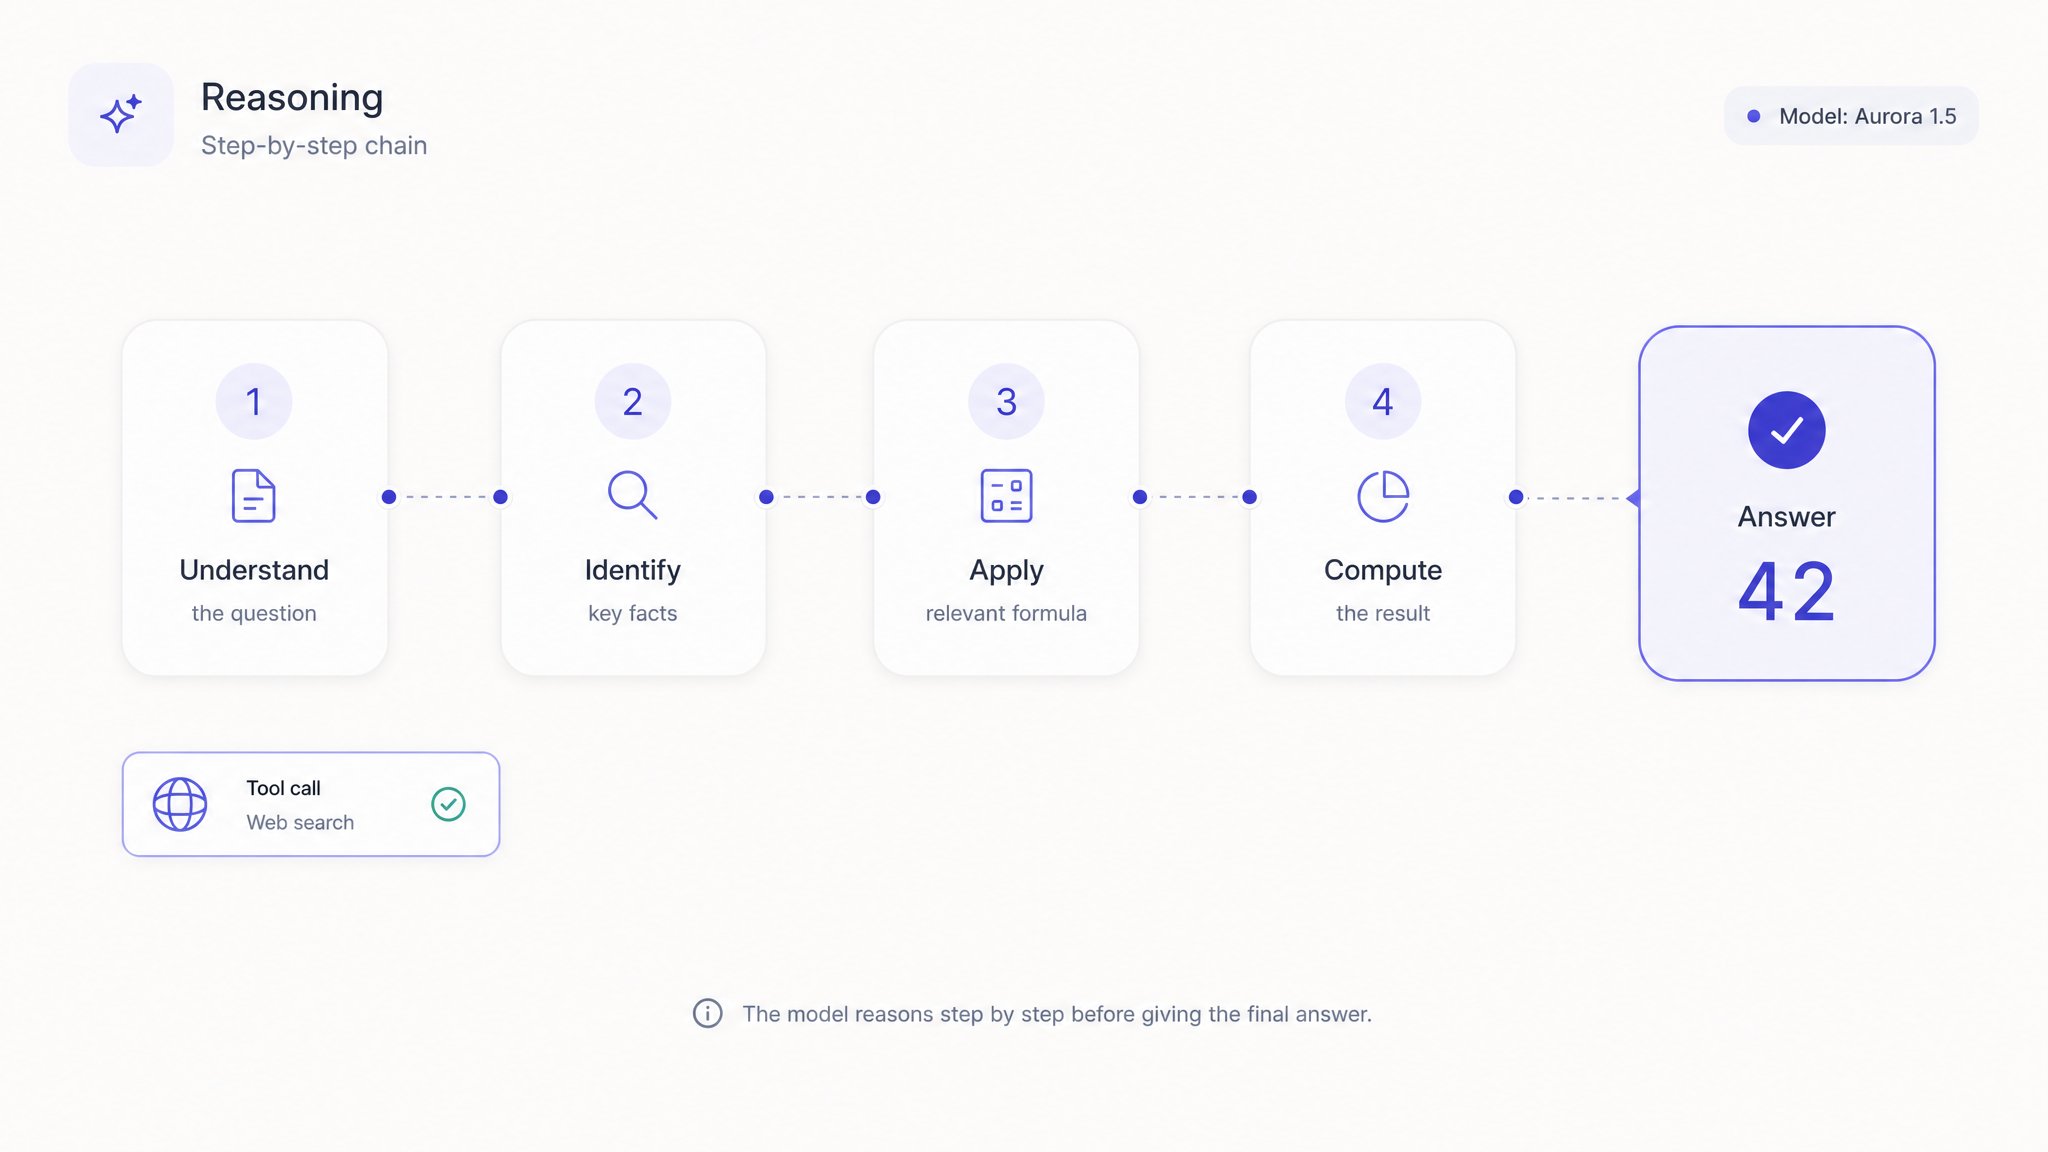
Agentic Reasoning mit einem einzigen Kimi API Key
Du brauchst transparentes Reasoning? Aktiviere den konfigurierbaren Thinking Mode, und das Modell zeigt seine Schritt-für-Schritt-Kette, bevor es sich auf eine Antwort festlegt, zusammen mit nativem Tool- und Function Calling. Auf Atlas Cloud läuft die gesamte Kimi API hinter einem einzigen OpenAI-kompatiblen Key, mit nutzungsbasierter Abrechnung pro Call und Day-0-Zugriff auf jedes neue Release. Tausche deine Base URL aus, und dein bestehender Code funktioniert weiter.
Kimi API im Vergleich: Ein Prompt, drei Models
Sende ein einziges identisches Briefing an die Kimi API und zwei konkurrierende Models und vergleiche anschließend die interaktive HTML-Seite, die jedes aus exakt denselben Anweisungen erstellt.
Erstelle eine vollständige Single-File-HTML-Seite für ein spielbares Snake-Arcade-Game, mit sämtlichem CSS und JavaScript inline und ohne externe Abhängigkeiten, CDNs, Bilder oder Fonts. Zeichne das Spielfeld auf einem Canvas in einem modernen Neon-auf-Dunkel-Farbschema, mit flüssiger Bewegung und einer weichen Leuchtspur hinter der Schlange. Unterstütze Steuerung per Pfeiltasten und WASD sowie Swipe-Gesten auf Touch-Geräten, zeige einen Live-Score und einen dauerhaft gespeicherten Highscore an und erhöhe die Spielgeschwindigkeit schrittweise, wenn der Score steigt. Löse jedes Mal, wenn Futter gefressen wird, eine kleine Partikel-Explosion aus, zeige ein animiertes Game-over-Overlay mit Restart-Button an und halte das Layout responsiv, sodass das Spielfeld sowohl auf Desktop als auch auf Mobilgeräten zentriert und gut lesbar bleibt.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Erstelle eine einzelne, vollständig in sich geschlossene HTML-Datei (sämtliches CSS und JavaScript inline, absolut keine externen Abhängigkeiten, CDNs, Bilder oder Web Fonts), die ein interaktives „lebendiges digitales Terrarium“ rendert — ein versiegeltes Glasgefäß in der Mitte des Bildschirms, das einen sich selbst erhaltenden Miniatur-Regenwald enthält, der in Echtzeit wächst. In jedem modernen Browser geöffnet, muss es sofort mit 60fps laufen, ohne Build-Schritt. Kernszene und Layout: Zentriere die Komposition symmetrisch und behandle das Glasgefäß als Hero-Bühne vor einem tiefen, vignettierte dunklen Hintergrund (radialer Verlauf von einer sanft moosbeleuchteten Mitte bis zu nahezu schwarzen Rändern), sodass der gesamte Fokus auf dem Gefäß liegt. Rendere alles auf einem vollflächigen HTML5 Canvas unter echtem Glassmorphism-DOM/CSS-Chrome: Die Gefäßwand muss überzeugende Glaseigenschaften zeigen — gekrümmte Brechungs-Highlights, einen hellen spiegelnden Rim-Light-Streifen, eine dezente milchige Unschärfe und verteilte Kondensationstropfen mit winziger Linsenwirkung — umgesetzt mit geschichteten radialen/linearen Verläufen, backdrop-filter blur, halbtransparenten weißen Konturen und weichen box-shadows. Im Inneren des Gefäßes befindet sich unten dunkler, feuchter Humusboden und ein dezenter volumetrischer Nebel, der langsam driftet. Die drei technischen Ebenen, die gestapelt werden und gleichzeitig existieren müssen (hier trennt sich ein schwaches von einem starken Model — ein schwaches Model erzeugt ein statisches Bild, ein starkes erweckt das ganze Gefäß zum Leben): 1. Rekursives L-system-Wachstum: Ranken, Farnwedel und Moose werden durch ein L-system / einen rekursiven Verzweigungsalgorithmus erzeugt und animieren ihr Entfalten über die Zeit — Stängel verlängern sich, Zweige unterteilen sich, Wedel entrollen sich, Blätter skalieren mit Easing hinein. Das Wachstum ist organisch und pro Zweig leicht randomisiert (Winkel-Jitter, Dickenverjüngung, Längenabnahme), sodass nach dem Neuladen keine zwei Pflanzen identisch aussehen. 2. Partikelsystem: Bernsteinfarbene, glühwürmchenartige Lichtpartikel (Dutzende) treiben und schweben mit weichem additivem Glow und sanfter Parallaxe durch den Nebel, dazu aufsteigende Kondensations-/Pollenkörnchen; Partikel reagieren subtil auf neu gewachsene Pflanzen. 3. Tag-Nacht-Lichtzyklus: Eine kontinuierliche Umgebungslicht-Schleife führt das von oben kommende Key Light von kühlem weißem Morgenlicht → warmem goldenem Abendlicht → tiefer indigo Nacht und zurück und färbt dabei die gesamte Szene, die Glas-Highlights, den Nebel und die Pflanzentöne entsprechend um. Pflanzen zeigen Phototropismus — Stängel biegen sich und neigen ihre Spitzen zur jeweils aktuellen Lichtrichtung, während sie sich bewegt. Primäre Interaktion: Ein Klick irgendwo auf die Glaswand oder ins Innere des Gefäßes lässt an der x-Position des Klicks einen einzelnen Samen in den Humus fallen, und dieser Samen durchläuft eine vollständige, sichtbare Lebensphase in Sequenz — der Samen fällt und setzt sich, keimt zu einem Spross, der Spross verzweigt sich rekursiv per L-system und bildet bei Reife eine kleine leuchtende Blüte — jede Phase mit Easing und klar lesbar, mit einer weichen Welle/Staubwolke beim Aufkommen. Mehrere Klicks erzeugen mehrere Pflanzen, die nebeneinander existieren und weiterwachsen und das Terrarium allmählich zu einem dichteren Dickicht füllen. Füge ein paar dezente Inline-Steuerelemente in glassmorphischen Pill-Buttons hinzu (z. B. „Terrarium zurücksetzen“ und ein Toggle „Tag/Nacht: auto ⇄ ziehen“, mit dem der Nutzer die Tageszeit scrubben kann, plus optional Pause). Zeige eine dezente Hinweiszeile („Tippe auf das Glas, um einen Samen zu pflanzen“), die nach der ersten Interaktion ausblendet. Palette und Stimmung: Waldiges Tinten-Grün und moosiges Gelbgrün für das Laub, Bernstein-/Honig-Glow für Lichtpartikel und Blüten, kühle Teal-Glas-Tönungen am Gefäß, warme Gold- und kühle Indigo-Washes im Tag-Nacht-Verlauf. Das Gesamtgefühl ist ruhig, atmend, meditativ — langsame, sanfte Bewegung, keine harten Übergänge. Technische Anforderungen: Verwende requestAnimationFrame mit Delta-Time, damit die Animation unabhängig von der Framerate ist; mache das Canvas responsiv für Größenänderungen des Fensters mit korrekter devicePixelRatio-Skalierung und halte das Gefäß zentriert; begrenze Partikel- und Zweigzahlen sinnvoll, damit alles flüssig bleibt; halte alle Zufallswerte pro Pflanze seeded, damit das Wachstum natürlich wirkt. Alles — Geometrie, Glow, Glas, Nebel, Licht, Partikel und die rekursiven Pflanzen — muss im Code gezeichnet oder berechnet werden, ohne externe Assets. Liefere ausschließlich das vollständige HTML-Dokument, bereit zum Speichern als einzelne .html-Datei und Öffnen.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Setzen Sie die Kimi API in Ihrem gesamten Stack produktiv ein
Ob Sie Code über riesige Repositories hinweg ausliefern, Designs in Benutzeroberflächen umwandeln oder Agent Swarms orchestrieren: Die Kimi API bringt Long-Context Reasoning und native Tool-Nutzung in echte Produktions-Workloads.

Coding auf Repository-Ebene mit der Kimi API
Kimi K2.7 Code liest ganze Repositories innerhalb eines 262K-token Fensters und refaktoriert, debuggt und erweitert Codebasen in einem Durchlauf. Teams nutzen es, um Legacy-Systeme zu modernisieren und Multi-File-Features auszuliefern, ohne den Projektkontext zu verlieren.

Designs in Front-End Code umwandeln
Geben Sie Kimi K2.5 einen Screenshot, ein Mockup oder ein kurzes Demo-Video, und es liefert aus dem visuellen Input funktionsfähigen Front-End Code zurück. Designer und Produktteams verwandeln statische Konzepte in wenigen Minuten in interaktive Seiten und Prototypen.

Lange Dokumente und Daten analysieren
Wenn Berichte oder Verträge Hunderte von Seiten umfassen, verarbeiten Kimi models sie innerhalb eines 256K-token Kontexts, um Trends und Konflikte offenzulegen. Analysten extrahieren strukturierte Antworten mit Quellenangaben, statt jede Seite manuell zu lesen.

Agent Swarms über die Kimi API orchestrieren
Agent Swarms ermöglichen Kimi K2.5, ein Ziel in bis zu 100 parallele Sub-Agents aufzuteilen und die Ausführungszeit um bis zu 4.5x zu verkürzen. Teams automatisieren Batch-Analysen und umfangreiche Builds, die ein einzelnes Modell nicht abschließen kann.

Autonome Agents mit Tool-Nutzung antreiben
Für agentische Tool-Nutzung trainiert, rufen Kimi models externe Funktionen, APIs und Suche auf, um Aufgaben ohne Schritt-für-Schritt-Prompting zu erledigen. Entwickler bauen Assistenten, die im Namen eines Nutzers in realen Systemen buchen, abfragen und handeln.

In Minuten zur Kimi API migrieren
Da die Kimi API OpenAI-kompatibel ist, tauschen Sie die Base URL und einen Key aus, um Traffic zu Moonshot models zu routen. Startups setzen Kimi ein, ohne Anwendungslogik neu zu schreiben, und zahlen transparente Preise pro Aufruf.
Kimi API vs. konkurrierende LLM APIs: Kontext, Modalität und Kosten
Vergleichen Sie die Kimi API mit anderen führenden Sprachmodell-APIs auf Atlas Cloud und sehen Sie, wo sie bei Kontextlänge, Eingabeflexibilität und Preis pro Token vorn liegt.
| Modell | Kontextfenster | Eingabetypen | Eingabepreis ($/1M tokens) | Ausgabepreis ($/1M tokens) |
|---|---|---|---|---|
| Kimi K2.7 Code | 256K tokens | Text, Bild | $0.95 | $4.00 |
| Kimi K2.6 | 256K tokens | Text, Bild, Video | $0.95 | $4.00 |
| Kimi K2.5 | 256K tokens | Text, Bild, Video | $0.60 | $3.00 |
| DeepSeek V4 Pro | 1M tokens | Text | $1.74 | $3.45 |
| GLM 5.2 | 1M tokens | Text | $1.40 | $4.40 |
| Grok 4.5 | 500K tokens | Text | $2.00 | $6.00 |
| Doubao Seed 2.1 Pro | 256K tokens | Text | $0.90 | $4.50 |
So verwenden Sie Kimi auf Atlas Cloud
In wenigen Minuten startklar — folgen Sie diesen einfachen Schritten, um Modelle über die Plattform von Atlas Cloud zu integrieren und bereitzustellen.
Atlas Cloud-Konto erstellen
Registrieren Sie sich auf atlascloud.ai und schließen Sie die Verifizierung ab. Neue Nutzer erhalten kostenlose Credits zum Erkunden der Plattform und Testen von Modellen.
Warum Kimi auf Atlas Cloud Verwenden
Die Kombination der fortschrittlichen Kimi-Modelle mit der GPU-beschleunigten Plattform von Atlas Cloud bietet unübertroffene Leistung, Skalierbarkeit und Entwicklererfahrung.
Leistung & Flexibilität
Niedrige Latenz:
GPU-optimierte Inferenz für Echtzeit-Reasoning.
Einheitliche API:
Führen Sie Kimi, GPT, Gemini und DeepSeek mit einer Integration aus.
Transparente Preisgestaltung:
Vorhersehbare Token-basierte Abrechnung mit serverlosen Optionen.
Unternehmen & Skalierung
Entwicklererfahrung:
SDKs, Analysen, Fine-Tuning-Tools und Vorlagen.
Zuverlässigkeit:
99,99% Verfügbarkeit, RBAC und compliance-bereite Protokollierung.
Sicherheit & Compliance:
SOC 2 Type II, HIPAA-Ausrichtung, Datensouveränität in den USA.
Kimi API: Fragen und Antworten
Die Kimi API bietet Entwicklern programmatischen Zugriff auf Moonshot AIs Kimi-Familie großer Sprachmodelle für Reasoning, Coding und Long-Context-Verständnis. Auf Atlas Cloud greifen Sie über einen einzigen OpenAI-kompatiblen Endpoint darauf zu, sodass ein einzelner Schlüssel alle Kimi-Versionen mit nutzungsbasierter Abrechnung pro Aufruf abdeckt.
Atlas Cloud hostet mehrere Versionen, darunter Kimi K2.5 für Long-Context- und agentische Workflows, Kimi K2.6 als Moonshots leistungsfähigstes allgemeines Modell und Kimi K2.7 Code für Programmierung und Debugging. Da sie dasselbe Request-Format verwenden, müssen Sie beim Wechsel zwischen ihnen nur einen einzigen Model-String ändern.
Diese Modelle sind besonders stark bei komplexem Coding, der Analyse von Multi-File-Repositories, dokumentenintensivem Reasoning und agentischem Tool Calling. Teams setzen Kimi ein, wenn eine Aufgabe sowohl ein großes Arbeitsgedächtnis als auch starke Schritt-für-Schritt-Logik erfordert, etwa beim Refactoring einer gesamten Codebase oder beim Prüfen umfangreicher Berichte.
Die Abrechnung erfolgt nutzungsbasiert, ohne Abonnement und ohne Mindestumsätze. Kimi K2.5 kostet $0.60 pro Million Input Tokens und $3.00 pro Million Output Tokens, während Kimi K2.6 und Kimi K2.7 Code bei $0.95 pro Million Input Tokens und $4.00 pro Million Output Tokens liegen. Context Caching senkt die Kosten für wiederholte oder gemeinsam genutzte Prompts.
Da Atlas Cloud Kimi über eine OpenAI-kompatible API bereitstellt, können Sie Ihr aktuelles OpenAI SDK auf den Atlas Endpoint ausrichten und einen Kimi-Modelnamen einsetzen. Ihre Anwendungslogik muss nicht neu geschrieben werden, was Kimi zu einem echten Drop-in für Chat-, Coding- und Agent-Pipelines macht.
Kimi K2.5, K2.6 und K2.7 Code unterstützen jeweils ein Kontextfenster von 262,144 Tokens, also ungefähr 256K Tokens. Diese Kapazität ermöglicht es, komplette Codebases, lange technische Handbücher oder Hunderte Seiten an Berichten in einen einzigen Request zu geben, ohne sie manuell in Chunks aufzuteilen.
Aktuelle Kimi-Versionen sind nativ multimodal und nicht auf Text beschränkt. Kimi K2.6 akzeptiert Text-, Bild- und Video-Input, und Kimi K2.5 kann über kombinierte visuelle und Text-Tokens reasonen. So können Sie Screenshots, Designdateien oder Aufzeichnungen übergeben und vom Modell gemeinsam mit Ihrem Prompt interpretieren lassen.
Entwickler entscheiden sich meist wegen der Kosten und des Kontexts dafür. Community-Berichte verweisen auf deutliche Einsparungen gegenüber führenden proprietären Modellen bei vergleichbarer Coding-Qualität, und das 256K-Fenster bewältigt Aufgaben mit ganzen Repositories und vollständigen Dokumenten, die Modelle mit kürzerem Kontext nicht leisten können. Legen Sie noch heute los.
Weitere Familien Erkunden
Kling 4.0
Die Kling 4 API stellt Kling 4.0 bereit, das Videomodell, das Kuaishou am 15. Oktober 2026 veröffentlicht hat. Es generiert bis zu 30 Sekunden in einem einzigen Durchlauf, folgt bis zu 10 Keyframes, mischt 15 Bilder, Videos und Motive über Omni Reference und fügt Stereo-Audio mit Lippensynchronisation hinzu. Atlas Cloud bedient alle vier Endpunkte, einschließlich der Videobearbeitung, über einen einzigen OpenAI-kompatiblen Schlüssel ab 0,11 $ pro Sekunde. Beginnen Sie noch heute mit der Entwicklung.

Seedance 2.5
Die Seedance 2.5 API bietet Entwicklern das gemeinsame Audio- und Videomodell von ByteDance Seed, das in einem Durchgang 4 bis 30 Sekunden aus Text, einem ersten Frame oder bis zu 50 Referenzen über Bilder, Video und Audio hinweg generiert. Es bearbeitet ausgewählte Bereiche, verlängert Clips und folgt White-Model- sowie Greenscreen-Eingaben. Atlas Cloud, ein autorisierter US-Wiederverkäufer, fügt einen 480p-Entwurfsmodus, native 1080p-Finaldateien und eine verbesserte 4K-Bereitstellung mit nutzungsbasierter Preisgestaltung hinzu.
Wan 3.0
Wan 3.0 ist Alibabas neuestes Videomodell, das in einer einzigen Generierung bis zu 30 Sekunden langes 1080p-Video bei 30fps mit Audio erzeugt. Steuern Sie es mit einem Text-Prompt, einem ersten Frame, bis zu 10 Referenzbildern oder einem Dokument. Standard kostet weniger pro Sekunde, während Prime die gleichen Funktionen beibehält und Ergebnisse schneller liefert. Beide laufen über denselben Atlas Cloud-Schlüssel wie Wan 2.7, 2.6 und 2.5.
GPT Image 2.6
Die GPT Image 2.6 API stellt Entwicklern das am 4. November 2026 veröffentlichte Bildmodell von OpenAI in zwei Versionen zur Verfügung: Flare für schnelle Iterationen und Sunburst für detaillierte visuelle Arbeiten. Es generiert Bilder 50 % schneller als bisher und bietet zusätzlich die Ausgabe von animierten GIFs, SVG-Export, Markup-Bearbeitungen für den eingekreisten Bereich sowie eine Komplexitätseinstellung. Atlas Cloud stellt beide Modelle über einen einzigen OpenAI-kompatiblen Schlüssel mit nutzungsbasierter Abrechnung bereit.
MiniMax H3
MiniMax H3 ist die multimodale Videofamilie von MiniMax für text-, bild- und referenzgesteuerte Erstellung. Über die unterstützten Routen hinweg bleiben Motive aus Referenzmedien erhalten, flexible Seitenverhältnisse stehen zur Verfügung, und H3 Developer kombiniert generierten Ton mit visuellen Inhalten, wobei die Ausgabeprofile je nach Endpoint ausgewählt werden. Atlas Cloud bündelt die Familie hinter einem OpenAI-kompatiblen Schlüssel mit transparenter nutzungsbasierter Abrechnung zum Standardtarif von $0.038 pro Sekunde. Beginnen Sie noch heute mit der Entwicklung.
GPT Image 2.5
GPT Image 2.5 ist das Bildgenerierungs- und Bearbeitungsmodell von OpenAI, das am 8. September 2026 in zwei API-Versionen veröffentlicht wurde. Flare ist die Standardversion mit einer bis zu 50 % geringeren Latenz als GPT Image 2, während Sunburst länger braucht, um eine feinere Kontrolle über detaillierte Bearbeitungen zu ermöglichen. Beide unterstützen bis zu 16 Referenzbilder, fünf Qualitätsstufen, transparente Hintergründe und benutzerdefinierte Größen bis zu 3840px. Atlas Cloud stellt die GPT Image 2.5 API zu den Token-Raten von OpenAI oder zu einem Festpreis pro Bild je nach 1K-, 2K- oder 4K-Stufe bereit.
Seedream 5.0 Pro
Die Seedream 5.0 Pro API bietet Entwicklern das steuerbare Bildbearbeitungsmodell von ByteDance auf Atlas Cloud. Sie platziert Bearbeitungen präzise mit Ankern und Koordinaten, trennt Bilder in bearbeitbare Ebenen, verschmilzt mehrere Referenzen und passt exakte Farben und Materialien an, mit mehrsprachigem Text in 2K und 3K. Auf Atlas Cloud erreichen Sie es über einen einzigen Schlüssel!
Seedance 2.0
Seedance 2.0 ist ByteDances Produktionsvideomodell für die präzise Erstellung von Einstellungen. Verwandle Prompts in Videos, animiere ein Erstbild mit optionaler Führung durch ein Letztbild oder gestalte Ergebnisse mit Referenzmedien und optionaler Websuche. Atlas Cloud vereint diese Workflows in einer einheitlichen API mit transparenter nutzungsbasierter Preisgestaltung und einem einzigen OpenAI-kompatiblen Schlüssel. Beginne noch heute mit der Entwicklung.
Kling V3.0
Die Kling-V3-API-Familie von Kuaishou unterstützt Workflows mit Text, Bildern und Referenzvideos. Übertragen Sie Bewegungen, während die Identität der Figur erhalten bleibt, steuern Sie die Generierung mit visuellen Referenzen und bearbeiten Sie Videos per natürlichsprachlichen Anweisungen. Atlas Cloud bietet Standard- und Pro-Endpunkte für unterschiedliche Produktionsanforderungen. Neu: Kling V4 ist jetzt auf Atlas Cloud verfügbar. Entdecken Sie es auf der Seite [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video ermöglicht Entwicklern den Zugriff auf xAIs Videofamilie zum Erstellen, Animieren, Erweitern und Bearbeiten von Clips. Erstelle 1- bis 15-sekündige Videos aus Prompts, steuere Personen, Objekte oder Stile mit bis zu sieben Referenzbildern und arbeite in 480p oder 720p. Atlas Cloud bündelt diese Möglichkeiten über OpenAI-compatible Endpoints mit transparenten Pay-as-you-go-Preisen. Beginne noch heute mit der Entwicklung.
Vidu Q4 Preview
Vidu Q4 ist Vidus neuestes Flaggschiff-Videomodell, entwickelt für die Generierung von Image-to-Video- und Reference-to-Video-Inhalten. Es kann ein einzelnes Standbild animieren und automatische Szenenübergänge erstellen, sodass Entwicklern zwei Eingabepfade für unterschiedliche Produkt-Workflows zur Verfügung stehen. Atlas Cloud stellt dedizierte API-Endpunkte mit veröffentlichten Parameterschemata zum verifizierten Standardpreis von $0.04 pro Sekunde bereit. Beginnen Sie noch heute mit der Entwicklung.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash ist die von Google DeepMind entwickelte, von Grund auf multimodale Videomodellfamilie für flexible Produktions-Workflows. Bearbeiten Sie bestehendes Filmmaterial per Textanweisung, wahren Sie mit bis zu 10 Referenzbildern und 3 Videoclips die visuelle Konsistenz oder verlängern Sie eine Aufnahme in verkettbaren Segmenten auf bis zu 40 Sekunden. Greifen Sie mit einem einzigen OpenAI-kompatiblen API-Schlüssel, nutzungsabhängiger Abrechnung und Verfügbarkeit ab Tag 0 auf jeden Workflow in Atlas Cloud zu. Beginnen Sie noch heute mit der Entwicklung.
Empfohlene Artikel
Anleitungen, Tutorials und Produkt-Updates, mit denen Sie das Beste aus Atlas Cloud herausholen.


