Der Code sieht fertig aus. Dann schlagen die Tests fehl, die Korrektur ändert eine Schnittstelle, und die nächste Anfrage beginnt zu laufen. Die beste KI-API fürs Programmieren zu wählen bedeutet, ein Modell und einen Endpunkt zu finden, die deine Art von Arbeit innerhalb eines akzeptablen Budgets abschließen.
Beginne mit Claude, GPT oder Gemini als Referenzkandidat. Vergleiche DeepSeek, Qwen und Kimi bei denselben Aufgaben, wenn du alternative Bereitstellungs- und Ausgabenoptionen suchst. Beim Debugging priorisiere Regressionstests. Beim Refactoring prüfe den Diff. Bei einem Coding-Agent überprüfe die gesamte Tool-Schleife, bevor du Token-Preise vergleichst.
Die Frustration ist messbar. In der Stack Overflow Developer Survey 2025 gaben 66 % der Befragten auf die Frage nach Frustrationen an, dass KI-Lösungen nahezu korrekt sind; 45 % berichteten, mehr Zeit mit dem Debugging von generiertem Code zu verbringen. Dies sind Umfrageantworten, keine Modellbewertung aus 2026. (Stack Overflow Developer Survey, 2025)
Wichtigste Erkenntnisse
- Wähle API und Agent getrennt.
- Erstelle eine Auswahlliste nach Aufgabe und benötigten Endpunkt-Funktionen.
- Speichere die ersten Antworten und bewerte sie anhand fester Akzeptanztests.
- Beziehe fehlgeschlagene Versuche und Reparaturen in deine Kostenberechnung ein.
Dieser Leitfaden bietet eine Auswahlliste, drei kopierbare Bewertungsaufgaben und ein Kostenarbeitsblatt. Die Recherche wurde am 21. September 2026 überprüft. Modellverfügbarkeit, dokumentierte Fähigkeiten und gemessene Ergebnisse sind durchgehend getrennte Evidenzkategorien.
Beste KI-API fürs Programmieren: Die Auswahlliste
Beginne mit zwei Kandidaten: einem, der zu deiner bestehenden Anwendung passt, und einer Alternative. Nutze diese sechs Familien, um dieses erste Paar zu bilden.
Die Tabelle schlägt Tests vor, ohne vergleichende Leistung zu behaupten. Der Zugriff hängt von deinem Konto, deiner Region, deinem Kontingent und deinem Endpunkt ab; ein Dokumentationseintrag bestätigt nicht, dass deine Zugangsdaten ihn aufrufen können.
| Spezifisches Modell und ID | Zugriffspfad | Zu bewertende Aufgabe | Wichtigste Entscheidungsgrenze | Endpunkt-Evidenz | Preisprüfung |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Eingeschränkte Änderungen über mehrere Dateien | Client- und Reasoning-Steuerung prüfen | Claude Platform Modellübersicht; Kontozugriff ungetestet | Keine Rate angegeben |
GPT-6 Astra, gpt-6-astra | OpenAI API | Programmieraufgaben mit mehreren Bedingungen | Route und Tools prüfen | OpenAI Modelldokumentation; Kontozugriff ungetestet | Keine Rate angegeben |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Interaktive Generierung und Review | Latenz und Protokoll prüfen | Google AI Modellverzeichnis; Kontozugriff ungetestet | Keine Rate angegeben |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud model route | Numerische Korrekturen; Kontext-Experimente | 0813-Version separat halten | Exakte Modellseite verifiziert; Laufzeitfunktionen ungetestet | 21. September 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud model route | Refactorings; eigenständige Schnittstellen | Angegebene Version; nicht die neueste | Exakte Modellseite verifiziert; Laufzeitfunktionen ungetestet | 21. September 2026 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud model route | Dieselben drei Aufgaben; CSV-Schnittstelle | Ausgabe und Abschlussgrenzen prüfen | Exakte Modellseite verifiziert; Laufzeitfunktionen ungetestet | 21. September 2026 |
Claude, GPT und Gemini bieten nützliche Referenzkandidaten. Ihre offiziellen Modellverzeichnisse identifizieren die oben genannten Versionen. Nutze einen Anbieter, den du bereits kennst, als Ausgangsbasis, und teste dann, ob eine Alternative die Kosten pro akzeptierter Aufgabe oder den Integrationsaufwand senkt. Betrachte das Verhalten eines Verbraucher-Assistenten nicht als das entsprechende API-Ergebnis.
Das Modellverzeichnis von OpenAI listet GPT-6 Astra neben der GPT-5.6-Familie. Das begründet einen aktuellen Kandidaten, nicht einen Programmier-Sieg gegenüber den anderen Zeilen. Die Tabelle vermeidet bewusst, alte Modell-IDs aus undatierten Vergleichsseiten zu übernehmen. (OpenAI model directory, abgerufen September 2026)
DeepSeek verdient einen Platz als separate zu untersuchende Modellfamilie. Teste, ob es den konkreten Fehler behebt, ohne die Änderung zu verbreitern. Wähle einen anderen Kandidaten, wenn die bereitgestellte Route dein erforderliches Antwortformat, Tool-Verhalten oder deine Latenzobergrenze nicht erfüllen kann, unabhängig vom allgemeinen Ruf des Modells.
Bewerte Qwen nach Version. Die genannte 122B-A10B-Bereitstellung liefert eine konkrete Preisreferenz. Führe die Parsing- und Browser-Checks durch, bevor du ein Werturteil fällst. Kontextangaben aus anderen Qwen-Releases können diesem Modell nicht zugeordnet werden.
Kimi ist der ausgearbeitete Konfigurationskandidat. Seine öffentliche Seite identifiziert die Modell-ID. Eine Konfigurationsprüfung ist möglich; erfolgreiche Generierung bleibt unbestätigt. Bewerte seine fertige Ausgabe anhand derselben Einschränkungen wie die anderen Kandidaten.
Atlas Cloud liegt in diesem Vergleich auf der Zugriffsebene. Es ist kein siebtes Modell. Seine Relevanz ist praktisch: Du kannst mehrere Kandidaten-Modellseiten einsehen und ihre Integrationsanforderungen vergleichen, bevor du dich auf einen Workflow festlegst.
Bei offenen Gewichten prüfe die genaue Release-Lizenz und das Bereitstellungsartefakt. Gehostete Inferenz hat separate Servicebedingungen und Betriebskosten; die Modellfamilie allein kann diese nicht begründen.
Coding-APIs, Modelle und Agents erklärt
Ein Modell erzeugt Inhalte als Reaktion auf Eingaben. Eine API definiert, wie deine Anwendung diese Eingabe sendet und das Ergebnis empfängt. Ein Coding-Agent organisiert die umgebende Arbeit: Dateien lesen, Tools aufrufen, Änderungen anwenden, Tests ausführen und entscheiden, ob fortgefahren wird.
Diese drei Ebenen können unabhängig voneinander fehlschlagen. Ein Modell kann einen korrekten Patch vorschlagen, während der Agent ihn in die falsche Datei schreibt. Eine API kann gültiges JSON zurückgeben, während die Anwendung einen Tool-Aufruf ignoriert. Ein fähiger Agent kann ins Stocken geraten, weil sein ausgewählter Endpunkt einen Parameter ablehnt.
Angenommen, du sendest einen Handler und bittest um einen ID-Parser. Eine grundlegende Codegenerierungs-API gibt Text zurück, der Code enthält. Dein Programm muss diesen Code noch extrahieren, ihn in einen passenden Arbeitsbereich legen und die Tests ausführen. Eine erfolgreiche HTTP-Antwort belegt die Zustellung, nicht die Korrektheit.
Ein Agent kann diese Schritte nur automatisieren, wenn du die Tools und Berechtigungen bereitstellst. Er braucht außerdem eine Abbruchbedingung. Ohne eine solche kann er wiederholt eine bereits akzeptable Funktion bearbeiten, die Aufgabe ausweiten oder zusätzliche Anfragen verbrauchen, um ein irrelevant scheinendes Detail zu verbessern.
Halte drei Budgetposten getrennt:
- Tool-Abonnement: die Anwendung, Editor-Integration oder der Agent-Service, den du nutzt.
- Inferenznutzung: Anfragen an den ausgewählten Modellendpunkt unter dessen Abrechnungsbedingungen.
- Ausführungsumgebung: Container, Test-Runner, Speicher und andere Infrastruktur.
Einige Produkte bündeln Teile dieses Stacks. Andere erwarten, dass du separate Zugangsdaten mitbringst. Prüfe den konkreten Tarif, bevor du annimmst, dass ein Editor-Abonnement beliebigen API-Datenverkehr aus deiner eigenen Anwendung einschließt.
Auch die Protokollkompatibilität hat eine Grenze. Ein Dienst, der ein vertrautes messages-Array akzeptiert, kann dennoch anderes Tool-Verhalten, andere Streaming-Ereignisse, Kontextgrenzen oder Reasoning-Steuerungen aufweisen. Das Kopieren einer Basis-URL kann die Unterstützung für jedes Feature im Ökosystem eines anderen Anbieters nicht begründen.
Ordne Anwendung, Agent, Endpunkt, Modell, Tools und Tests zu. Identifiziere bei jedem Schritt die abzurechnende Komponente und den verantwortlichen Betreiber, bevor du Modelle wechselst.
Beste KI-API fürs Programmieren: 7 Auswahlprüfungen
1. Funktionale Korrektheit und Regressionsverhalten. Schreibe die erwarteten Ausgaben, bevor du Code anforderst. Eine Preisfunktion, die gewöhnliche Ganzzahlen verarbeitet, aber null als null akzeptiert, verletzt den Vertrag. Führe sowohl die neuen Randfälle als auch bestehende Projekttests aus; das Bestehen eines neuen Tests kann einen kaputten Aufrufer an anderer Stelle verbergen.
2. Umfang der Änderung. Vergleiche den Patch mit der Anfrage. Das Extrahieren eines ID-Parsers sollte die URL, die Erfolgsantwort und die Fehlerantwort bewahren. Eine unaufgeforderte Framework-Migration erzeugt Review-Aufwand, selbst wenn die Ersetzung kompiliert. Entscheide im Voraus, ob unbezogene Änderungen die Antwort disqualifizieren oder eine Reparatur erfordern.
3. Nützlicher Kontext und Ausgaberaum. Deine Anfrage enthält Anweisungen, relevante Dateien, Tool-Definitionen und vorherige Konversation. Reserviere auch genügend Platz für die Antwort. Ein großes beworbenes Kontextfenster belegt nicht, dass das Modell die relevante Invariante findet oder dass dein Endpunkt dasselbe Maximum akzeptiert.
Teste die Kontextqualität mit einer wichtigen Abhängigkeit. Füge einen Aufrufer ein, dessen Schnittstelle stabil bleiben muss, und prüfe, ob das Modell ihn respektiert. Miss die Trunkierung separat: Eine Antwort, die mitten in einer Funktion endet, kann nicht akzeptiert werden, nur weil ihre Anfangspassagen vielversprechend aussahen.
4. Tool-Aufrufe und strukturierte Ausgabe. Überprüfe die bereitgestellte Route mit deinem tatsächlichen Tool-Schema. Prüfe Argumenttypen, fehlende Felder, Tool-Identifikatoren und die Folgeantwort nach einem Tool-Ergebnis. Ein Modell, das ein plausibles JSON-Objekt schreibt, hat nicht unbedingt einen nativen Tool-Call-Roundtrip abgeschlossen.
5. Zeit bis zu einem akzeptierten Ergebnis. Erfasse die Dauer des gesamten Versuchs, einschließlich Reparaturen und Tests. Bei einem interaktiven Assistenten zählt auch die Zeit bis zum ersten sichtbaren Text, aber sie kann die Fertigstellungszeit nicht ersetzen. Ein schnelles erstes Token, gefolgt von einer langen unbrauchbaren Antwort, blockiert den Entwickler weiterhin.
6. Eingabe-, Ausgabe-, Cache- und Wiederholungsgebühren. Lies die Abrechnungskategorien, die dein gewählter Endpunkt tatsächlich ausweist. Trenne Cache-Lesevorgänge von gewöhnlicher Eingabe, sofern zutreffend. Verfolge erfolglose Anfragen und abgebrochene Schleifen. Wenn der Anbieter das benötigte Detail nicht offenlegt, markiere die fehlenden Annahmen der Schätzung ausdrücklich.
7. Integrations- und Code-Handling-Bedingungen. Bestätige, dass dein Editor oder deine Anwendung die Route, die Authentifizierungsmethode und das Fehlerformat unterstützt. Prüfe die aktuellen Datenverarbeitungsbedingungen des Anbieters, bevor du privaten Quellcode sendest. Offene Gewichte beschreiben eine Modellverteilungswahl; sie belegen nicht, wie ein gehosteter Dienst deine Anfragen behandelt.
Öffentliche Benchmarks können bei der Kandidatenauswahl helfen, vorausgesetzt, du liest ihre Bedingungen. SWE-bench Verified enthält 500 menschlich gefilterte Instanzen. Die aktuelle Seite beschreibt außerdem eine Bash-Only-Ansicht, die dieselbe mini-SWE-agent-Umgebung verwendet. Diese Details helfen zu erklären, was verglichen wird. (SWE-bench, abgerufen September 2026)
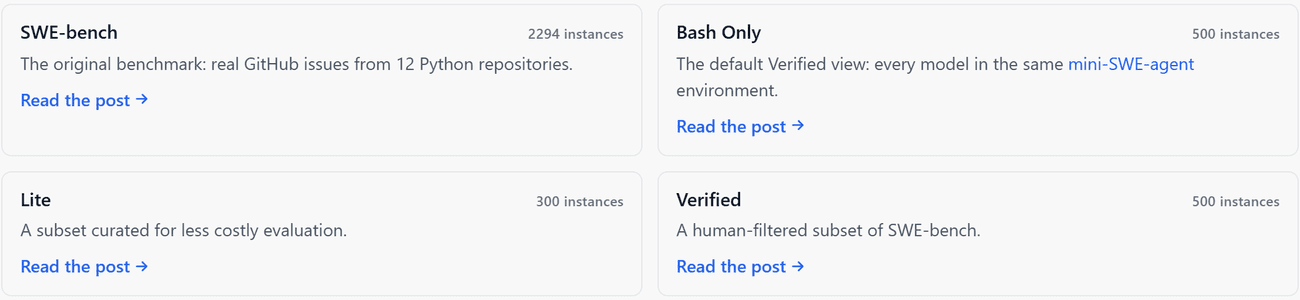 SWE-bench-Seite mit der Größe des Verified-Datasets und der gemeinsamen Agent-Umgebung
Quellenevidenz: die echte Benchmark-Seite, aufgenommen am 21. September 2026. Dataset- und Ausführungsbedingungen gehören neben jede Leistungsaussage.
Benchmark-Ergebnisse beschreiben ein bestimmtes Setup. Deine Sprache, Geschäftsregeln, Berechtigungen und Review-Standards können abweichen. Triff die endgültige Entscheidung anhand von Arbeit, die du überprüfen kannst.
Beste KI-API fürs Programmieren: Führe drei praktische Prüfungen durch
Diese drei reproduzierbaren Bewertungsbeispiele legen unterschiedliche Fehlermodi offen. Lege ihre Akzeptanzregeln fest, bevor du die Ausgabe anforderst. Beurteile die Funktion oder Seite anhand ihres Vertrags, unabhängig von der Erklärungsqualität.
Für DeepSeek V4 Pro, Qwen3.5 122B A10B und Kimi K3 ist das vorgesehene Protokoll drei unabhängige Durchläufe pro Aufgabe. Das bedeutet 27 erste Versuche. Erlaube höchstens eine Feedback-Reparatur pro Versuch, bewahre die erste Antwort auf und berichte Erst- und reparierte Ergebnisse getrennt.
Fordere Temperatur null nur dort an, wo sie unterstützt wird, und protokolliere die tatsächlich akzeptierte Einstellung. Verwende eine angeforderte Ausgabengrenze von 4.096 Token für A und B und 8.192 für C, nachdem du die Endpunktgrenzen geprüft hast. Standardwerte und nicht unterstützte Steuerungen müssen festgehalten werden. Niedrige Temperatur garantiert keine identischen Antworten.
Evidenzstatus: Der Zugriff auf die Testumgebung wurde durch einen Cloudflare-Access-Anmeldebildschirm blockiert. Die 27 Kandidatenversuche konnten nicht ausgeführt werden. Die folgende Evidenz zeigt lokal ausgeführten Originalcode und ein vom Artikel erstelltes CSV-Referenz-Fixture, keine Kandidatenmodellergebnisse. Bestehensquoten der Modelle, Token-Nutzung und Aufgabenkosten bleiben ungemessen.
Aufgabe A: numerische Preisauswahl korrigieren. Füge diesen exakten Prompt in eine frische Sitzung ein:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Die festen Akzeptanz-Eingaben sind [2,10,3], ["12","3"], ein leeres Array, nur ungültige Werte, null, negative Zahlen und nur aus Leerzeichen bestehende Strings. Lehne leere Strings nach dem Trimmen ab. Prüfe, dass das ursprüngliche Array nach dem Aufruf exakt dieselben Elemente in derselben Reihenfolge enthält.
Das Original verwendet JavaScripts Standardsortierung und mutiert seine Eingabe. Die Aufgabe prüft daher zwei verschiedene Pflichten: das korrekte numerische Minimum auswählen und die Daten des Aufrufers nicht verändern. Teste die Konvertierungsregeln ausdrücklich, da eine kurze, auf Koerzierung basierende Lösung versehentlich boolesche Werte oder null akzeptieren kann.
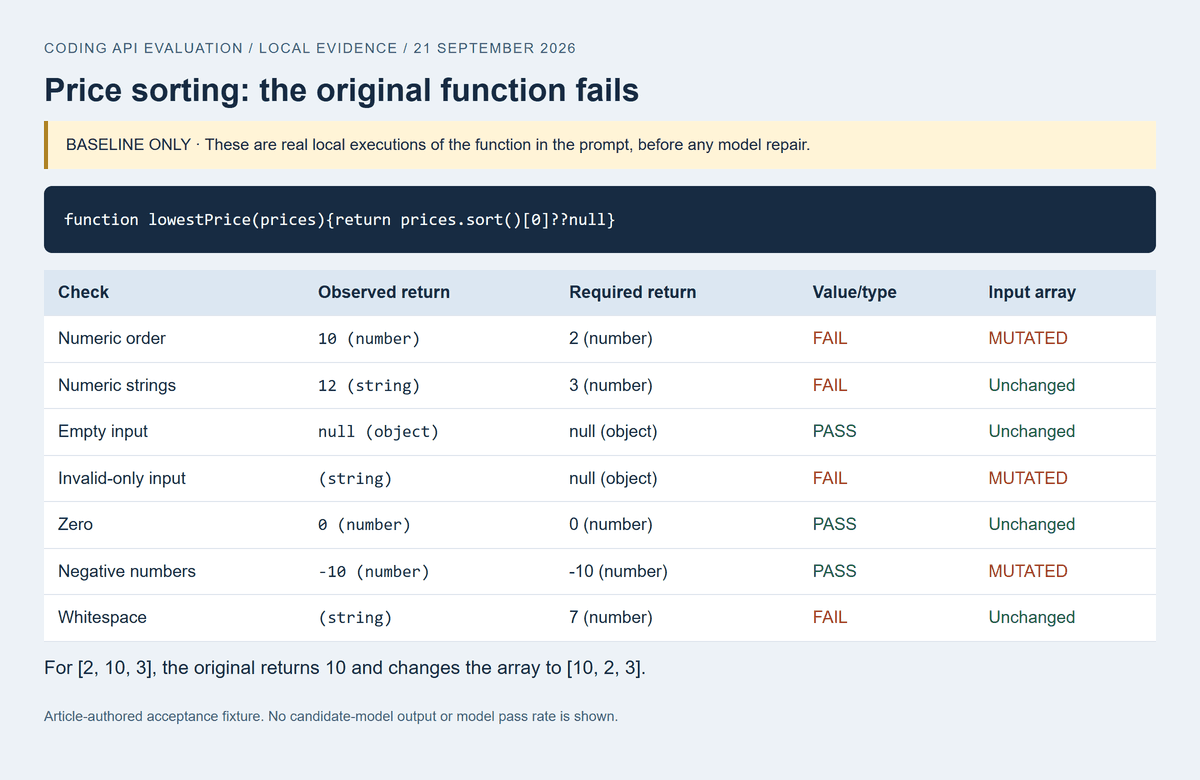 Lokale Ausführung der ursprünglichen Preisfunktion mit fehlerhafter numerischer Sortierung und mutierter Eingabe
Ausgeführte Baseline: Die Originalfunktion gibt für [2,10,3] 10 zurück und ändert das Array zu [10,2,3]. Numerische Strings verletzen ebenfalls den Rückgabewert-Vertrag. Es wird keine Modellreparatur gezeigt.
Aufgabe B: eine Schnittstelle während eines kleinen Refactorings bewahren. Verwende diesen Prompt unverändert:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Akzeptiere "12" und "0012" als 12. Lehne "1e2", "1.0", negative Zahlen, null, Leerzeichen, Nicht-String-Eingaben und Werte außerhalb des sicheren Ganzzahlbereichs von JavaScript ab. Prüfe den registrierten Pfad und beide Antwortinhalte. Ungültige Eingaben dürfen findUser nicht erreichen.
Diese Aufgabe testet, ob das Modell den Unterschied zwischen numerischer Konvertierung und der spezifizierten String-Grammatik versteht. Untersuche den Diff auf unbezogene Änderungen und rufe dann den Handler mit gestubbten Request- und Response-Objekten auf. Ein korrekter Helfer, gepaart mit einem unveränderten, permissiven Handler, schlägt trotzdem fehl.
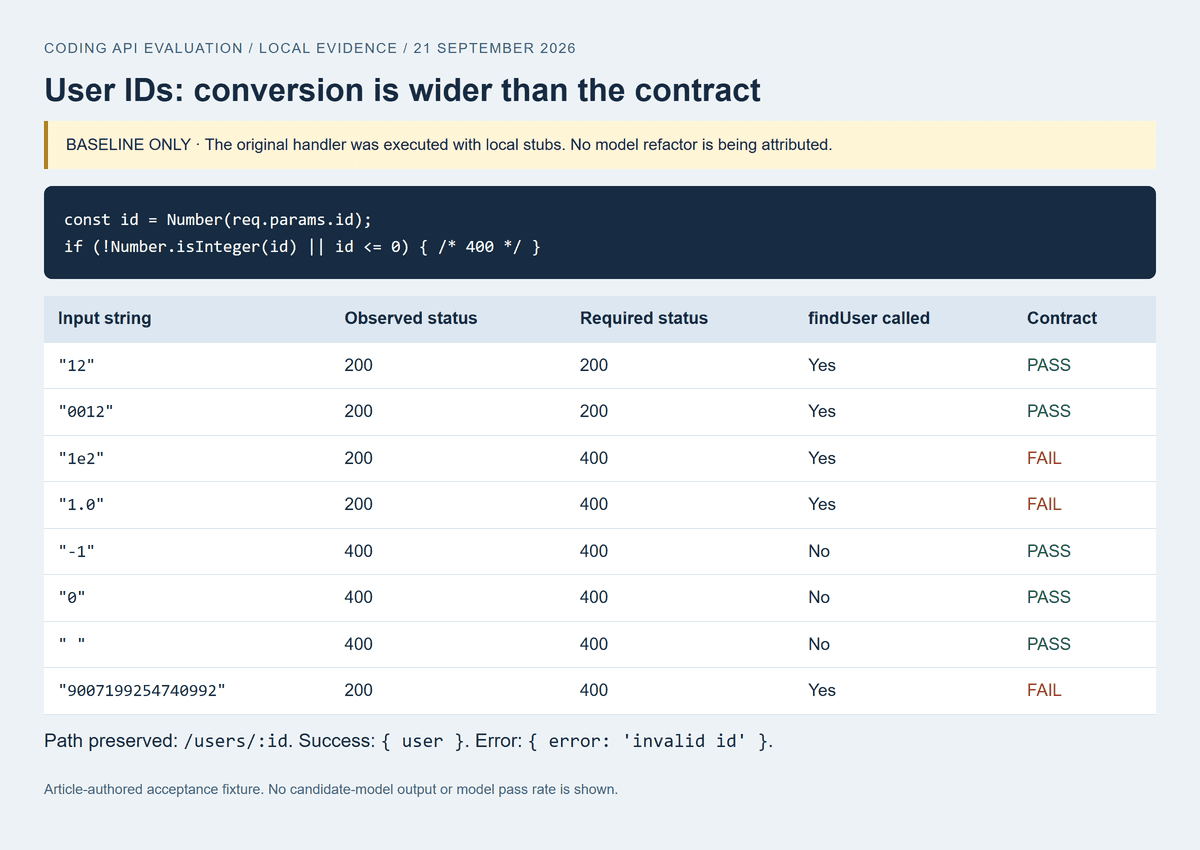 Testprotokoll des ursprünglichen Handlers mit akzeptierten ungültigen numerischen Strings und Status 200
Ausgeführte Baseline: Der Originalhandler gibt für "1e2", "1.0" und "9007199254740992" 200 zurück, entgegen der erforderlichen 400-Antwort. Lokale Stubs zeichneten die Aufrufe auf; dies ist kein modellgeneriertes Refactoring.
Aufgabe C: eine CSV-Vorschau erstellen, die du bedienen kannst. Reiche ein:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Teste mit diesen exakten Datensätzen, zuerst mit LF und dann mit CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Erwarte zwei Spalten, drei Datenzeilen, Alices Komma in einer Zelle und Bobs korrekt angezeigtes escaped Anführungszeichen. Eves Wert muss als wörtlicher Text erscheinen, ohne Bildelement, Ereignisausführung oder Netzwerkanfrage. Füge eine Zeile mit drei Feldern hinzu und bestätige, dass die Seite die Abweichung sichtbar meldet.
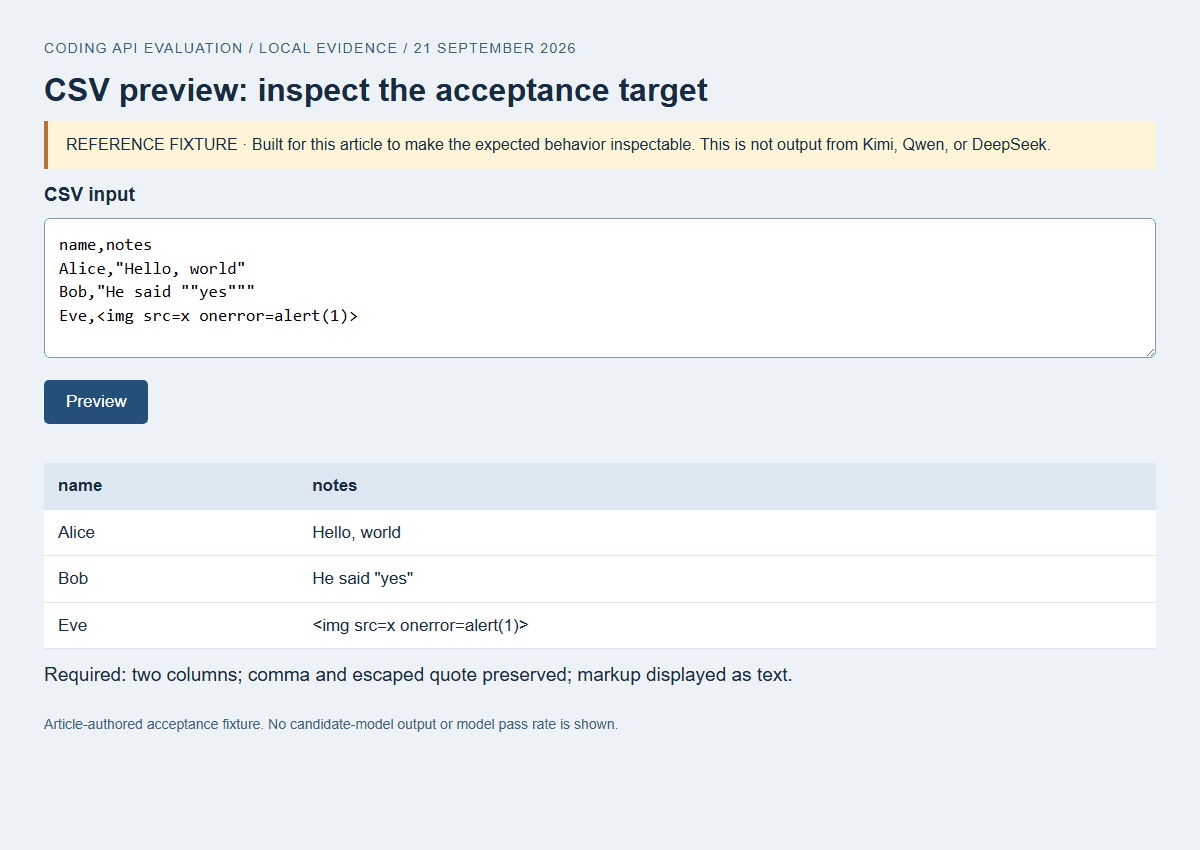 CSV-Akzeptanz-Fixture mit zitierten Werten und Anforderungen an wörtliches Markup
Bedientes Referenz-Fixture, für diesen Artikel erstellt, nicht von einem Kandidatenmodell generiert. Browser-Checks verifizierten LF/CRLF-Parsing, escaped Anführungszeichen, wörtliches Markup, sichtbare Feldanzahlfehler und keine HTTP-Anfragen. Der Screenshot zeigt den Zustand gültiger Eingabe nach dem Klick auf Preview.
Speichere Rohausgabe, Logs, Modell-ID, Datum, Parameter, Timing, Reparaturen und manuelle Änderungen. Sende fehlgeschlagene Assertions für eine Reparatur, ohne die erwarteten Ergebnisse zu ändern. Bewahre Ablehnungen, Trunkierungen und Fehler neben Erfolgen auf.
Beste KI-API fürs Programmieren mit kleinem Budget
Vergleiche Token-Raten neben Fertigstellungsqualität und Nutzung. Wiederholte Eingaben können die Kosten für Codereview dominieren; Ganzdatei-Generierung kann die Ausgabekosten erhöhen. Wiederholte Reparaturen kommen zu beidem hinzu.
Der Atlas-Katalog und die exakten Detailseiten zeigten am 21. September 2026 diese Raten in USD pro Million Token:
- DeepSeek V4 Pro: $1.68 Eingabe und $3.38 Ausgabe. Der separate V4 Pro 0813-Eintrag verwendet andere Raten; ersetze ihn nicht.
- Qwen3.5 122B A10B: $0.30 Eingabe und $2.40 Ausgabe. Der Katalog zeigte reguläre Raten von $0.40 und $3.20 mit 25 % Rabatt, Stand September 2026.
- Kimi K3: $3.00 Eingabe und $15.00 Ausgabe.
Dies sind angezeigte Produktionsraten, keine Rechnungen aus der Bewertung des Artikels. Cache-spezifische Raten und ihre Anwendbarkeit wurden nicht bestätigt. Werbe-Rabatte für DeepSeek und Kimi wurden nicht bestätigt. Eine fehlende Rabattbeobachtung beweist nicht, dass kein Angebot existiert.
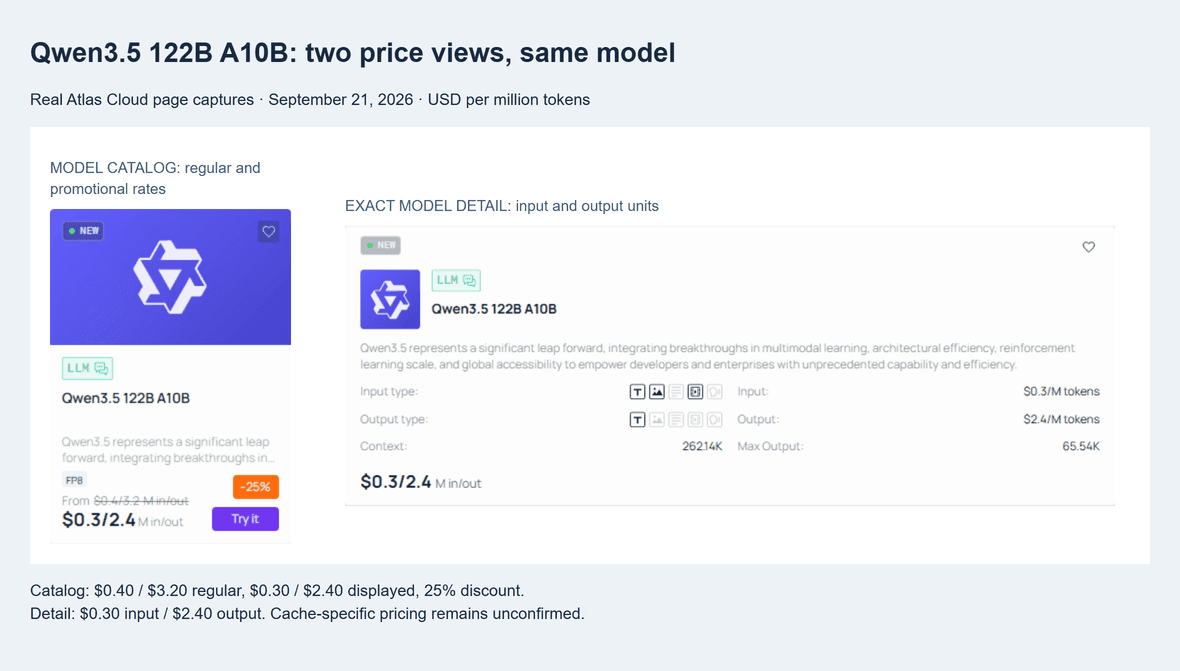 Qwen3.5 122B A10B Katalograbatt neben seinen exakten Modell-Detail-Eingabe- und Ausgaberaten
Qwen-Preis-Gegenprüfung, 21. September 2026: Der Katalog zeigt die 25 %-Aktion; das exakte Modell-Detail bestätigt $0.30 Eingabe und $2.40 Ausgabe pro Million Token. Cache-spezifische Raten bleiben unbestätigt.
Berechne den Modellanteil einer Aufgabe wie folgt:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Belaste gecachte Token nicht erneut als gewöhnliche Eingabe, wenn der Abrechnungsdatensatz sie separat behandelt. Prüfe, ob Reasoning-Nutzung in der abrechenbaren Ausgabe enthalten ist. Wenn keine Aufgabe besteht, melde „kein erfolgreiches Ergebnis“; eine Division durch null oder die Anzeige von null Fertigstellungskosten würde den Leser irreführen.
Für ein transparentes Rechenbeispiel nehmen wir 10.000 gewöhnliche Eingabe-Token und 2.000 Ausgabe-Token zu den angezeigten Qwen-Raten an. Die geschätzte Modellgebühr beträgt $0.0078, vor allen anderen zutreffenden Posten. Dies ist eine hypothetische Anfrage, keine beobachtete Token-Nutzung oder tatsächliche Rechnung.
Eine gleich große Reparatur brächte die Schätzung auf $0.0156. Tatsächliche Reparaturen enthalten unterschiedlichen Kontext und unterschiedliche Ausgabe, daher berechne jede Anfrage aus ihrer aufgezeichneten Nutzung.
| Aufgabe | Modell | Erster Durchlauf | Nach Reparatur | Token-Nutzung | Kostenquelle | Gesamtgebühr | Gesamtzeit | Manuelle Änderungen |
|---|---|---|---|---|---|---|---|---|
| A, B, C; je 3 Wiederholungen geplant | DeepSeek V4 Pro | Nicht gemessen | Nicht gemessen | Nicht erfasst | Kein Nutzungsdatensatz | Unbekannt | Nicht gemessen | Keine bewertet |
| A, B, C; je 3 Wiederholungen geplant | Qwen3.5 122B A10B | Nicht gemessen | Nicht gemessen | Nicht erfasst | Kein Nutzungsdatensatz | Unbekannt | Nicht gemessen | Keine bewertet |
| A, B, C; je 3 Wiederholungen geplant | Kimi K3 | Nicht gemessen | Nicht gemessen | Nicht erfasst | Kein Nutzungsdatensatz | Unbekannt | Nicht gemessen | Keine bewertet |
Erweitere für dein eigenes Arbeitsblatt jede Zeile zu einer Zeile pro Modell und Wiederholung. Zähle einen reparierten Erfolg einmal im Nenner der akzeptierten Aufgaben. Beziehe erfolglose Versuche in den Zähler ein und behalte separate Spalten für Erst- und Endakzeptanz.
Verfolge menschliches Review und Infrastruktur separat. Das Entwirren einer unnötigen Umschreibung kann eine Inferenzersparnis zunichtemachen. Vergleiche Kandidaten, die sowohl die Akzeptanzanforderungen als auch dein Review-Zeitbudget erfüllen.
Beste KI-API fürs Programmieren mit Atlas Cloud
Beginne mit der Kimi K3 Modellseite, bestätige die ID und prüfe die API- und Code-Ansichten. Halte die gewählte Version neben dem Testdatensatz.
Lies die LLM-Protokolldokumentation, bevor du zwei Routen als austauschbar behandelst. Sie identifiziert Chat Completions als die Route mit breiter Abdeckung und verweist Nutzer auf die supported_apis jedes Modells. Sampling-Steuerungen und Tool-Funktionen hängen ebenfalls von der beworbenen Unterstützung des Modells ab.
Hier gibt es konkrete Integrationsdetails, die es sich zu prüfen lohnt. Die Dokumentation besagt, dass übersetzte Anthropic-Anfragen cache_control nicht anwenden und anbietergehostete Tools auf dieser übersetzten Route nicht verfügbar sind. Diese Einschränkungen sind wichtig, wenn dein bestehender Agent natives Caching oder ein gehostetes Browsing-Tool annimmt. Bringe den Client mit der tatsächlichen Route in Einklang.
Das folgende Node.js-Beispiel veranschaulicht eine Textanfrage. Es verwendet das integrierte fetch, eine Umgebungsvariable für Zugangsdaten und die verifizierte Kimi-Modell-ID. Speichere den exakten Prompt von Aufgabe A als task-a.txt. Setze die Basis-URL-Umgebungsvariable auf die in der Atlas-Dokumentation gezeigte API-Basis, die auf /v1 endet.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages transportiert die Aufgabe; model wählt die Bereitstellung; max_tokens fordert eine Ausgabengrenze an. Der Antwortleser prüft auf gewöhnlichen abgeschlossenen Text, bevor er Code zurückgibt. Das Timeout begrenzt die Wartezeit dieses Beispiels; es belegt nicht, dass der Server die Verarbeitung eingestellt hat oder keine Gebühr angefallen ist.
Temperatur wird weggelassen, da die Unterstützung pro Modell und das zugesagte Verhalten überprüft werden müssen. Das Beispiel wiederholt nicht automatisch. Prüfe die Fehlerklasse, bevor du eine begrenzte Wiederholungsrichtlinie hinzufügst, und protokolliere niemals den Autorisierungsheader. Dieser Veröffentlichungscode wurde während der Artikelproduktion nicht mit einem API-Schlüssel ausgeführt.
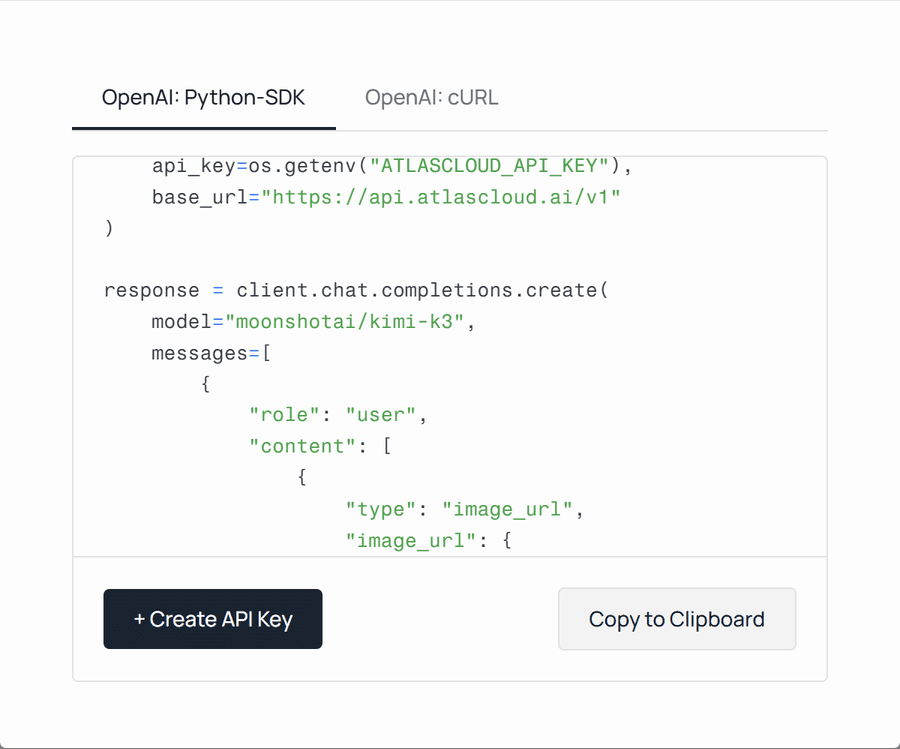 Öffentliches Kimi K3 API-Codebeispiel mit dem Atlas-Endpunkt und der Modellkennung
Öffentlicher Kimi K3 Code-Dialog, aufgenommen am 21. September 2026. Dies ist Konfigurationsevidenz, kein abgeschlossener Programmierdurchlauf. Das Beispiel der Seite enthält Medieneingabe; das Artikelbeispiel verwendet nur Text.
Führe die Akzeptanzprüfungen von Aufgabe A auf jeder zurückgegebenen Funktion aus. Bevor du zu DeepSeek oder Qwen wechselst, überprüfe dessen Protokoll und Parameter. Halte Prompts und Tests unverändert, während du Ausgabe und Nutzung vergleichst; eine gemeinsame Request-Form belegt kein identisches Verhalten.
Bevor du eine Coding-API in der Produktion einsetzt
Führe generierten Code zuerst in einem Wegwerf-Branch oder isolierten Arbeitsbereich aus. Verwende für die CSV-Aufgabe einen lokalen Browserkontext mit blockierten Netzwerkanfragen und ohne Zugriff auf sensiblen Anwendungszustand. Gib dem Prozess bei Repository-Aufgaben nur die für die Bewertung benötigten Dateien und Befehle.
Definiere Erfolg außerhalb der Antwort des Modells. Wenn ein Agent „alle Tests bestanden“ sagt, sollte dich das zu einem tatsächlichen Testprotokoll, Exit-Code und geprüften Revision führen. Speichere den Diff mit dieser Evidenz. Andernfalls kann eine spätere Reparatur die Dateien nach dem scheinbaren Erfolg ändern und den Bericht veralten lassen.
Behandle Timeouts und Wiederholungen als Anwendungsverhalten, das du besitzt. Setze eine Anfragefrist und ein Gesamtaufgabenbudget. Trenne Fehler, die durch Zugangsdaten oder ungültige Parameter verursacht werden, von vorübergehenden Transportfehlern. Eine ungültige Anfrage zu wiederholen kostet Zeit; eine Anfrage zu wiederholen, die Nebenwirkungen auslöst, kann doppelte Arbeit erzeugen.
Wenn der Agent Tools aufrufen kann, unterscheide schreibgeschützte Inspektion von Schreibvorgängen. Vergib Operationskennungen, wo dein Tool-Design dies unterstützt, und bestätige den Zustand, bevor du einen unsicheren Schreibvorgang wiederholst. Die Wiederholungsrichtlinie eines Modellendpunkts kann keine Idempotenz für die Tools garantieren, die deine Anwendung danach ausführt.
Schütze Logs genauso bewusst wie Quelldateien. Erfasse Modell-IDs, Zeitstempel, Status, Timing und Nutzung, ohne routinemäßig Geheimnisse oder ganze private Repositories in Telemetrie zu kopieren. Bewahre benötigte Rohausgaben-Evidenz an einem angemessen eingeschränkten Ort auf und lege fest, wie lange das Team sie aufbewahren muss.
Prüfe Streaming mit deinem echten Client. Er muss Teilereignisse, Beendigung, Fehler und Nutzungsdatensätze, wo verfügbar, verarbeiten. Bestätige die Ratenbegrenzungen für das tatsächliche Konto und die Bereitstellung. Ein ruhiges Einzelnutzer-Experiment kann nicht belegen, wie sich dieselbe Route verhält, wenn ein Team gleichzeitig Anfragen stellt.
Verwende diese kurze Release-Checkliste:
- Akzeptanztests und bestehende Regressionen bestehen auf der finalen Revision.
- Der Diff bleibt innerhalb der genehmigten Aufgabengrenze.
- Timeout-, Abbruch- und Wiederholungsverhalten wurden geprüft.
- Tool-Aufrufe und strukturierte Antworten funktionieren am ausgewählten Endpunkt.
- Logs schließen Zugangsdaten und unnötigen privaten Code aus.
- Datenverarbeitungsbedingungen erfüllen die Anforderungen des Teams.
- Ein Fallback hat seine eigene verifizierte Konfiguration und seinen eigenen Testdatensatz.
Private Repositories erfordern eine dienstspezifische Entscheidung. Prüfe aktuelle Aufbewahrungs-, Trainingsnutzungs-, Zugriffs- und Vertragsbedingungen mit der für den Code verantwortlichen Person. Sende nur genehmigtes Material. Schließe nicht auf Vertraulichkeit daraus, dass Modellgewichte verfügbar sind oder ein Protokoll dem ähnelt, das du bereits verwendest.
Beste KI-API fürs Programmieren: Triff deine endgültige Wahl
Triff die Entscheidung in drei Durchgängen.
Erstens, eliminiere Kandidaten, denen eine erforderliche Fähigkeit fehlt. Schreibe die Bedingungen auf, die gelten müssen: ein akzeptiertes Ausgabeformat, eine funktionierende Tool-Schleife, eine angemessene Datenverarbeitungsvereinbarung oder eine machbare Antwortfrist. Ein Kandidat, dem eine davon fehlt, braucht eine separate Behebungsentscheidung, bevor er in den endgültigen Vergleich gehört.
Zweitens, vergleiche Kosten pro akzeptierter Aufgabe und verstrichene Zeit. Verwende alle Versuche unter derselben Reparaturrichtlinie. Trenne Erst-Durchlauf-Erfolge von reparierten Erfolgen und zeige fehlende Nutzungsdatensätze auf. Wenn zwei Modelle beide den Vertrag erfüllen, vergleiche ihre Review-Last ebenso wie die Modellgebühren. Deine Entwickler werden mit den resultierenden Patches leben.
Drittens, behalte einen Fallback und definiere seinen Auslöser. Beispiele sind ein anhaltender Endpunktausfall, wiederholte strukturierte Ausgabefehler oder Aufgabenkosten, die eine gewählte Obergrenze überschreiten. Teste die alternative Konfiguration im Voraus. Das Umschalten einer Modell-ID unter Druck kann ein zweites Integrationsproblem einführen, wenn ihre Steuerungen oder ihr Antwortverhalten abweichen.
Die drei kleinen Aufgaben in diesem Leitfaden sind eine Screening-Übung. Erweitere die Suite mit repräsentativer Arbeit aus deiner eigenen Codebasis, bevor du dich für breite Änderungen auf einen Kandidaten verlässt. Halte ein paar Aufgaben außerhalb des Prompt-Tunings, damit du prüfen kannst, ob Verbesserungen über die von dir optimierten Beispiele hinaus übertragen werden.
Die beste KI-API fürs Programmieren ist die Kombination, die du erklären kannst: Sie erledigt die erforderliche Arbeit, legt nachvollziehbare Kosten offen und passt zu der Art, wie deine Anwendung läuft. Kein universeller Sieger ist nötig, um diese Entscheidung zu treffen.
Öffne den aktuellen Modellkatalog, wähle zwei Kandidaten und speichere ihre exakten IDs und Einstellungen. Verwende dann für beide dieselbe Aufgabe, dieselben Tests und dieselbe Abbruchregel.
Häufig gestellte Fragen
Was ist die beste KI-API fürs Programmieren mit kleinem Budget?
Beginne mit einem Kandidaten, dessen angezeigte Raten zu deinem voraussichtlichen Eingabe- und Ausgabevolumen passen, und vergleiche dann die Kosten pro akzeptierter Aufgabe. Die Zeilen für Qwen, DeepSeek und Kimi bieten konkrete Versionen zum Untersuchen, ohne einen getesteten Wertgewinner zu behaupten. Begrenze Reparaturversuche, verwende relevanten Kontext bewusst wieder und verfolge fehlgeschlagene Anfragen. Beziehe Review-Zeit separat ein, damit eine niedrige Inferenzrechnung keine große Aufräumlast verbirgt.
Ist ein Coding-Abonnement günstiger als die Bezahlung von API-Token?
Das hängt von deiner Arbeitslast und davon ab, was der Tarif umfasst. Ein Abonnement kann für interaktive Nutzung innerhalb seiner unterstützten Anwendung geeignet sein, während nutzungsbasierte Abrechnung zu einem benutzerdefinierten Dienst mit variablem Verkehr passen kann. Prüfe Modellzugriff, Obergrenzen, Nebenläufigkeit und ob externe API-Aufrufe überhaupt enthalten sind. Vergleiche dieselbe Menge nützlicher Arbeit über einen repräsentativen Zeitraum; ein monatlicher Listenpreis und eine Token-Rate messen unterschiedliche Dinge.
Was ist der Unterschied zwischen einem Coding-Modell und einem Coding-Agent?
Das Modell generiert Antworten. Der Agent verwaltet die Schleife um diese Antworten, einschließlich Dateizugriff, Tool-Ausführung, Tests und Abbruchregeln. Du kannst ein Coding-Modell über eine API aufrufen, ohne einen Agent zu bauen, zum Beispiel um eine Funktion für menschliches Review vorzuschlagen. Wenn du autonome Änderungen willst, bewerte das Modell zusammen mit dem Agent und den Berechtigungen, die tatsächlich verwendet werden.
Welche KI-API sollte ich für Debugging und Refactoring verwenden?
Erstelle eine Auswahlliste mit Kandidaten, die zu deinen Endpunkt- und Code-Handling-Anforderungen passen, und verwende dann kleine Bugs und eingeschränkte Refactorings aus deiner Arbeit. Aufgabe A prüft Korrektheit und Eingabemutation; Aufgabe B prüft Parsing und Bewahrung der Schnittstelle. Lass darauf repräsentative Repository-Tests folgen.
Bevorzuge den Kandidaten, der deine Akzeptanzbedingungen mit überschaubarem Review-Aufwand erfüllt, statt einen, der einfach die längste Erklärung oder die umfangreichste Umschreibung liefert.
Gibt es eine kostenlose KI-API fürs Programmieren?
Ein Testguthaben, eine Anwendung mit kostenloser Stufe und herunterladbare Modellgewichte sind unterschiedliche Angebote. Keines gibt deiner Anwendung automatisch unbegrenzte gehostete Inferenz. Prüfe aktuelle Berechtigung, Ablauf, Kontingente und unterstützte Modelle, bevor du mit kostenlosem Zugang planst. Dieser Artikel behauptet kein derzeit verfügbares kostenloses Kontingent.
Wenn du Gewichte selbst hostest, rechne mit Compute- und Betriebskosten, auch wenn das Herunterladen der Gewichte nichts kostet.
Kann ich privaten Repository-Code an eine Coding-API senden?
Sende nur Code, den deine Organisation gemäß den geltenden Bedingungen des jeweiligen Dienstes teilen darf. Prüfe Aufbewahrung, Trainingsnutzung, Zugriffskontrollen und vertragliche Anforderungen für die gewählte Bereitstellung.
Entferne Zugangsdaten und unbezogene Dateien und prüfe, was dein Agent automatisch in Prompts und Logs aufnimmt. Ein offenes Gewichtsmodell oder ein vertrautes API-Format belegt für sich genommen nicht, dass ein gehosteter Dienst die Vertraulichkeitsanforderungen deines Teams erfüllt.


