Ihre Anfrage wird erfolgreich zurückgegeben. Die Anwendung hat immer noch kein verwendbares Bild. Vielleicht enthält die Antwort eine Aufgaben-ID, oder das fertige Bild enthält ein zusätzliches Objekt, das es für die Seite ungeeignet macht.
Eine generative KI-API für Entwickler ermöglicht es Ihrer Anwendung, Eingaben an ein Modell zu senden und generierte Inhalte zu empfangen. Wählen Sie eine aus, die auf Ihre erforderlichen Eingaben, das Ausgabeformat, die Wartezeit und die Akzeptanzkriterien abgestimmt ist. Erstellen Sie dann die Auftragsabwicklung und die Prüfungen, die eine Antwort in etwas verwandeln, das ein Benutzer nutzen kann.
Dieser Leitfaden folgt einem Bild-Workflow von der Auswahl bis zur Auslieferung. Sie erhalten eine Aufgabenauswahltabelle, passende JavaScript- und Python-Beispiele, 3 konkrete Bild-Briefings und ein Kostenarbeitsblatt. Der gleiche Entscheidungsprozess gilt für Text und Video, mit unterschiedlichen Protokollen und Ausgabeprüfungen.
Wichtige Erkenntnisse
- Wählen Sie die Aufgabe und die Akzeptanzkriterien vor dem Modell.
- Speichern Sie asynchrone Aufgaben-IDs, damit unterbrochene Arbeit fortgesetzt werden kann.
- Messen Sie die Kosten pro akzeptierter Ausgabe, einschließlich abgelehnter Generierungen.
- Testen Sie Dateien und geschäftliche Einschränkungen, bevor Sie ein fertiges Ergebnis anzeigen.
Generative KI-API für Entwickler: Was sie tut
Ein Modell führt die Generierung durch. Eine API definiert, wie Ihre Software diese Arbeit anfordert. Ein SDK verpackt die Schnittstelle in sprachspezifische Hilfsfunktionen. Eine gehostete Plattform betreibt den Zugang zu Modellen, während Ihre Anwendung die Benutzererfahrung, Berechtigungen und Regeln für die Akzeptanz des Ergebnisses bereitstellt.
Diese Unterscheidungen sind wichtig, wenn Sie eine Produktseite lesen. Eine Chat-Anwendung, die Bilder erstellt, belegt nicht, dass ihr Entwickler-Endpunkt dieselben Eingaben akzeptiert. Ein SDK mit einer praktischen Methode beseitigt nicht die Notwendigkeit, seine zugrunde liegende Antwort und Fehlerzustände zu verstehen.
Beginnen Sie mit der folgenden Aufgabenübersicht. Die Spalte Interaktion beschreibt ein Anwendungsdesign, das bewertet werden soll, und nicht ein Versprechen, dass jeder Anbieter diesen Modus unterstützt.
| Aufgabe | Eingabe | Erforderliche Fähigkeit | Ausgabe | Zu bewertende Interaktion | Akzeptanzkriterien |
|---|---|---|---|---|---|
| Support-Antwortentwurf | Ticket und genehmigte Hilfeinhalte | Fundierte Textgenerierung | Entwurfstext | Synchron oder Streaming | Beantwortet das Ticket; keine erfundenen Richtlinien |
| Dokumentfeld-Extraktion | Dokumenttext oder unterstützte Datei | Strukturierte Extraktion | JSON-Felder | Anfrage oder Warteschlangenauftrag | Gültiges Schema und Quellennachweis |
| Redaktionelle Illustration | Schriftliches visuelles Briefing | Text-zu-Bild | Bilddatei | Asynchroner Auftrag | Korrekte Objekte, Layout, Abmessungen |
| Bildbearbeitung | Quellbild und Anweisung | Bildkonditionierte Bearbeitung | Bearbeitetes Bild | Asynchroner Auftrag | Angeforderte Änderung; beibehaltene Details |
| Videogenerierung | Prompt oder unterstützte Referenz | Videogenerierung | Videodatei | Warteschlangenauftrag | Korrekte Dauer, Bewegung, Audio falls erforderlich |
| Retrieval-unterstützte Antwort | Frage und abgerufene Passagen | Retrieval plus Generierung | Antwort und Referenzen | Synchron oder Streaming | Behauptungen durch abgerufene Passagen gestützt |
Das Generieren eines Bildes, das Analysieren eines hochgeladenen Bildes und das Bearbeiten eines vorhandenen Bildes sind separate Fähigkeiten. Überprüfen Sie jede explizit. Ebenso kann ein Video-Endpunkt ein Startbild unterstützen, ohne beliebige Mehrbild-Referenzen zu unterstützen.
Embeddings wandeln Eingaben in Vektoren um, die für Retrieval und Ähnlichkeit nützlich sind. Sie können helfen, relevante Dokumente zu finden, bevor eine Antwort generiert wird. Sie erzeugen nicht selbst die Antwort und belegen nicht, dass abgerufene Inhalte ihre Behauptungen stützen.
Die praktische Grenze ist Eingabe → Anfrage → Ausgabe → Anwendungsakzeptanz. Sie besitzen die letzte Stufe. Ein generiertes Rechnungsfeld muss noch validiert werden; ein Bild muss noch inspiziert werden; eine Support-Antwort benötigt noch die Berechtigung, das darin enthaltene Versprechen zu machen.
Die Protokollauswahl variiert ebenfalls. Googles Referenz unterscheidet zwischen Standardgenerierung, Streaming und Live-Interaktion. Betrachten Sie dies als Beweis dafür, dass sich die Interaktionsmodi unterscheiden, und nehmen Sie nicht an, dass sie anderswo identisch unterstützt werden. (Google Gemini API-Referenz, abgerufen im September 2026.)
Generative KI-API für Entwickler: Wie man wählt
Schreiben Sie ein kleines Akzeptanz-Briefing, bevor Sie Kataloge vergleichen. Für eine redaktionelle Bildfunktion könnte dies Querformat-Ausgabe, eine begrenzte Objektanzahl, kein sichtbares Branding und einen menschlichen Prüfschritt festlegen. Für die Ticket-Klassifizierung könnte es einen festen Label-Satz und ein explizites unsicheres Ergebnis festlegen.
Bewerten Sie Kandidaten in dieser Reihenfolge:
- Eingaben und Ausgaben. Überprüfen Sie den genauen Modell-Endpunkt auf unterstützte Dateien, Eingabegrenzen, Ausgabeformate und Referenzbild-Verhalten. Ein Modellfamilienname ist zu breit, um als Vertrag zu dienen.
- Aufgabenerfüllung. Probieren Sie repräsentative Briefings aus, auch unangenehme. Zählen Sie Beschränkungsfehler getrennt von Datei- oder Netzwerkfehlern, damit Sie wissen, was behoben werden muss.
- Integrationspassung. Bestätigen Sie Authentifizierung, Antwortumschläge, Aufgabenstatuswerte und Client-Bibliotheksunterstützung. Berücksichtigen Sie den Arbeitsaufwand, diese an Ihr bestehendes Backend anzupassen.
- Wartezeit und Parallelität. Entscheiden Sie, ob Benutzer gehen und zurückkehren können. Testen Sie Ihre erwartete Arbeitslast, bevor Sie sich für eine interaktive Erfahrung mit kurzer Frist entscheiden.
- Abrechnungsklarheit. Identifizieren Sie die abrechenbare Einheit und welche Einstellungen sie ändern. Prüfen Sie die Behandlung von Fehlern und Rückerstattungen, anstatt anzunehmen, dass jede eingereichte Anfrage die gleiche Gebühr erhält.
- Datenanforderungen. Überprüfen Sie Eingabebehandlung, Aufbewahrung, Löschung und geltende Bedingungen anhand der tatsächlichen Daten, die Sie senden möchten. Dokumentieren Sie ungelöste Fragen, bevor Sie sensibles Material verwenden.
- Änderungsmanagement. Führen Sie ein Regressionsset und zeichnen Sie Modellkennungen, Prompts und Parameter auf. Planen Sie, wie Sie das Verhalten nach einer Aktualisierung oder einem Austausch neu bewerten.
Institutionelle Richtlinien veranschaulichen, warum Zugriffs- und Datenregeln zu dieser Entscheidung gehören: Harvard beschreibt genehmigte Zugriffswege und Einschränkungen für seine KI-Entwicklerwerkzeuge. Dies sind Harvards Vereinbarungen, keine universellen Berechtigungen für Ihre Anwendung. (Harvard University Information Technology, abgerufen im September 2026.)
| Zugriffsweg | Geeignetes Team | Integrationsaufwand | Betriebliche Verantwortung | Hauptbeschränkung | Vor der Auswahl zu prüfen |
|---|---|---|---|---|---|
| Direkter Modellanbieter | Team, das auf die Fähigkeiten eines Anbieters ausgerichtet ist | Anbieterspezifische API, Konten, Adapter | Ihre App und Aufträge; Anbieter-Inferenz | Zusätzliche Anbieter erfordern separate Verträge | Endpunktfunktionen, Regionen, Kontingente, Bedingungen |
| Gehostete Multi-Modell-Plattform | Team, das mehrere unterstützte Modelle bewertet | Gemeinsamer Zugang plus modellspezifische Validierung | Ihre App und Aufträge; plattformgehostete Inferenz | Gemeinsamer Zugang standardisiert nicht jeden Parameter | Genaue Modelle, Schemata, Abrechnung, Datenpfad |
| Selbst gehostetes offenes Modell | Team mit Infrastruktur- und Modellbereitstellungsfähigkeiten | Bereitstellen, Verfügbarmachen, Absichern und Warten der Inferenz | Hardware, Bereitstellung, Skalierung, Überwachung, Updates | Kapazität und Engineering-Overhead | Lizenz, Hardware-Eignung, Durchsatz, Wartung |
Atlas Cloud ist eine gehostete Option, die Sie in Betracht ziehen sollten, wenn mehrere Modellfunktionen in derselben Anwendung benötigt werden. Dieser Artikel verwendet seine Bild-Aufgaben-Schnittstelle als konkretes Beispiel. Sie müssen weiterhin die Ein- und Ausgaben jedes Modells validieren; allein das Ändern einer Modell-ID reicht nicht aus.
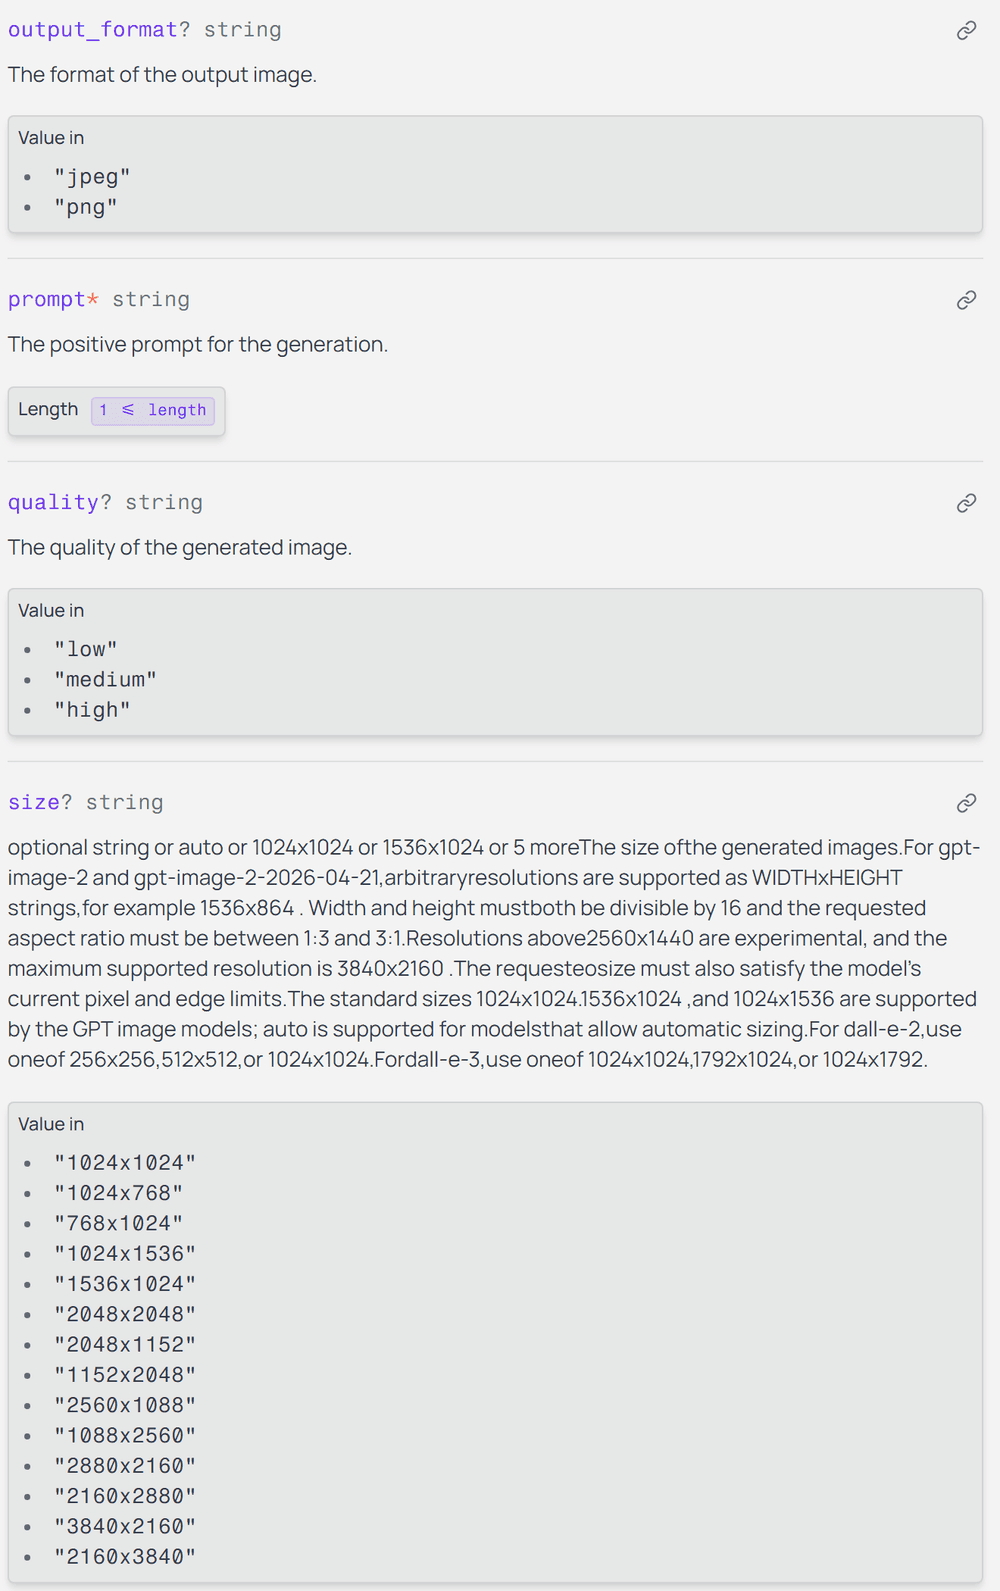
Offizielle Bild-Endpunktdokumentation mit Ausgabeformat, Qualität und Größenbeschränkungen
Modellspezifische Parameter sind Teil des Integrationsvertrags. Lesen Sie ihre zulässigen Werte, bevor Sie einen Anfragetext wiederverwenden.
Für ein kleines SaaS-Team ist der nützliche Vergleich der Gesamtaufwand, um ein akzeptiertes Ergebnis auszuliefern. Berücksichtigen Sie Adaptercode, Support-Untersuchung, Überprüfungszeit und Migrationstests neben der Inferenzgebühr. Dadurch wird verhindert, dass ein praktischer Prototyp einen teuren Produktionsworkflow verbirgt.
Generative KI-API für Entwickler: Erste Anfrage
Das Beispiel verwendet GPT Image 2 Text-to-Image, mit der Modell-ID openai/gpt-image-2/text-to-image. Die Endpunktdokumentation listet quality: high, size: 2048x1152 und output_format: png. Dies sind die angeforderten Einstellungen für die folgenden Beispiele.
1. Legen Sie den Prompt im Playground fest. Verwenden Sie das unten stehende Frühstücks-Briefing, ohne ein Referenzbild hinzuzufügen. Überprüfen Sie den Modellnamen und die festgelegten Einstellungen, bevor Sie auf Ausführen klicken. Eine Auswahl, die zurückspringt, wenn Sie ein Feld verlassen, ist nicht die von Ihnen angeforderte Einstellung.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Behalten Sie die Authentifizierung auf dem Server. Ihr Frontend sollte Ihr eigenes Backend bitten, einen Auftrag zu starten. Speichern Sie ATLAS_API_KEY in der Serverumgebung. Fügen Sie ihn niemals in Browser-JavaScript, Bild-URLs oder clientseitig sichtbare Protokolle ein. Setzen Sie ATLAS_API_HOST auf api.atlascloud.ai; dies ist ein Hostname, ohne Schema oder Pfad.
3. Reichen Sie einmal ein und speichern Sie die ID. Die dokumentierte Generierungsroute ist POST /api/v1/model/generateImage. Lesen Sie data.id und speichern Sie sie für den Auftrag Ihrer Anwendung. Wenn die Einreichungsantwort verloren geht, untersuchen Sie den Fall, bevor Sie eine weitere potenziell abrechenbare Aufgabe erstellen.
4. Fragen Sie den gespeicherten Auftrag ab. Fragen Sie GET /api/v1/model/prediction/{prediction_id} ab. Die Vorhersagedokumentation beschreibt processing, completed und failed, mit Ausgabe-URLs in data.outputs. Ein abgeschlossener Status sollte dennoch auf ein nicht leeres Ausgabe-Array überprüft werden.
5. Herunterladen und validieren. Speichern Sie die Datei unter Ihrer Kontrolle, überprüfen Sie, ob sie dekodiert werden kann, und prüfen Sie sie anhand des Briefings. Erst dann geben Sie ein akzeptiertes Ergebnis an die Anwendung zurück. Ein Download- oder Validierungsfehler sollte dem vorhandenen Auftrag zugeordnet bleiben.
Der folgende Code wurde aus der offiziellen Schnittstellendokumentation zusammengestellt. Er wird nicht als Live-API-Benchmark präsentiert. Der Medien-Workflow des Artikels verwendet den Browser-Test-Playground, nicht einen API-Schlüssel.
Speichern Sie den genauen Frühstücks-Prompt als prompt.txt. Verwenden Sie für Node.js eine Umgebung mit integriertem fetch, installieren Sie sharp und speichern Sie dies als generate.mjs. Führen Sie es in einem dedizierten Arbeitsverzeichnis aus. Führen Sie nur eines der beiden Sprachbeispiele aus, es sei denn, Sie möchten absichtlich zwei Aufträge.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
The shorter Python equivalent uses requests and Pillow, the same prompt.txt, and identical settings. It also accepts PREDICTION_ID for resuming. These scripts demonstrate one local job; a deployed service needs persistent job records and bounded downloads.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
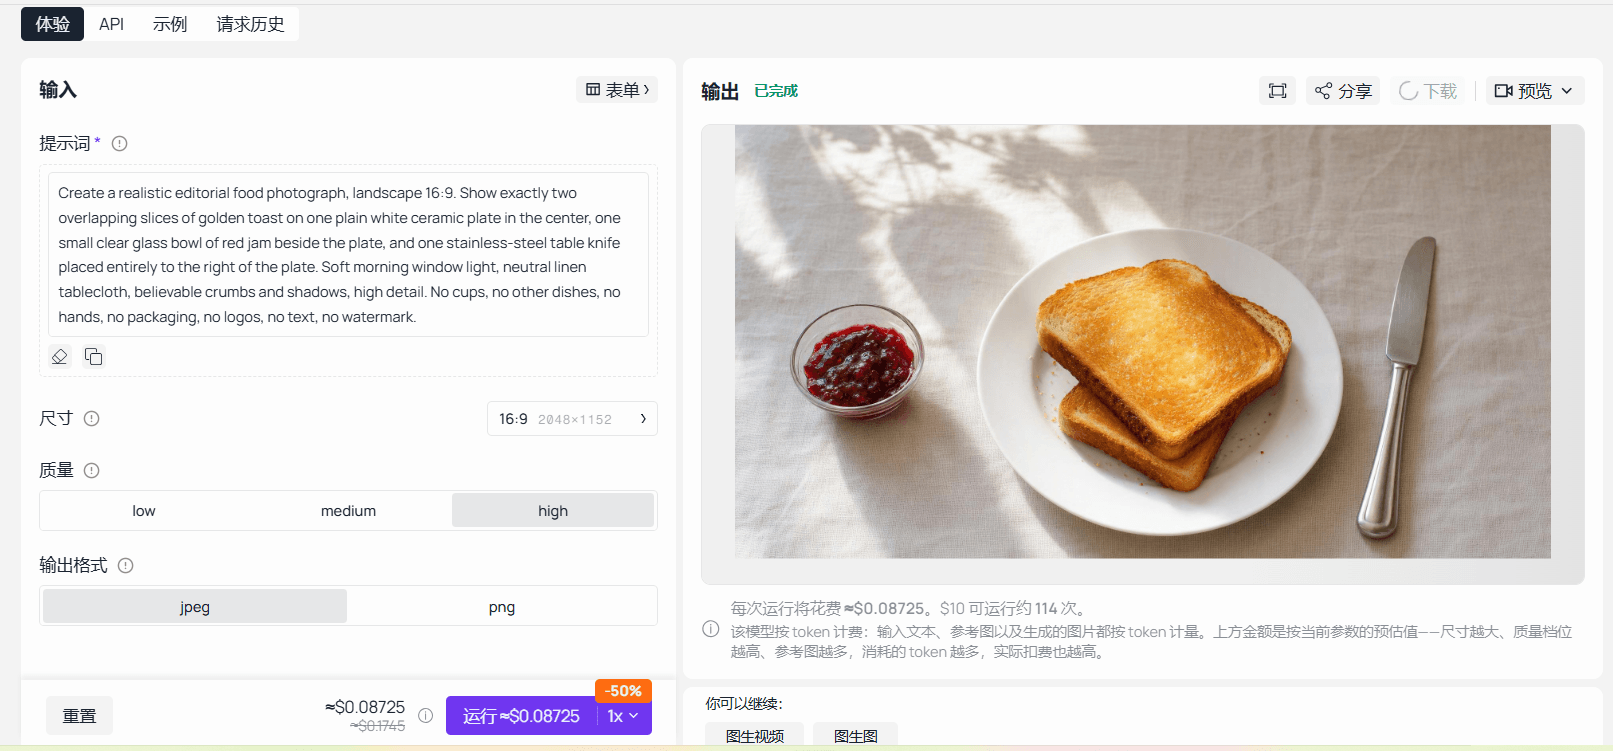 Abgeschlossener GPT Image 2 Playground mit dem eingereichten Frühstücks-Prompt und der fertigen Ausgabe
Ein abgeschlossener Playground-Lauf zeichnet den eingereichten Prompt, die Ausgabegröße, die Qualitätseinstellung und das generierte Ergebnis zusammen auf.
Eine Polling-Frist stoppt diesen Client am Warten; sie bricht keine serverseitige Arbeit ab. Eine bereits laufende Anfrage kann nach dem Polling-Fenster abgeschlossen werden, daher ist dies keine strikte End-to-End-Latenzgarantie. Bewahren Sie die ID auf und ermöglichen Sie einem Worker, sie später zu überprüfen.
Generative KI-API für Entwickler: Praktische Anwendungen
Die 3 folgenden Briefings testen unterschiedliche Anforderungen. Sie sind unabhängige Anfragen, keine Kette, bei der ein Ergebnis zur nächsten Eingabe wird. Behalten Sie dasselbe Modell und dieselben angeforderten Einstellungen bei, damit die Unterschiede in den Briefings leicht verständlich bleiben.
A. Redaktionelles Lebensmittelbild: Anzahl und Platzierung. Der Frühstücks-Prompt testet, ob die Ausgabe 2 Toast-Scheiben, 1 Teller, 1 Marmeladenschale und 1 Messer enthält. Das Messer muss rechts vom Teller liegen, und alle erforderlichen Objekte müssen innerhalb des Rahmens bleiben.
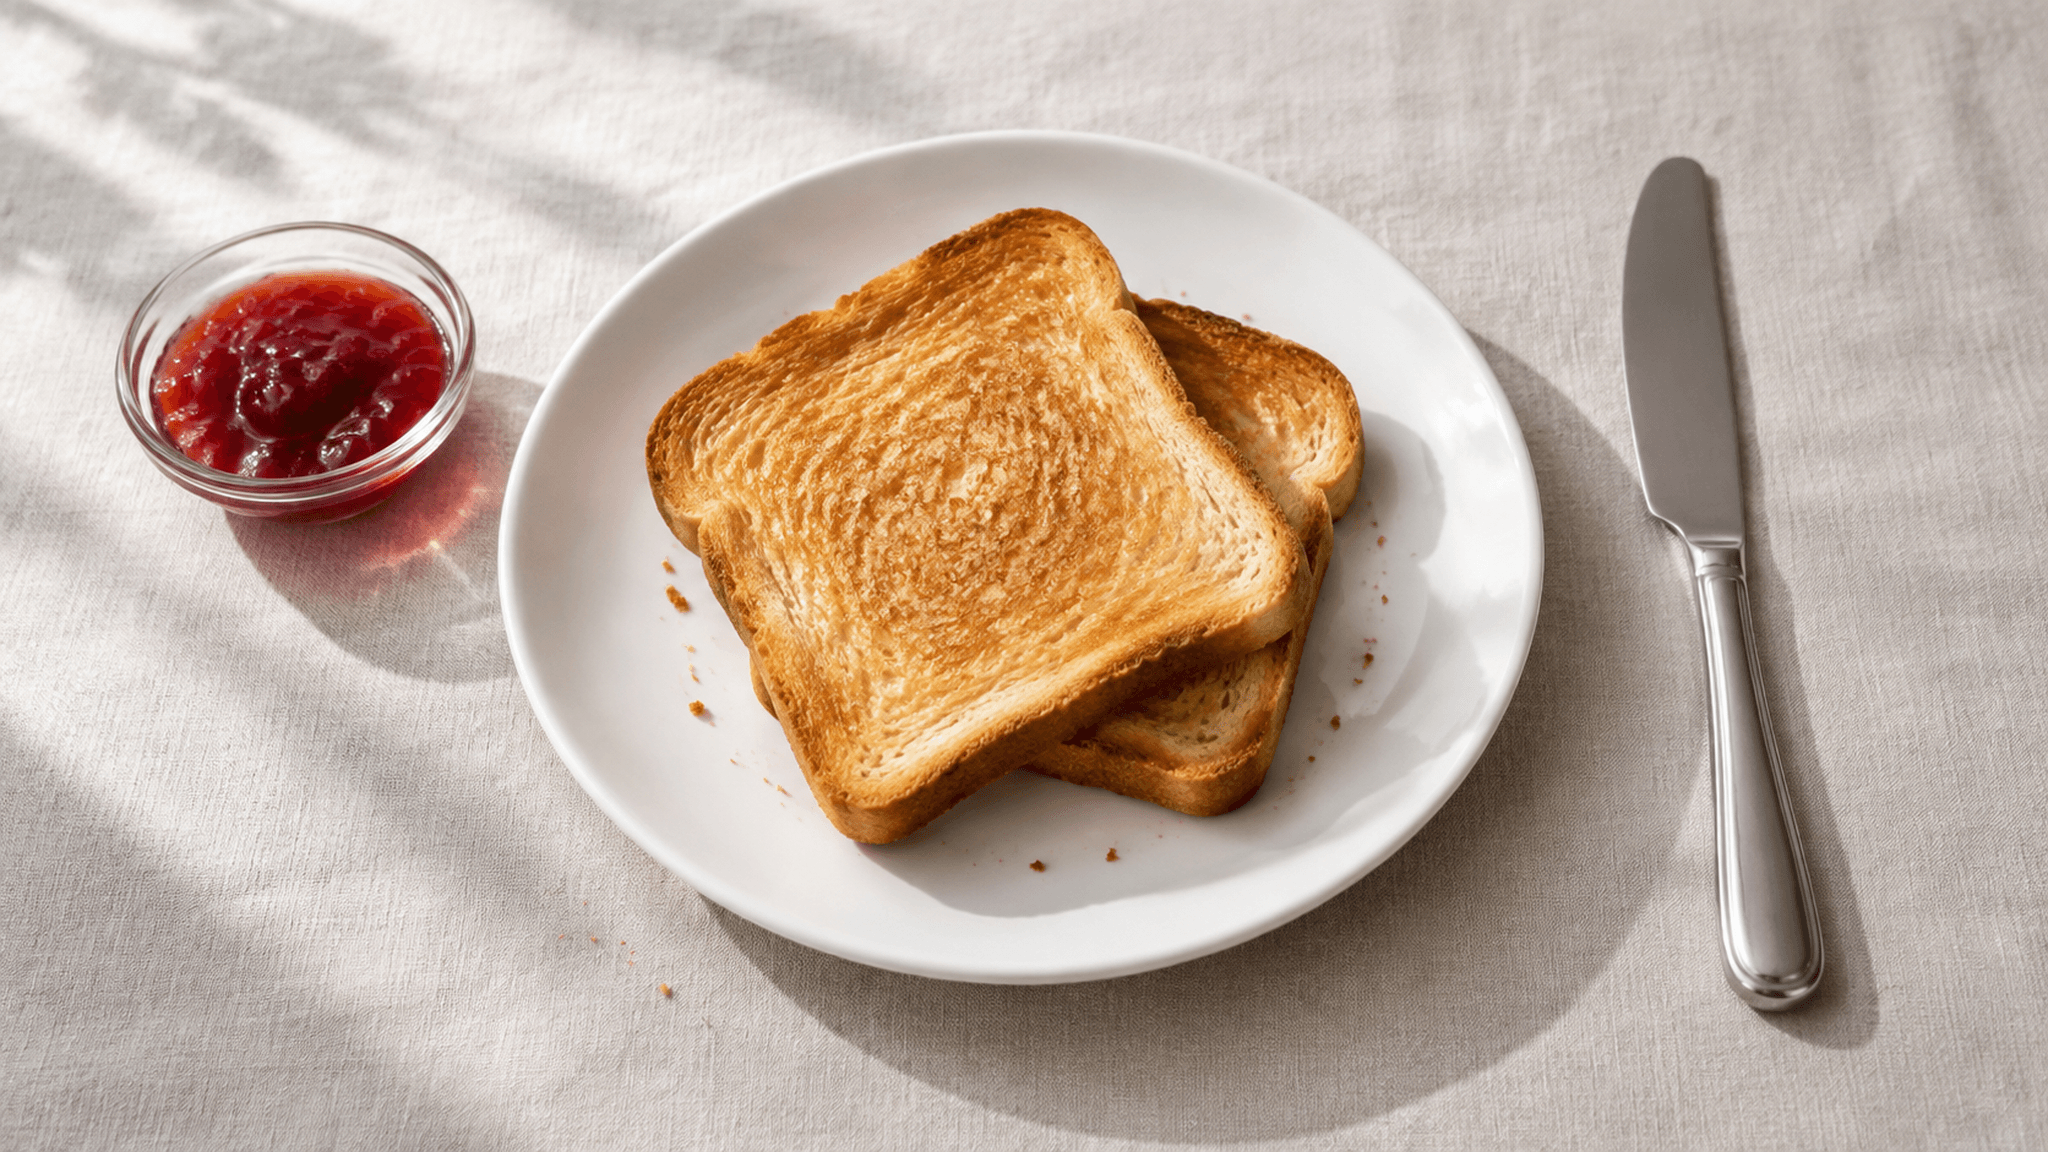
Beispiel für die Generierung eines Frühstücksbildes zusammen mit Objektanzahl- und MesserplatzierungsprüfungsThe generierte Ergebnis enthält den angeforderten Teller, Toast, Marmeladenschale und das Messer auf der rechten Seite, bereit für die Platzierungsüberprüfung unten.
Überprüfen Sie überlappende Scheiben einzeln. Ein visuell überzeugendes Frühstück kann immer noch fehlschlagen, wenn eine Tasse im Hintergrund erscheint oder das Messer auf den Teller wandert. Wenn ein Ergebnis fehlschlägt, überarbeiten Sie die mehrdeutige räumliche Anweisung, ändern Sie eine Variable und behalten Sie den Ablehnungsgrund bei. Vermeiden Sie es, wiederholt um ein allgemein besseres Bild zu bitten.
B. Artikelcover: nutzbarer Platz für Überschrift. Diese Anfrage behandelt die Komposition als Layout-Abhängigkeit. Der Seiteneditor benötigt leeren Platz auf der linken Seite, während die rechte Seite die Werkzeuge und den Topf trägt. Fügen Sie den tatsächlichen Titel später mit HTML/CSS hinzu, damit er editierbar und lesbar bleibt.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
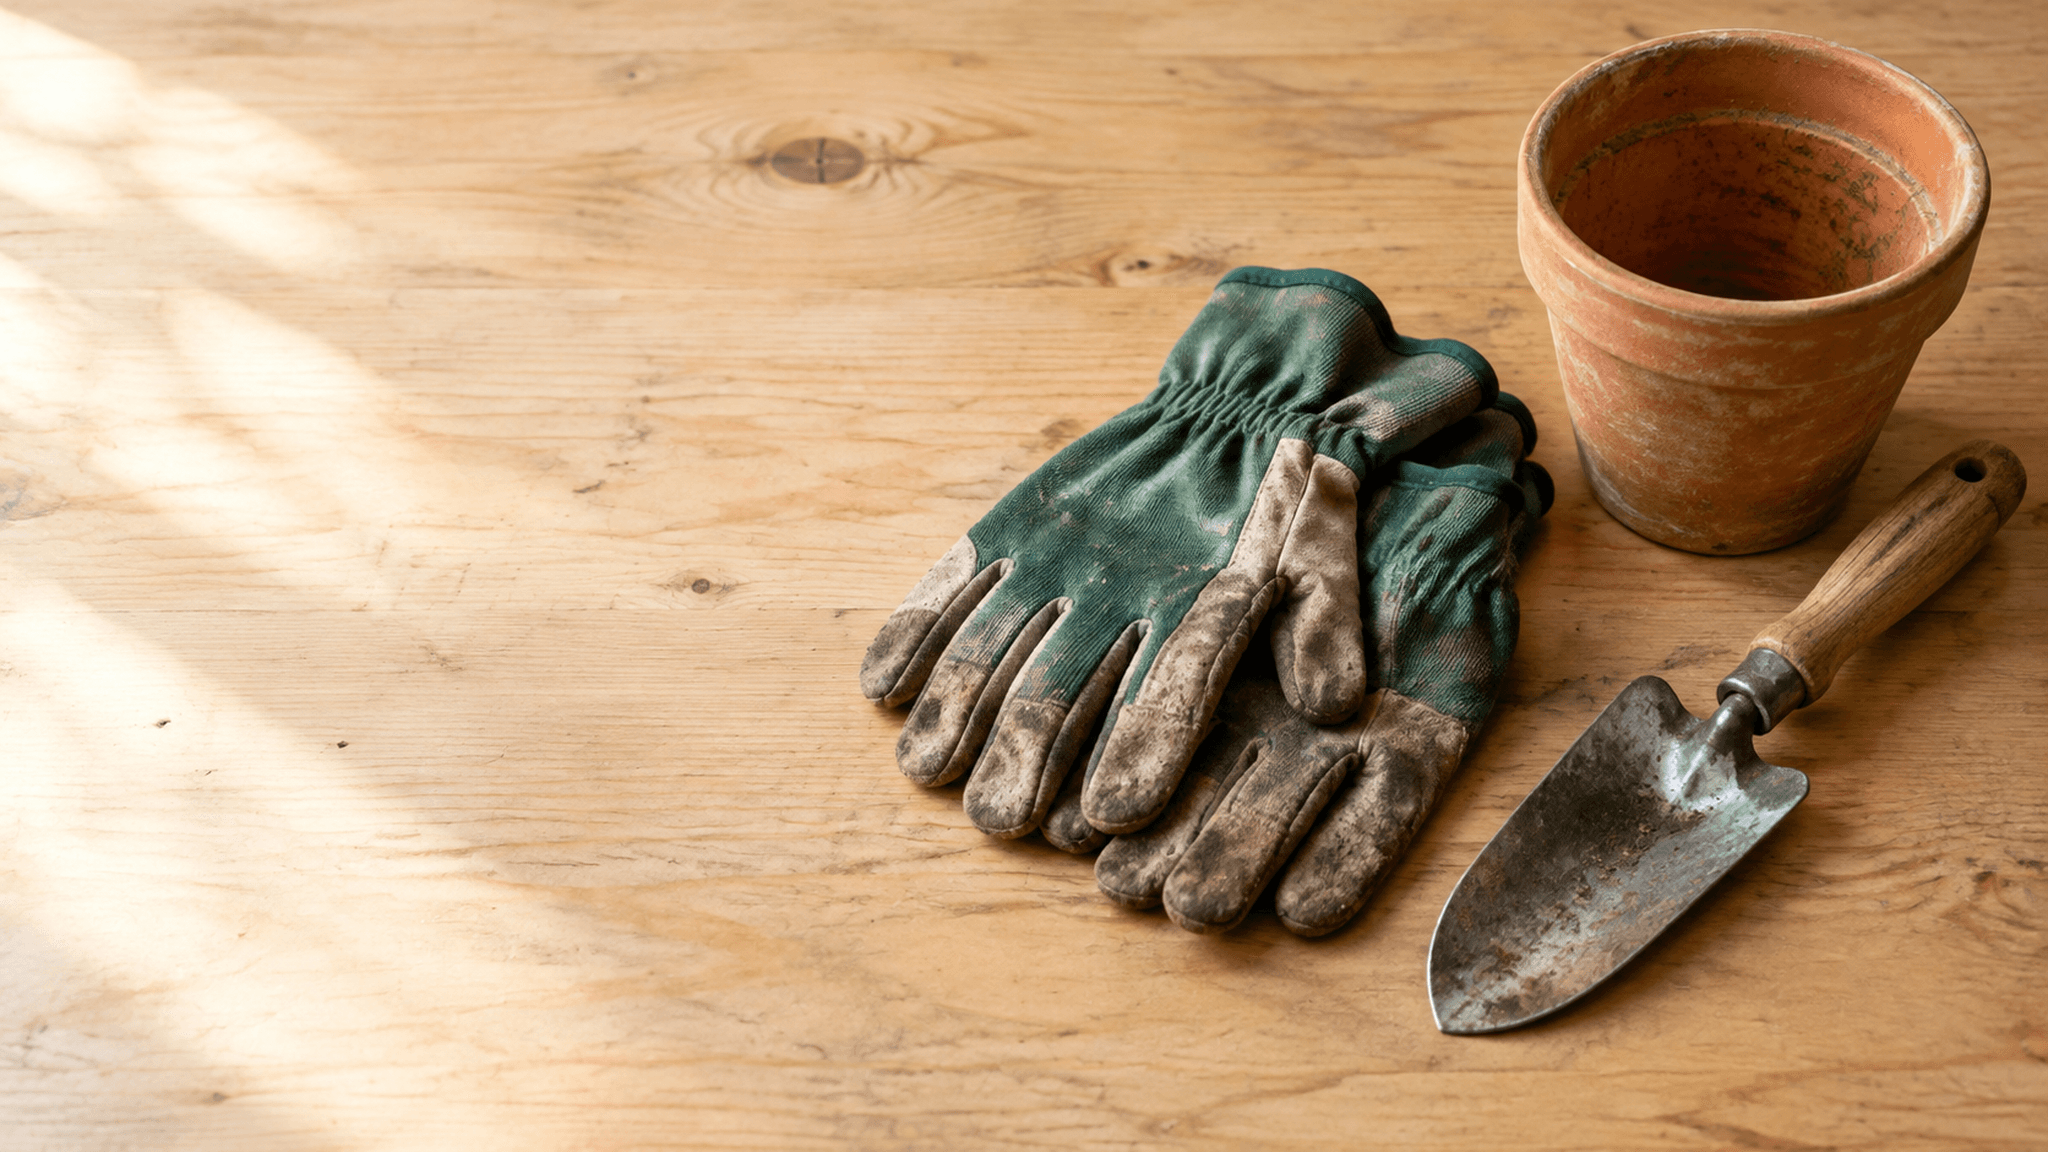 Beispiel für ein Workbench-Cover mit angefordertem Platz für die Überschrift auf der linken Seite und Objekten auf der rechten Seite
Das Ergebnis bewahrt nutzbaren leeren Raum auf der linken Seite, während Handschuhe, Topf und Kelle auf der rechten Seite bleiben.
Überprüfen Sie das Ergebnis beim beabsichtigten Veröffentlichungsausschnitt. Ein Querformat-Master kann seinen nützlichen leeren Bereich verlieren, wenn eine mobile Karte mittig zuschneidet. Wenn die Komposition fehlschlägt, geben Sie engere Objektgrenzen an oder ändern Sie den Anwendungsausschnitt. Verbergen Sie den Fehler nicht, indem Sie Text über die angeforderten Motive legen.
C. Stoffillustration: Detail und Reihenfolge. Die nächste Anfrage verlangt 3 gefaltete Stoffmuster mit unterscheidbaren sichtbaren Texturen. Sie testet Anzahl, Position und ob das Ergebnis eine erklärende Illustration in der Größe unterstützt, in der Leser sie sehen.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
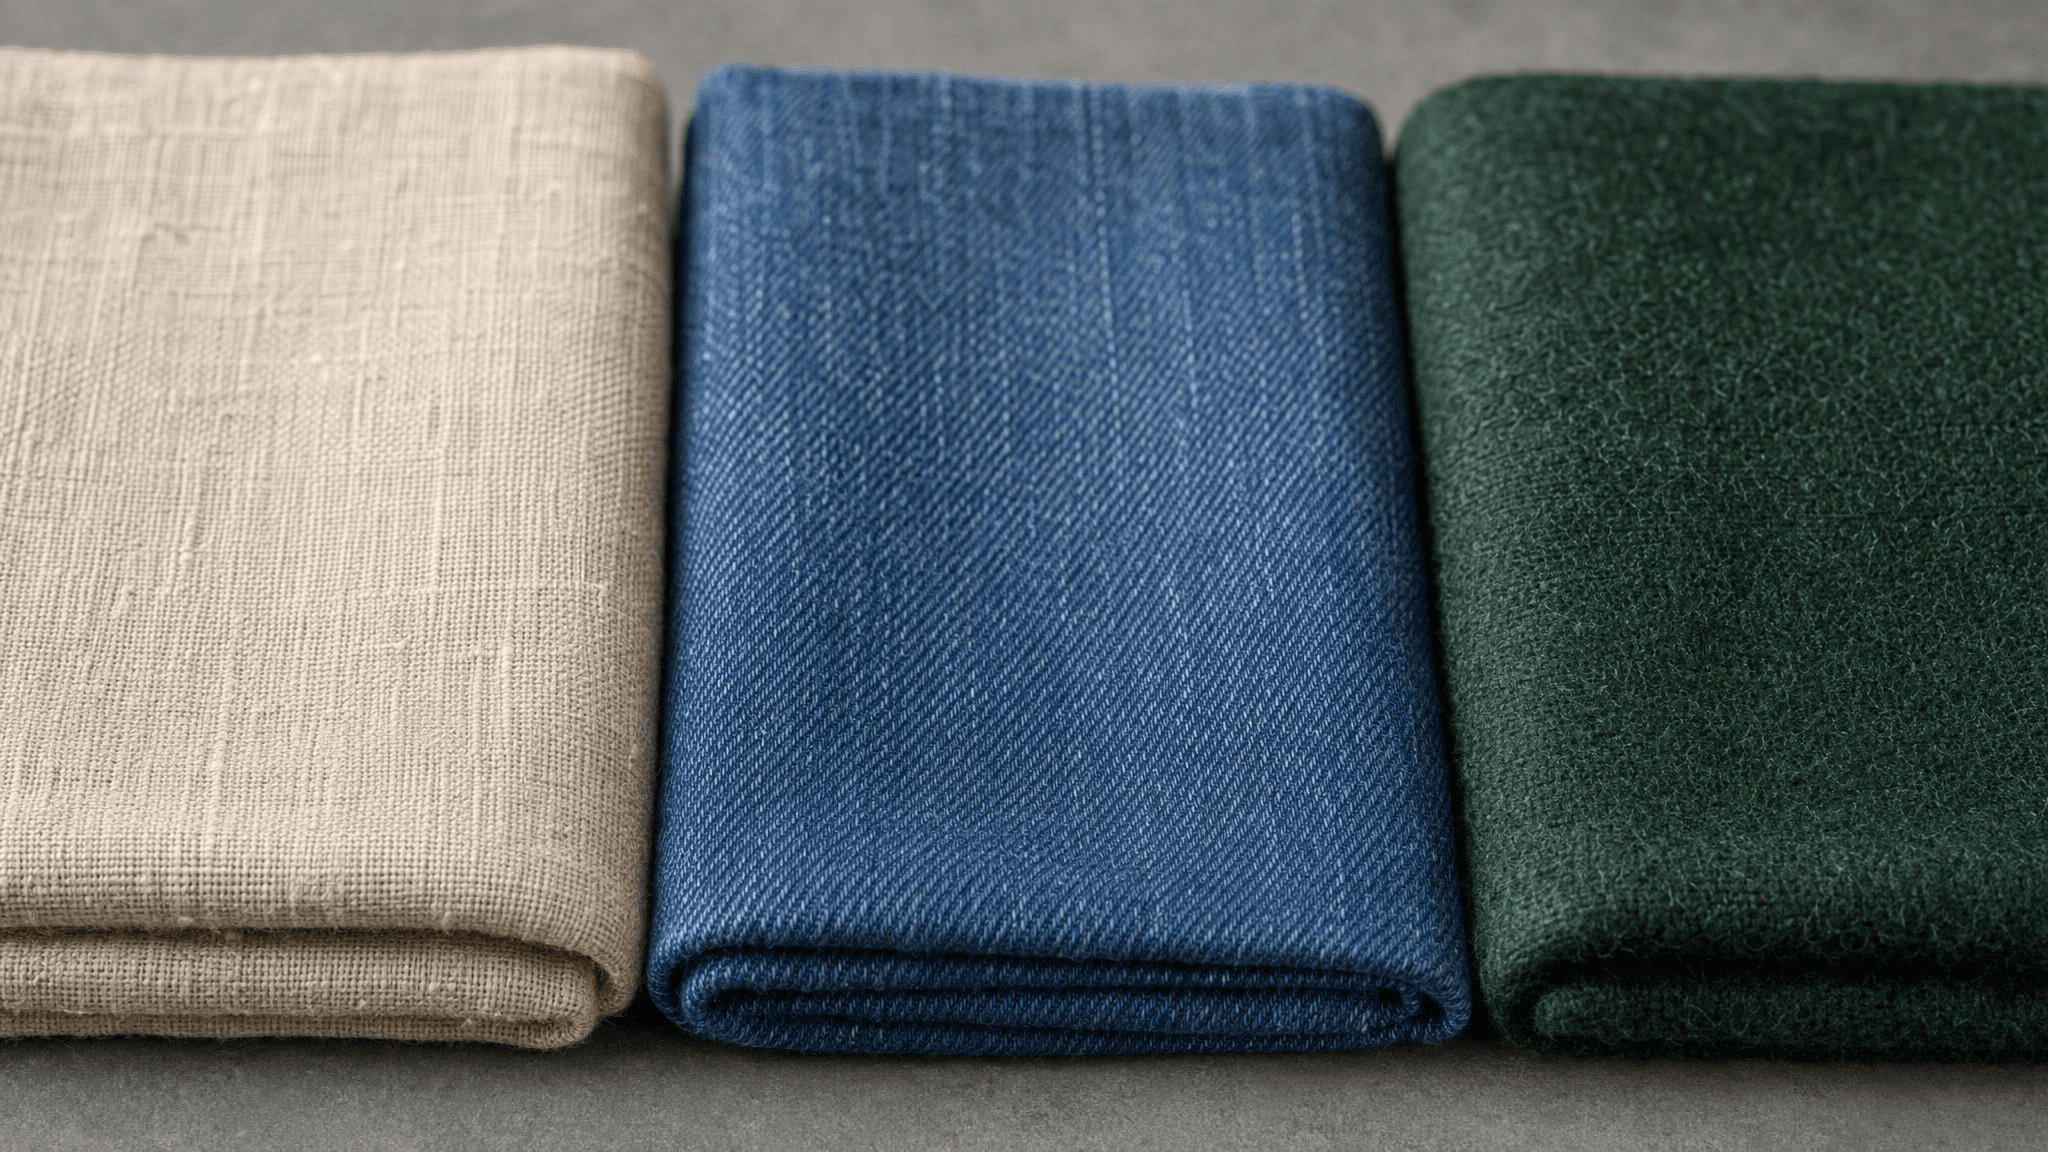 KI-generierte Stoffillustration mit Platzierungsprüfungen für beige, blaue und dunkelgrüne Muster
Die drei angeforderten Muster sind visuell unterscheidbar. Diese generierte Textur ist eine Illustration, kein Beweis für die Faserzusammensetzung eines realen Produkts.
Wenn das mittlere Muster keine lesbare Webstruktur aufweist, notieren Sie dieses Problem und passen Sie den Bildausschnitt oder die Detailanweisung an. Beschreiben Sie generierte Textur niemals als gemessene Eigenschaft eines realen Produkts.
Textfunktionen benötigen ähnlich enge Prüfungen. Lehnen Sie bei der Ticket-Klassifizierung Labels außerhalb des zulässigen Satzes ab und behalten Sie einen unsicheren Pfad bei. Verlangen Sie bei der Dokumentextraktion Felder und Quellbereiche zusammen mit parsebarem JSON. Eine syntaktisch gültige Antwort kann immer noch den falschen Betrag in das falsche Feld setzen.
Generative KI-API für Entwickler: Fehler behandeln
Verfolgen Sie Transport-Erfolg, Aufgabenabschluss und geschäftliche Akzeptanz getrennt. Eine erfolgreiche HTTP-Antwort kann eine laufende Aufgabe enthalten. Eine abgeschlossene Aufgabe kann einen fehlerhaften Download erzeugen. Ein lesbares Bild kann gegen das Briefing verstoßen. Jeder Fall erfordert eine andere Wiederherstellungsaktion.
Legen Sie 3 Zeitgeber bewusst fest: einen individuellen HTTP-Timeout, ein Polling-Intervall und ein gesamtes Wartefenster. Die Beispiele verwenden einen 30-sekündigen API-Anfrage-Timeout, 2-sekündiges Polling und ein 10-minütiges Polling-Fenster. Dies sind Anwendungsentscheidungen, keine beworbene Serviceleistung.
| Symptom | Mögliche Ursache | Als Nächstes prüfen | Wiederholungsansatz |
|---|---|---|---|
| Parameterfehler | Nicht unterstütztes Feld oder Wert | Genaues Endpunkt-Schema und gesendete Nutzlast | Zuerst die Anfrage korrigieren |
| HTTP 401 | Authentifizierungsproblem oder falsche Route | Schlüsselkonfiguration und Endpunktpfad | Keine unveränderte Wiederholung |
| Unzureichendes Guthaben | Verfügbares Guthaben oder Kontingent | Abrechnungsstatus des Kontos | Zuerst Finanzierung oder Kontingent klären |
| HTTP 429 | Ratenlimit erreicht | Konto-/Modell-Parallelität und Anfragerate | Begrenzter Backoff mit Jitter |
| Aufgabe meldet Fehlschlag | Modell-, Eingabe- oder Richtlinienfehler | Vorhersage-ID, Fehlercode, Fehlerdetail | Vor neuer Generierung untersuchen |
| Polling-Timeout | Client-Frist oder langsame Aufgabe | Vorhandener Aufgabenstatus | Abfrage derselben ID fortsetzen |
| Abgeschlossen mit leerer Ausgabe | Fehlendes oder unerwartetes Ergebnis | Vollständige strukturierte Auftragsantwort | Zur Untersuchung markieren; kein blindes erneutes Einreichen |
Die aktuelle Fehlerdokumentation der Plattform besagt, dass LLM- und Medien-Endpunkte keine Retry-After- oder verbleibenden Ratenlimit-Header bereitstellen. Verwenden Sie eine clientseitige Verzögerungsrichtlinie; machen Sie die Wiederherstellung nicht von einem Header abhängig, den diese Routen nicht zurückgeben. Andere API-Familien können sich anders verhalten.
Halten Sie automatische Lese-Wiederholungen begrenzt. Exponentielle Verzögerungen plus etwas zufälliger Jitter helfen zu verhindern, dass viele Worker gleichzeitig wiederholen. Reduzieren Sie die Parallelität, wenn die Drosselung anhält. Wiederholte Fehler sollten zu einem beobachtbaren Vorfall werden und nicht zu einer endlosen Schleife, die hinter einem Spinner verborgen ist.
Wiederholungen bei der Einreichung verdienen eine strengere Behandlung. Wenn eine Verbindung geschlossen wird, nachdem Sie den Body gesendet haben, wissen Sie möglicherweise nicht, ob der Server eine Aufgabe erstellt hat. Zeichnen Sie eine lokale Absicht vor der Einreichung auf und untersuchen Sie den Anforderungsverlauf oder Support-Traces, wenn keine Vorhersage-ID eintrifft. Erfinden Sie keinen Idempotenz-Header, es sei denn, der Endpunkt dokumentiert ihn.
Nachdem Sie eine ID haben, verwenden Sie sie zum Fortsetzen. Ein Download-Fehler sollte einen weiteren Download-Versuch oder eine Statusprüfung auslösen, nicht eine weitere Bilderzeugungsanfrage. Die Beispiele behalten absichtlich das automatische Wiederholungsverhalten bei Polling-Lesevorgängen bei und stoppen bei einer fehlgeschlagenen Einreichung.
Behalten Sie für jeden Auftrag Ihre Anwendungsauftrags-ID, Vorhersage-ID, Anforderungs-IDs, Modell, Einstellungen, Zeitstempel und endgültige Disposition bei. Speichern Sie Prompts nur gemäß einer geeigneten Datenrichtlinie. Fügen Sie niemals Autorisierungsheader oder sensible Benutzerinhalte in allgemeine Fehlerprotokolle ein.
Geben Sie dem Frontend Zustände, die es erklären kann: Vorbereitung, Verarbeitung, Ausgabe prüfen, bereit oder Aufmerksamkeit erforderlich. Zeigen Sie einen wiederherstellbaren Auftrag an, wenn jemand die Seite neu lädt. Deaktivieren Sie wiederholte Einreichungen, solange derselbe lokale Auftrag aussteht, erlauben Sie aber dennoch eine absichtliche neue Anfrage, wenn dies angemessen ist.
Generative KI-API für Entwickler: Reale Kosten
Ein niedriger Anfragepreis sagt nichts über die Kosten einer nutzbaren Funktion aus. Ihr Budget benötigt den berechneten Betrag, die Anzahl der akzeptierten Ausgaben und die unterstützende Arbeit, die für deren Bereitstellung erforderlich ist.
Text-APIs unterscheiden üblicherweise zwischen Eingabe- und Ausgabe-Tokens. Langer Kontext, abgerufene Passagen, Gesprächsverlauf und wiederholte Antworten können alle zur Nutzung beitragen. Zeichnen Sie die Kategorien auf, die der gewählte Endpunkt tatsächlich abrechnet, anstatt eine einzelne Token-Schätzung auf jede Arbeitslast anzuwenden.
Untersuchen Sie für Bilder die Abrechnungseinheit und Konfiguration des genauen Modells. Größe und Qualität können die Abrechnung je nach Modell unterschiedlich beeinflussen. Bei Videos können Dauer, Auflösung und Modellwahl die Gebühr ändern. Machen Sie aus dem Startpreis eines Katalogs kein Angebot für eine bestimmte Konfiguration.
Der genaue Preis des ausgewählten Bildmodells für hohe Qualität, 2048 × 1152, wurde während der Recherche für diesen Artikel nicht sowohl im Katalog als auch auf der Detailseite überprüft. Es wird hier kein aktueller Stückpreis oder Rabatt zugesichert. Bestätigen Sie ihn, bevor Sie eine kostenpflichtige Produktionsbewertung durchführen.
Verwenden Sie 2 verwandte Berechnungen:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Halten Sie den Beobachtungszeitraum konsistent. Geben Sie bei fortlaufender Speicherung an, ob die Berechnung den ersten Monat, einen definierten Aufbewahrungszeitraum oder eine zugewiesene wiederkehrende Kosten abdeckt. Vermeiden Sie den Vergleich der reinen Inferenzzahl eines Modells mit den vollständig belasteten Kosten eines anderen Workflows.
Hypothetisches Beispiel: Sie reichen 100 Anfragen ein und akzeptieren 80 Ausgaben. Teilen Sie die tatsächliche Gesamtgebühr für diesen Stapel durch 80. Wenn für alle 100 Anfragen ein identischer Betrag c berechnet würde, wären die API-Kosten pro akzeptierter Ausgabe 1,25c. Diese Bedingung ist wichtig: Sie geht nicht davon aus, dass jede fehlgeschlagene Anfrage berechnet wird.
| Modell | Einstellungen | Einreichungen | Tatsächliche Gebühr | Akzeptierte Ausgaben | API-Kosten pro akzeptierter Ausgabe | Messdatum |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | Zu erfassen | Zu erfassen | Zu erfassen | Zu berechnen | Zu erfassen |
| Dasselbe Modell, nächste Bewertungscharge | Genaue Einstellungen erfassen | Zu erfassen | Zu erfassen | Zu erfassen | Zu berechnen | Zu erfassen |
Verwenden Sie dies als Arbeitsblatt, nicht als Ergebnistabelle. Die Bilddemonstrationen belegen keine repräsentative Akzeptanzrate oder Produktionskosten. Halten Sie Playground-Angebote getrennt von abgerechneten Abrechnungsdatensätzen, insbesondere bei der Bewertung in einer Testumgebung.
Wenn die akzeptierten Ausgaben gleich null sind, melden Sie den Stapel als erfolglos und zeigen Sie die Gesamtausgaben an. Ein Kosten-pro-akzeptierter-Ausgabe-Verhältnis ist in diesem Fall undefiniert. Das Verbergen fehlgeschlagener Stapel würde Ihr Budget besser aussehen lassen, als die Anwendung sich verhält.
Reduzieren Sie zuerst Verschwendung: Validieren Sie Eingaben vor der Einreichung, speichern Sie Auftrags-IDs, verhindern Sie versehentliche Duplikate und verwenden Sie akzeptierte Assets wieder, wenn das Produkt dies zulässt. Vergleichen Sie dann günstigere Einstellungen anhand derselben Briefings und Prüfungen. Eine Einstellung, die das Angebot reduziert, aber die Ablehnungsarbeit verdoppelt, kann die Funktionskosten erhöhen.
Testen Sie die Ausgabe, nicht nur die Antwort
Schreiben Sie Akzeptanzkriterien, während Sie den Prompt entwerfen. Dies verhindert, dass ein überzeugendes Bild Ihre Definition von Erfolg im Nachhinein ändert. Trennen Sie harte Anforderungen von optionalen Präferenzen und zeichnen Sie auf, warum ein Prüfer ein Ergebnis abgelehnt hat.
Automatisieren Sie die Prüfungen mit klaren mechanischen Antworten: Download-Erfolg, Dateidekodierung, Format, Abmessungen und Dateigrößenbeschränkungen. Validieren Sie für JSON das Schema, erforderliche Felder, zulässige Labels und Typen. Ein fehlendes erforderliches Feld sollte nicht stillschweigend zu einem erfundenen Standardwert werden.
Verwenden Sie menschliche Überprüfung für Anforderungen, die Interpretation erfordern. Im Frühstücksbeispiel muss ein Prüfer überlappende Scheiben unterscheiden, das Messer identifizieren, seine Position beurteilen und nach zusätzlichen Objekten suchen. Ein automatisierter Vision-Prüfer kann unterstützen, aber bewerten Sie seine Fehler, bevor Sie ihn Ergebnisse allein genehmigen lassen.
Die Frühstücksüberprüfung sollte die folgenden unabhängigen Prüfungen umfassen:
- Genau 2 Toast-Scheiben, 1 weißer Teller, 1 klare Marmeladenschale und 1 Messer.
- Messer rechts vom Teller; erforderliche Objekte vollständig im Bild.
- Keine zusätzlichen Tassen, Teller, Hände, Verpackungen oder sichtbares Branding.
- Lesbares PNG in den angeforderten Abmessungen.
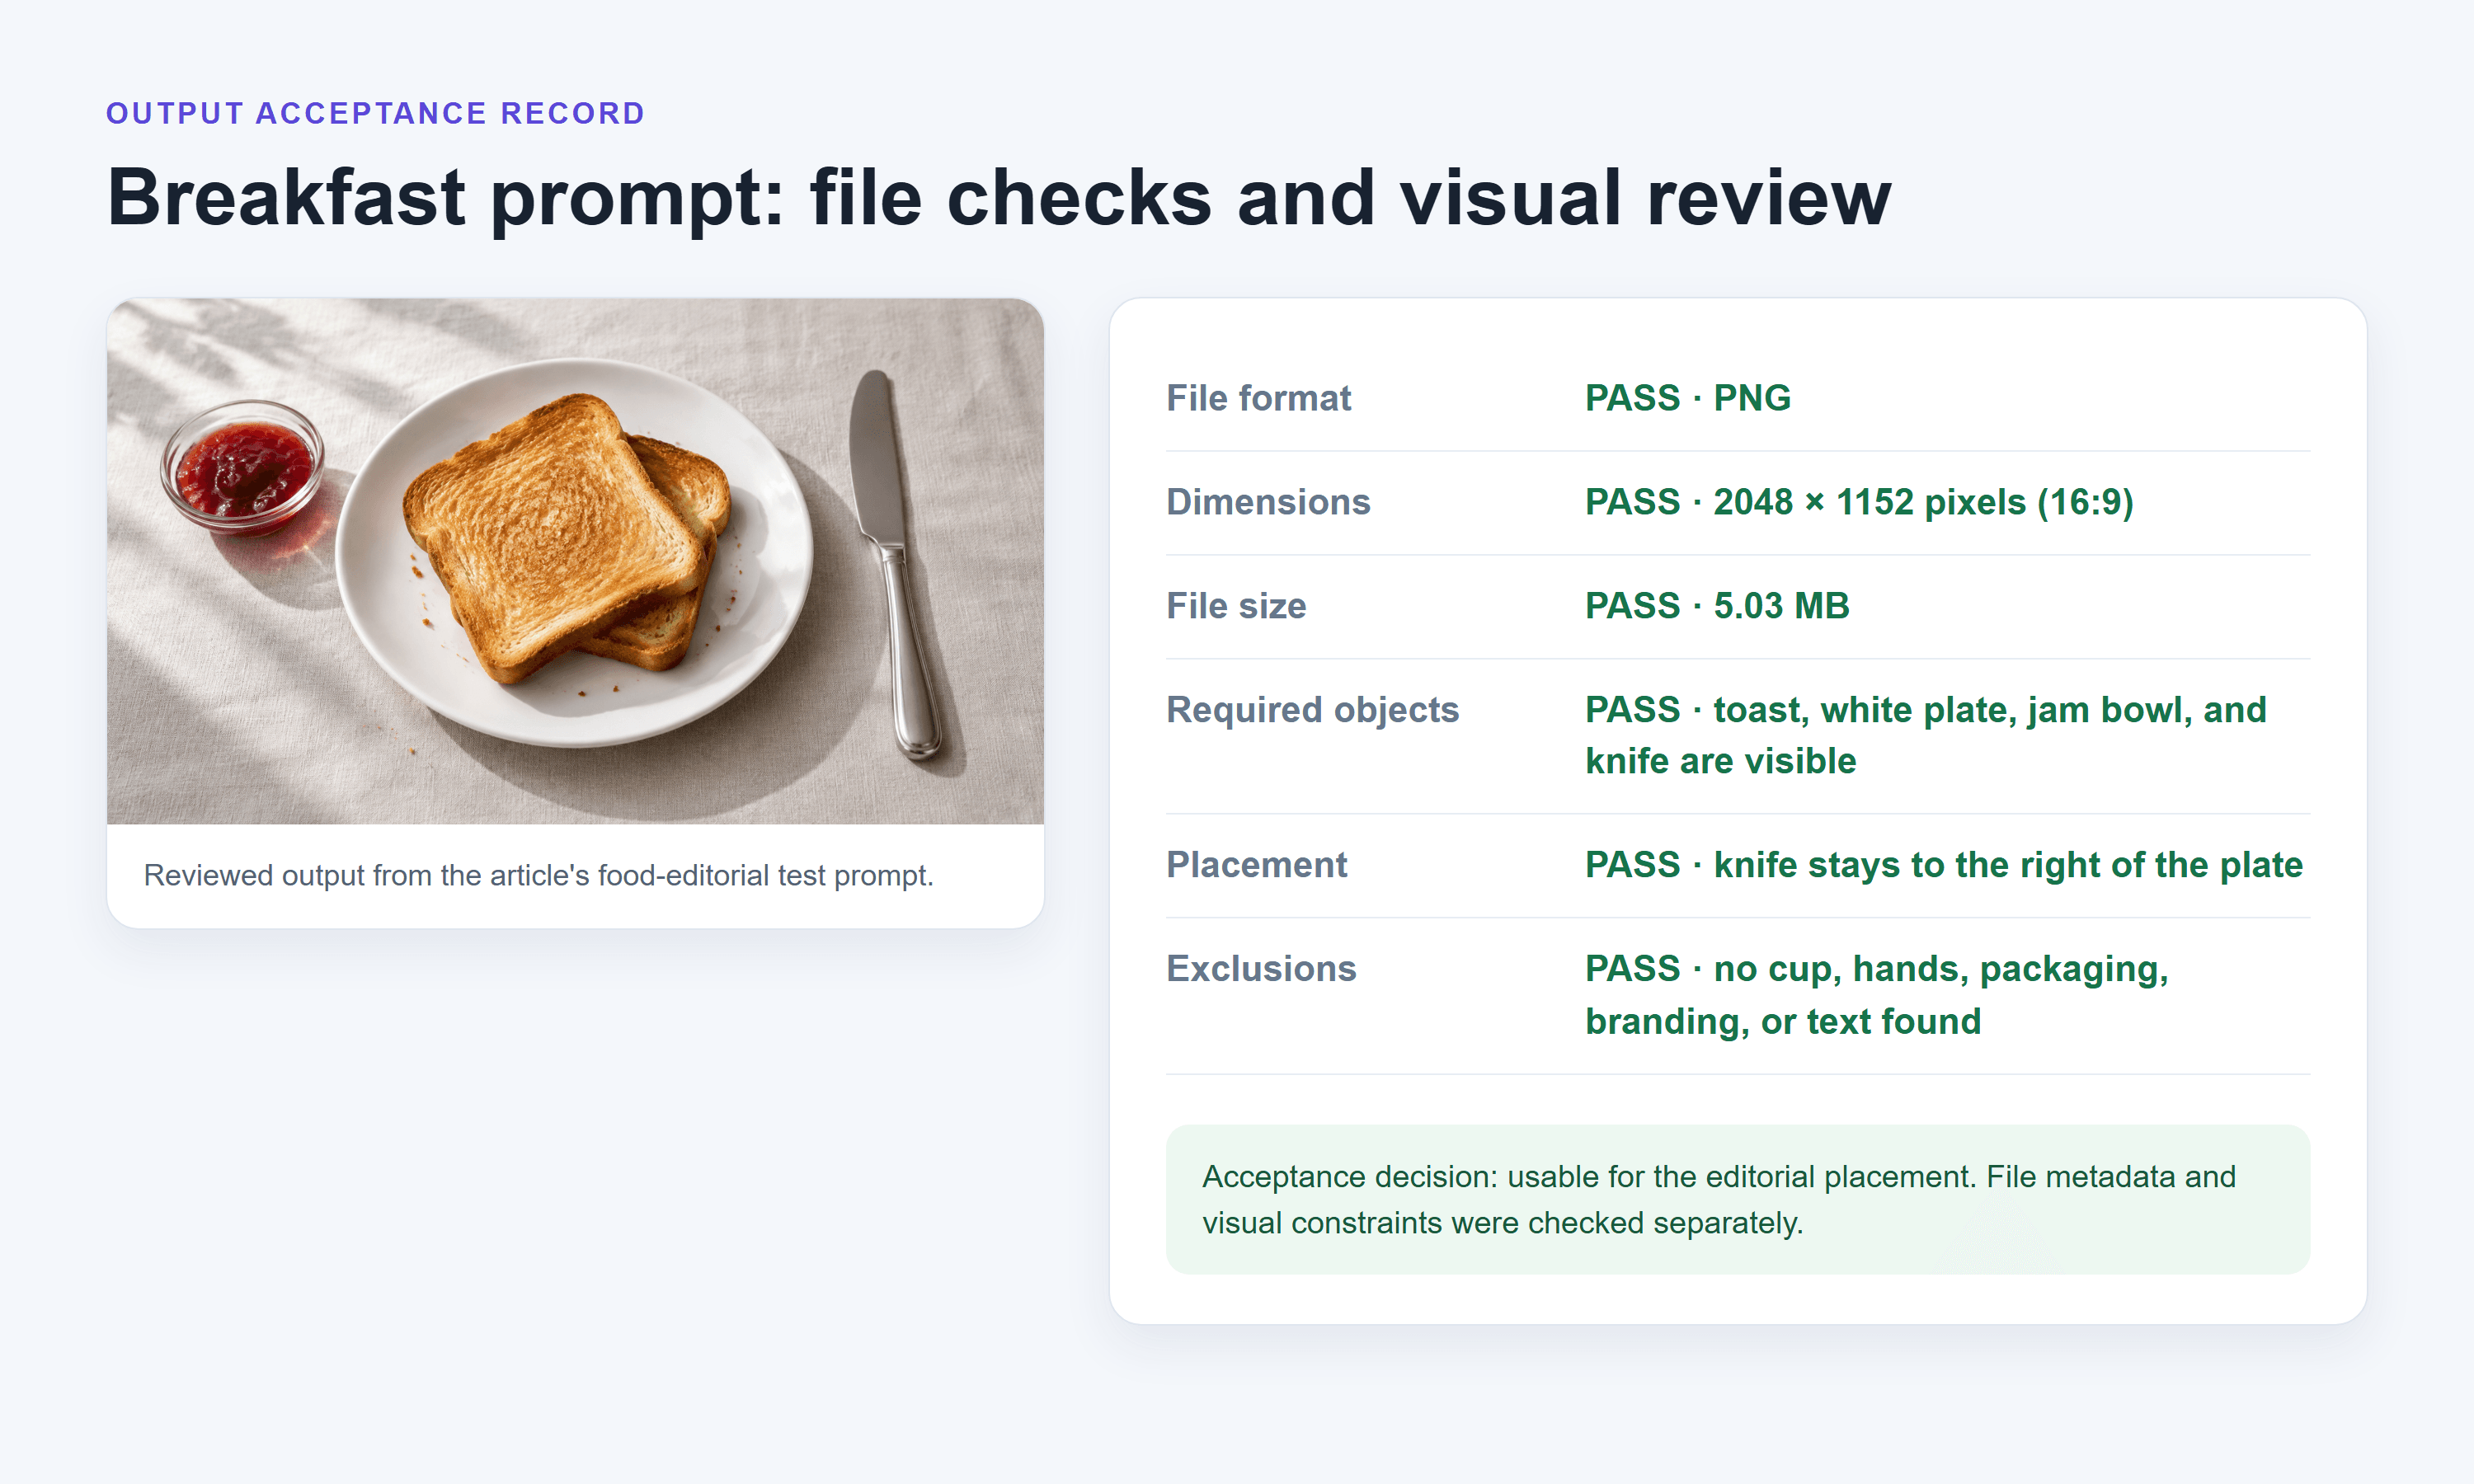 Validierungsaufzeichnung, die Dateimetadatenprüfungen von visuellen Akzeptanzprüfungen trennt
Die Aufzeichnung meldet die tatsächlichen Abmessungen und die Größe der generierten Datei getrennt von ihren visuellen Akzeptanzprüfungen.
Erstellen Sie ein festes Regressionsset aus der tatsächlichen Funktion: gewöhnliche Anfragen, überfüllte Kompositionen, widersprüchliche Anweisungen, schwierige Ausschnitte und relevante Eingabegrenzen. Versionieren Sie die Briefings und Prüferregeln. Wiederholen Sie sie, wenn Sie das Modell, die Prompt-Vorlage oder die Ausgabeeinstellungen ändern.
Melden Sie technischen Erfolg und Akzeptanzrate getrennt. Eine lesbare Datei, die ein zusätzliches Objekt enthält, zählt als erfolgreiche Lieferung und als Inhaltsablehnung. Die Kombination dieser Ergebnisse in einer Erfolgszahl verbirgt die Korrektur, die Ihr Team benötigt.
Die Entwicklerumfrage 2025 ergab, dass 46 % der Genauigkeit von KI-Tools misstrauten und 33 % ihr vertrauten; 3 % berichteten von hohem Vertrauen. Diese Antworten betreffen KI-Tools in Entwicklungs-Workflows, nicht eine gemessene Fehlerrate für Generierungs-APIs. (Stack Overflow Developer Survey, 2025.)
Ebenso können 3 illustrative Läufe keine Gesamtgenauigkeit oder eine nützliche p95-Latenz belegen. Sammeln Sie eine größere, relevante Stichprobe unter den Bedingungen, die Sie in der Produktion erwarten, und behalten Sie Ausreißer bei. Verwenden Sie die Demonstrationen, um die Prüfungen zu entwickeln, und treffen Sie dann eine Release-Entscheidung durch systematische Bewertung.
Eine Produktions-Checkliste vor dem Versand
Die erste funktionierende Anfrage klärt nur einen kleinen Teil der Release-Entscheidung. Ihre Anwendung muss auch Ausgaben eindämmen, unvollendete Arbeit wiederherstellen und erklären, was passiert ist, wenn kein Ergebnis verfügbar ist.
Zugriff schützen. Bewahren Sie Anmeldeinformationen im Backend auf, trennen Sie Umgebungen, beschränken Sie den Zugriff auf Auftragsdatensätze und planen Sie die Rotation von Anmeldeinformationen. Autorisieren Sie jede Status- und Download-Anfrage gegenüber dem Benutzer, dem dieser Auftrag gehört. Eine nicht erratbare Aufgaben-ID ist kein Ersatz für Berechtigungsprüfungen.
Eingaben und Ressourcennutzung begrenzen. Validieren Sie Prompt-Länge, Upload-Typ und -Größe, angeforderte Ausgabeeinstellungen und unterstützte Kombinationen. Erzwingen Sie für heruntergeladene Medien zulässige Ziele, Weiterleitungen, Byte-Limits und Dekodierungslimits. Die kompakten Skripte oben veranschaulichen den Lebenszyklus; sie sind kein gehärteter öffentlicher Download-Dienst.
Legen Sie Budgets vor der Einreichung fest. Definieren Sie Limits pro Benutzer und pro Aufgabe, maximale gleichzeitige Aufträge und wer teurere Einstellungen anfordern darf. Reservieren Sie Budget, solange Arbeit aussteht, damit gleichzeitige Anfragen nicht alle dieselbe Prüfung des verbleibenden Guthabens bestehen.
Status persistent speichern. Schreiben Sie den lokalen Auftrag, bevor Sie den Anbieter aufrufen. Speichern Sie die zurückgegebene Vorhersage-ID sofort und machen Sie das Polling nach einem Prozessneustart fortsetzbar. Wenn der Einreichungsstatus unbekannt ist, verwenden Sie einen Untersuchungsstatus, anstatt den Benutzern zu sagen, dass der Auftrag definitiv fehlgeschlagen ist.
Besitzen Sie das gelieferte Asset. Entscheiden Sie, wo akzeptierte Dateien gespeichert werden, wer darauf zugreifen kann und wann sie ablaufen. Überprüfen Sie die Lebensdauer und Aufbewahrungsbedingungen der Anbieter-Links, anstatt sich unbegrenzt auf eine temporäre Ausgabe-URL zu verlassen. Fügen Sie die Löschung abgeleiteter Dateien in den Daten-Workflow der Anwendung ein.
Machen Sie Fehler verständlich. Unterscheiden Sie eine verzögerte Aufgabe, ein abgelehntes Ergebnis und einen Dienstfehler. Bieten Sie einen klaren Weg, absichtlich zu wiederholen oder eine Überprüfung anzufordern. Bewahren Sie das Briefing des Benutzers auf, damit die Wiederherstellung nicht die Rekonstruktion der Arbeit erfordert.
Änderungen überwachen. Verfolgen Sie Abschluss, Akzeptanz, Kosten und Wartezeit getrennt. Führen Sie das Regressionsset nach Modell- oder Parameteränderungen erneut aus und halten Sie die vorherige Konfiguration nach Möglichkeit verfügbar. Schwärzen Sie sensible Protokolle und weisen Sie sowohl Inhalts- als auch Betriebsdatensätzen Aufbewahrungsfristen zu.
Um die Beispielplattform für Ihre eigene Anwendung zu bewerten, beginnen Sie mit dem Atlas Cloud-Modellkatalog und lesen Sie dann die Dokumentation des ausgewählten Endpunkts und der Vorhersage. Wählen Sie eine Aufgabe, definieren Sie die Akzeptanz und zeichnen Sie auf, was die Bewertung tatsächlich liefert, bevor Sie den Zugriff erweitern.
Häufig gestellte Fragen
Welche generative KI-API sollte ich für meine Anwendung wählen?
Wählen Sie anhand der Eingaben, Ausgaben, akzeptablen Wartezeit und Überprüfungsanforderungen der Funktion. Führen Sie dieselben repräsentativen Briefings gegen die Kandidaten aus, die Sie rechtlich und betrieblich nutzen können. Vergleichen Sie die Kosten für akzeptierte Ausgaben und den Integrationsaufwand neben den Fähigkeiten. Es gibt keine universelle Wahl, die durch diese 3 Bildbeispiele belegt wird.
Gibt es kostenlose generative KI-APIs für Entwickler?
Einige Dienste bieten Testversionen oder eingeschränkte kostenlose Nutzung an, aber Verfügbarkeit, Berechtigung, Kontingente und zulässige Nutzungen ändern sich. Überprüfen Sie die aktuellen Bedingungen für den genauen Endpunkt. Ein kostenloses Kontingent für Verbrauchertools beinhaltet nicht unbedingt API-Zugriff. Selbst-Hosting verbraucht auch Hardware, Strom und Engineering-Zeit, selbst wenn Modellgewichte herunterladbar sind.
Benötige ich Machine-Learning-Erfahrung, um eine generative KI-API zu verwenden?
Sie können mit HTTP, JSON, Authentifizierung und gewöhnlichen Backend-Entwicklungsfähigkeiten beginnen. Das Ausliefern einer zuverlässigen Funktion erfordert zusätzlich Bewertungs- und Betriebsarbeit. Sie müssen die Grenzen des Modells gut genug verstehen, um akzeptable Ausgaben zu definieren, ohne unbedingt selbst ein Modell zu trainieren.
Kann eine API Text, Bilder und Video verarbeiten?
Eine Plattform kann alle 3 bereitstellen, aber jede Fähigkeit kann unterschiedliche Endpunkte, Parameter, Ausgabetypen und Wartemuster verwenden. Überprüfen Sie jede Schnittstelle separat. Ein gemeinsames Konto oder Anmeldeinformationen machen einen Text-Anfragetext nicht mit einem Bild- oder Videomodell kompatibel.
Warum gibt meine Bildanfrage eine Aufgaben-ID anstelle eines Bildes zurück?
Der Endpunkt reicht Arbeit asynchron ein. Speichern Sie die ID und fragen Sie die dokumentierte Statusroute ab. Rufen Sie die Datei ab, wenn die Aufgabe abgeschlossen ist, und validieren Sie sie dann. Wenn Ihr Client aufhört zu warten, läuft der serverseitige Auftrag möglicherweise noch; setzen Sie diesen Auftrag fort, bevor Sie einen weiteren einreichen.
Wie kann ich die API-Kosten senken, ohne den Workflow zu beeinträchtigen?
Verhindern Sie doppelte Einreichungen, validieren Sie Eingaben frühzeitig, verwenden Sie akzeptierte Assets wieder, wo angemessen, und testen Sie günstigere Konfigurationen anhand unveränderter Akzeptanzkriterien. Messen Sie die tatsächlichen Gebühren pro akzeptiertem Ergebnis. Eine generative KI-API für Entwickler verdient ihren Platz, wenn die umgebende Anwendung nutzbare Arbeit zu Kosten liefern kann, die Sie tragen können.


