Eine KI-API für die Batch-Generierung ist nützlich, wenn jede Ausgabe einzeln gefunden, geprüft und erneut versucht werden kann. Das ist wichtiger als die Frage, wie viele Prompts man auf einmal abschickt. Der teure Moment ist nicht Anfrage Nummer 1.000. Er kommt, wenn Aufgabe 37 ein Zeitlimit überschreitet, Aufgabe 38 erfolgreich ist, zwei Dateien denselben Namen teilen und niemand sagen kann, welches Bild sicher veröffentlicht werden darf.
Behandle einen Batch als Sammlung wiederherstellbarer Asset-Jobs. Gib jedem Job eine dauerhafte Business-ID, speichere die exakte Eingabe und die Modelleinstellungen, begrenze die Nebenläufigkeit und versuche nur das Element erneut, das tatsächlich fehlgeschlagen ist. Diese Anleitung verwendet einen Workflow für eine 8-Asset-Charakterkampagne, damit ein Entwickler- oder Growth-Team ein Manifest in einen kontrollierten Produktionslauf verwandeln kann.
Wichtigste Erkenntnisse
- Ein Batch-Job und parallele Anfragen lösen unterschiedliche Latenz- und Kontrollprobleme.
- Stabile Asset-IDs und Idempotenzschlüssel machen Teilausfälle beherrschbar.
- Beginne mit 4 bis 8 visuellen Assets, prüfe sie und erweitere dann.
- Eine erfolgreiche API-Antwort muss vor der Veröffentlichung trotzdem visuell und rechtlich geprüft werden.
KI-API für die Batch-Generierung: Die Antwort zuerst
Eine KI-API für die Batch-Generierung übermittelt eine Reihe unterschiedlicher Generierungsaufgaben an eine asynchrone Warteschlange und gibt deren Ergebnisse dann über Statusabfragen, einen Abschluss-Callback oder eine herunterladbare Ausgabedatei zurück. Jede Aufgabe braucht eine Identität, die außerhalb des Modellanbieters existiert. Die Job-ID des Anbieters hilft im Betrieb, aber maya-ridgeline-001 ist das, womit dein Redaktions- oder Kampagnensystem das Asset Monate später identifizieren kann.
Vermische nicht drei verwandte Ideen. Ein einzelner Prompt kann mehrere Varianten anfordern. Dein eigener Worker kann mehrere normale Anfragen gleichzeitig senden. Ein serverseitiger Batch-Job ist eine vom Anbieter verwaltete Sammlung, die später abgeschlossen wird. Letzterer passt oft zu Offline-Arbeit, während kontrollierte parallele Anfragen zu einem Dashboard passen, das sofortigen Fortschritt benötigt.
Die aktuelle Batch-API-Dokumentation von OpenAI veranschaulicht das asynchrone Muster: Anfragen werden in JSONL gesammelt, als Job übermittelt, auf Abschluss geprüft und als Ergebnisse abgerufen. Ihr 24-Stunden-Fenster, separate Batch-Rate-Limits und Limits sind spezifisch für diesen Dienst und kein Versprechen, das jeder Bildanbieter gibt (OpenAI Batch API documentation, September 2026). Die aktuelle Referenz von Gemini dokumentiert ebenfalls lang laufende Batch-Jobs, Statusabfragen und Webhook-Unterstützung für ihren Dienst (Gemini Batch API reference, September 2026).
| Entscheidungspunkt | Batch-API | Kontrollierte parallele Anfragen |
|---|---|---|
| Erwartete Antwort | Aufgeschobener Abschluss | Jede Anfrage kehrt zurück, sobald sie fertig ist |
| Am besten geeignet für | Offline-Katalog-, Storyboard- und Content-Bibliotheksarbeit | Interaktive Tools und kurze Review-Schleifen |
| Fehlerbehandlung | Ergebnisse pro Element nach Abschluss des Jobs lesen | Jede Unteranfrage behandeln, sobald sie abgeschlossen ist |
| Kosten und Limits | Anbieterspezifische Batch-Regeln können von Live-Verkehr abweichen | Verwendet die gewöhnlichen Anfrage-Limits des Kontos |
| Wesentliche Aufzeichnung | Asset-ID, Anfrage-ID, Ergebniszustand, Ausgabeort | Dieselben Felder, plus Zustand laufender Versuche |
Wähle kontrollierte parallele Anfragen, wenn ein Prüfer das erste brauchbare Bild schnell sehen muss. Wähle einen serverseitigen Batch-Job, wenn die Arbeit warten kann und der Anbieter einen dokumentierten Batch-Pfad anbietet. Speichere in beiden Fällen asset_id, normalisierte Eingabe, Referenz-Hash, Modell, Versuchszahl und Ausgabe-URL. Diese gemeinsame Ebene hält den Workflow portabel, falls sich der Auslieferungsmechanismus ändert.
Warum Batch-Bildprojekte im großen Maßstab scheitern
Produktions-Batches scheitern meist stückweise. Eine Anfrage kann abgeschlossen, abgelaufen, abgelehnt werden oder eine Ausgabe liefern, die technisch gültig, aber visuell unbrauchbar ist. Eine Anwendung, die nur eine finale URL speichert, hat die Informationen weggeworfen, die nötig sind, um alles außer dem einfachsten Erfolgsfall wiederherzustellen.
Der erste Fehler ist die fehlende Identität. Wenn die Anfrage nur einen Prompt-String trägt, kann eine Ausgabe nicht zuverlässig einem Produkt, einer Kampagnensprache oder einer Quellzeile zugeordnet werden. Vom Prompt abgeleitete Dateinamen sind fragil, weil Prompt-Überarbeitungen und wiederholte Produkte kollidieren. Verwende eine stabile Asset-ID aus dem Business-Datensatz und gib dann jedem Generierungsversuch ein eigenes Suffix.
Der zweite Fehler ist das erneute Versuchen ohne Idempotenz. Ein Netzwerk-Timeout beweist nicht, dass der Anbieter keine Arbeit geleistet hat. Wenn ein Worker dasselbe Asset sofort mit einer neuen Anfrageidentität erneut übermittelt, kann er doppelte Ausgaben und doppelte Kosten erzeugen. Ein Idempotenzschlüssel lässt den Aufrufer im Grunde sagen: „Dies ist immer noch dasselbe angeforderte Asset." Ob ein bestimmter Endpunkt diesen Mechanismus unterstützt, hängt vom Anbieter ab. Bestätige ihn daher in der API-Dokumentation, bevor du dich darauf verlässt.
Der dritte Fehler ist eine blinde Warteschlange mit 40 oder 60 Prompts. Eine Abweichung bei Farbe, Komposition oder Produktidentität kann erst sichtbar werden, wenn der Lauf abgeschlossen ist. Eine kürzliche Diskussion unter Creators beschreibt das Prüfen von Storyboard-Seiten mit etwa 7 bis 8 Bildern, bevor die nächste Seite gesendet wird, speziell um Genauigkeits- und Konsistenzfehler zu erkennen (batch image generation discussion, Juni 2026). Das ist Community-Erfahrung, kein Benchmark, aber ein sinnvoller operativer Kontrollpunkt.
Verwende eine Kleinserien-QC-Regel: Führe 4 bis 8 Assets aus, prüfe sie, korrigiere bei Bedarf Prompt oder Referenz und gib dann die nächste Gruppe frei. Behalte den ursprünglichen Prompt, die Prompt-Version, die Eingabereferenz, die Modellversion, wenn verfügbar, die Qualitätseinstellung, das Seitenverhältnis, Zeitstempel, Fehlerklasse und Review-Entscheidung. Eine URL allein kann nicht beantworten, warum ein Asset existiert oder ob es wiederverwendet werden sollte.
Eine zuverlässige KI-API für die Batch-Generierung entwerfen
Die Umsetzung kann klein sein. Ein Manifest, ein Queue-Worker, ein append-only Job-Datensatz und ein prüferfreundlicher Ausgabeordner reichen für den Anfang. Das Ziel ist kein großes Orchestrierungssystem. Es ist ein Workflow, in dem eine Person beantworten kann: Was wurde angefordert, was ist passiert und was sollte als Nächstes laufen?
Gib jeder Batch-Ausgabe eine dauerhafte Asset-Identität
Mach asset_id zu einem Business-Schlüssel, nicht zu einer Anbieter-Job-ID. Ein nützlicher Aufgaben-Datensatz kann die untenstehenden Felder enthalten. Halte ihn in einer Datenbank, wenn mehrere Worker arbeiten, oder in einer versionierten CSV plus JSONL-Log für ein kleineres Team.
| Feld | Warum es existiert |
|---|---|
asset_id | Unveränderliche Identität für das veröffentlichbare Asset |
source_row | Ordnet zurück zum Produkt-, Kampagnen- oder Content-Datensatz zu |
prompt_version | Zeigt, welche Anweisungsvorlage das Ergebnis erzeugt hat |
reference_hash | Bestätigt, welches gesperrte Quellbild verwendet wurde |
model, aspect_ratio, quality | Macht den Lauf so reproduzierbar, dass er diagnostiziert werden kann |
attempt, idempotency_key, status | Trennt einen Unterjob-Retry von einer neuen Anfrage |
output_url, review_status, failure_reason | Verbindet Auslieferung und menschliche Abnahme |
Zum Beispiel bleibt maya-train-001 die Asset-Identität. maya-train-001-a2 ist Versuch 2. Der Idempotenzschlüssel kann maya-train-001-v1 sein, wobei v1 die unveränderliche angeforderte Spezifikation identifiziert. Wenn sich das Briefing wesentlich ändert, erstelle eine neue Prompt-Version, anstatt den alten Datensatz zu überschreiben.
Verwende eine Batch-Warteschlange, keine unbegrenzte Schleife
Lege vor dem Versand ein Nebenläufigkeitslimit, eine Asset-Anzahl-Obergrenze, eine finanzielle Leitplanke und ein Retry-Limit fest. Eine praktische Startkonfiguration sind 4 laufende Jobs, höchstens 2 Generierungsversuche pro Job und nicht mehr als 8 visuelle Aufgaben vor dem nächsten Qualitätsgate. Das sind Startwerte, keine Plattformgarantien. Setze sie unterhalb der dokumentierten Limits deines Kontos und passe sie an, nachdem du reale Abschlusszeiten und Fehlerraten beobachtet hast.
Der Worker sollte eine ausstehende Aufgabe beanspruchen, sie als submitted markieren, die Anbieter-Anfrage-ID speichern und denselben Datensatz aktualisieren, wenn ein Ergebnis eintrifft. Wenn eine Budgetgrenze erreicht ist, keine Arbeit mehr beanspruchen. Wenn die Warteschlange zur Prüfung pausiert wird, lass bereits übermittelte Arbeit abschließen, aber gib nicht automatisch eine weitere Gruppe frei.
Versuche nur den fehlgeschlagenen Unterjob erneut
Versuche failed, timed_out oder anbieterspezifische wiederholbare Zustände einzeln pro Asset erneut. Verwende begrenztes exponentielles Backoff mit Jitter für 429-Antworten, vorübergehende 5xx-Antworten und echte Transport-Timeouts. Speichere die Fehlerklassifizierung und die geplante Wiederholungszeit. Wiederhole nicht automatisch eine Content-Policy-Ablehnung, fehlerhafte Eingabe, fehlende Referenz oder eine visuelle Ablehnung durch einen menschlichen Prüfer.
Übermittle niemals einen ganzen Batch erneut, weil ein Unterjob fehlgeschlagen ist. Archiviere erfolgreiche Ergebnisse sofort und bewahre die Quell-zu-Ausgabe-Zuordnung. Wenn ein Batch-Job mit Teilergebnissen abläuft, übernimm die abgeschlossenen Unterjobs, identifiziere die unvollendeten Asset-IDs und erstelle einen neuen Job, der nur diese verbleibenden Datensätze enthält. Das ist der Unterschied zwischen Wiederherstellung und Duplizierung.
Ein kopierbarer 8-Asset-Batch-Bild-Workflow
Das folgende Beispiel ist bewusst fiktiv: Maya, eine erwachsene Reisefotografin bei einem Hochland-Auftrag. Es macht die operativen Mechanismen konkret, ohne zu implizieren, dass eine reale Person die Kampagne befürwortet. Ersetze die Felder durch deine eigenen zulässigen Charakter-, Talent-Release- oder Kampagnendaten und behalte die Struktur bei.
Schritt 0: Erstelle das Manifest, bevor du generierst
Erstelle batch-manifest.csv, bevor du einen Playground öffnest oder einen Endpunkt aufrufst. Es gibt dem Operator ein klares Abnahmeziel für jedes Asset.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | canonical character reference | 16:9 | pending |
| maya-ridgeline-001 | a | sunrise ridgeline campaign image | 16:9 | pending |
| maya-market-001 | a | mountain market editorial image | 16:9 | pending |
| maya-cabin-001 | a | cabin planning editorial image | 16:9 | pending |
| maya-lake-001 | a | lakeside field-notes image | 16:9 | pending |
| maya-forest-001 | b | forest trail campaign image | 16:9 | pending |
| maya-train-001 | b | train journey editorial image | 16:9 | pending |
| maya-workbench-001 | b | field-kit preparation image | 16:9 | pending |
| maya-portrait-001 | b | close portrait campaign image | 16:9 | pending |
Generiere einen deterministischen Idempotenzschlüssel für jede unveränderliche Anfrage, wie maya-ridgeline-001-v1. Die untenstehende Form ist absichtlich anbieterneutral. Setze den Anbieter-Endpunkt und seine dokumentierten Parameter in request; kopiere keinen fiktiven privaten Endpunkt in die Produktion.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Schritt 1: Erstelle eine kanonische Charakterreferenz
Generiere das Master-Bild separat. Es ist der Identitätsanker für jede spätere Szene und verdient daher eine kurze Prüfung, bevor irgendein Batch beginnt. Wähle im GPT Image 2 playground Hohe Qualität und 16:9 und verwende dann diesen Prompt:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Behalte ein Bild, das Mayas Gesicht, Haare, Jacke, Kameragurt und ein vollständiges Paar Hände klar zeigt, ohne Text oder duplizierte Person. Speichere es als maya-master-001.png, berechne einen Referenz-Hash und hänge dieselbe Quelle an nachgelagerte Unterjobs an. Bündle diesen Schritt nicht. Eine schwache Master-Referenz vervielfacht die Mehrdeutigkeit über jede Szene.
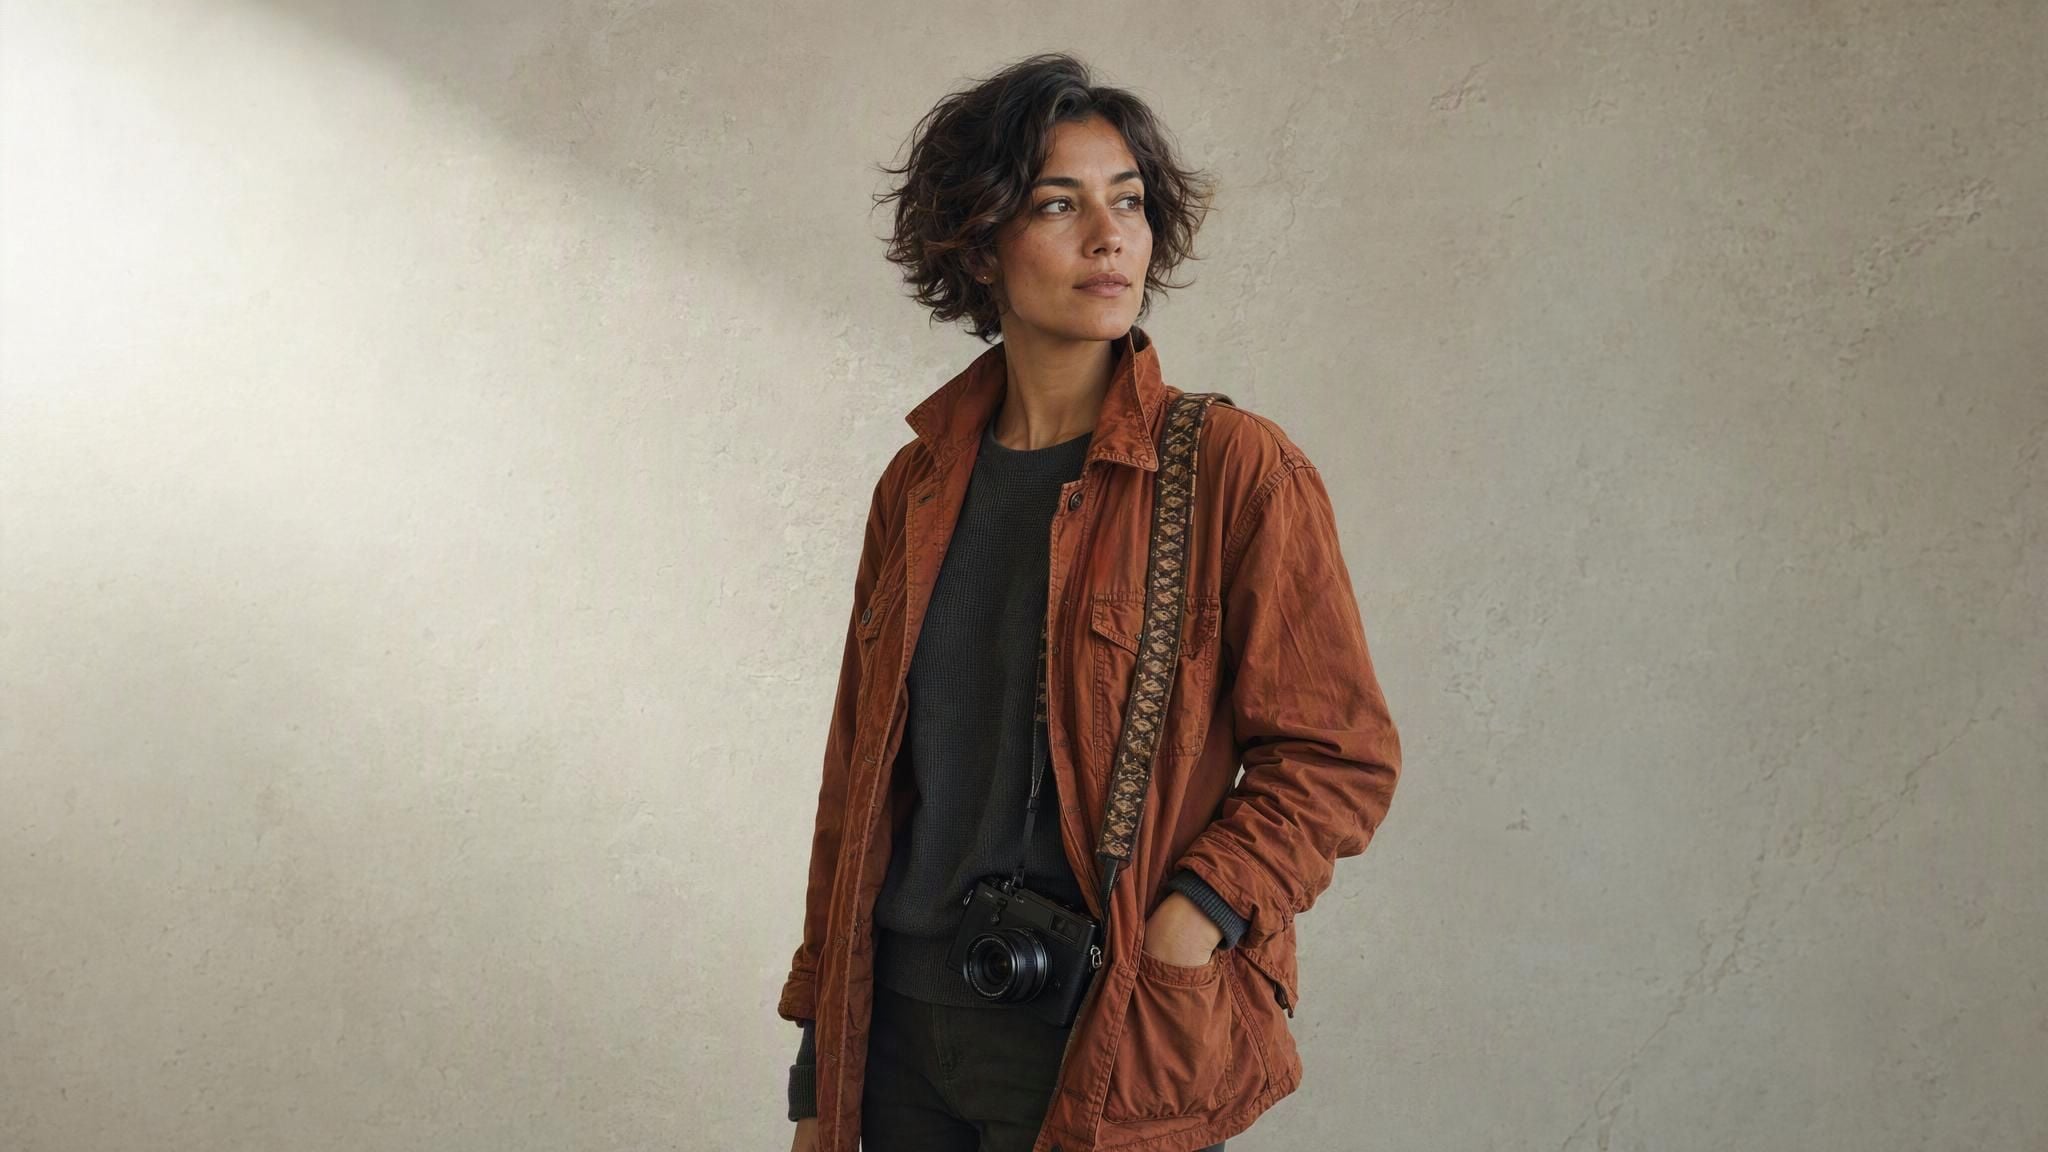
Feature-Demo für KI-API für die Batch-Generierung: Mayas Charakterreferenz-Prompt neben dem generierten Reisefotografinnen-Porträt
Ein echter GPT Image 2 Master-Referenz-Lauf: Der Prompt etabliert die fiktive Fotografin, deren Identität spätere Szenenjobs bewahren müssen.
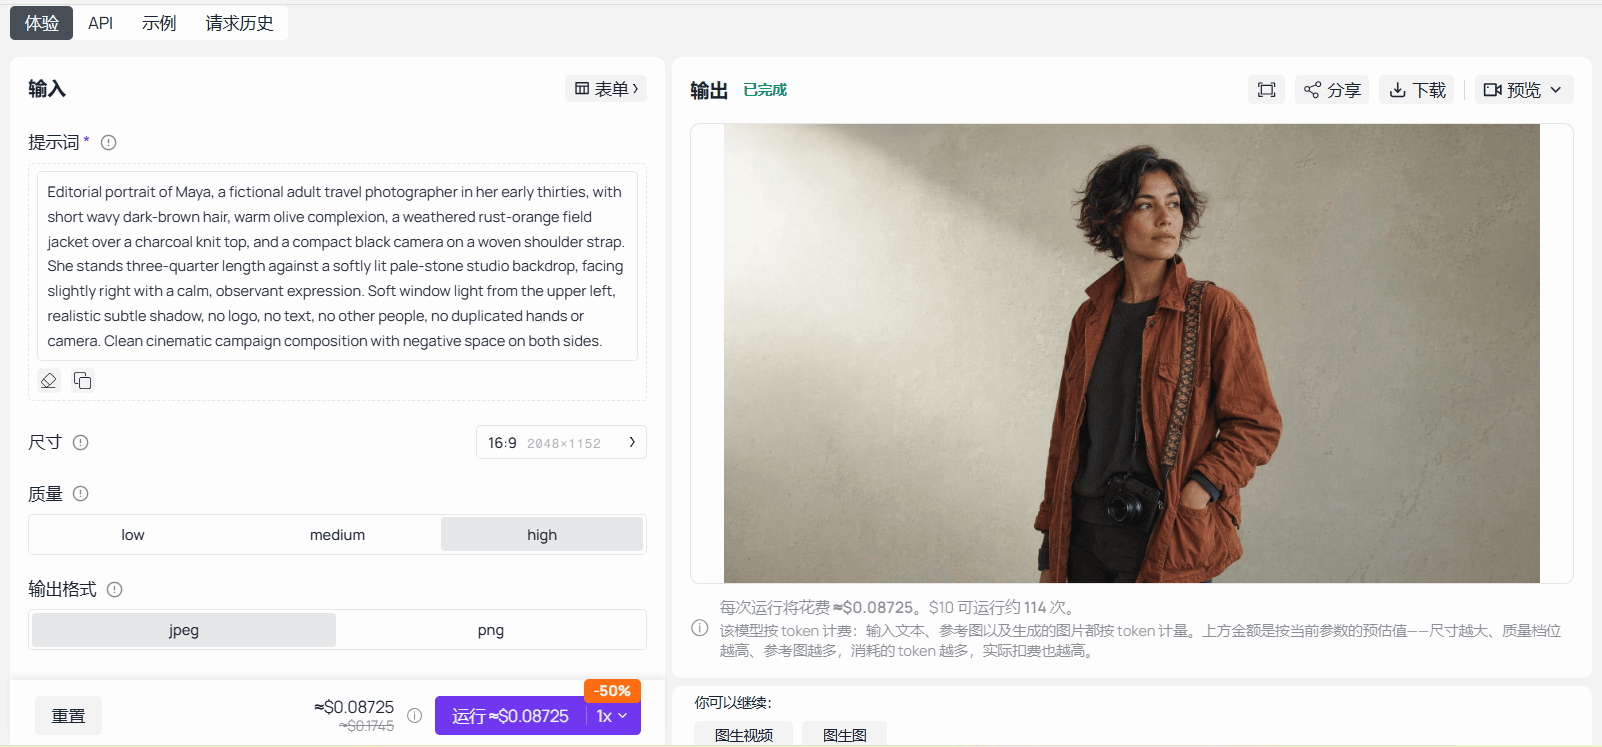
GPT Image 2 Playground abgeschlossen mit Hoher Qualität, einer 16:9-Einstellung und Mayas Master-Porträt
GPT Image 2 auf Atlas Cloud mit dem Charakterreferenz-Prompt des Artikels und dem abgeschlossenen Ergebnis im Ausgabebereich.
Schritt 2: Führe Batch A als 4 verknüpfte Charakterszenen aus
Lade maya-master-001.png in Seedream v4.7 Sequential hoch. Halte die Referenz, die Prompt-Vorlage und das 16:9-Verhältnis konstant. Verwende diesen Prompt:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Verwende den sequenziellen oder kohärenten Batch-Modus, den die Live-Seite tatsächlich bereitstellt. Akzeptiere nur Ausgaben, die eindeutig maya-ridgeline-001 bis maya-lake-001 zugeordnet werden können. Wenn der Playground eine Ausgabe pro Anfrage statt 4 separater Unter-Assets zurückgibt, übermittle dieselbe gesperrte Vorlage als 4 Unterjobs. Bewahre denselben Referenz-Hash und dieselben Parameter, anstatt vorzugeben, die Schnittstelle habe ein Feature geliefert, das sie nicht hat.
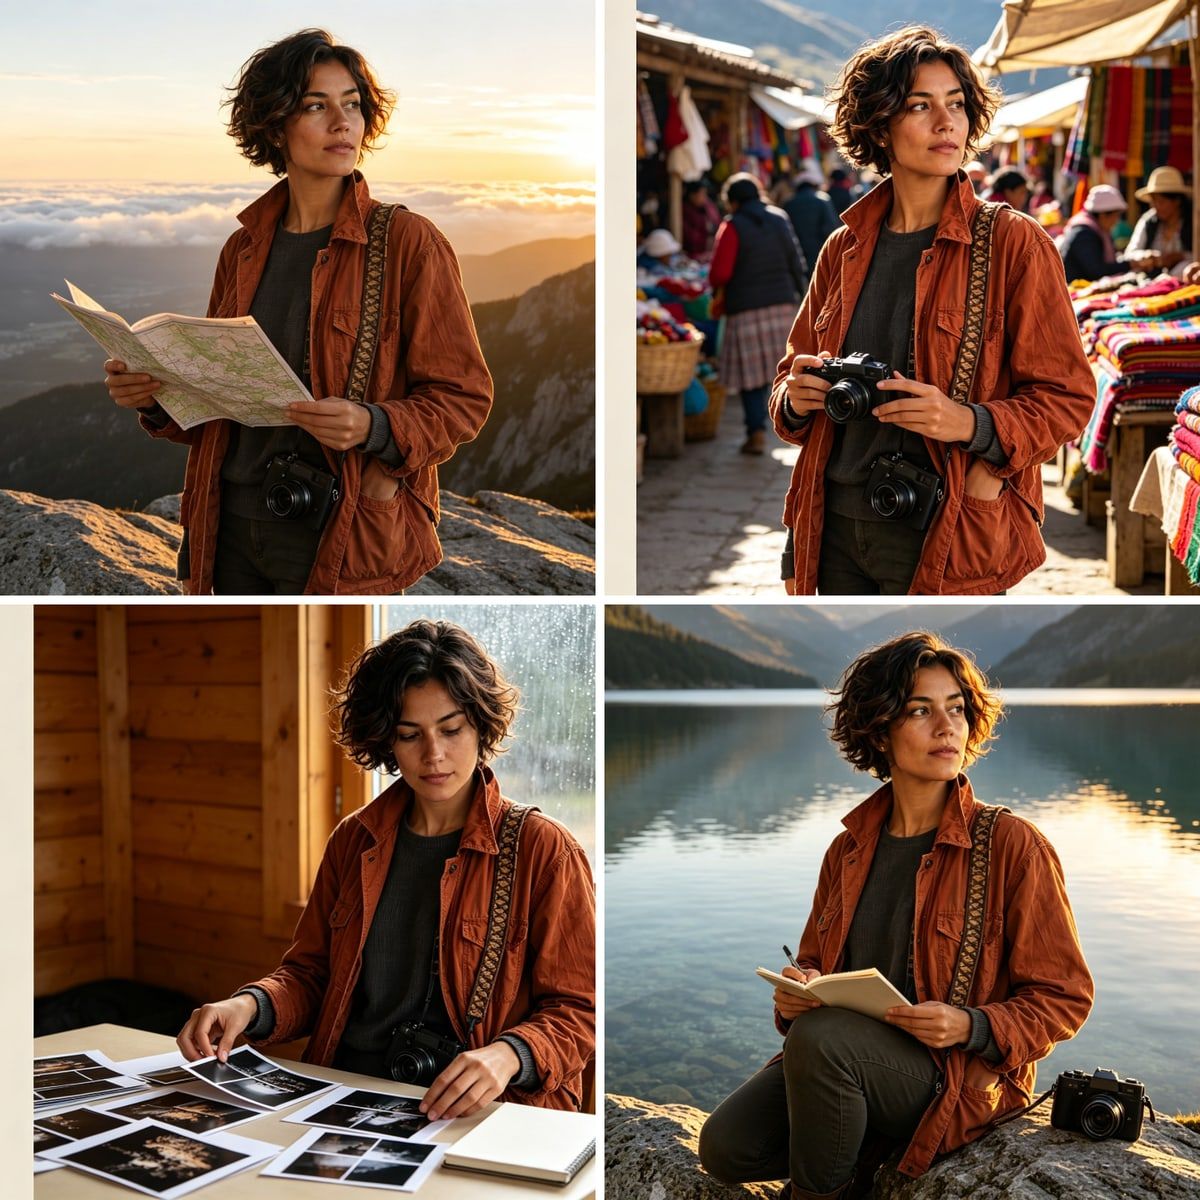
Vier echte Seedream v4.7 Sequential Maya-Szenenausgaben in einem Raster, zugeordnet zu Ridgeline-, Market-, Cabin- und Lake-Asset-IDs
Das 4-Szenen-Batch-A-Ausgaberaster: Jeder Frame bleibt ein separater Asset-Datensatz, auch wenn das Modell eine kohärente Sequenz erzeugt.
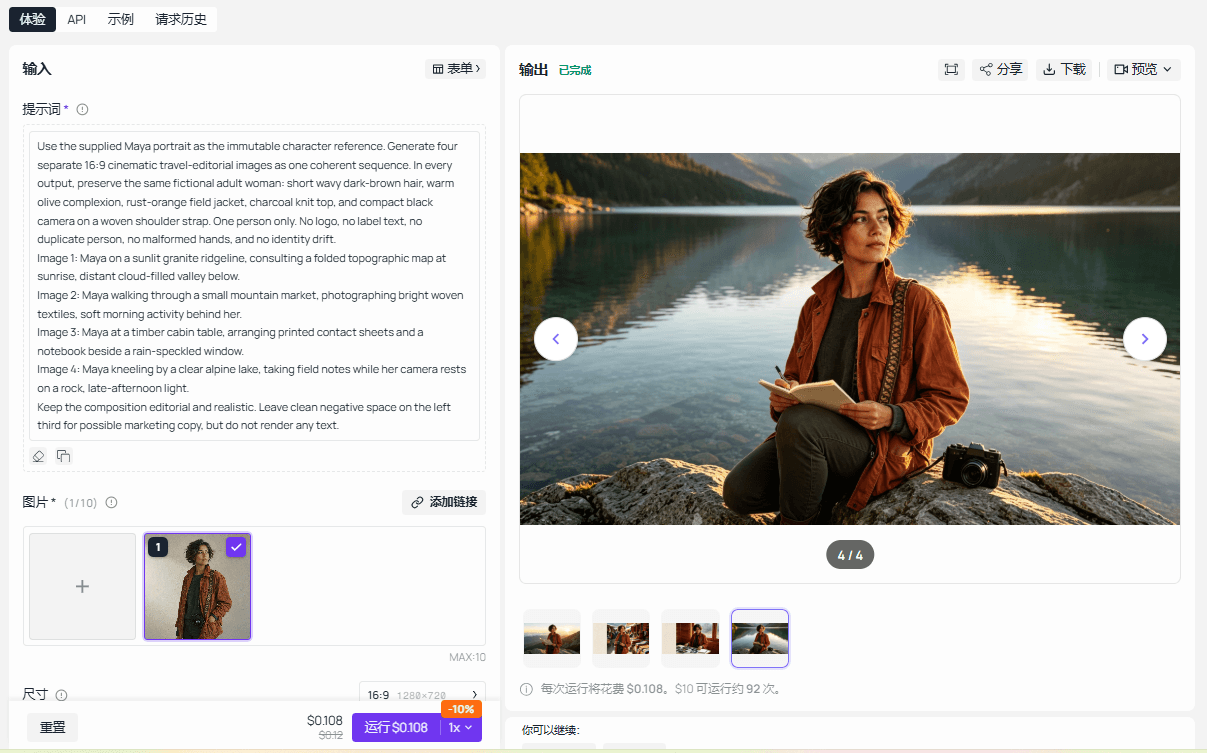
Seedream v4.7 Sequential Playground abgeschlossen mit dem verknüpften Maya-Szenen-Prompt und seiner echten Ausgabe
Seedream v4.7 Sequential auf Atlas Cloud mit dem verknüpften Charakter-Szenen-Prompt des Artikels und einem abgeschlossenen Ergebnis.
Schritt 3: Führe Batch B aus und stoppe dann zur Qualitätskontrolle
Verwende die genehmigte Master-Referenz erneut. Erstelle sie nicht neu und schreibe die Identitätsregeln nicht um. Übermittle die nächsten 4 Szenen mit einem neuen Batch-Label und denselben Abnahmekriterien:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Stoppe nach Batch B. Prüfe alle 8 Szenen-Datensätze, bevor du eine weitere Kampagnensequenz freigibst. Diese Pause fängt die Arten von Abweichung ab, die Warteschlangen verbergen: sich ändernde Haare oder Garderobe, eine zweite Person, die auftaucht, unaufgeforderte Schriftzeichen, fehlerhafte Hände oder eine Szene, die ihrem Kanal nicht mehr dient. Speichere die Prüferentscheidung neben dem Asset und nicht in einer nicht verfolgten Chat-Nachricht.
Schritt 4: Wende eine Entscheidung zum Veröffentlichen, Wiederholen oder Ablehnen an
Markiere ein Bild als approved, wenn es eine Maya enthält, mit der Master-Referenz in Gesicht, Haaren, Garderobe und Kamera übereinstimmt, keinen kaputten Text oder fehlerhafte Anatomie enthält und zu seiner zugewiesenen Szene passt. Markiere es als retry, wenn Maya sich dupliziert, abweicht, ein notwendiges Requisit verliert oder fehlerhafte Hände oder Schriftzeichen zeigt. Markiere es als rejected, wenn die Komposition dem beabsichtigten Kanal nicht dienen kann oder der Charakter nicht mehr erkennbar ist.
Behalte bei einem Retry maya-train-001 als Business-Asset und erstelle den Versuch maya-train-001-a2. Übermittle nur diesen Unterjob mit der ursprünglichen Idempotenzschlüssel-Spezifikation, die nur angepasst wird, wenn der Prompt bewusst versioniert wird. Führe die anderen 7 Assets nicht erneut aus, nur weil eine Szene repariert werden muss.
Modelle für die Batch-Generierung auswählen
Wähle ein Modell rund um die Arbeitseinheit, nicht um ein Leaderboard. Eine saubere Master-Referenz und eine kohärente Szenensequenz sind unterschiedliche Aufgaben. Eine Bearbeitung eines einzelnen fehlgeschlagenen Bildes ist wieder etwas anderes. Wenn ein Team diese Phasen über eine OpenAI-kompatible Integration testen möchte, bietet Atlas Cloud einen natürlichen Ort, um die beiden in diesem Beispiel verwendeten Modellseiten zu validieren.
| Aufgabe | Modell und Arbeitsmethode | Preiskontext, den du vor dem Einreihen prüfen solltest |
|---|---|---|
| Einen sauberen Charakter-Master erstellen | GPT Image 2, ein Lauf in Hoher Qualität mit 16:9, der zum Referenzanker wird | GPT Image 2 Developer Text-zu-Bild wird ab etwa $0,004 pro Bild gegenüber $0,009 Standard angeführt, ein angezeigter Rabatt von 50 % zum Stand September 2026 |
| Ein kohärentes Szenenset aufbauen | Seedream v4.7 Sequential, gleiche Referenz und gesperrtes Prompt-Schema über Unterjobs hinweg | Der aktuelle Katalog führt $0,03 pro Bild an; verifiziere den Live-Ausgabemodus und Preis vor der Produktion |
| Ein fehlgeschlagenes Asset reparieren | GPT Image 2 Edit-Modus, begrenzt auf das Asset, das die Prüfung nicht bestanden hat | Bestätige den Edit-Endpunkt, die Ausgabegröße, die Qualität und den aktuellen Preis, bevor du dich bindest |
Preise ändern sich je nach Modell, Modus und gewählten Einstellungen. Verwende den Atlas Cloud models catalog, um Verfügbarkeit, Rabatte und den genauen Modus an dem Tag erneut zu prüfen, an dem du Arbeit einreihst. Behandle die Tabelle als Schätzungseingabe, niemals als Werbeaussage oder Kostengarantie.
Qualitätskontrolle, Kosten und Rechte, bevor du skalierst
Die abgeschlossene Generierung hat 3 getrennte Bedeutungen: Der Anbieter meldet Erfolg, die Datei wurde korrekt archiviert und ein menschlicher Prüfer akzeptiert sie zur Veröffentlichung. Mach alle 3 in deinen Datensätzen sichtbar. Eine abgeschlossene Aufgabe mit fehlender Ausgabedatei ist ein operativer Fehler. Eine gespeicherte Datei mit einem duplizierten Charakter ist ein kreativer Fehler. Keiner von beiden sollte automatisch zur Veröffentlichung weiterschreiten.
Verwende eine Prüfer-Checkliste, die einfach genug ist, um sie auf jedes Unter-Asset anzuwenden:
| Prüfung | Prüferfrage |
|---|---|
| Charakteridentität | Stimmt Maya mit der genehmigten Master-Referenz in Gesicht, Haaren, Garderobe und Kamera überein? |
| Objektanzahl | Gibt es genau die erwartete Anzahl von Schlüsselobjekten? |
| Prompt-Übereinstimmung | Erfüllt die Szene den zugewiesenen Anwendungsfall? |
| Text-Artefakte | Gibt es unerwünschten, fehlerhaften oder nicht unterstützten Text? |
| Verhältnis und Dateiname | Passt die gespeicherte Datei zum Manifest-Datensatz? |
| Rechteprüfung | Sind die Referenz und die beabsichtigten Aussagen für diese Verwendung zulässig? |
Schätze die Kosten nach dem Lauf mit approved asset cost = total completed attempts cost / approved assets. Das legt die Kosten für Retries und abgelehnte Ergebnisse offen, ohne vorzugeben, dass jedes Bild dieselben Endkosten hat. Lege vor dem Start ein Task-Limit, ein Batch-Limit und ein Tageslimit fest. Pausiere den Versand, wenn eine dieser Obergrenzen erreicht wird.
Verwende nur eigene, lizenzierte oder anderweitig zulässige Referenzbilder. Prüfe die aktuellen Plattformrichtlinien und die Bedingungen des Modells vor kommerzieller Nutzung. Bitte das Modell nicht, Zertifizierungen, Laborergebnisse, Sicherheitsversprechen, medizinische Aussagen oder nicht verifizierte Produktspezifikationen zu erfinden. Eine polierte Ausgabe macht eine nicht belegte Aussage nicht veröffentlichbar.
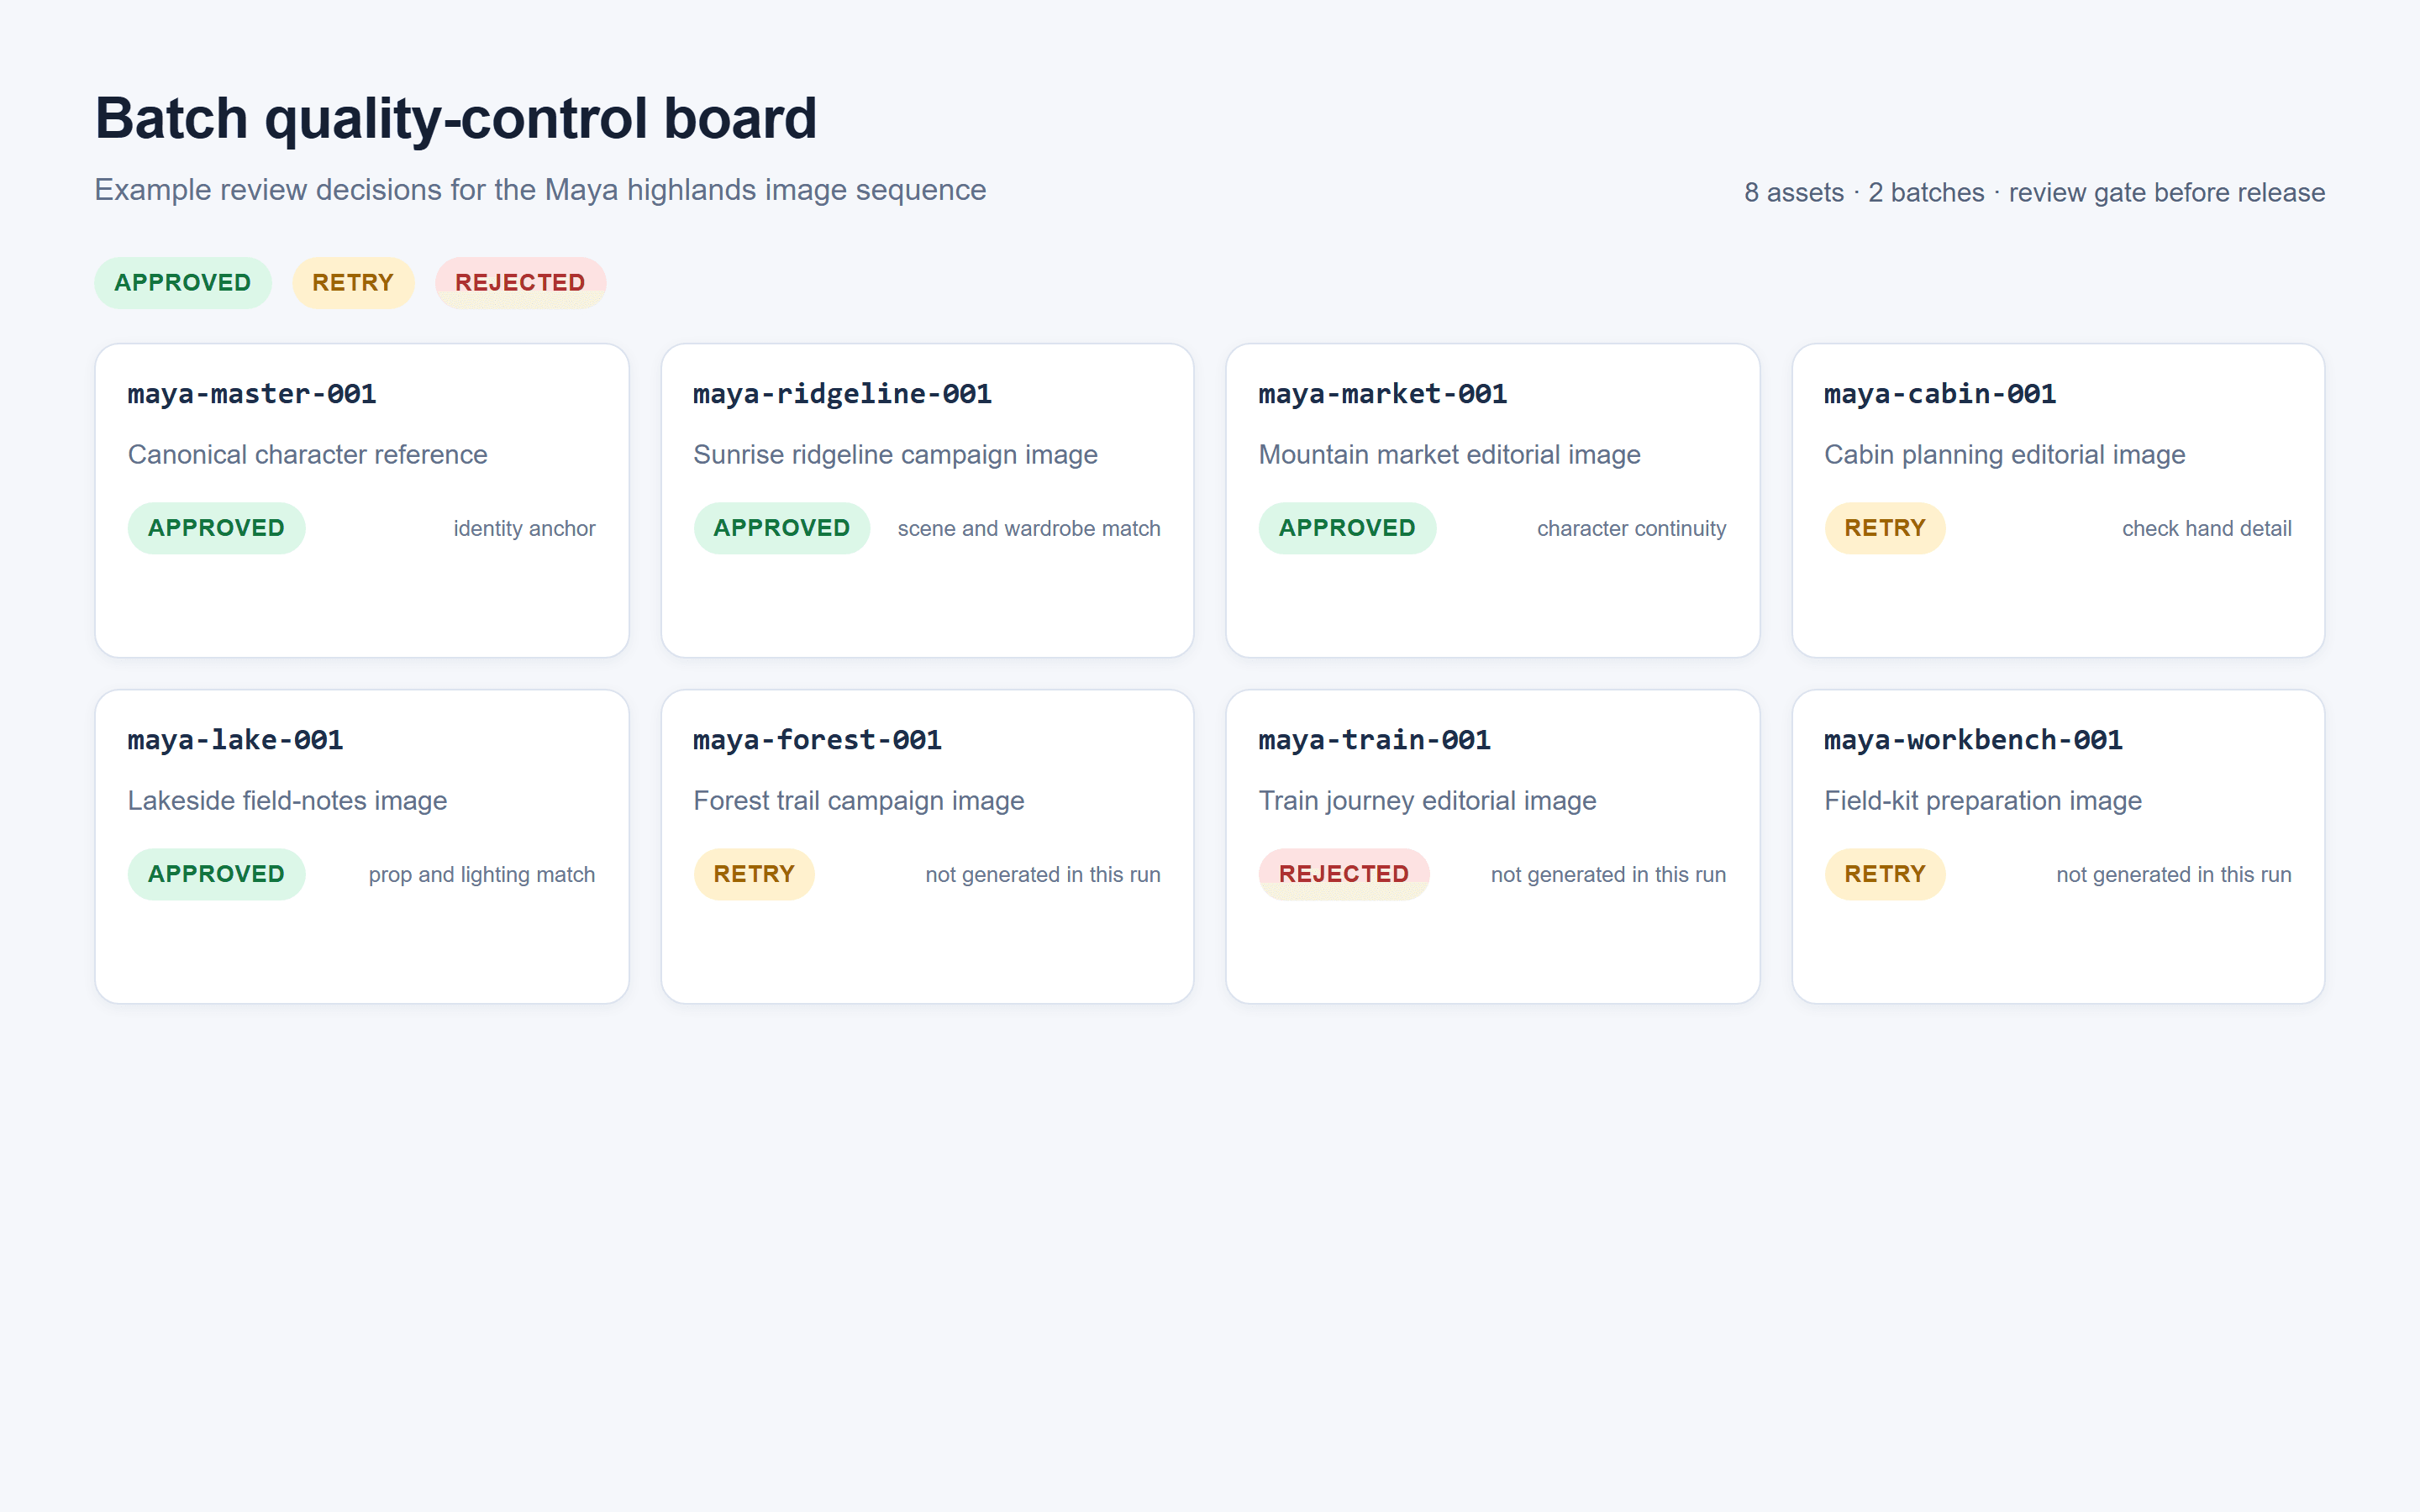
Im Browser gerendertes Batch-Qualitätskontrollboard mit 8 Maya-Asset-IDs und den Review-Zuständen approved, retry und rejected
Ein im Browser gerendertes Review-Board ordnet echte Laufdateien ihren 8 Asset-IDs zu und macht die Entscheidung zum Veröffentlichen, Wiederholen oder Ablehnen sichtbar.
KI-API für die Batch-Generierung: Checkliste für den Produktionsstart
Bevor du von der 8-Asset-Übung zu einem Live-Katalog oder einer Content-Bibliothek übergehst, bestätige jeden Punkt unten.
- Jedes Asset hat eine unveränderliche
asset_id. - Prompt, Referenz-Hash, Modell, Verhältnis und Qualität sind aufgezeichnet.
- Jede Übermittlung hat einen Idempotenzschlüssel, wo der Anbieter einen unterstützt.
- Die Nebenläufigkeit bleibt unter dem tatsächlich dokumentierten Limit des Kontos.
- Task-, Batch- und Tagesbudget-Obergrenzen bestehen.
- 429-Antworten, 5xx-Antworten, Timeouts und Content-Ablehnungen folgen unterschiedlichen Regeln.
- Retries haben ein hartes Maximum.
- Erfolgreiche Ergebnisse werden sofort archiviert und zur Quelldatenmenge zurückverfolgt.
- Ein Kleinserien-QC-Gate wird bestanden, bevor die nächste Gruppe freigegeben wird.
- Eine abschließende Stichprobenprüfung kontrolliert Charakteridentität, Text, Verhältnis, Dateinamen und Rechte.
Diese Checkliste hält eine KI-API für die Batch-Generierung nützlich, wenn die Menge wächst. Sie hinterlässt auch einen klaren Audit-Trail, wenn eine Redaktion fragt, warum ein bestimmtes Bild generiert, akzeptiert oder erneut ausgeführt wurde.
FAQ: KI-API für die Batch-Generierung
Was ist eine KI-API für die Batch-Generierung?
Es ist eine Möglichkeit, viele unabhängige KI-Aufgaben zu übermitteln, ihre Ausführung zu verfolgen und Ergebnisse später zu sammeln. Eine gute Umsetzung behält für jede Aufgabe eine dauerhafte Business-Asset-ID, unabhängig davon, ob der Anbieter einen asynchronen Batch-Job oder normale gleichzeitige Anfragen verwendet.
Ist eine Batch-API besser als das Senden von Bildanfragen parallel?
Keines ist automatisch besser. Verwende kontrollierte parallele Anfragen, wenn der Workflow sofortigen Fortschritt braucht. Verwende einen Anbieter-Batch-Job für nicht dringende Mengen, wenn seine dokumentierten Warteschlangen-, Bearbeitungs- und Kostenregeln zu deiner Arbeit passen. Beide brauchen Protokolle pro Asset und Prüfung.
Wie viele KI-Bilder sollte ich in einen Batch packen?
Beginne mit 4 bis 8 visuellen Assets, wenn du ein neues Prompt-Schema oder eine Charakterreferenz validierst. Erweitere erst, nachdem das Team jedes Ergebnis zuordnen, Abweichungen schnell erkennen und einen fehlgeschlagenen Unterjob wiederherstellen kann, ohne die Gruppe neu zu starten. Anbieter-Limits mögen weit mehr erlauben, aber ein operativ nützlicher Batch ist ein prüfbarer.
Wie verhindern Idempotenzschlüssel doppelte Generierungskosten?
Sie identifizieren eine Übermittlung nach einem Retry als dieselbe beabsichtigte Operation. Wenn der Endpunkt Idempotenz unterstützt, kann der Anbieter vermeiden, einen wiederholten Netzwerkaufruf als völlig neue Generierung zu behandeln. Speichere den Schlüssel mit dem Asset-Datensatz und bestätige die genaue Semantik in der Dokumentation des Anbieters.
Kann ich Bilder von derselben Charakterreferenz als Batch generieren?
Ja. Verwende ein genehmigtes, zulässiges Referenzbild; hänge seinen Hash an jeden Unterjob an; sperre die Identitätsanweisungen und prüfe eine kleine Szenengruppe vor der Erweiterung. Referenzkonsistenz reduziert Mehrdeutigkeit, ersetzt aber keine visuelle QC.
Sollte ich einen ganzen fehlgeschlagenen Batch erneut versuchen oder nur fehlgeschlagene Assets?
Versuche nur die fehlgeschlagenen Assets erneut. Archiviere zuerst Erfolge, klassifiziere den Fehler und erstelle einen neuen Versuchsdatensatz für den betroffenen Unterjob. Eine erneute Übermittlung des ganzen Batches macht doppelte Assets und unnötige Ausgaben wahrscheinlicher.


