Ein grüner API-Testbericht wirkt beruhigend, bis Ihnen auffällt, dass jede Assertion nur HTTP 200 prüft. Die Antwort könnte den Datensatz des falschen Kunden enthalten und trotzdem bestehen.
Wählen Sie KI-Tools für API-Tests passend zu der Arbeit, die Sie bereits haben. Bewerten Sie Postman Agent Mode, wenn Ihr Team Collections pflegt, KushoAI, wenn eine Spezifikation Ihr Ausgangspunkt ist, und Keploy, wenn Sie generierte Flows oder Regressionstests aus aufgezeichnetem Traffic benötigen. Prüfen und führen Sie die resultierenden Tests aus, bevor Sie ihnen vertrauen.
Diese Anleitung behandelt KI-Unterstützung für das Testen gewöhnlicher APIs. Die Genauigkeit der Antworten eines KI-Modells zu testen, ist ein separates Bewertungsproblem.
Wichtigste Erkenntnisse
- Geben Sie den Vertrag, Anfrageabhängigkeiten und genehmigte Geschäftserwartungen an.
- Prüfen Sie, ob Assertions falsche Daten, fehlende Felder und fehlerhafte Typen ablehnen.
- Kaufen Sie erst, nachdem die geprüften Tests wiederholt in Ihrer vorgesehenen CI-Umgebung ausgeführt wurden.
Der Produktvergleich unten gibt die offizielle Dokumentation wieder, die am 21. September 2026 geprüft wurde. Er ist kein direkter Vergleichstest dreier kostenpflichtiger Konten.
Das durchgearbeitete Beispiel verwendet eine gepinnte Swagger-Petstore-Spezifikation und trennt Vertragserwartungen, beobachtetes Verhalten und absichtlich veränderte Antwortkopien.
Unser lokaler Lauf bestand 5 Live-Tests und lehnte alle 3 absichtlich geänderten Antwortkopien ab. Eine separate Prüfung auf fehlenden Namen gab weiterhin 200 zurück, was zeigt, warum der Umfang eines grünen Berichts wichtig ist.
Was KI-Tools für API-Tests tatsächlich tun
KI-Unterstützung fließt üblicherweise in vier Teile des API-Testens ein. Ein Modell liest Ihre Spezifikation, schlägt Szenarien vor, entwirft Assertions und hilft, Fehler zu erklären. Jeder Teil erfordert andere Belege. Eine plausible Erklärung eines Fehlers belegt nicht, dass die vorgeschlagene Korrektur richtig ist.
Für die Spezifikationsprüfung stellen Sie die OpenAPI-Datei und die relevanten Geschäftsregeln bereit. Für die Szenarioplanung fügen Sie Beispiele gültiger Daten und bekannte Grenzen hinzu. Für ausführbare Skripte geben Sie Ihren Runner, die Authentifizierungseinrichtung und Fixture-Konventionen an. Für die Diagnose stellen Sie die tatsächliche Anfrage, Antwort und Fehlermeldung nach dem Entfernen von Geheimnissen bereit.
Trennen Sie diese vier Mechanismen bei der Bewertung von Produkten:
- LLM-Generierung: schlägt Tests aus Sprache, Schemas und Beispielen vor. Eine prüfende Person muss die erwarteten Ergebnisse kontrollieren.
- Traffic-Replay: vergleicht späteres Verhalten mit aufgezeichneten Interaktionen, oft unter Verwendung aufgezeichneter Abhängigkeitsantworten.
- Property-based Testing: konstruiert systematisch Eingaben, um Eigenschaften wie Schema-Konformität herauszufordern.
- Testausführung: sendet Anfragen, bewertet Assertions und liefert Berichte und Exit-Codes zurück.
Ein Produkt kann mehrere Mechanismen kombinieren. Fragen Sie, welcher Mechanismus jeden Test erzeugt hat und wodurch sein erwartetes Ergebnis bestimmt wird. Das Aufzeichnen einer falschen Antwort kann denselben Fehler als Regressionsbasis bewahren. Das Generieren eines ausgefeilten Testnamens kann eine nicht belegte Erwartung verschleiern.
Denken Sie bei Assertions in drei Tiefen. Erstens: Hat der Server erfolgreich geantwortet? Zweitens: Hat der Body die dokumentierten Felder und Typen? Drittens: Repräsentiert dieser Body die Ressource und Operation, die Sie angefordert haben?
Bei einer Haustier-Suche besteht ein gültiges Objekt mit ganzzahliger ID die dritte Prüfung trotzdem nicht, wenn diese ID zu einem anderen Haustier gehört. Umgekehrt beweist die Übereinstimmung mit der angeforderten ID nicht, dass jedes Feld das Schema erfüllt. Verwenden Sie beide Prüfungen und fügen Sie Geschäftsregeln nur dort hinzu, wo das Team eine vereinbarte Quelle dafür hat.
Das praktische Ergebnis, das Sie wollen, ist ein wartbares Testartefakt mit einer erklärbaren Orakel-Instanz: einem klaren Grund, warum jedes Ergebnis bestehen oder fehlschlagen sollte. Zählen Sie nach der Prüfung nützliche Szenarien, einschließlich der abgelehnten, statt die Länge der anfänglich generierten Liste zu feiern.
KI-Tools für API-Tests im Workflow-Vergleich
Beginnen Sie mit dem Artefakt, das Ihr Team heute liefern kann. Eine etablierte Collection zu migrieren, fehlende Geschäftsregeln zu rekonstruieren und die Aufzeichnung von Abhängigkeiten einzurichten, sind unterschiedliche Projekte. Ein Tool, das zu einem Ausgangspunkt passt, kann an einem anderen zusätzliche Arbeit verursachen.
| Tool oder Ansatz | Nützliche Eingabe | Rolle von KI oder Automatisierung | Ausführungs- und CI-Weg | Prüfbare Ausgabe | Wichtigste Testfrage |
|---|---|---|---|---|---|
| Postman Agent Mode | Collections, Anfragen, Antworten, Umgebungen, Specs | Entwirft und bearbeitet Testskripte im Workspace-Kontext | Collection Runner und kompatibler CLI-Workflow | Standard-Postman-JavaScript-Assertions | Bewahrt es Ihre Variablen und testet es den Vertrag? |
| KushoAI | OpenAPI, Postman-Collection, cURL | Generiert Szenarien und Testsuiten; unterstützt natürlichsprachliche Verfeinerung | Plattformausführung und dokumentierte CI-Integration; Berechtigung prüfen | Generierte Anfragen, Abhängigkeiten und erwartete Ergebnisse prüfen | Kann Ihr ausgewählter Plan die Suite dort ausführen und behalten, wo Sie sie benötigen? |
| Keploy | Specs oder Anfragedefinitionen; alternativ echte Traffic | KI-Generierung und ein separater Record/Replay-Weg | Generierte Flows oder aufgezeichnete Tests in unterstützten lokalen/CI-Umgebungen | Testdefinitionen, Baselines und Abhängigkeits-Mocks prüfen | Welcher Weg deckt Ihre tatsächlichen Fehlermodi ab? |
| Vorhandener Runner plus ein LLM | Genehmigte Matrix, Spec, Fixture-Konventionen | Entwirft Code zur Prüfung | Ihr pytest oder ein anderer etablierter Runner | In Ihr Repository committeter Code | Ist die Prüfung günstiger als das direkte Schreiben derselben Tests? |
Postman Agent Mode für vorhandene Collections
Postman ist eine sinnvolle erste Bewertung, wenn Ihre Collection bereits nützliche Anforderungsreihenfolge, Umgebungsvariablen und Authentifizierungseinrichtung enthält. Agent Mode kann diesen Kontext nutzen, um standardmäßige JavaScript-Testskripte zu generieren. Diese Skripte können in den bestehenden Workflow zur Ausführung von Collections eintreten, statt eine neue Assertion-Sprache zu erfordern.
Ein fokussierter Test ist aufschlussreicher, als es zu bitten, alles zu testen. Wählen Sie die Anfrage aus, die eine zuvor in der Collection erstellte Ressource abruft. Stellen Sie ihr Schema bereit und bitten Sie um Validierung erforderlicher Felder, dokumentierte Feldtypen und eine Assertion, die die zurückgegebene ID mit der gespeicherten Erstellungs-ID verbindet.
Prüfen Sie dann die vorgeschlagenen Änderungen, bevor Sie sie akzeptieren. Ein Antwortbeispiel könnte ein Haustier namens Milo enthalten. Gleichheit mit Milo ist aussagekräftig, wenn Ihr Fixture Milo ausdrücklich erstellt hat; sie ist fragil, wenn der Generator einen Namen aus einem gemeinsam genutzten Beispieldatensatz kopiert hat. Dasselbe Literal kann je nach Quelle eine gültige Assertion oder eine versehentliche Abhängigkeit sein.
Prüfen Sie den Variablenbereich sorgfältig. Eine in einer Umgebungsvariablen gespeicherte ID muss für die spätere Anfrage verfügbar sein und zu diesem Lauf gehören. Gemeinsam genutzte Variablen über gleichzeitige Läufe hinweg können sporadische Fehler erzeugen, die Serverdefekten ähneln. Bitten Sie den Generator, neben den Assertions auch Setup und Cleanup zu erklären.
Führen Sie für den ersten Abnahmetest die Collection zweimal mit isolierten Daten aus und prüfen Sie dann die exportierte oder versionierte Darstellung. Bestätigen Sie, dass eine Teamkollegin oder ein Teamkollege die geänderten Skripte prüfen kann, ohne das KI-Gespräch zu wiederholen. Vergewissern Sie sich außerdem, dass Ihre gewählte CLI, Ihr Reporter und Ihr Plan den vorgesehenen Ausführungspfad unterstützen.
Hier wird keine durchgeführte Postman-Generierung vorgestellt. Die nützliche Bewertungsfrage ist, ob sein Workspace-Kontext Ihre Prüfarbeit an einer vorhandenen Collection reduziert. Dafür sind Ihre eigene Collection und ein Test auf Kontoebene erforderlich, nicht eine aus einem Produktscreenshot gezogene Schlussfolgerung.
KushoAI für spezifikationsbasierte Testgenerierung
KushoAI akzeptiert Swagger/OpenAPI-, Postman- und cURL-Eingaben und dokumentiert Testgenerierung, natürlichsprachliche Verfeinerung und CI-Ausführung. Das macht es zu einem Kandidaten, wenn ein Team nützliche API-Definitionen, aber einen Rückstand ungeschriebener Tests hat. Dies sind vom Anbieter beschriebene Fähigkeiten, keine gemessenen Ergebnisse zur Fehlererkennung. (KushoAI-Dokumentation, September 2026)
Wählen Sie die Eingabe mit dem reichhaltigsten vertrauenswürdigen Kontext. Eine cURL-Anfrage kann eine gültige Anfrage beschreiben, sagt aber üblicherweise wenig über optionale Felder, zulässige Enum-Werte oder dokumentierte Fehler aus. Eine OpenAPI-Datei fügt Struktur hinzu; eine genehmigte Szenariomatrix fügt die Absicht hinzu, die die Struktur möglicherweise unklar lässt.
Bitten Sie für einen Petstore-Test um getrennte Fälle für ein gültiges Haustier, einen fehlenden erforderlichen Namen, eine ID mit falschem Typ und einen ungültigen Statusfilter. Prüfen Sie, ob das Tool Anforderungen an den Request-Body von Anforderungen an das Response-Schema unterscheidet. Diese können in einem Beispiel ähnlich aussehen, aber unterschiedliche Verpflichtungen auferlegen.
Untersuchen Sie als Nächstes einen verbundenen Create-Read-Update-Flow. Das Lesen muss die mit dem aktuellen Setup verbundene ID verwenden. Die Aktualisierung muss dieselbe Ressource anvisieren, und ein späteres Lesen muss das geänderte Feld verifizieren. Vier unabhängige Anfragen mit attraktiven Testnamen belegen nicht, dass die Abhängigkeitskette funktioniert.
Behandeln Sie die erste Generierung als Vorschlag. Behalten Sie dokumentierte Erwartungen, überarbeiten Sie Skripte mit falschem Datenfluss und markieren Sie unterspezifizierte Ergebnisse für eine Anforderungsentscheidung. Wenn das Tool mehrere gleichwertige Fälle für fehlende Felder vorschlägt, behalten Sie die nützlichen Unterscheidungen, statt für die Pflege von Duplikaten zu bezahlen.
Bitten Sie vor dem Kauf darum, die Suite aus Ihrer vorgesehenen Pipeline auszuführen und das Fehlerartefakt zu prüfen. Bestätigen Sie die aktuellen CI-Berechtigungen, den Umgang mit Anmeldeinformationen und die verfügbaren Exportformate im ausgewählten Plan. Gehen Sie nicht davon aus, dass ein kostenloser interaktiver Test dieselben Automatisierungsrechte gewährt wie eine Team-Bereitstellung.
Keploy für generierte Tests und Traffic-Replay
Die Dokumentation von Keploy stellt zwei unterschiedliche Ausgangspfade vor. Die KI-Generierung akzeptiert Ressourcen wie OpenAPI, Postman, cURL oder Endpunkte und erstellt verbundene API-Flows. Record and Replay zeichnet API-Interaktionen und ihre Abhängigkeiten für die spätere Ausführung mit Mocks auf. Die Beschreibung des KI-Flows und die Beschreibung der Abhängigkeitsaufzeichnung sollten nicht als identische Mechanismen behandelt werden. (Keploy-Dokumentation, September 2026)
Wenn Ihre Schwierigkeit darin besteht, zu reproduzieren, was eine Anwendung mit einer Datenbank oder einem vorgelagerten Dienst getan hat, bewerten Sie den Aufzeichnungsweg. Zeichnen Sie in einer isolierten Umgebung einen kleinen Create-Read-Update-Durchlauf auf, prüfen Sie die aufgezeichneten Abhängigkeiten und spielen Sie ihn nach einer kontrollierten Anwendungsänderung erneut ab. Prüfen Sie, was die Laufzeit unterstützt, bevor Sie ein größeres Rollout planen.
Wenn Ihre Schwierigkeit darin besteht, Fälle aus einer Spezifikation abzuleiten, bewerten Sie den Generierungsweg separat. Fragen Sie, wie seine vorgeschlagenen Anfragen Anmeldeinformationen erhalten, IDs zwischen Schritten weitergeben und Daten bereinigen. Das Vorhandensein von Aufzeichnungsfunktionen an anderer Stelle im Produkt beantwortet diese Fragen für eine generierte Suite nicht.
Dynamische Werte erfordern Urteilsvermögen. Ein Zeitstempel darf legitimerweise variieren; eine Ressourcen-ID kann zwei Anfragen verbinden und muss daher möglicherweise verglichen werden. Ein pauschales Ignorieren jedes sich ändernden Felds kann Fehler verbergen. Prüfen Sie Ausschlüsse Feld für Feld und behalten Sie Vergleiche bei, die bedeutungsvolle Beziehungen ausdrücken.
Prüfen Sie außerdem die Baseline, bevor Sie sie akzeptieren. Eine Aufzeichnung, die eine falsche Summe, eine versehentliche Fallback-Antwort oder veraltete Daten enthält, kann konsistent erneut abgespielt werden. Konsistenz hilft, Änderungen zu erkennen, aber das Team entscheidet weiterhin, ob das aufgezeichnete Verhalten korrekt war.
Eine nützliche Ergänzung: Schemathesis bietet schema-gesteuertes Property-based API-Testing. Es kann eine API mit generierten Eingaben neben geprüften Beispielen herausfordern. Behandeln Sie es als einen anderen Testmechanismus, nicht als Synonym für einen LLM-Testgenerator. Seine Ergebnisse müssen weiterhin vor dem Hintergrund des Vertrags und der Implementierung interpretiert werden.
Kostenlose KI-Tools für API-Tests: Grenzen und Kosten
„Kostenlos“ kann einen Client, ein begrenztes KI-Kontingent, einen Open-Source-Runner oder einen temporären Test beschreiben. Diese Angebote decken unterschiedliche Teile des Workflows ab. Ein kostenloser Client belegt nicht, dass automatisierte Generierung, geplante Ausführung oder Berichtsexport ebenfalls kostenlos sind.
Wie am 21. September 2026 geprüft, listet der Free-Plan von Postman 50 KI-Credits pro Monat auf. Credits sind seine Abrechnungseinheit; sie bedeuten nicht 50 Tests oder 50 vollständige Suiten. Seine Vergleichstabelle unterscheidet das KI-Kontingent von Ausführung, datengesteuerten Funktionen und Ergebnisexporten. (Postman-Preise, September 2026)
Die aktuelle Preisgestaltung von KushoAI verwendet Developer Edition und Enterprise. Keploy unterscheidet Playground, Pro und Enterprise neben seinem Open-Source-Angebot. Verwenden Sie den aktuellen Kaufbildschirm, um die relevanten Limits zu bestätigen. Ältere Tool-Übersichten können eingestellte Plannamen beschreiben oder Kontingente kombinieren, die separat abgerechnet werden.
| Kostenkomponente | Was in einem Test erfasst werden sollte | Was die Rechnung irreführend machen kann |
|---|---|---|
| Lizenzen und Plan | Editoren, Prüfende, Abrechnungsintervall, erforderliche Funktionen | Jährliche Listenpreise mit monatlichen Verpflichtungen vergleichen |
| KI-Generierung | Credit-Verbrauch für dieselbe genehmigte Aufgabe, einschließlich Wiederholungen | Annehmen, ein Credit entspreche einem Test |
| Ausführung | Lokale Läufe, gehostete Läufe, CI-Jobs, Zeitpläne, Berichte | Interaktive Läufe als Berechtigung für jeden Automatisierungsweg behandeln |
| Unabhängiges Modell | Eingabe- und Ausgabe-Tokens für Entwurf und Prüfung | Wiederholte Übermittlungen der vollständigen Spec ignorieren |
| Engineering-Zeit | Prüfung, Fixture-Reparatur, Fehlertriage, Wartung | Anfängliche Generierungszeit als Gesamtlieferzeit zählen |
Verwenden Sie eine kleine Abnahmeaufgabe, um die Kosten zu schätzen. Geben Sie jedem Kandidaten dieselben Operationen und Erwartungen und erfassen Sie dann, wie viele Szenarien die Prüfung überstehen. Führen Sie Generierungszeit, manuelle Prüfzeit und Ausführungszeit in getrennten Spalten. Das Warten auf ein Modell und das Korrigieren einer gefährlichen Assertion verursachen unterschiedliche Kosten für das Team.
Ein nützlicher Nenner sind geprüfte, ausführbare Szenarien, die Ihr Team behalten würde. Er verhindert, dass ein Generator mit vielen redundanten Fällen allein deshalb günstiger erscheint, weil seine Ausgabe länger ist. Erfassen Sie nicht unterstützte Fälle, die Sie entfernt haben, und Anforderungen, die ungeklärt bleiben.
Dieser Artikel beansprucht weder einen gemessenen Prozentsatz an Arbeitsersparnis noch einen Vergleich des Durchsatzes kostenpflichtiger Pläne. Diese Zahlen erfordern einen kontrollierten Test mit gleichwertigen Eingaben. Beziehen Sie für eine Kaufentscheidung eine realistische Wartungsänderung ein, etwa das Hinzufügen eines erforderlichen Felds, damit die Schätzung sowohl den nächsten Sprint als auch die erste Demo abdeckt.
KI-Tools für API-Tests: Von OpenAPI zum ersten Lauf
Verwenden Sie eine isolierte lokale Instanz des echten Swagger-Petstore-Projekts. Pinnen Sie Commit d57941e8fe959e508796b27469b1e8bba73392dc; seine Spezifikation deklariert OpenAPI 3.0.4 und Anwendungsversion 1.0.29-SNAPSHOT. Lesen Sie die gepinnte Datei statt einer unabhängig aktualisierten öffentlichen Demo. (Swagger-Petstore-Spezifikation, September 2026)
1. Bereiten Sie den Dienst vor und erfassen Sie die Umgebung. Beziehen Sie das Repository über diese Quellseite, checken Sie die gepinnte Revision aus und installieren Sie ein kompatibles JDK und Maven. Die README des Projekts gibt diesen Startbefehl aus dem Repository-Verzeichnis an:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty verwendet Port 8080. Setzen Sie BASE_URL auf Ihren Loopback-HTTP-Ursprung an diesem Port mit angehängtem /api/v3. Bestätigen Sie vor dem Testen, dass /openapi.json relativ zu dieser Basis lesbar ist.
Dieser Lauf verwendete Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 und jsonschema 4.26.0. Erfassen Sie auch Ihre Versionen. Der Quell-Build lädt Abhängigkeiten und Swagger UI herunter, daher ist ein gepinnter Anwendungs-Commit allein kein vollständig hermetischer Build.
2. Importieren Sie die gepinnte Spezifikation. Wählen Sie /pet, /pet/{petId} und /pet/findByStatus aus. Halten Sie Delete für die Bereinigung verfügbar. Überschreiben Sie den öffentlichen Serverstandort der Spezifikation mit Ihrer lokalen Basis. Prüfen Sie diese Einstellung, bevor Sie eine Schreibanfrage senden.
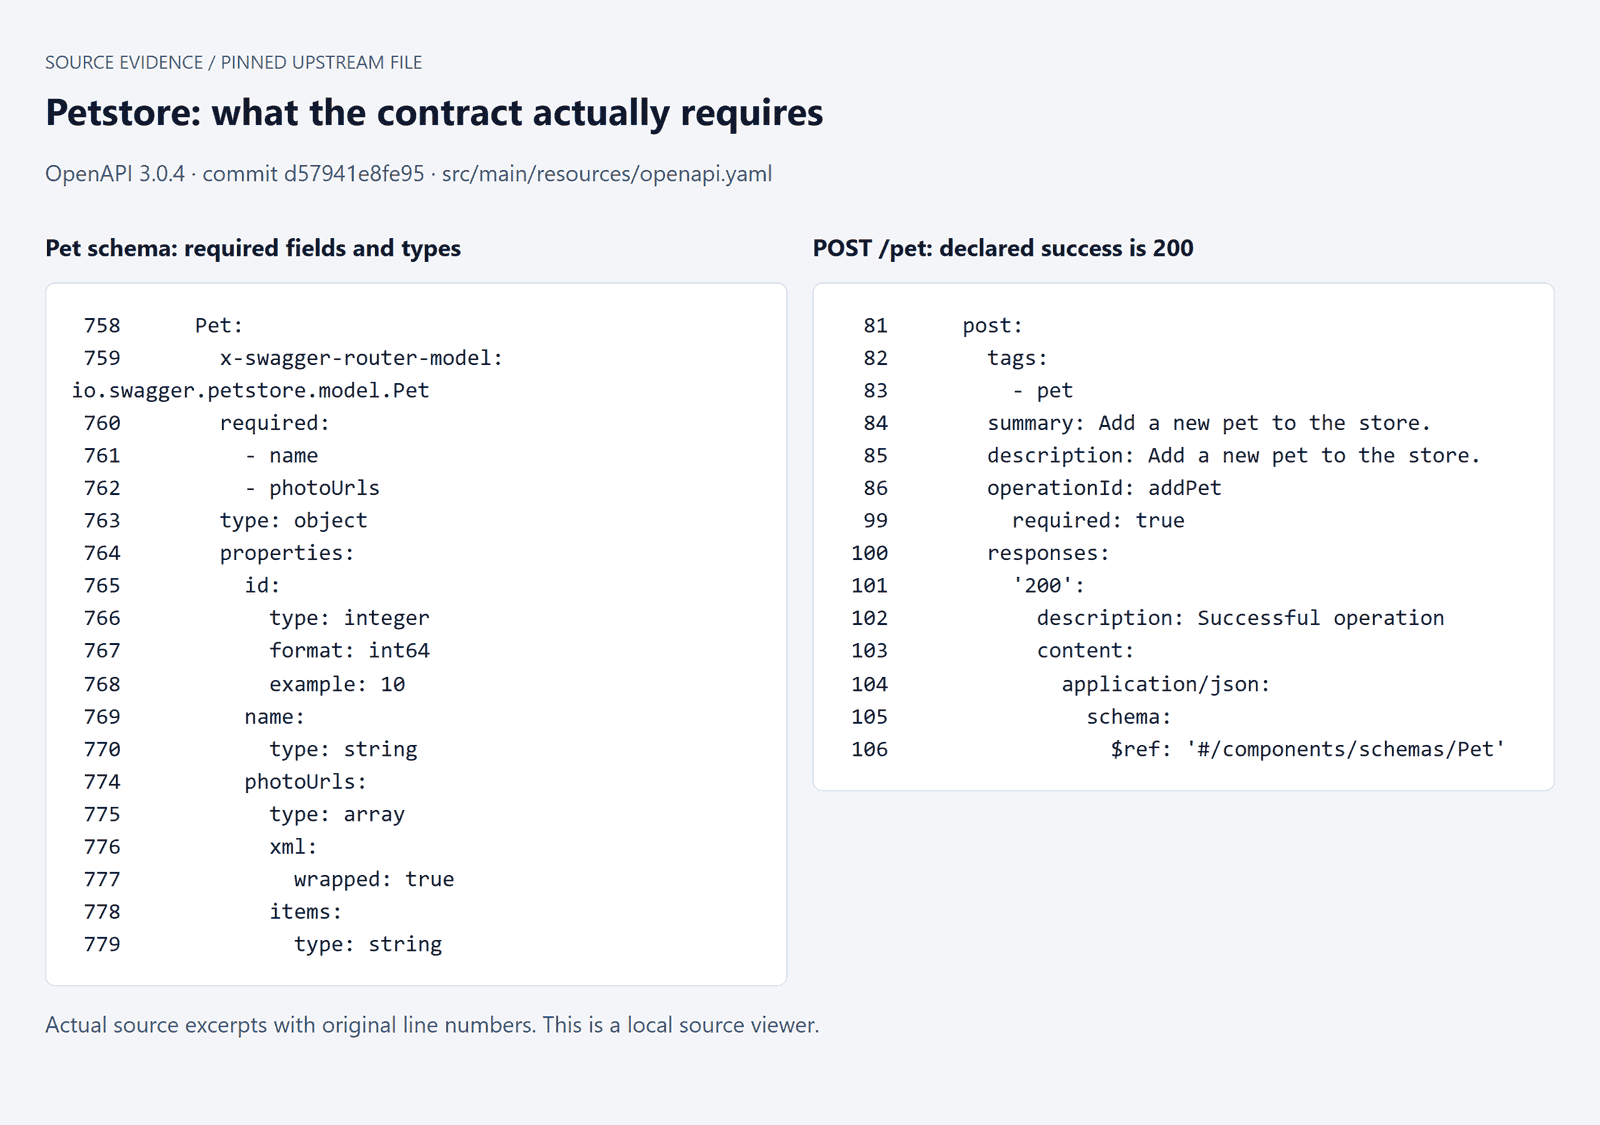 Gepinnte OpenAPI-Petstore-Quelle mit erforderlichen Feldern und ausgewählten Operationsdefinitionen
Echte Quellauszüge lokal gerendert: Pet erfordert name und photoUrls; POST /pet deklariert 200 für Erfolg. Ursprüngliche Zeilennummern bleiben erhalten.
3. Generieren Sie eine Matrix vor ausführbarem Code (Prompt A). Hängen Sie die Spezifikation an und fügen Sie diesen Prompt in Ihren gewählten Generator ein:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Prüfen Sie das Orakel für jedes Szenario. Petstore dokumentiert eine erfolgreiche Erstellung als 200. Sein Pet-Schema erfordert name und photoUrls; id hat einen ganzzahligen Typ, steht aber nicht in dieser erforderlichen Liste. Die Validierung fehlender Felder und die Identität von Anfrage und Antwort erfordern daher unterschiedliche Prüfungen.
| Operation | Eingabe oder Sequenz | Beleg für erwartetes Ergebnis | Zu prüfende Assertion | Ausführungsstatus |
|---|---|---|---|---|
| addPet, getPetById | Erstellen, dann aktuelle ID lesen | Dokumentiert 200 und Pet-Schema; explizite Flow-Erwartung | Body validieren und zurückgegebene ID vergleichen | Lokal bestanden |
| updatePet, getPetById | Namen ändern und erneut lesen | Update-Operation plus genehmigte Fixture-Absicht | Gleiche ID, neuer Name, gültiges Schema | Lokal bestanden |
| findPetsByStatus | Nach Setup available abfragen | Dokumentiertes Enum und erfolgreiche Array-Antwort | Alle zurückgegebenen Statuswerte stimmen überein; erstellte ID ist vorhanden | Lokal bestanden |
| getPetById | Nicht ganzzahlige Pfad-ID | Dokumentiert: ungültige ID 400 | Exakter Status für diesen dokumentierten Fall | Bestanden: 400 |
| findPetsByStatus | Nicht dokumentierter Enum-Wert | Dokumentiert: ungültiger Status 400 | Exakter Status, jede Abweichung beibehalten | Bestanden: 400 |
| addPet | Erforderlichen name weglassen | Erforderliches Schemafeld; 400- und 422-Beschreibungen bilden nicht jede Variation ab | Verhalten erfassen; exakte Zuordnung vor Gating klären | 200 ohne name zurückgegeben; Abweichung beibehalten |
5. Generieren und prüfen Sie die Ausführungsdatei (Prompt B). Hängen Sie die genehmigte Matrix und Spezifikation mit diesem Prompt an:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Ausführen, bewahren und bereinigen. Verwenden Sie eine laufspezifische Haustier-ID, erfassen Sie die Erstellungsantwort und übergeben Sie ihre ID an spätere Anfragen. Validieren Sie die Aktualisierung durch ein frisches Lesen. Eine erfolgreiche Update-Antwort allein beweist nicht, dass der Server die Änderung persistiert hat.
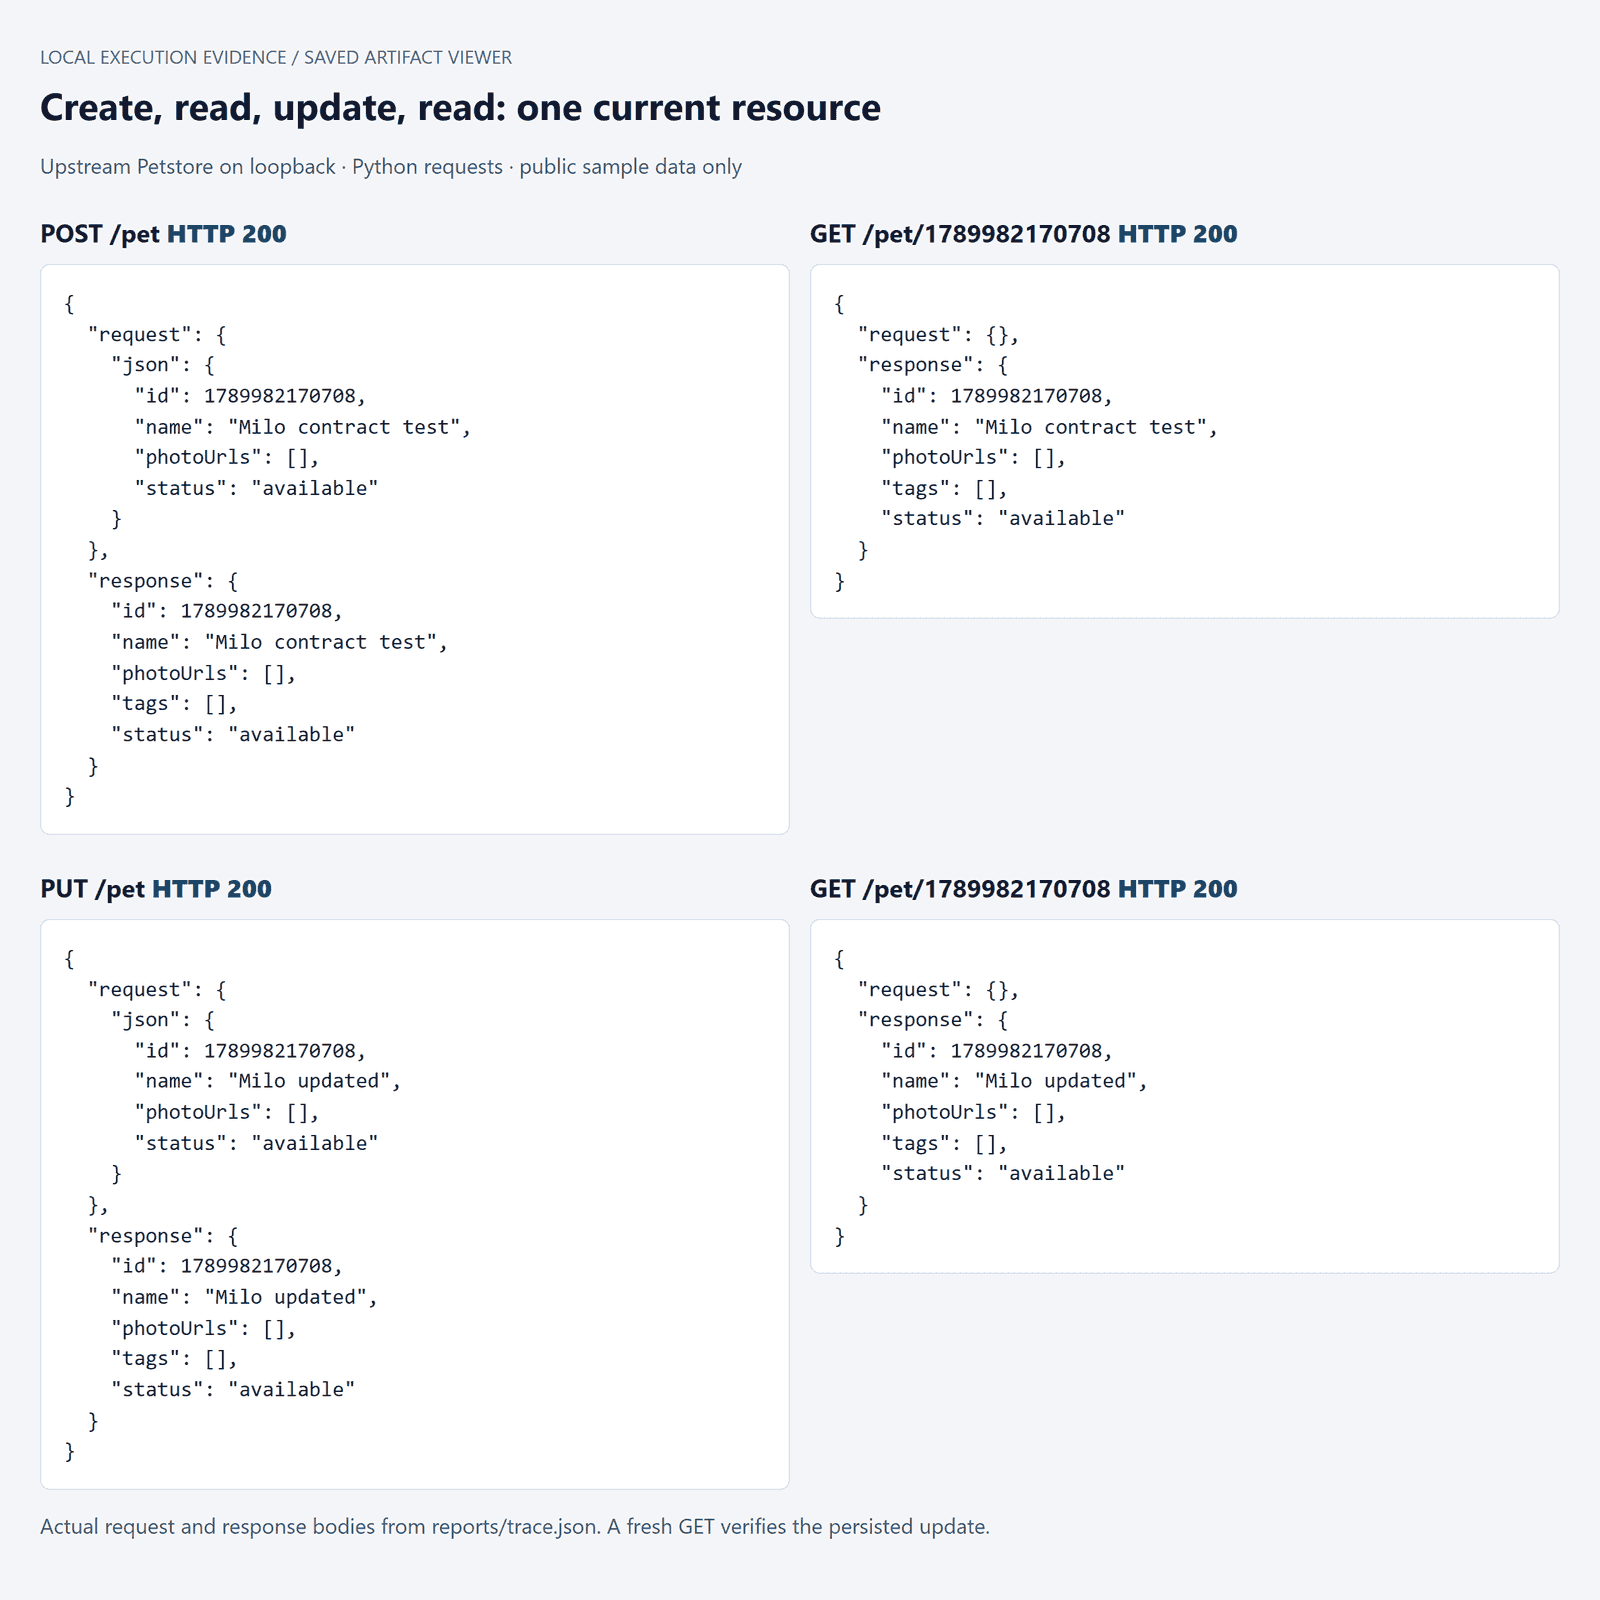 Lokaler Petstore-Anfragekettenbeleg mit Erstellung, Lookup, Aktualisierung und ID-Übergabe
Gespeicherte lokale Anfragen und Antworten: Dieselbe laufspezifische ID übersteht Erstellen, Lesen, Aktualisieren und ein frisches Lesen. Alle 4 angezeigten Anfragen gaben 200 zurück.
Speichern Sie Request-Bodies, Antworten, Assertion-Fehler und das Ergebnis der Bereinigung. Beschränken Sie das Löschen auf IDs, die in diesem Lauf erstellt wurden. Behalten Sie unerwartete Antworten als Befunde, einschließlich Fällen, in denen die Demonstrationsimplementierung ungültige Eingaben akzeptiert. Passen Sie Assertions nicht nur an, um einen grünen Screenshot zu erhalten.
Was dieser Lauf ergab: Die 5 Live-Testfunktionen bestanden, einschließlich Prüfungen auf ungültige ID und ungültigen Status, die 400 zurückgaben. Die separate Prüfung auf fehlenden Namen gab 200 und einen Body ohne name zurück. Wir haben diese Schema-Abweichung außerhalb der grünen Suite beibehalten; ihre genaue beabsichtigte Fehlerzuordnung muss noch geklärt werden. Beide erstellten Datensätze wurden erfolgreich gelöscht.
Die lokalen Tests wurden in diesem Artikellauf unabhängig von den drei kommerziellen Tools entworfen. Alle 5 Live-Tests wurden beibehalten; keiner wurde entfernt oder in seinen Erwartungen nach der Ausführung gelockert. Die menschliche Prüfzeit wurde nicht gemessen. Der Belegordner enthält die Testdateien, Dependency-Lock, Rohantworten und Reproduktionsanweisungen.
So validieren Sie KI-Tools für API-Tests
Eine nützliche Assertion sollte eine relevante falsche Antwort ablehnen. Sie können diese Eigenschaft testen, ohne den laufenden Dienst zu ändern: Speichern Sie eine echte erfolgreiche Antwort, kopieren Sie sie und ändern Sie absichtlich jeweils ein Feld. Dies sind kontrollierte Antwortmutationen, keine Produktionsschwachstellen und kein vollständiger Mutationstesting-Benchmark.
Halten Sie den ursprünglichen Status und Body zusammen. Führen Sie den Validator zuerst gegen die unveränderte Antwort aus und vergewissern Sie sich, dass er die Baseline akzeptiert. Erstellen Sie dann drei unabhängige Kopien. Ändern Sie die ID, ändern Sie den Typ von name und entfernen Sie den erforderlichen name. Jede Kopie sollte aus einem Grund fehlschlagen, der zur Änderung passt.
| Gespeicherte Baseline | Kontrollierte Änderung | Relevante Prüfung | Tatsächliches Ergebnis |
|---|---|---|---|
| Erfolgreicher Lookup des aktuellen Haustiers | Andere ganzzahlige ID einsetzen; Status 200 beibehalten | Zurückgegebene ID entspricht der erwarteten ID dieses Laufs | Fehlgeschlagen: erwartete und tatsächliche ID unterscheiden sich |
String-name | Namen durch eine Zahl ersetzen | String-Typ des Pet-Schemas | Fehlgeschlagen: 42 ist kein String |
Erforderlicher name vorhanden | name entfernen | Erforderliche Liste des Pet-Schemas | Fehlgeschlagen: name ist erforderlich |
Das ID-Beispiel legt eine häufige Schwäche offen. Ein Schema-Validator kann die falsche Ganzzahl akzeptieren, weil die Form weiterhin gültig bleibt. Die Beziehungs-Assertion liefert die fehlende Einschränkung. In den anderen beiden Beispielen liefert die Schema-Validierung Einschränkungen, die eine reine Statusprüfung nicht sehen kann.
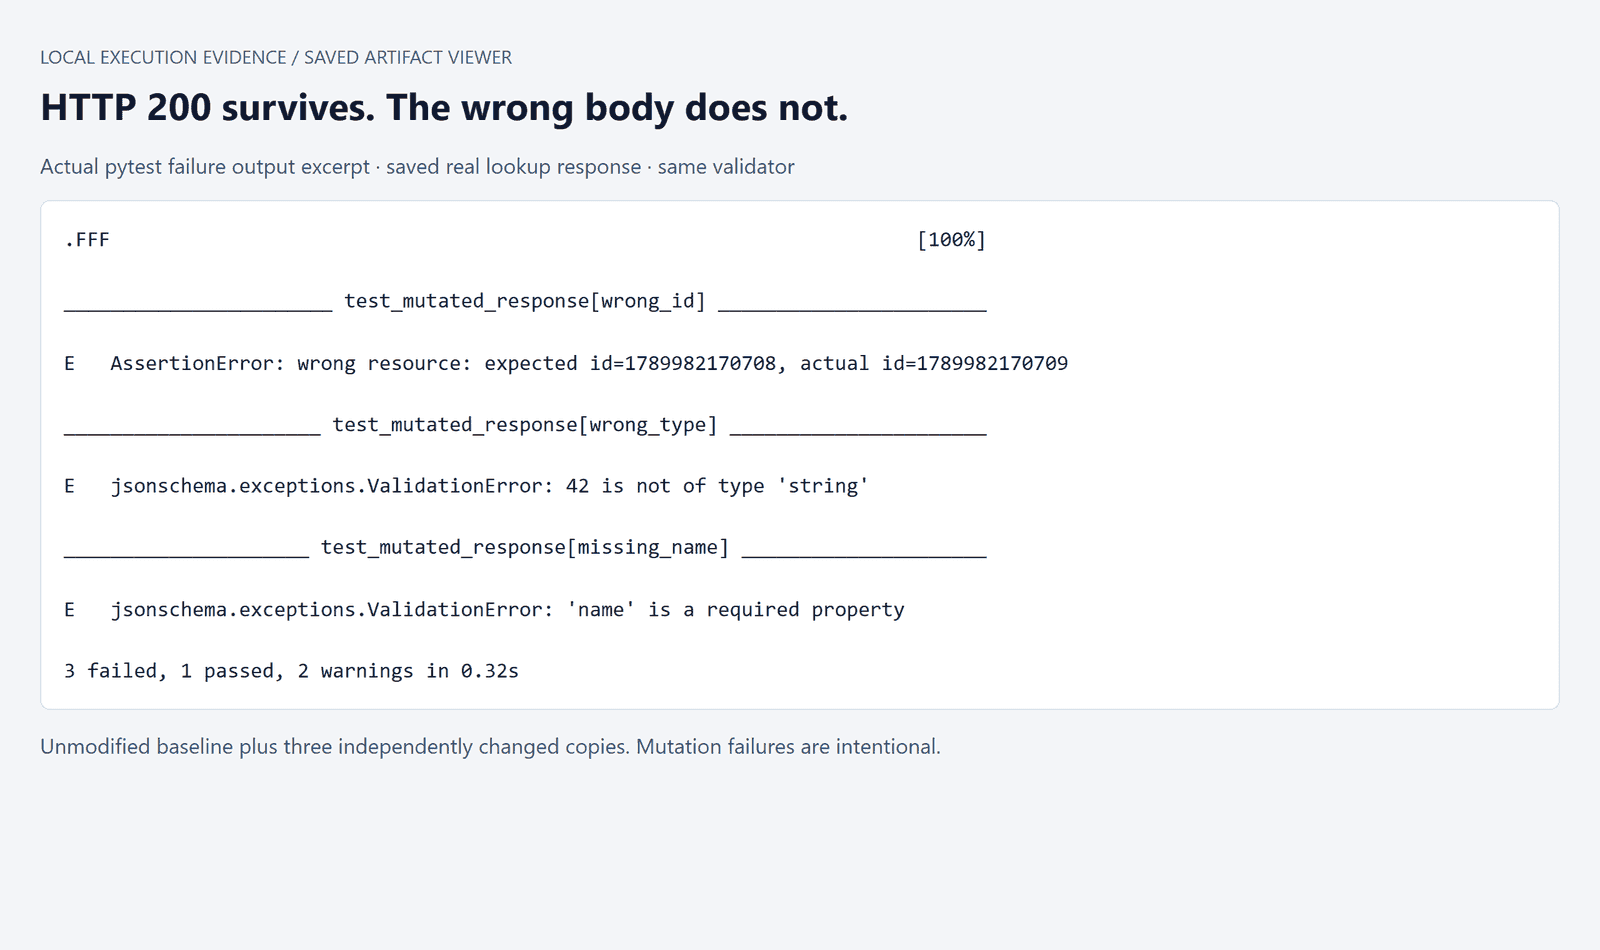 Tatsächliche Assertion-Fehlerausgabe für kontrollierte Petstore-Antwortmutationen
Tatsächliche pytest-Fehlerauszüge: Die ursprüngliche Antwort bestand, und alle 3 unabhängigen Mutationen schlugen fehl. Diese Fehler wurden in gespeicherten Kopien absichtlich herbeigeführt.
In diesem Lauf bestand die unveränderte Baseline, und 3 von 3 geänderten Kopien schlugen fehl. Der Mutationslauf gab Exit-Code 1 zurück und bewahrte das Fehlersignal. Der Validator wendet die relevanten strukturellen Einschränkungen des Pet-Schemas und eine separate ID-Beziehungsprüfung an; diese kleine Demonstration ist kein vollständiger OpenAPI-Konformitätsvalidator.
Für ein wiederholbares Audit hängen Sie die Testdatei und die gepinnte Spezifikation an Prompt C an:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Prüfen Sie vorgeschlagene „selbstheilende“ Änderungen mit besonderer Sorgfalt. Das Ersetzen einer erwarteten 400 durch 200 kann eine Regression verbergen. Eine legitime Vertragsänderung benötigt eine Anforderungsreferenz und eine geprüfte Teständerung. Die beobachtete Antwort ist ein Beleg für die Untersuchung, keine automatische Erlaubnis, Korrektheit neu zu definieren.
Trennen Sie Fehlerkategorien, bevor Sie KI um eine Korrektur bitten. Ein Timeout kann auf eine nicht verfügbare Umgebung hinweisen. Ein Lookup-Fehler kann von einem defekten Fixture stammen. Ein Importfehler gehört zum Testcode. Eine reproduzierbare Abweichung vom vereinbarten Vertrag kann zum Produkt gehören. Bewahren Sie genügend Kontext, um sie zu unterscheiden.
Berichten Sie den Nenner ehrlich. Drei ausgewählte Antwortänderungen zu erkennen, beweist Sensitivität gegenüber diesen drei Änderungen. Es belegt weder Endpunktabdeckung, Codeabdeckung, Sicherheitsabdeckung noch eine allgemeine Fehlererkennungsrate. Ebenso sagt eine große Testanzahl wenig über doppelte Szenarien oder die Stärke ihrer Assertions aus.
Authentifizierung und Autorisierung verdienen unabhängige Tests in einer geeigneten Anwendung: fehlende Anmeldeinformationen, abgelaufene Anmeldeinformationen und Zugriff auf die Ressourcen eines anderen Benutzers. Das Demonstrationsverhalten von Petstore kann nicht belegen, dass Ihre Produktionszugriffskontrollen funktionieren.
KI-Tools für API-Tests in CI/CD
Sobald eine prüfende Person die Suite akzeptiert, committen Sie genau diese Version. Ein Build sollte bekannte Erwartungen gegen die Kandidatenanwendung ausführen. Tests bei jedem Build neu zu generieren, führt eine weitere sich ändernde Komponente ein und macht Fehler schwerer reproduzierbar.
Pinnen Sie Runner, Abhängigkeiten, Fixtures und Spezifikation. Speichern Sie einen Dependency-Lock neben den Tests und bewahren Sie die Anwendungsrevision im Bericht auf. Lösen Sie Geheimnisse aus der CI-Umgebung auf, halten Sie sie aus generierten Dateien heraus und prüfen Sie, dass Fehlerprotokolle sie nicht offenlegen.
Mit pytest ist die grundlegende Berichtsform einfach:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Stellen Sie BASE_URL über die Job-Umgebung bereit. Starten Sie den lokalen Dienst im Job-Lebenszyklus, warten Sie auf Bereitschaft und führen Sie dann die Suite aus. Erfassen Sie immer den Bericht und das Dienstprotokoll, auch bei Fehlern. Beenden Sie den Vorgang, indem Sie den eigenen Dienst des Jobs stoppen und seine Daten bereinigen; vermeiden Sie prozessweite Bereinigungsbefehle auf gemeinsam genutzten Agents.
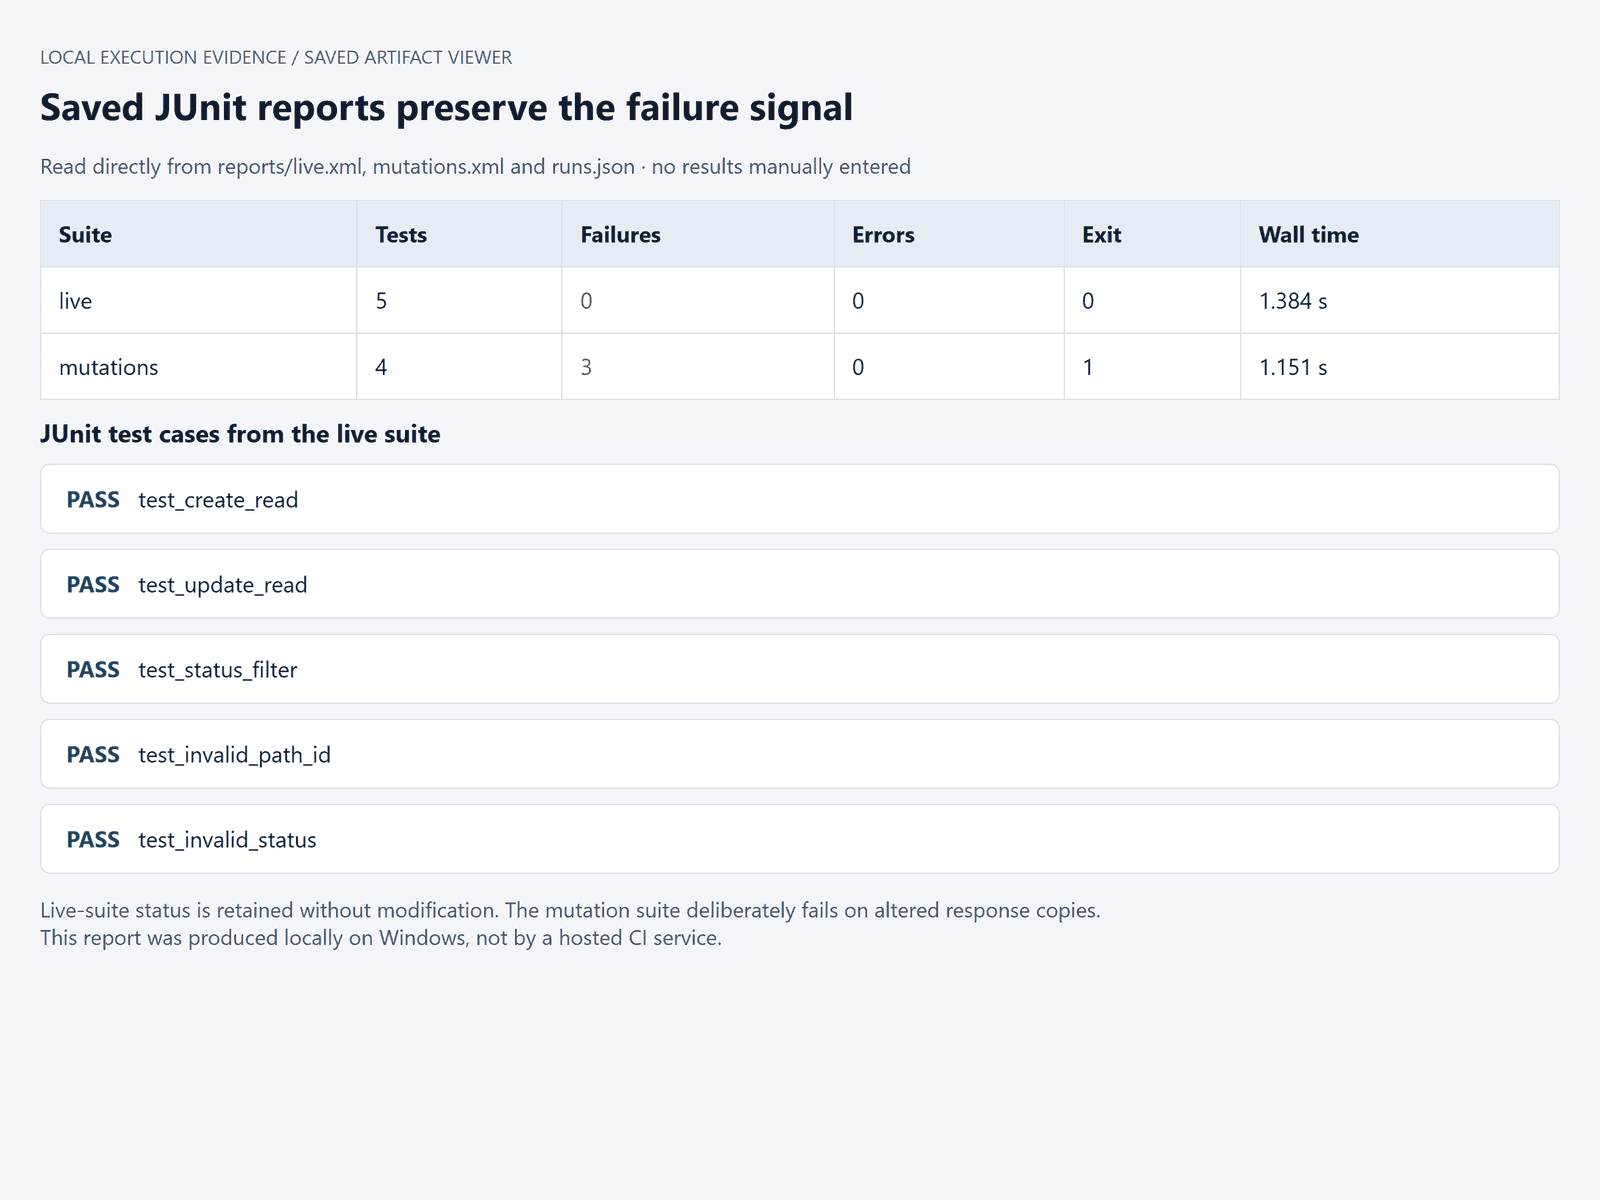 Lokaler pytest-JUnit-Bericht mit getrenntem Live-Vertrags- und Assertion-PrüfergebnissActual local
JUnit-Ergebnisse: 5 Live-Tests bestanden; die Suite mit kontrollierten Kopien enthält 1 bestehende Baseline und 3 absichtliche Fehler. Es wird kein gehosteter CI-Lauf beansprucht.
Die gemessenen Wandzeiten, einschließlich des Starts des Python-Prozesses, betrugen 1,384 Sekunden für die Live-Suite und 1,151 Sekunden für die Suite mit kontrollierten Kopien. Diese schließen Service-Build/Start, Installation von Abhängigkeiten, Entwurf und Prüfung aus. JUnit-Dateien und die ungekürzten Protokolle werden separat gespeichert.
Testen Sie den Fehlerpfad, bevor Sie sich auf das Gate verlassen. Eine fehlgeschlagene Assertion muss einen fehlschlagenden Job-Exit-Code erzeugen. Wiederholungen sollten begrenzt und für bekannte Infrastruktur-Transienten begründet sein; wiederholte Wiederholungen, die schließlich einen Produktfehler verbergen, machen das Gate weniger aussagekräftig.
Behandeln Sie Bereinigungsfehler ausdrücklich. Halten Sie den primären Assertion-Fehler sichtbar, erfassen Sie, welche Ressource verbleibt, und lassen Sie das Teardown sein eigenes Problem melden. Parallele Jobs benötigen getrennte Bezeichner oder Namespaces. Ein Test, der allein besteht, aber die Daten eines anderen Jobs liest, ist nicht für den unbeaufsichtigten Einsatz bereit.
Wenn Sie bereits pytest haben, können Sie das Entwurfsmodell separat wählen. Atlas Cloud passt zu dieser engeren Rolle: eine Modellschicht für einen benutzerdefinierten Workflow, dessen Ausführung und Berichterstattung bereits existieren. Es wird hier nicht als vollständige API-Testing-Plattform oder natives Backend für die drei oben genannten Produkte vorgestellt.
Öffnen Sie für diese Bewertung DeepSeek V4.1 Flash, Modell-ID deepseek-ai/deepseek-v4.1-flash, und stellen Sie dieselbe öffentliche Spezifikation und geprüfte Matrix bereit, die lokal verwendet wurden. Verwenden Sie Prompt B und speichern Sie dann den zurückgegebenen Entwurf getrennt vom geprüften Test. Vergleichen Sie seine Annahmen mit dem Vertrag, bevor Sie irgendetwas ausführen.
Falls von der Schnittstelle angeboten, ist eine Temperatur von 0,2 eine Ausgangseinstellung für den Entwurf, keine Garantie für Determinismus. Prüfen Sie das verfügbare Ausgabelimit vor dem Hintergrund der Größe Ihrer Suite. Konsultieren Sie den aktuellen Modellkatalog für Token-Preise, statt anhand eines alten Artikels zu budgetieren.
Die Arbeitsteilung bleibt ausdrücklich: Das Modell schlägt Code vor, eine prüfende Person genehmigt Erwartungen, und der Runner erzeugt Ergebnisse. Das Zugriffsgate für die Testumgebung verhinderte einen abgeschlossenen Atlas-Lauf für diesen Artikel, daher ist dies ein Bewertungsrezept und kein gemessenes Modellergebnis. Sie können diesen Weg bewerten, ohne einen funktionierenden Test-Runner zu migrieren oder seine Ausführungsverantwortlichkeiten an ein Chatmodell zu übergeben.
Auswahl von KI-Tools für API-Tests für Ihr Team
Wählen Sie die kleinste Bewertung, die Ihre Entscheidung ändern kann. Verwenden Sie einen verbundenen Workflow, einen dokumentierten Negativfall und einige kontrollierte falsche Antworten. Halten Sie die Eingaben über Kandidaten hinweg gleichwertig. Eine ausgefeilte Onboarding-Erfahrung sollte nicht schwerer wiegen als ein Test, der die falsche Ressource nicht erkennen kann.
Bewerten Sie für einen ausgereiften Collection-Workflow zunächst die KI-Funktionen in diesem Workspace. Vorhandene Umgebungskonfiguration und Anfrageabhängigkeiten sind wertvoller Kontext. Messen Sie, ob die generierten Änderungen Prüfaufwand sparen, ohne fragile Annahmen einzuführen.
Bewerten Sie für ein Team mit einer soliden Spezifikation und einem Schreib-Rückstand die spezifikationsbasierte Generierung. Achten Sie darauf, was passiert, wenn die Spezifikation unvollständig ist. Ein Generator, der fehlende Erwartungen klar kennzeichnet, ist leichter zu prüfen als einer, der sie selbstbewusst erfindet.
Bewerten Sie für eine Anwendung, deren Fehler von vorgelagertem Verhalten abhängen, Aufzeichnung und Wiedergabe. Prüfen Sie aufgezeichnete Baselines und Abhängigkeitsunterstützung, bevor Sie in große Aufzeichnungen investieren. Entscheiden Sie, welche dynamischen Felder variieren dürfen und welche Beziehungen intakt bleiben müssen.
Bewerten Sie für ein Team mit einem stabilen Runner ein unabhängiges Modell für Entwurf und Prüfung. Sie behalten das bereits bekannte Ausführungsformat, besitzen aber auch Integration, Fixture-Design und Wartung. Beziehen Sie diesen Besitz in die Kostenberechnung ein.
Bevor Sie für KI-Tools für API-Tests bezahlen, verlangen Sie fünf konkrete Nachweise:
- Die geprüfte Suite läuft gegen Ihre vorgesehene Umgebung.
- Relevante kontrollierte Fehler lassen die passenden Assertions fehlschlagen.
- Tests und nützliche Berichte können in einem akzeptablen Format aufbewahrt werden.
- Wiederholte Läufe, einschließlich CI-Ausführung, bewahren Isolierung und Fehlersignale.
- Kosten für Generierung, Ausführung und Wartung passen zum Budget des Teams.
Weisen Sie jemanden zu, die akzeptierte Suite zu pflegen. Eine Spezifikationsänderung sollte eine Prüfung der betroffenen Assertions, Fixtures und Konsumenten auslösen. Bewahren Sie die alten Fehlerbelege auf, bis die Änderung verstanden ist. Das macht die nächste Version leichter bewertbar und gibt dem Team einen Grund, einem grünen Bericht zu vertrauen.
Häufig gestellte Fragen
Welches KI-Tool sollte ich für API-Tests verwenden?
Beginnen Sie mit Ihren vorhandenen Eingaben. Bewerten Sie Postman Agent Mode für etablierte Collections, KushoAI für spezifikationsgeführte Generierung und Keploy für seine unterschiedlichen Wege der generierten Flows und der Aufzeichnung. Wenn Ihr Team bereits pytest oder einen anderen Runner pflegt, kann ein separates Entwurfsmodell passen. Verwenden Sie denselben kleinen Workflow, um Assertions, Ausführung und Prüfaufwand jedes Kandidaten zu bewerten.
Gibt es kostenlose KI-Tools für API-Tests?
Es gibt kostenlose Clients, Open-Source-Testtools und begrenzte KI-Kontingente. Sie decken unterschiedliche Bedürfnisse ab. Der Free-Plan von Postman listet Stand 21. September 2026 50 monatliche KI-Credits auf; das ist keine Testanzahl. Prüfen Sie, ob Ihre erforderlichen Export-, Automatisierungs-, Berichterstattungs- und Kollaborationsfunktionen enthalten sind, bevor Sie einen interaktiven Test als kostenlose CI-Lösung betrachten.
Kann KI API-Tests aus einer OpenAPI-Spezifikation generieren?
Ja, ein Generator kann Operationen, Schemas, Parameter und Antwortdefinitionen verwenden, um Tests vorzuschlagen. Die Spezifikation kann dennoch Geschäftsregeln auslassen oder Fehlerzuordnungen mehrdeutig lassen. Stellen Sie genehmigte Erwartungen bereit und prüfen Sie das Ergebnis. Im gepinnten Petstore-Beispiel ist eine erfolgreiche Erstellung als 200 dokumentiert, was veranschaulicht, warum vertraute REST-Konventionen den tatsächlichen Vertrag nicht ersetzen können.
Wie erkenne ich, ob KI-generierte Assertions nützlich sind?
Prüfen Sie drei Dinge: dokumentierte Schema-Einschränkungen, Beziehungen zwischen Anfragen und Antworten und Sensitivität gegenüber absichtlich falschen Daten. Speichern Sie eine echte Antwort, ändern Sie eine relevante Eigenschaft und führen Sie denselben Validator erneut aus. Behalten Sie die Fehlermeldung. Dies liefert enge, reproduzierbare Belege zu diesen Assertions, während breitere Abdeckungs- und Sicherheitsfragen für separate Tests offenbleiben.
Kann ich KI-generierte API-Tests in CI/CD ausführen?
Ja, wenn das generierte Format, der Runner, die Umgebung und der Plan diesen Weg unterstützen. Committen Sie geprüfte Tests, installieren Sie gepinnte Abhängigkeiten, verwenden Sie isolierte Fixtures und exportieren Sie einen strukturierten Bericht wie JUnit. Vergewissern Sie sich, dass Fehler einen Exit-Code ungleich null zurückgeben. Ein erfolgreicher lokaler Lauf bereitet die Suite auf CI vor; er beweist nicht, dass eine gehostete Pipeline ausgeführt wurde.
Kann KI manuelles API-Testing ersetzen?
KI kann wiederholtes Entwerfen reduzieren und Prüfenden helfen, schwache Assertions zu finden. Menschen entscheiden weiterhin über beabsichtigtes Verhalten, untersuchen mehrdeutige Fehler und erkunden Risiken außerhalb der bereitgestellten Beispiele. Verwenden Sie KI-Tools für API-Tests, um prüfbare Testartefakte zu erstellen, und beurteilen Sie sie dann anhand reproduzierbarer Belege. Eine kleinere Suite, die aussagekräftige Fehler erkennt, ist leichter zu vertrauen als eine unerklärte Sammlung grüner Prüfungen.


