DeepSeek Harness war nicht Teil dieses Benchmarks. Es wurde zwei Tage später veröffentlicht. Das bedeutet, die relevante Frage ist nicht „Welcher hat gewonnen?“. Die relevante Frage ist, wie man dieselbe Aufgabe mit beiden Tools, auf demselben Modell, ausführt und die Abrechnung liest, ohne sich selbst zu täuschen.
Wichtige Erkenntnisse
- Die Wahl des Harness kann den Token-Verbrauch bei vergleichbaren Agent-Aufgaben um etwa das 7-fache schwanken lassen.
- Messen Sie DeepSeek Harness und OpenCode mit demselben Modell und demselben Repository-Zustand.
- Verwenden Sie separate API-Schlüssel, bevor Sie sich für den täglichen Gebrauch entscheiden.
Zwei Laptops, die dieselbe Codierungsaufgabe mit zwei Agent-Harnesses ausführen
Das faire Setup: ein Modell, eine Aufgabe, zwei Terminals.
Was der öffentliche Benchmark uns sagt
Composio führte 30 komplexe Multi-App-Workflows mit 8 Agent-Harnesses durch, alle mit DeepSeek V4 Flash, einem 900-Sekunden-Limit pro Aufgabe und binärer programmatischer Bewertung über 240 Läufe (Composio, August 2026). Gleiches Modell, unterschiedlicher Harness.
| Harness | Bestehensquote | Medianzeit | Durchschn. Tokens pro Aufgabe |
|---|---|---|---|
| Pi Agent | 66,7 % | 132,2 s | 559.000 |
| Prime Agent | 62,5 % | 242,1 s | 1.400.000 |
| OMP | 56,7 % | 272,4 s | 742.000 |
| Claude Code | 53,3 % | 122,7 s | 742.000 |
| Codex | 53,3 % | 245,0 s | 678.000 |
| DeepAgents | 53,3 % | 187,1 s | 665.000 |
| Hermes Agent | 50,0 % | 175,5 s | 192.000 |
| OpenCode | 46,7 % | 129,7 s | 692.000 |
Die Token-Spalte ist wichtiger als die Rangliste. Die Spanne reicht von 192.000 bis 1.400.000 durchschnittliche Tokens pro Aufgabe. Das ist dasselbe Modell, das durch verschiedene Laufzeiten vergleichbare Arbeit leistet.
OpenCode liefert eine nachvollziehbare Basislinie: 692.000 Tokens pro Aufgabe, 46,7 % Bestehensquote und 129,7 Sekunden Medianzeit. DeepSeek Harness hat keine öffentliche direkte Vergleichszahl aus diesem Benchmark, da DeepSeek es am 13. August 2026 veröffentlichte, zwei Tage nachdem der Benchmark veröffentlicht wurde.
Verwenden Sie die Tabelle als Warnung, nicht als Urteil. Sie zeigt, dass der Harness die Kosten dominieren kann. Sie beweist nicht, ob DeepSeek Harness OpenCode in Ihrem Repository schlägt.
Was sich ändert, wenn Sie den Harness wechseln
Vergleichen Sie vor dem Testen die beiden Tools anhand der Aspekte, die einen entwickelnden Entwickler betreffen: Einrichtungsaufwand, Reife, Token-Transparenz und wie viel der Agent-Schleife Sie ersetzen können.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Von | DeepSeek AI | Anomaly (ursprünglich SST) |
| Veröffentlicht | 13. August 2026 | Ende 2025 |
| GitHub-Sterne | ~143k | ~198k |
| Lizenz | MIT | MIT |
| Sprache | TypeScript | Go |
| Schnittstelle | Web-UI auf 127.0.0.1:3080 | Terminal-TUI |
| Status | Entwicklervorschau, breaking changes erwartet | Ausgereift, weit verbreitet |
| Architektur | Austauschbare Plugins für Modelle, Tools, Sitzungen, Sandboxes, Speicher, Schleifen und UI | Fester Kern mit Build/Plan-Agenten, MCP-Unterstützung und LSP-Erweiterungen |
| Konfiguration | $DSH_HOME/settings.yaml | opencode.json |
| Token-Abrechnung | Token-Meter mit Kontextdruck und Aufschlüsselungsprognosen | Sitzungsbezogene Token- und Kostenverfolgung im TUI |
| Am besten geeignet für | Teams, die die Agent-Schleife selbst modifizieren möchten | Teams, die einen Codierungs-Agenten wollen, der heute funktioniert |
OpenCode bietet Ihnen einen stabilen Codierungs-Agenten mit Erweiterungspunkten an den Rändern. DeepSeek Harness bietet Ihnen eine Laufzeit, bei der die Schleife selbst ausgetauscht werden kann. Diese Flexibilität hilft, wenn Sie Agent-Infrastruktur aufbauen. Sie erhöht das Risiko, wenn Sie ein Standardwerkzeug für Produktionscode in dieser Woche benötigen.
Beide Tools können denselben OpenAI-kompatiblen Endpunkt ansteuern. Das ermöglicht einen fairen Test: ein Modell, eine Basis-URL, eine Aufgabe und ein Start-Repository-Zustand.
Für diese Anleitung läuft DeepSeek V4 Flash über Atlas Cloud, das einen OpenAI-kompatiblen Endpunkt bereitstellt, der von beiden Tools akzeptiert wird. Der Eintrag deepseek-v4-flash-0731 zeigt 0,14 $ pro Million Eingabe-Tokens, 0,28 $ pro Million Ausgabe-Tokens, ein Kontextfenster von 1.048.576 Tokens und maximal 393.216 Ausgabe-Tokens (Stand August 2026). Jeder Anbieter funktioniert, solange beide Harnesses denselben Endpunkt und Modellnamen verwenden.
OpenCode veröffentlicht auch aggregierte Nutzungsdaten. DeepSeek-Modelle haben 233 Billionen Tokens durch OpenCode bewegt, wobei V4 Flash 85,5 % und V4 Pro 14,5 % ausmacht (OpenCode, August 2026). Dieses Nutzungsmuster macht V4 Flash zu einer praktischen Standardeinstellung für den Vergleich.
Schritt 1: Beide Tools auf dasselbe Modell ausrichten
Erstellen Sie einen API-Schlüssel und eine Basis-URL, und füttern Sie dann beide Tools mit demselben Paar. Erstellen Sie den Schlüssel in der Atlas Cloud-Konsole und exportieren Sie ihn einmal:
plaintext1export ATLAS_API_KEY="your-api-key"
Überprüfen Sie den Endpunkt, bevor Sie ihn an einen der Harnesses übergeben:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }'
Dieser Aufruf beweist, dass die Route, der Schlüssel und die Modell-ID funktionieren, bevor ein Harness Tools, Wiederholungen oder Konversationswiedergaben hinzufügt.
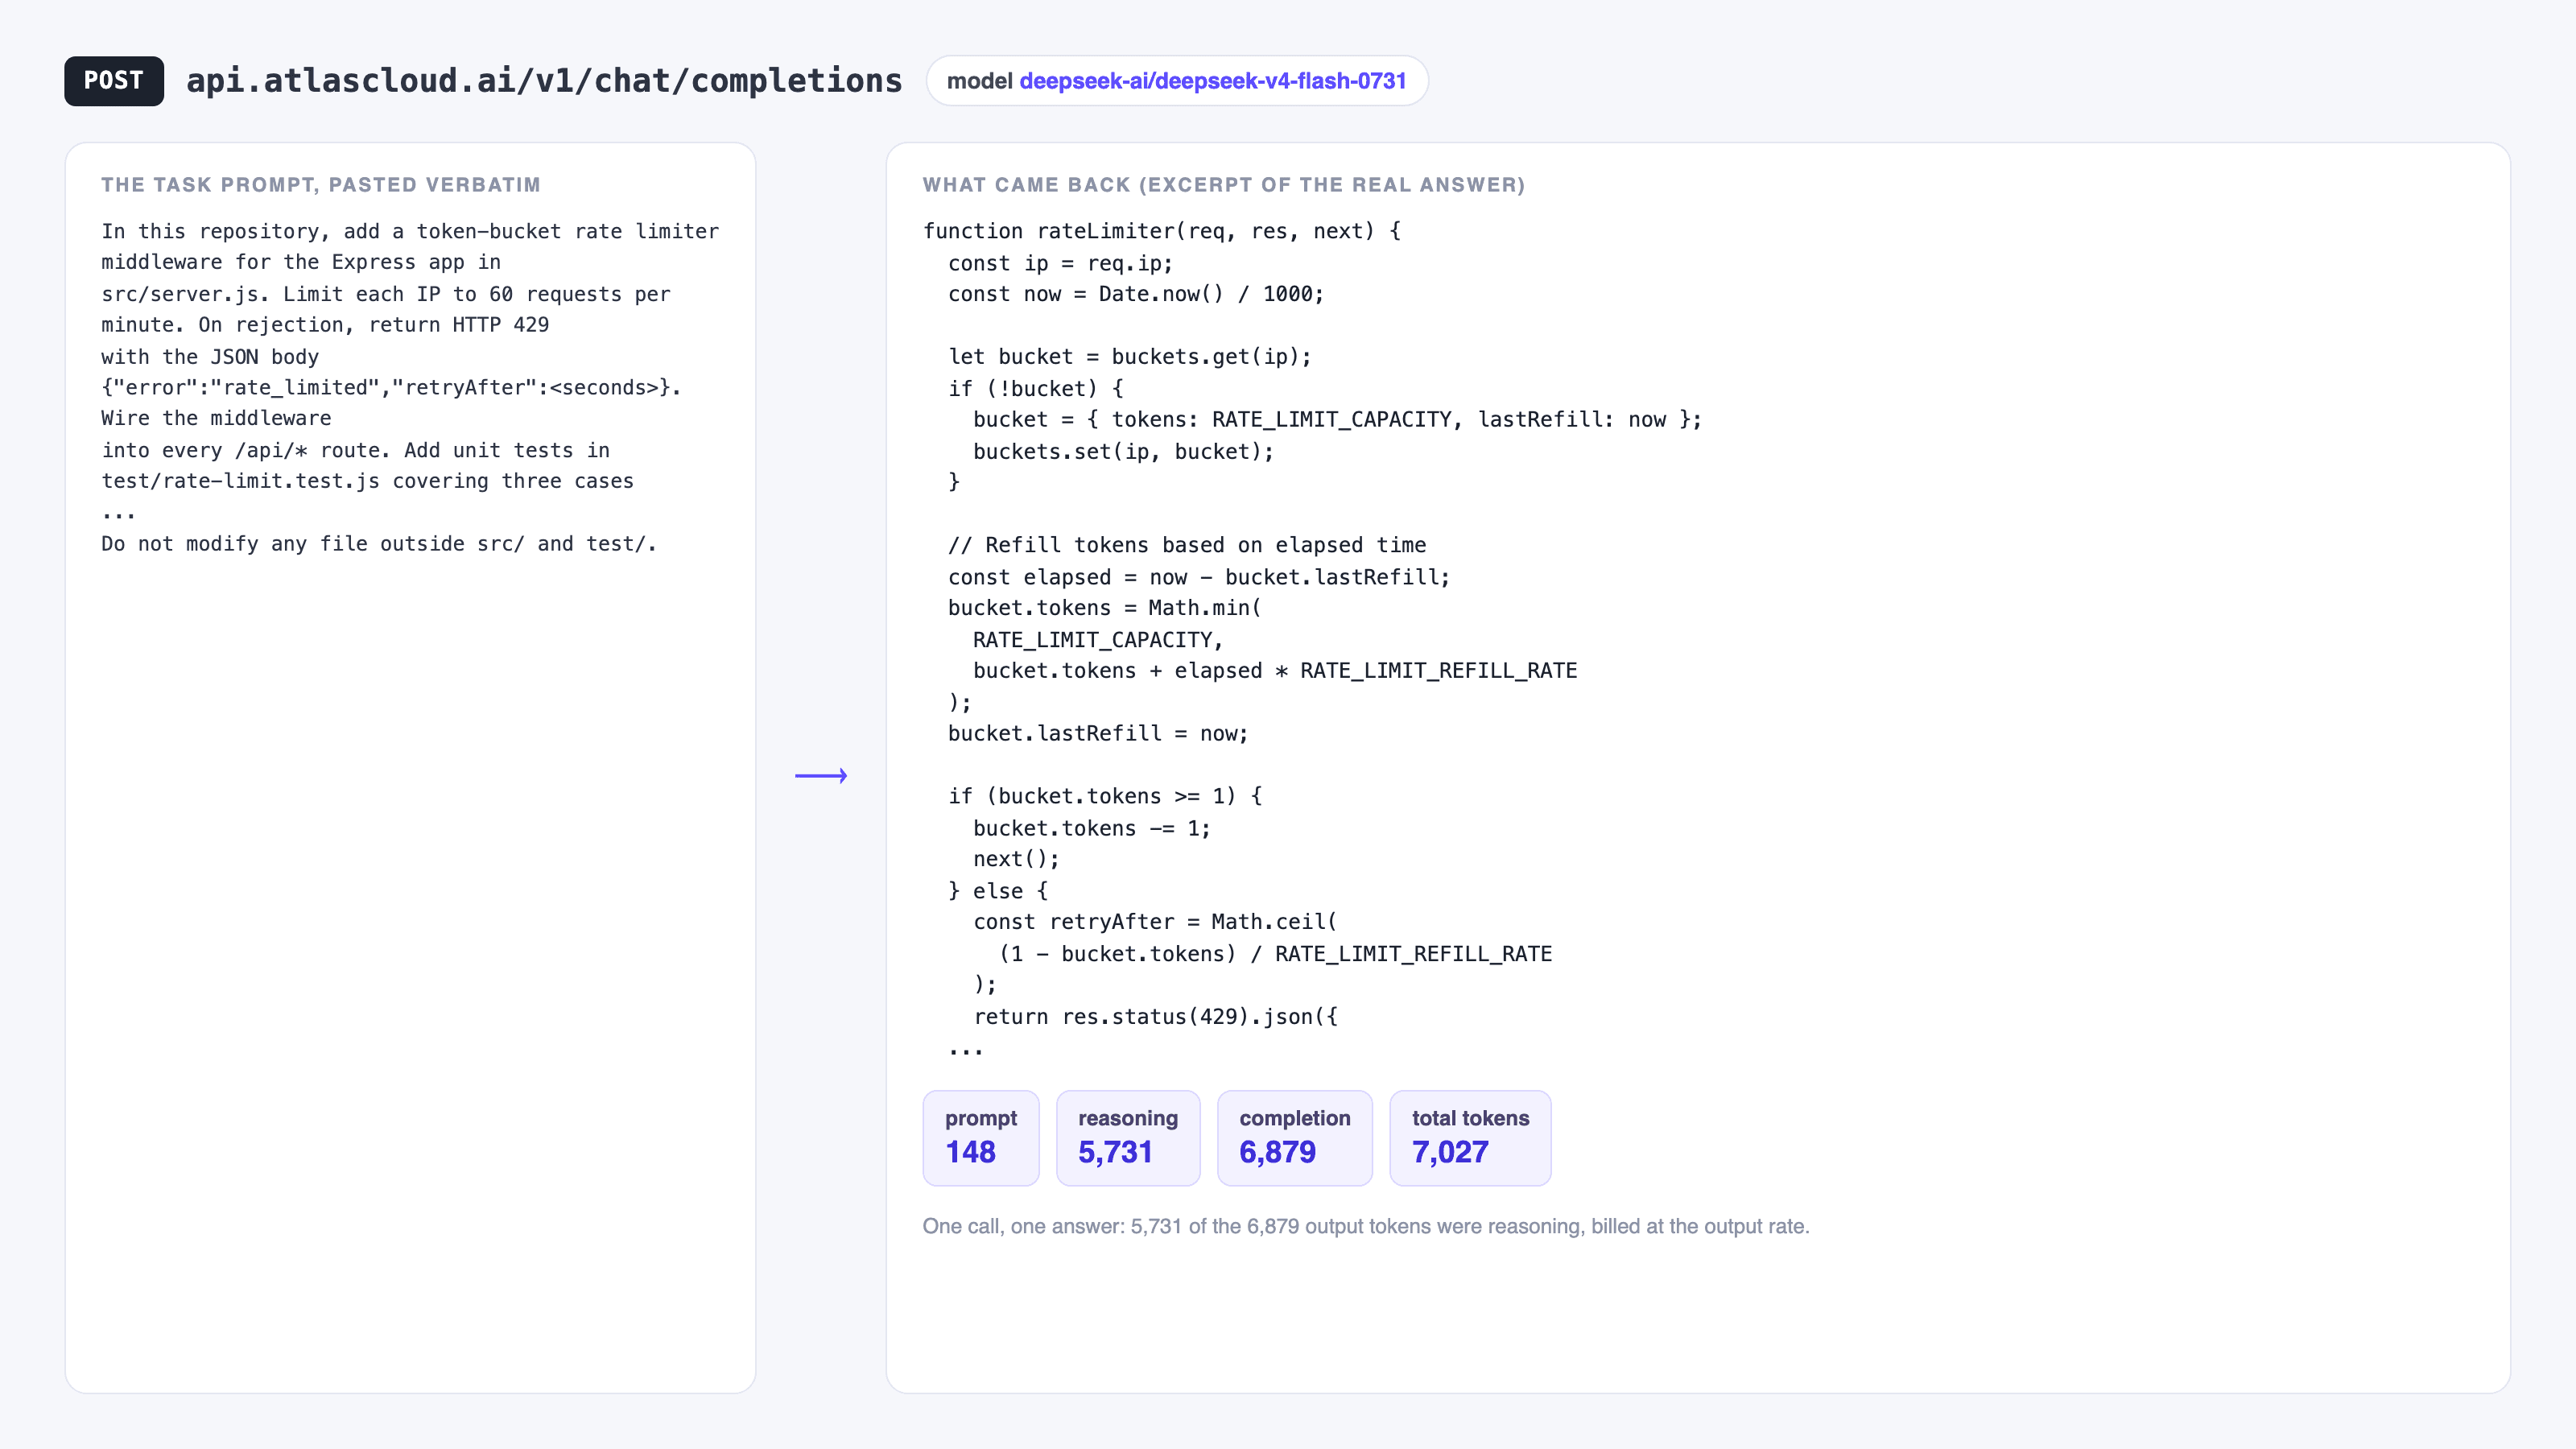
Codierungsaufforderung, generierter Code und Token-Statistiken aus einem Modellaufruf
Ein direkter Aufruf von deepseek-ai/deepseek-v4-flash-0731: 148 Eingabe-Tokens, 6.879 Ausgabe-Tokens zurück, darunter 5.731 Reasoning-Tokens. Betrachten Sie dies als Basislinie, bevor ein Harness Tool-Schemas und Verlauf hinzufügt.
DeepSeek Harness liest $DSH_HOME/settings.yaml, und benutzerdefinierte OpenAI-kompatible Anbieter werden unter dem Plugin llm-pi-ai eingetragen (DeepSeek Harness-Dokumentation, August 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731
Verwenden Sie openai-completions für diesen Endpunkt. Das Web-UI kann denselben Anbieterblock unter Einstellungen, Modelle, Benutzerdefinierten Anbieter hinzufügen schreiben, und dann den Schlüssel in $DSH_HOME/.credentials.yaml speichern.
OpenCode liest opencode.json im Projektstammverzeichnis oder im globalen Konfigurationsverzeichnis (OpenCode-Dokumentation, August 2026):
json1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20}
Verwenden Sie @ai-sdk/openai-compatible, da dieser Endpunkt /v1/chat/completions bedient. Setzen Sie die tatsächlichen Kontext- und Ausgabelimits. OpenCode verwendet sie, wenn es entscheidet, wann zusammengefasst werden soll, und falsche Limits können den Token-Vergleich verzerren.
Schritt 2: Dieselbe Benchmark-Aufgabe in DeepSeek Harness ausführen
Wählen Sie eine Aufgabe, die groß genug ist, um mehrere Tool-Aufrufe zu benötigen, und klein genug, um sie zu bewerten. Verwenden Sie für beide Läufe denselben Repository-Zustand, committen oder stashen Sie also vor dem Start.
Fügen Sie diese genaue Aufgabe in beide Tools ein:
plaintext1In this repository, add a token-bucket rate limiter middleware for the Express 2app in src/server.js. Limit each IP to 60 requests per minute. On rejection, 3return HTTP 429 with the JSON body {"error":"rate_limited","retryAfter":<seconds>}. 4Wire the middleware into every /api/* route. Add unit tests in 5test/rate-limit.test.js covering three cases: a request under the limit is 6allowed, a request over the limit is blocked with 429, and the counter resets 7after the window expires. Run the test suite and fix failures until it passes. 8Do not modify any file outside src/ and test/.
Starten Sie Harness von Ihrem Projektverzeichnis aus:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web
Die UI läuft unter http://127.0.0.1:3080. Wählen Sie den atlas-Anbieter und das Modell deepseek-ai/deepseek-v4-flash-0731, fügen Sie die Aufgabe ein und lassen Sie sie beenden. Geben Sie nach dem Start des Laufs keine Hinweise. Zusätzliche Hilfe für ein Tool macht den Vergleich ungültig.
Wenn Harness fertig ist, öffnen Sie die Trajectory-Ansicht. Dieser Sitzungsdatensatz enthält die Token-Zahlen.
Schritt 3: Den Lauf in OpenCode wiederholen
Setzen Sie das Repository auf den exakten Startzustand zurück. Der zweite Harness darf keine Dateien erben, die der erste bereits geändert hat.
plaintext1git checkout -- . && git clean -fd
Führen Sie dann OpenCode mit demselben Modell aus:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731
Fügen Sie dieselbe Aufgabenaufforderung aus Schritt 2 ein. Verwenden Sie den Standard-build-Agenten. Lassen Sie es ohne Hinweise beenden.
Bewerten Sie beide Läufe mit demselben Befehl:
plaintext1npm test
Ein Lauf, der die Suite rot hinterlässt, ist fehlgeschlagen, selbst wenn die Agent-Zusammenfassung zuversichtlich klingt. Verwenden Sie binäre Bewertung: bestanden oder nicht bestanden.
Schritt 4: Token-Verbrauch ablesen
Beide Tools verfolgen die Nutzung, aber keiner der Zähler sollte Ihre endgültige Rechnungsnummer sein.
DeepSeek Harness enthält ein standardmäßig aktiviertes Token-Meter. Es zeigt tokenUsage, contextPressure und contextBreakdown in der Trajectory-Ansicht an. contextBreakdown sagt Ihnen, ob die Rechnung vom System-Prompt, Tool-Schemas, Datei-Lesevorgängen oder Konversationswiedergabe stammt. Das Meter schätzt ungefähr ein Token pro vier Zeichen, verwenden Sie es also als Diagnoseansicht.
OpenCode verfolgt Tokens und Kosten pro Sitzung und zeigt sie in der TUI-Statuszeile an. Seine integrierte Aufschlüsselung ist kleiner, daher untersuchen Teams, die eine Pro-Tool-Zuordnung benötigen, die Sitzungsdatenbank oft mit externen Analyzern.
Verwenden Sie für den Vergleich die Zahlen des Anbieters:
| Was vergleichen | Woher bekommen |
|---|---|
| Gesamte Eingabe-Tokens | Dashboard des Anbieters, pro API-Schlüssel |
| Gesamte Ausgabe-Tokens | Dashboard des Anbieters, pro API-Schlüssel |
| Anzahl der Modellaufrufe | Harness-Trajectory-Ansicht / OpenCode-Sitzungsprotokoll |
| Wanduhrzeit | Stoppuhr, Start bis zur letzten Dateischreiboperation |
| Bestanden oder nicht bestanden | npm test Exit-Code |
Erstellen Sie zwei API-Schlüssel, harness-test und opencode-test, und verwenden Sie jeden Schlüssel für einen Lauf. Das Dashboard des Anbieters liefert Ihnen dann eine saubere Seite-an-Seite-Nutzung, ohne zwei interne Schätzer abzugleichen.
Warum die Rechnung schwankt
Der Token-Verbrauch ändert sich aus konkreten Gründen. Diese fünf sind in der Regel wichtiger als der Modellpreis.
Konversationswiedergabe summiert sich. Agenten senden die wachsende Konversation bei jedem Schritt erneut. Eine 40-Schritte-Aufgabe kostet eher die Summe von 40 wachsenden Prompts als 40 identische Prompts. Harnesses, die früh zusammenfassen, landen eher am unteren Ende der Benchmark-Spanne.
Cache-Treffer senken die Eingabekosten. Cache-Treffer bei DeepSeek V4 Flash kosten etwa 0,0028 $ pro Million Tokens gegenüber 0,14 $ pro Million bei einem Fehltreffer, also etwa 98 % günstiger. Caching benötigt ein bytegenaues stabiles Präfix. Wenn ein Harness den System-Prompt-Text zwischen Aufrufen mischt, werden Treffer zu Fehltreffern.
Tool-Schemas reiten mit. Zwanzig verbundene MCP-Server bedeuten zwanzig Schema-Sets im Prompt, selbst wenn die Aufgabe zwei davon verwendet. Trennen Sie Tools, die Sie nicht benötigen, bevor Sie den Benchmark durchführen, sonst messen Sie Ihr Tool-Setup anstelle des Harness.
Große Tool-Ausgaben vergiften den Kontext. Ein cat einer 3.000-zeiligen Datei oder ein ausführliches fehlgeschlagenes Testprotokoll bleibt für spätere Aufrufe in der Konversation. DeepSeek Harness kann übergroße Tool-Ergebnisse vor der Zusammenfassung beschneiden. Schalten Sie das ein, wenn die Aufgabe verrauschte Ausgaben produziert.
Wiederholungen verstecken sich in der Aufrufanzahl. Ein Harness, der eine fehlschlagende Testschleife wiederholt, gibt jedes Mal Tokens aus. Vergleichen Sie Modellaufrufe neben den Gesamt-Tokens, damit Sie eine Wiederholungsschleife von einem teuren Prompt trennen können.
Zum Atlas Cloud-Tarif für DeepSeek V4 Flash liegt eine Aufgabe mit 692.000 Tokens, die auf Eingabe ausgerichtet ist, im niedrigen einstelligen Cent-Bereich. Das ist wenig für einen Lauf und viel für ein Team, das den ganzen Tag Agenten ausführt. Durchsuchen Sie den vollständigen Modellkatalog, wenn Sie den Test mit einem zweiten Modell wiederholen und Modell-Effekte von Harness-Effekten trennen möchten.
DeepSeek Harness ist noch eine Entwicklervorschau, und seine README warnt vor breaking changes. Benchmarken Sie es, wenn Sie die Kontrolle über die Agent-Schleife wünschen. Standardisieren Sie nur darauf, wenn Ihr Team Änderungen verkraften kann. OpenCode ist die stabilere Wahl für Teams, die ein Werkzeug für heute benötigen.
Häufig gestellte Fragen
Ist DeepSeek Harness besser als OpenCode?
Für die meisten Teams noch nicht. OpenCode ist ausgereift, terminal-nativ, hat etwa 198k Sterne und einen großen Anbieterkatalog und funktioniert heute. DeepSeek Harness ist neuer, in der Entwicklervorschau und warnt vor breaking changes. Wählen Sie Harness, wenn Sie Agent-Interna modifizieren möchten. Wählen Sie OpenCode, wenn Sie einen Codierungs-Agenten für die tägliche Arbeit möchten.
Funktioniert DeepSeek Harness nur mit DeepSeek-Modellen?
Nein. Es ist modellunabhängig. Es enthält Katalog-Anbieter für DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure und Codex, und Sie können jeden benutzerdefinierten Anbieter hinzufügen, der openai-completions, openai-responses oder anthropic-messages in $DSH_HOME/settings.yaml spricht. Die Konfiguration in Schritt 1 zeigt es auf einen OpenAI-kompatiblen Endpunkt ohne Adaptercode.
Wie überprüfe ich den Token-Verbrauch von DeepSeek Harness?
Verwenden Sie das integrierte Token-Meter in der Trajectory-Ansicht. Es zeigt tokenUsage, contextPressure und contextBreakdown. Behandeln Sie es als Schätzung, da es ungefähr ein Token pro vier Zeichen verwendet. Für die Abrechnungsgenauigkeit lesen Sie das Dashboard des Anbieters, idealerweise mit einem dedizierten API-Schlüssel für jeden Lauf.
Welcher Harness verbraucht weniger Tokens, DeepSeek Harness oder OpenCode?
Noch kein öffentlicher direkter Vergleich beantwortet das. Der Composio-Benchmark maß OpenCode mit 692.000 durchschnittlichen Tokens pro Aufgabe, aber er wurde ausgeführt, bevor DeepSeek Harness ausgeliefert wurde. Führen Sie den Test von Schritt 2 bis Schritt 4 in Ihrem eigenen Repository durch, da der Token-Verbrauch von der Codebasis-Größe, dem Tool-Setup und der Aufgabenform abhängt.
Kann ich DeepSeek Harness und OpenCode mit demselben API-Schlüssel ausführen?
Ja, für einen beiläufigen Test. Für eine saubere Messung verwenden Sie zwei separate Schlüssel, einen pro Harness. Das Dashboard des Anbieters ordnet dann jeden Token dem korrekten Lauf zu.
Was ist der Unterschied zwischen einem Agent und einem Harness?
DeepSeek beschreibt einen Agent als Modell plus Harness. Das Modell argumentiert. Der Harness verbindet das Modell mit Dateien, Shell-Befehlen, Tools, Sitzungen, Genehmigungen und der Schleife, die die nächste Aktion bestimmt. Ändern Sie den Harness, und dasselbe Modell kann eine unterschiedliche Anzahl von Tokens für dieselbe Aufgabe ausgeben.


