

Ein 900-seitiges Projektarchiv ist schnell hochgeladen. Die schwierigere Frage ist, ob das Modell auf die genaue Klausel, den genauen Commit oder den genauen Datenpunkt verweisen kann, den Sie benötigen. Anwendungsfälle für das 1M-Kontextfenster von DeepSeek V4.1 Flash sind sinnvoll, wenn mehrere zusammenhängende Quellen gemeinsam betrachtet werden müssen, etwa eine Codebasis, ein Forschungskorpus oder jahrelange Projektaufzeichnungen. Das größere Fenster verringert die Notwendigkeit, diese Materialien vorab aufzuteilen, während Belegprüfungen weiterhin bestimmen, ob eine Antwort verlässlich ist.
Am besten geeignet sind dateiübergreifende Codeüberprüfung, Forschungssynthese, Richtlinienvergleich, Feedback-Analyse, Projektzeitachsen und lange multimodale Aufzeichnungen. DeepSeek gibt einen 1M-Token-Kontext an, aber diese Kapazität ist keine Garantie dafür, dass jedes Detail korrekt wiedergegeben wird. Prüfen Sie die Modell- und API-Limits für Ihre Route und testen Sie dann Ihr eigenes Material, bevor Sie sich auf das Ergebnis verlassen.
Wichtige Erkenntnisse
- Verwenden Sie ein Millionen-Token-Fenster, wenn die Frage von Beziehungen zwischen vielen relevanten Quellen abhängt.
- Fordern Sie Datei-, Abschnitts- oder Seitenverweise an und trennen Sie direkte Belege von Schlussfolgerungen.
- Beginnen Sie mit einem Test mit bekannter Antwort und erweitern Sie den Kontext nur, wenn er das Ergebnis verbessert.
- Schätzen Sie die Kosten anhand von Eingabe, Ausgabe und Cache-Behandlung, nicht allein anhand des Kontextlimits.
Was bedeutet ein 1M-Token-Kontextfenster?
Ein Kontextfenster ist die Informationsmenge, die ein Modell in einer Anfrage oder einem Konversationszustand berücksichtigen kann, einschließlich bereitgestelltem Material und der umgebenden Anweisungen. Die aktuelle API-Preisseite von DeepSeek listet DeepSeek-V4.1-Flash mit einer Kontextlänge von 1M und einer maximalen Ausgabe von 384K Token. Das ist das vom Anbieter angegebene Limit; Ihre Anwendung, Ihr Endpunkt oder Ihre Anforderungskonfiguration kann ein kleineres Limit auferlegen. ( DeepSeek-API-Dokumentation )
Token sind Textbestandteile, keine Wörter oder Seiten. Ein Quellarchiv mit Code, Tabellen, Markup, wiederholtem Boilerplate und Scans kann ganz anders tokenisiert werden als sauberer Fließtext mit derselben Seitenzahl. Schätzen Sie für eine reale Arbeitslast die Token mit dem Tokenizer oder der Nutzungsberichterstattung der API, die Sie aufrufen werden. Beziehen Sie Systemanweisungen, Dateinamen, Metadaten, Fragetext und das Antwortbudget in Ihre Schätzung ein.
Der praktische Nutzen ist Kontinuität. Sie können nach Abhängigkeiten über mehrere Module hinweg oder nach Widersprüchen zwischen einer aktuellen Richtlinie und ihren Anhängen fragen, ohne vorher manuell Zusammenfassungen zusammenfügen zu müssen. Der Kompromiss besteht darin, dass ein sehr großer Prompt irrelevantes oder dupliziertes Material enthalten, länger für die Verarbeitung brauchen und die exakte Wiederauffindung trotzdem erschweren kann. Behandeln Sie „passt ins Fenster“ als Kapazitätsprüfung und testen Sie dann, ob das Modell die Fakten finden kann, die Ihre Aufgabe benötigt.
Die besten Anwendungsfälle für das 1M-Kontextfenster von DeepSeek V4.1 Flash
Die richtige Frage ist nicht „Kann ich alles hochladen?“, sondern „Welche Quellen müssen verglichen werden, um dies zu beantworten?“ Verwenden Sie einen langen Kontext, wenn die Antwort von Verbindungen zwischen Materialien abhängt, und legen Sie fest, wie Sie diese Antwort überprüfen werden, bevor Sie das vollständige Archiv senden.
| Anwendungsfall | Warum ein langer Kontext hilft | Was enthalten sein sollte | Was zu überprüfen ist |
|---|---|---|---|
| Überprüfung einer großen Codebasis | Schnittstellen und Konventionen erstrecken sich über Module | Relevanter Quellcode, Tests, Architekturhinweise | Dateipfade, Symbole, Testnachweise |
| Forschungssynthese | Methoden und Ergebnisse müssen nebeneinander verglichen werden | Paper, Berichte, Einschränkungen | Quelle und Vorbehalte jeder Behauptung |
| Vergleich von Verträgen oder Richtlinien | Definitionen und Ausnahmen wiederholen sich über Abschnitte hinweg | Aktuelle und frühere Versionen, Anhänge | Klauselnummern und genauer Wortlaut |
| Feedback-Analyse | Themen treten in vielen Kommentaren auf | De-identifiziertes Feedback und Kodierungsregeln | Repräsentative Zitate und Zählmethode |
| Zeitachse der Projektgeschichte | Entscheidungen entwickeln sich über Besprechungsprotokolle hinweg | Protokolle, Entscheidungslogs, Release Notes | Daten, Verantwortliche, widersprüchliche Aufzeichnungen |
| Lange Incident-Überprüfung | Logs, Tickets und Postmortems erklären verschiedene Phasen | Relevanter Zeitraum und Incident-Dokumente | Zeitstempel, Ereignisquelle, Unsicherheit |
| Multimodale Dokumentenüberprüfung | Text- und visuelle Nachweise müssen möglicherweise gemeinsam gelesen werden | Unterstützte Bilder und ihre Bildunterschriften oder ihr Kontext | Ob der Endpunkt den Medientyp unterstützt |
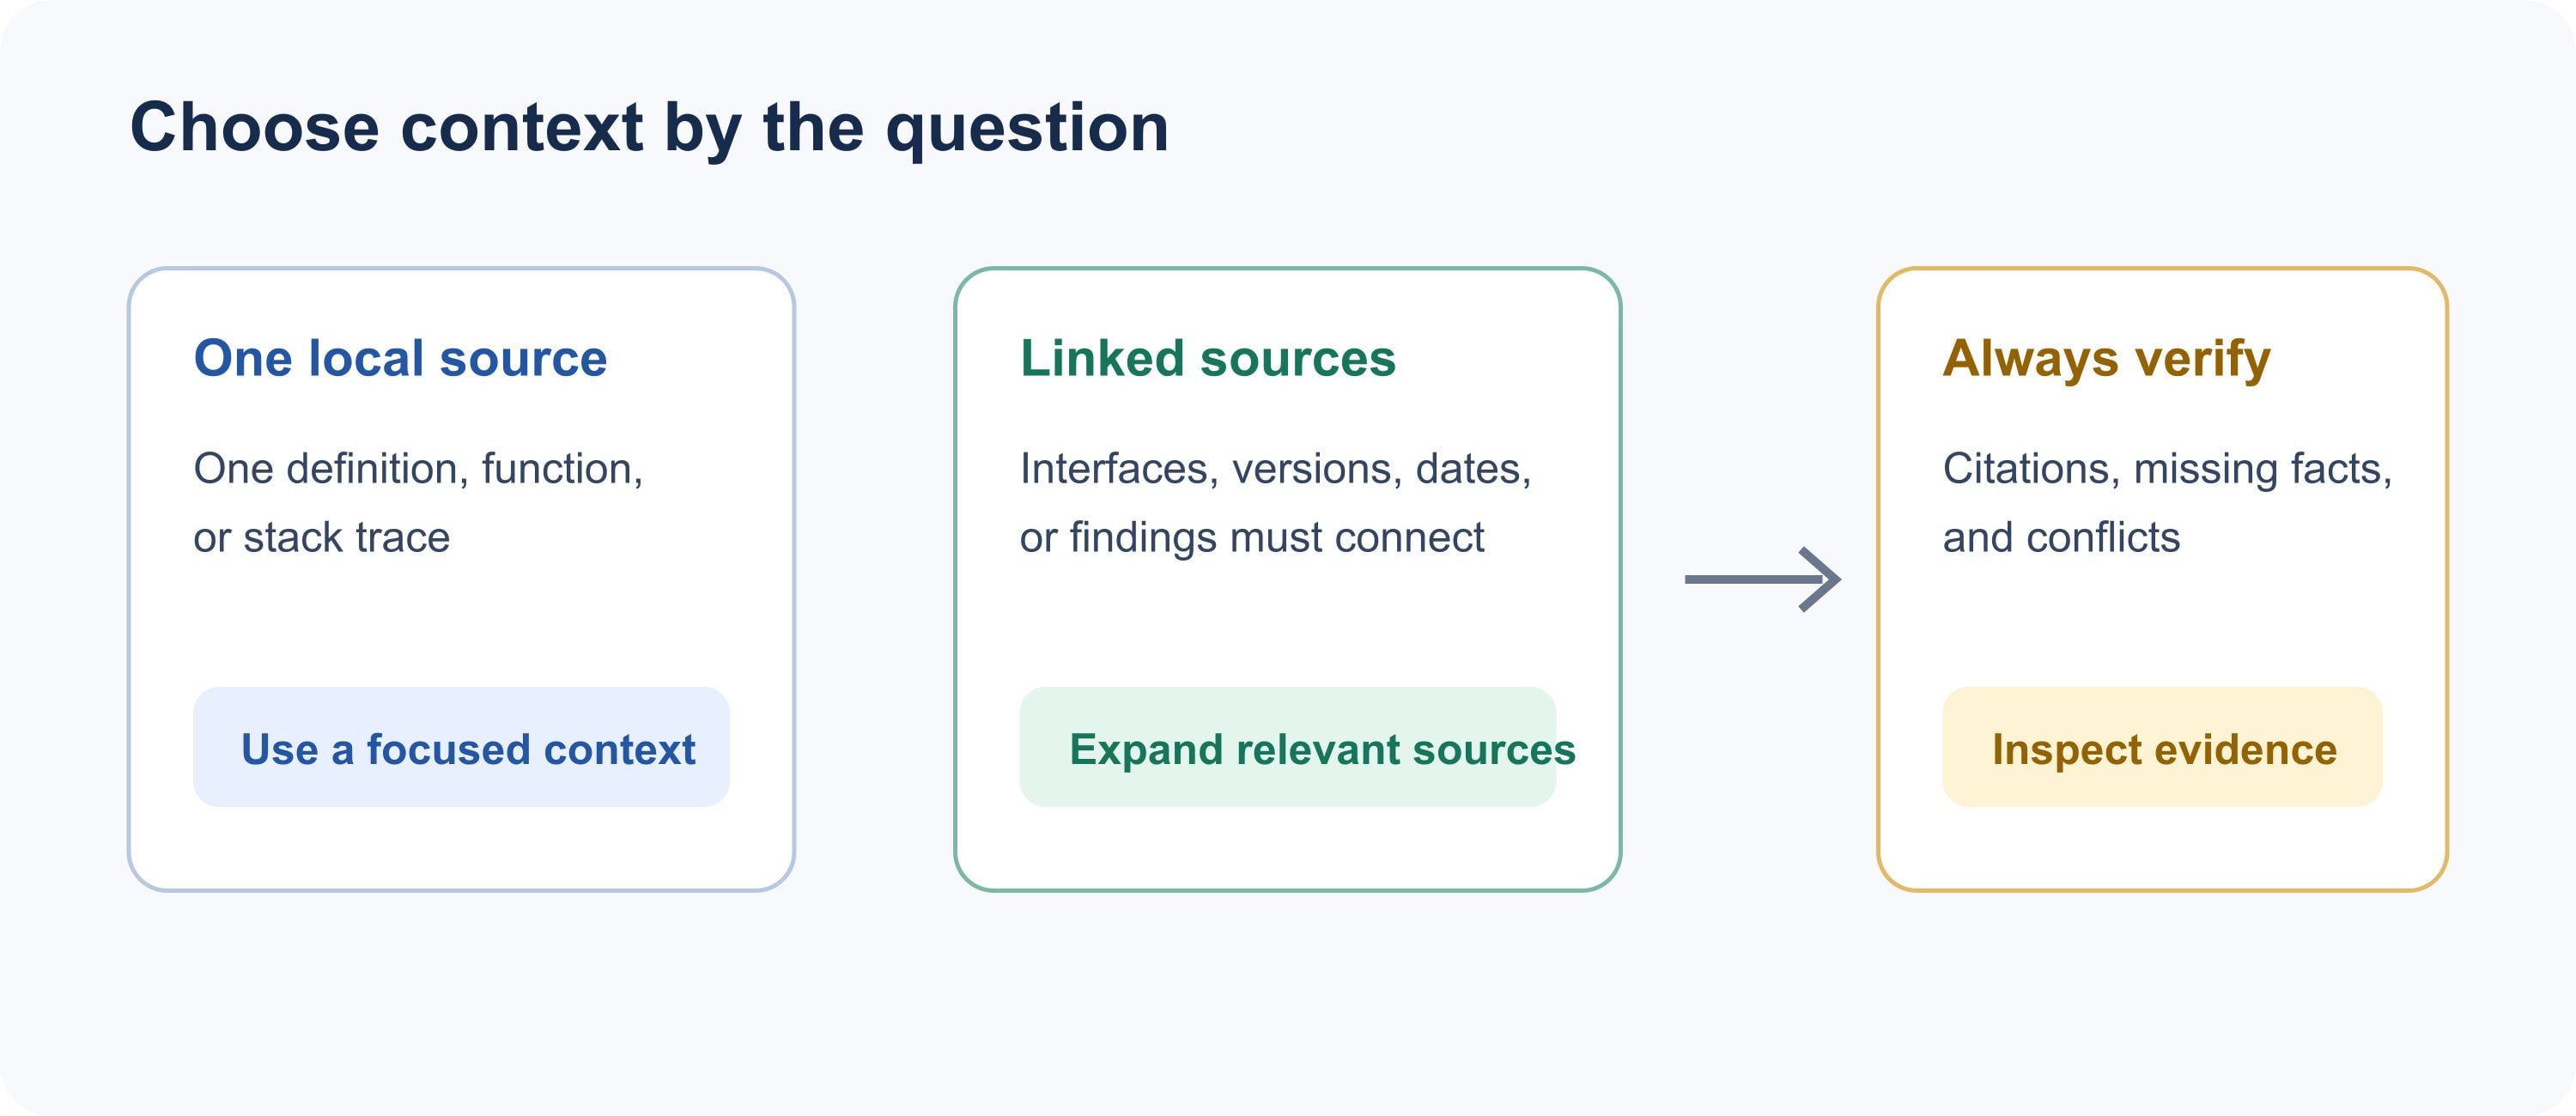
Verwenden Sie einen fokussierten Kontext für eine lokale Frage; erweitern Sie ihn, wenn Quellen verbunden werden müssen, und prüfen Sie dann die Belege.
Eine große Codebasis dateiübergreifend überprüfen
Ein Millionen-Token-Kontext kann einem Entwickler helfen, eine Datenstruktur von einer API-Grenze über Dienstlogik, Speicherung und Tests nachzuvollziehen. Er ist nützlich für Architekturzusammenfassungen, das Auffinden wahrscheinlich betroffener Module und das Entwerfen eines Refactoring-Plans, der an mehreren Stellen dokumentierte Konventionen berücksichtigt.
Geben Sie dem Modell einen begrenzten Repository-Snapshot statt eines ungefilterten Festplatten-Dumps. Beziehen Sie für die Änderung relevante Quelldateien, die nächstgelegenen Tests, Abhängigkeitsmanifeste und Architekturhinweise ein. Schließen Sie Build-Ausgaben, eingebundene Abhängigkeiten, generierte Bundles und doppelte Kopien aus, es sei denn, die Frage betrifft sie. Fragen Sie nach Dateipfaden und Symbolnamen für jede vorgeschlagene Abhängigkeit sowie nach einer Unterscheidung zwischen beobachtetem Verhalten und einer Annahme.
Verwenden Sie die Ausgabe als Überprüfungsplan. Bestätigen Sie, dass jedes zitierte Symbol existiert, prüfen Sie die zitierten Zeilen und führen Sie die Prüfungen des Projekts selbst aus. Das Modell sollte nicht behaupten, dass Tests bestanden wurden, es sei denn, ein Tool hat sie tatsächlich ausgeführt und das Ergebnis zurückgegeben. Bei einem lokalisierten Fehler in einer Funktion ist ein kleinerer Kontext oft schneller und leichter zu prüfen.
Forschung über Paper und Berichte hinweg synthetisieren
Ein langer Kontext hilft, wenn Studien unterschiedliche Methoden, Populationen, Messgrößen oder Definitionen verwenden. Bitten Sie um eine Vergleichstabelle mit einer Zeile pro Quelle und Spalten für Forschungsfrage, Daten, Methode, Ergebnis, Einschränkungen und Relevanz für Ihre Frage. Behalten Sie Aussagen auf Quellenebene an ihrer Quelle, statt zuzulassen, dass eine vermischte Zusammenfassung Widersprüche auslöscht.
Unterscheiden Sie beispielsweise beim Vergleich von Bewertungen eines Tools ein Benchmark-Ergebnis von einer Feldstudie und von der Interpretation eines Autors. Bitten Sie das Modell, inkompatible Messgrößen zu kennzeichnen, statt Ergebnisse zu bewerten, die nicht vergleichbar sind. Öffnen Sie dann die Quellpassagen hinter den entscheidungsrelevantesten Aussagen. Eine Synthese ist eine Landkarte der Belege, kein Ersatz für die Prüfung der Paper.
Lange Verträge, Richtlinien oder Spezifikationen vergleichen
Verträge und Richtlinien definieren einen Begriff oft einmal und schränken ihn an anderer Stelle ein. Wenn Sie die maßgebliche Version, Änderungen, Anlagen und relevante ältere Entwürfe zusammen bereitstellen, können geänderte Definitionen, Querverweise, fehlende Bedingungen und offensichtliche Konflikte besser sichtbar werden.
Fordern Sie für jede Beobachtung den genauen Abschnitt oder die genaue Klausel und einen kurzen Auszug an, den eine prüfende Person finden kann. Trennen Sie textliche Unterschiede von ihren möglichen Konsequenzen. Das Modell kann helfen, eine Prüfung zu organisieren, aber rechtliche Auslegung, Compliance-Entscheidungen und Unterzeichnungsbefugnis bleiben bei qualifizierten Personen, die Gerichtsbarkeit und Kontext berücksichtigen können.
Kundenfeedback in großem Umfang analysieren
Eine große Menge Feedback kann wiederkehrende Anfragen und Einwände über Kanäle oder Zeiträume hinweg aufzeigen. Stellen Sie eine definierte Stichprobe bereit, entfernen Sie nicht benötigte personenbezogene Informationen und geben Sie ein Kodierschema an, etwa „Onboarding-Reibung“, „fehlende Integration“ oder „Preisverwirrung“. Bitten Sie um repräsentative Beispiele und Gegenbeispiele, nicht nur um eine Liste von Themen.
Präsentieren Sie vom Modell generierte Themenprozentsätze nicht als Umfragestatistiken. Wenn Sie Zählungen benötigen, definieren Sie die Einheit (Nachricht, Kunde oder Vorgang), deduplizieren Sie Datensätze, wenden Sie eine konsistente Kennzeichnungsregel an und überprüfen Sie die Zählung mit einem wiederholbaren Skript oder einer von Menschen geprüften Stichprobe. Das Modell ist nützlich, um Kategorien vorzuschlagen und Beispiele zu finden; eine dokumentierte Methode stützt quantitative Aussagen.
Eine Zeitachse aus Projektunterlagen erstellen
Bei einer Übergabe oder Postmortem können die relevanten Belege über Besprechungsprotokolle, Release Notes, Entscheidungsprotokolle und Tickets verstreut sein. Bitten Sie um eine chronologische Tabelle mit Datum, Ereignis, genanntem Verantwortlichen, sofern angegeben, Quellort und Konfidenz oder Mehrdeutigkeit. Weisen Sie das Modell an, widersprüchliche Daten beizubehalten, statt stillschweigend eines auszuwählen.
Eine nützliche Zeitachse hilft einem neuen Teammitglied zu sehen, was entschieden wurde, wann sich eine Anforderung geändert hat und welches Dokument jedes Ereignis stützt. Überprüfen Sie kritische Übergänge anhand der Quellaufzeichnung, besonders wenn eine Notiz später geschrieben wurde oder eine Besprechung zusammenfasst, statt sie direkt aufzuzeichnen.
Lange Incident-Aufzeichnungen und multimodales Material überprüfen
Die Incident-Überprüfung kann davon profitieren, Warnmeldungen, Betriebsnotizen, Tickets und das Postmortem in einem Belegsatz zusammenzuhalten. Bitten Sie um eine Abfolge beobachteter Ereignisse und unterscheiden Sie ausdrücklich Zeitstempel in Logs von späteren Schätzungen in erzählenden Notizen. Dies kann den ersten Durchgang kohärenter machen, während der Bereitschaftsingenieur vor Maßnahmen weiterhin die Quellsysteme prüft.
In der offiziellen Ankündigung von DeepSeek heißt es, V4.1-Flash sei mit nativer multimodaler Unterstützung in seiner API live. Die genauen Bildformate, Anforderungsmethoden und Limits hängen vom Endpunkt und der Integration ab. Bestätigen Sie diese Details, bevor Sie annehmen, dass ein Textbudget von einer Million Token auch die Bildverarbeitung beschreibt. ( Ankündigung zu DeepSeek V4.1-Flash )
Wann helfen eine Million Token, und wann erzeugen sie Rauschen?
Mehr Kontext hilft, wenn Quellen querverwiesen werden müssen. Eine Codeänderung an einer gemeinsam genutzten Schnittstelle kann mehrere Module und Tests erfordern. Ein Versionsvergleich benötigt beide vollständigen Versionen und ihre Anhänge. Eine Projektzeitachse kann Aufzeichnungen erfordern, die über Monate verteilt sind.
Ein lokaler Fehler mit klarem Stacktrace benötigt möglicherweise nur die Funktion, ihre Aufrufer und den relevanten Test. Eine Frage nach einer einzigen Definition benötigt möglicherweise nur den maßgeblichen Abschnitt. Bei diesen Aufgaben vergrößert die Aufnahme eines gesamten Repositorys den Suchraum und kann die nützliche Passage begraben.
Entfernen Sie vor dem Erweitern des Prompts wiederholte Exporte, veraltete Entwürfe, nicht zusammenhängende Ordner, Boilerplate und Aufzeichnungen außerhalb des Zeitraums der Frage. Führen Sie ein Manifest darüber, was Sie einbezogen haben und warum. Wenn sich die Antwort ändert, sobald Sie eine große Menge nicht zusammenhängender Dateien hinzufügen, ist das ein Signal, den Quellensatz zu straffen und den Test erneut auszuführen.
Ein praktischer Workflow für zuverlässige Antworten bei langem Kontext
Verwenden Sie ein konsistentes Belegprotokoll, damit eine flüssige Antwort nicht mit einer verifizierten verwechselt wird. Kennzeichnen Sie die Quellen zunächst mit stabilen Dateinamen und, wo möglich, Seitenzahlen, Überschriften, Zeilennummern, Daten oder Versionskennungen. Bewahren Sie genügend umgebenden Kontext, um Auszüge korrekt zu interpretieren.
Formulieren Sie als Nächstes eine Entscheidung oder Forschungsfrage. Legen Sie die Ausgabeform und die Stellen fest, die das Modell zitieren muss. Ein wiederverwendbarer Prompt ist:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Fügen Sie für eine Codebasis hinzu: „Zitieren Sie Repository-Pfade sowie Funktions- oder Klassennamen. Bevor Sie eine Änderung vorschlagen, listen Sie die betroffenen Dateien und die Testnachweise auf, die den Vorschlag stützen. Behaupten Sie nicht, dass ein Test ausgeführt wurde, es sei denn, sein Ergebnis ist in den bereitgestellten Nachweisen enthalten.“
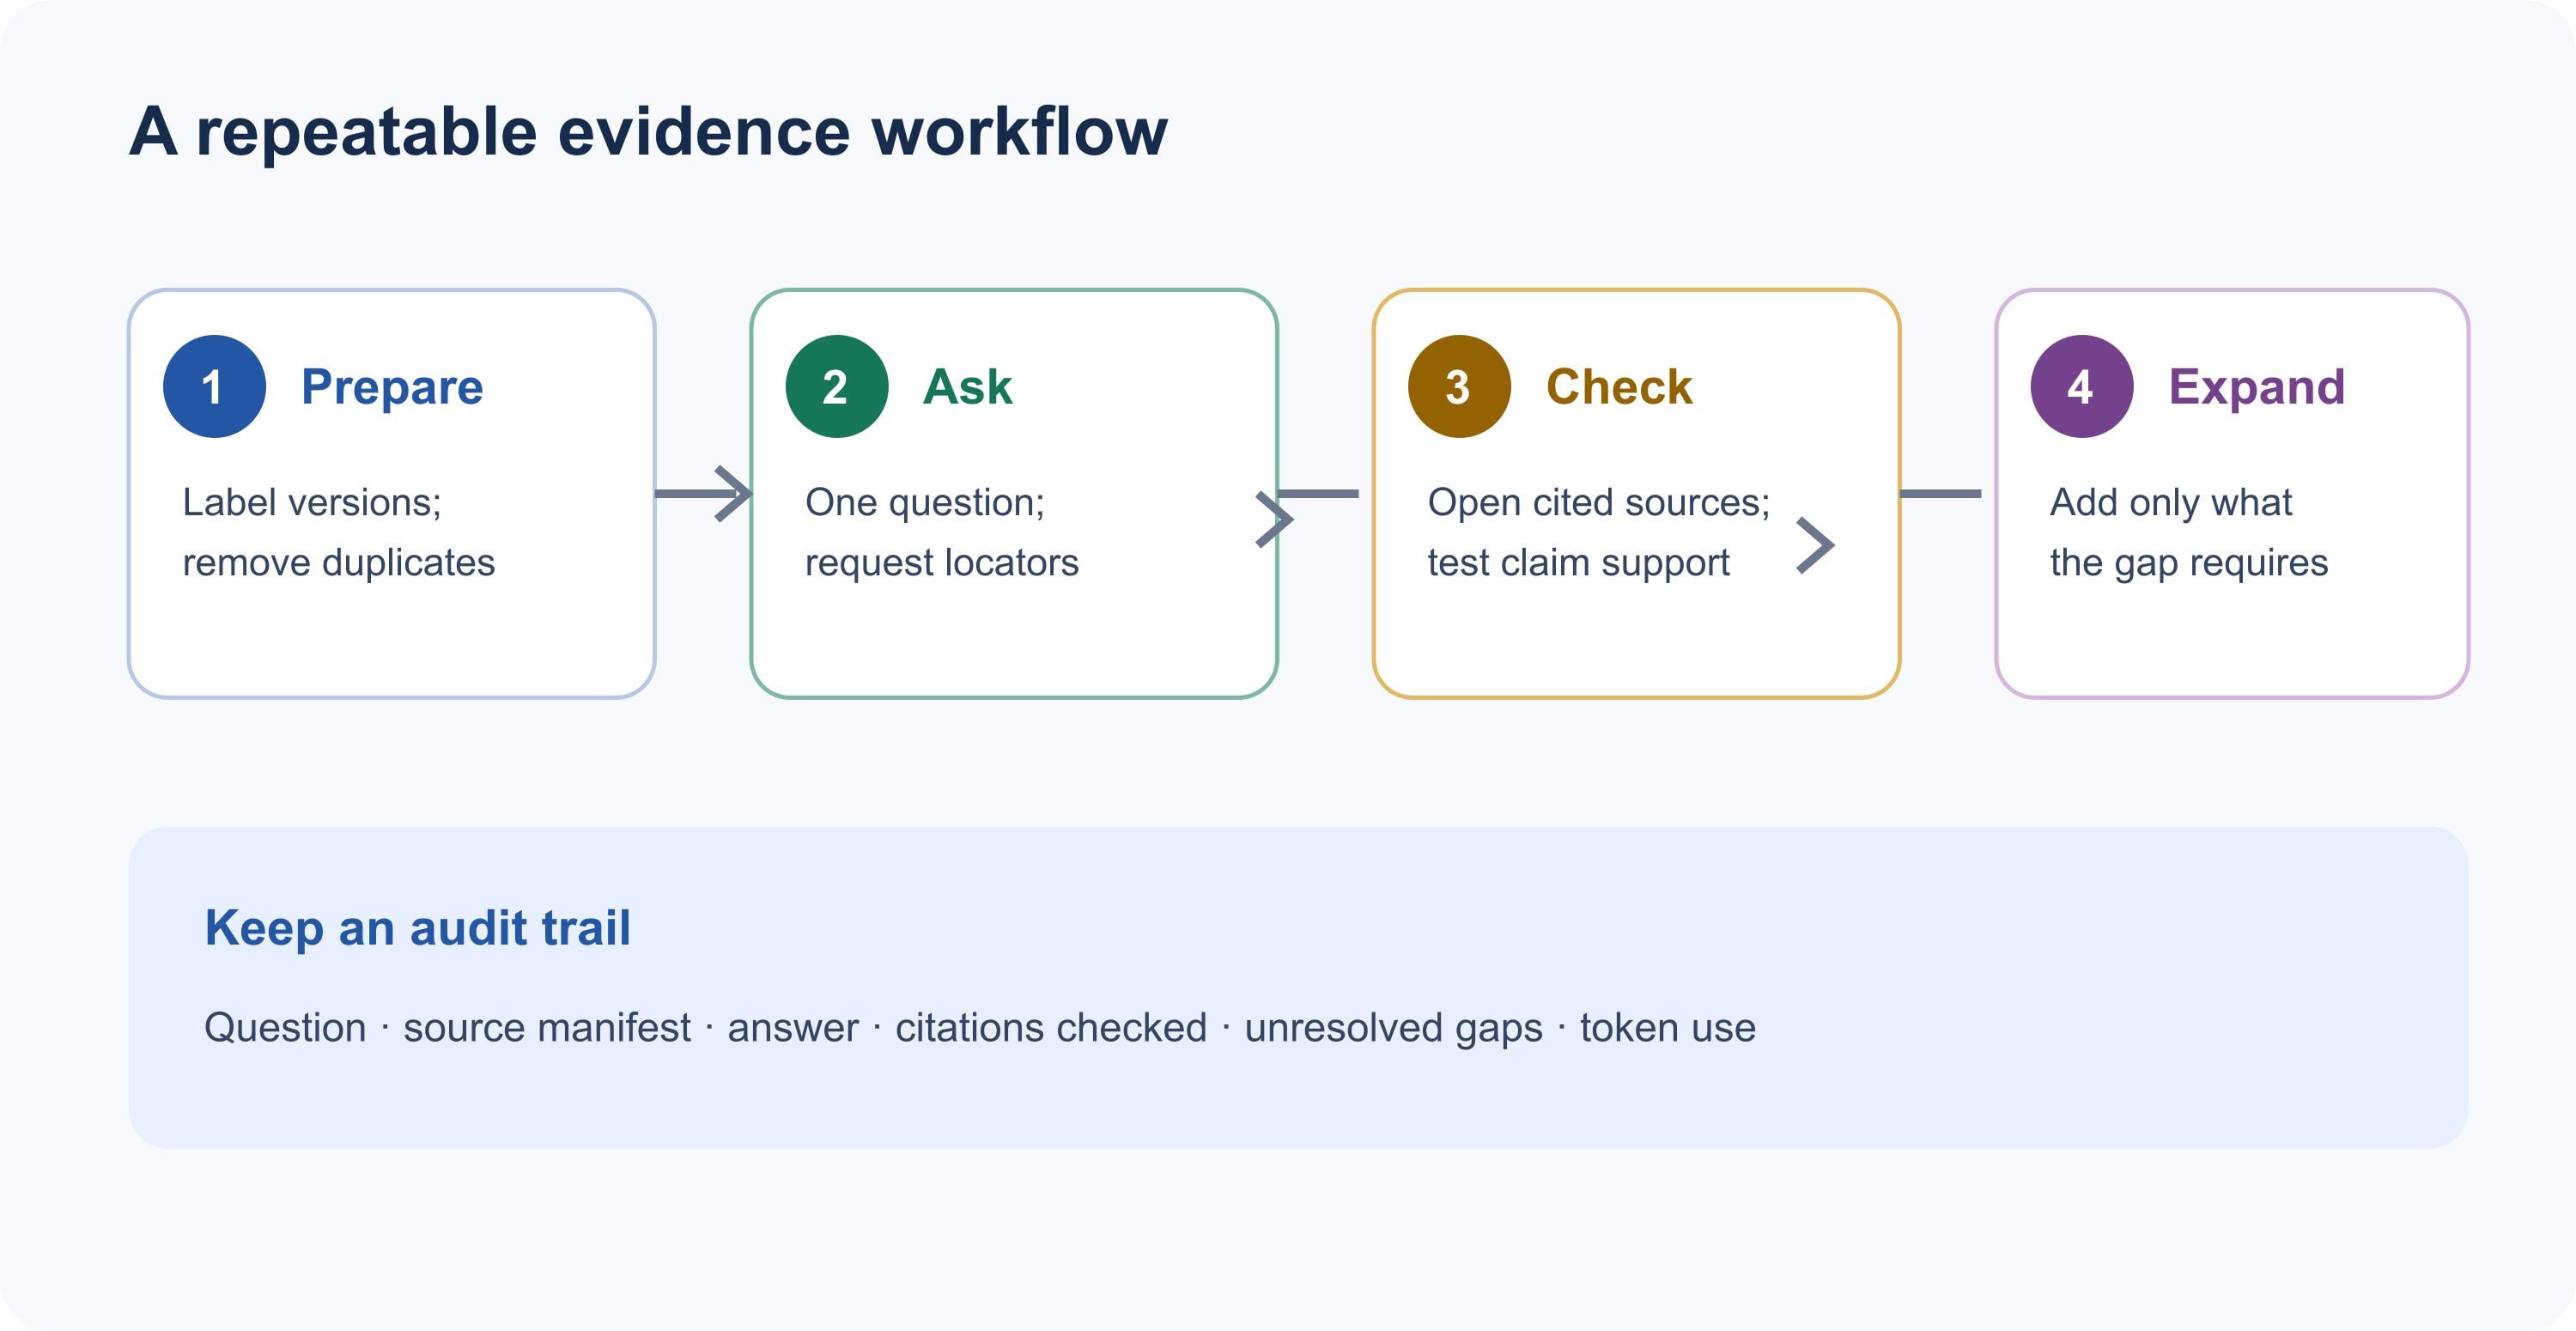
Bereiten Sie Quellen vor, stellen Sie eine begrenzte Frage, prüfen Sie Verweise und erweitern Sie nur, um eine Lücke zu schließen.
Prüfen Sie die Antwort dann in drei Durchgängen. Prüfen Sie, ob jeder Verweis auf eine reale Stelle zeigt. Prüfen Sie, ob die zitierte Passage die Aussage stützt und nicht nur das Thema erwähnt. Prüfen Sie schließlich Auslassungen und Konflikte, indem Sie gezielte Rückfragen zu demselben Quellensatz stellen. Lassen Sie bei Entscheidungen mit hohem Risiko eine qualifizierte prüfende Person die Quellmaterialien direkt lesen.
Belegkarte für den Langkontext-Workflow
| Phase | Aktion | Beibehalten | Stoppsignal |
|---|---|---|---|
| 1. Vorbereiten | Quellen kennzeichnen, deduplizieren und abgrenzen | Quellenmanifest und Versionen | Unbekannte Herkunft oder veraltetes Duplikat |
| 2. Fragen | Eine Frage und ein Belegformat festlegen | Dateinamen und Fundstellen in der Antwort | Breite Anfrage ohne Entscheidungsziel |
| 3. Prüfen | Zitierte Passagen öffnen und Aussagen vergleichen | Gestützte Aussagen und ausdrückliche Lücken | Verweis stützt die Aussage nicht |
| 4. Erweitern | Nur Quellen hinzufügen, die für ungeklärte Verbindungen nötig sind | Verbesserung bei Prüfungen mit bekannter Antwort | Mehr Eingabe ohne bessere Belege |
Wie Sie testen, ob 1M-Kontext für Ihre Aufgabe nützlich ist
Erstellen Sie ein kleines Evaluierungsset, bevor Sie das vollständige Archiv laden. Schreiben Sie Fragen, deren Antworten Sie bereits aus dem Quellmaterial kennen. Platzieren Sie einige Fakten am Anfang, einige in der Mitte und einige gegen Ende. Fügen Sie mindestens eine Frage hinzu, die das Verbinden zweier Dokumente erfordert, und eine, die anhand der bereitgestellten Quellen nicht beantwortet werden kann.
Stellen Sie dieselben Fragen zuerst an eine kleinere, relevante Teilmenge und erhöhen Sie dann den Kontext in abgestuften Schritten. Erfassen Sie faktische Korrektheit, Genauigkeit der Fundstellen, übersehene Belege, nicht gestützte Aussagen, Verweigerung bei der unbeantwortbaren Frage, Latenz und Token-Nutzung. Halten Sie den Prompt und die Dekodierungseinstellungen stabil, damit Änderungen interpretierbar sind. Wiederholen Sie eine Frage, wenn die Ausgaben zwischen den Läufen erheblich variieren.
| Prüfung | Was eine bestandene Antwort zeigt | Was nach einem Fehler zu tun ist |
|---|---|---|
| Bekannter Fakt an früher, mittlerer, später Position | Abruf über die Quellspanne hinweg | Indexierung, Dateibezeichnungen und Prompt-Länge prüfen |
| Dokumentübergreifende Verknüpfung | Belege können über Quellen hinweg verbunden werden | Beide Verweise anfordern und dann die Verknüpfungsfrage eingrenzen |
| Unbeantwortbare Frage | Das Modell kann fehlende Belege melden | „Nur bereitgestellte Quellen verwenden“ verschärfen und erneut testen |
| Verweisprüfung | Fundstelle und Auszug stützen die Aussage | Die Aussage als unbestätigt behandeln, bis sie korrigiert ist |
| Vergleich mit größerem Kontext | Zusätzliches Material verbessert die Zielaufgabe | Rauschen entfernen, wenn Genauigkeit oder Latenz schlechter wird |
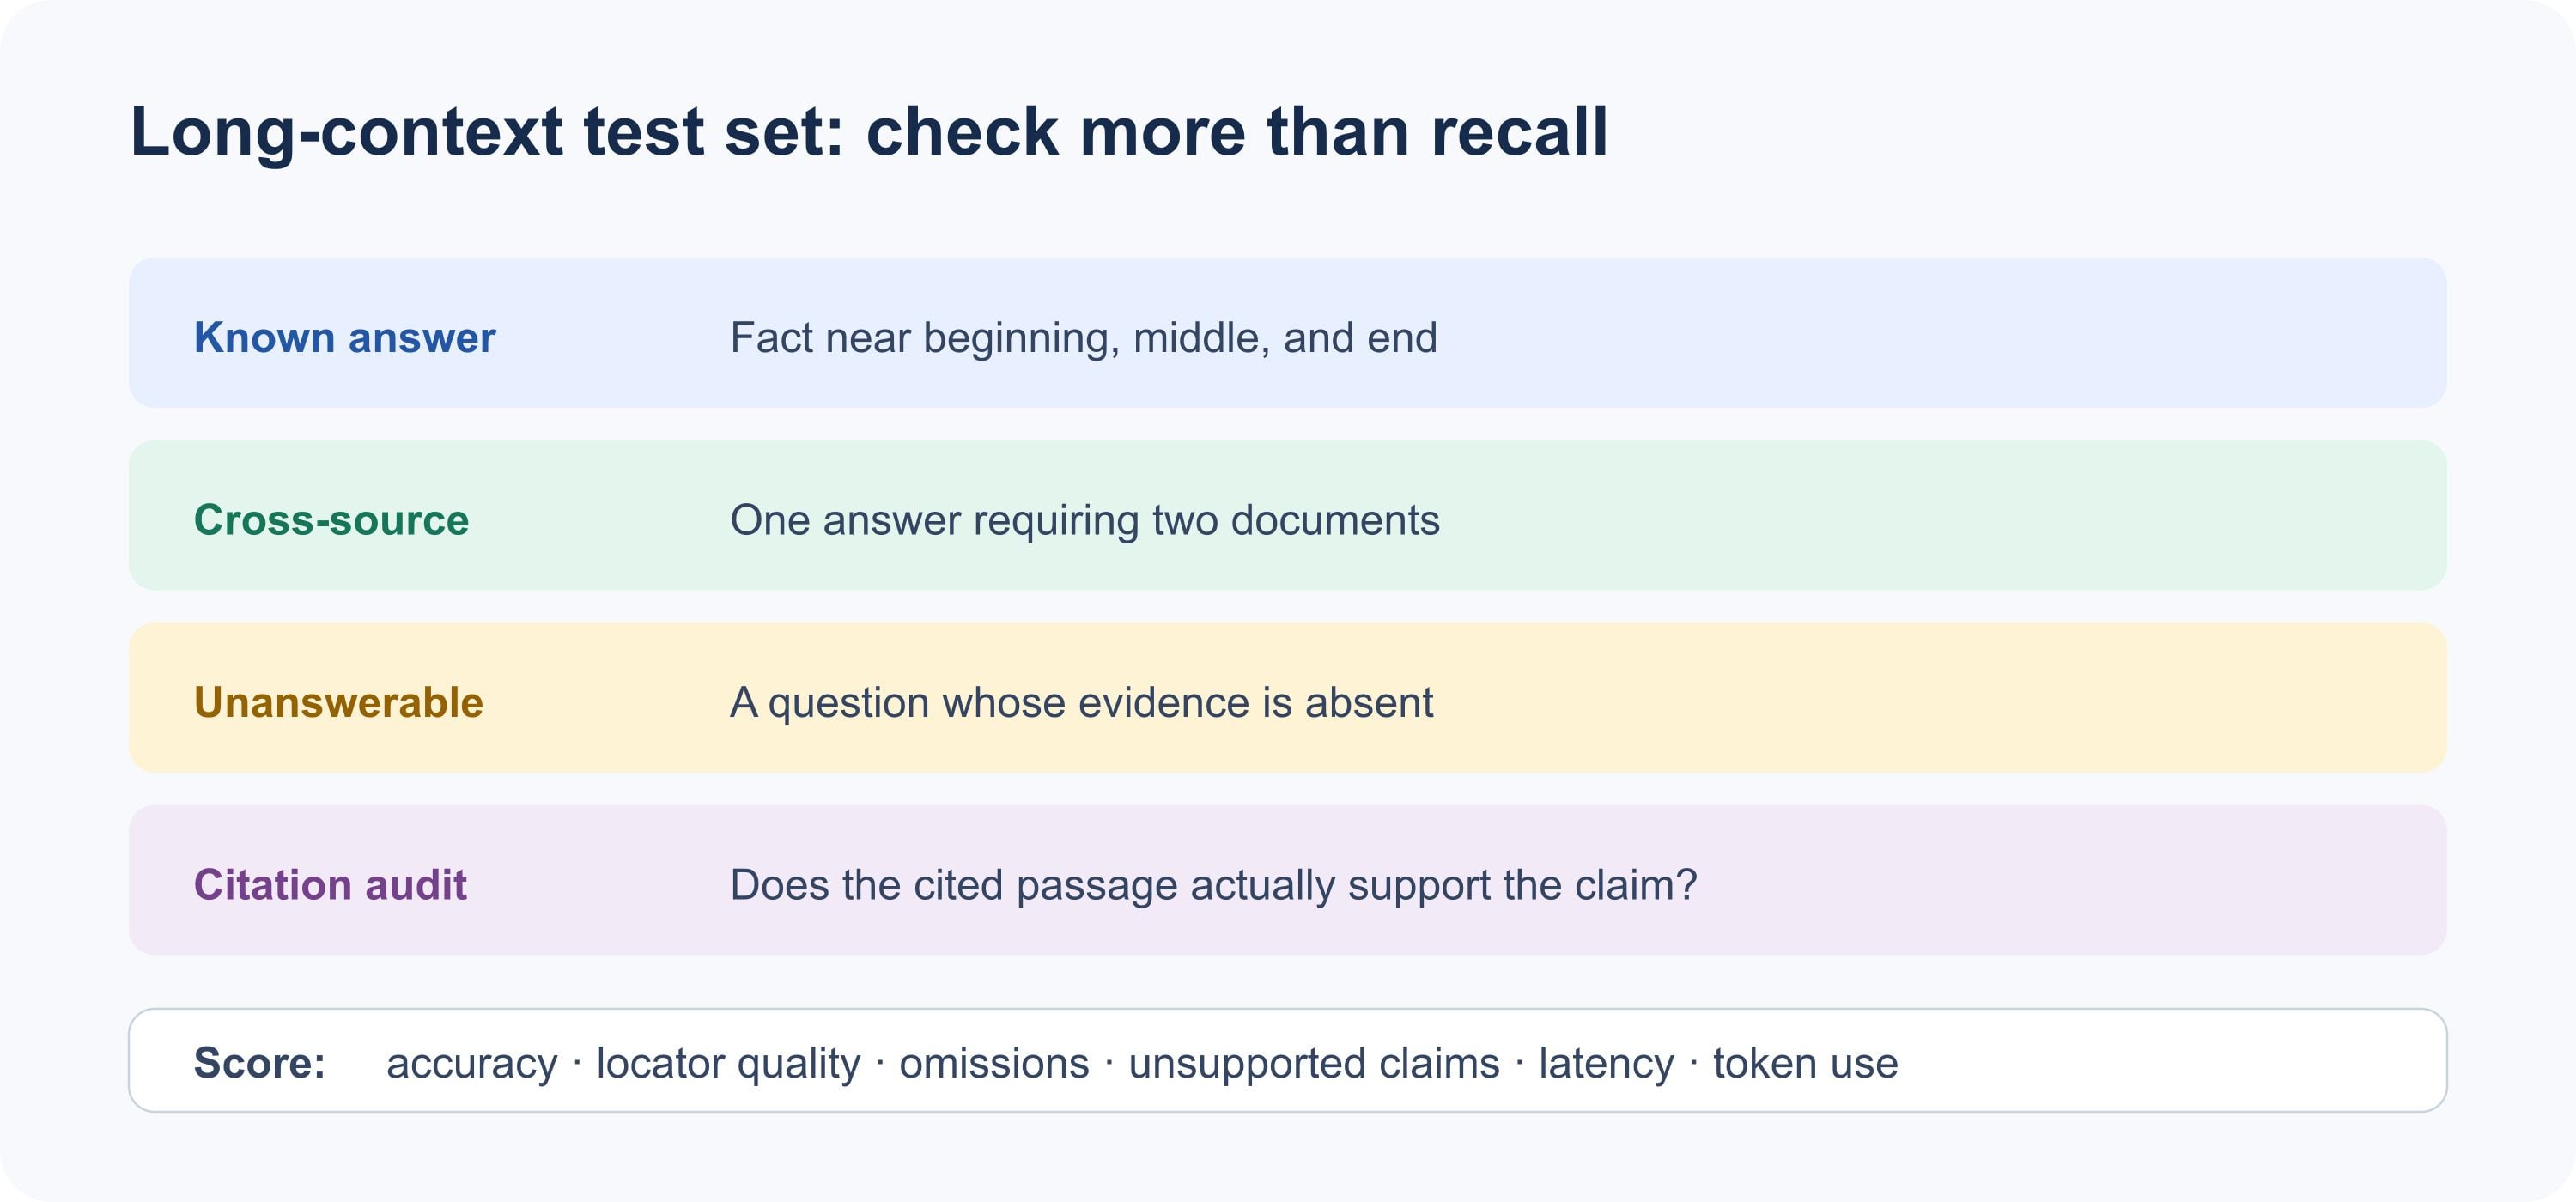
Bewerten Sie Abruf, Verweisunterstützung, Auslassungen, nicht gestützte Aussagen, Latenz und Token-Nutzung.
Berichte aus der Community sind gemischt und aufgabenabhängig. Ein Reddit-Nutzer berichtete über einen Harness-spezifischen Anstieg fehlerhafter Tool-Argumente bei größeren Kontextgrößen, während Kommentatoren von erfolgreicher Arbeit mit höheren Token-Zahlen in anderen Setups schrieben. Das ist ein guter Grund, Ihren eigenen Harness zu benchmarken, aber kein Beleg für eine universelle Fehlerschwelle. ( Diskussion zu DeepSeek-Kontext auf Reddit )
Ein sinnvolles Vorgehen beim Hochskalieren ist: Validieren Sie den Prompt an einer kleinen Stichprobe, fügen Sie die für dokumentübergreifende Fragen benötigten Quellgruppen hinzu und testen Sie dann eine repräsentative große Anfrage. Behalten Sie den kleinsten Kontext, der die eigentliche Frage mit verlässlichen Belegen beantwortet. Dies erleichtert auch die Interpretation von Latenz- und Kostenvergleichen.
API-Preise und Zugriff für DeepSeek V4.1 Flash
Bei Atlas Cloud zeigt das Modelllisting derzeit DeepSeek V4.1 Flash mit einem 1M-Kontext und Preisen von $0.30 pro Million Eingabe-Token, $1.20 pro Million Ausgabe-Token und $0.03 pro Million Cache-Lese-Token. Das Listing zeigt keinen Rabatt für dieses Modell. Dies sind Atlas-Cloud-Preise, die sich von den zeitabhängigen Peak- und Off-Peak-Preisen von DeepSeek selbst unterscheiden. Prüfen Sie den Atlas-Cloud-Modellkatalog und die Modell-Preisseite erneut, bevor Sie veröffentlichen oder budgetieren, da sich Preise ändern können.
Bei den aufgeführten Preisen kostet eine Anfrage mit 100.000 nicht gecachten Eingabe-Token und 2.000 Ausgabe-Token etwa $0.03 für Eingabe plus $0.0024 für Ausgabe, insgesamt $0.0324 vor anderen anwendbaren Gebühren. Wenn die Eingabe als Cache-Lesevorgänge abgerechnet wird, würden 100.000 gecachte Token stattdessen $0.003 kosten. Das Beispiel geht von diesen Token-Zahlen und Preisen aus; es ist kein Angebot für eine bestimmte Arbeitslast. Die volle 1M-Kapazität wird nicht allein deshalb berechnet, weil sie existiert. Die Abrechnung richtet sich nach Nutzung und Cache-Behandlung.
Für Teams, die einen einzigen API-Einstiegspunkt wünschen, bietet die Modellseite zu DeepSeek V4.1 Flash das Modell und Details zum Aufruf. Vergleichen Sie Ihren gemessenen Token-Verbrauch und Ihre Integrationsanforderungen auch mit dem offiziellen Endpunkt; Modellnamen, Limits und Preise können je nach Anbieter abweichen.
Häufig gestellte Fragen
Ist ein 1M-Token-Kontextfenster dasselbe wie 1M Wörter?
Nein. Token können Wortteile, Satzzeichen, Codefragmente oder andere Einheiten sein. Die Anzahl der Wörter oder Seiten, die hineinpassen, hängt vom Material und seiner Tokenisierung ab. Verwenden Sie gemessene Token-Zahlen statt einer festen Seitenumrechnung.
Verwendet DeepSeek V4.1 Flash immer das vollständige Kontextfenster?
Nein. Eine Million Token ist eine maximale Kontextspezifikation, kein Ziel für jede Anfrage. Ein kurzer Prompt verbraucht weniger, und eine bestimmte Oberfläche oder API-Route kann eine niedrigere Obergrenze erzwingen. Prüfen Sie die Endpunktdokumentation und die tatsächlichen Nutzungsfelder.
Reicht 1M-Kontext für eine gesamte Codebasis?
Von der Token-Zahl her mag er für einige Codebasen passen, aber das macht nicht jede Datei relevant oder jede Antwort zuverlässig. Beziehen Sie die für die Frage benötigten Dateien ein, überprüfen Sie zitierte Pfade und Symbole und testen Sie Änderungen mit den echten Prüfungen des Projekts.
Sollte ich jedes verfügbare Dokument in einen Prompt packen?
Nur wenn die Dokumente dieselbe Frage betreffen. Beginnen Sie mit einem Quellenmanifest, entfernen Sie Duplikate und nicht zusammenhängendes Material und fügen Sie mehr hinzu, wenn ein dokumentübergreifender Test es erfordert. Die besten Anwendungsfälle für das 1M-Kontextfenster von DeepSeek V4.1 Flash werden durch Belege definiert, die verglichen werden müssen, nicht durch die Größe des Archivs.





