Zwei Teams können Hunderte Tokens pro Sekunde für DeepSeek V4.1 Flash melden und trotzdem unterschiedliche Dinge messen. Das eine kann die Decode-Geschwindigkeit für eine einzelne Anfrage bedeuten; ein anderes den aggregierten Output über Dutzende gleichzeitige Anfragen. Um die DeepSeek V4.1 Flash Inferenz-Durchsatzoptimierung zu verbessern, wählen Sie zuerst die Metrik, die Ihr Service benötigt, benchmarken Sie dann Ihren eigenen Anfragenmix, ändern Sie jeweils eine Serving-Variable und verifizieren Sie Latenz, Qualität und Kosten gemeinsam. Die Modellfamilie umfasst jetzt das Update Flash-1017 vom 17. Oktober, daher sollten Sie den genauen Checkpoint notieren, bevor Sie Ergebnisse vergleichen. Öffentliche Berichte zeigen nützliche Optimierungspfade, aber keiner ersetzt einen passenden Test auf Ihrer Hardware.
Wichtigste Erkenntnisse
- Aggregierte Output-Tokens/s messen die Kapazität über Anfragen hinweg; die Decode-Geschwindigkeit pro Anfrage misst die Erfahrung eines einzelnen Nutzers.
- Reproduzieren Sie Ihre Prompt-Längen, Output-Limits, Nebenläufigkeit, den Warmzustand und das Latenzziel, bevor Sie tunen.
- Der komprimierte KV-Cache und das begrenzte Replay von V4.1 Flash reduzieren den Speicherdruck, garantieren aber keine feste End-to-End-Beschleunigung.
- Vergleichen Sie vLLM und SGLang nur unter übereinstimmenden Bedingungen bei Modell, Hardware, Workload und Messung.
Was bedeutet Durchsatz für DeepSeek V4.1 Flash?
Durchsatz ist eine Rate, aber Zähler und Testgrenze sind entscheidend. Für einen Inferenzdienst sollten Sie mindestens fünf Messungen erfassen:
| Metrik | Was sie aussagt | Typische Verwendung |
|---|---|---|
| Aggregierte Output-Tokens/s | Von allen aktiven Anfragen pro Sekunde erzeugte Output-Tokens | Kapazitätsplanung und Flotteneffizienz |
| Decode-Tokens/s pro Anfrage | Vom einzelnen Request erfahrene Generierungsgeschwindigkeit | Interaktive Reaktionsfähigkeit während der Generierung |
| Prefill-Tokens/s | Pro Sekunde verarbeitete Input-Tokens | Lange Prompts und retrieval-lastige Workloads |
| Zeit bis zum ersten Token (TTFT) | Zeit von der Anfrageankunft bis zum ersten Output-Token | Wahrgenommene Startverzögerung |
| End-to-End-Latenz, p50/p95 | Gesamtdauer einer Anfrage über die Verkehrsverteilung | Service-Level-Ziele und Tail-Verhalten |
Ein Server kann den aggregierten Durchsatz erhöhen, indem er mehr Sequenzen batcht, während jeder Nutzer länger zwischen Tokens wartet. Umgekehrt kann eine für niedrige Nebenläufigkeit optimierte Konfiguration flotte individuelle Antworten liefern, während Beschleuniger unterausgelastet bleiben. Keines der Ergebnisse ist universell besser. Das richtige Ziel ist ein Punkt auf der Durchsatz-Latenz-Kurve, der das Serviceziel Ihres Produkts erfüllt.
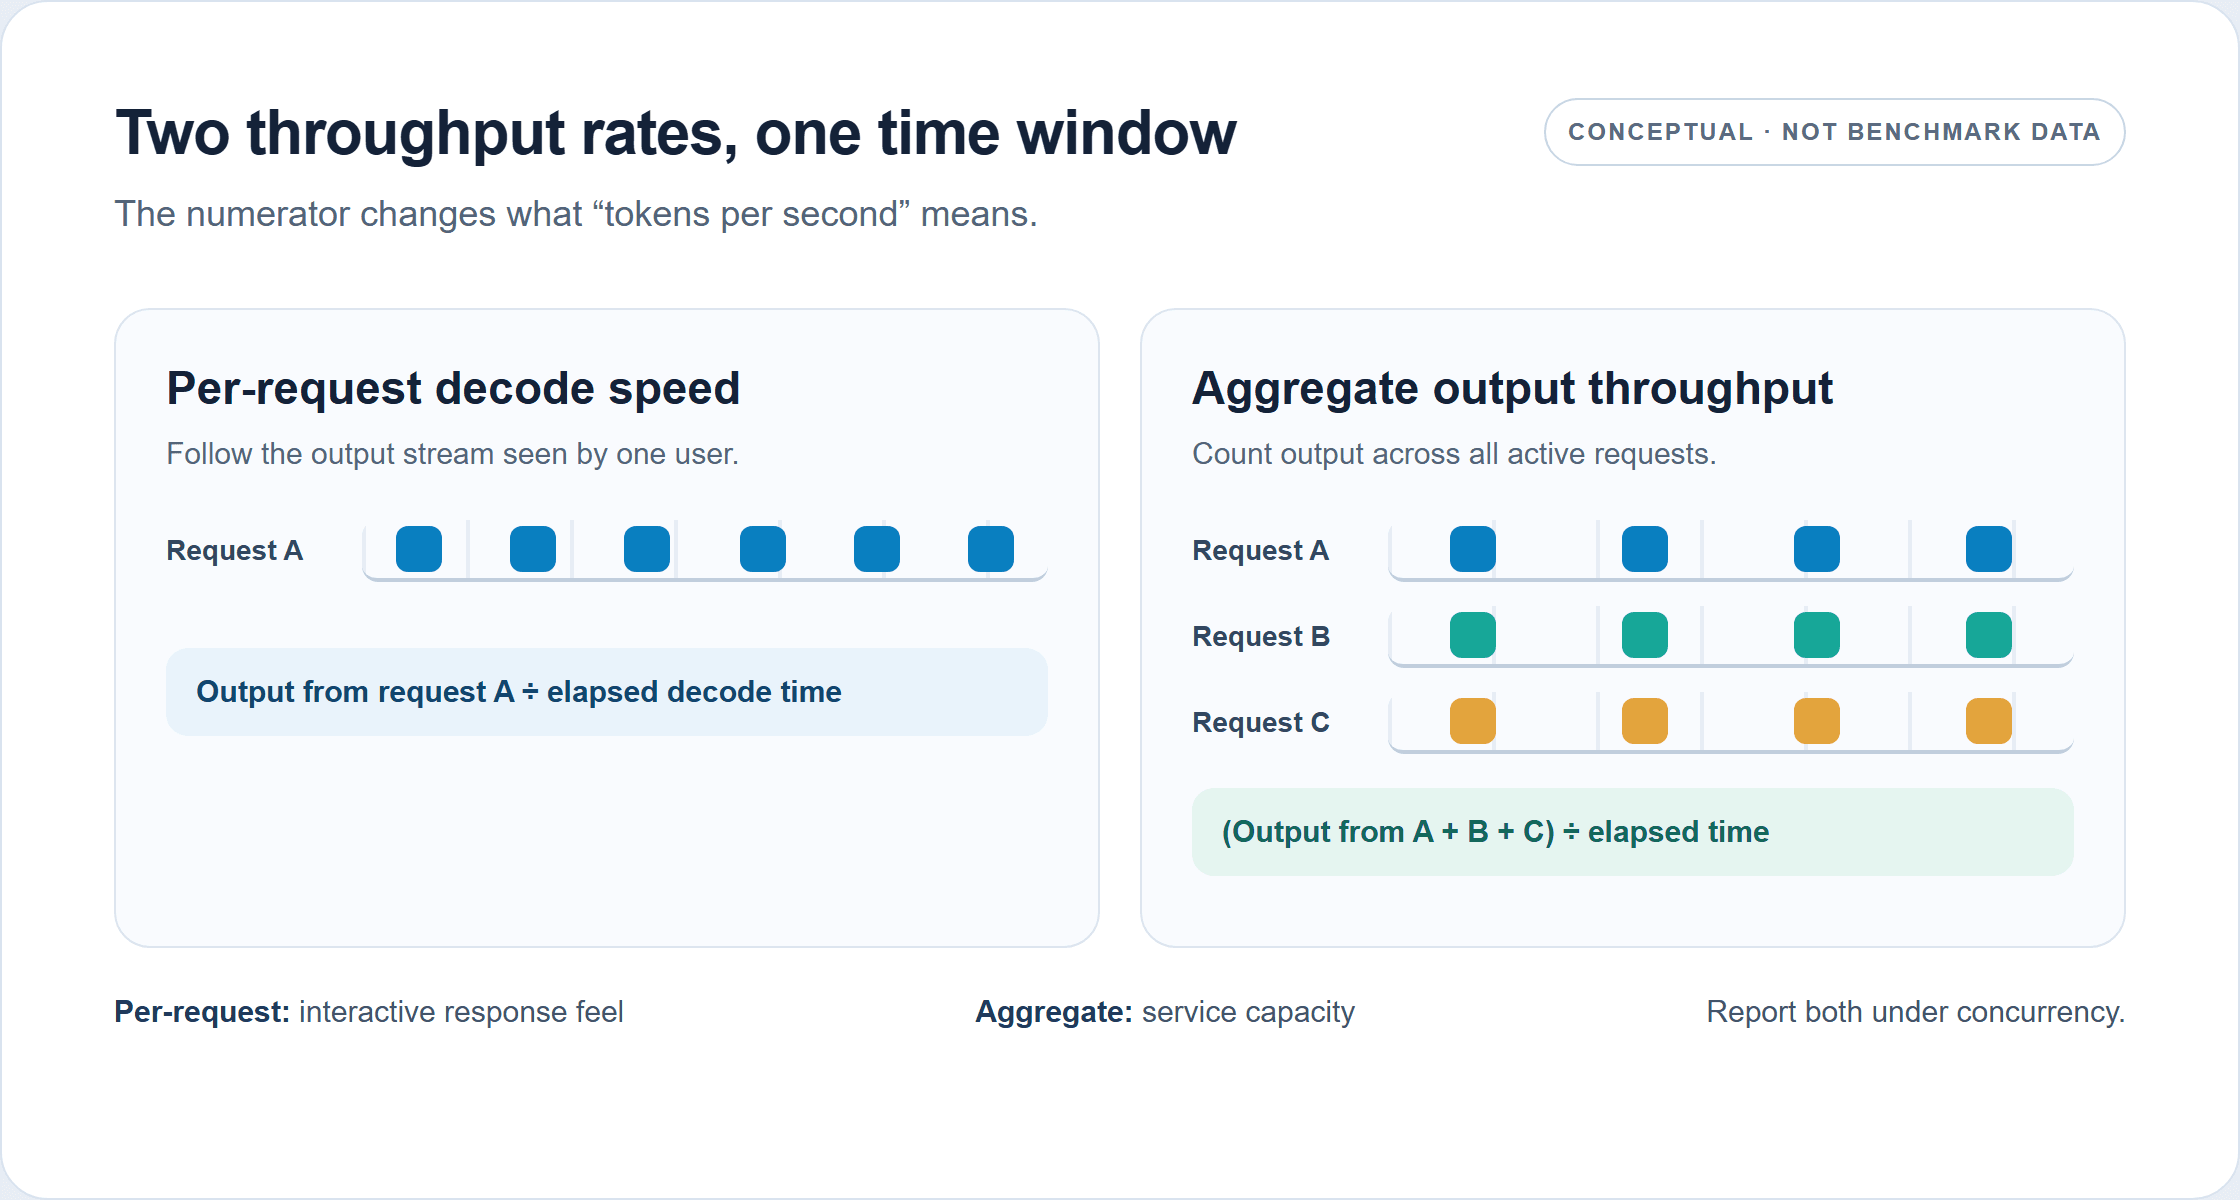
Die beiden Raten zählen unterschiedliche Output-Streams. Dies ist ein konzeptionelles Diagramm, keine gemessene DeepSeek V4.1 Flash-Performance.
Geben Sie an, ob der Durchsatz Prefill, Decode oder beides umfasst. Geben Sie an, ob Sie durch die GPU-Anzahl teilen. Melden Sie erfolgreiche Output-Tokens statt der angeforderten maximalen Tokens und legen Sie Abbrüche oder Fehler offen. Ohne diese Details kann eine Tokens/s-Angabe einem Betreiber nicht sagen, ob sie seine Anwendung vorhersagt.
Eine reproduzierbare DeepSeek V4.1 Flash Baseline erstellen
Eine nützliche Baseline ähnelt dem Produktionsverkehr so stark, dass sie dessen Engpass offenlegt. Ein einzelner kurzer Prompt ist ein schlechter Stellvertreter für einen Agenten, der wiederholt einen großen Gesprächsverlauf sendet, und eine feste Ausgabe von 1.024 Tokens verfehlt Workloads, die früh stoppen oder stark variieren.
Workload und Messfenster festlegen
Erstellen Sie Anfrage-Buckets aus beobachtetem Verkehr. Bewahren Sie für jedes Bucket die ungefähre Input-Länge, erwartete Output-Länge, das Ankunftsmuster und etwaige gemeinsame Präfixe. Beziehen Sie Tool- oder Reasoning-Turns ein, wenn sie Teil des realen Anfragepfads sind. Halten Sie Prompts, Sampling-Einstellungen, Stoppbedingungen und Output-Limits zwischen den Läufen konstant.
Führen Sie sowohl einen Fall mit niedriger Nebenläufigkeit als auch die Nebenläufigkeit aus, die Ihr Service zur Spitzenlast erwartet. Fügen Sie dann Zwischenstufen der Nebenläufigkeit hinzu, um zu erkennen, wo der Durchsatz nicht mehr steigt oder die Latenz ihr Limit überschreitet. Verwenden Sie nach dem Warm-up ein stabiles Messfenster, wiederholen Sie jeden Punkt und melden Sie den Median plus die Spanne. Ein kurzer Burst misst möglicherweise Startverhalten statt stabiler Servicekapazität.
Trennen Sie Kaltstartmessungen vom Warm-Serving. Kalte Läufe umfassen je nach Stack Modellladung, Graph-Capture oder Cache-Befüllung; warme Läufe beschreiben ein System, das bereit zum Servieren ist. Messen Sie bei einem Prefix-Caching-Workload Cache-Hit- und Cache-Miss-Verkehr getrennt. Fassen Sie sie nicht zu einem Durchschnitt zusammen, es sei denn, der Mix entspricht der Produktion.
Ein Benchmark-Protokoll führen
Speichern Sie für jeden Lauf eine Zeile mit diesen Feldern: Checkpoint- oder Modellrevision; Runtime und Commit; GPU-Modell und -Anzahl; Interconnect; Präzision und Quantisierung; Tensor-, Expert- oder Pipeline-Parallel-Layout; Input- und Output-Token-Verteilung; Nebenläufigkeit und Ankunftsmuster der Anfragen; Warm- oder Kaltzustand; Laufdauer; Erfolgsrate; aggregierter Durchsatz; Decode-Geschwindigkeit pro Anfrage; TTFT; und p50/p95-End-to-End-Latenz.
Dieses Protokoll ist nützlicher als eine Leaderboard-Zahl, weil es das nächste Experiment reproduzierbar macht. Frieren Sie es vor dem Tuning ein. Wenn sich Workload oder Checkpoint ändern, starten Sie eine neue Baseline, statt die Differenz einem Serving-Flag zuzuschreiben.
Prefill, Decode, KV-Cache oder Scheduling diagnostizieren
Nutzen Sie Symptome, um die nächste Messung auszuwählen, nicht um eine Lösung zu erraten. Hohe TTFT bei akzeptabler Decode-Geschwindigkeit deutet auf Input-Verarbeitung, Queuing, Cache-Misses oder Start-Overhead hin. Langsames Decode bei niedriger Nebenläufigkeit legt nahe, Kernel, Speicherbandbreite, parallele Kommunikation und den Ausführungspfad des Modells zu untersuchen. Ein aggregierter Durchsatz, der bei steigender Nebenläufigkeit ein Plateau erreicht, kann auf Speicherdruck, Scheduler-Limits, Kommunikations-Overhead oder einen gesättigten Compute-Pfad hindeuten. Degradation bei langem Kontext erfordert die Messung von Cache-Residency, Prefill-Arbeit und Host-zu-Device-Transfer.
| Beobachtung | Erste Prüfungen |
|---|---|
| TTFT steigt mit der Prompt-Länge | Prefill-Rate, Queue-Zeit, Prefix-Cache-Hit-Rate, Graph- oder Kompilierungs-Warm-up |
| Decode-Geschwindigkeit ist selbst bei Nebenläufigkeit 1 niedrig | Runtime-Modellpfad, Kernel-Unterstützung, Präzision, GPU-Auslastung, Kommunikations-Overhead |
| Aggregierte Tokens/s erreichen ein Plateau bei steigender Nebenläufigkeit | KV-Cache-Kapazität, Scheduler-Batching, Speicherbandbreite, parallele Topologie |
| p95-Latenz steigt stark, während sich der aggregierte Output verbessert | Batch-Größe, Queueing-Richtlinie, Mix der Anfragelängen, Serviceziel |
| Lange Prompts verdrängen nützliche aktive Anfragen | KV-Cache-Residency, Cache-Zuordnung, Kontextverteilung, Host-Speicherverkehr |
V4.1 Flash verfügt über Architekturmerkmale, die einige dieser Belastungen mildern sollen. Der Modellbericht beschreibt CSA2 mit Cross-Layer-Cache-Wiederverwendung und globalem FP4-KV-Caching, was einen berichteten globalen KV-Footprint von 890 Bytes pro Token ergibt, etwa ein Viertel des entsprechenden Footprints von V4-Flash. SWA Bounded Replay adressiert einen anderen Speicherkompromiss: Statt den gesamten Zustand der Sliding-Window-Attention zu persistieren, kann eine Bereitstellung fehlenden Zustand rekonstruieren, indem sie das jüngste Fenster erneut abspielt. DeepSeek berichtet für dieses Design von einem persistenten KV-Cache nahe einem Achtel des Footprints von V4-Flash, mit einem kleinen zusätzlichen Aufwand für Prefill-Neuberechnung. Dies sind Architektur- und Deployment-Ergebnisse, kein Versprechen eines achtfachen Durchsatzes. (DeepSeek technical report, September 2026)
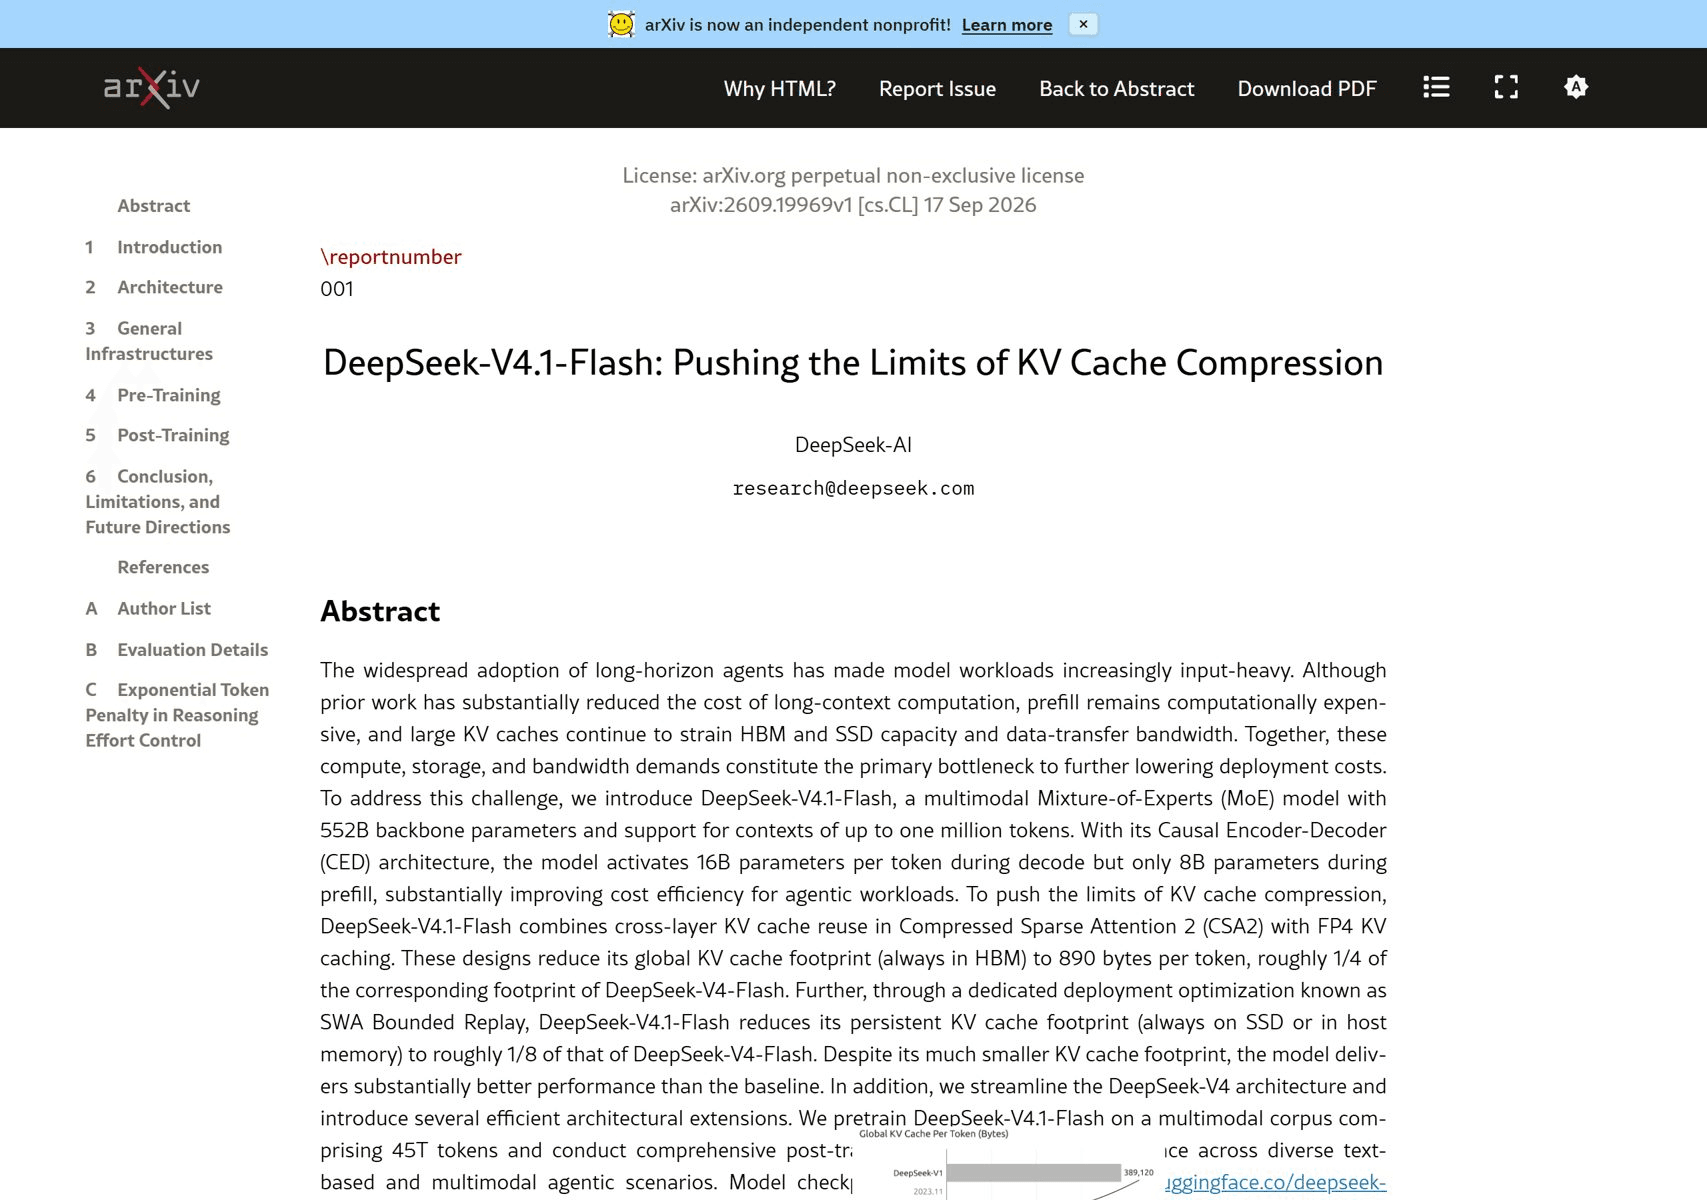
Die Quellabbildung beschreibt Cache-Kapazität, nicht einen End-to-End-Durchsatzmultiplikator für jedes Deployment.
Wenn die Diagnose unklar ist, profilen Sie einen repräsentativen Lauf und prüfen Sie Queue-Zeit, GPU-Auslastung, Speichernutzung und Timing pro Stufe. Ändern Sie eine Variable, führen Sie denselben Workload erneut aus und prüfen Sie die Output-Korrektheit oder Aufgabenqualität. So wird verhindert, dass eine scheinbare Beschleunigung eine Regression im Service oder bei Antworten maskiert.
vLLM oder SGLang gegen dasselbe Ziel tunen
Wählen Sie eine Runtime, deren aktueller Modellpfad den Checkpoint und die Hardware unterstützt, die Sie bereitstellen möchten. Verifizieren Sie die genaue Release, Kernel, das Graph-Verhalten und das parallele Layout. Dass ein Modell als unterstützt aufgeführt ist, bedeutet nicht, dass jede Quantisierung oder Topologie gleichermaßen optimiert ist.
vLLM: Den release-spezifischen Modellpfad validieren
Der Oktober-Bericht des vLLM-Teams beschreibt eine Entwicklung auf seinem AgentX-Benchmark: etwa 1,9× Verbesserung beim Low-Latency-Ergebnis und etwa 5,3× Durchsatz unter einer 150-TPS-Beschränkung gegenüber seiner Day-Zero-Baseline. Die Arbeit umfasste SWA Bounded Replay mit CUDA-Graphen und modellspezifische Kernel-Integration. Betrachten Sie diese Werte als Beleg dafür, dass sich der Stack unter diesem Benchmark im Laufe der Zeit wesentlich verändert hat, nicht als Multiplikatoren, die auf einen anderen Cluster anzuwenden sind. ( vLLM engineering report, Oktober 2026)
Etablieren Sie für Ihren Lauf zuerst eine unterstützte Release und eine bewährte Konfiguration. Messen Sie dann Graph-Capture- oder Replay-Verhalten, Batching und Parallelität einzeln. Behalten Sie die Latenzbeschränkung bei, die zur Auswahl eines höheren Durchsatzpunkts verwendet wurde. Wenn Graph-Capture den Start oder Speicherbedarf verändert, beziehen Sie diese Kosten in die Deployment-Entscheidung ein.
SGLang: Profil der Nebenläufigkeit abgleichen
Der Bericht des SGLang-Teams liefert ein ungewöhnlich klares Beispiel dafür, warum der Testkontext zählt. Auf 8 H200-GPUs stieg sein optimierter Lauf ohne spekulative Dekodierung von ungefähr 76 auf 168 Tokens/s pro Nutzer bei Nebenläufigkeit eins und von etwa 96 auf 221 Output-Tokens/s pro GPU bei Nebenläufigkeit 64. Er verwendete feste 8.192-Token-Inputs und 1.024-Token-Outputs. Seine separaten 4×GB300-Ergebnisse verwendeten andere Prompt-Längen, parallele Einstellungen und DSpark-Spekulativdekodierung. Der Bericht spricht daher dafür, die Optimierungen von SGLang an Ihrem Verkehr zu bewerten und nicht direkt gegen die vLLM-AgentX-Zahlen zu ranken. ( LMSYS/SGLang optimization report, September 2026)
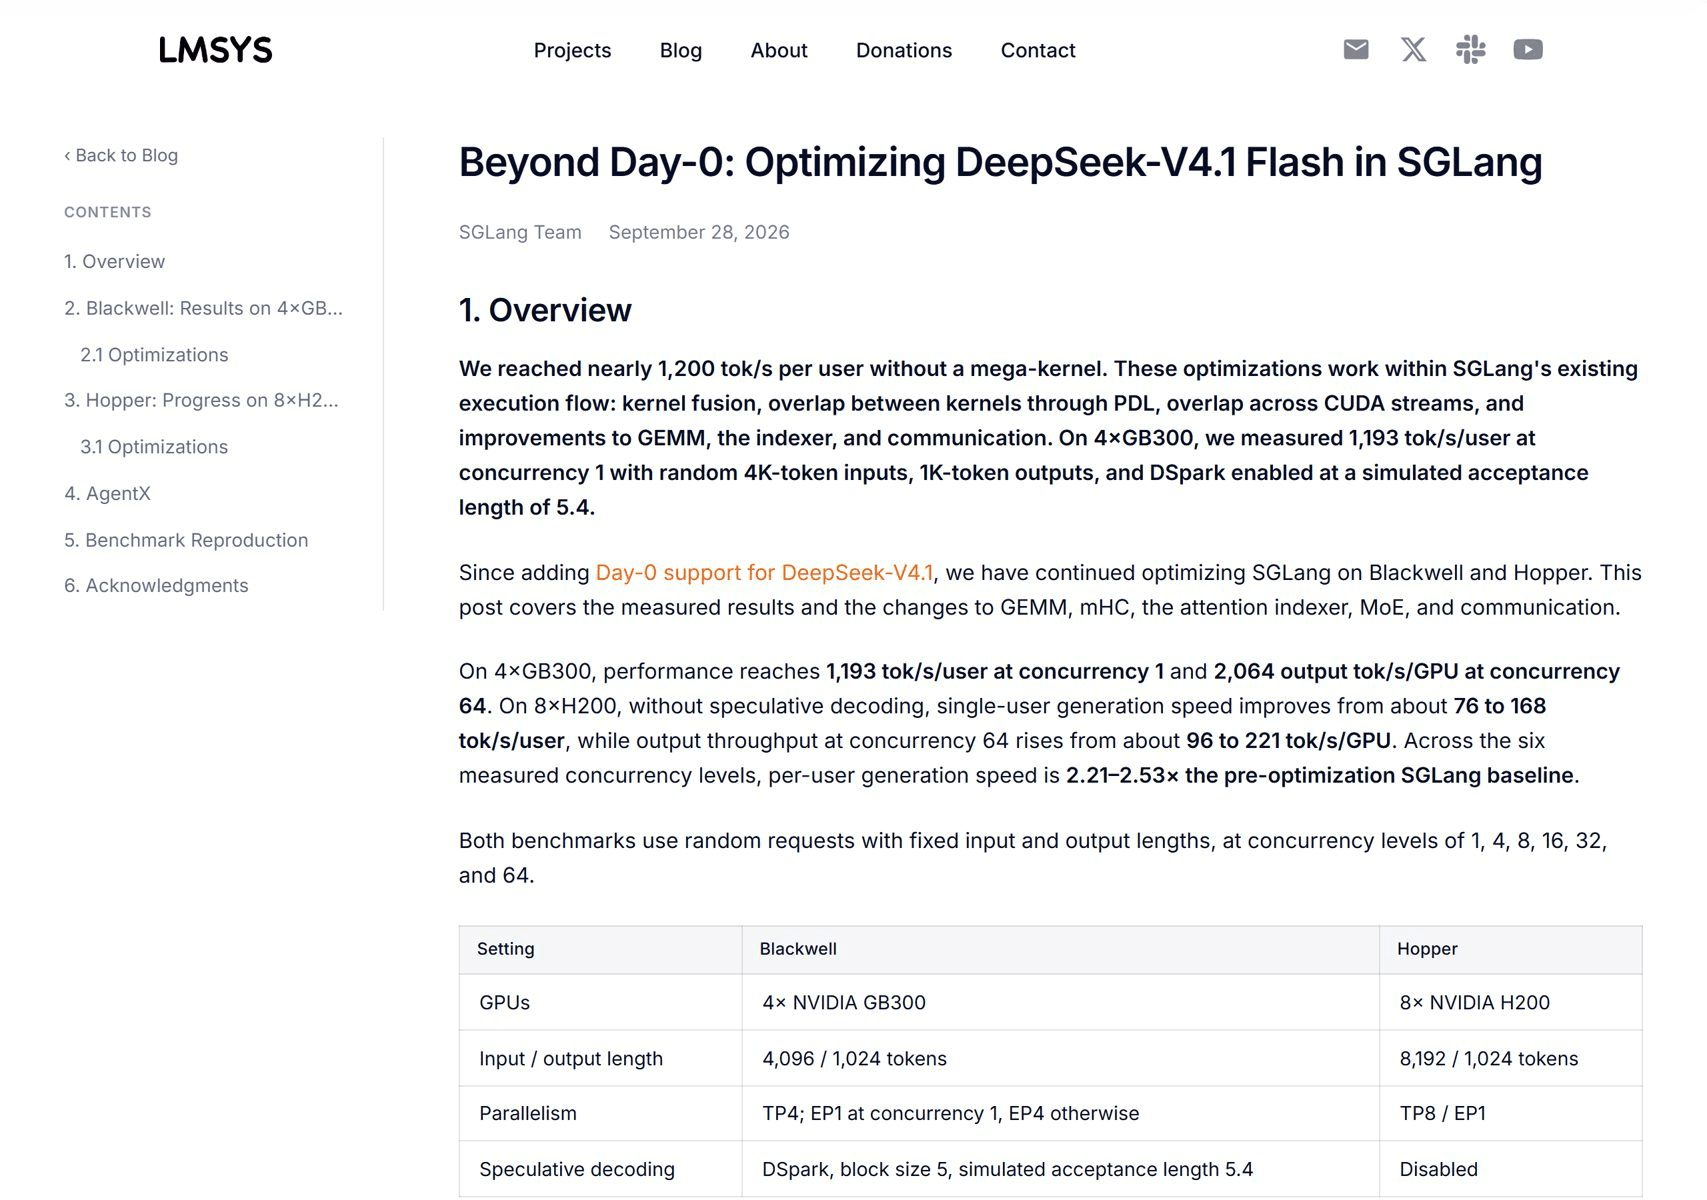
Die Quellberichte verwenden unterschiedliche Workloads und Hardware; ihre Zahlen sollten nicht als direkter Vergleich gelesen werden.
Beginnen Sie mit einer Runtime und optimieren Sie deren unterstützten Pfad. Erstellen Sie nur dann einen Vergleich mit einer zweiten Runtime, wenn Sie Checkpoint, GPU-Zuordnung, Prompt- und Output-Verteilungen, Nebenläufigkeit, Warm-up und Serviceziel konstant halten können. Dieser Vergleich kostet Engineering-Zeit, bestätigen Sie daher zuerst, dass der aktuelle Stack tatsächlich der begrenzende Faktor ist.
Nebenläufigkeit und langen Kontext optimieren, ohne das SLO zu verletzen
Erhöhen Sie die Nebenläufigkeit schrittweise und erfassen Sie bei jedem Schritt aggregierten Output, Decode-Geschwindigkeit pro Anfrage, TTFT, p95-Latenz, Speichernutzung und Fehler. Behalten Sie den Punkt mit dem höchsten Durchsatz nur dann bei, wenn seine Latenz und Fehlerraten weiterhin Ihr Serviceziel erfüllen. Wenn Anfragen vor der Generierung in der Warteschlange stehen, kann ein größerer Batch die Geräteauslastung verbessern, während sich das Produkt langsamer anfühlt.
Messen Sie bei Long-Context-Verkehr die aktive Kontextverteilung und die Cache-Hit-Rate. Ein angegebenes maximales Kontextfenster bedeutet nicht, dass jede Anfrage mit dieser Länge gleichzeitig bedient werden kann. Der KV-Cache konkurriert mit Gewichten, Aktivierungen, Graph-Pools und Runtime-Puffern um Speicher. Lassen Sie Headroom für variable Anfragelängen und messen Sie Eviction oder Preemption unter realistischem Verkehr.
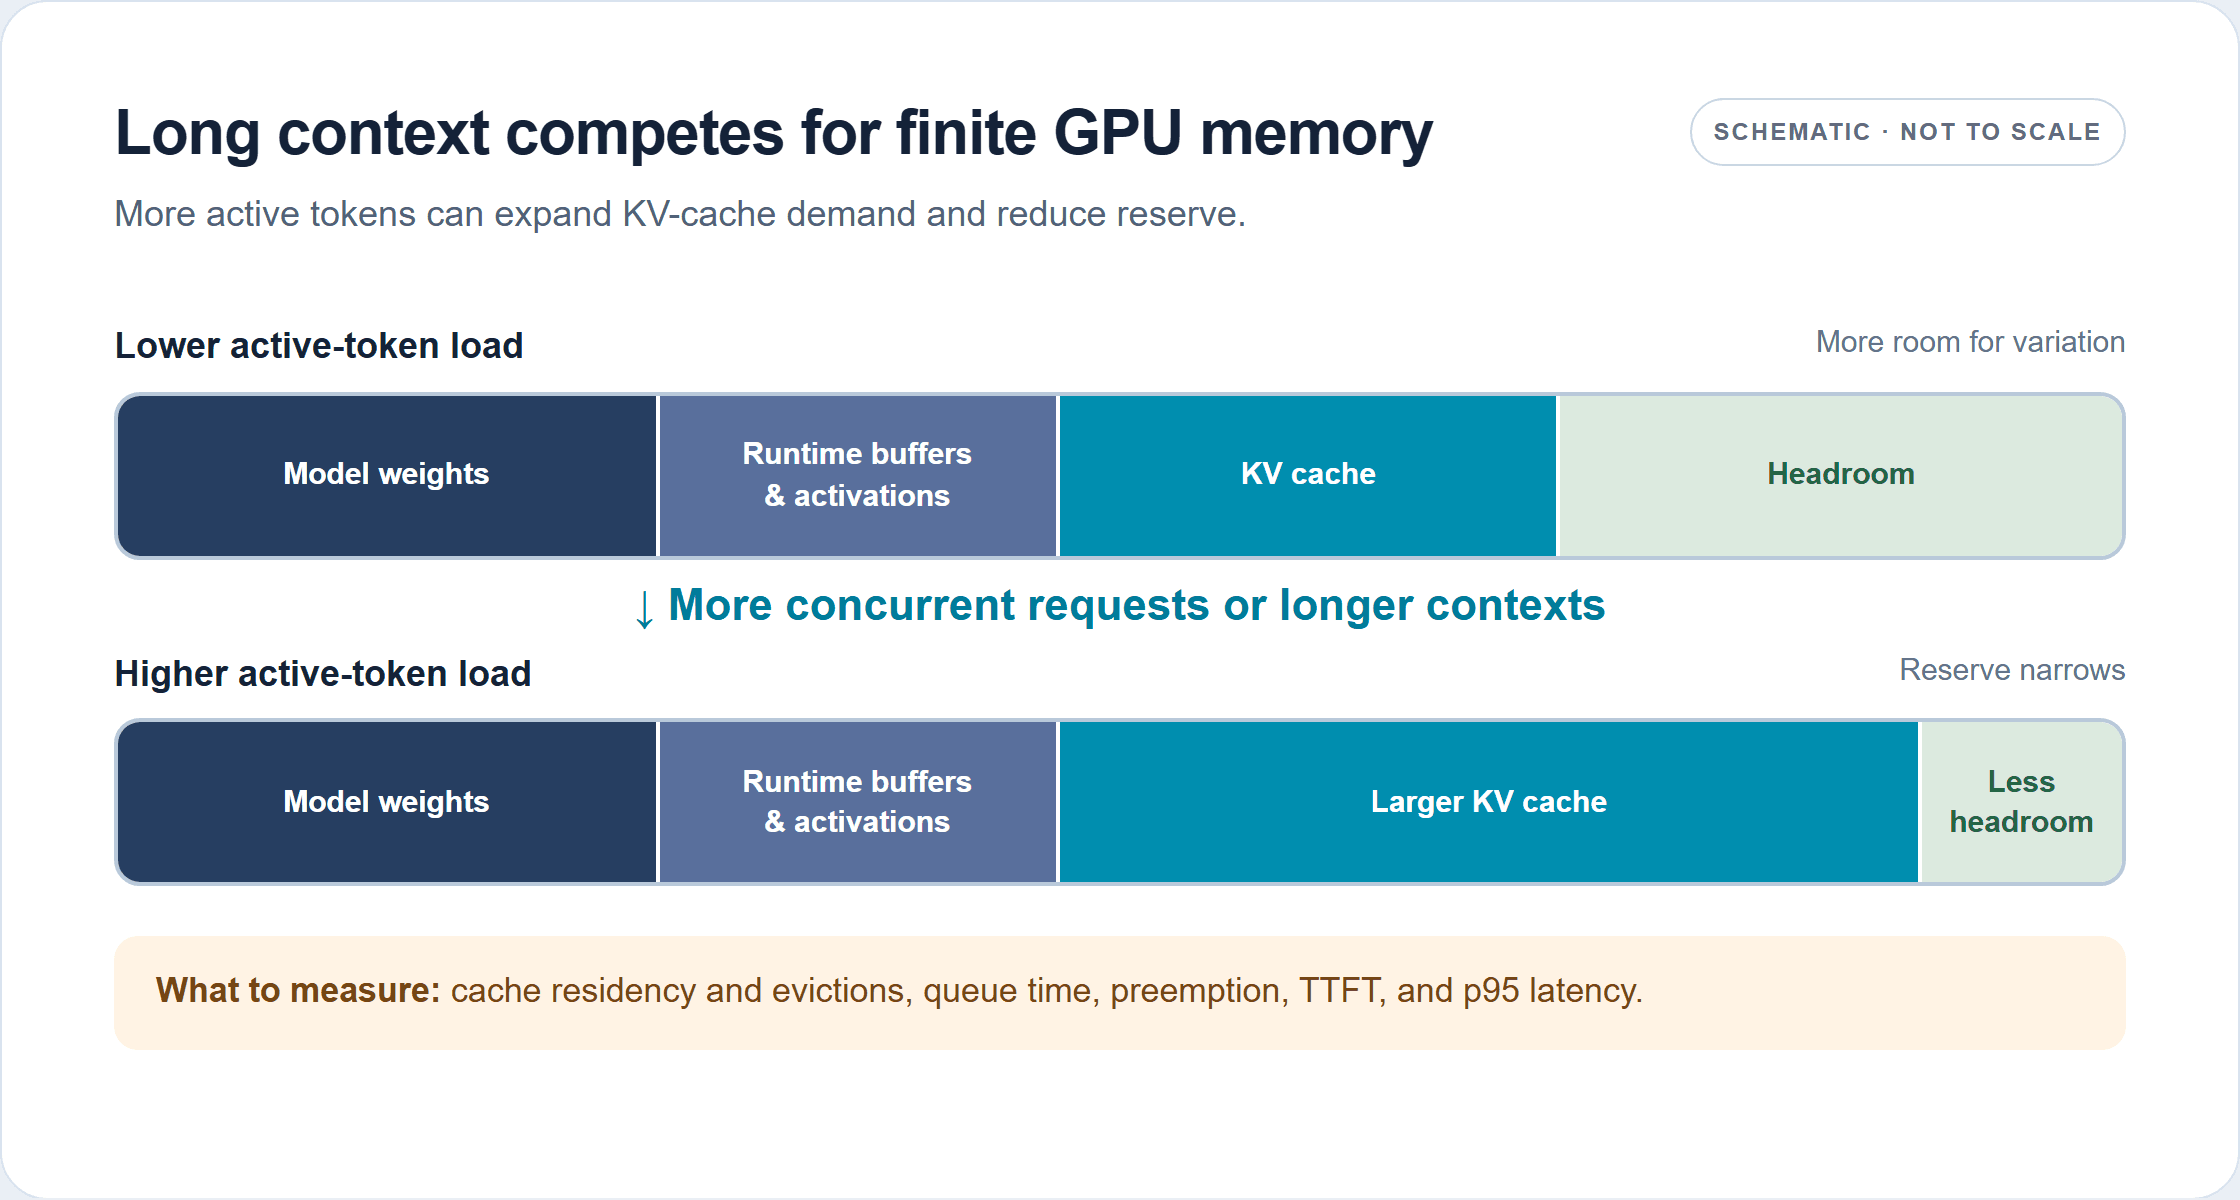
Längere Kontexte oder mehr gleichzeitige Anfragen können den KV-Cache-Bedarf erhöhen. Die Speicherblöcke sind schematisch und nicht maßstabsgetreu.
Behandeln Sie Quantisierung, KV-Cache-Präzision, Tensor-Parallelität, Expert-Parallelität und Prefill/Decode-Disaggregation als separate Experimente. Sie können Speichernutzung, Kommunikation, Kernel-Auswahl, Output-Qualität und Latenz verändern. Das beste Layout hängt von GPU-Typ und Interconnect ab; mehr GPUs können die Kommunikationskosten erhöhen oder einige Ressourcen ungenutzt lassen. Verifizieren Sie nach Änderungen an Präzision oder Modellausführung die exakte Output-Qualität und Fehlermodi.
Die praktische Reihenfolge ist einfach: Baseline reproduzieren, die Metrik identifizieren, die ihr Ziel verfehlt, eine Engpass-Hypothese bilden, eine Einstellung ändern und wiederholen. Wenn die Einstellung eine Metrik verbessert und eine andere verschlechtert, entscheiden Sie explizit, ob dieser Kompromiss zum Produkt passt. So wird Optimierung eine kontrollierte Entscheidung statt eines Haufens von Flags.
Spekulative Dekodierung und jede behauptete Beschleunigung validieren
Spekulative Dekodierung kann die serielle Arbeit am Zielmodell reduzieren, wenn Draft-Tokens effizient akzeptiert werden und die Runtime die Verifikation gut implementiert. Ihr Nutzen hängt vom Draft-Pfad, Akzeptanzverhalten, Batch-Form, Hardware und Prompt-/Output-Mix ab. Sie kann decode-gebundenem Verkehr helfen und wenig Wert haben, wenn Prefill, Queuing oder Kommunikation dominieren.
Führen Sie einen A/B-Test mit aktivierter und deaktivierter Spekulation durch. Halten Sie Modell-Checkpoint, Prompt-Set, Token-Limit, Ankunftsmuster, Nebenläufigkeit, Warm-up und Messfenster konstant. Erfassen Sie, falls verfügbar, akzeptierte Tokens pro Verifikationsschritt zusammen mit aggregiertem Durchsatz, Geschwindigkeit pro Anfrage, TTFT, p95-Latenz, GPU-Nutzung, Fehlern und Aufgabenqualität. Eine simulierte Akzeptanzlänge in einem veröffentlichten Benchmark ist eine Testbedingung, kein Wert, der für Ihre Prompts angenommen werden sollte.
Eine behauptete Beschleunigung ist nur nützlich, wenn sie drei Prüfungen besteht: dasselbe Serviceziel, akzeptable Antwortqualität und ein fairer Kostenvergleich. Berichten Sie bei jeder Zahl, die Sie veröffentlichen, den vollständigen Kontext. Vermeiden Sie es, unterschiedliche GPU-Anzahlen, Prompt-Längen, Output-Längen, Präzisionsmodi, Modellrevisionen oder Metriken zu vergleichen, als wären sie ein kontrolliertes Experiment.
Selbst hosten oder eine verwaltete DeepSeek V4.1 Flash API verwenden?
Selbst-Hosting ist sinnvoll, wenn der Verkehr stabil genug ist, um die GPUs sinnvoll zu nutzen, das Team Inferenzinfrastruktur betreiben kann und die Kontrolle über Hardware oder Ausführung den operativen Aufwand rechtfertigt. Beziehen Sie die vollen Kosten für Beschleuniger, Kapazitäts-Headroom, Strom, Netzwerk, Speicher, Wartung und Engineering-Zeit ein. Ein hohes Spitzen-Tokens/s-Ergebnis allein belegt keine niedrigeren Kosten pro erfolgreicher Aufgabe.
Eine verwaltete API ist nützlich, wenn ein Team die Produktnachfrage schnell validieren, den Betrieb einer Serving-Flotte vermeiden oder eine API-Baseline mit seinem eigenen Deployment vergleichen muss. Atlas Cloud führt DeepSeek V4.1 Flash unter der Modell-ID deepseek-ai/deepseek-v4.1-flash mit einer OpenAI-kompatiblen API auf. Die DeepSeek V4.1 Flash Modellseite zeigt derzeit $0.30 pro Million Input-Tokens, $1.20 pro Million Output-Tokens und $0.03 pro Million Cache-Read-Tokens, mit keinem angezeigten Rabatt Stand Oktober 2026. Prüfen Sie die aktuelle Preisliste vor der Schätzung von Ausgaben. Ein verwalteter Endpoint beseitigt nicht die Notwendigkeit, Ihre eigene Anfragelatenz oder Verkehrsökonomie zu messen.
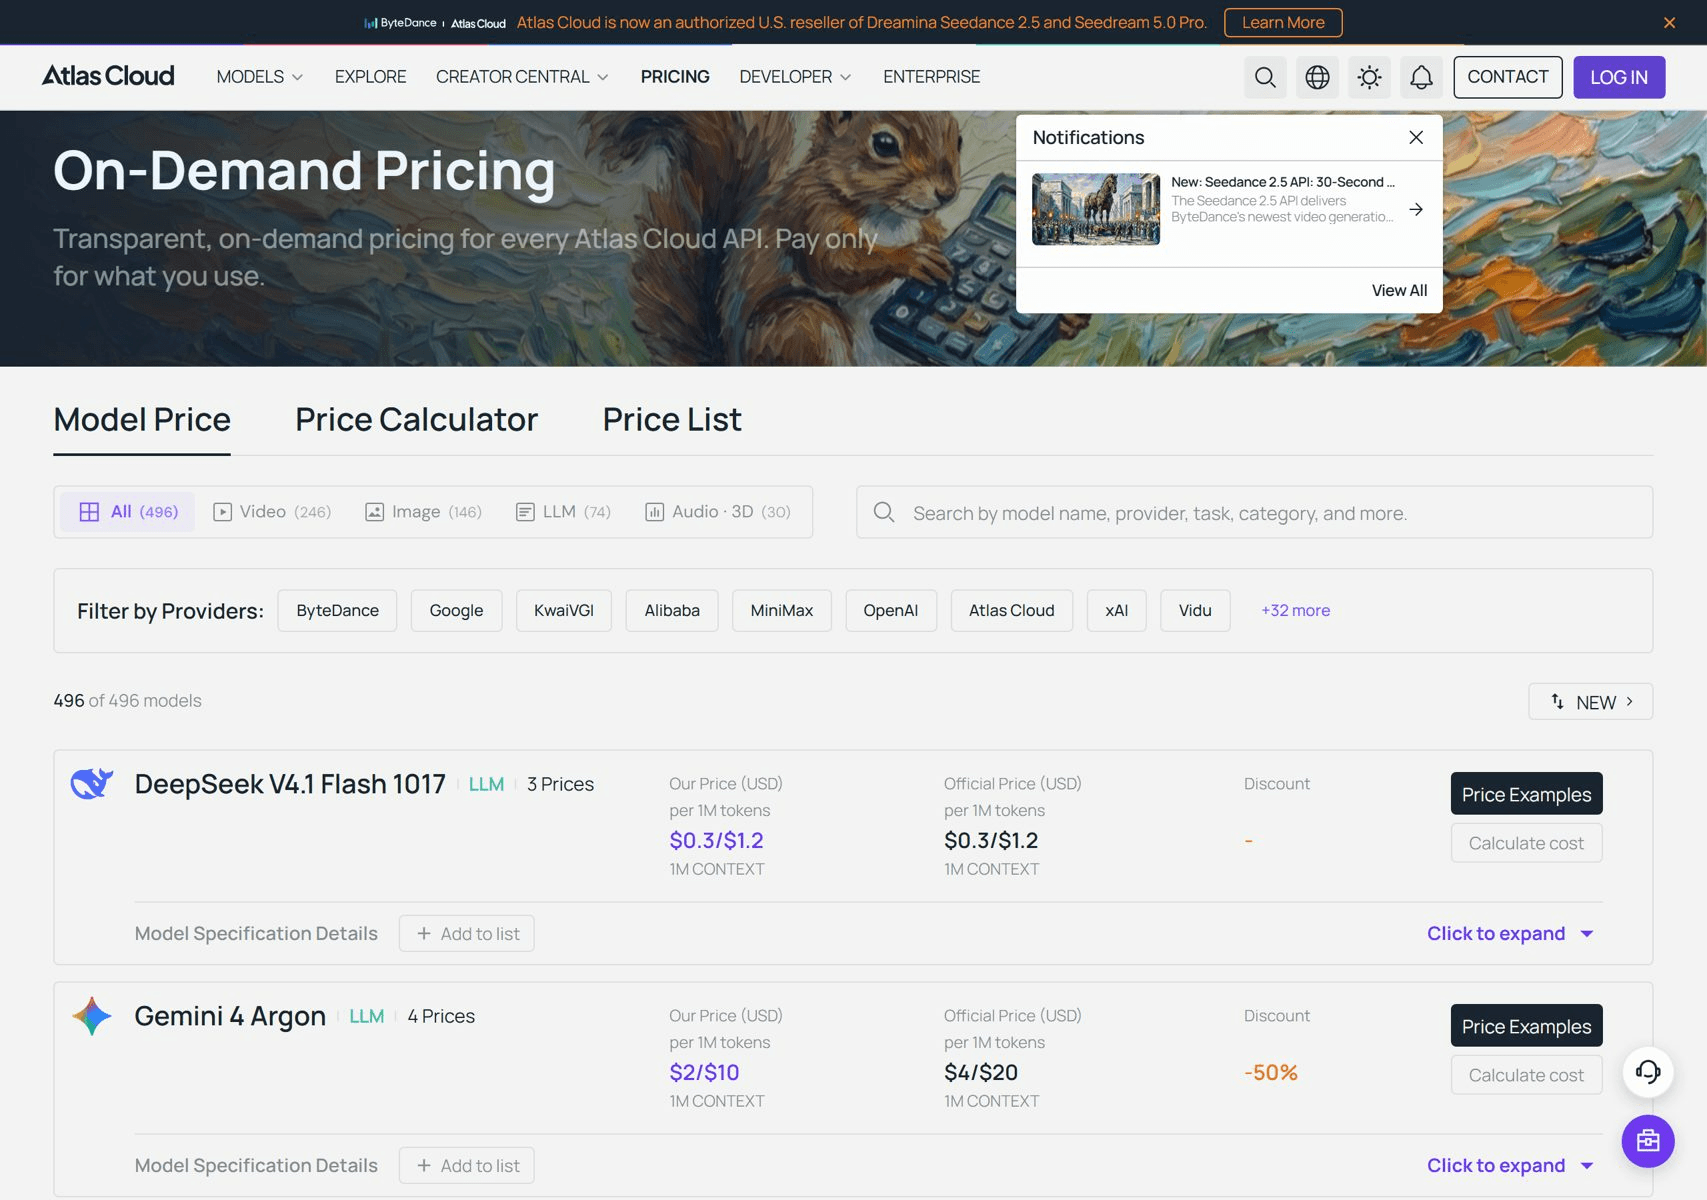
Das Listing weist auf eine verwaltete API-Option hin; es ist kein Serving-Benchmark.
Für eine faire Deployment-Entscheidung spielen Sie dieselben Geschäftsanfragen gegen den selbst gehosteten Service und den verwalteten Endpoint erneut ab. Vergleichen Sie Kosten pro abgeschlossener Aufgabe, Latenzverteilung, Zuverlässigkeit und den Personalaufwand für die Wartung jeder Option. Wenn Ihr Hauptziel die DeepSeek V4.1 Flash Inferenz-Durchsatzoptimierung ist, behalten Sie für beide Wege denselben Workload und dieselben Erfolgskriterien bei.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Durchsatz und Tokens pro Sekunde pro Nutzer?
Aggregierter Durchsatz zählt Output über aktive Anfragen. Tokens/s pro Nutzer messen die Decode-Rate einer Anfrage. Batching kann den ersten Wert erhöhen und gleichzeitig den zweiten senken; melden Sie daher beide für interaktive Services.
Verbessert eine Erhöhung der Nebenläufigkeit immer den Durchsatz?
Nein. Der aggregierte Output kann steigen, bis Compute oder Speicher sättigen, und dann ein Plateau erreichen. Queuing und Tail-Latenz können sich danach weiter verschlechtern. Hören Sie auf, die Nebenläufigkeit zu erhöhen, wenn das Serviceziel verfehlt wird.
Können vLLM- und SGLang-Benchmark-Zahlen direkt verglichen werden?
Nur wenn Modellrevision, Hardware, Prompt- und Output-Längen, Nebenläufigkeit, Warmzustand, Messgrenze und Latenzbeschränkung übereinstimmen. Veröffentlichte Berichte verwenden unterschiedliche Setups und zeigen daher Optimierungspfade statt eines direkten Runtime-Siegers.
Wann sollte ich eine verwaltete API statt Selbst-Hosting verwenden?
Verwenden Sie eine verwaltete API, wenn Integrationsgeschwindigkeit und reduzierter Infrastrukturaufwand wichtiger sind als das Eigentum am Serving-Stack. Hosten Sie selbst, wenn Auslastung, operatives Know-how, Kontrolle und ein gemessener Gesamtkostenfall den Betrieb der GPUs rechtfertigen.





