Ein Kontextfenster mit einer Million Tokens sagt Ihnen, wie viel Text ein Modell akzeptieren darf – nicht, wie zuverlässig es jede Klausel interpretiert. Für die Genauigkeit der Langdokumentanalyse von DeepSeek V4.1 Flash sind die öffentlich verfügbaren Belege nützlich, aber unvollständig: Die Modellkarte von DeepSeek meldet 45,2 Exact-Match auf LongBench-V2 für das V4.1 Flash Basismodell in einem 1-Shot-Setup, während die API inzwischen auf einen neueren 1017-Build umgestellt wurde. Dieser Benchmark ist ein Signal zu einem Evaluierungssetup, keine Erfolgsquote für Ihren Vertrag, Ihren Jahresbericht oder Ihr Forschungsarchiv.
Die praktische Antwort lautet, Flash für schnelles Retrieval und eine erste Synthese zu verwenden und dann für wichtige Entscheidungen Belege auf Seitenebene sowie menschliche Prüfung zu verlangen. Keine hier zitierte öffentliche Quelle bietet eine reproduzierbare Evaluierung des aktuellen Builds über die fünf unten stehenden Dokumentaufgaben. Der Testplan ist ein sofort ausführbares Protokoll, keine Behauptung, dass diese Durchläufe bereits stattgefunden haben.
Wichtige Erkenntnisse
- Die Modellfamilie unterstützt bis zu 1 Mio. Tokens, aber ein Kontextlimit ist keine Genauigkeitsgarantie.
- Der veröffentlichte LongBench-V2-Wert von 45,2 gilt für das Basismodell und ein 1-Shot-Benchmark-Setup.
- Die DeepSeek-API stellt jetzt V4.1-Flash-1017 bereit; die Release Notes veröffentlichen keinen neuen Langdokumentwert.
- Fragen Sie nach Belegstellen, prüfen Sie sie anhand der Quelle und messen Sie Fehler an Ihren eigenen Dokumenten.
Was das 1 Mio.-Token-Fenster für die Dokumentenanalyse bedeutet
Die Modellkarte von DeepSeek beschreibt V4.1 Flash als Unterstützung von Kontexten bis zu einer Million Tokens. Die API-Dokumentation bezeichnet das aktuell bereitgestellte Modell als DeepSeek-V4.1-Flash-1017 und nennt eine Kontextlänge von 1 Mio. Das sind Kapazitätsspezifikationen. Sie belegen nicht, wie oft das Modell eine Fußnote findet, zwei Dokumentversionen auseinanderhält oder zugibt, dass eine angeforderte Information fehlt. (DeepSeek model card)
Ein Token ist keine Seite. Die Seitenzahl variiert je nach Tabellen, Fußnoten, Layout, Sprache und Extraktionsqualität. Ein gescanntes PDF kann OCR benötigen; eine Tabelle kann ihre Zeilenbeschriftungen verlieren, wenn sie in Text umgewandelt wird; Kopfzeilen und wiederkehrende Seitenelemente können Kontext verbrauchen, ohne bei der Frage zu helfen. Auch der Prompt und die angeforderte Antwort verbrauchen Tokens. Eine nominale Obergrenze von einer Million Tokens bedeutet daher nicht, dass jede Datei mit einer Million Tokens über jede Chat-Oberfläche oder jeden API-Client unverändert ankommt.
Erfassen Sie vor einem Test die genaue Modellkennung, den Client und die Eingabemethode. Prüfen Sie, ob der vollständige extrahierte Text gesendet wurde, ob der Anbieter ihn gekürzt hat und ob die Anfrage die erwartete Modellversion erreicht hat. Die aktuelle DeepSeek API verwendet deepseek-flash für den neuesten Flash-Build. Wenn Ihr Gateway oder SDK einen anderen Alias verwendet, erfassen Sie diesen Alias und überprüfen Sie sein Routing. Teams, die wiederholbare gehostete Aufrufe einrichten, können mit der Modellplattform von Atlas Cloud beginnen und dann den API-Eintrag zu DeepSeek V4.1 Flash öffnen.
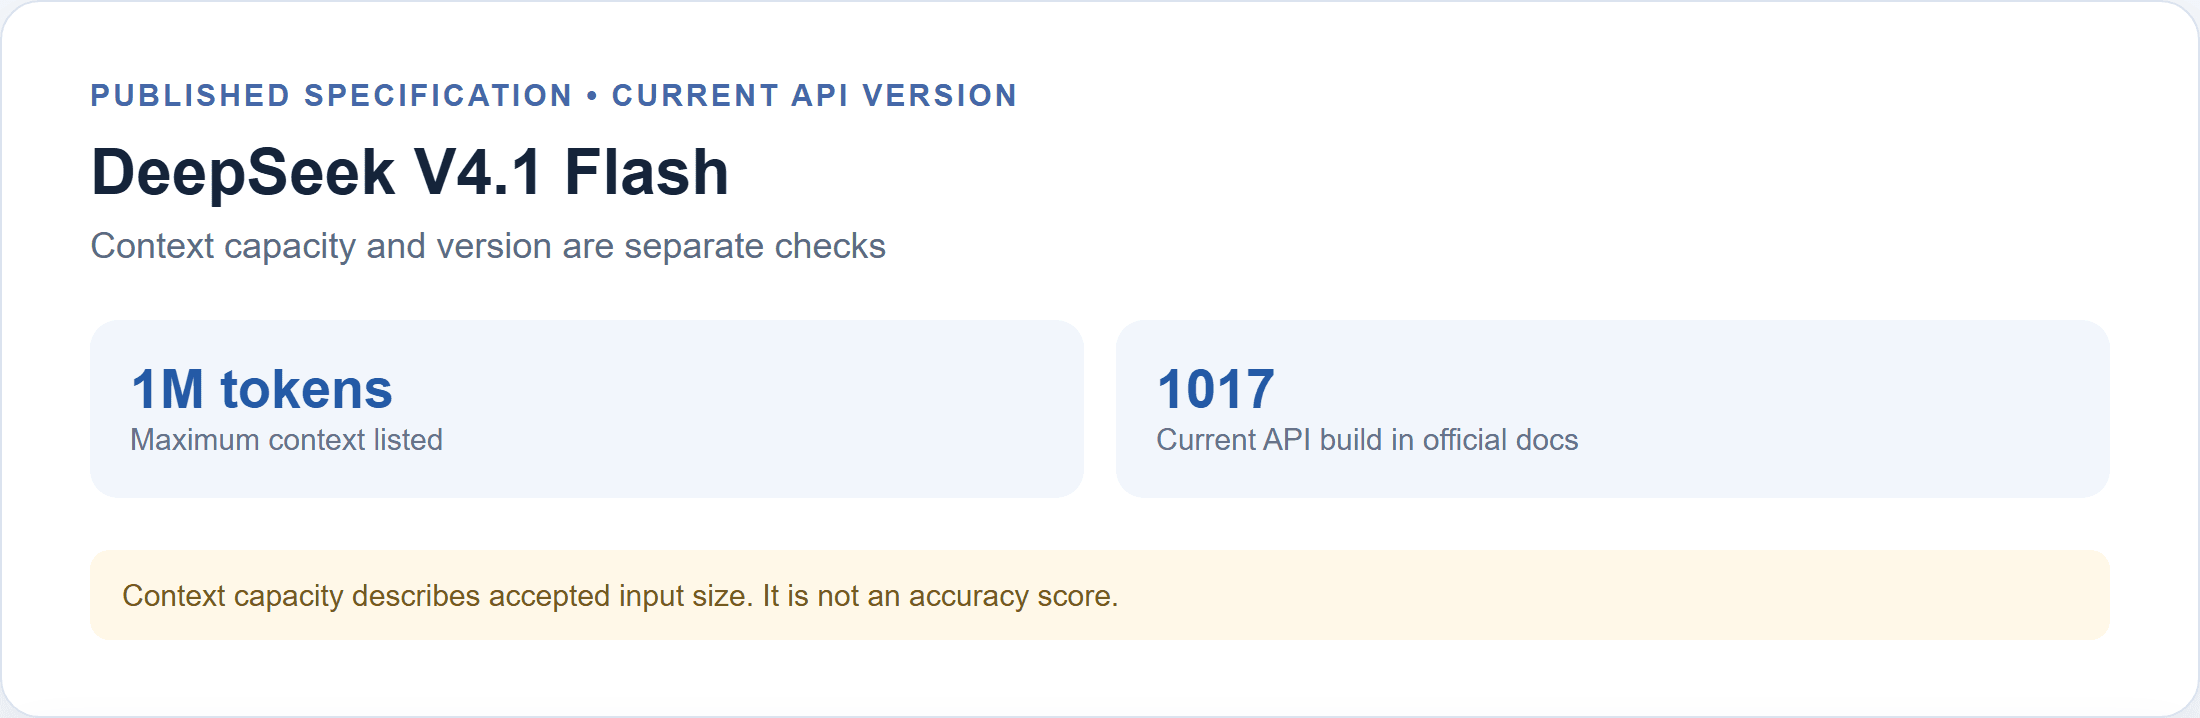
Die veröffentlichte Spezifikation nennt maximal 1 Mio. Kontext; die aktuelle API-Dokumentation weist den 1017-Build aus.
Ein erfolgreicher Upload oder eine erfolgreiche Anfrage zeigt nur, dass das System eine Eingabe akzeptiert hat. Um sicherzustellen, dass ein relevantes Detail die Antwort beeinflusst hat, fragen Sie nach einer genauen Fundstelle, rufen Sie die Passage ab und bestätigen Sie, dass der umgebende Text die Aussage stützt.
Was der LongBench-V2-Wert zeigt – und was nicht
Die LongBench-V2-Zeile der Modellkarte meldet Exact-Match-Werte unter einem 1-Shot-Setup. Die Tabelle kennzeichnet die Ergebnisse als Basismodell-Evaluierungen und gibt an, dass alle Basismodelle dasselbe interne Evaluierungsframework verwenden. Außerdem heißt es dort, dass Werte innerhalb von 0,3 als gleichwertig gelten. Die Werte sind:
| Basismodell in der Modellkarte | LongBench-V2 (EM) | Shots |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
Der Abstand von 0,5 Punkten zwischen V4-Flash-Base und V4.1-Flash-Base ist größer als das in der Karte angegebene Äquivalenzband von 0,3, bleibt aber ein knapper Benchmark-Vergleich. Die 45,2 sind keine „45,2 % Genauigkeit bei langen PDFs“. Es ist ein Exact-Match-Wert für ein bestimmtes Basismodell, Benchmark-Set, Prompt-Setup und einen bestimmten Evaluator. Er bewertet nicht direkt ein gehostetes Instruct-/API-Modell, das Ihre Fragen mit einem anderen Prompt beantwortet.
LongBench-V2 enthält 503 Multiple-Choice-Fragen in sechs Kategorien, darunter Einzeldokument- und Mehrdokument-Fragebeantwortung, lange Dialoge, Code-Repositories und strukturierte Daten. Seine Kontexte reichen von 8.000 bis 2 Millionen Wörtern. Die Autoren des Benchmarks berichten von 53,7 % durchschnittlicher Genauigkeit für Expertinnen und Experten unter einem 15-Minuten-Limit und 50,1 % für das beste direkt antwortende Modell in ihrer berichteten Evaluierung. Seine Breite macht es zu einem nützlichen Stresstest, aber eine aggregierte Zahl kann nicht diagnostizieren, welche Dokumentoperation stark oder schwach ist. (LongBench-V2-Paper)
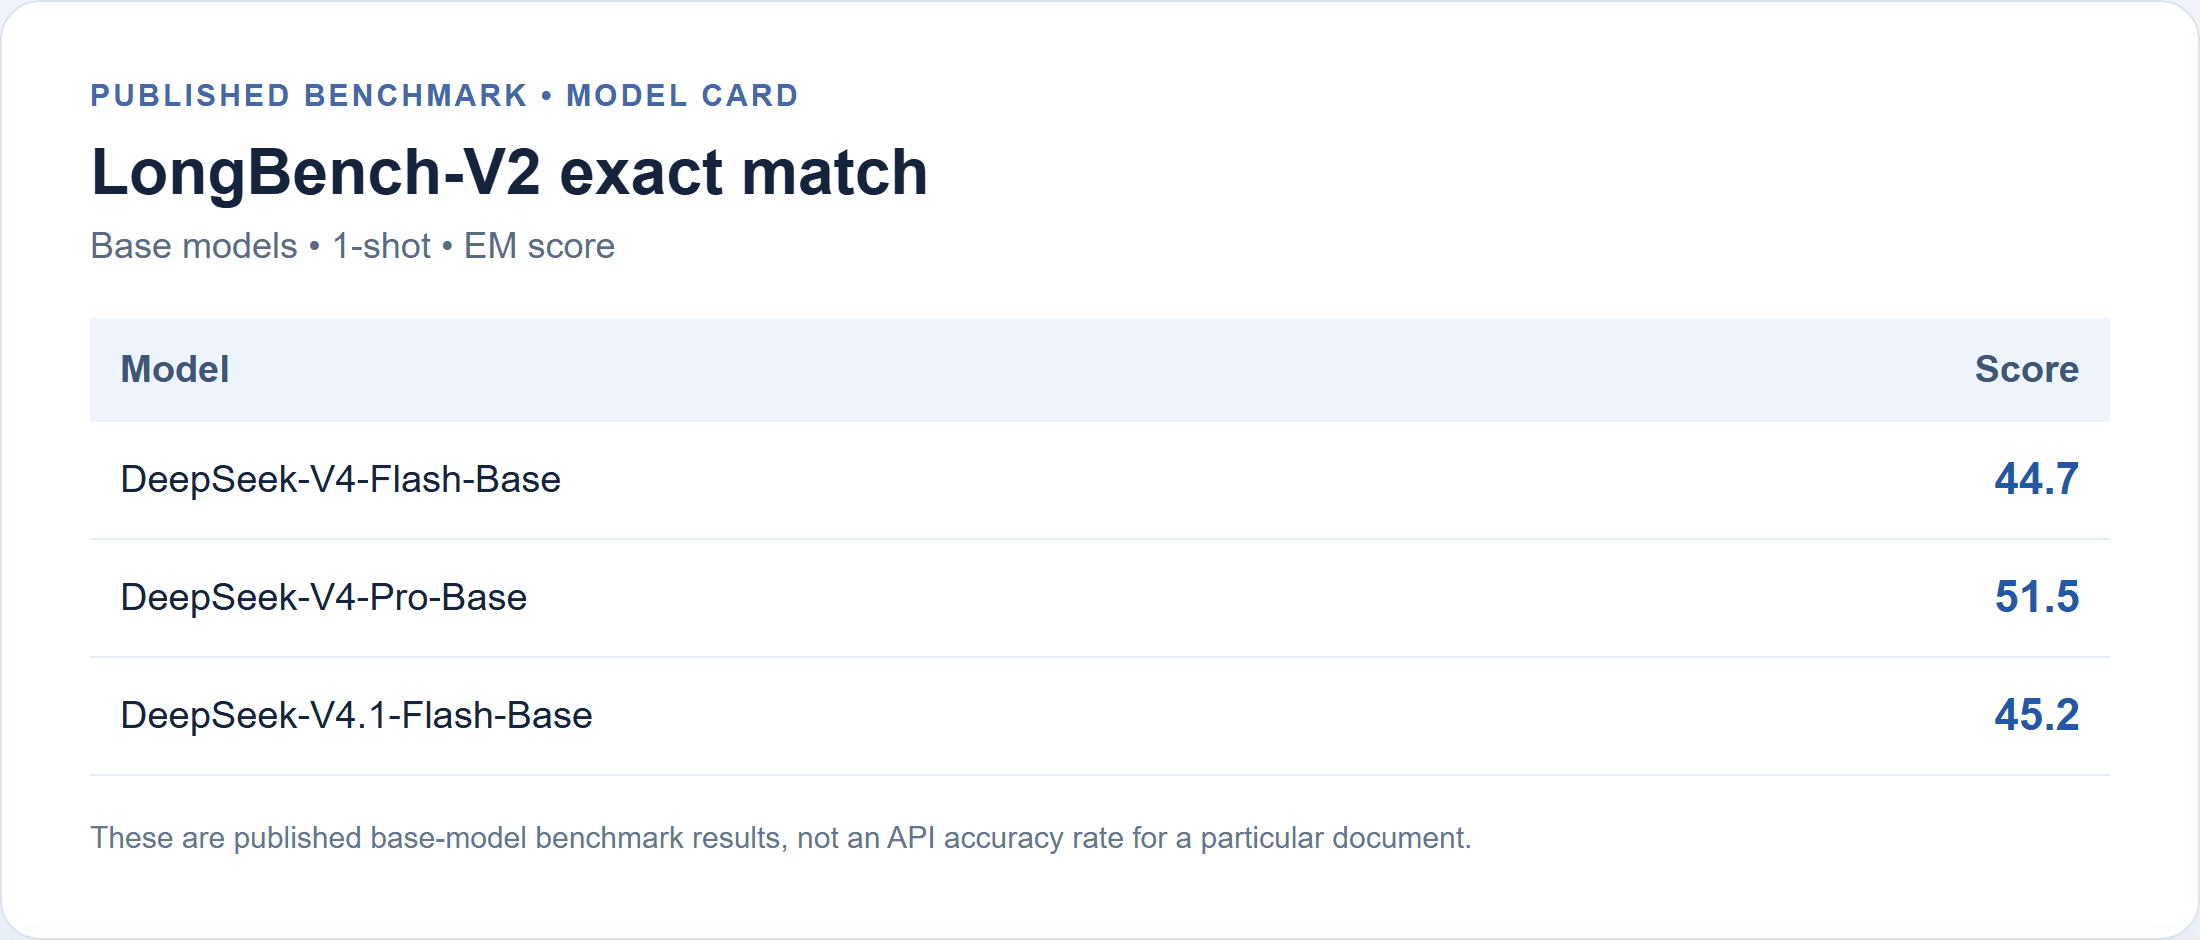
Die veröffentlichte Zeile ist ein Basismodell-1-Shot-Ergebnis. Sie ist keine gemessene API-Erfolgsquote.
Es gibt einen Versionsvorbehalt. In den Release Notes von DeepSeek vom 17. Oktober heißt es, dass die API und die Web-App auf V4.1-Flash-1017 aktualisiert wurden und der API-Modellname weiterhin deepseek-flash lautet. Die Release Notes listen aktualisierte Agent- und Reasoning-Benchmarks auf, berichten aber nicht über ein neues LongBench-V2-Ergebnis. Somit bleibt 45,2 eine nützliche veröffentlichte Referenz für das V4.1 Flash Basismodell, während die Genauigkeit des aktuellen API-Builds bei Langdokumentfragen in diesen Quellen nicht quantifiziert wird. Übertragen Sie unabhängige Benchmark-Gewinne nicht auf Dokument-QA. (DeepSeek V4.1-Flash-1017-Update)
So führen Sie einen fairen Genauigkeitstest für lange Dokumente durch
Eine nützliche Evaluierung benötigt eine feste Quelle, einen Lösungsschlüssel und Bewertungsregeln. Beginnen Sie mit einem öffentlichen Jahresbericht oder technischen Bericht, dessen Version und Seitenstruktur geteilt werden können. Speichern Sie das PDF und den extrahierten Text, erfassen Sie Quell-URL und Abrufdatum und notieren Sie, ob Sie native Textextraktion oder OCR verwendet haben. Wählen Sie kein Dokument nur deshalb aus, weil Sie bereits wissen, dass das Modell damit gut umgeht.
Bevor Sie das Modell mit einem Prompt versehen, schreiben Sie den Lösungsschlüssel selbst aus der Quelle. Erfassen Sie für jede Frage die erwartete Antwort und die genaue Seite oder den Abschnitt. So wird verhindert, dass eine überzeugende Antwort zum Bewertungsmaßstab wird. Formulieren Sie Fragen spezifisch genug für die Bewertung, ohne die Mehrdeutigkeit zu beseitigen, mit der eine Leserin oder ein Leser tatsächlich konfrontiert wäre.
Verwenden Sie für jeden Durchlauf dasselbe Dokument, denselben Fragensatz, dieselbe Modellkennung, denselben Prompt, dieselbe Reasoning-Einstellung und dasselbe Ausgabeformat. Wenn die API Temperatur- oder Reasoning-Steuerungen offenlegt, erfassen Sie diese. Führen Sie den Satz mehr als einmal aus, wenn Sie die Variabilität schätzen möchten; ein Durchlauf ist eine Stichprobe, keine stabile Rate. Korrigieren Sie die Ausgabe nicht stillschweigend, bevor Sie sie bewerten.
Ein kompakter Satz kann fünf verschiedene Fehlermöglichkeiten abdecken:
| Aufgabe | Beispielhafte Frageform | Was zu überprüfen ist |
|---|---|---|
| Einzelpunkt-Suche | „Welches Datum nennt der Bericht für die überarbeitete Richtlinie?“ | Exakter Wert und zitierte Seite |
| Abschnittsübergreifende Verknüpfung | „Wie hängt das Risiko in Abschnitt 2 mit der Kontrolle in Abschnitt 7 zusammen?“ | Beide Passagen und ob die Verknüpfung genannt oder abgeleitet wird |
| Ausnahmebehandlung | „Wer ist von der angegebenen Deckung ausgeschlossen?“ | Fußnote, Geltungsbereich und Einschränkungen |
| Versionskonflikt | „Welcher Wert gilt nach der Überarbeitung, und was hat er ersetzt?“ | Daten, Versionsbezeichnungen und beide Fundstellen |
| Fehlende Informationen | „Welche Aufbewahrungsfrist nennt der Bericht für Anbieterkopien?“ | Eingeständnis, wenn das Dokument nichts dazu sagt |
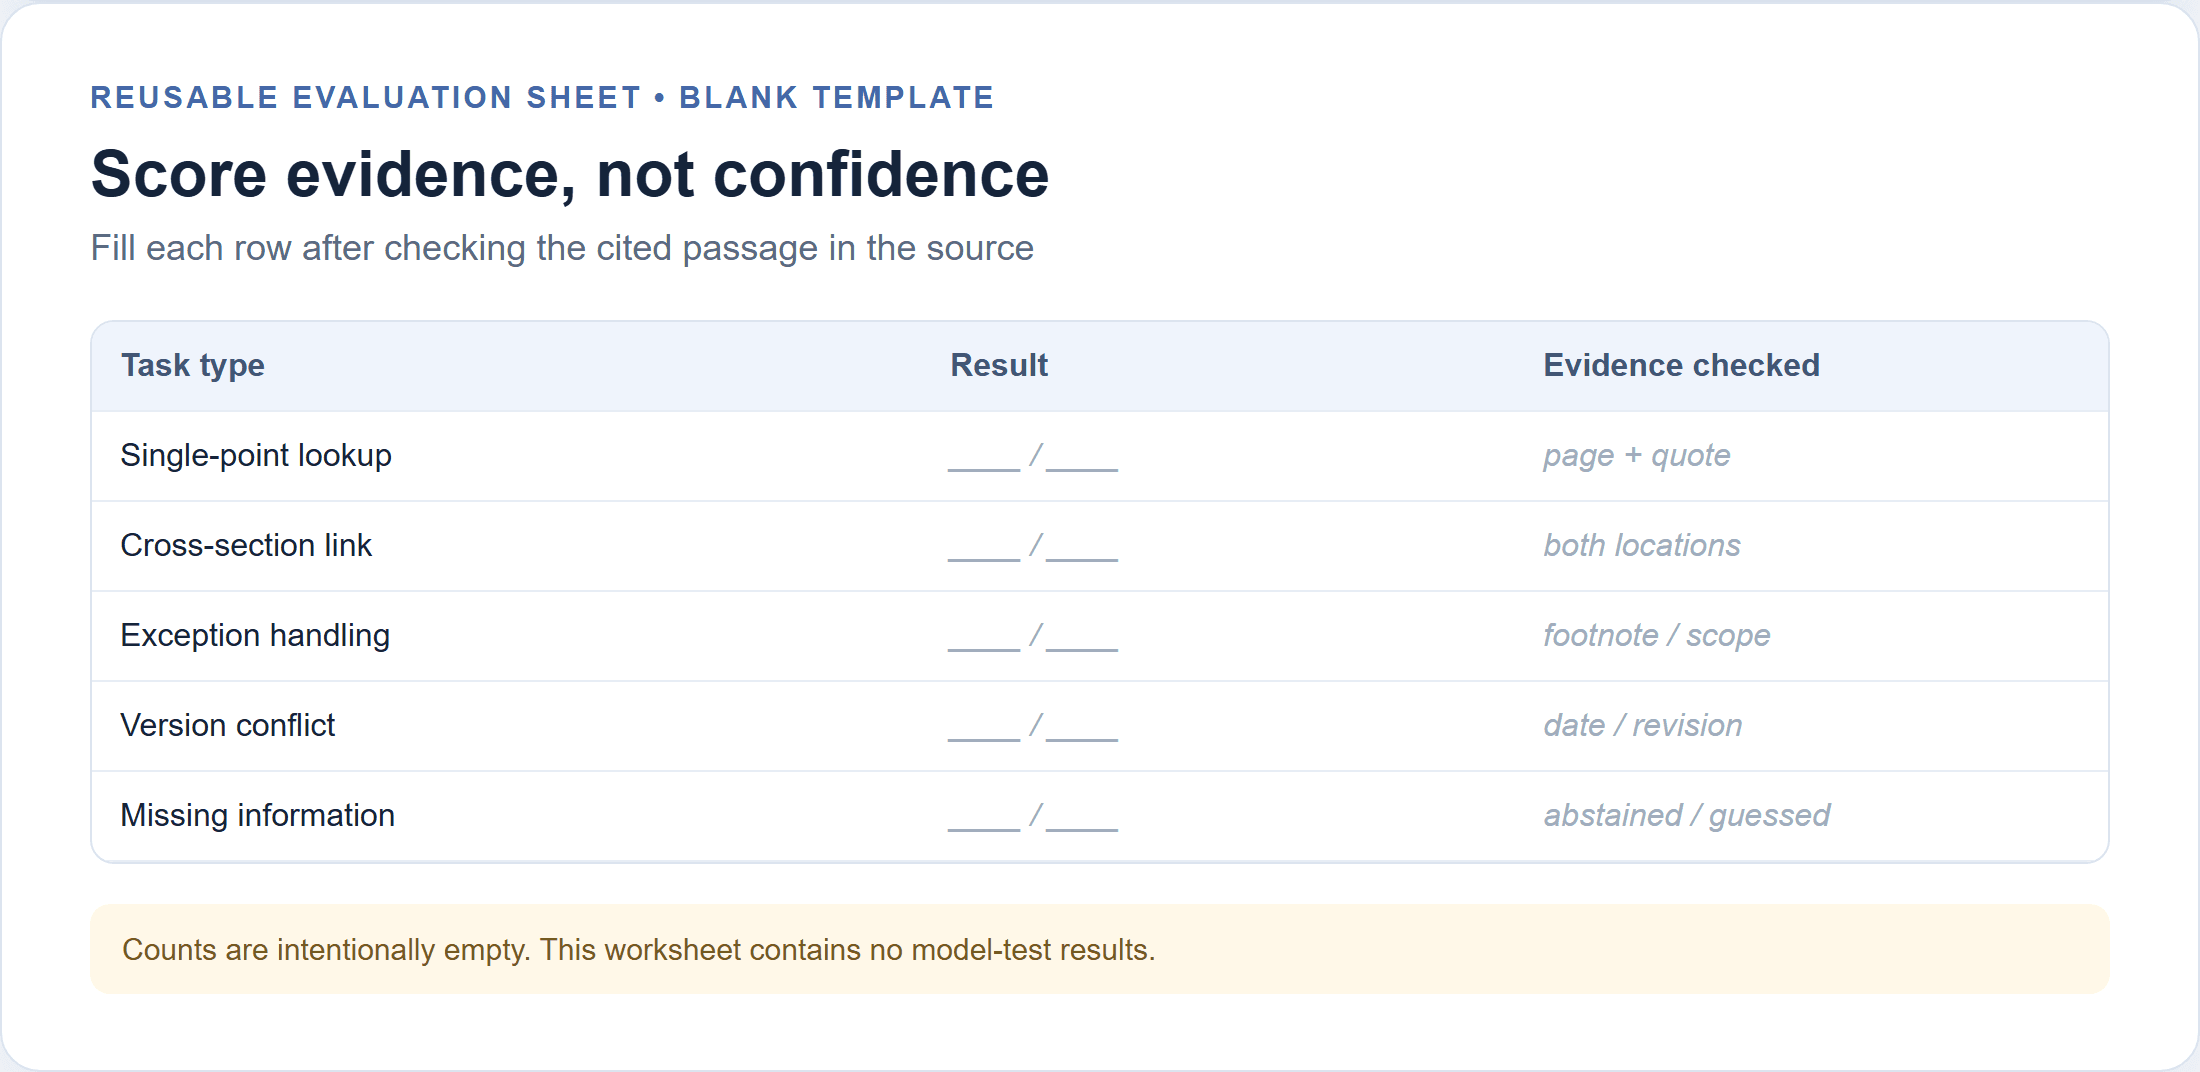
Dies ist ein leeres Bewertungsarbeitsblatt, keine Ergebnistabelle. Füllen Sie es erst aus, nachdem Sie jede Antwort anhand des Quelldokuments überprüft haben.
Bewerten Sie jede Antwort als richtig, teilweise richtig, falsch, nicht belegt oder korrekt nicht beantwortet. Zählen Sie nicht belegte Aussagen getrennt von falschen Antworten, da eine Antwort die richtige Kernaussage liefern und ein Detail erfinden kann. Prüfen Sie, ob jeder Beleg auf die Passage verweist, die die Aussage stützt. Berichten Sie die Fragenanzahl und die Kategorieanzahlen gemeinsam. Ein Gesamtprozentsatz verdeckt, ob das Modell Fußnoten übersehen hat oder nur dann Schwierigkeiten hatte, wenn Informationen über Abschnitte verteilt waren.
Bewahren Sie die exakte Quelldatei, Extraktion, Prompts, Rohantworten und das Bewertungsblatt auf. Veröffentlichen Sie nur Material, das Sie teilen dürfen, und schwärzen Sie vertrauliche Namen oder Kontodetails. Eine prüfende Person sollte jede bewertete Antwort von der Modellausgabe bis zu einer Seite in der gespeicherten Quelle zurückverfolgen können.
Wo Antworten auf lange Dokumente typischerweise scheitern
Ohne einen Durchlauf mit dem aktuellen Build gegen ein genanntes Dokument wäre es falsch zu behaupten, dass V4.1 Flash eine bestimmte Fehlerquote oder ein bestimmtes Fehlermuster gezeigt hat. Die folgenden Kategorien sind Prüfpunkte, keine gemessenen Befunde zu diesem Modell.
Beginnen Sie mit Verlust des Geltungsbereichs. Ein Fließtextabsatz kann eine Regel nennen, während eine Fußnote sie auf eine Region, einen Datumsbereich oder eine Kundengruppe beschränkt. Fragen Sie ausdrücklich nach der Ausnahme und prüfen Sie, ob die zitierte Passage sie enthält. Ein Zitat nur aus dem Hauptabsatz kann unzureichend sein.
Prüfen Sie als Nächstes Versionsverwechslungen. Berichte können ähnliche Werte in einem Entwurf und einem überarbeiteten Abschnitt wiederholen. Bitten Sie das Modell, das Datum oder die Version anzugeben, die zu jedem Wert gehört, statt nur nach „der aktuellen Zahl“ zu fragen. Wenn es stillschweigend einen auswählt, bewerten Sie die Antwort als unvollständig, auch wenn die Auswahl zufällig richtig ist.
Abschnittsübergreifende Fragen laden zu Schlussfolgerungen ein. Ein Modell kann zwei korrekte Fakten zu einer kausalen Erklärung kombinieren, die das Dokument nie liefert. Verlangen Sie, dass es direkte Aussagen getrennt von Schlussfolgerungen kennzeichnet. Vergleichen Sie dann die Schlussfolgerung mit den Belegen und entscheiden Sie, ob sie für die Aufgabe angemessen ist.
Testen Sie schließlich die Enthaltung. Fügen Sie eine Frage ein, deren Antwort fehlt. Eine selbstsichere Vermutung ist ein Fehler, auch wenn sie plausibel klingt. Lassen Sie bei Verträgen, Compliance, klinischem Material oder folgenreicher Finanzanalyse den Originaltext von einer qualifizierten Person prüfen, bevor Sie eine Schlussfolgerung verwenden.
Ein Verifizierungs-Workflow für sicherere Antworten
Dieser Prompt macht Antworten leichter prüfbar. Er kann Korrektheit nicht garantieren und keine Quellenprüfung ersetzen. Verwenden Sie ihn mit einer Extraktion, die Seitenbeschriftungen beibehält, und stellen Sie dann gezielte Fragen, statt eine allgemeine Zusammenfassung einer riesigen Datei anzufordern.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Teilen Sie die Arbeit bei einem langen Bericht nach Aufgabe auf, nicht automatisch nach einer willkürlichen Seitenzahl. Fragen Sie zuerst nach einer Quellenkarte: Abschnittstitel, Daten, definierte Begriffe und relevante Tabellen. Fragen Sie dann ein bestimmtes Thema ab und fordern Sie die zugehörigen Belegpassagen an. Übergeben oder rufen Sie für eine abschnittsübergreifende Schlussfolgerung beide Passagen im selben Turn ab und bitten Sie das Modell, die Verknüpfung zu erklären und dabei jede Schlussfolgerung zu kennzeichnen.
Verwenden Sie eine menschliche Verifizierungsschleife:
- Prüfen Sie die zitierte Seite und das Zitat in der Originaldatei.
- Bestätigen Sie, dass das Zitat benachbarte Ausnahmen und Tabellenüberschriften enthält.
- Kennzeichnen Sie jede Aussage als direkt, abgeleitet, nicht belegt oder widersprochen.
- Korrigieren Sie den Prompt oder teilen Sie die Aufgabe auf, wenn die Extraktion wichtige Struktur ausgelassen hat.
- Speichern Sie die Rohabfrage und die Rohantwort, damit eine prüfende Person die Entscheidung reproduzieren kann.
Wenn Sie einen gehosteten Endpunkt verwenden, nehmen Sie die Token-Nutzung in das Laufprotokoll auf. Die Modellpreisseite von Atlas Cloud listet DeepSeek V4.1 Flash derzeit mit $0.30 pro 1 Mio. Eingabe-Tokens, $1.20 pro 1 Mio. Ausgabe-Tokens und $0.03 pro 1 Mio. Cache-Read-Tokens auf, ohne aufgeführten Rabatt. Prüfen Sie das aktuelle Angebot, bevor Sie budgetieren. Diese Preisreferenz gilt für Atlas Cloud, nicht als universeller DeepSeek-API-Preis.
Bei diesen aufgeführten Sätzen kosten 100.000 nicht gecachte Eingabe-Tokens und 3.000 Ausgabe-Tokens etwa $0.033: $0.030 für die Eingabe plus $0.0036 für die Ausgabe.
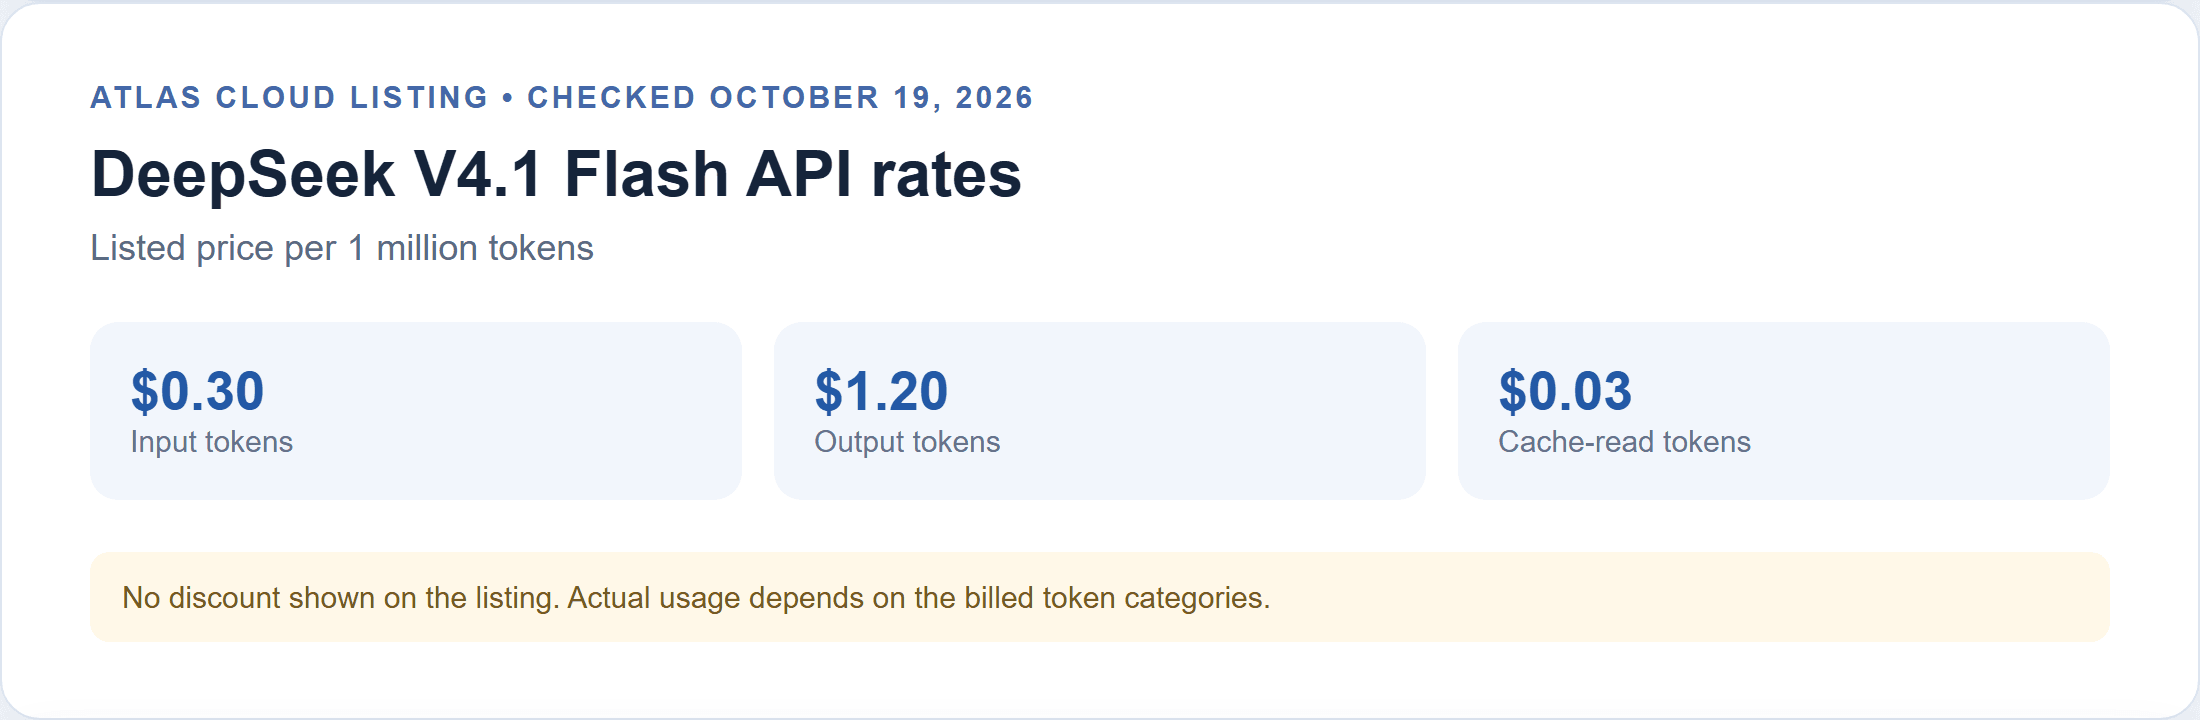
Atlas Cloud Preis geprüft am 19. Oktober 2026; das Angebot zeigt keinen Rabatt. Eine Eingabe mit 1 Mio. Tokens und eine Antwort mit 20.000 Tokens würden bei denselben Sätzen etwa $0.324 kosten, vor Cache-Behandlung oder anderen abrechenbaren Posten. Dies sind Rechenbeispiele, keine gemessenen Rechnungen aus Dokumententests. Die tatsächliche Eingabe umfasst den Prompt und den extrahierten Text; wiederholte Aufrufe erhöhen die Nutzung. Verwenden Sie die vom Anbieter zurückgegebenen Token-Zahlen, statt anhand der Seitenzahl zu schätzen.
Wann Sie DeepSeek V4.1 Flash für lange Dokumente einsetzen sollten
Flash ist ein vernünftiger erster Durchlauf, wenn Sie Definitionen finden, Daten sammeln, eine Abschnittskarte erstellen oder eine Zusammenfassung entwerfen müssen, die eine Person prüft. Diese Aufgaben haben sichtbare Belegspuren und lassen sich leicht mit präziseren Fragen erneut ausführen. Behalten Sie für wiederkehrende Arbeit Fragen mit bekannten Antworten bei und führen Sie sie erneut aus, wenn sich Modellversion, Extraktionspipeline oder Prompt ändern.
Fügen Sie Kontrollen hinzu, wenn eine Frage weit auseinanderliegende Abschnitte kombiniert, von einer Fußnote abhängt oder Revisionen vergleicht. Verwenden Sie Zitate als Navigationshilfen, nicht als Beweis für sich. Wenn eine Antwort eine Vertragsverpflichtung, eine Compliance-Position, eine Finanzoffenlegung oder eine andere folgenreiche Entscheidung beeinflusst, lassen Sie jede wesentliche Aussage in der Quelle von einer qualifizierten prüfenden Person verifizieren.
Die nützliche Frage ist, ob dieses Modell bei Ihrer Version des Dokuments und Ihrem genauen Workflow Antworten mit Belegen liefert, die einer Prüfung standhalten. Das ist der Test, der die Genauigkeit der Langdokumentanalyse von DeepSeek V4.1 Flash für Ihren eigenen Anwendungsfall belegen kann.
Häufig gestellte Fragen
Bedeutet ein Kontextfenster mit 1 Mio. Tokens, dass ein Modell ein Dokument mit 1 Mio. Tokens genau analysieren kann?
Nein. Es beschreibt die unterstützte Kontextkapazität. Die tatsächliche Anfrage enthält außerdem Anweisungen und Ausgabebudget, während Extraktion, Schnittstellenlimits und Fragenkomplexität beeinflussen, ob nützliche Belege verfügbar sind und korrekt interpretiert werden.
Ist LongBench-V2 dasselbe wie Genauigkeit bei der Dokument-Fragebeantwortung?
Nein. Es umfasst mehrere Langkontext-Aufgabenkategorien und berichtet Leistung unter einem bestimmten Setup. Es ist ein Vergleichssignal, keine Garantie für ein bestimmtes PDF, einen API-Build, Prompt oder Domänenbereich.
Sollte ich einen Prompt verwenden oder ein langes Dokument in Abschnitte aufteilen?
Verwenden Sie eine Quellenkarte und gezielte Fragen, wenn die Struktur wichtig ist. Halten Sie Passagen, die verglichen werden müssen, für den Syntheseschritt gemeinsam verfügbar, und bewahren Sie Seitenbeschriftungen auf, damit Sie die Antwort verifizieren können.
Wie sollte ich Zitate aus einer KI-generierten Zusammenfassung verifizieren?
Öffnen Sie jede zitierte Seite in der Originaldatei, prüfen Sie das Zitat und den umgebenden Text und bestätigen Sie, dass die Passage die konkrete Aussage stützt. Verifizieren Sie Tabellenüberschriften und Fußnoten ebenso wie den zitierten Satz.
Wie beeinflussen Eingabe- und Ausgabe-Tokens die Kosten?
Eingabe-Tokens umfassen das Dokument, die Anweisungen und die Frage. Ausgabe-Tokens umfassen die Antwort. Längere Prompts, mehrere Aufrufe und wiederholte Passagen erhöhen die Nutzung; verwenden Sie abgerechnete Token-Zahlen und die aktuelle Preistabelle des Anbieters für Schätzungen.





