

Ein Entwickler sieht „1M tokens“ und bereitet sich darauf vor, ein ganzes Repository, dessen Issue-Historie und einen langen Designbericht in einer einzigen Anfrage zu senden. Das entscheidende Detail beim 1M-Kontextfenster von Gemini 4 Argon ist, dass 1,048,576 Tokens von Eingabe, Thinking und Ausgabe gemeinsam genutzt werden. Es sind nicht eine Million Eingabe-Tokens plus weitere eine Million für die Antwort. Google nennt eine standardmäßige synchrone Ausgabeobergrenze von 65,536 Tokens, während Long Decode die Generierung bis zur verbleibenden gemeinsamen Kapazität erweitern kann. Googles Modellspezifikation liefert die Limits; dieser Leitfaden macht daraus ein Budget und eine Entscheidung über Long Context, Retrieval und Chunking.
Wichtigste Erkenntnisse
- Der Kontext mit 1,048,576 Tokens ist ein gemeinsames Budget für Eingabe, Thinking und Ausgabe.
- Die standardmäßige synchrone Ausgabe ist auf 65,536 Tokens begrenzt; Long Decode fügt keinen zusätzlichen Kontext hinzu.
- Verwenden Sie Long Context, wenn Beziehungen über eine bekannte Quellensammlung hinweg wichtig sind; nutzen Sie Retrieval oder Chunking, wenn dies nicht der Fall ist.
Was bedeutet das 1M-Kontextfenster von Gemini 4 Argon?
Das Budget von 1,048,576 Tokens wird geteilt
Ein Kontextfenster ist das Token-Limit, das für eine Anfrage verfügbar ist. Für Argon dokumentiert Google eine einheitliche Gesamtsumme von 1,048,576. Der Prompt, angehängtes Quellenmaterial, Thinking-Tokens und die generierte Antwort schöpfen aus diesem Kontingent. Es beschreibt Kapazität, nicht das Versprechen, dass jedes Detail gleichermaßen leicht abrufbar oder durchdenkbar ist.
Wenn eine Anfrage 900,000 Quellen-Tokens enthält, verbleiben höchstens 148,576 für Thinking und Ausgabe, bevor schnittstellenspezifische Einschränkungen gelten. Eine Anwendung, die annimmt, anschließend eine Antwort mit 200,000 Tokens anfordern zu können, hat dasselbe Budget überzogen.
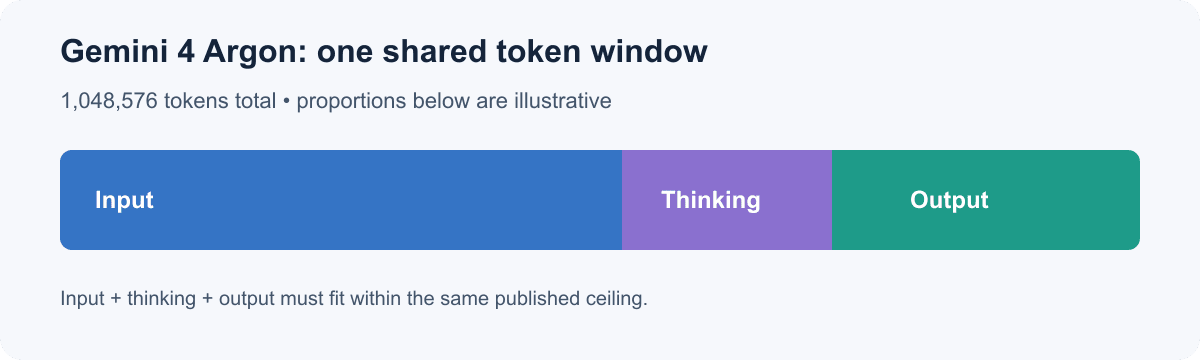
Das veröffentlichte Fenster ist eine gemeinsame Obergrenze. Segmentgrößen sind konzeptionell, keine feste Aufteilung.
Eingabe, Thinking und Ausgabe schöpfen aus einem Fenster
Eine nützliche Planungsgleichung ist:
input tokens + thinking tokens + output tokens <= 1,048,576
Dies ist eine Budgetprüfung, nicht die Behauptung, dass Entwickler für jeden Aufruf eine exakte Anzahl an Thinking-Tokens festlegen können. Google listet Thinking-Einstellungen mit niedrig, mittel und hoch; der interne Verbrauch kann je nach Aufgabe und Einstellungen variieren. Reservieren Sie Platz fürs Reasoning, statt den theoretischen Rest als garantierte Antwortkapazität zu behandeln.
Argon akzeptiert Text-, Bild-, Video-, Audio- und PDF-Eingaben mit Textausgabe. Die Verrechnung von Medien entspricht nicht der von reinem Text, sodass eine Datei- oder Seitenanzahl die Gesamtzahl der Tokens nicht zuverlässig vorhersagen kann. Prüfen Sie die Nutzungsmetadaten einer repräsentativen Anfrage.
Kontextfenster vs. Ausgabelimit: Der entscheidende Unterschied
Die standardmäßige Ausgabeobergrenze
Die Modellseite listet eine maximale Ausgabe von 65,536 Tokens für die standardmäßige synchrone Generierung, etwa ein Sechzehntel des Gesamtfensters. Eine Anfrage kann innerhalb des Gesamtkontextlimits liegen und dennoch die aktive Ausgabeobergrenze überschreiten.
Für viele Anwendungen ist dieser Standardwert ausreichend. Eine Repository-Überprüfung oder Dokumentensynthese benötigt normalerweise eine fokussierte Antwort, keine, die so lang ist wie die Quellensammlung. Eine begrenzte Ausgabe lässt sich leichter prüfen, speichern und an einen weiteren Schritt übergeben.
Was Long Decode ändert
Long Decode unterstützt eine deutlich längere Generierung, laut Modellspezifikation bis zu 1,048,576 Tokens. Es erweitert nicht das Gesamtfenster. Wenn der Prompt bereits den größten Teil davon belegt, bleibt weniger Kapazität für Thinking und Ausgabe. Auch API-Pfad, SDK, Anfrageeinstellungen und Antwortverarbeitung spielen eine Rolle. Prüfen Sie daher die aktuelle Integrationsanleitung, bevor Sie sich in der Produktion auf eine lange Antwort verlassen.
Verwenden Sie Long Decode nur, wenn das Ergebnis wirklich umfangreiches generiertes Material benötigt, etwa eine große strukturierte Transformation, die in einem Vorgang zurückgegeben wird. Wenn die Antwort in validierte Abschnitte aufgeteilt werden kann, kann eine stufenweise Generierung unvollständige Ergebnisse leichter erkennbar und wiederherstellbar machen.
Eingabe-, Thinking- und Ausgabe-Tokens budgetieren
Beginnen Sie mit dem Ergebnis und schätzen Sie dann die Quellen-Tokens mit der Zählmethode des ausgewählten Modells, sofern verfügbar. Zählen Sie auch Anweisungen, Tool-Ergebnisse, Schema-Text und Gesprächsverlauf mit. Reservieren Sie einen Puffer für Thinking und Schätzfehler, statt den theoretischen Rest auszugeben.
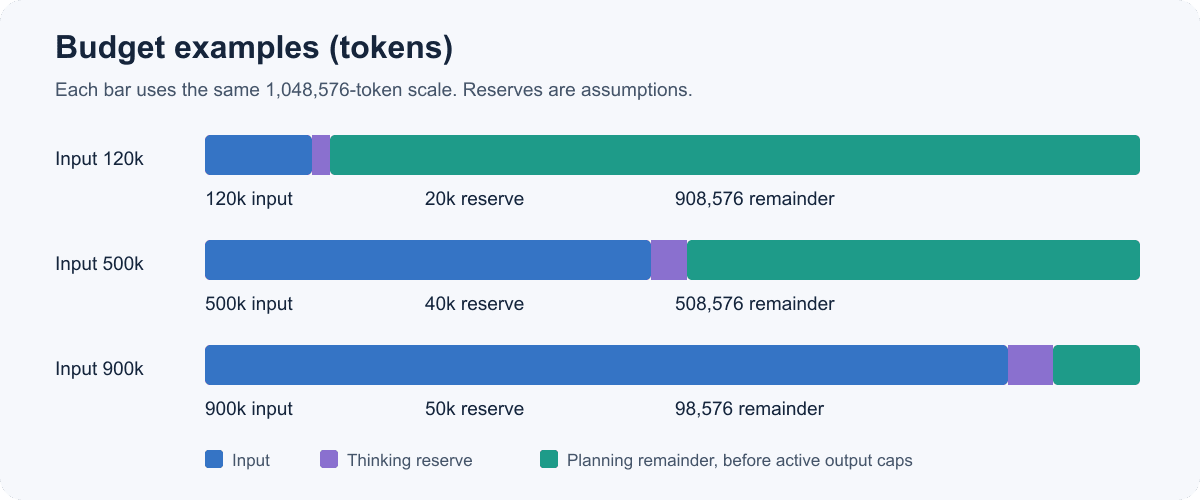
Die folgenden Zahlen sind Rechenbeispiele, kein feststehender Reasoning-Verbrauch. „Planungsrest“ ist die Gesamtsumme nach angenommener Eingabe und reserviertem Thinking-Kontingent. Es gelten weiterhin die tatsächlichen Dienstlimits.
| Angenommene Eingabe | Thinking-Reserve | Planungsrest für Ausgabe | Beispiel |
|---|---|---|---|
| 120,000 | 20,000 | 908,576 | Mehrere Handbücher, prägnante Synthese |
| 500,000 | 40,000 | 508,576 | Codebasis-Überprüfung mit Dateireferenzen |
| 900,000 | 50,000 | 98,576 | Archivvergleich mit begrenzter Antwort |
Veranschaulichende Arithmetik bei einer Obergrenze von 1,048,576 Tokens; Reserven sind Planungsannahmen.
Verwenden Sie diese Checkliste zur Anfrageplanung:
- Eingabe: geschätzte Quellen- und Prompt-Tokens.
- Thinking: Kapazität basierend auf Aufgabenkomplexität und unterstützten Einstellungen reservieren.
- Ausgabe: eine Obergrenze wählen, die zum Ergebnis passt.
- Prüfen: die drei Beträge summieren und Raum für Schätzfehler lassen.
- Pfad: bestätigen, dass der ausgewählte Endpunkt oder das SDK die Ausgabelänge und das Fortsetzungsverhalten unterstützt.
Für eine Codebasis-Überprüfung mit 500,000 Tokens könnte ein Team 40,000 Tokens für Thinking reservieren und eine Antwort mit 25,000 Tokens anstreben. Dieser Plan verbraucht auf dem Papier 565,000 Tokens und lässt Spielraum für ungenaue Schätzungen oder zusätzliche Anweisungen. Das Team sollte dennoch die tatsächliche Nutzung und die konfigurierten Generierungslimits überprüfen. Die Reserve ist ein Planungswerkzeug, keine Vorhersage des internen Reasonings.
Bevor Sie einen Batch-Lauf starten, beproben Sie mehr als einen Anfragetyp. Eine kurze Dokumentationsseite, ein codeintensives Modul und eine PDF mit Tabellen können unterschiedliche Tokenzahlen erzeugen, selbst wenn ihre Dateigrößen ähnlich aussehen. Zählen Sie repräsentative Eingaben und vergleichen Sie die Schätzungen dann mit der von der API zurückgegebenen Nutzung. Wenn die tatsächliche Thinking- oder Ausgabemeldung des Modells von Ihren Annahmen abweicht, aktualisieren Sie Reserve und Obergrenze, bevor Sie die Batch-Größe erhöhen. Dieser kleine Kalibrierungsschritt hilft, einen Long-Context-Workflow innerhalb seines Token- und Budgetrahmens zu halten.
Was passt in eine Million Tokens?
Dokumente, Code und multimodales Material
Eine Million Tokens kann eine Analyse in einem Durchgang für eine Sammlung von Handbüchern, mehrere Verträge, einen großen Quellcodebaum oder ein langes Transkript mit Notizen plausibel machen. Google hat grobe Illustrationen wie etwa 1,500 Textseiten oder 30,000 Codezeilen verwendet. Betrachten Sie diese als Größenbeispiele, nicht als Garantien. Layout, Codedichte, Sprache, Formatierung und Tokenisierung beeinflussen die Anzahl.
Beziehen Sie für Repository-Arbeiten Build-Dateien, generierten Code, Kommentare, Abhängigkeitsmetadaten, Tests und relevanten Issue-Kontext in Ihre Schätzung ein. Fragen Sie dann, ob die Aufgabe alles benötigt. Eine modulübergreifende Architekturüberprüfung kann von einem breiten Quellenbestand profitieren; eine Frage zu einer einzelnen Fehlermeldung wahrscheinlich nicht.
Multimodale Eingaben erschweren Schätzungen zusätzlich. Dauer eines Videos, Frame-Sampling, Audio, Auflösung und API-Behandlung können die Nutzung und die vom Modell gesehenen Belege beeinflussen. Beziehen Sie für eine eng gefasste Frage nur relevante Medien ein und prüfen Sie die Nutzung einer repräsentativen Anfrage, bevor Sie skalieren.
Tokenzahlen sind keine Seitenzahlen
Ein Token ist eine Verarbeitungseinheit des Modells, kein Wort, Zeichen, keine Seite oder Zeile. Bezeichner, Tabellen, Quellcode und nicht englischsprachige Texte können anders tokenisiert werden als gewöhnliche Prosa. Eine Seitenschätzung kann nicht sagen, ob Ihre spezielle Sammlung passt.
Kapazität ist außerdem etwas anderes als Qualität. Wenn eine Quellensammlung hineinpasst, beweist das nicht, dass das Modell jede versteckte Ausnahme findet, jede Abhängigkeit bewahrt oder widersprüchliche Passagen korrekt auflöst. Die Spezifikation legt ein Limit fest, keine vollständige Erinnerung und keine aufgabenspezifische Genauigkeitsbewertung. Fordern Sie bei folgenreichen Schlussfolgerungen Quellenangaben an und validieren Sie wichtige Aussagen anhand der Originale.
Wann ein 1M-Fenster hilft und wann nicht
Long Context ist am nützlichsten, wenn eine Antwort von Beziehungen abhängt, die über Material verstreut sind, das eine einfache Abfrage möglicherweise nicht abruft. Weniger überzeugend ist es für wiederholte eng gefasste Fragen über einen sich ändernden Korpus, bei dem Retrieval eine kleinere Belegmenge auswählen kann. Dies sind Workflow-Abwägungen, keine allgemeingültige Genauigkeitsrangfolge.
| Ansatz | In Betracht ziehen, wenn | Abwägung |
|---|---|---|
| Long-Context-Anfrage | Eine einmalige Analyse Beziehungen über eine bekannte Quellensammlung hinweg benötigt | Große Eingabe kann Kosten und Latenz erhöhen; Abdeckung überprüfen |
| Retrieval | Nutzer wiederholte Fragen über einen sich ändernden Korpus stellen | Indexierung und Retrieval bestimmen, welche Belege das Modell erreichen |
| Chunking | Dokumente als unabhängige Einheiten oder Stufen verarbeitet werden können | Beziehungen über Chunks hinweg müssen abgeglichen werden |
| Hybrid | Sie eine breite Orientierung gefolgt von fokussierten Belegprüfungen benötigen | Mehr Orchestrierung und Zustandsverwaltung |
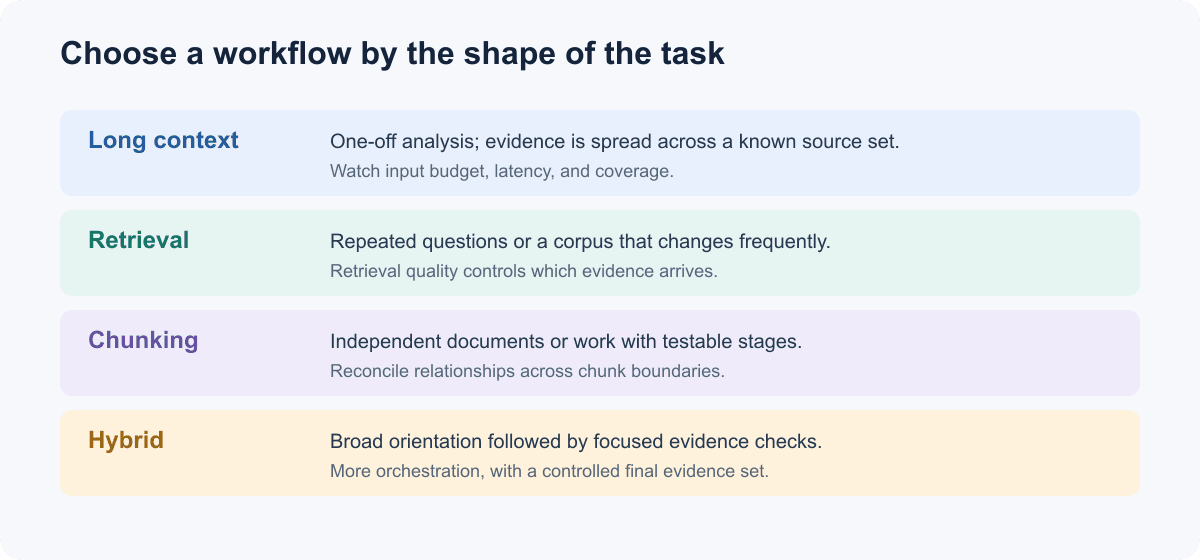 Wählen Sie anhand von Aufgabenform und Abfragemuster und validieren Sie dann mit repräsentativen Eingaben.
Erwägen Sie Long Context für den Vergleich von Richtlinien, deren Klauseln sich gegenseitig beeinflussen, für die Überprüfung einer Änderung über viele Softwaremodule hinweg oder für die Synthese von Dokumenten, bei denen ein Detail in einer Quelle die Interpretation einer anderen ändert. Retrieval eignet sich für wiederholte Support-Fragen gegen eine wachsende Wissensdatenbank. Chunking funktioniert, wenn Quelleinheiten unabhängig sind oder jede Stufe eine prüfbare Ausgabe hat. Ein hybrider Workflow kann die Sammlung zuerst kartieren und dann Passagen für eine endgültige Antwort abrufen und verifizieren.
Bewerten Sie Optionen anhand derselben repräsentativen Fragen. Verfolgen Sie, ob erforderliche Belege einbezogen wurden, ob Zitate auf die richtigen Passagen verweisen, den Tokenverbrauch, die Antwortzeit und den Wiederherstellungsaufwand nach einer unvollständigen Antwort. Das liefert Ihrem Team Belege für seine Workload, statt anzunehmen, dass ein größeres Fenster sie automatisch verbessert.
Gemini 4 Argon für Long-Context-Aufgaben verwenden
Modell-ID und Anfragepfad bestätigen
Google listet die Gemini-API-Modell-ID als `gemini-4-argon`. Bestätigen Sie, dass sie für Ihr Konto aktiviert ist und dass die genaue API-Oberfläche die von Ihnen benötigten Funktionen unterstützt. Derselbe Modellname garantiert nicht, dass jeder Proxy, jedes SDK, jede Konsole oder jeder Client identische Limits oder Long-Decode-Verhalten bietet.
Prüfen Sie vor der Produktion:
- Die Modell-ID und Verfügbarkeit für Ihr Konto oder Ihre Region.
- Die synchrone Ausgabeobergrenze und wie Long Decode angefordert oder zurückgegeben wird.
- Ob das SDK Fortsetzungen verarbeitet und wie es teilweise fehlgeschlagene Antworten meldet.
- Unterstützte Thinking-Einstellungen, Tools, Caching und Modalitäten für die ausgewählte API.
- Die tatsächlichen Eingabe- und Ausgabenutzungsfelder der Anfrage.
Googles Long-Context-Leitfaden beschreibt das einheitliche Budget. Seine SDK- und API-Anleitung kann sich ändern. Legen Sie daher eine unterstützte SDK-Version fest, prüfen Sie das aktuelle Beispiel und testen Sie denselben Transport und dieselbe Antwortverarbeitung, die für die Produktion geplant sind, per Integrationstest. Kopieren Sie keine Parameternamen aus einer älteren Modellintegration, ohne zu prüfen, dass sie weiterhin gelten.
Den Ausgabevertrag kleiner als die Quellensammlung machen
Geben Sie dem Modell eine begrenzte Aufgabe und Antwortform. Fordern Sie für ein Repository-Audit Ergebnisse an, gruppiert nach Schweregrad mit Dateipfaden und Zeilenverweisen, und geben Sie an, ob Hypothesen oder nur bestätigte Defekte einbezogen werden sollen. Benennen Sie für einen Vertragsvergleich die Klauseln und fordern Sie Abschnittsbezeichner oder kurze unterstützende Auszüge an. Das ist leichter zu prüfen als „alles analysieren“. Planen Sie bei großen Antworten Fortsetzungen und Teilabschlüsse ein. Speichern Sie Bezeichner und Antwortchunks, wenn das SDK sie bereitstellt, validieren Sie strukturierte Ausgaben vor der Weiterverwendung und wiederholen Sie nach Möglichkeit nur einen fehlgeschlagenen Teil. Dies sind Schutzmaßnahmen, die implementiert und überprüft werden müssen, nicht die Behauptung, dass jedes SDK Unterbrechungen identisch behandelt.
Preise und Zugriff: Was vor dem Ausführen zu prüfen ist
Googles Ankündigung nennt derzeit Einführungspreise von $2 pro Million Eingabe-Tokens und $10 pro Million Ausgabe-Tokens bis zum 30. November 2026, gefolgt von angegebenen Preisen von $4 und $20 pro Million. Dies ist zeitkritisch: Prüfen Sie die offizielle Gemini 4 Argon-Ankündigung erneut, bevor Sie veröffentlichen oder Ausgaben prognostizieren. Schätzen Sie Eingabe und Ausgabe getrennt, da promptlastige und generierungslastige Workloads unterschiedliche Kostenprofile haben.
Die Verfügbarkeit von Argon über Atlas Cloud ist auf den für diesen Artikel geprüften Verzeichnisseiten nicht bestätigt. Der Atlas Gemini-Modellkatalog zeigt die derzeit dort aufgeführten Gemini-Modelle und Zugriffsdetails; er belegt nicht, dass Argon verfügbar ist. Bestätigen Sie eine modellspezifische Detailseite, ein Protokoll und einen Preis, bevor Sie Anfragen routen oder Kosten vergleichen.
Beginnen Sie mit einer repräsentativen Anfrage und erfassen Sie Modell- und SDK-Versionen, Tokenverbrauch, Latenz, Fehler und aufgabenspezifische Qualitätsprüfungen. Überdenken Sie Budget und Retrieval-Wahl, wenn sich Quellensammlungen oder Abfragemuster ändern. Das 1M-Kontextfenster von Gemini 4 Argon ist nützlich, wenn seine Breite ein echtes quellenübergreifendes Problem löst und Ihre Anfrage ein klares Budget- und Verifizierungsplan hat.
Häufig gestellte Fragen
Wird das 1M-Fenster von Gemini 4 Argon von Eingabe und Ausgabe geteilt?
Ja. Google definiert ein einzelnes Fenster mit 1,048,576 Tokens, das von Eingabe, Thinking und Ausgabe geteilt wird. Wie viel für eine Antwort übrig bleibt, hängt von der Anfrage und den geltenden Schnittstellenlimits ab.
Wie hoch ist das standardmäßige Ausgabelimit von Gemini 4 Argon?
Die Spezifikation listet 65,536 Tokens für die standardmäßige synchrone Ausgabe. Long Decode kann eine größere Generierung unterstützen, abhängig von der verbleibenden gemeinsamen Kapazität und dem API-Pfad.
Kann Gemini 4 Argon 1M Tokens in einer Antwort generieren?
Die Modellseite listet Long Decode mit bis zu 1,048,576 Ausgabe-Tokens, aber dies ist eine Obergrenze der Fähigkeit, keine Garantie, dass eine Anfrage mit Eingabe auch eine Million Tokens zurückgeben kann. Eingabe und Thinking belegen dasselbe Gesamtfenster.
Bedeutet ein 1M-Kontextfenster, dass jedes Detail genau erinnert wird?
Nein. Es beschreibt das maximale Token-Budget, nicht perfektes Retrieval oder Reasoning. Fordern Sie Belegverweise an und testen Sie bekannte Edge Cases aus Ihrem eigenen Material.
Ist Gemini 4 Argon derzeit über Atlas Cloud verfügbar?
Ich konnte in dem für diesen Artikel geprüften Atlas Cloud-Katalog keinen Argon-spezifischen Modelleintrag oder keine Detailseite bestätigen. Prüfen Sie das aktuelle Verzeichnis, bevor Sie Unterstützung annehmen; der obige Gemini-Kataloglink belegt für sich genommen nicht die Verfügbarkeit von Argon.


