

Wichtigste Erkenntnisse
- Argon akzeptiert Text-, Bild-, Video-, Audio- und PDF-Eingaben; die dokumentierte Ausgabe ist Text.
- Das Kontextfenster von 1.048.576 Token wird von Eingabe und Ausgabe gemeinsam genutzt. Die standardmäßige synchrone Ausgabe ist auf 65.536 Token begrenzt.
- Bildgenerierung, Audiogenerierung und Live API werden vom Argon-Modell nicht unterstützt.
- Überprüfen Sie Aussagen anhand von Seitenzahlen, Zeitstempeln oder sichtbaren Belegen, bevor Sie sie in einem Workflow verwenden.
Was „multimodal“ für Gemini 4 Argon bedeutet
Für die Gemini API bedeutet multimodal, dass Argon in einer Anfrage verschiedene Arten von Ausgangsmaterial empfangen und über dieses Material zusammen mit Textanweisungen Reasoning betreiben kann. Die aktuelle Gemini-API-Modellseite listet Text-, Bild-, Video-, Audio- und PDF-Eingaben auf, wobei Text die Ausgabe ist. Sie listet außerdem strukturierte Ausgabe, Funktionsaufrufe, Codeausführung, Dateisuche und Such-Grounding unter den unterstützten Fähigkeiten auf. Diese Tools können einen Workflow prägen, aber sie ändern die Ausgabemodalität nicht in ein Bild, eine Audiospur oder einen Live-Konversationsstream. (Google AI for Developers, Oktober 2026)
Die Token-Angaben müssen sorgfältig gelesen werden. Google gibt ein einheitliches Kontextfenster von 1.048.576 Token für Eingabe und Ausgabe zusammen an. Eine normale synchrone Anfrage hat eine maximale Ausgabe von 65.536 Token; Long Decode kann bis zu 1.048.576 erreichen, wenn der dokumentierte Hintergrundfortsetzungsablauf verwendet wird. Wenn Ihr Prompt und angehängte Inhalte den größten Teil des gemeinsamen Fensters verbrauchen, bleibt weniger Raum für Reasoning und Antworttext. Die Schlagzeile „1M Kontext“ bedeutet nicht, dass jede Anfrage mit einer Million Token in eine gewöhnliche Antwort passt.
| Von Ihnen bereitgestelltes Material | Dokumentierter Input? | Argon-Ausgabe | Eine nützliche erste Aufgabe | Zu prüfende Belege |
|---|---|---|---|---|
| Text und PDF | Ja | Text | Einen Bericht zusammenfassen oder Aussagen über Abschnitte hinweg vergleichen | Seite, Überschrift, Tabellenzeile oder zitierte Passage |
| Bild | Ja | Text | Ein Diagramm lesen, Objekte identifizieren oder zwei Bilder vergleichen | Beschriftungen, Werte, Positionen und Bildausschnitt |
| Video | Ja | Text | Ereignisreihenfolge beschreiben oder einen Moment in einem Clip finden | Zeitstempel und der tatsächliche Frame |
| Audio | Ja | Text | Fragen zu einer hochgeladenen Aufnahme beantworten | Audiosegment, Transkript, Sprecher oder Geräusch |
| Generierte Medien | Keine Bilder-/Audio-Generierung aufgeführt | Text | Eine schriftliche Analyse oder ein strukturiertes Ergebnis zurückgeben | Schema und Quellbeleg |
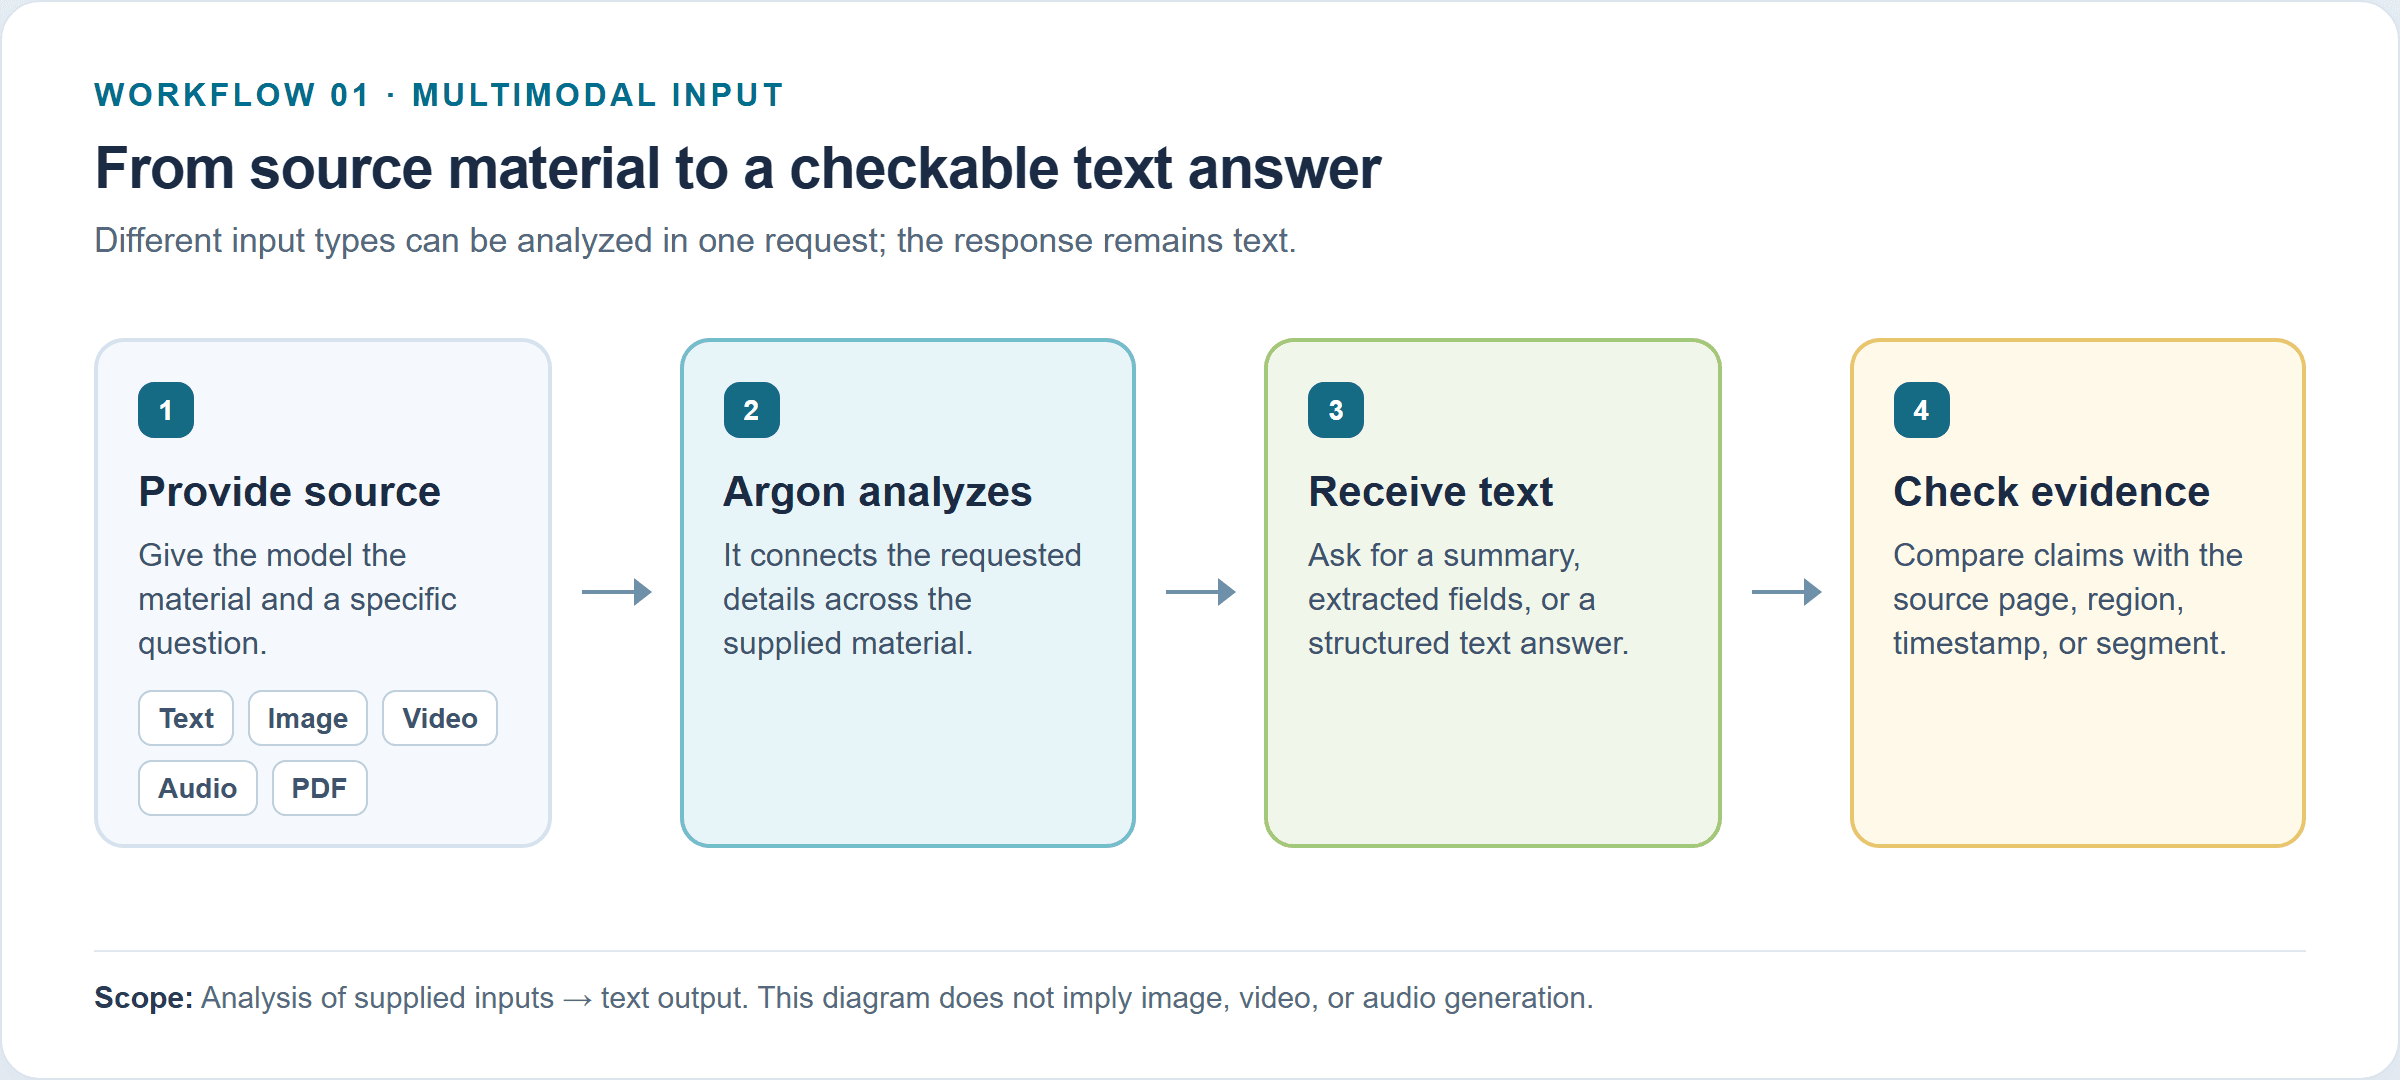 Workflow-Abbildung: Bereitgestellter Text, Bild, Video, Audio oder PDF wird zu einer Textantwort analysiert und dann gegen Quellbelege geprüft.
Die Gemini-App kann Funktionen bieten, die mithilfe anderer Modelle und Tools Medien zusammenstellen oder erstellen. Gehen Sie nicht davon aus, dass diese Funktionen auf App-Ebene Fähigkeiten des API-Modells gemini-4-argon selbst sind. Treffen Sie eine Implementierungsentscheidung anhand der API-Fähigkeitstabelle und der exakten Modell-ID, nicht anhand eines Produktfamilien-Labels.
Was Gemini 4 Argon in Bildern, Videos, Audio und PDFs analysieren kann
Der beste Weg zu entscheiden, ob Argon passt, ist, die Belege zu benennen, die Ihre Aufgabe benötigt. „Ein Video verstehen“ ist zu vage. „Finde jedes Mal, wenn der Bediener ein Teil in die Ablage legt, und zitiere den Zeitstempel“ ist überprüfbar.
Bilder: prüfen, vergleichen und visuelle Informationen extrahieren
Eine Bildanfrage kann Argon bitten, eine Szene zu beschreiben, zwei bereitgestellte Bilder zu vergleichen, sichtbaren Text zu extrahieren, ein Diagramm zu interpretieren oder visuelle Befunde in einem strukturierten Format zurückzugeben. Dies sind Analyseaufgaben: Die Ausgabe ist Text oder strukturierter Text. Sie können einem Support-Team helfen, Produktfotos zu triagieren, einer Forscherin, Abbildungen zu sichten, oder einem Bediener, Beschriftungen aus einem Bildsatz zu extrahieren.
Unabhängige Tests bieten eine nützliche Realitätsprüfung, sofern Sie sie als einen Benchmark-Aufbau und nicht als Prognose für Ihre eigenen Bilder behandeln. Roboflows Vision Evals vom Oktober 2026 führt Argon unter den Top-Modellen in den getesteten Aufgaben zur Objekterkennung, OCR und visuellen Schlussfolgerung auf. Die OCR-Bewertung trennt exakte Transkription und verwandte Teilaufgaben, und der Artikel berichtet über Schwachstellen wie kleinen oder unscharfen Text und schwierigere visuelle Lesungen. Der Aufbau, die ausgewählten Bilder, Prompts und die Bewertung definieren diese Ergebnisse; sie belegen keine allgemeine Erfolgsquote für jeden Scan oder jedes Diagramm. (Roboflow, Oktober 2026)
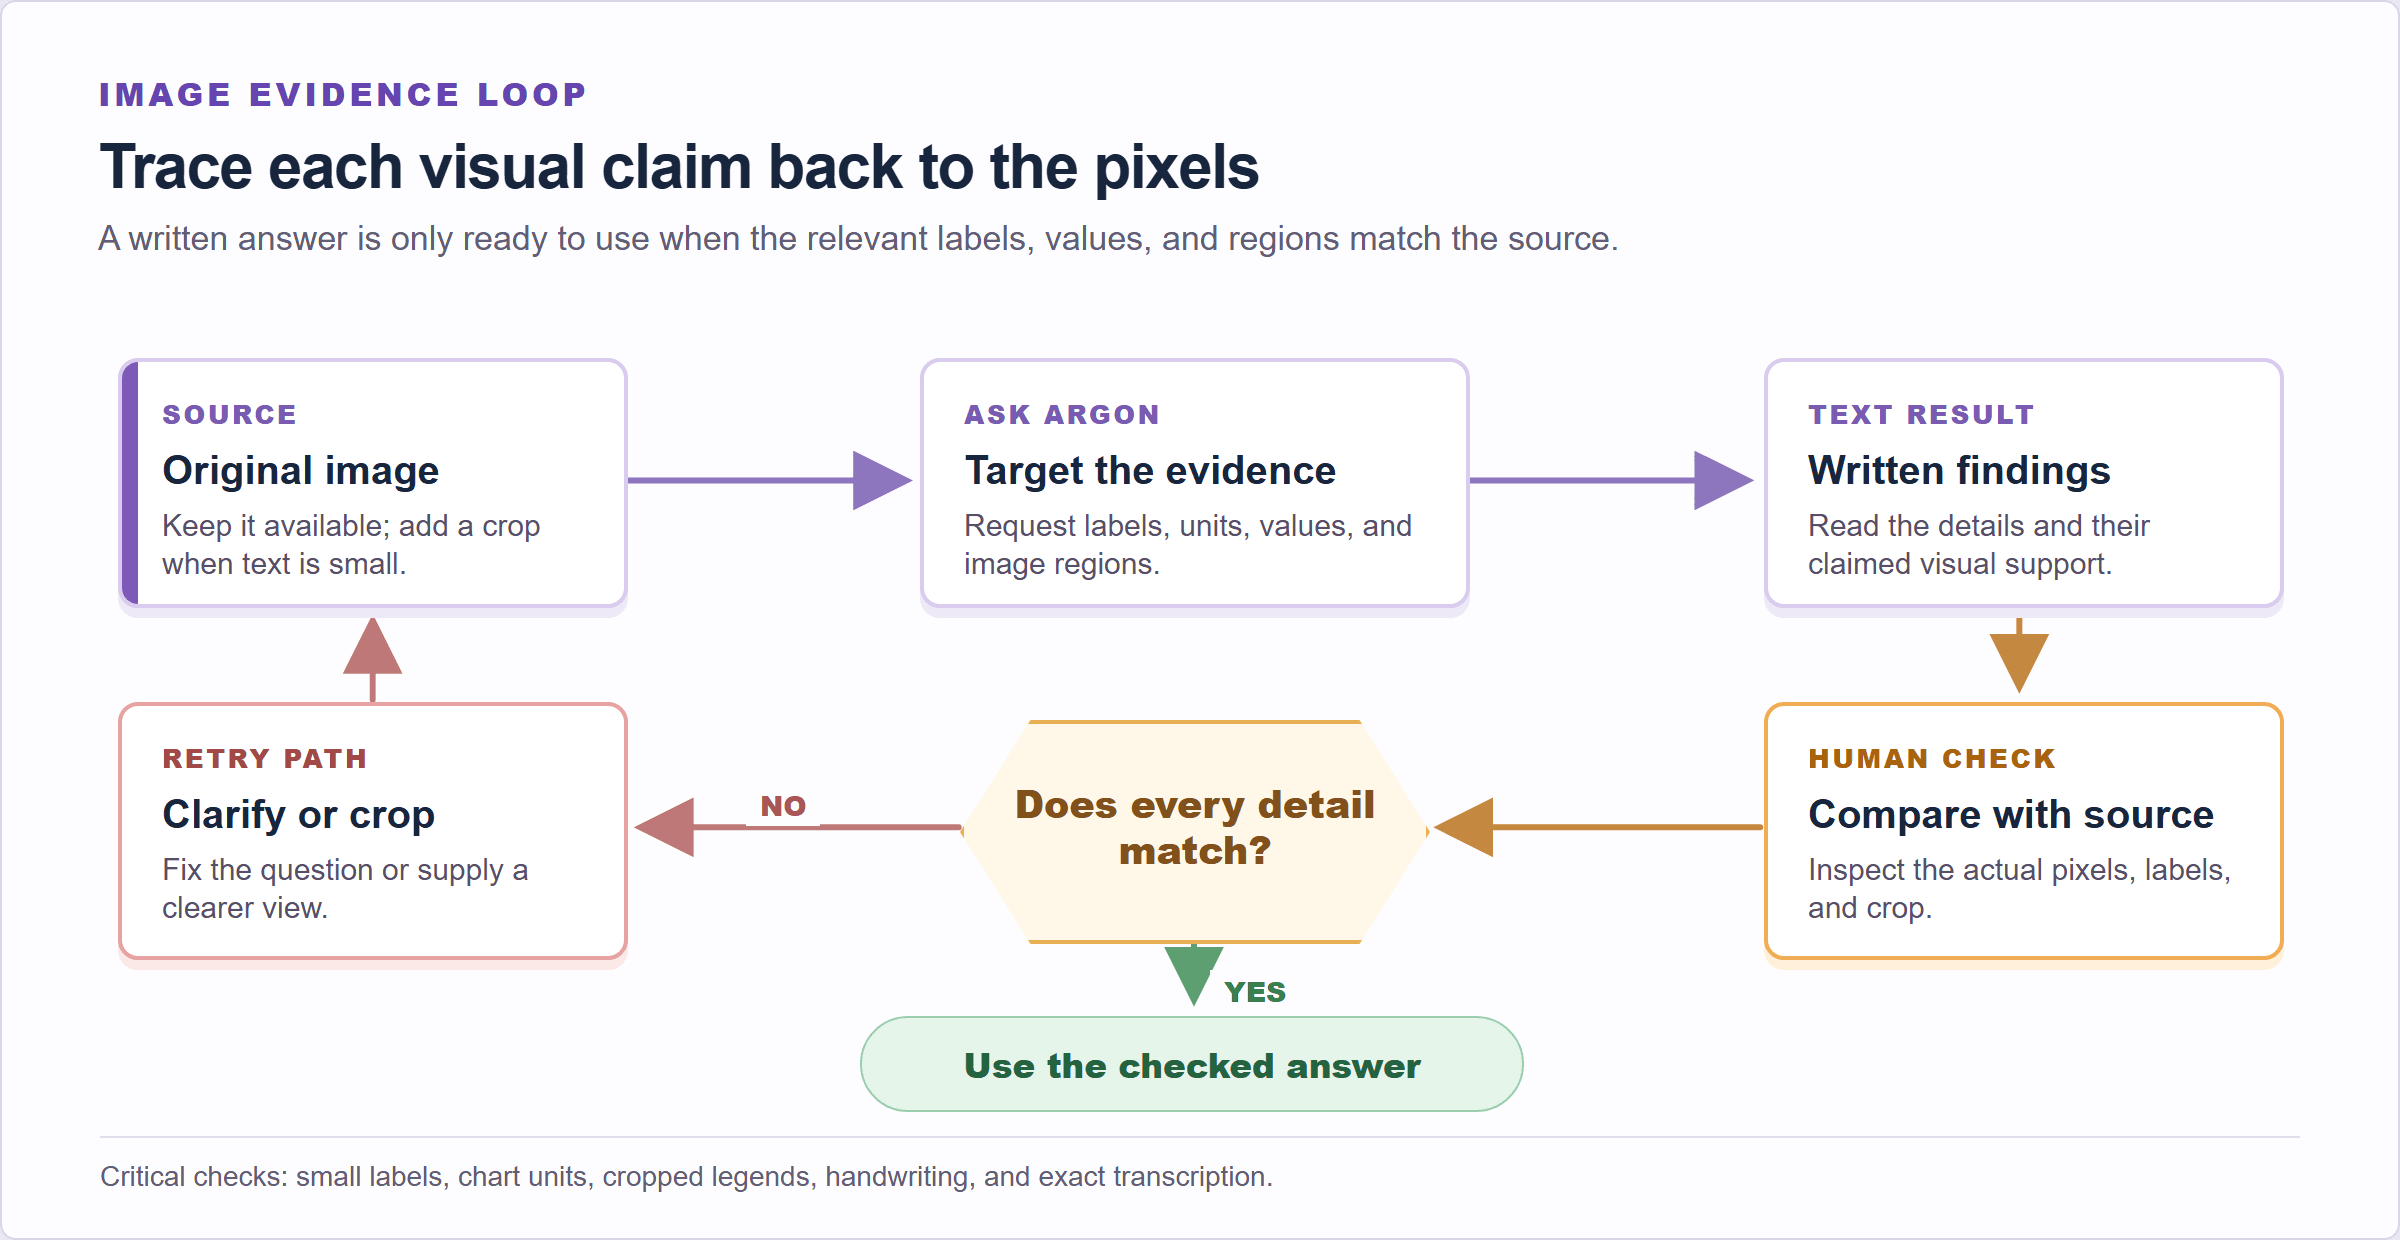 Workflow-Abbildung: Fragen Sie nach Bilddetails und den sie stützenden Regionen und überprüfen Sie dann jede Aussage am Originalbild.
Fragen Sie bei einem Diagramm nach Titel, Achsen, Einheiten, relevanten Werten und der Bildregion, die jeden Wert stützt. Vergleichen Sie diese Details dann mit der Quelle. Kleine Beschriftungen, Screenshots mit niedriger Auflösung, Handschrift, überlappende Markierungen oder eine abgeschnittene Legende sollten manuell geprüft werden. Wenn exakte Transkription wichtig ist, fügen Sie einen klaren Ausschnitt bei und bewahren Sie das Original auf, damit eine prüfende Person jedes Zeichen kontrollieren kann.
Video: Schlussfolgerungen über Ereignisse im Zeitverlauf ziehen
Video fügt Reihenfolge und Zeit hinzu. Argon kann Fragen zu Aktionen, Änderungen und Ereignissen über Frames hinweg beantworten. Die API unterstützt agentisches Videoverständnis, eine Option, die die Zeitachse dynamisch untersuchen kann; der dokumentierte Standardmodus ist statisch. Prüfen Sie den Videoleitfaden und die Anfrageeinstellungen für den Modus, den Ihre Integration tatsächlich verwendet.
Eine nützliche Produktionsfrage könnte lauten: „Zu welcher Zeit entfernt der Techniker den Filter, und was passiert unmittelbar davor und danach?“ Verlangen Sie Zeitstempel und untersuchen Sie dann diese Momente. Eine flüssige Beschreibung ohne zeitlich ausgerichtete Belege reicht für Vorfallprüfung, Qualitätskontrollen oder Trainingsdaten nicht aus.
Googles Robotik-Team beschreibt einen Argon-Workflow, der eine 136-sekündige Overhead-Aufnahme eines zwearmigen Roboters analysiert, der Papier zu einem Origami-Fuchs faltet. Das System erzeugt eine Hierarchie zeitlich ausgerichteter Annotationen, von der Gesamtaufgabe bis zu Teilaufgaben und kontaktbezogenen Aktionen, mit Qualitätskontroll-Labels rund um Wiederholungsversuche. Dies ist ein konkretes Beispiel dafür, dass die Ausgabe der Videoanalyse Labels und Struktur sind, die an das Filmmaterial gebunden sind. Der Artikel ist ein Forschungsbeispiel und keine Garantie dafür, dass ein allgemeiner API-Aufruf eine Robotik-Pipeline reproduziert. (Google Developers Blog, Oktober 2026)
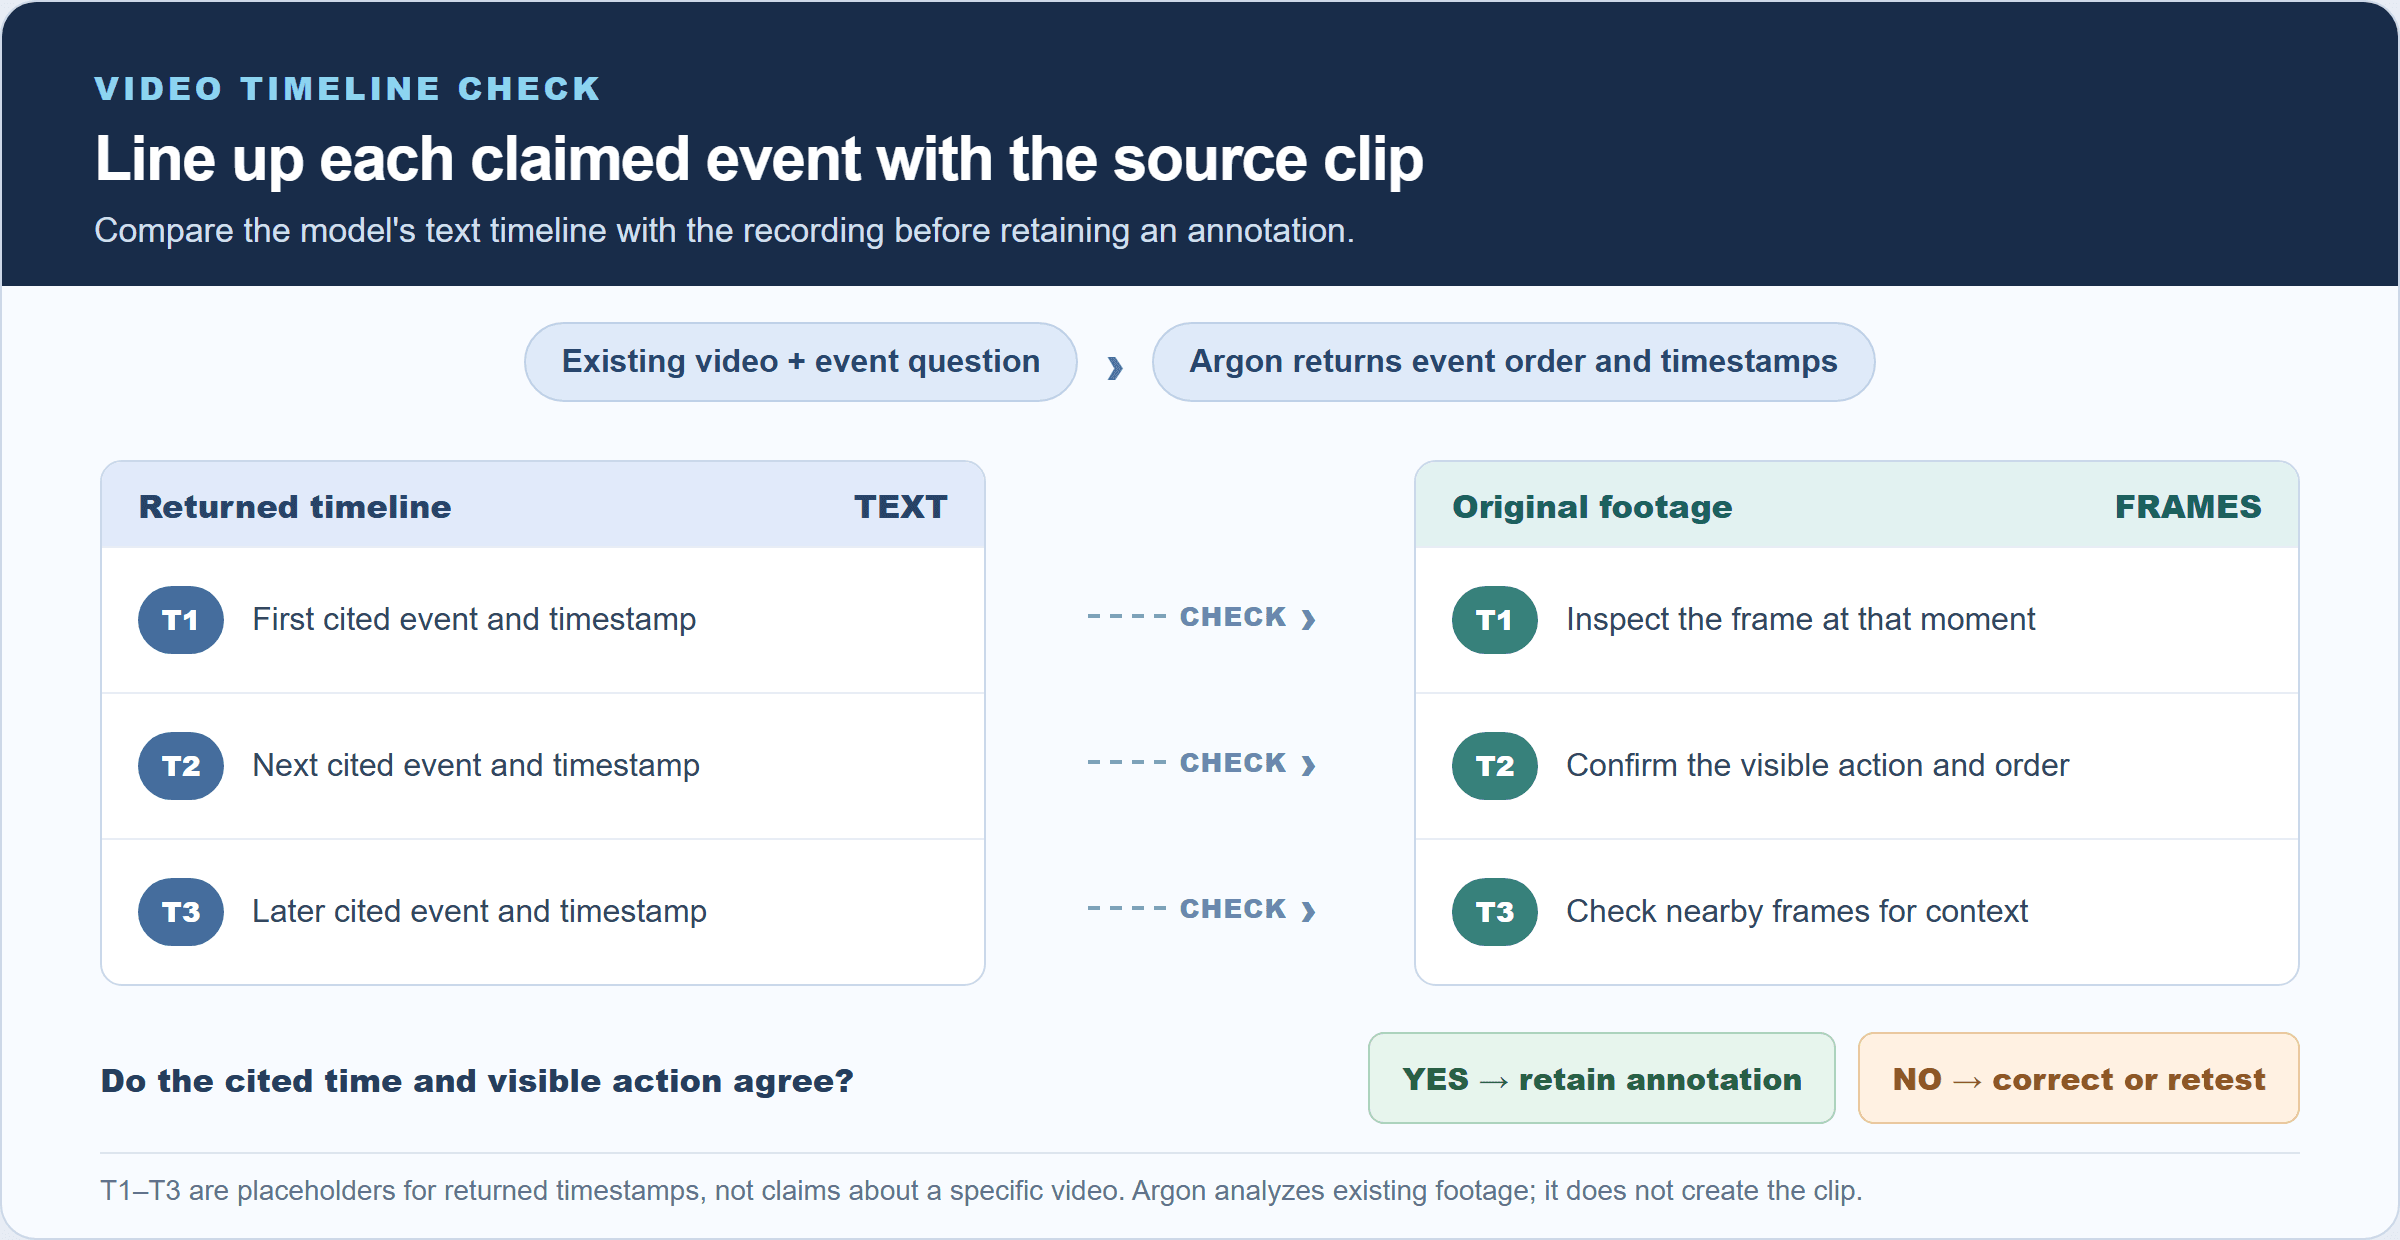 Workflow-Abbildung: Fragen Sie nach Ereignisreihenfolge und Zeitstempeln und überprüfen Sie dann jeden zitierten Moment anhand der Originalaufnahme.
Bewegung kann leicht falsch gelesen werden, wenn sich die Kamera bewegt, Hände ein Objekt verdecken oder zwei Aktionen kurz hintereinander geschehen. Prüfen Sie die zurückgegebenen Zeitstempel stichprobenartig anhand des Originalmaterials. Wenn eine Antwort die Sicherheit oder eine Bestanden/Nicht-bestanden-Entscheidung betrifft, lassen Sie die kritischen Frames von einer Person oder einem speziell dafür entwickelten Vision-System verifizieren.
Audio: bereitgestellte Aufnahmen analysieren
Audio-Eingabe ermöglicht es Ihnen, Fragen zu stellen, die in einer Aufnahme verankert sind, etwa was gesagt wurde, welches Geräusch zuerst auftrat oder ob eine bestimmte Phrase vorkommt. Prüfen Sie vor der Konzeption einer Integration die aktuelle Dokumentation zur Audioeingabe auf unterstützte Formate, Dauer- und Sampling-Einschränkungen und die genaue Anfrageform. „Audio-Eingabe unterstützt“ allein legt nicht jedes Transkriptionsverhalten fest und garantiert nicht, dass ein Anhang tatsächlich durch Ihren Client übergeben wurde.
Erstellen Sie ein kleines Testset mit bekannten Antworten aus Aufnahmen, die Sie verarbeiten dürfen. Nehmen Sie klare Sprache, sich überlappende Sprecher, Hintergrundgeräusche, Stille und Nicht-Sprachgeräusche auf, wenn diese in der Produktion vorkommen. Fragen Sie nach Zeitstempeln oder einem kurzen Belegzitat, wo die Schnittstelle dies unterstützt. Verifizieren Sie, dass der Anhang das Modell erreicht hat, und vergleichen Sie dann das Ergebnis mit der Aufnahme. So werden sowohl Modellfehler als auch Integrationsfehler wie ausgelassene Dateiteile oder nicht unterstützte Kodierung erfasst.
PDFs und gemischte Dokumente: Details über Quellen hinweg verbinden
PDF-Unterstützung ist wertvoll, wenn eine Frage Prosa, Tabellen und Abbildungen überspannt. Eine prüfende Person könnte fragen, ob die Zusammenfassung eines Berichts mit einer Tabelle weiter hinten im Dokument übereinstimmt, oder eine Aussage und die sie stützende Abbildung extrahieren. Mehrere Dokumente können zum Vergleich bereitgestellt werden, vorbehaltlich der Token- und Dateigrenzen der Anfrage.
Verlangen Sie bei jeder Aussage eine Quellenangabe. Seitenverweise sind nützlich, aber validieren Sie sie, da die PDF-Seitennummerierung von der gedruckten Seitenbeschriftung abweichen kann. Verlangen Sie bei einer Tabelle sowohl Zeilenbeschriftung und Spaltenüberschrift als auch den Wert. Bitten Sie das Modell bei einem Diagramm, das verwendete visuelle Element zu benennen. Wenn ein PDF gescannt, gedreht, schwach oder dicht gesetzt ist, testen Sie repräsentative Seiten, anstatt anzunehmen, dass alle Seiten gleich gut geparst wurden.
Ein kompaktes Ausgabeschema kann die Prüfung erleichtern: Aussage, Quellenort, stützender Auszug oder visuelles Detail sowie Konfidenz oder „nicht gefunden“. Strukturierte Ausgaben können eine Form erzwingen, aber ein gültiges JSON-Objekt kann dennoch eine fehlerhafte Lesart enthalten. Formatvalidierung und Faktenvalidierung sind getrennte Prüfungen.
So testen Sie das multimodale Verständnis von Gemini 4 Argon
Führen Sie eine kurze Evaluierung durch, bevor Sie das Modell mit einem großen Batch verbinden. Wählen Sie eine Quelle, bei der ein Mensch die richtige Antwort feststellen kann, und definieren Sie, was als korrektes Ergebnis zählt. Der Sinn besteht darin, den gesamten Pfad von der Dateiauswahl bis zur Modellantwort zu testen, nicht nur zu prüfen, ob die Antwort plausibel klingt.
- Wählen Sie einen öffentlichen Bericht mit einem Diagramm oder ein kurzes Video mit klar identifizierbaren Ereignissen. Halten Sie einen menschlich geprüften Lösungsschlüssel bereit.
- Bitten Sie das Modell, nur das angehängte Material zu verwenden und jeder Aussage einen Ort zuzuordnen.
- Vergleichen Sie jede Aussage mit der Quelle. Erfassen Sie Auslassungen, falsche Lesarten, nicht gestützte Schlussfolgerungen und Orte, die sich nicht auf Belege zurückführen lassen.
- Wiederholen Sie dies mit mehreren Beispielen, die Ihren tatsächlichen Dateien ähneln, einschließlich schwieriger Fälle.
- Legen Sie eine Bestehensgrenze basierend auf den Kosten eines Fehlers fest. Leiten Sie unsichere oder hochrelevante Ergebnisse an eine menschliche Prüfung weiter.
Sie können diesen Prompt anpassen:
Analysieren Sie nur das angehängte Material. Beantworten Sie die folgenden Fragen in einer Tabelle. Zitieren Sie für jede Aussage die Seitenzahl, den Zeitstempel oder den sichtbaren Beleg, der sie stützt. Wenn das Material die Antwort nicht enthält, sagen Sie „nicht gefunden“. Leiten Sie keine fehlenden Fakten ab.
Ersetzen Sie bei einem Bild „Seitenzahl, Zeitstempel“ durch „Bildregion und sichtbare Beschriftung“. Fragen Sie bei einem PDF nach der Seite und dem Tabellen- oder Abschnittsnamen. Fordern Sie bei Audio einen Zeitstempel und die Wörter oder Geräusche an, die die Antwort stützen. Diese kleinen Änderungen machen die Ausgabe leichter prüfbar.
Verfolgen Sie Fehler nach Typ, statt eine einzige Gesamtgenauigkeit zu verwenden. Eine falsche Ziffer in einem Diagramm, ein verpasstes Ereignis und ein Zitat der falschen Seite haben unterschiedliche Konsequenzen. Dieser Evaluierungsrahmen verwandelt eine beeindruckende Fähigkeitsliste in eine wiederholbare Entscheidung darüber, ob das Modell für Ihre Dateien verlässlich ist.
Grenzen von Gemini 4 Argon: Was multimodale Unterstützung nicht bedeutet
Eingabeunterstützung impliziert keine passende Ausgabeunterstützung. Die API listet derzeit Bildgenerierung, Audiogenerierung und Live API als für Argon nicht unterstützt auf. Wenn die Aufgabe darin besteht, ein neues Bild, einen Soundtrack oder eine Echtzeit-Sprachinteraktion zu erstellen, wählen Sie ein Modell oder Tool, das diese Ausgabe ausdrücklich aufführt. Sie können Argon weiterhin verwenden, um den Prompt, das Ausgangsmaterial oder das generierte Ergebnis zu analysieren.
Ein Fenster mit einer Million Token garantiert ebenfalls keine vollständige Erinnerung. Es wird von Anfrage und Antwort gemeinsam genutzt, und lange Eingaben können Latenz und Kosten erhöhen. Das Modell kann ein Detail übersehen, fehlende Informationen ableiten oder einen falschen Zeitstempel zurückgeben, während es sicher klingt. Long Decode ist ein API-Ausführungspfad mit zusätzlichen Anforderungen, nicht das Standardverhalten für jeden Client.
Benchmarks sind richtungsweisende Belege. Roboflow berichtet Ergebnisse aus bestimmten Aufgaben-Datensätzen und Evaluierungseinstellungen, während Googles Model Card eine breitere Gruppe interner und öffentlicher Evaluierungen zusammenfasst. Keines davon ersetzt einen Test mit Ihrer Kameraqualität, Ihren Dokumentlayouts, Ihrem Vokabular, Ihren Sprachen und Ihrer Fehlertoleranz. Eine hohe Punktzahl in einer Kategorie kann keine zuverlässige Leistung bei einer anderen Aufgabe belegen.
Ziehen Sie eine prüfende Person hinzu, wenn die Antwort eine finanzielle, rechtliche, sicherheitsbezogene, medizinische oder beschäftigungsbezogene Entscheidung beeinflusst. Bewahren Sie die Originaleingabe und die zurückgegebenen Belege zusammen auf, damit eine Person die Schlussfolgerung prüfen kann. Protokollieren Sie bei wiederkehrenden Workflows die Modellversion, den Prompt, relevante Einstellungen, die Quellkennung und das Prüfergebnis. Diese Aufzeichnung hilft, eine Modelländerung von einem Datei- oder Integrationsproblem zu unterscheiden.
| Aufgabe | Guter erster Test | Genau prüfen |
|---|---|---|
| Diagramm lesen | Nach beschrifteten Werten mit Achseneinheiten fragen | Kleine Schriften, dichte Legenden, ungefähre visuelle Lesarten |
| OCR | Einen sauberen Ausschnitt mit bekannter Transkription verwenden | Unschärfe, Handschrift, Drehung, gemischte Schriften |
| Videoereignisse | Nach mit Zeitstempeln versehenen Aktionen in Reihenfolge fragen | Verdeckung, schnelle Schnitte, abgeleitete Ursachen |
| Audio-Fragen und -Antworten | Eine bekannte Frage zu einer kurzen Aufnahme stellen | Rauschen, mehrere Sprecher, Umgang mit Anhängen |
| PDF-Vergleich | Nach Aussage, Seite und stützender Passage fragen | Gescannte Seiten, nicht übereinstimmende Seitennummerierung, seitenübergreifende Schlussfolgerungen |
Zugriff, Preisgestaltung und wo Atlas Cloud passt
Die öffentliche API-Modell-ID ist gemini-4-argon; Google listet derzeit Gemini API und AI Studio als Zugriffswege auf. Googles aktuelle Mitteilung nennt einen Einführungstarif von $2 pro Million Eingabe-Token und $10 pro Million Ausgabe-Token bis zum 30. November 2026, danach $4 bzw. $20. Gecachte Eingabe hat separate Bedingungen, sodass sie nicht als gewöhnliche Eingabe geschätzt werden sollte. (Google, Oktober 2026)
Die aktuelle All-Models-Auflistung von Atlas Cloud zeigte Gemini 4 Argon bei der Prüfung für diesen Artikel nicht. Das bedeutet, dass es hier keine verifizierte Atlas-Argon-Modellseite und keinen Atlas-Preis zum Zitieren gibt. Behandeln Sie eine allgemeine Plattformauflistung nicht als Verfügbarkeitsnachweis. Wenn Ihr Team Anbieter vergleicht oder einen breiteren Modell-Workflow aufbaut, kann Atlas Cloud ein Ort sein, um andere aufgeführte Modelle zu durchsuchen, aber bestätigen Sie die genaue Modellseite und die unterstützten Operationen, bevor Sie um einen Anbieter herum planen.
Die Quellenprüfung beeinflusst auch die Empfehlung: Verwenden Sie Googles offiziellen Weg, um Argon heute zu testen, und behandeln Sie Atlas Cloud als separate Option zur Entdeckung von Modellen, die tatsächlich aufgeführt sind. Es wird hier nicht behauptet, dass Argon auf Atlas Cloud gehostet wird.
Ist Gemini 4 Argon das Richtige für Ihre Aufgabe?
Setzen Sie Argon auf eine Auswahlliste, wenn die Aufgabe Schlussfolgerungen über gemischtes Material, das Extrahieren visueller Details, das Verfolgen von Ereignissen durch ein Video oder die Prüfung eines langen Berichts erfordert. Sein großer gemeinsamer Kontext und die Textausgabe können helfen, Belege in einer Tabelle oder einem strukturierten Ergebnis zusammenzuführen. Der nächste Schritt ist eine kleine, menschlich prüfbare Evaluierung mit Ihren eigenen repräsentativen Eingaben.
Wählen Sie ein anderes Modell oder Tool, wenn das erforderliche Ergebnis generierte Bilder, generiertes Audio oder eine Live-Audio-/Videokonversation ist. Vergleichen Sie bei OCR oder operativen Entscheidungen seine Ausgabe mit einer speziell dafür entwickelten Alternative, wenn Genauigkeit, Geschwindigkeit oder planbare Kosten wichtiger sind als breites Reasoning.
Wenn die Evaluierung Ihre aufgabenspezifische Schwelle besteht, pilotieren Sie es mit Protokollierung und menschlicher Prüfung, bevor Sie das Volumen erhöhen. Wenn sie fehlschlägt, klassifizieren Sie die Fehler und entscheiden Sie, ob klarere Eingaben, ein geänderter Prompt, ein anderes Modell oder ein separates OCR-/Transkriptionssystem die richtige Lösung ist. Die nützliche Frage ist, ob die multimodalen Fähigkeiten von Gemini 4 Argon Ihr Fehlerbudget erfüllen.
Häufig gestellte Fragen
Kann Gemini 4 Argon Videos und Audio analysieren?
Ja. Seine API listet sowohl Video als auch Audio als unterstützte Eingaben auf. Videoverständnis kann Beschreibungen oder zeitgestempelte Analysen zurückgeben; Audio kann für audiogestützte Fragen bereitgestellt werden. Prüfen Sie die aktuelle Dokumentation zu Dateiformaten und Anfragen und verifizieren Sie dann die Antwort anhand der Originalmedien.
Generiert Gemini 4 Argon Bilder oder Audio?
Nein. Die aktuelle API-Fähigkeitstabelle markiert Bildgenerierung und Audiogenerierung als für dieses Modell nicht unterstützt. Seine dokumentierte Ausgabemodalität ist Text, selbst wenn seine Eingabe Bilder, Audio oder Video enthält.
Was bedeutet das 1M-Token-Kontextfenster von Gemini 4 Argon?
Das Limit von 1.048.576 Token wird von Eingabe und Ausgabe gemeinsam genutzt. Die standardmäßige synchrone Ausgabe ist auf 65.536 Token begrenzt. Google dokumentiert einen separaten Long-Decode-Ablauf für größere Ausgaben bis zum gemeinsamen Limit, mit Hintergrundausführung und Fortsetzungsschritten.
Wie viel kostet der Zugriff auf die Gemini 4 Argon API?
Stand 16. Oktober 2026 listet Google $2 pro Million Eingabe-Token und $10 pro Million Ausgabe-Token bis zum 30. November 2026 auf. Die aufgeführten anschließenden Preise sind $4 und $20. Prüfen Sie die Live-Preisgestaltung und die Bedingungen für gecachte Token, bevor Sie ein Projekt kalkulieren.


