Eine Zwei-Personen-Szene wird überzeugend, wenn man sehen und hören kann, wem welche Zeile gehört. Um Gemini Omni 1.2 Flash Multi-Speaker-Dialog leicht verständlich zu machen, geben Sie jeder Figur eine feste visuelle und stimmliche Identität, schreiben Sie kurze Zeilen in Sprechreihenfolge und prüfen Sie das fertige Video mit Augen und Ohren. Googles Update vom November 2026 unterstützt natürlichere Multi-Speaker-Sprache und Clips bis zu 15 Sekunden, aber ein Prompt kann keine saubere Sprecherzuweisung beim ersten Rendern garantieren. Beginnen Sie mit einem einfachen 2-Personen-Austausch und fügen Sie erst dann eine dritte Wendung oder Straßenatmosphäre hinzu, wenn Sie die grundlegende Übergabe beurteilen können.
Wichtige Erkenntnisse
- Gemini Omni 1.2 Flash generiert Video mit nativem Ton, einschließlich Dialog; es unterscheidet sich von reinen Audio-Gemini-Text-to-Speech-Modellen.
- Verwenden Sie benannte Sprecher, exakte zitierte Zeilen, klare Positionen und einen stillen Zuhörer für jede Wendung.
- Lassen Sie Platz für Pausen innerhalb des 15-Sekunden-Maximums und prüfen Sie dann jede Zeile anhand des Clips.
- Berechnen Sie den Preis für ein Rendering anhand der ausgewählten Dauer und Auflösung, nicht anhand des niedrigsten beworbenen Preises einer Plattform.
Was bedeutet Multi-Speaker-Dialog in Gemini Omni 1.2 Flash?
Das Modell erzeugt eine kurze Szene, in der Menschen als Teil des generierten Audio- und Videomaterials sprechen können. Der praktische Test ist, ob ein Zuschauer erkennen kann, wer welche Zeile sagt, ohne ein Transkript zu lesen. Die Worte, die Stimme, die sichtbare Person und die Mundbewegung müssen gleichzeitig übereinstimmen. Ein Clip kann bei stummgeschaltetem Ton überzeugend wirken und diesen Test dennoch nicht bestehen.
Google kündigte Gemini Omni 1.2 Flash am 5. November 2026 mit bis zu 15 Sekunden generiertem oder bearbeitetem Video an. Es beschreibt flüssigeren Dialog, klarere Lippensynchronisation und ausgeprägtes Multi-Speaker-Conditioning. Das sind Fähigkeitsaussagen, kein Versprechen, dass jedes Skript genau wie geschrieben geliefert wird (Googles Ankündigung vom November 2026).
Googles veröffentlichte Demonstration zeigt die angekündigte Fähigkeit. Sie ist von den drei unten bereitgestellten Videofällen getrennt.
Was hat sich gegenüber Gemini Omni 1.1 Flash geändert?
Der offizielle Vergleich gibt 1.2 eine längere Obergrenze: 15 Sekunden statt 10. Er nennt auch Verbesserungen bei Sprache, Lippensynchronisation, Referenzverfolgung und konversationellem Editing. Die zusätzlichen 5 Sekunden machen einen 3-Wendungen-Austausch plausibler für das Skript, aber eine längere Dauer schafft nicht mehr Sprechzeit, wenn ein Regisseur auch Pausen, körperliche Reaktionen und Szenenwechsel verlangt.
Die sicherste Lesart ist richtungsweisend. Besseres Conditioning kann Dialog leichter dirigierbar machen, während jeder gelieferte Clip noch geprüft werden muss. Ein Creator kann das 15-Sekunden-Limit nutzen, um ein Skriptziel zu setzen. Ein Produzent, der exakten rechtlichen Text oder eine präzise Stimmübereinstimmung verspricht, sollte die generierte Ausgabe als Entwurf behandeln, bis sie die Prüfung besteht.
Video-Dialog vs. Multi-Speaker-Text-to-Speech
Gemini-Text-to-Speech-Modelle nehmen Text entgegen und geben Audio zurück. Ihre Sprechereinstellungen und Stimmauswahlen gehören zu diesem Audio-Workflow, den Google separat dokumentiert (Googles Gemini-Text-to-Speech-Dokumentation, abgerufen im November 2026). Die Text-to-Video-Route von Gemini Omni 1.2 Flash nimmt einen Szenen-Prompt entgegen und erzeugt Video mit nativem Ton. Ein speech_config-Beispiel für Text-to-Speech ist keine Gemini Omni 1.2 Flash Videosteuerung. Diese Beispiele beschreiben stimmliche Charakteristik im Text; sie erheben nicht den Anspruch, eine aufgenommene Stimme hochzuladen, zu klonen oder auszuwählen. Wenn ein Briefing die Stimme eines bestimmten Schauspielers erfordert, überprüfen Sie Zugriff und Einwilligung separat, bevor Sie die Aufnahme planen.
Wenn Ihr Deliverable ein Podcast-Gespräch oder ein feststehendes Voiceover ist, verwenden Sie Text-to-Speech und schneiden Sie das Bild um dieses Audio herum. Wenn es sich um zwei sichtbar sprechende Personen in einer generierten Szene handelt, verwenden Sie Gemini Omni 1.2 Flash Video und testen Sie die Ausrichtung in der tatsächlichen Ausgabe.
Wo kann man es ausführen und was kostet ein Clip?
Wählen Sie die Text-to-Video-Route
Google listet Gemini Omni 1.2 Flash in seinen Kreativ- und Entwicklerprodukten auf. Verwenden Sie für einen reproduzierbaren Test eine Route: Atlas Cloud bietet das Modell an, und sein Gemini Omni 1.2 Flash Text-to-Video-Playground ist der Ort, an dem Sie die folgenden Prompts einfügen. Die Routen-ID lautet google/gemini-omni-1.2-flash/text-to-video. Die folgenden Prompts verwenden nur Text, ohne Bild-, Bewegungs- oder Stimmreferenzen.
Die Prompts fordern 12 Sekunden in 16:9 für das Büro, 15 Sekunden in 16:9 für das Café und 12 Sekunden in 16:9 für das Straßeninterview an. Die drei bereitgestellten Dateien sind 720p. Bestätigen Sie die Live-Steuerelemente und ausgewählten Werte, bevor Sie auf Ausführen drücken. Eine auf einer Produktseite beworbene Einstellung ist kein Beweis dafür, dass ein bestimmter Testlauf sie akzeptiert hat. Speichern Sie die ausgewählten Werte und das Angebot mit jeder Ausgabe. Dadurch wird jedes Rendering zu einem nützlichen Beweis: Sie können den Prompt mit der ausgewählten Auflösung und Route vergleichen, wenn Sie seine Ausgabe überprüfen. Dieser Leitfaden spezifiziert die Text-to-Video-Route, daher sollte ein Ergebnis aus einer Image-to-Video- oder Reference-to-Video-Route separat gekennzeichnet werden.
Die bereitgestellten Videodateien enthalten keine abgeschlossene Playground-Aufzeichnung, ausgewählte Einstellungen oder ein Angebot vor dem Absenden. Ihre Route und Konfiguration bleiben daher unbestätigt.
| Route | Input für diesen Leitfaden | Am besten geeignet | Wo die Kosten überprüft werden |
|---|---|---|---|
| Googles Kreativprodukte | Ein Szenen-Prompt; Steuerelemente variieren je nach Produkt | Manuelle Erstellung im Google-Editor | Der aktuelle Plan- oder Guthabenbildschirm |
| Google API | Eine Entwickler-Videoanfrage | Anwendungsintegration | Googles Preis für die exakte Auflösung |
| Atlas Cloud Text-to-Video | Prompt, Dauer, Seitenverhältnis, Auflösung | Wiederholung dieser reinen Texttests in einem Playground | Das Angebot der ausgewählten Konfiguration vor dem Absenden |
Prüfen Sie den Preis, bevor Sie rendern
Google nennt 0,07 $ pro generierter Sekunde für 720p über seine API, 30 % unter Gemini Omni 1.1 Flash. Bei diesem Angebotspreis kosten 12 Sekunden 720p 0,84 $, bevor andere abrechenbare Arbeiten hinzukommen. Diese Berechnung ist kein Atlas Cloud-Angebot für die bereitgestellten Dateien; ihre Route und Abrechnung sind unbestätigt. Credits in Flow oder einem anderen Editor folgen den eigenen Regeln dieses Produkts.
Atlas Cloud listet einen niedrigeren Einstiegs-Sekundenpreis in seinem Modellkatalog, aber das Minimum kann einer anderen Auflösung oder Konfiguration entsprechen. Lesen Sie das Live-Angebot, nachdem Sie Dauer und Auflösung gewählt haben. Ein 360p-Entwurf kann helfen, einen Prompt zu erkunden; es ist eine separate Generierung und keine Bild-für-Bild-Vorschau eines späteren 1080p-Renderings.
Zwei Stimmen in eine 15-Sekunden-Szene einpassen
Geben Sie jedem Sprecher eine visuelle und stimmliche Identität
Schreiben Sie Beschreibungen, die ein Prüfer verifizieren kann. „Sprecher A steht links in einem marineblauen Hemd“ ist klarer als „der erste Kollege“. Fügen Sie eine hörbare Unterscheidung hinzu, z. B. mittlere Tonlage gegenüber tieferer. Halten Sie Namen, Kleidung, Position und Stimmen im gesamten Prompt konsistent. Diese Anker machen eine vertauschte Zeile leichter erkennbar.
Visuelle Identität ist wichtig, weil Audio allein einen Prüfer täuschen kann. Wenn sich die Stimmen unterscheiden, aber der falsche Mund sich bewegt, hat der Clip ein Lippensynchronisationsproblem. Wenn sich der richtige Mund bewegt, aber A's Stimme sich bei A's zweiter Wendung ändert, liegt Voice Drift vor. Das Café-Beispiel bringt A nach B zurück, damit ein Prüfer überprüfen kann, ob A's Stimme konsistent bleibt.
Planen Sie Zeit für Sprache und Reaktion ein
Lesen Sie das Skript im vorgesehenen Tempo laut vor. Fügen Sie an jeder Übergabe eine natürliche Pause ein und lassen Sie dann Platz für eine Reaktion des Zuhörers und für die Eröffnungseinstellung, die beide Gesichter etabliert. Das überarbeitete Büro-Skript hat 5 Wendungen in 12 Sekunden. Das Café hat 8 kurze Wendungen in 15 Sekunden und ist damit der anspruchsvollste Zeittest hier. Dies sind Beispielskripte, keine universelle Wörter-pro-Sekunde-Schwelle oder ein Versprechen über die Ausgabe.
| Szenenbudget | Gesprochene Sequenz | Benötigte Zeit über Worte hinaus |
|---|---|---|
| 12-Sekunden-Büro | A-B-A-B-A | Beide Personen etablieren und 4 Übergaben unterbringen |
| 15-Sekunden-Café | Acht abwechselnde Wendungen | Sieben Übergaben mit wenig Spielraum |
| 12-Sekunden-Straße | A-B-A-B-A | Vier Übergaben über Straßenatmosphäre |
Eine lange Zeile verleitet zum Hetzen oder Auslassen gegen Ende. Wenn der Entwurf fast die gesamten 15 Sekunden zum Vorlesen beansprucht, kürzen Sie ihn vor der Generierung. Wenn das Szenario mehr Dialog benötigt, planen Sie separate Einstellungen und überprüfen Sie die Kontinuität als weitere Produktionsaufgabe. Halten Sie Gesichter während gesprochener Zeilen beim ersten Versuch sichtbar. Schnelle Schnitte und verdeckte Münder machen die Beurteilung der Sprecherzuweisung schwieriger. Führen Sie einen zeitlich abgestimmten Table-Read mit zwei Personen durch, wenn die Zeilenreihenfolge wichtig ist. Lassen Sie eine Person A und die andere B sprechen, während eine dritte Person notiert, wo jeder Satz endet. Wenn das letzte Wort an der Clip-Grenze landet, entfernen Sie vor dem Rendern eine Klausel oder einen Reaktionsschlag. Ein kürzeres Skript ist leichter zu prüfen, weil der Prüfer den gesamten Austausch wiedergeben kann, ohne raten zu müssen, ob eine Zeile außerhalb des Bildes fortgesetzt werden sollte.
Wie man Gemini Omni 1.2 Flash für 2 Sprecher promptet
Ein nützlicher Prompt liest sich wie ein kompaktes Drehbriefing: Setting und Kamera, Identitäten, exakter Dialog, dann Ton- und Ausschlussregeln. Diese Reihenfolge gibt einem Prüfer auch eine Checkliste. Es ist eine Prompting-Methode, keine dokumentierte Garantie für Kontrolle. Halten Sie die Figurenbezeichnungen vom Identitätsabsatz bis zum Dialogblock identisch. Vermeiden Sie es, dieselbe Person sowohl als A als auch als „der Kunde“ in Anweisungen zu einer späteren Wendung zu bezeichnen, es sei denn, die Zuordnung ist bereits explizit. Ein Leser sollte in der Lage sein, zwei Spalten zu zeichnen, eine für jede Person, und jede angeforderte Aktion und gesprochene Zeile genau einer Spalte zuzuordnen.
Verwenden Sie explizite Sprecherbezeichnungen und zitierte Zeilen
Verwenden Sie eine Zeile pro Wendung mit Speaker A: oder Speaker B: und zitierten Wörtern. Geben Sie an, wer still bleibt. Die Bitte um „eine Diskussion über die Startbereitschaft“ erlaubt Improvisation. Ein exaktes Skript lässt Sie ein fehlendes oder umgeschriebenes Wort sofort markieren.
Hier ist der erste zu kopierende Prompt. Er hält beide Erwachsenen in einer durchgehenden Einstellung, damit der Zuschauer jeden Mund prüfen kann.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
Bereitgestelltes 12-Sekunden-720p-Büro-Rendering. Beide Personen bleiben sichtbar; die fünf gesprochenen Zeilen und die Lippensynchronisation erfordern noch eine Hörprüfung.
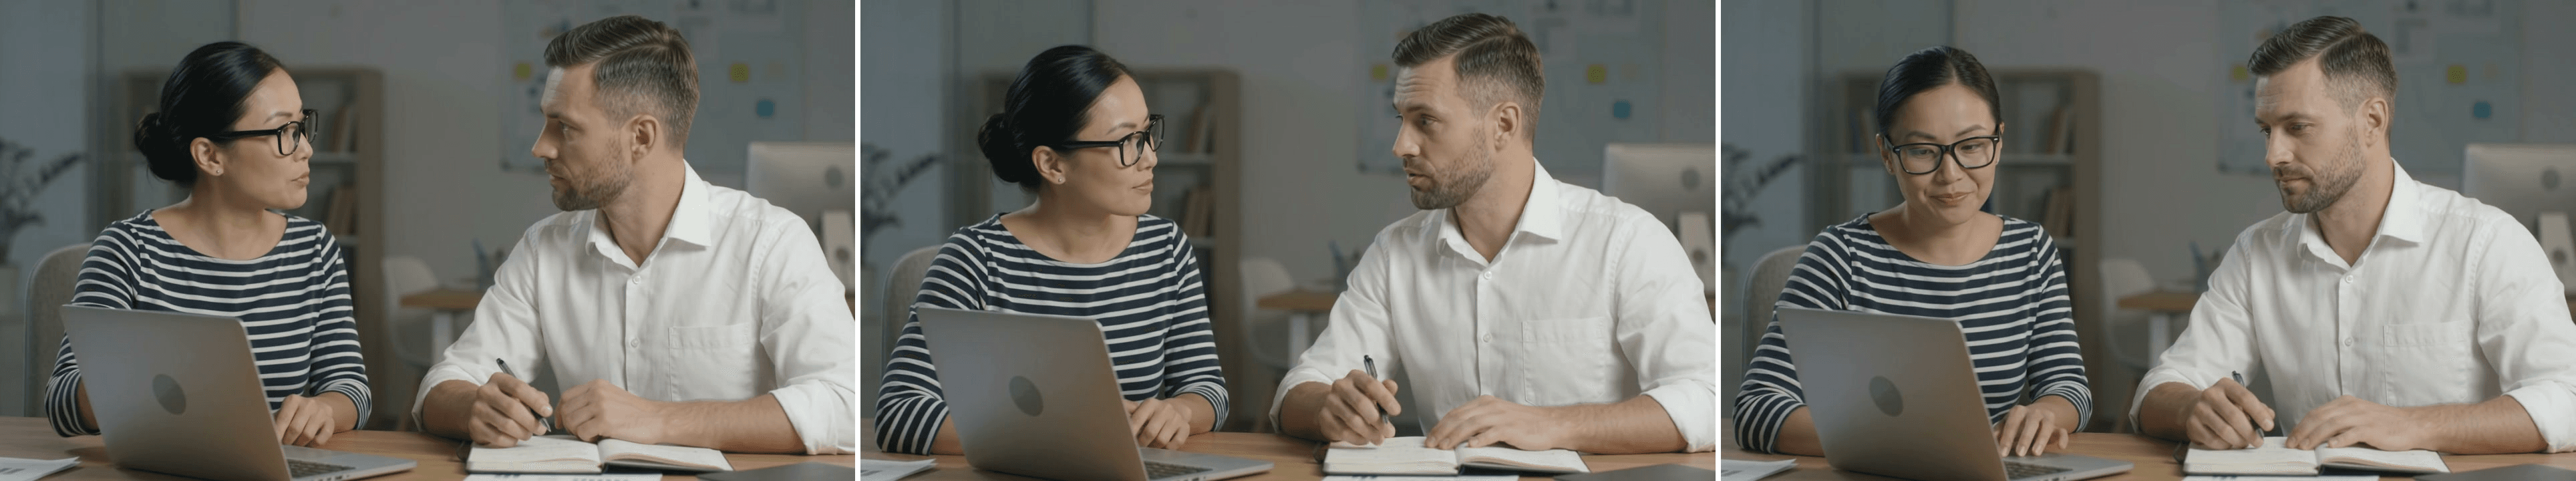 Fall A Einzelbilder, von links nach rechts (etwa 0:02, 0:05, 0:10): Die Frau wendet sich ihrem Kollegen zu; er scheint zu antworten, während beide im Bild bleiben; sie richten ihre Aufmerksamkeit wieder auf Laptop und Notizbuch.
Steuern Sie die Kamera, ohne den Sprecher zu verlieren
Eine durchgehende halbnahe 2er-Einstellung ist eine diagnostische Wahl. Beide Gesichter bleiben im Blick, sodass eine verpasste Übergabe nicht hinter dem Schnitt versteckt werden kann. Das Modell kann den Bildausschnitt dennoch variieren, weshalb die endgültige Datei geprüft werden muss.
Sobald die Übergabe für Ihren Zweck funktioniert, versuchen Sie eine maßvolle Bewegung, die beide Gesichter bewahrt. Der Straßen-Prompt fordert eine solche in einem 16:9-Rahmen an, der beide Gesichter sichtbar hält, wodurch Mundbewegungen leichter zu beurteilen sind. Das ist ein Grund, zuerst die Büro-Baseline zu etablieren.
Halten Sie Hintergrundaudio unter dem Dialog
Benennen Sie die Atmosphäre und ihre Priorität. Leiser Raumton gibt dem Büro-Clip wenig Konkurrenz zur Sprache. Sanfter Café-Klang fügt Kontext hinzu und hält die Zeilen testbar. Der Straßen-Prompt verlangt Schritte und ferne Geräusche unter beiden Stimmen, ohne Passantensprache.
Negative Anweisungen können unerwünschtes Audio reduzieren, bleiben aber Anfragen. Achten Sie auf eine dritte Stimme, Erzählung, Musik und Markenaudio. Prüfen Sie das Bild auch auf Untertitel und Logos.
3 Dialog-Szenen, die zeigen, wer wann spricht
Die drei bereitgestellten Videodateien zeigen die beabsichtigten Büro-, Café- und Straßenszenen. Ihr visueller Inhalt kann hier geprüft werden, aber die Dateien belegen nicht, welche Route oder Einstellungen sie erzeugt haben. Die folgenden Prompts sind reproduzierbare Anfragen, keine Behauptung, dass die Ausgabe jedes Wort korrekt gesprochen hat. Das Büro prüft 5 Wendungen, das Café testet 8 schnelle Wendungen und die Straße fügt Umgebungsgeräusche hinzu.
| Fall | Prompt-Anfrage | Bereitgestellte Datei | Hauptprüfung |
|---|---|---|---|
| A: Büro-Übergabe | 12s, 16:9, 5 Wendungen | 12s, 16:9, 720p | Fünf Zeilen, korrekte Münder |
| B: Café-Austausch | 15s, 16:9, 8 Wendungen | 15s, 16:9, 720p | Acht Zeilen, stabile Stimmen |
| C: Straßeninterview | 12s, 16:9, 5 Wendungen | 12s, 16:9, 720p | Straßenhörbarkeit und Sprecherwechsel |
Eine Büro-Übergabe mit fünf Wendungen
Verwenden Sie den vollständigen Prompt und das Video oben. Beide Kollegen bleiben in derselben Einstellung, sodass jede der fünf angeforderten Wendungen eine sichtbare Person zum Prüfen hat. Notieren Sie jede hörbare Zeile gegen den Text und prüfen Sie den aktiven Mund. Die bereitgestellte Datei etabliert die Szene und Dauer, aber ihre Worte und Lippensynchronisation wurden nicht unabhängig verifiziert.
Eine klare Übergabe in einem Clip würde eine Schlussfolgerung nur über diesen Clip stützen, nicht über eine modellweite Erfolgsquote. Bewahren Sie das erste Ergebnis auf, damit jede Überarbeitung mit dem Original verglichen werden kann.
Ein Café-Austausch mit acht Wendungen
Fordern Sie 15 Sekunden in 16:9 an. Acht kurze Wendungen setzen wiederholte Stimmzuordnung und Timing unter Druck. Vergleichen Sie die erste und letzte Zeile jeder Person und prüfen Sie dann, ob sich eine Zeile überschneidet oder verschwindet. Die bereitgestellte Datei ist 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
Ein Outdoor-Q&A
Fordern Sie 12 Sekunden in 16:9 an. Dies fügt eine leichte Kamerabewegung und Umgebungsgeräusche hinzu. Die bereitgestellte Datei ist 16:9 bei 720p und kann auf fünf Sprecherwendungen und Straßenhörbarkeit geprüft werden.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
Kombinierte Wiedergabe: 0:00–0:15 ist Fall B, der Café-Austausch; 0:15–0:27 ist Fall C, das Straßeninterview. Beide Quellclips sind vollständig enthalten.
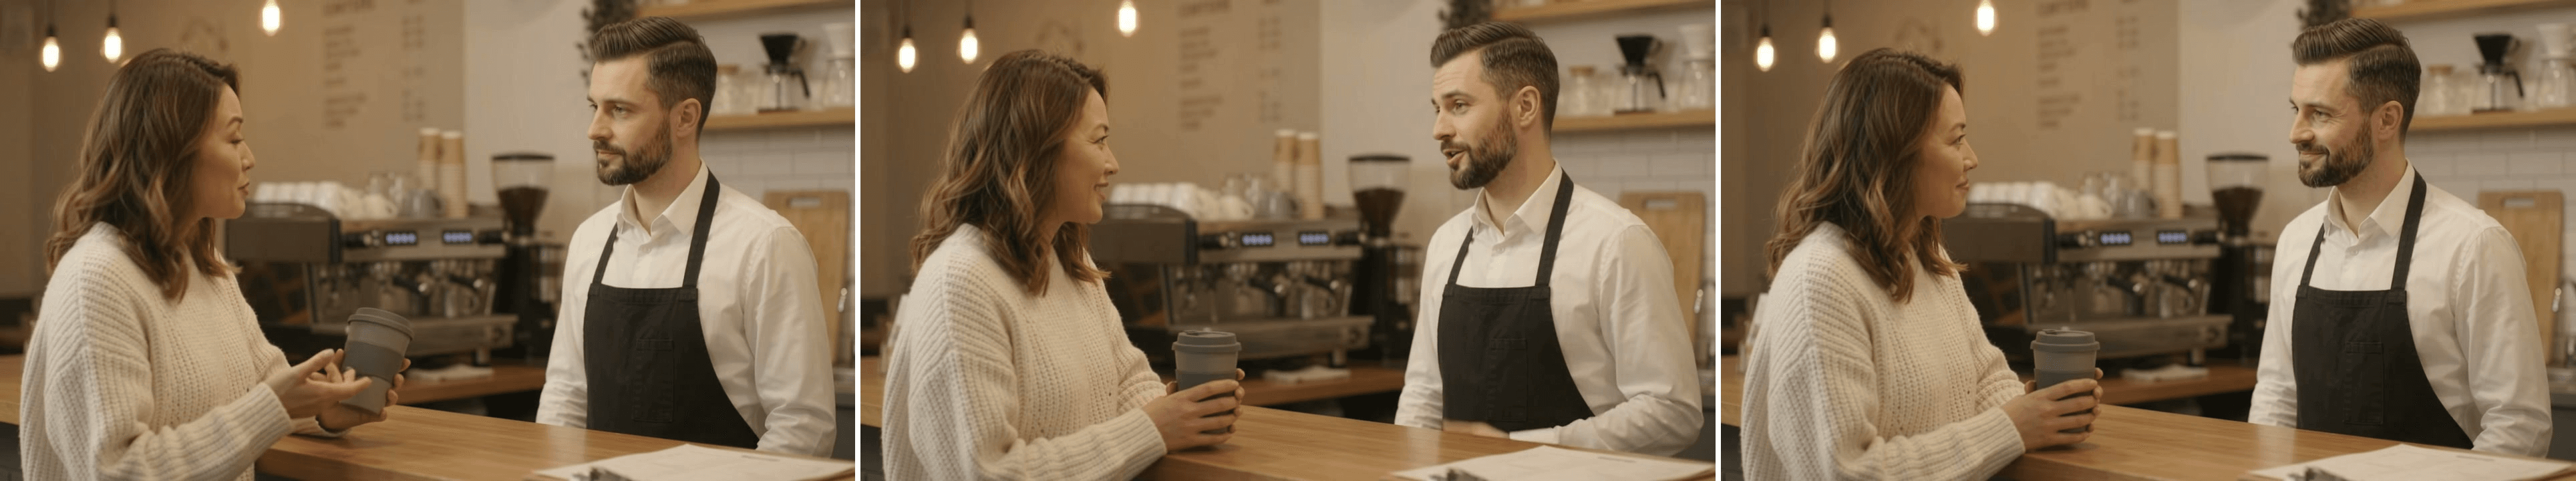 Fall B Einzelbilder, von links nach rechts (etwa 0:02, 0:08, 0:13 des kombinierten Videos): Die Kundin zeigt ihre Tasse; der Café-Mitarbeiter scheint zu antworten; sie wenden sich am Ende einander zu.
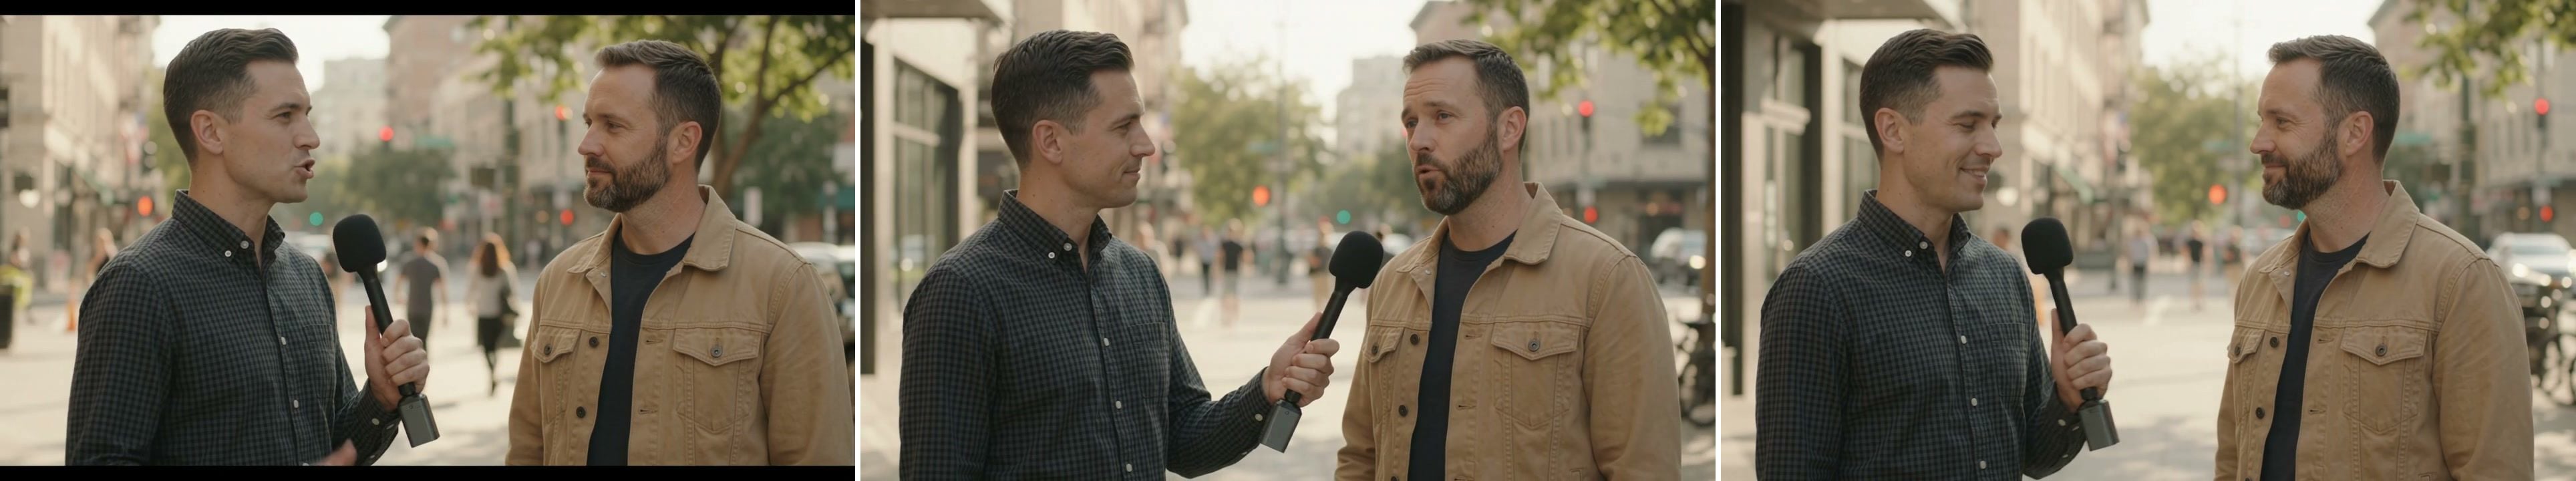
Fall C Einzelbilder, von links nach rechts (etwa 0:16, 0:19, 0:26 des kombinierten Videos): Der Interviewer hält das Mikrofon; er dreht es zum Interviewten; beide wenden sich am Ende einander zu.
Prüfen Sie Sprecherreihenfolge, Lippensynchronisation und Voice Drift vor der Veröffentlichung
Überprüfen Sie den Clip Zeile für Zeile
Laden Sie das Video herunter. Spielen Sie es einmal ab, ohne das Skript zu lesen, um offensichtliche Verwirrung zu finden, und spielen Sie es dann erneut mit dem Prompt daneben ab. Pausieren Sie bei jeder Wendung und notieren Sie, was Sie hören. Untersuchen Sie beide Münder und notieren Sie Sprache außerhalb der skriptierten Wendungen. Für eine wiederholbare Überprüfung protokollieren Sie die Start- und Endzeit jeder hörbaren Zeile, den erwarteten Sprecher, die gehörte Stimme und den sichtbaren Mund, der sich bewegt hat. Schreiben Sie „unklar“, wenn ein Gesicht verdeckt ist oder der Ton ein Wort überdeckt. Machen Sie aus einer unklaren Zelle kein Bestehen, nur weil der Rest der Szene überzeugend aussieht. Ein zweiter Zuhörer, der den Prompt nicht gesehen hat, kann angeben, wer seiner Meinung nach spricht; vergleichen Sie dieses Urteil mit dem Skript, bevor Sie entscheiden, ob ein öffentlicher Zuschauer die Szene verstehen wird.
Prüfen Sie 4 Dinge für jede Zeile:
- Worte: Wurden die zitierten Worte in der richtigen Reihenfolge gesprochen, ohne ausgelassenes Ende oder hinzugefügten Satz?
- Stimmbesitzer: Klang die benannte Person wie der Sprecher, insbesondere als A zurückkehrte?
- Sichtbares Timing: Bewegte sich der Mund dieser Person, während der Zuhörer still blieb?
- Andere Inhalte: Fügte der Clip einen Erzähler, Passanten, Untertitel, Logo oder Musik hinzu?
Eine mit Zeitstempeln versehene Qualitätssicherungs-Zeitleiste bleibt ausstehend, bis das Audio und die Mundbewegungen Zeile für Zeile überprüft wurden.
Überarbeiten Sie jeweils eine Einschränkung
Wenn die letzte Zeile verschwindet, kürzen Sie das Skript oder geben Sie ihm mehr Dauer innerhalb der 15-Sekunden-Grenze. Wenn die falsche Figur spricht, wiederholen Sie die visuelle Position und geben Sie an, dass der Zuhörer still bleibt. Wenn die Atmosphäre ein Wort überdeckt, verringern oder entfernen Sie sie. Wenn ein Schnitt den aktiven Mund verdeckt, kehren Sie zu einer durchgehenden 2er-Einstellung zurück. Ändern Sie einen Faktor pro Wiederholung, damit die nächste Ausgabe eine klare Frage beantwortet.
Keine dieser Änderungen garantiert eine Lösung. Wenn ein Rendering überarbeitet werden muss, speichern Sie seine Datei, Einstellungen und das Problem, das Sie beheben möchten. Ein Produzent kann dann entscheiden, ob ein weiteres Rendering die Kosten wert ist oder ob aufgenommene Stimmen und manuelles Editing die erforderliche Präzision bieten. Beginnen Sie bei einem kurzen, sichtbar gesprochenen Austausch mit dem Büro-Prompt und akzeptieren Sie einen Clip erst nach der Zeile-für-Zeile-Prüfung. Das ist der Standard für Gemini Omni 1.2 Flash Multi-Speaker-Dialog.
Häufig gestellte Fragen
Kann Gemini Omni 1.2 Flash dieselben Stimmen über separate Clips hinweg beibehalten?
Eine Stimme, die innerhalb eines generierten Clips erkennbar bleibt, ist eine engere Anforderung als sie über separate Generierungen hinweg zu bewahren. Diese reinen Textbeispiele testen den ersten Fall. Versprechen Sie daraus keine clipübergreifende Stimmidentität. Eine Kampagne, die einen wiederkehrenden Sprecher benötigt, sollte einen separaten Kontinuitätstest durchführen.
Kann Gemini Omni 1.2 Flash Dialog in anderen Sprachen als Englisch generieren?
Das Modell kann andere Sprachen erzeugen, aber diese Prompts sind auf Englisch. Überprüfen Sie die Zielsprache Wort für Wort mit einem fließend sprechenden Zuhörer, einschließlich Namen, Zahlen und lokalisierten Aussagen. Der erfolgreiche Sprachtest eines anderen Creators ist ein Beweis für diesen Test, keine Garantie für Ihr Skript.
Wie behalte ich jede Zeile dem richtigen Sprecher zugewiesen?
Geben Sie jeder Person eine visuelle Position und Stimme, kennzeichnen Sie jede zitierte Zeile und geben Sie an, wer während der Wendung der anderen Person still bleibt. Überprüfen Sie das generierte Video Zeile für Zeile. Wenn ein Rendering das Briefing nicht erfüllt, kürzen Sie den Austausch oder verwenden Sie einen kontrollierten Audio-Workflow für exakte Lieferung.
Wie viele Dialogwendungen passen in einen 15-sekündigen Gemini Omni 1.2 Flash Clip?
Der Café-Prompt fordert acht kurze Wendungen in 15 Sekunden an, während die Büro- und Straßen-Prompts fünf Wendungen in 12 Sekunden anfordern. Dies sind Skriptbeispiele, keine garantierten Limits. Lesen Sie die Zeilen laut vor, berücksichtigen Sie Pausen und kürzen Sie sie, wenn die letzte Wendung das Ende des Clips erreicht.
Benötigt Gemini Omni 1.2 Flash ein Referenzbild für Zwei-Sprecher-Dialog?
In diesen drei Text-to-Video-Prompts wird kein Referenzbild verwendet. Sie beschreiben die Position, Kleidung und Stimme jedes Sprechers im Text. Wenn ein Projekt ein bestimmtes Gesicht oder einen visuellen Stil benötigt, testen Sie eine Route, die Referenzen akzeptiert, und überprüfen Sie deren Ausgabe separat.


