Kurzantwort
Ein GitHub AI Video Generator Skill verbindet deinen Code mit KI-Videomodellen. Im Jahr 2026 hängt die Wahl zwischen Open-Source (kostenlos, selbst gehostet) und Bezahl-APIs (Cloud, sofort) von vier Variablen ab: verfügbarer VRAM, Anforderungen an den Datenschutz, benötigte Qualitätsobergrenze und monatliches Generierungsvolumen. Für Produktionsworkflows mit mehreren SOTA-Modellen bietet Atlas Cloud (atlascloud.ai) Zugriff auf über 300 Modelle – darunter Kling v3.0, Seedance 2.0, Vidu 3.0, Veo und Sora – über einen einzigen API-Schlüssel mit transparentem Pay-per-Use-Preismodell.
Du möchtest die Videomodelle hinter diesen Tools direkt vergleichen? Der Atlas Cloud Modellvergleich stellt Bild- und Videomodelle nebeneinander mit einem Prompt dar – der Preis wird vor der Generierung angezeigt.
-
Was ist ein AI Video Generator Skill? {#was-ist-ein-skill}
Im Kontext von GitHub-Repositorys ist ein AI Video Generator Skill ein wiederverwendbares Modul, ein Wrapper oder eine Integrationsschicht, die eine Anwendung mit einem KI-Videogenerierungs-Backend verbindet – entweder einem selbst gehosteten Open-Source-Modell oder einer Cloud-API.
Stell es dir als die Abstraktion zwischen deiner Anwendungslogik und der eigentlichen Inferenz-Engine vor. Ein Skill kann sein:
- Eine Python-Klasse, die die
Wan 2.2-Modellpipeline für Text-zu-Video-Generierung kapselt - Ein ComfyUI-Custom-Node, der eine Verbindung zur Atlas Cloud API für die Kling-v3.0-Generierung herstellt
- Ein n8n-Workflow-Node, der Seedance 2.0 per REST auslöst und eine Video-URL zurückgibt
- Ein LangChain-Tool oder ein MCP-Server-Skill, der einen Videogenerierungs-Endpunkt bei Bedarf aufruft
Die Kernfrage, vor der jeder Entwickler beim Bau eines solchen Skills steht: Soll das Backend aus Open-Source-Gewichten bestehen, die lokal laufen, oder aus einer kostenpflichtigen Cloud-API?
Echte Daten aus 2026. Keine Theorie.
-
GitHub Open Source im Jahr 2026 {#open-source-landschaft}
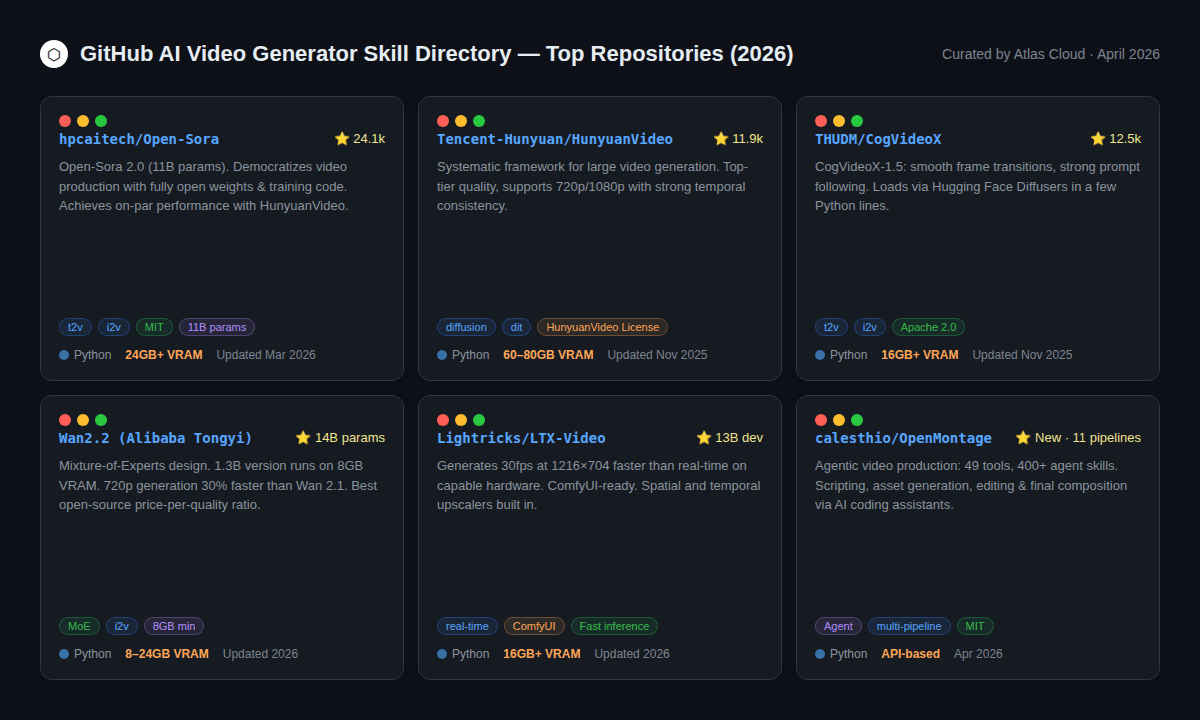
Das Open-Source-Ökosystem für Videogenerierung ist deutlich ausgereifter. Einige Repos sind inzwischen echte Alternativen zu Bezahl-APIs – zumindest für bestimmte Aufgaben.
Stufe 1: Produktionsreife Open-Source-Modelle
HunyuanVideo (Tencent, 11,9k ⭐) – Einer der besseren Open-Source-Videogeneratoren. Beherrscht 720p und 1080p. Die Haupteinschränkung ist der Hardwarebedarf: 60–80 GB VRAM für das vollständige Modell, was es nur Teams mit Enterprise-GPU-Zugang zugänglich macht. Die Community-Lizenz erlaubt kommerzielle Nutzung mit Namensnennung.
CogVideoX-1.5 (THUDM/CogVideo, 12,5k ⭐) – Unter Apache 2.0 veröffentlicht, ist dies eines der entwicklerfreundlichsten Open-Modelle. Es wird nativ über Hugging Face Diffusers in wenigen Zeilen Python geladen. Bildübergänge sind flüssig, und die Prompt-Befolgung ist stark. Mindestens 16 GB VRAM erforderlich. Eine solide Wahl, wenn dein Team bereits auf Hugging Face lebt.
Open-Sora 2.0 (hpcaitech, 24,1k ⭐) – Das am meisten gestartete Open-Source-Videogenerierungsprojekt auf GitHub. Version 2.0 (11B Parameter) erreicht eine mit HunyuanVideo vergleichbare Leistung bei VBench-Benchmarks, und die Trainingskosten wurden mit etwa 200.000 US-Dollar angegeben – eine bemerkenswerte Zahl für ein Modell dieser Klasse. Text-zu-Video, Bild-zu-Video und unendlich lange Generierung.
Stufe 2: Leichtere Open-Source-Optionen (weniger VRAM)
Wan 2.2 (Alibaba Tongyi) – Die Zugänglichkeit ist hier überzeugend: Die 1,3B-Variante läuft auf 8 GB VRAM, die 14B-Variante auf 24 GB. Die Mixture-of-Experts (MoE)-Architektur liefert bei geringeren Rechenkosten mehr Details, und Version 2.2 ist bei 720p 30 % schneller als ihr Vorgänger. Für Entwickler mit einer einzelnen Consumer-GPU ist Wan 2.2 die stärkste Open-Source-Option.
LTX-Video (Lightricks) – Entwickelt für Geschwindigkeit vor allem anderen. Generiert 30 fps bei 1216×704 Auflösung schneller als Echtzeit auf leistungsfähiger Hardware. Die ComfyUI-Integration ist ausgereift, und räumliche sowie zeitliche Upscaler sind integriert.
Stufe 3: Agentische Pipelines
OpenMontage (calesthio, neu April 2026) – Eine wirklich neuartige Kategorie: ein agentisches Videoproduktionssystem mit 11 Pipelines, 49 Tools und über 400 Agent-Skills. Funktioniert mit KI-Coding-Assistenten wie Claude Code, Cursor und Copilot. Behandelt die gesamte Pipeline – Recherche, Skripterstellung, Assets, Schnitt – von Anfang bis Ende ohne manuelle Schritte. Entwickelt für Teams, die mehrere KI-Tools in einem Workflow miteinander verbinden.
-
Bezahl-API-Verzeichnis: SOTA-Modelle jetzt verfügbar {#bezahl-api-verzeichnis}
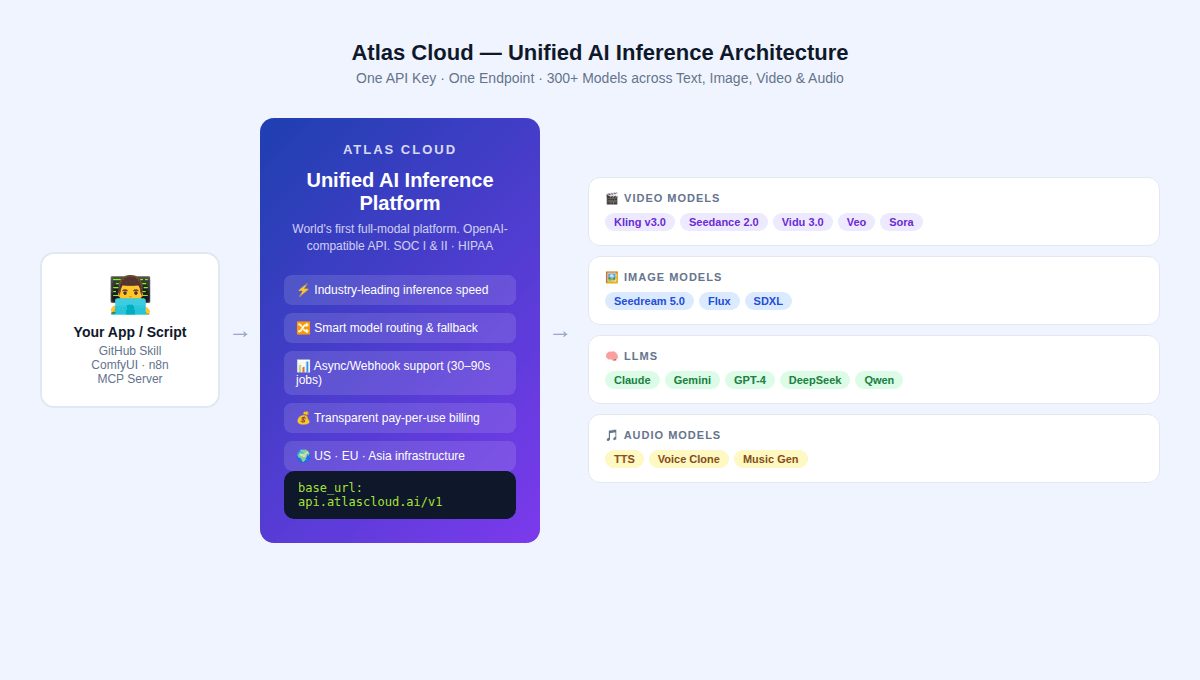
Die Landschaft der Bezahl-APIs im Jahr 2026 wird von drei großen Modellfamilien bestimmt, jede mit einem eigenen technischen Ansatz. Alle drei sind über die Atlas Cloud-einheitliche API verfügbar.
Kling v3.0 (Kuaishou)
Veröffentlicht am 5. Februar 2026. Basierend auf einer Multi-modalen visuellen Spracharchitektur – Text, Bilder, Audio und Video werden in einem System verarbeitet.
Was es tatsächlich besser kann als die Konkurrenz:
- Komplexe menschliche Bewegungen – Laufen, Tanzen, Kampfsport – ohne die Verformung „Spaghetti-Arme“, die andere Modelle plagt
- Mehrsprachige native Audioerzeugung (5 Sprachen, einschließlich synchronisierter Lippenbewegungen)
- Motion Brush: ein Tool, mit dem Entwickler (oder Endnutzer) Bewegungspfade direkt auf Quellbilder malen können – eine Funktion, die derzeit bei konkurrierenden Modellen kein Äquivalent hat
- Element Binding für konsistente Charakter- und Objektverfolgung über Einstellungen hinweg
Wo es schwächelt: Die Rendergeschwindigkeit ist auf der Pro-Stufe langsamer als bei einigen Mitbewerbern. Die Übergänge des Storyboard-Tools können laut unabhängigen Testern „holprig“ sein.
Am besten geeignet für: Social-Shorts auf TikTok und Reels, E-Commerce-Produktvideos, alles, was viel Volumen mit konsistenten Charakteren erfordert.
Seedance 2.0 (ByteDance)
Am 8. Februar 2026 veröffentlicht, stellt Seedance 2.0 einen Paradigmenwechsel in der Art und Weise dar, wie KI-Video gepromptet wird – von rein textbasierten Prompts hin zu echter Regie-ähnlicher referenzbasierter Steuerung.
Die zentrale technische Innovation: Seedance 2.0 akzeptiert gleichzeitig quad-modale Eingaben – Text, Bild, Video und Audio. Sein „Universal Reference“-System ermöglicht es einem Entwickler, ein Referenzvideo einer tanzenden Person zu übergeben, und das Modell reproduziert die Kamerabewegung, die Charakteraktionen und die Komposition in einer generierten Ausgabe. Dies löst die Charakterkonsistenz auf eine Weise, die reine Text-zu-Video-Modelle nicht können.
Unabhängige Tests bestätigen, dass es hervorragend ist für:
- Mehrere Einstellungen umfassendes Storytelling mit konsistenter Charakteridentität über Schnitte hinweg
- Synchronisierte Audio-Video-Generierung (Dual-Branch-Architektur erzeugt Ton und Video gleichzeitig)
- Präzise Nachbildung von Komposition und Beleuchtung aus Referenzmaterialien
Hinweis zur Verfügbarkeit: Stand April 2026 ist der internationale API-Zugang zu Seedance 2.0 über Plattformen wie Atlas Cloud möglich. Der direkte BytePlus-API-Zugang für internationale Entwickler war in der Vergangenheit nicht immer verfügbar – überprüfe den aktuellen Status, bevor du eine Abhängigkeit von direkten ByteDance-Endpunkten aufbaust.
Am besten geeignet für: Musikvideos, präzise Charakteranimation, Produktanzeigen, bei denen die Bewegung exakt sein muss, Agenturen, die Storyboard-zu-Video-Workflows durchführen.
Vidu 3.0 (Shengshu AI / Tsinghua)
Basierend auf der ursprünglichen U-ViT-Architektur, die Diffusions- und Transformer-Technologien kombiniert, konzentriert sich Vidu auf die Bereiche, in denen die meisten KI-Videos noch kämpfen: Umgebungskohärenz und filmische Konsistenz.
Besondere Merkmale:
- Universelles Referenzsystem für konsistente Beleuchtung über mehrere Einstellungen hinweg
- Intelligente Hintergrundmusikgenerierung, die sich automatisch an die Stimmung der Szene anpasst
- Langform-Generierung mit starker zeitlicher Konsistenz (entscheidend für Sequenzen länger als 5 Sekunden)
Beste Anwendungsfälle: Professionelle Filmproduktions-Workflows, Animationsdesign, kreative Werbung, die filmische Qualität erfordert.
Sora 2 (OpenAI)
Sora 2 bleibt der Maßstab für Genauigkeit der Physiksimulation. Zerbrich ein Glas in einem Sora-2-Prompt, und das Bruchmuster, die Flüssigkeitsphysik und die Reflexionen verhalten sich wie im echten Leben – die meisten Mitbewerber können diese Konsistenz noch nicht erreichen.
Am besten geeignet für: VFX-Arbeiten, Architekturvisualisierung, Dokumentations-B-Roll, überall dort, wo physikalische Genauigkeit wichtiger ist als Geld zu sparen.
Preisgestaltung: Sora 2 hat die höchste Rechnung in dieser Kategorie. Du bezahlst für die Rechenleistung.
-
Inferenzkosten: Die echten Zahlen {#inferenzkosten}
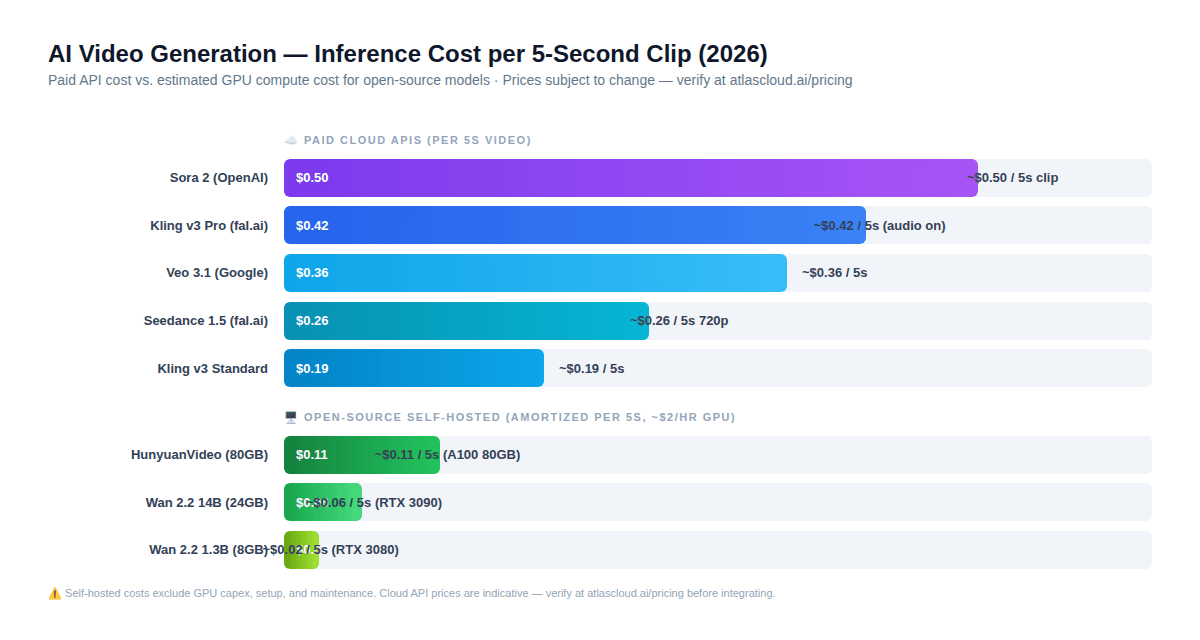
Dieser Abschnitt enthält die wichtigste kontraintuitive Erkenntnis des gesamten Leitfadens – eine, die die übliche Intuition der meisten Entwickler zu Open-Source vs. Bezahl-APIs verändert.
Die versteckten Kosten selbst gehosteter Modelle
Die meisten Entwickler nehmen an: „Open-Source = kostenlos = immer günstiger.“
Diese Annahme ist für die meisten Teamgrößen falsch.
Hier ist die tatsächliche Rechnung für einen 5-Sekunden-Videoclip im Jahr 2026:
Selbst gehostetes Open-Source (amortisierte GPU-Kosten bei ca. 2 $/Std.):
- Wan 2.2 1.3B (RTX 3080): ~0,02 $ pro 5-Sekunden-Clip
- Wan 2.2 14B (RTX 3090): ~0,06 $ pro 5-Sekunden-Clip
- HunyuanVideo (A100 80GB): ~0,11 $ pro 5-Sekunden-Clip
Bezahl-Cloud-API (indikative Preise – überprüfe unter atlascloud.ai/pricing):
- Kling v3 Standard: ~0,19 $ pro 5-Sekunden-Clip
- Seedance 1.5 720p mit Audio: ~0,26 $ pro 5-Sekunden-Clip
- Kling v3 Pro mit Audio: ~0,42 $ pro 5-Sekunden-Clip
- Sora 2: ~0,50 $ pro 5-Sekunden-Clip
Die selbst gehosteten Zahlen sehen isoliert betrachtet überzeugend aus. Das Problem ist, dass sie Folgendes ausschließen:
- 1. GPU-Hardware – Eine A100 80GB kostet 10.000–15.000 $. Bei 1.000 Videos pro Monat (~0,11 $ pro Video) bräuchtest du über 9.000 Monate, um nur die Hardware wieder hereinzuholen.
- Einrichtungszeit – CUDA-Konfiguration, Herunterladen von Modellgewichten, VRAM-Verwaltung und Fehlersuche bedeuten 20–40 Entwicklungsstunden für die Ersteinrichtung.
- Laufende Wartung – Modellupdates, Abhängigkeitskonflikte und Infrastrukturzuverlässigkeit sind fortlaufende Zeitkosten.
- Opportunitätskosten – Zeit, die für Inferenzinfrastruktur aufgewendet wird, ist Zeit, die nicht für das Produkt aufgewendet wird.
Die praktische Randbedingung:
Selbsthosting lohnt sich nur, wenn: (a) du bereits GPUs für andere Workloads laufen hast, (b) du über 5.000 Videos pro Monat erzeugst, oder (c) Vorschriften dich zwingen, alles on-prem zu halten.
Unterhalb dieser Schwelle sind Bezahl-APIs – insbesondere einheitliche Plattformen wie Atlas Cloud – günstiger, wenn die Gesamtbetriebskosten ehrlich berechnet werden.
-
Ratenbegrenzung und API-Latenz – Worauf Entwickler tatsächlich stoßen {#ratenbegrenzung}
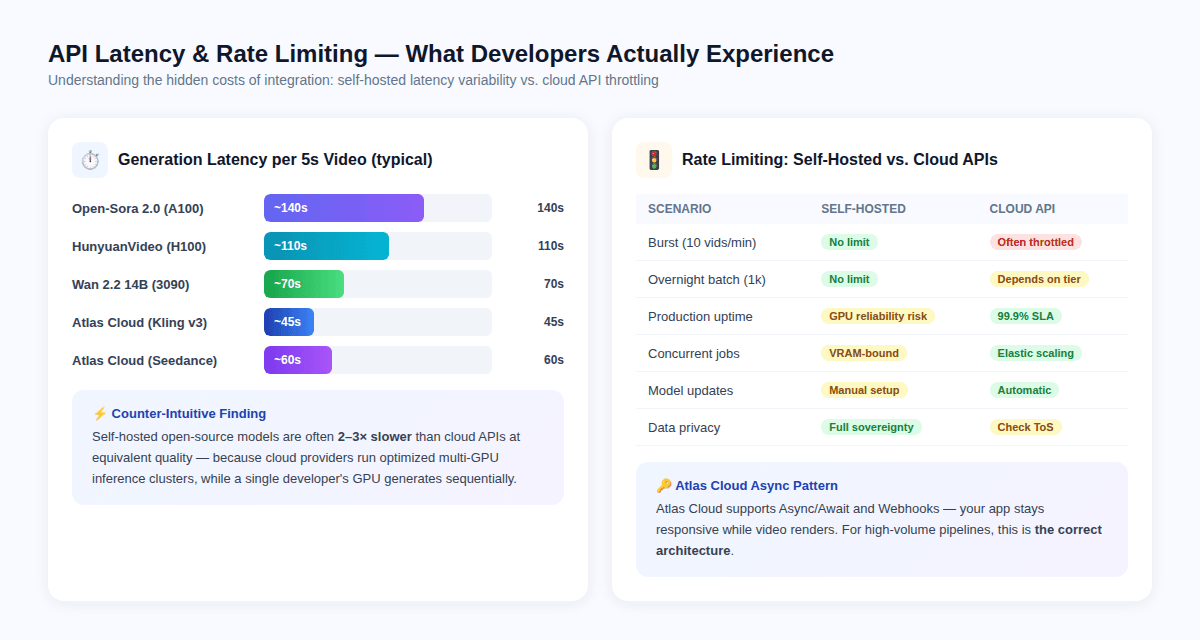
Das Latenzparadoxon
Kontraintuitiverweise sind Cloud-APIs oft pro Video schneller als selbst gehostete Modelle – nicht weil die Modelle unterschiedlich sind, sondern weil Cloud-Anbieter optimierte Multi-GPU-Inferenzcluster mit Hardware-Batching betreiben, während eine einzelne Entwickler-GPU Frames sequenziell generiert.
Typische Latenz pro 5-Sekunden-Clip:
- Open-Sora 2.0 auf A100: ~140 Sekunden
- HunyuanVideo auf H100: ~110 Sekunden
- Wan 2.2 14B auf RTX 3090: ~70 Sekunden
- Atlas Cloud / Kling v3: ~45 Sekunden
- Atlas Cloud / Seedance 2.0: ~60 Sekunden
Das bedeutet, dass das Erstellen eines GitHub-Skills um ein selbst gehostetes Modell zu längeren Wartezeiten für den Benutzer führen kann, selbst wenn die Kosten pro Video niedriger sind.
Ratenbegrenzung: Die Produktionsrealität
Selbst gehostete Modelle haben keine API-bedingten Ratenbegrenzungen – sie werden nur durch den VRAM und die thermischen Grenzen deiner GPU eingeschränkt.
Bezahl-APIs setzen Ratenbegrenzungen durch, die je nach Preismodell variieren. Die relevanten technischen Implikationen:
- Burst-Anfragen (10+ Videos pro Minute) führen bei den meisten Bezahl-API-Stufen zur Drosselung
- Nächtliche Batch-Jobs (1.000+ Videos) erfordern ein sorgfältiges asynchrones Design, um Zeitüberschreitungen zu vermeiden
- Gleichzeitige Anfragen bei selbst gehosteten Modellen sind durch den VRAM begrenzt – das gleichzeitige Ausführen von 2 Inferenzen des 14B-Modells auf einer einzelnen 24GB-Karte ist normalerweise nicht möglich
Atlas Cloud löst das Problem der Ratenbegrenzung durch eine Async/Webhook-Architektur: Deine Anwendung sendet einen Generierungsauftrag, erhält eine Aufgaben-ID und wird per Webhook benachrichtigt, wenn das Rendern abgeschlossen ist. Dieses Muster verhindert, dass die Anwendung während des Videorenderns hängt, und skaliert korrekt für Batch-Workloads.
Die korrekte Architektur für die Produktion
plaintext1# Atlas Cloud Async Pattern – Produktionsbereit 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Generierungsaufgabe senden 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Product showcase reel, smooth motion, 9:16 aspect ratio", 14 size="1080x1920", 15 n=1 16) 17 18# Asynchrone Antwort verarbeiten 19video_url = response.data[0].url 20print(f"Video generiert: {video_url}")
Für Bild-zu-Video-Workflows ist zu beachten, dass einige Modelle – einschließlich bestimmter Kling-i2v-Varianten – für die Bild-zu-Video-Generierung keinen separaten Seitenverhältnis-Parameter akzeptieren; die Ausgabeauflösung folgt den Abmessungen des Eingabebildes. Erstelle deine vorgelagerte Bildgenerierung mit dem korrekten Zielseitenverhältnis.
-
Lokales Hosting vs. Cloud-API: Die Abwägungsmatrix {#lokal-vs-cloud}
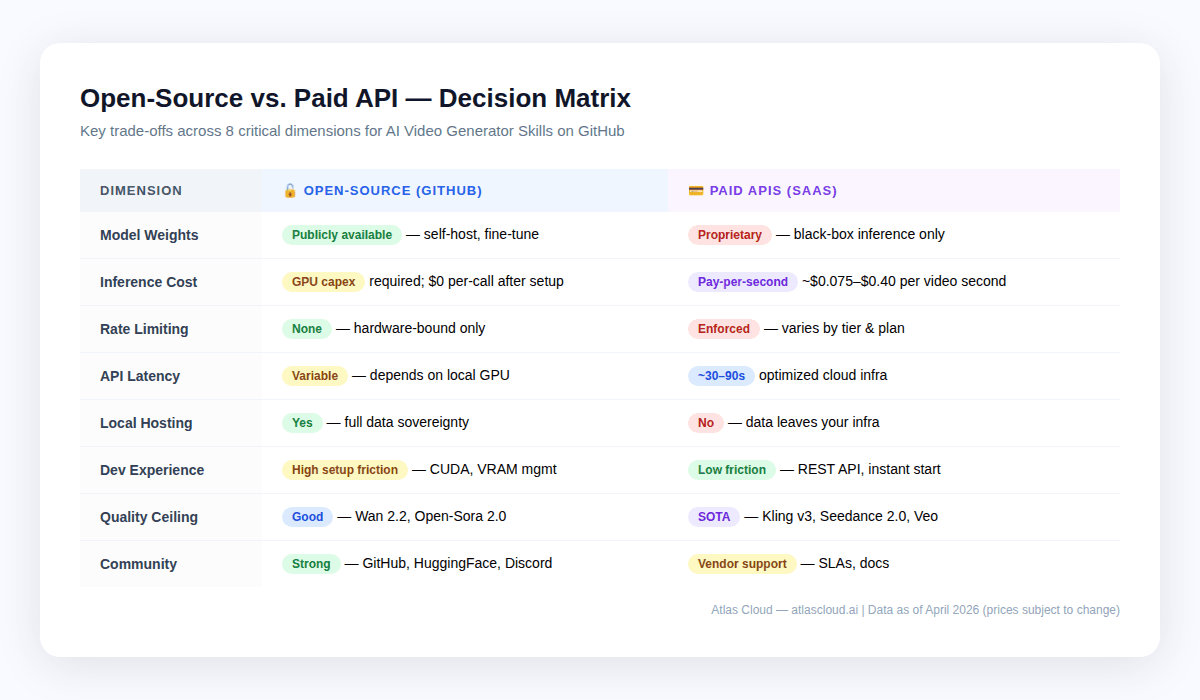
Es ist kein Entweder-oder. Die meisten Produktionspipelines mischen beides: Open-Source für das Prototyping und grobe Durchläufe in großen Mengen, Cloud-APIs für finale Renderings und Spitzenqualität.
Wann lokal sinnvoll ist
- Compliance-Auflagen – HIPAA, GDPR oder alles Proprietäre, das deine Server nicht verlassen darf. Selbsthosting ist deine einzige Möglichkeit. Atlas Cloud ist HIPAA-konform und SOC I & II zertifiziert, was die meisten Anforderungen von Unternehmen abdeckt, aber regulierte Betriebe sollten ihre spezifischen Anforderungen noch einmal überprüfen.
- Sehr hohes Volumen bei akzeptabler Qualität – Teams, die 10.000+ Videos pro Monat auf Wan-2.2-Qualitätsniveau generieren, könnten feststellen, dass GPU-Mietkosten bei diesem Maßstab niedriger sind als API-Gebühren.
- Forschung und Feintuning – Offene Modellgewichte ermöglichen das Feintuning auf proprietären Datensätzen. Keine Cloud-API bietet derzeit benutzerdefiniertes Modelltraining.
- Luftdichte Systeme – Edge-Bereitstellungen ohne Konnektivität oder abgeschottete Netzwerke.
Wann Cloud-APIs gewinnen
- Time-to-Market – Eine Atlas-Cloud-Integration dauert Stunden, nicht Wochen
- Spitzenqualität – Open-Source-Führer wie Wan 2.2 und Open-Sora 2.0 hinken immer noch hinter proprietären Modellen wie Kling v3 und Seedance 2.0 hinterher, insbesondere bei menschlichen Bewegungen, konsistenten Einstellungen und nativem Audio
- Spitzenlasten – Cloud-APIs skalieren nach oben und unten; deine eigenen GPUs tun das nicht
- Niedrigeres Volumen – Unter ~5.000 Videos pro Monat gewinnen Cloud-APIs normalerweise bei den Gesamtkosten
- Multi-Modell-Flexibilität – Der Katalog von Atlas Cloud mit über 300 Modellen ermöglicht es dir, innerhalb einer einzigen Integration von Kling zu Seedance zu Veo zu wechseln
-
Community-getriebene vs. anbietergetriebene Entwicklung {#community-vs-anbieter}
Es ist leicht, dies beim Vergleich von APIs zu übersehen, aber es ist tatsächlich wichtig, wenn du GitHub-Skills entwickelst.
Community-getrieben (Open-Source):
- Jeder kann Fehlerbehebungen einreichen und Funktionen anfordern – und sie werden zusammengeführt
- Die Dokumentation ist oft hervorragend, weil die Benutzergemeinschaft Beispiele beisteuert
- Bahnbrechende Änderungen in Modell-APIs erfolgen langsam mit öffentlichen Ankündigungsfristen
- Die Communities von ComfyUI und Hugging Face Diffusers verfügen über umfangreiche Bibliotheken vorgefertigter Workflows, LoRA-Adapter und feinabgestimmter Checkpoints
- Forschungsarbeiten erscheinen mit offenem, reproduzierbarem Code
Anbietergetriebene Entwicklung (Bezahl-APIs):
- Die API-Stabilität wird durch kommerzielle SLAs geregelt – bahnbrechende Änderungen sind seltener, kommen aber vor
- Neue Modellveröffentlichungen (z. B. Kling 3.0 im Februar 2026, drei Tage vor Seedance 2.0) erfolgen in wettbewerbsbestimmter Geschwindigkeit und oft ohne Vorankündigung
- Modellverbesserungen werden serverseitig bereitgestellt, ohne dass der Entwickler etwas tun muss
- Die technische Dokumentation wird professionell gepflegt
Die praktische Auswirkung für GitHub-Skill-Autoren: Wenn du einen Skill schreibst, der stabil und wartungsarm bleiben soll, ist eine Cloud-API mit stabilen Endpunktverträgen einfacher zu warten als ein Skill, der an eine bestimmte Open-Source-Modellversion gebunden ist. Umgekehrt: Wenn dein Skill Entwicklern Zugang zu den neuesten Forschungsmodellen ohne API-Kosten geben soll, ist das Open-Source-Ökosystem der Ort, an dem diese Arbeit stattfindet.
-
Fallstudie: Social-Media-Agentur (500 Videos/Monat) {#fallstudie-1}
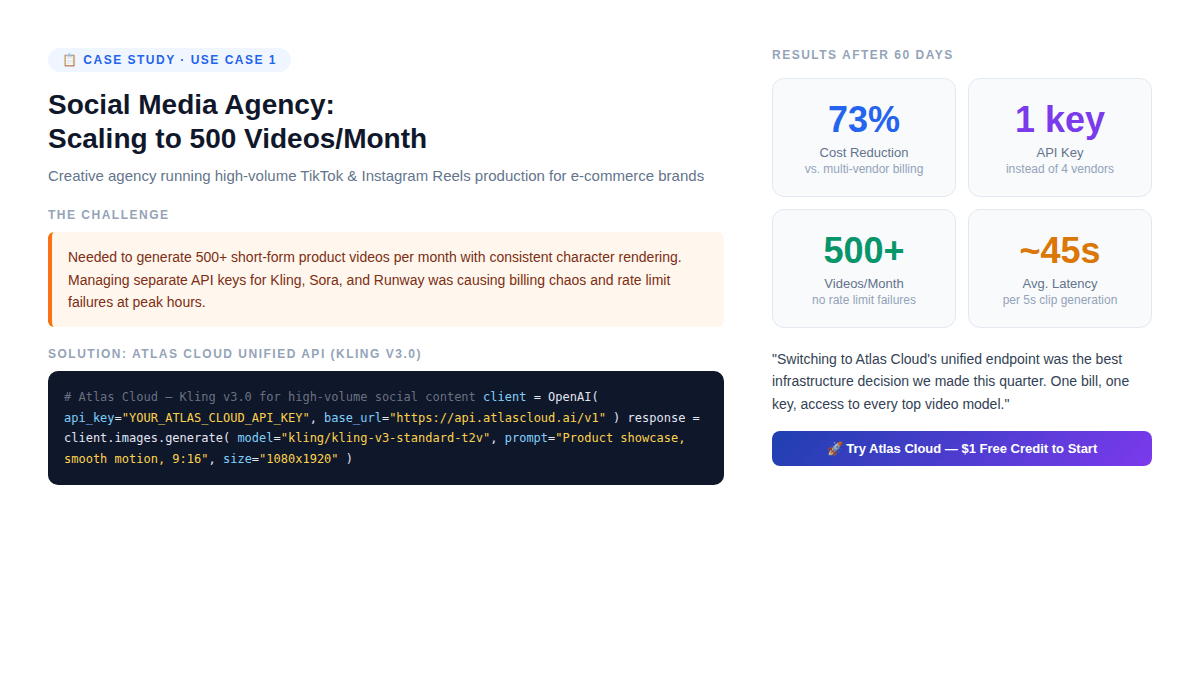
Das Setup: Eine Kreativagentur, die kurze Produktvideos für 20 E-Commerce-Kunden erstellt. Sie benötigen 500 Videos pro Monat, Charaktere, die in allen Clips gleich aussehen, 9:16 Hochformat, 5–10 Sekunden lang, gebündelt außerhalb der Geschäftszeiten.
Ursprüngliche Architektur (vor Atlas Cloud):
- Separate API-Schlüssel für Kling, RunwayML und Pika
- Drei Abrechnungs-Dashboards, drei Ratenbegrenzungs-Pools
- Manuelle Modellauswahl pro Kunde
- Fehler bei der Ratenbegrenzung zu Stoßzeiten führten zu Lieferverzögerungen
Problem, das dies verursachte: Als Kling v3.0 veröffentlichte, musste die Agentur ein neues SDK neu integrieren, die Abrechnung aktualisieren und die Kompatibilität testen – dreimal für drei Anbieter.
Lösung: Atlas Cloud einheitliche API mit Kling v3.0 Standard
plaintext1# Atlas Cloud – Social-Media-Video-Pipeline 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, smooth motion, cinematic lighting, 9:16 vertical format", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Ergebnisse nach 60 Tagen:
- 73 % Reduzierung der Kosten pro Video (eine Rechnung, keine anbieterspezifischen Aufschläge)
- Keine Fehler durch Ratenbegrenzung (die elastische Infrastruktur von Atlas Cloud absorbierte Spitzenlasten)
- Modellwechsel von Kling zu Seedance für bestimmte Kunden dauerte weniger als 2 Minuten (einen Parameter ändern)
- Der 20 %-Bonus auf die erste Einzahlung kompensierte effektiv die Produktionskosten des ersten Monats
Die nicht offensichtliche Erkenntnis: Die Agentur reduzierte die Anzahl der Anbieter nicht, weil Kling besser wurde. Sie reduzierte sie, weil die Verwaltung mehrerer Anbieterbeziehungen bei 500 Videos/Monat nicht-triviale Betriebskosten verursacht, die in den Preisen der einzelnen APIs nicht sichtbar sind.
-
Fallstudie: Indie-Entwickler baut ein Video-SaaS {#fallstudie-2}
Das Setup: Ein Solo-Entwickler baut ein „Text-zu-Produktdemo“-Tool für Startups in der Frühphase. Benötigt mehrere Stile – filmisch, animiert, Realfilm. Muss schnell validieren und die Infrastruktur unter 200 $/Monat halten, während er herausfindet, ob das überhaupt jemand will.
Architekturentscheidung:
Der Entwickler dachte zunächst darüber nach, Wan 2.2 auf einer gemieteten A100-Instanz (~2 $/Std.) selbst zu hosten. Bei 100 Testvideos während der Validierung wurden die Kosten auf ~6 $ GPU-Zeit geschätzt. Schien günstiger als Atlas Cloud.
Was in der Kalkulation fehlte:
- Das Einrichten der Wan-2.2-Pipeline dauerte 3 Tage (CUDA-Abhängigkeiten, VRAM-Verwaltung, Serverkonfiguration)
- Die Qualitätslücke der Wan-2.2-Ausgabe im Vergleich zu Kling v3 bedeutete, dass das SaaS den beabsichtigten Preis nicht verlangen konnte
- Die Server-Betriebszeitverwaltung fügte ~2 Stunden/Woche laufende Wartung hinzu
Überarbeitete Architektur mit Atlas Cloud:
plaintext1# Flexible Modell-Routing – je nach Benutzerebene umschalten 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Niedrigere Kosten 4 "pro": "kling/kling-v3-professional-t2v", # Höhere Qualität 5 "enterprise": "bytedance/seedance-2.0" # Maximale Kontrolle 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Ergebnis: Der Entwickler startete in 4 Tagen statt 3 Wochen. Die Premium-Stufe mit Seedance 2.0 rechtfertigte einen 3-fachen Preisaufschlag gegenüber der kostenlosen Stufe, und die abgestufte Modellstruktur wurde mit einem einzigen Atlas Cloud-Schlüssel aufgebaut – nicht mit drei separaten Anbieterintegrationen.
-
Der Atlas Cloud-Vorteil: Warum „Eine API“ die richtige Architektur ist {#atlas-cloud-vorteil}
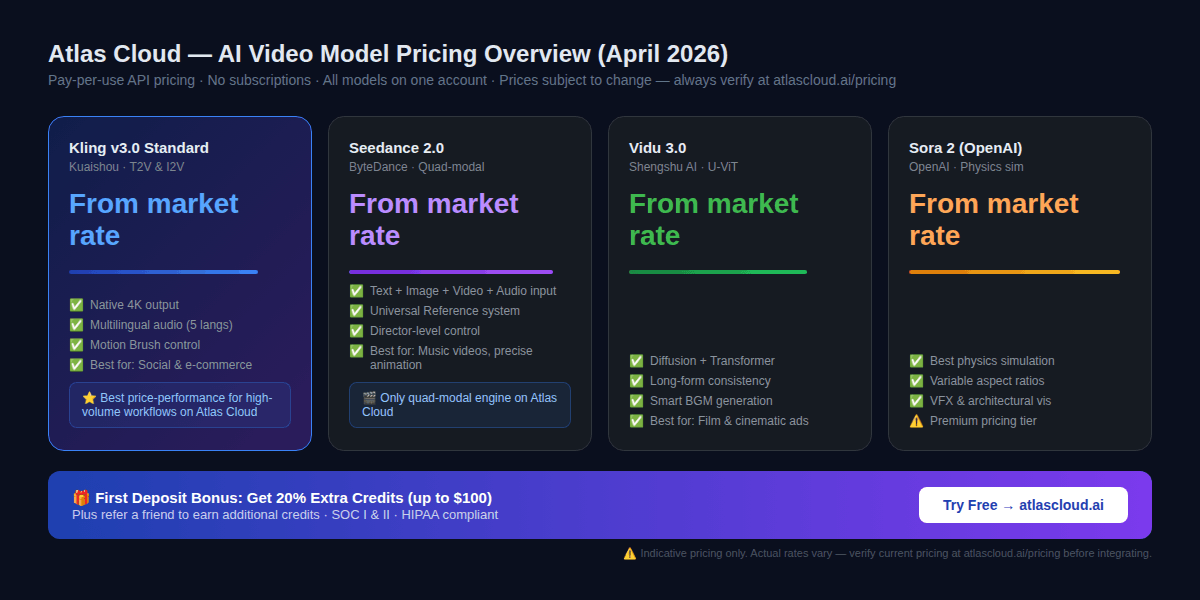
Atlas Cloud positioniert sich als die weltweit erste vollmodale KI-Inferenzplattform – eine einheitliche API, die über 300 Modelle für Text-, Bild-, Video- und Audiogenerierung bedient.
Für Autoren von GitHub AI Video Generator Skills sind die spezifischen Vorteile:
-
OpenAI-kompatible API (Drop-In-Ersatz)
Atlas Cloud verwendet einen OpenAI-kompatiblen Endpunkt. Wenn dein Skill bereits mit dem OpenAI SDK integriert ist, erfordert der Wechsel zu Atlas Cloud für die Videogenerierung das Ändern von zwei Zeilen: api_key und base_url. Kein neues SDK, kein neues Authentifizierungssystem.
-
Einheitliche Abrechnung für Multi-Modell-Workflows
Produktionsvideoworkflows verwenden selten nur ein Modell. Eine typische Pipeline könnte verwenden:
- Seedream 5.0 für die Bildgenerierung (Startbilder)
- Kling v3.0 für die Bild-zu-Video-Konvertierung
- Ein LLM (Claude, GPT-4 oder DeepSeek) für die Prompt-Optimierung
- Ein TTS-Modell für die Sprachausgabe
Bei separaten Anbieterkonten sind das vier Abrechnungsbeziehungen, vier Ratenbegrenzungs-Pools und vier Integrationspunkte. Mit Atlas Cloud ist es ein API-Schlüssel und eine Rechnung.
-
Modellbezogene Preistransparenz
Atlas Cloud veröffentlicht Preise pro Modell ohne versteckte Rechengebühren. Das Geschäftsmodell ist einfach: Bezahle für das, was du generierst. Neue Entwickler erhalten einen 20 %-Bonus auf ihre erste Einzahlung (bis zu 100 $), und ein Empfehlungsprogramm bietet zusätzliche Credits. Überprüfe immer die aktuellen Preise unter atlascloud.ai/pricing, bevor du finanzielle Prognosen erstellst.
-
Compliance-Abdeckung
Für Enterprise-GitHub-Skills, die in regulierten Umgebungen eingesetzt werden: Atlas Cloud besitzt SOC I & II-Zertifizierung und ist HIPAA-konform, mit Infrastruktur in den Regionen USA, EU und Asien. Dies deckt die Mehrheit der Anforderungen an den Datenaufbewahrungsort von Unternehmen ab.
-
ComfyUI-, n8n- und MCP-Server-Integration
Atlas Cloud integriert nativ die Tools, die am häufigsten zum Erstellen von GitHub-Videogenerierungs-Skills verwendet werden:
- ComfyUI – Custom Nodes für die Erstellung visueller Workflows
- n8n – Workflow-Automatisierung mit Atlas Cloud-Videogenerierungsschritten
- MCP Server – Model Context Protocol-Integration für KI-Agentenframeworks
-
Welchen Stack solltest du tatsächlich verwenden? {#entscheidungshilfe}
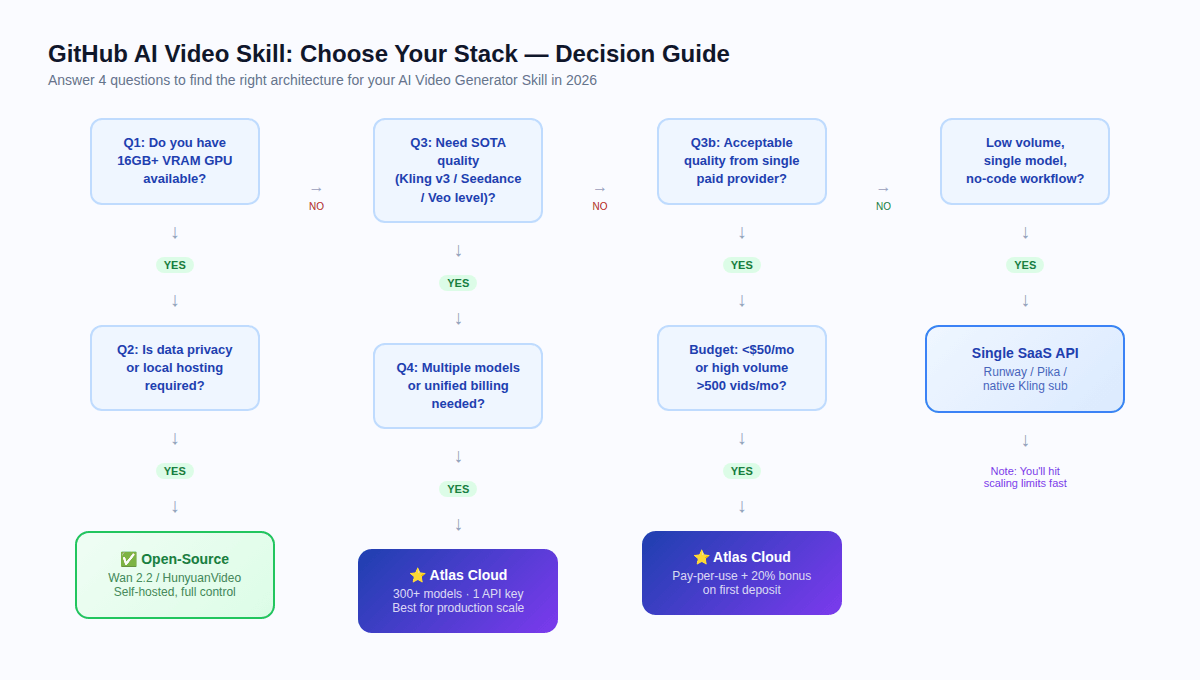
Gehe diese vier Fragen durch:
F1: Hast du einen GPU mit 16 GB+ VRAM verfügbar?
Wenn nein → Selbsthosting ganz überspringen. Cloud-API ist dein einziger praktikabler Weg.
F2: Ist Datenschutz oder lokales Hosting aufgrund von Vorschriften erforderlich?
Wenn ja + GPU verfügbar → Open-Source evaluieren (Wan 2.2 oder HunyuanVideo je nach VRAM).
Wenn ja + keine GPU → Atlas Cloud nutzen (HIPAA-konform, SOC-zertifiziert) und deine spezifischen regulatorischen Anforderungen überprüfen.
F3: Benötigst du SOTA-Qualität (Kling v3, Seedance 2.0, Veo-Niveau)?
Wenn ja → Cloud-API erforderlich. Open-Source-Modelle haben im Jahr 2026 eine erhebliche Qualitätslücke im Vergleich zu den besten proprietären Modellen.
Wenn akzeptable Qualität auf Open-Source-Niveau → Wan 2.2 selbst gehostet könnte funktionieren.
F4: Brauchst du mehrere Modelle oder eine einheitliche Abrechnung?
Wenn ja → Atlas Cloud. Die Verwaltung von drei Anbieterkonten in großem Maßstab hat versteckte Betriebskosten, die erst bei Produktionsvolumen sichtbar werden.
Zusammenfassung der Empfehlungen nach Anwendungsfall
| Anwendungsfall | Empfohlener Stack |
| Forschung / Prototyping | Open-Source (Wan 2.2, CogVideoX) |
| Social-Media-Agentur, 500+/Monat | Atlas Cloud + Kling v3.0 |
| Musikvideo / Charakteranimation | Atlas Cloud + Seedance 2.0 |
| VFX / Physiksimulation | Atlas Cloud + Sora 2 |
| Datensouverän / offline | Selbst gehostet (HunyuanVideo, Open-Sora 2.0) |
| SaaS mit abgestufter Modellqualität | Atlas Cloud (ein Schlüssel, mehrere Modelle) |
| Hochvolumiges Open-Source-Batch | Wan 2.2 selbst gehostet (ab 10.000+/Monat) |
-
FAQ {#faq}
F: Was ist ein AI Video Generator Skill?
Ein wiederverwendbares Code-Modul oder eine Integrationsschicht, die eine Anwendung mit einem KI-Videogenerierungs-Backend verbindet – entweder Open-Source-Gewichte oder eine Cloud-API. Übliche Formen: Python-Klasse, ComfyUI-Node, n8n-Workflow, MCP-Server-Tool.
F: Was ist der minimale VRAM für das Selbsthosten eines Open-Source-Videomodells?
8 GB VRAM für Wan 2.2 1.3B (akzeptable Qualität für kurze Clips). 16 GB für CogVideoX-1.5 oder Open-Sora (bessere Qualität). 24 GB+ für Wan 2.2 14B. 60–80 GB für HunyuanVideo oder Open-Sora 2.0 Vollmodell.
F: Ist Open-Source-KI-Videogenerierung wirklich kostenlos?
Die Modellgewichte sind kostenlos. Die Inferenz ist nicht kostenlos – sie erfordert GPU-Rechenleistung. Bei geringem Volumen (<5.000 Videos/Monat) sind Cloud-APIs wie Atlas Cloud bei korrekter Berechnung der Gesamtbetriebskosten in der Regel günstiger.
F: Kann ich Atlas Cloud für Bild-zu-Video-Workflows (i2v) verwenden?
Ja. Atlas Cloud unterstützt i2v-Varianten für Kling, Seedance und Vidu. Hinweis: Bei i2v-Modellen akzeptieren einige Varianten keinen separaten Seitenverhältnis-Parameter – die Ausgabeauflösung folgt den Abmessungen des Eingabebildes.
F: Wie geht Atlas Cloud mit Ratenbegrenzung um?
Atlas Cloud unterstützt Async/Webhook-Muster. Videogenerierungsaufträge werden als Aufgaben gesendet; deine Anwendung erhält eine Aufgaben-ID und wird benachrichtigt, wenn das Rendern abgeschlossen ist. Dies verhindert Blockierungen im großen Maßstab.
F: Welches ist das beste Modell für Charakterkonsistenz über Einstellungen hinweg?
Seedance 2.0s Universal Reference-System ist im Jahr 2026 die fortschrittlichste Lösung. Es ermöglicht dir, Referenzvideos, Bilder und Audio zu übergeben, um ein konsistentes Charakteraussehen und eine konsistente Bewegung in generierten Clips zu erhalten.
F: Unterstützt Atlas Cloud ComfyUI?
Ja. Atlas Cloud hat eine native ComfyUI-Integration, sowie n8n-Nodes und MCP-Server-Kompatibilität.
F: Wie handhaben Open-Source-Videomodelle Seitenverhältnisse?
Variiert je nach Modell. Open-Sora unterstützt 16:9, 9:16, 1:1 und 2.39:1 über das Flag --aspect_ratio. Wan 2.2 und LTX-Video unterstützen mehrere Verhältnisse. Bei i2v-Workflows folgen die meisten Modelle dem Seitenverhältnis des Eingabebildes, unabhängig von angegebenen Parametern.
Zusammenfassung
Die Landschaft von 2026 teilt sich in zwei Lager, jedes mit seinem Sweet Spot:
Open-Source macht Sinn, wenn du freie GPUs hast, über 10.000 Videos pro Monat erzeugst, Daten deine Server nicht verlassen dürfen oder du auf deinem eigenen proprietären Material feintunen musst.
Bezahl-APIs sind die bessere Wahl, wenn du die bestmögliche Qualität benötigst, Geschwindigkeit wichtiger ist als Kosten, du unter 5.000 Videos pro Monat liegst oder du mehrere Modelle mischen möchtest, ohne Anbieterverträge jonglieren zu müssen.
Atlas Cloud verbindet beide Welten: als einheitliche Plattform, die Zugriff auf über 300 Modelle bietet – einschließlich der besten Open-Source-Modelle über gehostete Inferenz und jedes große proprietäre Modell – über einen einzigen OpenAI-kompatiblen API-Schlüssel. Für die meisten Entwickler, die 2026 produktionsreife GitHub AI Video Generator Skills erstellen, ist es der Weg mit der geringsten Reibung vom Prototypen zur Produktion.
Preisinformationen in diesem Artikel sind indikativ und können sich ändern. Überprüfe immer die aktuellen Tarife unter atlascloud.ai/pricing bevor du finanzielle Prognosen erstellst. Die Modellverfügbarkeit kann je nach Region variieren.
Atlas Cloud: atlascloud.ai – SOC I & II zertifiziert · HIPAA-konform · Infrastruktur in USA, EU, Asien


