Ein Enterprise-Kunde fragt, ob ein Jahresplan nach der Verlängerung erstattet werden kann. Ihr Assistent durchsucht einen riesigen Dokumentensatz und gibt ein klares Ja. Er zitiert sogar eine Richtlinie. Der Haken: Er hat v4.1 gewählt, eine archivierte Richtlinie, während eine unterzeichnete Zusatzvereinbarung und v4.2 etwas anderes sagen.
Deshalb beginnen Best Practices für Wissensdatenbanken mit GPT-6 Astra mit Belegen. Geben Sie dem Modell eine Autoritätsreihenfolge, rufen Sie nur autorisierte aktuelle Belege ab und lassen Sie jede wesentliche Behauptung auf ein Dokument, eine Version und einen Abschnitt zurückverweisen. Wenn die Belege sich widersprechen oder ausgehen, muss die Antwort stoppen.
GPT-6 Astra kann mit File Search und einem Kontextfenster von 1.050.000 Token arbeiten, mit einer maximalen Ausgabe von 128.000 Token. Kapazität hilft bei der Untersuchung. Sie entscheidet jedoch nicht, welche Richtlinie aktuell ist, welcher Benutzer sie sehen darf oder ob ein Zitat eine benachbarte Behauptung tatsächlich stützt. ( OpenAI-Modellseite für GPT-6 Astra, September 2026 )
Animierter autoritätsorientierter Wissensdatenbank-Workflow
Ein 8-sekündiges generiertes Workflow-Visual: Ein unterzeichneter Override und die aktuelle Richtlinie bleiben in der Belegablage, während eine archivierte Datei sichtbar beiseitegeschoben wird. Dies veranschaulicht Quellen-Governance, nicht eine Live-Produktoberfläche oder ein Quelldokument.
Wichtige Erkenntnisse
- Genehmigen Sie die Quellenautorität vor dem Upload.
- Messen Sie Retrieval und Antworttreue getrennt.
- Filtern Sie vor dem Retrieval nach Zugriff, Status, Datum und Region.
- Behandeln Sie langen Kontext als Untersuchungswerkzeug, nicht als Standard-Prompt.
- Eskalieren Sie Konflikte und fehlende Belege an Menschen.
Warum GPT-6-Astra-Wissensdatenbanken mit 1M Token scheitern
Die meisten Fehler beginnen vor der Antwort. Ein Drive-Export behandelt eine unterzeichnete Zusatzvereinbarung, eine aktuelle Richtlinie, eine alte FAQ und einen Entwurf als gleichermaßen durchsuchbare Prosa. Ein leistungsfähiges Modell kann aus diesem unübersichtlichen Satz sehr schnell einen überzeugenden Absatz machen.
Vier Prüfungen erfassen die häufigen Fehlermuster:
- Autoritätsdrift: Eine neuere Richtlinie oder Kunden-Zusatzvereinbarung verliert gegen eine populäre alte FAQ.
- Zitationstheater: Die Antwort enthält einen Quellenlink, aber die zitierte Passage stützt die Behauptung nicht.
- Unkontrollierte Experimente: Chunk-Größe, Top-k und Kontextbudget ändern sich alle gleichzeitig, sodass niemand weiß, was besser geworden ist.
- Zugriffsdrift: Regionale Ausnahmen, eingeschränkte Entwürfe oder private Notizen werden für das falsche Publikum abrufbar.
Praktiker für Legal-RAG, die Evaluation diskutieren, trennen tendenziell „Hat das Retrieval die erforderliche Quelle gefunden?“ von „Hat die Antwort diese Quelle treu angewendet?“ Diese Trennung gehört in jedes Release-Gate, auch bei einem internen Support-Bot. ( r/Rag-Diskussion zu juristischen Wissensdatenbanken, September 2026 )
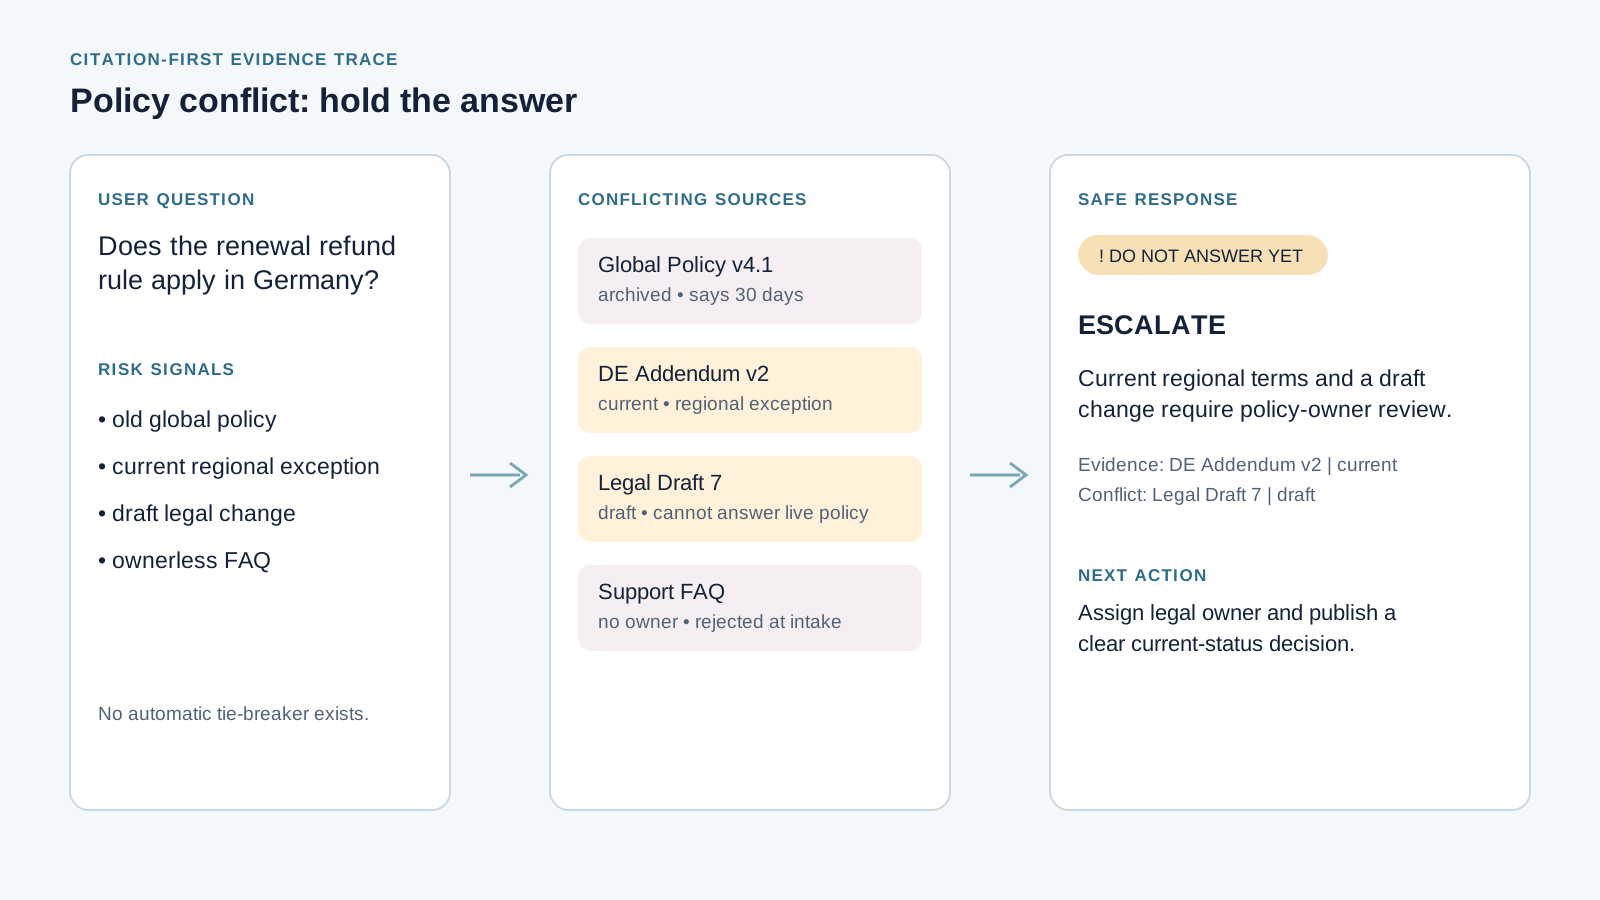
Belegspur eines Versionskonflikts in der Wissensdatenbank mit einem Enthaltungsergebnis
Ein Konflikt ist eine nützliche Ausgabe. Dieser Fall zeigt, warum ein System „noch nicht antworten“ zurückgeben sollte, anstatt stillschweigend zwischen einem Entwurf, einer regionalen Ausnahme, einer alten Richtlinie und einer Datei ohne Verantwortlichen zu wählen.
GPT-6-Astra-Wissensdatenbank-Workflow, Modelle und Kosten
Verwenden Sie für den Piloten einen Browser-Tab: Quellen inventarisieren, das Autoritätsmanifest genehmigen, Dateien und Metadaten normalisieren, einen kleinen Belegsatz abrufen und dann antworten und bewerten. Das operative Ziel ist eine überprüfbare Belegspur, keine clevere Chat-Demo.
Für Teams, die den Rest ihres Stacks vergleichen, bietet Atlas Cloud einen Ort, um aktuelle Modelloptionen zu prüfen. Gehen Sie nicht davon aus, dass ein Katalog GPT-6 Astra listet, bis Sie dies am Tag der Veröffentlichung überprüft haben.
| Ebene | Gelöstes Problem | Was es nicht allein lösen kann | Pilotregel |
|---|---|---|---|
| Langer Kontext | Ein großes Untersuchungspaket lesen | Autorität, Berechtigungen, Zitationsstützung | Für Ausnahmen und Untersuchungen verwenden |
| File Search | Einen kleinen Quellensatz abrufen | Versions-Governance | Vor der Suche filtern |
| Benutzerdefiniertes Retrieval | Indexierung und Ranking optimieren | Antworttreue | Kontextbudget in Tests konstant halten |
| Menschliche Eskalation | Konflikte und folgenschwere Entscheidungen lösen | Routinemäßige Skalierung | Verantwortlichen und Reaktionszeit festlegen |
| Modell oder Tool | Aufgabe | Empfohlene Einstellung | Veröffentlichter Preis für die Planung |
|---|---|---|---|
| GPT-6 Astra | Konfliktbeurteilung, Synthese, Evaluation | reasoning.effort: high | $10/MTok Eingabe, $50/MTok Ausgabe |
| OpenAI File Search | autorisierter Dokumentabruf | Metadatenfilter und Zitate | Tool-Gebühren vor dem Start prüfen |
| Routine-Modellroute | Tags und risikoarme Klassifizierung | zuerst benchmarken | keinen Preis hartcodieren |
| Atlas-Cloud-Modellkatalog | spätere Modellerkundung | den Live-Katalog verwenden | Astra-Verfügbarkeit wird nicht angenommen |
Beginnen Sie mit 20 bis 50 wertvollen Fragen und einem bewusst unhandlichen Dokumentensatz. Fügen Sie eine abgelöste Richtlinie, eine fehlende Zusatzvereinbarung, eine regionale Ausnahme und mindestens eine Frage hinzu, die keine Antwort erhalten darf.
Schritt 1: Ein Autoritätsmanifest erstellen
Bevor Sie etwas hochladen, verwandeln Sie das Inventar in eine freigegebene Entscheidungsschicht. Ein menschlicher Verantwortlicher sollte das zurückgegebene JSON genehmigen, bevor es zu KB_MANIFEST.md wird. Dies ist die erste Leitplanke gegen eine makellose Antwort, die auf außer Dienst gestelltem Text aufbaut.
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
Einstellungen: Modell gpt-6-astra; Responses API; reasoning.effort: high; strukturierte JSON-Ausgabe. Geben Sie für die erste Prüfung nur Titel, Verantwortlichen, Inkrafttretensdatum, Region, Status und Zugriffsebene an.
Fertig, wenn: Jede Datei einen Verantwortlichen, ein Datum, einen Status und einen Rang hat und Refund Policy v4.1 als durch v4.2 abgelöst markiert ist.
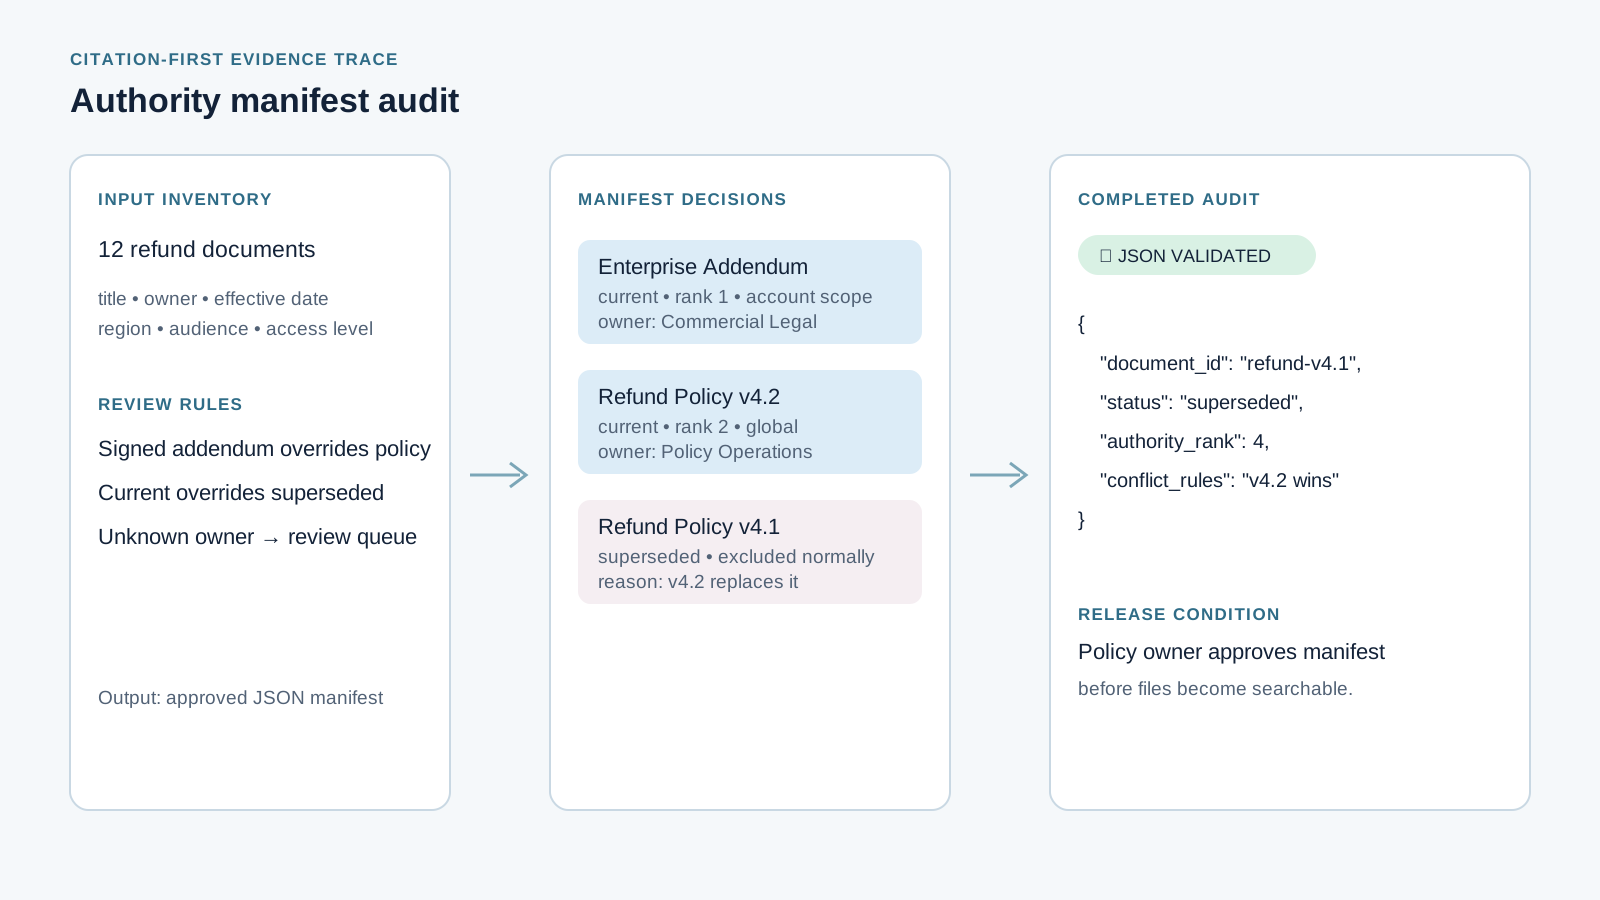
Autoritätsmanifest-Audit mit abgeschlossenen JSON-Entscheidungen
Abgeschlossenes Autoritätsmanifest-Audit für den Rückerstattungspiloten. Die Audit-Seite verzeichnet ein abgelöstes v4.1 und die Enterprise-Override-Regel.
Schritt 2: Eine GPT-6-Astra-Wissensdatenbank für Retrieval vorbereiten
Normalisieren Sie die genehmigten Quellen. Behalten Sie Überschriften, Bedingungen, Seitenmarkierungen und Versionsdaten bei. Entfernen Sie doppelte Fußzeilen, Navigation und OCR-Rückstände. Laden Sie kein Dokument hoch, das keinen Verantwortlichen oder kein Inkrafttretensdatum hat.
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
Einstellungen: Hängen Sie document_id, version, effective_date, status, region, audience und authority_rank als Metadaten an. Beginnen Sie Retrieval-Tests mit ungefähr 2.000 Token an insgesamt abgerufenem Kontext. Ändern Sie jeweils nur eine Variable: Chunking-Strategie oder Abrufanzahl, niemals beide.
Fertig, wenn: Archiviertes Material von normalen Abfragen ausgeschlossen ist und Dateien ohne bekannten Verantwortlichen in eine Prüfungswarteschlange gelangen.
Der nächste Motion-Case macht die Sortierentscheidung sichtbar: Zwei genehmigte Quellenordner bleiben zusammen in der Autoritätsablage, während ein mehrdeutiger Entwurf in einen separaten Prüfpfad wandert. Es ist ein illustratives Workflow-Rendering, keine Live-Antwort von GPT-6 und keine Produktoberfläche.
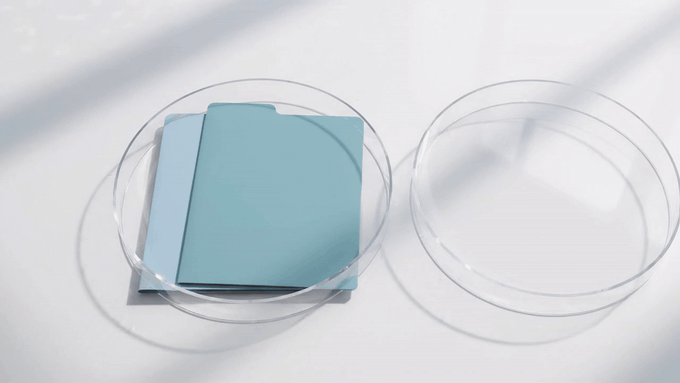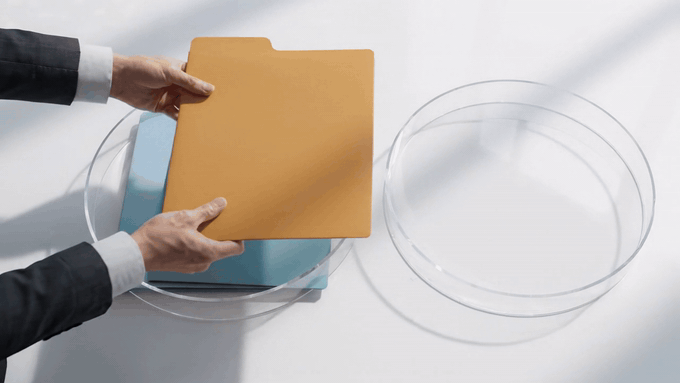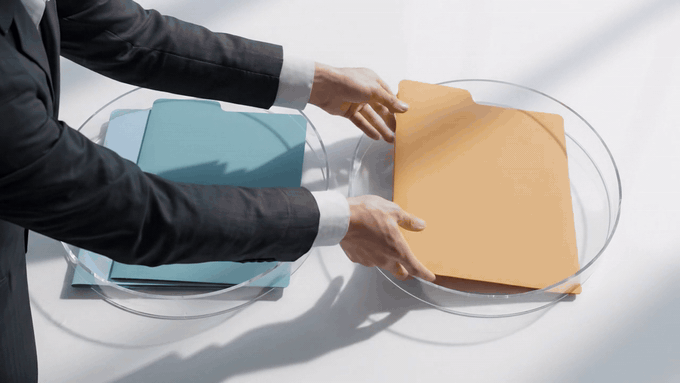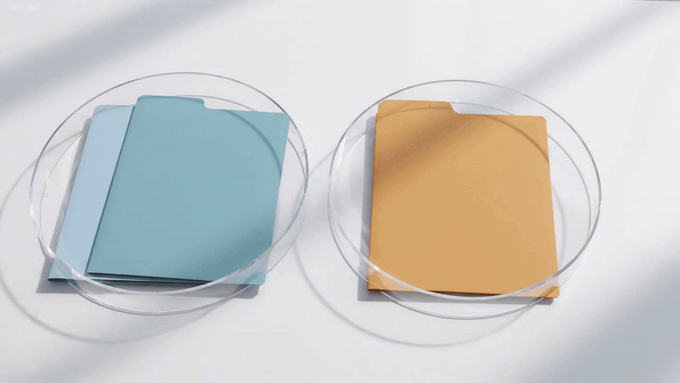
Animierte Belegübergabe an die menschliche Prüfung
Ein 8-sekündiges generiertes Workflow-Visual: Genehmigte Quellenordner bleiben zusammen, während der ungelöste Ordner an die menschliche Prüfung weitergeleitet wird.
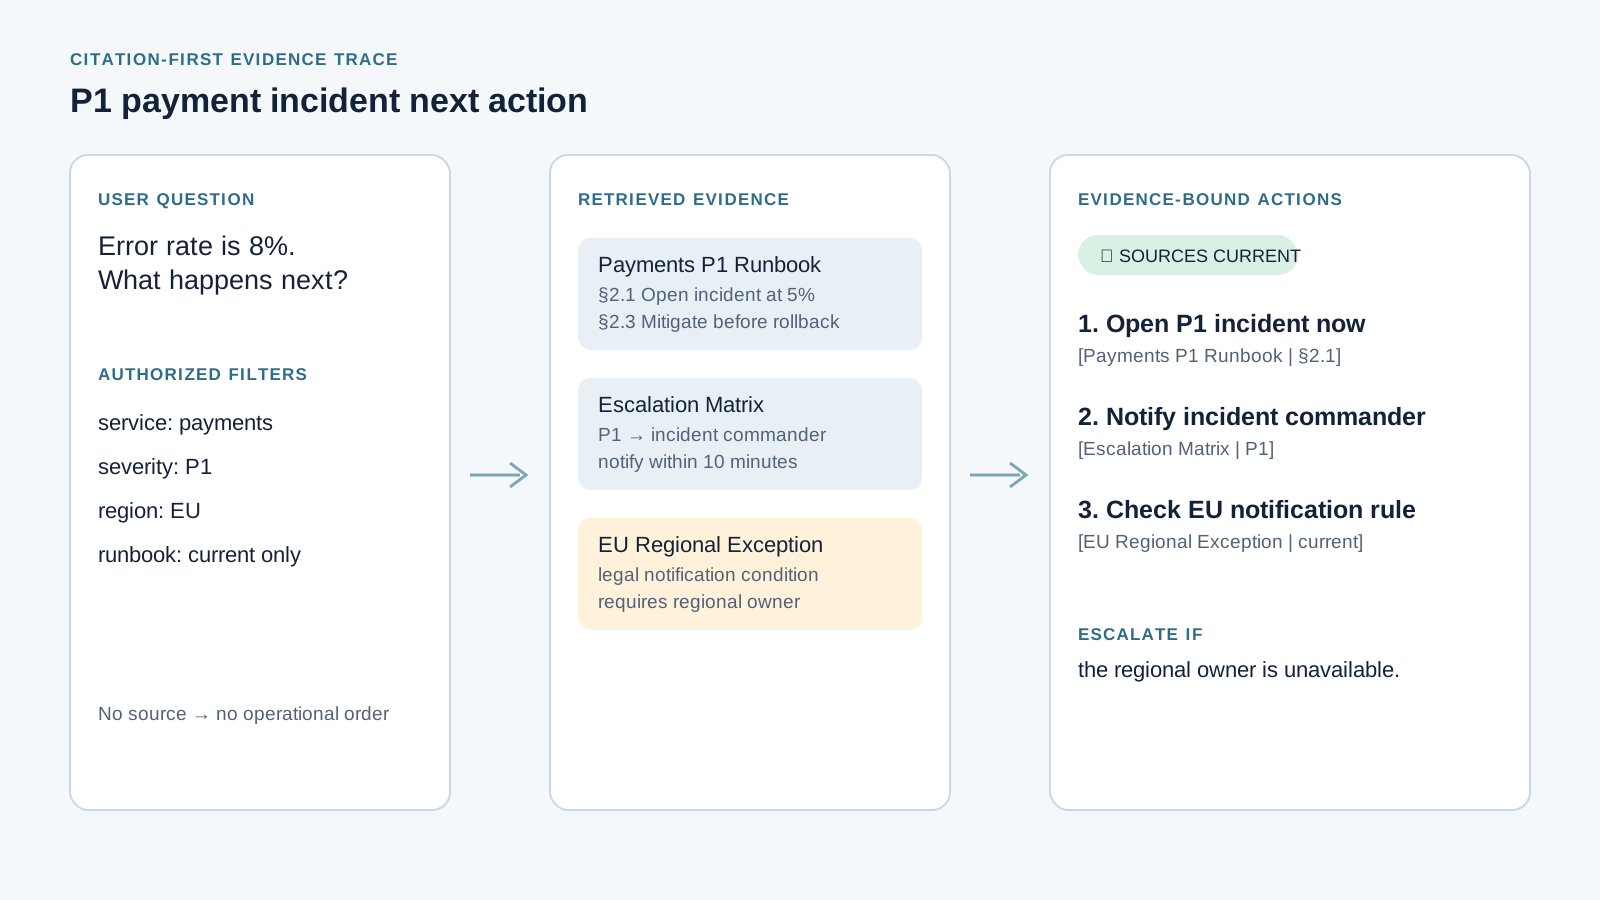
Belegspur eines P1-Zahlungsvorfalls mit einer Eskalationsbedingung
Fall 2. Eine Frage zu einem Zahlungsfehler zieht ein On-Call-Runbook, eine Eskalationsmatrix und eine regionale Ausnahme heran. Die Antwort identifiziert den Incident-Commander-Trigger, anstatt einen Wiederherstellungsplan zu improvisieren.
Schritt 3: Eine beleggebundene Antwort anfordern
Binden Sie die Antworterzeugung an abgerufene, autorisierte Belege. Das Modell sollte Fakten, Annahmen und nächste Schritte trennen, damit Prüfer sehen können, wo das System aufhört, etwas zu wissen.
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
Einstellungen: Verwenden Sie reasoning.effort: high und File Search. Wenden Sie Filter für aktuellen Status, Benutzerautorisierung, Region und Publikum vor dem Abruf an. Tool Calling gehört zur Responses API; die aktuelle OpenAI-Empfehlung nennt außerdem klare Erfolgsbedingungen und Tool-Grenzen für Astra-Workflows. ( OpenAI-Modellhinweise, September 2026 )
Fertig, wenn: Die Antwort die aktuelle allgemeine Richtlinie und die unterzeichnete Enterprise-Zusatzvereinbarung zitiert, niemals archiviertes v4.1 als Regel verwendet und INSUFFICIENT_EVIDENCE zurückgibt, wenn die Zusatzvereinbarung fehlt.
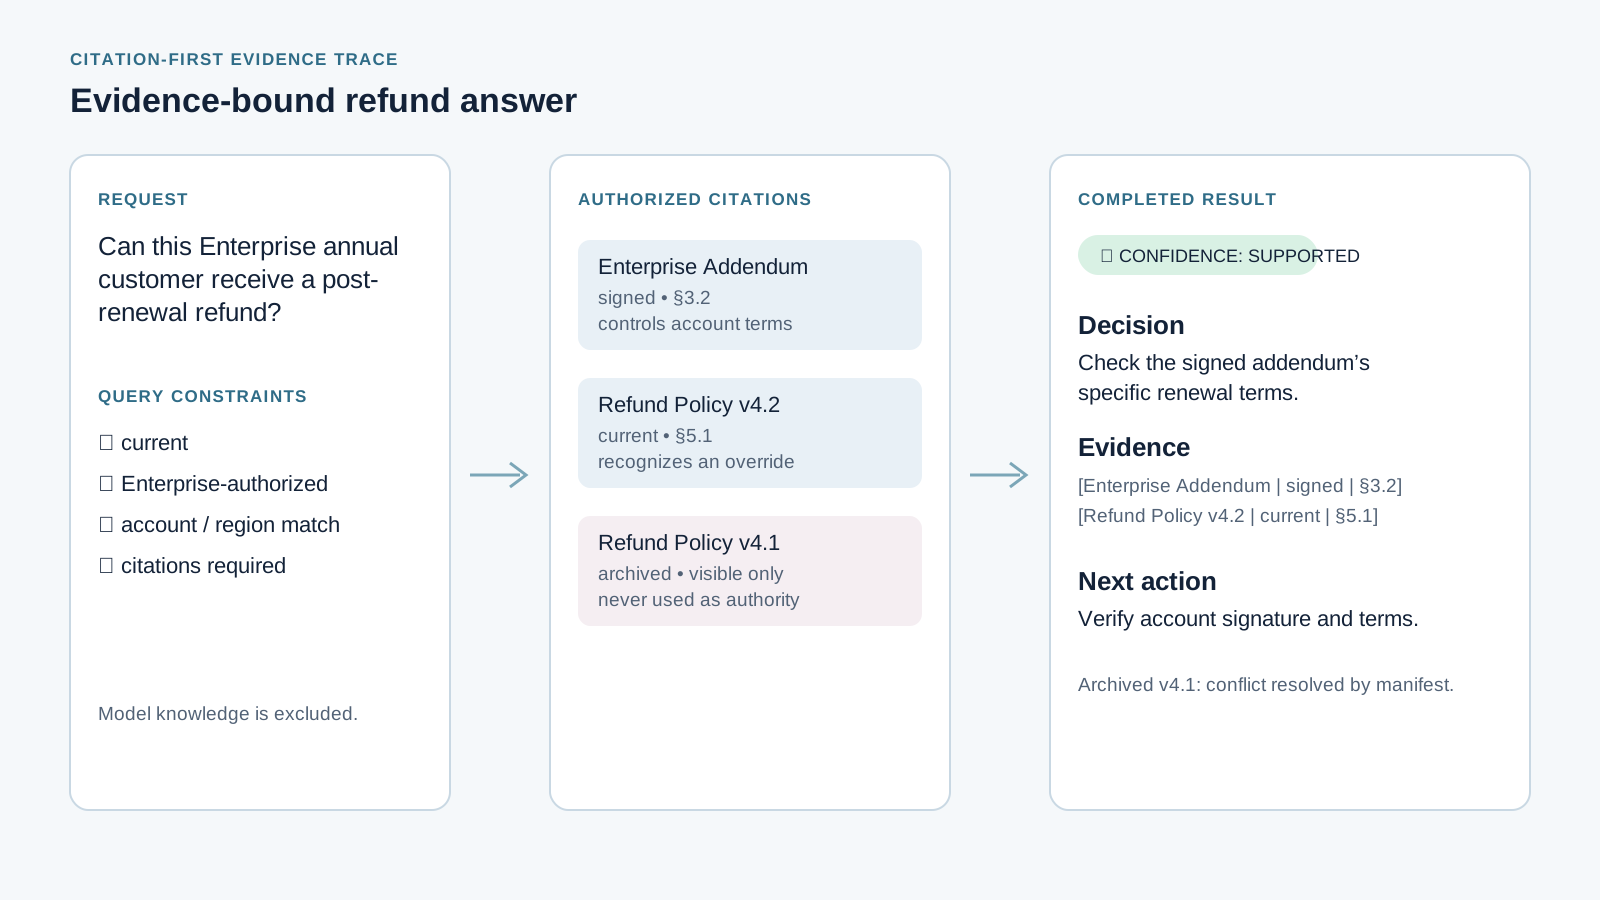
Beleggebundene Rückerstattungsantwort mit Zitaten aus der aktuellen Richtlinie
Primäres abgeschlossenes Ergebnis: Die Entscheidung wird durch v4.2 und die unterzeichnete Zusatzvereinbarung gestützt, während das archivierte Dokument nur als gelöster Konflikt sichtbar bleibt.
Schritt 4: Retrieval und Belegtreue getrennt bewerten
Eine Antwort kann ein Dokument zitieren und dennoch die falsche Klausel anwenden. Bewerten Sie Retrieval-Recall und Behauptungstreue getrennt. So entsteht eine Release-Entscheidung, die ein Produkt-, Support- oder Rechtsverantwortlicher verteidigen kann.
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
Einstellungen: Erstellen Sie ein Golden Set mit 20 Fragen, je 4 für einfache, häufige, widersprüchliche, nicht zu beantwortende und risikoreiche Fälle. Belassen Sie risikoreiche und Konfliktfragen bei hohem Reasoning. Benchmarken Sie niedrigeren Aufwand nur für risikoarme Arbeit, nachdem die Baseline bestanden ist.
Fertig, wenn: Das Set einen Fehler enthält, bei dem das richtige Dokument abgerufen, aber die falsche Klausel angewendet wurde, sowie eine korrekte Enthaltung. Menschliche Prüfer beproben jede gestützte risikoreiche Antwort.
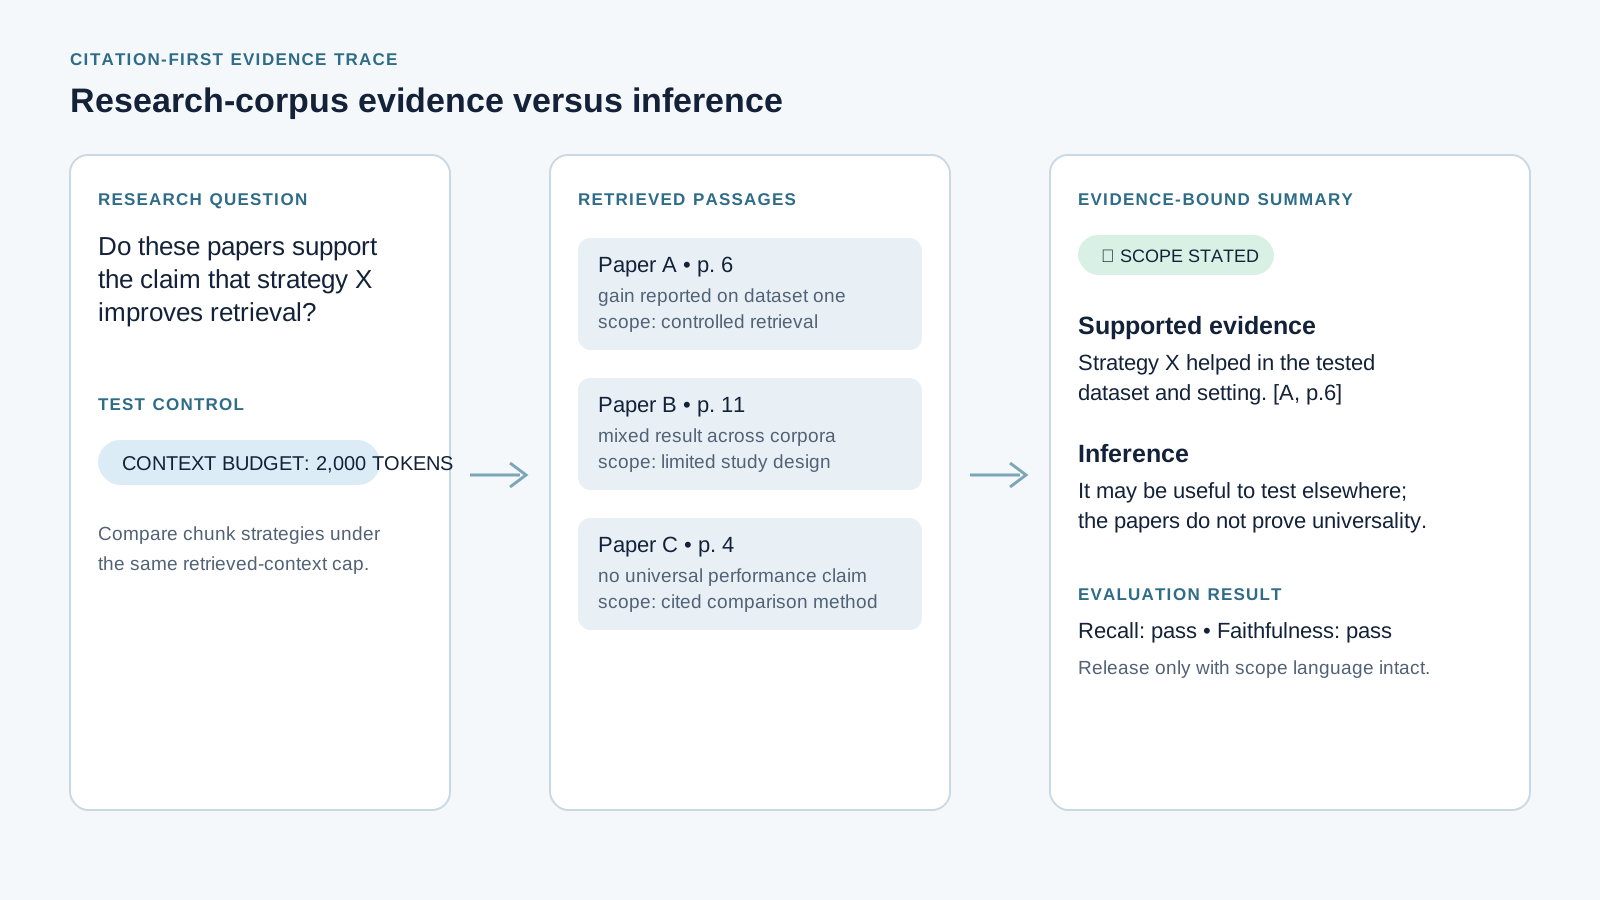
Belegspur eines Forschungskorpus, die Stützung und Inferenz unter einem Budget von 2.000 Token vergleicht
Fall 3. Eine Antwort aus einem Forschungskorpus trennt, was drei Arbeiten explizit stützen, von einer Inferenz. Der Retrieval-Vergleich hält das Kontextbudget bei 2.000 Token.
Die GPT-6-Astra-Wissensdatenbank skalieren, ohne Belege zu verlieren
Die Pilotmuster ändern sich je nach Domäne. Behalten Sie die Belegspur bei, aber machen Sie die Autoritätsquelle und die Ablehnungsgrenze arbeitsbezogen.
| Pilot | Autoritätsquelle | Erforderliche Metadaten | Ablehnen oder eskalieren, wenn | Menschliches Release-Gate |
|---|---|---|---|---|
| Enterprise-Rückerstattungsrichtlinie | unterzeichnete Zusatzvereinbarung, aktuelle Richtlinie | Konto, Region, Inkrafttretensdatum, Status | Zusatzvereinbarung fehlt oder aktuelle Quellen widersprechen sich | Support- und Richtlinienverantwortlicher |
| P1-Incident-Runbook | aktuelles Runbook und Eskalationsmatrix | Service, Schweregrad, Verantwortlicher, letzte Übung | Aktion hat keinen Verantwortlichen oder kein aktuelles Runbook | Incident Commander |
| Forschungskorpus | zitierte Passagen aus Arbeiten | DOI, Seite, Veröffentlichungsdatum, Methode | Schlussfolgerung geht über die Belege hinaus | Fachprüfer |
Für Code und interne Regelsammlungen geben Sie AGENTS.md, Architekturentscheidungen, aktuellen Deployment-Verfahren und außer Betrieb genommenen Skripten explizite Ränge. Für Forschung geben Sie „Beleg“ und „Inferenz“ als unterschiedliche Felder zurück. Im Kundensupport leisten Filter für Produkt, Region und Inkrafttretensdatum den Großteil der Zuverlässigkeitsarbeit.
Kosten- und Routing-Checkliste. Eine risikoreiche Antwort mit 20K Eingabe-Token und 2K Ausgabe-Token kostet etwa $0.30 in GPT-6-Astra-Text-Token: 20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000. Das schließt File Search- und andere Tool-Gebühren aus, die vor dem Start in der aktuellen Konsole überprüft werden sollten. Eingaben über 272K Token haben höhere Modellpreise, daher sollte ein 1M-Token-Prompt nicht der Routineweg sein.
| Aufgabenrisiko | Reasoning-Aufwand | Belegregel | Menschliche Prüfung |
|---|---|---|---|
| Tags und Routing | vor Senkung benchmarken | nur Metadaten | stichprobenartig |
| Standard-Support | mittel oder hoch nach Tests | aktuelle zitierte Quelle | Ausnahmewarteschlange |
| Konflikt, Richtlinie oder Incident | hoch | jede Behauptung quellengebunden | erforderlich |
| Recht, Medizin, Finanzen, HR, Datenschutz | hoch | bei Unvollständigkeit enthalten | vor Maßnahme erforderlich |
Beginnen Sie die Kostenkontrolle vorgelagert: Entfernen Sie veraltete und Dateien ohne Verantwortlichen, filtern Sie Metadaten vor dem Retrieval, testen Sie zuerst wertvolle Fragen und bewahren Sie Manifest, abgerufene Passagen, Modellversion und Release-Entscheidung auf. Teams, die später eine Multi-Modell-Route benötigen, können die aktuelle LLM-API-Dokumentation zusammen mit ihren eigenen Pilotergebnissen prüfen.
Bei regulierten, privaten, beschäftigungsbezogenen, gesundheitlichen, finanziellen oder produktionsvorfallbezogenen Inhalten wenden Sie Zugriffsfilter vor dem Retrieval an, bestätigen Sie Datenverarbeitungs- und Aufbewahrungsbedingungen, halten Sie einen Rückzugspfad bereit und leiten Sie unvollständige Belege an einen verantwortlichen Menschen weiter. Eine flüssige Antwort ist in solchen Kontexten niemals endgültige Beratung.
Häufig gestellte Fragen
Macht ein Kontextfenster mit 1M Token RAG überflüssig?
Nein. Es kann einem Prüfer helfen, ein größeres Paket zu lesen, aber es legt weder Dokumentautorität noch Benutzerzugriff, Aktualität, Zitationspräzision oder einen Release-Test fest. Verwenden Sie Retrieval für die routinemäßige Belegauswahl und reservieren Sie breiten Kontext für Ausnahmeuntersuchungen.
Was sollte niemals in eine GPT-6-Astra-Wissensdatenbank gelangen?
Nehmen Sie keine Dateien ohne Verantwortlichen, undatierten Richtlinien, Entwürfe ohne expliziten Entwurfsworkflow, Inhalte, die der Anfragende nicht sehen darf, oder archiviertes Material ohne Regel für historische Verwendung auf. Legen Sie diese Dateien zur Prüfung vor oder archivieren Sie sie außerhalb des normalen Retrievals.
Wie sollten zwei aktuelle Dokumente behandelt werden, die sich widersprechen?
Geben Sie ESCALATE zurück, benennen Sie den Konflikt, bewahren Sie beide Zitate auf und weisen Sie einen Verantwortlichen zu. Ein Modell sollte nicht stillschweigend einen Tie-Breaker erfinden. Das Manifest benötigt eine dokumentierte Regel vor dem nächsten Release.
Was ist die beste Chunk-Größe für eine GPT-6-Astra-Wissensdatenbank?
Es gibt keine universelle Zahl. Bewahren Sie aussagekräftige Richtlinienüberschriften und Bedingungen, und vergleichen Sie dann Strategien unter demselben Kontextbudget. Ein festes Top-k kann ein viel größeres abgerufenes Tokenbudget verbergen und ein Experiment besser aussehen lassen, als es ist.
Wie beweise ich, dass eine Antwort in der richtigen Quelle begründet ist?
Speichern Sie die erwartete Quelle für jede Golden-Frage, die abgerufenen Passagen, die endgültigen atomaren Behauptungen und die Bewertung eines Prüfers für Recall, Zitationspräzision, Treue, Konfliktbehandlung und Enthaltung. Bei risikoreichen Antworten ist ein fehlender Stützungsnachweis ein Fehlschlag.
Wie viel kostet eine GPT-6-Astra-Wissensdatenbank?
Verwenden Sie die Token-Formel und addieren Sie dann aktuelle File Search- und Tool-Gebühren. Für das obige Beispiel ergeben 20K Eingabe plus 2K Ausgabe etwa $0.30 in Modell-Token. Die praktische Ersparnis entsteht dadurch, veraltetes Material herauszuhalten und hohes Reasoning dort einzusetzen, wo Belege zählen. Das ist die dauerhafte Version von Best Practices für Wissensdatenbanken mit GPT-6 Astra.


