GPT Image 2.5 Rate-Limits liegen derzeit je nach kostenpflichtigem API-Tier zwischen 5 und 250 Bildern pro Minute, wie auf den Modellseiten von OpenAI für Flare und Sunburst aufgeführt. Beide Seiten nennen auch Token-Limits. Prüfen Sie vor der Terminplanung Ihre tatsächliche Kontokonfiguration: ChatGPT-Nutzungskontingente, OpenAI-API-Limits und Atlas-Cloud-Endpunktbeschränkungen müssen getrennt geprüft werden.
Der unangenehme Moment kommt, wenn eine Kampagne fast fertig ist und die letzten Bilder noch fehlen. Erneutes Klicken auf „Generieren“ kann dazu führen, dass Sie eine ursprüngliche Aufgabe, eine doppelte Aufgabe und keine klare Vorstellung davon haben, welche zuerst fertig wird.
Dieser Leitfaden verbindet die veröffentlichten Limits mit einem praktischen Lieferplan. Sie finden eine Diagnosetabelle, ein Warteschlangenverfahren, eine durchgerechnete Berechnung für 100 Bilder und eine kontrollierte Methode, um zu prüfen, ob ein erfolgreiches Bild tatsächlich dem Briefing entspricht. Das sinnvolle Ziel ist ein Ordner mit freigegebenen Assets bis zu Ihrer Frist.
Dokumentation geprüft am 16. September 2026. Kontospezifische Kapazität und exakt konfigurierte Kosten erfordern eine separate Prüfung.
Redaktioneller Status: Das Zugangsgate der Testumgebung verhinderte die sechs geplanten Generierungen. Der Artikel enthält das reproduzierbare Protokoll und offizielle Quellennachweise, aber seine drei Ausgabevergleiche und der Screenshot des abgeschlossenen Laufs bleiben nicht verfügbar.
Wichtigste Erkenntnisse
- Identifizieren Sie Ihren Zugriffsweg, bevor Sie ein Limit anwenden.
- Prüfen Sie Konto, Projekt, Modell und etwaige gemeinsame Kontingente.
- Diagnostizieren Sie den Fehler, bevor Sie über einen erneuten Versuch entscheiden.
- Planen Sie Budget für freigegebene Bilder ein, einschließlich Prüfung und Nacharbeit.
GPT Image 2.5 Rate-Limits hängen von Ihrem Zugriffsweg ab
Beginnen Sie an der Stelle, an der Sie auf „Generieren“ geklickt haben. Ein ChatGPT-Abonnement, ein OpenAI-API-Projekt und ein Atlas Cloud-Konto sind unterschiedliche Zugriffswege. Ein Screenshot von einem kann das Kontingent eines anderen nicht belegen.
Prüfen Sie in ChatGPT Ihren aktuellen Plan, den Zugriff auf die Bildfunktion und die Meldung, die angezeigt wird, wenn die Generierung stoppt. Ein kostenpflichtiges Abonnement begründet kein unbegrenztes Kontingent. Planen Sie die Tagesarbeit nicht anhand einer täglichen Bildanzahl, die vom Konto einer anderen Person kopiert wurde.
In der Veröffentlichungsdiskussion fragen Nutzer, ob Plus weiterhin ein tägliches Bildlimit hat. Das zeigt ein Anliegen der Leser; die Zahlen in diesen Fragen begründen keine Richtlinie. (Reddit-Diskussion zur Veröffentlichung, September 2026.)
Notieren Sie für die API die Organisation, das Projekt und die genaue Modellkennung, die Ihre Anwendung verwendet. Identifizieren Sie für Atlas den ausgewählten Endpunkt und das Konto, auf dem er läuft. Ordnen Sie dann das sichtbare Signal einem Limit-Typ zu.
| Limit-Typ | Sichtbares Signal | Nächste Prüfung |
|---|---|---|
| Produktnutzungskontingent | ChatGPT meldet, dass die Bilderstellung vorübergehend nicht verfügbar ist | Aktuelle Meldung des Kontos und etwaige Rücksetzzeit lesen |
| Bilder pro Minute (IPM) | Bildraten-Beschränkung bei wiederholten Übermittlungen | Bildkontingent für diesen Weg und dieses Modell bestätigen |
| Token pro Minute (TPM) | Fehler oder Kontobereich nennt ein Token-Limit | Das entsprechende Token-Kontingent prüfen |
| Parallele Arbeit | Aufgaben warten, während andere Aufgaben aktiv bleiben | Laufende Arbeiten zählen und die Parallelitätsrichtlinie verifizieren |
| Guthaben oder Abrechnungskontingent | Abrechnungswarnung oder Kontingentfehler | Guthaben, Abrechnungsstatus und Ausgabenbeschränkungen prüfen |
| Modellzugriff | Berechtigungs- oder Modell-nicht-verfügbar-Antwort | Kontoberechtigung und den genauen Endpunkt bestätigen |
Halten Sie diese Unterscheidung im Auftragsblatt Ihres Teams sichtbar. Ein Marketer, der sagt „Ich habe das Limit erreicht“, sollte Weg und Meldung notieren, bevor ein Kollege mit der Fehlersuche beginnt.
Stellen Sie außerdem fest, wer sonst noch dieselben Kontoresourcen nutzt. Ein zweiter Arbeitsplatz bietet nicht unbedingt zusätzliche Kapazität. Fragen Sie den Kontoinhaber, ob Website, internes Tool und nächtliche Aufträge aus demselben Pool schöpfen.
Der Eintrag „Free: not supported“ in der API-Tabelle betrifft dieses API-Modell-Tier. Er belegt nicht, ob das kostenlose ChatGPT-Produkt Bilder generieren kann.
GPT Image 2.5 Rate-Limits nach API-Tier
Die offiziellen Modellseiten veröffentlichen derzeit für beide Varianten die folgende Tabelle. Es handelt sich um öffentliche Nutzungs-Tier-Zahlen, geprüft am 16. September 2026, nicht um eine Garantie, dass jedes Konto genau diese Konfiguration hat.
| OpenAI API usage tier | TPM | IPM |
|---|---|---|
| Free | Nicht unterstützt | Nicht unterstützt |
| Tier 1 | 100,000 | 5 |
| Tier 2 | 250,000 | 20 |
| Tier 3 | 800,000 | 50 |
| Tier 4 | 3,000,000 | 150 |
| Tier 5 | 8,000,000 | 250 |
Quellen: (OpenAI-Modellseite Flare, geprüft September 2026) und (OpenAI-Modellseite Sunburst, geprüft September 2026).
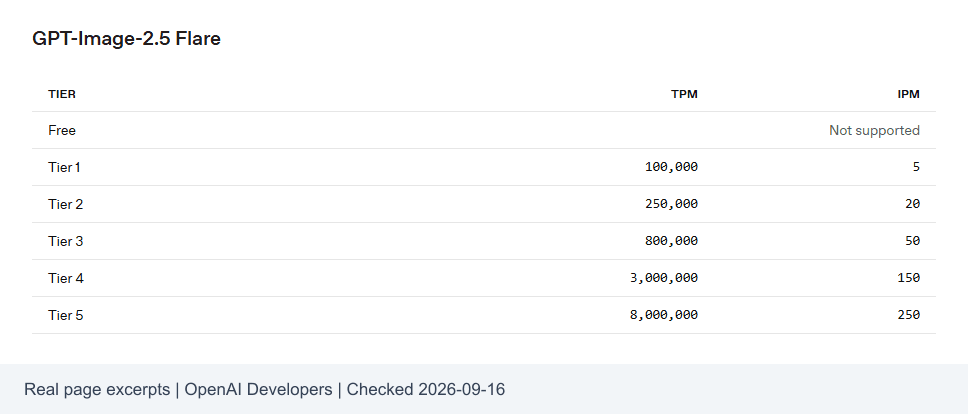 Offizielle OpenAI-Modellseite mit den GPT-Image-2.5-Rate-Limits nach Nutzungs-Tier
Offizieller Nachweis der Modellseite. Prüfdatum: 16. September 2026.
IPM zählt Bilder; RPM zählt Anfragen. Bewahren Sie diese Unterscheidung in Ihrer Planungstabelle. Bei einem Bild pro erfolgreicher Anfrage können die beiden Zahlen in einer einfachen Schätzung übereinstimmen. Mehrere Ausgaben, Wiederholungen oder anderes Endpunktverhalten können diese Annahme durchbrechen.
Nutzen Sie die Tabelle als Ausgangspunkt für ein Kapazitätsgespräch. Notieren Sie das veröffentlichte Tier und vergleichen Sie es mit den Limits, die für das Konto sichtbar sind, das die Arbeit tatsächlich ausführt. Wenn sie abweichen, recherchieren Sie, bevor Sie sich auf eine Frist festlegen.
Übereinstimmende Tabellen zeigen nicht, dass Flare und Sunburst eine Aufgabe in derselben Zeit abschließen. Sie belegen auch nicht, dass ein Wechsel zwischen den Varianten ihre Kontingente addiert. Bestätigen Sie etwaige gemeinsame Limits in der Kontokonfiguration.
Ein Team, das eine Kampagne für Freitag vorbereitet, kann daraus einen kurzen Preflight machen: Produktionsweg identifizieren, aktuelles Kontingent prüfen, andere geplante Arbeitslasten prüfen und eine Person damit beauftragen, die Warteschlange zu beobachten. Speichern Sie das Prüfdatum, damit ein alter Screenshot nicht zur dauerhaften Betriebsannahme wird.
Multiplizieren Sie ein Minutenkontingent nicht mit den Minuten eines Tages und versprechen Sie nicht diese Anzahl fertiger Bilder. Eine solche Berechnung lässt Leerlaufzeiten, Generierungslatenz, andere Einschränkungen und abgelehnte Ausgaben außer Acht.
GPT Image 2.5 Rate-Limits diagnostizieren, bevor Sie es erneut versuchen
Speichern Sie Fehlertext, HTTP-Status, Zeitstempel und die verfügbare Anforderungskennung, bevor Sie etwas ändern. Ein Screenshot, der nur „429“ zeigt, lässt zu viel im Unklaren.
Die OpenAI-Dokumentation beschreibt Organisations- und Projektlimits, gemeinsame Modellpools, Antwort-Header und die Behandlung temporärer Fehler. Sie empfiehlt, mindestens so lange zu warten wie ein gelieferter Retry-After-Wert, Jitter hinzuzufügen und schnelle wiederholte Fehlversuche zu vermeiden, die das Minutenkontingent verbrauchen können. (OpenAI Rate Limits, geprüft September 2026.)
Das folgende Diagnoseverfahren ist ein Vorschlag für das Anwendungsdesign. Fehlerbezeichnungen und Wiederherstellungssteuerungen müssen auf die Plattform abgebildet werden, die Sie tatsächlich verwenden.
| Sichtbare Situation | Zuerst prüfen | Aktion |
|---|---|---|
| Temporärer 429 | Fehlertext und etwaiger Hinweis auf Wartezeit oder Rücksetzung | Die betroffene Warteschlange anhalten, dann das Übermittlungstempo reduzieren |
OpenAI insufficient_quota | Guthaben, Abrechnungsstatus und Kontoberechtigung | Kontoproblem lösen; automatische Wiederholungen stoppen |
| Zeitüberschreitung nach Übermittlung | Ursprünglicher Anforderungsdatensatz, Aufgaben-ID falls verfügbar, Verlauf | Ursprüngliche Aufgabe abgleichen, bevor erneut übermittelt wird |
| Lange Warteschlange | Status „Ausstehend“ und Anzahl aktiver Aufgaben | Weiter warten, solange die Aufgabe gültig bleibt; Verzögerungen separat prüfen |
| Parameter- oder Inhaltsablehnung | Spezifischer Validierungs- oder Ablehnungsgrund | Anforderung korrigieren; nicht als Rate-Limit-Wiederholung einstufen |
Der OpenAI-Code in der Tabelle ist ein OpenAI-spezifisches Diagnosebeispiel. Er ist kein Versprechen, dass Atlas dasselbe Fehlerobjekt zurückgibt oder dieselben Header unterstützt.
Bei einer Zeitüberschreitung trennen Sie, was Sie wissen, von dem, was Sie vermuten. „Mein Client hat das Warten beendet“ belegt nicht, ob der Server den Auftrag angenommen hat. Markieren Sie den lokalen Datensatz als unsicher und prüfen Sie den ursprünglichen Vorgang über den Status- oder Verlaufsmechanismus, den der Weg bietet.
Wenn kein Abgleichmechanismus existiert, leiten Sie diese Unsicherheit an eine Bedienperson weiter. Blind erneutes Übermitteln kann einen weiteren abrechenbaren Auftrag erzeugen. Halten Sie dieses Risiko fest, bevor jemand einen erneuten Versuch beschließt.
Verwenden Sie für den Rücksetzzeitpunkt die Antwort oder Kontomeldung, die für das Limit gilt, das Sie erreicht haben. Vermeiden Sie die Annahme, dass jede Beschränkung um Mitternacht oder genau 60 Sekunden nach dem Fehler zurückgesetzt wird.
Bewahren Sie die Nachweise nach der Wiederherstellung auf. Ein kleiner Vorfallsbericht mit Weg, ursprünglichem Fehler, Wartedauer und Endergebnis hilft der nächsten Bedienperson, ein Kontoproblem von einem Verkehrsanstieg zu unterscheiden.
GPT Image 2.5 Rate-Limits mit einer Warteschlange bewältigen
Eine Warteschlange gibt Ihrem Team einen Ort, an dem entschieden wird, was als Nächstes läuft. Für eine kleine Kampagne können eine Tabellenkalkulation und eine Bedienperson ausreichen. Eine Anwendung kann dieselben Entscheidungen in einem dauerhaften Auftragsspeicher umsetzen.
Verwenden Sie diese sechsstufige SOP:
- Weisen Sie eine stabile Geschäfts-ID zu. Notieren Sie Prompt-Version, gewünschte Ausgabe, Modell, Abmessungen, Qualität und Frist. Ein überarbeitetes Briefing erhält eine neue Version.
- Prüfen Sie vorhandene Arbeiten. Geben Sie die gespeicherte Ausgabe für einen abgeschlossenen Auftrag zurück. Lassen Sie einen aktiven oder unsicheren Auftrag im Abgleich, anstatt eine weitere Übermittlung zu erstellen.
- Steuern Sie Tempo und Parallelität getrennt. Lassen Sie Arbeit nur zu, wenn das lokale Ratenbudget und ein laufender Slot verfügbar sind. Wiederholungen verwenden dieselben Zulassungskontrollen.
- Befolgen Sie einen Server-Wartehinweis. Warten Sie bei einem bestätigten wiederholbaren Fehler mindestens die angewiesene Dauer und fügen Sie etwas Zufälligkeit hinzu.
- Verwenden Sie andernfalls ein begrenztes Backoff. Erhöhen Sie die Verzögerungen zwischen Versuchen, fügen Sie Jitter hinzu und begrenzen Sie die Verzögerung. Behalten Sie die Gesamtfrist der Aufgabe im Blick.
- Stoppen Sie bewusst. Wenn das Wiederholungsbudget oder die Frist erschöpft ist, speichern Sie die letzten Nachweise und senden Sie die Aufgabe zur Prüfung.
Dieser plattformneutrale Pseudocode veranschaulicht Planungsentscheidungen. Er ist kein Atlas-SDK und kein Endpunktvertrag.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt_after(delay + random_jitter) 18 19save_final_state_for_review()
Der atomare Anspruch ist wichtig, wenn zwei Worker dieselbe Warteschlangenzeile sehen. Beide dürfen nicht unabhängig voneinander zu dem Schluss kommen, dass der Auftrag frei zur Übermittlung ist. Speichern Sie den Übermittlungsstatus, bevor ein Worker verschwindet oder neu startet.
Die Deduplizierung auf Anwendungsebene lässt immer noch ein schwieriges Fenster: Ein Dienst kann eine Anforderung annehmen, kurz bevor der Client die Antwort verliert. Native Endpunkt-Idempotenz kann einige Risiken doppelter Übermittlungen adressieren, wenn sie dokumentiert ist. Eine lokale Geschäfts-ID allein kann keine Exactly-Once-Ausführung garantieren, und dieser Leitfaden geht nicht davon aus, dass Atlas einen bestimmten Idempotenz-Header akzeptiert.
Priorisieren Sie nach Lieferbedarf. Schließen Sie das fehlende Bild der freigegebenen Kampagne ab, bevor Sie optionale Varianten zulassen. Führen Sie eine kurze Bedienernotiz, die erklärt, warum die Arbeit gestoppt wurde, damit ein Kollege ohne Raten fortfahren kann.
100 Bilder rund um GPT Image 2.5 Rate-Limits planen
Verwenden Sie zwei Zähler: generierte Ausgaben und akzeptierte Ergebnisse. Der zweite Zähler sagt dem Kampagnenverantwortlichen, ob die Arbeit fertig ist.
Betrachten Sie ein hypothetisches Planungsbeispiel mit einer Ausgabe pro Aufgabe. Nehmen Sie ein effektives Kontingent von 5 IPM, eine durchschnittliche Belegung von 60 Sekunden pro laufendem Slot und maximal 2 gleichzeitige Aufgaben an. Diese Eingaben sind illustrativ, nicht Messungen von Atlas oder OpenAI.
| Planungseingabe oder -berechnung | Hypothetischer Wert | Interpretation |
|---|---|---|
| Benötigte freigegebene Bilder | 100 | Das tatsächliche Lieferziel |
| Effektives Bildkontingent | 5 IPM | Angenommene Kontokapazität |
| Bildkontingent für 100 Ausgaben | 100 ÷ 5 = 20 Minuten | Kontingent-Kapazitätsanforderung, kein Versprechen der Fertigstellung |
| Gleichzeitige Aufgaben | 2 | Angenommene Obergrenze für laufende Aufgaben |
| Durchschnittliche Slot-Belegung | 60 Sekunden | Übermittlung bis zum Abschluss |
| Kapazität auf Parallelitätsseite | 2 × 60 ÷ 60 = 2 Bilder/Minute | Niedriger als das Bildkontingent |
| Angenommene Akzeptanzrate | 80 % | Vereinfachte Schätzung für die Planung |
| Generierungskontingent für 100 akzeptierte Bilder | 100 ÷ 0.8 = 125 Ausgaben | Enthält ein grobes Nacharbeitsbudget |
| Kapazitätszeit bei 2 Ausgaben/Minute | 125 ÷ 2 = 62,5 Minuten | Schließt zusätzliche Prüf- und Übergabearbeit aus |
Eine nützliche Näherung ist:
plaintext1sustainable images/minute ≈ minimum of: 2 image allowance 3 request allowance × images per request 4 token allowance ÷ applicable tokens per image 5 concurrency × 60 ÷ average occupancy seconds
Verwenden Sie vergleichbare Einheiten und tatsächliche Kontomessungen. Wenn der Token-Verbrauch nicht verfügbar ist, lassen Sie diesen Term unaufgelöst, anstatt ihn aus der Wortanzahl des Prompts zu schätzen. Diese Formel beschreibt ein Planungsmodell, nicht die Implementierung des Anbieters.
Die Schätzung von 125 Ausgaben geht von einer stabilen Akzeptanzwahrscheinlichkeit über alle Versuche aus. Echte Nacharbeit kann korreliert sein: Ein Prompt, der wiederholt Objekte falsch zählt, schlägt möglicherweise weiter fehl, bis jemand ihn ändert. Überprüfen Sie wiederkehrende Fehler, bevor Sie weitere Versuche kaufen.
Unterschiedliche Arbeiten erfordern unterschiedliche Abnahme-Kriterien:
- Wöchentliche Inhaltsillustrationen: Das Motiv muss zum Artikel passen und der Beschnitt muss in der Veröffentlichungsgröße funktionieren.
- Produktkonzeptmaterial: Das Bild muss die geforderte Form und Platzierung bewahren. Ein Konzeptbild kann keine verifizierte Produktfotografie ersetzen.
- Lehr- oder Rezeptillustrationen: Anzahl, Objekte und Detailreihenfolge müssen zur Erklärung passen. Eine zusätzliche Zutat kann Leser in die Irre führen.
Addieren Sie Download-, Prüf-, Überarbeitungs- und Übergabezeit zum Zeitplan. Wenn eine Person jedes Asset prüft, messen Sie auch das Tempo dieser Person.
Trennen Sie vor einer Frist wesentliche Bilder von optionalen Varianten. Verfolgen Sie fertige, abgelehnte, aktive und unsichere Elemente unabhängig voneinander. Ein Ordner mit 100 Dateien kann dennoch um mehrere freigegebene Ergebnisse zu kurz sein.
Nacharbeit reduzieren, bevor Sie Ihre Limits erhöhen
Definieren Sie ein Bestehen-Kriterium, bevor Sie auf „Generieren“ klicken. Das macht die Entscheidung wiederholbar und verhindert, dass ein überzeugend aussehendes Bild mit falscher Anzahl oder unbrauchbarem Text durchrutscht.
Das kontrollierte Protokoll hier verwendet GPT Image 2.5 Flare Text-to-Image, ein PNG pro Aufgabe, bei 2048x1152. Führen Sie für jedes Briefing zuerst max aus, dann high, wobei alle anderen verfügbaren Einstellungen unverändert bleiben. Bewahren Sie die Originale auf und prüfen Sie beide in derselben Anzeigegröße.
Nachweisstatus: Die sechs Flare-Ausgaben unten wurden für die drei Briefings bei 2048x1152 generiert. Jedes Paar dokumentiert ein MAX- und ein HIGH-Ergebnis. Diese Beispiele unterstützen die hier gezeigten Prüfschritte, aber sechs Ausgaben begründen weder eine breite Qualitätsrangfolge noch einen Anspruch auf eine Akzeptanzrate.
A. Objektanzahl und Komposition
Kopieren Sie diesen Prompt unverändert:
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged in two neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Zählen Sie jede Tomate, prüfen Sie die zwei Reihen und kontrollieren Sie alle vier Kanten des Bretts. Suchen Sie dann nach verbotenen Objekten. Akzeptieren Sie das Bild nur, wenn das gesamte Briefing erfüllt ist. Eine korrekte Tomatenanzahl mit abgeschnittenem Brett erfordert dennoch eine Entscheidung über Reparatur oder Neugenerierung.
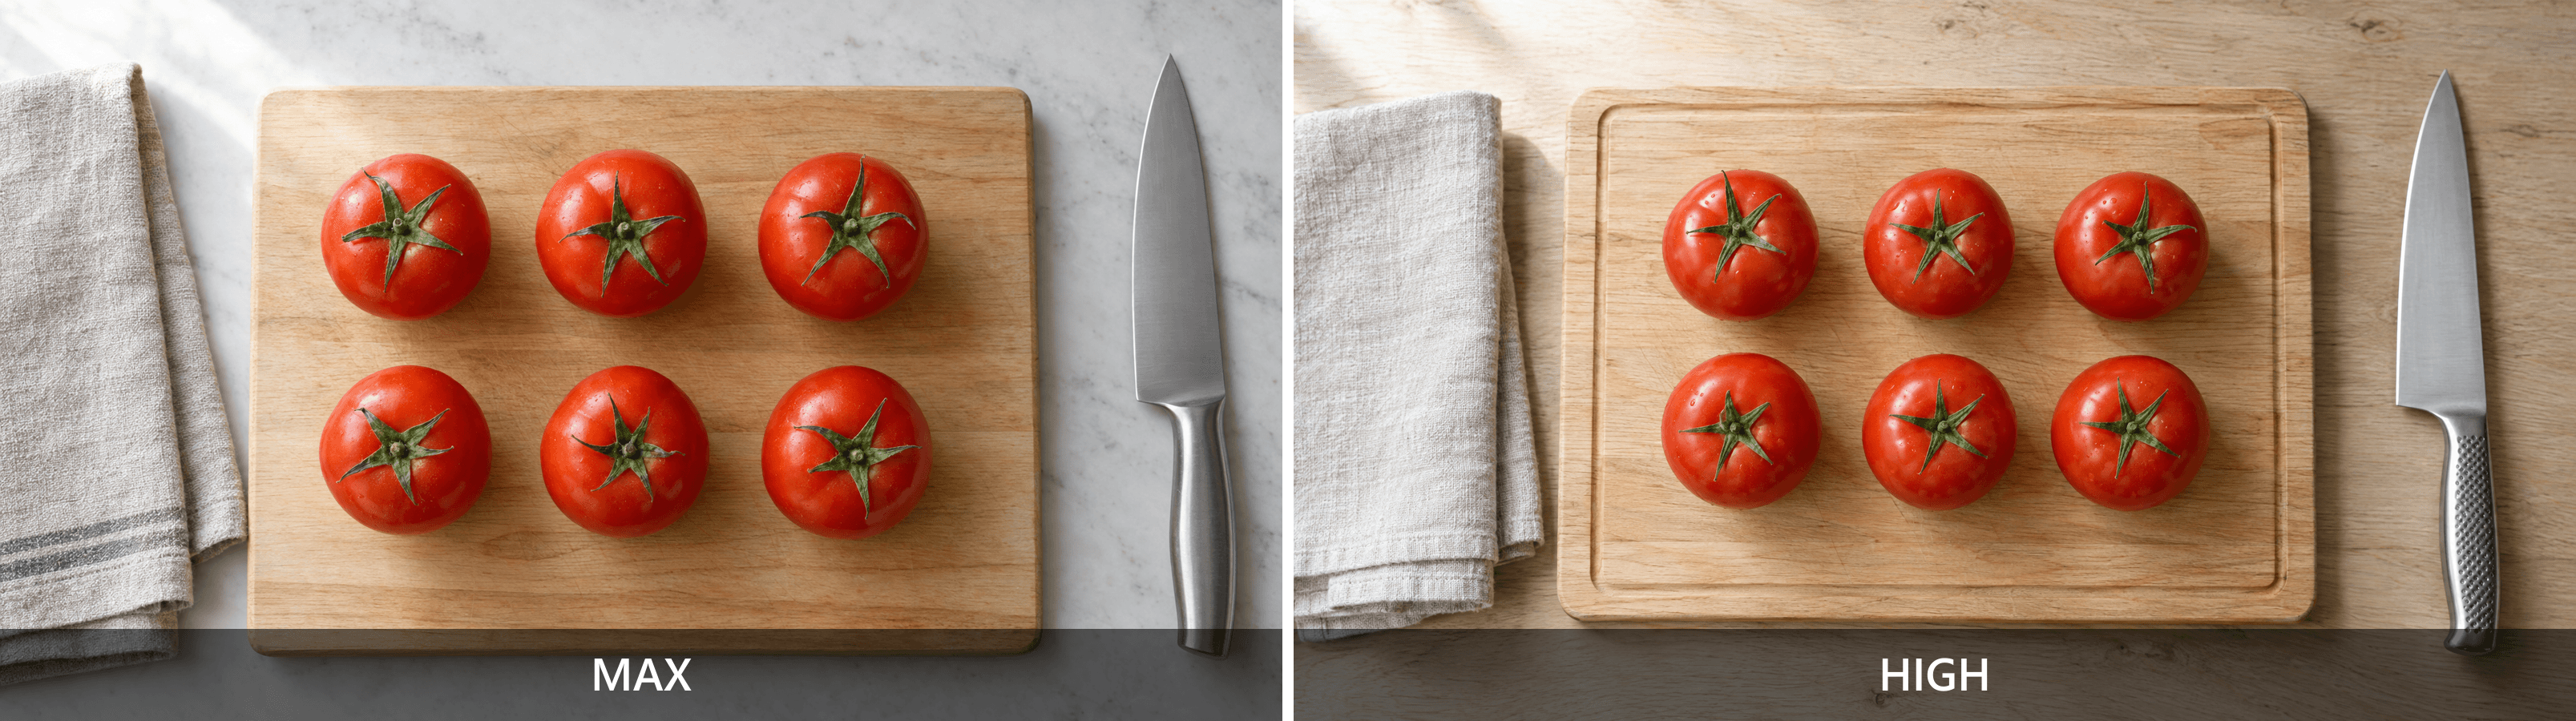 High- und Max-Flare-Ausgaben für die Sechs-Tomaten-Zählung und die Vollbrett-Prüfung
Links: MAX. Rechts: HIGH. Beide Ausgaben zeigen sechs Tomaten in zwei Reihen; prüfen Sie das gesamte Brett, Messer, Handtuch und alle verbotenen Objekte, bevor Sie eines der Ergebnisse freigeben.
B. Platz für eine Überschrift
plaintext1Create a realistic editorial still-life photograph for a home-office 2article. Place an open unbranded notebook, one black pen, and one plain 3ceramic coffee cup entirely within the left half of a pale oak desk. 4Keep the right 45 percent of the frame empty, showing only the desk 5surface so a designer can add a headline later. No laptop, no phone, 6no plants, no visible writing, no text, and no logos. 7Use soft daylight and a slightly elevated camera angle. 8Horizontal 16:9 composition.
Bei 2048 Pixeln Breite beginnt das rechte 45-Prozent-Segment bei ungefähr x = 1126. Prüfen Sie diesen Bereich im Original. Platzieren Sie dann in einer lokalen Layout-Vorschau eine echte Überschrift, um die Lesbarkeit zu beurteilen. Eine Hilfslinie ist eine Postproduktions-Anmerkung, nicht Teil der generierten Szene.
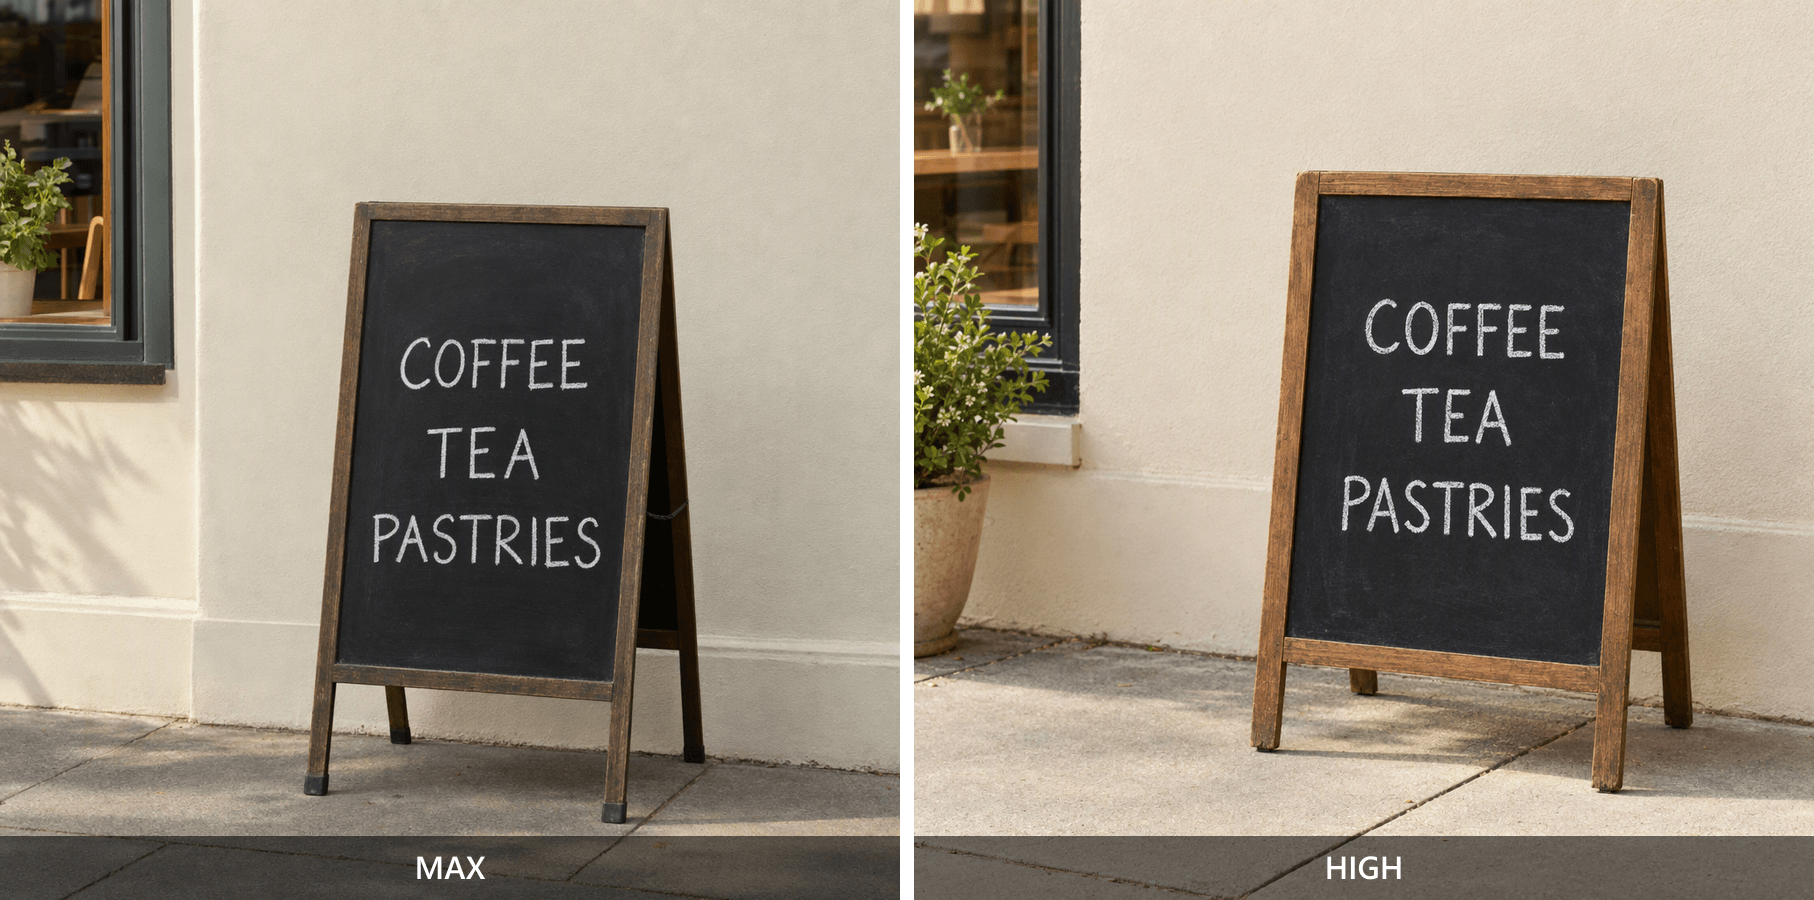 High- und Max-Ausgaben für das Homeoffice mit der markierten Überschriftsfläche auf der rechten Seite
Links: MAX. Rechts: HIGH. Beide Ausgaben bewahren eine nutzbare Schreibtischfläche auf der rechten Seite für eine Überschrift; beurteilen Sie diesen leeren Bereich in der endgültigen Anzeigegröße.
C. Exakter Kurztext
plaintext1Create a realistic photograph of a small freestanding black chalkboard 2outside a quiet neighborhood cafe. The board must contain exactly 3these three lines of clearly readable white lettering: 4COFFEE 5TEA 6PASTRIES 7Do not add prices, extra words, logos, or other readable signs. 8Show the full board with a simple cream-colored wall behind it, 9warm morning daylight, and a small area of clean pavement. 10No people. Horizontal 16:9 composition.
Lesen Sie jeden Buchstaben im Original und in der Vorschau in Veröffentlichungsgröße. Prüfen Sie den Hintergrund auf zusätzliche lesbare Schilder. Dies ist eine KI-generierte Testszenen, kein Foto, das ein echtes Café dokumentiert. Bewahren Sie Rechtschreibfehler in den Nachweisen auf, anstatt sie wegzuretouchieren.
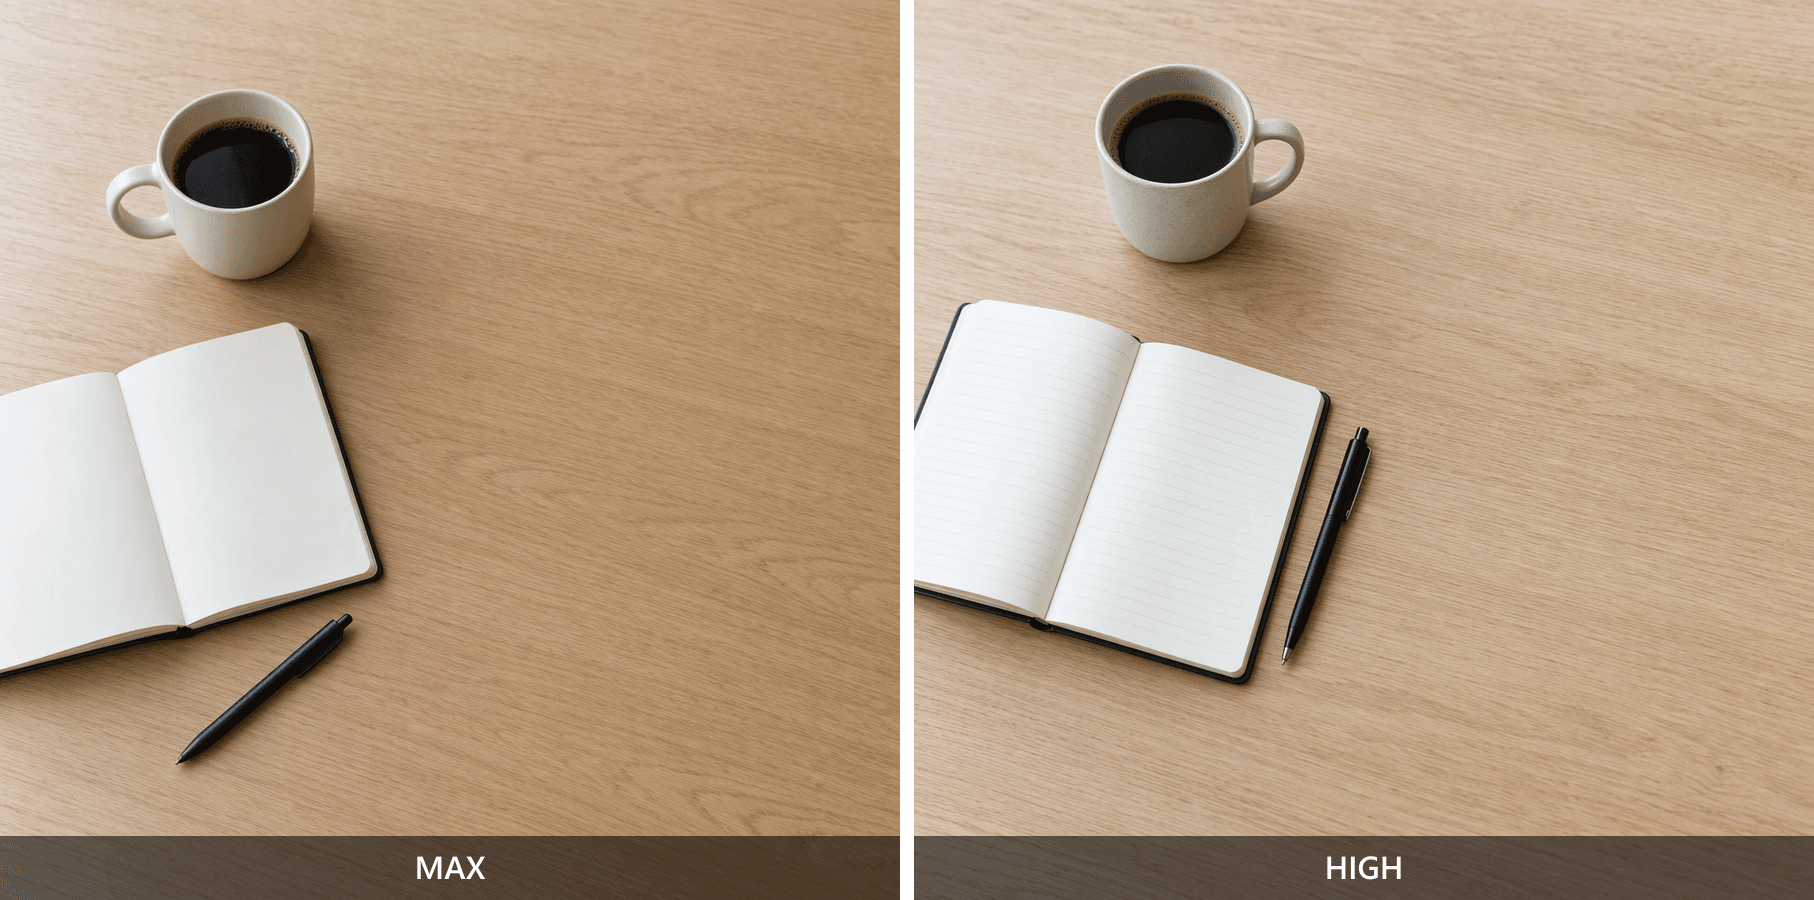
High- und Max KI-generierte Café-Kreidetafeln zur Prüfung von COFFEE, TEA und PASTRIES
Links: MAX. Rechts: HIGH. Lesen Sie jede Zeile in Veröffentlichungsgröße und prüfen Sie den Hintergrund auf zusätzlichen lesbaren Text, bevor Sie ein Ergebnis freigeben.
Sechs Ausgaben können einen Prüfprozess veranschaulichen. Sie können keine Plattformerfolgsrate, keinen Produktionsdurchsatz und keine Rate-Limit-Obergrenze belegen. Ein einzelnes Paar kann auch die Auswirkungen der Qualitätseinstellungen nicht von der Generierungsvariabilität isolieren.
Beurteilen Sie eine Einstellung anhand des akzeptierten Assets und seiner dokumentierten Kosten. Ohne genaue Preise bleibt eine Kostenaussage zu High gegenüber Max ungemessen. Wenn beide bestehen, dokumentieren Sie das; wenn keines besteht, überarbeiten Sie das Briefing, bevor Sie denselben Fehler wiederholen.
Atlas Cloud für Ihren Bild-Workflow bewerten
Verwenden Sie dieselbe repräsentative Aufgabe, um einen Zugriffsweg zu bewerten. So bleibt die Bewertung an die Arbeit gebunden, die Ihr Team liefern muss.
Die ausgewählte GPT Image 2.5 Flare Text-to-Image-Seite ist der Endpunkt für dieses Protokoll. Öffnen Sie sie, bestätigen Sie den Modellnamen, fügen Sie einen der vollständigen Prompts oben ein und wählen Sie die gewünschte Größe und Qualität.
Prüfen Sie, was das Formular tatsächlich beibehält, nachdem Sie ein Bedienelement verlassen haben. Eine eingegebene Breite, die vor der Übermittlung zurückgesetzt wird, erzeugt keinen 2048-Pixel-Test. Notieren Sie die übernommenen Einstellungen, führen Sie eine Aufgabe aus, warten Sie auf einen Endzustand und laden Sie die tatsächliche Ausgabe herunter.
Speichern Sie die Aufgabenkennung, falls sie angezeigt wird, zusammen mit Übermittlungszeitpunkt, Abschlusszeitpunkt und Ergebnisdatei. Erstellen Sie für den Vergleichslauf eine separate Aufgabe und ändern Sie nur die Qualität. Leiten Sie keine neue Ausgabe aus Beispielbildern ab, die bereits auf der Modellseite angezeigt werden.
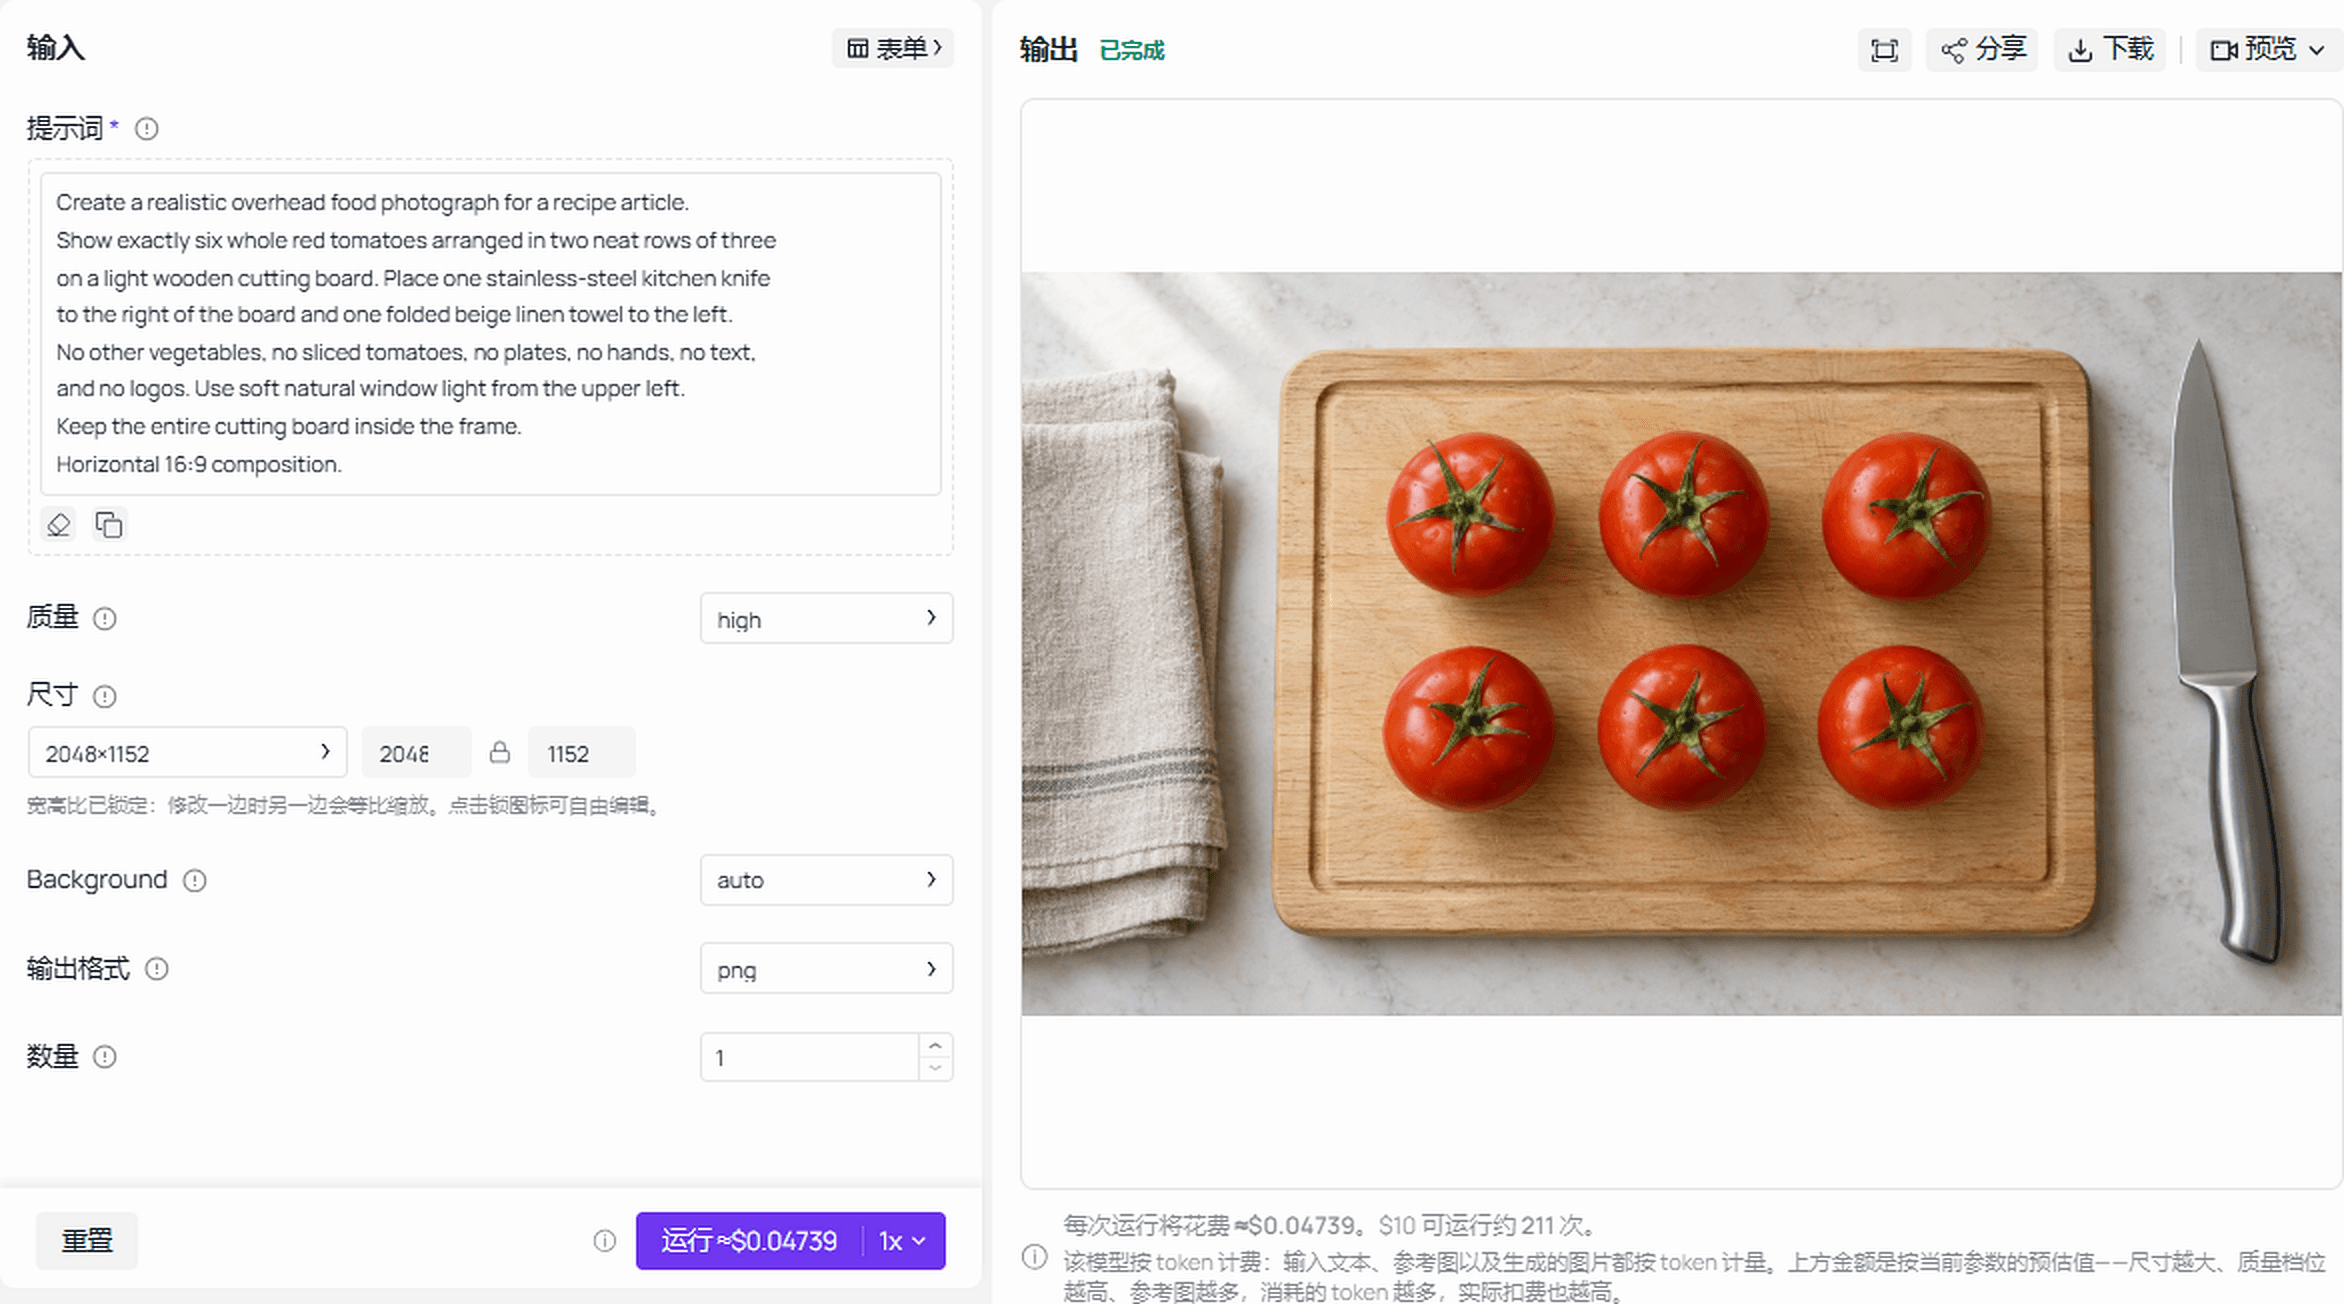 Abgeschlossener Flare-Lauf mit Tomaten-Briefing, aktiven Einstellungen und generiertem Ergebnis
Abgeschlossener Flare-Lauf: Der Bildschirm zeigt das Tomaten-Briefing, HIGH-Qualität, Größe 2048x1152, PNG-Ausgabe und das zurückgegebene Sechs-Tomaten-Ergebnis.
Bewerten Sie den Weg anhand von fünf Feldern:
- Modell und Endpunkt: Bestätigen Sie Flare Text-to-Image und nicht einen Edit-Endpunkt oder eine andere Variante.
- Rate und Parallelität: Ermitteln Sie die geltenden Kontolimits und ob Arbeitslasten sie gemeinsam nutzen.
- Aufgabenwiederherstellung: Prüfen Sie, wie das Konto aktive Arbeiten, endgültige Fehler und Ergebnisse nach einer Zeitüberschreitung anzeigt.
- Konfigurierte Kosten: Prüfen Sie die Einheit, ausgewählte Abmessungen, Qualität und etwaige Rabattbedingungen.
- Abnahme und Nacharbeit: Bewahren Sie die ursprüngliche Ausgabe und einen kurzen Grund für jedes abgelehnte Asset auf.
Verwenden Sie das aktuelle Modellverzeichnis als Einstieg für die Preisprüfung und prüfen Sie dann die ausgewählte Konfiguration. Ein gerundeter Startpreis belegt nicht die Gebühr für 2048x1152 + max.
Atlas-Kontoparallelität, Produktionsdurchsatz, gemeinsame Kontingente und Abrechnung fehlgeschlagener Aufgaben wurden für diesen Artikel nicht unabhängig festgestellt. Bestätigen Sie sie kontoseitig. Testumgebungs-Aufgabenzeiten können ebenfalls keine Produktions-API-Leistung belegen.
Führen Sie einen repräsentativen Prompt aus, prüfen Sie das Ergebnis und kontrollieren Sie Ihre Kontolimits, bevor Sie skalieren.
GPT Image 2.5 Rate-Limits – FAQ
Wie viele GPT-Image-2.5-Bilder kann ich pro Minute generieren?
Die kostenpflichtigen OpenAI-API-Modellseiten-Tiers listen 5 bis 250 IPM. Verwenden Sie für die Betriebsplanung die aktuellen Einstellungen Ihres Kontos, einschließlich Token und anderer geltender Einschränkungen. Ein veröffentlichtes Bildkontingent garantiert nicht, dass jedes Bild innerhalb dieser Minute fertig wird oder die Prüfung besteht.
Hat ChatGPT Plus ein festes tägliches Bildlimit?
Dieser Artikel legt keine universelle feste Tagesanzahl für Plus fest. Prüfen Sie die aktuelle Bildgenerierungsmeldung und Planinformationen Ihres Kontos. Nutzerberichte können helfen, eine zu untersuchende Frage zu identifizieren, aber eine Zahl aus der Sitzung einer anderen Person kann nicht sicher zum täglichen Produktionsbudget Ihres Teams werden.
Haben Flare und Sunburst dieselben Rate-Limits?
Ihre offiziellen Modellseiten zeigten bei der Prüfung am 16. September 2026 übereinstimmende Tier-Tabellen. Das belegt weder übereinstimmende Generierungszeiten noch getrennte Kapazitätspools. Bevor Sie eine geteilte Arbeitslast planen, bestätigen Sie die Limits und Freigaberegeln, die für beide Varianten in Ihrem Konto gelten.
Warum erhalte ich einen 429-Fehler, obwohl ich noch Guthaben habe?
Ein Guthaben beantwortet, ob noch Mittel vorhanden sind; es beantwortet nicht, ob die aktuelle Anforderung in eine Ratenbeschränkung passt. Lesen Sie den Fehlertext und jeden Wartehinweis. Wenn der Fehler ein Konto- oder Kontingentproblem identifiziert, beheben Sie dieses Problem, anstatt anzunehmen, dass wiederholte verzögerte Übermittlungen es lösen.
Wann werden die GPT-Image-2.5-Rate-Limits zurückgesetzt?
Verwenden Sie die entsprechenden Antwort-Header oder die Kontomitteilung. Verschiedene Einschränkungen können unterschiedliche Fenster haben, und es gibt hier keine einzige Rücksetzzeit für alle Wege. Befolgen Sie eine vorgegebene Mindestwartezeit, reduzieren Sie das Tempo der Warteschlange und bewahren Sie den ursprünglichen Auftragsstatus, während Sie entscheiden, ob ein erneuter Versuch angemessen ist.
Entfernt die Nutzung von Atlas Cloud die GPT-Image-2.5-Rate-Limits?
Nein. Bewerten Sie Atlas als Zugriffsoption mit eigenem Endpunktverhalten und eigenen Kontobeschränkungen. Bestätigen Sie diese Details, bevor Sie das Volumen erhöhen. Ein praktischer Plan für GPT Image 2.5 Rate-Limits kombiniert verifizierte Kapazität, kontrollierte Übermittlungen, Aufgabenwiederherstellung und Abnahmeprüfungen, die vermeidbare Nacharbeit reduzieren.


