

Der how i become a millionaire in 30 days-Clip ist ein Witz darüber, einen Chatbot nach einer wundersamen Abkürzung zu fragen und die am wenigsten magische Antwort überhaupt zu bekommen: „Such dir einen Job.“ Der verletzte Blick der Figur, das hektische Tippen und der zweite Versuch sind die eigentliche Geschichte. Unten finden Sie zwei Online-Beispiele, die zeigen, wie dasselbe Setup mit einem Menschen und einem Haustier funktioniert. Dann bauen wir eine neue, längere Version mit einer originellen Figur, einem neuen Schauplatz, lesbarem Dialog und einer Reaktion, die lange genug anhält, um zu zünden.
Wichtigste Erkenntnisse
- Die erkennbare Abfolge ist die hoffnungsvolle Frage, die direkte Antwort, die beleidigte Pause und ein weiterer Versuch.
- Online-Versionen mit Mensch und Haustier ändern den Darsteller, behalten aber das Timing des Witzes bei.
- Unsere originelle 26-Sekunden-Spielplatzversion verwendet ein Kind als Darsteller und fügt lesbaren Dialog im Schnitt hinzu, anstatt ein Videomodell zu bitten, eine Telefonoberfläche zu zeichnen.
- Behandeln Sie „Such dir einen Job“ als eine geskriptete Pointe, nicht als Beweis dafür, was ein Chatbot antworten würde oder als echten Vermögensplan.
Was passiert in den Online-Versionen?
Das erste Online-Beispiel hält den Witz nah an einem alltäglichen Telefongespräch. Eine Person hebt ein Telefon mit vollem Selbstvertrauen, schaut für die Antwort nach unten und verliert diese Zuversicht abrupt. Beobachten Sie die Veränderung der Körperhaltung. Das Setup wird in Richtung Telefon gesprochen, aber die Pointe wird nach außen zum Zuschauer hin gespielt. Die Reaktion macht die kurze Zeile einprägsam.
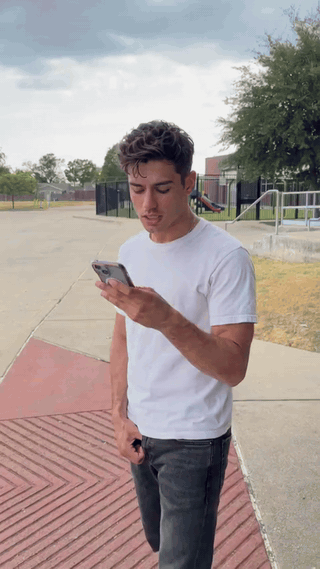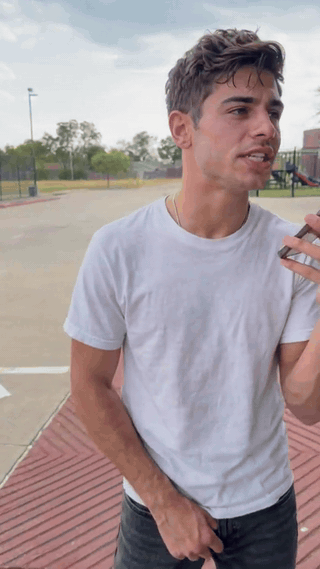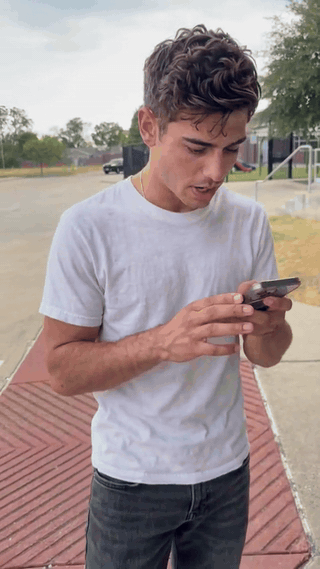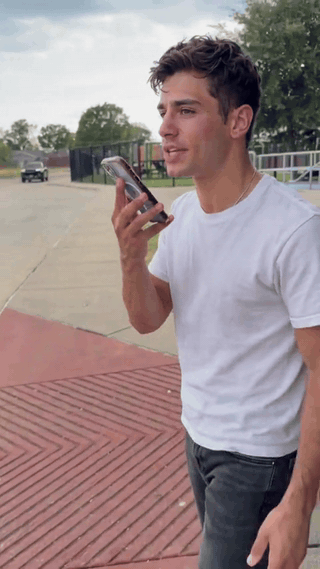
Online-Beispiel, menschliche Version. Der entscheidende visuelle Moment ist der Wechsel von hoffnungsvoller Darbietung zu sichtbarem Unglauben.
Das zweite Online-Beispiel setzt ein Haustier in dieselbe Rolle. Seine aufrechte Haltung und das Telefon-Requisit machen den Ehrgeiz absurd, bevor die Antwort eintrifft. Eine Kopfdrehung und ein langer Blick in die Kamera erledigen die Arbeit, die ein menschlicher Schauspieler mit Augenbrauen und einem gemurmelten Protest erledigen würde. Das ist mehr als ein Kostümwechsel: Die Körpersprache des Tieres verändert das Gefühl der Pointe, während die Frage und die Antwort erkennbar bleiben.
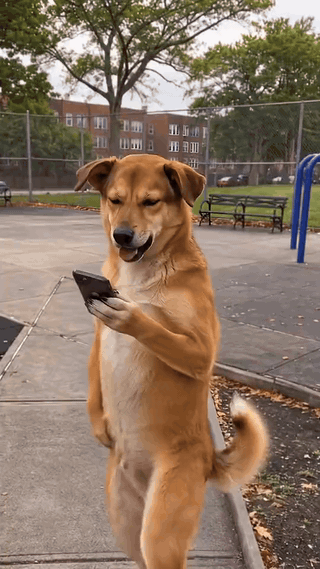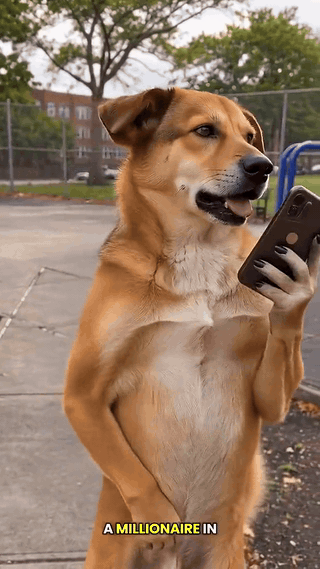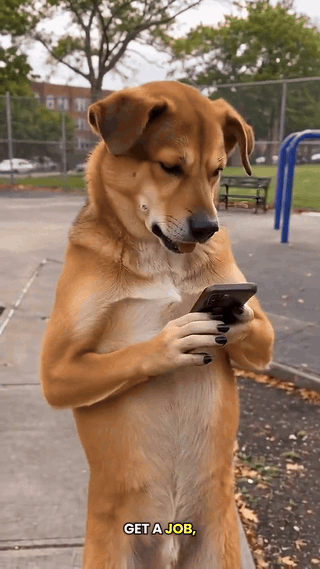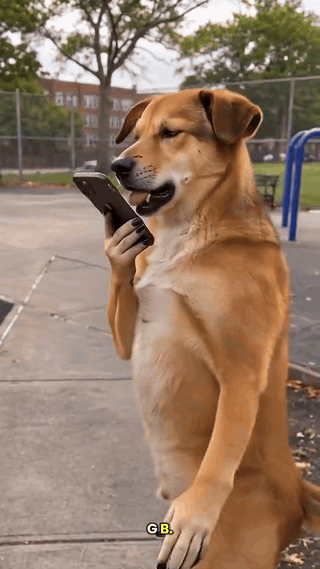
Online-Beispiel, Haustier-Version. Die Darbietung beruht auf einer aufrechten Haltung, einer lesbaren Telefongeste und dem verzögerten beleidigten Blick.
Dies sind Beispiele des kursierenden Videoformats, keine Aufzeichnungen, die eine bestimmte Chatbot-Antwort belegen. Eine Comedy-Sketch kann den Austausch inszenieren; ein KI-Remake kann den Darsteller generieren. Der Ausdruck „how I become“ wird hier beibehalten, weil er Teil der gesuchten Meme-Zeile ist, obwohl „how do I become“ normales Englisch ist. Keiner der Ausdrücke macht das Video zu einer Finanzberatung.
Die vier Schläge, die es erkennbar machen
| Schlag | Was die Zuschauer sehen | Warum es wichtig ist |
|---|---|---|
| Fragen | Ein Telefon wird hochgehalten, als könne es ein Geheimnis enthüllen | Das Selbstvertrauen der Figur baut eine übergroße Erwartung auf. |
| Antwort | „Such dir einen Job.“ erscheint oder wird vorgelesen | Die Antwort ist absichtlich schlicht und kurz. |
| Reagieren | Die Figur erstarrt, schaut auf oder starrt in die Kamera | Die Pause lässt das Publikum die Beleidigung gemeinsam mit der Figur entdecken. |
| Erneut fragen | Schnelles Tippen oder eine weitere Sprachnachricht | Die Figur lehnt die gewöhnliche Antwort ab und erweitert den Witz. |
Die Reihenfolge ist wichtiger als eine exakte Einstellungslänge. Wenn die Antwort kommt, bevor der Zuschauer die Frage versteht, gibt es keinen Kontrast. Wenn die Reaktion sofort abgeschnitten wird, hat die Pointe keinen Raum zum Atmen. Wenn die Figur einfach weggeht, verliert der Clip den hartnäckigen zweiten Versuch, der dieses Format ausmacht.
Wie erstellt man eine eigene Version?
Beginnen Sie mit der Struktur des Witzes und ändern Sie dann die Darbietung, den Schauplatz und das Ende. Wenn Sie das Filmmaterial einer anderen Person Einstellung für Einstellung nachspielen, wird das Ergebnis schwerer zu unterscheiden und Sie haben weniger Kontrolle über den Dialog. Für unsere Demonstration platzieren wir ein fiktives Kind auf einem sonnigen Spielplatz. Das Kind fragt mit heller Begeisterung nach einer Millionärs-Abkürzung und erhält dann die direkte Antwort „Such dir einen Job.“ Dieser Rat ist für ein Kind absichtlich absurd; der Wechsel von Entzücken zu Unglauben trägt den Witz. Der Telefonbildschirm zeigt zum Kind, sodass das Modell niemals App-Schaltflächen oder lesbare Nachrichten erfinden muss.
Die nützliche Design-Einschränkung besteht darin, Darbietung von Text zu trennen. Ein Videomodell kann eine Person animieren, die ein Telefon hochhält, liest, zurückschreckt und tippt. Es ist weniger zuverlässig darin, exakten Chat-Text auf einem sich bewegenden Telefon darzustellen. Wir generieren daher zuerst die Schauspielerei und fügen danach saubere, redaktionelle Untertitel hinzu. Die Untertitel geben die geskripteten Zeilen des Witzes wieder; sie werden nicht als Screenshot einer echten ChatGPT-Sitzung präsentiert.
1. Erstellen Sie ein konsistentes erstes Bild
Verwenden Sie ein Querformat-Bild im 16:9-Format, auf dem das Gesicht des Kindes, beide Hände und das Telefon sichtbar sind. Eine halbnahe Komposition lässt Raum für den Ausdruckswechsel, ohne die farbenfrohe Rutsche und die Schaukeln hinter dem Kind zu verlieren. Lassen Sie etwas unübersichtlichen Platz für Untertitel. Das erste Bild sollte hoffnungsvoll aussehen und nicht bereits schockiert.
Für diesen Artikel wird das erste Bild mit Seedream v5.0 Pro on Atlas Cloud generiert. Der Prompt ist bewusst konkret:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
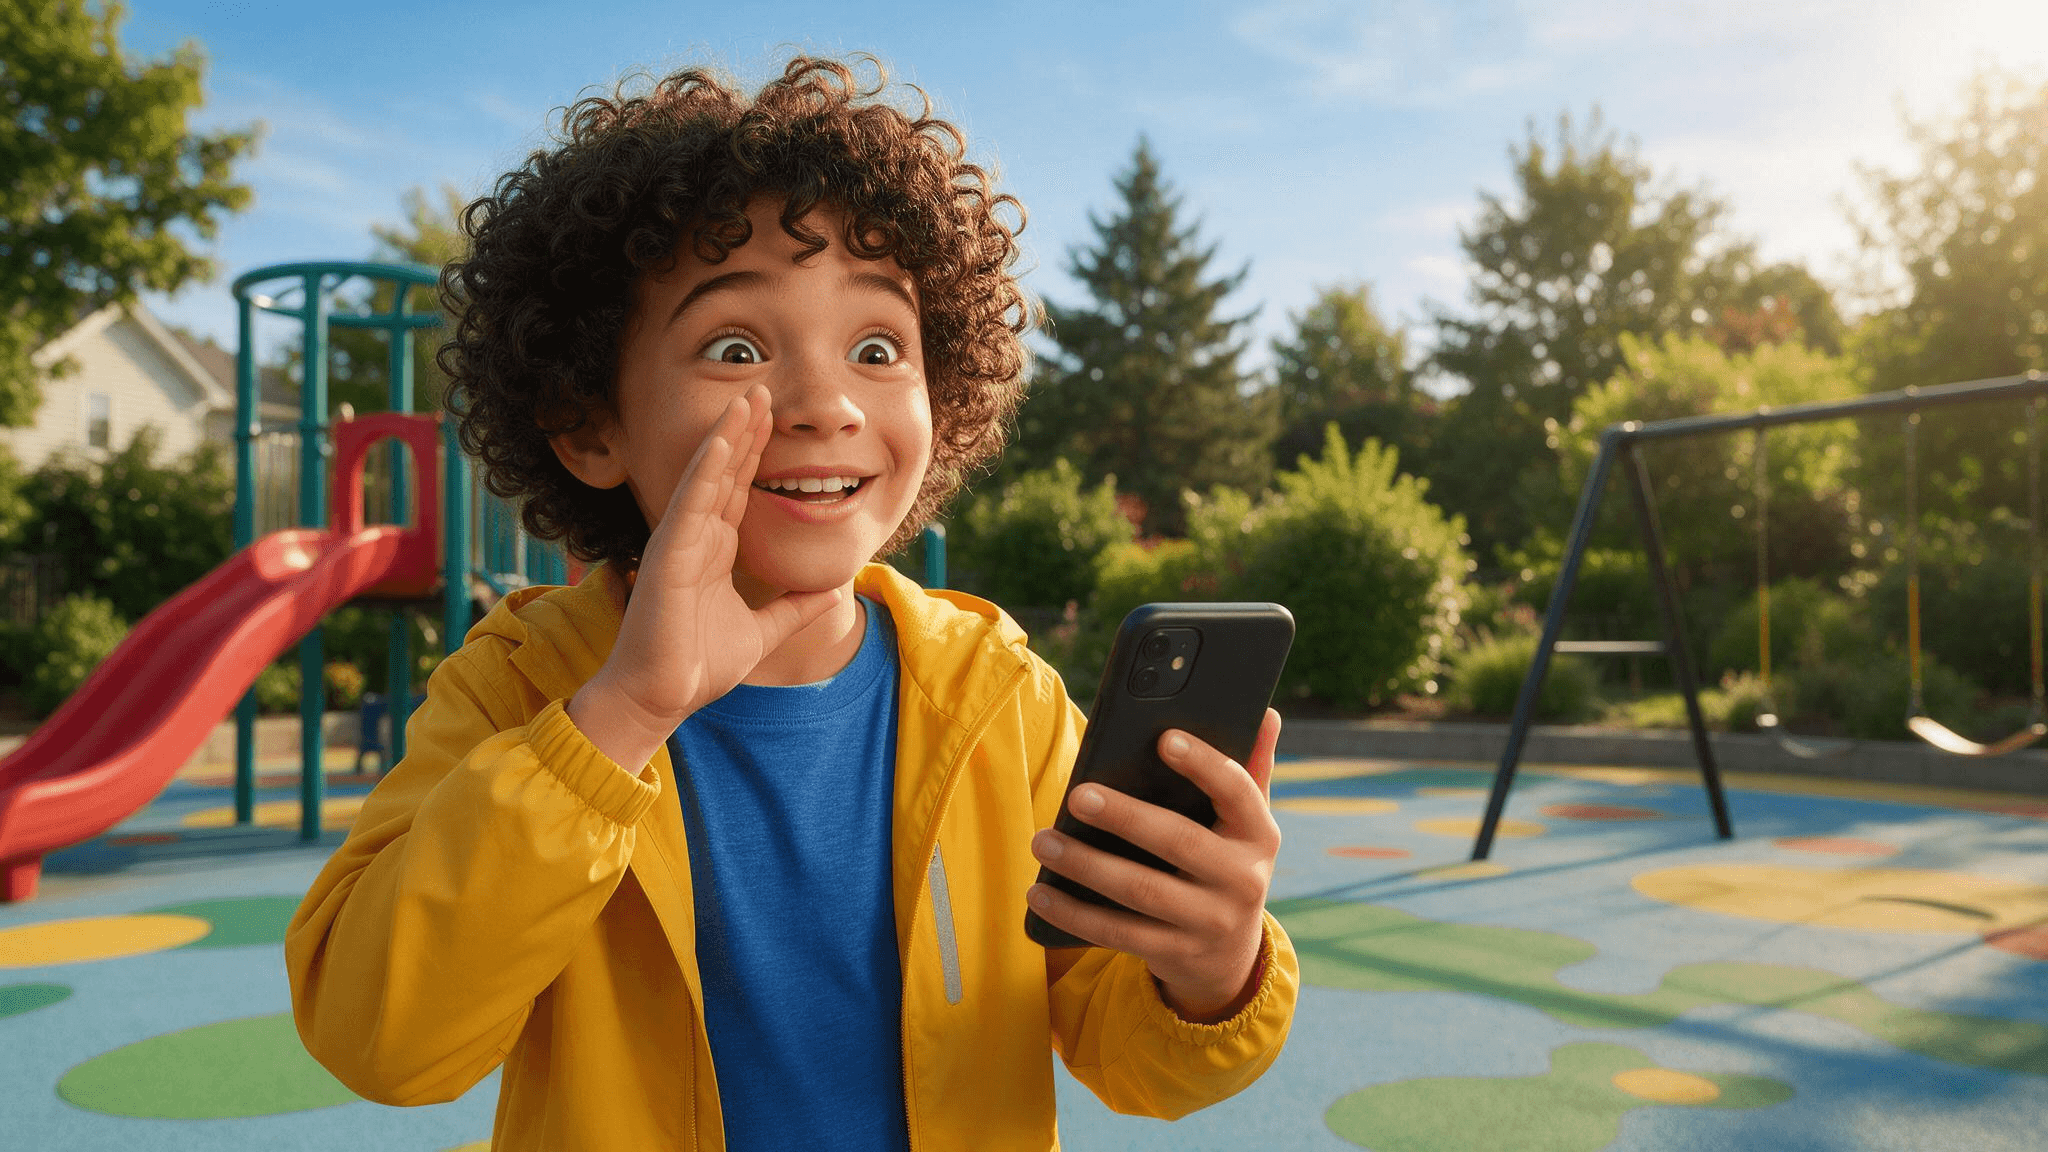
Unser generiertes Ausgangsbild. Das breite Lächeln und die erhobenen Brauen des Kindes etablieren den hoffnungsvollen Anfang; die Rutsche und die Schaukeln machen den neuen Schauplatz unverkennbar.
2. Animieren Sie eine vollständige Reaktion, kein bewegtes Porträt
Verwenden Sie das erste Bild als Bildeingabe für Seedance 2.5 Image-to-Video on Atlas Cloud. Wir setzen das Ziel auf 26 Sekunden, Querformat 16:9, mit Ton. Der Prompt fordert eine Abfolge unterschiedlicher Gesichtsreaktionen. Er bittet das Modell nicht, Chat-Bläschen anzuzeigen oder die Pointe zu buchstabieren, da diese genauen Worte im Schnitt hinzugefügt werden.
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
Der gelieferte Clip macht den emotionalen Wandel leicht nachvollziehbar: Das Kind beginnt mit einem Grinsen, öffnet den Mund vor Überraschung über die erste Antwort, runzelt die Stirn, tippt eine weitere Frage und gibt schließlich ein genervtes Schulterzucken von sich. Das zusätzliche Standbild unten isoliert den Moment, in dem die gewöhnliche Antwort den Millionärsplan des Kindes über den Haufen wirft.
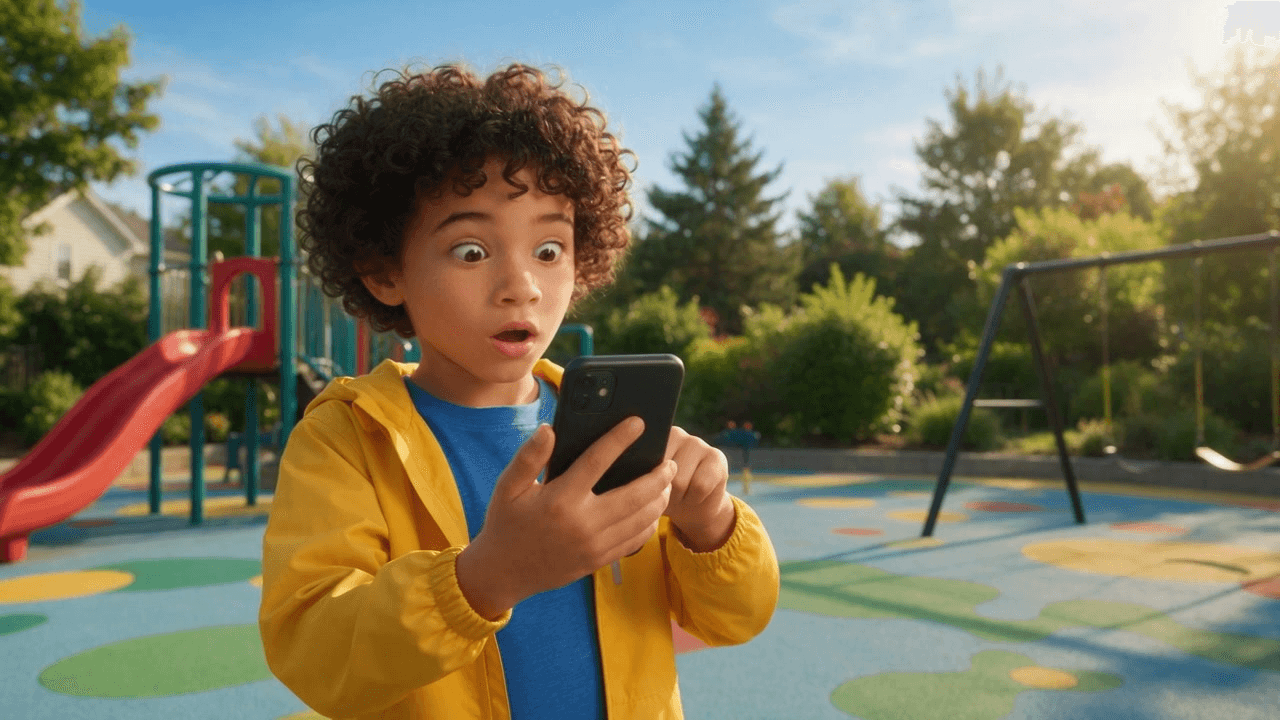
Standbild aus etwa 6 Sekunden des generierten Videos. Im Vergleich zum hoffnungsvollen ersten Bild machen die geweiteten Augen und der offene Mund die Wirkung der Pointe sofort sichtbar.
3. Fügen Sie exakten Dialog hinzu und halten Sie den Witz ohne Ton lesbar
Das kurze Skript reicht aus. Setzen Sie die Frage auf den Bildschirm, während das Kind das Telefon anspricht, bringen Sie „Such dir einen Job.“ erst ein, wenn das Kind die Antwort liest, und lassen Sie einen Moment vor dem Protest. Verwenden Sie für die Nachfrage eine neue Frage, anstatt die Eröffnung Wort für Wort zu wiederholen. Untertitel sollten in einem konsistenten sicheren Bereich mit starkem Kontrast sitzen und niemals das Gesicht oder die Hände verdecken.
| Moment in unserem 26-Sekunden-Schnitt | Redaktionelle Bildunterschrift | Darbietungshinweis |
|---|---|---|
| Eröffnung | „How I become a millionaire in 30 days?“ | Helle, sichere Darbietung zum Telefon. |
| Antwort | „Such dir einen Job.“ | Augen senken sich zum Bildschirm; Lächeln verschwindet. |
| Reaktion | „Im Ernst?“ | Überraschung weicht einem Stirnrunzeln vor dem Tippen. |
| Zweiter Versuch | „Okay, aber was, wenn ich diesen Teil überspringe?“ | Telefon kommt wieder hoch; Ton wird flehend. |
Halten Sie den Text kurz genug, um ihn auf einen Blick zu erfassen. Erfinden Sie keinen realistischen Chat-Screenshot, um zu beweisen, dass die Zeile von einer App generiert wurde. Eine klar gestaltete Bildunterschrift kommuniziert den geskripteten Austausch ehrlich und hält den 16:9-Clip auch ohne Ton verständlich. Der Originalton bleibt beim Video; die vier eingeblendeten Zeilen sind redaktionelle Untertitel.
4. Exportieren, prüfen und kennzeichnen
Exportieren Sie eine durchgehende MP4-Datei, anstatt einen Quellclip in mehrere Artikel-Einbettungen zu schneiden. Überprüfen Sie die tatsächliche Dauer nach dem Export. Die angeforderten 26 Sekunden sind nur dann von Bedeutung, wenn die Datei tatsächlich länger als 20 Sekunden ist und die zusätzliche Zeit sinnvolle Aktion enthält. In diesem Artikel ist das abschließende Originalbeispiel unten mit einem Vorschaubild eingebettet, damit die Leser die vollständige Sequenz an Ort und Stelle sehen können.
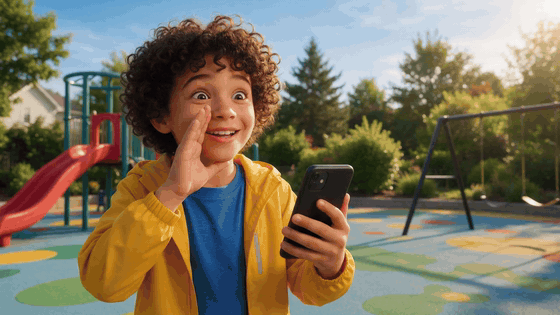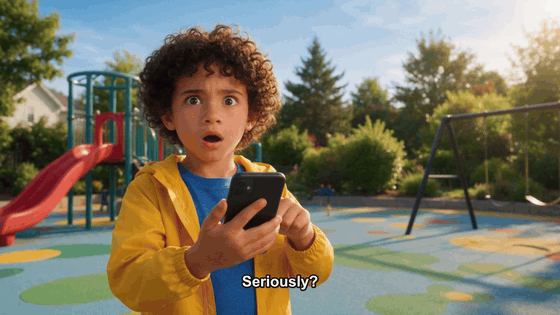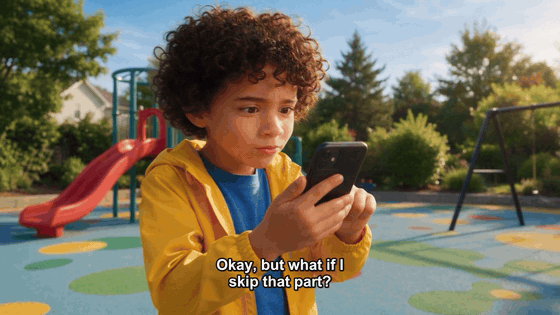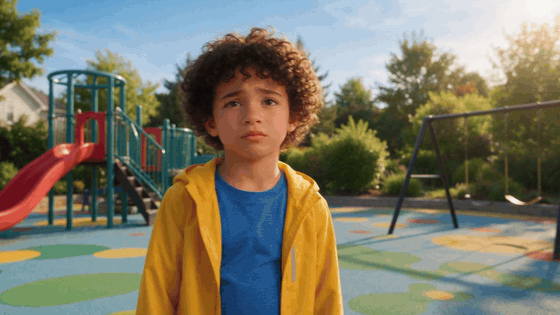
Unser Originalbeispiel: Ein Kind auf einem Spielplatz fragt, erhält die direkte Antwort, starrt ungläubig, tippt und versucht es erneut in einem 26-sekündigen Querformat-Video. Die Untertitel sind redaktionelle Ergänzungen zur generierten Darbietung.
Bevor Sie eine KI-generierte realistische Szene veröffentlichen, verwenden Sie die KI-Inhaltskennzeichnung der Plattform, wo dies zutreffend ist. TikToks Richtlinien für KI-generierte Inhalte erklären die Kennzeichnungswerkzeuge und Anforderungen für realistische KI-Medien. YouTubes Richtlinien für veränderte oder synthetische Inhalte beschreiben die Offenlegung während des Uploads. Verwenden Sie Ihr eigenes Abbild, eine fiktive Figur oder eine Teilnehmerin oder einen Teilnehmer, die oder der der Darstellung zugestimmt hat. Die beiden obigen Online-GIFs sind Beispiele zur Analyse; die Veröffentlichung eines Remakes erfordert Ihr eigenes Filmmaterial, Ihren eigenen Ton und Ihre eigenen Genehmigungen.
Was lässt die Pointe in einem längeren Schnitt zünden?
Eine 26-Sekunden-Version braucht mehr als zwei Kopien eines 13-Sekunden-Memes. Wir geben dem Kind einen sichtbaren Strategiewechsel. Zunächst wird das Telefon wie ein Abkürzungsautomat behandelt. Nach der Antwort wiederholt das Kind nicht einfach die Forderung: Es runzelt die Stirn, tippt, formuliert um und versucht, mit der Antwort zu verhandeln. Dieser Wechsel verwandelt den letzten Schlag in einen neuen Witz statt in Füllmaterial.
Die Lesbarkeit ohne Ton verändert auch den Schnitt. In einem Feed können Zuschauer den Clip stumm antreffen. Die Untertitel müssen die Frage und die Antwort zu den richtigen Momenten enthüllen, während die Bewegung des Darstellers die Emotion liefert. Die verzögerte „Im Ernst?“-Bildunterschrift sollte nicht während des ersten verblüfften Bildes erscheinen; der stille Blick kommt zuerst. In dieser winzigen Pause liest der Zuschauer das Gesicht.
Schließlich sollten Sie das Setup wahrheitsgemäß halten. Das Video ist eine inszenierte Comedy-Szene und die Zeile ist ein geskripteter Gag. Es zeigt keine echte Chatbot-Sitzung und verspricht nicht, dass jeder in 30 Tagen reich werden kann. Die nächste nützliche Aktion besteht darin, einen originellen Darsteller und Schauplatz zu wählen, die vier Schläge zu storyboarden und zu testen, ob jemand Ihren Entwurf ohne Ton verstehen kann. Wenn sie sowohl die Frage als auch den empörten zweiten Versuch identifizieren können, funktioniert das Format.
FAQ
Hat ein Chatbot wirklich mit „Such dir einen Job“ geantwortet?
Der Ausdruck ist die Pointe in einem Comedy-Format. Ein Video, das ihn zeigt, ist kein Beweis für einen echten Chatbot-Austausch oder eine Antwort, die Sie immer erhalten werden.
Kann ich das Meme mit einem Haustier oder einem Freund erstellen?
Ja, wenn Sie ein geeignetes Foto und die Genehmigung jeder gezeigten Person haben. Eine Haustier-Version benötigt klare Augen, Schnauze und Fellzeichnungen. Eine Freundes-Version benötigt ein klares Gesicht und die Zustimmung, mit den Zeilen dargestellt zu werden.
Warum ein Videomodell verwenden und dann Untertitel separat hinzufügen?
Das Modell übernimmt Bewegung und Schauspiel; ein Editor übernimmt den exakten Text. Die Trennung dieser Aufgaben vermeidet verstümmelte Telefonbildschirme und gibt Ihnen Kontrolle über das Timing der Pointe.
Überschreitet das Originalbeispiel hier 20 Sekunden?
Ja. Die gelieferte MP4-Datei wird nach dem Export verifiziert, anstatt sich nur auf die im Generator ausgewählte Dauer zu verlassen. Die zusätzliche Zeit wird für einen zweiten Versuch und eine abschließende Reaktion verwendet.





