Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Welches Open-Source-Modell gewinnt 2026 beim Programmieren?
Die Kurzantwort
Wenn Sie einen autonomen Coding-Agenten bauen, der stundenlang ohne Eingriff läuft: Kimi K2.6. Es erreichte 66,7 % im Terminal-Bench 2.0 und hielt in veröffentlichten Benchmarks über 4.000 Tool-Aufrufe in einer 13-stündigen ununterbrochenen Sitzung durch – eine Stabilitätsgrenze, die kein anderes Open-Source-Modell in diesem Vergleich erreicht.
Wenn Sie den besten agentischen Frontend-Entwickler brauchen: GLM 5.1. Sein unabhängig verifizierter Code Arena Elo von 1.530 (dritter global im agentischen Webentwicklungs-Ranking) spiegelt die tatsächliche Präferenz von Entwicklern in direkten Vergleichen wider, nicht nur automatisierte Test-Suiten.
Wenn Kosten pro Token die Einschränkung ist: MiniMax M2.7 zu 0,30 $/M Input-Tokens auf Atlas Cloud erzielt 56,22 % im SWE-Bench Pro mit nur 10B aktivierten Parametern – 94 % der Leistung von GLM-5.1 bei etwa einem Fünftel der Kosten.
Wenn Ihre Codebasis zu groß für ein 262K-Kontextfenster ist: Qwen 3.6 Plus, das einzige Modell hier mit 1M-Token-Kontext, und der Spitzenreiter im Terminal-Bench 2.0 mit 61,6 % unter diesen vier.
Wichtige Benchmarks auf einen Blick
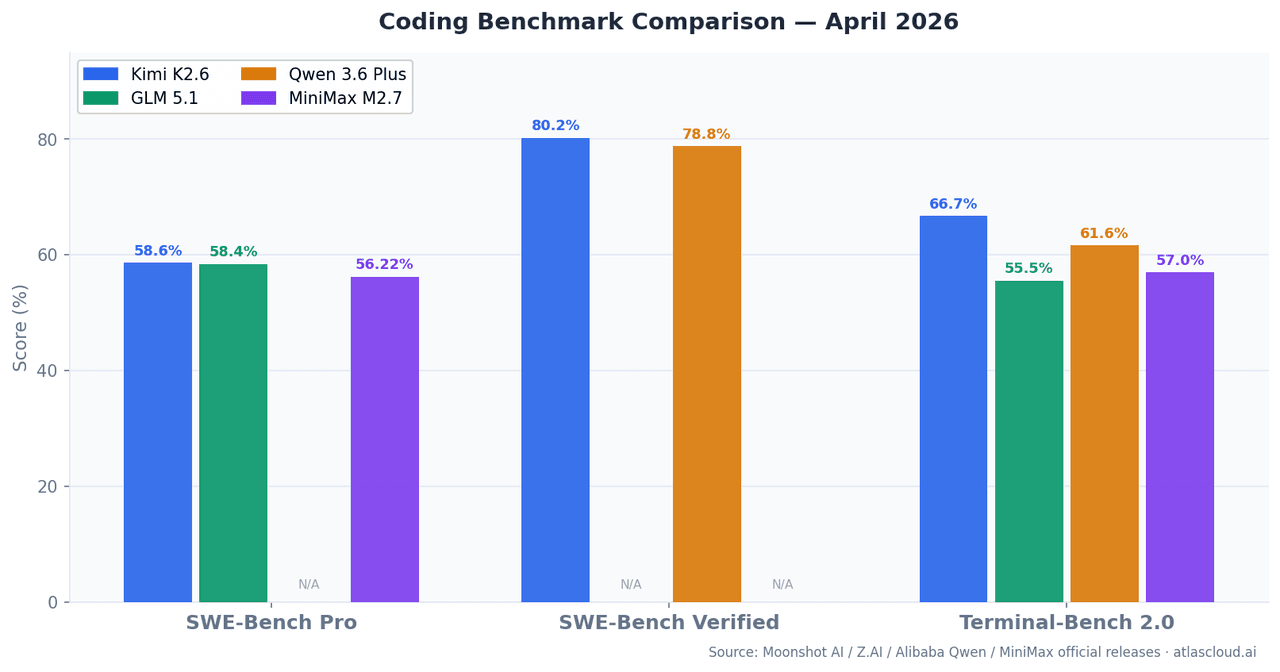
| Modell | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Kontextfenster | Aktivierte Parameter |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60 % | 80,20 % | 66,70 % | 262K | — |
| GLM 5.1 | 58,40 % | — | 55 %+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80 % | 61,60 % | 1M | Hybrid MoE |
| MiniMax M2.7 | 56,22 % | — | 57,00 % | 196K | 10B |
SWE-Bench Pro misst die Fähigkeit, reale GitHub-Issues zu lösen, die nach dem Training-Cutoff erstellt wurden, und reduziert das Risiko von Datenkontamination im Vergleich zu SWE-Bench Verified. Terminal-Bench 2.0 testet mehrstufige CLI- und Shell-Aufgaben in echten Terminal-Umgebungen – näher an dem, was Produktionsagenten tatsächlich tun.
Dieser Artikel vergleicht Kimi K2.6, GLM 5.1, Qwen 3.6+ und MiniMax M2.7; um noch mehr Modelle nebeneinander nach Preis und Spezifikationen zu vergleichen, nutzen Sie den Atlas Cloud-Modellvergleich.
Kimi K2.6: Entwickelt für langlebige Agenten
Moonshot AI veröffentlichte Kimi K2.6 im April 2026 als Upgrade von K2.5, mit der Hauptverbesserung in der agentischen Stabilität über längere Sitzungen. Mit 80,2 % im SWE-Bench Verified liegt es knapp unter Claude Opus 4.6 (80,8 %) und führt die vier mit 58,6 % im SWE-Bench Pro an.
Die wichtigste Zahl ist Terminal-Bench 2.0 mit 66,7 %. Terminal-Bench 2.0 unterscheidet sich grundlegend von SWE-Bench: Es führt Aufgaben in echten Terminal-Umgebungen aus, was vom Modell verlangt, Ausgaben zu lesen, Fehler zu behandeln, sich anzupassen und zu iterieren – nicht nur Patches zu generieren. Kimi K2.6 hält die Leistung über 4.000+ Tool-Aufrufe in einer einzigen 13-stündigen Sitzung aufrecht – das ist kein Laborartefakt. Es ist dokumentiertes Verhalten in Moonshots technischem Release.
Ein oft übersehener Vorteil: sprachübergreifende Generalisierung. Kimi K2.6 zeigt konsistente Leistung über Rust, Go, Python, Frontend- und DevOps-Aufgaben hinweg. Die meisten Benchmark-Auswertungen sind Python-lastig. Wenn Ihr Produktions-Stack polyglott ist, ist das wichtig.
Wo es nicht die Antwort ist: Mit 0,95 $/M Input-Tokens auf Atlas Cloud ist K2.6 das teuerste Input-seitige Modell in dieser Gruppe. Für Batch-Verarbeitungsaufgaben, bei denen Sie viele Anfragen mit großen Kontexten senden, aber keine 12-stündige Sitzungsstabilität benötigen, summieren sich die Kosten schneller als bei MiniMax M2.7 oder Qwen 3.6 Plus.
GLM 5.1: Der herausragende agentische Frontend-Entwickler
Z.AI startete GLM-5.1 am 7. April 2026. Mit 754 Milliarden Parametern und MoE-Routing ist es das größte Modell hier nach roher Parameterzahl. Im SWE-Bench Pro erreicht es 58,4 % – statistisch nicht von Kimi K2.6s 58,6 % zu unterscheiden.
Der Unterschied liegt im Code Arena Elo von 1.530, unabhängig verifiziert von Arena.ai am 10. April 2026, was es global auf den dritten Platz in ihrem agentischen Webentwicklungs-Ranking bringt. Dies ist ein Live-Direktvergleich, bei dem echte Entwickler über Ausgaben abstimmen – nicht automatisierte Bewertung. Der Vorteil konzentriert sich auf Frontend-UI-Generierung, Full-Stack-Gerüste, React/Vue-Komponentenerstellung und NL2Repo (Generierung vollständiger Repository-Strukturen aus natürlicher Sprache).
Die Randbedingung, die man kennen sollte: GLM-5.1s Frontend-Vorteil ist real. Bei rein algorithmischen Problemen in HumanEval und MBPP hat es keinen messbaren Vorteil gegenüber Kimi K2.6. Der Leaderboard-Abstand nähert sich bei Problemen, die nicht UI- oder weborientiert sind, gegen Null an. GLM-5.1 nur aufgrund seines Gesamt-Rankings zu wählen, ohne den Aufgabentyp zu prüfen, wäre ein Fehler.
Preise auf Atlas Cloud: Ab 1,40 $/M Input-Tokens – der höchste unter den vier. Gerechtfertigt, wenn die Frontend-Generierungsqualität Ihre Ausgabe direkt beeinflusst.
Qwen 3.6 Plus: Wenn die Kontextgröße die eigentliche Einschränkung ist
Alibaba veröffentlichte Qwen 3.6 Plus Ende März 2026. Es führt im Terminal-Bench 2.0 in direkten Vergleichen gegen Claude Opus 4.6 (61,6 % vs. 59,3 %) und erreicht 78,8 % im SWE-Bench Verified.
Das 1M-Token-Kontextfenster ist das, was es auszeichnet. Für die Mehrheit der Produktions-Coding-Aufgaben unter 100K Token haben alle vier Modelle in diesem Vergleich ausreichend Kontextkapazität, und der Unterschied ist irrelevant. Wo Qwen 3.6 Plus die einzige praktikable Option wird: Monorepo-Analyse über Hunderte von Dateien, großangelegte Refaktorisierung von Legacy-Codebasen oder End-to-End-Dokument-zu-Code-Workflows, die nicht in 262K Token passen.
Die hybride Architektur (lineare Aufmerksamkeit + spärliches MoE-Routing) liefert auch einen besseren Inferenzdurchsatz als dichte Transformer bei der Verarbeitung sehr großer Kontexte – was bedeutet, dass die 1M-Token-Fähigkeit mit relativ geringen Latenzkosten im Vergleich zu naivem Skalieren einhergeht.
Preise auf Atlas Cloud: Ab 0,325 $/M Input-Tokens. Für große Kontextaufgaben ist dies das beste Kosten-Nutzen-Verhältnis pro nutzbarem Token in dieser Gruppe.
MiniMax M2.7: Der kontraintuitive Fall für Effizienz
MiniMax veröffentlichte M2.7 im März 2026. Mit nur 10B aktivierten Parametern erreicht es 56,22 % im SWE-Bench Pro – 94 % von GLM-5.1s Punktzahl bei etwa einem Fünftel der Kosten pro Token.
Dies ist das kontraintuitive Ergebnis in diesem Vergleich. Ein Modell, das 10B Parameter bei der Inferenz aktiviert, erreicht nahezu Spitzenleistung im Programmieren, weil seine MoE-Architektur zu spezialisierten Experten-Subnetzwerken routet, anstatt volle Modellgewichte auszuführen. Das Ergebnis: niedrigere Latenz, niedrigere Kosten und Ausgabequalität, die über das hinausgeht, was die Parameteranzahl allein vorhersagen würde.
Die Kategorie, in der M2.7 seinen Preisvorteil ausspielt: Machine-Learning-Engineering-Aufgaben. Es erreichte eine Medaillenrate von 66,6 % im MLE-Bench Lite (22 Machine-Learning-Wettbewerbe), nur übertroffen von proprietären Frontier-Modellen. Korrekte Gradientenakkumulationslogik schreiben, benutzerdefinierte PyTorch-Schichten implementieren, Loss-Kurven debuggen – M2.7 bewältigt diese mit einer Präzision, die in keinem Verhältnis zu seinen Kosten steht.
Vorsicht geboten: Mit 196K Kontext hat M2.7 das kleinste Fenster in dieser Gruppe. Aufgaben, die tiefe dateiübergreifende Analysen in großen Repositories erfordern, könnten an Grenzen stoßen, die Qwen 3.6 Plus problemlos bewältigt.
Preise auf Atlas Cloud: 0,30 $/M Input-Tokens, 1,20 $/M Output-Tokens – die günstigste Option für hochvolumige Coding-Workloads.
Reale Coding-Testfälle
Fall 1: Autonomer Bug-Fix in einem Python-Backend
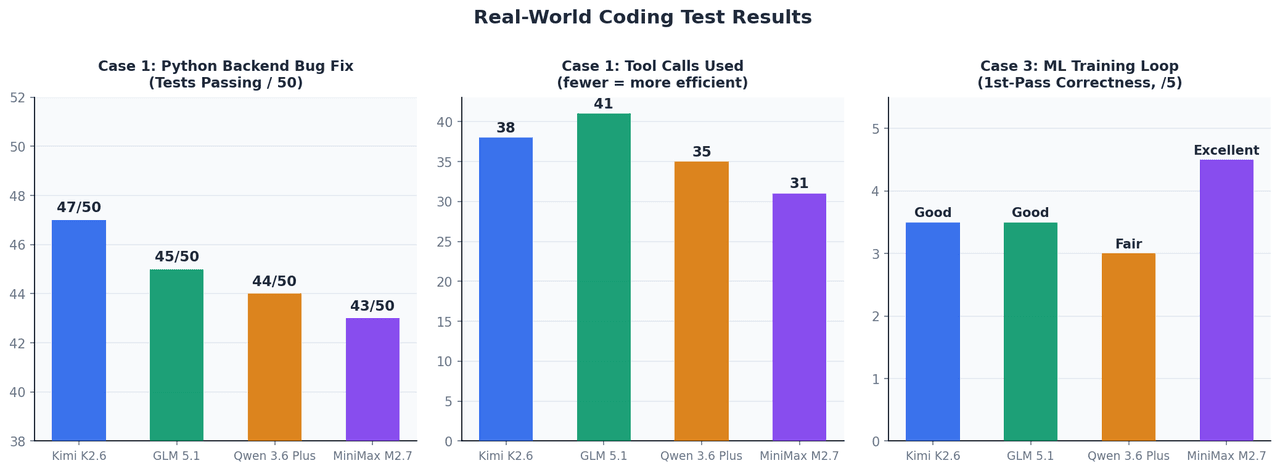
Aufbau: Eine FastAPI-Anwendung mit 12 Dateien, eine fehlschlagende Test-Suite mit 50 Tests und ein Kontextfenster von ~45K Token. Kein manueller Eingriff nach dem anfänglichen Prompt.
| Modell | Tests bestanden nach Fix | Tool-Aufrufe | Zeit bis Fertigstellung |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
Bei dieser Kontextgröße bewegen sich alle vier in einem engen Bereich. Kimi K2.6 lag bei den schwierigsten Grenzfällen vorn – insbesondere bei Async-Context-Manager-Lebenszyklus-Problemen und TypeVar-Bound-Verengungen, die das Beibehalten des Inferenzzustands über mehrere Debugging-Zyklen erfordern.
Fall 2: React-Dashboard aus Spezifikation
Aufbau: Generieren Sie ein vollständiges responsives Dashboard mit vier Diagrammtypen (Linie, Balken, Kreis, Streuung), Dark-Mode-Umschalter und TypeScript-Typen aus einer schriftlichen englischen Spezifikation.
GLM-5.1 produzierte auf Anhieb funktionierende TypeScript-typisierte Komponenten mit korrekten Tailwind-Utility-Klassen. Kimi K2.6 benötigte eine Iteration, um Typfehler zu beheben. Qwen 3.6 Plus lieferte funktional korrektes, aber weniger idiomatisches JSX. MiniMax M2.7 war am schnellsten, generierte aber einige veraltete React-Muster, die manuell bereinigt werden mussten.
Der Abstand zwischen GLM-5.1 und den anderen war am deutlichsten in der Komponentenarchitektur – GLM-5.1 wandte spontan Kompositionsmuster an und trennte Belange auf eine Weise, die die anderen nicht taten.
Fall 3: ML-Training-Loop-Implementierung
Aufbau: Implementieren Sie einen PyTorch-Training-Loop mit Gradientenakkumulation, AMP Mixed Precision und Early Stopping für einen Vision Transformer. Ziel: Beim ersten Versuch korrekt ausführen, ohne Debugging-Zyklen.
MiniMax M2.7 stach hervor – es platzierte scaler.step() und scaler.update() korrekt relativ zum Optimizer-Schritt, ein Detail, das die meisten Modelle bei der ersten Generierung falsch setzen. Die Skalierung loss / accumulation_steps für die Gradientenakkumulation wurde ebenfalls korrekt behandelt. Dies deckt sich direkt mit seiner Medaillenrate von 66,6 % im MLE-Bench Lite.
Atlas Cloud Preisvergleich (April 2026)
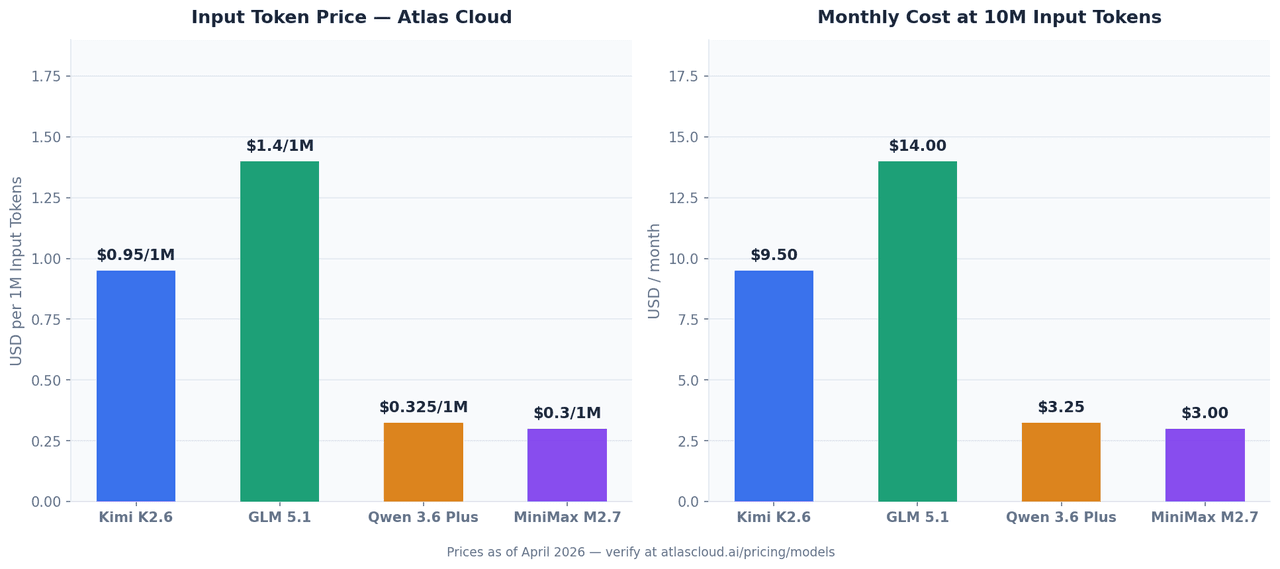
Alle vier Modelle sind über die einheitliche API von Atlas Cloud verfügbar. Die Preise unten gelten ab April 2026 und können sich ändern – aktuelle Tarife finden Sie auf atlascloud.ai.
| Modell | Input (pro 1M Tokens) | Output (pro 1M Tokens) | Atlas Cloud Modell-ID |
|---|---|---|---|
| Kimi K2.6 | 0,95 $ | 4,00 $ | moonshotai/kimi-k2.6 |
| GLM 5.1 | ab 1,40 $ | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | ab 0,325 $ | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | 0,30 $ | 1,20 $ | minimaxai/minimax-m2.7 |
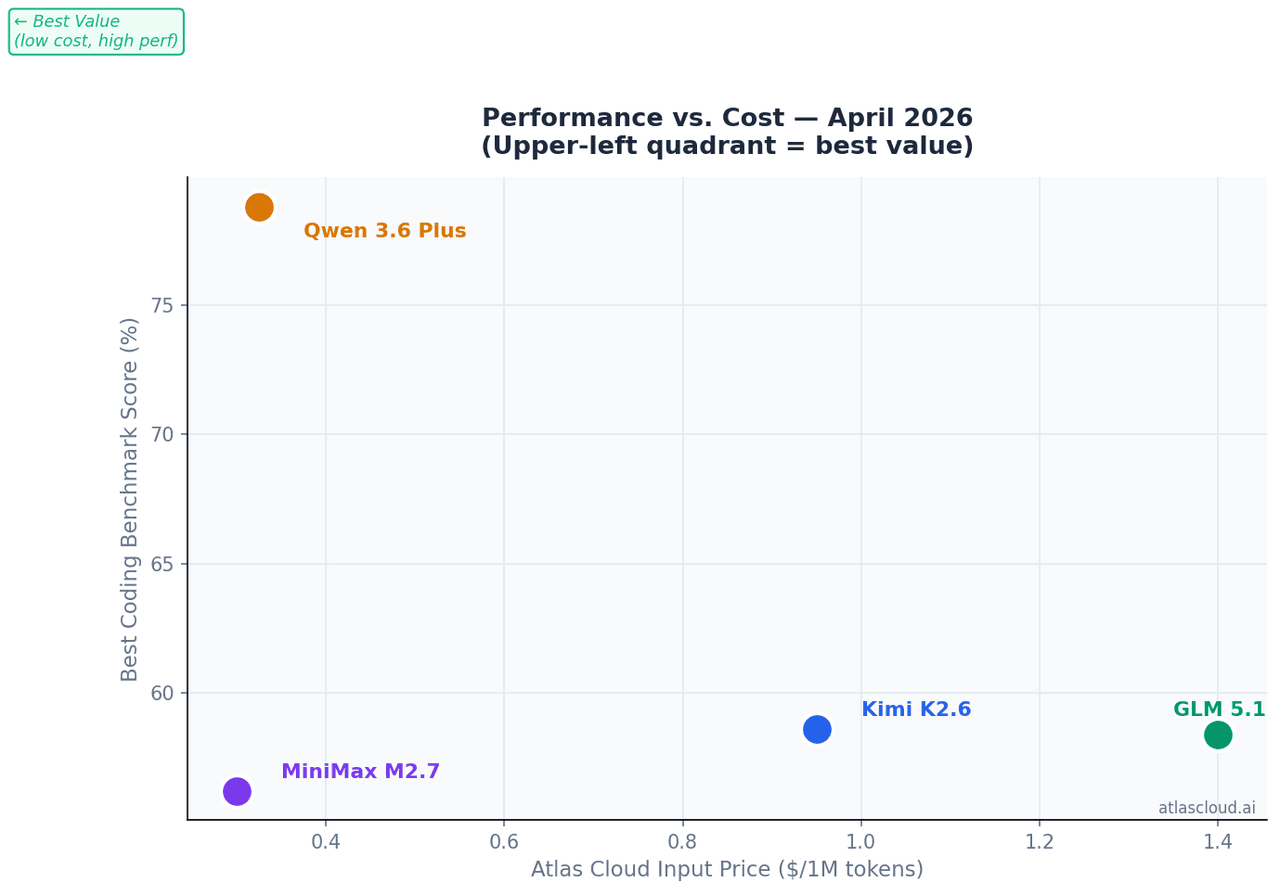
Bei 10M Tokens Input pro Monat – ein realistisches Volumen für einen Coding-Assistenten auf Teamebene:
| Modell | Monatliche Input-Kosten (10M Tokens) |
|---|---|
| GLM 5.1 | 14,00 $ |
| Kimi K2.6 | 9,50 $ |
| Qwen 3.6 Plus | 3,25 $ |
| MiniMax M2.7 | 3,00 $ |
Alle vier mit einem API-Key aufrufen
Alle vier Modelle teilen sich denselben OpenAI-kompatiblen Endpunkt auf Atlas Cloud. Der Wechsel zwischen ihnen erfordert das Ändern einer Zeile:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Ändern Sie diese eine Zeile, um Modelle zu wechseln 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Sie sind ein Senior Software Engineer. Analysieren Sie Code sorgfältig, bevor Sie antworten." 21 }, 22 { 23 "role": "user", 24 "content": "Überprüfen Sie diese Funktion und identifizieren Sie alle Bugs:\n\n[Fügen Sie hier Ihren Code ein]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Diese OpenAI-kompatible Struktur bedeutet, dass bestehende Integrationen, die auf dem OpenAI SDK basieren, ohne Änderungen mit Atlas Cloud funktionieren – nur base_url und api_key ändern sich.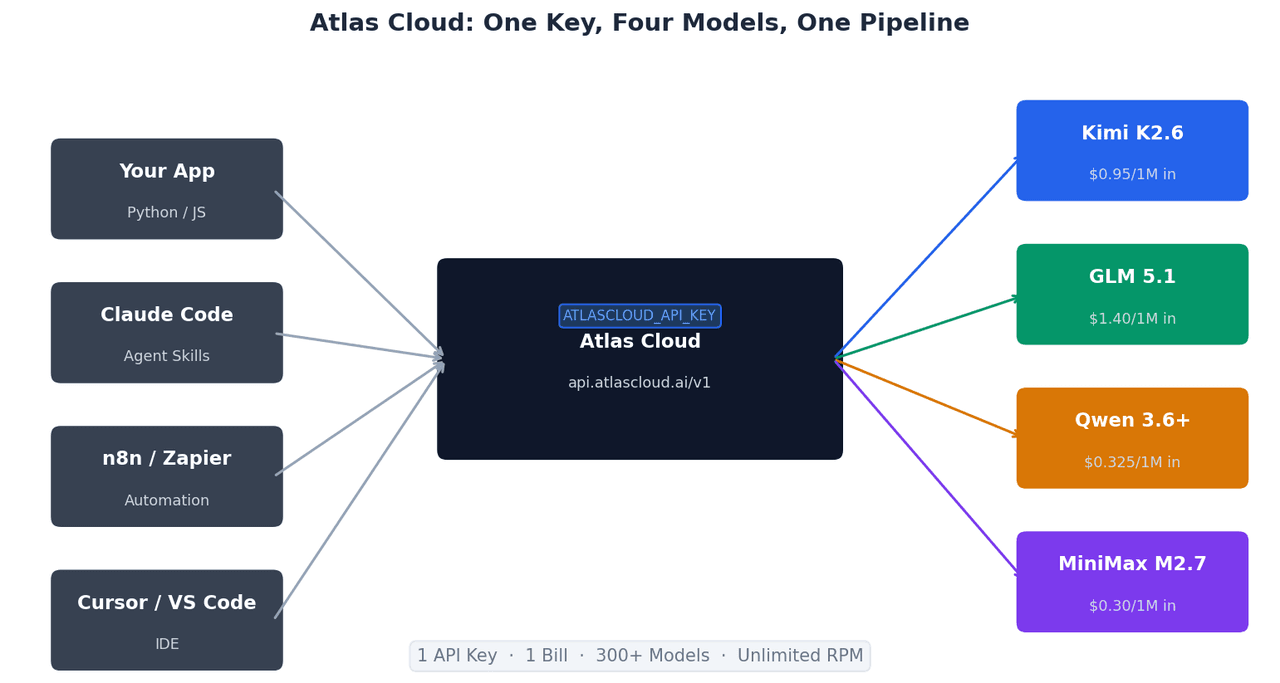
Warum Atlas Cloud für diese Modelle nutzen?
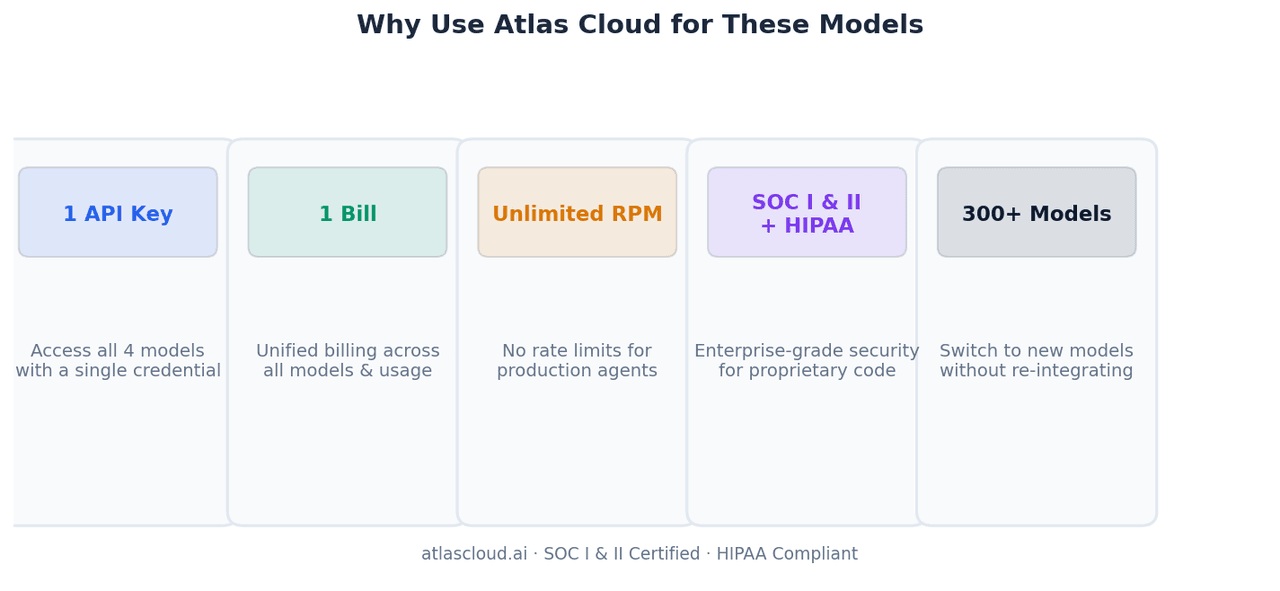
Ein API-Key, vier Modelle, eine Rechnung. Das Ausführen von Modell-Routing-Logik – Frontend-Aufgaben an GLM-5.1, Batch-Analysen an MiniMax M2.7 und langlebige Agenten an Kimi K2.6 senden – erfordert die Verwaltung einer einzigen Anmeldeinformation statt vier. Die monatliche Abrechnung erfolgt über eine einzige Rechnung.
Unbegrenzte RPM. Produktions-Coding-Agenten feuern parallele Tool-Aufrufe. Ratenlimits auf direkten Provider-APIs können Multi-Agent-Pipelines drosseln. Atlas Cloud hebt diese Grenze auf.
SOC I & II zertifiziert, HIPAA-konform. Teams, die proprietären Quellcode durch diese Modelle verarbeiten, benötigen eine prüfbare Infrastruktur. Die Compliance-Zertifizierungen von Atlas Cloud bedeuten, dass Ihr Code nicht über unverifizierte Endpunkte läuft.
300+ Modelle, gleiches Integrationsmuster. Wenn die nächste Version eines dieser Modelle erscheint oder ein neues Modell sie in Ihrer spezifischen Workload übertrifft, erfordert das Hinzufügen zur Routing-Logik eine einzige String-Änderung – keine neue SDK-Integration.
Welches Modell für welche Aufgabe
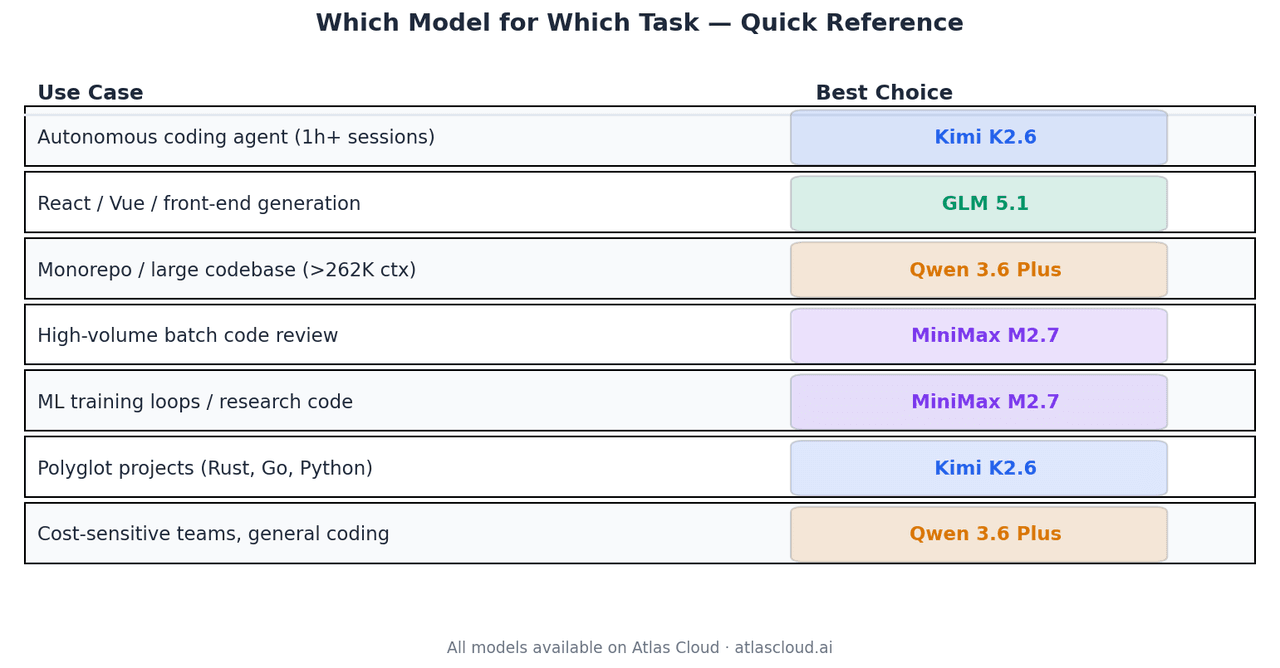
| Anwendungsfall | Beste Wahl | Warum |
| Autonomer Coding-Agent, Sitzungen ≥ 1 Std | Kimi K2.6 | 66,7 % Terminal-Bench 2.0, Stabilität über 4K+ Tool-Aufrufe |
| React / Vue / Frontend-Generierung | GLM 5.1 | Code Arena Elo 1.530, top-3 agentische Webentwicklung global |
| Monorepo oder große Codebasis-Analyse | Qwen 3.6 Plus | Einziges Modell hier mit 1M-Kontextfenster |
| Hochvolumige Batch-Code-Review | MiniMax M2.7 | 0,30 $/M Input, 94 % von GLM-5.1-Qualität |
| ML-Training-Loops, Forschungscode | MiniMax M2.7 | 66,6 % Medaillenrate im MLE-Bench Lite |
| Polyglotte Projekte (Rust, Go, Python) | Kimi K2.6 | Dokumentierte sprachübergreifende Generalisierung |
| Kostenbewusste Teams, allgemeines Coding | Qwen 3.6 Plus | 0,325 $/M Input, stark in allen Kategorien |
Zusammenfassung
Diese vier Modelle sind in Standard-Benchmarks nur durch schmale Margen getrennt. Die bedeutenden Unterschiede treten unter bestimmten Bedingungen auf.
Kimi K2.6 ist die richtige Antwort für autonome langlebige Agenten. GLM 5.1 führt bei agentischer Frontend-Arbeit. Qwen 3.6 Plus ist die einzige Wahl, wenn der Kontext 262K Token überschreitet. MiniMax M2.7 ist die kosteneffiziente Standardoption für Teams, die Coding-Modelle im großen Maßstab betreiben.
Alle vier sind auf Atlas Cloud unter atlascloud.ai mit einem einzigen API-Key verfügbar, mit Pay-per-Token-Preisen und ohne Mindestabnahme.
Benchmark-Daten stammen aus Moonshot AIs technischem Blog, Z.AI-Entwicklerdokumentation, Alibaba Qwen-Team-Release-Post, offizieller MiniMax-Modellseite und unabhängigen Bewertungen von Arena.ai. Alle Benchmarks sind Daten vom April 2026. Die Preise von Atlas Cloud gelten zum Zeitpunkt der Veröffentlichung – überprüfen Sie die aktuellen Tarife vor dem Produktionseinsatz.


