Zwei Personen sitzen sich an einem Tisch gegenüber. Eine Zeile beginnt, dann bewegen sich beide Münder. Ein Gegenschuss kommt, und die Stimme scheint nicht mehr zum Gesicht zu gehören. Das ist das Scheitern, das Kreative vermeiden wollen, wenn sie nach einem Kling 4 Dialog-Lippensynchronisationstest suchen.
Dieser Artikel beginnt mit einer Versionsprüfung und führt dann 3 kurze, reproduzierbare Dialogtests mit der verifizierten Kling 3.0-Familie durch: ein Sprecher, 2 Sprecher abwechselnd und ein gemischter englisch-spanischer Austausch. Jeder Test verwendet natives Audio zum Generierungszeitpunkt; der Artikel zeigt die visuellen Ergebnisse als GIFs neben derselben 10-Punkte-Bewertungstabelle. Dies sind einzelne Durchläufe, kein universeller Benchmark.
Wichtige Erkenntnisse
- Kuaishou hat offiziell Kling 3.0 angekündigt, kein separat spezifiziertes Kling 4 Dialogmodell.
- Kurze, benannte, abwechselnde Zeilen geben einem Prüfer eine klarere Grundlage zur Überprüfung der Sprecherzuordnung.
- GIFs machen Gesichtsbewegungen und Sprecherwechsel leicht erkennbar, während die Quell-MP4 weiterhin benötigt wird, um das Audio-Timing zu überprüfen.
- Behandeln Sie einen 10-Sekunden-Durchlauf als Skriptprüfung, bevor Sie in eine anspruchsvollere Produktionsversion investieren.
- Prüfen Sie den stillen Zuhörer genauso genau wie die sprechende Person.
Kling 4 Dialog-Lippensynchronisationstest: Zuerst die Versionsprüfung
Der Begriff „Kling 4“ sammelt derzeit mehrere verschiedene Dinge in Suchergebnissen: 4K-Ausgabe, Kling 3.0, Kling Video O3, Vorab-Sprache und unbestätigte Benennung. Zum Zeitpunkt dieses Tests konnte ich keine offizielle Kuaishou-Spezifikation für ein veröffentlichtes „Kling 4“-Dialogmodell finden. Ein unbestätigtes Label als fertiges Produkt zu bezeichnen, würde den Test weniger nützlich machen.
Der verifizierbare aktuelle Referenzpunkt ist Kling AI 3.0. Kuaishou kündigte die Familie Video 3.0, Video 3.0 Omni, Image 3.0 und Image 3.0 Omni am 5. Februar 2026 an. Die Ankündigung beschreibt natives Audio über Sprachen, Dialekte und Akzente hinweg; Dialogszenen mit kontrollierter Sprechreihenfolge; Multi-Shot-Regie; und Videolängen bis zu 15 Sekunden (Kuaishou Technology, Februar 2026).
Diese Produktaussage setzt ein nützliches Testziel. Sie zertifiziert nicht jeden generierten Clip. Natives Audio bedeutet, dass das Modell Audio als Teil des Videoauftrags generieren kann. Es garantiert nicht, dass sich ein bestimmter Mund bei jedem Konsonanten schließt, dass ein Zuhörer still bleibt oder dass ein Schnitt die Sprecheridentität bewahrt. Das sind die Details, die dieser Test prüft.
Die 3 Durchläufe unten bewahren das visuelle Ergebnis mit der Bewertungstabelle auf, damit ein Leser dieselben Beweise bewerten kann, die die schriftlichen Notizen informiert haben.
Was wir getestet haben
Das Protokoll entfernt absichtlich Ausreden. Jede Szene verwendet 16:9-Bildformat, eine Dauer von 10 Sekunden, natives Audio aktiviert oder auf Auto gesetzt, wo der Playground diese Einstellung bietet, keine Musik und keine Postproduktions-Lippensynchronisation. Jeder sichtbare Sprecher bekommt eine kurze Zeile. Die GIFs des Artikels bewahren die visuelle Leistung; überprüfen Sie die Original-MP4-Dateien separat, wenn Sie das Klang-Timing beurteilen.
| Test | Modell | Dauer | Sichtbare Charaktere | Sprache | Gesprochene Zeilen | Hauptbewertungsziel |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 Sekunden | 1 | Englisch | 1 | Erste Silbe, Laute mit geschlossenen Lippen, Endpause |
| 2 | Kling V3.0 Standard T2V | 10 Sekunden | 2 | Englisch | 2 | Korrekte Sprecher- und ruhige Zuhörer-Verhalten |
| 3 | Kling V3.0 Pro T2V | 10 Sekunden | 2 | Englisch und Spanisch | 2 | Sprachwechsel, Zuordnung und Gesichtskontinuität |
Die Bewertungstabelle vergibt für jede Kategorie 0, 1 oder 2 Punkte. Eine 2 bedeutet, dass das Verhalten für das beabsichtigte 10-Sekunden-Beispiel klar genug ist. Eine 1 bedeutet, dass es teilweise überzeugend ist, aber einer weiteren Prüfung bedarf. Eine 0 bedeutet, dass ein Betrachter das Problem deutlich sehen kann. Die Gesamtsumme ist eine Aufzeichnung eines generierten Ergebnisses unter einem Prompt, keine Aussage über alle Ausgaben des Modells.
| Kategorie | 0 Punkte | 1 Punkt | 2 Punkte |
|---|---|---|---|
| Mund-zu-Wort-Timing | Offensichtliche Abweichung | Folgt meist mit sichtbaren Fehlern | Timing wirkt durchgehend natürlich |
| Korrekte Sprecherzuordnung | Falscher oder geteilter Sprecher | Ein unsicherer Moment | Jede Zeile gehört zur benannten Person |
| Verhalten des stillen Zuhörers | Zuhörer spricht oder formt Wörter | Kleinere vereinzelte Mundbewegung | Zuhörer bleibt natürlich aufmerksam |
| Gesichtsausdruck-Kontinuität | Gesicht bricht sichtbar oder wechselt | Kleine Instabilität | Ausdruck bleibt kohärent |
| Audio-Kontinuität über einen Schnitt | Stimme löst sich oder ändert sich abrupt | Übergang ist bemerkbar | Schnitt unterstützt denselben Dialogtakt |
Das Testdesign beantwortet auch die wahrscheinlichen Fan-out-Fragen hinter dieser Suche: Ist Kling 4 veröffentlicht, welches aktuelle Modell kann Dialoge generieren, können 2 Personen abwechseln, wie kann ein Creator verhindern, dass beide Charaktere sprechen, funktioniert gemischtsprachiger Dialog, und was sollte ein kleines Testbudget abdecken?
Kling-Dialogtest #1: Ein Sprecher, eine kurze Zeile
Eine einzelne Person, die eine kurze Zeile sagt, ist die Baseline. Sie isoliert die frühesten nützlichen Prüfungen: die erste Mundöffnung, einen Verschluss um einen „p“- oder „b“-Laut und den entspannten Takt nach dem Ende der Sprache. Wenn diese Baseline falsch aussieht, machen ein weiterer Charakter, ein Kameraschnitt oder eine andere Sprache die Diagnose nur schwieriger.
Dieser Durchlauf verwendet eine fiktive Büroangestellte namens Maya. Die Szene hat eine kleine Handgeste und eine direkte Blicklinie, aber keine schnelle Kamerabewegung. Das lässt Mund und Stimme als Hauptbeweise übrig.
Durchlaufeinstellungen: 16:9, 10 Sekunden, höchste verfügbare Playground-Auflösung zum Laufzeitpunkt, natives Audio Ein oder Auto, keine Hintergrundmusik. Modell: Kling V3.0 Standard Text-to-Video.
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
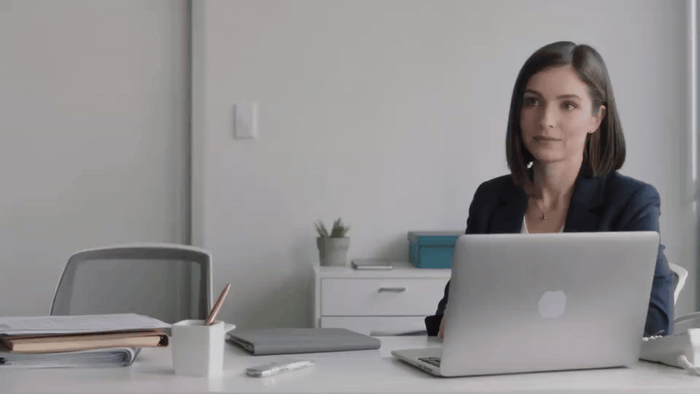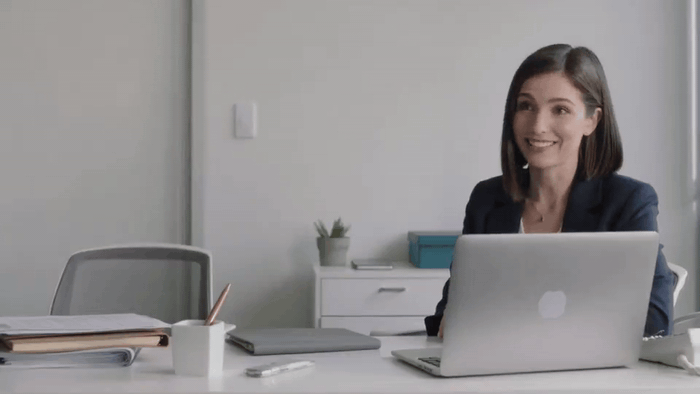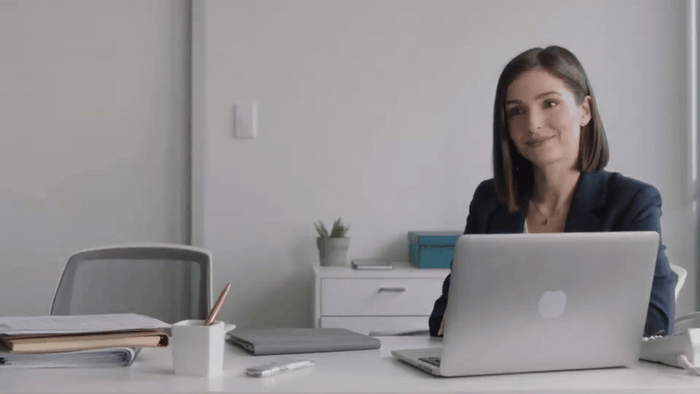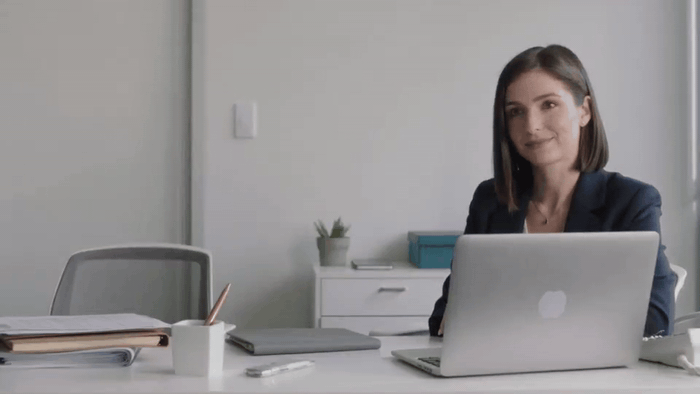
Testergebnis 1 visuell: Maya liefert eine Bürozeile
Testergebnis 1 visuell. Beobachten Sie Mayas Mundschluss während „Please“ und die Pause nach der Zeile; verwenden Sie die Quell-MP4, um das Audio-Timing zu beurteilen.
Durchlaufstatus: Im Atlas-Test-Playground gerendert. Das visuelle GIF ist oben eingebettet.
| Testergebnis 1 visuell | Status | Was das GIF zeigt |
|---|---|---|
| Einzelsprecher-Bildausschnitt | Klar | Maya ist die einzige sichtbare Person in der gesamten Büroszene |
| Mundbewegung | Sichtbar | Der enge Bildausschnitt macht die Sprechbewegung leicht zu prüfen |
| Gesichtskontinuität | Stabil | Blinzeln, Pose und Beleuchtung bleiben durch den Clip konsistent |
| Zuhörerverhalten und Schnitt | Nicht zutreffend | Diese Baseline-Szene hat keinen zweiten Sprecher oder Gegenschuss |
| Audio-Timing | Quell-MP4 prüfen | Das eingebettete GIF hat keinen Ton |
Wenn die Zeile an Klarheit verliert, ändern Sie nur 1 Variable für einen separat gekennzeichneten erneuten Durchlauf. Erstens: Verkürzen Sie den gesprochenen Satz. Zweitens: Entfernen Sie die Handgeste oder unnötige Kameraanweisungen. Vermeiden Sie es, Charakter, Dauer und Sprache gleichzeitig zu ändern. Das verwandelt eine Diagnose in ein neues Experiment.
Kling-Dialogtest #2: Zwei Personen im Wechsel
Hier wird die Dialoggenerierung genau geprüft. Eine glaubwürdige Szene benötigt 2 getrennte Aktionen: Maya muss sprechen, während Daniel zuhört, dann muss Daniel sprechen, während Maya zuhört. Die stille Person ist kein toter Raum. Ihr geschlossener Mund, Augenkontakt, kleine Reaktion und stabiles Gesicht sind Teil des Beweises.
Der Prompt verwendet 3 Anker für jeden Sprecher: einen Namen, eine linke oder rechte Position und ein sichtbares Kleidungsdetail. Er gibt auch das erwartete Verhalten des Zuhörers an. Das sind keine Zauberworte. Sie geben dem Modell einen expliziteren Szenenvertrag und dem Prüfer klare Fehlerbedingungen.
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
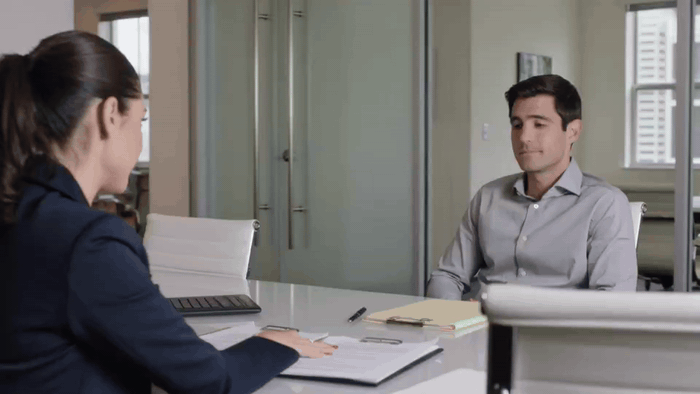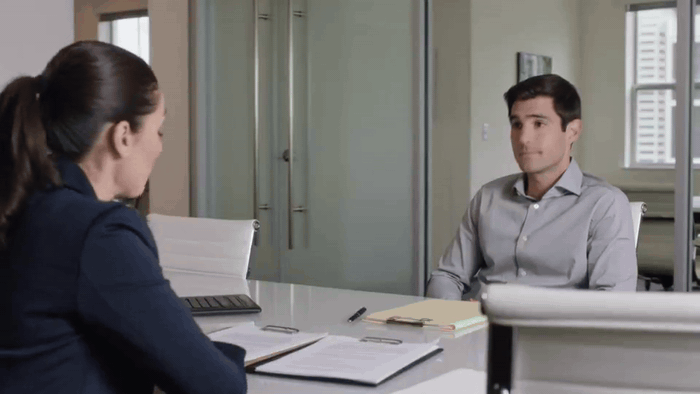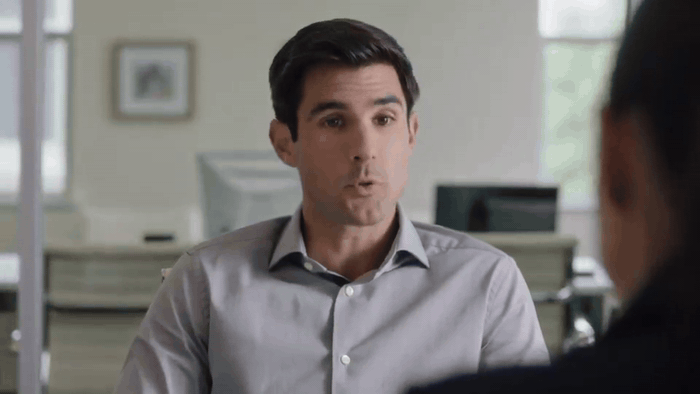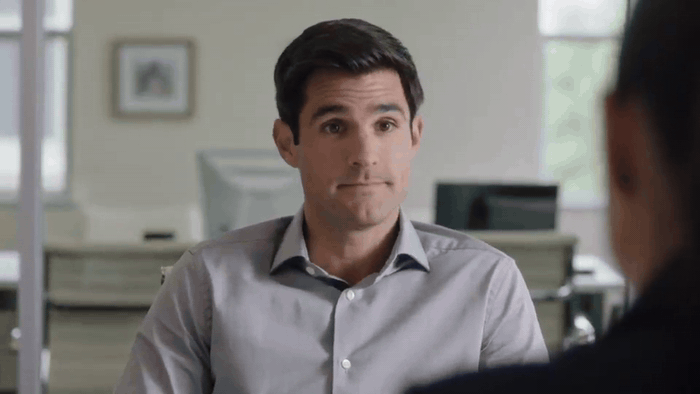
Testergebnis 2 visuell: Maya und Daniel wechseln sich in einem Bürogespräch ab
Testergebnis 2 visuell. Beobachten Sie den Mund des Zuhörers während jeder Zeile und den Sprecherwechsel beim Gegenschuss; verwenden Sie die Quell-MP4, um das Audio-Timing zu beurteilen.
Kreative beschreiben in Community-Diskussionen regelmäßig das gegenteilige Problem: Ein beabsichtigter Lippensynchronisationsauftrag kann die Synchronisation verlieren oder einer Person, die ruhig sein sollte, unerwünschte Mundbewegungen verleihen. Das ist anekdotische Erfahrung und keine Produktspezifikation, aber ein guter Grund, den Zuhörer bei jedem Durchlauf zu prüfen (r/KLING, September 2026).
Durchlaufstatus: Im Atlas-Test-Playground gerendert. Das visuelle GIF ist oben eingebettet.
| Testergebnis 2 visuell | Status | Was das GIF zeigt |
|---|---|---|
| Zwei-Sprecher-Setup | Klar | Maya und Daniel erscheinen im selben Bürogespräch |
| Sprecherwechsel | Sichtbar | Die Szene wechselt von Mayas Zug zu Daniels Gegenschuss |
| Zuhörerverhalten | Prüfbar | Das GIF hält die nicht sprechende Person für eine visuelle Prüfung sichtbar |
| Gesichtskontinuität | Stabil | Daniels Gesicht und Büroumgebung bleiben im Gegenschuss konsistent |
| Audio-Timing | Quell-MP4 prüfen | Das eingebettete GIF hat keinen Ton |
Die praktische Grenze ist bescheiden: Ein sequenzieller 10-Sekunden-Austausch mit 2 Personen kann getestet werden. Er sollte nicht als fertige Vorlage für eine lange Szene mit Unterbrechungen, Gruppenreaktionen, schnellen Schnitten und mehreren Sprachen behandelt werden. Erhöhen Sie die Schwierigkeit eine Dimension nach der anderen.
Kling-Dialogtest #3: Gemischtsprachiger Dialog
Der dritte Durchlauf testet eine engere Version der Funktion, die Kuaishou beschreibt: Eine Person spricht Englisch, dann antwortet die andere auf Spanisch. Der Wert liegt nicht in der Neuheit. Ein gemischtsprachiger Austausch kann einen Sprecherzuordnungsfehler aufdecken, den ein einsprachiger Clip verbirgt, besonders wenn ein Schnitt und ein anderes Klangmuster zusammenkommen.
Die spanische Antwort ist absichtlich kurz. Jede Person hat weiterhin eine Zeile, die Aufnahme reihenfolge bleibt explizit, und dem Zuhörer wird gesagt, dass er still bleiben soll. Die Pro-Stufe wird hier als separater, anspruchsvollerer Test verwendet und nicht als Ersatz für einen klaren Prompt.
Durchlaufeinstellungen: 16:9, 10 Sekunden, höchste verfügbare Auflösung und Qualität zum Laufzeitpunkt, natives Audio Ein oder Auto, keine Hintergrundmusik. Modell: Kling V3.0 Pro Text-to-Video.
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
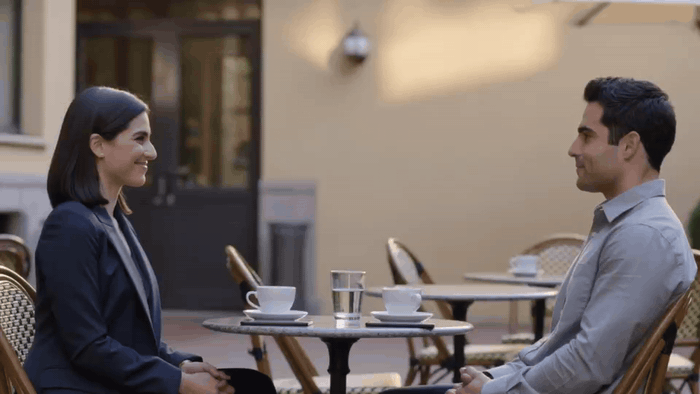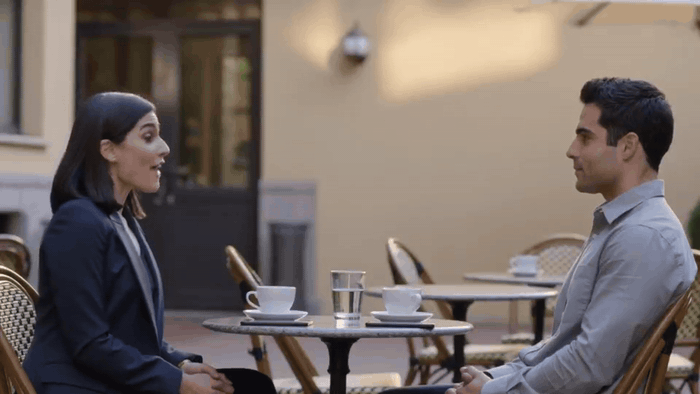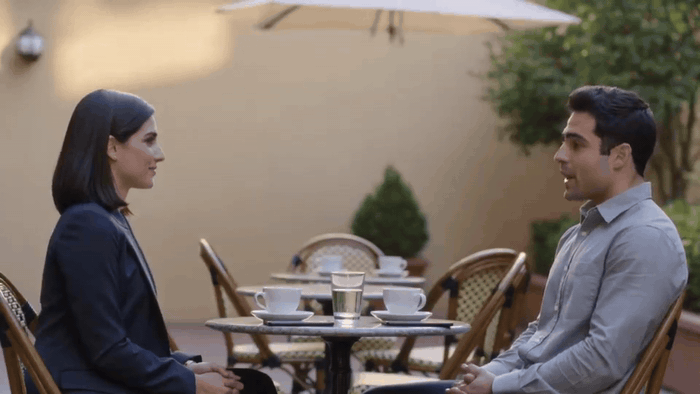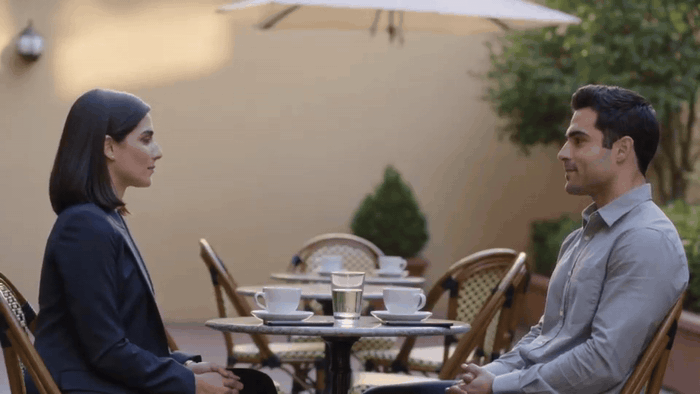
Testergebnis 3 visuell: zwei Sprecher tauschen Zeilen in einem Außencafé aus
Testergebnis 3 visuell. Beobachten Sie, welches Gesicht jede Zeile durch den englisch-spanischen Wechsel besitzt; verwenden Sie die Quell-MP4, um das Audio-Timing zu beurteilen.
Durchlaufstatus: Im Atlas-Test-Playground gerendert. Das visuelle GIF ist oben eingebettet.
| Testergebnis 3 visuell | Status | Was das GIF zeigt |
|---|---|---|
| Zwei-Personen-Café-Setup | Klar | Beide Personen bleiben am Außencafétisch positioniert |
| Sprecherwechsel | Sichtbar | Der Bildausschnitt bewahrt den Austausch zwischen den beiden Charakteren |
| Gesichts- und Umgebungskontinuität | Stabil | Garderobe, Sitzordnung und Beleuchtung des späten Nachmittags im Café bleiben konsistent |
Sauberere Kling-Lippensynchronisationsergebnisse
Die 3 Prompts teilen eine Struktur, die einen Fehler sichtbar und einen erneuten Durchlauf erklärbar macht. Verwenden Sie diese Checkliste, bevor Sie mehr Feinschliff hinzufügen.
- Behalten Sie bei einem ersten Dialogtest nicht mehr als 2 sichtbare Personen bei.
- Geben Sie jeder Person 1 Satz pro Zug.
- Halten Sie englische Zeilen wenn möglich bei etwa 8 bis 12 Wörtern.
- Markieren Sie den Sprecher mit Position, einem sichtbaren Merkmal und einem Namen.
- Geben Sie an, dass der andere Charakter natürlich mit geschlossenem Mund zuhört.
- Legen Sie das Skript mit einem 10-Sekunden-Beispiel fest, bevor Sie Detail Einstellungen oder Dauer erhöhen.
- Prüfen Sie Lippentiming, Sprecherzuordnung, Zuhörerverhalten, Gesichtskontinuität und den Schnitt als separate Kontrollen.
- Kombinieren Sie im ersten Durchlauf nicht einen langen Monolog, eine Gruppenszene, schnelle Schnitte und Sprachwechsel.
| Prompt-Element | Beispiel in den Tests | Was es dem Prüfer zu isolieren hilft |
|---|---|---|
| Position | „Maya ... on the left“ | Welche Person sprechen soll |
| Aussehensanker | „navy blazer“ | Ob die Identität über einen Schnitt hinweg hält |
| Exakte Zeile | „Great. I will check it before lunch.“ | Der erwartete Klang und das Mund-Timing |
| Stille-Rolle-Anweisung | „remains silent ... mouth closed“ | Unerwünschte Lippenbewegung des Zuhörers |
| Aufnahmeabfolge | „Shot 1 ... Shot 2“ | Ob das Audio nach einem Schnitt angehängt bleibt |
Diese Formatierung verspricht keine perfekten Ergebnisse. Sie gibt einem kleinen Team eine Möglichkeit, den Quell-Prompt, die Medien und die Entscheidung zusammenzuhalten. Wenn ein Clip einen erneuten Durchlauf benötigt, notieren Sie, ob der Fehler bei der ersten Silbe, während einer Zuhörerreaktion oder beim Schnitt auftrat. „Die Lippensynchronisation fühlte sich falsch an“ ist zu vage, um ein Produktionsskript zu verbessern.
Budget und Modellwahl
Verwenden Sie eine kostengünstigere aktuelle Stufe, um das Skript zu validieren, und reservieren Sie den Test der höheren Stufe für die Version, die Sie tatsächlich präsentieren möchten. Das ist die Rolle, die Standard und Pro in diesem Artikel spielen. Ein Creator kann dieselbe Prompt-Struktur in einem einzigen Atlas Cloud Modell-Arbeitsbereich ausführen, die Testaufzeichnung bewahren und einen Vergleich anstellen, ohne das Skript für eine andere Schnittstelle neu zu schreiben.
Die folgenden Zahlen sind Preis kontext, keine Werbeaussage. Sie wurden am 28. September 2026 gegen das Atlas Cloud Modellverzeichnis und die Modelldetailseiten geprüft. Das Verzeichnis zeigte zum Zeitpunkt der Überprüfung eine Reduzierung um 15 %. Preise und Modellparameter können sich ändern, prüfen Sie die Seite daher erneut, bevor Sie ein Kundenbudget festlegen.
| Modell für diesen Test | Seitenpreis pro Sekunde, geprüft Sep. 2026 | Geschätzte 10-Sekunden-Generierung | Beste Verwendung in diesem Protokoll |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071, runter von $0.084 | $0.71 | Validierung der Ein-Sprecher- und Wechsel-Prompt-Struktur |
| Kling V3.0 Pro T2V | $0.095, runter von $0.112 | $0.95 | Ausführen des gemischtsprachigen oder Präsentationskandidaten |
Die aufgelisteten Gesamtkosten für die 3 10-Sekunden-Tests betragen $2.37 vor etwaigen erneuten Durchläufen. Behandeln Sie dies als einfache Planungsschätzung. Sie geht davon aus, dass der angezeigte Preis pro Sekunde gilt, die angeforderte Dauer vom Live-Formular akzeptiert wird und die für das Konto geltende Preisgestaltung mit der öffentlichen Seite übereinstimmt. Das reale Playground-Schema ist die letzte Instanz für verfügbare Seitenverhältnisse, Qualitätsoptionen und native Audio-Steuerelemente.
Kling-Dialog-Lippensynchronisation FAQ
Ist Kling 4 offiziell veröffentlicht?
Ich konnte keine offizielle Kuaishou-Spezifikation für ein veröffentlichtes Kling 4 Dialogmodell verifizieren. Die hier verwendete offizielle Veröffentlichung ist Kling 3.0. Suchseiten, die „4K“ oder ein zukunftsweisendes Label an Kling anhängen, sollten nicht als Bestätigung eines separaten „Kling 4“-Produkts behandelt werden.
Welches Modell sollte ich heute für einen Kling-Dialog-Lippensynchronisationstest verwenden?
Für eine kurze Skriptprüfung verwenden Sie den verifizierten aktuellen Kling V3.0 Standard Text-to-Video-Weg. Verwenden Sie Pro für eine anspruchsvollere Nachverfolgung wie die gemischtsprachige Szene in diesem Artikel. Halten Sie das Setup stabil genug, damit Sie erkennen können, ob sich ein Ergebnis aufgrund des Prompts oder der Modellstufe geändert hat.
Kann Kling 2 Personen nacheinander sprechen lassen?
Kuaishou sagt, dass Video 3.0 Multi-Charakter-Dialoge mit kontrolliertem Inhalt und Sprechreihenfolge generieren kann. Führen Sie in der Praxis zuerst ein kurzes Wechselbeispiel durch. Benennen Sie jeden Sprecher, verankern Sie seine Position und Kleidung, geben Sie die Aufnahmeabfolge an und weisen Sie den Zuhörer ausdrücklich an, still zu bleiben.
Warum bewegen beide Charaktere in meinem Kling-Video die Lippen?
Die Szene lässt möglicherweise die Sprecherzuordnung zu offen, oder das Modell erzeugt in diesem Durchlauf unerwünschte Gesichtsbewegungen. Beschränken Sie den Test auf 2 Personen und je 1 Zeile. Fügen Sie dann eine direkte Anweisung für stille Zuhörer hinzu und prüfen Sie das Ergebnis mit seinem Audio. Wenn das Problem bleibt, melden Sie es als fehlgeschlagenes Ergebnis und führen Sie nur 1 geänderte Variable erneut aus.
Unterstützt Kling englischen und spanischen Dialog in 1 Clip?
Kuaishou listet sowohl Englisch als auch Spanisch unter den von Video 3.0 native Audio unterstützten Sprachen auf. Eine Liste unterstützter Sprachen ist nicht dasselbe wie eine Garantie für ein bestimmtes Dialogskript. Der dritte Kling 4 Dialog-Lippensynchronisationstest oben hält den Austausch kurz, damit Sie Sprachwechsel, Mundbewegung und Sprecherzuordnung in derselben Datei beurteilen können.
Sollte ich ein GIF oder Video verwenden, um einen Lippensynchronisationstest zu zeigen?
Verwenden Sie ein GIF, wenn der Artikel eine leichte, schnell erfassbare Ansicht der Gesichtsbewegung und des Sprecherwechsels benötigt. Verwenden Sie die Original-MP4, wenn Sie Wörter und Klang-Timing überprüfen. Die 3 hier eingebetteten Ergebnisse sind GIFs, während ihre Quell-MP4-Dateien im Artikel-Asset-Ordner verbleiben.


