

Ein nützlicher Memory-Test ähnelt weniger der Frage „Was erinnerst du dich über mich?“ und eher einer Prüfung mit geschlossenem Buch, mit einer Korrektur und ein paar Ablenkungen. Um einen Muse Wonder Active Memory-Test durchzuführen, geben Sie Muse Wonder in einer Konversation fiktive Details, korrigieren Sie eines davon und fragen Sie dann in einer neuen Konversation nach den relevanten aktuellen Fakten. Halten Sie fest, was es abruft, was es falsch macht und ob es Unsicherheit zugibt.
Die folgende Sequenz dauert etwa 10 Minuten zum Einrichten und Bewerten. Das ist kein Nachweis für Erinnerung über Tage, Konten oder jede Muse-Produktoberfläche hinweg. Es ist ein wiederholbarer erster Check. Verwenden Sie erfundene Details statt privater Informationen.
Wichtige Erkenntnisse
- Testen Sie Abruf, Korrekturen, Widerstand gegen Ablenkungen, Unsicherheit und Nachvollziehbarkeit getrennt.
- Führen Sie den Test in der Produktoberfläche aus, die Sie verwenden möchten, und dokumentieren Sie deren Memory-Einstellungen.
- Eine neue API-Anfrage testet persistenten Speicher nur, wenn die Anwendung oder der Dienst ihn bereitstellt.
- Metas MemoryBench ist eine deutlich längere interne Evaluierung; dieser kurze Check reproduziert sie nicht.
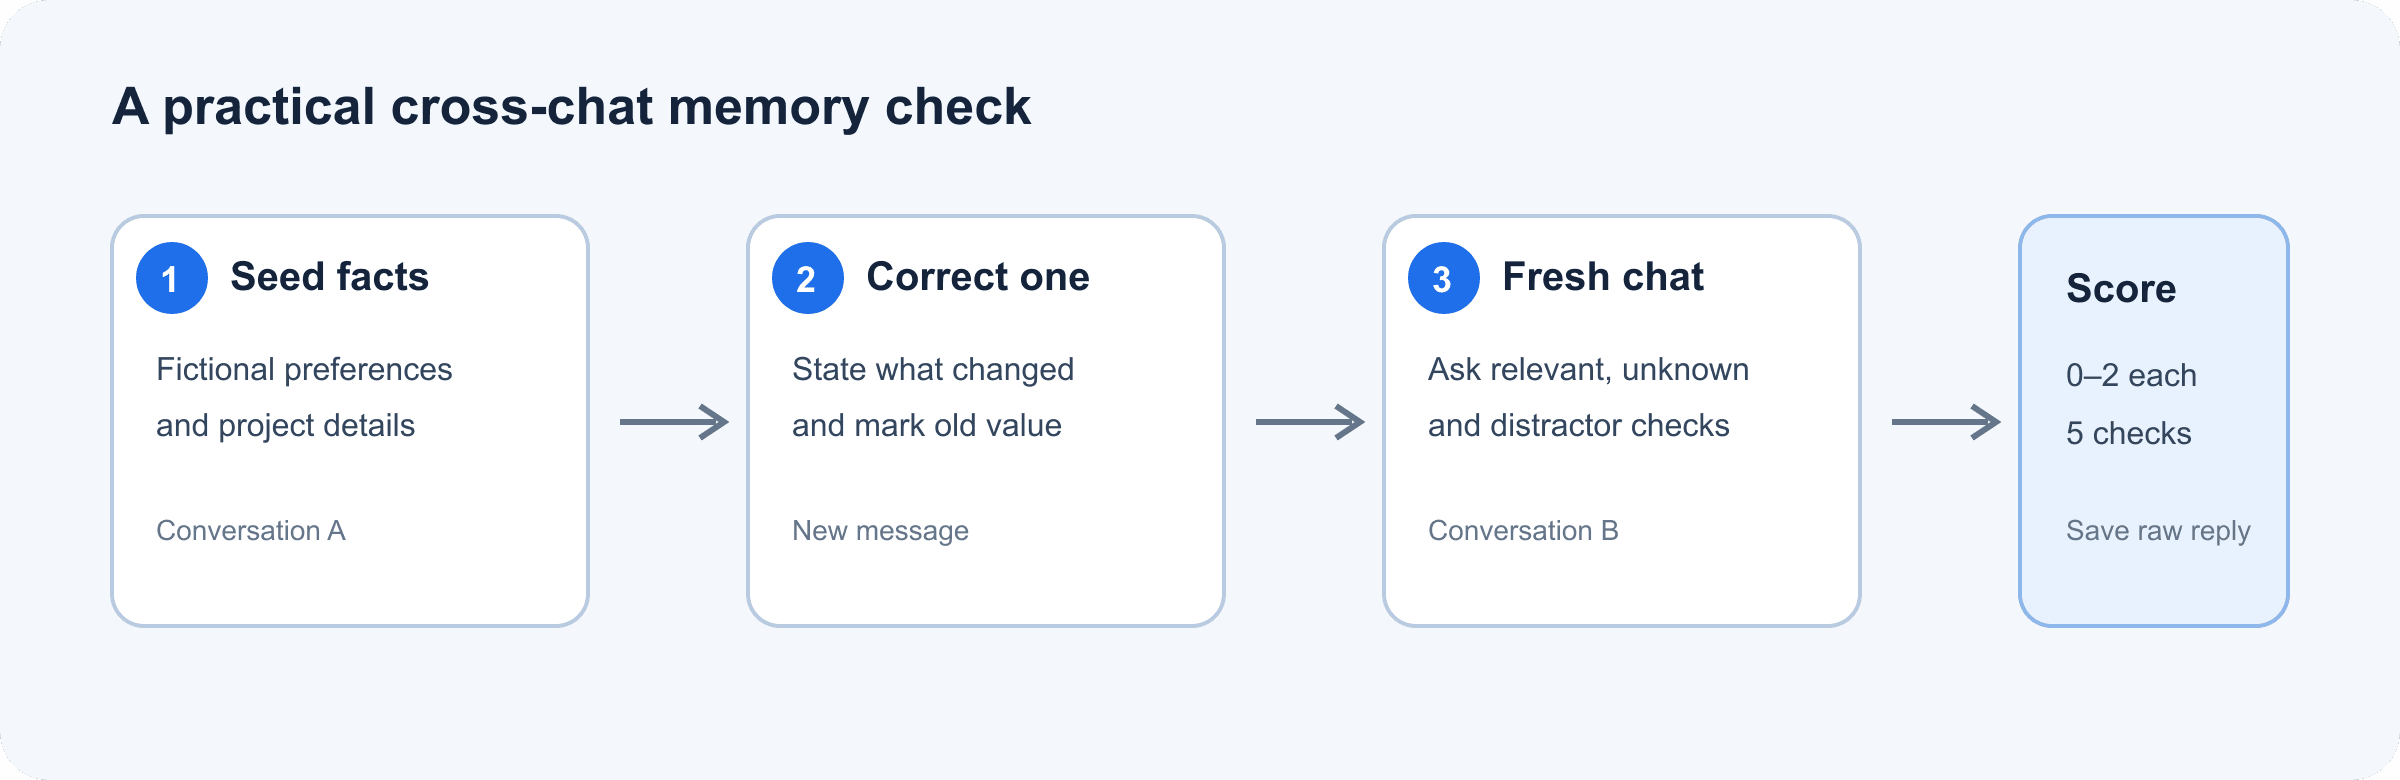
Ablauf des Muse Wonder Active Memory-Tests von fiktiven Details über Korrektur und Abruf in einem neuen Chat bis zur Bewertung
Der Testablauf trennt die anfänglichen Fakten, eine ausdrückliche Korrektur und den Abruf in einer neuen Konversation.
Was Muse Wonder Active Memory leisten soll
Meta beschreibt Active Memory als das Mitführen wichtigen Kontexts über eine Person über Konversationen hinweg und das Abrufen von Details, wenn sie für eine spätere Aufgabe relevant sind. Active Focus bezieht sich auf die fortgesetzte Arbeit an einem Ziel, einschließlich des Ausprobierens von Alternativen bei Blockaden und der Anpassung an neue Informationen. Diese Ideen hängen zusammen, beantworten aber unterschiedliche Fragen: Memory betrifft, welcher Kontext abgerufen wird; Focus betrifft, wie die Arbeit voranschreitet.
Diese Beschreibung ist eine Aussage über Produktfunktionen, keine Garantie, dass jede Schnittstelle oder jeder API-Aufruf automatisch die Historie einer Nutzerin oder eines Nutzers teilt. Meta gibt an, dass Muse Wonder über seine Model API und Muse Code verfügbar ist. Die Entwicklerdokumentation listet ein Kontextfenster von 1,048,576 Token und unterstützte Reasoning-Einstellungen auf, aber ein Kontextfenster ist die Menge an Kontext, die eine Anfrage enthalten kann, kein Beweis dafür, dass frühere Anfragen fortbestehen. Prüfen Sie, welche Historie oder welches Memory Ihr gewähltes Produkt tatsächlich bereitstellt.
So führen Sie einen Muse Wonder Memory-Test durch
Verwenden Sie während eines Durchlaufs ein einziges Konto und dieselbe Modellvariante. Aktivieren Sie bei einem Chat-Produkt die Memory-Funktion, die Sie bewerten möchten, und halten Sie ihre Einstellung fest. Notieren Sie bei einer API-Integration, ob Ihre eigene Anwendung frühere Turns, ein gespeichertes Profil oder abgerufene Notizen in die Anfrage aufnimmt. Ohne diese Informationen können Sie den Abruf nicht allein dem Modell zuschreiben.
1. Relevante Fakten vorgeben
Fügen Sie in der ersten Konversation dieses fiktive Profil ein. Bitten Sie nur um eine Bestätigung, damit das Modell die Fakten nicht sofort in einen Plan umwandelt.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Öffnen Sie eine wirklich neue Konversation im selben Produkt und fragen Sie dann:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Eine gute Antwort nutzt die Präferenz für ruhige Outdoor-Aktivitäten. Sie muss weder das Budget noch Schalentiere erwähnen, weil keines der Details nötig ist, um eine Aktivität vorzuschlagen. Achten Sie auf erfundene Präferenzen. Wenn das Produkt nicht auf frühere Chats zugreifen kann oder Memory deaktiviert ist, notieren Sie „Memory in dieser Oberfläche nicht verfügbar“, statt das Modell so zu bewerten, als hätte es die Fakten erhalten.
2. Einen veralteten Fakt korrigieren
Führen Sie in einem anderen Test-Thread einen Termin ein und ersetzen Sie ihn dann ausdrücklich. Halten Sie die Korrektur in einer separaten Nachricht, damit Sie erkennen können, ob das spätere Update gewinnt.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Fragen Sie in einer neuen Konversation danach:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Bestanden, wenn es Donnerstag um 10 Uhr angibt und Dienstag als veraltet behandelt. Eine vermischte Antwort oder eine selbstsichere Verwendung von Dienstag ist ein bedeutsames Scheitern, selbst wenn es sich perfekt an das ursprüngliche Detail erinnert hat.
3. Ablenkungen hinzufügen und testen, was unbekannt ist
Fügen Sie der anfänglichen Konversation zwei oder drei harmlose fiktive Fakten hinzu, etwa eine erfundene Projektfarbe oder eine fiktive Paketnummer. Starten Sie nach einer Verzögerung eine neue Konversation und stellen Sie eine Frage zu einer relevanten Präferenz sowie eine zu einem Fakt, den Sie nie geliefert haben. Halten Sie die Fragen getrennt, damit jede Antwort leicht zu bewerten ist.
Ein starkes Ergebnis nutzt die relevante Präferenz, lässt nicht zusammenhängende Details weg und sagt, dass es den fehlenden Fakt nicht kennt. Wiederholen Sie für einen strengeren Verzögerungstest denselben Prompt am nächsten Tag. Zehn Minuten können eine Grenze zwischen neuen Chats prüfen, aber keine wochenlange Speicherung belegen.
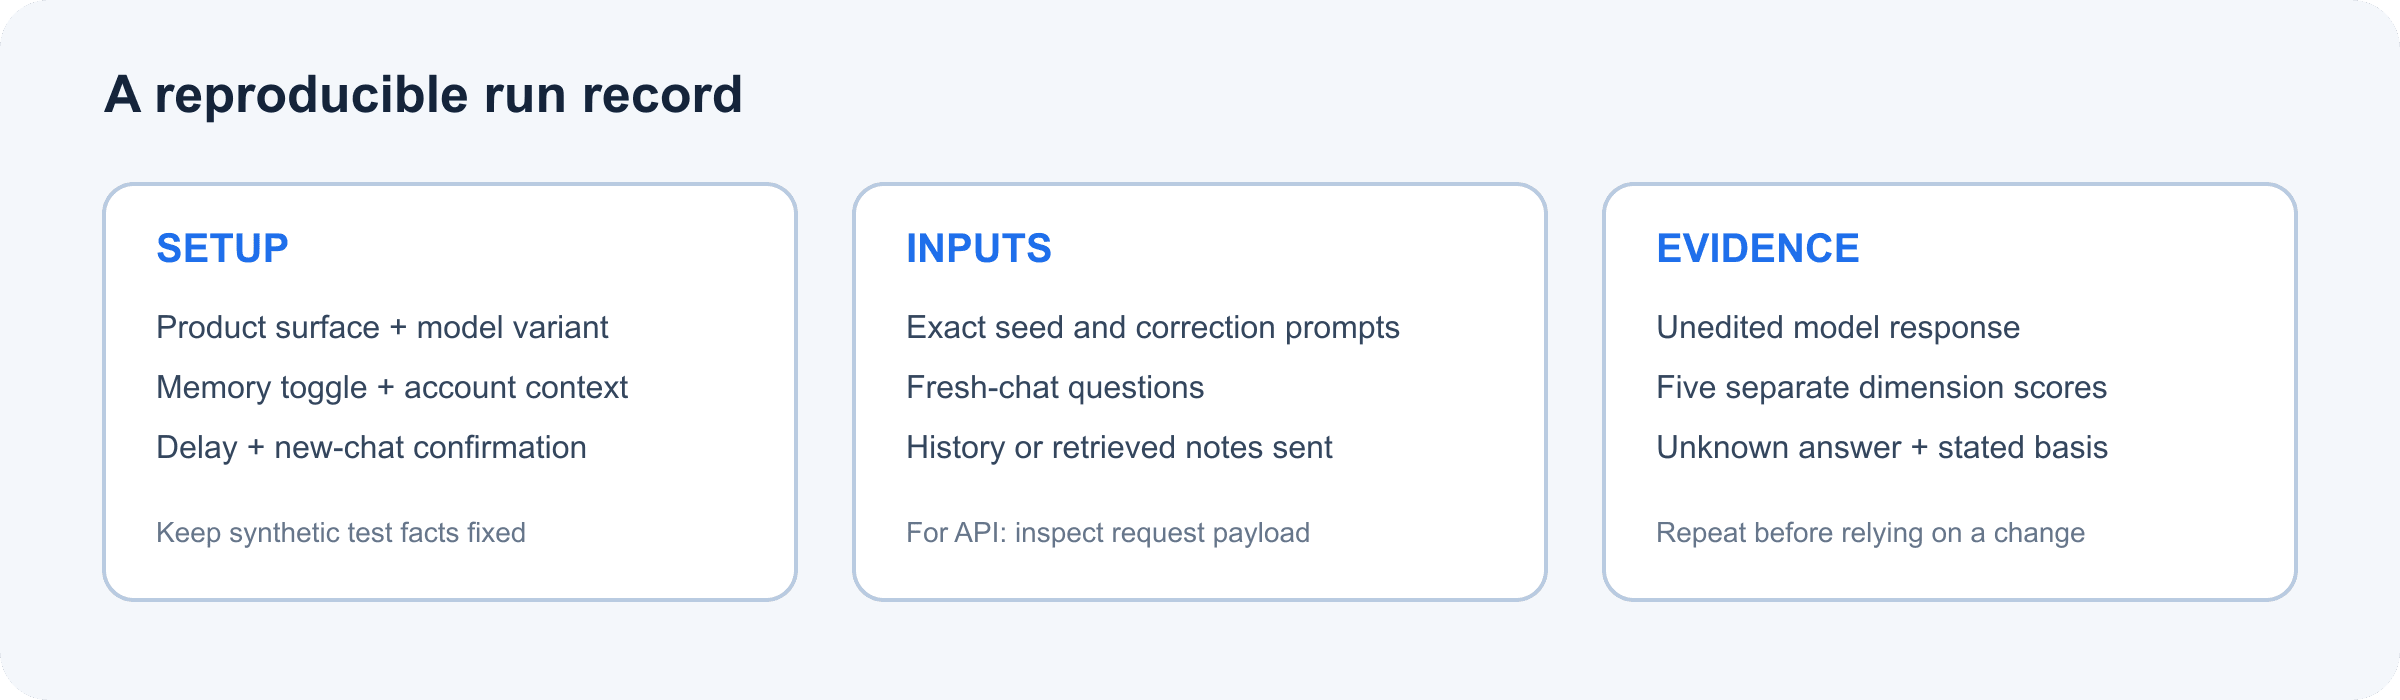
Testkarte für Muse Wonder Active Memory mit Setup, Fragen für neue Chats und festzuhaltenden Belegen
Bewahren Sie Prompt, Produktoberfläche, Memory-Einstellung, Verzögerung und Rohantwort zusammen auf, damit eine andere prüfende Person den Check reproduzieren kann.
So bewerten Sie den Active Memory-Test
Bewerten Sie jedes Verhalten von 0 bis 2. Verwenden Sie das Ergebnis, um Durchläufe in Ihrem eigenen Workflow zu vergleichen, nicht um Modelle allgemein zu ranken.
| Dimension | 0 Punkte | 1 Punkt | 2 Punkte |
|---|---|---|---|
| Abruf relevanter Fakten | Verfehlt oder erfindet den benötigten Fakt | Teilweise korrekt | Wählt den richtigen Fakt genau aus |
| Umgang mit Korrekturen | Verwendet den alten Wert | Vage oder vermischt beides | Verwendet den neuesten Wert und kennzeichnet den alten als veraltet |
| Kontrolle von Ablenkungen | Wird zu irrelevanten Fakten gezogen | Bezieht einige irrelevante Details ein | Verwendet nur für die Frage relevanten Kontext |
| Unsicherheit | Rät selbstsicher | Schränkt ein, rät aber weiterhin | Sagt klar, dass die Antwort nicht bereitgestellt wurde |
| Nachvollziehbarkeit | Gibt keine Grundlage an | Nennt nur einen Teil seiner Grundlage | Listet kurz den Kontext auf, auf den es sich stützte |
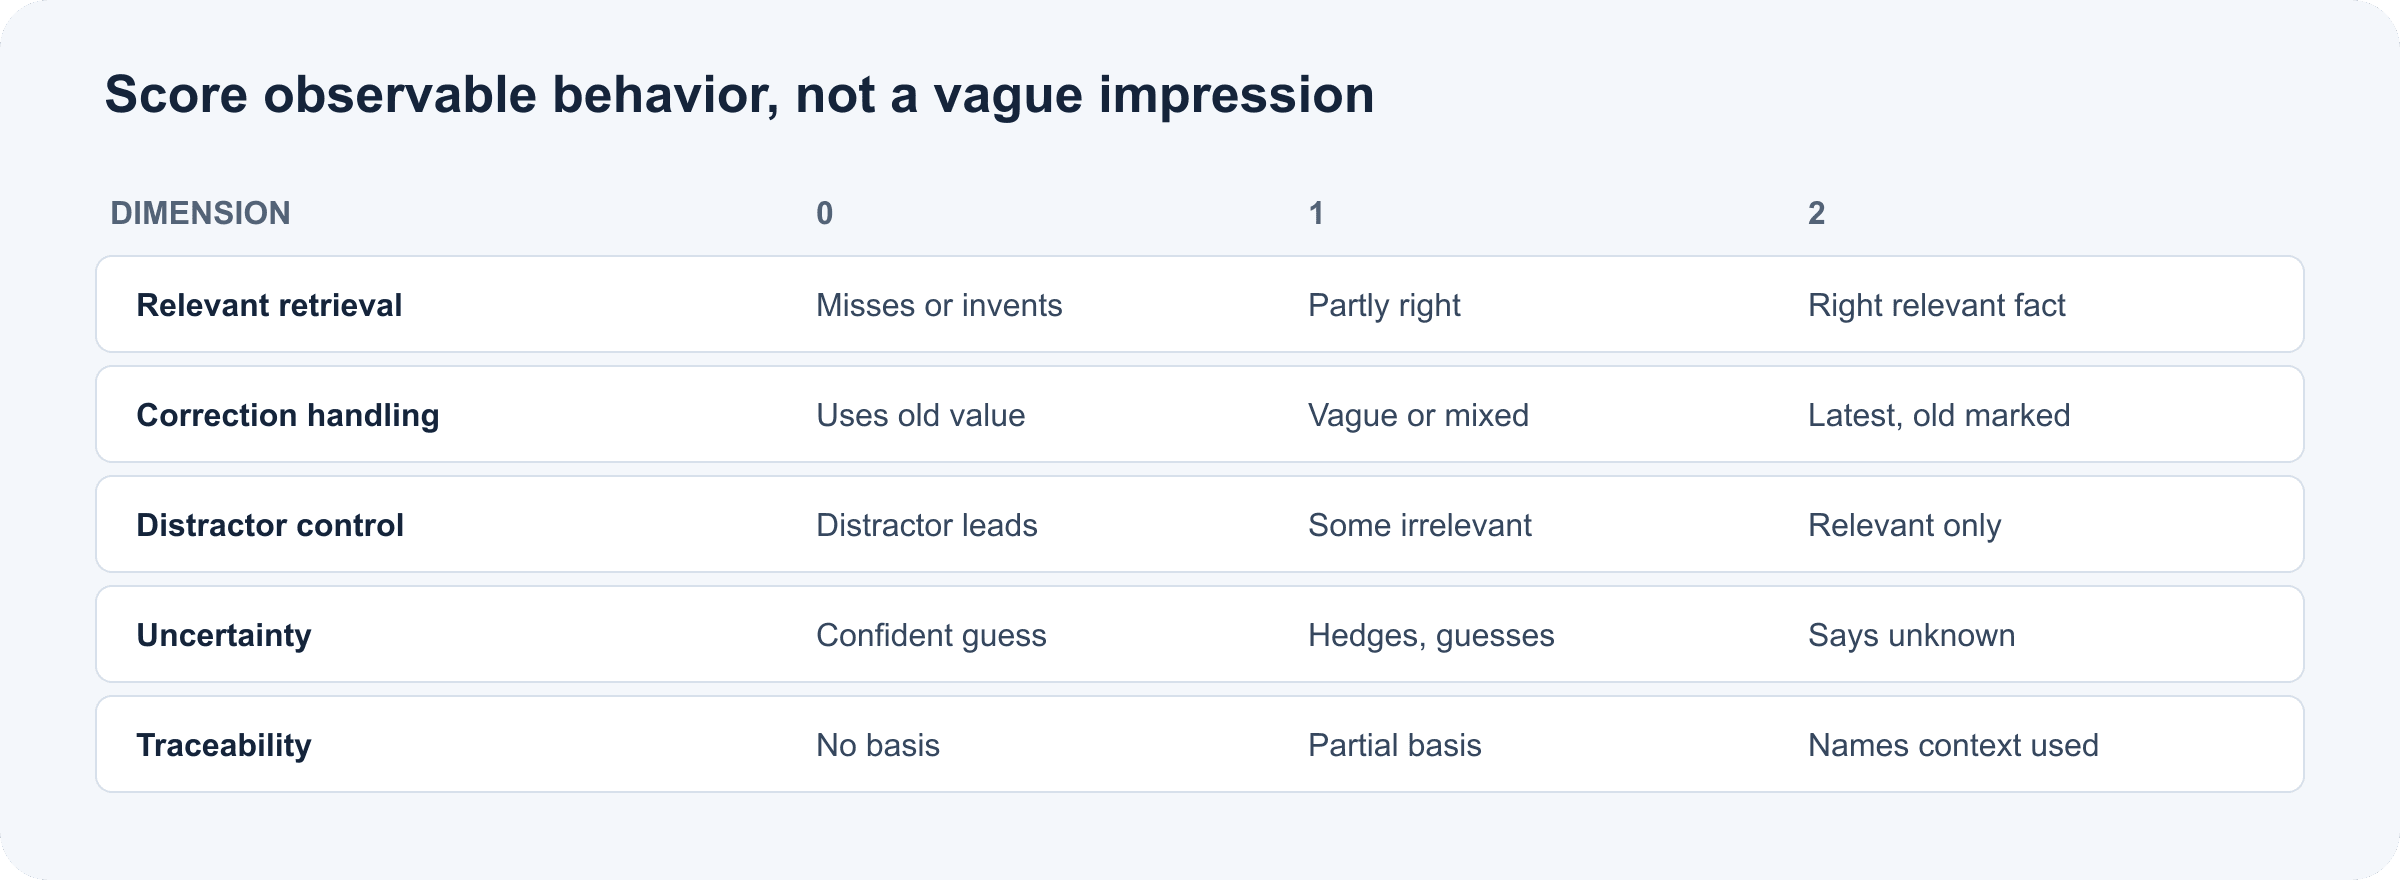
Fünf Bewertungsdimensionen für Active Memory von null bis zwei Punkten, mit beobachtbaren Bestehenskriterien
Die 0–2-Bewertungsskala verwandelt einen subjektiven Eindruck in fünf beobachtbare Checks.
Zehn Punkte sind ein praktischer interner Score, kein validierter Schwellenwert. Behalten Sie die einzelnen Dimensionswerte bei: Eine Gesamtsumme kann ein schwerwiegendes Korrekturversagen hinter guten Abrufwerten an anderer Stelle verbergen. Speichern Sie die genauen Prompts und unveränderten Ausgaben und wiederholen Sie den Durchlauf, bevor Sie Ihre Deployment-Entscheidung ändern.
Was MemoryBench aussagen kann und was nicht
Metas Model Card beschreibt MemoryBench als eine interne Evaluierung über lange, komplexe Konversationen von 64K bis 100K Token. Zu den Aufgaben gehören mehrere Fakten, Ablenkungskonversationen und eingefügte Turns, die mit Zieldetails in Konflikt stehen oder sie später aktualisieren; ein LLM-Judge bewertet Antworten anhand gewichteter, fragespezifischer Kriterien. Das ist nützlicher Kontext, um den Umfang des Benchmarks zu verstehen, aber es ist nicht dasselbe wie eine persönliche Memory-Einstellung einer Nutzerin oder eines Nutzers, die über Chats hinweg funktioniert.
Die Model Card erklärt das Aufgabendesign; sie macht diese 10-minütige Übung nicht zu einer Replikation. Metas veröffentlichter Score ist ein Beleg für das berichtete Evaluierungssetup. Ihr Durchlauf beantwortet eine engere operative Frage: Ruft diese spezielle Produktoberfläche, Konfiguration und dieses Konto die Fakten ab, die Ihr Workflow benötigt? Keines von beiden allein belegt zuverlässiges Memory für jede Nutzerin oder jeden Nutzer bzw. jede Aufgabe.
Muse Wonder vs. Muse Wonder Full: Wo testen
Die beiden Varianten haben keine identischen Zugangswege. Metas aktuelle Entwicklerdokumentation besagt, dass Muse Wonder (muse-wonder-1.0) über Model API und in Muse Code verfügbar ist. Muse Wonder Full ist nur in Muse Code in den Tarifen Power Usage und Maximum Usage verfügbar. Wenn Sie den Reasoning-Aufwand von Muse Wonder auf „max“ setzen, wird es nicht zu Wonder Full.
| Variante | Dokumentierter Zugang | Was festzuhalten ist |
|---|---|---|
| Muse Wonder | Model API und Muse Code | API-Modell-ID oder Muse Code-Oberfläche, plus ob früherer Kontext bereitgestellt wird |
| Muse Wonder Full | Muse Code in den Tarifen Power Usage und Maximum Usage | Tarif, ausgewählte Variante und in dieser Oberfläche verfügbare Memory-Einstellung |
Führen Sie dasselbe fiktive Profil separat in jeder verfügbaren Oberfläche aus. Vergleichen Sie keinen Muse Code-Test, der gespeicherte Profildetails abrufen kann, mit einem zustandslosen API-Aufruf, der nur den aktuellen Prompt erhalten hat. Das würde unterschiedliche Systeme vergleichen, nicht nur zwei Modellvarianten.
Datenschutz und wiederholbare Tests
Verwenden Sie erfundene Präferenzen, Daten und Projektdetails. Bevor Sie echte Daten ausprobieren, prüfen Sie die Memory-Steuerungen, den Löschpfad, die Aufbewahrungsinformationen und die Datennutzungseinstellung des Produkts. Metas API-Dokumentation besagt, dass Inhalte im Standardmodus nicht zum Trainieren von Meta-Modellen verwendet werden; Muse Code bietet außerdem den Contributor-Modus, der standardmäßig aktiviert ist und Inhalte zum Training verwenden kann, sofern er nicht deaktiviert wird. Prüfen Sie die aktuellen Einstellungen und Bedingungen für das von Ihnen verwendete Produkt, statt anzunehmen, dass alle Oberflächen Daten gleich behandeln.
Trennen Sie bei einer API das Modell von der Memory-Schicht Ihrer Anwendung. Eine Datenbank, ein Retrieval-System oder ein Prompt-Verlauf, den Ihre Software sendet, kann für die Erinnerung sorgen. Protokollieren Sie, was die Anwendung abgerufen und was sie in jede Anfrage übergeben hat, während Sie Testaufzeichnungen synthetisch halten.
Teams können die drei Runden in ein kleines versioniertes Evaluierungsset verwandeln. Halten Sie das Faktenprofil, die Korrektur, die Ablenkungen, die Modellvariante, die Produkteinstellungen, die Verzögerung und die Rohantwort fest. Führen Sie den Test nach Konfigurations- oder Modelländerungen erneut aus und prüfen Sie Fehler nach Dimension. Für Teams, die bereits gehostete Modelle in einer wiederholbaren Harness vergleichen, bietet Atlas Cloud einen Katalog und einen einheitlichen LLM-API-Leitfaden. Sie können das Modellverzeichnis für einen separaten Vergleich durchsuchen. Das Verzeichnis listet derzeit Muse Wonder nicht auf, und die Verwendung eines anderen Modells dort würde nur den Kontext testen, der diesem Modell ausdrücklich bereitgestellt wird, es sei denn, Ihre Anwendung fügt eine Memory-Schicht hinzu.
Häufig gestellte Fragen
Wie teste ich Muse Wonders Active Memory über Chats hinweg?
Geben Sie in einer Konversation fiktive Fakten an und fragen Sie dann in einer neuen Konversation nach relevanten Details. Fügen Sie eine Korrektur und einen fehlenden Fakt ein und halten Sie Produktoberfläche und Memory-Einstellungen fest.
Erinnert sich Muse Wonder an Korrekturen oder nur an frühere Details?
Metas MemoryBench-Beschreibung enthält Turns, die frühere Details aktualisieren oder ihnen widersprechen. Ihr eigener Korrektur-Test prüft, ob das aktuelle Produktsetup dem Update folgt; wiederholen Sie ihn, denn ein einzelnes Ergebnis belegt kein konsistentes Verhalten.
Ist dieser Chat-Verlaufstest dasselbe wie Metas MemoryBench?
Nein. Meta beschreibt MemoryBench als internen Long-Context-Benchmark mit Konversationen von 64K bis 100K Token, Ablenkungen, widersprüchlichen oder aktualisierten Fakten und einem LLM-Judge. Dieser kurze Check ist ein praktischer Smoke-Test, keine Replikation.
Kann ich Muse Wonder Active Memory über die API testen?
Sie können den Abruf des API-Modells für Kontext testen, der die Anfrage erreicht. Prüfen Sie für Persistenz über Anfragen hinweg, was die API oder Ihre Anwendung speichert und sendet. Die Verfügbarkeit eines großen Kontextfensters zeigt nicht für sich genommen, dass separate Anfragen Memory teilen.
Wie unterscheide ich Modell-Memory von in der App gespeichertem Memory?
Untersuchen Sie die vollständige Anfrage, die an das Modell gesendet wird. Wenn Ihre Anwendung ein Profil, eine abgerufene Notiz oder eine frühere Konversation einfügt, hat diese Software-Schicht das Memory bereitgestellt. Vergleichen Sie gegebenenfalls mit einem kontrollierten Durchlauf, der es auslässt.
Ist es sicher, personenbezogene Informationen in einem Active Memory-Test zu verwenden?
Verwenden Sie für den Test fiktive Informationen. Wenn Sie später echte Daten bewerten, prüfen Sie zuerst die Memory-, Lösch-, Aufbewahrungs- und Datennutzungseinstellungen des jeweiligen Produkts.
Ein Muse Wonder Active Memory-Test ist am nützlichsten, wenn er offenlegt, welcher Schritt fehlgeschlagen ist: Zugriff auf früheren Kontext, Abruf, Korrektur, Filterung oder Unsicherheit. Speichern Sie den Rohdurchlauf und wiederholen Sie ihn anschließend unter dem genauen Setup, dem Sie vertrauen möchten.
Quellen: Metas Muse Wonder-Ankündigung (12. Oktober 2026); Meta Model API-Modelldokumentation (abgerufen am 15. Oktober 2026); Muse Wonder Model Card (Oktober 2026).





