

Ein Benchmark-Spitzenwert kann entschlossen wirken, bis dasselbe Modell beim nächsten Durchlauf eine Anforderung verfehlt. Ein nützlicher Muse Wonder-Zuverlässigkeitstest stellt eine engere Frage: Erfüllt das Modell deine Aufgabe, nach deinem Standard, wiederholt, unter denselben Bedingungen?
Erste Belege sind gemischt, weil die Tests unterschiedliche Dinge messen. Ein Aufgabenset vom Launch-Tag gab dem Standard-Muse-Wonder eine sehr hohe Punktzahl nach einem Durchlauf pro Aufgabe. Eine andere Bewertung fand Stärken in der Rechercheanalyse neben schwächerem Umfragedesign, Verkaufsaussagen und Folienlayout. Keines der Ergebnisse beweist, wie konsistent es mit deiner Codebasis oder deinem Agent-Workflow umgehen wird.
Wichtigste Erkenntnisse
- Behandle Launch-Benchmarks als Fähigkeitssignale, nicht als Produktionsgarantien.
- Muse Wonder und Muse Wonder Full sind separate Varianten. Halte ihre Ergebnisse getrennt.
- Miss Pass-Rate, Wiederholbarkeit, Vollständigkeit und Wiederherstellung als unterschiedliche Ergebnisse.
- Beginne mit 10 bis 20 echten Aufgaben, friere das Setup ein und wiederhole wichtige Aufgaben mindestens dreimal.
- Wähle einen Schwellenwert basierend auf den Kosten einer falschen Antwort und deinem menschlichen Überprüfungsprozess.
Ist Muse Wonder zuverlässig? Die kurze Antwort
Die bis zum 15. Oktober 2026 verfügbaren Belege stützen eine Bewertung Aufgabe für Aufgabe, nicht ein universelles Zuverlässigkeitsurteil. Muse Wonder schnitt bei einigen frühen Prüfungen gut ab, während andere Durchläufe Fehler oder Präsentationsarbeit aufdeckten, die noch überprüft werden musste. Die Studien unterscheiden sich in Prompts, Reasoning-Einstellungen, Bewertern, Stichprobengrößen und Anzahl der Versuche.
(Meta, 12. Oktober 2026) sagt, Muse Wonder und Muse Wonder Full seien für professionelle und persönliche Agent-Aufgaben entwickelt, mit Funktionen namens Active Memory und Active Focus. Das sind Produktaussagen über beabsichtigtes Verhalten. Die Aussage, dass ein Modell sich von Fehlern erholen kann, ist ein Grund, die Wiederherstellung in deinem eigenen Workflow zu testen, nicht ein Beweis dafür, dass es zuverlässig wiederherstellt.
Halte Standard-Wonder getrennt von Wonder Full. Meta listet Standard-Muse-Wonder für seine Model API und Muse Code, während Full über Muse-Code-Abonnements angeboten wird. Standard-Wonder mit einer höheren Reasoning-Einstellung laufen zu lassen, macht es nicht zu Full.
Für eine Entscheidung, die du verteidigen kannst, teste die genaue Variante und den genauen Weg, den du einsetzen willst. Zähle eine Aufgabe nur dann als erfolgreich, wenn sie eine schriftliche Abnahmeregel erfüllt und ihr Ergebnis überprüfbar ist.
Was ein Muse Wonder-Zuverlässigkeitstest messen sollte
Genauigkeit und Konsistenz sind verschieden
Eine Pass-Rate misst, wie viele Versuche eine definierte Bewertungsgrundlage erfüllen. Konsistenz misst, ob wiederholte Durchläufe derselben Aufgabe jedes Mal akzeptable Ergebnisse liefern. Ein Modell kann eine hohe Pass-Rate haben und dennoch auf eine Weise variieren, die für deinen Workflow relevant ist.
Verfolge vier Dimensionen getrennt:
| Maß | Was zu erfassen ist | Beispielprüfung |
|---|---|---|
| Genauigkeit | Versuche, die die Bewertungsgrundlage bestehen | Stimmt die extrahierte Summe mit dem Quelldokument überein? |
| Konsistenz | Ob wiederholte Versuche bestehen und übereinstimmen | Bewahren drei Durchläufe dieselben erforderlichen Einschränkungen? |
| Vollständigkeitsqualität | Ob jedes angeforderte Ergebnis vorliegt | Sind alle Dateien, Zitate und angeforderten Felder enthalten? |
| Wiederherstellung | Ob der Durchlauf nach einem Fehler korrekt fortgesetzt wird | Meldet er einen Tool-Fehler, versucht er sicher erneut und verifiziert er den Endzustand? |
Eine Antwort, die vollständig klingt, ist nicht unbedingt vollständig. Eine Codeänderung braucht Tests; eine Recherchezusammenfassung braucht nachvollziehbare Quellen; ein Agent-Durchlauf braucht Nachweise, dass seine letzte Aktion stattgefunden hat.
Trenne Modellfehler von Workflow-Fehlern
Erfasse genügend Kontext, um einen Modellfehler von einem Serving- oder Tool-Problem zu unterscheiden. Protokolliere mindestens die Modellvariante und -version, die Reasoning-Einstellung, den Prompt, die Tool-Konfiguration, das Datum, die Laufzeit, Token- oder Aufgabenkosten und die Rohausgabe.
Klassifiziere Fehler, bevor du sie bewertest:
- Modell: falsche Tatsache, schlechte Argumentation oder verfehlte Anforderung.
- Tool: fehlgeschlagener API-Aufruf, ungültige Tool-Argumente oder falsches Ergebnis aus einem externen System.
- Serving: Timeout, Unterbrechung oder nicht verfügbarer Endpunkt.
- Bewertung: unklare Bewertungsgrundlage oder eine Prüfung, die akzeptable nicht von inakzeptabler Arbeit unterscheiden kann.
Wenn du alle vier in einer einzigen Fehlerrate zusammenfasst, weißt du nicht, was zu beheben ist.
Was aktuelle Muse Wonder-Tests zeigen
Metas veröffentlichte Benchmark-Vergleiche sind Anbieter-Belege über Benchmark-Leistung. Sie sind nicht dasselbe wie eine unabhängig durchgeführte Workflow-Bewertung. Unabhängige Tests haben ebenfalls Grenzen: ein kleines öffentliches Aufgabenset, ein Versuch, ein bestimmter Modellweg oder eine menschliche Präferenzbewertung beantworten nur eine enge Frage.
Die folgende Tabelle trennt die Belege nach Quelle und Umfang. Sie ist ein Leitfaden dafür, was jedes Ergebnis stützen kann, keine kombinierte Punktzahl.
| Belegquelle | Was getestet wurde | Datum und Setup | Was es dir sagen kann | Wichtigste Einschränkung |
|---|---|---|---|---|
| Meta-Ankündigung und Modellmaterialien | Fähigkeits-Benchmarks und beabsichtigte Agent-Funktionen | Angekündigt am 12. Oktober 2026; anbieterberichtete Vergleiche | Welche Fähigkeiten Meta betont und welche Varianten es veröffentlicht hat | Anbietertests belegen keine Wiederholbarkeit in deinem Workflow |
| (Spring Prompt, 13. Oktober 2026) | Umfragen, Produkteinträge, Folien, Anzeigenplanung, Schach und visuelle Suche | 13. Oktober; Standard-API-Modell, generell mittleres Reasoning; öffentliche Aufgaben | Die Leistung variierte je nach Aufgabe; einige Bewertungen umfassten wiederholte Produkteintrag-Durchläufe | Die meisten Aufgaben waren kleine Stichproben; viele Ergebnisse waren ein Durchlauf pro Aufgabe; kein Coding- oder Muse-Code-Test |
| (Quantslant, 12. Oktober 2026) | 23 Aufgaben aus den Bereichen Agenten, Coding, Schreiben, Reasoning und ein langes Dokument | 12. Oktober; Standardmodell über OpenRouter, niedriges Reasoning; ein Durchlauf pro Aufgabe | Das Modell bestand dieses definierte Aufgabenset unter diesem Setup mit hoher Rate | Ein einzelner Durchlauf kann keine Konsistenz zwischen Durchläufen messen; Ergebnisse nahe 100 % erfordern eine Prüfung auf Aufgabenebene |
| Community-Beiträge | Einzelne Coding-, Agent- und Benchmark-Reaktionen | Beiträge aus der Launch-Phase; selbst ausgewählte Nutzer und Aufgaben | Nützliche Hinweise darauf, was als Nächstes zu testen ist | Anekdoten und Abstimmungen sind keine gemessenen Pass-Raten |
Der Quellenkontrast ist wichtig. Quantslant berichtete 99,7 % über sein 23-Aufgaben-Set, mit einem Durchlauf pro Aufgabe und einer niedrigen Reasoning-Einstellung. Es bemerkte auch einen fehlgeschlagenen Unit-Test in einer Coding-Aufgabe zur Zahl-zu-Wort-Umwandlung. Dieses Ergebnis ist ein Beleg über diese bestimmte Suite, nicht ein Beleg dafür, dass 99,7 % der Alltagsaufgaben bestehen werden oder dass wiederholte Durchläufe übereinstimmen.
Spring Prompt berichtete am 13. Oktober ein variableres Bild für Standard-Wonder bei API-Standardeinstellungen. Der Rechercheanalyse-Wert lag bei 93,6/100 über neun öffentliche Aufgaben, während nur drei von neun Umfrageplänen alle Prüfungen bestanden. Bei Produkteinträgen lag der Anteil, der über drei Wiederholungen als zuverlässig veröffentlichungsreif eingestuft wurde, bei 66,1 % für faktische Briefings und 51,8 % für Verkaufs-Briefings. Fünf von sechs Foliendecks benötigten Layout-Korrekturen, und eines wurde als präsentabel beurteilt. Das sind separate Maße mit separaten Grundgesamtheiten, keine Teile einer Gesamtpunktzahl.
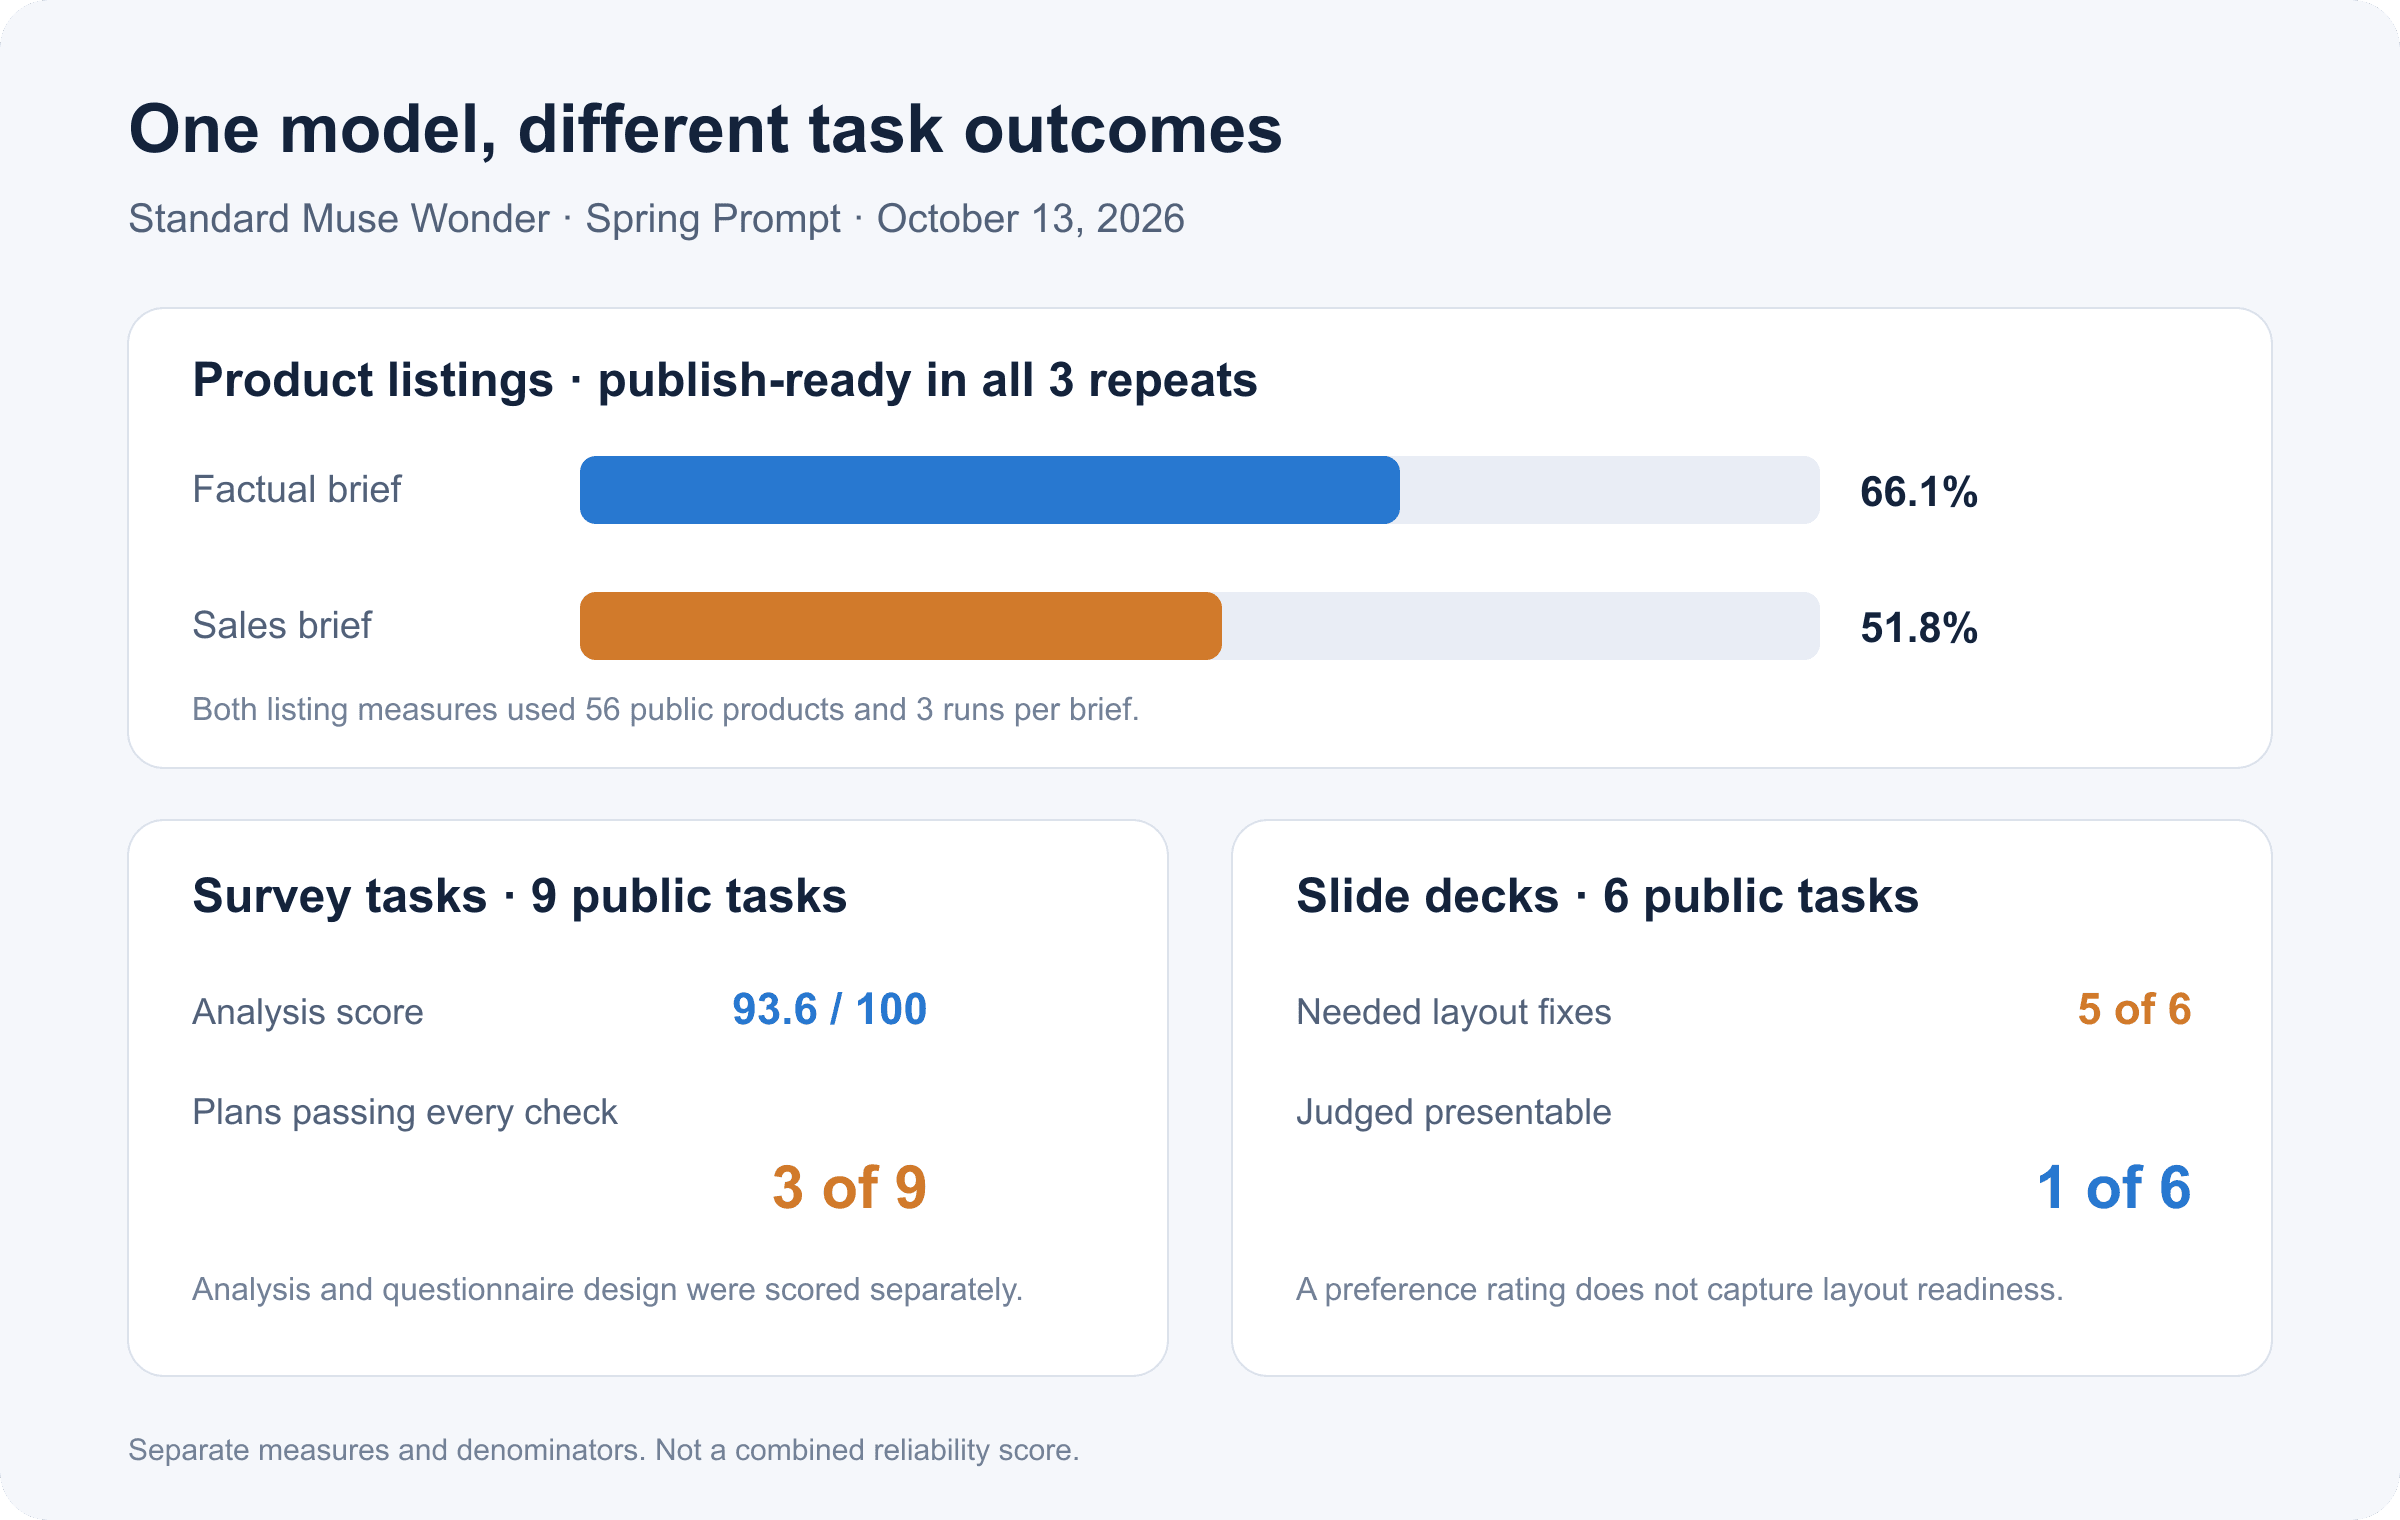
Spring Prompts Ergebnisse für Standard-Muse-Wonder vom 13. Oktober 2026: wiederholt getestete Eintrags-Pass-Raten, Umfrageanalyse und Deck-Review-Ergebnisse
Unabhängige Aufgabenergebnisse aus einer Bewertung. Die Maße verwenden unterschiedliche Grundgesamtheiten und werden getrennt dargestellt, nicht zu einer Punktzahl kombiniert.
Spring Prompts Tests haben weder Coding noch persistentes Gedächtnis noch Muse Code gemessen. Der Vergleich kann daher nicht klären, ob Wonder für Coding zuverlässig ist oder ob Full besser abschneidet. Er zeigt jedoch, warum ein einzelnes breites Label wichtige Aufgabenunterschiede verbirgt.
Metas Launch-Artikel besagt, dass Standard-Muse-Wonder über die Meta Model API und Muse Code verfügbar ist, während Wonder Full für Muse-Code-Abonnenten verfügbar ist. Er beschreibt Active Memory und Active Focus als Funktionen zum Behalten nützlicher Details und zum Fortsetzen der Arbeit durch Fehler hindurch. Diese Beschreibungen helfen, Testfälle zu definieren, aber der Launch-Artikel ist keine unabhängige Studie mit wiederholten Durchläufen.
Bei Coding- und 3D-Build-Behauptungen, die in Community-Threads der Launch-Woche diskutiert wurden, behandle Beiträge als Hypothesen. Verwandle eine konkrete Beschwerde in eine reproduzierbare Aufgabe und überprüfe die Ausgabe. Wandele Kommentare oder Upvotes nicht in eine Erfolgsrate um.
Wie man einen wiederholbaren Muse Wonder-Zuverlässigkeitstest durchführt
1. Baue ein kleines Aufgabenset aus echter Arbeit auf
Wähle 10 bis 20 Aufgaben, von denen dein Team tatsächlich erwartet, dass das Modell sie bewältigt. Teile sie in Kategorien wie Coding, faktische Extraktion, Befolgen von Anweisungen, langer Kontext und Tool-Nutzung auf. Bevorzuge Aufgaben mit objektiven Tests, Referenzantworten oder einer klaren Bewertungsgrundlage.
Nimm realistische Randfälle auf: fehlende Eingabe, widersprüchliche Anforderungen, ein nicht verfügbares Tool und eine Aufgabe, die eine Klärungsfrage auslösen sollte. Halte sensible oder regulierte Daten außerhalb, es sei denn, dein genehmigter Prozess erlaubt es.
2. Friere Prompt, Modell und Einstellungen ein
Schreibe den genauen Prompt und die Systemanweisungen auf. Erfasse den Modellnamen und die Version, das Reasoning-Level, die Tools, den bereitgestellten Kontext, das Datum und etwaige Zeitlimits. Vergleiche Standard-Wonder nicht mit Full, als wären sie dasselbe Modell.
Ein nützlicher Test-Prompt kann das Modell bitten, seine Belege zu zeigen und nicht testbare Anforderungen zu identifizieren:
Lies die beigefügte Spezifikation und Implementierung. Gib nur zurück: (1) jede Anforderung markiert mit PASS, FAIL oder NOT TESTABLE; (2) den genauen Beleg für jeden Status; (3) jede fehlende Anforderung; (4) einen minimal reproduzierbaren Test für jedes FAIL. Behaupte nicht, dass ein Test bestanden wurde, es sei denn, du kannst auf seine Ausgabe verweisen.
Dies ist eine Bewertungseingabe, keine Garantie dafür, dass das Modell ihr folgen wird. Bewerte die resultierende Antwort und überprüfe jede behauptete Testausgabe unabhängig.
3. Wiederhole Aufgaben und bewerte jeden Versuch
Führe jede Aufgabe mit hoher Auswirkung mindestens dreimal mit demselben Setup aus. Wenn das Budget nur einen Versuch erlaubt, kennzeichne das Ergebnis als erste Stichprobe statt als Konsistenzergebnis. Bewahre jede Rohantwort auf; berichte nicht nur die beste.
Verwende eine Zeile für jeden Versuch. Halte die Abnahmeregel über die Durchläufe hinweg stabil.
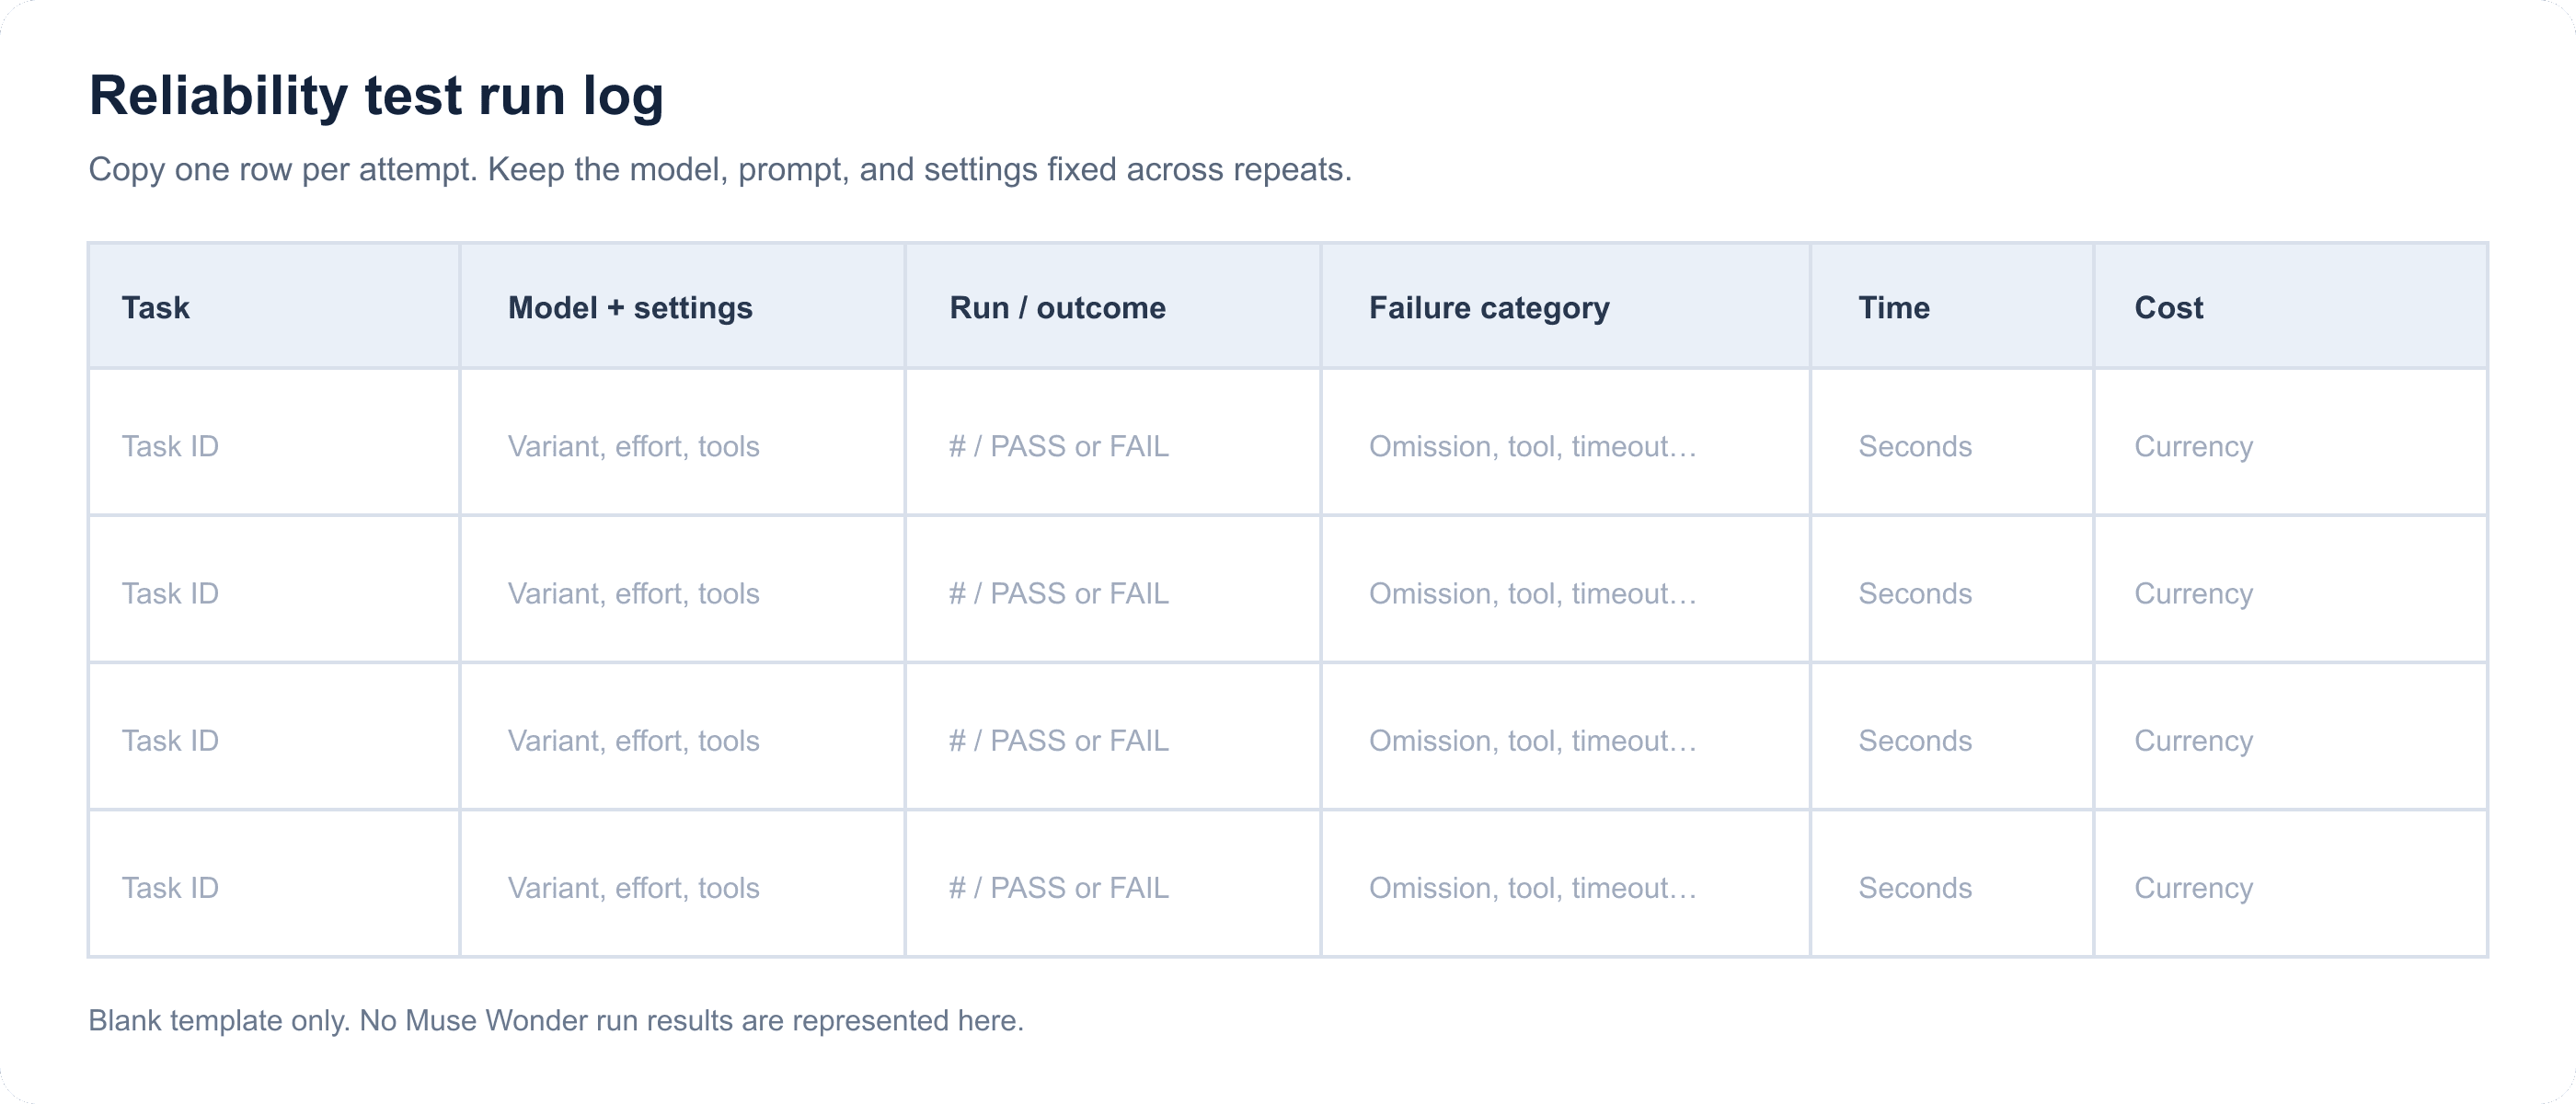
Leeres Muse Wonder-Zuverlässigkeitstest-Protokoll mit Feldern für Aufgabe, Modell, Durchlauf, Ergebnis, Fehler, Zeit und Kosten
Wiederverwendbare leere Vorlage. Fülle eine Zeile pro Versuch aus; sie enthält keine gemessenen Muse Wonder-Ergebnisse.
4. Führe ein Fehlerprotokoll und überprüfe die Wiederherstellung
Verwende spezifische Kategorien: sachlicher Fehler, Auslassung, fehlgeschlagener Code-Test, Tool-Fehler, Timeout, nicht unterstützte Vollständigkeitsbehauptung oder Format-Abweichung. Notiere bei mehrstufiger Arbeit, wo der Durchlauf gestoppt wurde und ob ein erneuter Versuch abgeschlossene Aktionen wiederholte oder den Endzustand verifizierte.
Ein Agent, der „fertig" sagt, ohne Belege, hat keine Vollständigkeitsprüfung bestanden. Verlange ein Testergebnis, eine gespeicherte Datei, eine Quellenangabe oder einen verifizierten Zustand, der zur Aufgabe passt.
5. Lege einen Entscheidungsschwellenwert rund um Fehlerkosten fest
Es gibt keinen nützlichen universellen Pass-Rate-Grenzwert. Ein Entwurf, den eine Person Zeile für Zeile prüft, hat ein anderes Risikoprofil als eine Datenbankmigration oder eine automatisierte Zahlung.
Lege den Schwellenwert aus drei Faktoren fest:
- Wie schädlich oder teuer ist ein falsches Ergebnis?
- Kann eine Person den Fehler erkennen, bevor er jemanden betrifft?
- Schlägt der Workflow sicher fehl, mit einem klaren Stopp und Prüfpfad?
Bei risikoarmen Entwürfen kann eine Überprüfung ausreichen. Bei Codeänderungen, Finanzen, Recht, Gesundheit oder Aktionen, die Nutzer betreffen, verwende stärkere Tests und unabhängige Verifikation. Lass nicht zu, dass ein hoher Durchschnitt einen schwerwiegenden Fehlermodus verbirgt.
Muse Wonder-Zuverlässigkeit nach Aufgabentyp
Coding und mehrstufige Builds
Führe die tatsächliche Testsuite des Repositorys aus und prüfe das angeforderte Verhalten. Bewerte Anforderungsabdeckung, Regressionsfehler und ob die behaupteten Änderungen des Modells mit den Dateien und der Testausgabe übereinstimmen. Eine überzeugende Bildschirmaufnahme oder Erklärung ist kein Ersatz für eine ausführbare Prüfung.
Die frühe Quantslant-Suite umfasste vier Coding-Aufgaben und berichtete, dass 15 von 16 Unit-Tests bei einer Zahl-zu-Wort-Aufgabe bestanden wurden. Das ist ein kleines Signal aus einem einzelnen Durchlauf. Spring Prompt hat Coding ausdrücklich nicht getestet, daher sollten seine Ergebnisse nicht verwendet werden, um über die Zuverlässigkeit von Coding-Agenten zu verallgemeinern.
Recherche und faktische Extraktion
Verwende ein Quellenpaket oder Referenzantworten, die dein Prüfer einsehen kann. Prüfe jede sachliche Behauptung gegen eine Primärquelle und verfolge erfundene Zitate und falsche Zuordnungen getrennt von der allgemeinen Antwortqualität.
Spring Prompts Umfrageanalyse war eine relative Stärke in seiner kleinen Bewertung, aber das Design von Umfragefragen war schwächer. Ein hoher Analysewert sollte nicht stillschweigend das Umfrageinstrument oder die Quellen hinter einer neuen Rechercheaufgabe zertifizieren.
Langkontext- und Agent-Workflows
Prüfe, ob das Modell jede Einschränkung beibehält, jedes Tool korrekt verwendet und den Endzustand verifiziert. Teste die Unterbrechungswiederherstellung bewusst: Stoppe einen Durchlauf nach einem bekannten Schritt und sieh dann, ob er von einem Checkpoint fortsetzt oder einen Seiteneffekt wiederholt.
Metas Ankündigung beschreibt Gedächtnis- und Wiederherstellungsfähigkeiten, aber die hier zitierten öffentlichen frühen Bewertungen belegen keine Langzeitkonsistenz für persistentes Gedächtnis oder Agent-Wiederherstellung. Miss diese Verhaltensweisen direkt, bevor du dich auf sie verlässt.
Muse Wonder vs. Muse Wonder Full: Belege getrennt halten
Muse Wonder und Muse Wonder Full sind unterschiedliche Varianten. Metas Launch-Informationen beschreiben separate Zugangswege, und unabhängige API-Tests von Standard-Wonder werden nicht zu Full-Ergebnissen, nur weil sich die Reasoning-Einstellung ändert.
| Vergleichsfrage | Was die verfügbaren Belege stützen |
|---|---|
| Ist Full dasselbe wie Standard-Wonder bei maximalem Reasoning? | Nein. Behandle sie als unterschiedliche Varianten und erfasse den genauen Namen. |
| Hat die zitierte Spring Prompt-API-Bewertung Full getestet? | Nein. Sie testete Standard-Wonder; Full lag außerhalb dieses Vergleichs. |
| Können die zitierten Standard-API-Zahlen Full einordnen? | Nein. Sie testen Full nicht. |
| Was würde einen fairen Vergleich ausmachen? | Dasselbe Aufgabenset, dieselbe Bewertungsgrundlage, dasselbe Datumsfenster, derselbe Tool-Zugang und dokumentierte Einstellungen, mit Wiederholungen für beide Varianten. |
Ein fairer Vergleich beginnt mit gepaarten Aufgaben und abgestimmten Bedingungen. Wenn Zugangswege unterschiedliche Prompts, Tools oder Abrechnungen auferlegen, dokumentiere diese Unterschiede und bezeichne den Vergleich als explorativ.
Kosten, Zugang und wo man Muse Wonder testet
Vergleiche die Kosten pro akzeptierter Aufgabe, nicht nur den gelisteten Preis pro Token. Lange Prompts, Wiederholungen, Reasoning-Token, Tool-Aufrufe, Timeouts und menschliche Überprüfung verändern alle die Kosten eines brauchbaren Ergebnisses. Quantslant berichtete die Token-Raten von Standard-Wonder mit 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token am 12. Oktober 2026, und sein eigener 23-Aufgaben-Durchlauf kostete 0,64 $. Das ist ein berichteter Weg und eine Arbeitslast, kein universeller Aufgabenpreis.
Metas aktuelle Launch-Ankündigung listet Standard-Wonder über die Meta Model API und Muse Code und Full über Muse-Code-Abonnements. Bestätige den Zugang, die regionale Berechtigung und die aktuelle Abrechnung in der offiziellen Oberfläche, bevor du budgetierst.
Beginne bei Atlas Cloud für einen breiteren Blick auf seine Entwicklerplattform. Stand 15. Oktober 2026 konnte ich Muse Wonder im Modellkatalog nicht bestätigen, daher stellt dieser Artikel Atlas Cloud nicht als Ausführungsweg für dieses Modell dar. Wenn dein Team andere dort bereits gelistete Modelle vergleicht, kann die Atlas Cloud-Modellbibliothek dir helfen, Kandidaten zu identifizieren, die gegen dasselbe Aufgabenset ausgeführt werden können.
Das nützliche Ergebnis eines Muse Wonder-Zuverlässigkeitstests ist eine an Belege gebundene Deployment-Entscheidung: welche Aufgabe bestanden wurde, wie oft sie bestanden wurde, was sie gekostet hat und welche Überprüfung weiterhin erforderlich ist.
Häufig gestellte Fragen
Ist Muse Wonder für Coding zuverlässig?
Frühe Launch-Tests liefern nur eine kleine Coding-Stichprobe. Quantslant berichtete vier Coding-Aufgaben, mit einem Unit-Test-Fehler in einer Aufgabe, während Spring Prompt Coding nicht getestet hat. Führe Repository-Tests mit deinen eigenen Aufgaben aus und wiederhole wichtige, bevor du eine Coding-Workflow-Entscheidung triffst.
Wie teste ich die Muse Wonder-Zuverlässigkeit selbst?
Verwende ein festes Set echter Aufgaben, bewahre die genauen Modell- und Prompt-Einstellungen auf, definiere Bestehenskriterien im Voraus und behalte jede Ausgabe. Wiederhole wichtige Aufgaben und verifiziere Ergebnisse mit Tests oder Quelldokumenten.
Wie oft sollte ich jede Muse Wonder-Aufgabe wiederholen?
Verwende mindestens drei Durchläufe für Aufgaben mit hoher Auswirkung als anfängliche Konsistenzprüfung. Drei Versuche bleiben eine kleine Stichprobe, erweitere das Set also, wenn Fehler kostspielig sind oder die Ausgaben variieren.
Was ist der Unterschied zwischen Muse Wonder und Muse Wonder Full?
Es sind separate Modellvarianten mit unterschiedlichen Verfügbarkeitswegen. Behandle Standard-Wonder bei maximalem Reasoning nicht als Full und übertrage Ergebnisse nicht zwischen ihnen ohne einen abgestimmten Test.
Kann ich Metas Muse Wonder-Benchmark-Werte vertrauen?
Verwende sie als anbieterberichtete Fähigkeitsbelege und lies das Benchmark-Setup. Sie beweisen keine konsistente Leistung über deine Prompts, Tools und wiederholten Durchläufe hinweg.
Ist Muse Wonder auf Atlas Cloud verfügbar?
Ich konnte es im Modellkatalog von Atlas Cloud zum 15. Oktober 2026 nicht verifizieren. Prüfe den Live-Katalog, bevor du einen Ausführungsanbieter wählst.





