MiniMax hat H3 am Freitag veröffentlicht. Innerhalb von 24 Stunden war Seedance 2.5 in den Händen der Nutzer, und der Zeitplan kollabierte in ein einziges Gespräch: 30 Sekunden, natives 4K, 50 Referenz-Eingaben. H3s Launch-Post lag still darunter, fast niemand hat einen echten Test damit durchgeführt.
Ich verstehe, warum. 30 Sekunden ist eine tolle Zahl. Sie passt in eine Schlagzeile.
Aber wenn du tatsächlich vertikale Kurz-Dramen produzierst, weißt du, dass das, was dir die Nacht verdirbt, nicht Sekunde 30 ist. Es ist Aufnahme 4. Der Kiefer des männlichen Leads verschiebt sich einen halben Zentimeter, seine Krawatte verliert eine Falte, und der Zuschauer wischt weiter, bevor der Haken sitzt. Niemand steigt wegen eines Clips von 15 statt 30 Sekunden aus. Sie steigen aus, weil der Typ in der Nahaufnahme nicht der Typ aus der Totalen ist.
Also habe ich den Datenblatt-Duell übersprungen. Ich habe ein Charakter-Turnaround-Blatt erstellt, eine sechsteilige Location-Tafel, einen 15-sekündigen Gothic-Kurz-Drama-Prompt geschrieben und das identische Paket an beide Seiten geschickt. Dann habe ich das Gesicht angestarrt.
Wichtige Erkenntnisse
- Nur H3 ist heute aufrufbar — Seedance 2.5s API ist bei ByteDance draußen, aber auf dieser Plattform noch eine Day-0-Seite.
- Spezifikationen trennen sich sauber: Seedance 2.5 = 30s in einem Durchlauf, natives 4K, bis zu 50 Referenzen; H3 = 5–15s, 2K, Stereo-Audio auf jedem Clip.
- Charakterstabilität ist ein Verpackungsproblem — ein gutes Referenzpaket, kein größeres Modell, hält das Gesicht.
- Beide erzeugen natives Audio; H3 fixiert zusätzlich eine Stimme aus bis zu drei Audio-Referenzen.
- Beurteile Pixel pro Frame, nicht Sekunden — im selben Durchlauf lieferte H3 1440p gegenüber Seedances 720p.
Das Seedance 2.5 vs MiniMax H3 Ergebnis, vor jeder Theorie
Bevor wir Theorien aufstellen, hier das, was der Workflow produziert. Das sind vier Einstellungen aus einem fertigen 15-sekündigen vertikalen Clip, nebeneinander. Es ist MiniMax' eigener H3-Referenzlauf, erstellt exakt aus dem Charakterblatt und der Location-Tafel, die du in Schritt 1 und Schritt 2 sehen wirst, in nativen 1440x2560. Meine eigenen Läufe des gleichen Pakets kommen später im Tutorial, mit sichtbarem Playground-Status.
Sie erreicht die geschnitzte Tür, das ist Tafel 4 der Location-Tafel, dann der Korridor-Konfrontation, dann eine enge Nahaufnahme von ihm, dann die Zweier-Einstellung. Sein Haaransatz teilt sich im Profil und in der Nahaufnahme gleich. Ihre halb hochgesteckte, geflochtene Krone überlebt eine Nahaufnahme des gesamten Gesichts, genau das, wo die meisten Modelle leise ein Gesicht neu aufbauen. Das cremefarbene Spitzenmieder behält denselben Halsausschnitt und dieselbe Ärmelmanschette vom ersten bis zum letzten Frame.
Das ist der ganze Test. Nicht dreißig Sekunden. Vier Einstellungen und ein Kiefer.
Warum Seedance 2.5 vs MiniMax H3 in derselben Woche durchbrachen und warum die meisten Charaktertests nutzlos sind
MiniMax hat H3 am 30. Juli veröffentlicht, ein allgemeines multimodales Videomodell, das Text, Bilder, Video und Audio als einen Kontext liest und 5 bis 15 Sekunden lange Clips mit bis zu 2K und nativem Stereoton ausgibt. Es kann auch vorhandenes Filmmaterial bearbeiten und Bewegung von einem Clip auf einen anderen übertragen, und MiniMax sagte, Gewichte würden innerhalb weniger Tage folgen (Reuters, Juli 2026).
Seedance 2.5 landete im selben Fenster mit einer lauteren Zahl: 30 Sekunden in einer einzigen Generierung, natives 4K und bis zu 50 multimodale Referenzeingaben in einem Job (The Next Web, Juli 2026). Seine API ist bereits in den Händen von Entwicklern, mit lokalisierter Bearbeitung, die einen Teil eines Frames neu zeichnet, während Performance, Beleuchtung und Kamerabewegung intakt bleiben, Referenz-zu-Video, das Greenscreen-Platten oder 3D-Weißmodell-Blockouts akzeptiert, elf Sprachen und einen experimentellen Langvideo-Modus, der 180 Sekunden erreicht (CineD, Juli 2026).
Die Aufmerksamkeitslücke ist der interessante Teil. Fast jeder Post, den ich finden konnte, war ein 2.5-Clip. In der Zwischenzeit sagen die öffentlichen Arena-Zahlen etwas anderes: Auf dem Artificial Analysis Image-to-Video Leaderboard führt Seedance 2.0 bei 720p mit 1.196 Elo, Gemini Omni Flash folgt mit 1.195, und MiniMax H3 liegt bereits vier Tage nach dem Start mit 1.185 auf Platz drei. Seedance 2.5 hat dort noch keine Bewertung (Artificial Analysis, Juli 2026). Das Modell mit dem geringsten Gesprächsstoff ist das mit dem höchsten Verhältnis von Punktzahl zu Aufmerksamkeit.
Jetzt der Teil, der tatsächlich deine Ausgabe bestimmt, weil er fast nichts damit zu tun hat, welches Logo du wählst.
Die meisten Charakterkonsistenz-Tests schlagen fehl, bevor das Modell überhaupt involviert ist. Vier Fehlermodi, und alle vier liegen bei dir:
| Fehlermodus | Was du in der Ausgabe siehst | Die Lösung |
|---|---|---|
| Multi-View-Referenzen als separate Dateien | Jede Einstellung hat ein „fast richtiges“ Gesicht, und keine zwei stimmen überein | Die Ansichten zu einem Bild zusammensetzen, dann Rollen im Prompt zuweisen („der Mann LINKS", „die Frau RECHTS") |
| Die Charakterbeschreibung pro Einstellung umschreiben | Kleidung und Accessoires driften von Einstellung zu Einstellung | Den Identitätsblock einmal schreiben und wörtlich wiederverwenden; nur Kamera und Aktion ändern sich pro Einstellung |
| Das Licht mit der Szene wandern lassen | Das Gesicht wird im neuen Licht strukturell neu aufgebaut | Eine separate Location-Tafel erstellen, die Lichtrichtung, Nebel und Bodenreflexion fixiert, und als Referenz einfügen |
| Maximale Dauer als Qualitätsmetrik behandeln | Eine Drift innerhalb von 30 Sekunden zerstört alle 30 | Auf die Granularität kürzen, die du wiederholen kannst, dann über Länge sprechen |
Möchtest du Seedance 2.5 und MiniMax H3 selbst mit demselben Prompt testen? Atlas Cloud's Modellvergleich führt sie in einem Durchlauf nebeneinander aus — identischer Prompt und Einstellungen, mit Kostenschätzung vor der Generierung — sodass du Gesichter, Bewegungen und Bildschirmtext beurteilen kannst, ohne zwei separate Tests zu buchen.
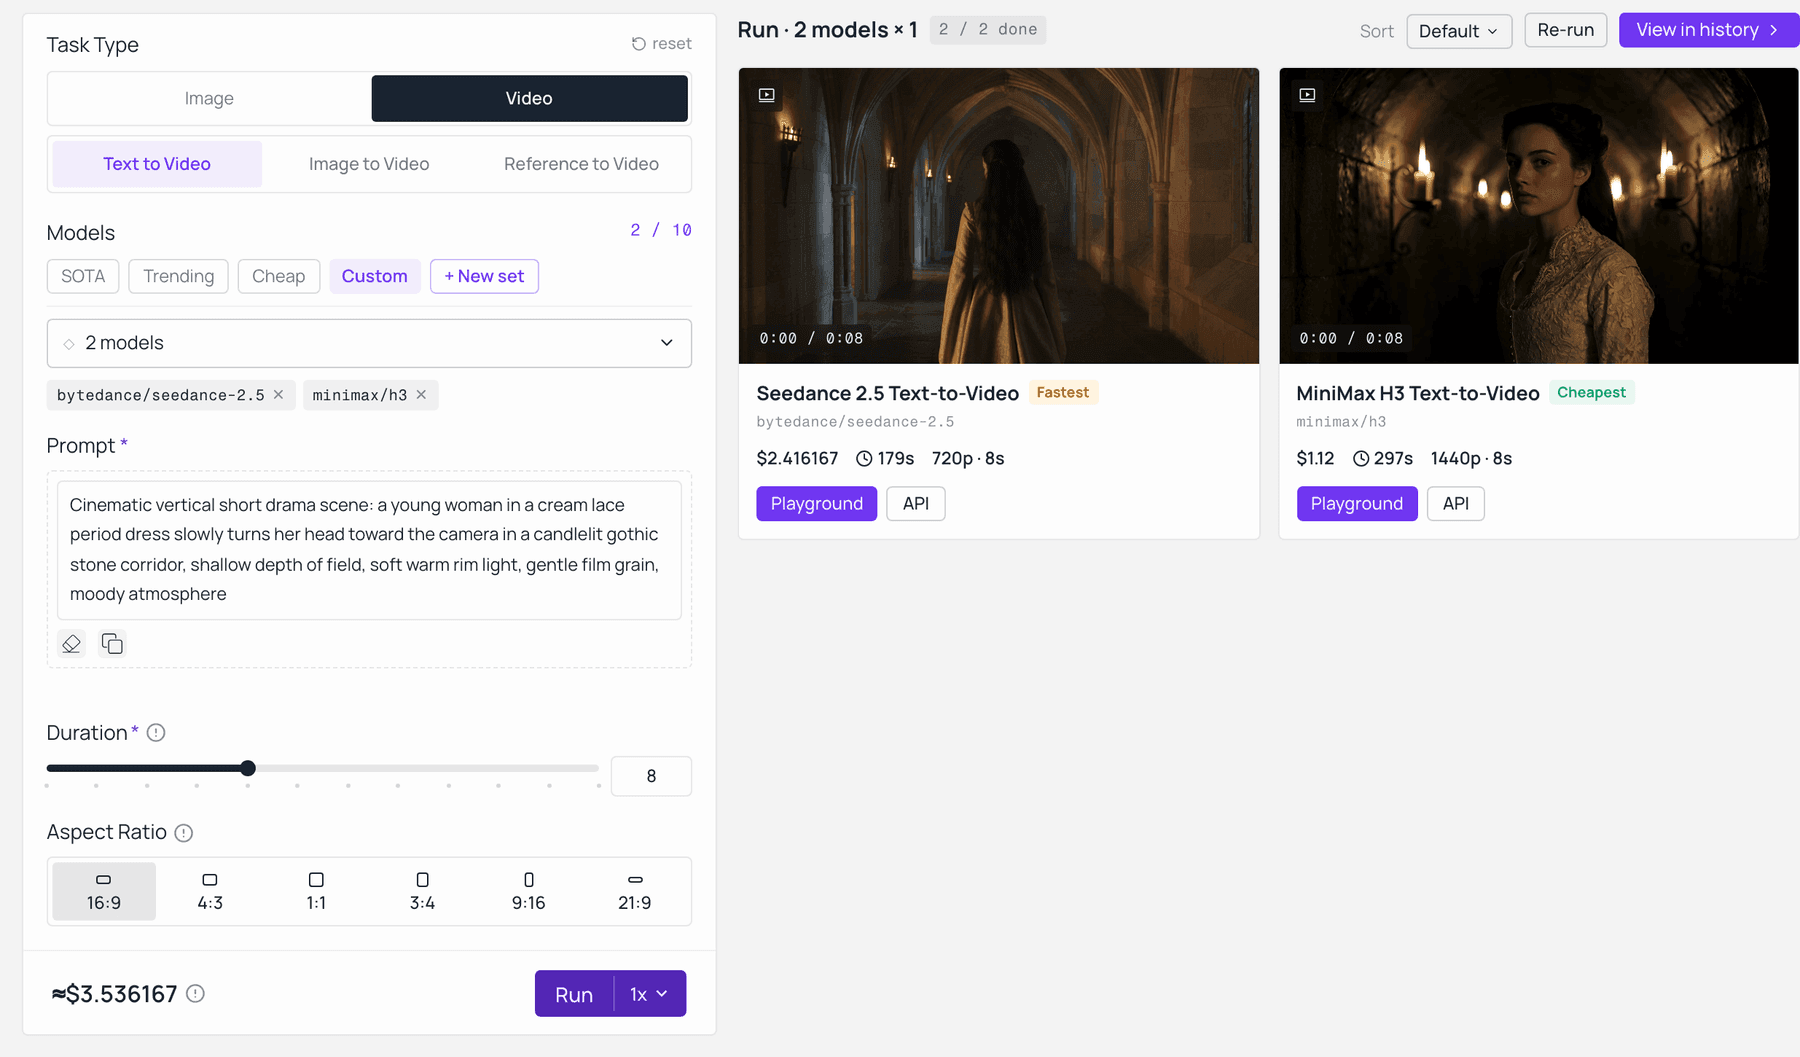
Seedance 2.5 und MiniMax H3 zum identischen Prompt im Atlas Cloud Modellvergleich. Seedance 2.5 lieferte 720p zu $2,42; MiniMax H3 lieferte 1440p für $1,12, und beide Preise wurden vor dem Lauf geschätzt. Live auf dem Modell-Explorer erfasst.
Zeile eins ist die, die die Leute am häufigsten falsch machen. Sende sechs Einzelaufnahmen und das Modell behandelt sie als sechs Kandidatenpersonen und mittelt sie. Sende eine saubere Kompositaufnahme und es behandelt sie als eine Person, die von drei Seiten gesehen wird. Gleiche Pixel, völlig anderes Ergebnis.
Seedance 2.5 vs MiniMax H3 Datenblatt und was du heute tatsächlich aufrufen kannst
Trenne Fähigkeit von Verfügbarkeit, und die Spannung wird klar. Bei roher Fähigkeit liegt Seedance 2.5 vorn bei Dauer, Auflösungsobergrenze, Referenzanzahl und Bearbeitungsgranularität. Bei Verfügbarkeit ist H3 derjenige mit drei Live-Endpunkten auf einer Allzweck-Modellplattform diese Woche. Wenn du KI-Videomodell-Vergleiche für die Planung 2026 machst, zählt die zweite Spalte genauso wie die erste.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video (was ich ausgeführt habe) | |
|---|---|---|---|
| Maximale Länge, eine Generierung | 5 bis 15 s | bis zu 30 s, ohne Stitching (Beta-Modus bis 180 s, experimentell) | Kurzclip-Menü, siehe Modellseite |
| Auflösung | nativ 2K, 1440p kurze Seite bei 16:9 bis 9:16; eine 768p-Stufe ist angekündigt | nativ 4K, 10-Bit-Farbe | bis zu 720p auf diesem Endpunkt |
| Bildrate | 24 fps | nicht separat veröffentlicht | nicht separat veröffentlicht |
| Referenzeingaben | 9 Bilder + 3 Videos + 3 Audio, insgesamt 12 Dateien | bis zu 50 multimodale Referenzen | 9 Bilder + 3 Videos + 3 Audio |
| Natives Audio | ja, jede Ausgabe, Stereo | ja, plus 11 Untertitel- und Sprachsprachen | ja |
| Bearbeitungsgranularität | Gesamtclip-Instruktionsbearbeitung (Charakter, Hintergrund, Beleuchtung, Dialog tauschen) | Regionsebene-Bearbeitung, die einen Teil eines Frames neu zeichnet | Gesamtclip-Instruktionsbearbeitung |
| Prompt-Limit | 7.000 Zeichen | nicht veröffentlicht | nicht veröffentlicht |
| Offene Gewichte | für Tage nach dem Start angekündigt | nicht angekündigt | nicht angekündigt |
| Artificial Analysis I2V Elo, 31. Juli 2026 | 1.185 (3.) | noch nicht bewertet | 1.196 (1., Dreamina 720p Eintrag) |
| Aufrufbar auf der getesteten Plattform | ja, 3 Endpunkte | noch nicht, Day-0-Seite | ja |
Vollständige Offenlegung zum Testaufbau. Seedance 2.5 war auf meiner Plattform zum Zeitpunkt des Tests nicht geöffnet, daher ist die Seedance-Seite Seedance 2.0 Reference-to-Video, das aktuell ausgelieferte Mitglied derselben Familie mit demselben quad-modalen Referenzsystem. Wo 2.5 die Antwort ändern würde, sage ich es. Die Seedance 2.5 Seite ist vorerst ein Day-0-Hinweis.
Alles unten läuft in einem Browser-Tab, mit einem Schlüssel, insgesamt drei Modelle:
| Schritt | Modell | Was es produziert | Wichtige Einstellungen | Was die Kosten treibt |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | das Charakter-Turnaround-Blatt | Qualität hoch, 16:9 | pro Bild, pay-as-you-go, aktueller Satz auf Modellseite |
| 2 | gleiches Modell, zweiter Lauf | die sechsteilige Locations- und Beleuchtungstafel | Qualität hoch, 16:9 | pro Bild, pay-as-you-go |
| 3 | MiniMax H3 Reference-to-Video | der 9:16-Clip mit nativem Audio | 9:16, 2K, Dauer 5 für Test, 15 für den echten Schnitt | Sekunden x Auflösung, Abrechnung pro Sekunde |
| 4 | Seedance 2.0 Reference-to-Video | der Kontrolllauf, identische Eingaben | 9:16, höchste verfügbare Auflösung, gleiche Dauer | Sekunden x Auflösung, Abrechnung pro Sekunde |
| 5 | H3 Reference-to-Video, Clip als Eingabe | eine fixierte Einstellung ohne alles neu zu rollen | gleiche Auflösung, kurze Dauer | Sekunden x Auflösung, Abrechnung pro Sekunde |
H3 hat auch Text-to-Video und Image-to-Video Einträge, falls du eine reine Text-Baseline oder Erst- und Letztbild-Kontrolle möchtest.
Noch etwas Wissenswertes, bevor du einen Batch planst: Bildschirmtext. Diese 15-sekündige H3-Titelsequenz hält englische Credits durch acht harte Schnitte ohne einen einzigen Rechtschreibfehler, was eines der schwierigsten Dinge ist, in generiertem Video stabil zu halten.
Der Seedance 2.5 vs MiniMax H3 Kurz-Drama-Workflow, Schritt für Schritt
Fünf Schritte. Kopiere die Prompts exakt wie geschrieben, einschließlich der hässlichen Teile. Ich habe sie für den Artikel nicht bereinigt, und du solltest sie für das Modell nicht bereinigen.
Schritt 1: Erstelle das Charakterblatt mit GPT Image 2
Erstelle das Referenzpaket, bevor du irgendein Video erstellst. Ein Bild, zwei Charaktere, drei Ansichten pro Person, reiner weißer, nahtloser Hintergrund, gleichmäßiges Studiolicht. Das entfernt jede Mehrdeutigkeit außer der, die dir wichtig ist: Wie sieht diese Person aus?
plaintext1Ein Ganzkörper-Charakter-Turnaround-Referenzblatt auf rein weißem, nahtlosem Hintergrund, zwei Charaktere nebeneinander, insgesamt sechs Figuren, gleichmäßiges neutrales Studiolicht, keine Schatten auf dem Boden, kein Text, keine Beschriftungen, kein Wasserzeichen. 2 3LINKE HÄLFTE, männlicher Lead, drei Ansichten in einer Reihe: frontal, rechtes Profil, Rücken. Ende 20, blasse Haut, dunkles, welliges, mittellanges Haar, scharfes Kinn. Trägt einen bodenlangen schwarzen Samt-Spenzer mit subtiler Ton-in-Ton-Stickerei auf Revers und Manschetten, eine schwarze Brokatweste, eine schwarze Seidenkrawatte, gerade schwarze Hosen, polierte schwarze Derby-Schuhe aus Leder. Arme entspannt an den Seiten, neutraler Ausdruck. 4 5RECHTE HÄLFTE, weiblicher Lead, drei Ansichten in einer Reihe: frontal, rechtes Profil, Rücken. Anfang 20, heller Teint, langes, welliges, kastanienbraunes Haar mit einer halb hochgesteckten geflochtenen Krone. Trägt ein cremefarbenes viktorianisches Baumwoll-Spitzenkleid, lange Ärmel mit Spitzenmanschetten, tailliertes Mieder mit kleinen Knöpfen, voller knöchellanger Rock, cremefarbene Knöchelriemen-Pumps mit niedrigem Absatz. Arme entspannt an den Seiten, neutraler Ausdruck. 6 7Fotografischer Realismus, konsistenter Maßstab zwischen allen sechs Figuren, Füße auf derselben Grundlinie ausgerichtet, scharfer Fokus von Kante zu Kante.
Einstellungen: Modell OpenAI GPT Image 2 Text-to-Image, Qualität hoch, Seitenverhältnis 16:9, alles andere Standard.
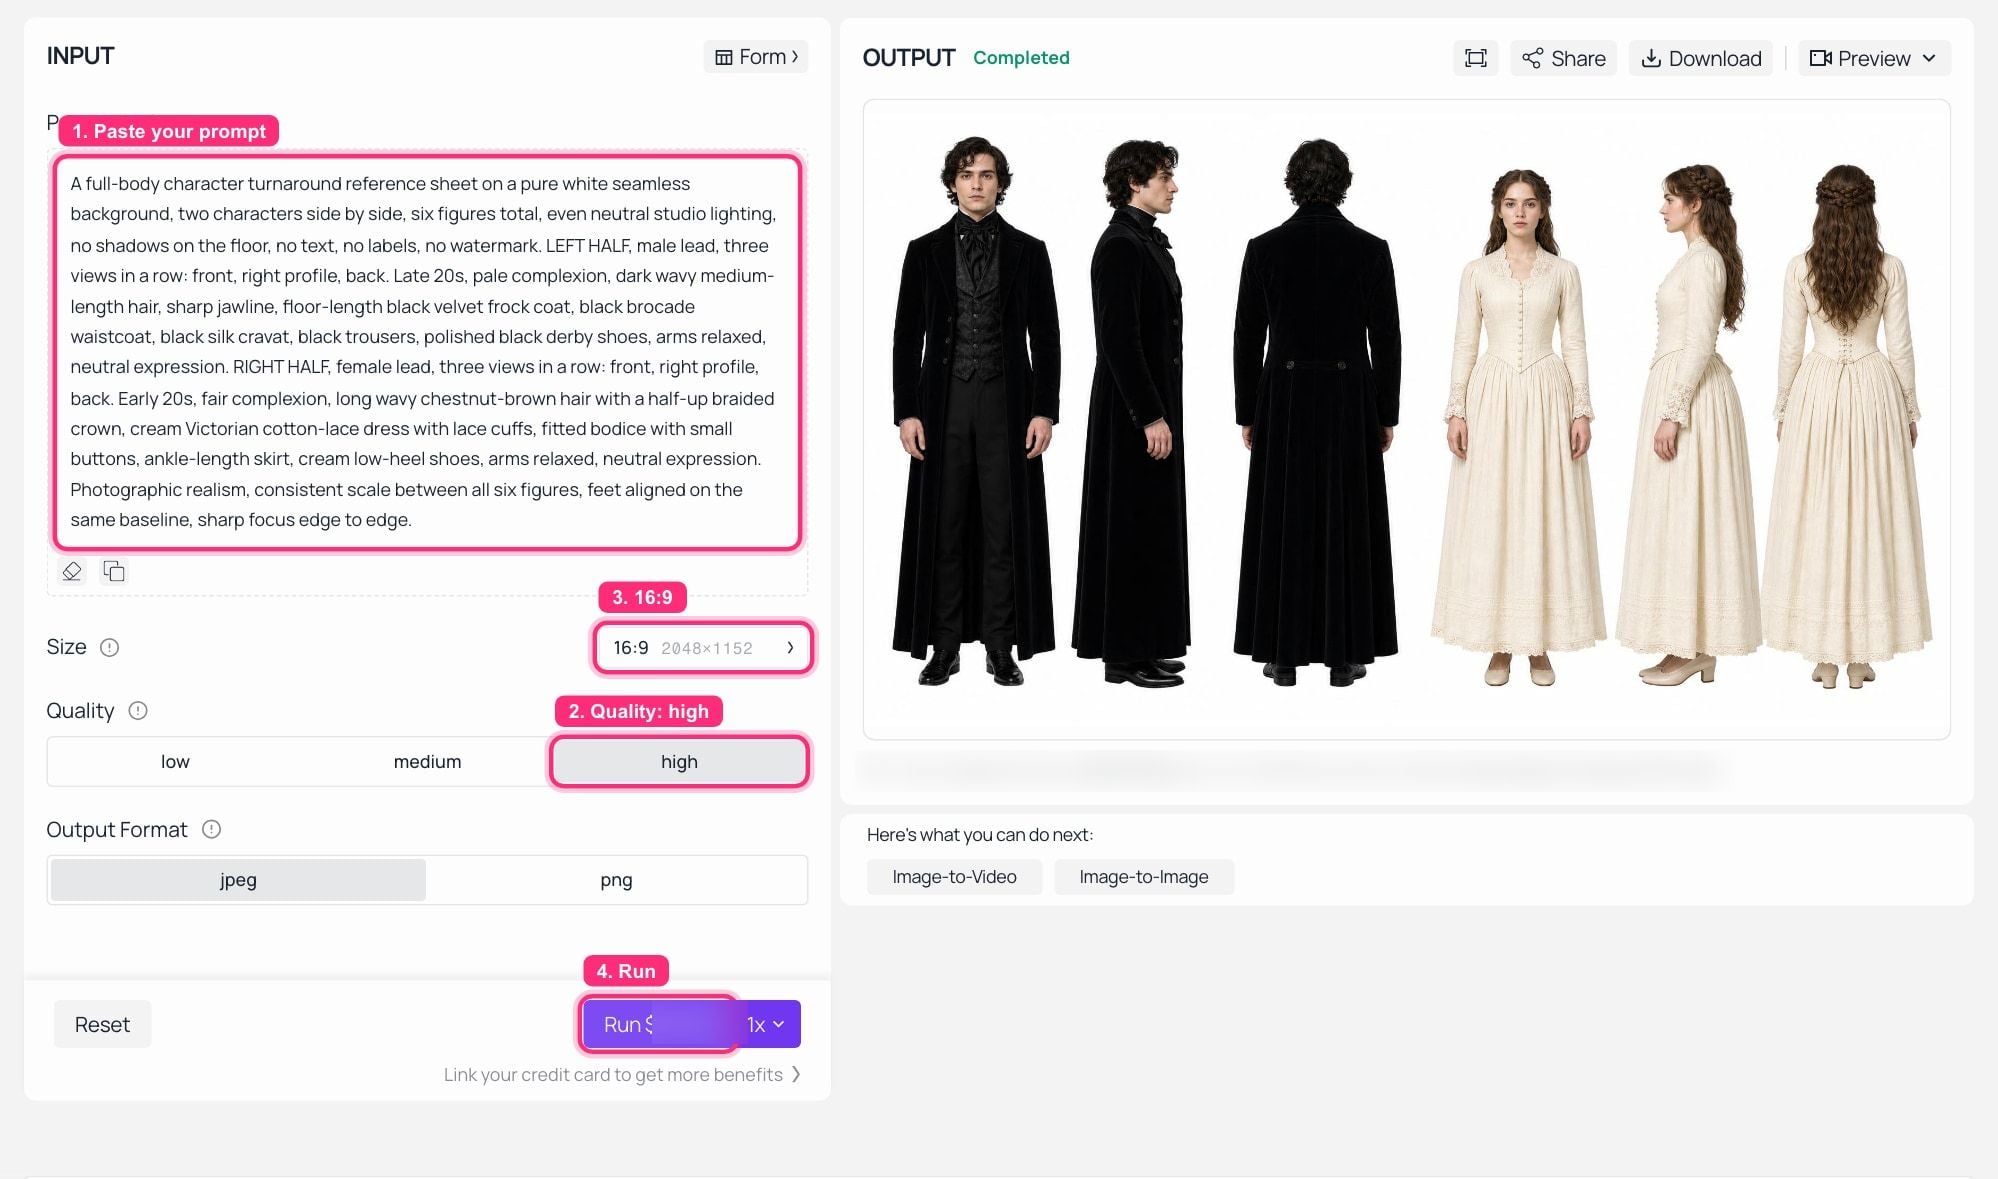 GPT Image 2 Text-to-Image auf Atlas Cloud, Lauf abgeschlossen: der Turnaround-Prompt links, sechs Figuren auf einem weißen Blatt im OUTPUT-Panel.
Dies ist die Zielform. Sechs Figuren, eine Grundlinie, nichts im Hintergrund, worüber man streiten könnte:
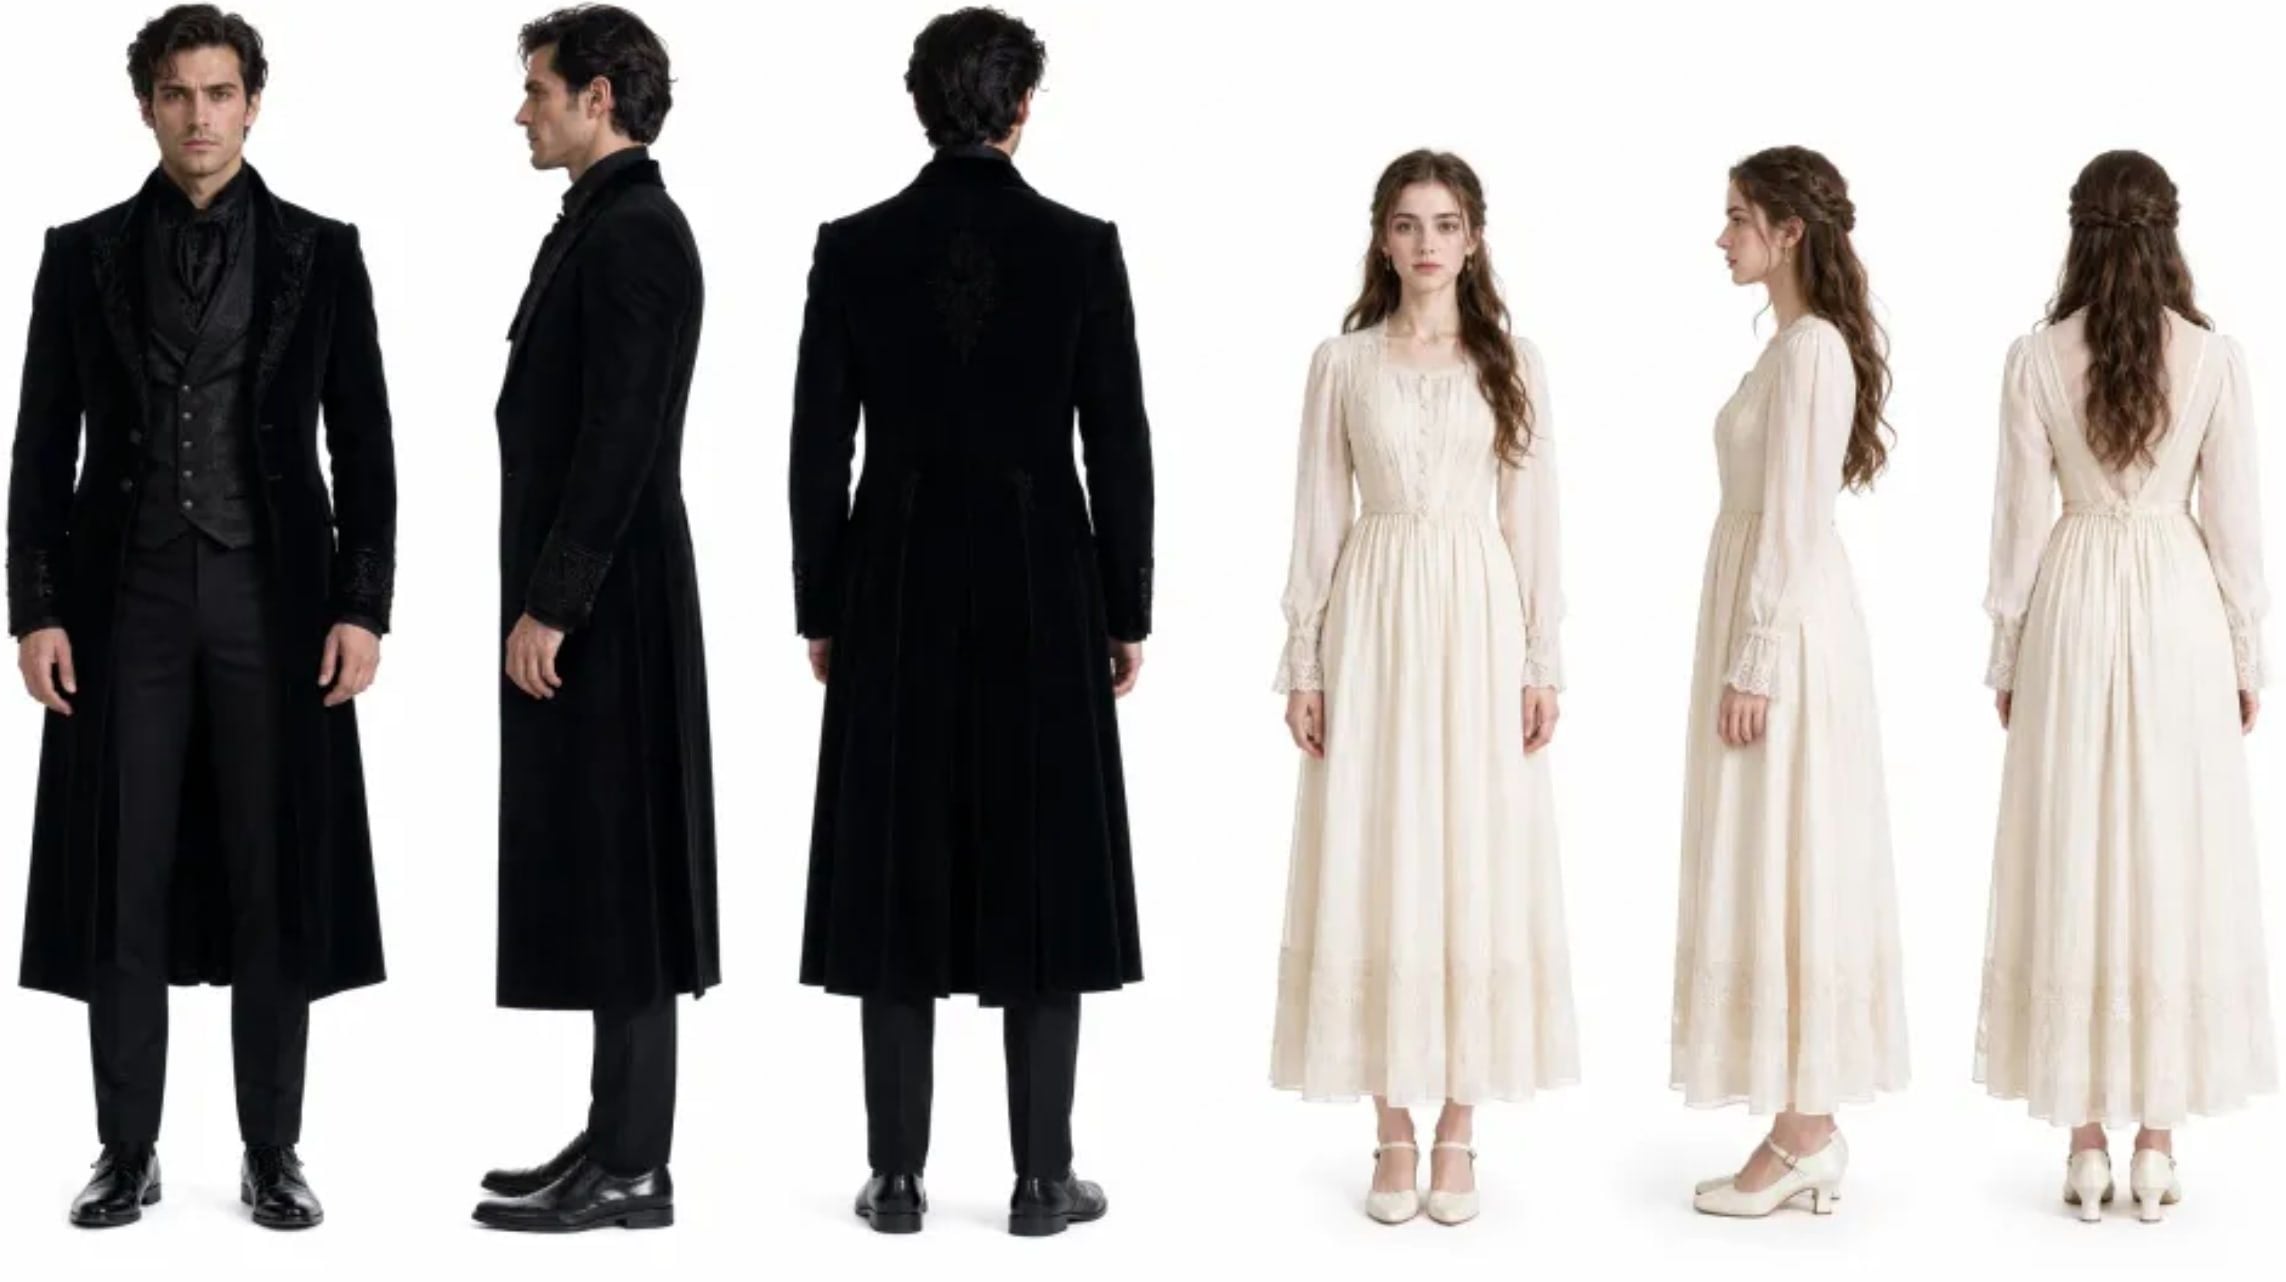 Das Referenzpaket, das den Demo-Clip antrieb: männlicher Lead in schwarzem Samt, weiblicher Lead in cremefarbener viktorianischer Spitze, drei Ansichten pro Person, eine Datei.
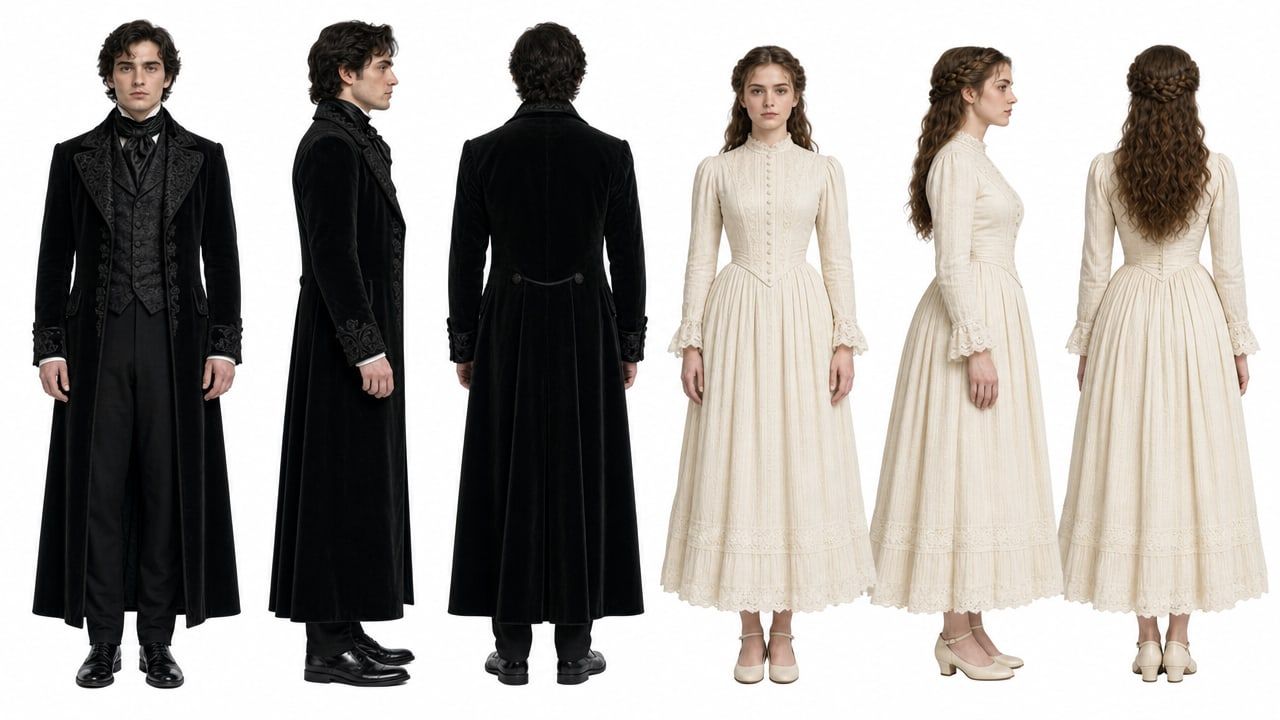 Mein eigener GPT Image 2 Lauf des Schritt-1-Prompts, zum Vergleich mit der Referenz oben.
Schritt 2: Fixiere die Location mit einer sechsteiligen Szenen-Tafel
Du hast das Gesicht gehalten. Das Licht wird dich dennoch verraten. Das zweite Referenzbild legt sechs Kamerapositionen fest, die Richtung des Mondlichts, wie viel Nebel in der Luft liegt und wie nass der Boden wirkt. Du sagst dem Modell, dass dieser Film genau eine Beleuchtungseinrichtung hat.
plaintext1Eine sechsteilige filmische Location-Tafel, 2 Reihen mal 3 Spalten, dünne schwarze Ränder zwischen den Tafeln, jede Tafel mit einer kleinen eleganten weißen Beschriftung in Großbuchstaben mit Buchstabenabstand am unteren Rand dieser Tafel. Thema: das Innere eines verlassenen gotischen Schlosses bei Nacht. Kaltes blaues Mondlicht, treibender niedriger Nebel, nasser reflektierender Steinboden, hohe Buntglasfenster, eiserne Kerzenhalter mit kleinen warmen Flammen, tiefe entsättigte Schwarztöne, schwere Samtvorhänge. Keine Personen in irgendeiner Tafel. 2 3Tafel 1, Beschriftung „WEITE ETABLIERUNGSANSICHT - KORRIDOR": ein langer, von Säulen gesäumter Korridor, der sich zu einem beleuchteten Buntglasfenster erstreckt. 4Tafel 2, Beschriftung „UNTERTE ANSICHT - MONDSCHEIN ÜBER BODEN": niedrige Kamera, ein Strahl Mondlicht, der über nasse Steinplatten streicht. 5Tafel 3, Beschriftung „TÜR & TREPPENKOMPOSITION": eine gewölbte Tür, die eine geschwungene Steintreppe einrahmt. 6Tafel 4, Beschriftung „NAHAUFNAHME - GESCHNITZTE TÜR": enge Aufnahme einer schweren geschnitzten Holztür mit einem Eisengriff. 7Tafel 5, Beschriftung „FENSTERANSICHT - NEBEL & VORHÄNGE": hohes Fenster, Nebel dringt herein, Vorhangkante im Vordergrund. 8Tafel 6, Beschriftung „LETZTER POSTER-RAHMEN - LEERE HALLE": symmetrische leere Halle, gemusterter Läufer, der zum Fenster führt. 9 10Fotografisch, filmisch, Filmkorn, konsistente Farbabstimmung über alle sechs Tafeln.
Einstellungen: gleiches Modell, Qualität hoch, Seitenverhältnis 16:9.
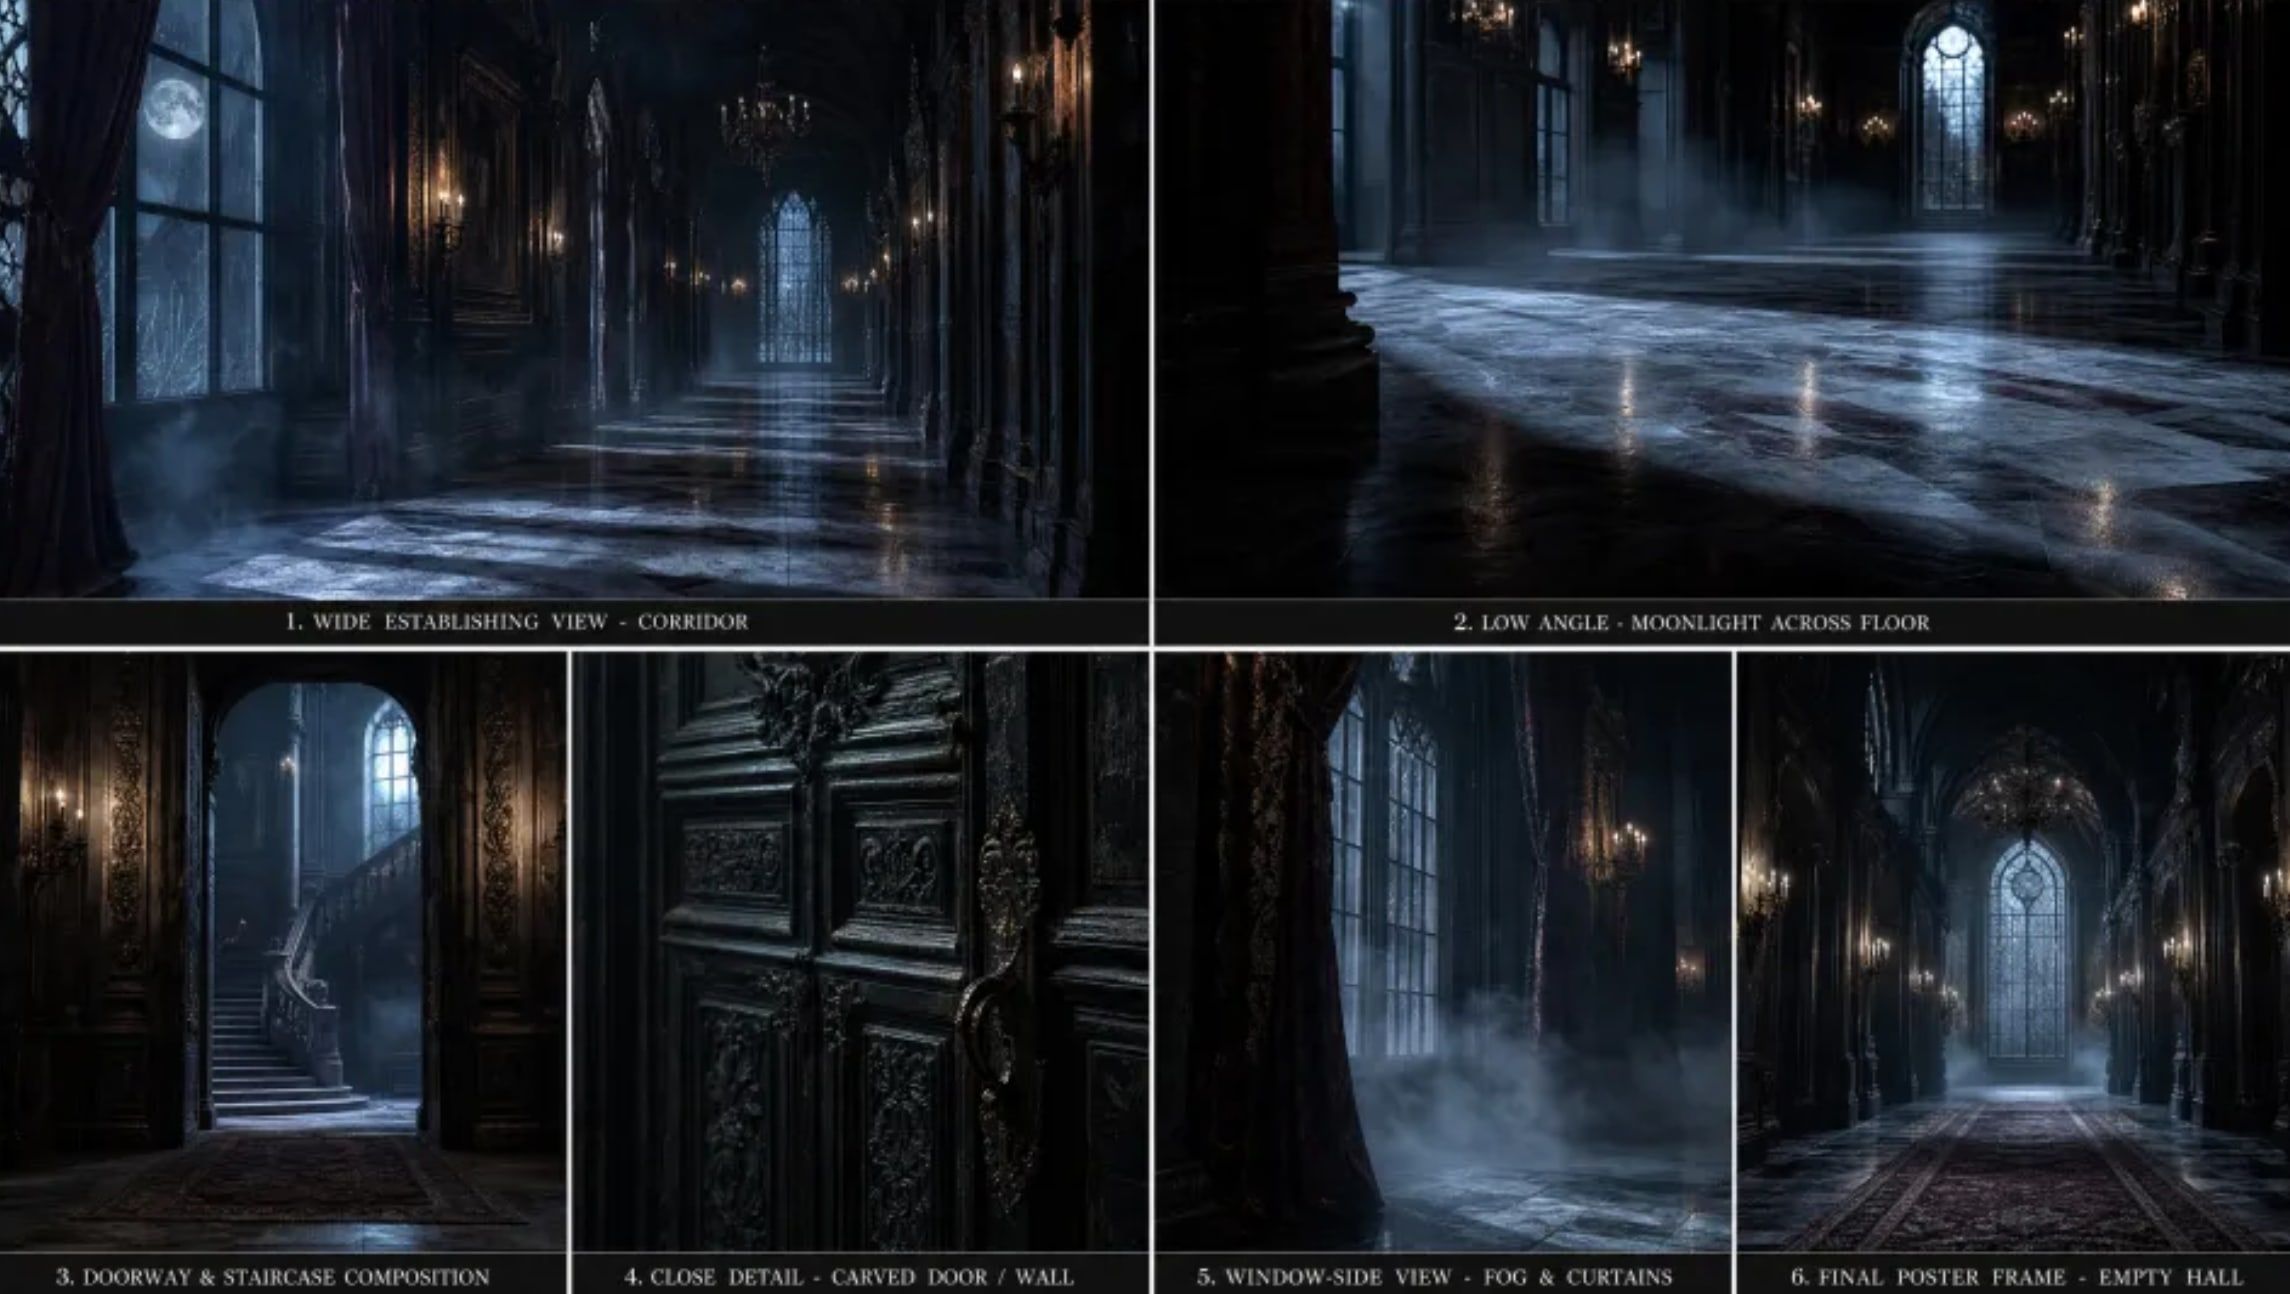 Die Location-Tafel, die den Demo-Clip antrieb: sechs gotische Schlossinterieurs, eine Farbgebung, Beschriftungen lesbar.
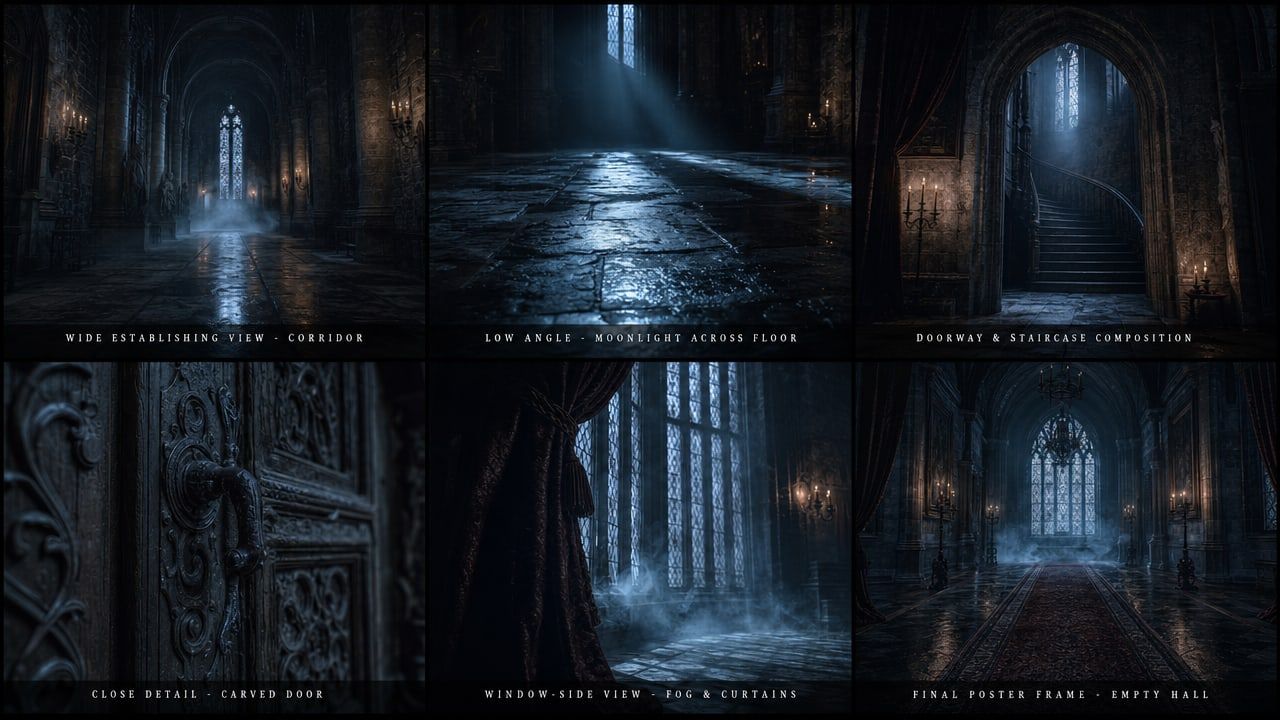 Mein eigener GPT Image 2 Lauf des Schritt-2-Tafel-Prompts.
Schritt 3: Generiere die Einstellung mit MiniMax H3 reference-to-video
Zwei Referenzbilder plus ein Prompt, der Kamerapositionen und Audioregien trägt. Ton wird im selben Durchlauf erzeugt, es gibt also keinen separaten Sprach- oder Musikschritt. Halte die Dauer kurz, während du justierst, und erhöhe sie dann auf 15 für den echten Schnitt.
plaintext1Referenzbild 1 ist das Charakterblatt: der Mann auf der LINKEN ist der weibliche Lead, die Frau auf der RECHTEN ist der weibliche Lead. Behalte beide Identitäten exakt wie gezeigt: sein Kinn, dunkles welliges Haar, schwarzer Samt-Spenzer, schwarze Brokatweste und schwarze Seidenkrawatte; ihr kastanienbraunes halb hochgestecktes Haar und cremefarbenes viktorianisches Spitzenkleid. Referenzbild 2 ist die Locations- und Beleuchtungstafel: passe ihr kaltes blaues Mondlicht, treibenden Nebel, nassen reflektierenden Steinboden und entsättigte Schwarztöne an. 2 39:16 vertikal, hochwertiger Live-Action-Kurz-Drama-Look, geringe Schärfentiefe, filmischer Kontrast, keine Untertitel, kein Bildschirmtext, kein Wasserzeichen. 4 5Einstellung 1: Mittlere Nahaufnahme, Kamera fährt langsam heran. Der weibliche Lead steht im mondbeschienenen Korridor, atmet flach, den Blick auf etwas außerhalb des Bildes rechts gerichtet. Nebel zieht auf Kniehöhe an ihr vorbei. 6Einstellung 2: Harter Schnitt. Über-die-Schulter von hinten, der männliche Lead tritt aus dem dunklen Torbogen ins Mondlicht, der Mantel fängt das Licht, Ausdruck kalt und neugierig. 7Einstellung 3: Enge Nahaufnahme auf sein Gesicht, halb vom Fenster beleuchtet, dann eine passende Nahaufnahme auf ihres, als sie sich weigert wegzusehen. 8 9Audio: tiefer anhaltender Bass-Drone, entferntes Steinecho, ihr unruhiger Atem, ein schwerer Schritt, als er ins Licht tritt, ein einzelnes sanftes Streicher-Crescendo beim letzten Schnitt.
Einstellungen: Modell MiniMax H3 Reference-to-Video, Auflösung 2K, Dauer 8 (der Schieberegler-Standard; für den echten Schnitt auf 15 erhöhen), Seitenverhältnis adaptiv, und beide Dateien in Referenzmaterialien. Das Panel zählt sie als 2 von 9, du hast also reichlich Platz für Kleidungs- oder Requisitenplatten später.
Bemerkenswert, was mit dem Seitenverhältnis passiert ist. Ich habe das Seitenverhältnis auf adaptiv gelassen und nur „9:16 vertikal" in den Prompt geschrieben. H3 kam trotzdem vertikal zurück, es hat also die Rahmung aus dem Text gelesen, anstatt das Formularfeld zu benötigen.
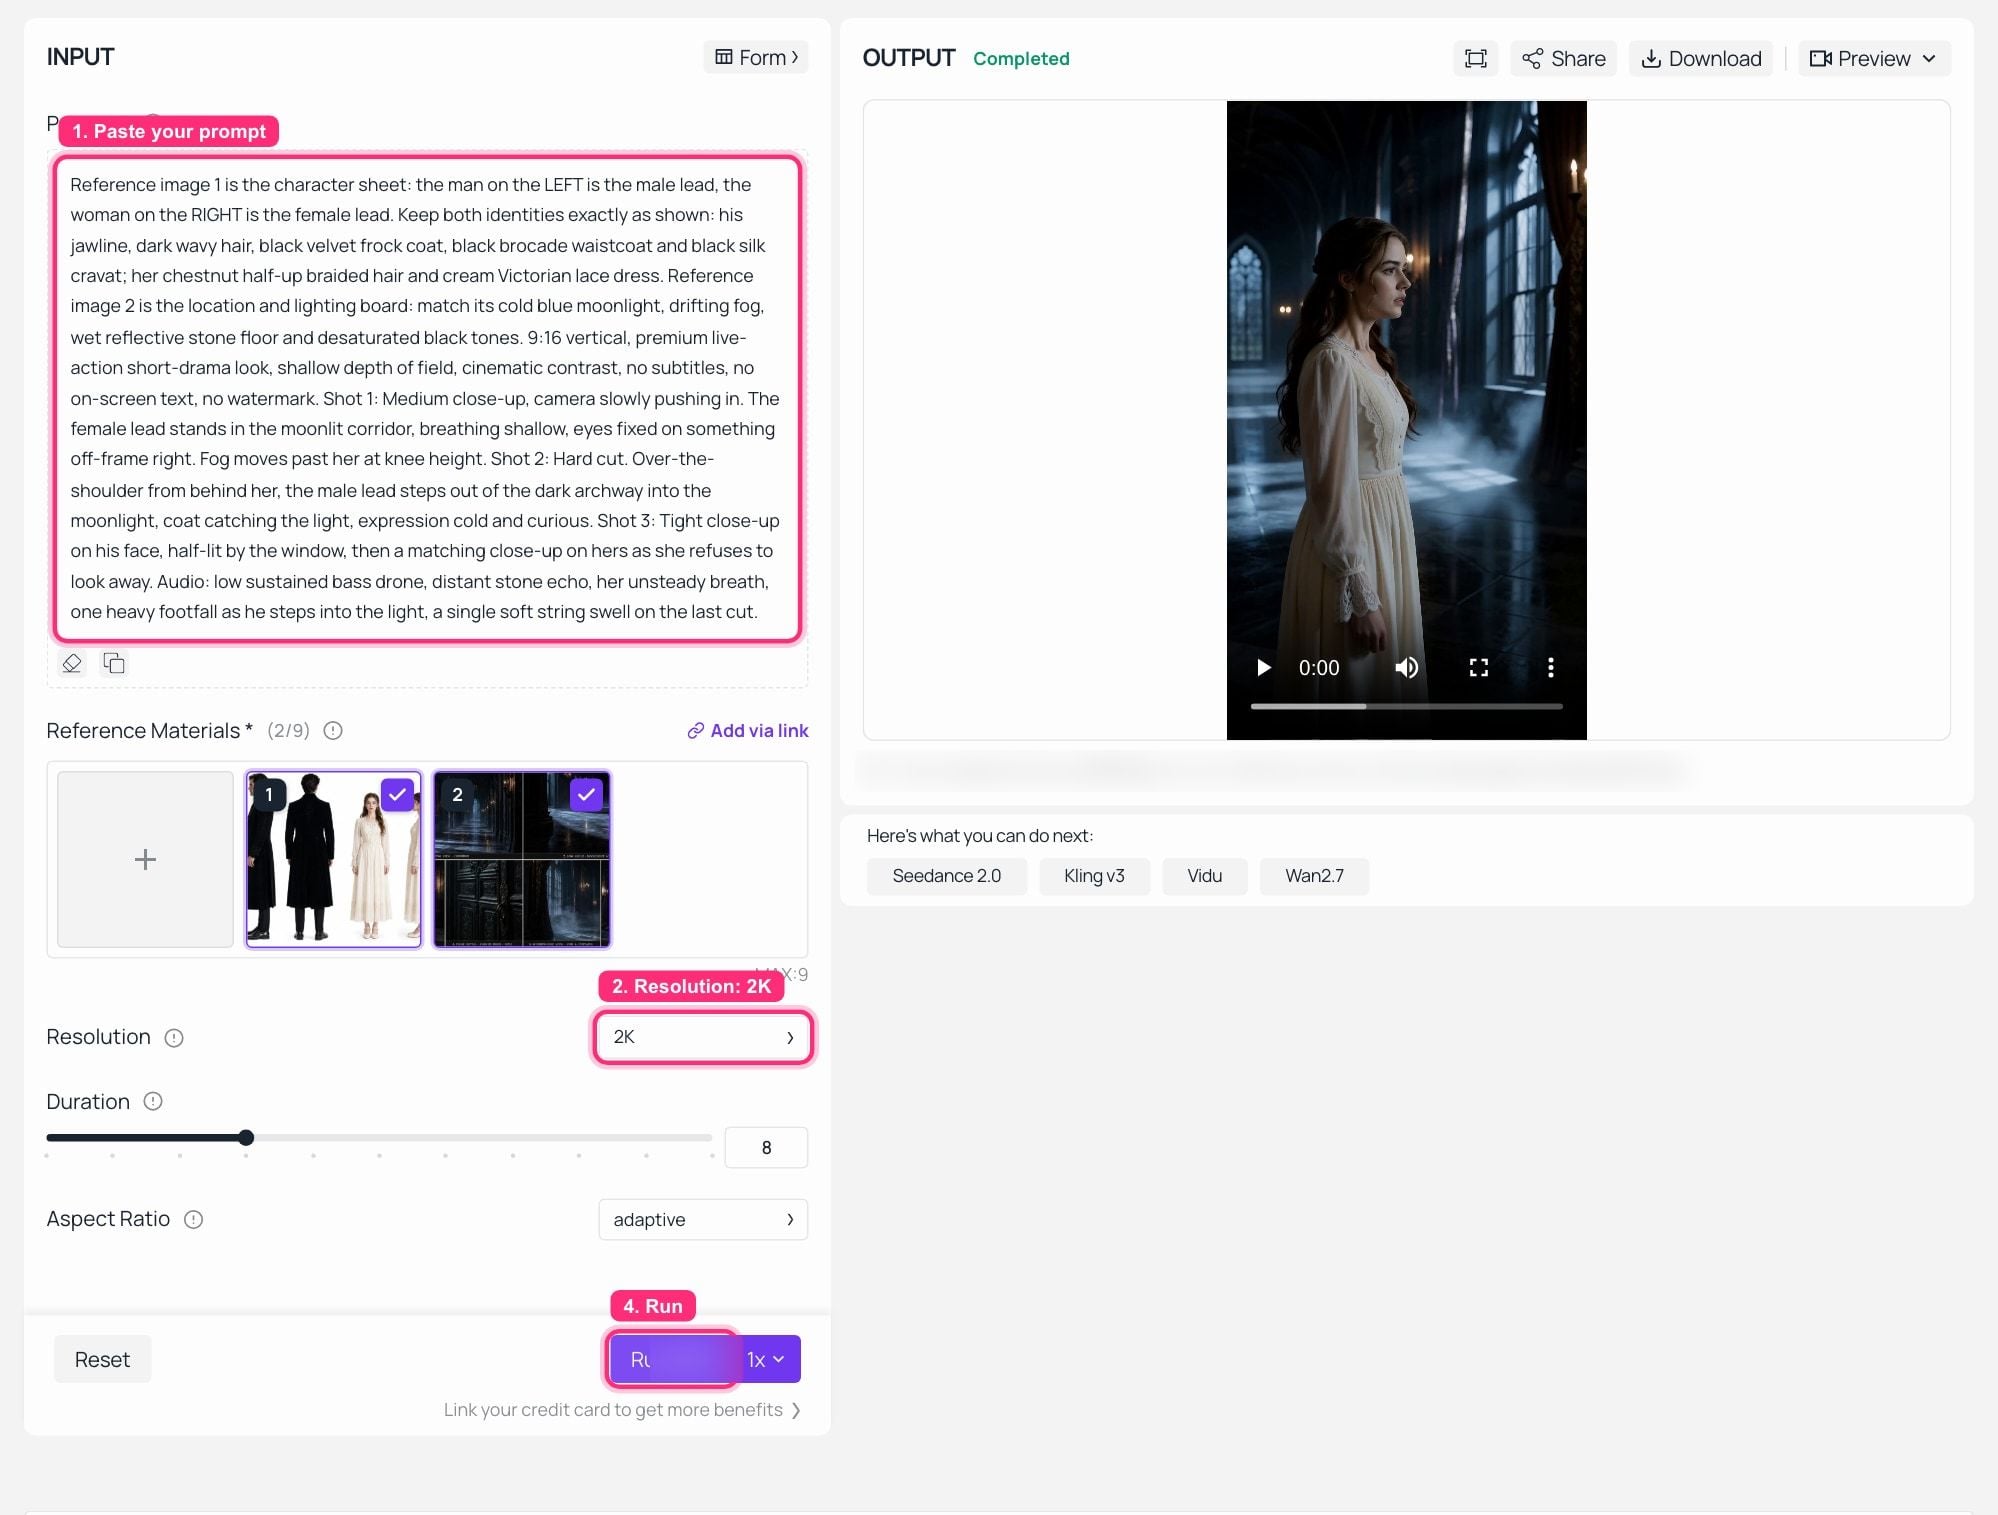 MiniMax H3 Reference-to-Video auf Atlas Cloud, Lauf abgeschlossen: beide Referenzdateien als 2 von 9 geladen, Auflösung 2K, und der generierte vertikale Clip wird im OUTPUT-Panel abgespielt.
Der erste Frame ist der weibliche Lead im cremefarbenen Spitzenmieder, stehend im Korridor aus Tafel 1, mit Nebel auf Kniehöhe und dem Mondlicht, das den nassen Boden genau dort trifft, wo die Tafel es platziert hat. Beide Referenzbilder sind gelandet.
Schritt 4: Führe die Seedance 2.5 vs MiniMax H3 Kontrolle mit dem identischen Paket durch
Ändere kein Wort. Gleiche zwei Referenzbilder, gleicher Prompt, anderes Modell. Ich habe die jeweilige Dauer-Voreinstellung jeder Seite unverändert gelassen, anstatt einen Abgleich zu erzwingen, und ich sage, was jede zurückgegeben hat. Einen Prompt „für" das andere Modell umzuformulieren, ist genau der Weg, wie Vergleiche zu lügen beginnen.
plaintext1Gleicher Prompt wie Schritt 3, wörtlich. Formuliere ihn nicht für das andere Modell um.
Einstellungen: Modell Seedance 2.0 Reference-to-Video, Auflösung 720p, gleiche zwei Referenzbilder in Referenzbildern (wieder 2 von 9, mit separaten Slots für bis zu 3 Referenzvideos und 3 Referenz-Audiodateien). Dauer auf der Seite auf Standard belassen, was als 10-Sekunden-Clip zurückkam.
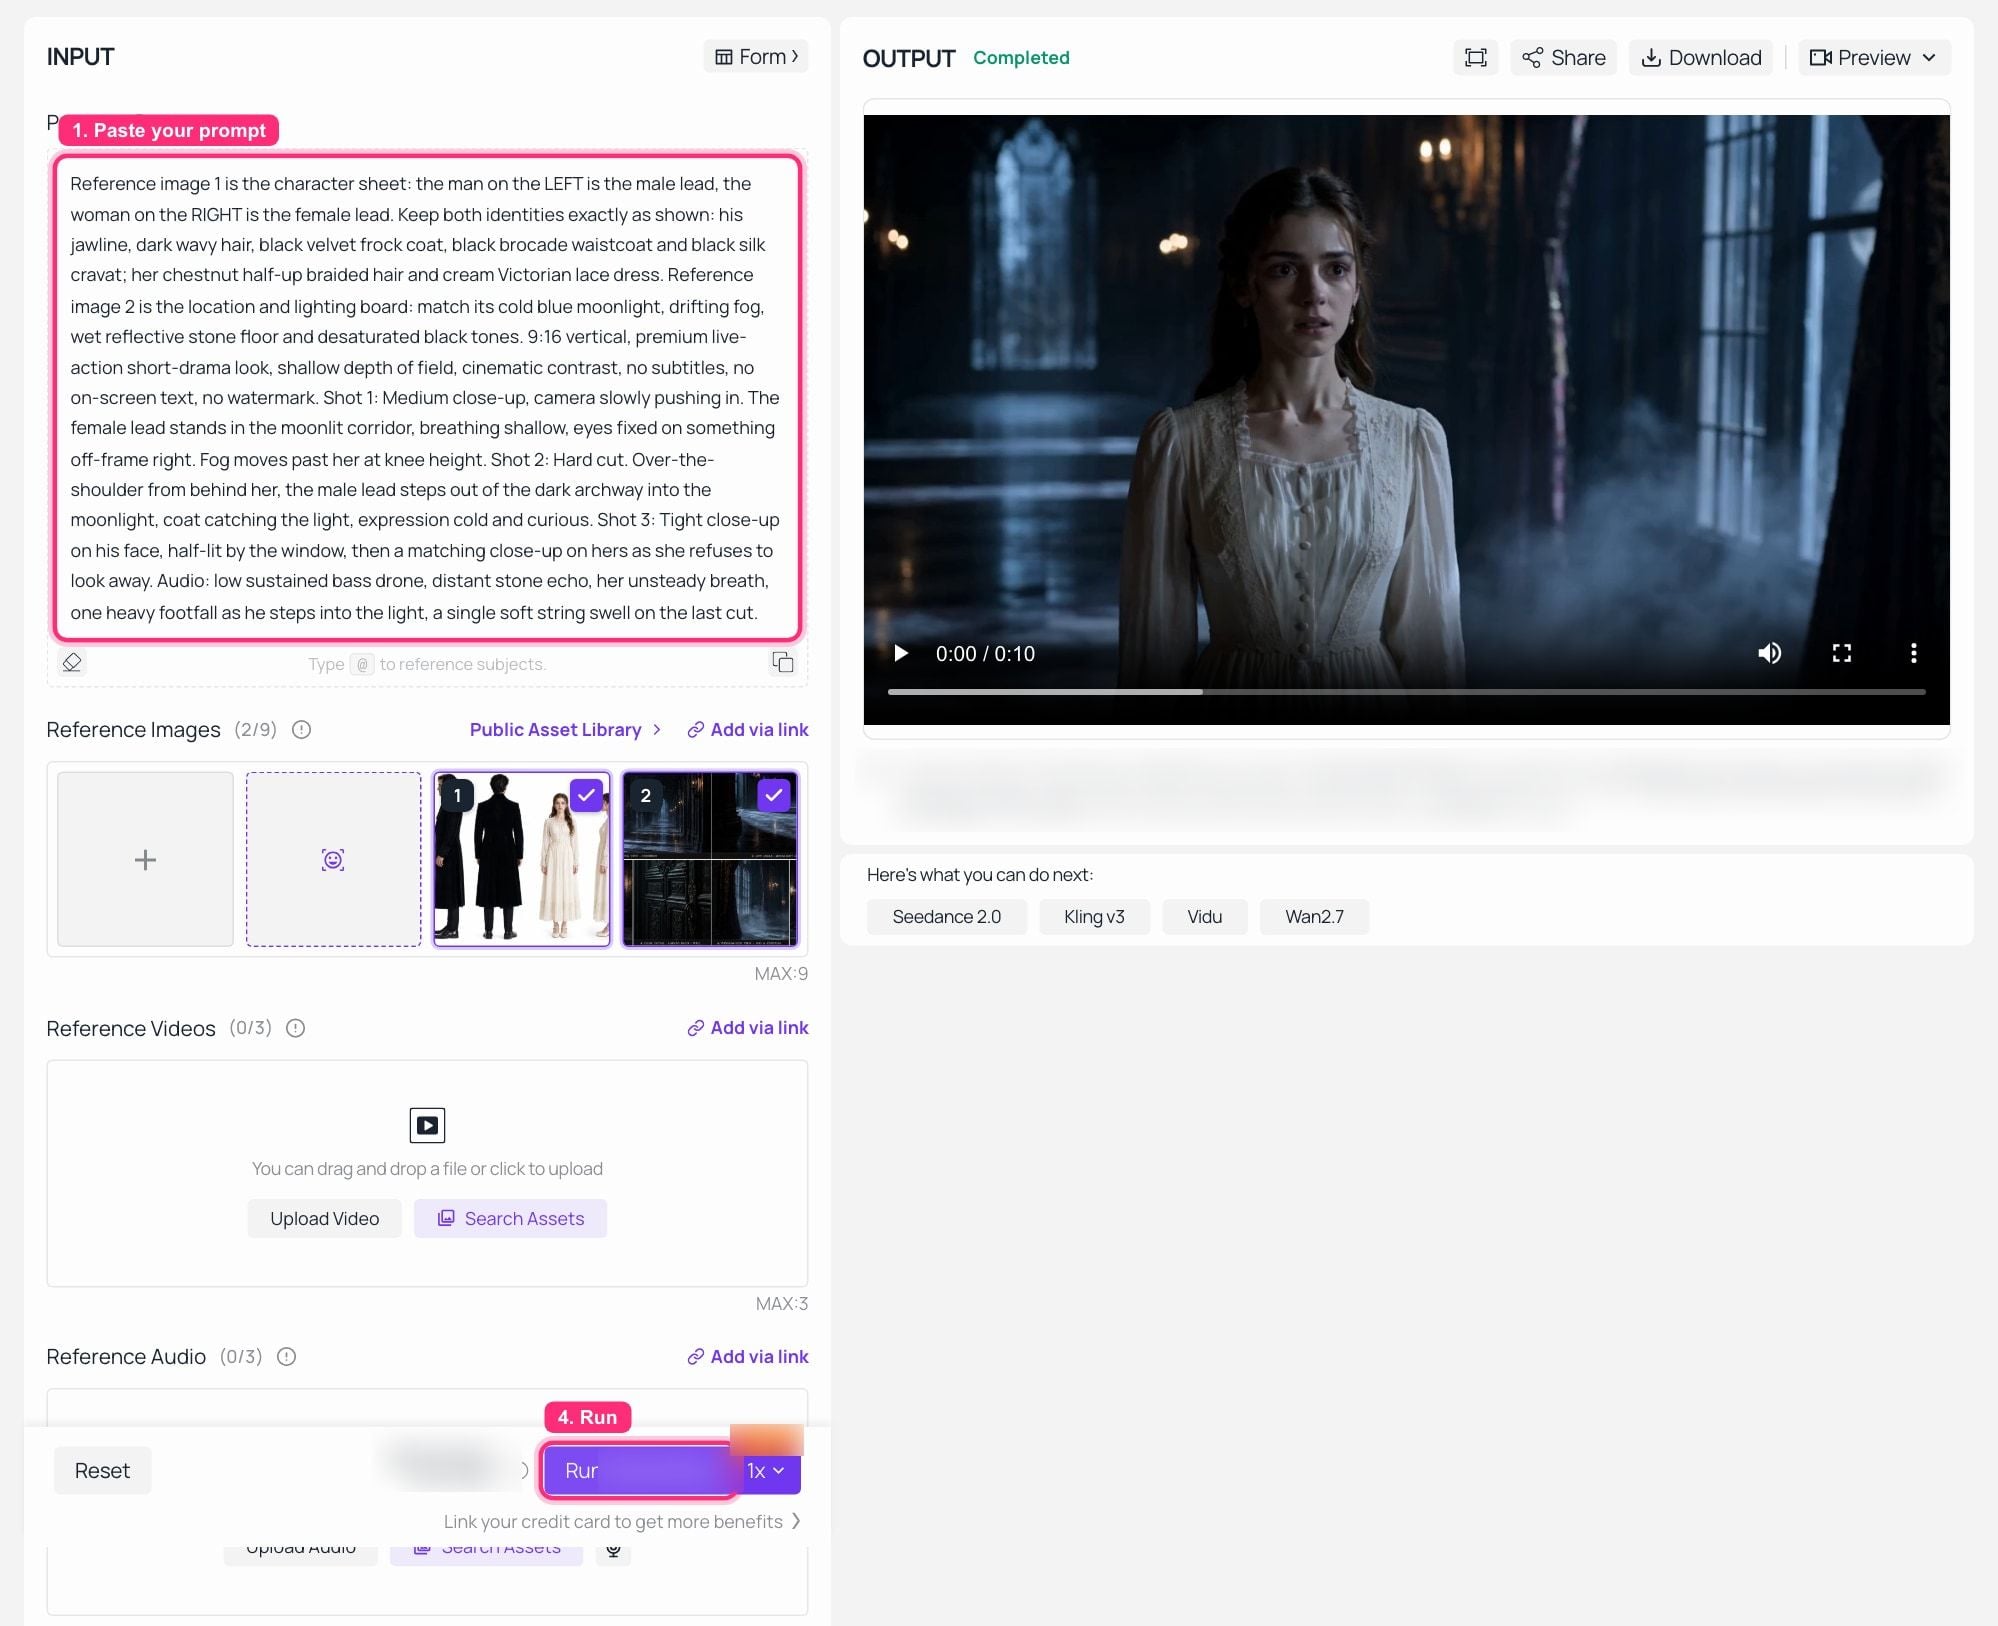 Seedance 2.0 Reference-to-Video auf Atlas Cloud, Lauf abgeschlossen mit dem identischen Referenzpaket und Prompt aus Schritt 3, und einem 10-Sekunden-Ergebnis im OUTPUT-Panel.
Hier ist, was die beiden OUTPUT-Panels tatsächlich zeigten, und ich berichte es flach, anstatt einen Gewinner zu wählen.
Beide Läufe hielten den Charakter. Gleiches cremefarbenes Spitzenkleid mit dem gleichen Ausschnitt und den gleichen Ärmelmanschetten, gleiches kastanienbraunes Haar, gleicher Nebel- und Mondlicht-Korridor aus der Tafel. Keiner hat eine andere Frau erfunden. Das Referenzpaket hat diese Arbeit auf beiden Seiten geleistet, was das Ergebnis ist, das mir am wichtigsten ist.
Die Unterschiede betrafen die Form, nicht das Gesicht. Dieser Seedance-Endpunkt lieferte 720p; H3 lieferte 2K bei identischen Eingaben. Und die Rahmung trennte sich: H3 las „9:16 vertikal" direkt aus dem Prompt-Text und gab vertikal zurück, während der Seedance-Lauf 16:9 zurückkam, weil diese Seite ihre eigene Seitenverhältnis-Steuerung hat und der Prompt-Text allein sie nicht überschrieb. Wenn du für TikTok schneidest, wird dich dieser Unterschied einen Lauf kosten, wenn du das Formularfeld das erste Mal vergisst. Seedance 2.5 würde wahrscheinlich die Auflösungshälfte davon ändern und regionale Wiederholungen hinzufügen, und ich werde nicht so tun, als hätte ich das gemessen.
Schritt 5: Eine Einstellung korrigieren, ohne den gesamten Clip neu zu rollen
Die wahren Kosten eines Kurzdramas sind nicht die erste Generation. Es ist Revision sieben. H3 akzeptiert einen vorhandenen Clip als Eingabe und bearbeitet ihn anhand von Anweisungen, wobei das, was du nicht erwähnt hast, gehalten wird. Seedance 2.5s Ansatz hier ist feiner: einen Bereich des Frames neu zeichnen und Performance, Beleuchtung und Kamera intakt lassen.
plaintext1Verwende den gelieferten Clip: behalte die beiden Charaktere, ihre Kleidung, die Kamerabewegungen und den Schnittrhythmus genau so, wie sie sind. Ändere nur die Umgebung: ersetze den mondbeschienenen Steinkorridor durch denselben Ballsaal des Schlosses, hohe Rundbogenfenster, einen beleuchteten Kronleuchter und warmes Kerzenlicht, und beleuchte beide Charaktere neu, sodass ihr Schlüssellicht vom Kronleuchter auf der linken Seite des Bildes kommt statt vom Fenster. Schreibe ihren einzigen gesprochenen Satz um zu „Du warst nie eingeschlafen, oder?" Behalte das Timing ihrer Performance auf denselben Schlägen bei.
Einstellungen: MiniMax H3 Reference-to-Video mit dem Clip aus Schritt 3 als Referenzeingabe, Dauer 5, Auflösung 2K.
Jenseits des Seedance 2.5 vs MiniMax H3 Tests: Vier Wege, ein Referenzpaket zu erweitern
Gleicher Charakter, nächste Episode. Speichere das Blatt aus Schritt 1 als Asset und ändere nur die Einstellungsliste und den Storyblock im Prompt. Identität kommt aus einer Datei, nicht aus deiner Erinnerung, wie du sie letzten Dienstag formuliert hast.
Fixiere auch die Stimme. H3 akzeptiert bis zu drei Audio-Referenzen, 2 bis 15 Sekunden pro Stück, und sie müssen zusammen mit einer Bild- oder Videoeingabe eingereicht werden. Gib ihm ein Sprachmuster und der Charakter spricht in dieser Klangfarbe, sodass du keinen Synchronsprecher zwischen Episoden neubesetzen musst.
Blocke die Kamera, bevor du für den Render bezahlst. Seedance 2.5s Reference-to-Video akzeptiert 3D-Weißmodell-Blockouts und Greenscreen-Platten, sodass du die Rahmung auf grauer Geometrie fixieren und dich erst dann für einen fertigen Look entscheiden kannst. Dieses Beispiel lief auf Seedance 2.1, einem früheren Mitglied der Familie, aber die Form des Workflows ist dieselbe.
Lokalisiere einen Master-Schnitt, anstatt ihn neu zu drehen. Austausch auf Regionsebene tauscht ein Gesicht, ein Produkt oder eine gesprochene Sprache, während Kamera, Timing und Lippenlänge unverändert bleiben. Hier wird ein einziger Beauty-Schnitt für Spanisch, Koreanisch und Hindi neu besetzt und neu vertont, wobei Raum, Rahmung und Lippenlänge beibehalten werden.
Und weil jemand fragen wird, wie Bewegungstransfer aussieht, wenn du aufhörst, vernünftig zu sein: drei Männer in Anzügen, ersetzt durch drei fotorealistische Wasserschweine, die dem Bewegungspfad des Originalclips Schlag für Schlag folgen, bis sie sich zu einer Pyramide stapeln.
Es gibt auch die einfache Version all dessen, die niemand postet: ein statisches Poster wird zu einem bewegten Poster, und das Layout überlebt.
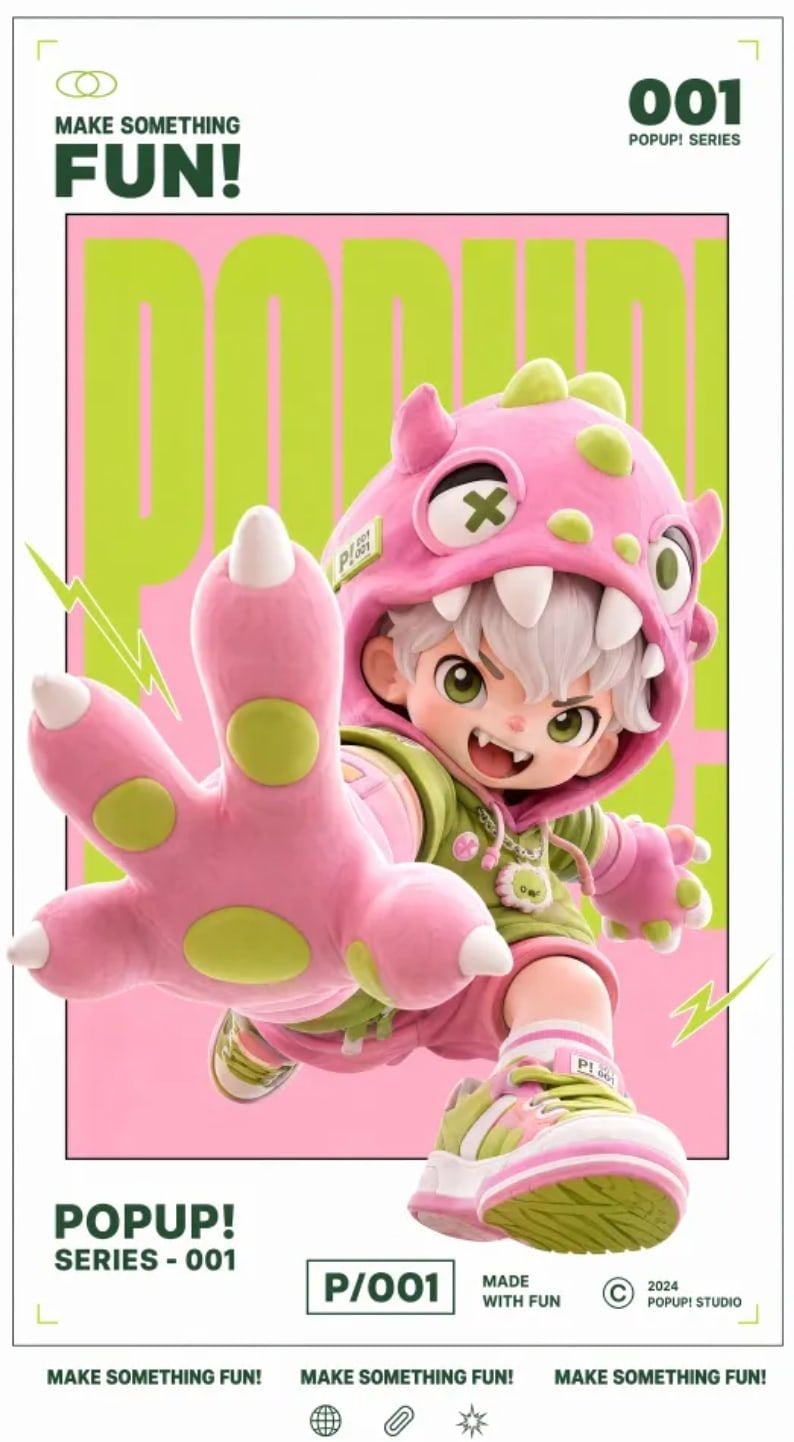 Das statische Quellposter. Gib es an Reference-to-Video mit „Behalte den Rahmen, die Palette und das Layout, animiere die Schrift" und du bekommst eine bewegte Version desselben Designs.
Was kostet dich ein Seedance 2.5 vs MiniMax H3 Kurzfilm tatsächlich?
Keine Zahlen hier, weil die Zahlen sich bewegen, aber die Struktur nicht. Beide Familien berechnen pro Sekunde, pay-as-you-go, ohne Sitzplatz und ohne Abonnement. Das lässt drei Variablen: Sekunden, Auflösungsstufe und Wiederholungen.
Die dritte ist die gesamte Rechnung. Ein 15-Sekunden-Clip, der beim ersten Versuch landet, ist eine Gebühr. Derselbe Clip beim siebten Versuch ist sieben. Die Geldeinsparung besteht also nicht darin, das günstigere Pro-Sekunde-Modell zu wählen, sondern darin, das Referenzpaket richtig zu machen, bevor du etwas generierst. Diese beiden Bildaufrufe in Schritt 1 und Schritt 2 sind die günstigste Zeile in der gesamten Pipeline und diejenige, die entscheidet, wie viele Videoaufrufe du tätigst. Höchste Rendite auf die Ausgaben in der gesamten Kette, mit Abstand.
Dann korrigiere den Pro-Sekunde-Instinkt. Gleiches Referenzpaket, gleiche Laufzeit: H3s Reference-to-Video gibt 1440p zurück, dieser Seedance-Reference-to-Video-Endpunkt gibt 720p zurück. Pro Sekunde ist die falsche Einheit. Pixel pro Frame, und ob du dann für einen separaten Upscale-Durchgang bezahlen musst, ist die richtige.
Audio gehört auch in die Rechnung. Beide Seiten produzieren natives synchrones Audio im selben Durchgang. Wenn deine aktuelle Pipeline Video-Modell plus TTS plus einen Editor zum Ausrichten von Spuren umfasst, sparst du zwei API-Aufrufe und einen Nachmittag einer Person, und diese Ersparnis erscheint auf keiner Preisliste irgendwo.
Welches für welchen Job:
| Job | Wähle | Warum | Einschränkung |
|---|---|---|---|
| Vertikales Kurzdrama, 9:16, TikTok oder ReelShort | MiniMax H3 | 1440p vertikal mit nativem Stereo, sofort aufrufbar, 15 s sind ein voller Haken | du schneidest bei 15 s, plane Beats entsprechend |
| Ein durchgehender 30-Sekunden-Markenfilm | Seedance 2.5 | Single-Generation, kein Stitching, natives 4K | Verfügbarkeit auf deiner Plattform zuerst prüfen |
| Eine Einstellung in einem genehmigten Schnitt korrigieren | Seedance 2.5 | Regionsebene-Neufassung lässt den Rest in Ruhe | H3 Gesamtclip-Bearbeitung bringt dich heute meistens hin |
| Produkt- und E-Commerce-Schnitte | beide | beide halten Bildschirmtext und Marken-Logos gut | Text bei der Ausgabeauflösung überprüfen |
| Spiel- oder Interface-Demos | MiniMax H3 | UI- und Typografie-Stabilität bei 2K ist stark | 15 s Obergrenze für einen einzelnen Durchlauf |
| Mehrsprachige Versionen eines Masters | Seedance 2.5 | Regionsersatz plus mehrsprachige Stimme | Lokalisierungsqualität erfordert noch Muttersprachler-Check |
| Lieferung heute Abend | MiniMax H3 | drei Endpunkte live, plus das gesamte Seedance 2.0 | Seedance 2.5 Zugang variiert je nach Plattform |
Bevor du auslieferst. MiniMax hat gesagt, H3s Gewichte würden innerhalb von Tagen nach dem Start folgen, und offene Gewichte sind nicht dasselbe wie eine kommerzielle Lizenz; lies die Bedingungen, bevor du selbst hostest. Wasserzeichen- und Nutzungsrichtlinien für kommerzielle Zwecke unterscheiden sich auch zwischen Consumer-Apps und API-Zugang auf beiden Seiten, und ich konnte während des Schreibens keine davon von einer primären Bedingungsseite bestätigen; überprüfe daher die Bedingungen des Anbieters, anstatt mein Wort dafür zu nehmen. Und nichts in einer Modelllizenz deckt Ähnlichkeit oder Markenrechte ab. Wenn eine reale Person, eine reale Marke oder das geistige Eigentum einer anderen Person in deinem Referenzpaket ist, ist das eine separate rechtliche Frage, und die Bedingungen des Modells werden sie nicht beantworten.
Jedes Modell in den obigen Tabellen läuft mit demselben Schlüssel, und die Modellseiten enthalten die aktuellen Preise sowie Copy-Paste-Code, einschließlich aller Aktionen, die diese Woche zufällig für die Seedance-Linie laufen.
Häufig gestellte Fragen
Ist Seedance 2.5 besser als MiniMax H3 für Charakterkonsistenz?
Auf dem Papier sollte es das sein, mit bis zu 50 multimodalen Referenzen gegenüber H3s 12 Dateien, plus Neufassungen auf Regionsebene. Aber zum 31. Juli 2026 gibt es keinen gepaarten öffentlichen Test, auf den ich verweisen könnte, und Seedance 2.5 hat noch keine Arena-Bewertung. In den Läufen, die ich tatsächlich machen konnte, war die Variable, die die Identitätsstabilität bestimmte, die Struktur des Referenzpakets, nicht die Modellgenerierung: Mit einem einzigen zusammengesetzten Turnaround-Blatt plus einer Beleuchtungstafel hielten beide Seiten den Charakter. Hol dir das Paket richtig, bevor du Zeit damit verbringst, Modelle zu vergleichen.
Kann ich Seedance 2.5 jetzt sofort nutzen, oder muss ich warten?
Seine API ist bei ByteDance live. Die Verfügbarkeit auf Drittanbieter-Modellplattformen ist uneinheitlich, und auf der, die ich getestet habe, ist es noch ein Day-0-Hinweis. Wenn du heute Abend eine Ausgabe brauchst, sind die aufrufbaren Optionen die drei Endpunkte von MiniMax H3 und die gesamte ausgelieferte Seedance 2.0-Linie.
Macht MiniMax H3 wirklich 30-Sekunden-Video?
Nein. Die Spezifikation ist 5 bis 15 Sekunden pro Generation bei 24 fps. Alles Längere ist Verlängerung oder Stitching, was eine andere Sache mit einem anderen Drift-Risiko ist. Die 30-sekündige Single-Generation gehört Seedance 2.5. Lass die beiden Behauptungen nicht verschwimmen.
Erzeugen beide Modelle Audio, und kann ich eine Stimme über Episoden hinweg behalten?
Beide erzeugen natives synchrones Audio im selben Durchlauf, und H3 gibt Stereo bei jedem Ergebnis aus. Für eine durchgehende Stimme akzeptiert H3 bis zu drei Audio-Referenzen von 2 bis 15 Sekunden, die zusammen mit einer Bild- oder Videoeingabe eingereicht werden müssen, nicht allein.
Wie viele Referenzbilder sollte ich tatsächlich senden?
Weniger, als du denkst, besser strukturiert, als du denkst. Eine gut komponierte Kompositaufnahme ist in der Regel besser als sechs lose Ausschnitte, weil separate Dateien das Modell dazu einladen, sie zu einer Person zu mitteln, die nicht existiert. Gib ihm zwei klare Aufgaben: Identität und Beleuchtung, und füge keine Stilproben hinzu, die sich gegenseitig bekämpfen.
Welches Modell sollte ich für TikTok- oder ReelShort-artige vertikale Kurzdramen verwenden?
Diese Woche ausliefernd, in 9:16, in hoher Auflösung mit bereits gemischtem Ton: MiniMax H3. Planst du eine 30-sekündige durchgehende Szene, in der du einzelne Regionen statt ganzer Clips neu rollen möchtest: Baue für Seedance 2.5 und prüfe, wann deine Plattform es öffnet.


