Produktive agentische Pipelines stürzen häufig aufgrund unerwarteter Schemaverletzungen ab. Selbst erstklassige autoregressive LLMs scheitern beim JSON-Parsing während hochvolumiger Tool-Aufrufe, was Entwickler dazu zwingt, komplexe Retry-Schleifen und benutzerdefinierte Fehlerbehandler zu erstellen.
TypeSafe Jev löst diesen strukturellen Fehler, indem es die sequenzielle Token-für-Token-Generierung vollständig aufgibt. Jev arbeitet als nicht-autoregressives Entscheidungsmodell, nimmt den Anwendungszustand auf und bewertet vorab deklarierte Schemafragen in einem einzigen parallelen Forward-Pass. Da die möglichen Ausgabeoptionen vor der Ausführung streng begrenzt werden, eliminiert Jev mathematisch fehlerhaftes JSON, ungültige Tool-Namen und schemafremden Text.
Wichtige Eckpunkte: Was ist TypeSafe Jev AI? Leistungs- und Geschwindigkeits-Benchmarks
TypeSafe Jev AI ist ein nicht-autoregressives Entscheidungsmodell, das speziell für Sub-Sekunden-Klassifizierung, Intent-Scoring und strukturiertes Microservice-Routing entwickelt wurde. Im Gegensatz zu autoregressiven LLMs bewertet Jev vorab deklarierte Schemaoptionen in einem einzigen Forward-Pass.
- Null Halluzination auf Typebene: Ersetzt String-Decoding-Schleifen durch begrenzte State-Schema-Primitive und erzielt eine Typfehlerrate von 0 %.
- Sub-500-ms-Ausführung: Nicht-autoregressives paralleles Sampling erreicht 70 ms–500 ms P95-Latenz und ist bis zu 200-mal schneller als Standard-LLMs.
- Kostenlose Output-Tokens: Null generierte sequenzielle Tokens bedeuten, dass Output-Tokens völlig kostenlos sind — $0.042/1M Input-Tokens.
- Am besten geeignet für: Microservice-Routing, agentisches Tool-Dispatching, Ticket-Triage und Intent-Gating.
Den AI-Stack neu denken: System-1-Intuition vs. System-2-Reasoning
Wenn man skalierbare Backend-Software entwickelt, zwingt das Durchleiten einfacher bedingter Prüfungen durch einen schwergewichtigen Chat-Completion-Endpunkt zu erheblicher Systemlatenz. Die meisten Microservices erfordern keine kreative Prosa oder mehrstufige Chain-of-Thought-Generierung; sie benötigen eine sofortige, deterministische Auswahl aus bekannten Optionen.
Anwendung des kognitiven Rahmens von Kahneman auf die Softwarearchitektur
TypeSafe-Mitbegründer Diogo Almeida, der zuvor Reinforcement Learning from Human Feedback bei OpenAI mitentwickelt hat, führte mit TypeSafe Jev einen strukturellen Kurswechsel ein, um diese Ineffizienz zu beheben. Die Plattform stützt sich direkt auf den kognitiven Rahmen von Kahneman und teilt die Verarbeitung in zwei unterschiedliche operative Schichten innerhalb der modernen AI-Stack-Architektur auf:
- System 2 Langsames, bedachtes Reasoning: Standard-autoregressive LLMs, die über sequenzielle Token-für-Token-Generierung arbeiten. Diese Modelle sind hervorragend beim Entwerfen langer Dokumente, beim Umgang mit mehrdeutigem Reasoning und beim Schreiben komplexen Codes.
- System 1 Schnelle, intuitive Entscheidungen: Ein dediziertes System-One-AI-Modell, das über Reinforcement Learning for Calibrated Decisions statt über traditionelles RLHF trainiert wurde. Es ist speziell für Sub-Sekunden-Klassifizierung, Intent-Scoring und Ausführungs-Routing ohne Konversations-Overhead konzipiert.
Jev vs. LLM: Kosten & Architektur: Entscheidungsmodelle vs. Chat-Modelle
Der Austausch von Allzweck-Chat-Modellen durch spezialisierte typisierte Entscheidungsmodelle optimiert Microservice-Workflows grundlegend, indem schnelle Bewertung von tiefer Generierung getrennt wird.
| Architektonische Dimension | Autoregressive LLMs (System 2) | TypeSafe Jev (System 1) |
| Primäre Aufgabe | Offene Textsynthese | Diskrete Auswahl und Schema-Bewertung |
| Ausführungslatenz | 3.000 ms bis 30.000 ms+ | 70 ms bis 500 ms |
| Ausgabeformat | Unstrukturierter Textstream | Streng typisierte Schema-Primitive |
| Compute-Schleife | Sequenzielles Token-Decoding | Einzelner Forward-Pass |
| Trainingsziel | Menschliche Präferenz (RLHF) | Kalibrierte Entscheidungssicherheit (RLCD) |
Das Auslagern von Routing, Sicherheits-Guardrails und Funktions-Dispatching weg von Standard-Chat-Modellen löst die autoregressiven LLMs innewohnenden Leistungsengpässe. Die Einbindung eines System-One-AI-Modells stellt sicher, dass schwergewichtige Reasoning-Engines nur dann ausgelöst werden, wenn offene Generierung wirklich erforderlich ist.
Wie das TypeSafe Jev Modell Null Halluzination auf Typebene liefert
Selbst mit aktiviertem striktem JSON-Modus liefern Frontier-LLMs bei hochparallelen Produktionsläufen regelmäßig schemafremde Schlüssel oder halluzinierte Enum-Werte zurück, wodurch 0,5 % bis 5 % der Pipeline-Anfragen fehlschlagen. Produktive Microservices erfordern absolute Typdeterminismus, doch autoregressive Modelle bleiben inhärent anfällig für String-Generierungsfehler.
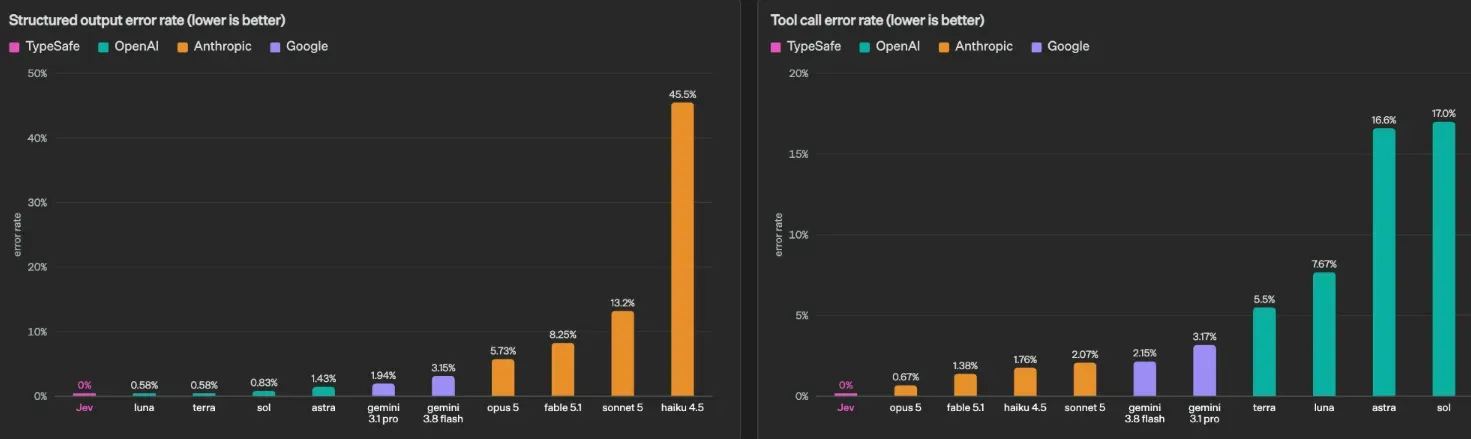
TypeSafe Jev löst dies, indem es String-Decoding-Schleifen durch eine begrenzte State-Architektur ersetzt. Anstatt beliebigen Text zu generieren und zu versuchen, ihn in JSON-Syntax zu zwingen, bewertet Jev die Eingabedaten gegen vordefinierte Schema-Beschränkungen in einem einzigen Durchlauf. Dieser strukturelle Wandel liefert echte Null-Halluzination-AI auf Typebene und führt zu 0 % Typfehlern über automatisierte Workflows hinweg.
Die drei zentralen Schema-Primitive
Jev verarbeitet alle Eingabefragen über drei explizite Primitive:
- Choice-Primitiv: Wählt genau eine Option aus einer vordefinierten Liste von bis zu 255 kategorialen Auswahlmöglichkeiten und gibt das gewinnende Label zusammen mit vollständigen Wahrscheinlichkeitsverteilungen zurück.
- Score-Primitiv: Bewertet die Eingabe anhand einer geordneten numerischen Skala oder eines beschreibenden Bewertungsrasters und liefert Bewertungen zusammen mit Wahrscheinlichkeitsverteilungen über jede Stufe.
- Noul-Primitiv: Berechnet die exakte Wahrscheinlichkeit einer Ja-oder-Nein-Bedingung als Float zwischen 0,0 und 1,0 und eliminiert zwischengeschaltete Textbegründungen.
Da jede Abfrage streng auf diese drei Primitive abgebildet wird, kann die Ausführungs-Engine keine ungültigen Schlüssel, nicht gelistete Tool-Namen oder fehlerhafte Payloads ausgeben.
Typsicherheit bei der Bewertung strukturierter Ausgaben
Traditionelle Chat-Modelle generieren Syntax Zeichen für Zeichen, was ständige Parsing-Risiken in Backend-Pipelines erzeugt.
| Bewertungsmetrik | Autoregressiver JSON-Modus | TypeSafe Jev System One |
| Durchsetzung des Ausgabetyps | String-Validierung nach der Generierung | Native mathematisch begrenzte Primitive |
| Häufigkeit von Typfehlern | Variabel (0,5 % bis 5 %+ Fehlerrate) | 0 % Typfehler (schema-gebunden) |
| Risiko ungültiger Enums | Hoch ohne benutzerdefinierte Retry-Schleifen | Null (konstruktionsbedingt unmöglich) |
Die strikte Beschränkung der Modellausführung auf einen begrenzten State garantiert eine zuverlässige Bewertung strukturierter Ausgaben. Anwendungen konsumieren Jev-Ausgaben direkt, ohne Exception-Handler für fehlerhafte JSON-Schemas schreiben zu müssen.
Hinweis zu Typdeterminismus vs. Wahrscheinlichkeit: TypeSafe Jev garantiert konstruktionsbedingt 0 % Typfehler und Schemaübereinstimmung und eliminiert mathematisch fehlerhafte Syntax, fehlende Schlüssel und nicht gelistete Enum-Werte. Wie alle Entscheidungsmodelle bleiben jedoch seine Ausgabeoptionen probabilistisch. Bei inhärent mehrdeutigen Eingaben sollten Konfidenzwerte verwendet werden, um die Ausführung zu steuern, anstatt absolute semantische Sicherheit anzunehmen.
Wie nicht-autoregressives paralleles Sampling Sub-500-ms-Latenz und kostenlose Outputs ermöglicht
Die Verwendung von Standard-Chat-Endpunkten für einfache Klassifizierungs-Tags wie {"category": "billing"} führt zu unnötiger Latenz in produktiven Microservices. Da autoregressive Modelle auf sequenzielles Token-Decoding angewiesen sind, bleiben Backend-Threads blockiert, während sie auf Generierungsschleifen einzelner Zeichen warten.
Die Mechanik der Single-Pass-Bewertung
Traditionelle Transformer führen autoregressive Generierungsschleifen aus, bei denen jedes neue Token einen separaten Durchlauf durch den Netzwerk-Stack erfordert. Diese sequenzielle Abhängigkeit erzeugt hohe Latenz und treibt die Infrastrukturkosten basierend auf dem generierten Token-Volumen in die Höhe.
TypeSafe Jev eliminiert die sequenzielle Generierung durch den Einsatz von nicht-autoregressivem parallelem Sampling. Wie in der TypeSafe-Launch-Mitteilung dargelegt, nimmt Jev den Kontextzustand auf und bewertet alle vorab deklarierten Schemaoptionen gleichzeitig innerhalb eines einzigen Forward-Pass.
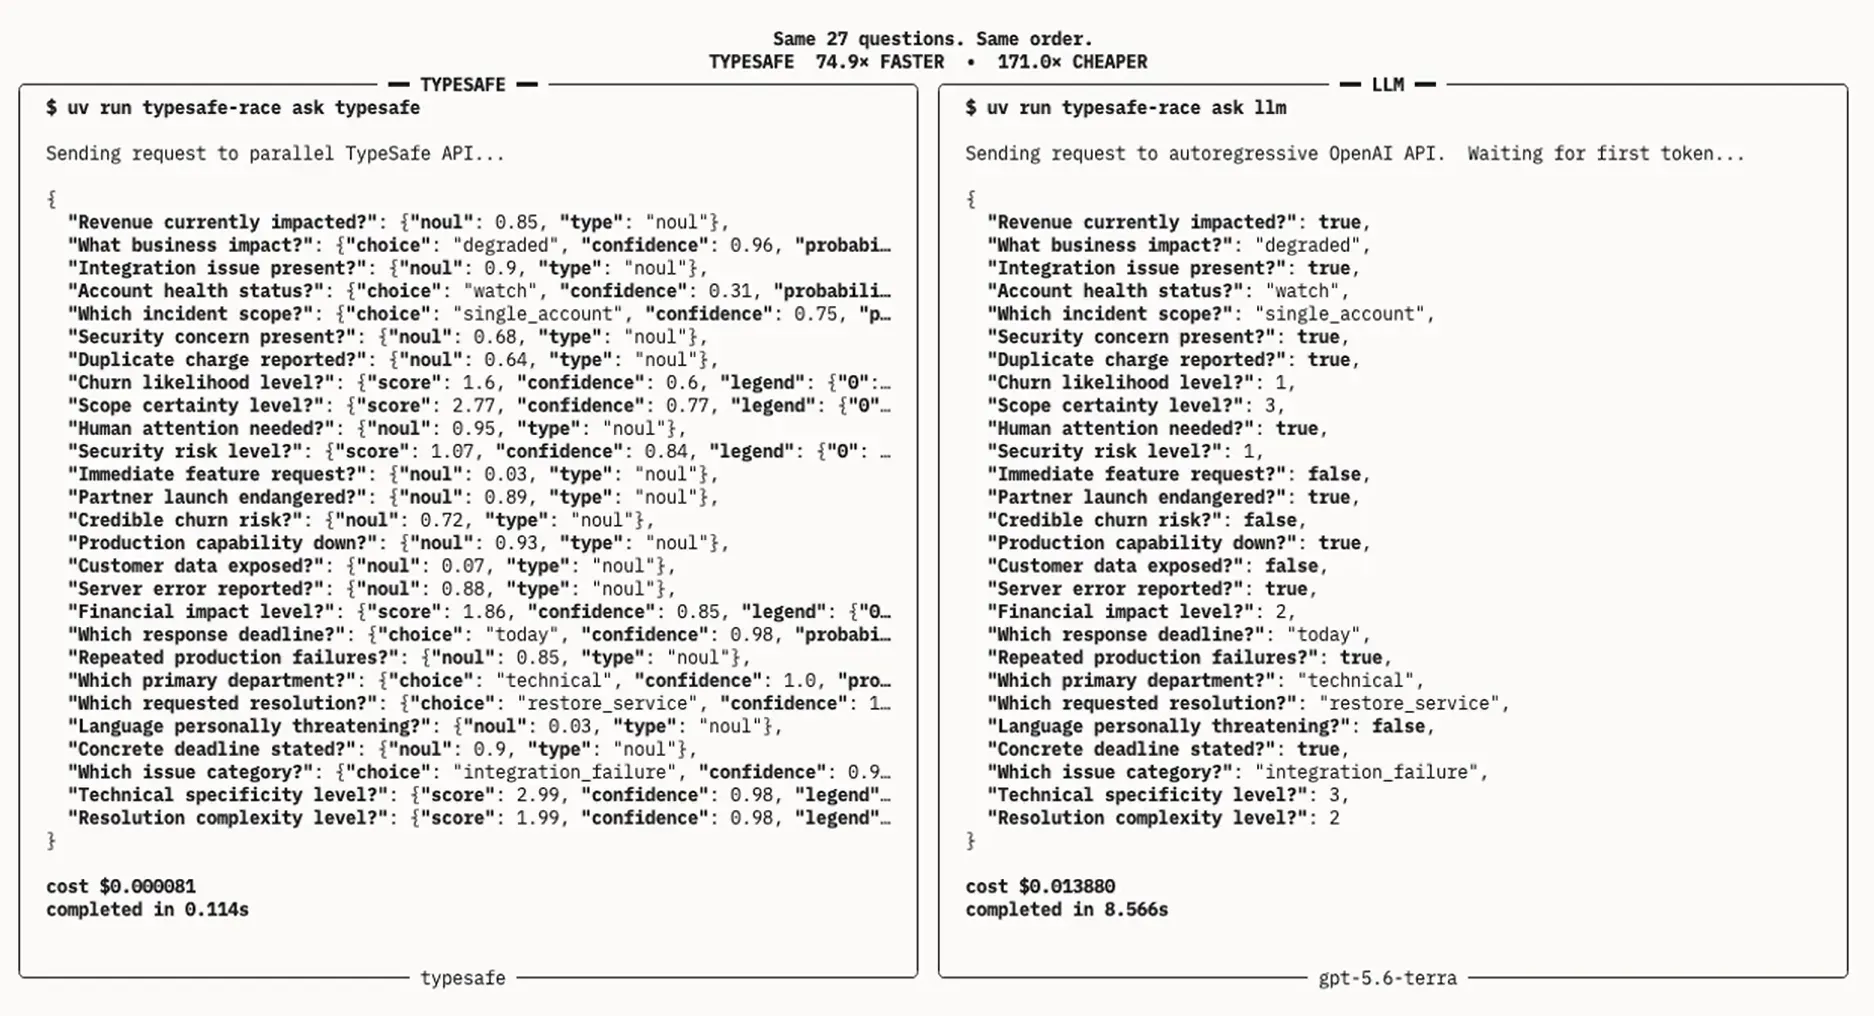
Terminal-Benchmark-Vergleich mit 27 gleichzeitigen Schema-Bewertungsfragen auf TypeSafe Jev vs. GPT 5.6 Terra Endpunkt
Da das Modell Wahrscheinlichkeitsverteilungen über vordefinierte Ausgaben berechnet, anstatt freien Text zu generieren, verschwinden Output-Decoding-Schleifen vollständig. Dieser strukturelle Wandel bringt drei wesentliche Leistungsvorteile:
- **Kostenlose Output-Tokens (Too Cheap to Meter): **Denn Jev bewertet Optionen in einem einzigen Forward-Pass, ohne sequenzielle Tokens zu generieren, sodass die Output-Bewertung praktisch keinen inkrementellen Rechenaufwand verursacht und Output-Tokens effektiv kostenlos werden.
- Vorhersehbare Preisgestaltung: Die Kontextverarbeitung kostet pauschal $0.042 pro Million Input-Tokens. Die Bewertung statischer Prompt-Schemas mit Jev verhindert eine exponentielle Inflation der API-Rechnung im Vergleich zum traditionellen Overhead bei der Ausführung langer Kontexte, der mit schwergewichtigen Chat-Endpunkten verbunden ist.
- Sub-Sekunden-Ausführung: Veröffentlichte TypeSafe Jev Latenz-Benchmarks zeigen P95-Antwortzeiten durchgängig zwischen 70 ms und 500 ms, bis zu 200-mal schneller als Frontier-Chat-Modelle.
Architektonische Leistungsaufschlüsselung
| Metrik / Dimension | Traditionelle autoregressive LLMs (System 2) | TypeSafe Jev System One Engine |
| Ausführungsschleife | Sequenzielles Token-für-Token-Decoding | Einzelner paralleler Durchlauf über vorab deklariertes Schema |
| Ausgabetyp | Unstrukturierte Text-Strings / JSON-Strings | Typisierte Entscheidungsprimitive (Choice, Score, Noul) |
| Schema-Fehlerrate | 0,58 % bis 45 %+ je nach Modell/Prompt | 0 % Typfehlerrate (mathematisch begrenzt) |
| P95-Latenzprofil | 3.000 ms bis 30.000 ms+ | 70 ms bis 500 ms |
| Output-Ökonomie | Variabel pro Token ($15 bis $60 / MTok) | KOSTENLOS (too cheap to meter) Keine sequenzielle Output-Token-Generierung |
| Primäre Domäne | Reasoning, Entwurfsschreiben, offene Synthese | Klassifizierung, Tool-Auswahl, Confidence-Gating |
Umgehung des Speicherbandbreiten-Engpasses
Bei der standardmäßigen LLM-Inferenz sättigt die Speicherbandbreite, da die Modellgewichte für jedes einzelne Token neu in die Speicherlogik geladen werden. Indem Jev Entscheidungsbewertungen in einem einzigen Forward-Pass abschließt, umgeht es diesen Speicherengpass vollständig und hält stabile Antwortgeschwindigkeiten selbst unter starkem gleichzeitigem Verkehr aufrecht.
Reinforcement Learning for Calibrated Decisions und Confidence-Gates
Standard-Chat-Modelle geben regelmäßig falsche Aussagen mit 99 % selbstberichteter Konfidenz aus, weil konventionelles Fine-Tuning überzeugende Formulierungen statt statistischer Wahrheit belohnt. In produktiven Microservices führt eine übermäßig selbstsichere falsche Entscheidung direkt zu beschädigten Datenbankeinträgen, fehlerhaften Tool-Argumenten und unerwarteter Systemausfallzeit.
Abgleich der Modellkonfidenz mit empirischer Genauigkeit
Um diese strukturelle Überkonfidenz zu beheben, führte TypeSafe Reinforcement Learning for Calibrated Decisions ein. Im Gegensatz zur traditionellen RLHF-Methodik, die auf subjektive menschliche Präferenz optimiert, trainiert RLCD Entscheidungsmodelle speziell darauf, kalibrierte Wahrscheinlichkeiten zu erzeugen.
Durch genauigkeitsabgestimmte Konfidenz bedeutet eine 0,90-Wahrscheinlichkeitsausgabe von Jev, dass die Kandidatenauswahl über Testdatensätze hinweg in 90 % der Fälle empirisch korrekt ist. Diese mathematische Kalibrierung ermöglicht zuverlässige probabilistische Entscheidungsfindung, ohne dass Entwickler komplexe Prompt-Heuristiken schreiben müssen, um die Ausgabesicherheit einzuschätzen.
Implementierung von Confidence-gesteuertem Routing in der Produktion
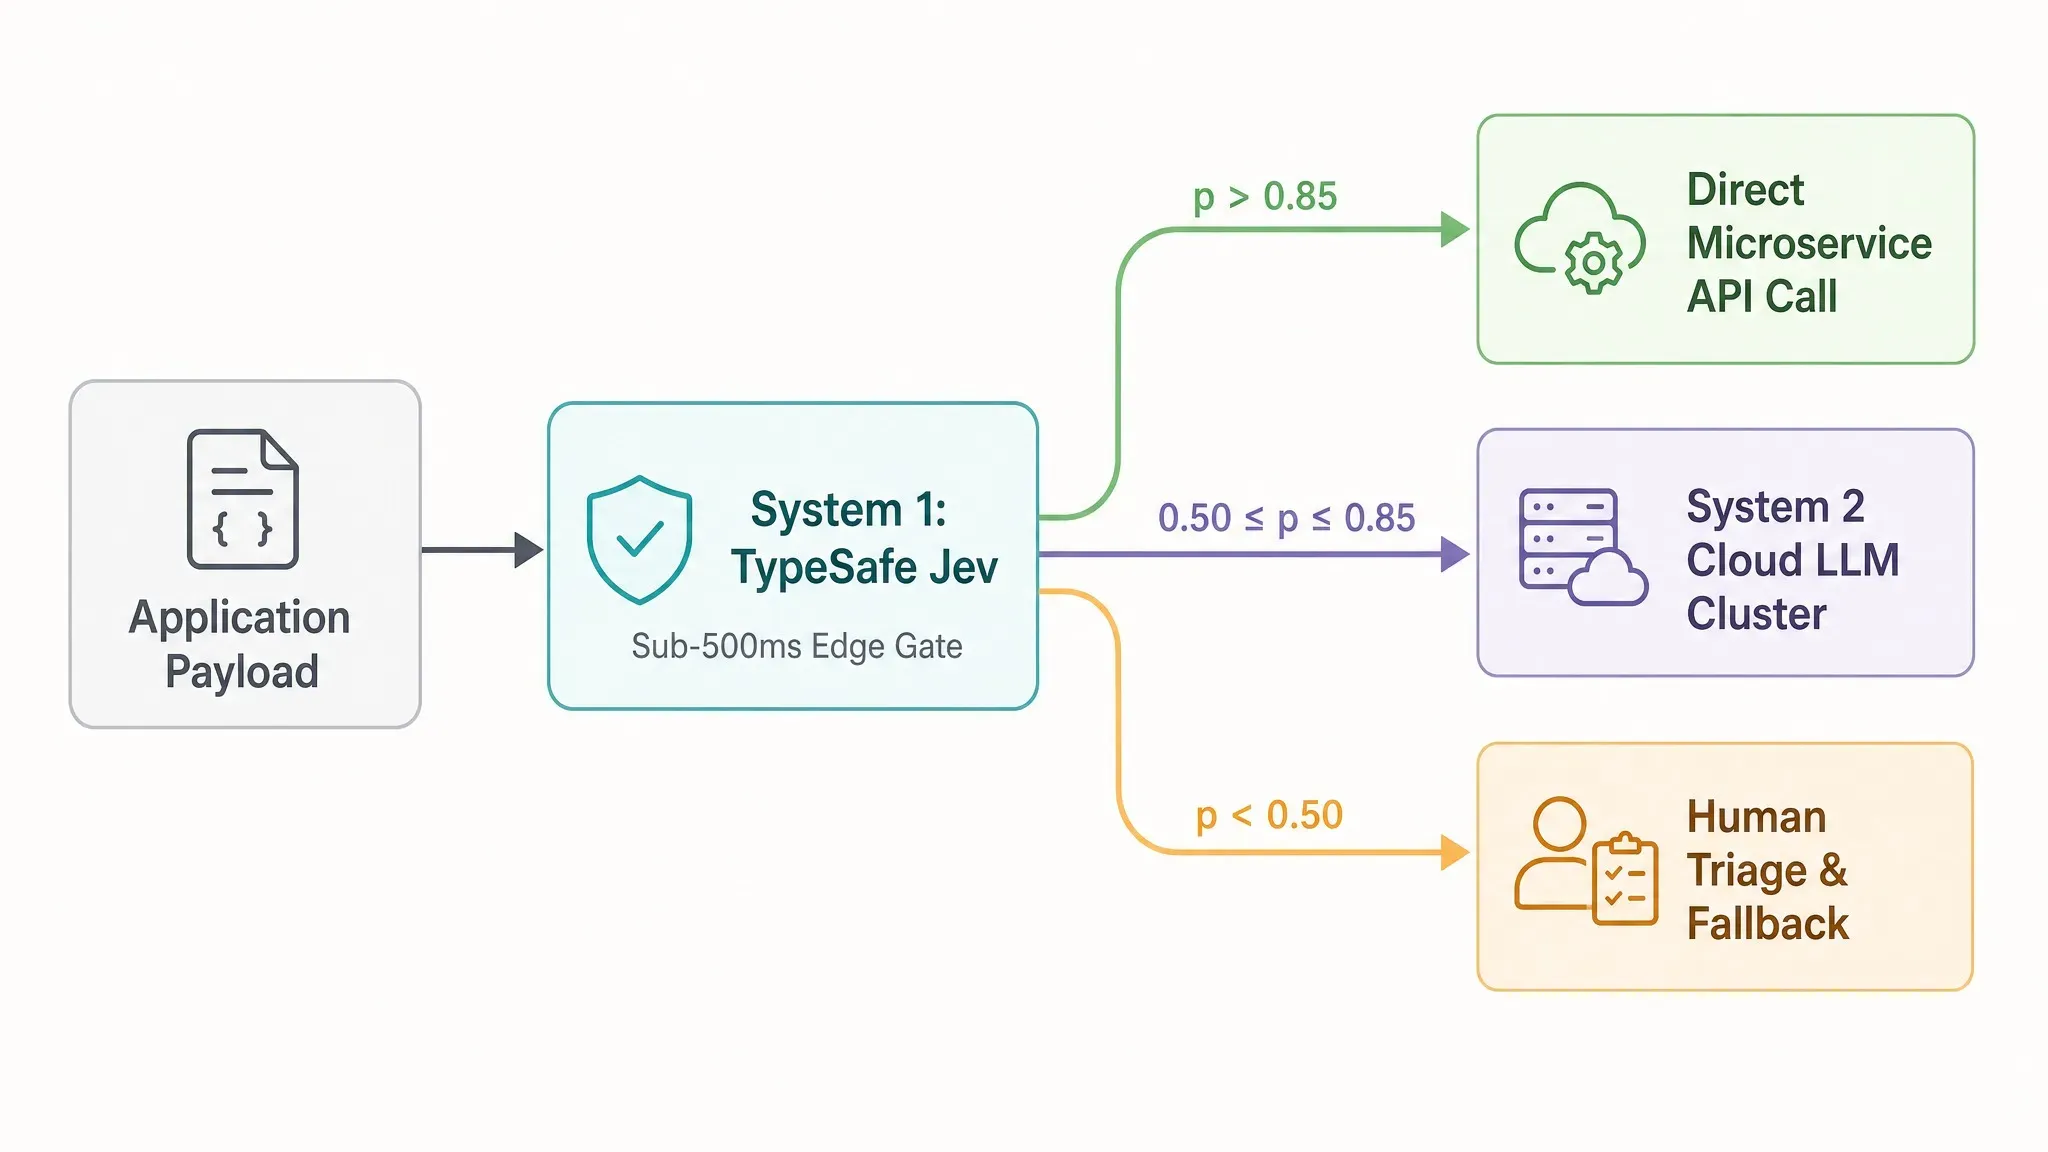
Ingenieure können diese kalibrierten Wahrscheinlichkeitsverteilungen nutzen, um schwellenwertbasierte Entscheidungs-Gates zu konfigurieren, z. B. in einem typischen Produktions-Setup:
p > 0.85(Fast-Path-Ausführung): Sofort im Hochgeschwindigkeitspfad ausführen, unter vollständiger Umgehung langsamer LLM-Endpunkte.0.50 ≤ p ≤ 0.85(System-2-Eskalation): Grenzwertige Ausgaben an ein Reasoning-LLM weitergeben, um mehrdeutige Edge Cases zu behandeln.p < 0.50(Fallback-Triage): Sicherheits-Standardwerte auslösen oder die Anfrage an eine menschliche Überprüfungswarteschlange weiterleiten.
Für grenzwertige Edge Cases 0,50 ≤ p ≤ 0,85 leitet das Confidence-gesteuerte Routing den Payload an eine Enterprise-Reasoning-Stufe weiter. Die Nutzung von GPT 5.6 Terra auf Atlas Cloud bietet ein optimales Fallback-Ziel für diese eskalierten Anfragen und nutzt sein 1.050K-Kontextfenster und die kosteneffiziente Token-Preisgestaltung von $2/$12, um eine tiefgehende Analyse durchzuführen, ohne die Infrastrukturkosten der Microservices aufzublähen.
Roh-Logprobs aus autoregressiven LLMs sind bekanntermaßen unkalibriert und verschieben sich, wann immer sich System-Prompts ändern. Durch die direkte Integration von RLCD in den Kern-Trainingsprozess macht Jev das Confidence-gesteuerte Routing produktionsreif und ermöglicht es Softwareteams, hochvolumige Pipelines sicher zu automatisieren und gleichzeitig Edge Cases zu isolieren.
Produktions-Designmuster: Hochgeschwindigkeits-AI-Pipelines in der Praxis
Produktive AI-Agenten stürzen häufig ab, wenn ein LLM eine nicht existierende Funktionssignatur wie get_user_billing_v2() erfindet oder ungültige Parametertypen an einen internen API-Endpunkt übergibt. Das Verketten mehrerer bedingter Prüfungen durch Standard-Chat-Completion-Endpunkte summiert die gesamte Systemlatenz und lässt kundenorientierte Microservices in Timeouts laufen.
Kernarchitekturmuster für hochvolumige Microservices
Die Integration von Sub-Sekunden-Entscheidungs-Engines in produktive AI-Pipelines ermöglicht es Softwareteams, unvorhersehbare Prompt-Schleifen durch deterministische Backend-Designmuster zu ersetzen:
- Agentische Tool-Auswahl: Bei der Auswahl von Tools innerhalb automatisierter Agenten-Workflows bewertet Jev verfügbare Funktionssignaturen gegen den aktuellen Anwendungszustand. Da Kandidatenfunktionen als explizite Optionen im Anfrage-Schema übergeben werden, kann Jev keine undefinierten Funktionsnamen zurückgeben, wodurch stille Laufzeitfehler während der agentischen Tool-Auswahl eliminiert werden. Diese schnelle Vorfilterung garantiert gültige Schema-Payloads, bevor Anweisungen an autonome LLM-Coding-Agent-Pipelines weitergegeben werden.
- Parallele Multi-Frage-Bewertung: Standard-Chat-Endpunkte zwingen Anwendungen, bedingte Fragen sequenziell zu bewerten, wodurch sich die Gesamtlatenz mit der Anzahl der durchgeführten Prüfungen multipliziert. Jev ermöglicht parallele Multi-Frage-Bewertung, indem Dutzende von Schemafragen über einen einzigen State-Payload in einem einzigen parallelen Forward-Pass bewertet werden. Das Ausführen von fünfzehn diskreten Klassifizierungsprüfungen dauert dasselbe 100-ms-Fenster wie das Ausführen einer einzigen.
- Ticket-Triage-Automatisierung: Für hochvolumige Microservices, die eingehende Kundentickets verarbeiten, analysiert Jev die Kundensentiment, leitet die technische Priorität weiter und prüft gleichzeitig die Rückerstattungsberechtigung. Die Implementierung von Ticket-Triage-Automatisierung mit Sub-Sekunden-Antwortzeiten verhindert Warteschlangen-Rückstände während plötzlicher Traffic-Spitzen.
Implementierung von System-One-Entscheidungsknoten über das SDK
Entwickler instanziieren latenzarme Entscheidungsknoten, indem sie das offizielle typesafe-sdk in bestehende Microservices integrieren. Der Ausführungs-Payload übermittelt den Anwendungszustand zusammen mit vorab deklarierten Schema-Primitiven direkt an den Endpunkt https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Traditionelle Tool-Calling-Setups re-tokenisieren den gesamten Prompt-Kontext für jede einzelne Funktionsbewertung. Durch die Entkopplung der State-Repräsentation von den Entscheidungsfragen führt Jev mehrzweigige Klassifizierungs-Pipelines in Backend-Systemen aus, ohne den Kontext-Token-Overhead zu multiplizieren, API-Rechnungen aufzublähen oder P95-Latenzgarantien zu opfern.
Bekannte TypeSafe Jev Einschränkungen und architektonische Kompromisse (Was Jev nicht kann)
Ein nicht-autoregressives Entscheidungsmodell einzusetzen und zu erwarten, dass es eine höfliche E-Mail-Antwort schreibt oder Positionen auf einer Rechnung summiert, führt unweigerlich zu fehlerhaftem Produktionscode. Engineering-Teams, die versuchen, Allzweck-LLMs vollständig durch System-One-Modelle zu ersetzen, stoßen schnell an physische architektonische Grenzen.
Analyse struktureller Grenzen
Das Verständnis der spezifischen Jev-Ausfallmodi ist entscheidend, bevor Jev in Microservice-Workflows eingebunden wird. Das Single-Forward-Pass-Design von Jev erzwingt strenge Grenzen bei mehreren Kernaufgaben:
- Offene Textgenerierung: Jev erzeugt keinen Konversationstext. Es kann keine Essays schreiben, Dokumente zusammenfassen oder natürlichsprachliche Erklärungen für seine Auswahlen generieren.
- Grenzen des Multi-Hop-Reasonings: Die Architektur bewertet unmittelbare State-Repräsentationen. Komplexe, sequenzielle Logikketten oder Grenzen des mehrstufigen Reasonings erfordern die Rückdelegation von Aufgaben an traditionelle autoregressive LLMs.
- Arithmetische Einschränkungen: Jev kann keine mathematischen Berechnungen durchführen oder Elemente innerhalb eines Kontext-Strings zuverlässig zählen. Arithmetische Einschränkungen erfordern, finanzielle Berechnungen und Array-Operationen im Standard-Backend-Code zu belassen.
- Wörtliche Kriterieninterpretation: Das Modell befolgt Prompt-Regeln wörtlich, ohne nicht ausdrücklich genannte Geschäftslogik abzuleiten. Mehrdeutige Schemaoptionen führen zu unerwarteten Wahrscheinlichkeitsverteilungen.
- Context Rot bei schweren Payloads: Das Übergeben massiver, unstrukturierter Logs erzeugt Context Rot, was die Bewertungsgenauigkeit beeinträchtigt. Das Herausfiltern von Rauschen aus Input-State-Payloads vor dem Senden von Anfragen bleibt unerlässlich.
Architektonisches Mapping: Fähigkeiten von System One vs. System Two
| Operative Aufgabe | TypeSafe Jev System One | Autoregressives LLM System Two |
| Kategoriale Klassifizierung | Nativ (Sub-500 ms) | Langsam (sequenzieller Text) |
| Textsynthese & Entwerfen | Unmöglich (keine Decoding-Schleife) | Nativ (offene Textgenerierung) |
| Mathematische Berechnung | Nicht unterstützt (arithmetische Einschränkungen) | Variabel (erfordert Codeausführung) |
| Rauschresistenz | Anfällig für Context Rot bei großen States | Höhere Widerstandsfähigkeit des Kontextfensters |
Jev als Sub-Sekunden-Entscheidungsknoten statt als universelle Reasoning-Engine zu behandeln, gewährleistet ein korrektes Systemdesign über produktive Microservices hinweg.
Zukünftige Cloud-Infrastruktur: Orchestrierung schneller Entscheidungsknoten
Jede eingehende Benutzeranfrage direkt an ein Reasoning-Modell mit 70 Milliarden Parametern weiterzuleiten, verbrennt Tausende von Dollar in verschwendeten GPU-Zyklen und zwingt Benutzer, mehrere Sekunden auf grundlegende Sicherheitsprüfungen und Payload-Routing zu warten. Moderne Microservice-Stacks können es sich nicht leisten, jeden eingehenden HTTP-Payload als offenes Reasoning-Problem zu behandeln.
Die Verschiebung hin zu hybriden AI-Architekturen
Cloud-Umgebungen entfernen sich von monolithischen LLM-Endpunkten hin zu einer entkoppelten hybriden AI-Architektur. In diesem aufkommenden Paradigma platzieren Cloud-Orchestratoren schnelle Entscheidungsknoten am Netzwerk-Edge, um eingehende Payloads sofort zu bewerten.
Durch die Abwicklung von Edge-AI-Routing, Schema-Verifizierung und Confidence-Scoring innerhalb von Sub-500-ms-Ausführungsfenstern filtern schnelle Entscheidungsknoten den Traffic, bevor er schwerere Modellcluster erreicht. Diese Topologie optimiert die Ressourcenzuweisung über drei verschiedene operative Cloud-Schichten hinweg:
- Edge-Guardrails und Routing: Schnelle Entscheidungsknoten bewerten Benutzerintention, bereinigen Eingaben und überprüfen die Schema-Konformität in einem einzigen Forward-Pass.
- State-Übergabe und Orchestrierung: Cloud-Orchestratoren analysieren Konfidenzwerte, führen Anfragen mit hoher Sicherheit sofort aus und leiten komplexe Reasoning-Aufgaben weiter.
- Zentralisiertes System-2-Reasoning: Schwere LLM-Cluster erhalten vorab gefilterte, strukturierte Payloads nur dann, wenn Multi-Turn-Synthese oder offene Generierung unbedingt erforderlich ist.
Bereitstellung von System-One-Modellen im großen Maßstab
Während Cloud-Plattformen ihre Hosting-Fähigkeiten erweitern, bietet die Einbindung eines TypeSafe Jev Deployments in die AI-Infrastruktur ein effizientes Muster für Edge-Microservices. Nicht-autoregressive Entscheidungsmodelle in der Nähe der Endbenutzer auszuführen, reduziert die Round-Trip-Zeiten drastisch und senkt die Rechenkosten für Anwendungen mit hohem Durchsatz.
Pipelines mit dedizierten Entscheidungsschichten aufzubauen, stellt sicher, dass Backend-Netzwerke unter schwerer Last reaktionsfähig bleiben und Frontier-Reasoning-Modelle ausschließlich auf Aufgaben fokussiert bleiben, die tiefe Berechnungen erfordern.


