Neuestes Update: Wan 3.0 ist seit dem 24. August 2026 live.
Du hast einen Ordner für eine 15-Sekunden-Werbung erstellt. Zwei Charakter-Stills. Ein vom Kunden übermitteltes Video mit Marken-Tonalität. Ein Brandbook, das nur als PDF existiert. Eine Sprachprobe des Schauspielers, den du eigentlich haben willst.
Dann hast du dein Videomodell geöffnet und es hat nach einem Bild gefragt.
Also hast du getan, was jeder tut. Du hast den Ordner in einen 800-Wörter-Prompt übersetzt und gebetet. Das Gesicht driftete in Einstellung drei. Die Jacke wechselte die Farbe. Die Stimme gehörte einer völlig anderen Person.
Wan 3.0s Omni-Referenz ist das erste Mal, dass ein Videomodell sagt: gut, gib mir den Ordner. Bis zu 20 Assets in einem einzigen Aufruf, über fünf Arten von Eingaben, zusammengehalten in einer einzigen durchgehenden 30-Sekunden-Einstellung.
Dieser Artikel macht drei Dinge und lässt den Rest aus. Er schlüsselt auf, was diese 20 Assets eigentlich sind, er verwendet Alibabas eigene generierte Clips als Belege und er gibt dir einen gleichwertigen Workflow, den du heute ausführen kannst, weil Wan 3.0 sich noch in der öffentlichen Beta auf Alibabas eigener Cloud befindet und noch nicht von Drittanbieter-Plattformen aufrufbar ist.
Wichtigste Erkenntnisse
- Wan 3.0s multimodale Referenz akzeptiert bis zu 20 Assets in einem Aufruf, darunter Bilder, Videos, Audio, Dokumente und Live-Webseiten, und hält sie über eine einzige 30-Sekunden-Einstellung hinweg konsistent.
- Es ist das erste Mainstream-Videomodell, das eine PDF, eine Präsentationsfolie oder eine URL als kreativen Input behandelt, anstatt dass man sie in einen Prompt umschreiben muss.
- Wan 3.0 trat am 6. August 2026 in die öffentliche Beta auf Alibaba Cloud Model Studio und Qwen Cloud als
wan3.0-videoein. Es hat geschlossene Gewichte. Jeder, der dir sagt, es sei bereits Apache 2.0, rät. - Die Schlagzeile mit den 20 Assets ist nicht der Punkt, an dem es wirklich die Nase vorn hat. Referenz-zu-Video-Modelle, die du jetzt aufrufen kannst, akzeptieren bereits mehr Assets als 20. Der Unterschied sind Dokumente und Webseiten, nicht die Anzahl.
- Du kannst das Zwei-Charakter-, referenzgebundene, vollständig vertonte Format kostenlos mit dem kostenlosen KI-Werbespot-Generator von Atlas Cloud testen: vier Produktfotos rein, ein 15-Sekunden-Sprachsketch raus, ohne Karte.
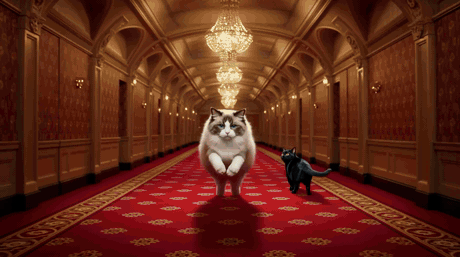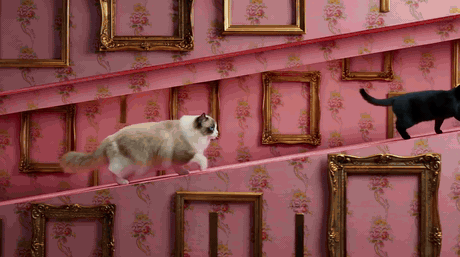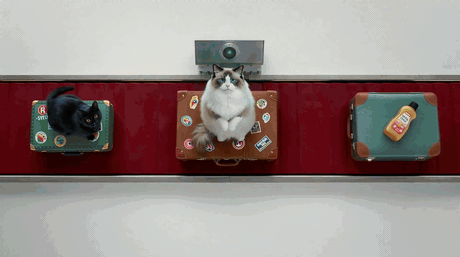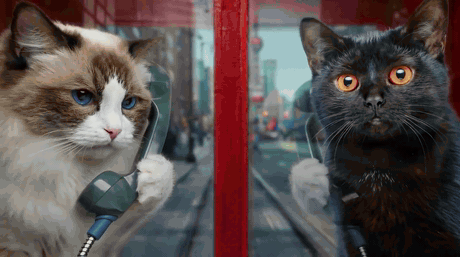
Zwei Katzen, gejagt durch fünf verschiedene Sets von Wan 3.0 ohne Charakterdrift_Zwei Referenzbilder. Fünf völlig verschiedene Sets, von einem Hotelkorridor bis zu einer Waschmaschinentrommel bis zu einer roten Telefonzelle. Kein einziger Frame Drift. Quelle: Alibabas offizielles_ Wan 3.0 Creator Handbook , August 2026, das auch die Quelle für alle anderen Wan 3.0 Clips in diesem Artikel ist.
Warum Multi-Referenz-Video auseinanderfällt und was Wan 3.0 Multimodale Referenz ändert
Videomodelle haben kein Gedächtnis zwischen Clips. Jede Generierung beginnt bei null. Das ist das ganze Problem in einem Satz.
Sobald deine Geschichte also mehr als eine Einstellung benötigt, flickst du zusammen. Einstellung eins liefert ein Gesicht, das du liebst. Einstellung zwei liefert einen Cousin dieses Gesichts. Einstellung drei ändert leise die Jacke von Pflaume zu Burgunderrot, und bis du es bemerkst, hast du bereits für elf Renderings bezahlt.
Einzelbild-Referenz hat geholfen, aber sie hat immer nur eine Sache fixiert. Ein Gesicht. Sie konnte nicht gleichzeitig ein Gesicht, ein Outfit, ein Requisit, einen Ort und eine Stimme halten, weil es einen Slot und fünf Jobs gab.
Es gibt zwei Auswege. Gib dem Modell mehr Slots, oder hör auf, es von vorne beginnen zu lassen. Wan 3.0 macht beides gleichzeitig, und deshalb sind die beiden Hauptfunktionen eigentlich eine Funktion. Eine native 30-Sekunden-Einstellung bedeutet, dass es keinen Schnitt gibt, über den die Figur driften kann. Zwanzig Referenz-Assets bedeuten, dass jedes Element, das fix bleiben muss, seinen eigenen dedizierten Slot bekommt, anstatt um einen zu kämpfen.
So sieht das aus, wenn nichts zusammengeflickt ist. Dreißig Sekunden, eine durchgehende Kamera, ein Kind in einem Einkaufswagen, das in einer Werbetafel landet und dann darunter wieder herauskommt.
Eine volle 30 Sekunden in einem Durchgang, ohne Schnitte, mit dem Soundtrack, der im selben Durchgang generiert wurde. Quelle: Alibabas offizielles Wan 3.0 Creator Handbook.
Was „20 Assets“ innerhalb der Wan 3.0 Multimodalen Referenz tatsächlich bedeutet
Zwanzig ist eine Schlagzeilenzahl. Was zählt, ist, dass die zwanzig nicht alle die gleiche Art von Ding sind. Wan 3.0s Omni-Referenz umfasst fünf Eingabetypen, und jeder steuert eine andere Achse der Ausgabe.
Bilder kontrollieren die Identität. Eine Charakterkarte, ein Produktfoto, eine Ortsplatte. Wan 3.0 nennt dies Pixel-Level-Konsistenz, und in Alibabas eigenen Beispielen erstreckt sich die Fixierung über das Gesicht hinaus auf die Kleidung: die geschichtete graue Robe, die lederne Westernjacke mit Riemen, die dunkle Taillenwicklung überleben einen sechzehnsekündigen Nahkampf an drei Orten.
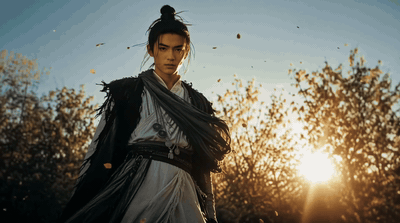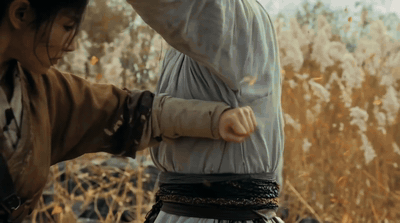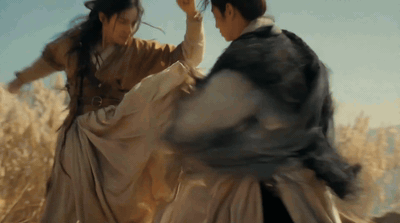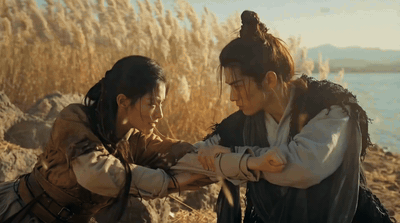
Zwei Charakterkarten treiben eine Wuxia-Kampfszene mit Kostümdetails, die von Frame zu Frame gehalten werden
Zwei Charakterkarten plus eine Ortsplatte des Schilfufer. Die Kleidung und die Umgebung halten durch jeden Wurf. Hier als stummes GIF gezeigt; die gelieferte Datei enthält einen 44,1-kHz-Stereomix. Quelle: Alibabas offizielles Wan 3.0 Creator Handbook.
Audio kontrolliert die Stimme. Das ist der Teil, der „multimodal“ mehr als nur Marketing sein lässt. Du hängst eine Sprachprobe pro Charakter an, schreibst die Zeilen in den Prompt, und der Dialog kommt in dieser Klangfarbe zurück, lippensynchron, im selben Durchgang wie das Bild. Zwei Personen, zwei Sprachreferenzen, ein Fitnessstudio.
Zwei Subjektbilder plus zwei separate Sprachreferenzclips, und der Dialog kommt in diesen beiden Stimmen zurück. Es lohnt sich, hierfür den Ton einzuschalten. Quelle: Alibabas offizielles Wan 3.0 Creator Handbook.
Video kontrolliert das Timing. Ein Referenzvideo ist nicht dazu da, kopiert zu werden. Es ist dazu da, seinen Rhythmus zu spenden: wie lange ein Beat hält, wie sich ein Übergang bewegt. In diesem liefern fünf Keyframes die Subjekte und ein Referenzvideo liefert den horizontalen Kartenflip-Rhythmus zwischen ihnen.
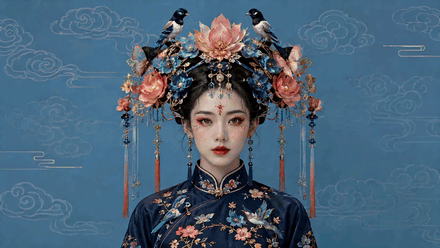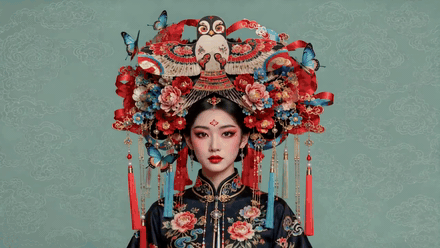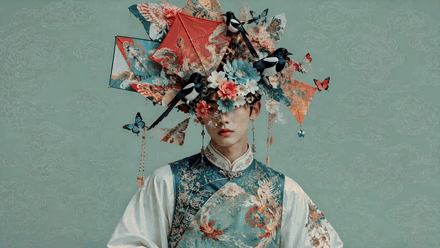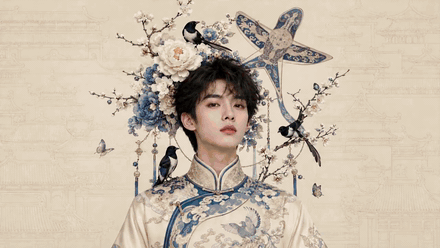
Fünf Keyframes, die mit dem Tempo aus einem Referenzvideo durchgeblättert werden_Fünf_ Keyframe-Bilder für die Subjekte, ein Referenzvideo für den Flip-Rhythmus. Quelle: Alibabas offizielles Wan 3.0 Creator Handbook.
Dokumente und Webseiten kontrollieren die Struktur. Das ist das wirklich Neue. Wan 3.0 akzeptiert Dokumentdateien und Live-URLs als kreativen Input, und die Berichterstattung über die Beta listet .doc, .xls, .ppt, .pdf und .txt unter den akzeptierten Formaten auf (AlphaSignal, August 2026). Die gleiche Logik funktioniert bereits mit einem Storyboard-Bild: ein Board rein, sechs Einstellungen raus, in der eigenen Reihenfolge des Boards.
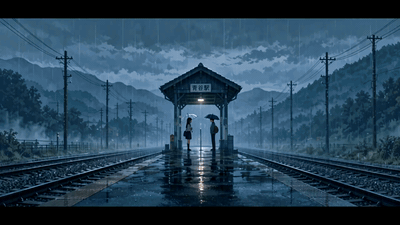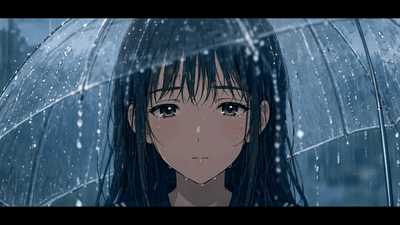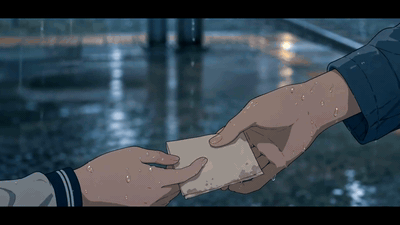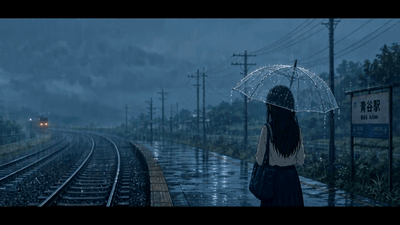
Ein einzelnes Storyboard-Blatt, erweitert in sechs aufeinanderfolgende Einstellungen an einem regnerischen Bahnsteig
Ein Storyboard-Blatt als Referenz, sechs Einstellungen in seiner Reihenfolge generiert, bis hin zum Notizwechsel in Einstellung fünf. Quelle: Alibabas offizielles Wan 3.0 Creator Handbook.
Erster und letzter Frame kontrollieren Endpunkte. Der älteste Trick im Buch, immer noch unterstützt, immer noch der schnellste Weg, eine Einstellung zu begrenzen.
So schlägt sich das gegen die Version, die die meisten Leute heute tatsächlich verwenden.
| Wan 2.7 Referenz-zu-Video | Wan 3.0 Omni-Referenz | |
|---|---|---|
| Referenz-Assets | ein Bild pro Subjekt, bis zu 3 Videos, 1 Sprachclip | bis zu 20 Assets insgesamt |
| Modalitäten | Bild, Video, Audio | Bild, Video, Audio, Dokument, Webseite |
| Maximale Dauer, ein Durchgang | 10 s | 30 s nativ, plus intelligente Dauer |
| Audio im selben Durchgang | ja | ja |
| Videobearbeitung und -verlängerung | nicht verfügbar | anweisungs- und referenzbasierte Bearbeitung, plus Verlängerung |
| Verfügbarkeit | live auf Drittanbieter-APIs | Alibaba Cloud Model Studio und Qwen Cloud Beta |
Es gibt eine Regel, die niemand in die Dokumente schreibt und die jeder auf die harte Tour lernt: eine Referenz, ein Job. Bild1 fixiert das Gesicht und das Outfit. Video1 spendet nur Bewegung. Audio1 spendet nur Klangfarbe. In dem Moment, in dem du einem einzelnen Asset zwei widersprüchliche Jobs gibst oder ein Referenzbild mit zwei Personen hochlädst, muss das Modell raten, und Raten ist genau das, was du verhindern wolltest. Alibabas Handbuch ist auch hier deutlich: ein Subjekt pro Referenzbild.
Der Wan 3.0 Multimodale Referenz Workflow, den du heute ausführen kannst
Zuerst die klare Antwort. Wan 3.0 befindet sich in der öffentlichen Beta auf Alibabas eigener Cloud, unter der Modell-ID wan3.0-video (Alibaba Wan, August 2026). Es ist noch nicht auf Drittanbieter-API-Plattformen gelandet, Atlas Cloud eingeschlossen. Jeder, der dir jetzt Wan 3.0 API-Zugang verkauft, verkauft etwas anderes weiter.
Was gelandet ist, ist die Workflow-Form. Referenzpaket rein, ein Aufruf, fertiger Clip mit Ton raus. Das läuft heute auf Referenz-zu-Video-Modellen, die du in einem Browser-Tab aufrufen kannst, und sobald du sie alle aufgereiht hast, sieht die 20-Asset-Schlagzeile anders aus.
| Modell | Referenz-Assets | Modalitäten | Maximale Dauer | Nativer Audio | Preis pro Sekunde |
|---|---|---|---|---|---|
| Wan 3.0 (Alibaba Beta, nicht auf Atlas) | 20 insgesamt | Bild, Video, Audio, Dokument, Webseite | 30 s | Ja | Berichtet $0,05 bis $0,20 je nach Auflösung |
| Wan 2.7 Referenz-zu-Video | 1 Bild pro Subjekt, 3 Videos, 1 Sprachclip | Bild, Video, Audio | 10 s | Ja | $0,10 |
| Seedance 2.5 Referenz-zu-Video | 50 (30 Bild / 10 Video / 10 Audio) | Bild, Video, Audio | 30 s | Ja | $0,13 |
| MiniMax H3 Referenz-zu-Video | gemischt, keine angegebene Obergrenze | Bild, Video, Audio | 15 s | Ja | $0,10 |
| Kling Video O3 Pro Referenz-zu-Video | 7 Bilder, oder 4 Bilder + 1 Video | Bild, Video | 15 s | Ja | $0,10 |
| Vidu Q3-Mix Referenz-zu-Video | 4 Bilder | Bild | 16 s | Ja | $0,11 |
| Veo 3.1 Referenz-zu-Video | 3 Bilder | Bild | 8 s | Optional | $0,20 |
Preise sind Atlas Cloud-Tarife Stand August 2026. Die Zahlen für Wan 3.0 sind die für die Alibaba Cloud Beta gemeldeten, kein Atlas-Tarif, und Alibaba hat noch keine öffentliche Preisliste für das Modell veröffentlicht, behandle diese Zeile also als vorläufig.
Lies die Tabelle zweimal, und die wahre Geschichte zeigt sich. Die 20-Asset-Schlagzeile ist nicht der Punkt, an dem Wan 3.0 die Nase vorn hat, denn Seedance 2.5 nimmt bereits 50 und erreicht die 30 Sekunden. Was nichts anderes auf dieser Liste annimmt, ist eine PDF.
Für die folgende Schritt-für-Schritt-Anleitung läuft die Demo auf Wan 2.7 Referenz-zu-Video, weil seine Eingabeform die engste lebende Verwandte der Omni-Referenz ist: mehrere Subjektbilder, ein optionales Referenzvideo und ein Sprachclip, alle innerhalb des Prompts auf character1- und character2-Labels abgebildet. Drei Modelle, ein Browser-Tab, keine lokale Installation.
Für einen aktuell gehosteten Durchlauf öffne Wan 3.0 auf Atlas Cloud und teste einen Prompt wie den untenstehenden, bevor du den Workflow veröffentlichst.
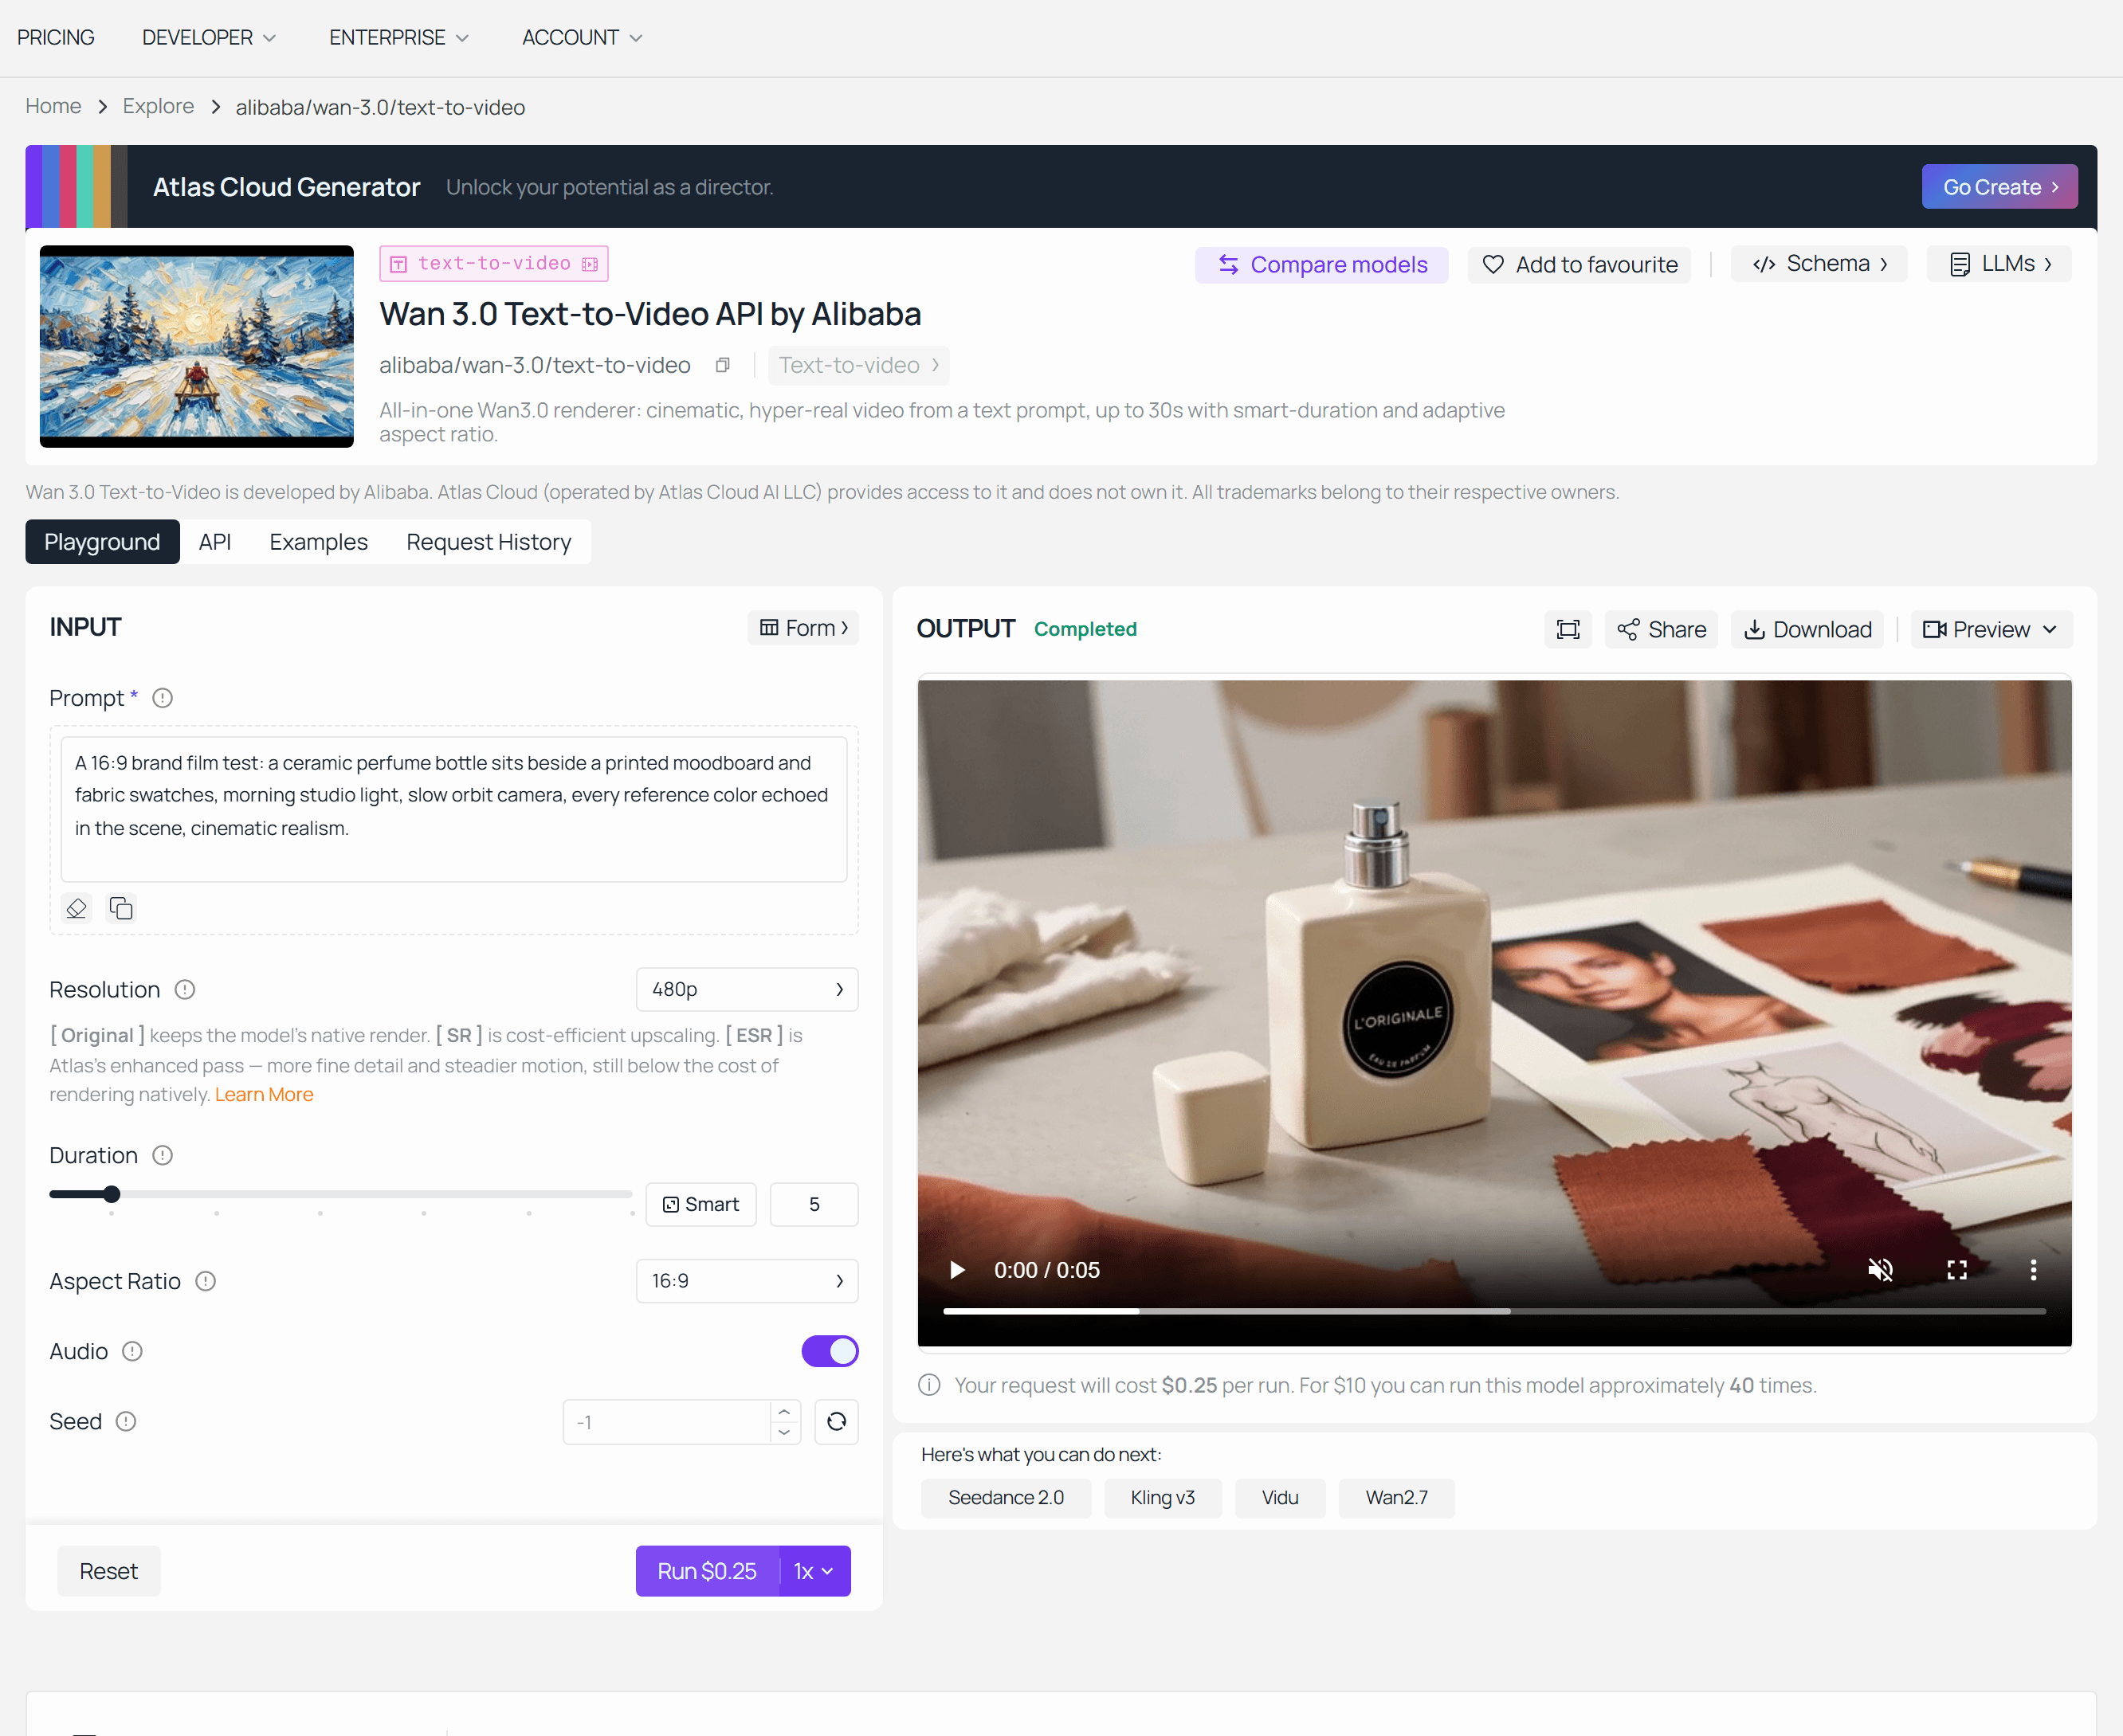
Wan 3.0 Prompt-zu-Ergebnis-Screenshot: 20-Referenz-Markenübergabe.
Bau es selbst: Eine Multimodale Referenz-Szene in vier Schritten
Die Szene: eine pastellfarbene Hotelrezeption. Ein todtrauriger Concierge. Ein Reisender mit einer Stoffkatze. Der Concierge blickt direkt in die Linse und sagt: „Die Katze hat eine Reservierung. Sie nicht."
Zwei Bilder plus ein Sprachclip, das sind drei Referenz-Assets über zwei Modalitäten. Das ist der kleinste Bau, der ehrlich multimodal ist und nicht nur Multi-Bild.
Schritt 1. Generiere Referenzbild 1, das Subjekt, das du fixieren musst
Referenzbilder haben drei Aufgaben und nur drei: ein Subjekt, zur Kamera gerichtet, sauberer Hintergrund. Alles andere ist Dekoration. Verwende GPT Image 2 mit Qualität high, Größe 16:9, n=1.
Plain1Ganzkörper-Studio-Porträt eines Hotel-Concierges mittleren Alters mit todtraurigem Ausdruck, genau mittig vor einer flachen, staubigen rosa Wand. Er trägt eine pflaumenfarbene, zweireihige Hoteluniform mit Goldborte und Messingknöpfen, eine kleine runde Pillbox-Mütze und einen dünnen Schnurrbart. Perfekt symmetrische Rahmung, gleichmäßiges, weiches Frontallicht, kein Schlagschatten an der Wand, 35mm Filmkorn, gedämpfte Pastellpalette. Nur ein Subjekt, keine anderen Personen, kein Text, kein Logo, keine Requisiten im Bild. 2
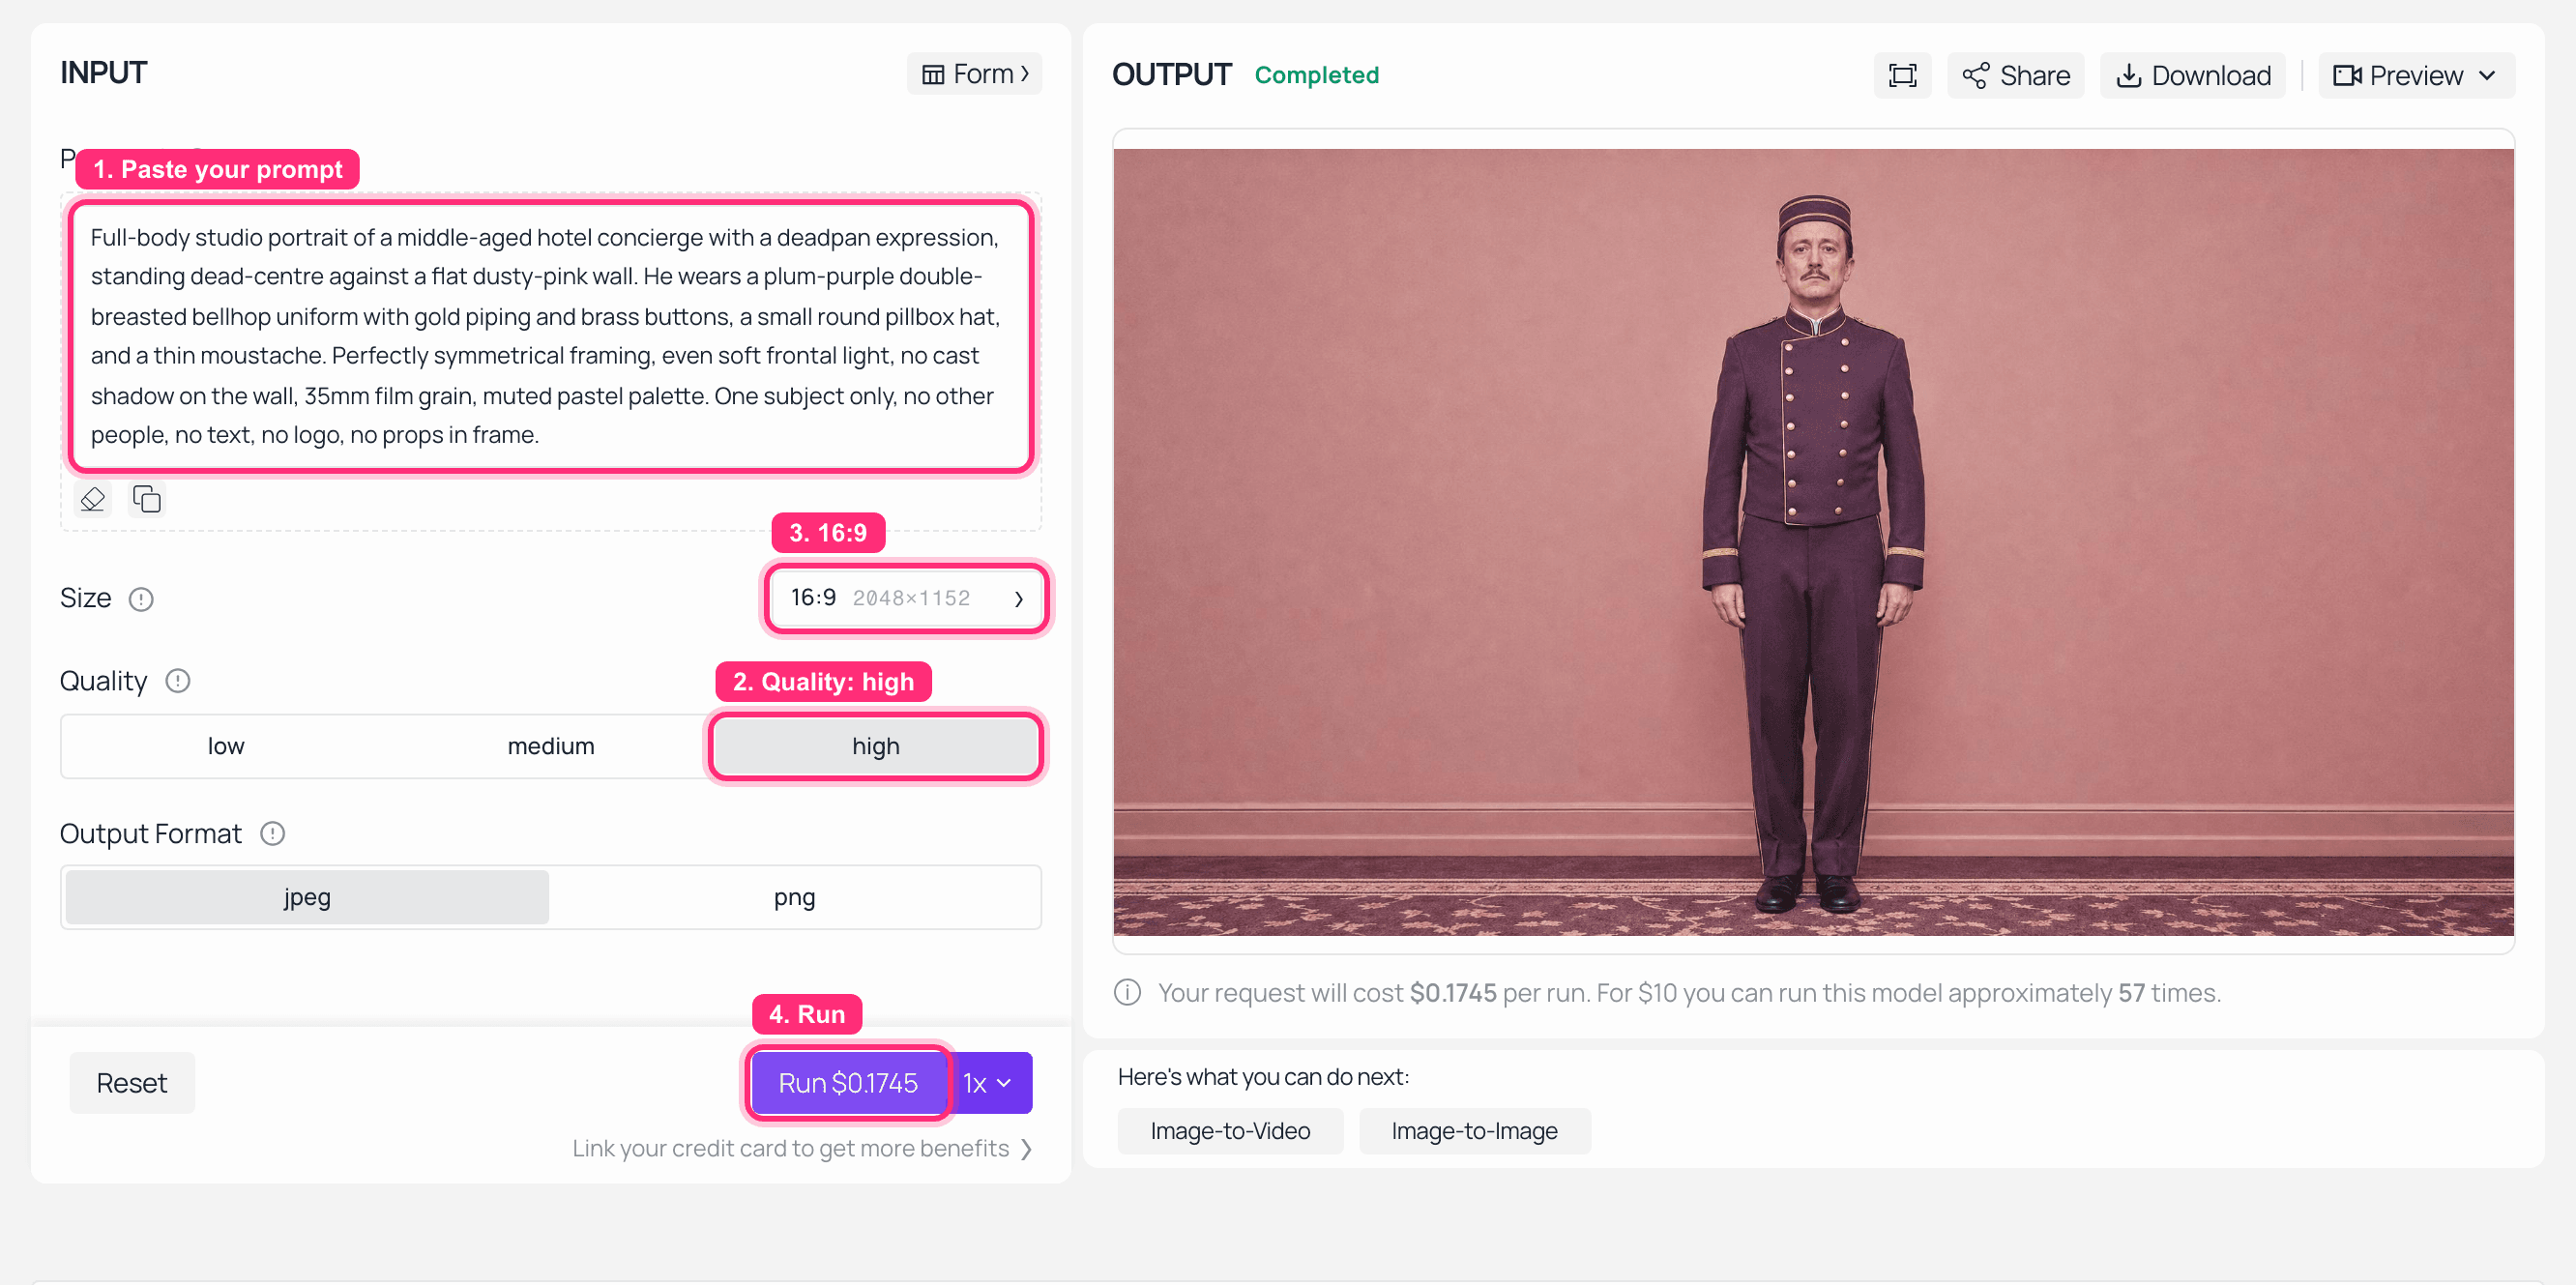
GPT Image 2 Playground auf Atlas Cloud mit dem Concierge-Referenzporträt im Ausgabefenster
GPT Image 2 auf Atlas Cloud: Qualität high, 16:9, ein Subjekt, flacher Hintergrund. Dies ist die Datei, die zu character1 wird.
Schritt 2. Generiere Referenzbild 2, das zweite fixierte Subjekt
Gleiches Modell, gleiche Einstellungen. Der Farbkontrast zwischen den beiden Charakteren ist bewusst, da er dem Modell eine einfache Möglichkeit gibt, sie auseinanderzuhalten, wenn sie sich einen Frame teilen.
Plain1Ganzkörper-Studio-Porträt einer jungen Reisenden, die eine flauschige Stoffkatze an ihre Brust drückt, genau mittig vor einer flachen, senfgelben Wand. Sie trägt einen senfgelben Wollmantel, eine rote Baskenmütze und eine runde Schildpattbrille und hält in ihrer freien Hand einen kleinen Vintage-Lederkoffer. Perfekt symmetrische Rahmung, gleichmäßiges, weiches Frontallicht, kein Schlagschatten an der Wand, 35mm Filmkorn, gedämpfte Pastellpalette. Nur ein Subjekt, keine anderen Personen, kein Text, kein Logo. 2
Schritt 3. Generiere die Sprachreferenz, die eigentliche multimodale Komponente
Der Sprachclip macht dies von einer Multi-Bild-Aufgabe zu einer multimodalen. Der Audio-Slot von Wan 2.7 möchte eine kurze Probe, ungefähr 1 bis 10 Sekunden, also halte die Zeile kurz. Verwende MiniMax Speech 2.6 HD und wähle eine tiefe, flache, ungerührte männliche Stimme.
Plain1Guten Abend. Checken Sie ein? Natürlich. Tut das jeder. 2
Schritt 4. Ein Aufruf, drei Referenzen, ein fertiger Clip
Jetzt kommt das gesamte Paket zusammen auf Wan 2.7 Referenz-zu-Video. Einstellungen: resolution: 1080P, ratio: 16:9, duration: 10, das ist die Obergrenze dieses Modells, prompt_extend: false, seed: -1. Lade images in der Reihenfolge, Schritt 1 zuerst, damit es auf character1 abgebildet wird, dann Schritt 2 als character2, und hänge die Datei aus Schritt 3 an audio an.
Plain1Symmetrische, mittige Totale einer pastellfarbenen Hotel-Lobby-Rezeption, staubige rosa Wände und ein senfgelber Schlüsselhalter dahinter. character1 ist der Concierge, der hinter dem Tresen steht; character2 ist die Reisende, die davor steht, immer noch ihre Stoffkatze haltend. Die Kamera fährt langsam entlang einer perfekten Mittelachse ein und neigt sich nie. character1 blickt direkt in die Linse und sagt flach: "Die Katze hat eine Reservierung. Sie nicht." character2 blinzelt einmal, dreht langsam den Kopf zur Katze, dann zurück zum Tresen. Die Katze starrt ohne sich zu bewegen direkt in die Kamera. 35mm Filmkorn, gleichmäßige, weiche Beleuchtung, gedämpfte Pastellpalette, keine Kameraverwacklung, keine Schnitte. 2
Negativ-Prompt:
Plain1Handkamera-Verwacklung, Jump Cuts, Untertitel, Bildschirmtext, Wasserzeichen, zusätzliche Personen, deformierte Hände, Gesichts-Morphing, Farbverschiebung, Bewegungsunschärfe 2
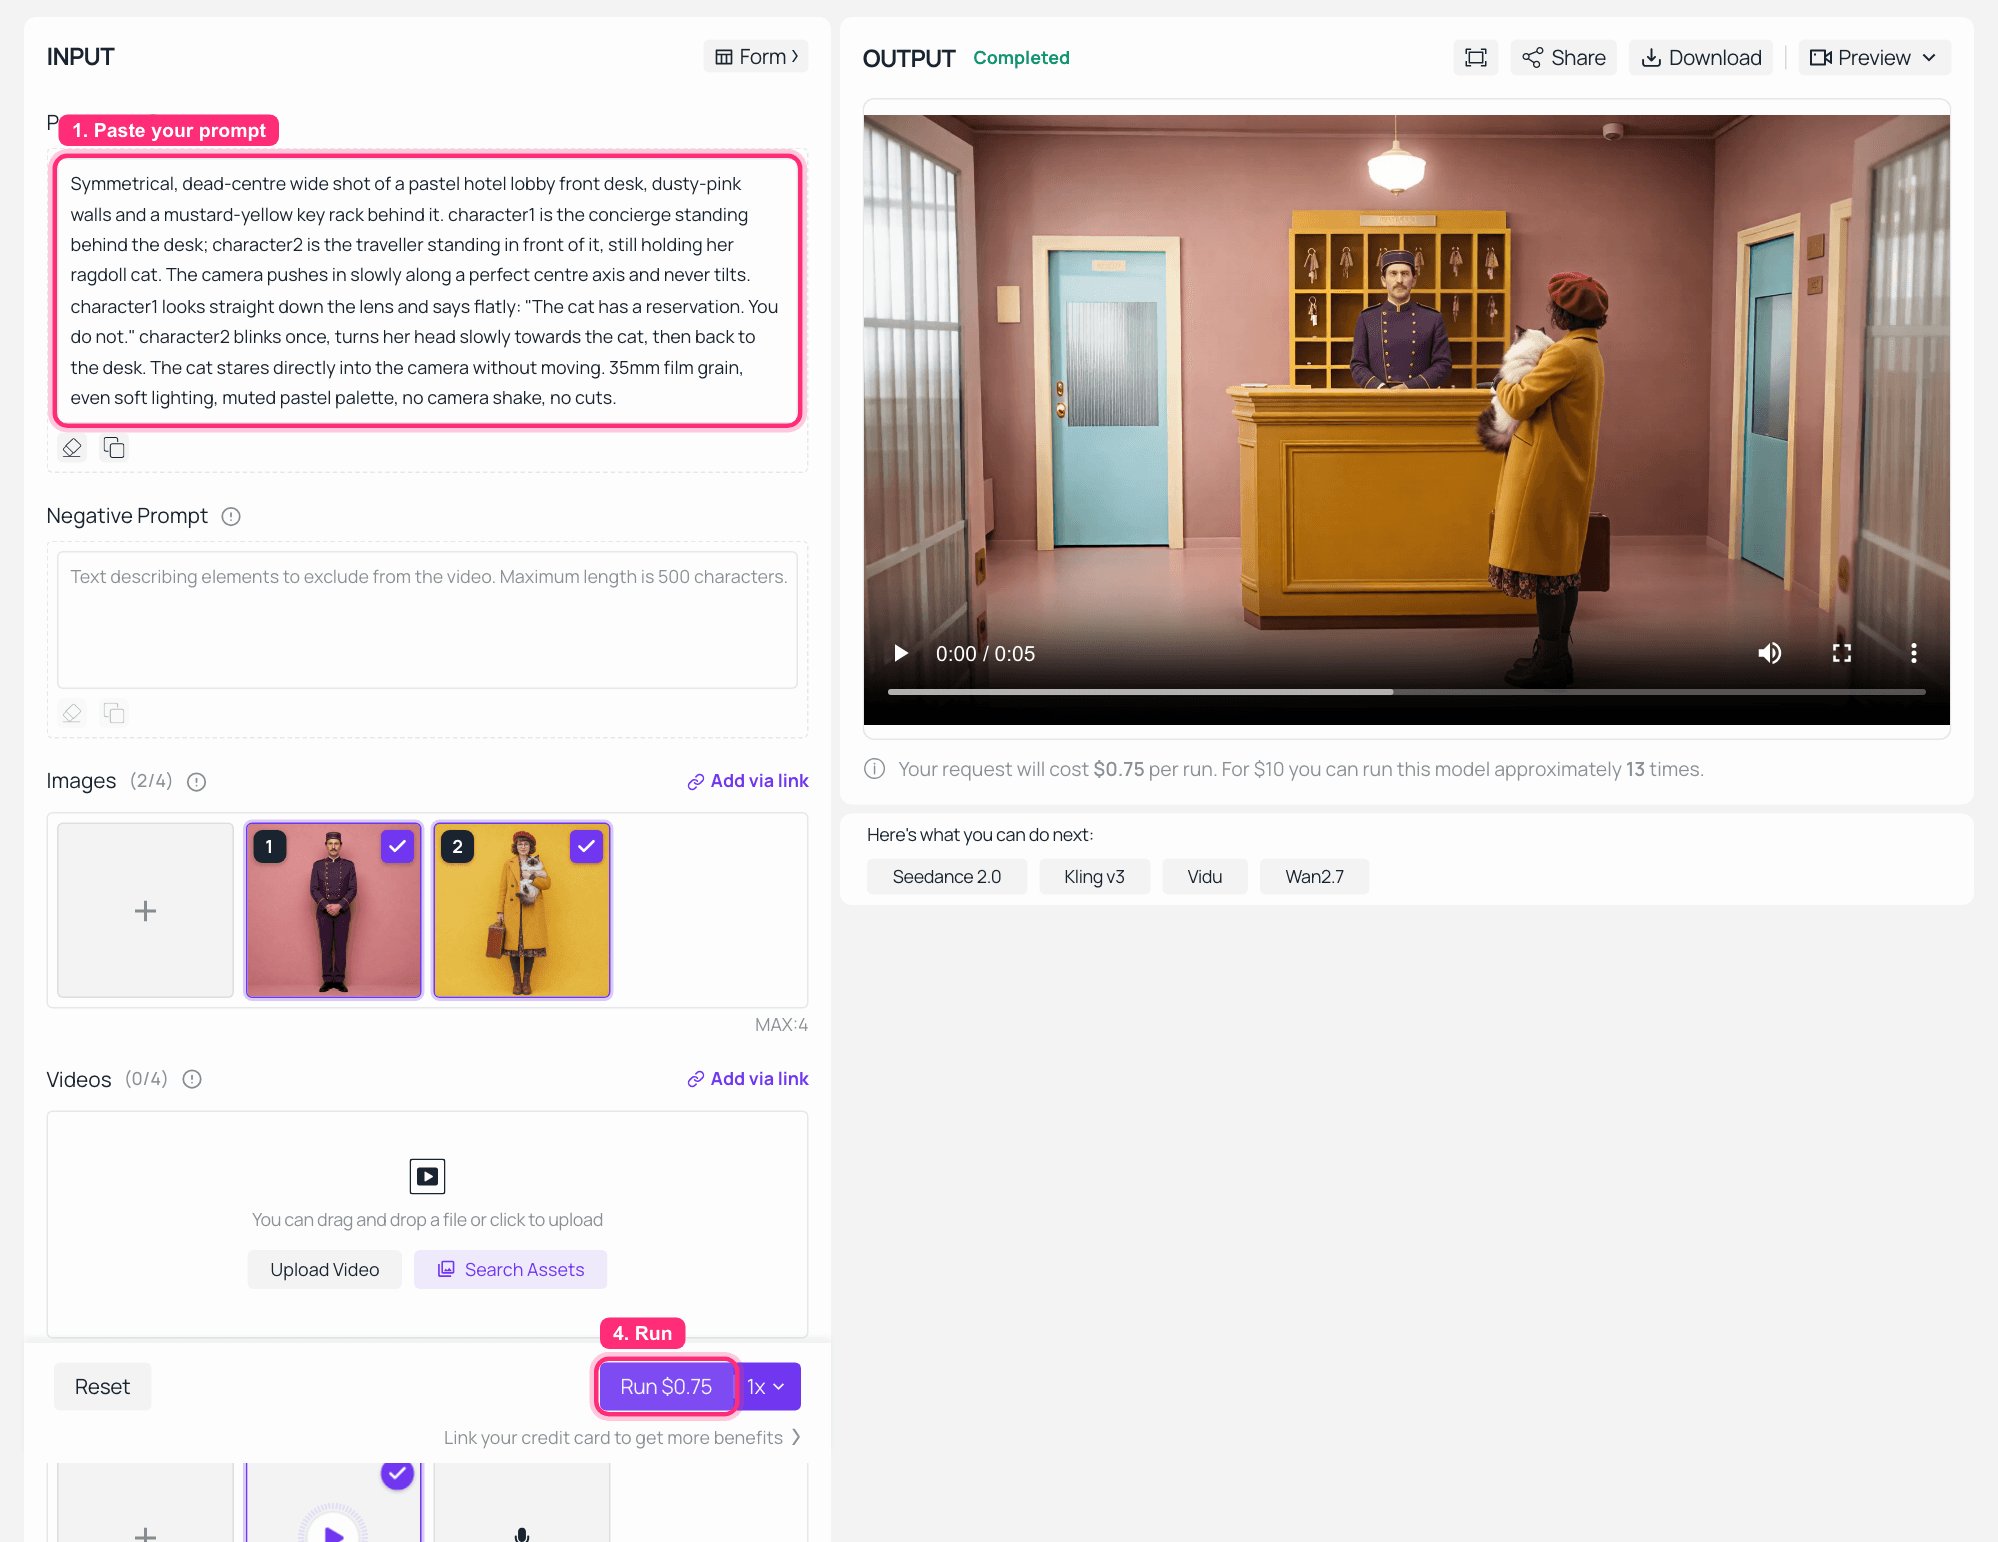
Wan 2.7 Referenz-zu-Video Playground auf Atlas Cloud mit zwei Referenzbildern und einer Audiodatei geladen und dem fertigen Clip im Ausgabefenster
Wan 2.7 Referenz-zu-Video auf Atlas Cloud: zwei Referenzbilder und ein Sprachclip auf der linken Seite, der fertige Take läuft rechts in 1080P und 16:9. Dieser Screenshot lief bei der Standarddauer des Modells; setze sie für die vollständige Version unten auf 10.
Der fertige Clip. Beide Gesichter gehalten, beide Outfits gehalten, und die Zeile in der geklonten Stimme aus Schritt 3 geliefert, daher lohnt es sich, diesen mit Ton abzuspielen.
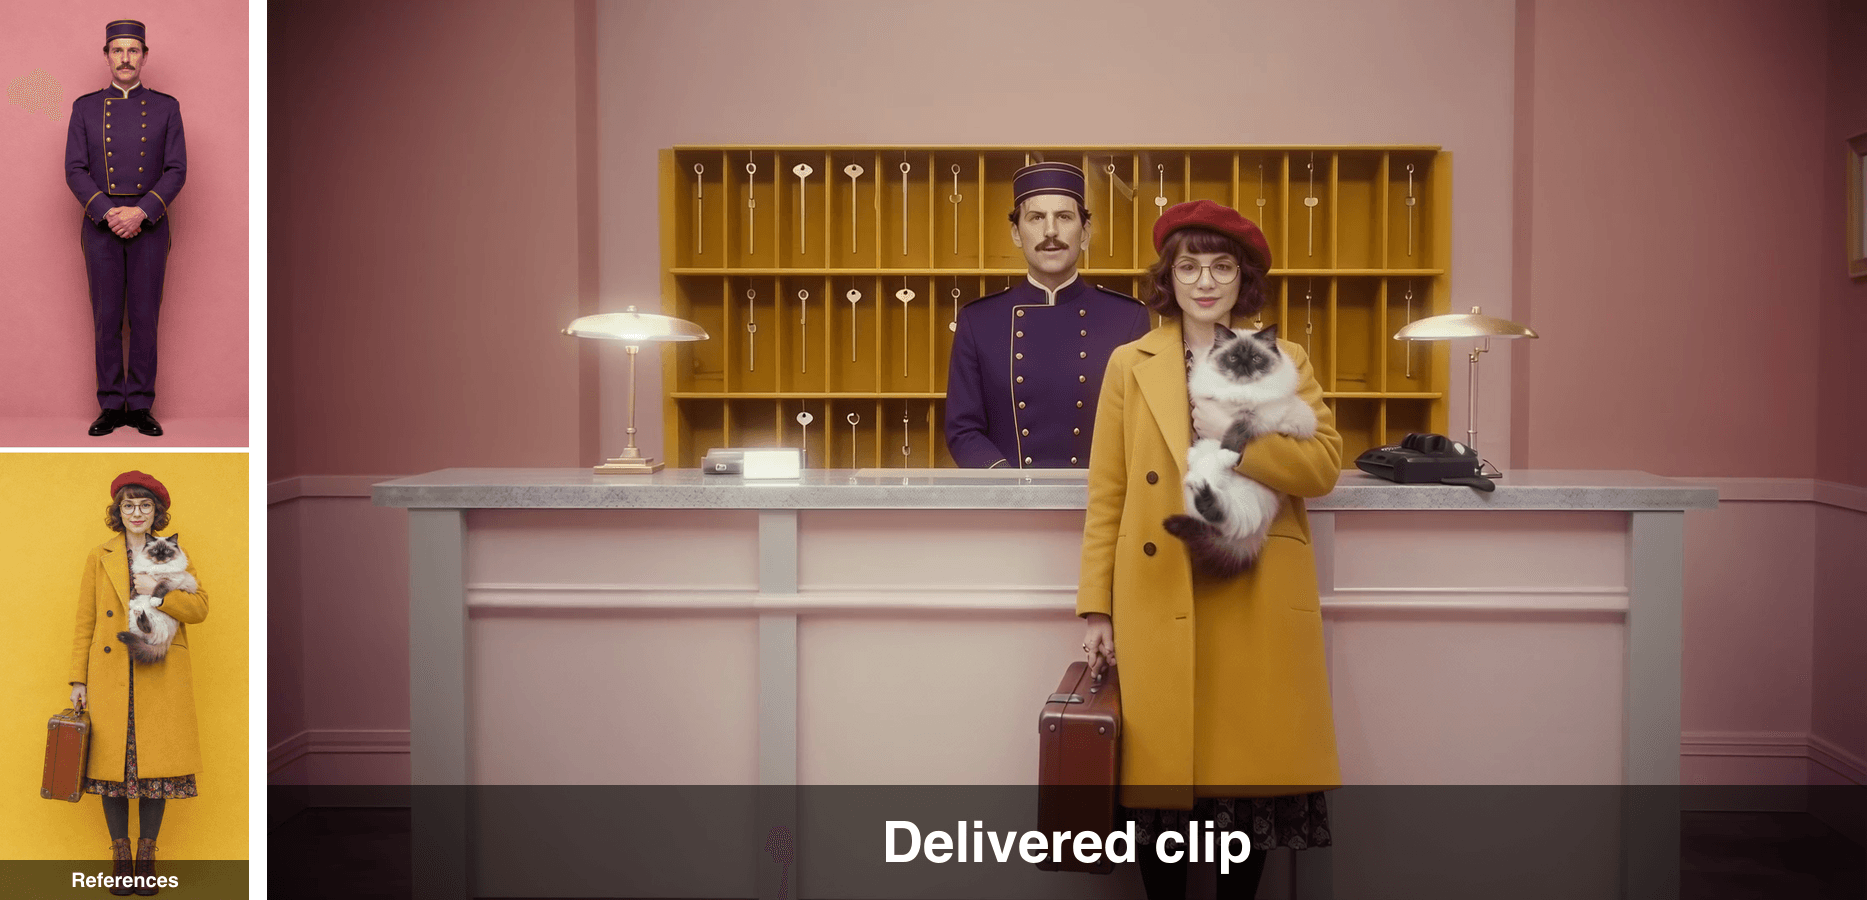
Die beiden Referenzporträts neben einem Frame des fertigen Clips, die die gleichen Gesichter und Outfits zeigen
Referenzen links, ein Frame aus dem gelieferten Clip rechts. Uniformborte, Baskenmütze, Brille und Katze überstehen die Reise.
Variationen des Wan 3.0 Multimodalen Referenz Workflows
Erweitere auf 30 Sekunden. Das gleiche Referenzpaket läuft auf Seedance 2.5 Referenz-zu-Video mit duration: 30, was dir die Länge gibt, die Wan 3.0 verspricht, ohne auf die Beta zu warten. Es nimmt bis zu 30 Referenzbilder, 10 Videos und 10 Audioclips, also hat das Paket Platz zum Wachsen. Schreibe die zusätzlichen 20 Sekunden als Beats in den Prompt, nicht als Stimmungen, sonst füllt das Modell auf.
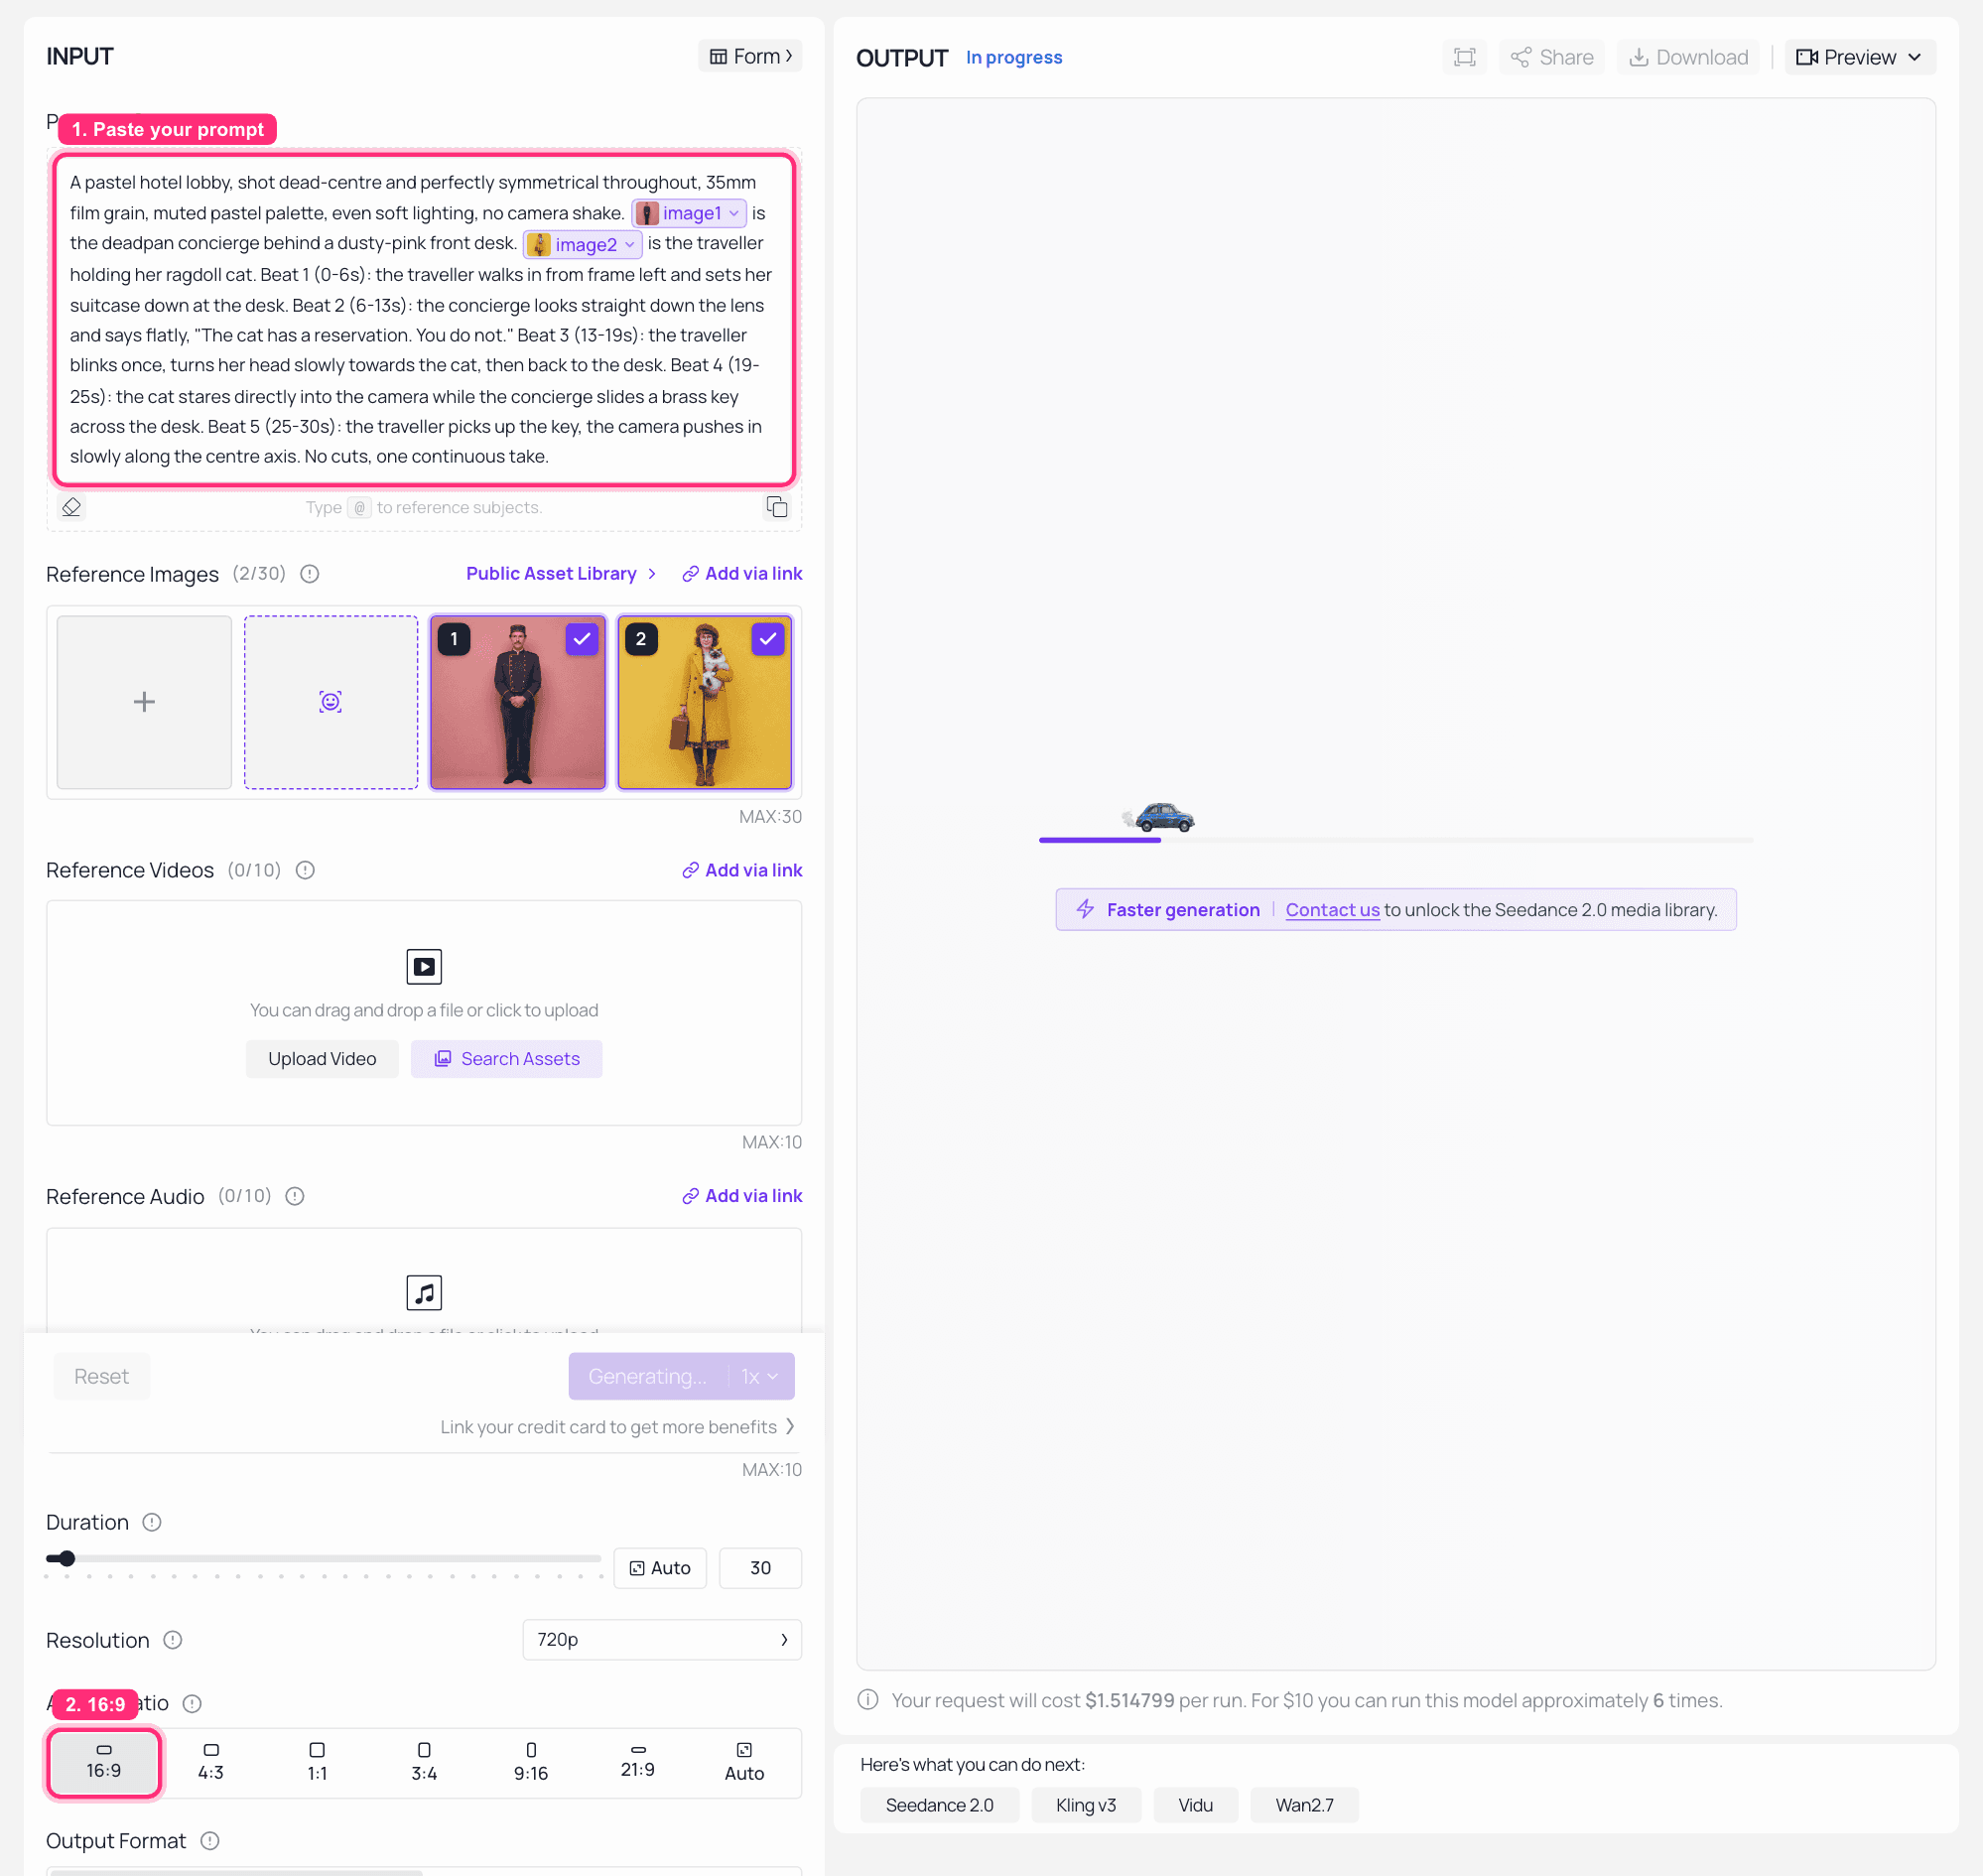
Seedance 2.5 Referenz-zu-Video Playground auf Atlas Cloud mit auf 30 gesetzter Dauer und dem langen Take gerendert
Seedance 2.5 Referenz-zu-Video auf Atlas Cloud mit auf 30 gesetzter Dauer und denselben zwei Referenzporträts, mitten in der Generierung erfasst. Beachte die @image1 und @image2 Chips im Prompt: So sagst du Seedance, welche Referenz welche Rolle spielt. Überprüfe den angegebenen Preis auf der Ausführen-Schaltfläche, bevor du zusagst, da er die Dauer widerspiegelt, die der Job tatsächlich einreichen wird.
Die 30-Sekunden-Version derselben Szene, dasselbe Referenzpaket, Beats Einstellung für Einstellung ausgeschrieben.
Füge ein Referenzvideo nur für die Bewegung hinzu. Hänge einen Clip an, dessen Tempo dir gefällt, und sage dies explizit im Prompt, etwa „Folge dem Referenzvideo nur für den Schnittrhythmus, ignoriere seine Subjekte und die Umgebung". Das ist der Trick hinter dem Kartenflip-Beispiel weiter oben.
Behebe Drift mit dem Negativ-Prompt, bevor du den Positiven anfasst. Gesichts-Morphing, Farbverschiebung und Handkamera-Verwacklung sind die drei Dinge, die referenzgesperrte Aufnahmen ruinieren, und sie sind normalerweise billiger zu unterdrücken als auszubeschreiben.
Teste das Multimodale Referenzformat kostenlos
Wenn du die Form davon haben möchtest, bevor du die Parameter haben möchtest, hat Atlas Cloud letzte Woche einen kostenlosen KI-Werbespot-Generator veröffentlicht, der dieselbe Kette ohne jegliche Einstellungsmöglichkeiten ausführt.
Du schreibst eine Zeile über dein Produkt und seine Verkaufsargumente. Es schreibt ein Zwei-Charakter-Comedy-Skript für dich, Aufhänger, Konflikt, Wendepunkt, und rendert dann ein 15-Sekunden-Video mit gesprochenem Dialog und integrierten Soundeffekten. Du kannst bis zu vier echte Produktfotos als Referenzen anhängen, und die Werbung behält deren Form, Farbe, Etikett und Logo vom Skript bis zum letzten Frame. Sechs Stile sind enthalten, vom lustigen Meme über Plot Twist und Sitcom bis hin zu Luxus und Hard Sell, und der Dialog kommt in der Sprache zurück, in der du die Beschreibung geschrieben hast.
Das ist dieselbe Zwei-Charaktere-plus-Referenzbilder-plus-Stimme-Kette aus dem Tutorial, minus dem Prompt-Schreiben und minus der Rechnung. Das macht es zu einer vernünftigen Möglichkeit, herauszufinden, ob dieses Format zu deinem Produkt passt, bevor du etwas für die Feinabstimmung ausgibst.
Um einen Eindruck davon zu bekommen, was ein Stapel von Referenz-Stills mit einem Produktstück macht, hier ist Wan 3.0s eigene Version der Aufgabe: fünf Bilder rein, eine Launch-Reel raus, jedes Still verankert einen Beat des Schnitts.
Fünf Referenz-Stills, erweitert zu einer Produkt-Launch-Reel im Material Design_Fünf Referenzbilder treiben einen neunsekündigen Produktfilm an, jedes verankert einen Beat und übergibt an den nächsten. Quelle: Alibabas offizielles Wan 3.0 Creator Handbook._
Was ein Wan 3.0 Multimodaler Referenz-Clip kostet
| Schritt | Modell | Einzelpreis | Menge | Kosten |
|---|---|---|---|---|
| 1 und 2, zwei Referenzbilder | GPT Image 2 | $0,009 pro Bild | 2 | $0,02 |
| 3, Sprachreferenz | MiniMax Speech 2.6 HD | $0,08 pro 1K Zeichen | 49 Zeichen | $0,00 |
| 4, der 10-Sekunden-Take in 1080P | Wan 2.7 Referenz-zu-Video | $0,15 pro Sekunde in 1080P | 10 s | $1,50 |
| Tutorial-Gesamt | ca. $1,52 | |||
| Variation, 30 Sekunden | Seedance 2.5 Referenz-zu-Video | $0,134 pro Sekunde in 480P | 30 s | ca. $4,02 |
| Kostenloser Weg | Kostenloser KI-Werbespot-Generator | kostenlos | 1 Clip, 15 s | $0 |
Das sind die eigenen Tarife der Plattform, geprüft im August 2026 und nach Verbrauch abgerechnet. Zwei Dinge bewegen die Gesamtsumme mehr, als die Leute erwarten. Auflösung ist das erste: die $0,10 pro Sekunde in der Vergleichstabelle ist Wan 2.7s Basistarif, und 1080P wird mit $0,15 abgerechnet, woher die $1,50 oben kommen. Das zweite ist, dass Seedance nach Pixelanzahl abrechnet, daher ist der angegebene $0,134 pro Sekunde der 480P-Wert und ein 720P-Take kostet mehr, als eine einfache Multiplikation vermuten lässt. Als Referenz: der gemeldete Wan 3.0 Beta-Tarif von $0,20 pro Sekunde in 1080P würde einen vollen 30-Sekunden-Take auf etwa $6 bringen, was mehr ist als der Seedance-Weg in 480P heute.
Ein Hinweis zur Nutzung dieser Sachen. Wan 3.0 ist eine Beta und seine Bedingungen können sich ändern, also lies sie erneut durch, bevor du eine Pipeline darauf aufbaust. Wenn deine Referenzbilder echte Menschen sind, hol dir vorher ihre Erlaubnis, da Referenz-zu-Video genau die Fähigkeit ist, die dies relevant macht. Die Beispielclips in diesem Artikel sind Alibabas eigene generierte Ergebnisse aus seinem öffentlichen Creator Handbook, die hier zu Kommentierungszwecken reproduziert werden.
Häufig gestellte Fragen
Wie viele Referenzen kann Wan 3.0s multimodale Referenz tatsächlich aufnehmen?
Bis zu 20 Assets in einem einzigen Aufruf, bestehend aus Bildern, Videos, Audio, Dokumenten und Webseiten. Die praktische Grenze ist niedriger als die technische. Weise jedem Asset genau einen Job zu, ein Subjekt pro Bild, und du wirst für die meisten Szenen weit weniger als 20 verwenden.
Kann Wan 3.0 wirklich eine PDF oder eine Webseite in ein Video verwandeln?
Ja, das ist der wirklich einzigartige Teil. Neben Text, Bild, Audio und Video akzeptiert es Dokumentdateien und Live-URLs, wobei die Berichterstattung über die Beta .doc, .xls, .ppt, .pdf und .txt auflistet. Kein anderes Referenz-zu-Video-Modell in der obigen Vergleichstabelle nimmt überhaupt ein Dokument an.
Ist Wan 3.0 Open Source? Kann ich es in ComfyUI ausführen?
Nein, und im Moment nicht. Wan 3.0 ist eine geschlossene Beta, die auf Alibabas eigener Cloud läuft. Frühere Wan-Generationen wurden offen veröffentlicht, weshalb die Erwartung besteht, aber Alibaba hat keine Gewichte für 3.0 bestätigt. Seiten, die eine 1,3B- oder 14B-Apache-2.0-Veröffentlichung von Wan 3.0 behaupten, werden durch nichts Offizielles gestützt.
Ist Wan 3.0 bereits über Drittanbieter-APIs verfügbar?
Noch nicht, Atlas Cloud eingeschlossen. Das nächste, was du heute aufrufen kannst, ist Wan 2.7 Referenz-zu-Video, dessen Eingabeform fast genau der Omni-Referenz entspricht, abgesehen von den Dokument- und Webseiten-Modalitäten, oder Seedance 2.5 Referenz-zu-Video, wenn du die vollen 30 Sekunden brauchst.
Was ist der günstigste Weg, ein referenzgesperrtes Zwei-Charakter-Video zu testen?
Der oben verlinkte kostenlose KI-Werbespot-Generator. Vier Referenzfotos rein, ein 15-Sekunden-Sprach-Zwei-Charakter-Clip raus, keine Parameter und kein Geld ausgeben. Wenn es dein Produkt und dein Format hält, dann gehe zur Bezahlkette und stimme sie ab.
Warum driften meine Charaktere trotz Referenzbildern immer noch?
Drei Ursachen, in der Reihenfolge ihrer Häufigkeit. Eine Referenz trägt zwei Jobs, wird also gebeten, sowohl das Gesicht als auch den Ort zu fixieren. Das Referenzbild hat mehr als eine Person oder einen unruhigen Hintergrund, sodass das Modell nicht weiß, welchen Teil es fixieren soll. Oder der Drift ist ein Rendering-Artefakt und kein Referenzfehler; in diesem Fall setze Gesichts-Morphing, Farbverschiebung in den Negativ-Prompt, bevor du etwas umschreibst.


