
MiniMax API
Als führende Suite von Large Language Models (LLMs), entwickelt von MiniMax AI, ist MiniMax darauf ausgelegt, die Produktivität in der realen Welt durch modernste künstliche Intelligenz neu zu definieren. Das Ökosystem umfasst MiniMax M2.5, das speziell für hocheffiziente professionelle Umgebungen entwickelt wurde, sowie MiniMax M2.1, ein Modell mit deutlich verbesserten mehrsprachigen Programmierfähigkeiten zur Bewältigung komplexer, groß angelegter technischer Aufgaben. Durch SOTA-Leistung beim Coding, beim agentischen Einsatz von Tools, bei intelligenter Suche und bei der Automatisierung von Office-Workflows ermöglicht MiniMax Nutzern, ein breites Spektrum wirtschaftlich wertvoller Abläufe mit beispielloser Präzision und Zuverlässigkeit zu optimieren.
MiniMax wurde von MiniMax entwickelt. Atlas Cloud (betrieben von Atlas Cloud AI LLC) stellt lediglich den Zugang bereit und ist nicht Eigentümerin des Modells. Alle Marken sind Eigentum ihrer jeweiligen Inhaber.
Erkunden Sie die Führenden Modelle
Atlas Cloud bietet Ihnen die neuesten branchenführenden kreativen Modelle.



Vergleich der MiniMax API-Modellpalette
Ein klarer Überblick darüber, was die einzelnen MiniMax-Endpunkte akzeptieren, erzeugen und kosten – von Text, Coding und agentischen Workflows bis hin zur Musikgenerierung.
| Modalität | Beschreibung |
|---|---|
| MiniMax M3 API (Text) | Sie brauchen ein schnelles agentisches Modell? MiniMax M3 wandelt Text-Prompts in Code, Tool Calls und Schlussfolgerungen um – auf Basis eines schlanken Kerns mit 10 billion activated parameters, der auf niedrige Latenz und Skalierbarkeit ausgelegt ist. Der Standardpreis beträgt $0.6 pro Million input tokens und $2.4 pro Million output tokens; für Prompts über 512K tokens gilt eine separate Preisstufe. Es eignet sich für lange, tool-intensive Agent-Sessions und moderne Anwendungsentwicklung. |
| MiniMax M2.7 (Text) | MiniMax M2.7 verwandelt natürlichsprachliche Anweisungen in produktionsreifen Code und mehrstufige Agent-Aktionen und nutzt dafür dasselbe Design mit 10 billion activated parameters für hohen Durchsatz. Der Standardpreis liegt bei $0.3 pro Million input tokens und $1.2 pro Million output tokens, wodurch umfangreiche agentische Läufe wirtschaftlich bleiben. Greifen Sie darauf zurück, wenn zuverlässiges Coding und Kapazität für App-Entwicklung wichtiger sind als die reine Modellgröße. |
| MiniMax M2.5 (Text) | Wenn Ihre Workloads kostengünstiges, skalierbares Reasoning erfordern, übernimmt MiniMax M2.5 Coding, agentische Orchestrierung und alltägliche Anwendungsentwicklung mit einer kompakten Engine mit 10 billion activated parameters. Der Listenpreis beträgt $0.3 pro Million input tokens und $1.2 pro Million output tokens; gecachte Eingaben kosten $0.03 pro Million und senken so die Kosten für wiederverwendeten Kontext. Damit ist es eine praktische Standardwahl für volumenstarke Pipelines mit Kontextwiederverwendung. |
| MiniMax Music 2.6 API (Text to Music) | Beschreiben Sie einen Stil und liefern Sie strukturierte Lyrics mit Tags wie [Verse] und [Chorus]; MiniMax Music 2.6 gibt daraufhin mit einer einzigen Generierungsanfrage einen vollständigen Gesangs- oder Instrumentaltrack zurück. Zu den Ausgabeformaten gehören MP3, WAV und PCM mit sample rates bis zu 44.1 kHz und bitrates bis zu 256 kbps; akzeptiert werden Prompts mit bis zu 2,000 Zeichen und Lyrics mit bis zu 3,500 Zeichen. Mit $0.15 pro Generierung eignet es sich für Soundtrack-Prototyping, Jingles und Hintergrundmusik für Apps und Videos. |
Neue Funktionen von MiniMax + Showcase
Die Kombination fortschrittlicher Modelle mit der GPU-beschleunigten Plattform von Atlas Cloud bietet unübertroffene Geschwindigkeit, Skalierbarkeit und kreative Kontrolle für die Bild- und Videogenerierung.
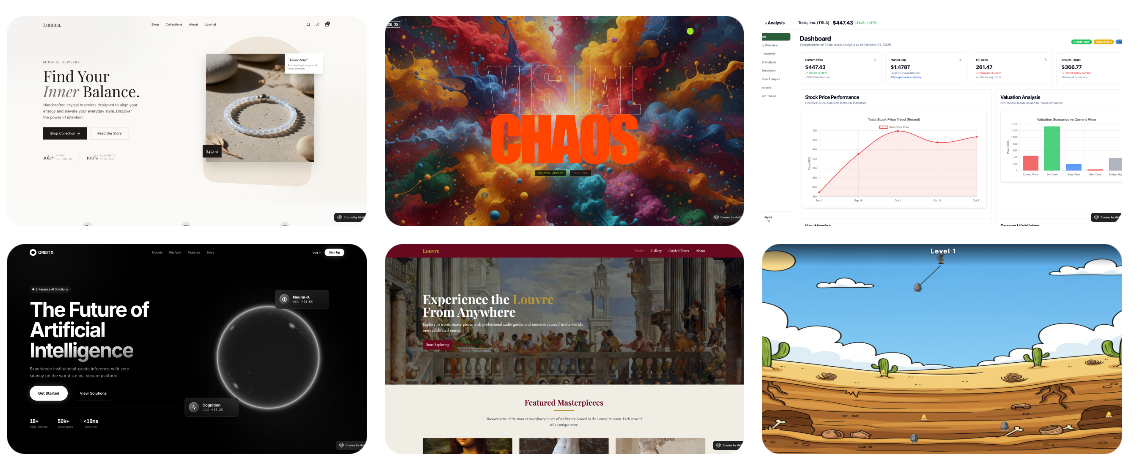
Fortgeschrittenes Coding und Agentenplanung mit MiniMax M2.5
MiniMax M2.5 unterstützt über 10 Programmiersprachen, darunter Rust, Go und Python, und erleichtert so umfassende Full-Stack-Entwicklung für Web-, Mobile- und Desktop-Plattformen. Durch die Integration fundierten Branchenwissens für professionelle Dokumentformatierung und Finanzmodellierung ermöglicht es nahtlose Übergänge vom Entwurf der Systemarchitektur bis zum Testen der finalen Deliverables. Es ist die maßgebliche Lösung für komplexe Softwareentwicklung und anspruchsvolle Office-Produktivitätsworkflows mit hohen Anforderungen.
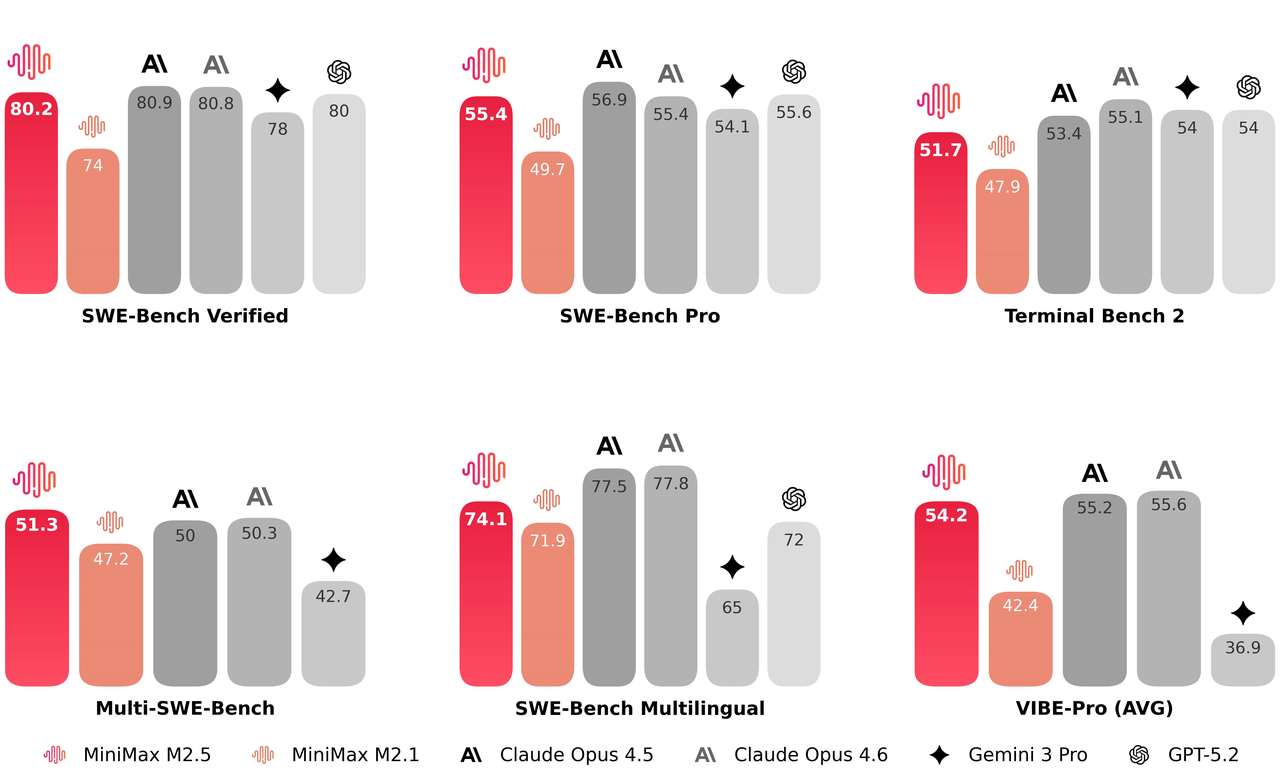
Schnelle Reaktionen und effiziente Aufgabenentscheidungen mit MiniMax M2.5
Die M2.5-Architektur erreicht eine um 37 % höhere Geschwindigkeit bei der End-to-End-Ausführung und reduziert die Dauer komplexer Aufgaben auf dem SWE-bench deutlich von 31,3 auf 22,8 Minuten. Durch die Optimierung der Logik zur Aufgabenzerlegung benötigt das Modell 20 % weniger Tokens und Suchrunden, um Ziele in Benchmarks wie BrowseComp zu erreichen. Es bietet eine schlanke Lösung für schnelle Entscheidungsfindung und eliminiert zugleich redundanten Rechenaufwand.
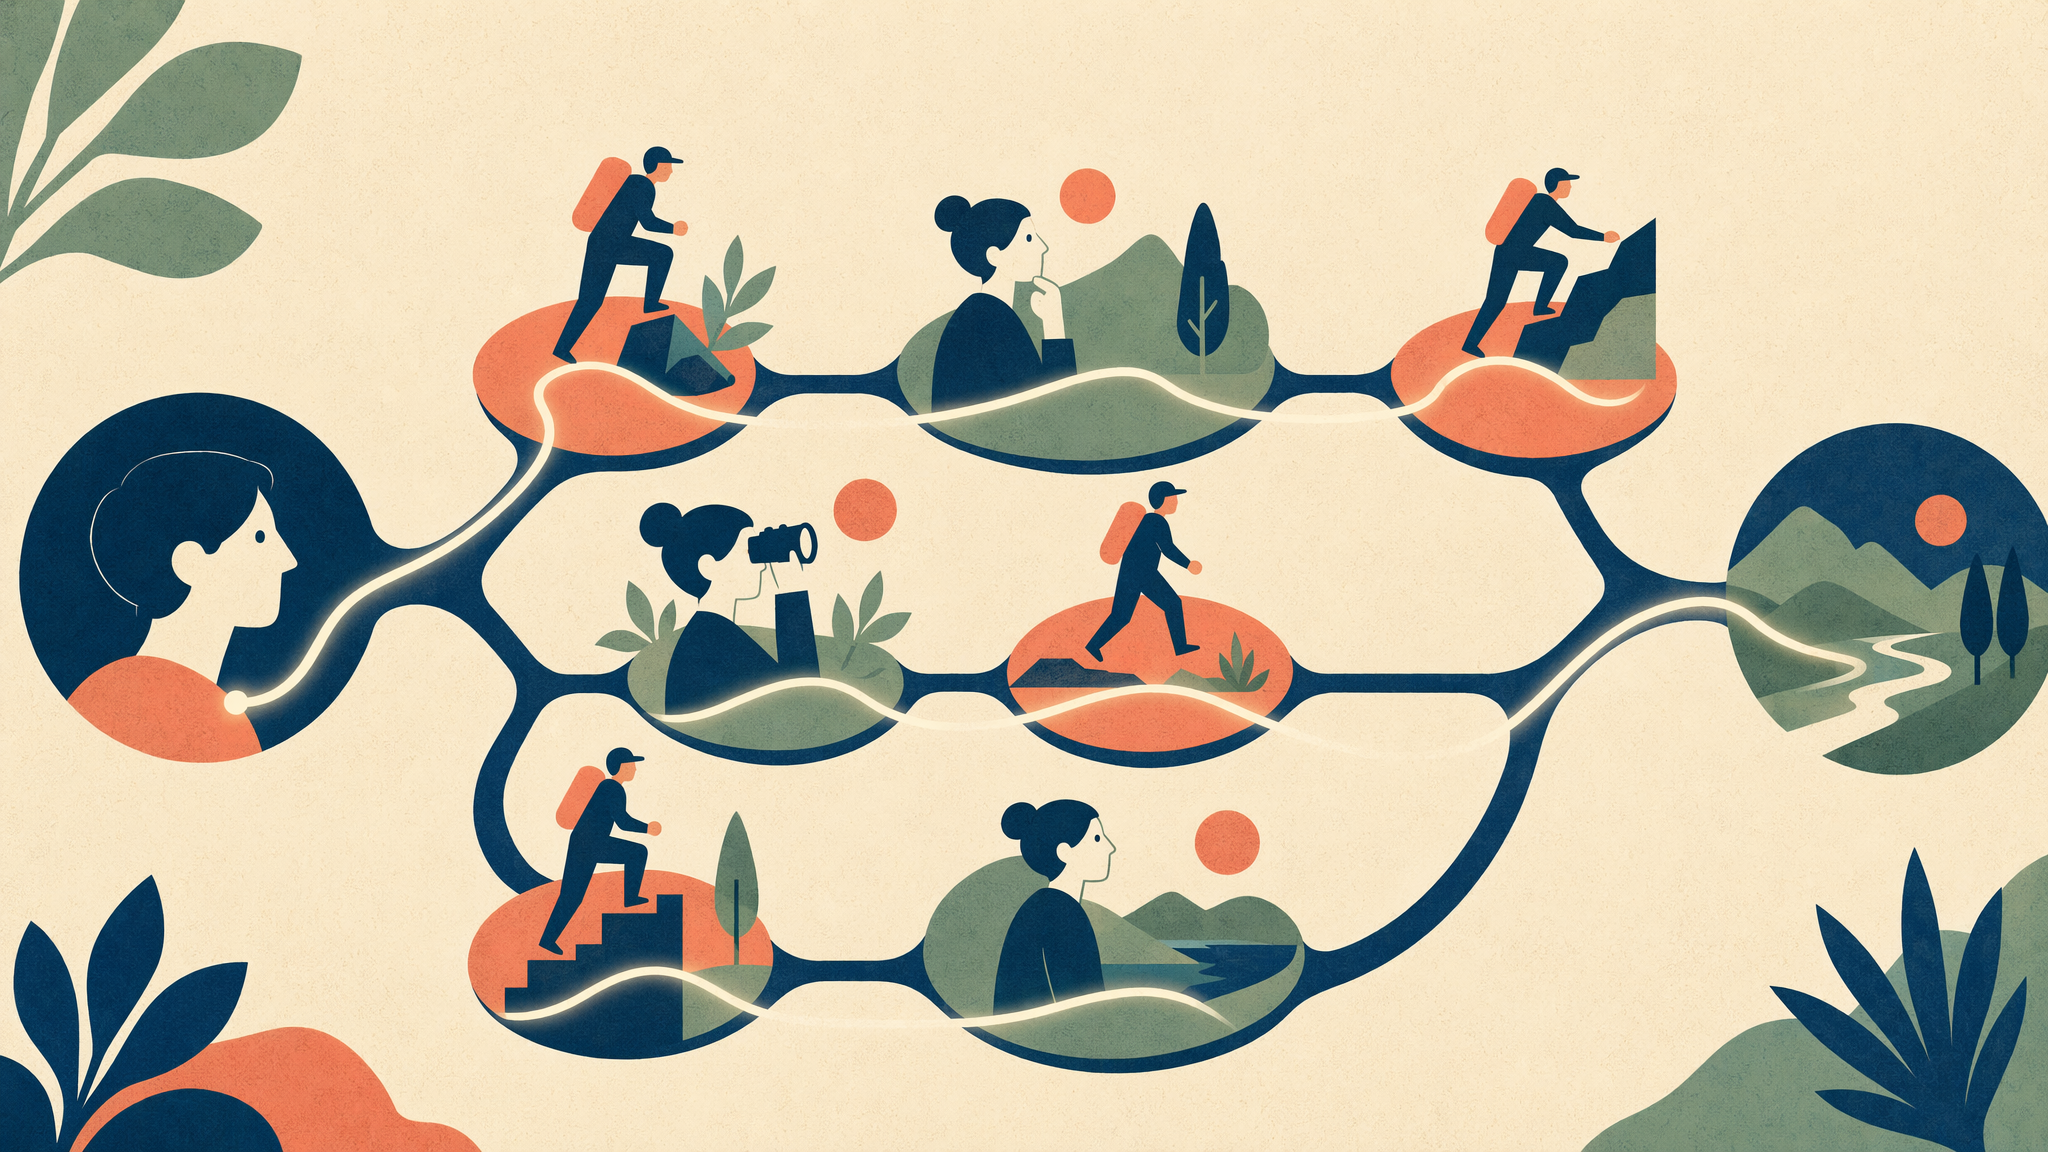
Verzahntes Denken, das seine Schlussfolgerungen bewahrt
Reasoning Tokens bleiben zwischen Turns erhalten, sodass das Modell jeden Schritt einer mehrstufigen Agentenkonversation mit dem zuvor aufgebauten Denkprozess fortsetzt. Dieses verzahnte Denken lässt es planen, handeln, beobachten und verfeinern, ohne die Logik zu verwerfen, die dorthin geführt hat. Das Ergebnis ist stabilere Entscheidungsfindung über lange Zeithorizonte hinweg – ein entscheidender Vorteil, wenn eine einzelne Aufgabe viele aufeinanderfolgende Tool Calls umfasst.
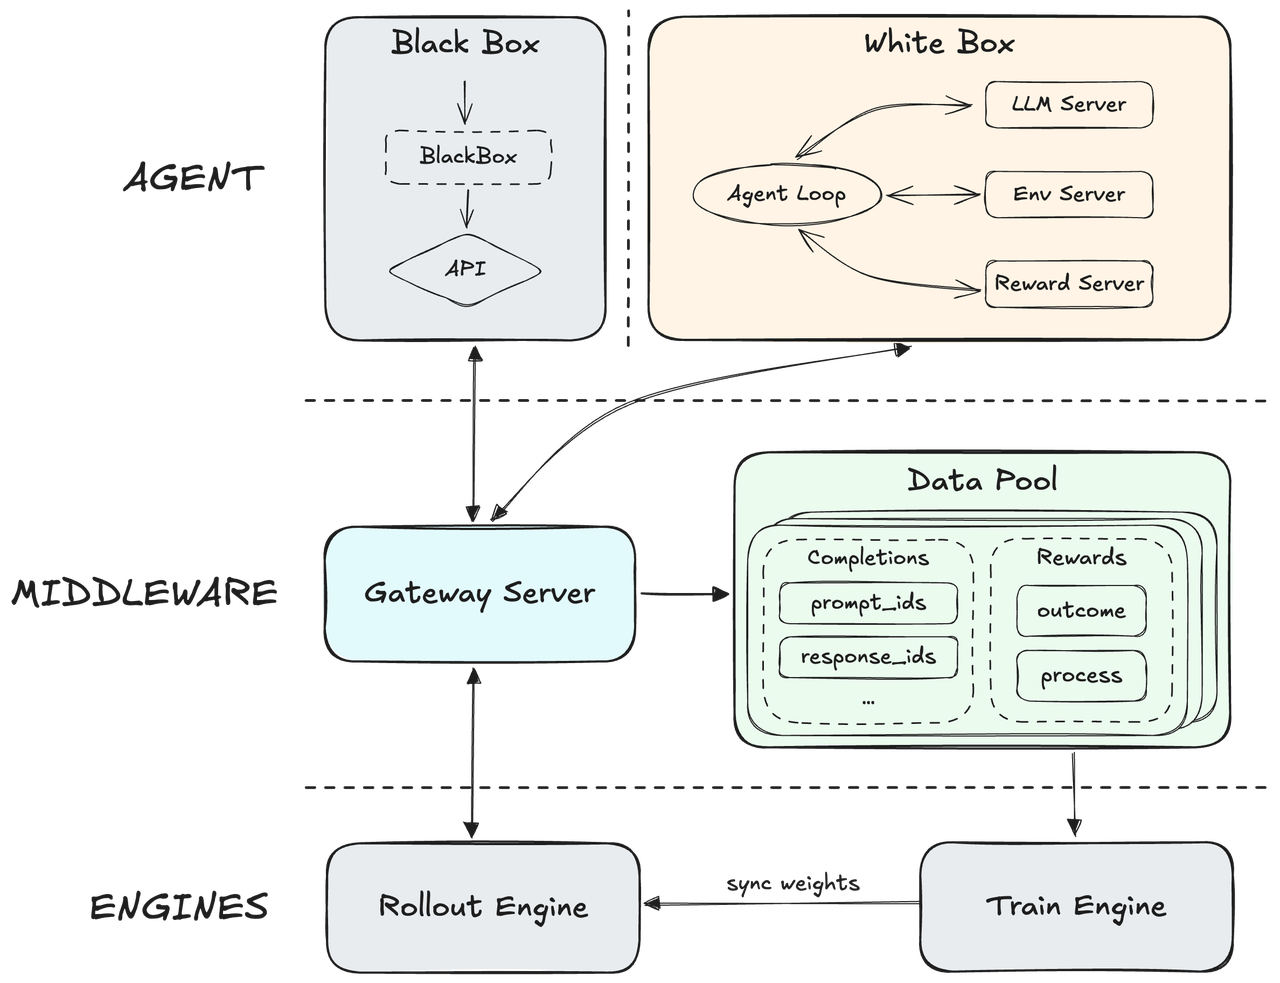
Evolutionäre Architektur durch Large-Scale RL mit MiniMax M2.5
Auf Basis eines nativen Agent RL Frameworks entkoppelt MiniMax seine Kern-Engine vom Agenten-Scaffolding, um über Hunderttausende vielfältige reale Umgebungen hinweg zu generalisieren. Es integriert einen ausgefeilten Process Reward Mechanism, der Echtzeit-Feedback aus der Ausführung nutzt, um Reasoning-Pfade zu verfeinern und erstklassige Ausgabequalität sicherzustellen. So entsteht ein hochgradig adaptives System, das überlegene Genauigkeit beibehält und gleichzeitig die gesamte operative Reaktionsgeschwindigkeit maximiert.
Ein 196K-Token-Kontextfenster in der MiniMax API
Jede Anfrage an MiniMax M2.1 verfügt über ein Kontextfenster mit 196.608 Tokens – groß genug, um weitläufige Monorepos, Hunderte Seiten Spezifikationen oder lange Agenten-Transkripte in einem einzigen Durchlauf aufzunehmen. Da das Gesamtbild im Kontext bleibt, verfolgt das Modell Abhängigkeiten über Dateien hinweg, statt mitten in der Aufgabe den Faden zu verlieren. Teams, die an großen Codebasen und dichten Forschungskorpora arbeiten, erhalten eine Kohärenz, mit der Modelle mit kurzem Kontext nicht mithalten können.
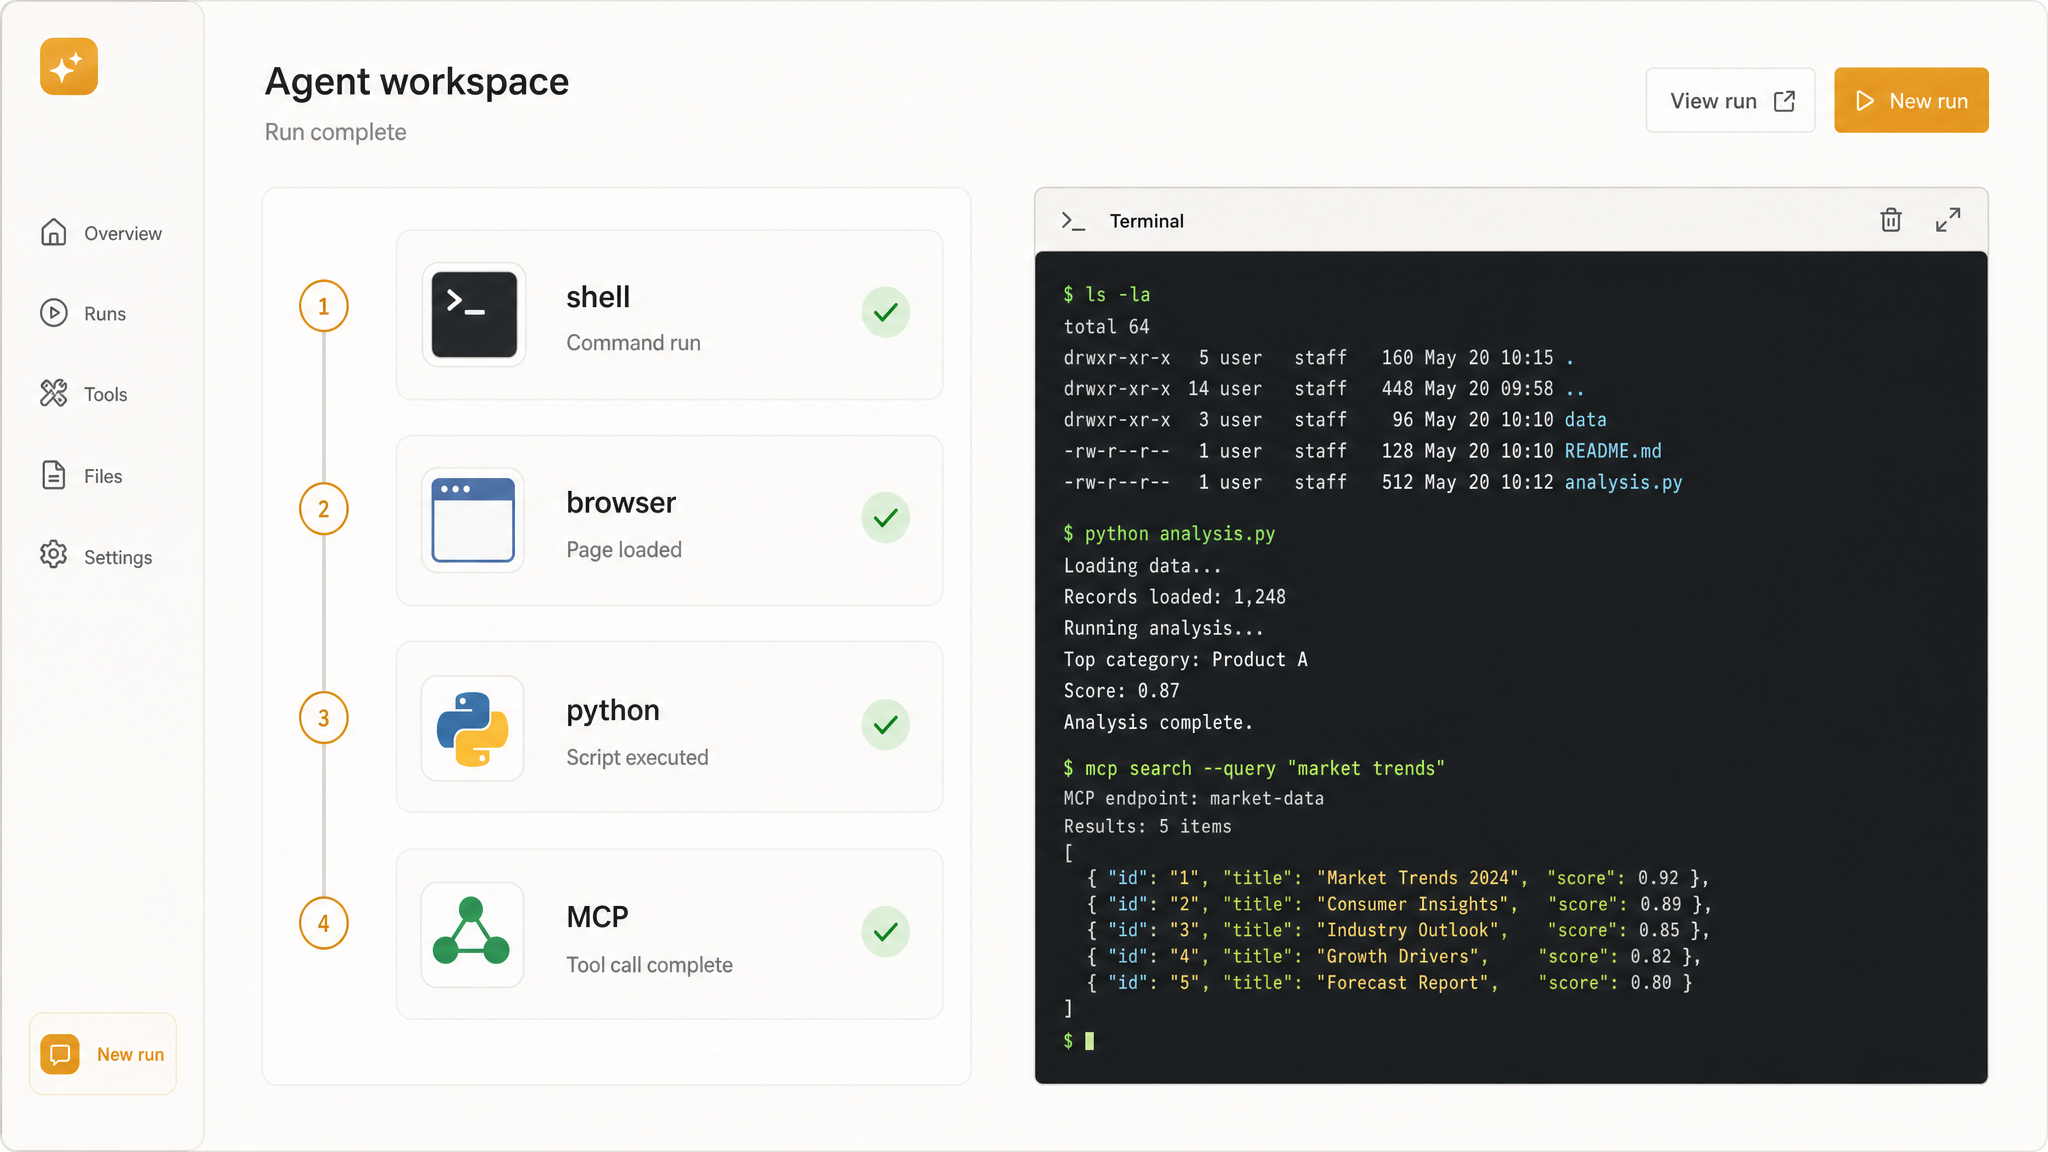
Shell, Browser und Code mit der MiniMax API orchestrieren
Function Calling macht MiniMax M2.1 zu einem aktiven Agenten, der Shell-Befehle, Browser-Sitzungen, Python-Ausführung und MCP Tools über langfristige Pläne hinweg orchestriert. Es verkettet Dutzende Schritte, liest Ausführungsfeedback und korrigiert sich selbst, statt beim ersten Ergebnis anzuhalten. Mit 47,9 Prozent auf Terminal-bench 2.0 bildet es eine verlässliche Grundlage für autonome Build-, Test- und Deployment-Schleifen.
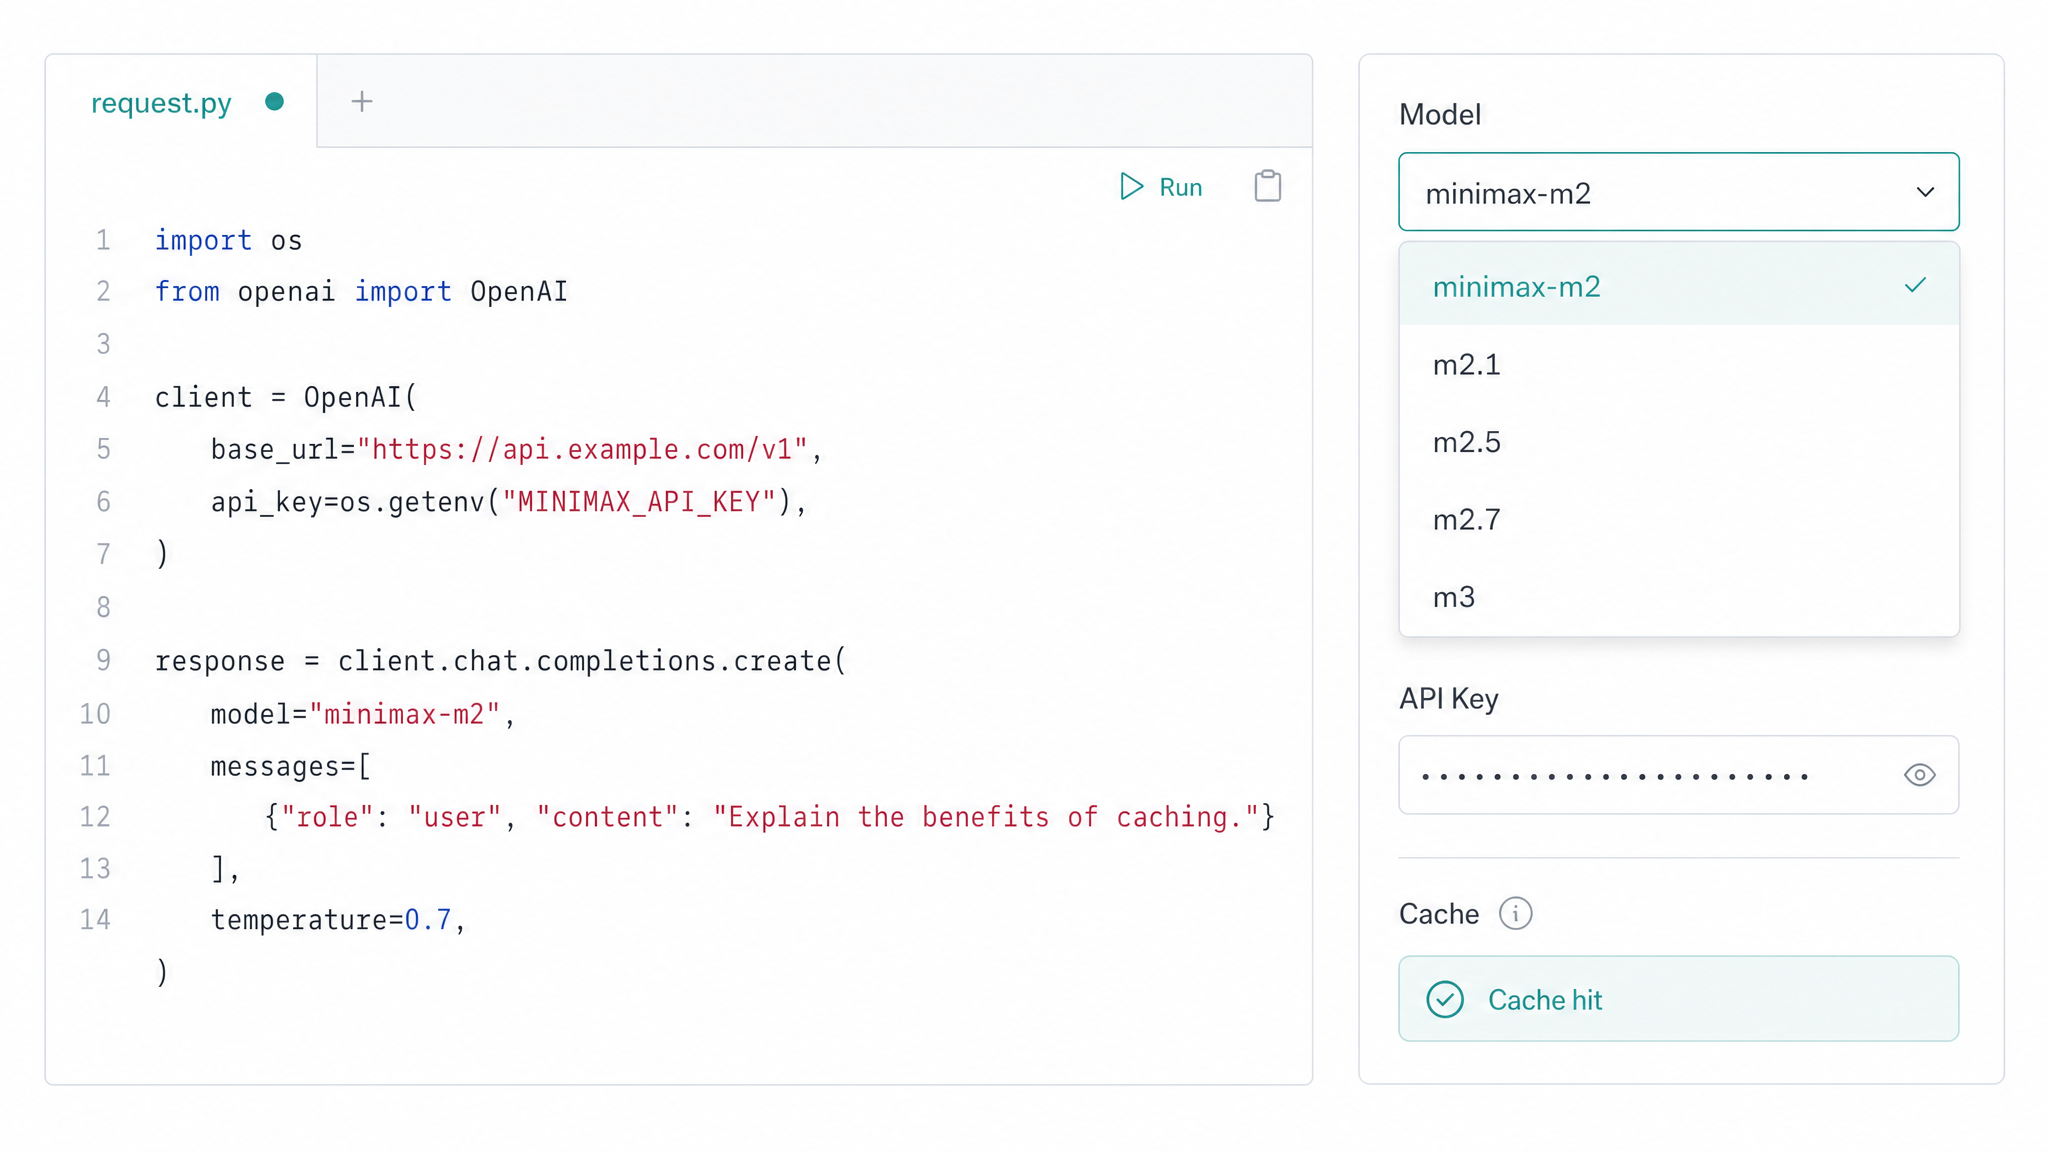
Ein MiniMax API Key für jede Model Tier
Ein OpenAI-kompatibler Key schaltet die gesamte MiniMax-Modellpalette frei, von M2 und M2.1 über M2.5, M2.7 und M3, ergänzt durch Anthropic SDK und direkten HTTP-Zugriff. Tiers wechseln Sie durch das Bearbeiten eines einzigen Model Strings – ohne Ihre Stack-Verkabelung anzupassen. Prompt Caching berechnet wiederholten Kontext mit 0,03 $ pro Million Tokens, sodass iterative Agentenschleifen und lange System Prompts auch im großen Maßstab bezahlbar bleiben.
Ein Prompt, drei Modelle: Das Coding-Duell der MiniMax API
Gib der MiniMax API und zwei Konkurrenzmodellen denselben Build-Prompt und sieh zu, wie jedes aus einer einzigen Anweisung eine funktionierende, einseitige Webseite macht.
Eine makellose, einseitige, eigenständige HTML-Seite (nur Inline-CSS und JavaScript — absolut keine externen Bibliotheken, CDNs, Fonts oder Bild-URLs; jede Textur ausschließlich aus CSS-Verläufen, box-shadows und inset shadows aufgebaut), die eine interaktive, skeuomorphe BUCHDRUCK-SETZWERKBANK rendert: Fülle den Viewport mit einer warmen Arbeitsfläche aus Walnussholz (geschichtete braune Verläufe + subtile Maserung über repeating linear-gradients und rauschähnliche Schatten-Sprenkel), beleuchtet von einer einzelnen warmen Wolframlampe oben links, sodass gebürstete Metallteile ein weiches Glanzlicht einfangen und jedes erhabene Objekt einen langen, weichen Schatten nach unten rechts wirft. Linke Seite: ein unterteiltes Schriftkasten-System (California Job Case) mit Rasterfächern, die winzige geprägte Bleisatz-Sorten enthalten (Buchstaben, Zahlen, Satzzeichen); jede Sorte ist ein abgeschrägter Metallsteg mit einem erhabenen, spiegelverkehrten Glyphen auf der Vorderseite. Mitte: ein offener Winkelhaken / eine offene Setzschiff-Ablage, in der sich gesetzte Lettern sammeln. Stelle einen vollständig funktionierenden Setzablauf bereit: (1) Der Nutzer tippt auf der physischen Tastatur ODER klickt Glyphen im Schriftkasten an, und für jedes Zeichen fliegt eine Bleisorte animiert aus ihrem Fach und fällt mit einer knackigen „Klack“-Mikro-Bounce-Absetzanimation in den Winkelhaken; (2) ziehbare dünne Bleistege zwischen den Sorten ermöglichen es dem Nutzer, Buchstabenabstand/Kerning per Drag anzupassen, mit live neu fließendem Layout; (3) eine drehbare Farbwalze (Brayer), die der Nutzer über die ausgeschlossene Form zieht und dabei einen glänzenden tiefindigoblauen Farbschimmer (animierte wandernde Spiegelreflexion) auf den erhabenen Schriftflächen hinterlässt; (4) ein herunterziehbarer Andruckhebel, den der Nutzer drückt (Click-and-hold oder Button), senkt ein Blatt cremefarbenes Büttenpapier über die eingefärbte Form und stempelt es — der Höhepunkt ist, wie der Hebel zurückfedert, während die frisch gedruckte Zeile auf dem Papier erscheint, mit wirklich eingedrückter Buchdruck-Typografie: Jeder Buchstabe ist ins Papier gepresst, mit einem inset shadow als physischer Vertiefung, die Farbe blutet/franst leicht in die sichtbare Papierfaser-Struktur aus, und ein zarter Plattenabdruck-Hof liegt um den Block. Palette: gebranntes Umbra, gebürstetes Messinggold und warmes Creme-/Reispapier-Off-White dominieren, mit tiefem Indigo als EINZIGEM kühlen Akzent. Integriere haptische Details: Messing-Rändelschrauben, einen Quoin-Schließkeil, holzfarbene Buttons mit realistischen gedrückten/aktiven Zuständen und befriedigendes Easing bei jedem Übergang (federartige cubic-bezier). Mach es responsiv (skaliert sauber bis auf Tablet-Breite herunter), halte den gesamten State in Vanilla JS, und lass den Nutzer eine kurze Gedichtzeile setzen, einfärben und einen Druck ziehen, den er visuell bewundern kann — alles muss handgefertigt, schwer und zeremoniell wirken, wobei die Physik von Fall, Drag und Abdruck durch Bewegung und Schatten vermittelt wird, nicht durch externe Assets.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Erstelle eine einzelne, vollständige, eigenständige HTML-Datei, die direkt in jedem modernen Browser ohne externe Abhängigkeiten geöffnet werden kann — sämtliches CSS und JavaScript muss inline enthalten sein, und externe Bibliotheken, CDNs, Fonts oder Bild-URLs sind nicht erlaubt (zeichne alles mit Canvas 2D oder per Code erzeugtem SVG). Baue eine interaktive „Brass Gear Train Workbench“: einen zusammensteckbaren mechanischen Zahnrad-Simulator auf einer staubigen technischen Blaupausen-Tischfläche, auf der der Nutzer einen funktionierenden Zahnradtrieb zusammensetzt und beobachten kann, wie sich physikalisch korrekte Rotation durch die Kette fortpflanzt. Zentrale Interaktions- und Simulationsanforderungen: - Rendere die Hauptbühne als Blaupausen-Zeichenfläche: ein feines cyanfarbenes Raster auf tiefem Engineering-Blue-Papier mit einem zarten Staubfilm und Vignette, dazu Bemaßungsmarken und technische Skizzenannotationen entlang der Ränder. - Stelle links einen Teilebehälter/eine Sidebar bereit, die Zahnräder in mehreren klar unterscheidbaren Größen enthält (unterschiedliche Zahnzahlen / Module, z. B. 12, 18, 24, 36, 48 Zähne). Der Nutzer zieht ein Zahnrad aus dem Behälter auf die Bühne; beim Loslassen rastet es am Raster ein. - Jedes Zahnrad muss als echtes, evolventenartiges Zahnrad in Messingtönen gezeichnet werden — warmer Goldkörper, gealterter Kupfer-Patina-Rand, elfenbeinfarbener Lichtakzent, sichtbare Nabe, Speichen und Mittelbohrung — mit subtiler Fasen-Schattierung, damit das Metall auch wie Metall wirkt. - Implementiere echte Eingriffserkennung: Wenn zwei platzierte Zahnräder in einem Achsabstand liegen, der innerhalb einer Toleranz der Summe ihrer Teilkreisradien entspricht (Modul × Zähne / 2), greifen sie automatisch ineinander und werden zu einer angetriebenen Kette gekoppelt; zeichne an der Stelle, an der die Zähne ineinandergreifen, einen Eingriffsindikator. Ketten können sich über mehrere Zahnräder verzweigen. - Platziere unten links ein Kurbel-Handrad als visuellen und mechanischen Ursprung. Der Nutzer dreht die Kurbel (per Drag zum Rotieren oder durch Halten eines Buttons); anschließend rotiert die gesamte im Eingriff befindliche Kette der Reihe nach. Berechne die Winkelgeschwindigkeit und Richtung jedes nachgelagerten Zahnrads strikt aus dem Übersetzungsverhältnis (ω_out = ω_in × N_in / N_out, Richtung wechselt bei jedem Eingriff), und animiere die Zähne so, dass sie am Kontaktpunkt perfekt phasenverriegelt bleiben, sodass keine Zähne sichtbar überlappen oder durcheinanderlaufen. - Das letzte Zahnrad der Kette treibt einen Zeiger über eine nummerierte Messuhr; der Zeiger muss einen echten Messwert anzeigen, der aus dem kumulierten Übersetzungsverhältnis abgeleitet ist (zeige die berechnete Ausgangsdrehzahl in RPM und die Gesamtübersetzung als Live-Text an). - Wenn der Nutzer versucht, Zahnräder zu platzieren, deren Zahngeometrie nicht ineinandergreifen kann (inkompatibler Abstand/inkompatibles Modul), muss diese Verbindung blockieren: Lass sie rot aufblitzen, stoppe die Fortpflanzung hinter dem fehlerhaften Gelenk und zeige eine kleine Warnung „tooth mismatch“ an. - Füge einen Lichtstrahl hinzu: ein Schaft warmen Morgenlichts, der von einem oberen Fenster schräg über die Bühne fällt, mit im Lichtstrahl treibenden Staubpartikeln und warmen Glanzreflexen, die über die Zahnradzähne gleiten, während sie sich drehen, sodass die Maschine wirkt, als würde sie erwachen. Visueller Feinschliff und UX-Politur: - Art Direction: retro-technische, handgezeichnete Linienführung verschmolzen mit fotorealistischem Metall — feines Blaupausenraster unter Messing, gealterter Bronze, grünblauer Patina und Elfenbeinweiß; warmes Seitenlicht mit langen, weichen Schlagschatten, um Volumen und Tiefe herauszuarbeiten. - Die Komposition soll die Kurbel klar als Einstiegspunkt lesbar machen, während die Antriebskette diagonal durch den Frame verläuft. - Integriere ein aufgeräumtes HUD mit Kurbelgeschwindigkeit, Gesamtübersetzung, Ausgangs-RPM und Zahnradanzahl sowie kleine Controls zum Umkehren der Kurbel, Leeren der Bühne und Anpassen der Kurbelgeschwindigkeit per Slider. - Alles muss flüssig laufen (requestAnimationFrame), responsiv auf die Fenstergröße reagieren und interaktiv weiterlaufen — Dragging, Einrasten, Eingreifen und Messwert-Updates sollen alle in Echtzeit reagieren. Es soll sich haptisch, präzise und lebendig anfühlen.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Entwickeln Sie produktionsreife Software mit der MiniMax API
Von mehrsprachigen Full-Stack-Builds bis hin zu autonomen Büro-Agenten verwandelt die MiniMax API die Programmiertiefe und die langfristige Werkzeugnutzung von M2.1 in Workflows, die Ihr Team jeden Tag ausliefert.

Full-Stack-Entwicklung über mehrere Sprachen hinweg
MiniMax M2.1 schreibt und überprüft Produktionscode in Rust, Go, TypeScript, C++ und mehr, von Low-Level-Systemen bis zu Anwendungsschichten. Teams, die polyglotte Services entwickeln, verlassen sich darauf, jede Ebene konsistent zu halten.

Native Mobile Apps über die MiniMax API
Wenn Android- und iOS-Features gemeinsam ausgeliefert werden müssen, generiert die MiniMax API Kotlin, Swift und Objective-C gemäß den jeweiligen Plattformkonventionen. So können kleine Teams beide Stores betreuen, ohne den Engineering-Aufwand aufzuteilen.

Autonome Coding Agents auf der MiniMax API
Binden Sie M2.1 per Function Calling in Ihre Agent-Schleife ein, um mehrstufige Aufgaben zu planen, Tools auszuführen und sich über lange Zeithorizonte hinweg selbst zu korrigieren. Entwickler nutzen dies, um Assistenten zu bauen, die echte Tickets abschließen, nicht nur Snippets.

Digitale Mitarbeitende für Office-Workflows
Als digitaler Mitarbeiter führt M2.1 End-to-End-Aufgaben in Administration, Finanzen, Data Science und HR auf Basis einfacher Textbefehle aus. Operations-Teams setzen es ein, um repetitive Backoffice-Arbeit in großem Umfang abzuarbeiten.

Reasoning über die gesamte Codebase mit 196K Context
Müssen Sie ein unbekanntes Repository umfassend refaktorieren? Mit einem Context Window von 196.61K Token liest M2.1 Hunderte Dateien auf einmal, verfolgt Abhängigkeiten und zeigt die Änderungen auf, die eine Migration tatsächlich erfordert.

Interaktive Web-Interfaces mit der MiniMax API
Dank starkem Designverständnis kann die MiniMax API ausgefeilte Web-Frontends, komplexe Interaktionen und sogar 3D-Simulationen wissenschaftlicher Szenen erstellen. Produktteams liefern datenreiche Dashboards und Visualisierungen direkt aus einem Prompt aus.
Wie die MiniMax API im Vergleich zu anderen Coding- und Agent-LLMs abschneidet
Vergleichen Sie die MiniMax API mit konkurrierenden Agenten- und Programmiermodellen auf Atlas Cloud, unter direkter Gegenüberstellung von Kontextfenster, Ausgabe-Obergrenze und nutzungsbasierten Token-Preisen.
| Model | Context Window | Max Output | Input Price ($/1M) | Output Price ($/1M) |
|---|---|---|---|---|
| MiniMax M3 | 524K tokens | 512K tokens | $0.60 / $1.20 (>512K) | $2.40 / $4.80 (>512K) |
| MiniMax M2.7 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| MiniMax M2.5 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| Kimi K2.7 Code | 262K tokens | 262K tokens | $0.95 | $4.00 |
| GLM 4.7 | 203K tokens | 203K tokens | $0.60 | $2.20 |
| DeepSeek V4 Flash | 1M tokens | 393K tokens | $0.14 | $0.28 |
So verwenden Sie MiniMax auf Atlas Cloud
In wenigen Minuten startklar — folgen Sie diesen einfachen Schritten, um Modelle über die Plattform von Atlas Cloud zu integrieren und bereitzustellen.
Atlas Cloud-Konto erstellen
Registrieren Sie sich auf atlascloud.ai und schließen Sie die Verifizierung ab. Neue Nutzer erhalten kostenlose Credits zum Erkunden der Plattform und Testen von Modellen.
Warum MiniMax auf Atlas Cloud Verwenden
Die Kombination der fortschrittlichen MiniMax-Modelle mit der GPU-beschleunigten Plattform von Atlas Cloud bietet unübertroffene Leistung, Skalierbarkeit und Entwicklererfahrung.
Leistung & Flexibilität
Niedrige Latenz:
GPU-optimierte Inferenz für Echtzeit-Reasoning.
Einheitliche API:
Führen Sie MiniMax, GPT, Gemini und DeepSeek mit einer Integration aus.
Transparente Preisgestaltung:
Vorhersehbare Token-basierte Abrechnung mit serverlosen Optionen.
Unternehmen & Skalierung
Entwicklererfahrung:
SDKs, Analysen, Fine-Tuning-Tools und Vorlagen.
Zuverlässigkeit:
99,99% Verfügbarkeit, RBAC und compliance-bereite Protokollierung.
Sicherheit & Compliance:
SOC 2 Type II, HIPAA-Ausrichtung, Datensouveränität in den USA.
Fragen zur MiniMax API, beantwortet
Die MiniMax API bietet Entwicklern programmgesteuerten Zugriff auf die von MiniMax AI entwickelte MiniMax-Familie großer Sprachmodelle – eine Reihe, die auf Coding, agentische Tool-Nutzung und langfristiges Reasoning ausgelegt ist. Auf Atlas Cloud erreichen Sie diese Modelle über einen OpenAI-kompatiblen Endpoint mit transparenter Pay-as-you-go-Preisgestaltung und Day-0-Zugriff auf neue Releases.
Atlas Cloud hostet die M-series text models, darunter MiniMax M2.5, MiniMax M2.7 und das Flaggschiff MiniMax M3, sowie MiniMax Music 2.6 für text-to-music generation. Alle Modelle nutzen dieselbe Authentifizierung und denselben Endpoint. Der Wechsel zwischen ihnen erfordert daher nur das Ändern einer einzigen model identifier in Ihrer Anfrage.
Diese Modelle sind für End-to-End-Softwareentwicklung optimiert: Sie beherrschen Multi-File-Editing, Compile-run-fix-Loops und testvalidierte Fehlerbehebung in vielen Programmiersprachen. Außerdem überzeugen sie in agentischen Szenarien, die function calling, mehrstufige Planung und die Wiederherstellung nach Ausführungsfehlern erfordern. Dadurch eignen sie sich besonders gut für autonome Coding Agents und toolgestützte Workflows.
Da die MiniMax API OpenAI-kompatibel ist, können Sie das standardmäßige OpenAI SDK auf die Atlas Cloud base URL ausrichten, Ihren Key übergeben und das model-Feld auf die gewünschte Version setzen. Streaming, function calling und JSON-strukturierte Ausgabe laufen alle über dieselbe Schnittstelle, sodass die meisten bestehenden Integrationen für den Einstieg lediglich eine Änderung von base URL und Key benötigen.
Die Kontextfenster variieren je nach Version. MiniMax M2 verarbeitet ungefähr 200K tokens – genug, um eine große Codebase oder umfangreiche Dokumentation in einer einzigen Anfrage zu laden –, während das neuere M3 dies auf etwa 1 million tokens erweitert. Wählen Sie das Modell mit größerem Kontextfenster, wenn Ihre Aufgabe viele Dateien oder umfangreiches Referenzmaterial umfasst.
Die Abrechnung erfolgt pay-as-you-go und tokenbasiert, ohne erforderliches Abonnement. Die M2-series text models beginnen bei $0.30 pro Million input tokens und $1.20 pro Million output tokens, während das leistungsstärkere M3 mit $0.60 pro Million input und $2.40 pro Million output berechnet wird. Cached input wird zu einem niedrigeren Tarif abgerechnet.
Ja. MiniMax hat die M-series weights unter einer modifizierten MIT license als Open Source veröffentlicht, die für sehr große kommerzielle Deployments eine attribution requirement ergänzt. Sie können die weights zur Evaluation selbst hosten und anschließend zur Atlas Cloud API wechseln, wenn Sie verwaltete Infrastruktur, verlässliche Uptime und keine GPU-Wartung möchten.
MiniMax zielt darauf ab, Coding- und agentische Qualität auf Frontier-Niveau zu einem Bruchteil der Kosten größerer proprietärer Modelle zu liefern. Dafür nutzt es ein mixture-of-experts design, das pro Token nur etwa 10 billion seiner 230 billion parameters aktiviert. Wenn Ihre Workload Codegenerierung, Refactoring oder toolnutzende Agents mit knappem Budget umfasst, bietet es eine starke Balance aus Leistungsfähigkeit, Geschwindigkeit und Preis. Die Benchmark-Position ändert sich mit jedem Release. Validieren Sie daher die aktuelle Version gegen Ihre eigenen Aufgaben, bevor Sie sich festlegen.
Weitere Familien Erkunden
Seedance 2.5
Die Seedance 2.5 API ist jetzt auf Atlas Cloud verfügbar! Sie bietet Entwicklern das neueste Videomodell von ByteDance. Es generiert in einem einzigen Durchgang bis zu 30 Sekunden natives Video aus Text, einem einzigen Bild oder bis zu 50 multimodalen Referenzen, mit synchronisiertem Audio und mehrsprachigem Text im Bildrahmen. Auf Atlas Cloud greifen Sie über einen einzigen Schlüssel darauf zu, wobei Motivkonsistenz und verbesserte Physik lange Einstellungen kohärent halten.

Wan 3.0
Die Wan 3.0 API ist die nächste Generation von Alibabas Wan-Videofamilie, die entwickelt wurde, um Langformat-Generierung, Multi-Referenz-Steuerung und audiovisuelle Qualität auf ein neues Niveau zu heben. Atlas Cloud hostet bereits Wan 2.7, 2.6 und 2.5, und Wan 3.0 läuft mit demselben einheitlichen Schlüssel ohne separate Einrichtung. Beginnen Sie noch heute mit der Entwicklung. Scrollen Sie nach unten zum Showcase, um zu sehen, was Wan 3.0 erschaffen kann.
MiniMax H3
MiniMax H3 ist die multimodale Videofamilie von MiniMax für text-, bild- und referenzgesteuerte Erstellung. Über die unterstützten Routen hinweg bleiben Motive aus Referenzmedien erhalten, flexible Seitenverhältnisse stehen zur Verfügung, und H3 Developer kombiniert generierten Ton mit visuellen Inhalten, wobei die Ausgabeprofile je nach Endpoint ausgewählt werden. Atlas Cloud bündelt die Familie hinter einem OpenAI-kompatiblen Schlüssel mit transparenter nutzungsbasierter Abrechnung zum Standardtarif von $0.038 pro Sekunde. Beginnen Sie noch heute mit der Entwicklung.
Seedream 5.0 Pro
Die Seedream 5.0 Pro API bietet Entwicklern das steuerbare Bildbearbeitungsmodell von ByteDance auf Atlas Cloud. Sie platziert Bearbeitungen präzise mit Ankern und Koordinaten, trennt Bilder in bearbeitbare Ebenen, verschmilzt mehrere Referenzen und passt exakte Farben und Materialien an, mit mehrsprachigem Text in 2K und 3K. Auf Atlas Cloud erreichen Sie es über einen einzigen Schlüssel!
Seedance 2.0
Seedance 2.0 ist ByteDances Produktionsvideomodell für die präzise Erstellung von Einstellungen. Verwandle Prompts in Videos, animiere ein Erstbild mit optionaler Führung durch ein Letztbild oder gestalte Ergebnisse mit Referenzmedien und optionaler Websuche. Atlas Cloud vereint diese Workflows in einer einheitlichen API mit transparenter nutzungsbasierter Preisgestaltung und einem einzigen OpenAI-kompatiblen Schlüssel. Beginne noch heute mit der Entwicklung.
GPT Image 2.5
Die gpt-image-2.5-Familie von OpenAI bietet Entwicklern die Wahl zwischen Flare und Sunburst für produktive Bild-Workflows. Rendern Sie mit beliebigen Auflösungen bis zu 3840x2160 und wählen Sie aus fünf Qualitätsstufen, darunter xhigh und max, um spezifische Ausgabeanforderungen zu erfüllen. Atlas Cloud stellt eine sofort einsatzbereite REST-Inferenz ohne Kaltstarts und mit einer Standardpreisgestaltung ab $0.004 pro Generierung bereit. Beginnen Sie noch heute mit der Entwicklung.
GPT Image 2
Die GPT Image 2 API bietet Entwicklern Zugang zum neuesten Bildmodell von OpenAI, dem Nachfolger von GPT Image 1.5. Es generiert und bearbeitet Bilder mit präziser Textdarstellung über lateinische und CJK-Schriften hinweg sowie mit starker Komposition für Poster, Mockups und Infografiken. Auf Atlas Cloud erreichen Sie es über eine einzige vereinheitlichte API zusammen mit über 300 Modellen, mit kostenlosen Credits, 99,99 % Verfügbarkeit und ohne erforderliche OpenAI-Organisationsverifizierung.
Gemini Omni Flash
Die gemini omni API stellt Entwicklern die nativ multimodale Gemini Omni Flash-Familie von Google DeepMind bereit, einschließlich Gemini Omni 1.1 Flash. Erstellen Sie kinematografische Videos mit synchronisiertem nativem Audio, animieren Sie Standbilder mit präziser Kontrolle über Start- und Endbild oder überarbeiten Sie vorhandenes Filmmaterial durch textgesteuerte Bearbeitungen, bei denen unveränderte Inhalte erhalten bleiben. Atlas Cloud bietet einen einzigen OpenAI-kompatiblen Schlüssel, einheitlichen Zugriff und transparente nutzungsbasierte Preise. Beginnen Sie noch heute mit der Entwicklung.
Grok Imagine
Die Grok Imagine API umfasst xAIs Bild-, Video- und Sprachmodelle, von Image 2.0 bis Video 1.5 und xAI TTS v1. Generieren Sie 1K oder 2K Standbilder über 14 Seitenverhältnisse, erweitern Sie eine Szene auf 15 Sekunden 1080p-Motion, steuern Sie Aufnahmen mit bis zu 7 Referenzbildern, oder озвучить Sie diese in 20 Sprachen. Atlas Cloud führt alle Modi auf einem Endpunkt aus, mit Pay-as-you-go-Preisgestaltung ab $0.02 pro Bild und $0.05 pro Sekunde. Beginnen Sie heute mit der Entwicklung.
Die leistungsstärksten kreativen Modelle von Google sind alle auf Atlas Cloud verfügbar. Veo 3.1 liefert kinoreife Videogenerierung, Nano Banana 2 ermöglicht die Erstellung von High-Fidelity-Bildern und Gemini bringt multimodale Intelligenz in jeden Workflow. Greifen Sie über einen einzigen API key mit Day-0-Verfügbarkeit und Pay-as-you-go-Preisen auf die vollständige Google-Modellsuite zu.
Seedance 2.0 Mini
Seedance 2.0 Mini bringt die multimodale Videogenerierung von ByteDance in Workflows, bei denen Geschwindigkeit und Kosten am wichtigsten sind. Es bietet die Kernfunktionen von Seedance 2.0 bei geringerem Ressourcenverbrauch – schnellere Generierung, niedrigere Kosten pro Video und dieselbe API-Integration, die Sie bereits nutzen. Für Teams, die hochvolumige Pipelines betreiben oder Prototyping in großem Maßstab durchführen, ist Mini der praktische Standard.
ByteDance
Von der Generierung kinoreifer Videos bis zur Erstellung von High-Fidelity-Bildern sind die leistungsstärksten Modelle von ByteDance jetzt auf der Atlas Cloud verfügbar. Führen Sie Seedance und Seedream in großem Maßstab zu den niedrigsten Inferenzpreisen und ohne Infrastruktur-Overhead aus.
Empfohlene Artikel
Anleitungen, Tutorials und Produkt-Updates, mit denen Sie das Beste aus Atlas Cloud herausholen.





