Qwen Image 2.0 Native 2K
Qwen Image 2.0 es el modelo de imágenes de nueva generación del equipo de Qwen en Alibaba Cloud. Diseñado para entradas de texto e imágenes, ofrece salida nativa en 2K, mayor fidelidad semántica, detalles realistas y un seguimiento preciso de las instrucciones en flujos de trabajo de creación y revisión. Atlas Cloud proporciona endpoints REST listos para usar para ambos modos, sin arranques en frío y con un precio estándar de $0.035 por imagen. Empieza a crear hoy mismo.
Qwen Image 2.0 ha sido desarrollado por Alibaba. Atlas Cloud (operado por Atlas Cloud AI LLC) proporciona acceso al modelo, pero no es su propietario. Todas las marcas comerciales pertenecen a sus respectivos titulares.
Explorar Modelos Líderes
Atlas Cloud le proporciona los últimos modelos creativos líderes en la industria.


Modos de generación y edición de Qwen Image 2.0
Compara dos endpoints de Qwen Image 2.0 para crear y perfeccionar imágenes con resoluciones de hasta 2K.
| Modalidad | Descripción |
|---|---|
| Qwen Image 2.0 Text to Image API | Convierte prompts de texto en imágenes con resoluciones de hasta 2K, gracias a una comprensión mejorada de los prompts y a una mayor calidad de imagen. Usa este endpoint para arte conceptual, imágenes de productos, recursos de marketing y otros flujos de trabajo visuales basados en prompts. |
| Qwen Image 2.0 Edit API | Diseñado para la edición de imágenes, este endpoint aplica instrucciones escritas a recursos visuales existentes y genera resultados con resoluciones de hasta 2K. Es adecuado para perfeccionar recursos, crear variaciones creativas, realizar cambios visuales específicos y gestionar flujos de producción iterativos. |
Qwen Image 2.0: del prompt al acabado preciso
Qwen Image 2.0 combina una salida de hasta 2K, una comprensión más sólida de los prompts, renderizado de texto bilingüe, edición guiada por referencias, semillas reproducibles y acceso REST a Atlas Cloud con precios transparentes de pago por uso.
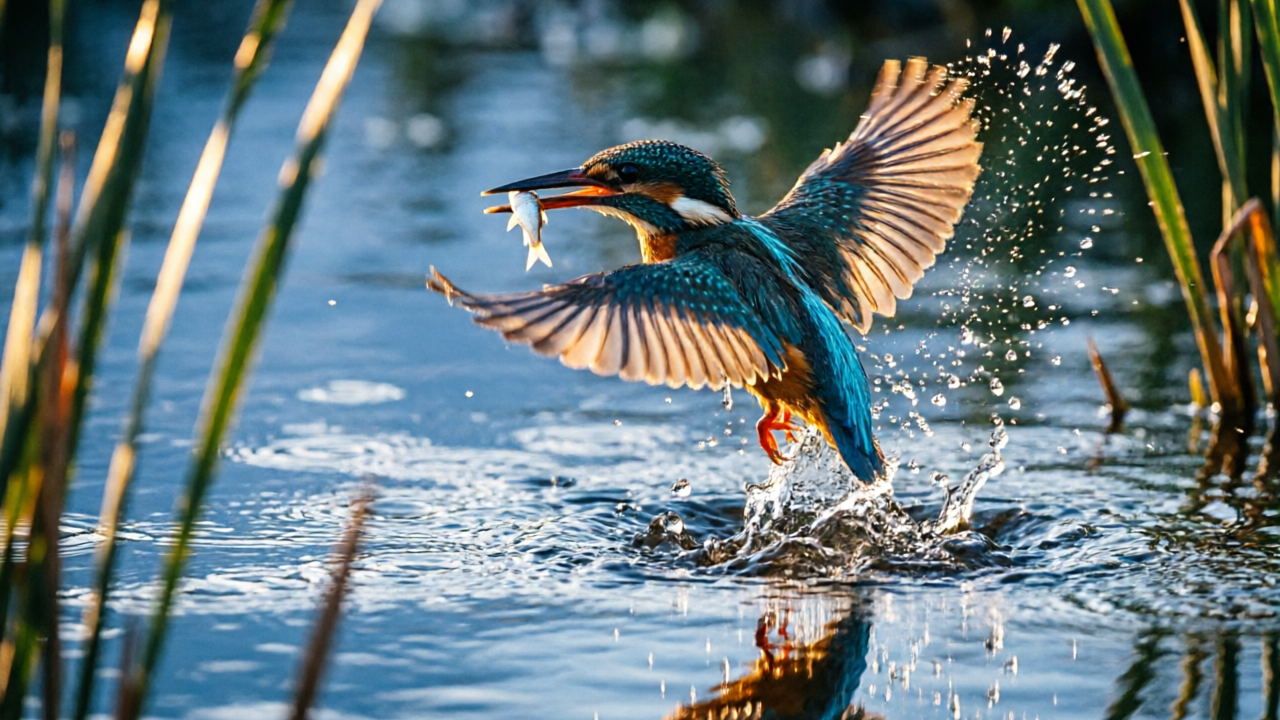
Detalle 2K de Qwen Image 2.0
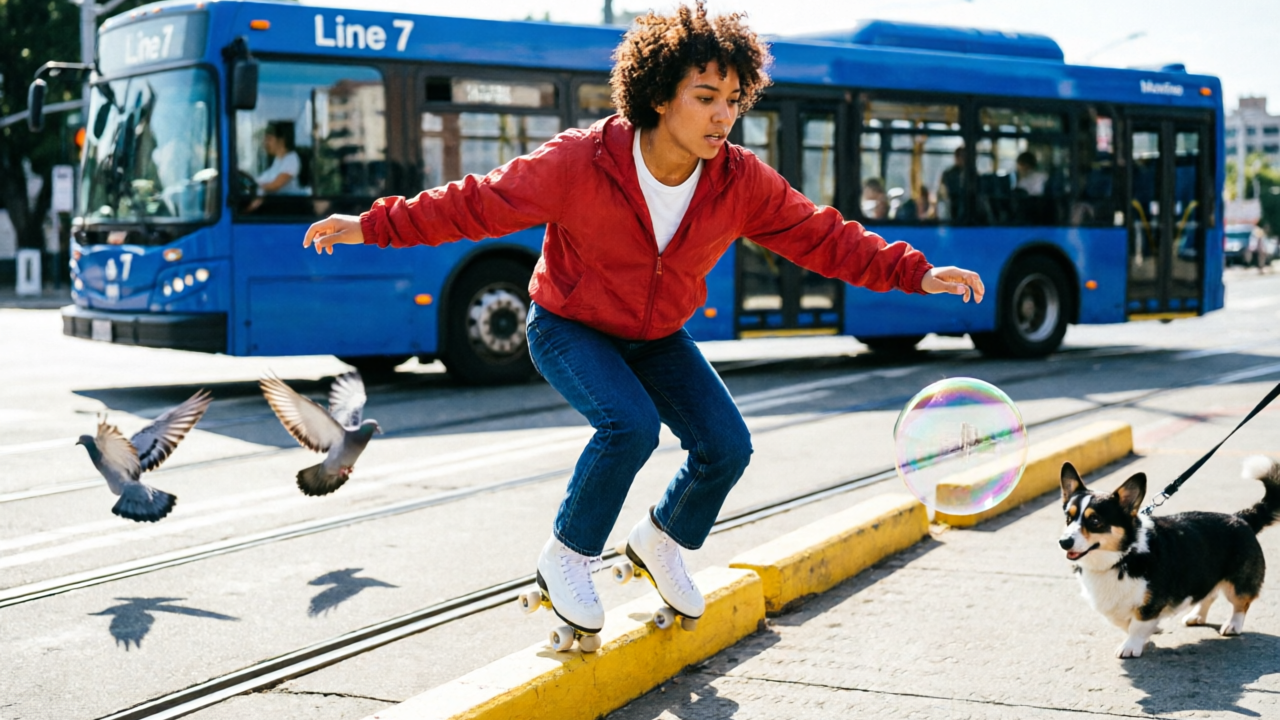
Qwen Image 2.0 genera imágenes con tamaños de 512 a 2048 píxeles por dimensión, con una salida de hasta 2K. Su calidad de imagen mejorada conserva superficies detalladas, escenarios con varias capas y pequeños acentos visuales en todo el encuadre. Elige las dimensiones que mejor se adapten a tu formato de entrega. Esto convierte al modelo en una opción ideal para imágenes de producto, fotografía editorial y arte conceptual detallado.
Control de prompts de Qwen Image 2.0
Los briefs estructurados siguen siendo manejables con prompts de hasta 800 caracteres en inglés o chino. Describe el sujeto, la iluminación, la composición, los materiales y la acción en una sola instrucción; después, usa una semilla fija cuando necesites iteraciones reproducibles. La comprensión mejorada de los prompts ayuda a preservar las relaciones entre varios elementos solicitados. Los conceptos complejos se vuelven más predecibles para campañas, escenas arquitectónicas y flujos de trabajo creativos dirigidos.
Tipografía bilingüe
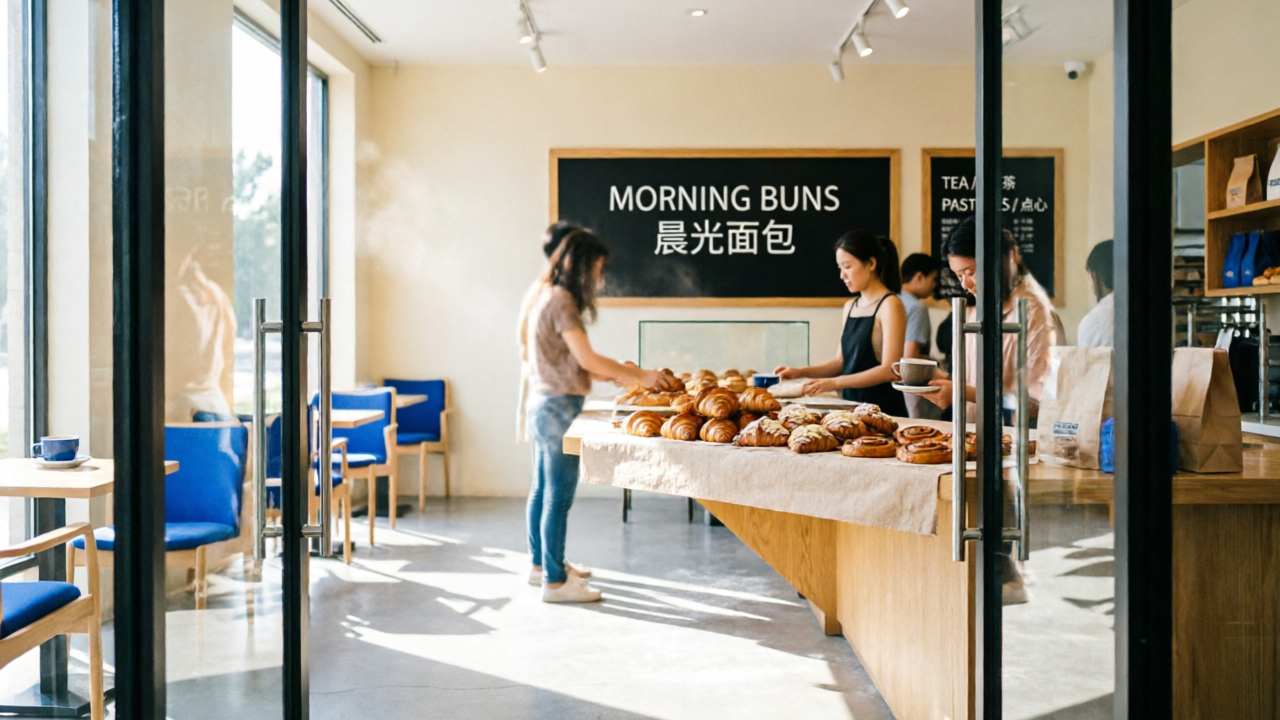
El texto legible en inglés y chino puede aparecer dentro de composiciones visuales densas y cuidadosamente elaboradas. El modelo combina el renderizado multilingüe con una composición fiable, lo que ayuda a que las etiquetas, los letreros, los titulares y los gráficos complementarios permanezcan alineados con la escena circundante. Las indicaciones bilingües pueden formar parte de la imagen en lugar de añadirse como una superposición independiente. Úsalo para gráficos promocionales amplios, recursos visuales para presentaciones, menús y obras con mucha información que, de otro modo, requerirían una limpieza manual considerable.
Edición guiada por referencias
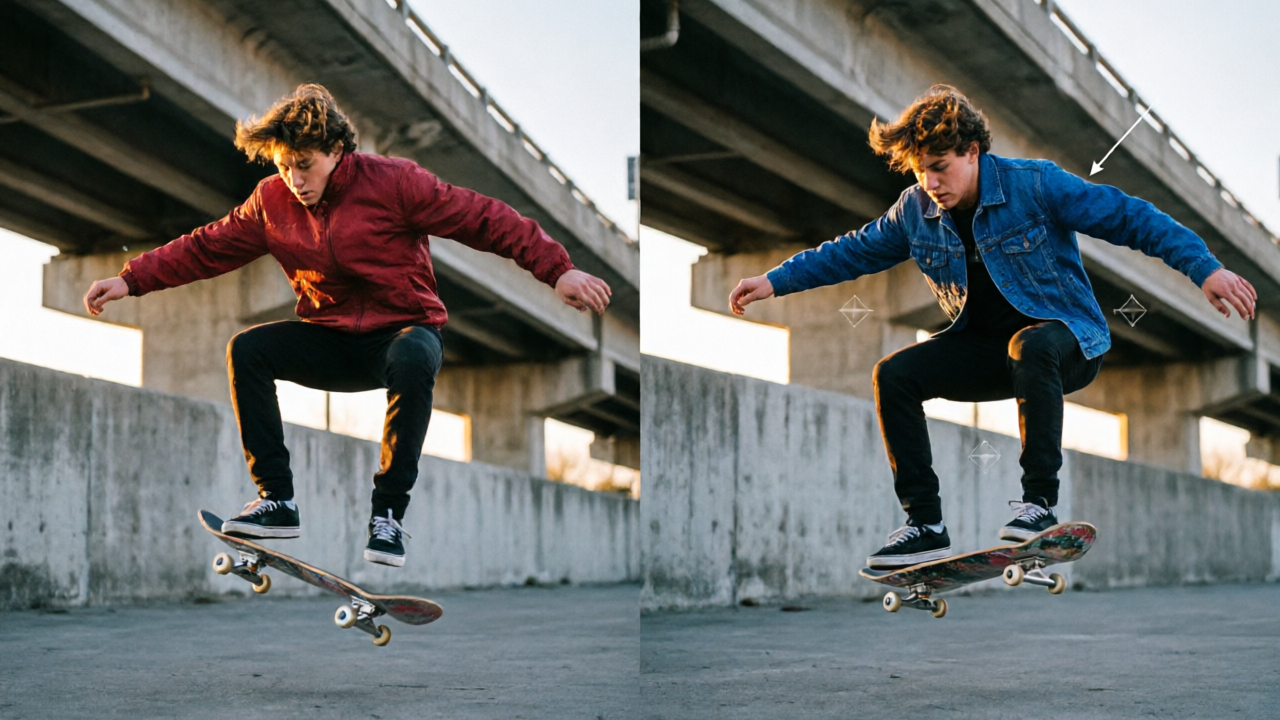
Comienza con una a tres imágenes de referencia y describe después la edición deseada en lenguaje natural. El endpoint de edición acepta instrucciones de hasta 800 caracteres y puede devolver imágenes de hasta 2K utilizando una semilla para ejecuciones repetibles. Este flujo de trabajo controlado es adecuado para revisiones de productos, cambios de estilo visual y desarrollo creativo iterativo, sin tener que reconstruir la composición original desde cero.
Control reproducible del lienzo
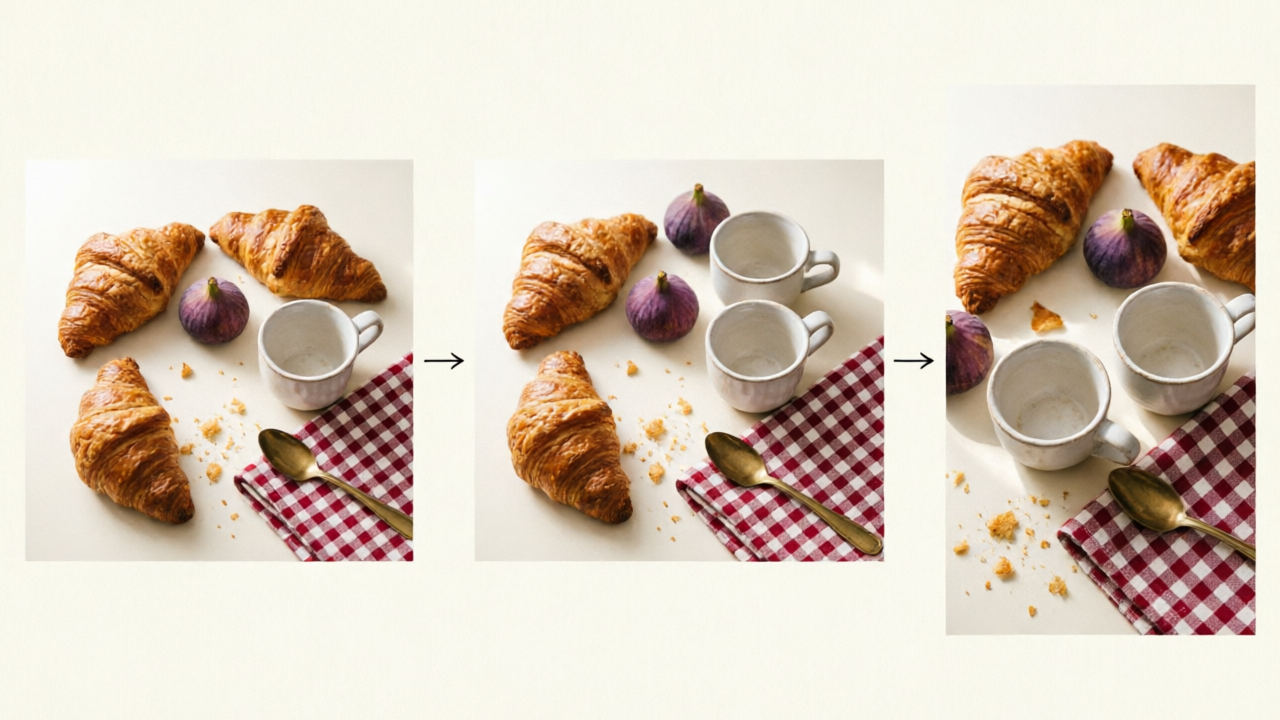
Las dimensiones de salida pueden variar de 512 a 2048 píxeles por lado, y las semillas aceptan valores de 0 a 2147483647. También hay disponible una semilla aleatoria, con un valor predeterminado de -1. Adapta el lienzo a necesidades cuadradas, apaisadas o verticales, conservando al mismo tiempo un punto de partida reproducible. Estos controles simplifican las pruebas sistemáticas y la producción coherente de recursos en múltiples ubicaciones.
Acceso REST a Qwen Image 2.0
Atlas Cloud ofrece generación de texto a imagen y edición de imágenes mediante endpoints REST al precio estándar de $0.035 por imagen. La inferencia lista para usar, la ausencia de arranques en frío y el acceso desde el día 0 eliminan el trabajo de alojar el modelo, mientras que una API unificada mantiene la integración coherente en toda la familia. Esta configuración admite prototipos, herramientas de producción y pipelines de imágenes escalables con una facturación transparente de pago por uso.
Qwen Image 2.0: Un mismo prompt para tres modelos de imagen
Descubre cómo Qwen Image 2.0 y dos modelos de imagen comparables interpretan prompts idénticos en diseño gráfico preciso y fotografía documental de acción rápida.
Una película de desastres cinematográfica sobre una mesa, capturada entre bastidores en el instante decisivo: la mano realista de un joven creador de maquetas entra en cuadro para estabilizar un faro en miniatura, derribado de lado por una ola repentina y gigantesca que irrumpe desde una taza de té de color blanco crema, mientras varias diminutas figuras del equipo de rodaje huyen presas del pánico cargando una cámara azul marino, un trípode, cables y equipo de iluminación; una claqueta en miniatura, perfectamente legible, muestra exactamente “LA ÚLTIMA TAZA” y “TOMA 07” con letras limpias y correctamente escritas. Tactilidad de animación stop-motion artesanal combinada con fotografía macro fotorrealista, destacando el choque humorístico entre las escalas humana y miniatura. Cámara baja rozando la superficie de la mesa; cables eléctricos enredados y brillantes rastros de agua forman marcadas líneas de fuga hacia el faro inclinado y la taza; un tornillo metálico desenfocado oculta parcialmente el primerísimo plano para crear profundidad por capas y confusión de escala. La intensa luz solar direccional del mediodía atraviesa persianas venecianas y proyecta sombras nítidas a rayas sobre el decorado, con gotas suspendidas centelleantes y un sutil desenfoque de movimiento en el equipo que escapa. Paleta estrictamente limitada a blanco crema, azul marino y naranja de seguridad. Veta de madera envejecida altamente convincente, pulpa de papel empapada y deformada, pintura de miniatura desconchada, metal rayado, tela húmeda, agua transparente con refracción físicamente precisa, tensión superficial, salpicaduras y relaciones espaciales coherentes. Acción densa alrededor del desastre central, equilibrada por un espacio negativo más sereno cerca de los bordes del encuadre, imperfecciones artesanales, grano fino de película contenido, poca profundidad de campo, lente macro, enfoque cercano, caída óptica realista, fotografía de efectos prácticos de alta gama, sin sobreprocesado aceitoso, sin detalle uniforme de pared a pared propio del HDR, sin piel de aspecto plástico, sin dominante de color turbia o sucia, sin resplandor omnipresente, sin iluminación de fantasía épica barata, sin estética oscura submarina o de ruinas espaciales, relación de aspecto horizontal amplia 16:9, a sangre.
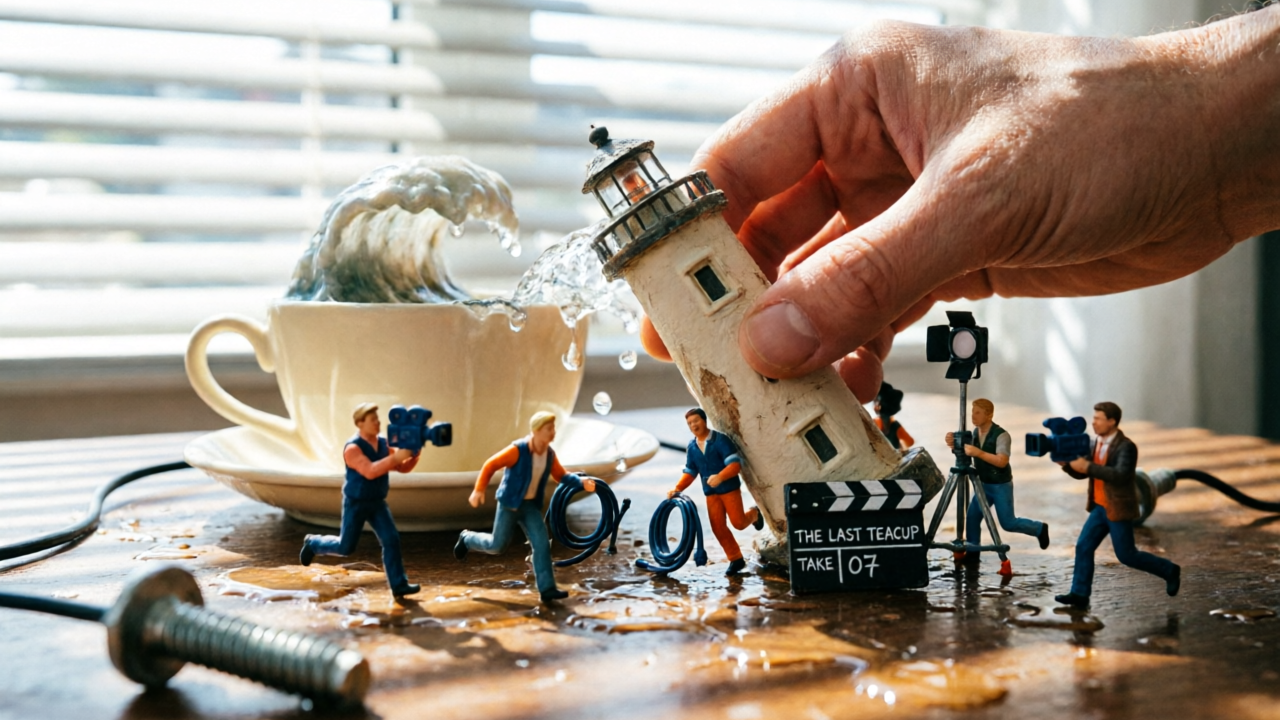
Generated with Qwen Image 2.0 Text-to-image on Atlas Cloud
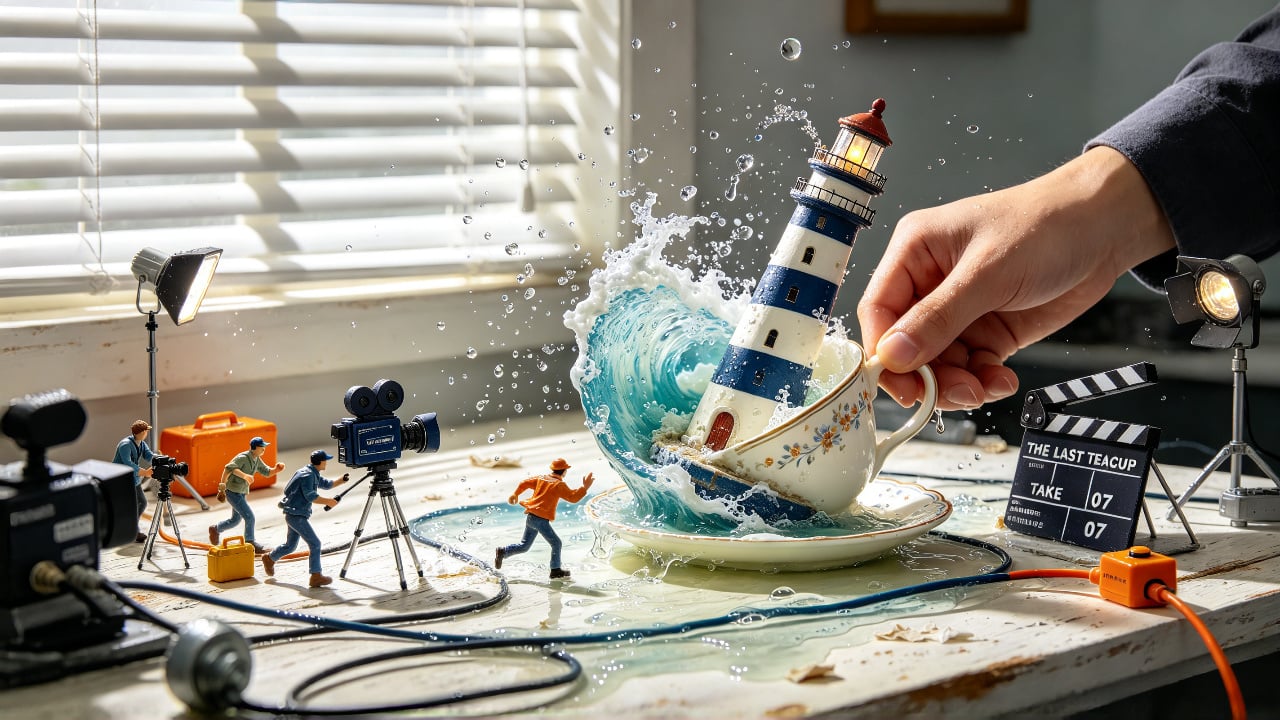
Generated with Seedream v4.7 Text-to-Image on Atlas Cloud
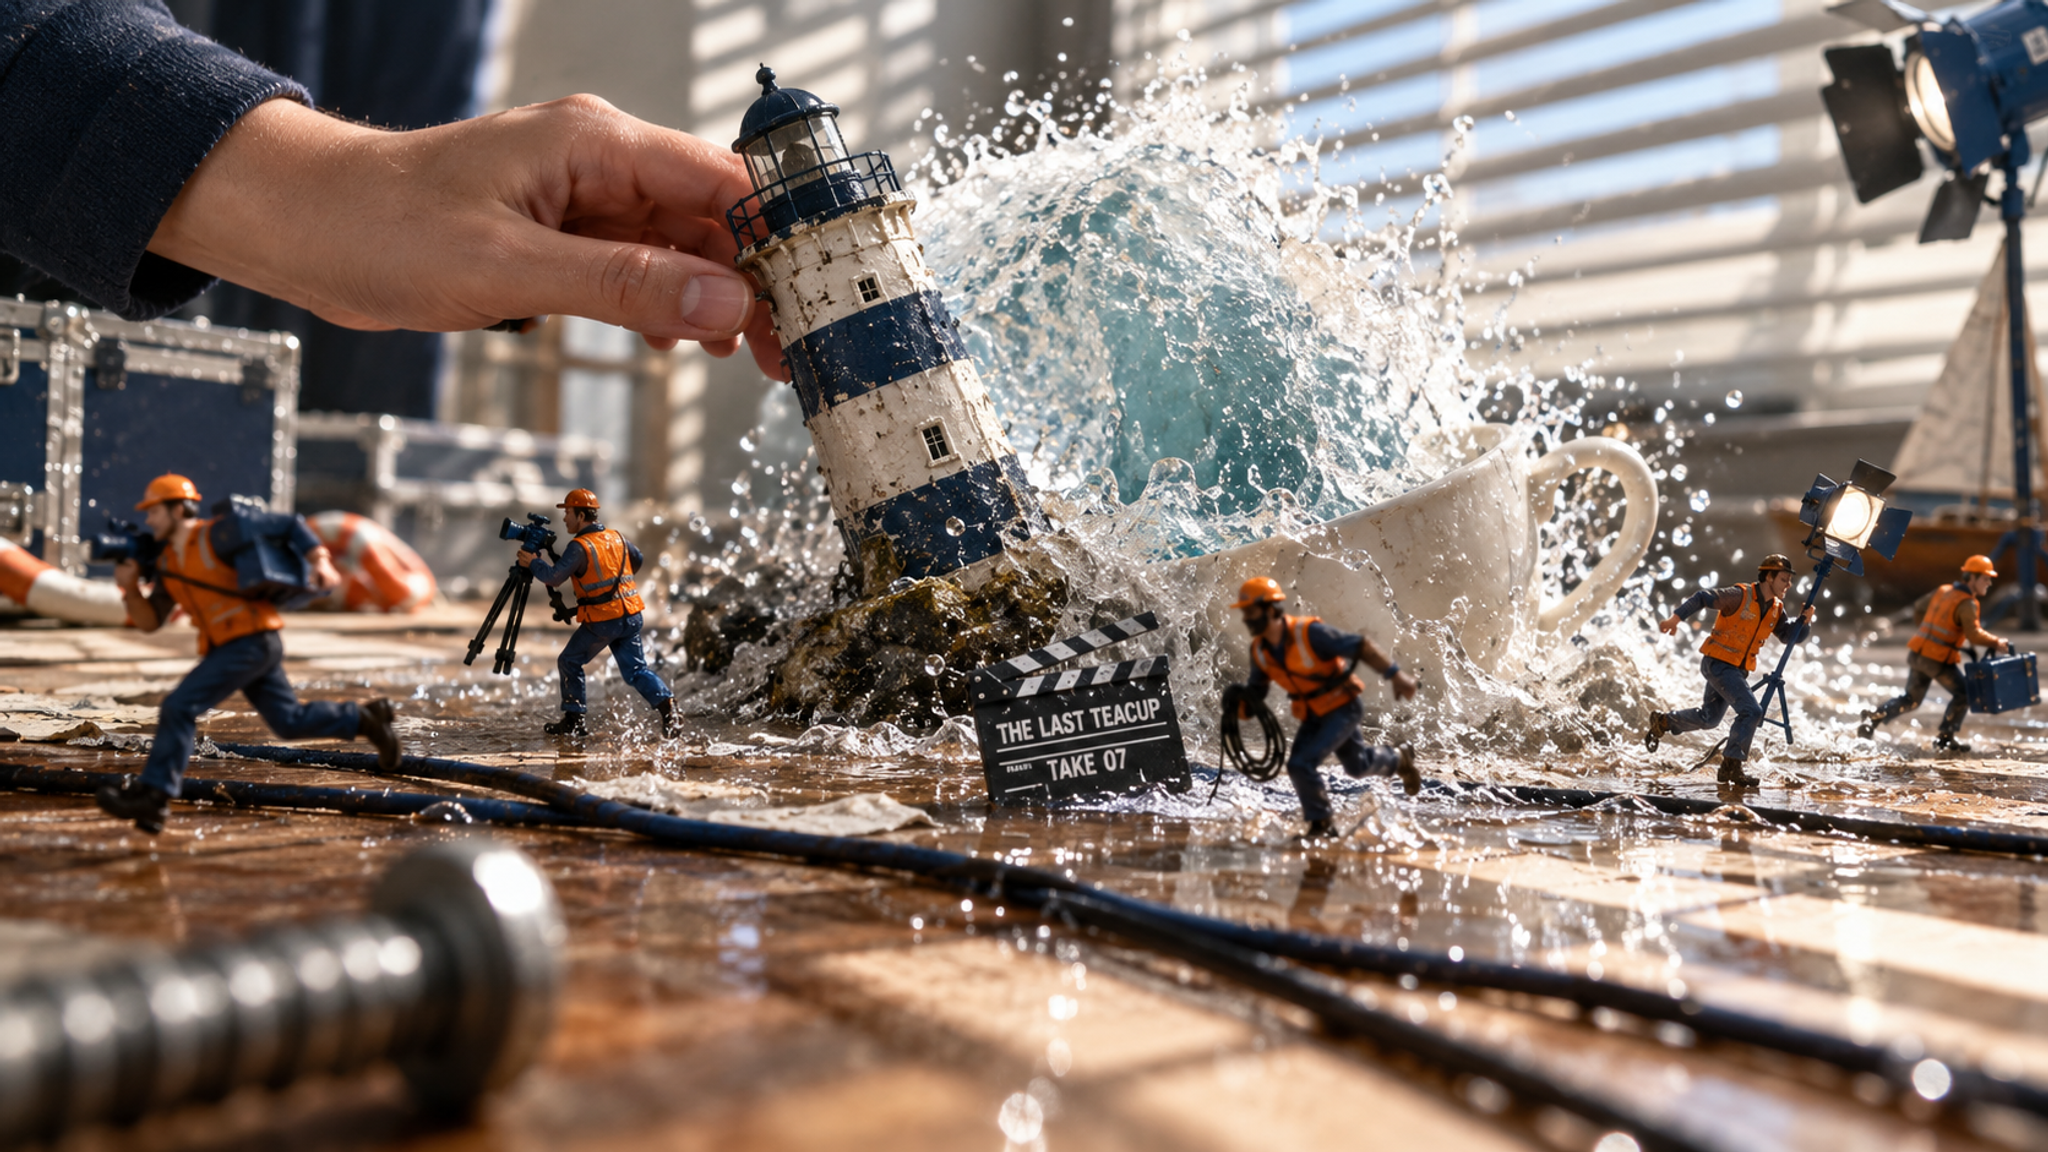
Generated with Wan-2.7 Text-to-image on Atlas Cloud
Una fuga en miniatura se desarrolla sobre la mesa de trabajo de un creador de figuritas, justo en el instante decisivo en que el creador se ha alejado: un equipo de diminutas figuras de arcilla blanca sin pintar ha doblado ingeniosamente una etiqueta de inspección de papel —con las palabras pequeñas, nítidas y perfectamente legibles “INSPECCIÓN FINAL”— para convertirla en un improvisado globo aerostático; una figura acaba de cortar la última cuerda de sujeción y el globo de papel se eleva bruscamente con un atisbo de desenfoque de movimiento, mientras sus compañeros retroceden, vitorean y contemplan el ascenso con asombro. Un frasco de pintura volcado derrama un río sinuoso de azul ultramar por la escena, bordeado por pequeñas huellas bermellón y puentes improvisados. Narración espacial precisa en miniatura, con cada personaje realizando una acción distinta. El estante de herramientas de madera crea un marcado marco dentro del marco; pinzas, punzones de modelado y cúteres forman líneas de fuga radiales hacia el globo ascendente; conserva un espacio negativo limpio y despejado en la esquina superior derecha. La luz direccional de la ventana entra diagonalmente desde la izquierda, produciendo sombras alargadas de bordes suaves e iluminando las huellas dactilares impresas en la arcilla sin tratar, la veta de madera desgastada, las fibras del papel doblado, las herramientas metálicas rayadas y la superficie pegajosa de la pintura semiseca. Solo una paleta estricta de tres colores: blanco arcilla, azul ultramar y rojo bermellón, con una variación tonal natural y contenida; sin colores de acento adicionales. Animación stop-motion exquisita combinada con cinematografía macro fotorrealista, imperfecciones táctiles artesanales, poca profundidad de campo selectiva, herramientas del primer plano suavemente desenfocadas, acción central perfectamente definida, grano sutil de película analógica, lente macro de 100 mm, cinematográfico pero íntimo, realismo sofisticado de efectos prácticos, sin superficies de plástico brillante, sin sobreprocesado grasiento, sin HDR, sin colores turbios, sin resplandor omnipresente, sin estilo de fantasía épica barata, sin atmósfera oscura submarina o de ruinas espaciales, composición horizontal amplia 16:9, encuadre completo de borde a borde.
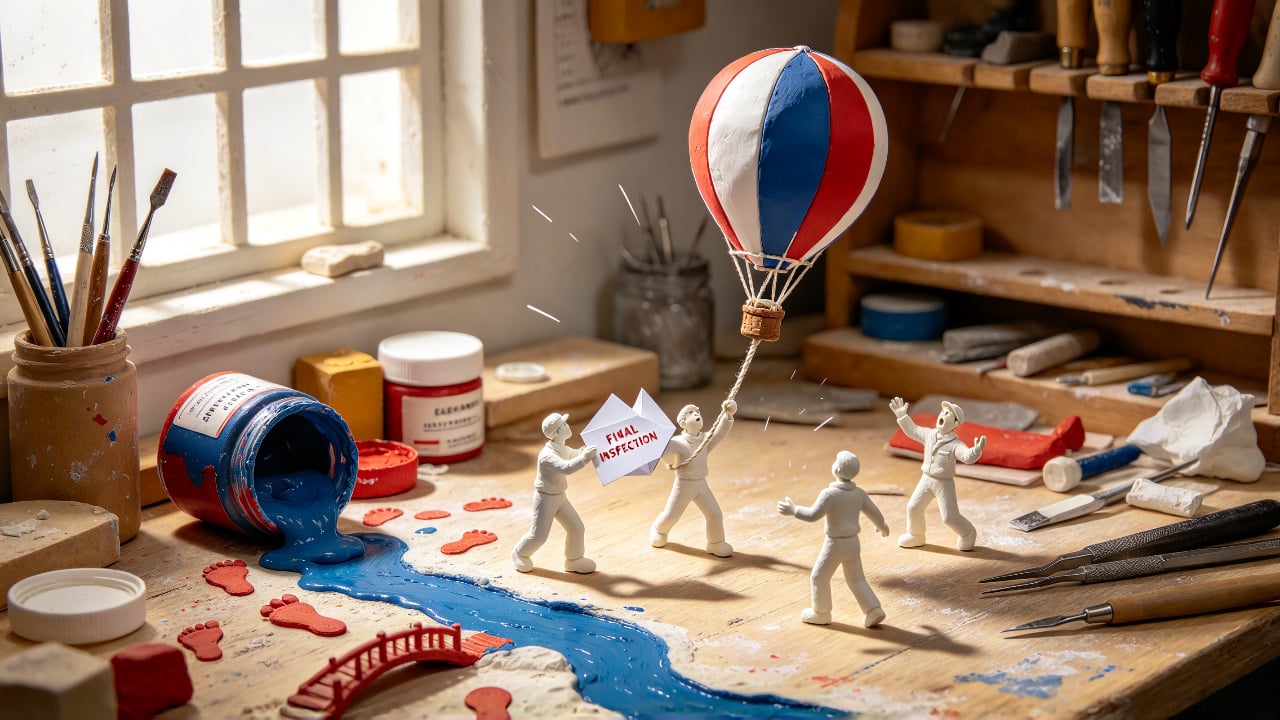
Generated with Qwen Image 2.0 Text-to-image on Atlas Cloud
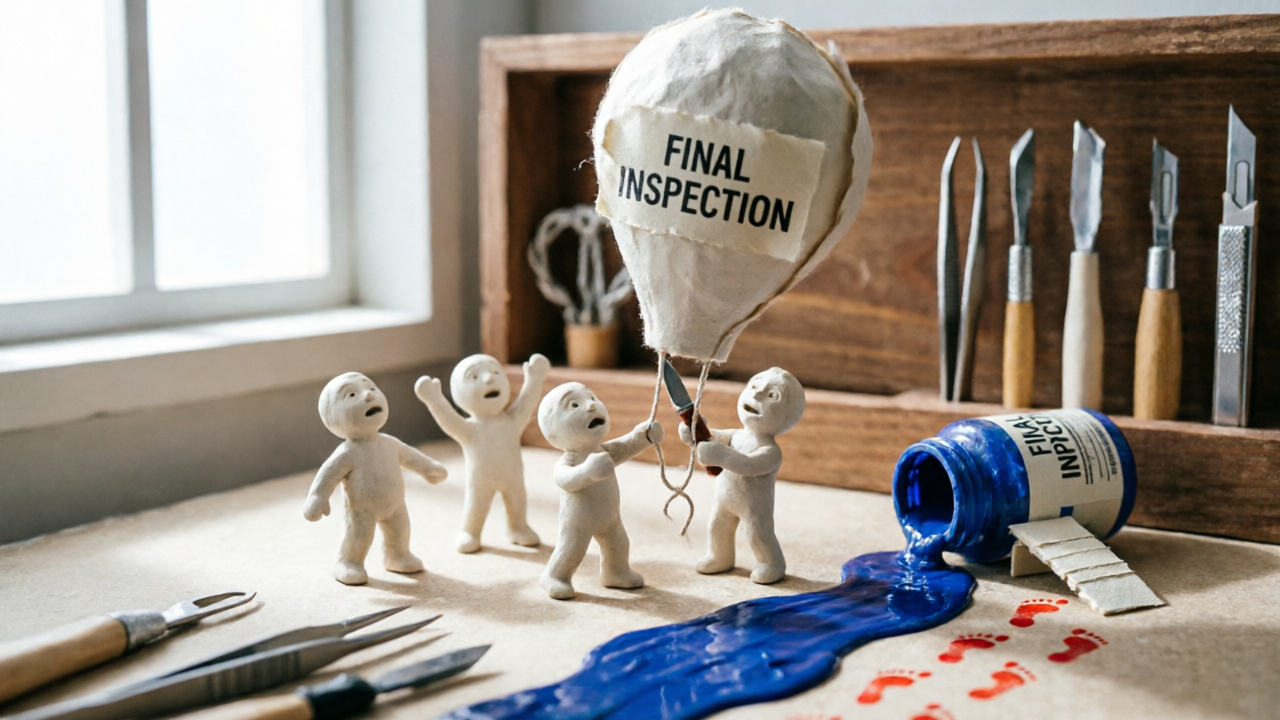
Generated with Seedream v4.7 Text-to-Image on Atlas Cloud
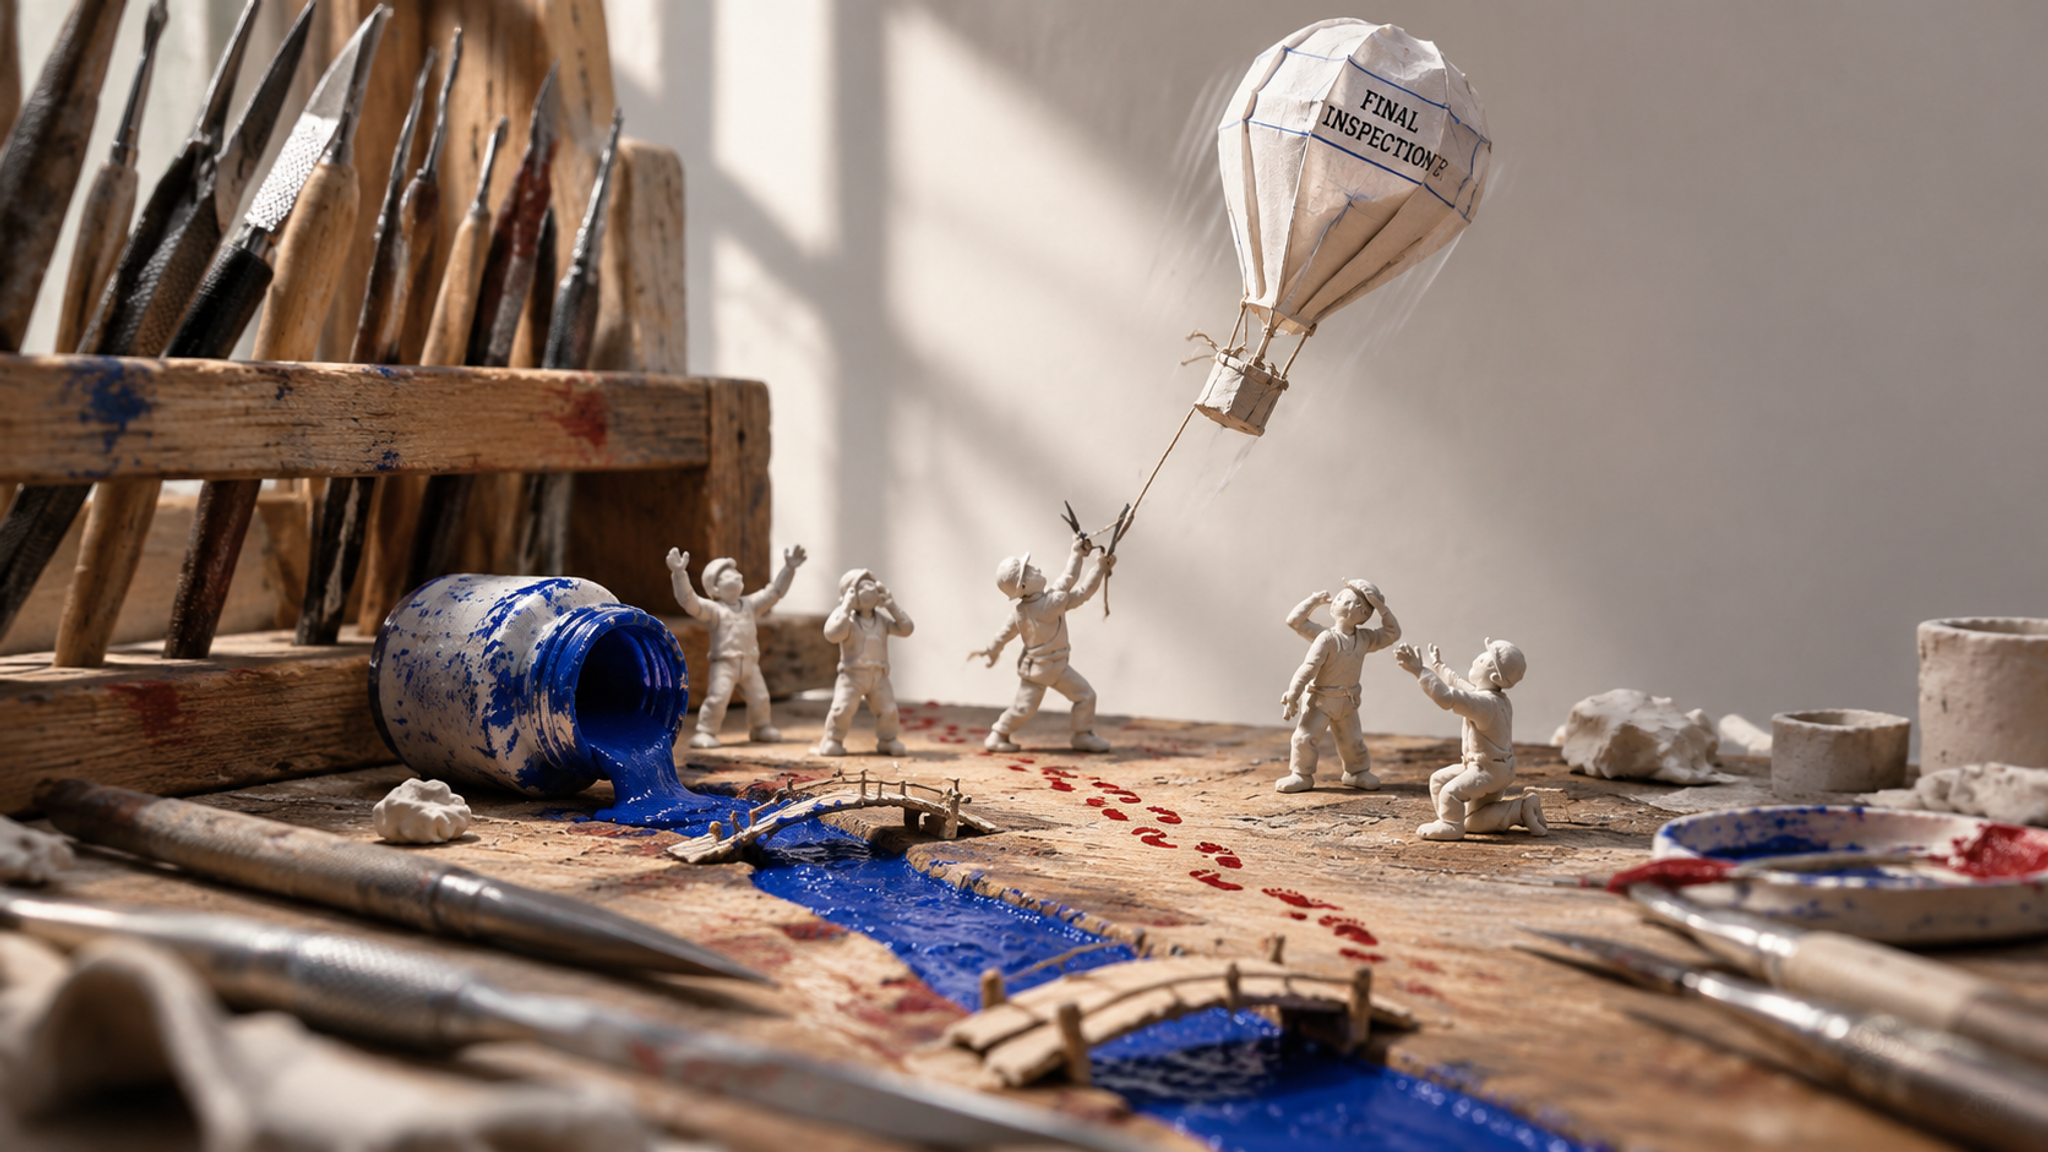
Generated with Wan-2.7 Text-to-image on Atlas Cloud
Del briefing a los recursos visuales terminados con Qwen Image 2.0
Qwen Image 2.0 convierte prompts detallados e imágenes existentes en gráficos para presentaciones, recursos para campañas, escenas de producto, storyboards, elementos visuales localizados y ediciones precisas con resoluciones de hasta 2K.

Diseño de presentaciones con Qwen Image 2.0
Convierte prompts detallados en recursos visuales pulidos para presentaciones, con diseños estructurados y texto legible dentro de la imagen. Los equipos de producto pueden crear diapositivas conceptuales, materiales explicativos y recursos para presentaciones internas con resoluciones de hasta 2K.

Tipografía para recursos de campaña
La tipografía renderizada profesionalmente aporta claridad a carteles, gráficos para redes sociales y conceptos de campaña creados a partir de prompts detallados. Los equipos de marketing obtienen líneas visuales adaptables para lanzamientos, promociones y comunicaciones de marca sin tener que reconstruir manualmente cada composición.

Escenas de producto con Qwen Image 2.0
Cuando las escenas de producto requieren detalle, genéralas a partir de prompts descriptivos con resoluciones de hasta 2K. Los minoristas y estudios creativos pueden perfeccionar los fondos, los objetos circundantes o el contexto de la campaña mediante instrucciones de edición claras para distintas ubicaciones.

Revisión precisa de imágenes
¿Necesitas cambiar un recurso visual existente sin empezar de cero? Proporciona instrucciones claras al endpoint de edición para actualizar texto, objetos, poses o estilo en los comentarios de clientes y los flujos de producción iterativos a gran escala.

Carteles y guías localizados
Los carteles y las guías con mucho texto pueden combinar narrativa visual con tipografía multilingüe. Los equipos de contenido global pueden crear materiales de viaje localizados, gráficos para eventos y conceptos de campañas regionales en una única imagen compuesta.

Storyboards con Qwen Image 2.0
Los prompts detallados pueden convertir narrativas en cómics, calendarios o paneles de storyboard con una composición visual estructurada. Los creadores pueden explorar secuencias, materiales explicativos educativos y conceptos de campaña antes de comprometer recursos en la producción completa.
Qwen Image 2.0 frente a API de imagen comparables
Compara los endpoints de Qwen Image 2.0 con las alternativas de Microsoft según la tarea, la resolución máxima de salida y el precio estándar por imagen.
| Modelo | Tarea | Resolución máxima | Precio estándar |
|---|---|---|---|
| Qwen Image 2.0 Text-to-image | Texto a imagen | 2048 × 2048 | $0.035/imagen |
| Qwen Image 2.0 Edit | Edición de imágenes | 2048 × 2048 | $0.035/imagen |
| MAI-Image-2.6-Flash Text-to-image | Texto a imagen | Máximo de 2.36 MP, equivalente a 1536 × 1536 | $0.044/imagen |
| MAI-Image-2.6-Flash Edit | Edición de imágenes | Máximo de 2.36 MP, equivalente a 1536 × 1536 | $0.047/imagen |
Cómo usar Qwen Image 2.0 en Atlas Cloud
Empieza en minutos — sigue estos sencillos pasos para integrar y desplegar modelos a través de la plataforma de Atlas Cloud.
Crea una cuenta en Atlas Cloud
Regístrate en atlascloud.ai y completa la verificación. Los nuevos usuarios reciben créditos gratuitos para explorar la plataforma y probar modelos.
Por Qué Usar Qwen Image 2.0 en Atlas Cloud
Combina modelos avanzados de Qwen Image 2.0 con la plataforma acelerada por GPU de Atlas Cloud, proporcionando rendimiento, escalabilidad y experiencia de desarrollo incomparables.
Rendimiento y Flexibilidad
Baja Latencia:
Inferencia optimizada por GPU para respuestas en tiempo real.
API Unificada:
Una sola integración para acceder a Qwen Image 2.0, GPT, Gemini y DeepSeek.
Precios Transparentes:
Facturación por Token, soporta modo Serverless.
Empresa y Escala
Experiencia del Desarrollador:
SDK, análisis de datos, herramientas de ajuste fino y plantillas todo en uno.
Confiabilidad:
99.99% de disponibilidad, control de permisos RBAC, registros de cumplimiento.
Seguridad y Cumplimiento:
Certificación SOC 2 Type II, cumplimiento HIPAA, soberanía de datos en EE.UU.
Preguntas frecuentes sobre la API de Qwen Image 2.0
Qwen Image 2.0 es un modelo de imágenes del equipo Qwen de Alibaba para generar imágenes a partir de texto y editar imágenes existentes mediante instrucciones. Atlas Cloud proporciona endpoints REST dedicados para ambas tareas, con resoluciones de salida de hasta 2K.
Usa el modelo para generar imágenes a partir de descripciones detalladas o modificar imágenes existentes mediante instrucciones en lenguaje natural. Su mejor comprensión de los prompts permite flujos de trabajo como gráficos de marketing, arte conceptual, imágenes de productos, infografías y diseño visual.
Sí. Atlas Cloud destaca la legibilidad del texto dentro de las imágenes y la compatibilidad con prompts complejos, lo que hace que el modelo sea adecuado para infografías, pósteres, materiales de marketing y otros diseños estructurados. Mantén explícitas las instrucciones sobre el texto y el diseño dentro del límite de 800 caracteres del prompt de la API.
Crea una clave de API en el panel de Atlas Cloud, elige el ID del modelo de generación o edición y envía una solicitud REST. La inferencia alojada significa que no necesitas configurar una GPU local ni implementar los pesos del modelo.
Envía una solicitud POST autenticada a https://api.atlascloud.ai/api/v1/model/generateImage con el ID del modelo y las entradas en el cuerpo JSON. La solicitud asíncrona devuelve un ID de predicción, que puedes consultar mediante el endpoint de predicción hasta que finalice el procesamiento.
Elige qwen/qwen-image-2.0/text-to-image para crear una imagen nueva a partir de un prompt. Para realizar cambios basados en instrucciones sobre imágenes de referencia, selecciona qwen/qwen-image-2.0/edit.
La generación de texto requiere un prompt y acepta valores opcionales de size y seed. La edición también requiere una matriz images, mientras que size y seed siguen siendo opcionales. Ambos endpoints aceptan prompts en chino e inglés de hasta 800 caracteres.
El endpoint de edición acepta de una a tres URL de imágenes de referencia, y cada imagen debe medir entre 384 y 3072 píxeles por dimensión. Las dimensiones de salida pueden oscilar entre 512 y 2048 píxeles, y el perfil del modelo indica compatibilidad con resoluciones de hasta 2K.
Atlas Cloud indica un precio base estándar de $0.035 por solicitud para los endpoints de generación de texto y edición. Este es el precio original de pago por uso, sin incluir descuentos temporales.
Establece seed en un número entero específico del 0 al 2147483647 cuando necesites pruebas reproducibles; el valor predeterminado de -1 selecciona una seed aleatoria. Mantén sin cambios el ID del modelo, el prompt y size al comparar resultados o aislar variaciones inesperadas.
Explorar Más Series
Seedance 2.5
¡La API de Seedance 2.5 ya está disponible en Atlas Cloud! Ofrece a los desarrolladores el modelo de video más reciente de ByteDance. Genera hasta 30 segundos de video nativo en una sola pasada a partir de texto, una sola imagen o hasta 50 referencias multimodales, con audio sincronizado y texto multilingüe en el encuadre. En Atlas Cloud puede acceder a él mediante una única clave, con consistencia del sujeto y físicas mejoradas que mantienen la coherencia en las tomas largas.

Wan 3.0
La API Wan 3.0 es la próxima generación de la familia de videos Wan de Alibaba, diseñada para llevar la generación de formato largo, el control de múltiples referencias y la calidad audiovisual a nuevas alturas. Atlas Cloud ya aloja Wan 2.7, 2.6 y 2.5, y Wan 3.0 se ejecuta con la misma clave unificada sin necesidad de configuración adicional. Empieza a construir hoy mismo. Desplázate hacia abajo hasta la galería para ver lo que Wan 3.0 puede crear.
MiniMax H3
MiniMax H3 es la familia de vídeo multimodal de MiniMax para la creación guiada por texto, imagen y referencias. En las rutas compatibles, conserva los sujetos del material de referencia, ofrece relaciones de aspecto flexibles y combina el sonido generado con los elementos visuales mediante H3 Developer, con perfiles de salida seleccionados según el endpoint. Atlas Cloud reúne toda la familia bajo una única clave compatible con OpenAI, con precios transparentes de pago por uso a partir de la tarifa estándar de $0.038 por segundo. Empieza a crear hoy mismo.
Seedream 5.0 Pro
La API de Seedream 5.0 Pro ofrece a los desarrolladores el modelo de edición de imágenes controlable de ByteDance en Atlas Cloud. Sitúa las ediciones con precisión mediante anclajes y coordenadas, separa las imágenes en capas editables, fusiona múltiples referencias y empareja colores y materiales exactos, con texto multilingüe a 2K y 3K. ¡En Atlas Cloud puede acceder a él mediante una sola clave!
Seedance 2.0
Seedance 2.0 es el modelo de vídeo para producción de ByteDance, diseñado para crear planos con precisión. Convierte prompts en vídeo, anima una imagen del primer fotograma con orientación opcional del último fotograma o da forma a los resultados mediante medios de referencia y búsqueda web opcional. Atlas Cloud reúne estos flujos de trabajo en una única API unificada, con precios transparentes de pago por uso y una sola clave compatible con OpenAI. Empieza a crear hoy mismo.
GPT Image 2.5
La familia gpt-image-2.5 de OpenAI ofrece a los desarrolladores la posibilidad de elegir entre Flare y Sunburst para flujos de trabajo de producción de imágenes. Renderiza con resoluciones arbitrarias de hasta 3840x2160 y elige entre cinco niveles de calidad, incluidos xhigh y max, para adaptarte a requisitos de salida específicos. Atlas Cloud proporciona inferencia REST lista para usar, sin arranques en frío y con precios estándar desde $0.004 por generación. Empieza a crear hoy mismo.
GPT Image 2
La API de GPT Image 2 ofrece a los desarrolladores acceso al último modelo de imágenes de OpenAI, el sucesor de GPT Image 1.5. Genera y edita imágenes con una representación de texto precisa en caracteres latinos y CJK, además de una sólida composición para carteles, maquetas e infografías. En Atlas Cloud, puede acceder a ella a través de una API unificada junto con más de 300 modelos, con créditos gratuitos, un tiempo de actividad del 99,99% y sin necesidad de verificación de organización de OpenAI.
Gemini Omni Flash
La API de gemini omni pone a disposición de los desarrolladores la familia Gemini Omni Flash nativamente multimodal de Google DeepMind, incluido Gemini Omni 1.1 Flash. Crea vídeos cinematográficos con audio nativo sincronizado, anima imágenes estáticas con un control preciso de los fotogramas inicial y final, o revisa metraje existente mediante ediciones guiadas por texto que conservan el contenido no modificado. Atlas Cloud proporciona una única clave compatible con OpenAI, acceso unificado y precios transparentes de pago por uso. Empieza a desarrollar hoy mismo.
Grok Imagine
La API Grok Imagine cubre los modelos de imagen, video y voz de xAI, desde Image 2.0 hasta Video 1.5 y xAI TTS v1. Genera imágenes de 1K o 2K en 14 relaciones de aspecto, expande una escena a 15 segundos de movimiento en 1080p, controla tomas con hasta 7 imágenes de referencia, o nárralas en 20 idiomas. Atlas Cloud ejecuta todos los modos en un endpoint, con precios de pago por uso desde $0.02 por imagen y $0.05 por segundo. Empieza a construir hoy.
Los modelos creativos más potentes de Google están todos disponibles en Atlas Cloud. Veo 3.1 ofrece generación de video cinematográfico, Nano Banana 2 impulsa la creación de imágenes de alta fidelidad y Gemini aporta inteligencia multimodal a cada flujo de trabajo. Acceda a la suite completa de modelos de Google a través de una sola API key con disponibilidad Day-0 y precios de pago por uso (pay-as-you-go).
Seedance 2.0 Mini
Seedance 2.0 Mini lleva la generación de video multimodal de ByteDance a los flujos de trabajo donde la velocidad y el costo son más importantes. Ofrece las capacidades principales de Seedance 2.0 con un menor consumo de recursos: generación más rápida, menor costo por video y la misma integración de API que ya utiliza. Para los equipos que ejecutan pipelines de alto volumen o crean prototipos a escala, Mini es la opción predeterminada práctica.
ByteDance
Desde la generación de video cinematográfico hasta la creación de imágenes de alta fidelidad, los modelos más potentes de ByteDance están disponibles en Atlas Cloud. Ejecute Seedance y Seedream a gran escala con los precios de inferencia más bajos y cero gastos generales de infraestructura.
Artículos recomendados
Guías, tutoriales y novedades de producto para aprovechar al máximo Atlas Cloud.


