Qwen Image 3.0 pro Identity Preserving Edits
Qwen Image 3.0 pro es la familia de generación y edición de imágenes de Qwen para desarrolladores que crean flujos de trabajo visuales para producción. Genera imágenes de hasta 2048×2048, reescribe automáticamente los prompts, selecciona la resolución según la intención del prompt y sigue instrucciones de edición en lenguaje natural, manteniendo los rasgos faciales y la identidad. Accede a ambos modelos a través de Atlas Cloud con una única clave compatible con OpenAI y un precio estándar de pago por uso de $0.04 por llamada. Empieza a desarrollar hoy.
Qwen Image 3.0 Pro ha sido desarrollado por Alibaba. Atlas Cloud (operado por Atlas Cloud AI LLC) proporciona acceso al modelo, pero no es su propietario. Todas las marcas comerciales pertenecen a sus respectivos titulares.
Explorar Modelos Líderes
Atlas Cloud le proporciona los últimos modelos creativos líderes en la industria.


Modos de generación y edición de Qwen Image 3.0 pro
Compara los endpoints de texto a imagen y de edición basada en referencias disponibles para Qwen Image 3.0 pro.
| Modalidad | Descripción |
|---|---|
| Qwen Image 3.0 Pro API (Text to Image) | Convierte prompts de texto en imágenes con resoluciones de hasta 2048×2048, reformulación automática de prompts y selección de resolución guiada por prompts. El excelente renderizado de texto complejo y el seguimiento preciso de los prompts permiten crear carteles, recursos visuales de productos, ilustraciones y otros recursos cuya composición sea fundamental. |
| Qwen Image 3.0 Pro API (Image Editing) | Proporciona de una a tres imágenes de referencia y una instrucción en lenguaje natural para producir una imagen editada. Se conservan detalles clave, como los rasgos faciales y la identidad, mientras se aplican los cambios solicitados, lo que hace que este endpoint sea adecuado para perfeccionar retratos, crear variaciones visuales y actualizar recursos de forma controlada. |
Dentro de Qwen Image 3.0 pro: tipografía, detalle y control
Qwen Image 3.0 pro combina renderizado de texto complejo, seguimiento preciso de prompts, generación de hasta 2048 × 2048, reescritura automática de prompts y ediciones que preservan la identidad a partir de una a tres referencias mediante la API unificada de pago por uso de Atlas Cloud.
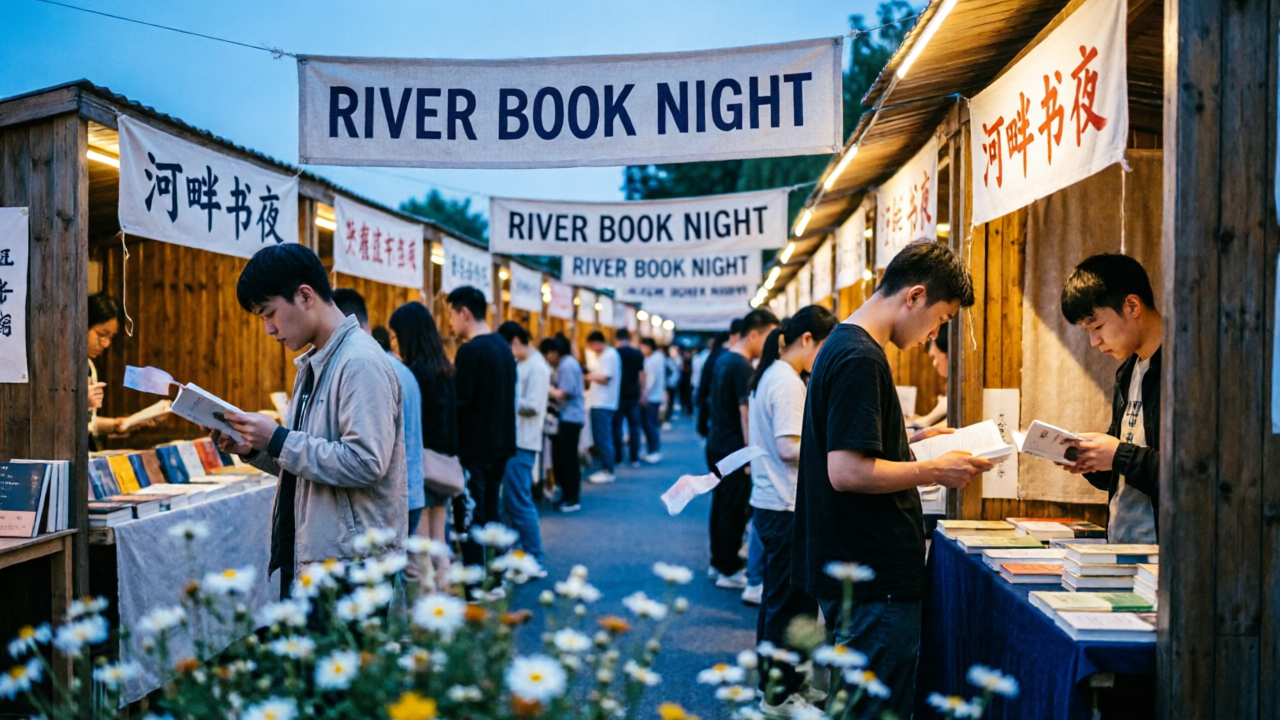
Tipografía en Qwen Image 3.0 pro
Qwen Image 3.0 pro sigue prompts detallados y gestiona el renderizado de texto complejo en inglés y chino. Puede estructurar composiciones creativas densas sin separar la tipografía de la escena. Especifica el texto, la jerarquía, la composición y el estilo visual en una sola solicitud, y luego revisa los nombres y números antes de publicar. Esto lo hace práctico para banners, gráficos editoriales, conceptos de packaging y piezas visuales con mucha información.
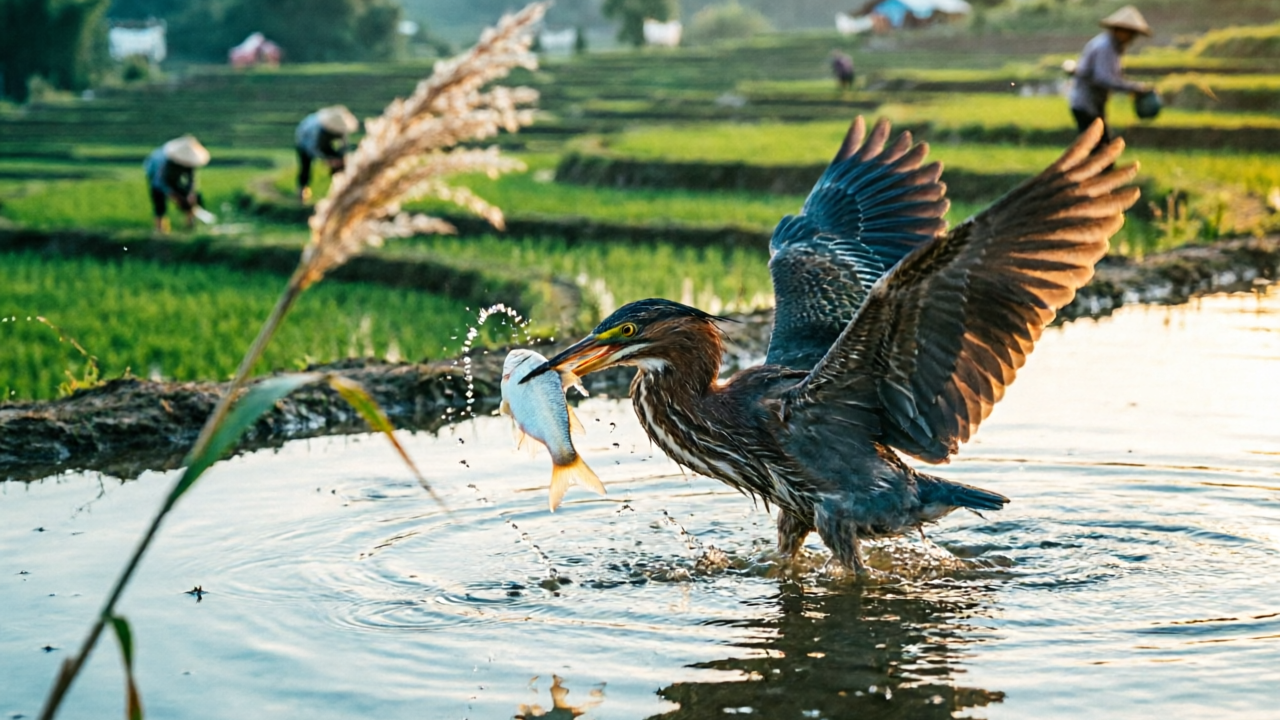
Detalle de 2048 × 2048
Genera imágenes con resoluciones de hasta 2048 × 2048 cuando importan las texturas finas y los detalles legibles. La selección de tamaño guiada por el prompt puede elegir automáticamente la resolución de salida, mientras que un tamaño explícito permite definir un lienzo concreto. Desde fotografía de producto hasta retratos editoriales, el presupuesto adicional de píxeles facilita una inspección más detallada, recortes posteriores flexibles y recursos de producción pulidos.
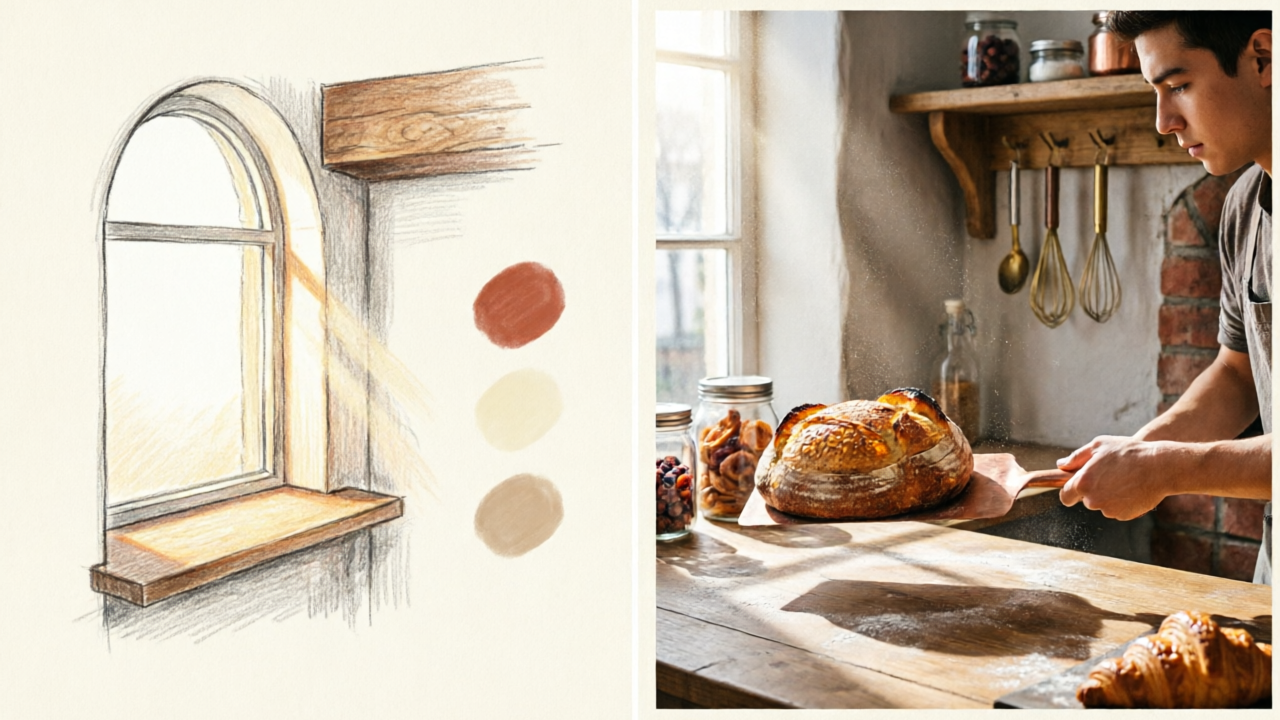
Dos modos de reescritura de prompts
Los prompts breves pueden ampliarse automáticamente antes de la generación, ya que la reescritura está activada de forma predeterminada. En el endpoint de generación de texto, el modo Direct realiza una única pasada de reescritura, mientras que el modo Agent utiliza un pipeline agéntico para enriquecer el briefing. Mantén activada la reescritura para conceptos exploratorios o desactívala cuando en producción importen más las formulaciones exactas y las instrucciones estrictamente controladas.
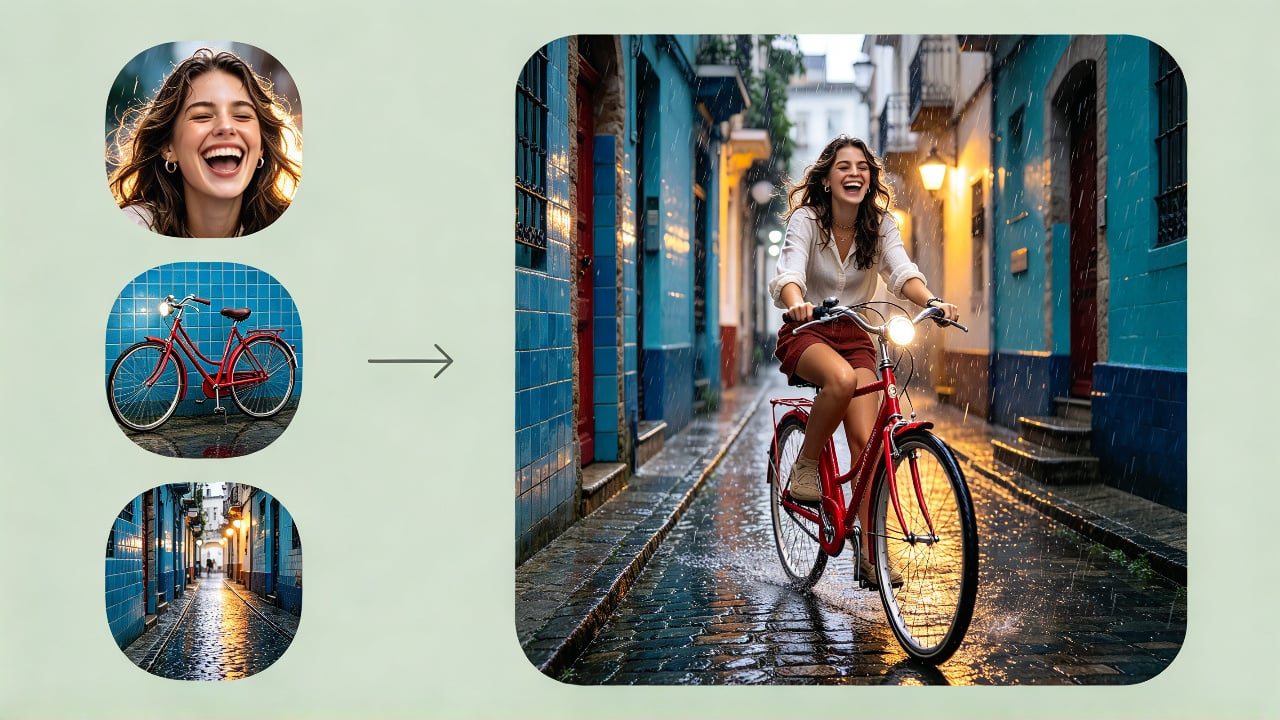
Ediciones con una a tres referencias
Incluye de una a tres imágenes de referencia en una edición y describe el cambio en lenguaje natural. El modelo puede usar esas fuentes como guía para el sujeto, el contexto o el estilo visual, al tiempo que conserva los rasgos faciales clave y la identidad. Pide un entorno, una estilización o una composición nuevos sin reconstruir desde cero el sujeto aprobado. Esto resulta adecuado para variantes de campaña, continuidad de personajes y escenas de producto guiadas por referencias.
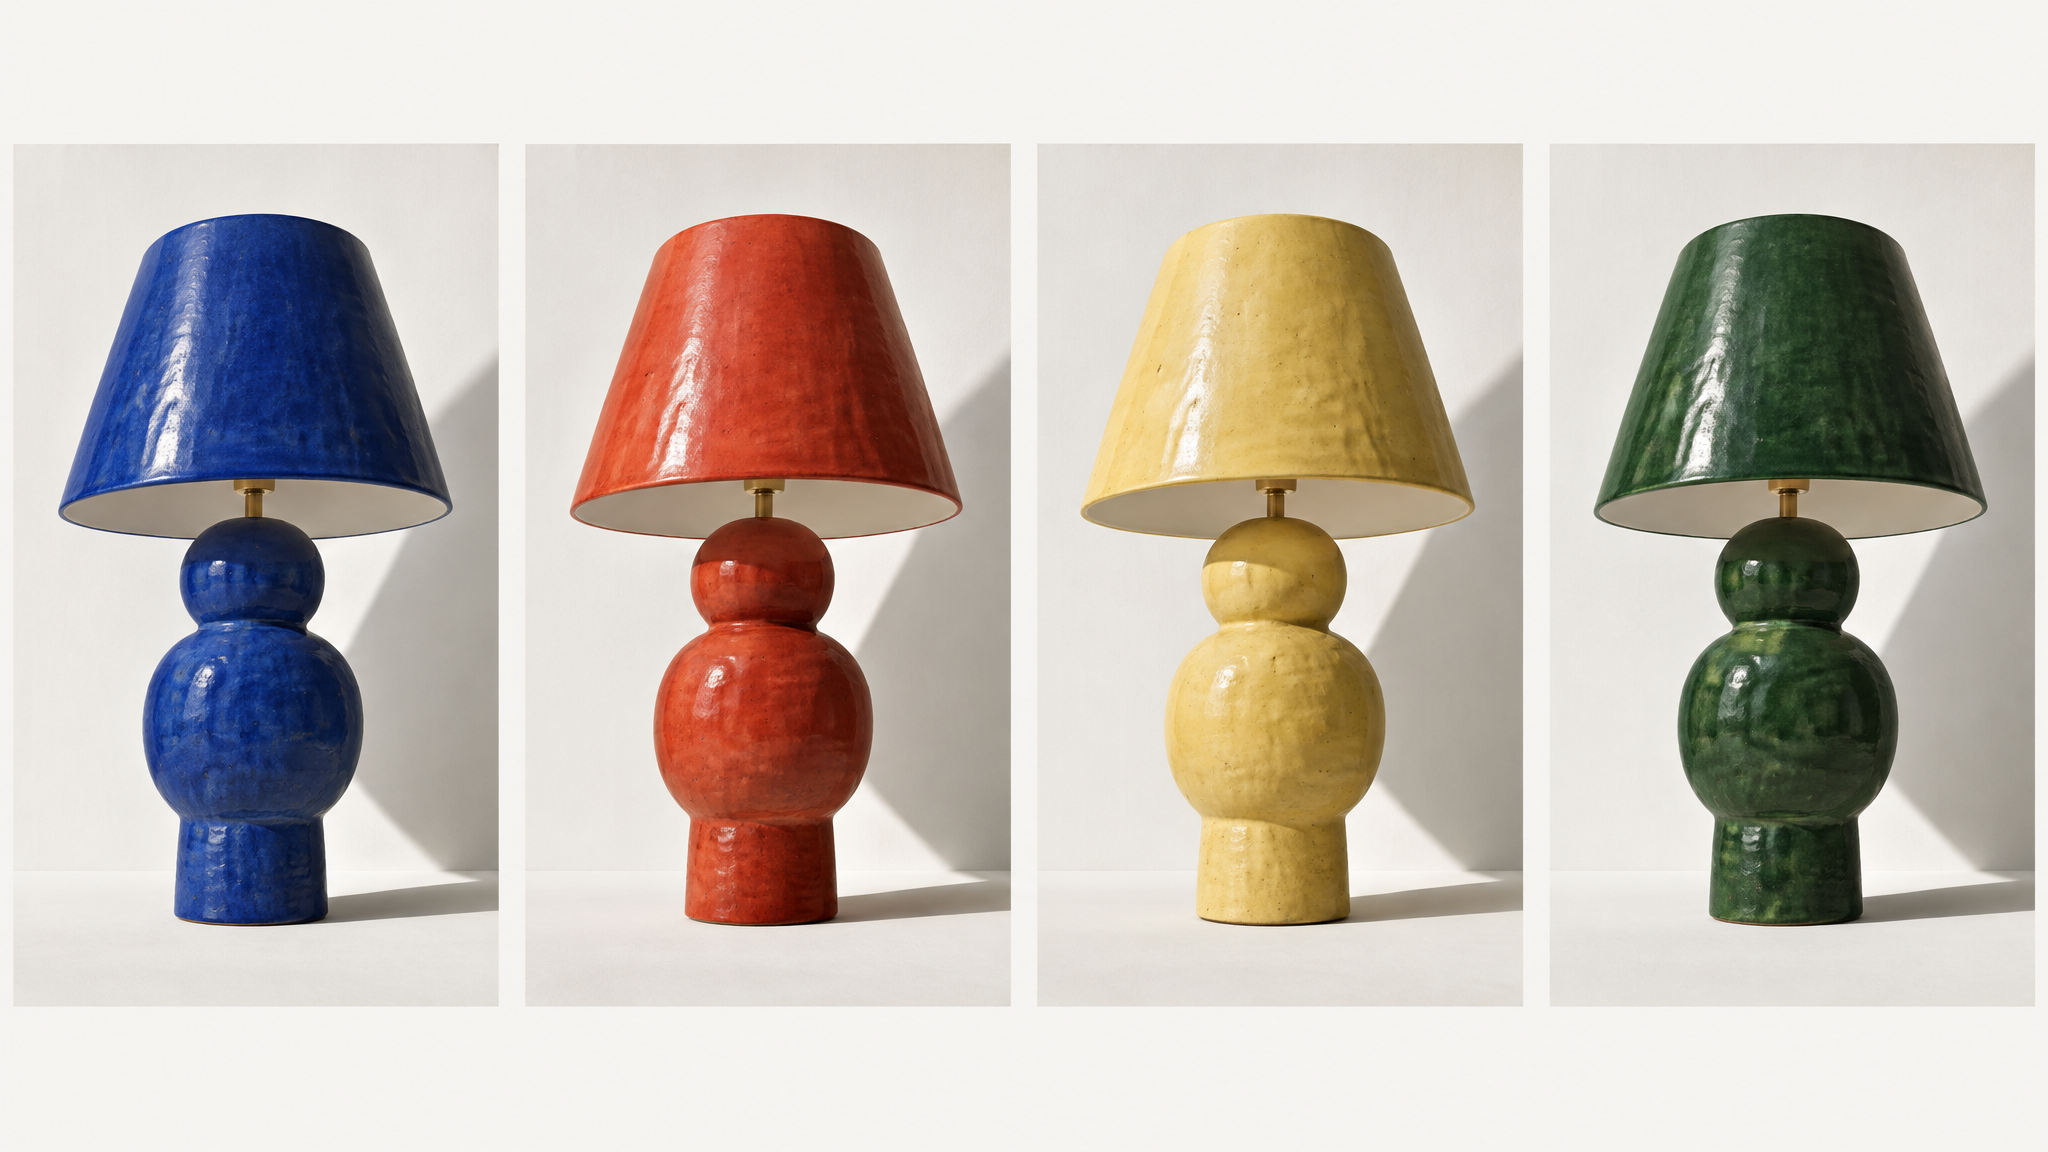
Controles reproducibles para lotes
¿Necesitas experimentos repetibles? Define una seed fija de 0 a 2147483647, añade un prompt negativo y solicita hasta cuatro resultados en una sola llamada de generación. Estos controles facilitan la comparación de revisiones de prompts, la exclusión de contenido no deseado y la evaluación de un conjunto reducido de opciones en condiciones coherentes. Úsalos para pruebas creativas estructuradas en lugar de depender de conjeturas puntuales.
Un prompt, tres visiones: comparación de Qwen Image 3.0 pro
Descubre cómo Qwen Image 3.0 pro, un destacado competidor externo y su predecesor de la misma serie interpretan prompts idénticos en diseños con abundante tipografía y fotografía documental.
En un bullicioso bazar de especias al mediodía, captura el instante decisivo y humorístico en que un joven vendedor lanza al aire un áspero saco de arpillera lleno de azafrán, justo cuando una paloma desenfocada por el movimiento roza un montón de cúrcuma y envía una nube radiante de polvo dorado suspendida por toda la escena; los clientes sorprendidos reaccionan de forma natural y cómica: uno protege claramente varias granadas rojas y brillantes con ambas manos, mientras otro sostiene simultáneamente contra el pecho varios paquetes de especias de papel doblado, con cada brazo, mano, dedo, objeto e interacción anatómicamente correctos, diferenciados y fáciles de interpretar. Encuadra el mercado a través de arcadas de piedra superpuestas para crear una composición marcada de marco dentro del marco, usando un punto de vista ligeramente elevado y un ángulo holandés; bloques repetidos de chiles carmesí, cuencos de cerámica azul índigo intenso y montones de cúrcuma amarilla viva crean una paleta disciplinada limitada únicamente a los colores primarios rojo, amarillo y azul. La luz cenital dura y direccional del mediodía proyecta sombras geométricas nítidas sobre los puestos, los rostros y las desgastadas piedras del pavimento. Conserva el realismo táctil de los gránulos de polvo suspendidos en el aire, las fibras tejidas de la arpillera, los filamentos de azafrán con textura de papel, los montones de especias polvorientos, las balanzas de cobre martillado, la cerámica esmaltada, la veta de la madera envejecida, los paquetes de papel arrugado, la piel joven y natural y un sutil grano de película analógica. Incluye un letrero de tienda ancho y horizontal, pintado a mano, que diga exactamente «ESPECIAS, SOL Y SORPRESA» con letras grandes y perfectamente legibles, además de varios carteles de precios manuscritos independientes que digan exactamente «AZAFRÁN 12», «CÚRCUMA 4», «CHILES 6» y «GRANADAS 3», todos correctamente escritos, claramente formados e integrados de manera natural en el puesto. Fotografía documental de revista de viajes vintage de los años 70, calidez humana espontánea, realismo contenido, objetivo ambiental de 28 mm, enfoque profundo y estratificado con un borde de primer plano suavemente obstruido, ligero desenfoque de movimiento en la paloma, rostros y manos nítidos, exposición auténtica, sin poses, sin renderizado excesivamente aceitoso, sin aspecto HDR, sin piel plástica, sin colores turbios, sin brillo excesivo, sin iluminación épica de fantasía, sin paleta arcoíris desordenada, sin manos deformes, sin dedos adicionales, sin personas duplicadas, sin texto ilegible, sin bordes, sin maqueta, formato panorámico horizontal 16:9, a sangre.
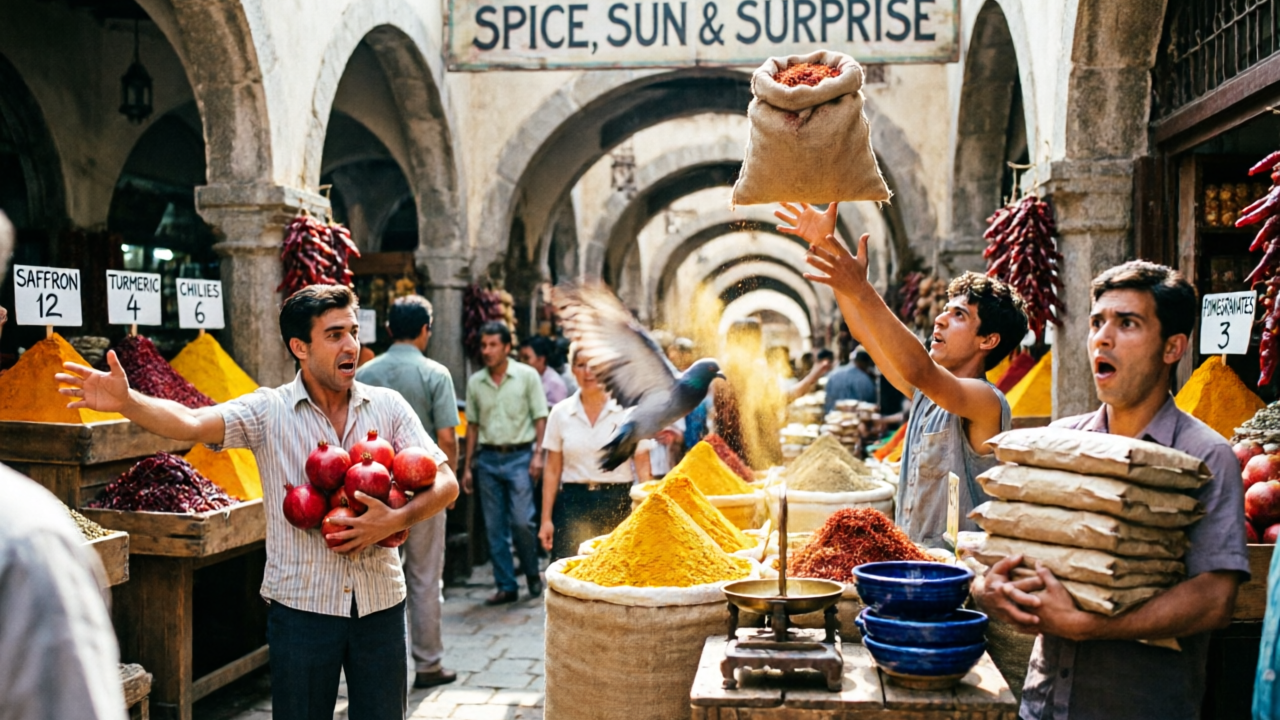
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
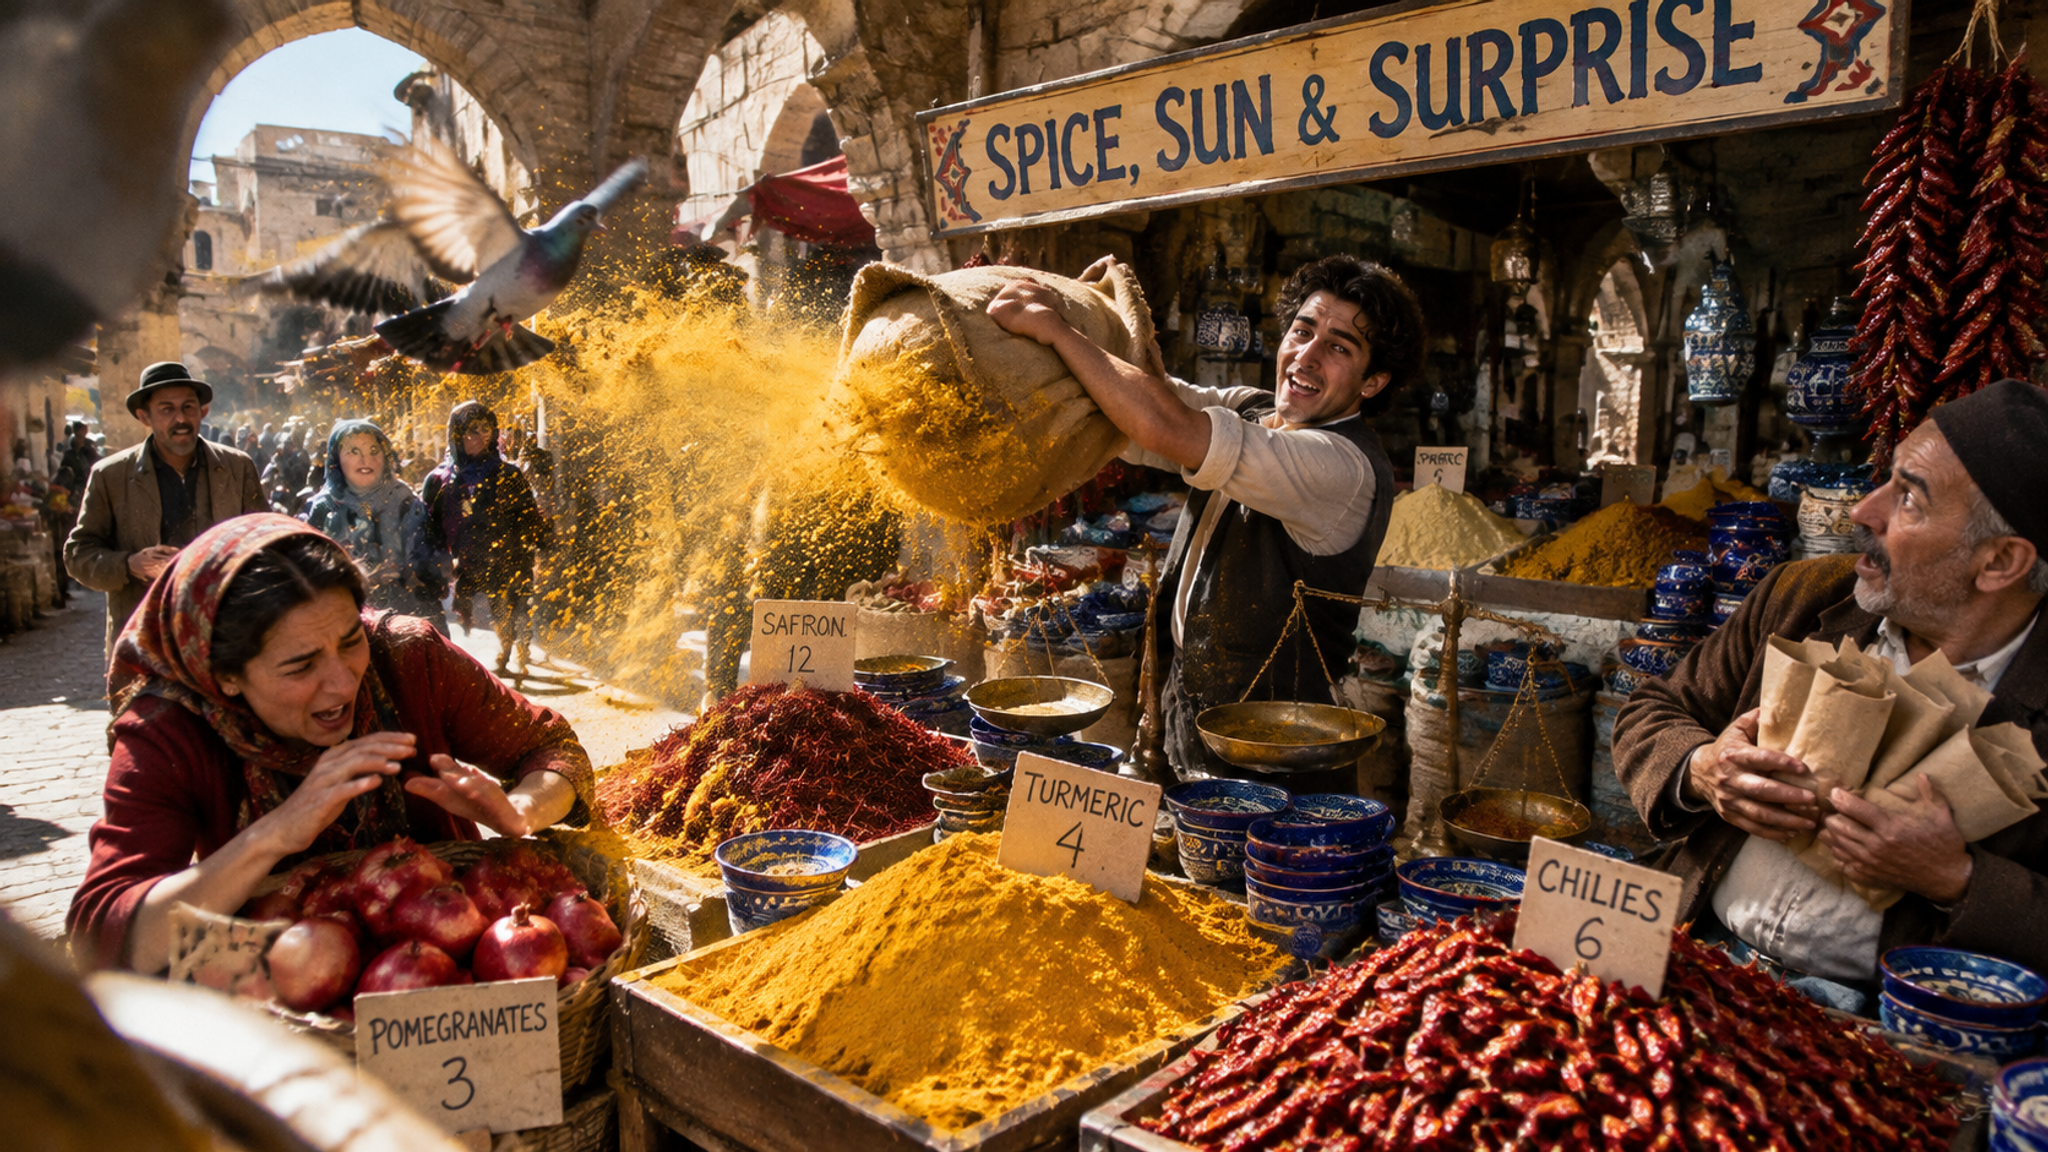
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
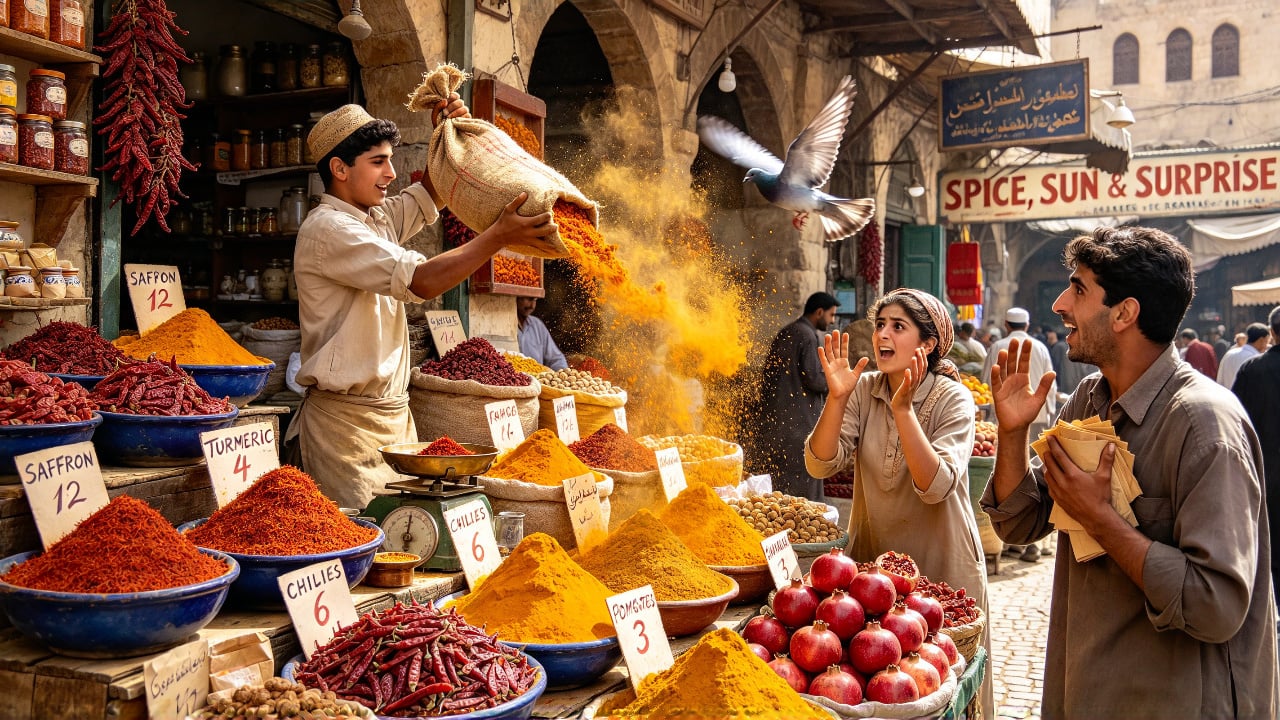
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
Fotografía documental cinematográfica en el interior de una lavandería autoservicio durante una noche lluviosa, capturando el instante decisivo en que una lavadora de carga frontal expulsa de repente una enorme cascada de espuma blanca; una joven con un impermeable amarillo brillante ríe espontáneamente mientras recoge el derrame con una palangana de plástico roja, sujetando el borde de forma natural con manos y dedos anatómicamente correctos, mientras su amiga permanece al otro lado del cristal empañado y escribe claramente con el dedo el texto exacto invertido en espejo «ÚLTIMO LAVADO 11:30», legible desde el interior de la lavandería; en ese mismo momento, un calcetín mojado golpea el cristal y queda pegado a él. Filas de puertas circulares de lavadoras crean una geometría repetitiva marcada y fuertes líneas de fuga hacia la profundidad, mientras los reflejos superpuestos en la ventana revelan tanto la acción juguetona del interior como la calle de neón empapada por la lluvia en el exterior, formando una narrativa doble y coherente. La luz direccional y fría de los fluorescentes del techo recorta siluetas nítidas y contornos limpios en los rostros, el impermeable, las manos, la espuma y el cromo; un neón magenta contenido se filtra por la ventana y se refleja en los charcos del pavimento, con una paleta disciplinada de tres colores: azul cian, amarillo vivo y magenta. Gotas de agua fotorrealistas sobre el cristal, burbujas translúcidas, tejido húmedo, metal cepillado, juntas de goma de las puertas, condensación, reflejos en los charcos, sutil desenfoque de movimiento en la espuma que salta, suave grano de película de alta sensibilidad, textura natural de piel joven, expresiones espontáneas, reflejos y superficies transparentes complejos pero espacialmente coherentes. Reportaje ambiental a la altura de los ojos, objetivo de 35 mm, profundidad de campo moderada, realismo cinematográfico, imperfecciones sutiles, sin poses preparadas, sin renderizado excesivamente grasiento, sin aspecto HDR, sin piel plástica, sin colores turbios, sin brillo excesivo, sin iluminación épica barata, formato panorámico horizontal 16:9, a sangre.
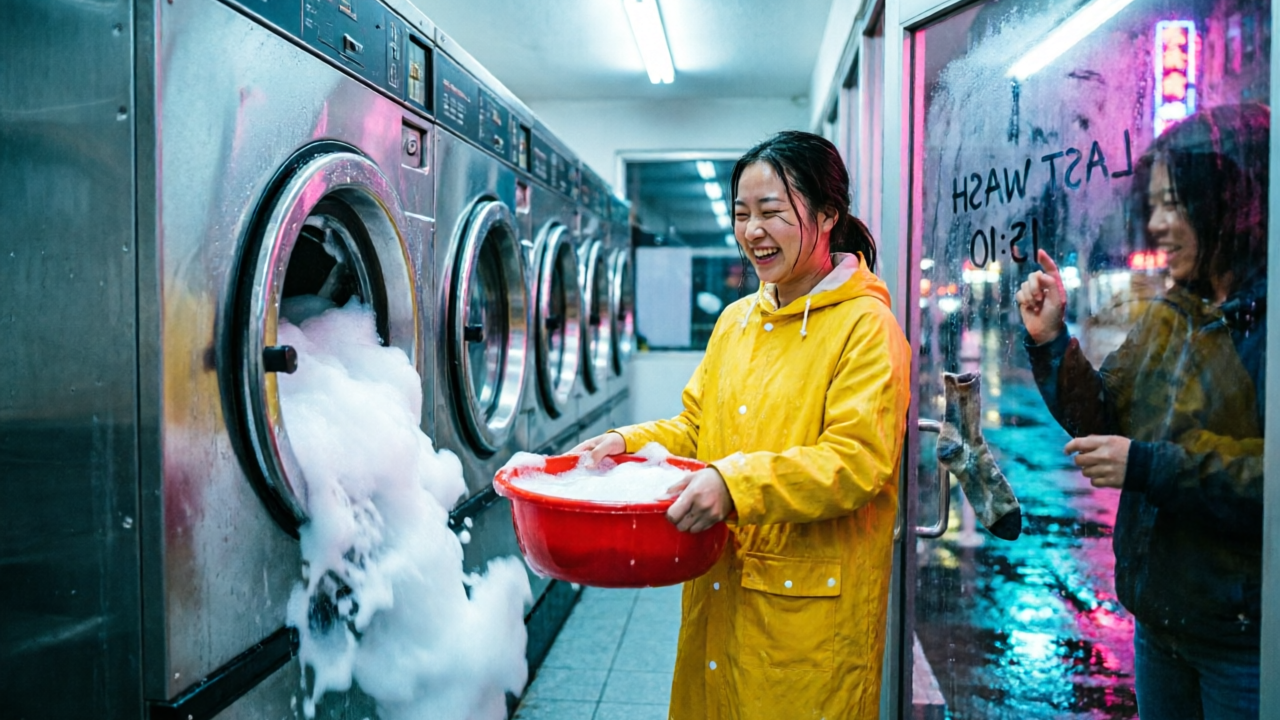
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
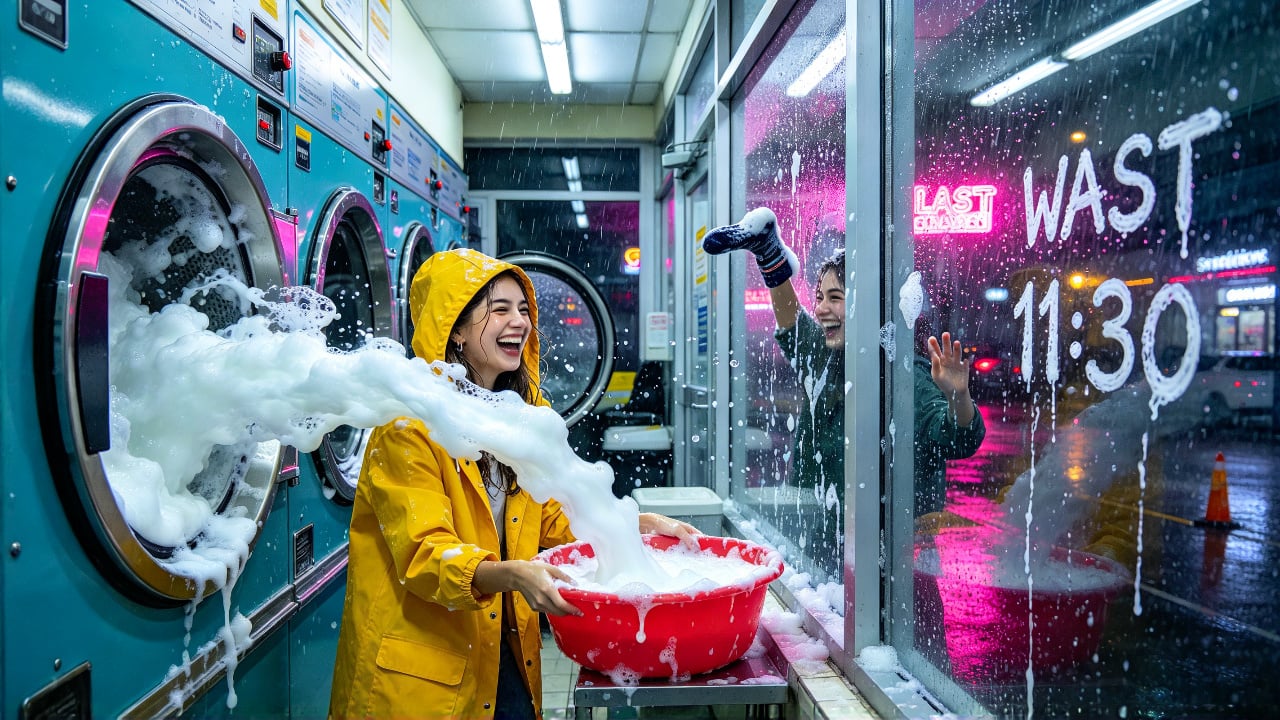
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
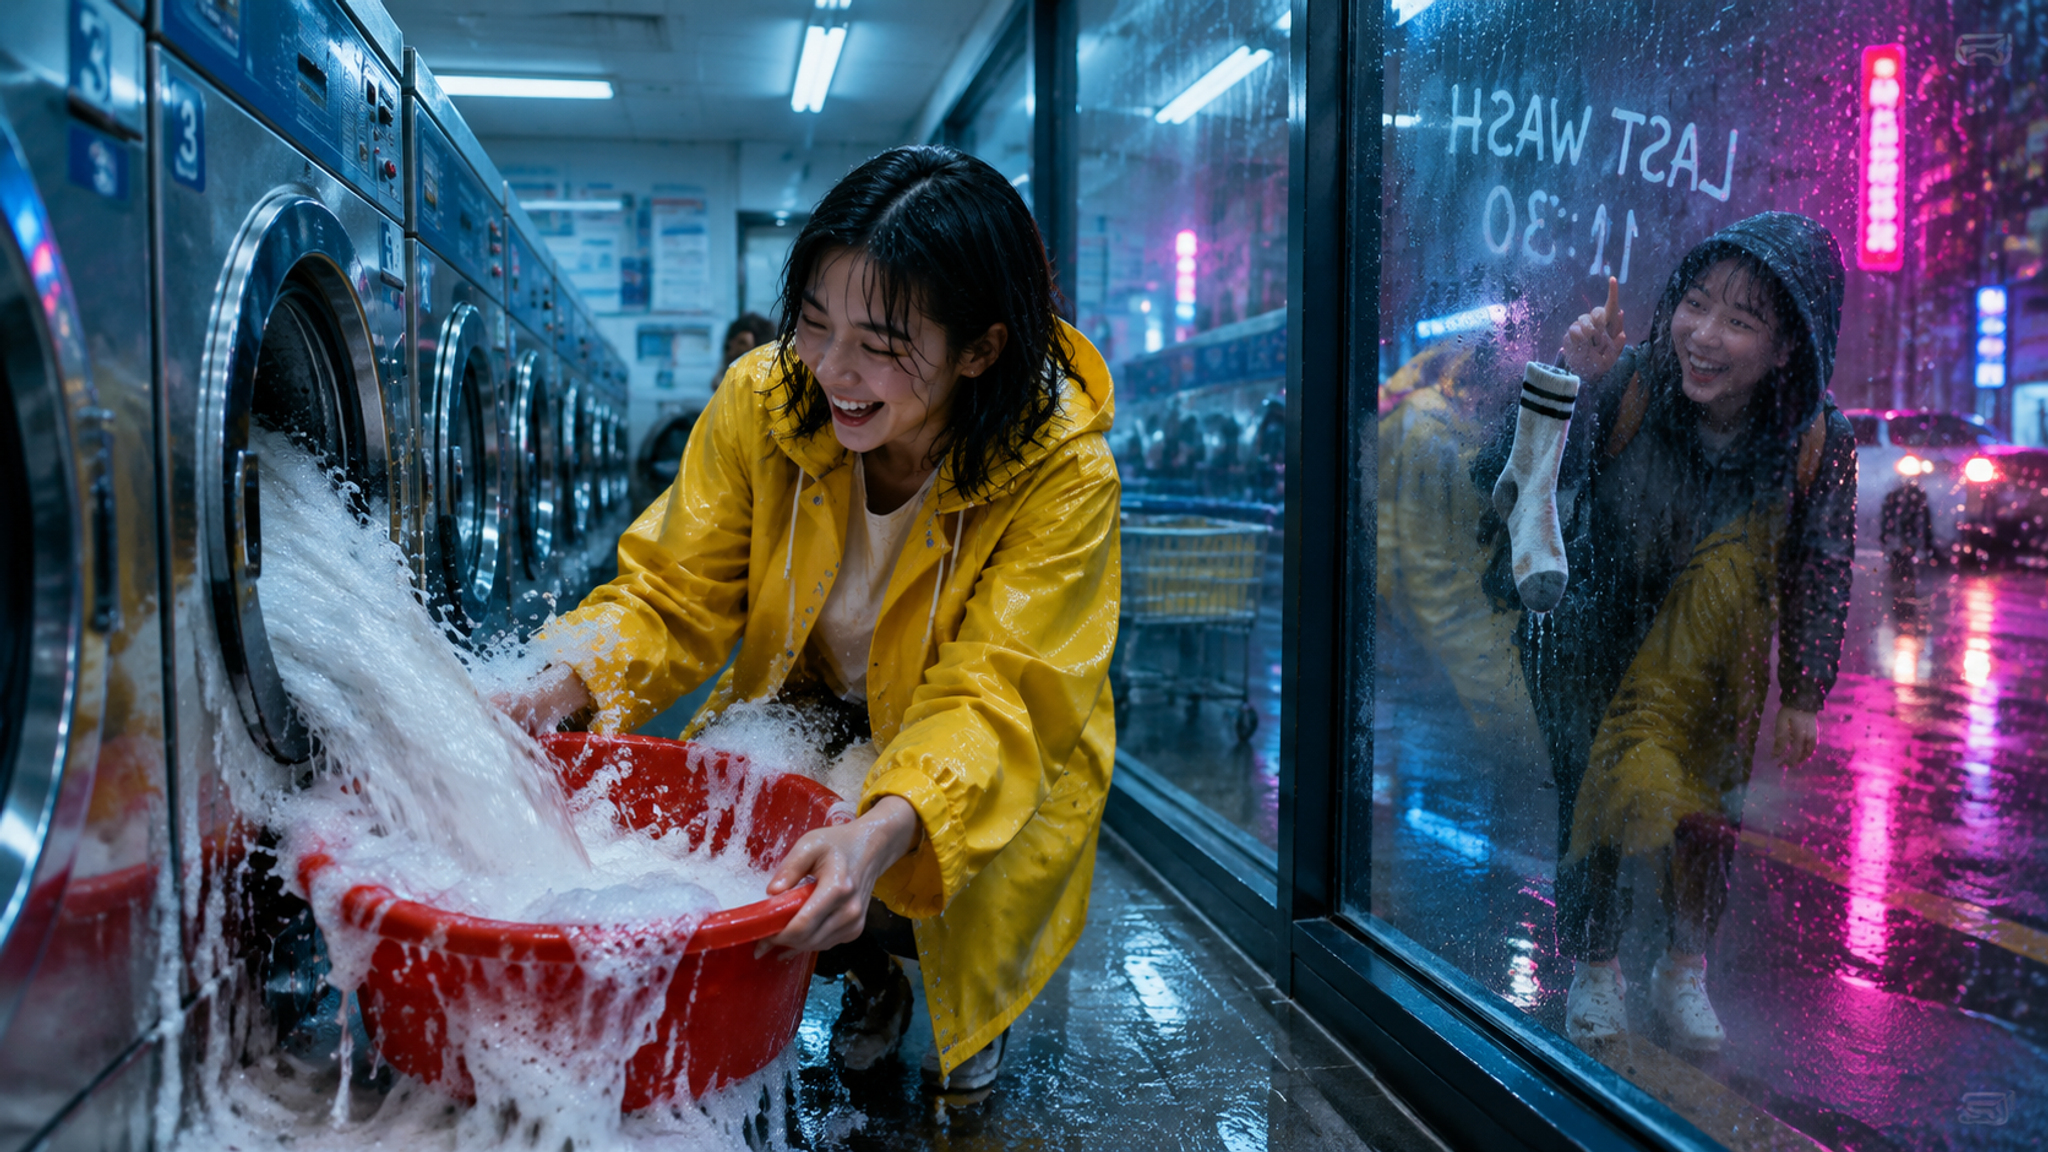
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
Crea sistemas visuales con Qwen Image 3.0 Pro
Qwen Image 3.0 Pro admite gráficos para campañas, imágenes de producto, conceptos de interfaces, storyboards y ediciones que preservan la identidad gracias al seguimiento preciso de instrucciones, la renderización de texto complejo, una salida de hasta 2048×2048 y de una a tres imágenes de referencia.

Pósteres de campaña con Qwen Image 3.0 Pro
Convierte prompts exigentes en pósteres de campaña, banners y gráficos para redes sociales aprovechando la capacidad de Qwen para renderizar texto complejo y seguir instrucciones con precisión. Crea recursos de marca de hasta 2048×2048 para lanzamientos, eventos y promociones.

Imágenes de producto con Qwen Image 3.0 Pro
Genera escenas de producto a partir de texto mientras la reescritura automática de prompts amplía ideas breves y el ajuste del tamaño guiado por el prompt selecciona un lienzo adecuado. El resultado admite imágenes de catálogo, promociones de ecommerce y pruebas rápidas de conceptos para equipos pequeños.

Ediciones de retratos que preservan la identidad
Preserva los rasgos faciales y la identidad mientras cambias la vestimenta, el entorno, la iluminación o el estilo visual mediante ediciones en lenguaje natural. Los estudios de retrato y las aplicaciones para creadores pueden producir variaciones de campaña reconocibles a partir de una a tres imágenes de referencia.

Conceptos de interfaces e infografías
¿Necesitas imágenes con mucha información a partir de instrucciones detalladas? Usa el seguimiento preciso de instrucciones y la renderización de texto complejo para crear prototipos de conceptos de interfaz, diagramas educativos, explicaciones anotadas y gráficos para presentaciones destinados a equipos de producto o aprendizaje.

Composiciones con múltiples referencias
Integra hasta tres imágenes de referencia en una sola solicitud de edición y, después, indica los cambios en lenguaje natural mientras los detalles clave permanecen intactos. Esto resulta adecuado para composiciones, variaciones de productos y flujos creativos centrados en personajes.

Storyboards con Qwen Image 3.0 Pro
Esboza escenas secuenciales a partir de prompts cuidadosamente redactados; el seguimiento de instrucciones ayuda a que cada fotograma respete los sujetos, entornos y la dirección visual solicitados. Cineastas, agencias y equipos de videojuegos pueden convertir sus primeras ideas en viñetas de storyboard.
Qwen Image 3.0 pro frente a las principales API de imágenes
Compara los endpoints de Qwen Image 3.0 pro, Seedream y Nano Banana según el flujo de trabajo, el tamaño máximo de salida, la capacidad de referencias, las herramientas para prompts y el precio estándar de Atlas Cloud.
| Modelo | Flujo de trabajo | Tamaño máximo de salida | Máximo de imágenes de referencia | Herramientas para prompts | Precio estándar |
|---|---|---|---|---|---|
| Qwen Image 3.0 Pro Text-to-Image | Texto a imagen | 2048×2048 | - | Reescritura automática del prompt | $0.04/image |
| Qwen Image 3.0 Pro Edit | Edición de imágenes | 1440×1440 | 3 | Reescritura automática del prompt | $0.04/image |
| Seedream v5.0 Pro Text-to-Image | Texto a imagen | Hasta 4.19 MP | - | Razonamiento y optimización del prompt | $0.045/image |
| Seedream v5.0 Pro Edit | Edición de imágenes | Hasta 4.19 MP | 10 | Razonamiento y optimización del prompt | $0.045/image |
| Nano Banana 2 Text-to-Image | Texto a imagen | 4K | - | Razonamiento y fundamentación mediante búsqueda | $0.08/image |
| Nano Banana 2 Edit | Edición de imágenes | 4K | 14 | Razonamiento y fundamentación mediante búsqueda | $0.08/image |
Cómo usar Qwen Image 3.0 Pro en Atlas Cloud
Empieza en minutos — sigue estos sencillos pasos para integrar y desplegar modelos a través de la plataforma de Atlas Cloud.
Crea una cuenta en Atlas Cloud
Regístrate en atlascloud.ai y completa la verificación. Los nuevos usuarios reciben créditos gratuitos para explorar la plataforma y probar modelos.
Por Qué Usar Qwen Image 3.0 Pro en Atlas Cloud
Combina modelos avanzados de Qwen Image 3.0 Pro con la plataforma acelerada por GPU de Atlas Cloud, proporcionando rendimiento, escalabilidad y experiencia de desarrollo incomparables.
Rendimiento y Flexibilidad
Baja Latencia:
Inferencia optimizada por GPU para respuestas en tiempo real.
API Unificada:
Una sola integración para acceder a Qwen Image 3.0 Pro, GPT, Gemini y DeepSeek.
Precios Transparentes:
Facturación por Token, soporta modo Serverless.
Empresa y Escala
Experiencia del Desarrollador:
SDK, análisis de datos, herramientas de ajuste fino y plantillas todo en uno.
Confiabilidad:
99.99% de disponibilidad, control de permisos RBAC, registros de cumplimiento.
Seguridad y Cumplimiento:
Certificación SOC 2 Type II, cumplimiento HIPAA, soberanía de datos en EE.UU.
Preguntas y respuestas sobre la API de Qwen Image 3.0 Pro
Qwen Image 3.0 Pro es el modelo de Alibaba para generar y editar imágenes a partir de texto o modificar imágenes existentes mediante instrucciones en lenguaje natural. En Atlas Cloud, admite resultados de hasta 2048×2048 y edición con entre una y tres imágenes de referencia.
Puedes usarlo para generar imágenes que requieran seguir instrucciones detalladas, representar texto complejo o producir resultados de alta resolución. En los flujos de edición, las instrucciones en lenguaje natural pueden modificar una imagen conservando detalles importantes, como los rasgos faciales y la identidad.
Elige la ruta de texto a imagen o de edición y, a continuación, llama al modelo mediante la API compatible con OpenAI de Atlas Cloud usando el ID de modelo correspondiente. Al construir y validar tu solicitud, toma como referencia principal el esquema de parámetros del Playground enlazado.
Selecciona qwen-image-3.0-pro/text-to-image para generar una imagen a partir de un prompt, o qwen-image-3.0-pro/edit para modificar imágenes de referencia. Ambas rutas tienen esquemas independientes en el Playground, así que usa el esquema asociado al flujo de trabajo elegido.
La generación de texto a imagen admite resoluciones de hasta 2048×2048. Cuando no se selecciona manualmente la resolución, el modelo puede utilizar el prompt para orientar su elección.
Proporciona entre una y tres imágenes de referencia junto con una instrucción de edición en lenguaje natural. El modelo de edición utiliza esas entradas para aplicar los cambios solicitados y conservar los detalles visuales clave, incluidos los rasgos faciales y la identidad.
Sí. El modelo de texto a imagen incluye la reescritura automática de prompts, además de la selección de resolución guiada por el prompt. Compara los resultados con tus instrucciones originales cuando sean importantes la redacción precisa, la composición o el texto integrado.
Atlas Cloud indica un precio base estándar de $0.04 por imagen para los modelos de texto a imagen y de edición. La facturación sigue un modelo de pago por uso, lo que permite a los desarrolladores utilizar cualquiera de los dos flujos sin comprometerse con una suscripción.
Ambas versiones admiten la generación de texto a imagen y la edición de imágenes. La descripción oficial de Alibaba presenta el modelo estándar como un equilibrio entre calidad y velocidad, pero las fuentes verificadas consultadas aquí no ofrecen una comparación cuantitativa con Pro. Prueba prompts representativos en ambas versiones antes de elegir una configuración predeterminada para producción.
Empieza con una imagen de referencia clara e indica explícitamente qué rasgos faciales o detalles de identidad deben permanecer sin cambios. El endpoint de edición admite hasta tres referencias y está diseñado para conservar esos detalles. Si la identidad sigue variando, simplifica la transformación solicitada y evalúa otra generación.
Explorar Más Series
Seedance 2.5
¡La API de Seedance 2.5 ya está disponible en Atlas Cloud! Ofrece a los desarrolladores el modelo de video más reciente de ByteDance. Genera hasta 30 segundos de video nativo en una sola pasada a partir de texto, una sola imagen o hasta 50 referencias multimodales, con audio sincronizado y texto multilingüe en el encuadre. En Atlas Cloud puede acceder a él mediante una única clave, con consistencia del sujeto y físicas mejoradas que mantienen la coherencia en las tomas largas.

Wan 3.0
La API Wan 3.0 es la próxima generación de la familia de videos Wan de Alibaba, diseñada para llevar la generación de formato largo, el control de múltiples referencias y la calidad audiovisual a nuevas alturas. Atlas Cloud ya aloja Wan 2.7, 2.6 y 2.5, y Wan 3.0 se ejecuta con la misma clave unificada sin necesidad de configuración adicional. Empieza a construir hoy mismo. Desplázate hacia abajo hasta la galería para ver lo que Wan 3.0 puede crear.
MiniMax H3
MiniMax H3 es la familia de vídeo multimodal de MiniMax para la creación guiada por texto, imagen y referencias. En las rutas compatibles, conserva los sujetos del material de referencia, ofrece relaciones de aspecto flexibles y combina el sonido generado con los elementos visuales mediante H3 Developer, con perfiles de salida seleccionados según el endpoint. Atlas Cloud reúne toda la familia bajo una única clave compatible con OpenAI, con precios transparentes de pago por uso a partir de la tarifa estándar de $0.038 por segundo. Empieza a crear hoy mismo.
Seedream 5.0 Pro
La API de Seedream 5.0 Pro ofrece a los desarrolladores el modelo de edición de imágenes controlable de ByteDance en Atlas Cloud. Sitúa las ediciones con precisión mediante anclajes y coordenadas, separa las imágenes en capas editables, fusiona múltiples referencias y empareja colores y materiales exactos, con texto multilingüe a 2K y 3K. ¡En Atlas Cloud puede acceder a él mediante una sola clave!
Seedance 2.0
Seedance 2.0 es el modelo de vídeo para producción de ByteDance, diseñado para crear planos con precisión. Convierte prompts en vídeo, anima una imagen del primer fotograma con orientación opcional del último fotograma o da forma a los resultados mediante medios de referencia y búsqueda web opcional. Atlas Cloud reúne estos flujos de trabajo en una única API unificada, con precios transparentes de pago por uso y una sola clave compatible con OpenAI. Empieza a crear hoy mismo.
GPT Image 2.5
La familia gpt-image-2.5 de OpenAI ofrece a los desarrolladores la posibilidad de elegir entre Flare y Sunburst para flujos de trabajo de producción de imágenes. Renderiza con resoluciones arbitrarias de hasta 3840x2160 y elige entre cinco niveles de calidad, incluidos xhigh y max, para adaptarte a requisitos de salida específicos. Atlas Cloud proporciona inferencia REST lista para usar, sin arranques en frío y con precios estándar desde $0.004 por generación. Empieza a crear hoy mismo.
GPT Image 2
La API de GPT Image 2 ofrece a los desarrolladores acceso al último modelo de imágenes de OpenAI, el sucesor de GPT Image 1.5. Genera y edita imágenes con una representación de texto precisa en caracteres latinos y CJK, además de una sólida composición para carteles, maquetas e infografías. En Atlas Cloud, puede acceder a ella a través de una API unificada junto con más de 300 modelos, con créditos gratuitos, un tiempo de actividad del 99,99% y sin necesidad de verificación de organización de OpenAI.
Gemini Omni Flash
La API de gemini omni pone a disposición de los desarrolladores la familia Gemini Omni Flash nativamente multimodal de Google DeepMind, incluido Gemini Omni 1.1 Flash. Crea vídeos cinematográficos con audio nativo sincronizado, anima imágenes estáticas con un control preciso de los fotogramas inicial y final, o revisa metraje existente mediante ediciones guiadas por texto que conservan el contenido no modificado. Atlas Cloud proporciona una única clave compatible con OpenAI, acceso unificado y precios transparentes de pago por uso. Empieza a desarrollar hoy mismo.
Grok Imagine
La API Grok Imagine cubre los modelos de imagen, video y voz de xAI, desde Image 2.0 hasta Video 1.5 y xAI TTS v1. Genera imágenes de 1K o 2K en 14 relaciones de aspecto, expande una escena a 15 segundos de movimiento en 1080p, controla tomas con hasta 7 imágenes de referencia, o nárralas en 20 idiomas. Atlas Cloud ejecuta todos los modos en un endpoint, con precios de pago por uso desde $0.02 por imagen y $0.05 por segundo. Empieza a construir hoy.
Los modelos creativos más potentes de Google están todos disponibles en Atlas Cloud. Veo 3.1 ofrece generación de video cinematográfico, Nano Banana 2 impulsa la creación de imágenes de alta fidelidad y Gemini aporta inteligencia multimodal a cada flujo de trabajo. Acceda a la suite completa de modelos de Google a través de una sola API key con disponibilidad Day-0 y precios de pago por uso (pay-as-you-go).
Seedance 2.0 Mini
Seedance 2.0 Mini lleva la generación de video multimodal de ByteDance a los flujos de trabajo donde la velocidad y el costo son más importantes. Ofrece las capacidades principales de Seedance 2.0 con un menor consumo de recursos: generación más rápida, menor costo por video y la misma integración de API que ya utiliza. Para los equipos que ejecutan pipelines de alto volumen o crean prototipos a escala, Mini es la opción predeterminada práctica.
ByteDance
Desde la generación de video cinematográfico hasta la creación de imágenes de alta fidelidad, los modelos más potentes de ByteDance están disponibles en Atlas Cloud. Ejecute Seedance y Seedream a gran escala con los precios de inferencia más bajos y cero gastos generales de infraestructura.
Artículos recomendados
Guías, tutoriales y novedades de producto para aprovechar al máximo Atlas Cloud.


