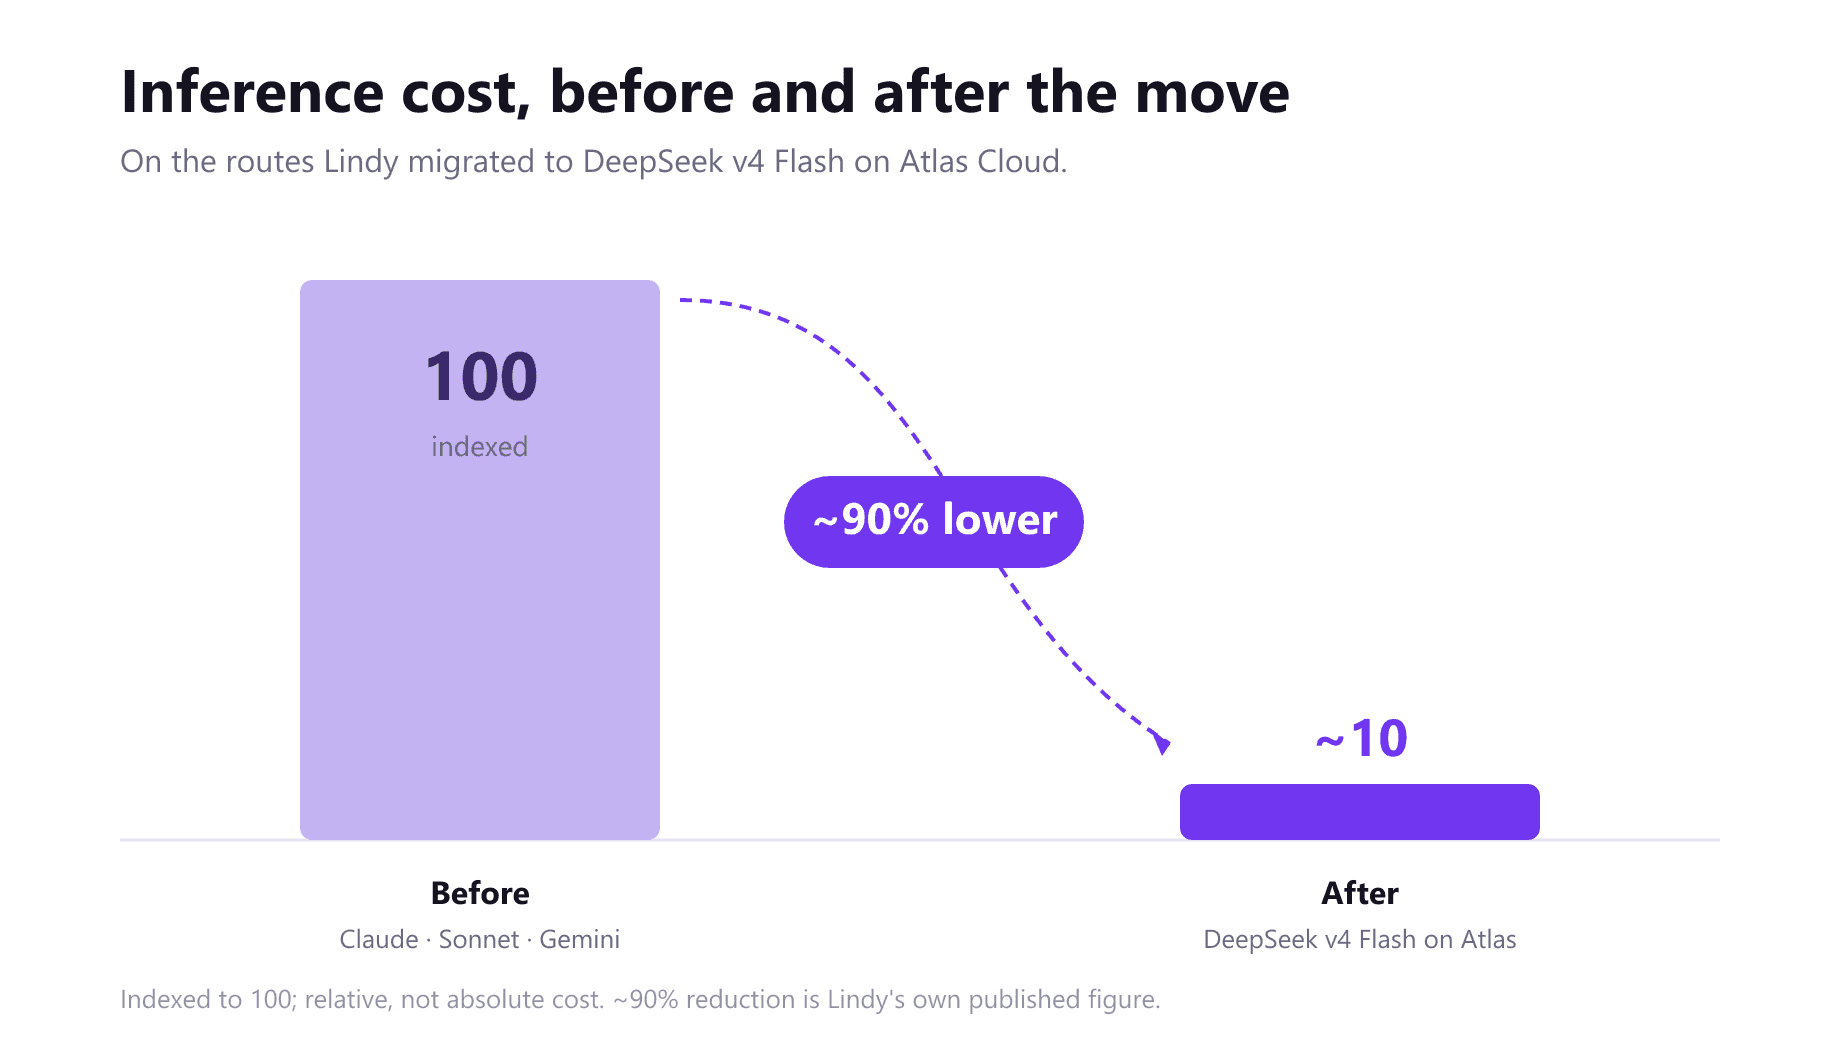
Lindy a créé l'employé IA. Elle a déplacé sa flotte sur des poids ouverts servis par Atlas Cloud, a réduit sa facture d'inférence d'environ 90 %, et ce, sans livrer un produit de moindre qualité.
~90 % de réduction des coûts d'inférence · 60 % des tokens d'entrée servis depuis le cache · 3 000+ requêtes par minute en continu · 10x+ de croissance du trafic, sans rien reconstruire · 24 modèles de 11 laboratoires sur une seule clé
Lindy exécute l'une des charges de travail agent les plus exigeantes en production, et elle tourne sur Atlas Cloud. Voici ce que cela a changé :
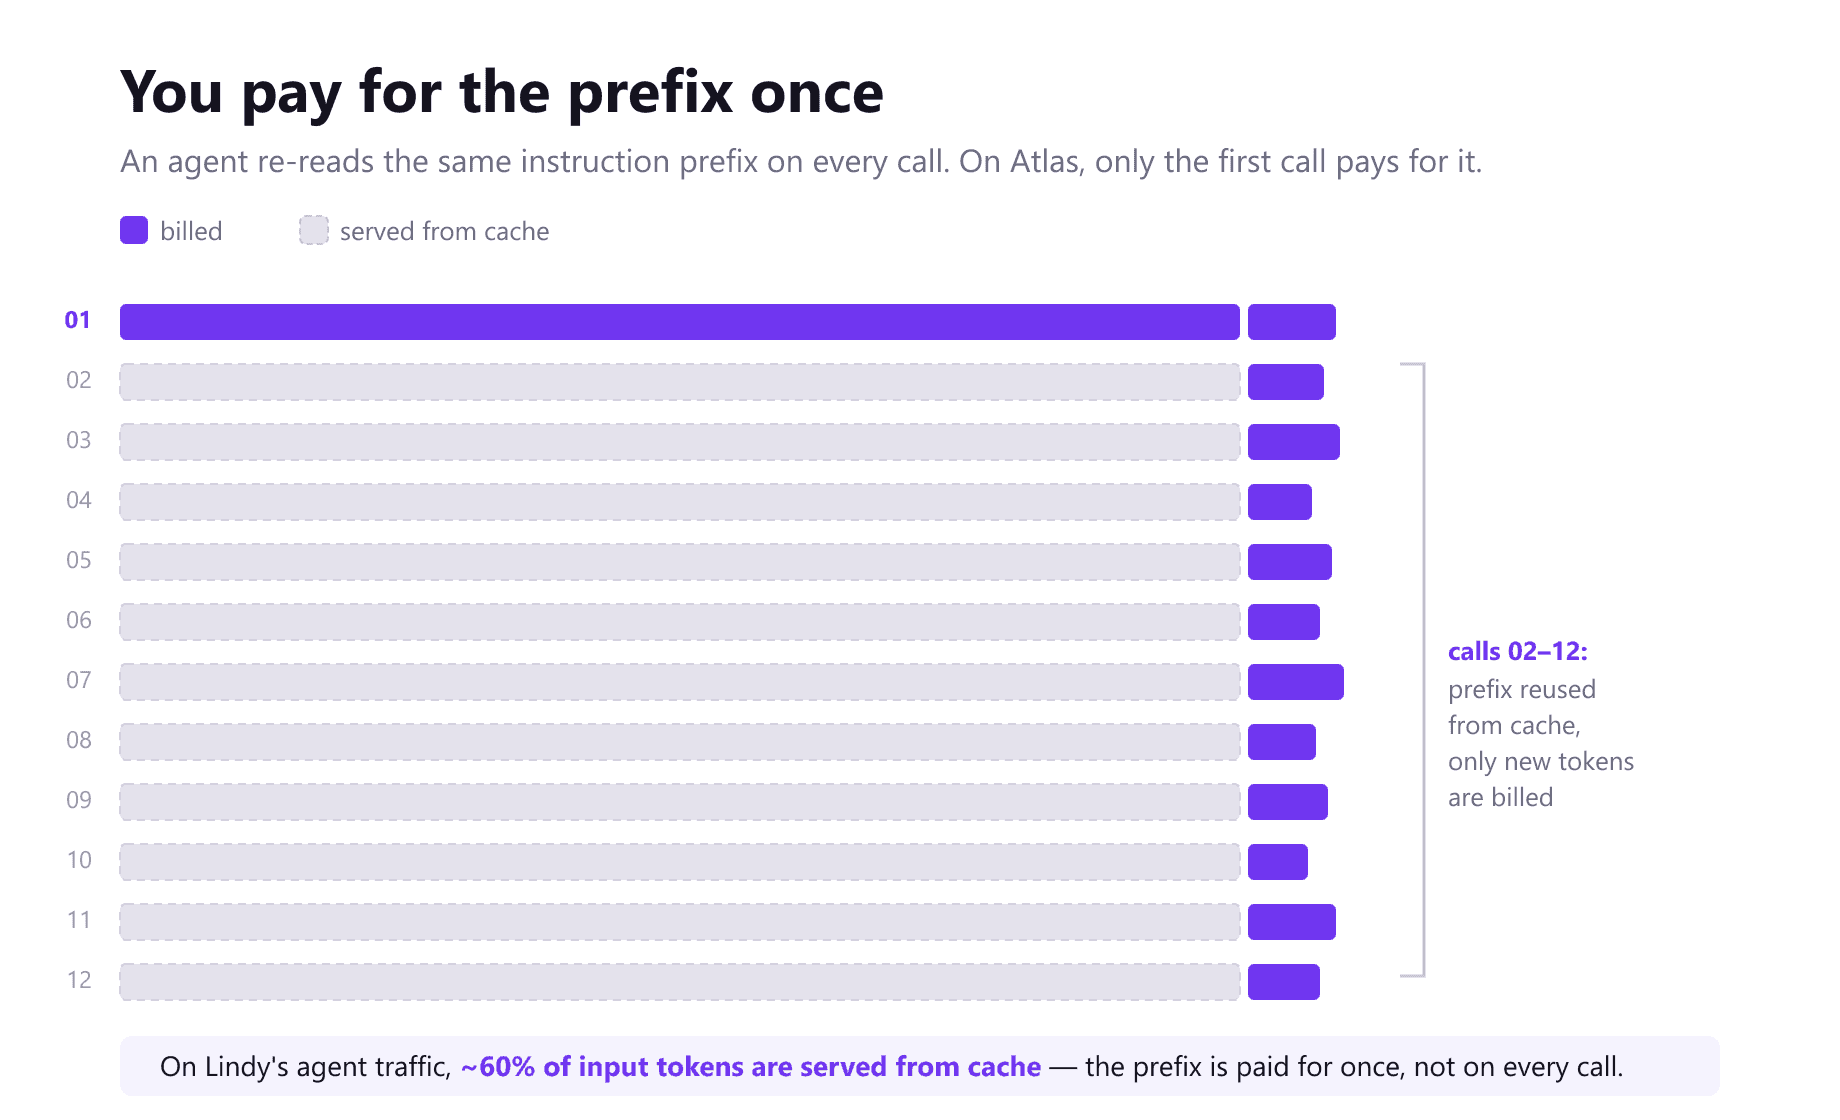
- Parce qu'Atlas facture l'appel répété au tarif du cache, Lindy déploie des agents qui vérifient leur travail plutôt que de deviner. Six de ses dix tokens d'entrée sont servis depuis le cache, si bien que le préfixe qu'un agent relit une douzaine de fois par tâche ne coûte presque rien.
- Parce qu'Atlas provisionne la charge de travail, Lindy a décuplé son volume en envoyant simplement plus de trafic, sans rien reconstruire, et Atlas maintient plus de 3 000 requêtes par minute pendant une heure d'affilée.
- Parce qu'Atlas porte tout le catalogue sur une seule clé, Lindy peut passer à un nouveau modèle en une après-midi. Elle a ainsi utilisé 24 modèles de 11 laboratoires via une seule intégration.
- Parce qu'Atlas le sert sur un contrat nominatif certifié SOC 2, Lindy peut placer un modèle open-weight devant les données de ses clients et répondre de qui l'exécute.
Les 90 % constituent le gros titre de Lindy. Ce qui fait que ça tient, et que la prochaine migration sera plus simple que celle-ci, c'est la plateforme sous-jacente.
Pour Lindy, la facture est le cœur du métier
Lindy conçoit des employés IA. Un Lindy Teammate intègre une entreprise comme un nouvel embauché : il reçoit des requêtes dans Slack, se connecte aux outils déjà d'utilisation de l'équipe, participe aux réunions et conserve ce qu'il apprend pour que la demande suivante démarre du bon pied. Personne n'écrit une automatisation ; ils délèguent, et l'agent fait le travail.
Cette conception impose une infrastructure robuste. Un employé IA qui lit un fil, vérifie un calendrier, recherche un enregistrement et rédige une réponse effectuera des dizaines d'appels de modèle avant que quiconque voie un seul mot. Et comme un Teammate sert toute une équipe, le volume augmente avec l'effectif. Dans cet contexte, le prix du modèle derrière le produit détermine la viabilité de l'entreprise.
"La tarification de Lindy n'est viable que si l'inférence devient de mère en mieux."
— Bruno Škvorc, Ingénieur logiciel principal, Lindy
Lindy a donc fait ce que les chiffres de la finance imposent. Elle a transféré la majorité de son trafic d'agents gérés de Claude, Sonnet et Gemini vers DeepSeek v4 Flash exécuté sur Atlas Cloud, et les coûts d'inférence des routes migrées ont baissé d'environ 90 % (lien). Le changement nom de modèle a pris une après-midi. Ce qui le rend durable, à l'échelle de production, sans dégrader le produit, c'est pourquoi ils ont choisi Atlas Cloud.
Pourquoi les 90 % tiennent : la onzième appel est quasi gratuite
Facturée au token, un agent paie le même préfixe une douzaine de fois par tâche, et la facture augmente avec la minutie de la réflexion. Cette taxe est ce qui maintient les produits d'agents peu profonds : un seul passage plutôt que trois, car le troisième coûte autant que le premier. C'est aussi pourquoi un échange simple de modèle donne moins que ce que le délit de vient économique suggère, le préfixe répété remplissant rapidement la facture.
Atlas supprime la taxe là où elle est la plus lourde. Six de ses dix tokens d'entrée de Lindy sont reconnus plutôt que reprocessés, au taux garanti par son volume réel, de sorte que le préfixe qui domine chaque appel d'agent est presque gratuit. C'est ce qui transforme un changement de modèle en 90 % durable plutôt qu'en chiffre qui s'érode à mesure que l'utilisation augmente, et c'est ce qui permet à un agent sur Atlas de faire trois passages là où un même agent, facturé au token, n'en ferait qu'un.
„Les workloads d'agents réutilisent beaucoup de contexte sur de nombreux appels de modèle. Le cache d'Atlas signifie que nous ne payons pas le même contexte en totalité à chaque fois, ce qui est une des principales raisons pour lesquelles les économies ont tenu à l'échelle."
— Ian McGregor, Chef du développement, Lindy
Une capacité qui était là avant d'être nécessaire
Le trafic des agents n'a pas de fenêtre de nuit silencieuse ni de jour de lancement à planifier. Le travail arrive pendant les heures de bureau et ne cesse pas pour vous permettre de monter en charge. Ce qui compte n'est pas le pic qu'un tampon peut absorber, mais le débit que le fournisseur peut maintenir constant. Lindy a fait croître son volume de plus d'un facteur dix en envoyant plus de trafic, sans rien reconstruire, et Atlas a maintenu plus de 3 000 requêtes par minute pendant une heure d'affilée. La capacité était en avance sur la charge, donc monter en charge était une décision commerciale, jamais un projet d'infrastructure.
Support qui livre du produit, pas des tickets
À ce volume, la différence entre les fournisseurs est moins dans le tableau de bord que dans qui répond quand quelque chose semble anormal. Les ingénieurs de Lindy et ceux d'Atlas travaillent sur un canal commun, et les réponses arrivent le même jour de la part de personnes qui peuvent agir. Certaines deviennent des modifications de produit : Lindy a demandé un moyen de transférer la propriété d'un compte d'équipe, Atlas ne le soutenait pas à l'époque, et cela a été livré, les ingénieurs d'Atlas ayant eux-mêmes déplacé le compte.
Un prestataire que l'on peut nommer
Passer à un modèle à poids ouvrable supprime la partie qui devait auparavant répondre de l'exécution du modèle. Les questions que la marque du laboratoire réglaient autrefois sont désormais pointées vers le fournisseur : qui sert ceci, sous quels contrôles, et que devient-il des données qui transitaient ? Atlas répond par son nom, et non par un routeur, sur un contrat certifié SOC ، avec les données clients ni stockées ni utilisées pour l'entraînement. C'est plus important pour un employé IA que pour un produit de discussion, car un Teleprend ) lit les fils Slack, les calendriers et les dossiers de l'entreprise pour laquelle il travaille. La question de l'infrastructure se trouve exactement sous la question de confiance du client, et Atlas répond aux deux.
Pas un obstacle : véritable fluidité opérationnelle
La migration a engagé Lindy à une stratégie, non pas à un modèle. DeepSeek v4 Flash a remporté les charges testées et conserve son poste tant qu'il est le meilleur rapport qualité-prix à qualité suffisante. Le prochain gagnant viendra d'un autre laboratoire, sous une autre licence, et comme Atlas Cloud donne accès à tous les modèles via une seule API, l'essai coûte une après-midi plutôt qu'un processus d'approvisionnement. En une journée de test, Lindy a envoyé 47 demandes via douze modèles qu'elle n'avait jamais utilisés , sur sept laboratoires et autour de trois modes, avec clé déjà existante. Trois sont devenus des bases de production. La liberté d'exécuter toujours le meilleur modèle via Atlas Cloud donne à Lindy une véritable fluidité opé.
Si vous déployez des agents sur une place de marché, déplacez-les
Lindy a suivi ce chemin exact. Elle a fait sa connaissance de DeepSeek d'abord sur OpenRouter, exécuté le modèle dans ses évaluations et prouvé qu'il valait la peine de le migrer. Dans ce test, elle a découvert ce qui déciderait pour où se déroulerait la production.
"Nous avons également testé le même modèle sur différents fournisseurs d'inférence. Bien curieusement, le fournisseur comptait. Le même modèle nominal pouvait obtenir différents scores selon qui le servait."
— Bruno Škvr, Ingénieur logiciel, Lindy
Une place de marché est faite pour vous accèder, non pour faire tourner votre produit. Envoyer du trafic de production à travers un routeur et il va vers un fournisseur ayant de la capacité disponible, vous ne choisissez donc pas qui sert votre modèle et vous ne pouvez pas voir qui l'a servi. Les mêmes poids sur des machines différentes donnent des valeurs différentes, selon la quantification ou une simplification de la infrastructure de service. Elles atteignent vos utilisateurs avant vos au etc. Chaque saut de réseau fait osciller la qualité du produit pourquoi vos clients paient. Vous ne pouvez pas le pour, car vous ne voyez pas qui a servi la requête. Vous ne pouvez pas la corriger, car vous n'avez pas de contrôle total sur l'acheminement. C'est votre réputation, sort celle d'une pièce que vous ne pouvez jamais retourner.
Donc Lindy n'a pas déployé sa production sur OpenRouter. Quand le trafic est devenu réel, il est passé sur un contrat direct avec Atlas : une pile de service unique pour chaque requête, réglée pour le modèle, tenu par un contrat, avec le caching et la capacité nécessaires pour une charge agent vivante, et tout le catalogue sur la même clé. Si vos agents sont en production et passent encore par un routeur, vous servez un produit que vous ne pouvez pas maintenir stable, sans le savoir jusqu'à ce qu'un client le remarque. Déplacez-les, comme Lindy l'a fait.
Parlez-nous de votre workload puis nous vous dirons combien cela devrait coûter, ou parcourez le catalogue.
À propos de Lindy
Lindy crée des participants IA. Lindy Meme, lancé en août 2026, travaille aux côtés d’une équipe humaine : il accepte des requêtes dans Slack, se connecte aux outils d’entreprise existants, participe aux réunions et construit le même contexte de l’équipe pour que chaque demande commence plus loin. Plutôt que de demander aux gens de construire et de maintenir des opérations Béas, Lindy leur demande de déléguer. Lindy a été fondé par Flo Crivello et est un groupe à San Francisco.
À propos d’Atlas Cloud
Atlas Cloud est une plateforme IA multimodale unifiée : plus de 400 modèles (vidéo, image, langage, audio) à travers une seule clé d’API, un seul point d'accès, et un seul compte de facturation, compatible OpenAI pour les modèles de langage. Certifiée SOC 2 et HIPAA.**


