
Kimi API for Vision-to-Code Generation
L’API Kimi est la gamme K2 à poids ouverts de Moonshot AI, du K2.5 nativement multimodal au K2.7 Code spécialisé dans le codage. Comme la vision est intégrée au modèle, vous pouvez transformer des captures d’écran, des maquettes d’interface utilisateur et de courtes vidéos en code frontend fonctionnel, coordonner jusqu’à 100 sous-agents parallèles et raisonner sur un contexte de 256K tokens. Atlas Cloud propose toute la famille via un endpoint unifié, avec une tarification transparente à l’usage. Commencez à développer dès aujourd’hui.
Kimi est développé par Moonshot AI. Atlas Cloud (exploité par Atlas Cloud AI LLC) en fournit l’accès mais n’en est pas propriétaire. Toutes les marques appartiennent à leurs détenteurs respectifs.
Explorez les Modèles Leaders
Atlas Cloud vous offre les derniers modèles créatifs de pointe de l'industrie.

Associer votre charge de travail au bon modèle Kimi API
Comparez d’un coup d’œil l’objectif de chaque endpoint Kimi et sa tarification standard par million de tokens.
| Modalité | Description |
|---|---|
| Kimi K2.7 Code API (texte vers texte) | Conçu spécialement pour les travaux d’ingénierie, cet endpoint transforme les prompts en langage naturel et les fichiers source existants en code fonctionnel, correctifs et automatisations pour développeurs. Il cible la programmation, le débogage et les workflows de développement avec l’IA où la génération de code fiable est prioritaire, avec une facturation standard de $0.95 par million de tokens d’entrée et de $4 par million de tokens de sortie. |
| Kimi K2.6 API (texte vers texte) | Fournissez-lui des prompts textuels, et Kimi K2.6 renvoie des réponses raisonnées, du code et des sorties structurées pour les tâches de productivité quotidiennes. Optimisé à la fois pour le raisonnement et le codage, il convient aux équipes qui souhaitent un modèle généraliste unique pour l’analyse, la rédaction et le développement logiciel, avec une entrée mise en cache facturée $0.16 par million de tokens pour les contextes répétés. |
| Kimi K2.5 API (texte vers texte) | Lorsqu’une tâche couvre de longs documents ou des pipelines en plusieurs étapes, Kimi K2.5 ingère des entrées textuelles étendues et renvoie des réponses cohérentes, tenant compte du contexte. Conçu pour la compréhension de longs contextes et les workflows intelligents, il repose sur une tarification transparente à l’usage de $0.60 par million de tokens d’entrée et de $3 par million de tokens de sortie, afin de rendre l’analyse à grande échelle rentable. |
L’API Kimi, d’un contexte de 256K à des essaims de 300 agents
L’API Kimi met les modèles K2 à mille milliards de paramètres de Moonshot AI à disposition via un endpoint unique, en combinant une fenêtre de contexte de 262,144 tokens avec une entrée native image et vidéo, des essaims d’agents autonomes et des modèles spécialisés optimisés pour le codage, le débogage et le raisonnement à long horizon.
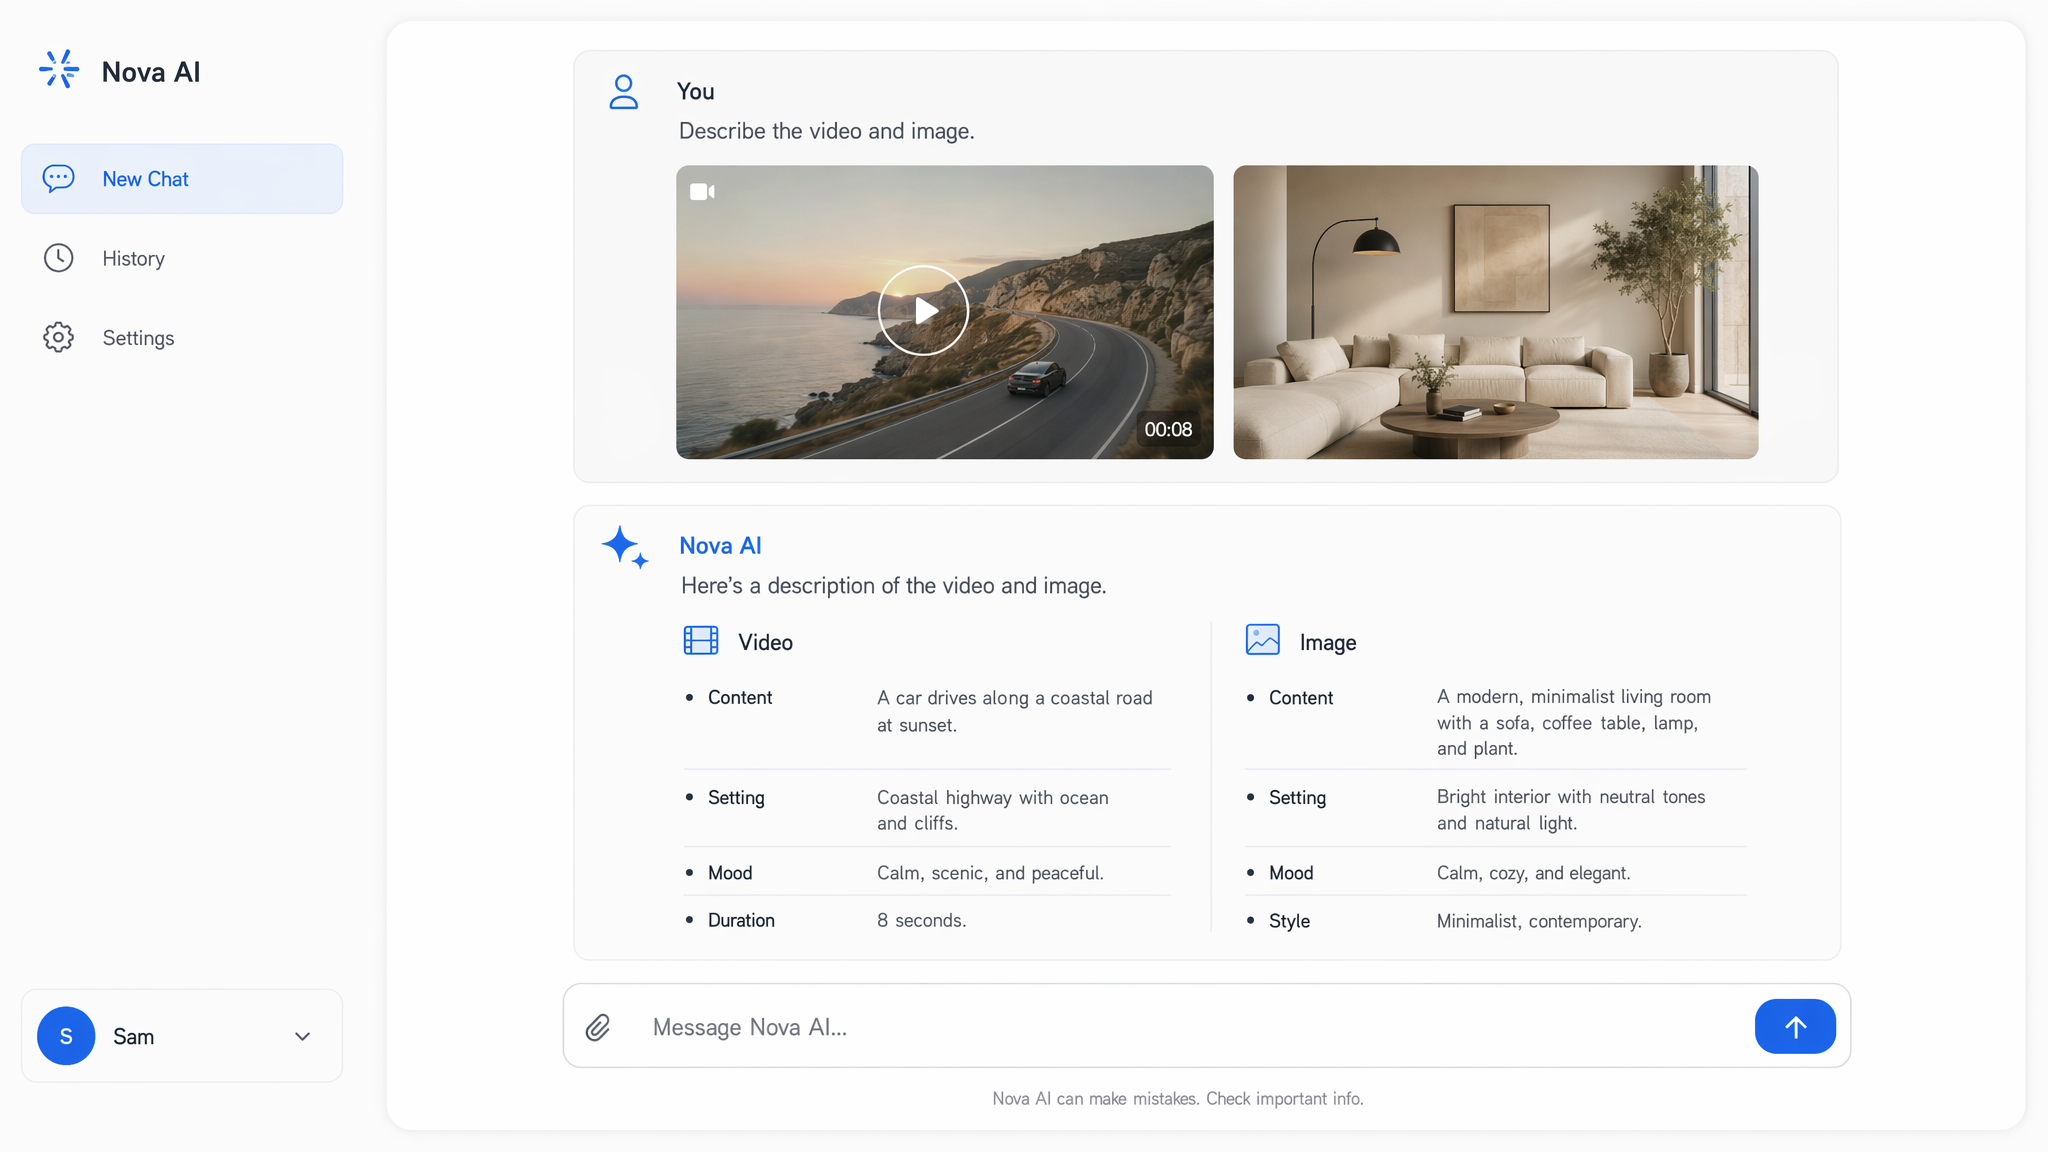
Compréhension native des images et des vidéos
K2.6 traite le texte, les images et la vidéo au sein d’une même architecture multimodale native, en acceptant des formats allant de PNG et WebP à MP4, MOV et WebM, sans plugins externes. Son encodeur de vision MoonViT lit directement les enregistrements d’écran, les fichiers de design et les schémas. Là où K2.5 gérait déjà le texte et les images, K2.6 étend la même pile à la compréhension complète de la vidéo, si bien que le contexte visuel devient simplement une entrée de plus.
Essaims d’agents autonomes via l’API Kimi
L’API Kimi expose un essaim d’agents autonomes capable de monter jusqu’à 300 sous-agents travaillant sur environ 4,000 étapes coordonnées. Plutôt que de raisonner sur un seul fil, K2.6 décompose un objectif global en branches parallèles et les orchestre jusqu’à leur achèvement. Chaque sous-agent prend en charge sa propre portion de la tâche, puis remonte ses résultats dans le plan partagé. Cette conception convient à l’automatisation à long horizon, lorsque le projet s’étend sur de nombreuses étapes dépendantes les unes des autres.
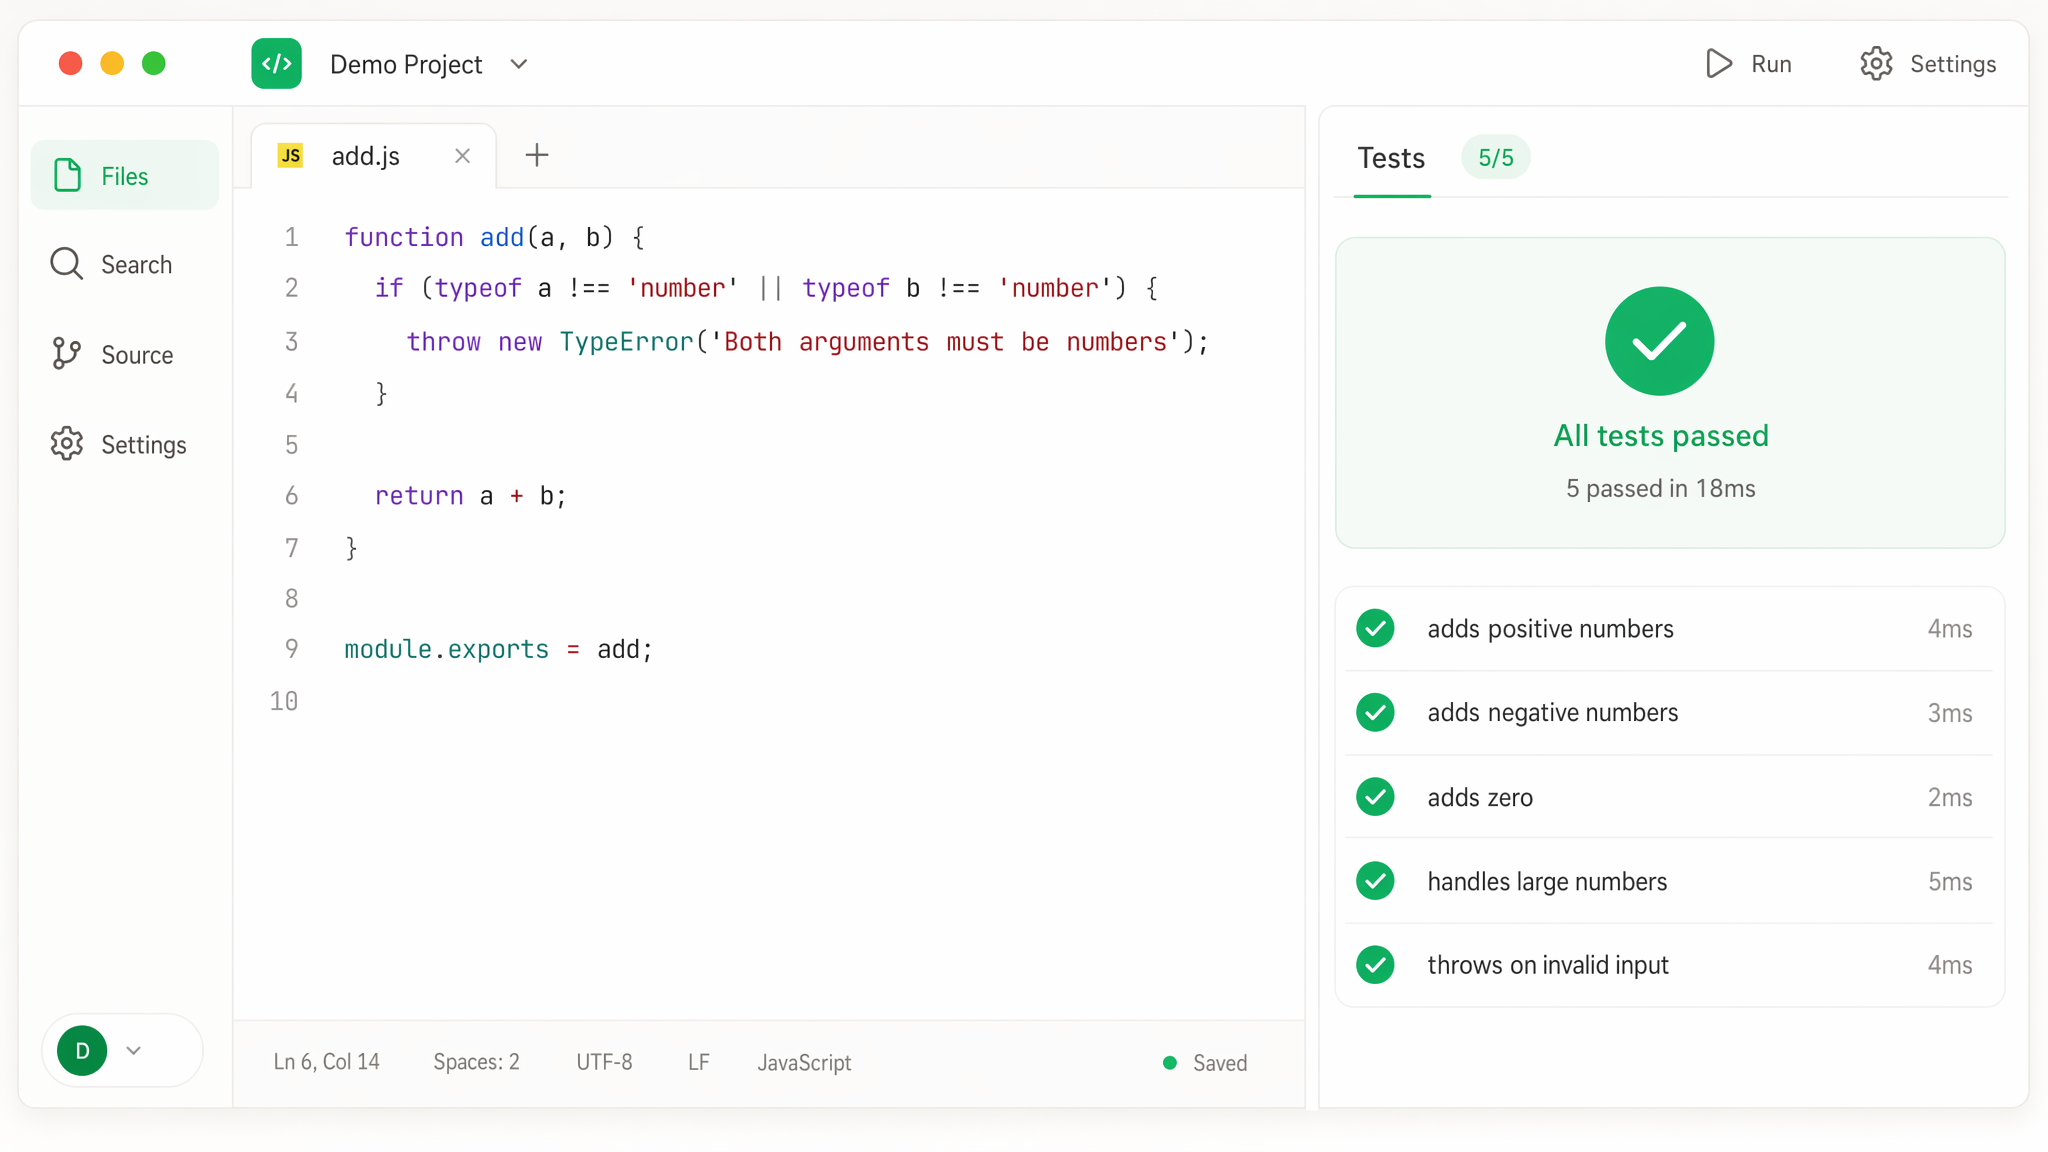
Codage et débogage intégrés
Le codage est au cœur de la famille, avec Kimi K2.7 Code conçu spécifiquement pour la programmation, le débogage et les workflows d’agents développeurs. Sur le benchmark de codage SWE-Bench Pro, K2.6 atteint 58.6, dépassant de peu plusieurs modèles frontier sur des correctifs de dépôts réels. Orientez l’un ou l’autre modèle vers une suite de tests en échec : il remonte à la cause du problème, propose un patch et itère jusqu’à ce que le build repasse au vert.
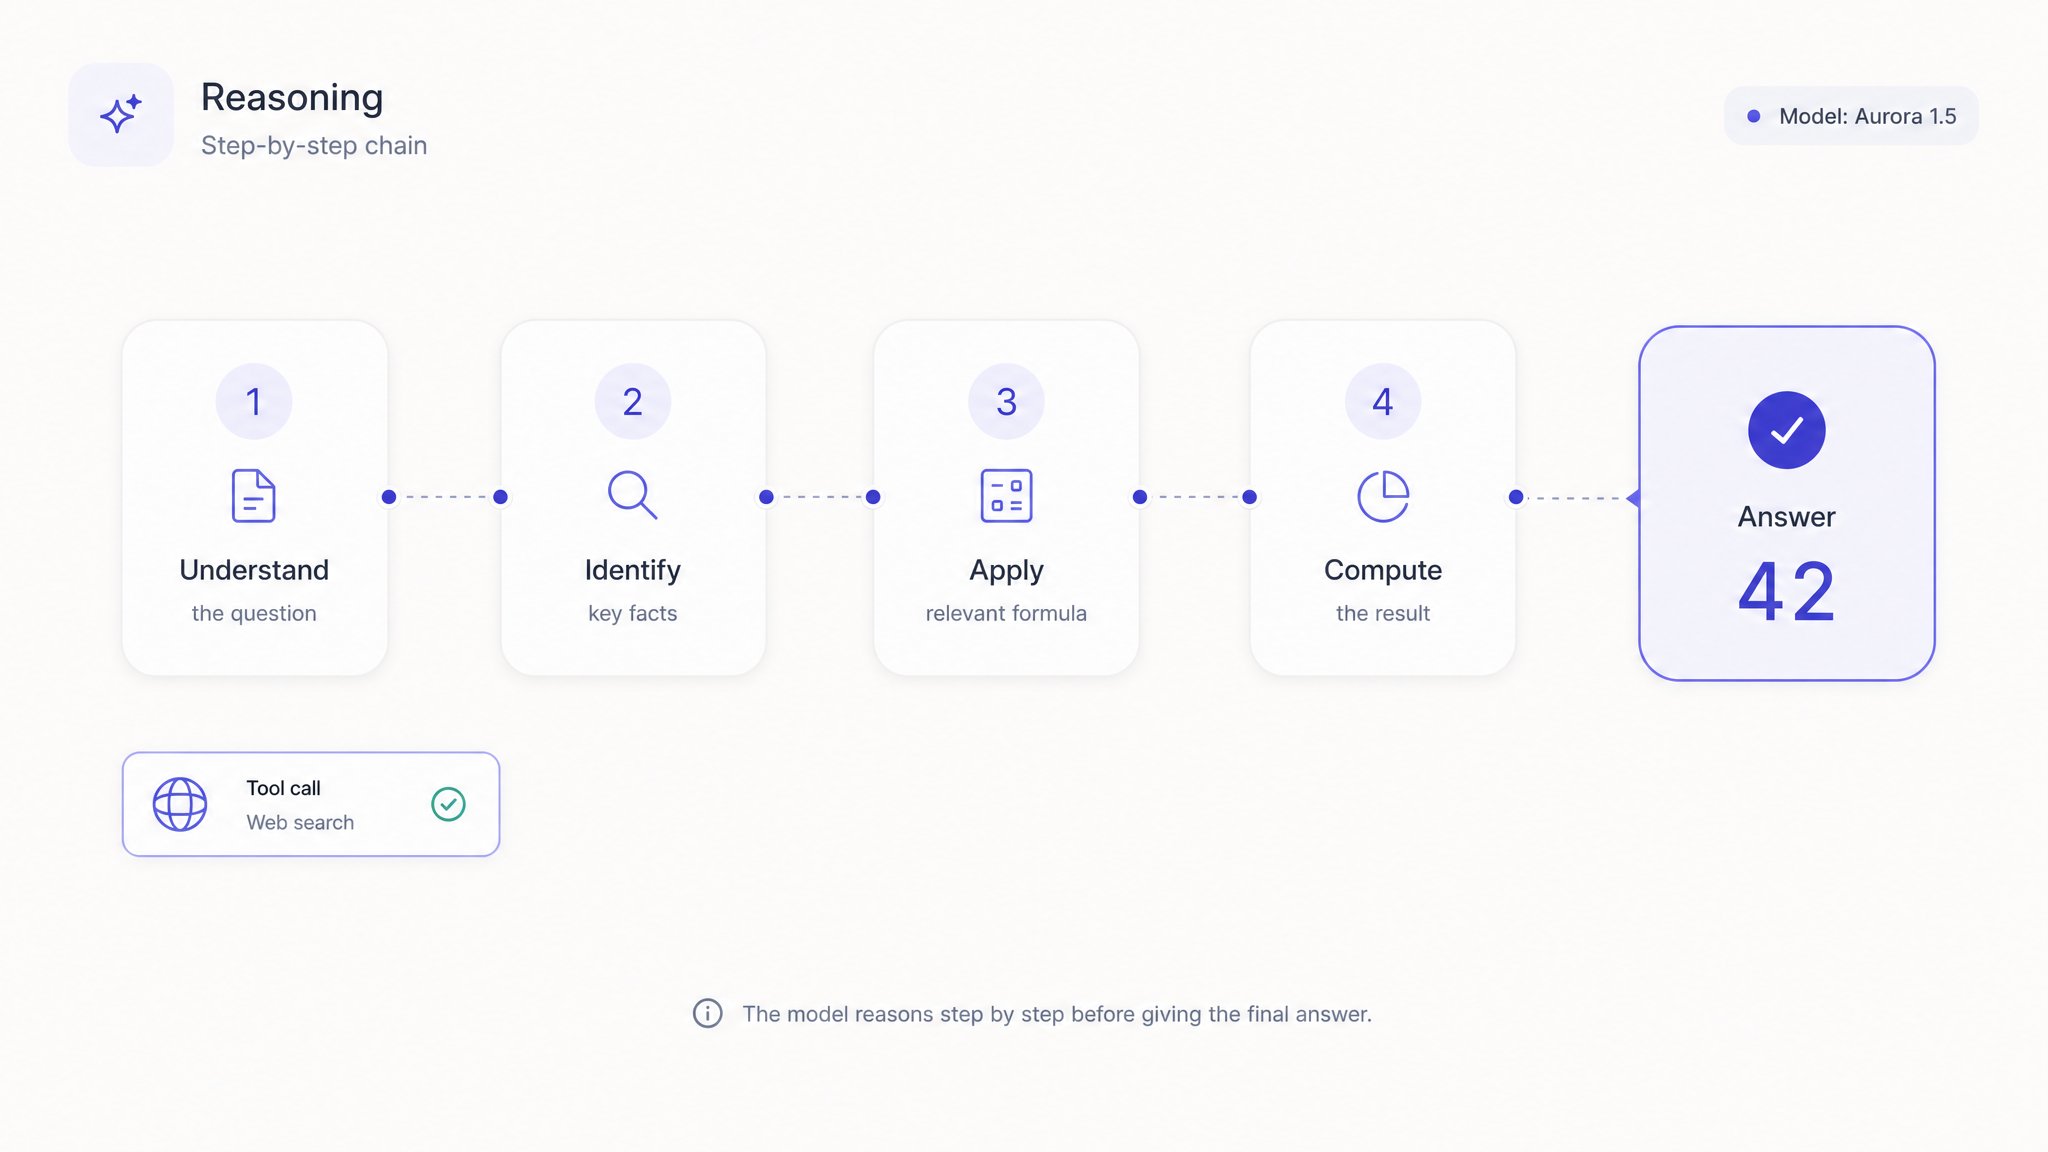
Raisonnement agentique avec une seule clé d’API Kimi
Besoin d’un raisonnement transparent ? Activez le mode de réflexion configurable et le modèle expose sa chaîne de raisonnement étape par étape avant de s’engager sur une réponse, avec prise en charge native des appels d’outils et de fonctions. Sur Atlas Cloud, toute l’API Kimi fonctionne derrière une seule clé compatible OpenAI, avec une tarification à l’appel en paiement à l’usage et un accès Day-0 à chaque nouvelle version. Remplacez votre URL de base et votre code existant continue de fonctionner.
Face-à-face de l’API Kimi : une invite, trois modèles
Envoyez un brief unique et identique à l’API Kimi et à deux modèles concurrents, puis comparez la page HTML interactive que chacun crée à partir exactement des mêmes instructions.
Crée une page HTML complète dans un seul fichier pour un jeu d’arcade Snake jouable, avec tout le CSS et le JavaScript intégrés, et aucune dépendance externe, CDN, image ni police. Affiche le plateau sur un canvas avec une palette moderne néon sur fond sombre, des déplacements fluides et une douce traînée lumineuse derrière le serpent. Prends en charge les flèches directionnelles et les contrôles WASD, ainsi que les gestes de balayage sur les appareils tactiles, affiche le score en direct et un meilleur score persistant, puis augmente progressivement la vitesse du jeu à mesure que le score grimpe. Déclenche une petite explosion de particules chaque fois que la nourriture est mangée, affiche une superposition animée de fin de partie avec un bouton de redémarrage, et conserve une mise en page responsive afin que le plateau reste centré et lisible sur ordinateur comme sur mobile.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Crée un fichier HTML unique et entièrement autonome (tout le CSS et le JavaScript intégrés, absolument aucune dépendance externe, CDN, image ni police web) qui affiche un « terrarium numérique vivant » interactif — un bocal en verre scellé placé au centre de l’écran, contenant une forêt tropicale miniature autosuffisante qui pousse en temps réel. Ouvert dans n’importe quel navigateur moderne, il doit s’exécuter immédiatement à 60fps, sans étape de build. Scène principale et mise en page : centre la composition de façon symétrique, en traitant le bocal en verre comme la scène principale sur un arrière-plan sombre profond avec vignettage (dégradé radial partant d’un centre doucement éclairé façon mousse et s’estompant vers des bords presque noirs), afin que toute l’attention se porte sur le bocal. Dessine l’ensemble sur un HTML5 Canvas plein écran, placé sous une véritable interface DOM/CSS glassmorphism : la paroi du bocal doit présenter de vraies qualités de verre — reflets de réfraction courbes, traînée brillante de rim-light spéculaire, léger flou givré et gouttelettes de condensation dispersées avec un minuscule effet de lentille — obtenues avec des dégradés radiaux/linéaires superposés, backdrop-filter blur, traits blancs semi-transparents et ombres portées douces. À l’intérieur du bocal se trouvent, au fond, un loam sombre et humide, ainsi qu’une légère brume volumétrique qui dérive lentement. Les trois couches techniques qui doivent s’empiler et coexister (c’est là que les modèles faibles se distinguent des modèles forts : un modèle faible produira une image statique, un modèle fort rendra tout le bocal vivant) : 1. Croissance récursive par L-system : les lianes, frondes de fougères et mousses sont générées par un L-system / algorithme de ramification récursive et animent leur déploiement au fil du temps — les tiges s’allongent, les branches se subdivisent, les frondes se déroulent, les feuilles apparaissent en changeant d’échelle avec easing. La croissance est organique et légèrement aléatoire pour chaque branche (variation d’angle, affinement de l’épaisseur, décroissance de la longueur), afin qu’aucune plante ne soit identique après un rechargement. 2. Système de particules : des lueurs ambrées façon lucioles (plusieurs dizaines) dérivent et ondulent dans la brume avec un doux éclat additif et une légère parallaxe, accompagnées de particules ascendantes de condensation/pollen ; les particules réagissent subtilement aux nouvelles plantes qui poussent. 3. Cycle d’éclairage jour-nuit : une boucle continue de lumière ambiante fait évoluer la lumière principale zénithale de l’aube blanc froid → crépuscule doré chaud → nuit indigo profonde, puis revient en arrière, en recolorant toute la scène, les reflets du verre, la brume et les teintes des plantes en conséquence. Les plantes manifestent un phototropisme : les tiges se courbent et orientent leurs pointes vers la direction actuelle de la lumière à mesure qu’elle se déplace. Interaction principale : cliquer n’importe où sur la paroi ou à l’intérieur du bocal fait tomber une graine unique dans le loam à la position x du clic, et cette graine joue une séquence complète et visible de cycle de vie — la graine tombe et se pose, germe en pousse, la pousse se ramifie récursivement via le L-system, puis fleurit en une petite fleur lumineuse à maturité — chaque étape étant animée avec easing et clairement lisible, avec une douce ondulation / bouffée de poussière à l’atterrissage. Plusieurs clics génèrent plusieurs plantes qui coexistent et continuent de pousser, remplissant progressivement le terrarium jusqu’à former un fourré plus dense. Ajoute quelques contrôles intégrés subtils sous forme de boutons pilules glassmorphic (par exemple « Réinitialiser le terrarium » et un interrupteur « Jour/Nuit : auto ⇄ glisser » permettant à l’utilisateur de faire défiler l’heure de la journée, ainsi qu’une pause optionnelle). Prévois une ligne d’indice discrète (« touchez le verre pour planter une graine ») qui s’estompe après la première interaction. Palette et ambiance : feuillages vert encre forestier et vert-jaune moussu, lueur ambre/miel pour les particules lumineuses et les fleurs, teintes froides de verre bleu-vert sur le bocal, lavis d’or chaud et d’indigo froid au fil du cycle jour-nuit. L’impression générale doit être calme, respirante, méditative — des mouvements lents et doux, sans transitions brutales. Exigences techniques : utilise requestAnimationFrame avec delta-time afin que l’animation soit indépendante du frame-rate ; rends le canvas responsive au redimensionnement de la fenêtre avec une mise à l’échelle correcte selon devicePixelRatio et garde le bocal centré ; limite raisonnablement le nombre de particules et de branches pour préserver la fluidité ; garde tout l’aléatoire seedé par plante afin que la croissance paraisse naturelle. Tout — géométrie, éclat, verre, brume, éclairage, particules et plantes récursives — doit être dessiné ou calculé en code, sans aucun asset externe. Fournis uniquement le document HTML complet, prêt à être enregistré comme un fichier .html unique et ouvert.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Mettez la Kimi API au service de toute votre stack
Que vous livriez du code dans d’immenses dépôts, transformiez des maquettes en interfaces ou orchestriez des essaims d’agents, la Kimi API apporte le raisonnement à long contexte et l’utilisation native d’outils aux charges de travail de production réelles.

Codage à l’échelle d’un dépôt avec la Kimi API
Kimi K2.7 Code lit des dépôts entiers dans une fenêtre de 262K tokens, afin de refactoriser, déboguer et étendre des bases de code en une seule passe. Les équipes s’appuient sur lui pour moderniser des systèmes hérités et livrer des fonctionnalités multi-fichiers sans perdre le contexte du projet.

Transformer des maquettes en code front-end
Fournissez à Kimi K2.5 une capture d’écran, une maquette ou une courte vidéo de démonstration, et il renvoie du code front-end fonctionnel à partir de l’entrée visuelle. Les designers et les équipes produit transforment des concepts statiques en pages interactives et en prototypes en quelques minutes.

Analyser de longs documents et des données
Lorsque des rapports ou des contrats comptent des centaines de pages, les modèles Kimi les traitent dans un contexte de 256K tokens pour faire ressortir tendances et contradictions. Les analystes extraient des réponses structurées avec citations au lieu de lire chaque page manuellement.

Orchestrer des essaims d’agents via la Kimi API
Les essaims d’agents permettent à Kimi K2.5 de diviser un objectif en jusqu’à 100 sous-agents parallèles, réduisant le temps d’exécution jusqu’à 4.5x. Les équipes automatisent l’analyse par lots et les constructions longues qu’un seul modèle ne peut pas mener à terme.

Alimenter des agents autonomes utilisant des outils
Entraînés à l’utilisation agentique d’outils, les modèles Kimi appellent des fonctions externes, des APIs et la recherche pour accomplir des tâches sans guidage étape par étape. Les développeurs créent des assistants capables de réserver, d’interroger et d’agir sur de vrais systèmes pour le compte d’un utilisateur.

Migrer vers la Kimi API en quelques minutes
Comme la Kimi API est compatible avec OpenAI, il suffit de remplacer l’URL de base et une clé pour router le trafic vers les modèles Moonshot. Les startups adoptent Kimi sans réécrire la logique applicative et bénéficient d’une tarification transparente à l’appel.
API Kimi vs API LLM concurrentes : contexte, modalité et coût
Comparez l’API Kimi aux autres API de modèles de langage phares sur Atlas Cloud et voyez où elle se distingue en matière de longueur de contexte, de flexibilité des entrées et de prix par jeton.
| Modèle | Fenêtre de contexte | Types d’entrée | Prix en entrée ($/1M tokens) | Prix en sortie ($/1M tokens) |
|---|---|---|---|---|
| Kimi K2.7 Code | 256K tokens | Texte, image | $0.95 | $4.00 |
| Kimi K2.6 | 256K tokens | Texte, image, vidéo | $0.95 | $4.00 |
| Kimi K2.5 | 256K tokens | Texte, image, vidéo | $0.60 | $3.00 |
| DeepSeek V4 Pro | 1M tokens | Texte | $1.74 | $3.45 |
| GLM 5.2 | 1M tokens | Texte | $1.40 | $4.40 |
| Grok 4.5 | 500K tokens | Texte | $2.00 | $6.00 |
| Doubao Seed 2.1 Pro | 256K tokens | Texte | $0.90 | $4.50 |
Comment utiliser Kimi sur Atlas Cloud
Soyez opérationnel en quelques minutes — suivez ces étapes simples pour intégrer et déployer des modèles via la plateforme Atlas Cloud.
Créer un compte Atlas Cloud
Inscrivez-vous sur atlascloud.ai et complétez la vérification. Les nouveaux utilisateurs reçoivent des crédits gratuits pour explorer la plateforme et tester les modèles.
Pourquoi Utiliser Kimi sur Atlas Cloud
Combiner les modèles Kimi avancés avec la plateforme accélérée par GPU d'Atlas Cloud offre des performances, une évolutivité et une expérience développeur inégalées.
Performance et Flexibilité
Faible Latence :
Inférence optimisée par GPU pour un raisonnement en temps réel.
API Unifiée :
Exécutez Kimi, GPT, Gemini et DeepSeek avec une seule intégration.
Tarification Transparente :
Facturation prévisible par token avec options serverless.
Entreprise et Échelle
Expérience Développeur :
SDK, analytiques, outils de fine-tuning et modèles.
Fiabilité :
99,99% de disponibilité, RBAC et journalisation conforme.
Sécurité et Conformité :
SOC 2 Type II, alignement HIPAA, souveraineté des données aux États-Unis.
Questions sur l’API Kimi, avec réponses
L’API Kimi donne aux développeurs un accès programmatique à la famille Kimi de grands modèles de langage de Moonshot AI, pour le raisonnement, le codage et la compréhension de longs contextes. Sur Atlas Cloud, vous y accédez via un endpoint compatible OpenAI unique : une seule clé couvre donc toutes les versions de Kimi, avec une tarification à l’utilisation, par appel.
Atlas Cloud héberge plusieurs versions, dont Kimi K2.5 pour les workflows à long contexte et agentiques, Kimi K2.6 comme modèle général le plus intelligent de Moonshot, et Kimi K2.7 Code pour la programmation et le débogage. Comme ils partagent le même format de requête, passer de l’un à l’autre revient simplement à modifier une seule chaîne de modèle.
Ces modèles excellent dans le codage complexe, l’analyse de dépôts multi-fichiers, le raisonnement sur de gros volumes de documents et l’appel d’outils agentique. Les équipes choisissent Kimi lorsqu’une tâche exige à la fois une grande mémoire de travail et une logique étape par étape solide, par exemple pour refactoriser toute une base de code ou auditer de longs rapports.
La facturation se fait à l’utilisation, sans abonnement ni minimum. Kimi K2.5 est facturé $0.60 par million de tokens d’entrée et $3.00 par million de tokens de sortie, tandis que Kimi K2.6 et Kimi K2.7 Code sont facturés $0.95 par million de tokens d’entrée et $4.00 par million de tokens de sortie. La mise en cache du contexte réduit le coût des prompts répétés ou partagés.
Comme Atlas Cloud expose Kimi via une API compatible OpenAI, vous pouvez faire pointer votre SDK OpenAI actuel vers l’endpoint Atlas et remplacer le nom du modèle par un modèle Kimi. Aucune réécriture de la logique de votre application n’est nécessaire, ce qui en fait un véritable remplacement direct pour les pipelines de chat, de codage et d’agents.
Kimi K2.5, K2.6 et K2.7 Code prennent chacun en charge une fenêtre de contexte de 262,144 tokens, soit environ 256K tokens. Cette capacité vous permet d’envoyer des bases de code entières, de longs manuels techniques ou des centaines de pages de rapports dans une seule requête, sans découpage manuel.
Les versions récentes de Kimi sont nativement multimodales, et non limitées au texte. Kimi K2.6 accepte les entrées texte, image et vidéo, et Kimi K2.5 raisonne sur des tokens visuels et textuels combinés : vous pouvez donc transmettre des captures d’écran, des fichiers de conception ou des enregistrements et demander au modèle de les interpréter avec votre prompt.
Les développeurs la choisissent le plus souvent pour son coût et son contexte. Les retours de la communauté indiquent des économies importantes par rapport aux principaux modèles propriétaires, avec une qualité de codage comparable, et la fenêtre 256K permet de traiter des dépôts entiers et des documents complets, ce que les modèles à contexte plus court ne peuvent pas faire. Commencez à développer dès aujourd’hui.
Explorer Plus de Familles
Kling 4.0
L'API Kling 4 fournit Kling 4.0, le modèle vidéo publié par Kuaishou le 15 octobre 2026. Il génère jusqu'à 30 secondes en un seul passage, suit jusqu'à 10 images clés, fusionne 15 images, vidéos et sujets via Omni Reference, et ajoute un son stéréo avec synchronisation labiale. Atlas Cloud dessert les quatre points de terminaison, y compris le montage vidéo, sur une seule clé compatible OpenAI à partir de 0,11 $ par seconde. Commencez à créer dès aujourd'hui.

Seedance 2.5
L'API Seedance 2.5 offre aux développeurs le modèle conjoint audio et vidéo de ByteDance Seed, générant 4 à 30 secondes en un seul passage à partir de texte, d'une première image ou de jusqu'à 50 références parmi des images, des vidéos et des audios. Elle édite des régions sélectionnées, prolonge des clips et suit les entrées de modèles blancs et d'écrans verts. Atlas Cloud, un revendeur autorisé aux États-Unis, ajoute un mode brouillon en 480p, des fichiers finaux natifs en 1080p et une livraison 4K améliorée avec une tarification à l'usage.
Wan 3.0
Wan 3.0 est le tout nouveau modèle vidéo d'Alibaba, capable de produire jusqu'à 30 secondes de vidéo 1080p à 30fps avec audio en une seule génération. Guidez-le à l'aide d'un prompt textuel, d'une première image, de jusqu'à 10 images de référence ou d'un document. Standard coûte moins cher par seconde, tandis que Prime conserve les mêmes capacités et renvoie les résultats plus rapidement. Les deux fonctionnent avec la même clé Atlas Cloud que Wan 2.7, 2.6 et 2.5.
GPT Image 2.6
L'API GPT Image 2.6 met à la disposition des développeurs le modèle d'image d'OpenAI lancé le 4 novembre 2026, en deux versions : Flare pour une itération rapide et Sunburst pour un travail visuel détaillé. Elle génère des images 50 % plus rapidement qu'auparavant et ajoute la sortie GIF animée, l'exportation SVG, des modifications de balisage ciblant la zone que vous encerclez, ainsi qu'un réglage de complexité. Atlas Cloud dessert les deux modèles avec une clé compatible OpenAI et une tarification à l'usage.
MiniMax H3
MiniMax H3 est la famille vidéo multimodale de MiniMax, conçue pour la création guidée par du texte, des images et des références. Sur les routes prises en charge, elle préserve les sujets des médias de référence, offre des rapports d’aspect flexibles et associe un son généré aux visuels via H3 Developer, avec des profils de sortie sélectionnés par endpoint. Atlas Cloud unifie cette famille derrière une seule clé compatible avec OpenAI, avec une tarification transparente à l’usage à partir du tarif standard de 0,038 $ par seconde. Commencez à développer dès aujourd’hui.
GPT Image 2.5
GPT Image 2.5 est le modèle de génération et d'édition d'images d'OpenAI, sorti le 8 septembre 2026 en deux versions d'API. Flare est la version par défaut, offrant une latence jusqu'à 50 % inférieure à celle de GPT Image 2, tandis que Sunburst prend plus de temps pour offrir un contrôle plus précis sur les modifications détaillées. Les deux prennent en charge jusqu'à 16 images de référence, cinq niveaux de qualité, des arrière-plans transparents et des tailles personnalisées jusqu'à 3840px. Atlas Cloud dessert l'API GPT Image 2.5 aux tarifs par jeton d'OpenAI, ou à un prix fixe par image selon le niveau 1K, 2K ou 4K.
Seedream 5.0 Pro
L'API Seedream 5.0 Pro offre aux développeurs le modèle d'édition d'images contrôlable de ByteDance sur Atlas Cloud. Elle positionne les modifications avec précision à l'aide d'ancrages et de coordonnées, sépare les images en calques modifiables, fusionne de multiples références et fait correspondre les couleurs et matériaux exacts, avec du texte multilingue en 2K et 3K. Sur Atlas Cloud, vous y accédez via une seule clé !
Seedance 2.0
Seedance 2.0 est le modèle vidéo de production de ByteDance pour créer des plans avec précision. Transformez vos prompts en vidéos, animez une image de première image avec un guidage facultatif par la dernière image, ou façonnez vos résultats à l’aide de médias de référence et d’une recherche web facultative. Atlas Cloud regroupe ces workflows dans une API unifiée, avec une tarification transparente à l’usage et une clé compatible avec OpenAI. Commencez à développer dès aujourd’hui.
Kling V3.0
Issu de Kuaishou, la famille d’API Kling V3 prend en charge les workflows de génération à partir de texte, d’images et de vidéos de référence. Transférez les mouvements tout en préservant l’identité des personnages, guidez la génération à l’aide de références visuelles et modifiez des vidéos avec des commandes en langage naturel. Atlas Cloud propose des points de terminaison Standard et Pro adaptés à différents besoins de production. Mise à jour : Kling V4 est désormais disponible sur Atlas Cloud. Découvrez-le sur la page [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video donne aux développeurs accès à la famille de modèles vidéo de xAI pour créer, animer, prolonger et retoucher des clips. Générez des vidéos de 1 à 15 secondes à partir de prompts, guidez des personnes, des objets ou des styles avec jusqu'à sept images de référence, et travaillez en 480p ou 720p. Atlas Cloud réunit ces fonctionnalités via des points de terminaison compatibles avec OpenAI, avec une tarification transparente à l'usage. Commencez à créer dès aujourd'hui.
Vidu Q4 Preview
Vidu Q4 est le dernier modèle vidéo phare de Vidu, conçu pour la génération image-to-video et reference-to-video. Il peut animer une seule image fixe et créer automatiquement des transitions entre les scènes, offrant ainsi aux développeurs deux modes d’entrée pour différents flux de produits. Atlas Cloud fournit des points de terminaison API dédiés, avec des schémas de paramètres publiés, au tarif standard vérifié de $0.04 par seconde. Commencez dès aujourd’hui à développer.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash est la famille vidéo nativement multimodale de Google DeepMind, conçue pour des workflows de production flexibles. Modifiez des séquences existantes à l’aide d’instructions textuelles, préservez la cohérence visuelle avec jusqu’à 10 images de référence et 3 clips vidéo, ou prolongez un plan par segments enchaînables jusqu’à 40 secondes. Accédez à tous les workflows sur Atlas Cloud avec une seule clé API compatible OpenAI, une tarification à l’usage et une disponibilité dès le Day-0. Commencez à développer dès aujourd’hui.
Articles recommandés
Guides, tutoriels et actualités produit pour tirer le meilleur d'Atlas Cloud.


