Une API d'IA pour la génération par lots est utile lorsque chaque résultat peut être retrouvé, examiné et relancé de manière autonome. C'est plus important que le nombre d'invites que vous soumettez en une fois. Le moment coûteux n'est pas la requête n° 1 000. C'est lorsque la tâche 37 expire, que la tâche 38 réussit, que deux fichiers portent le même nom et que personne ne peut dire quelle image peut être publiée sans risque.
Considérez un lot comme un ensemble de tâches d'actifs récupérables. Attribuez à chaque tâche un identifiant métier durable, enregistrez l'entrée exacte et les paramètres du modèle, limitez la concurrence et ne relancez que l'élément qui a réellement échoué. Ce guide utilise un flux de travail de campagne de personnage à 8 actifs afin qu'un développeur ou une équipe de croissance puisse transformer un manifeste en une exécution de production maîtrisée.
Points clés à retenir
- Une tâche par lots et des requêtes parallèles résolvent des problèmes de latence et de contrôle différents.
- Des identifiants d'actifs stables et des clés d'idempotence rendent les défaillances partielles gérables.
- Commencez par 4 à 8 actifs visuels, examinez-les, puis développez.
- Une réponse d'API réussie nécessite encore un examen visuel et des droits avant publication.
API d'IA pour la génération par lots : la réponse d'abord
Une API d'IA pour la génération par lots soumet un ensemble de tâches de génération distinctes à une file d'attente asynchrone, puis renvoie leurs résultats via des vérifications de statut, un rappel d'achèvement ou un fichier de sortie téléchargeable. Chaque tâche a besoin d'une identité qui existe en dehors du fournisseur du modèle. L'identifiant de tâche du fournisseur facilite l'exploitation, mais c'est maya-ridgeline-001 qui permet à votre système éditorial ou de campagne d'identifier l'actif des mois plus tard.
Ne confondez pas trois idées liées. Une seule invite peut demander plusieurs variantes. Votre propre worker peut envoyer plusieurs requêtes normales en même temps. Une tâche par lots côté serveur est un ensemble géré par le fournisseur qui se termine plus tard. Cette dernière convient souvent au travail hors ligne, tandis que des requêtes parallèles maîtrisées conviennent à un tableau de bord qui a besoin d'une progression immédiate.
La documentation actuelle de l'API Batch d'OpenAI illustre le modèle asynchrone : les requêtes sont regroupées dans un fichier JSONL, soumises en tant que tâche, vérifiées pour l'achèvement et récupérées sous forme de résultats. Sa fenêtre de 24 heures, ses limites de débit de lot distinctes et ses limites sont propres à ce service, et non une promesse que chaque fournisseur d'images fait (documentation de l'API Batch d'OpenAI, septembre 2026). La référence actuelle de Gemini documente de même les tâches par lots de longue durée, les vérifications de statut et la prise en charge des webhooks pour son service (référence de l'API Batch de Gemini, septembre 2026).
| Point de décision | API par lots | Requêtes parallèles maîtrisées |
|---|---|---|
| Réponse attendue | Achèvement différé | Chaque requête est renvoyée à mesure qu'elle se termine |
| Idéal pour | Travail hors ligne sur catalogue, storyboard et bibliothèque de contenu | Outils interactifs et boucles de révision courtes |
| Gestion des échecs | Lire les résultats par élément après l'achèvement d'une tâche | Traiter chaque requête enfant à mesure qu'elle se règle |
| Coût et limites | Les règles de lot propres au fournisseur peuvent différer du trafic en direct | Utilise les limites de requêtes ordinaires du compte |
| Enregistrement essentiel | ID d'actif, ID de requête, état du résultat, emplacement de sortie | Les mêmes champs, plus l'état de la tentative en cours |
Choisissez des requêtes parallèles maîtrisées lorsqu'un réviseur doit voir rapidement la première image utilisable. Choisissez une tâche par lots côté serveur lorsque le travail peut attendre et que le fournisseur documente un chemin par lots. Dans les deux cas, stockez asset_id, l'entrée normalisée, le hachage de référence, le modèle, le nombre de tentatives et l'URL de sortie. Cette couche commune rend le flux de travail portable si le mécanisme de livraison change.
Pourquoi les projets d'images par lots échouent à grande échelle
Les lots de production échouent généralement par fragments. Une requête peut être terminée, expirée, rejetée, ou renvoyer un résultat techniquement valide mais visuellement inutilisable. Une application qui n'enregistre qu'une URL finale a jeté l'information nécessaire pour se remettre de tous les cas, sauf du succès le plus simple.
Le premier échec est l'absence d'identité. Si la requête ne porte qu'une chaîne d'invite, un résultat ne peut pas être associé de manière fiable à un produit, à une locale de campagne ou à une ligne source. Les noms de fichiers dérivés de l'invite sont fragiles, car les révisions d'invite et les produits répétés entrent en collision. Utilisez un ID d'actif stable issu de l'enregistrement métier, puis donnez à chaque tentative de génération son propre suffixe.
Le deuxième échec est la relance sans idempotence. Un délai d'attente réseau ne prouve pas que le fournisseur n'a effectué aucun travail. Si un worker soumet immédiatement à nouveau le même actif avec une nouvelle identité de requête, il peut créer des résultats en double et des frais en double. Une clé d'idempotence permet à l'appelant de dire, en substance, « il s'agit toujours du même actif demandé ». Le fait qu'un point de terminaison donné prenne en charge ce mécanisme dépend du fournisseur ; vérifiez-le donc dans la documentation de l'API avant de vous y fier.
Le troisième échec est une file d'attente aveugle de 40 ou 60 invites. Une dérive de couleur, de composition ou d'identité de produit peut ne devenir visible qu'une fois l'exécution terminée. Une récente discussion entre créateurs décrit l'examen de planches de storyboard d'environ 7 à 8 images avant d'envoyer la page suivante, précisément pour détecter les erreurs d'exactitude et de cohérence (discussion sur la génération d'images par lots, juin 2026). C'est une expérience communautaire, pas un benchmark, mais c'est un point de contrôle opérationnel judicieux.
Appliquez une règle de contrôle qualité par petits lots : exécutez 4 à 8 actifs, inspectez-les, corrigez l'invite ou la référence si nécessaire, puis déverrouillez le groupe suivant. Conservez l'invite d'origine, la version de l'invite, la référence d'entrée, la révision du modèle si disponible, le réglage de qualité, le format d'image, les horodatages, la classe d'erreur et la décision de révision. Une URL seule ne peut pas expliquer pourquoi un actif existe ou s'il doit être réutilisé.
Concevoir une API d'IA fiable pour la génération par lots
L'implémentation peut être modeste. Un manifeste, un worker de file d'attente, un enregistrement de tâche en ajout seul et un dossier de sortie adapté au réviseur suffisent pour commencer. L'objectif n'est pas un grand système d'orchestration. C'est un flux de travail où une personne peut répondre : qu'a-t-on demandé, que s'est-il passé et que faut-il exécuter ensuite ?
Donnez à chaque sortie de lot une identité d'actif durable
Faites de asset_id une clé métier, et non un ID de tâche du fournisseur. Un enregistrement de tâche utile peut inclure les champs ci-dessous. Conservez-le dans une base de données lorsque plusieurs workers opèrent, ou dans un CSV versionné accompagné d'un journal JSONL pour une équipe plus petite.
| Champ | Pourquoi il existe |
|---|---|
asset_id | Identité immuable de l'actif publiable |
source_row | Renvoie au produit, à la campagne ou à l'enregistrement de contenu |
prompt_version | Indique quel modèle d'instruction a produit le résultat |
reference_hash | Confirme quelle image source verrouillée a été utilisée |
model, aspect_ratio, quality | Rend l'exécution suffisamment reproductible pour diagnostiquer |
attempt, idempotency_key, status | Distingue une relance de tâche enfant d'une nouvelle requête |
output_url, review_status, failure_reason | Relie la livraison et l'acceptation humaine |
Par exemple, maya-train-001 reste l'identité de l'actif. maya-train-001-a2 est la tentative 2. La clé d'idempotence peut être maya-train-001-v1, où v1 identifie la spécification immuable demandée. Si le brief change sensiblement, créez une nouvelle version d'invite au lieu d'écraser l'ancien enregistrement.
Utilisez une file d'attente par lots, pas une boucle illimitée
Définissez un plafond de concurrence, un plafond du nombre d'actifs, un garde-fou monétaire et un plafond de relances avant la répartition. Une configuration de départ pratique est de 4 tâches en cours, au plus 2 tentatives de génération par tâche et pas plus de 8 tâches visuelles avant le prochain point de contrôle qualité. Ce sont des valeurs de départ, et non des garanties de plateforme. Fixez-les en dessous des limites documentées de votre compte et ajustez-les après avoir observé les temps d'achèvement et les taux d'erreur réels.
Le worker doit prendre en charge une tâche en attente, la marquer comme submitted, enregistrer l'ID de requête du fournisseur et mettre à jour ce même enregistrement lorsqu'un résultat arrive. Lorsqu'un plafond budgétaire est atteint, arrêtez de prendre en charge du travail. Lorsque la file d'attente est mise en pause pour révision, laissez le travail déjà soumis se terminer, mais ne libérez pas automatiquement un autre groupe.
Ne relancez que la tâche enfant échouée
Relancez les états failed, timed_out ou les états réessayables propres au fournisseur, un actif à la fois. Utilisez un backoff exponentiel plafonné avec gigue pour les réponses 429, les réponses 5xx transitoires et les véritables délais d'attente de transport. Enregistrez la classification de l'erreur et l'heure de relance planifiée. Ne répétez pas automatiquement un refus lié à la politique de contenu, une entrée mal formée, une référence manquante ou un rejet visuel de la part d'un réviseur humain.
Ne resoumettez jamais un lot entier parce qu'un enfant a échoué. Archivez immédiatement les résultats réussis et préservez la correspondance source-sortie. Si une tâche par lots expire avec des résultats partiels, ingérez les enfants terminés, identifiez les ID d'actifs inachevés et créez une nouvelle tâche contenant uniquement ces enregistrements restants. C'est la différence entre la récupération et la duplication.
Un flux de travail d'images par lots à 8 actifs à copier
L'exemple suivant est délibérément fictif : Maya, une photographe de voyage adulte en reportage en haute montagne. Il rend la mécanique opérationnelle concrète sans laisser entendre qu'une personne réelle a approuvé la campagne. Remplacez les champs par votre propre personnage autorisé, votre autorisation de droit à l'image ou vos données de campagne, et conservez la structure.
Étape 0 : créez le manifeste avant de générer
Créez batch-manifest.csv avant d'ouvrir un playground ou d'appeler un point de terminaison. Il donne à l'opérateur une cible d'acceptation claire pour chaque actif.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | référence de personnage canonique | 16:9 | en attente |
| maya-ridgeline-001 | a | image de campagne de crête au lever du soleil | 16:9 | en attente |
| maya-market-001 | a | image éditoriale de marché de montagne | 16:9 | en attente |
| maya-cabin-001 | a | image éditoriale de préparation en cabane | 16:9 | en attente |
| maya-lake-001 | a | image de notes de terrain au bord du lac | 16:9 | en attente |
| maya-forest-001 | b | image de campagne de sentier forestier | 16:9 | en attente |
| maya-train-001 | b | image éditoriale de voyage en train | 16:9 | en attente |
| maya-workbench-001 | b | image de préparation du kit de terrain | 16:9 | en attente |
| maya-portrait-001 | b | image de campagne de portrait rapproché | 16:9 | en attente |
Générez une clé d'idempotence déterministe pour chaque requête immuable, telle que maya-ridgeline-001-v1. La forme ci-dessous est volontairement neutre vis-à-vis du fournisseur. Placez le point de terminaison du fournisseur et ses paramètres documentés à l'intérieur de request ; ne copiez pas un point de terminaison privé fictif en production.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Étape 1 : créez une référence de personnage canonique
Générez l'image maître séparément. C'est l'ancre d'identité de chaque scène ultérieure, elle mérite donc une courte révision avant le début de tout lot. Dans le playground GPT Image 2, sélectionnez High quality et 16:9, puis utilisez cette invite :
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Conservez une image qui montre clairement le visage, les cheveux, la veste, la sangle d'appareil photo de Maya et une paire complète de mains, sans texte ni personne en double. Enregistrez-la sous maya-master-001.png, calculez un hachage de référence et joignez cette même source aux tâches enfants en aval. Ne traitez pas cette étape par lots. Une référence maître faible multiplie l'ambiguïté sur chaque scène.
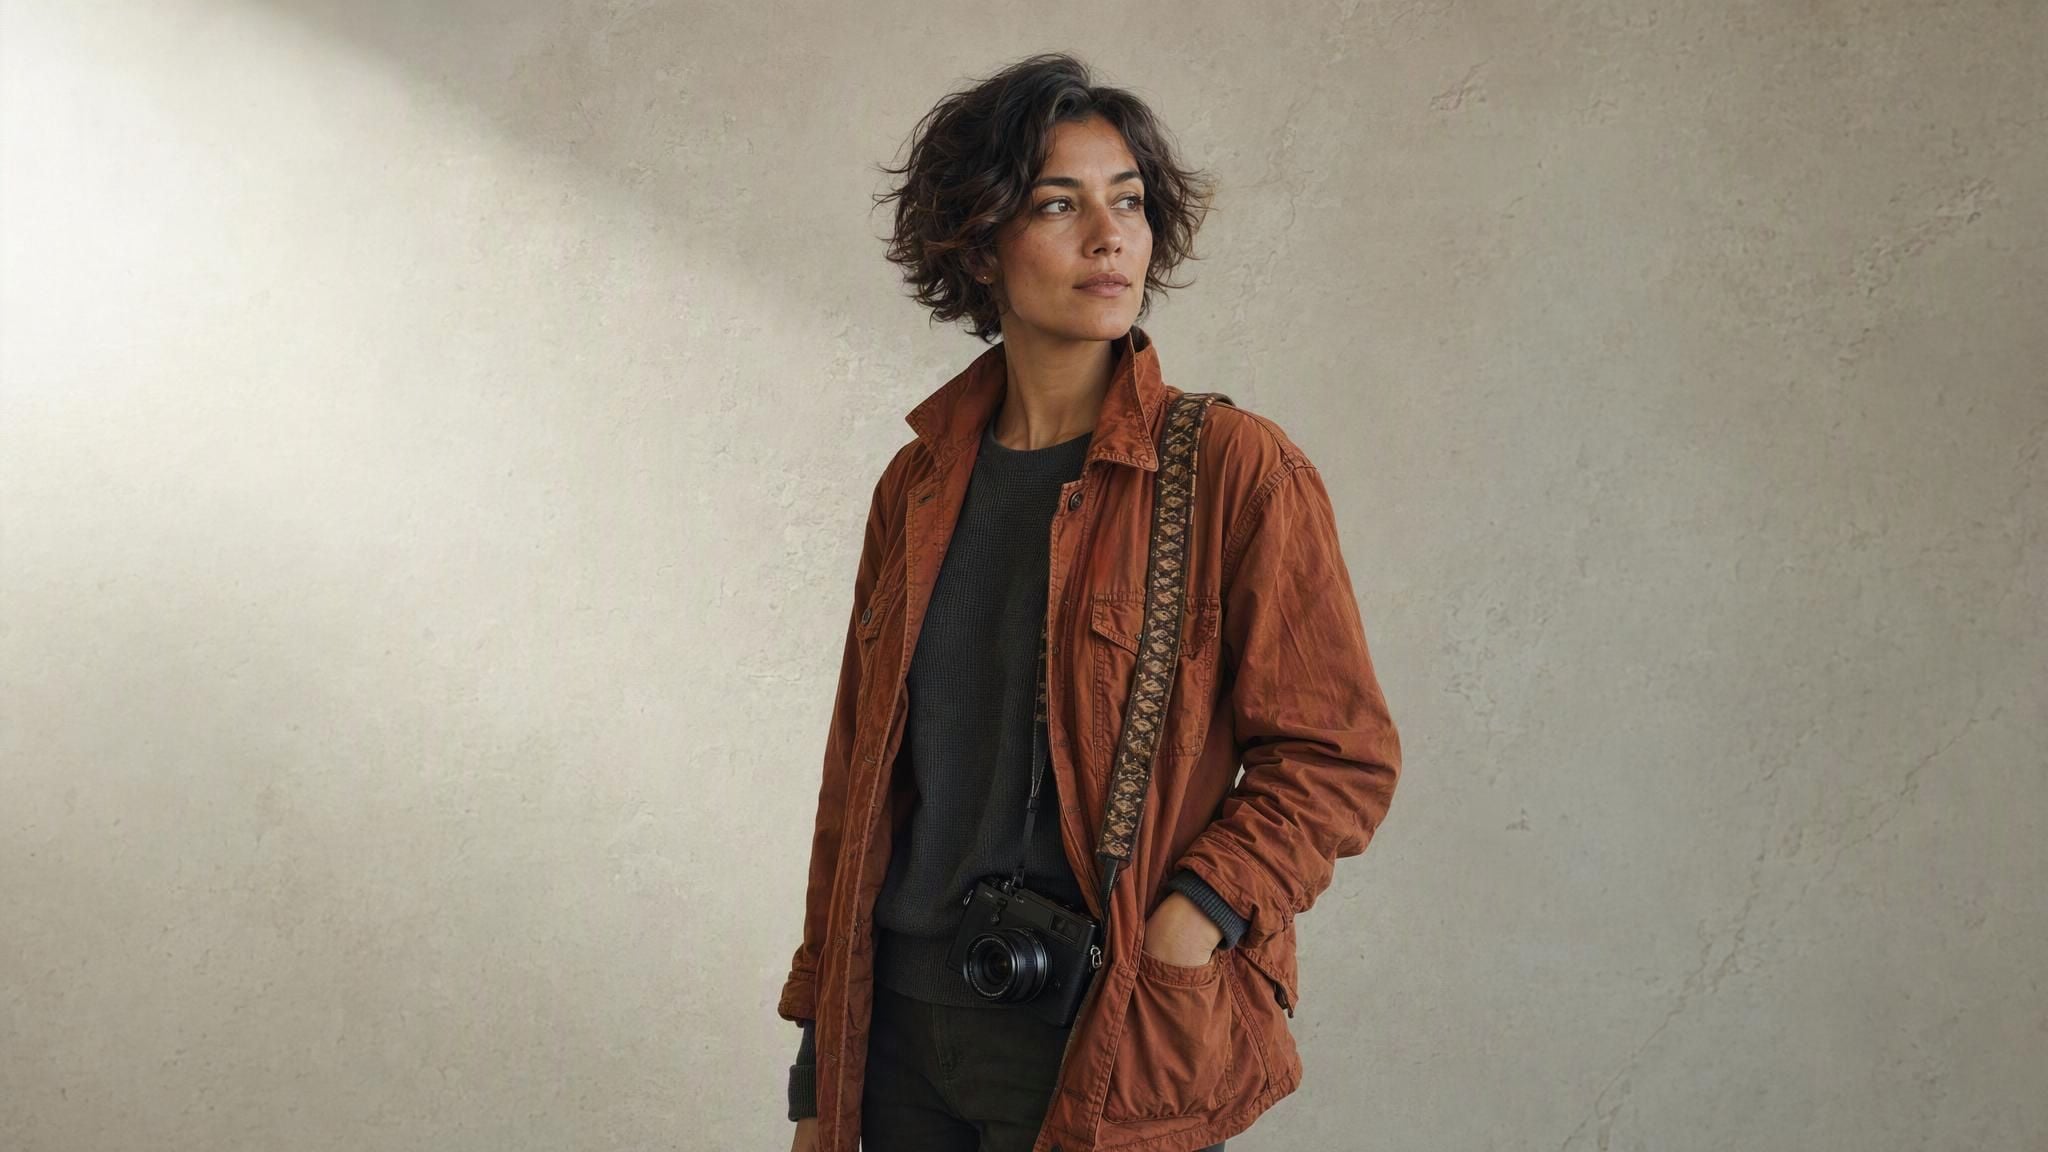
Démonstration de fonctionnalité pour l'API d'IA pour la génération par lots : l'invite de référence de personnage de Maya à côté du portrait de photographe de voyage généré
Une véritable exécution de référence maître GPT Image 2 : l'invite établit la photographe fictive dont l'identité devra être préservée par les tâches de scène ultérieures.
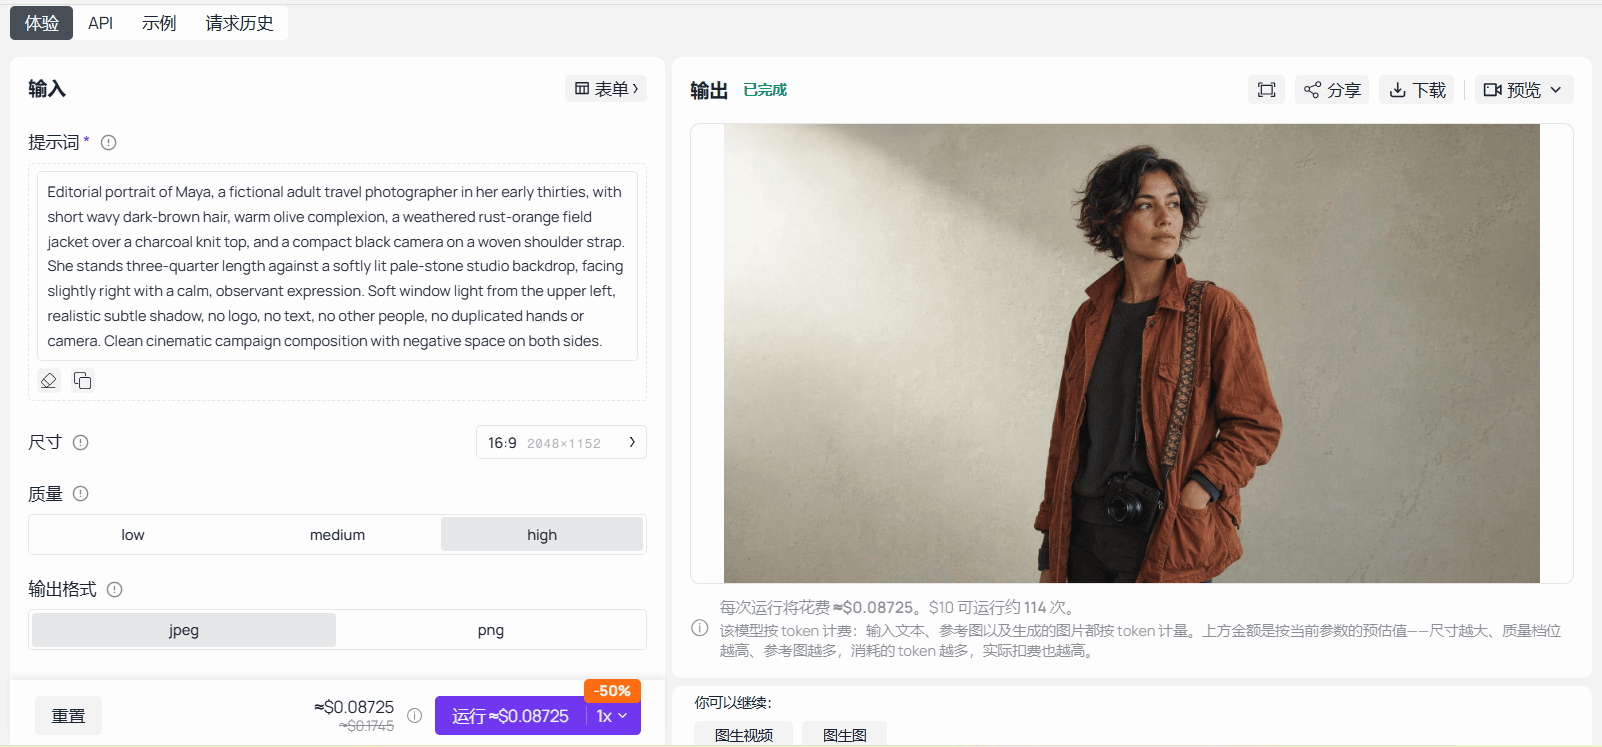
Playground GPT Image 2 complété avec High quality, un réglage 16:9 et le portrait maître de Maya
GPT Image 2 sur Atlas Cloud avec l'invite de référence de personnage de l'article et son résultat terminé dans le panneau de sortie.
Étape 2 : exécutez le lot A sous forme de 4 scènes de personnage liées
Téléversez maya-master-001.png vers Seedream v4.7 Sequential. Gardez la référence, le modèle d'invite et le format 16:9 constants. Utilisez cette invite :
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Utilisez le mode séquentiel ou par lots cohérent que la page en ligne expose réellement. N'acceptez que les résultats qui peuvent être associés sans ambiguïté à maya-ridgeline-001 jusqu'à maya-lake-001. Si le playground renvoie un résultat par requête au lieu de 4 actifs enfants distincts, soumettez le même modèle verrouillé sous forme de 4 tâches enfants. Conservez le même hachage de référence et les mêmes paramètres plutôt que de prétendre que l'interface a fourni une fonctionnalité qu'elle n'a pas.
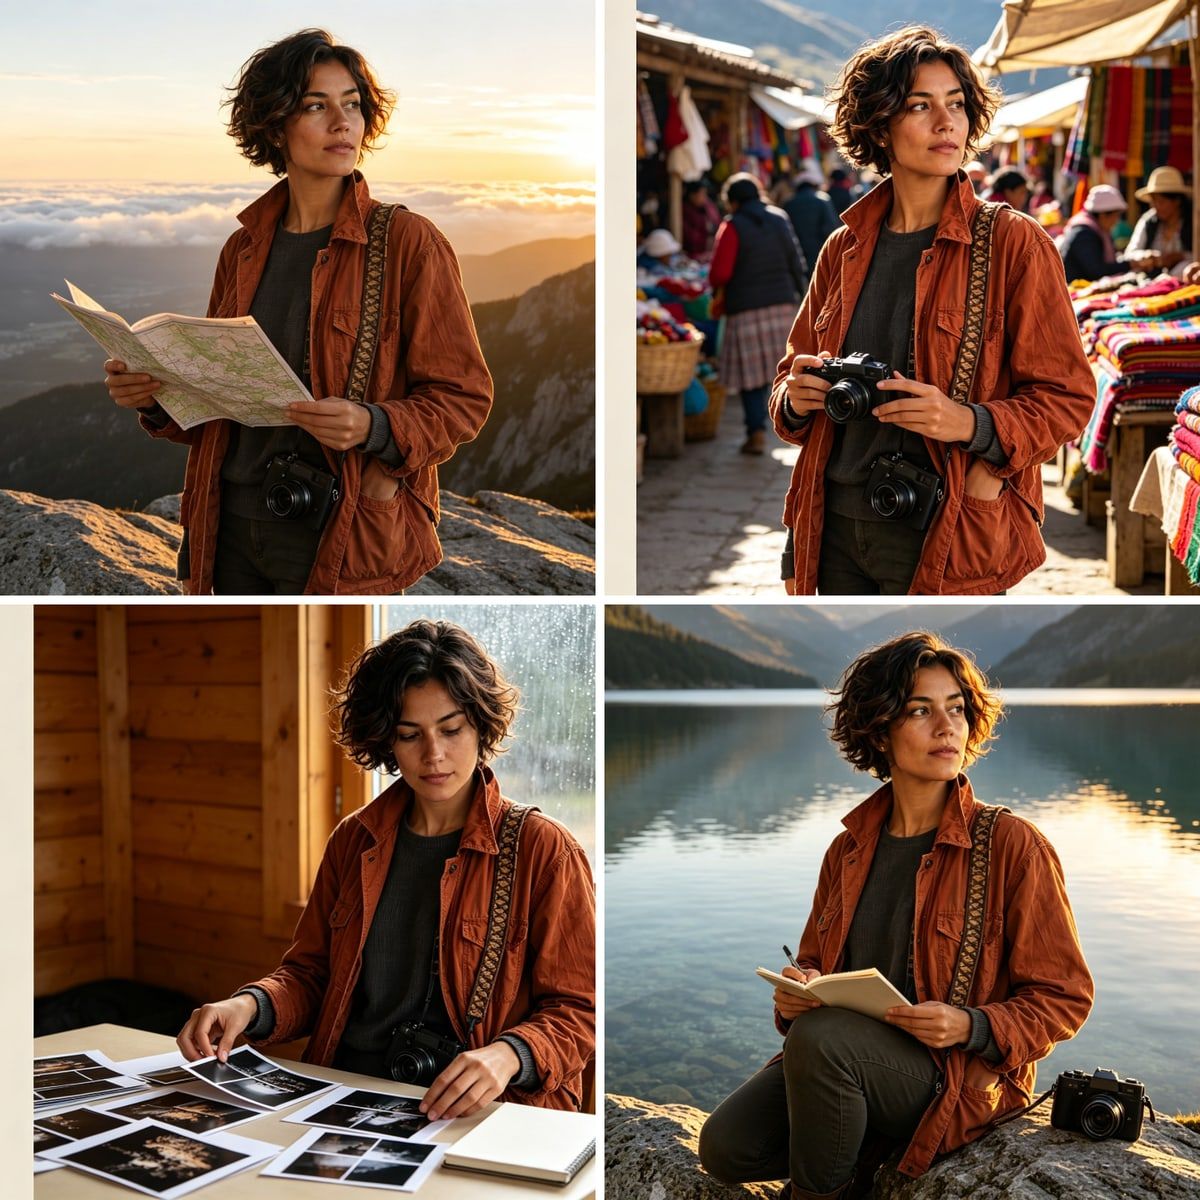
Quatre véritables sorties de scènes Maya de Seedream v4.7 Sequential dans une grille, associées aux ID d'actifs crête, marché, cabane et lac
La grille de sortie du lot A à 4 scènes : chaque image reste un enregistrement d'actif distinct même lorsque le modèle produit une séquence cohérente.
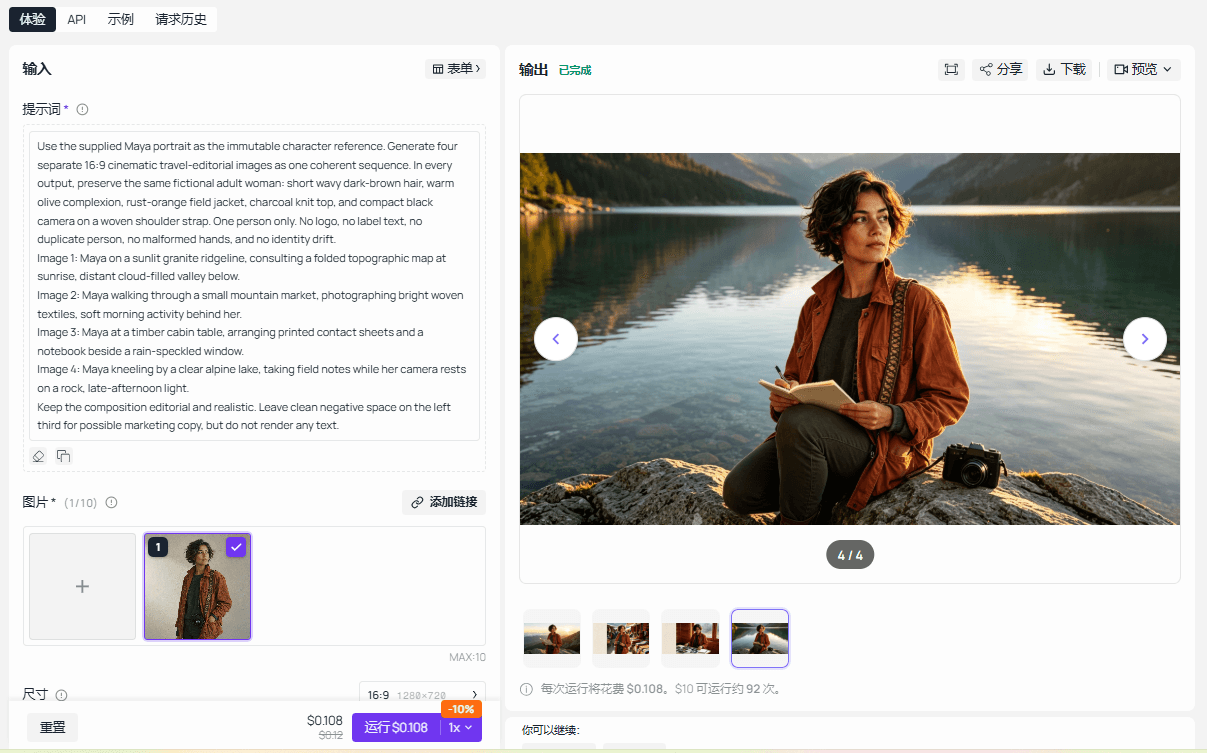
Playground Seedream v4.7 Sequential complété avec l'invite de scène Maya liée et son résultat réel
Seedream v4.7 Sequential sur Atlas Cloud avec l'invite liée de scène de personnage de l'article et un résultat terminé.
Étape 3 : exécutez le lot B, puis arrêtez-vous pour le contrôle qualité
Réutilisez la référence maître approuvée. Ne la recréez pas et ne réécrivez pas les règles d'identité. Soumettez les 4 scènes suivantes avec une nouvelle étiquette de lot et les mêmes contrôles d'acceptation :
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Après le lot B, arrêtez-vous. Examinez les 8 enregistrements de scène avant de lancer une autre séquence de campagne. Cette pause permet de détecter les types de dérive que les files d'attente masquent : des changements de coiffure ou de garde-robe, l'apparition d'une seconde personne, un lettrage non demandé, des mains malformées ou une scène qui ne sert plus son canal. Enregistrez la décision du réviseur à côté de l'actif plutôt que dans un message de discussion non suivi.
Étape 4 : appliquez une décision de publication, de relance ou de rejet
Marquez une image comme approved lorsqu'elle contient une seule Maya, correspond à la référence maître pour le visage, les cheveux, la garde-robe et l'appareil photo, ne contient aucun texte cassé ni anatomie malformée, et correspond à sa scène assignée. Marquez-la comme retry lorsque Maya se dédouble, dérive, perd un accessoire nécessaire ou présente des mains ou un lettrage malformés. Marquez-la comme rejected lorsque la composition ne peut pas servir le canal prévu ou que le personnage n'est plus reconnaissable.
Pour une relance, conservez maya-train-001 comme actif métier et créez la tentative maya-train-001-a2. Soumettez uniquement cette tâche enfant, la spécification de clé d'idempotence d'origine n'étant ajustée que si l'invite est délibérément versionnée. Ne réexécutez pas les 7 autres actifs simplement parce qu'une scène a besoin d'être réparée.
Choisir des modèles pour la génération par lots
Choisissez un modèle en fonction de l'unité de travail, et non d'un classement. Une référence maître propre et une séquence de scènes cohérente sont des tâches différentes. La retouche d'une seule image échouée l'est encore davantage. Si une équipe souhaite tester ces étapes via une seule intégration compatible OpenAI, Atlas Cloud offre un lieu naturel pour valider les deux pages de modèles utilisées dans cet exemple.
| Tâche | Modèle et méthode de travail | Contexte tarifaire à vérifier avant la mise en file d'attente |
|---|---|---|
| Créer une référence maître de personnage propre | GPT Image 2, une exécution High quality en 16:9 qui devient l'ancre de référence | Le text-to-image GPT Image 2 Developer est annoncé à partir d'environ $0.004 par image contre $0.009 en standard, une remise affichée de 50 % en septembre 2026 |
| Construire un ensemble de scènes cohérent | Seedream v4.7 Sequential, même référence et schéma d'invite verrouillé sur les tâches enfants | Le catalogue actuel indique $0.03 par image ; vérifiez le mode de sortie et le prix en direct avant la production |
| Réparer un actif échoué | Mode d'édition GPT Image 2, limité à l'actif qui a échoué à la révision | Confirmez le point de terminaison d'édition, la taille de sortie, la qualité et le prix actuel avant de vous engager |
Les prix varient selon le modèle, le mode et les réglages choisis. Utilisez le catalogue de modèles Atlas Cloud pour revérifier la disponibilité, les remises et le mode exact le jour où vous mettez du travail en file d'attente. Considérez le tableau comme une donnée d'estimation, jamais comme une allégation promotionnelle ou une garantie de coût.
Contrôle qualité, coût et droits avant de passer à l'échelle
L'achèvement d'une génération a 3 significations distinctes : le fournisseur signale un succès, le fichier a été archivé correctement et un réviseur humain l'accepte pour publication. Rendez ces 3 éléments visibles dans vos enregistrements. Une tâche terminée avec un fichier de sortie manquant est un échec opérationnel. Un fichier enregistré avec un personnage en double est un échec créatif. Ni l'un ni l'autre ne devrait progresser automatiquement vers la publication.
Utilisez une liste de contrôle du réviseur suffisamment simple pour être appliquée à chaque actif enfant :
| Contrôle | Question du réviseur |
|---|---|
| Identité du personnage | Maya correspond-elle à la référence maître approuvée pour le visage, les cheveux, la garde-robe et l'appareil photo ? |
| Nombre d'objets | Y a-t-il exactement le nombre attendu d'objets clés ? |
| Conformité à l'invite | La scène fournit-elle le cas d'usage assigné ? |
| Artefacts textuels | Y a-t-il du texte indésirable, malformé ou non pris en charge ? |
| Format et nom de fichier | Le fichier enregistré correspond-il à l'enregistrement du manifeste ? |
| Examen des droits | La référence et les allégations prévues sont-elles autorisées pour cet usage ? |
Estimez le coût après l'exécution avec approved asset cost = total completed attempts cost / approved assets. Cela expose le coût des relances et des résultats rejetés sans prétendre que chaque image a le même coût final. Définissez un plafond de tâches, un plafond de lot et un plafond quotidien avant de commencer. Mettez la répartition en pause si l'un de ces plafonds est atteint.
N'utilisez que des images de référence que vous possédez, que vous avez sous licence ou qui sont autrement autorisées. Vérifiez les politiques actuelles de la plateforme et les conditions du modèle avant tout usage commercial. Ne demandez pas au modèle d'inventer des certifications, des résultats de laboratoire, des promesses de sécurité, des allégations médicales ou des spécifications produit non vérifiées. Une sortie soignée ne transforme pas une allégation non étayée en une allégation publiable.
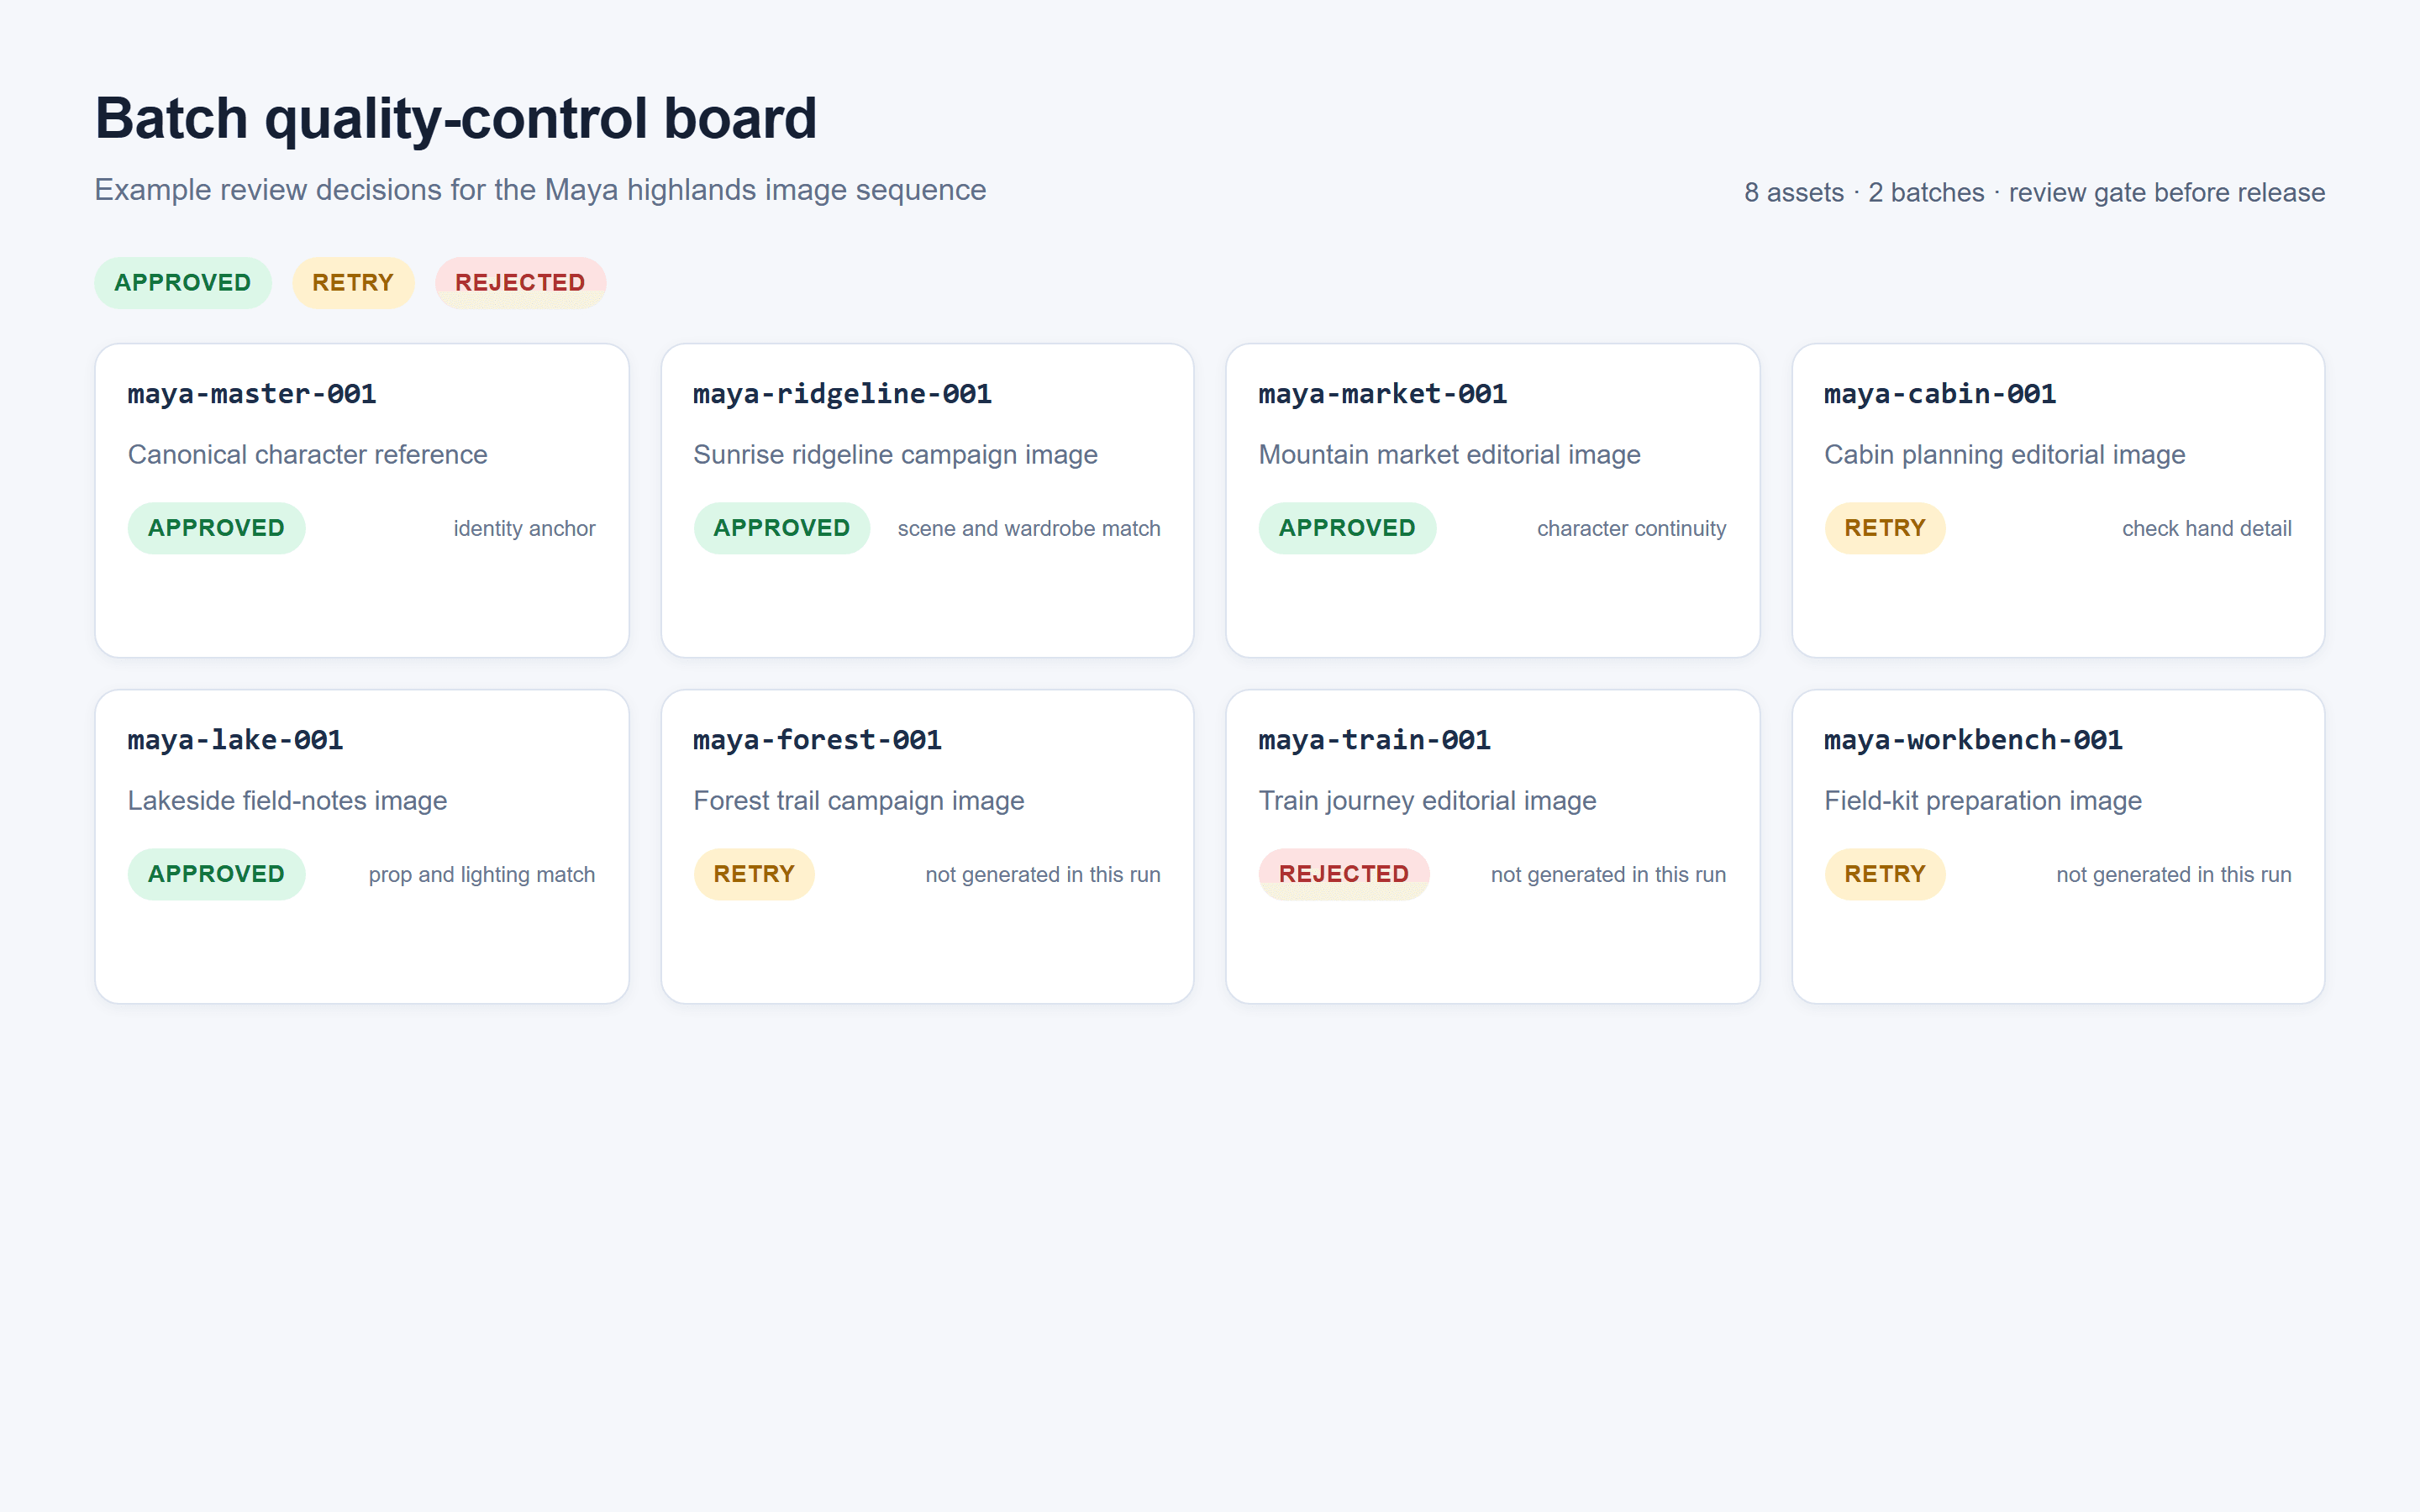
Tableau de contrôle qualité de lot rendu dans le navigateur montrant 8 ID d'actifs Maya avec les états de révision approuvé, à relancer et rejeté
Un tableau de révision rendu dans le navigateur associe les fichiers d'exécution réels à leurs 8 ID d'actifs et rend visible la décision de publication, de relance ou de rejet.
API d'IA pour la génération par lots : liste de contrôle de lancement en production
Avant de passer de l'exercice à 8 actifs à un catalogue ou une bibliothèque de contenu en direct, confirmez chaque point ci-dessous.
- Chaque actif possède un
asset_idimmuable. - L'invite, le hachage de référence, le modèle, le format et la qualité sont enregistrés.
- Chaque soumission possède une clé d'idempotence lorsque le fournisseur en prend en charge une.
- La concurrence reste en dessous de la limite documentée réelle du compte.
- Des plafonds budgétaires par tâche, par lot et par jour existent.
- Les réponses 429, les réponses 5xx, les délais d'attente et les refus de contenu suivent des règles différentes.
- Les relances ont un maximum strict.
- Les résultats réussis sont archivés et associés immédiatement aux données sources.
- Un point de contrôle qualité par petits lots est franchi avant la libération du groupe suivant.
- Un examen final par échantillon vérifie l'identité du personnage, le texte, le format, les noms de fichiers et les droits.
Cette liste de contrôle maintient l'utilité d'une API d'IA pour la génération par lots lorsque le volume augmente. Elle laisse également une piste d'audit claire lorsqu'un éditeur demande pourquoi une image particulière a été générée, acceptée ou réexécutée.
FAQ : API d'IA pour la génération par lots
Qu'est-ce qu'une API d'IA pour la génération par lots ?
C'est un moyen de soumettre de nombreuses tâches d'IA indépendantes, de suivre leur exécution et de collecter les résultats plus tard. Une bonne implémentation conserve un ID d'actif métier durable pour chaque tâche, que le fournisseur utilise une tâche par lots asynchrone ou des requêtes simultanées normales.
Une API par lots est-elle meilleure que l'envoi de requêtes d'images en parallèle ?
Ni l'une ni l'autre n'est automatiquement meilleure. Utilisez des requêtes parallèles maîtrisées lorsque le flux de travail a besoin d'une progression immédiate. Utilisez une tâche par lots du fournisseur pour un volume non urgent lorsque ses règles documentées de file d'attente, de délai d'exécution et de coût conviennent à votre travail. Les deux nécessitent des journaux et une révision par actif.
Combien d'images d'IA dois-je mettre dans un seul lot ?
Commencez par 4 à 8 actifs visuels lorsque vous validez un nouveau schéma d'invite ou une référence de personnage. Augmentez seulement lorsque l'équipe peut associer chaque résultat, détecter rapidement une dérive et récupérer une tâche enfant échouée sans redémarrer le groupe. Les limites du fournisseur peuvent en autoriser bien plus, mais un lot utile sur le plan opérationnel est un lot révisable.
Comment les clés d'idempotence évitent-elles les coûts de génération en double ?
Elles identifient une soumission comme la même opération prévue après une relance. Si le point de terminaison prend en charge l'idempotence, le fournisseur peut éviter de traiter un appel réseau répété comme une génération entièrement nouvelle. Enregistrez la clé avec l'enregistrement de l'actif et confirmez la sémantique exacte dans la documentation du fournisseur.
Puis-je générer des images par lots à partir de la même référence de personnage ?
Oui. Utilisez une seule image de référence approuvée et autorisée ; joignez son hachage à chaque tâche enfant ; verrouillez les instructions d'identité ; et examinez un petit groupe de scènes avant d'étendre. La cohérence des références réduit l'ambiguïté, mais elle ne remplace pas le contrôle qualité visuel.
Dois-je relancer un lot entier échoué ou seulement les actifs échoués ?
Ne relancez que les actifs échoués. Archivez d'abord les succès, classez l'échec et créez un nouvel enregistrement de tentative pour la tâche enfant concernée. La resoumission d'un lot entier rend plus probables les actifs en double et les dépenses inutiles.


