Un rapport de test d'API tout vert est rassurant… jusqu'à ce que vous remarquiez que chaque assertion ne vérifie que le code HTTP 200. La réponse pourrait contenir l'enregistrement d'un autre client et réussir quand même.
Choisissez des ai tools for api testing en fonction du travail que vous avez déjà. Évaluez Postman Agent Mode si votre équipe maintient des collections, KushoAI si une spécification est votre point de départ, et Keploy si vous avez besoin de flux générés ou de tests de régression construits à partir du trafic enregistré. Examinez et exécutez les tests obtenus avant de leur faire confiance.
Ce guide couvre l'assistance IA pour tester des API ordinaires. Tester l'exactitude des réponses d'un modèle d'IA est un problème d'évaluation distinct.
Points clés
- Fournissez le contrat, les dépendances des requêtes et les attentes métier validées.
- Vérifiez si les assertions rejettent les données erronées, les champs manquants et les types incorrects.
- Achetez seulement après que les tests examinés s'exécutent de manière répétée dans votre environnement CI prévu.
La comparaison de produits ci-dessous reflète la documentation officielle consultée le 21 septembre 2026. Il ne s'agit pas d'un benchmark comparatif de trois comptes payants.
L'exemple détaillé utilise une spécification Swagger Petstore épinglée et distingue les attentes du contrat, le comportement observé et les copies de réponse délibérément modifiées.
Notre exécution locale a validé 5 tests réels et rejeté les 3 copies de réponse délibérément modifiées. Une sonde distincte sur un nom manquant a tout de même renvoyé 200, ce qui montre pourquoi la portée d'un rapport vert compte.
Ce que font réellement les AI Tools for API Testing
L'assistance IA intervient généralement à quatre endroits du test d'API. Un modèle lit votre spécification, propose des scénarios, rédige des assertions et aide à expliquer les échecs. Chaque partie exige des preuves différentes. Une explication plausible d'un échec ne prouve pas que le correctif proposé est correct.
Pour la revue de spécification, fournissez le fichier OpenAPI et les règles métier pertinentes. Pour la planification des scénarios, ajoutez des exemples de données valides et de limites connues. Pour les scripts exécutables, incluez votre runner, votre configuration d'authentification et vos conventions de fixtures. Pour le diagnostic, fournissez la requête réelle, la réponse et le message d'échec après avoir retiré les secrets.
Gardez ces quatre mécanismes distincts lors de l'évaluation des produits :
- Génération par LLM : propose des tests à partir du langage, des schémas et des exemples. Un relecteur doit vérifier les résultats attendus.
- Rejeu de trafic : compare le comportement ultérieur avec les interactions capturées, souvent à l'aide des réponses de dépendances enregistrées.
- Tests basés sur les propriétés : construisent systématiquement des entrées pour éprouver des propriétés telles que la conformité au schéma.
- Exécution de tests : envoie des requêtes, évalue les assertions et renvoie des rapports et des codes de sortie.
Un produit peut combiner plusieurs mécanismes. Demandez quel mécanisme a produit chaque test et ce qui détermine son résultat attendu. Enregistrer une réponse incorrecte peut perpétuer la même erreur comme référence de régression. Générer un nom de test soigné peut masquer une attente non étayée.
Réfléchissez aux assertions à trois niveaux. Premièrement, le serveur a-t-il répondu avec succès ? Deuxièmement, le corps possède-t-il les champs et types documentés ? Troisièmement, ce corps représente-t-il la ressource et l'opération que vous avez demandées ?
Pour une recherche d'animal, un objet valide avec un ID entier échoue tout de même au troisième contrôle si cet ID appartient à un autre animal. Inversement, un ID correspondant à celui demandé ne prouve pas que chaque champ respecte le schéma. Utilisez les deux contrôles, et ajoutez des règles métier uniquement là où l'équipe dispose d'une source validée.
Le résultat concret que vous recherchez est un actif de test maintenable doté d'un oracle explicable : une raison claire pour laquelle chaque résultat doit réussir ou échouer. Comptez les scénarios utiles après revue, y compris ceux que vous rejetez, plutôt que de vous réjouir de la longueur de la liste générée initialement.
Les AI Tools for API Testing comparés par flux de travail
Partez de l'artefact que votre équipe peut fournir aujourd'hui. Migrer une collection établie, reconstituer des règles métier manquantes et mettre en place l'enregistrement des dépendances sont des projets différents. Un outil adapté à un point de départ peut générer du travail supplémentaire à un autre.
| Outil ou approche | Entrée utile | Rôle de l'IA ou de l'automatisation | Voie d'exécution et de CI | Sortie vérifiable | Question principale de l'essai |
|---|---|---|---|---|---|
| Postman Agent Mode | Collections, requêtes, réponses, environnements, specs | Rédige et modifie des scripts de test dans le contexte de l'espace de travail | Collection Runner et flux CLI compatible | Assertions JavaScript Postman standard | Préserve-t-il vos variables et teste-t-il le contrat ? |
| KushoAI | OpenAPI, collection Postman, cURL | Génère des scénarios et des suites de tests ; prend en charge le raffinement en langage naturel | Exécution sur la plateforme et intégration CI documentée ; vérifiez l'offre | Inspectez les requêtes générées, les dépendances et les résultats attendus | Votre offre sélectionnée peut-elle exécuter et conserver la suite là où vous en avez besoin ? |
| Keploy | Specs ou définitions de requêtes ; ou bien trafic réel | Génération par IA et une voie distincte d'enregistrement/rejeu | Flux générés ou tests enregistrés dans des environnements locaux/CI pris en charge | Examinez les définitions de tests, les références et les mocks de dépendances | Quelle voie couvre vos modes de défaillance réels ? |
| Runner existant plus un LLM | Matrice validée, spec, conventions de fixtures | Rédige du code à des fins de revue | Votre pytest ou autre runner établi | Code validé dans votre dépôt | La revue coûte-t-elle moins cher que d'écrire directement les mêmes tests ? |
Postman Agent Mode pour les collections existantes
Postman est une première évaluation raisonnable lorsque votre collection contient déjà un ordre de requêtes utile, des variables d'environnement et une configuration d'authentification. Agent Mode peut utiliser ce contexte pour générer des scripts de test JavaScript standard. Ces scripts peuvent s'intégrer au flux d'exécution de collection existant plutôt que d'exiger un nouveau langage d'assertion.
Un essai ciblé est plus révélateur que de lui demander de tout tester. Sélectionnez la requête qui récupère une ressource créée plus tôt dans la collection. Fournissez son schéma et demandez une validation des champs obligatoires, des types de champs documentés et une assertion reliant l'ID renvoyé à l'ID de création stocké.
Inspectez ensuite les modifications proposées avant de les accepter. Un exemple de réponse peut contenir un animal nommé Milo. Une égalité avec Milo est pertinente si votre fixture a explicitement créé Milo ; elle est fragile si le générateur a copié un nom depuis un enregistrement d'exemple partagé. Le même littéral peut être une assertion valide ou une dépendance accidentelle, selon son origine.
Vérifiez soigneusement la portée des variables. Un ID stocké dans une variable d'environnement doit être disponible pour la requête ultérieure et doit appartenir à cette exécution. Des variables partagées entre exécutions concurrentes peuvent créer des échecs intermittents qui ressemblent à des défauts du serveur. Demandez au générateur d'expliquer la mise en place et le nettoyage ainsi que les assertions.
Pour le premier test d'acceptation, exécutez la collection deux fois sur des données isolées, puis inspectez la représentation exportée ou versionnée. Confirmez qu'un collègue peut examiner les scripts modifiés sans refaire la conversation avec l'IA. Vérifiez également que votre CLI, votre reporter et votre offre choisis prennent en charge la voie d'exécution que vous comptez utiliser.
Aucune génération Postman exploitée n'est présentée ici. La question d'évaluation utile est de savoir si son contexte d'espace de travail réduit votre travail de revue sur une collection existante. Cela nécessite votre propre collection et un essai au niveau du compte, et non une conclusion tirée d'une capture d'écran produit.
KushoAI pour la génération de tests à partir de specs
KushoAI accepte des entrées Swagger/OpenAPI, Postman et cURL et documente la génération de tests, le raffinement en langage naturel et l'exécution en CI. Cela en fait un candidat lorsqu'une équipe dispose de définitions d'API utiles mais d'un arriéré de tests non écrits. Ce sont des capacités décrites par le fournisseur, et non des résultats mesurés de détection de défauts. (Documentation KushoAI, septembre 2026)
Choisissez l'entrée offrant le contexte fiable le plus riche. Une requête cURL peut décrire une requête valide, mais elle en dit généralement peu sur les champs facultatifs, les valeurs d'énumération autorisées ou les erreurs documentées. Un fichier OpenAPI ajoute de la structure ; une matrice de scénarios validée ajoute l'intention que la structure peut laisser ambiguë.
Pour un essai sur Petstore, demandez des cas distincts pour un animal valide, un nom obligatoire manquant, un ID de type incorrect et un filtre de statut invalide. Vérifiez si l'outil distingue les exigences du corps de requête des exigences du schéma de réponse. Celles-ci peuvent sembler similaires dans un exemple tout en imposant des obligations différentes.
Ensuite, examinez un flux connecté de création-lecture-mise à jour. La lecture doit utiliser l'ID associé à la configuration actuelle. La mise à jour doit cibler la même ressource, et une lecture ultérieure doit vérifier le champ modifié. Quatre requêtes indépendantes aux noms de test séduisants n'établissent pas que la chaîne de dépendances fonctionne.
Traitez la première génération comme une proposition. Conservez les attentes documentées, révisez les scripts dont le flux de données est incorrect et signalez les résultats sous-spécifiés pour une décision sur les exigences. Si l'outil suggère plusieurs cas équivalents de champ manquant, retenez les distinctions utiles plutôt que de payer pour maintenir des doublons.
Avant d'acheter, demandez à exécuter la suite depuis votre pipeline prévu et inspectez l'artefact d'échec. Confirmez les autorisations CI actuelles, la gestion des identifiants et les formats d'export disponibles sur l'offre sélectionnée. Ne supposez pas qu'un essai interactif gratuit accorde les mêmes droits d'automatisation qu'un déploiement d'équipe.
Keploy pour les tests générés et le rejeu de trafic
La documentation de Keploy présente deux points de départ distincts. La génération par IA accepte des ressources telles que OpenAPI, Postman, cURL ou des endpoints et construit des flux d'API connectés. L'enregistrement et le rejeu capturent les interactions d'API et leurs dépendances pour une exécution ultérieure avec des mocks. La description du flux IA et celle de l'enregistrement des dépendances ne doivent pas être considérées comme des mécanismes identiques. (Documentation Keploy, septembre 2026)
Si votre difficulté consiste à reproduire ce qu'une application a fait avec une base de données ou un service en amont, évaluez la voie d'enregistrement. Capturez un petit parcours de création-lecture-mise à jour dans un environnement isolé, inspectez les dépendances capturées et rejouez après une modification contrôlée de l'application. Vérifiez ce que le runtime prend en charge avant de planifier un déploiement plus large.
Si votre difficulté consiste à dériver des cas à partir d'une spécification, évaluez la voie de génération séparément. Demandez comment ses requêtes proposées obtiennent des identifiants, transportent des ID entre les étapes et nettoient les données. La présence de fonctionnalités d'enregistrement ailleurs dans le produit ne répond pas à ces questions pour une suite générée.
Les valeurs dynamiques exigent du discernement. Un horodatage peut légitimement varier ; un ID de ressource peut relier deux requêtes et donc nécessiter une comparaison. Ignorer largement chaque champ changeant peut masquer des erreurs. Examinez les exclusions champ par champ et conservez les comparaisons qui expriment des relations significatives.
Inspectez également la référence avant de l'accepter. Un enregistrement qui contient un total erroné, une réponse de repli accidentelle ou des données obsolètes peut se rejouer de manière cohérente. La cohérence aide à détecter les changements, mais l'équipe décide toujours si le comportement capturé était correct.
Un complément utile : Schemathesis fournit des tests d'API basés sur les propriétés et pilotés par le schéma. Il peut éprouver une API avec des entrées générées aux côtés d'exemples examinés. Traitez-le comme un mécanisme de test différent, et non comme un synonyme de générateur de tests par LLM. Ses résultats doivent encore être interprétés par rapport au contrat et à l'implémentation.
AI Tools for API Testing gratuits : limites et coûts
« Gratuit » peut désigner un client, une allocation d'IA limitée, un runner open source ou un essai temporaire. Ces offres couvrent différentes parties du flux de travail. Un client gratuit n'établit pas que la génération automatisée, l'exécution planifiée ou l'export de rapports sont eux aussi gratuits.
Au 21 septembre 2026, l'offre gratuite de Postman indique 50 crédits IA par mois. Les crédits sont son unité de facturation ; ils ne signifient pas 50 tests ni 50 suites complètes. Son tableau comparatif distingue l'allocation d'IA de l'exécution, des fonctionnalités pilotées par les données et des exports de résultats. (Tarifs Postman, septembre 2026)
La présentation tarifaire actuelle de KushoAI utilise Developer Edition et Enterprise. Keploy distingue Playground, Pro et Enterprise, en plus de son offre open source. Utilisez l'écran d'achat actuel pour confirmer les limites pertinentes. Les anciens comparatifs d'outils peuvent décrire des noms d'offres retirées ou combiner des allocations facturées séparément.
| Composante de coût | Ce qu'il faut consigner dans un essai | Ce qui peut rendre la facture trompeuse |
|---|---|---|
| Sièges et offre | Éditeurs, relecteurs, intervalle de facturation, fonctionnalités requises | Comparer les prix annuels affichés avec des engagements mensuels |
| Génération par IA | Utilisation des crédits pour la même tâche validée, y compris les nouvelles tentatives | Supposer qu'un crédit équivaut à un test |
| Exécution | Exécutions locales, exécutions hébergées, jobs CI, planifications, rapports | Considérer les exécutions interactives comme une autorisation pour chaque voie d'automatisation |
| Modèle indépendant | Jetons d'entrée et de sortie pour la rédaction et la revue | Ignorer les soumissions répétées de la spec complète |
| Temps d'ingénierie | Revue, réparation des fixtures, tri des échecs, maintenance | Compter le temps de génération initial comme temps de livraison total |
Utilisez une petite tâche d'acceptation pour estimer le coût. Donnez à chaque candidat les mêmes opérations et attentes, puis consignez combien de scénarios survivent à la revue. Gardez le temps de génération, le temps de revue manuelle et le temps d'exécution dans des colonnes distinctes. Attendre un modèle et corriger une assertion dangereuse imposent des coûts différents à l'équipe.
Un dénominateur utile est le nombre de scénarios examinés et exécutables que votre équipe conserverait. Cela évite qu'un générateur avec de nombreux cas redondants paraisse moins cher simplement parce que sa sortie est plus longue. Consignez les cas non étayés que vous avez retirés et les exigences qui restent non résolues.
Cet article ne revendique aucun pourcentage mesuré d'économie de main-d'œuvre ni ne compare le débit des offres payantes. Ces chiffres nécessitent un essai contrôlé avec des entrées équivalentes. Pour une décision d'achat, incluez une modification de maintenance réaliste, comme l'ajout d'un champ obligatoire, afin que l'estimation couvre le prochain sprint autant que la première démo.
AI Tools for API Testing : de l'OpenAPI à une première exécution
Utilisez une instance locale isolée du vrai projet Swagger Petstore. Épinglez le commit d57941e8fe959e508796b27469b1e8bba73392dc ; sa spécification déclare OpenAPI 3.0.4 et la version d'application 1.0.29-SNAPSHOT. Lisez le fichier épinglé plutôt qu'une démo publique mise à jour indépendamment. (Spécification Swagger Petstore, septembre 2026)
1. Préparez le service et consignez l'environnement. Obtenez le dépôt via cette page source, extrayez la révision épinglée et installez un JDK et Maven compatibles. Le README du projet donne cette commande de démarrage depuis le répertoire du dépôt :
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty utilise le port 8080. Définissez BASE_URL sur votre origine HTTP loopback sur ce port avec /api/v3 ajouté. Confirmez que /openapi.json est lisible relativement à cette base avant de tester.
Cette exécution a utilisé Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 et jsonschema 4.26.0. Consignez aussi vos versions. La compilation depuis les sources télécharge des dépendances et Swagger UI, donc un commit applicatif épinglé seul ne constitue pas une compilation entièrement hermétique.
2. Importez la spécification épinglée. Sélectionnez /pet, /pet/{petId} et /pet/findByStatus. Gardez delete disponible pour le nettoyage. Remplacez l'emplacement du serveur public de la spécification par votre base locale. Vérifiez ce paramètre avant d'envoyer toute requête d'écriture.
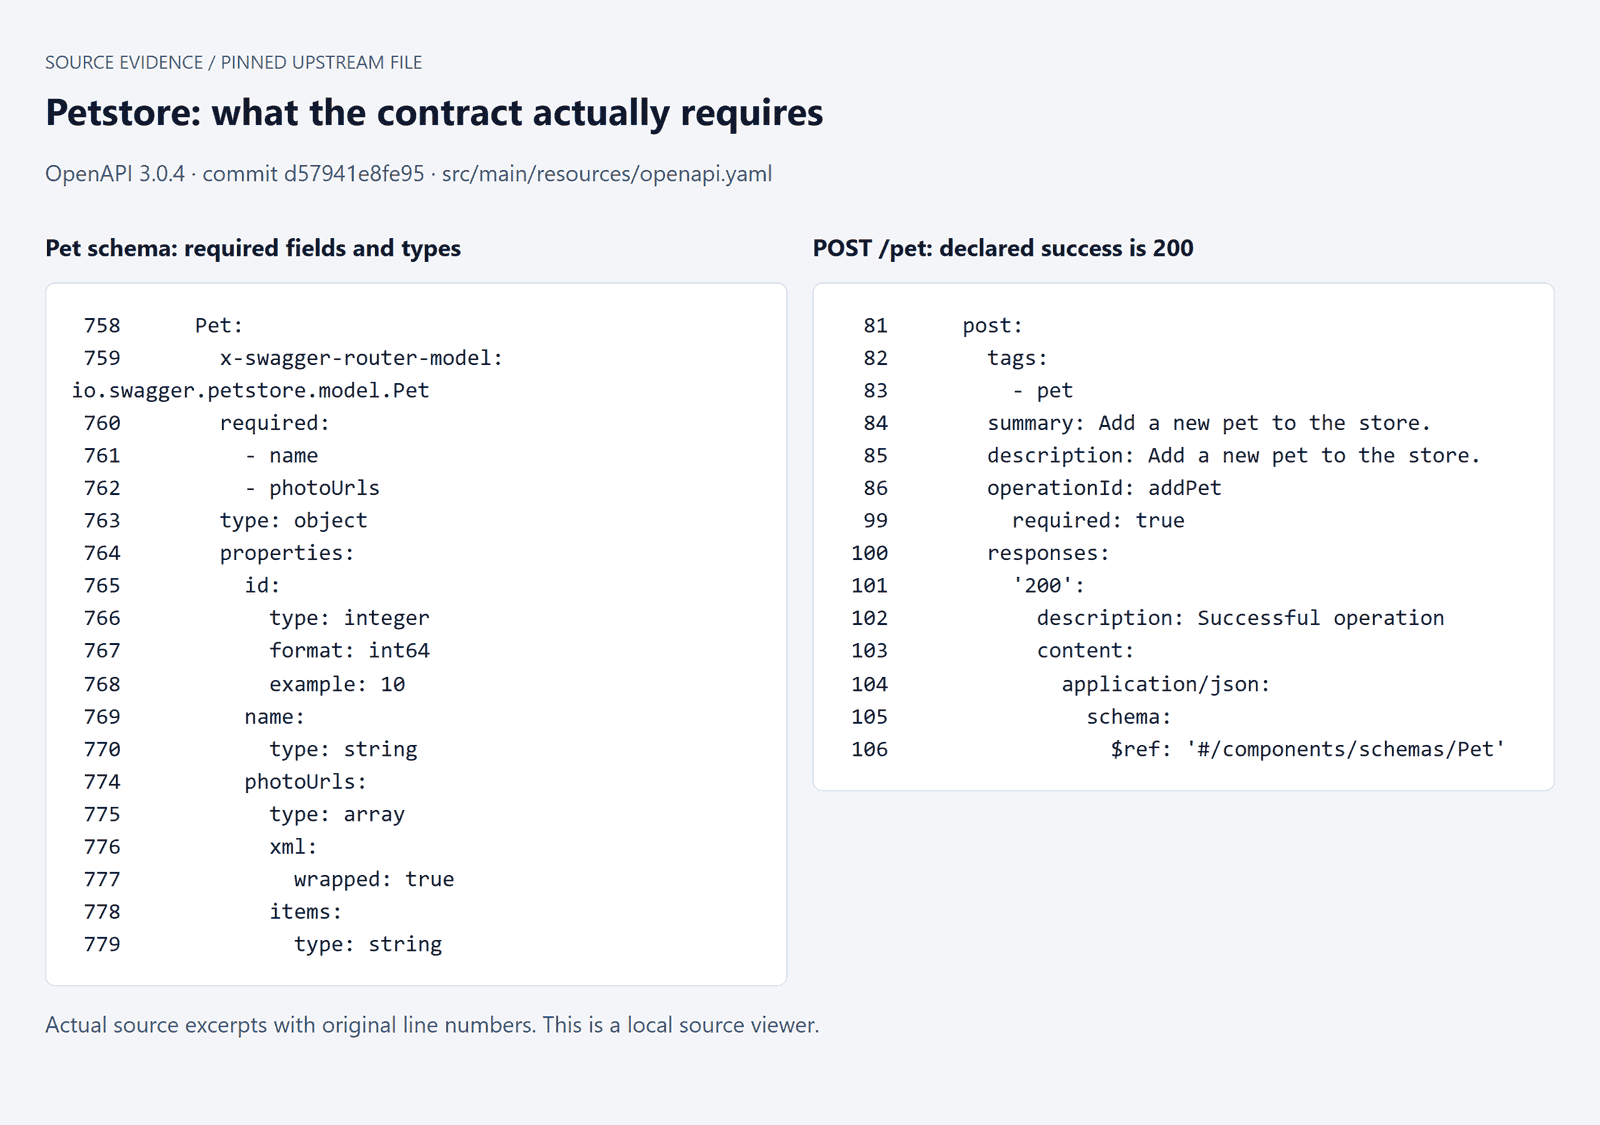 Source OpenAPI Petstore épinglée montrant les champs obligatoires et les définitions d'opérations sélectionnées
Extraits réels des sources rendus localement : Pet exige name et photoUrls ; POST /pet déclare 200 en cas de succès. Les numéros de ligne d'origine sont conservés.
3. Générez une matrice avant le code exécutable (Prompt A). Joignez la spécification et collez ce prompt dans le générateur choisi :
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Examinez l'oracle pour chaque scénario. Petstore documente une création réussie comme 200. Son schéma Pet exige name et photoUrls ; id a un type entier mais ne figure pas dans cette liste des champs obligatoires. La validation des champs manquants et l'identité requête-réponse nécessitent donc des contrôles différents.
| Opération | Entrée ou séquence | Preuve du résultat attendu | Assertion à examiner | Statut d'exécution |
|---|---|---|---|---|
| addPet, getPetById | Créer, puis lire l'ID actuel | 200 documenté et schéma Pet ; attente de flux explicite | Valider le corps et comparer l'ID renvoyé | Réussi localement |
| updatePet, getPetById | Modifier le nom et relire | Opération de mise à jour plus intention de fixture validée | Même ID, nouveau nom, schéma valide | Réussi localement |
| findPetsByStatus | Interroger available après la configuration | Énumération documentée et réponse de tableau réussie | Tous les statuts renvoyés correspondent ; l'ID créé est présent | Réussi localement |
| getPetById | ID de chemin non entier | 400 d'ID invalide documenté | Statut exact pour ce cas documenté | Réussi : 400 |
| findPetsByStatus | Valeur d'énumération non documentée | 400 de statut invalide documenté | Statut exact, conserver toute divergence | Réussi : 400 |
| addPet | Omettre le name obligatoire | Champ de schéma obligatoire ; les descriptions 400 et 422 ne couvrent pas toutes les variations | Consigner le comportement ; résoudre le mappage exact avant de bloquer | A renvoyé 200 sans name ; divergence conservée |
5. Générez et inspectez le fichier d'exécution (Prompt B). Joignez la matrice et la spécification validées avec ce prompt :
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Exécutez, conservez et nettoyez. Utilisez un ID d'animal propre à l'exécution, capturez la réponse de création et transmettez son ID aux requêtes ultérieures. Validez la mise à jour par une nouvelle lecture. Une réponse de mise à jour réussie ne prouve pas à elle seule que le serveur a persisté la modification.
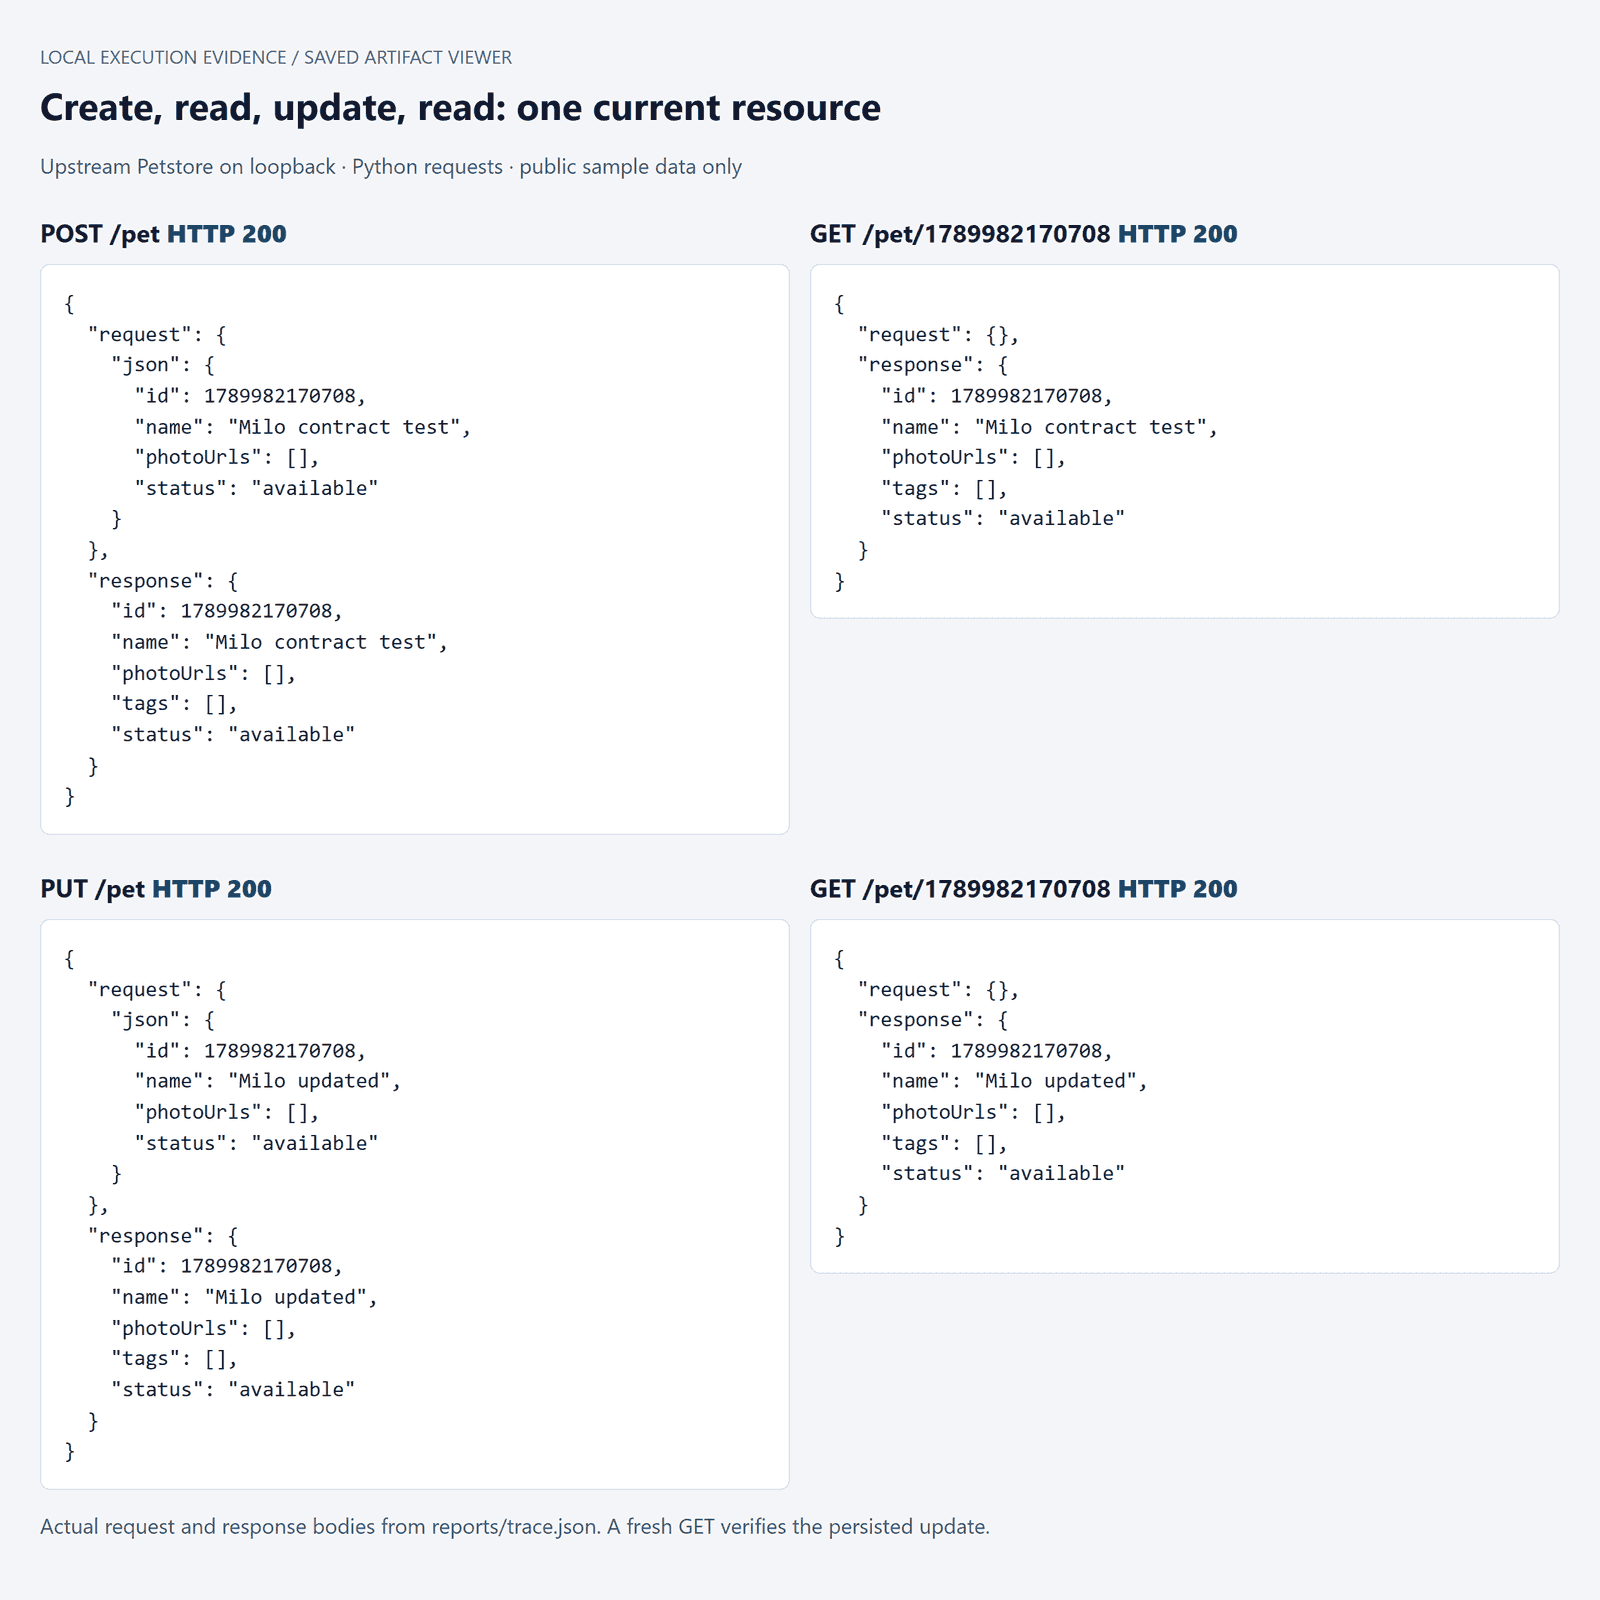 Preuve locale de la chaîne de requêtes Petstore montrant création, recherche, mise à jour et transfert d'ID
Requêtes et réponses locales enregistrées : le même ID propre à l'exécution survit à la création, la lecture, la mise à jour et une nouvelle lecture. Les 4 requêtes affichées ont toutes renvoyé 200.
Enregistrez les corps de requête, les réponses, les échecs d'assertion et le résultat du nettoyage. Limitez la suppression aux ID créés par cette exécution. Conservez les réponses inattendues comme constats, y compris les cas où l'implémentation de démonstration accepte des entrées invalides. N'ajustez pas les assertions simplement pour obtenir une capture d'écran verte.
Ce que cette exécution a révélé : les 5 fonctions de test réelles ont réussi, y compris les contrôles d'ID invalide et de statut invalide renvoyant 400. La sonde distincte sur un nom manquant a renvoyé 200 et un corps sans name. Nous avons conservé cette divergence de schéma en dehors de la suite verte ; son mappage d'erreur exact prévu nécessite encore une clarification. Les deux enregistrements créés ont été supprimés avec succès.
Les tests locaux ont été rédigés dans le cadre de cette exécution pour l'article, indépendamment des trois outils commerciaux. Les 5 tests réels ont tous été conservés ; aucun n'a été retiré ni n'a vu ses attentes assouplies après exécution. Le temps de revue humaine n'a pas été mesuré. Le dossier de preuves contient les fichiers de test, le verrouillage des dépendances, les réponses brutes et les instructions de reproduction.
Comment valider les AI Tools for API Testing
Une assertion utile doit rejeter une mauvaise réponse pertinente. Vous pouvez tester cette propriété sans modifier le service en cours d'exécution : enregistrez une vraie réponse réussie, copiez-la et modifiez délibérément un champ à la fois. Ce sont des mutations de réponse contrôlées, et non des vulnérabilités de production ni un benchmark complet de tests de mutation.
Gardez le statut et le corps d'origine ensemble. Exécutez d'abord le validateur contre la réponse non modifiée et vérifiez qu'il accepte la référence. Créez ensuite trois copies indépendantes. Modifiez l'ID, modifiez le type du name, et supprimez le name obligatoire. Chaque copie doit échouer pour une raison correspondant à l'altération.
| Référence enregistrée | Modification contrôlée | Contrôle pertinent | Résultat réel |
|---|---|---|---|
| Recherche réussie de l'animal actuel | Substituer un autre ID entier ; conserver le statut 200 | L'ID renvoyé égale l'ID attendu pour cette exécution | Échec : les ID attendu et réel diffèrent |
name de type chaîne | Remplacer le name par un nombre | Type chaîne du schéma Pet | Échec : 42 n'est pas une chaîne |
name obligatoire présent | Supprimer le name | Liste des champs obligatoires du schéma Pet | Échec : name est obligatoire |
L'exemple de l'ID expose une faiblesse courante. Un validateur de schéma peut accepter le mauvais entier parce que la forme reste valide. L'assertion de relation fournit la contrainte manquante. Dans les deux autres exemples, la validation de schéma fournit des contraintes qu'un contrôle portant uniquement sur le statut ne peut pas voir.
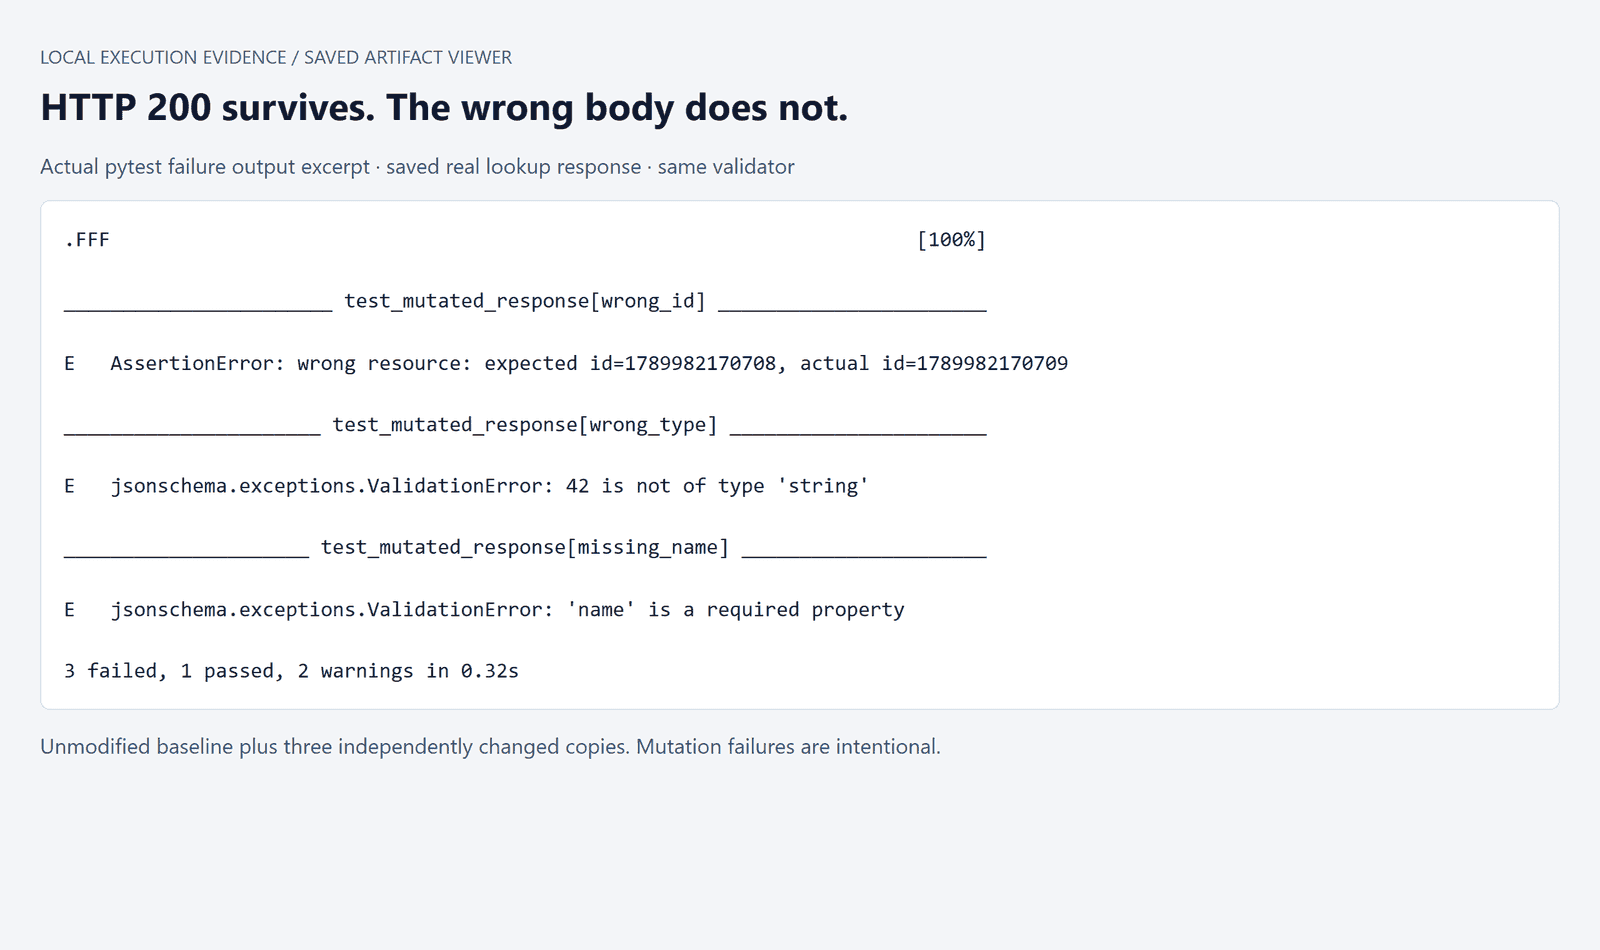 Sortie réelle d'échec d'assertion pour les mutations de réponse Petstore contrôlées
Extraits réels d'échecs pytest : la réponse d'origine a réussi, et les 3 mutations indépendantes ont toutes échoué. Ces échecs ont été délibérément provoqués dans des copies enregistrées.
Dans cette exécution, la référence inchangée a réussi et 3 sur 3 copies altérées ont échoué. L'exécution des mutations a renvoyé le code de sortie 1, préservant le signal d'échec. Le validateur applique les contraintes structurelles pertinentes du schéma Pet et un contrôle distinct de relation d'ID ; cette petite démonstration n'est pas un validateur complet de conformité OpenAPI.
Pour un audit reproductible, joignez le fichier de test et la spécification épinglée au Prompt C :
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Examinez avec un soin particulier les modifications « auto-réparatrices » suggérées. Remplacer un 400 attendu par un 200 peut masquer une régression. Un changement légitime de contrat nécessite une référence aux exigences et une modification de test examinée. La réponse observée est une preuve pour l'investigation, et non une autorisation automatique de redéfinir la justesse.
Séparez les catégories d'échec avant de demander un correctif à l'IA. Un timeout peut indiquer un environnement indisponible. Un échec de recherche peut provenir d'une fixture cassée. Une erreur d'import relève du code de test. Une divergence reproductible avec le contrat convenu peut relever du produit. Préservez suffisamment de contexte pour les distinguer.
Rapportez le dénominateur honnêtement. Détecter trois changements de réponse sélectionnés prouve la sensibilité à ces trois changements. Cela n'établit ni la couverture des endpoints, ni la couverture du code, ni la couverture de sécurité, ni un taux général de détection de défauts. De même, un grand nombre de tests en dit peu sur les scénarios en double ou la force de leurs assertions.
L'authentification et l'autorisation méritent des tests indépendants dans une application appropriée : identifiants manquants, identifiants expirés et accès aux ressources d'un autre utilisateur. Le comportement de démonstration de Petstore ne peut pas établir que vos contrôles d'accès de production fonctionnent.
AI Tools for API Testing en CI/CD
Une fois qu'un relecteur accepte la suite, validez cette version exacte. Une build doit exécuter des attentes connues contre l'application candidate. Régénérer les tests à chaque build introduit une composante changeante supplémentaire et rend les échecs plus difficiles à reproduire.
Épinglez le runner, les dépendances, les fixtures et la spécification. Stockez un verrouillage des dépendances aux côtés des tests et conservez la révision de l'application dans le rapport. Résolvez les secrets depuis l'environnement CI, gardez-les hors des fichiers générés et vérifiez que les journaux d'échec ne les exposent pas.
Avec pytest, la forme de rapport de base est simple :
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Fournissez BASE_URL via l'environnement du job. Démarrez le service local dans le cycle de vie du job, attendez qu'il soit prêt, puis exécutez la suite. Collectez toujours le rapport et le journal du service, même en cas d'échec. Terminez en arrêtant le service propre au job et en nettoyant ses données ; évitez les commandes de nettoyage à l'échelle du processus sur des agents partagés.
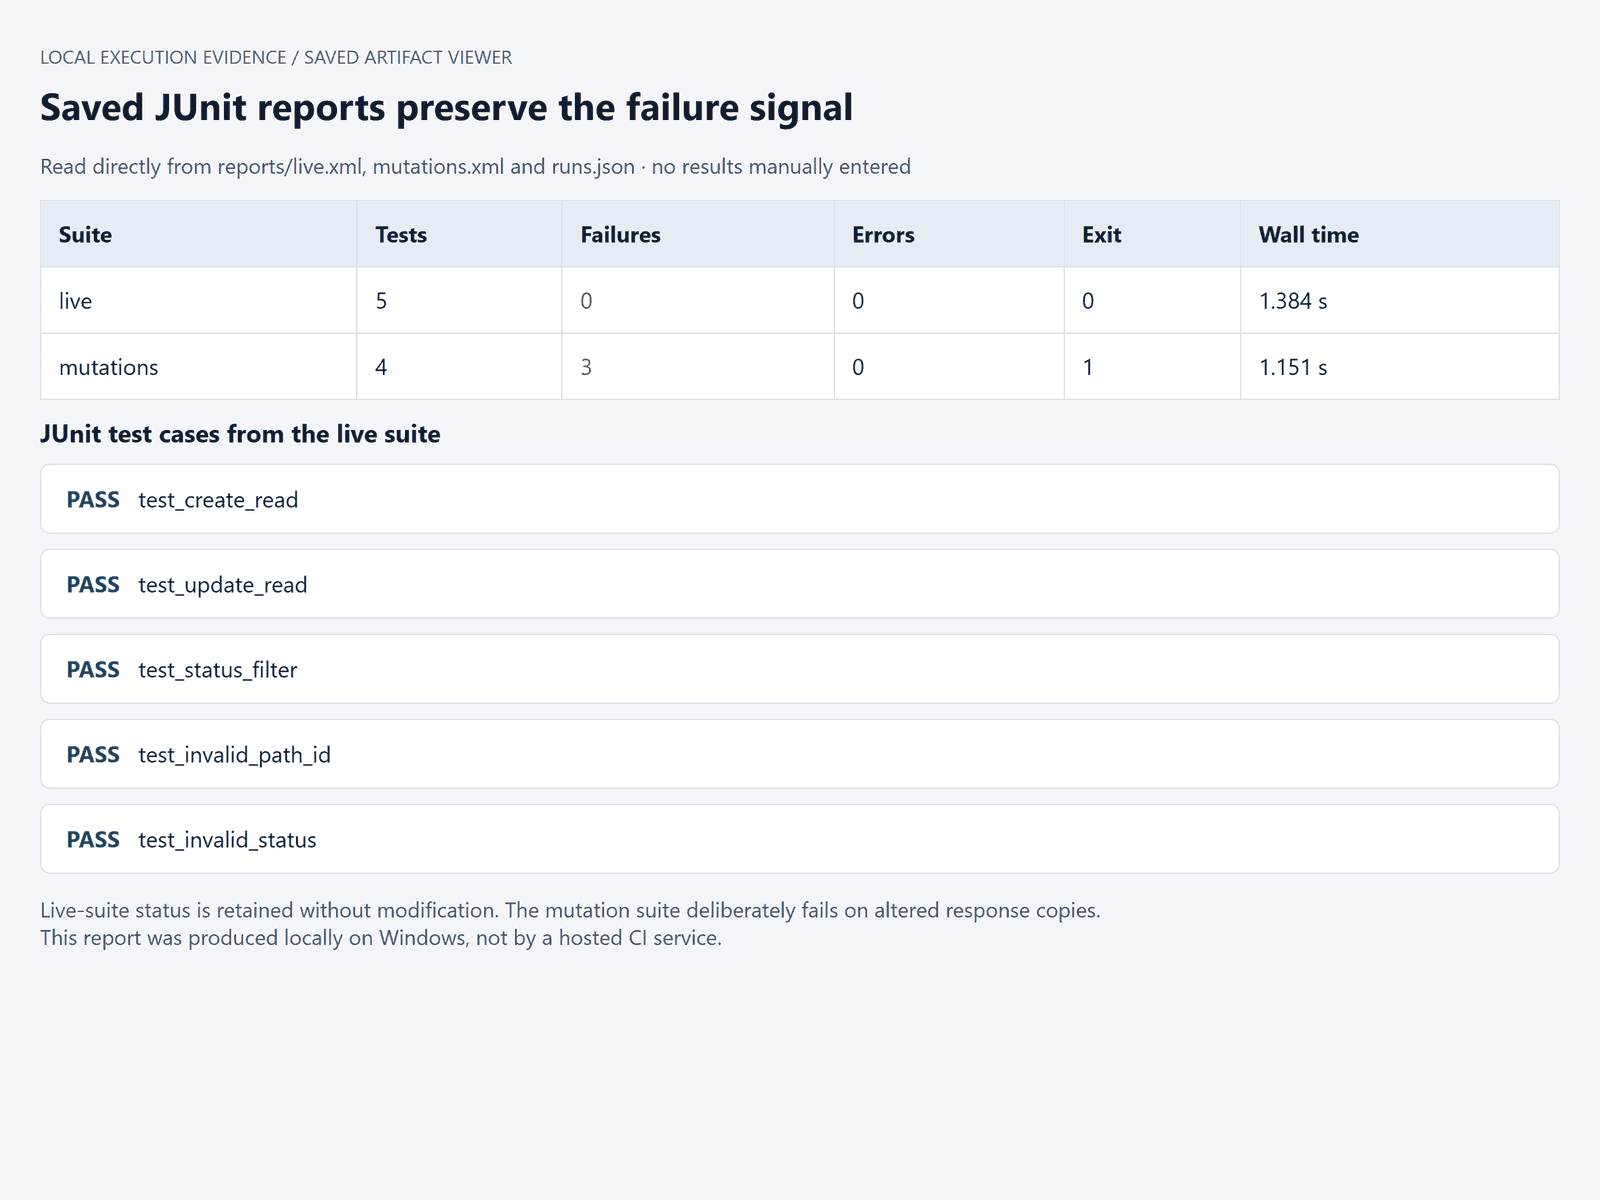 Rapport JUnit pytest local avec résultats distincts pour contrat réel et vérification d'assertionsActuel local
Résultats JUnit : 5 tests réels réussis ; la suite de copies contrôlées contient 1 référence réussie et 3 échecs intentionnels. Aucune exécution CI hébergée n'est revendiquée.
Les temps réels mesurés, y compris le démarrage du processus Python, étaient de 1,384 seconde pour la suite réelle et 1,151 seconde pour la suite de copies contrôlées. Ceux-ci excluent la compilation/démarrage du service, l'installation des dépendances, la rédaction et la revue. Les fichiers JUnit et les journaux non abrégés sont enregistrés séparément.
Testez le chemin d'échec avant de vous fier au point de contrôle. Une assertion échouée doit produire un code de sortie de job en échec. Les nouvelles tentatives doivent être limitées et justifiées pour des problèmes transitoires d'infrastructure connus ; des tentatives répétées qui finissent par masquer une défaillance produit rendent le point de contrôle moins informatif.
Gérez explicitement les échecs de nettoyage. Gardez l'échec de l'assertion principale visible, consignez quelle ressource reste et laissez le teardown signaler son propre problème. Les jobs parallèles ont besoin d'identifiants ou d'espaces de noms distincts. Un test qui réussit seul mais lit les données d'un autre job n'est pas prêt pour un usage sans surveillance.
Si vous disposez déjà de pytest, vous pouvez choisir le modèle de rédaction séparément. Atlas Cloud correspond à ce rôle plus étroit : une couche de modèle pour un flux de travail personnalisé dont l'exécution et le reporting existent déjà. Il n'est pas présenté ici comme une plateforme complète de test d'API ni comme un backend natif pour les trois produits ci-dessus.
Pour cette évaluation, ouvrez DeepSeek V4.1 Flash, ID de modèle deepseek-ai/deepseek-v4.1-flash, et fournissez la même spécification publique et la même matrice examinée que celles utilisées localement. Utilisez le Prompt B, puis enregistrez le brouillon renvoyé séparément du test examiné. Comparez ses hypothèses avec le contrat avant d'exécuter quoi que ce soit.
Si elle est exposée par l'interface, une température de 0,2 est un réglage de départ pour la rédaction, et non une garantie de déterminisme. Vérifiez la limite de sortie disponible par rapport à la taille de votre suite. Consultez le catalogue de modèles actuel pour la tarification des jetons plutôt que d'établir un budget à partir d'un ancien article.
La répartition du travail reste explicite : le modèle propose du code, un relecteur approuve les attentes et le runner produit les résultats. Le verrou d'accès à l'environnement de test a empêché une exécution Atlas complète pour cet article, il s'agit donc d'une recette d'évaluation plutôt que d'un résultat de modèle mesuré. Vous pouvez évaluer cette voie sans migrer un runner de test fonctionnel ni confier ses responsabilités d'exécution à un modèle de chat.
Choisir les AI Tools for API Testing pour votre équipe
Choisissez l'évaluation la plus petite susceptible de changer votre décision. Utilisez un flux de travail connecté, un cas négatif documenté et quelques réponses erronées contrôlées. Gardez des entrées équivalentes entre les candidats. Une expérience d'intégration soignée ne doit pas peser plus lourd qu'un test incapable d'identifier la mauvaise ressource.
Pour un flux de travail de collection mature, commencez par évaluer les fonctionnalités d'IA de cet espace de travail. La configuration d'environnement existante et les dépendances des requêtes constituent un contexte précieux. Mesurez si les modifications générées économisent du travail de revue sans introduire d'hypothèses fragiles.
Pour une équipe disposant d'une spécification solide et d'un arriéré de rédaction, évaluez la génération à partir de la spec. Faites attention à ce qui se passe lorsque la spécification est incomplète. Un générateur qui signale clairement les attentes manquantes est plus facile à examiner qu'un générateur qui les invente avec assurance.
Pour une application dont les défaillances dépendent du comportement en amont, évaluez l'enregistrement et le rejeu. Inspectez les références capturées et la prise en charge des dépendances avant d'investir dans de grands enregistrements. Décidez quels champs dynamiques peuvent varier et quelles relations doivent rester intactes.
Pour une équipe disposant d'un runner stable, évaluez un modèle indépendant pour la rédaction et la revue. Vous conservez le format d'exécution que vous connaissez déjà, mais vous assumez aussi l'intégration, la conception des fixtures et la maintenance. Incluez cette responsabilité dans le calcul des coûts.
Avant de payer pour des ai tools for api testing, exigez cinq démonstrations concrètes :
- La suite examinée s'exécute contre votre environnement prévu.
- Les erreurs contrôlées pertinentes font échouer les assertions appropriées.
- Les tests et les rapports utiles peuvent être conservés dans un format acceptable.
- Les exécutions répétées, y compris en CI, préservent l'isolation et les signaux d'échec.
- Les coûts de génération, d'exécution et de maintenance correspondent au budget de l'équipe.
Assignez quelqu'un à la maintenance de la suite acceptée. Un changement de spécification doit déclencher une revue des assertions, des fixtures et des consommateurs concernés. Conservez les anciennes preuves d'échec jusqu'à ce que le changement soit compris. Cela facilite l'évaluation de la prochaine version et donne à l'équipe une raison de faire confiance à un rapport vert.
Questions fréquentes
Quel outil d'IA dois-je utiliser pour tester des API ?
Partez de vos entrées existantes. Évaluez Postman Agent Mode pour les collections établies, KushoAI pour la génération guidée par spécification, et Keploy pour ses voies distinctes de génération de flux et d'enregistrement. Si votre équipe maintient déjà pytest ou un autre runner, un modèle de rédaction distinct peut convenir. Utilisez le même petit flux de travail pour évaluer les assertions, l'exécution et l'effort de revue de chaque candidat.
Existe-t-il des AI tools for API Testing gratuits ?
Il existe des clients gratuits, des outils de test open source et des allocations d'IA limitées. Ils répondent à des besoins différents. L'offre gratuite de Postman indique 50 crédits IA mensuels au 21 septembre 2026 ; ce n'est pas un nombre de tests. Vérifiez si vos fonctionnalités requises d'export, d'automatisation, de reporting et de collaboration sont incluses avant de considérer un essai interactif comme une solution CI gratuite.
L'IA peut-elle générer des tests d'API à partir d'une spécification OpenAPI ?
Oui, un générateur peut utiliser les opérations, les schémas, les paramètres et les définitions de réponse pour proposer des tests. La spécification peut toutefois omettre des règles métier ou laisser les mappages d'erreur ambigus. Fournissez des attentes validées et examinez le résultat. Dans l'exemple Petstore épinglé, une création réussie est documentée comme 200, ce qui illustre pourquoi les conventions REST familières ne peuvent pas remplacer le contrat réel.
Comment savoir si les assertions générées par l'IA sont utiles ?
Vérifiez trois choses : les contraintes de schéma documentées, les relations entre requêtes et réponses, et la sensibilité à des données délibérément incorrectes. Enregistrez une réponse réelle, modifiez une propriété pertinente et relancez le même validateur. Conservez le message d'échec. Cela fournit des preuves étroites et reproductibles sur ces assertions, tout en laissant les questions de couverture plus large et de sécurité ouvertes pour des tests séparés.
Puis-je exécuter des tests d'API générés par l'IA en CI/CD ?
Oui, lorsque le format généré, le runner, l'environnement et l'offre prennent en charge cette voie. Validez les tests examinés, installez des dépendances épinglées, utilisez des fixtures isolées et exportez un rapport structuré tel que JUnit. Vérifiez que les échecs renvoient un code de sortie non nul. Une exécution locale réussie prépare la suite pour la CI ; elle ne prouve pas qu'un pipeline hébergé a été exécuté.
L'IA peut-elle remplacer les tests d'API manuels ?
L'IA peut réduire la rédaction répétitive et aider les relecteurs à repérer les assertions faibles. Les personnes décident toujours du comportement attendu, enquêtent sur les échecs ambigus et explorent les risques en dehors des exemples fournis. Utilisez des ai tools for api testing pour produire des actifs de test examinables, puis jugez-les sur la base de preuves reproductibles. Une suite plus petite qui attrape des erreurs significatives est plus facile à croire qu'une collection inexpliquée de contrôles verts.


